本文和 混合逻辑时钟 属于同一系列。时钟帮助描述事件先后,一致性模型规定哪些读写结果才算正确。
你有一个三副本的键值存储。客户端 A 写入
x = 1,收到成功响应。随后客户端 B 读取
x,得到初始值
0。期间没有其他写入。
这是 bug 吗?
如果接口承诺线性一致性,就是
bug。如果只承诺最终一致性,这次旧值读取不一定违规:在写入停止、复制通信恢复等前提下,各副本最终应收敛到
1。但一次短暂测试既不能证明收敛,也不能证明系统永远不会收敛。
工程师经常把一致性简化成“强一致 vs 最终一致”。中间确实有很多选择,却不是一条从强到弱、包办所有属性的直线:读写排序、会话可见性、最终收敛和事务隔离,需要分开看。 放松排序也不会自动换来某个延迟或可用性指标。
这篇文章回答三个问题:
- 同一组读写历史,在线性、顺序、因果一致性下为什么会得到不同判定?
- 四种会话保证、前缀可见性和最终收敛分别补上什么,不能代替什么?
- ZooKeeper、Spanner、DynamoDB、Cassandra 的具体接口承诺是什么,怎样用 Go 检查小规模操作历史?
一、一致性模型到底在定义什么
“一致性”至少有三种常见含义:
| 含义 | 回答的问题 | 例子 |
|---|---|---|
| ACID 中的 C | 事务是否保持业务与数据库约束? | 外键、唯一性、余额约束 |
| CAP 中的 C | 操作能否表现为尊重实时序的原子访问? | 线性一致性 |
| 本文的数据一致性模型 | 并发读写允许出现哪些观察结果? | 线性、顺序、因果等模型 |
这些不是互不相干的分类;CAP 的 C 正是本文要讨论的一种模型。副本、共享内存、并发对象都可以用历史描述,模型本身不要求底层必须有多个副本。
操作历史(history)记录谁调用了什么操作、何时调用、何时返回、返回了什么。还必须指定对象的顺序规范:本文的寄存器初始为
0,写操作覆盖旧值,读操作返回合法顺序中最近一次写的值。只有“存在一个全序”,没有这条读写规范,并不足以定义线性或顺序一致性。
对象操作与事务不要混为一谈
- 线性一致性(Linearizability)适用于并发对象,也能讨论多个对象组成的历史。它有局部性:每个对象分别线性一致,组合起来仍线性一致。
- 顺序一致性(Sequential Consistency)同样能约束多对象历史,却没有这种局部性。逐键检查通过,不代表整段程序通过。
- 可串行化(Serializability)要求事务的结果等价于某个串行执行,但不要求这个串行序尊重事务之间的实时先后。
- 严格可串行化(Strict Serializability)在可串行化上加入实时序:一个事务完成后另一个才开始,前者必须排在后者之前。
可以把严格可串行化理解为“事务级的线性一致性”。不能仅凭每个键都线性一致,就推出跨键事务严格可串行化;两个线性一致的读操作之间,其他事务仍可能插入写入。
二、线性一致性与顺序一致性:差在实时序
线性一致性
Herlihy 和 Wing 的 1990 年论文 Linearizability: A Correctness Condition for Concurrent Objects 定义了线性一致性:
存在一个符合对象顺序规范的全序,每个操作仿佛在调用与返回之间的某一点完成;如果操作 A 返回后操作 B 才调用,A 必须排在 B 前面。
这里有两件事:读写结果必须符合寄存器规范;已经结束的操作,不能被排到随后开始的操作后面。 这个先后约束叫实时序(Real-time Order),不要求客户端用精确同步的物理时钟来实现。
重叠操作可以按任一方向排序,但仍要让整段历史合法。假设只有一次
write(x,1):
- 与写重叠的读可以返回
0,把它排在写之前即可;也可以返回1,排在写之后即可。 - 写返回后才开始的读必须返回
1。 - 如果一个读返回
1,它结束之后同一对象的另一个读才开始,后者不能再返回0。
第三条经常被“重叠读可以任意返回”掩盖:每个操作单独看似合理,不代表它们能共同找到一个合法顺序。
顺序一致性
Lamport 在 1979 年的论文 How to Make a Multiprocessor Computer That Correctly Executes Multiprocess Programs 中提出顺序一致性:
存在一个符合对象顺序规范的全序,并保持每个进程内部的程序序。
它不要求保持不同进程之间的实时序。这里的进程可理解为一个按顺序发请求的客户端;“进程内顺序”不能被检查器任意打乱。
构造一个反例:C1 写 1 并返回,C2 随后写
2 并返回,C3 再读到
1。每个客户端只有一个操作。
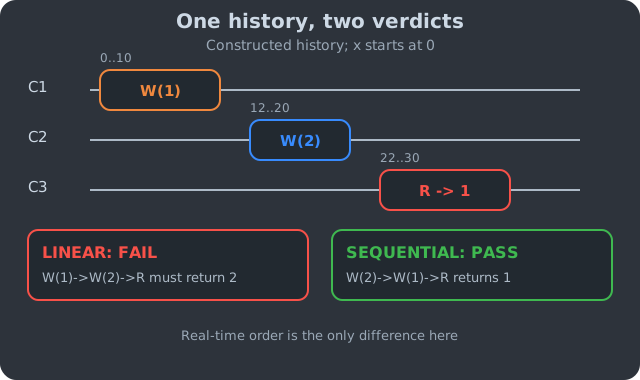
图 1|同一历史,两个判定。
线性一致性要求 W(1) → W(2) → R,所以读必须返回
2;顺序一致性可以采用
W(2) → W(1) → R,读到 1 合法。
读图要点:条形表示调用到返回的区间,时间向右推进。三条操作分别属于 C1、C2、C3,因此重排没有违反进程内程序序;图中区间是构造反例,不是延迟测量。
这并不表示顺序一致性允许任意旧值。若同一客户端依次写
1、写 2、读
1,且没有其他写入,程序序已经锁定两个写的顺序,这段历史连顺序一致性也不满足。
顺序一致性为什么不能逐键验证
设 x、y 初始都为
0:
- P1:
write(x,1),然后read(y) → 0。 - P2:
write(y,1),然后read(x) → 0。
单看 x,可把读 0 排在写
1 之前;单看 y
也可以。每个对象分别满足顺序一致性。
但合起来,程序序和读到初始值的要求构成环:
\[ W_x \prec R_y \prec W_y \prec R_x \prec W_x \]
不存在合法全序。Herlihy–Wing 论文中的线性一致性局部性,恰好避开了这种逐对象组合失效的问题。
| 维度 | 线性一致性 | 顺序一致性 |
|---|---|---|
| 共同要求 | 合法全序、进程内程序序 | 合法全序、进程内程序序 |
| 跨进程实时序 | 必须保持 | 不要求 |
| 逐对象组合 | 成立 | 不成立 |
| 能否仅凭模型推断延迟 | 不能,取决于协议和拓扑 | 不能,较少约束只提供优化空间 |
异常不是一条强弱阶梯
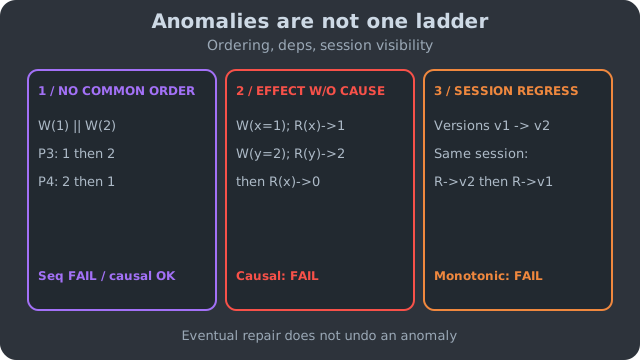
图 2|三种异常对应三种约束。 并发写观察分歧破坏共同全序;看到结果却看不到原因破坏因果依赖;同会话读回退破坏单调读。
读图要点:第一格中的 W(1) || W(2)
表示无因果关系的并发写;第三格的 v1 → v2
是版本序,不是数据值大小。最终修复能让副本收敛,却不能撤销已经发生的错误业务决策。
第一格具体是:P1 独立写 x=1,P2 独立写
x=2;P3 先读 1 再读
2,P4 先读 2 再读
1,没有其他写入。两个观察者要求相反的写顺序,所以不满足顺序一致性。基本因果一致性允许不同观察者把这两个并发写排成不同顺序;若还要求一致的冲突解决与收敛,就必须再加约束,不能把这种分歧当成永久合法状态。
Write Skew 则属于事务隔离问题。例如两个值班事务都看到另一人仍在值班,各自把自己的状态改为离岗,最后无人值班。这可以发生在快照隔离下,却不满足可串行化。它不能与寄存器的旧值读直接排在同一阶梯上。
三、因果一致性:结果不能越过原因
定义与反例
因果一致性(Causal Consistency)要求进程的观察尊重因果依赖。对读写存储,常用的依赖来源是:
- 程序序:同一进程先执行的操作先于后执行的操作。
- 读自关系(Reads-from):读返回某次写的版本,该写先于这个读。
- 传递性:两条依赖接起来,仍是一条依赖。
这沿用 Lamport 的 happens-before 思想。这里只把系统能记录的程序序、读自关系纳入模型;电话、消息或其他服务传递的依赖,只有通过上下文显式带回存储系统,才会被它识别。
设只有以下两次写,x、y 初始都为
0:P1 写 x=1;P2 读到
x=1 后写 y=2;P3 读到
y=2 后再读 x。
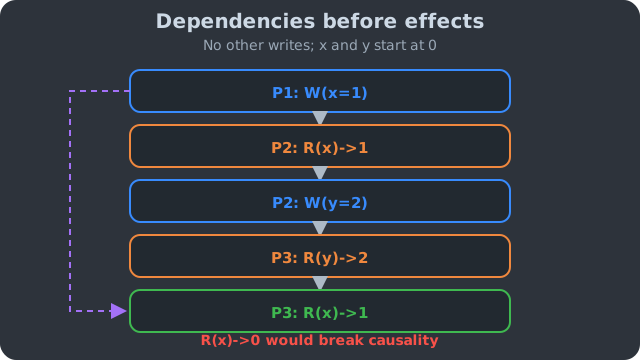
图 3|先有原因,后有结果。 P3 看到
y=2 后,后续读取不能漏掉它的因果前驱
write(x,1);在没有其他写 x
的本例中,必须返回 1。
读图要点:实线是直接的读自关系或程序序,虚线是传递性得到的可见性要求。箭头只向前,不存在从 P3 的读指回 P1 的写的依赖边;“原因必须可见”不是让原因发生在结果之后。
如果后来还有合法的覆盖写,因果一致性不要求 P3
永远读到字面值
1。保证针对的是版本依赖及其可见性,不是把某个值冻结下来。
“最强的可用一致性”有条件
Mahajan、Alvisi 和 Dahlin 的 2011 年技术报告 Consistency, Availability, and Convergence 给出的上界是实时因果一致性(Real-Time Causal Consistency,RTC),不是普通因果一致性的无条件总冠军。
报告的结论建立在值无关的读写模型、异步遗漏故障与不可靠网络、始终可用、单向收敛(one-way convergence)等假设上。这里“值无关”指排序机制不依赖写入的具体值;模型允许读返回多个并发版本,把冲突解决另放一层。它并非直接针对本文的单值覆盖写寄存器。
RTC 增加的条件是:若 A 已结束、B 才开始,依赖图不能反过来把 B 排在 A 前面;但不强制把所有这样的 A、B 建立成一条依赖边,所以仍不等于线性一致性。把上界改写成“任何比普通因果一致性更强的模型都不可能在分区下可用”,既丢了条件,也丢了 RTC 与普通因果的区别。
这个上界不是对任意数据类型、任意事务接口的总排名,更不意味着因果系统总能立即服务一个迁移过来的客户端。例如客户端在 DC1 看过某个版本,随后带着因果上下文去 DC2;如果 DC2 尚未收到那个版本,且两个数据中心正处于分区,DC2 要么等待依赖,要么拒绝这次请求,要么放弃原来的保证。
不带上下文的跨区切换,不能免费继承会话历史。 原地客户端能继续服务,与任意客户端可随意切换副本,是不同承诺。
COPS:把依赖检查放在远端可见之前
Lloyd 等人在 SOSP 2011 发表的 COPS(Clusters of Order-Preserving Servers),实现了跨数据中心的因果一致性并加入收敛,论文称为 causal+。它不只给写操作贴一个时间戳:
- 客户端维护已读、已写版本的因果上下文;新写携带必要依赖。
- 远端数据中心收到
write(y,2)时,如果依赖的x版本还没到,就先保留这次写,不让客户端看到。 - 依赖满足之后,才使新版本可见。并发冲突还需要一致的解决规则,因果顺序本身不会选出赢家。
COPS-GT 的重点是提供无锁的只读事务,让一次多键读取获得因果一致的视图;它不是一个仅靠“只追踪最近依赖”解决元数据膨胀的版本。依赖压缩、版本保留和垃圾回收仍需设计:既要减少元数据,又不能在落后副本尚未补齐时丢掉必要信息。
从 Lamport 的事件偏序到 COPS 的版本依赖,工程难点已经从“给事件编号”变成“何时可以暴露新版本”。因果一致性还不自动提供任意多键读写事务的原子性,这也是它与严格可串行化不能简单互换的原因。
四、最终收敛、会话保证与前缀可见性
最终一致性是进展承诺
最终一致性(Eventual Consistency)的常见表述是:
写入停止后,在更新能够继续传播、非故障副本继续运行等前提下,副本最终收敛到相同状态。
这个定义不指定多久收敛,也不替你定义并发冲突如何合并。一个系统允许暂时读旧值,不能据此就证明它最终一致;必须有足够的传播和冲突解决机制。
线性、顺序、因果等排序约束,主要回答“已经出现的历史能否接受”,属于安全性(Safety)。收敛主要回答“之后是否终会达成状态”,属于活性(Liveness)。安全性约束本身不保证尚未结束的操作一定完成,也不保证某个永远无人读取的副本必定更新。 因而不要画一根“线性 → 因果 → 最终”的无条件蕴含箭头。
最终一致的存储通常仍有基本有效性约束,不能凭空返回从未写过的值。实际接口还可能承诺会话语义、读隔离或新鲜度上界。缓存、统计汇总等场景也未必需要全部会话保证,不能说“纯最终一致几乎不可用”。
强最终一致性(Strong Eventual Consistency,SEC)进一步要求:收到同一组更新的副本具有相同状态;配合最终传播,得到收敛。这是 CRDT 的重要性质,但不等于线性一致,也不等于总能读到最新值,详见 CRDT 理论。
四种会话保证:保护谁的历史
Terry 等人在 PDIS 1994 的 Session Guarantees for Weakly Consistent Replicated Data 中提出四种会话保证。会话是保证的作用范围;换连接、换设备是否仍属同一会话,要看系统怎样传递上下文。
| 保证 | 需要保持的关系 | 典型违反 |
|---|---|---|
| 单调读(Monotonic Reads) | 后续读不能丢掉此前已观察到的更新 | 第一次读含版本
v2,换副本后只剩 v1 |
| 单调写(Monotonic Writes) | 同会话的写按程序序生效 | 接收端先暴露第二次写,再暴露第一次写 |
| 读己之写(Read Your Writes) | 后续读反映自己的先前写,或合法的覆盖结果 | 改完地址后刷新,仍看到改动前的版本 |
| 写跟随读(Writes Follow Reads) | 新写的可见位置不能越过其先前读所依赖的更新 | 根据帖子写出的回复,先于帖子在远端可见 |
“更新”指版本、可见更新集合或对象模型规定的顺序,不是整数越大就越新。余额从
5 被写成 -1
可以是完全合法的新版本。并发版本可能不可比较,也不能只拿一个自增序号处理所有情况。
单调写约束的是各接收端的生效顺序,不是检查客户端调用时间是否递增;后者只是程序本来就按顺序发请求。读己之写也不要求自己的值永远存在:后续合法覆盖写可以改变它。
在标准读写模型、相同会话边界及一致的可见性定义下,这四种保证组合起来可以表达因果一致性所需的约束。不能把它理解成“四个 API 选项打勾,就自动获得任意跨服务因果一致性”。
PRAM 与前缀不是相邻的两个档位
PRAM(Pipelined Random Access Memory),也称 FIFO 一致性,核心要求是:每个观察者保持同一个写进程的写入顺序;不同写进程的写仍可被观察者以不同顺序交织。它不要求保持所有读到写的跨进程因果依赖。它与会话保证的对应关系依赖具体形式化定义,不宜直接用三项会话保证的口号替代定义。
前缀一致性(Consistent
Prefix)必须先说清楚“谁的序列”。若已经指定一条写序列
A → B → C,一次观察可包含
A、A → B 或完整序列,不能跳过
A 却先包含
B。它不一定保证同一会话下一次读取的前缀更长,也不自动跨独立分区建立全局因果关系。
Azure Cosmos DB 提供名为 Consistent Prefix 的级别。其当前文档明确区分单文档写与事务批量写:前者按最终一致处理,后者保持同批事务更新一起可见;读取保证也有逻辑分区范围。不能只凭这个名称,推断“任意用户发帖与另一个用户回帖,一定按因果可见”。先核对产品对有序序列的定义,再做映射。
怎样看保证关系图

图 4|先分轴,再比较强弱。 上半图的箭头只表示同一读写模型中的排序蕴含:线性一致性蕴含顺序一致性,后者蕴含因果一致性,再蕴含 PRAM;下半图把最终收敛与其他作用范围分开。
读图要点:没有箭头就不声称蕴含,垂直位置也不代表延迟或可用性排序。严格可串行化比较的是事务;前缀可见性依赖指定的写序列;会话保证只保护被识别出的那段会话历史。图中不把整个产品贴到唯一节点上,产品的读模式和事务接口将在下一节分别核对。
五、真实系统:看接口,不给产品贴单一标签
以下依据公开文档核对至 2026 年 10 月。API、索引、复制模式和事务范围是承诺的一部分。
ZooKeeper:有全序写,不等于每次读都最新
ZooKeeper 用 ZAB 对更新排序,更新提供线性一致性;普通读通常由连接的服务器本地服务。客户端按顺序观察更新,能读到自己的成功写入,同一会话不会退回已经观察过的状态,但其他客户端刚完成的写可能尚不可见。
“写线性一致、普通读顺序一致”是常用摘要,不能把读和写拆成两个互不相干的模型。实际保证来自全序更新、每客户端
FIFO
和会话观察;整个普通读写接口不提供无条件线性一致性。官方用
ordered sequential consistency,记为
OSC(U),描述更新与读的组合保证。
更容易踩坑的是 sync。官方 ZooKeeper
Internals 的 Consistency Guarantees
明确提醒:sync 当前不是 quorum
操作,因此不能把 sync
后再读无条件当作线性一致读。它通常改善新鲜度,但在旧 Leader
等场景下仍可能不足。
若客户端先成功完成一个真正的 quorum
更新操作,再读取,可以利用该更新的排序与会话保证建立读取屏障。要把写屏障的业务副作用、成功确认及会话条件一起考虑,不能只把
sync() 当成免费升级按钮。
Spanner:默认事务的外部一致性,不包括任意历史读
Spanner 的默认 Serializable 事务提供外部一致性(External Consistency),即严格可串行化:事务有合法串行序,这个序保持非重叠事务的实时先后。默认强读可观察开始之前已提交的事务;显式选择陈旧读时,读取的是某个历史快照,不能再要求它包含调用前的全部提交。
TrueTime 返回一个覆盖真实时间的区间。提交协议选择提交时间戳,并在返回成功之前确保真实时间已经越过它,这就是 commit-wait;它还依赖复制、并发控制和跨分片事务协议。在任意数据库外面睡一会儿,不能复制出这套保证。
2012 年 Spanner 论文中的 \(\epsilon\) 是 TrueTime 区间的半宽,不是区间宽度,也不是当前产品每次提交固定增加的延迟。本文不把旧论文的毫秒数字写成今天的 SLA。强只读事务没有写提交的 commit-wait,却仍可能等待安全读时间或数据可用;“无需 commit-wait”不等于“读取零额外开销”。
DynamoDB:强读比会话保证强,事务与跨区另看
DynamoDB 读一致性文档 规定:
- 默认最终一致读可能漏掉近期成功写入。
- 表和本地二级索引(LSI)支持强一致读;它反映读取之前所有成功写入,而不只是当前会话自己的写。在普通单 item 读写语境中,这是线性一致性的“写后再读”语义。
- 全局二级索引(GSI)和 DynamoDB Streams
只支持最终一致读,不能用
ConsistentRead=true把它们升级。 - 相同大小和类型的读取,强一致读消耗的读容量是最终一致读的两倍。计费倍数不等于固定的延迟倍数,也不能据此猜测请求一定走哪台 Leader。
DynamoDB
提供事务。TransactWriteItems、TransactGetItems
支持同一区域、同一账号中跨表的多 item 事务,当前上限为 100
项,另有总大小等限制。它们和普通单 item
写等相关操作之间提供可串行化隔离;普通
Query、Scan
不会因此变成整个查询的事务快照。要保留一组 item
的原子读语义,使用对应事务接口,而不是循环强读。
Global tables 还要区分复制模式:
- MREC(Multi-Region Eventual Consistency):跨区异步复制。在本区发强读,仍可能漏掉另一区尚未复制过来的写;源区事务的多项更新也不承诺在远端原子出现。
- MRSC(Multi-Region Strong Consistency):支持在各副本强读此前成功写入,不能再笼统说“DynamoDB 全球表都是最终一致”。它有区域与功能限制,当前不支持 LSI 和事务 API。
这两种模式的约束见 Global tables 工作方式;不要把默认读模式、跨区复制和事务隔离压缩成一个 AP 标签。
Cassandra:quorum 保证交集,不包办实时序
Cassandra 的一致性级别规定一次请求需要哪些副本应答。普通读写使用 timestamp 和 Last-Write-Wins(LWW)处理冲突,不同于共识排序。
| 级别 | 请求等待的范围 | 不应推导出的保证 |
|---|---|---|
ONE |
一个副本 | 当前读一定包含所有近期写 |
QUORUM |
复制集合中的多数副本 | 普通读写自动线性一致 |
ALL |
全部副本 | 自动获得跨分区事务或实时序 |
LOCAL_QUORUM |
本地数据中心的多数副本 | 全球最新、跨区线性一致 |
设副本数为 \(N\),读、写分别等待 \(R\)、\(W\) 个副本。在相同的稳定复制集合中,\(R+W>N\) 保证读写集合有交集。它本身不证明相交副本按真实时间保存最后一次请求的值;还要考虑时间戳、冲突规则、未完成写及故障恢复。
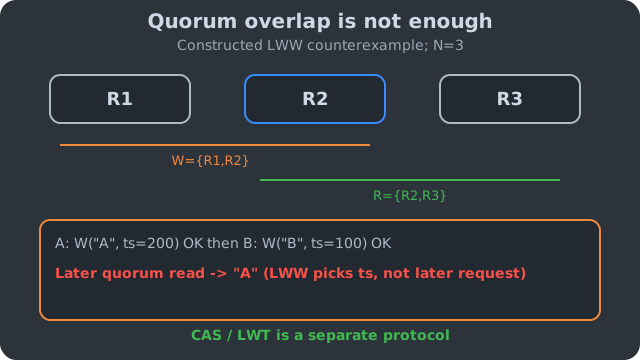
图 5|交集不是线性化点。 A 的写以时间戳
200 成功,B 随后以 100 成功,再做
quorum 读,LWW 仍可能返回 A。三次操作不重叠,返回 A
才真正构成实时序反例。
读图要点:上半图只展示集合交集;下半图展示另一个独立条件——按时间戳选赢家。200、100
是构造数字,不是时钟测量。两个重叠写谁赢,本来就可由线性一致性任选,所以仅举“并发写按
timestamp 排序”不足以证明违反。
Cassandra 的轻量事务(LWT)通过 Paxos 提供单分区
compare-and-set 的线性一致语义,涉及
SERIAL、LOCAL_SERIAL
及普通提交级别。它不是把普通写改为
QUORUM,也不是跨分区事务;需要按文档选择串行读,并避免随意混用普通写来破坏条件更新所依赖的假设。
系统接口对照
- ZooKeeper 更新 / 普通读:线性更新、FIFO
与会话观察;普通读可旧,
sync后读也不保证线性一致。 - Spanner 默认 Serializable 事务 / 强读:外部一致性;陈旧读是历史快照,其他隔离模式另查。
- DynamoDB 表 / LSI 强读:此前成功写入可见;GSI、Streams 不支持,多项原子读用事务。
- DynamoDB 跨区复制:MREC 异步,MRSC 可强读;两种模式的区域、事务和索引限制不同。
- Cassandra 普通多数派读写:应答交集与 LWW 冲突规则;不等于线性一致或跨分区原子性。
- Cassandra LWT:单分区条件更新的线性语义;串行级别、读路径与普通写混用要单独核对。
六、Go 检查器:只对能判断的历史下结论
下面的完整程序也保存在仓库文章目录的
checker.go。它检查一个覆盖写寄存器的线性一致性和顺序一致性,不声称检查因果一致性或全部会话保证。网页读者可将代码保存为
checker.go。
用已安装的 Go 运行:
go run checker.go程序仅依赖标准库,本次在 Go 1.27.3、Linux amd64 上运行。输入边界如下:
History只含一个寄存器的操作,初值由Check(h, initial)显式传入;数据值可以下降、重复、为负。- 每个操作已经成功返回;不含超时、失败、未完成操作。
Process标识串行客户端,同一客户端不能有重叠调用。CallTime、RetTime是统一记录器的事件顺序或可可信比较的时间,调用严格先于返回,事件标记互不相同。不能直接拼接未同步客户端的墙钟;精度不足的相同标记会被拒绝。
核心是两套前驱约束,完整代码如下:
package main

import (
    "fmt"
    "sort"
)

type Op struct {
    Process  int
    Type     string
    Value    int
    CallTime int64
    RetTime  int64
}

type History []Op

type Result struct {
    Linearizable bool
    Sequential   bool
}

func Check(h History, initial int) (Result, error) {
    byProcess := make(map[int]History)
    events := make(map[int64]bool)
    for i, op := range h {
        if op.Type != "read" && op.Type != "write" {
            return Result{}, fmt.Errorf("operation %d: invalid type %q", i, op.Type)
        }
        if op.CallTime >= op.RetTime {
            return Result{}, fmt.Errorf("operation %d: call must precede return", i)
        }
        if events[op.CallTime] || events[op.RetTime] {
            return Result{}, fmt.Errorf("operation %d: event times must be unique", i)
        }
        events[op.CallTime], events[op.RetTime] = true, true
        byProcess[op.Process] = append(byProcess[op.Process], op)
    }
    for pid, ops := range byProcess {
        sort.Slice(ops, func(i, j int) bool { return ops[i].CallTime < ops[j].CallTime })
        for i := 1; i < len(ops); i++ {
            if ops[i-1].RetTime >= ops[i].CallTime {
                return Result{}, fmt.Errorf("process %d: overlapping or tied operations", pid)
            }
        }
    }
    linear := make([][]int, len(h))
    sequential := make([][]int, len(h))
    for i, op := range h {
        for j, before := range h {
            if before.RetTime < op.CallTime {
                linear[i] = append(linear[i], j)
            }
            if before.Process == op.Process && before.CallTime < op.CallTime {
                sequential[i] = append(sequential[i], j)
            }
        }
    }
    return Result{accepts(h, linear, initial), accepts(h, sequential, initial)}, nil
}

func accepts(h History, predecessors [][]int, initial int) bool {
    done := make([]bool, len(h))
    var search func(int, int) bool
    search = func(placed, value int) bool {
        if placed == len(h) {
            return true
        }
        for i, op := range h {
            if done[i] {
                continue
            }
            ready := true
            for _, j := range predecessors[i] {
                if !done[j] {
                    ready = false
                    break
                }
            }
            if !ready || (op.Type == "read" && op.Value != value) {
                continue
            }
            next := value
            if op.Type == "write" {
                next = op.Value
            }
            done[i] = true
            if search(placed+1, next) {
                return true
            }
            done[i] = false
        }
        return false
    }
    return search(0, initial)
}

func main() {
    scenarios := []struct {
        name string
        h    History
    }{
        {"fresh read", History{{1, "write", 1, 0, 10}, {2, "read", 1, 12, 20}}},
        {"stale read", History{{1, "write", 1, 0, 10}, {2, "write", 2, 12, 20}, {3, "read", 1, 22, 30}}},
        {"read own old value", History{{1, "write", 1, 0, 10}, {1, "read", 0, 12, 20}}},
        {"smaller new value", History{{1, "write", 5, 0, 10}, {1, "write", -1, 12, 20}, {1, "read", -1, 22, 30}}},
        {"overlapping old read", History{{1, "write", 1, 0, 10}, {2, "read", 0, 5, 15}}},
        {"unwritten value", History{{1, "read", 9, 0, 10}}},
        {"empty history", nil},
        {"invalid type", History{{1, "delete", 1, 0, 10}}},
        {"overlapping session", History{{1, "write", 1, 0, 10}, {1, "read", 1, 5, 15}}},
        {"invalid interval", History{{1, "write", 1, 10, 0}}},
        {"tied events", History{{1, "write", 1, 0, 10}, {2, "read", 1, 10, 20}}},
        {"large timestamps", History{{1, "write", 1, 1<<62 + 1, 1<<62 + 2}, {2, "read", 1, 1<<62 + 3, 1<<62 + 4}}},
    }
    for _, s := range scenarios {
        r, err := Check(s.h, 0)
        if err != nil {
            fmt.Printf("%s: INVALID (%v)\n", s.name, err)
            continue
        }
        fmt.Printf("%s: linear=%t sequential=%t\n", s.name, r.Linearizable, r.Sequential)
    }
}线性检查保留所有“先返回、后调用”的边,顺序检查只保留同进程的程序序边。accepts
回溯枚举这些边允许的拓扑序:写更新寄存器状态,读必须匹配当前状态。如果能放完全部操作就接受;所有分支失败才拒绝。这也说明“存在一个合法序”怎么落实成检查,而不是把读值和最新调用时间做一次比较。
本次 CLI 实际输出:
fresh read: linear=true sequential=true
stale read: linear=false sequential=true
read own old value: linear=false sequential=false
smaller new value: linear=true sequential=true
overlapping old read: linear=true sequential=true
unwritten value: linear=false sequential=false
empty history: linear=true sequential=true
invalid type: INVALID (operation 0: invalid type "delete")
overlapping session: INVALID (process 1: overlapping or tied operations)
invalid interval: INVALID (operation 0: call must precede return)
tied events: INVALID (operation 1: event times must be unique)
large timestamps: linear=true sequential=true
stale read 正是图 1
的历史。smaller new value 是同一客户端写
5、再写 -1、再读
-1,两种模型都接受。read own old value
则是同一客户端写 1 后读到初始值
0,两种都拒绝。未写入的 9
也不会被当成某种弱一致性下的合法新值。
为什么不输出“最终一致性:PASS”
有限历史不能证明“将来总会收敛”。即使所有观测读都相同,仍可能存在尚未访问的落后副本;即使现在读到旧值,系统也可能稍后修复。没有传播和故障前提,给它输出
true 没有检测意义。
同样,客户端调用时间递增证明不了远端单调写;要检查单调读、读己之写,需要写版本身份及读自关系;要检查因果一致性,还需要跨键依赖和会话上下文。这些信息不在当前寄存器历史里,不能假装已验证。
从教学搜索到 Jepsen
Gibbons 和 Korach 的 Testing Shared Memories(SIAM Journal on Computing,1997)讨论了历史检验的复杂性。检查难度依赖对象类型及历史表示,不能把一句 NP-complete 当作每个寄存器算法都同样慢的结论。上面的朴素回溯最坏有阶乘级排列,定位是短反例,不承诺“几十个操作总能很快跑完”。
实际分布式测试还要处理调用成功但响应丢失、客户端崩溃、超时和未完成操作。超时不等于写没有生效。 随意把未知结果操作删掉,可能制造假反例,也可能漏掉真的问题。
Jepsen 在故障注入过程中记录历史,再交给模型对应的检查器;Knossos、Go 实现的 Porcupine 会用剪枝、分区等手段控制搜索空间。检查器超时或返回未知,不等于模型通过;一次历史通过,也只是这次执行未发现反例,不是系统正确性的证明。见 Jepsen 方法论 与 线性一致性的实现。
七、工程取舍:从业务不变量倒推接口
“强一致一定慢”说得太粗
复制状态机常需要多数派确认写入,但线性一致性定义不规定每个读都重新发起共识。有效租约、读屏障、单副本执行等方案的通信路径不同;是否正确,要看故障模型和协议前提。
跨区通信、提交等待和冲突重试都会进入延迟预算。放松保证可能去掉其中一些等待,也可能引入依赖检查或更复杂的冲突处理。没有拓扑、负载、故障条件和指标口径,就不能许诺固定 P99 或“数量级提升”。
强读也挡不住“先读再写”的竞争
库存剩余
1。两个客户端各自做一次线性一致读,都可能读到
1;随后各自写入扣减结果,仍可能卖出两件。单次读写各自正确,并不让这段业务逻辑成为原子操作。
需要的是符合范围的原子条件更新、compare-and-set,或合适的事务隔离。多个账户之间的约束要核对跨对象事务;单 item 决策则不必自动升级成全库事务。“金融选强一致”不足以描述正确方案。
弱一致也有合适的位置
如果统计页面允许暂时落后,最终一致可能足够;如果用户发布后必须立即看到自己的帖子,就补读己之写;如果回复不能越过帖子,检查跨键、跨客户端依赖是否被追踪。防重复提交需要幂等键,冲突合并需要业务规则,不能期待“最后总会收敛”替应用处理这些问题。
三个选型问题
- 要保护哪个不变量,范围是什么? 单键状态机、多键交易、整次查询快照,分别对应不同接口。
- 谁必须看见谁的结果? 任意客户端的实时后继读、同一会话的后续读、因果链后继,保证不同;换副本时上下文也要跟着走。
- 故障时愿意等什么? 多数派、远端依赖、历史快照安全时间,还是允许返回旧值。再用真实负载验证延迟与恢复,而不是按产品名猜 AP/CP。
还有一个持续的工程问题:怎样压缩与回收因果元数据,同时允许落后副本恢复和客户端迁移?COPS 给出了依赖检查的具体路径,Viotti–Vukolić 的 2016 年综述则帮助区分不同一致性定义。定义统一到哪一步、部署额外假设在哪里,决定了论文保证能否原样搬进生产系统。
八、小结
- 线性一致性:合法操作序,加跨进程实时序;它不自动提供多次操作的事务原子性。
- 顺序一致性:合法操作序,加进程内程序序;不能靠逐键验证推出全局成立。
- 因果一致性:依赖先于结果;并发冲突的统一解决与收敛需要额外规则。
- 最终一致性:在明确传播前提下最终收敛;有限历史不能证明它,收敛也不能撤销已经发生的异常。
- 会话与前缀保证:先说清作用范围、版本关系和写序列,再比较它们的强弱。
真正要选的是“在什么范围、经由什么接口、故障时仍承诺什么”,而不是一个产品名或一个“强一致”标签。
参考资料
核心论文与技术报告
- Herlihy, M., & Wing, J. M. (1990). Linearizability: A Correctness Condition for Concurrent Objects. ACM TOPLAS, 12(3), 463–492。定义及局部性。
- Lamport, L. (1979). How to Make a Multiprocessor Computer That Correctly Executes Multiprocess Programs. IEEE Transactions on Computers, C-28(9), 690–691。顺序一致性。
- Viotti, P., & Vukolić, M. (2016). Consistency in Non-Transactional Distributed Storage Systems. ACM Computing Surveys, 49(1), Article 19。模型定义、作用范围与关系;作者公开稿。
- Mahajan, P., Alvisi, L., & Dahlin, M. (2011). Consistency, Availability, and Convergence. UTCS TR-11-22,技术报告,§2–3。RTC 上界与模型假设。
- Lloyd, W., et al. (2011). Don’t Settle for Eventual: Scalable Causal Consistency for Wide-Area Storage with COPS. SOSP,§4。causal+、依赖检查与 COPS-GT。
- Terry, D. B., et al. (1994). Session Guarantees for Weakly Consistent Replicated Data. PDIS。四种会话保证。
- Gibbons, P. B., & Korach, E. (1997). Testing Shared Memories. SIAM Journal on Computing, 26(4), 1208–1244。历史检验的复杂性。
- Corbett, J. C., et al. (2012). Spanner: Google’s Globally-Distributed Database. OSDI,§3、§4.1.2。TrueTime 误差界与 commit-wait。
系统文档
- ZooKeeper Programmer’s Guide:一致性保证
- ZooKeeper Internals:Consistency Guarantees 与 sync 限制
- Spanner:TrueTime 与外部一致性
- DynamoDB:读一致性
- DynamoDB:事务 API 与隔离边界
- DynamoDB:global tables 的 MREC / MRSC
- Cassandra:Dynamo 架构、quorum 与 timestamp
- Cassandra:Guarantees 与单分区 LWT
- Azure Cosmos DB:Consistency levels,Consistent prefix 与读取范围
工具与可复现材料
- Jepsen:故障注入、历史记录与模型检查。
- Porcupine:Go 线性一致性检查器。
- 仓库文章同目录的
checker.go:与正文代码相同的单寄存器检查器及 CLI 示例。 - 仓库文章同目录的
draw_figures.py:运行python3 draw_figures.py可重绘五张图;图中历史与时间戳均为构造反例。
源码下载
本文相关源码已整理,共 2 个文件。
文章导航
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【分布式系统百科】会话保证与因果一致性:用户视角的一致性
最终一致性承诺'最终'收敛,但没说收敛之前用户会看到什么。你改了头像刷新后消失、余额先涨后跌、回复比原帖先出现——这些都是缺少会话保证的症状。Terry 等人在 1994 年定义了四种会话保证,COPS 和 Eiger 把因果一致性做到了跨数据中心,Bailis 的 Bolt-on 方案让老系统也能补上因果语义。
【分布式系统百科】无主复制:Dynamo 风格的读写 Quorum
主从复制依赖 Leader 串行化写入,Leader 挂了就得等故障转移;多主复制解决了跨数据中心延迟,但冲突解决极其复杂。无主复制(Leaderless Replication)走了第三条路:去掉 Leader,任何节点都能接受读写,用 Quorum 机制保证读到最新值。本文从 Amazon Dynamo 论文出发…
【分布式系统百科】FLP、CAP 与不可能性结果:被误读的三座里程碑
FLP 说异步系统中共识不可能,但 Raft 跑得好好的。CAP 说三选二,但 Spanner 声称兼得。矛盾不在定理本身,在于读定理时跳过了精确条件。本文回到 FLP、CAP、共识数和收割/产出四篇原始论文,逐一拆解它们的真实陈述、证明思路与工程边界。
【分布式系统实战】CRDT 入门:不靠共识也能合并——但代价是什么
Raft 保证强一致,但 Leader 一挂全卡。CRDT 不需要共识也能合并——代价是元数据膨胀、只能单调、最终一致。G-Counter、LWW-Register、OR-Set 的 Go 实现,正确性验证,以及什么时候该用 Raft、什么时候该用 CRDT。