“这笔钱好像扣了两次”“钱扣了但订单没生成”“退款退了两次”——支付系统的很多工单最后都落到三个词上:幂等(Idempotency)、事务(Transaction)、一致性(Consistency)。网络不可靠导致重试,重试要求幂等;跨服务写要求事务;分布式事务做不到廉价的强一致,就要定义一致性语义,再用补偿把状态收敛回去。
本文面向设计支付、账务、订单系统的后端工程师,不展开”什么是幂等”的名词解释,而是沿一条支付下单链路逐跳回答:哪一步必须幂等、用什么兜底、出错了怎么收敛。不展开的话题:共识协议本身、跨境清算报文细节。
上一篇《账务数据库设计》把底层存储选型讲完了,接下来我们关心的是上层:业务怎么正确地写入这些表。
一、为什么支付必须幂等
1.1 网络永远不可靠
计算机网络的一个工程公理是:一次请求要么到达、要么没到达、要么到达了但响应没回来,第三种情况对客户端而言无法与前两种区分。放到支付链路上:
- 用户点”立即支付”,客户端向网关发起请求,网关超时——钱到底扣没扣?
- 网关向银行发 ISO
8583(卡组织收单报文)请求,银行返回前网络抖动,网关未收到
00成功码——发卡行已经落账,网关不知道。 - 商户服务器回调被调用,HTTP 连接被负载均衡踢掉,支付平台没收到 200——回调会被重推。
只要链路里有任何一跳”不知道对端状态”,客户端唯一的生存策略就是重试;而重试的前提是接收方能识别重复请求并返回同一结果。这个能力就是幂等。
1.2 不幂等的真实损失
缺少幂等时,重复请求会落成三类典型资金问题:
- 重复扣款(Double Charge):同一张卡、同一笔订单被扣款两次。典型路径是网关超时后客户端重试,后端没有用订单号或幂等键识别重复,把它当成新订单。
- 少付/漏账:上游已经扣用户钱,下游入账失败,账务表没有对应贷方分录。资金跑进”在途户”(suspense account)堆积,一旦超过阈值,监管会要求写情况说明。
- 多扣(Over-Capture):同一张订单被 capture 两次(比如用户连点”确认付款”触发两次调用),虽然每笔都成功,但合计金额超过订单金额。这类问题通常在月末对账时才被发现。
这类问题难缠的原因不在代码量,而在触发条件:它们只在超时、并发重试、进程崩溃恰好落在某个窗口时出现,常规功能测试几乎覆盖不到。Warszawski 与 Bailis 在 2017 年的 ACIDRain 研究中对 12 个电商应用做并发攻击,找到 22 个可利用的并发异常,说明”应用层判重 + 弱隔离级别”在真实代码里很常见。
1.3 重试的四种来源
重试不只来自网络层。把支付链路画出来,我们至少能看到四类不同来源的重试:
- 客户端重试:用户连点、App 自动重发、SDK 内置 backoff。
- 网关/中间件重试:HTTP 客户端在 502/504 上的自动 retry、Service Mesh 的 retry budget。
- 回调重发:支付平台无法确认商户收到通知,会按 0s、30s、1min、5min、…、24h 的指数退避持续重推,直到商户返回成功或达到上限。
- 消息中间件重投:Kafka 的 at-least-once、RocketMQ 的重试队列、SQS 的 visibility timeout 过期都会导致同一消息多次投递。
系统里只要包含这四类来源中的任何一类,接收方就必须假设”任意接口、任意时刻都可能收到重复请求”。这不是防御式编程,是底线。
二、幂等的三层设计
幂等不是一个开关,而是一个需要在三层协作的系统属性。
2.1 接口层:Idempotency-Key 与请求指纹
接口层的目标是:对同一个逻辑请求,无论重试多少次,都返回同一结果(包括同样的副作用次数——恰好一次)。
最干净的做法是客户端生成一个全局唯一的
Idempotency-Key(UUID v4 或 ULID),随 HTTP
头发送:
POST /v1/charges HTTP/1.1
Host: api.example.com
Idempotency-Key: 9c4e4c1e-3b8e-4d7d-9f7e-2f4a6c7d8e9f
Content-Type: application/json
Authorization: Bearer ***

{"amount": 12000, "currency": "CNY", "source": "card_xxx"}
服务端收到后:
- 若 key 不存在:正常处理,把 key、请求指纹(Request Fingerprint)、响应体、状态码一并写入幂等表。
- 若 key 存在且指纹匹配:直接返回缓存的响应体与状态码(包括 4xx)。
- 若 key 存在但指纹不匹配:返回
422 Unprocessable Content,提示”该 key 已用于不同请求”。 - 若 key 存在但处理中:返回
409 Conflict,可带Retry-After,让客户端稍后再试。
这两个状态码取自 IETF HTTPAPI 工作组的 The Idempotency-Key HTTP Header Field 草案(draft-07 第 2.7 节)。该草案目前仍是 Internet-Draft,没有成为 RFC,引用时应视为”业界共识的整理”而非强制标准。
Stripe 的官方文档写明:它保存某个
key 第一次请求的状态码和响应体,无论成功失败,包括
500;key 在至少 24
小时后可能被清理,清理后再用同一 key
会被当成新请求;参数与原请求不一致会报错;参数校验失败或与并发中的同
key
请求冲突时不保存结果,客户端可以重试。超过保留期的重试由业务层(见
2.2)兜底。
2.2 业务层:唯一业务单号与状态机
接口层只能挡住”同一 key 的重试”,挡不住”同一逻辑、不同 key 的重试”(例如客户端为每次重试都生成新 key)。业务层的兜底是业务唯一约束:
- 每笔支付必须带商户订单号
out_trade_no,在支付机构侧与商户维度组成唯一索引(merchant_id, out_trade_no)。 - 每次退款必须带退款单号
out_refund_no,在(charge_id, out_refund_no)上唯一。 - 每笔转账带
transfer_id,在(tenant_id, transfer_id)上唯一。
当业务系统收到一个已经存在的 out_trade_no
时,如果请求参数与第一次一致,应返回和第一次一致的结果,而不是报错”订单已存在”;如果同一
out_trade_no
带着不同金额再来,就不是重试而是客户端错误,应拒绝并保留第一次的订单不动。
2.3 数据层:去重表与唯一索引
最后一层是数据库。即便接口和业务都漏了,数据库的唯一索引也应当拦住双写:
CREATE TABLE idempotency_keys (
    key_hash        BYTEA       PRIMARY KEY,
    tenant_id       BIGINT      NOT NULL,
    endpoint        TEXT        NOT NULL,
    request_hash    BYTEA       NOT NULL,
    response_code   SMALLINT,
    response_body   JSONB,
    status          SMALLINT    NOT NULL,   -- 0=processing,1=done,2=failed
    created_at      TIMESTAMPTZ NOT NULL DEFAULT now(),
    expires_at      TIMESTAMPTZ NOT NULL
);

CREATE INDEX idx_idem_expire ON idempotency_keys (expires_at);
配合业务表:
CREATE TABLE charges (
    id              BIGINT      PRIMARY KEY,
    merchant_id     BIGINT      NOT NULL,
    out_trade_no    VARCHAR(64) NOT NULL,
    amount          BIGINT      NOT NULL,
    currency        CHAR(3)     NOT NULL,
    status          SMALLINT    NOT NULL,
    created_at      TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (merchant_id, out_trade_no)
);
三层叠加形成防御纵深:任何一层被绕过,下一层仍有机会拦住重复写入。注意它们的保留期不同——幂等表会过期,业务唯一索引不会,所以真正的长期兜底是业务表。
三、Idempotency-Key 的工程细节
3.1 请求指纹与响应缓存
幂等表里除了存 key,还得存请求指纹和响应快照,否则遇到”同 key 不同 body”的异常请求就只能抛 500。指纹通常是对请求体按字段白名单做规范化后哈希(SHA-256),规范化要点:
- JSON 字段按字典序排序;
- 数值字段按 decimal 精度归一(
100与100.00等价); - 忽略
client_ip、timestamp等环境字段; - 二进制字段用 base64 编码。
响应缓存则要把HTTP
status、响应头白名单、响应体都存下来,重放时原样返回。一个设计选择是:如果第一次响应是
202 Accepted(异步),重试时业务状态已经推进,你要么原样返回
202(严格重放),要么返回当前状态。Stripe
文档描述的是前者:同一 key
返回第一次保存的结果;想拿最新状态应调用 GET。
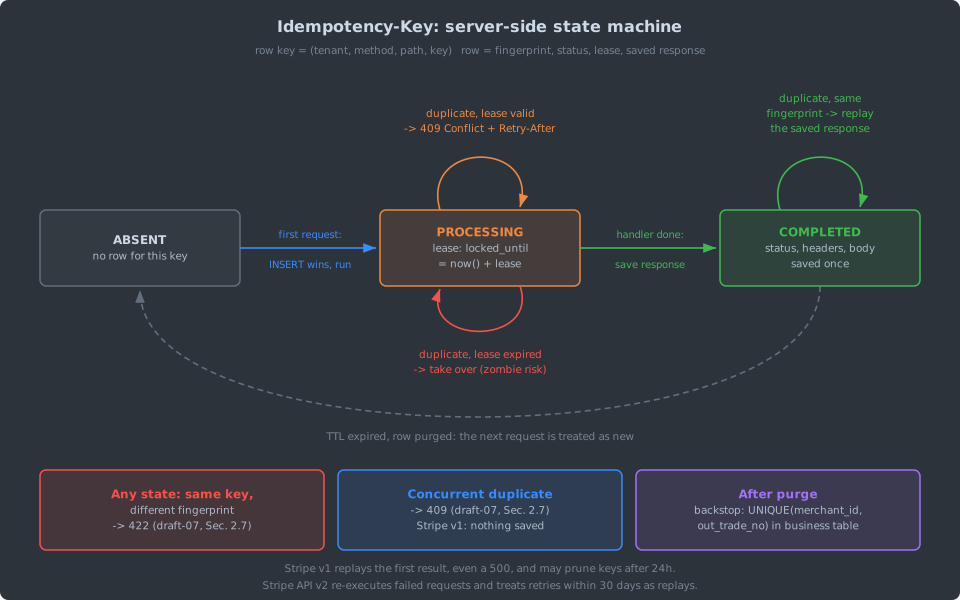
下图把服务端一个 key
的生命周期画成状态机。PROCESSING
带租约(lease),持有者崩溃后租约过期,后来的重复请求可以接管;接管存在”旧持有者其实还活着”的僵尸风险,因此业务表的唯一约束必须保留。
3.2 并发与竞态
幂等的难点不是串行重试,而是并发重试。客户端超时后立即重试,两次请求可能同时到达两台不同的服务实例:
- 实例 A 查幂等表,key 不存在;
- 实例 B 查幂等表,key 也不存在;
- A 开始处理,B 也开始处理;
- 两次都写了数据,才发现冲突。
正确做法是在第一次查询就占位:
-- PostgreSQL:INSERT ... ON CONFLICT(MySQL 用 INSERT IGNORE 后检查 affected rows)
INSERT INTO idempotency_keys (key_hash, tenant_id, endpoint, request_hash, status, expires_at)
VALUES ($1, $2, $3, $4, 0, now() + interval '24 hours')
ON CONFLICT (key_hash) DO NOTHING
RETURNING key_hash;- 如果
RETURNING有值:本实例抢到锁,继续处理。 - 如果无值:说明已存在,改为
SELECT读出原记录:status=1:直接返回缓存响应;status=0:返回409 Retry-After,让客户端稍后重试;status=2:返回记录里的失败响应。
“占位—处理—回填”三步一定要分开事务,否则长事务会把幂等表锁成热点。占位那条
INSERT 立即提交,处理完业务再开一个短事务更新
status=1 并写入响应缓存。
3.3 与重试 backoff 的互动
客户端重试策略与服务端幂等共同决定了端到端成本。常见反模式是客户端用固定间隔 1s 重试 10 次:服务端还没处理完,客户端已经又打了 9 个 409,查幂等表的 QPS 直接飙到业务 QPS 的 10 倍。
工程上推荐:
- 客户端:指数退避 + jitter,例如
min(2^n * 100ms + rand(100ms), 30s),最多重试 6 次。 - 服务端:
Retry-After头显式告诉客户端该等多久,幂等占位记录里存一个expected_duration_ms,Retry-After = max(0, expected_duration_ms - elapsed)。 - 熔断:客户端连续 N 次 409 后熔断对同一 key 的查询,直接走 GET 查最终状态。
3.4 Idempotency-Key 的 TTL 与清理
幂等表会迅速膨胀。保留期至少要覆盖客户端的最长重试窗口;Stripe 文档给出的是”至少 24 小时”,自建系统常按对账周期取更长。清理方式:
expires_at上建索引 + 定时DELETE WHERE expires_at < now()小批量清理;- 或者按天分表/分区,过期直接
DROP PARTITION,避免大事务。
TiDB 从 v6.5 起支持行级 TTL,可以把手动清理交给后台任务:
CREATE TABLE idempotency_keys (...) TTL = `expires_at` + INTERVAL 0 DAY;四、订单状态机
4.1 一笔支付的生命周期
Idempotency-Key 保证的是”同一请求不会执行两次”,但支付本身是个跨越多步骤的流程,需要显式建模成状态机。一个典型的卡支付状态机:
stateDiagram-v2
    [*] --> Created
    Created --> Authorizing: submit
    Authorizing --> Authorized: auth_ok
    Authorizing --> Failed: auth_fail
    Authorized --> Capturing: capture
    Capturing --> Captured: capture_ok
    Capturing --> Authorized: capture_retry
    Captured --> Refunding: refund
    Refunding --> Refunded: refund_ok
    Refunding --> Captured: refund_fail
    Authorized --> Reversed: void
    Created --> Canceled: cancel
    Failed --> [*]
    Refunded --> [*]
    Reversed --> [*]
    Canceled --> [*]
几个细节:
- Authorize 与 Capture
分离:卡支付里授权(ISO 8583 的
0100授权请求)只占用持卡人额度,随后的请款/清算才真正形成扣款,两者是独立环节,可以分别成功或失败。 - Capturing、Refunding 是中间态:区分”请求已发出、等待网络回执”与”确认成功”非常关键。没有中间态的状态机一旦超时就只能回滚,容易造成资金悬挂。
- 非法跃迁必须拒绝:比如
Refunded → Captured不可达。状态机实现里要有白名单校验。
4.2 状态机持久化
不要把状态机实现成内存对象,必须落库。推荐结构:
CREATE TABLE payment_state (
    charge_id       BIGINT      PRIMARY KEY,
    state           SMALLINT    NOT NULL,
    version         INT         NOT NULL DEFAULT 0,
    last_event_id   BIGINT,
    updated_at      TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE payment_events (
    id              BIGSERIAL   PRIMARY KEY,
    charge_id       BIGINT      NOT NULL,
    event_id        VARCHAR(64) NOT NULL,   -- 上游事件 ID
    from_state      SMALLINT    NOT NULL,
    to_state        SMALLINT    NOT NULL,
    event_type      VARCHAR(32) NOT NULL,
    payload         JSONB,
    created_at      TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (charge_id, event_id)
);
跃迁用乐观锁保护:
UPDATE payment_state
SET state = $new_state, version = version + 1, last_event_id = $event_id, updated_at = now()
WHERE charge_id = $id AND state = $expected_state AND version = $expected_version;
UPDATE 影响行数为 0
就说明被别人先跃迁了,业务层要决定:重新读取状态后重试、报错、或者静默成功。
4.3 状态机与幂等的协同
同一个 event_id(上游传来的事件 ID)对同一
charge_id 只允许消费一次——这就是
payment_events 上
UNIQUE (charge_id, event_id) 的作用。事件插入与
payment_state
的条件更新放在同一个本地事务里,重复事件触发唯一冲突,整笔回滚后直接丢弃。
把状态机与 Idempotency-Key 并列理解:前者保护跨事件的一致性,后者保护同一事件的幂等性,两者是正交的。
五、分布式事务方案与谱系
单机事务的 ACID 在跨服务、跨数据库时要付出协调成本。CAP 定理(Gilbert & Lynch 2002 给出证明)说的是:发生网络分区时,系统无法同时保证线性一致和每个请求都得到非错误响应;它不是”平时三选二”,而是分区期间的取舍。工程上更常用的是按业务需要选择一致性强度,BASE(Basically Available, Soft state, Eventually consistent)是其中偏可用的一端。
今天支付系统里的几种模式并非凭空出现,它们分别来自三条研究线:原子提交(2PC/XA)、补偿(Sagas/TCC)、幂等消息与 API。
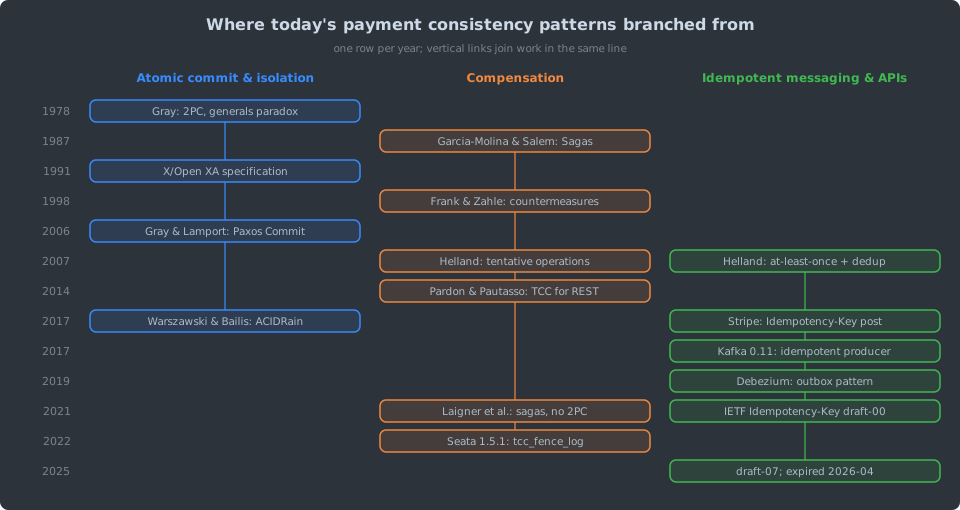
下面把主流方案逐一展开。
5.1 两阶段提交(2PC / XA)
2PC 的流程最早由 Gray 在 1978 年的 Notes on Data Base Operating Systems 中系统描述:协调者先向所有参与者发 Prepare,全部 OK 后发 Commit,任一 Prepare 失败则发 Rollback。
工程落地里它的代表是 XA 协议(X/Open
1991 年发布的 XA
规范),Oracle、DB2、MySQL(InnoDB)、PostgreSQL(PREPARE TRANSACTION)等数据库都支持。
2PC 的硬伤:
- 协调者故障时阻塞:参与者投了 Yes 之后,如果协调者在发出决定前宕机,参与者处于 in-doubt 状态——锁还占着、既不能自行提交也不能自行回滚,只能等协调者恢复或人工介入。Gray 与 Lamport 2006 年的 Paxos Commit 正是为消除这一阻塞而提出。
- 同步阻塞:Prepare 阶段参与者的锁必须持有到 Commit 结束,高并发下吞吐骤降。
- 跨公网不适用:握手次数多,任一网络抖动都会放大成超时。
结论:2PC 适合参与者少、网络可控、对强一致要求高的场景,比如同一机房内的批处理;面向互联网的跨服务支付链路较少直接使用 XA。
5.2 TCC(Try-Confirm-Cancel)
TCC 把”预留—确认—取消”的业务协议显式化;Pardon 与 Pautasso 在 2014 年把它整理为面向 REST 服务的 Atomic Distributed Transactions: a RESTful Design。每个参与者实现三个接口:
- Try:做预留/冻结,不实际生效。例如扣款的 Try 是”冻结 100 元”。
- Confirm:真正生效。扣款的 Confirm 是”从冻结账户实际扣除”。
- Cancel:释放预留。扣款的 Cancel 是”解冻 100 元”。
协调者收到业务请求后:
- 所有参与者先调 Try;
- 全部 OK 则依次调 Confirm;
- 任一 Try 失败则对已 Try 成功的调 Cancel。
TCC 的优点:
- 无锁:Try 阶段只冻结业务资源,不持有数据库行锁,吞吐远高于 2PC;
- 跨语言、跨系统:只要实现三个 HTTP 接口即可;
- 补偿语义清晰:Cancel 显式定义,不靠日志回放。
代价:
- 业务侵入强:每个参与者都要多写两倍代码;
- 空回滚与悬挂:Cancel 先到、Try 后到会造成”空回滚后再冻结”,需要防悬挂记录(见 7.3);
- 幂等要求三倍:Try/Confirm/Cancel 都必须幂等。
开源实现:Seata 的 TCC 模式、DTM 的 TCC。
5.3 SAGA
SAGA 概念来自 Garcia-Molina 与 Salem 1987 年的 SIGMOD 论文 Sagas,核心思想是把长事务拆成一串短事务,每个短事务有对应的补偿事务。成功则顺序推进,失败则逆序补偿。论文同时指出代价:Saga 之间没有隔离,中间状态对外可见。
SAGA 有两种协调方式:
- Orchestration(编排):有一个中央协调器(Saga Coordinator),显式调度每一步。代表实现:Temporal、AWS Step Functions、DTM 的 Saga 模式、Seata 的 Saga 模式。
- Choreography(编舞):没有中心,每个服务订阅上一步的事件并决定自己干什么。代表实现:基于 Kafka/RocketMQ 事件驱动的微服务链。
对比:
| 维度 | Orchestration | Choreography |
|---|---|---|
| 可观测性 | 强:整个流程一图看全 | 弱:链路分散在多服务 |
| 耦合度 | 协调器知道所有参与者 | 各服务只知道事件 schema |
| 改动成本 | 改协调器 | 改多个服务的事件监听 |
| 运行时开销 | 协调器是潜在瓶颈 | 无中心瓶颈 |
| 故障定位 | 一处回放即可复盘 | 需要跨服务串 trace_id |
工程上,SAGA 是互联网金融场景里最常见的选择。它不要求参与者实现冻结语义(这是 TCC 的痛点),也不要求全局锁(这是 2PC 的痛点),代价是只能做到最终一致性。对大多数业务来说这是可接受的——用户在”下单后 5 秒看到订单生成”和”下单时阻塞等待所有事务提交”之间,一定选前者。
5.4 可靠消息最终一致性
这个方案的核心是:把本地事务与消息发送绑定,让下游通过消费消息触发自己的本地事务。代表:
- RocketMQ 事务消息:生产者先发”半消息”,本地事务成功后提交,失败则回滚;Broker 对长时间未决的半消息回查生产者,确定最终状态(见 RocketMQ 文档)。
- Kafka Outbox Pattern:Kafka 本身没有事务消息,但可以通过 Outbox 表 + CDC(Change Data Capture)实现等价语义(见第六章)。
- Pulsar Transaction:Apache Pulsar 2.7+ 原生支持事务消息。
5.5 四种方案的选型矩阵
| 方案 | 一致性 | 吞吐 | 侵入性 | 运维复杂度 | 典型场景 |
|---|---|---|---|---|---|
| 2PC/XA | 强 | 低 | 低(数据库协议级) | 高(悬挂恢复) | 银行核心批扣 |
| TCC | 最终(Try 预留提供业务级隔离) | 中 | 高 | 中 | 需要资源冻结的扣款、额度占用 |
| SAGA | 最终 | 高 | 中 | 中(协调器) | 互联网支付、电商下单 |
| 可靠消息 | 最终 | 高 | 低 | 低(依赖 MQ) | 异步通知、对账触发 |
一个常见的工程组合:同步主链路用 SAGA,异步边链路用可靠消息,少数强一致诉求点用 TCC。
六、Outbox Pattern 与 CDC
6.1 问题的提出
可靠消息方案有一个经典坑:本地事务与消息发送不在同一个事务里。假设订单服务写订单 + 发 MQ:
tx BEGIN
  INSERT INTO orders (...);
  mqProducer.send("order.created", ...);   // ← 这里失败怎么办?
tx COMMIT
两种失败都会出事:
- 订单写成功,MQ 发失败 → 下游永远收不到事件;
- MQ 发成功,订单回滚 → 下游按”幻订单”处理。
RocketMQ 事务消息通过”半消息 + 回查”解决,但绑定了 RocketMQ。跨 MQ 可移植的方案是 Outbox Pattern。
6.2 Outbox 表设计
把”要发的消息”作为一条记录插到与订单同一个数据库的 outbox 表里,这样它们天然共享事务:
CREATE TABLE outbox (
    id              BIGSERIAL   PRIMARY KEY,
    aggregate_type  VARCHAR(32) NOT NULL,
    aggregate_id    VARCHAR(64) NOT NULL,
    event_type      VARCHAR(64) NOT NULL,
    payload         JSONB       NOT NULL,
    created_at      TIMESTAMPTZ NOT NULL DEFAULT now(),
    published_at    TIMESTAMPTZ
);

CREATE INDEX idx_outbox_unpub ON outbox (id) WHERE published_at IS NULL;
事务里同时写业务表和 outbox:
BEGIN;
INSERT INTO orders (...) VALUES (...);
INSERT INTO outbox (aggregate_type, aggregate_id, event_type, payload)
    VALUES ('order', '12345', 'OrderCreated', '{"amount":10000}');
COMMIT;
然后由一个独立的 Relay 进程或
CDC 工具读 outbox 推到
MQ。读一条、推一条、标记
published_at,失败则下次重试。因为是读库推
MQ,at-least-once
投递天然成立,消费者只需保证幂等即可。
6.3 用 CDC 替代 Relay
Debezium 订阅 PostgreSQL 的 WAL 或 MySQL 的 binlog,把 outbox 表的变更直接转成 Kafka 消息,完全不需要业务代码主动发消息。好处:
- 更低的发布延迟:不需要轮询 outbox 表,变更写入日志后即可被捕获;
- 保持提交顺序:按 LSN/binlog 位点顺序读取;
- 不占业务吞吐:CDC 是旁路,但会占用复制槽与日志保留空间。
代价:
- 需要运维一套 Kafka + Debezium;
- Schema 变更要和下游协调;
- 首次快照可能对主库有冲击,需要用
incremental snapshot。
Debezium 为此提供了 Outbox
Event Router 单消息转换,按 aggregatetype
路由 topic、以 aggregateid 作为消息
key,同一聚合的事件因此落在同一分区、保持顺序。
七、补偿策略
7.1 自动补偿 vs 人工介入
SAGA 和 TCC 都要求补偿可自动执行,但”能自动”不等于”应当自动”。一个可执行的分流规则:
- 技术失败(网络超时、DB 短暂不可用)→ 带退避的自动重试,超过上限再补偿;
- 业务失败(风控拒绝、账户不存在)→ 立即补偿,不重试;
- 资金异常(金额不匹配、货币不一致)→ 停止自动流程,挂人工工单。
自动补偿重试达到上限后,应把资金挂到独立的差错/暂挂科目,由清结算人员核查,而不是无限重试。这样做把”未知”显式记账,避免自动化在异常输入下把问题放大。
7.2 补偿也要幂等
重复补偿是真实存在的——SAGA 协调器重启、MQ 重投、人工按错按钮,都会导致同一个 Cancel 被调两次。补偿接口必须:
- 对同一
saga_id + step_id只扣减/解冻一次; - 带版本号,已补偿则静默返回成功;
- 补偿失败单独告警,不要掩盖在”最终成功”的统计里。
7.3 空回滚、悬挂与防悬挂
TCC 的两个经典问题必须显式处理,下图对比了有无防悬挂记录时的时序:
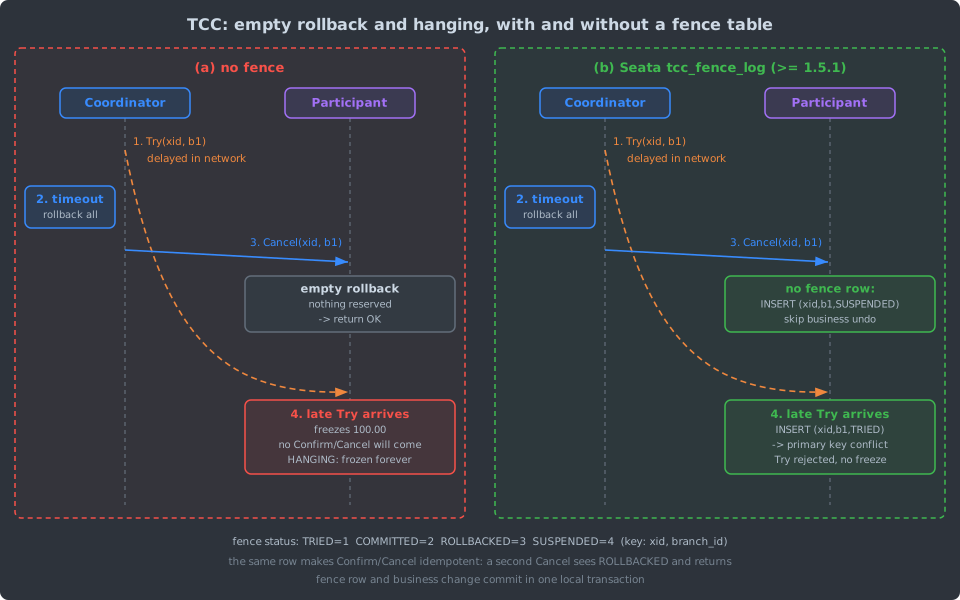
- 空回滚(Empty Rollback):Try 因网络延迟未到达,协调者超时发起回滚,Cancel 先到。参与者找不到 Try 记录,应直接返回成功且不做任何业务撤销,同时留下一条”已回滚”标记。
- 悬挂(Hanging):空回滚之后,迟到的 Try 才到达。如果照常执行,就会冻结资金,而全局事务已经结束,不会再有 Confirm 或 Cancel 来释放它。防悬挂的做法是让 Try 先检查标记:发现该分支已回滚,就拒绝执行、不预留任何资源。
Seata 从 1.5.1 起提供 tcc_fence_log
表实现这套逻辑(见 Seata
TCC 文档):以 (xid, branch_id)
为主键,Cancel 发现无记录时插入状态为 SUSPENDED
的行并跳过业务撤销;迟到的 Try 插入 TRIED
行时撞主键而失败;同一行还让重复的 Confirm/Cancel
看到已完成状态后直接返回。关键前提是:fence
记录与业务变更在同一个本地事务里提交,否则两者之间仍有窗口。
可靠消息方案没有这两个问题(因为它不做预留),但多了消息积压和消息顺序问题,需要在消费端做好幂等 + 业务状态机。
7.4 补偿链路的资源隔离
大促后集中退款这类流量尖峰,最容易暴露的问题是补偿链路与正向链路共用线程池和连接池:正向请求打满下游后,补偿请求也排不上队,订单停在
Refunding 这类中间态。可执行的隔离手段:
- 协调器入口加令牌桶限流;
- 正向与补偿使用不同的线程池、连接池和消息分区;
- 所有中间态设置
stuck_duration告警,超过阈值转人工工单。
八、代码示例
下面给出一个最小可用的工程骨架。语言选 Go,因为它更贴近支付网关团队的主流技术栈;Java 的等价实现思路一致,只是换成 Spring Boot + MyBatis。
8.1 Idempotency-Key 中间件(Go)
package idem

import (
    "bytes"
    "context"
    "crypto/sha256"
    "encoding/json"
    "errors"
    "io"
    "net/http"
    "time"
)

type Store interface {
    Acquire(ctx context.Context, key []byte, reqHash []byte, ttl time.Duration) (acquired bool, cached *Response, err error)
    Complete(ctx context.Context, key []byte, resp *Response) error
}

type Response struct {
    Status int             `json:"status"`
    Header http.Header     `json:"header"`
    Body   json.RawMessage `json:"body"`
}

type Middleware struct {
    store Store
    ttl   time.Duration
}

func New(store Store, ttl time.Duration) *Middleware {
    return &Middleware{store: store, ttl: ttl}
}

func (m *Middleware) Wrap(h http.Handler) http.Handler {
    return http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
        key := r.Header.Get("Idempotency-Key")
        if key == "" || r.Method != http.MethodPost {
            h.ServeHTTP(w, r)
            return
        }
        bodyHash, err := hashBody(r)
        if err != nil {
            http.Error(w, "cannot read body", http.StatusBadRequest)
            return
        }
        keyHash := sha256.Sum256([]byte(key))
        acquired, cached, err := m.store.Acquire(r.Context(), keyHash[:], bodyHash, m.ttl)
        if errors.Is(err, ErrConflict) {
            http.Error(w, "idempotency key reused with different payload", http.StatusUnprocessableEntity)
            return
        }
        if err != nil {
            http.Error(w, "idempotency store error", http.StatusServiceUnavailable)
            return
        }
        if !acquired && cached != nil {
            writeCached(w, cached)
            return
        }
        if !acquired && cached == nil {
            w.Header().Set("Retry-After", "2")
            http.Error(w, "request in progress", http.StatusConflict)
            return
        }
        rec := &recorder{ResponseWriter: w, status: 200}
        h.ServeHTTP(rec, r)
        _ = m.store.Complete(r.Context(), keyHash[:], rec.snapshot())
    })
}

// hashBody 读出 body 计算 SHA-256 后放回,供后续 handler 再读。
// 生产实现应先按字段白名单做 JSON 规范化(见 3.1),并用 http.MaxBytesReader 限制大小。
func hashBody(r *http.Request) ([]byte, error) {
    b, err := io.ReadAll(r.Body)
    if err != nil {
        return nil, err
    }
    r.Body = io.NopCloser(bytes.NewReader(b))
    sum := sha256.Sum256(b)
    return sum[:], nil
}

type recorder struct {
    http.ResponseWriter
    status int
    buf    []byte
}

func (r *recorder) WriteHeader(code int) { r.status = code; r.ResponseWriter.WriteHeader(code) }
func (r *recorder) Write(p []byte) (int, error) {
    r.buf = append(r.buf, p...)
    return r.ResponseWriter.Write(p)
}
func (r *recorder) snapshot() *Response {
    return &Response{Status: r.status, Header: r.Header().Clone(), Body: r.buf}
}

func writeCached(w http.ResponseWriter, c *Response) {
    for k, vs := range c.Header {
        for _, v := range vs {
            w.Header().Add(k, v)
        }
    }
    w.WriteHeader(c.Status)
    _, _ = w.Write(c.Body)
}

var ErrConflict = errors.New("idempotency key conflict")
PostgreSQL 实现 Store(为聚焦逻辑,这里假设
key_hash 已由 tenant、endpoint 与原始 key
共同哈希得到,表中省略了
tenant_id、endpoint 两列):
func (p *PgStore) Acquire(ctx context.Context, key, reqHash []byte, ttl time.Duration) (bool, *Response, error) {
    // 第一步:尝试占位。RETURNING 只有在本次真正插入时才返回行。
    var inserted []byte
    err := p.db.QueryRowContext(ctx, `
        INSERT INTO idempotency_keys (key_hash, request_hash, status, expires_at)
        VALUES ($1, $2, 0, now() + make_interval(secs => $3))
        ON CONFLICT (key_hash) DO NOTHING
        RETURNING key_hash
    `, key, reqHash, ttl.Seconds()).Scan(&inserted)
    if err == nil {
        return true, nil, nil
    }
    if !errors.Is(err, sql.ErrNoRows) {
        return false, nil, err
    }

    // 第二步:已存在,读出原记录判断。
    var (
        storedHash []byte
        status     int
        body       sql.NullString
    )
    err = p.db.QueryRowContext(ctx, `
        SELECT request_hash, status, response_body::text
        FROM idempotency_keys WHERE key_hash = $1
    `, key).Scan(&storedHash, &status, &body)
    if errors.Is(err, sql.ErrNoRows) {
        return false, nil, nil // 刚被清理,让客户端重试
    }
    if err != nil {
        return false, nil, err
    }
    if !bytes.Equal(storedHash, reqHash) {
        return false, nil, ErrConflict
    }
    if status == 0 {
        return false, nil, nil // processing
    }
    var resp Response
    if err := json.Unmarshal([]byte(body.String), &resp); err != nil {
        return false, nil, err
    }
    return false, &resp, nil // done 或 failed,都重放保存的响应
}
两步法的要点是用 RETURNING
是否有行来区分”本实例刚插入”与”已有记录”。曾经流行的写法
ON CONFLICT DO UPDATE SET key_hash = EXCLUDED.key_hash RETURNING ...
在冲突时也会返回行,若再用”status=0
且指纹相同”推断”是我插入的”,就会把另一个实例正在处理的请求误判成自己抢到了锁,导致同一请求执行两次。这段代码没有实现
3.2 节提到的租约接管,持有者崩溃后的 status=0
记录要靠 locked_until 字段或后台任务回收。
8.2 Outbox 发布器(Go)
func publish(ctx context.Context, db *sql.DB, mq MQ) error {
    rows, err := db.QueryContext(ctx, `
        SELECT id, event_type, payload FROM outbox
        WHERE published_at IS NULL
        ORDER BY id ASC
        LIMIT 500
        FOR UPDATE SKIP LOCKED`)
    if err != nil { return err }
    defer rows.Close()

    type msg struct{ id int64; topic string; body []byte }
    var batch []msg
    for rows.Next() {
        var m msg
        if err := rows.Scan(&m.id, &m.topic, &m.body); err != nil { return err }
        batch = append(batch, m)
    }

    for _, m := range batch {
        if err := mq.Send(ctx, m.topic, m.body); err != nil {
            return err // 下次重试
        }
        _, _ = db.ExecContext(ctx, `UPDATE outbox SET published_at = now() WHERE id = $1`, m.id)
    }
    return nil
}
关键点:
FOR UPDATE SKIP LOCKED让多个 Relay 实例并行跑不重复;- 批量读、逐条发、逐条标;
- 发送失败立即 return,依赖外层循环 backoff。
8.3 Java 版 Idempotency 中间件(Spring Boot)
对使用 Spring 生态的团队,上面的 Go
例子可以直接翻译为一个 HandlerInterceptor:
@Component
public class IdempotencyInterceptor implements HandlerInterceptor {

    private final IdempotencyStore store;
    private final Duration ttl;

    public IdempotencyInterceptor(IdempotencyStore store,
                                  @Value("${idem.ttl:PT24H}") Duration ttl) {
        this.store = store;
        this.ttl = ttl;
    }

    @Override
    public boolean preHandle(HttpServletRequest req, HttpServletResponse resp, Object handler)
            throws Exception {
        if (!"POST".equals(req.getMethod())) return true;
        String key = req.getHeader("Idempotency-Key");
        if (key == null || key.isBlank()) return true;

        byte[] body = ((ContentCachingRequestWrapper) req).getContentAsByteArray();
        byte[] reqHash = DigestUtils.sha256(body);
        byte[] keyHash = DigestUtils.sha256(key.getBytes(StandardCharsets.UTF_8));

        IdempotencyStore.AcquireResult r = store.acquire(keyHash, reqHash, ttl);
        if (r.acquired()) {
            req.setAttribute("idem.keyHash", keyHash);
            return true;
        }
        if (r.cachedResponse() != null) {
            resp.setStatus(r.cachedResponse().status());
            r.cachedResponse().headers().forEach(resp::setHeader);
            resp.getOutputStream().write(r.cachedResponse().body());
            return false;
        }
        resp.setHeader("Retry-After", "2");
        resp.sendError(409, "request in progress");
        return false;
    }

    @Override
    public void afterCompletion(HttpServletRequest req, HttpServletResponse resp, Object handler, Exception ex) {
        byte[] keyHash = (byte[]) req.getAttribute("idem.keyHash");
        if (keyHash == null) return;
        ContentCachingResponseWrapper w = (ContentCachingResponseWrapper) resp;
        store.complete(keyHash, new IdempotencyStore.Snapshot(
                w.getStatus(),
                Map.of("Content-Type", w.getContentType() == null ? "application/json" : w.getContentType()),
                w.getContentAsByteArray()));
    }
}
关键点和 Go 版一致:先占位再处理、响应缓存要带 status 与 header、同 key 不同指纹必须报 409。
8.4 SAGA 协调器骨架(Go)
type Step struct {
    Name      string
    Forward   func(ctx context.Context) error
    Compensate func(ctx context.Context) error
}

type Saga struct {
    ID    string
    Steps []Step
}

func (s *Saga) Run(ctx context.Context, log Log) error {
    completed := []int{}
    for i, step := range s.Steps {
        if err := withRetry(ctx, step.Forward); err != nil {
            log.Failed(s.ID, step.Name, err)
            for j := len(completed) - 1; j >= 0; j-- {
                k := completed[j]
                if cerr := withRetry(ctx, s.Steps[k].Compensate); cerr != nil {
                    log.CompensationFailed(s.ID, s.Steps[k].Name, cerr)
                    return cerr // 停在这里,挂人工
                }
            }
            return err
        }
        completed = append(completed, i)
        log.Success(s.ID, step.Name)
    }
    return nil
}
真实生产里 Saga
必须可持久化、可恢复:每一步的开始与结束写事件表,协调器重启后能根据事件表继续执行。Temporal、DTM
已经把这一层做好了,自己写只建议在教学或极小规模场景。
8.5 完整流程图
下单 → 扣库存 → 扣账户 → 通知 的 SAGA 正向 + 补偿路径:
sequenceDiagram
    participant C as Client
    participant O as Order Service
    participant I as Inventory Service
    participant A as Account Service
    participant N as Notification Service
    participant S as Saga Coordinator

    C->>O: POST /orders (Idempotency-Key)
    O->>S: start saga(order_id)
    S->>I: reserve(stock)
    I-->>S: ok
    S->>A: debit(amount)
    A-->>S: FAILED (insufficient)
    Note over S: 进入补偿
    S->>I: release(stock)
    I-->>S: ok
    S->>O: mark canceled
    O-->>C: 402 Payment Required

    Note over C,N: 正向路径(成功)
    C->>O: POST /orders (retry / new)
    O->>S: start saga
    S->>I: reserve(stock)
    I-->>S: ok
    S->>A: debit(amount)
    A-->>S: ok
    S->>N: send(notify)
    N-->>S: ok
    S->>O: mark paid
    O-->>C: 201 Created
两条路径都经过同一个协调器,正向与补偿的每一步都要求幂等;协调器自身通过事件表做检查点。
九、Exactly-Once 与跨系统一致性
在消息系统、流处理、支付链路里,“exactly-once”(恰好一次)几乎是所有工程师都希望获得却又容易误解的承诺。我们先把它讲清楚再继续。
9.1 三种语义
- At-most-once(至多一次):可能丢消息,绝不重复。适用于审计日志(丢一点可接受)或高频心跳。
- At-least-once(至少一次):不会丢,但可能重复。绝大多数 MQ、HTTP 重试都是这一档。
- Exactly-once(恰好一次):既不丢也不重。成本最高。
要区分”投递”与”处理效果”。在发送方无法确认对端是否收到的网络里,单靠传输层无法保证每条消息恰好送达一次;能做到的是让重复投递不产生重复效果。Confluent
2017 年的 Exactly-once
Semantics Are Possible: Here’s How Kafka Does It 介绍的
Kafka 0.11 方案正是如此:幂等生产者(producer id +
序号去重)+ 跨分区事务 + read_committed
消费,保证的是 Kafka
内部”读—处理—写”的恰好一次效果;一旦副作用写到 Kafka
之外(数据库、银行接口),仍要靠下游自己幂等。Helland 2007
年在 Life beyond Distributed Transactions
中把这一点总结为:跨实体的消息至少投递一次,接收方必须记住处理过什么。
9.2 支付系统的等价表述
放到支付语境下,所谓”exactly-once”其实是:
- 对外 API:同一
Idempotency-Key恰好一次改变状态; - 对内 MQ:at-least-once 投递 + 消费端幂等 = 业务侧 exactly-once;
- 对账:日终审计时账务总和与外部对账文件一致,差异额低于阈值。
承认这三件事是不同语义,系统设计就会清楚很多。别把 exactly-once 当一个总开关,而是要看在哪一层用什么手段逼近 exactly-once 的业务效果。
9.3 消费端幂等的五种实现
- 业务唯一键去重:消费前查
(source_system, external_id)是否已处理。简单直接,适合写少。 - Token 去重表:每条消息带一个 token(MQ
的 msgId 或业务事件 ID),消费前
INSERT ... ON CONFLICT DO NOTHING,成功才处理。 - 状态机 guard:消费后只在合法状态下跃迁,重复消费自然无效。
- 版本号/条件更新:
UPDATE ... WHERE version = ?,条件不满足即静默。 - 幂等宿主(Idempotent Consumer):Camel、Spring Integration 都有内置模式,把去重表封装成消费者装饰器。
五种里最常用的是状态机 + 条件更新。它的好处是去重与业务逻辑共用一张表,不需要额外同步。
9.4 跨系统一致性模式图
再从架构视角俯视一次,支付链路里跨系统的一致性大致有这四种模式组合:
flowchart LR
    A[Client] -->|Idempotency-Key| B[API Gateway]
    B -->|状态机跃迁| C[Order Service]
    C -->|本地事务 + Outbox| D[(DB)]
    D -->|CDC| E[Kafka]
    E -->|at-least-once| F[Account Service]
    E --> G[Inventory Service]
    E --> H[Notification Service]
    F -->|幂等消费| I[(Ledger DB)]
    G -->|幂等消费| J[(Stock DB)]
    F -->|失败事件| K[Saga Coordinator]
    K -->|补偿| G
    K -->|补偿| F
    K -->|挂单| L[Ops Console]
这张图里每条线都可以对照前文的章节:
- A → B 的 Idempotency-Key 由第三节和 8.1 的中间件实现;
- C → D 的状态机由第四节落库;
- D → E 的 Outbox/CDC 在第六节;
- E → F/G/H 的 at-least-once 由消费端幂等(9.3)兜底;
- K 的补偿、防悬挂与挂单规则在第七节。
整套模式里唯一不可妥协的点是:任何一跳都要能被安全重试。这就是本文反复强调的”幂等是底座”。
十、性能、观测与合规
10.1 幂等表的热点问题
高 QPS 下,幂等表可能成为瓶颈,尤其在单主库架构里。常见优化:
- 按 key_hash 分片:将幂等表水平拆分到 8 / 16 / 64 个分表;
- 写缓冲:把幂等占位先写 Redis,异步落库。但要小心 Redis 故障时 fallback 到 DB 的幂等是否生效;
- 行级 TTL:避免单张表无限膨胀;
- 只保留哈希:指纹和响应体大时,可以把响应单独放对象存储(S3/OSS),幂等表只存指针。
幂等表的访问量至少等于带 key
的写请求量,再乘上重试放大系数;这个系数取决于客户端退避策略,应从
idempotency.hit_rate
指标实测,而不是套用别人的经验值。
10.2 观测指标
一套生产级幂等/事务体系应当对外暴露至少以下指标:
idempotency.hit_rate:命中缓存的请求比例,反映重试频率;idempotency.conflict_rate:同 key 不同指纹的比例,反映客户端逻辑质量;saga.step_latency:每一步的延迟分布;saga.compensation_rate:正向失败触发补偿的比例;saga.stuck_count:处于中间态超过阈值的实例数;outbox.lag:outbox 表中未发布记录的最大年龄;cdc.lag:CDC 消费位点与主库当前位点的差值。
这些指标应在事故复盘时作为第一档证据。没有它们,链路一旦出事你只能靠日志 grep。
10.3 混沌测试
幂等与事务的正确性最怕”在测试里永远不复现”。生产级团队应当定期在预发环境注入:
- 网络抖动:随机丢包、延迟、DNS 抖动;
- 中间件故障:kill MQ broker、Redis、DB 主库;
- 时钟偏移:把协调器时钟往前/后拨几分钟;
- 重复投递:强制 MQ 对指定 topic 重投 N 遍;
- 协调器重启:在 SAGA 执行中途 SIGKILL 一次。
目标只有一个:混沌结束后,账务表总和与预期完全一致。这既是幂等的终极验收标准,也是第 23 篇对账系统要回答的问题。
10.4 与合规的接口
幂等与分布式事务虽然是技术问题,但和合规交叉的点并不少:
- 可审计:状态机事件、Outbox 归档要按所在机构适用的会计档案与支付业务监管规定保留(具体年限以适用法规为准);幂等表本身可以过期,但它记录的业务结果必须能从事件表追溯;
- 可追溯:一笔支付的所有中间态必须能串成完整时间线,供监管检查;
- 差错处理流程:自动补偿失败进人工工单,这一步的 SOP 必须文档化、可演练;
- 不可篡改:事件表只追加不更新,与《复式记账工程化》里 postings 表的 append-only 策略一致。
合规这条线不展开,放到后续的反洗钱与 KYC、对账系统工程两篇里再讲。这里的要点是:幂等与事务设计必须在 Day 1 就考虑可审计性,否则补起来成本惊人。
十一、工程坑点与落地清单
11.1 十个常见坑
下面这些坑都能直接对应到前文某一节的机制:
- 幂等表没有唯一索引:只有主键 + 应用层判重,被并发请求绕过。
- 幂等响应没缓存 status:第一次返回 202,第二次返回 201,客户端状态机错乱。
- 请求指纹算错:把
client_ip、timestamp算进指纹,同 key 不同时间重试被视为冲突。 - 状态机用枚举字符串:上下游版本不一致时产生”未知状态”。枚举务必用数字 + 注释文档。
- Outbox 不带顺序:下游乱序消费导致”退款先于下单”的事件到达。用 aggregate_id 做 partition key。
- CDC 不做 DDL 对齐:业务加字段没通知下游,消费者反序列化挂。Debezium 有 Schema Registry 兜底,务必开启。
- SAGA 协调器没有恢复:重启后事件丢失,部分订单永远挂着。必须把状态写库。
- 补偿没做限流:补偿风暴打爆下游,扩大故障面。补偿链路用独立线程池 + 独立 MQ 分区。
- TCC 没防悬挂:空回滚后迟到的 Try 照常冻结,业务表出现”冻结却无全局事务”的记录(见 7.3)。
- 回调没签名 + 没防重放:伪造回调被当成真实结果,这属于《支付网关设计》的范畴,但在这一层就要留好验签位。
11.2 场景匹配表
| 业务 | 推荐方案 | 理由 |
|---|---|---|
| 卡支付同步主链路 | Idempotency-Key + 状态机 + SAGA | 吞吐与一致性平衡 |
| 同库或同机房的账务批处理 | 本地事务 / XA | 参与者少、网络可控 |
| 异步通知、下游触发 | Outbox + CDC + Kafka | 解耦、可回放 |
| 跨机构转账 | TCC + 人工挂账 | 悬挂可控、合规可查 |
| 交易所撮合 → 清结算 | 本地事务 + 异步消息 | 延迟极低 |
| 商户分账 | SAGA Orchestration | 步骤多、可视化 |
11.3 落地清单
- 所有写接口必须接受且持久化
Idempotency-Key; - 所有业务实体必须有跨租户唯一的业务单号;
- 所有状态流转必须走状态机白名单并带乐观锁;
- 所有事件发布走 Outbox + CDC,禁止事务内直接发 MQ;
- 所有跨服务写优先选 SAGA,次选 TCC,慎选 2PC;
- 所有补偿接口与正向接口同等级幂等;
- 所有中间态都设置 stuck 告警(通常 1–5 分钟阈值);
- 所有自动补偿失败三次挂人工工单,不再自动重试;
- 所有对账差错进差错户,不进正常账户(接《对账系统工程》);
- 所有事故复盘回填到 Idempotency-Key / 状态机白名单 / 补偿策略,形成闭环。
11.4 与其他篇章的交叉引用
架构层(通用幂等模式) 与 金融科技层(支付语义) 应分开读、合在一起落地:
- 《系统架构 · 幂等性设计》从 HTTP 语义、Idempotency-Key 存储模式、分布式锁与去重表讲通用后端;本文在其上叠加 支付状态机、SAGA/TCC、Outbox 与监管对账——支付写接口的 Key TTL、与订单号的绑定规则,以本篇第三节、11.3 清单为准。
- 《复式记账工程化》给出状态机落地时的账务侧视角;
- 《账务数据库设计》为幂等表、Outbox 表、状态表提供物理承载;
- 《支付网关设计》承接 签名、防重放、异步回调重推与补单——与本文 1.3 节四类重试来源在网关层汇合;
- 《支付系统全景》提供收单/发卡链路全景,便于把本文 SAGA 步骤映射到真实角色;
- 《对账系统工程》承接幂等失败后的差错与补偿;
- 《金融级可靠性》讨论两地三中心下的事务恢复策略。
十二、争论与开放问题
2PC 真的该被抛弃吗? 微服务社区常说”不要用分布式事务”,但 Laigner 等人 2021 年对开源微服务应用的实证研究(VLDB)发现,开发者回避 2PC 后往往用临时拼凑的应用层逻辑处理一致性,正确性没有保障。反过来,Gray 与 Lamport 的 Paxos Commit、以及 Spanner 这类把 2PC 建在复制组之上的系统,说明阻塞问题可以在基础设施层解决。对支付团队而言,真正的问题不是”2PC 好不好”,而是协调成本应该由数据库承担还是由业务代码承担。
Saga 缺乏隔离怎么办? Garcia-Molina 与 Salem 当年就承认 Saga 不提供隔离;Frank 与 Zahle 1998 年提出语义锁、可交换更新、悲观视图等”对策”(countermeasures),但这些对策都要求业务方逐个分析读写冲突。ACIDRain 一类研究表明,应用层自己实现的隔离恰恰是并发漏洞的高发区。目前没有通用、自动化的方法验证一组 Saga 补偿在并发下仍保持业务不变量。
Idempotency-Key 会标准化到什么程度?
IETF 草案在 2025 年推进到 draft-07
后已过期,失败请求是否保存结果、保留期多长、并发重复返回什么,各家仍有分歧——Stripe
v1 连 500 也重放,而 v2 API
对同 key
的失败请求会重新执行且不产生重复副作用。自建系统应把这些选择写进
API 文档,而不是假设客户端”知道”。
exactly-once 的边界在哪里? Kafka 事务只覆盖 Kafka 内部的读写;把副作用延伸到外部数据库或银行接口时,仍要回到 Helland 的结论:至少一次投递 + 接收方去重。如何在跨组织、无共享事务日志的链路上做端到端去重,目前只能靠业务单号与对账兜底。
参考资料
规范与官方文档(A 级)
- Stripe API Reference, Idempotent requests
- Jena, J. & Dalal, S., The Idempotency-Key HTTP Header Field, IETF HTTPAPI Internet-Draft, draft-07
- X/Open, Distributed Transaction Processing: The XA Specification, 1991
- Apache Seata, TCC
模式(含
tcc_fence_log防悬挂) - Apache RocketMQ, Transaction Message
- Debezium Documentation, Outbox Event Router
- PingCAP, Periodically Delete Data Using TTL
- Temporal Documentation, Saga pattern
论文(A 级)
- Gray, J., Notes on Data Base Operating Systems, in Operating Systems: An Advanced Course, LNCS 60, Springer, 1978
- Garcia-Molina, H. & Salem, K., Sagas, ACM SIGMOD 1987
- Frank, L. & Zahle, T. U., Semantic ACID Properties in Multidatabases Using Remote Procedure Calls and Update Propagations, Software: Practice and Experience, 1998
- Gilbert, S. & Lynch, N., Brewer’s Conjecture and the Feasibility of Consistent, Available, Partition-Tolerant Web Services, ACM SIGACT News, 2002
- Gray, J. & Lamport, L., Consensus on Transaction Commit, ACM TODS, 2006
- Helland, P., Life beyond Distributed Transactions: an Apostate’s Opinion, CIDR 2007(ACM Queue 2016 年重刊)
- Pardon, G. & Pautasso, C., Atomic Distributed Transactions: a RESTful Design, WWW 2014 Companion
- Warszawski, T. & Bailis, P., ACIDRain: Concurrency-Related Attacks on Database-Backed Web Applications, ACM SIGMOD 2017
- Laigner, R. et al., Data Management in Microservices: State of the Practice, Challenges, and Research Directions, PVLDB 14(13), 2021
工程博客(B 级)
- Leach, B., Designing robust and predictable APIs with idempotency, Stripe Blog, 2017
- Narkhede, N., Exactly-once Semantics Are Possible: Here’s How Kafka Does It, Confluent Blog, 2017
站内
上一篇:《账务数据库设计:TiDB/OceanBase/Postgres 下的分片、索引、热点账户》
下一篇:《支付系统全景:收单、发卡、聚合、跨境、B2B、C2C》
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【金融科技工程】09 支付网关设计:路由、限流、补单、异步通知、签名与防重放
从业务系统到支付宝、微信、银联、Visa、Stripe、Airwallex,中间这一层"支付网关"承担了路由、限流、熔断、补单、签名、异步通知分发等几乎所有脏活累活。本文系统整理一个自研或半自研支付网关的工程设计,包括数据模型、双状态机、路由策略、密钥管理与可观测性。
【金融科技工程】金融科技工程全景:从支付到交易所的系统分类与读图
金融科技(FinTech)不是普通后端加一张账户表。钱的原子性、监管的硬边界、一个小数点的代价,把这个领域推进到工程强度最高的那一档。本文是【金融科技工程】25 篇的总目录与阅读地图:先交代为什么它比一般业务系统更难,再给出对账体、支付体、交易体、风控合规体四维分类,把后续 24 篇挂到骨架上,最后给出一份绿地项目的落地顺序建议。
【金融科技工程】订阅与计费系统:用量计量、账单、发票、出海 VAT/GST
SaaS 与云服务的订阅与用量计费工程实践:计费模型、计量(Metering)、订阅生命周期、账单与发票、dunning、出海税务(VAT/GST/sales tax/消费税)、定价引擎与数据模型。
【金融科技工程】撮合引擎实现:撮合算法、价格优先时间优先、状态机、低延迟工程
深入剖析中央限价订单簿(CLOB)撮合引擎的数据结构与算法,覆盖价格时间优先、Pro-Rata、订单类型、自成交预防、集合竞价、确定性回放、WAL 快照、单线程事件循环与 Disruptor 模型,并给出 Rust/Go 简化实现与单元测试清单。