算子与框架决定「卡怎么跑」;真正卡住上线的,经常是另一层——机房脏活:进线够不够、机柜能不能上 60–120 kW、光纤极性有没有画错、RoCE 的 PFC 谁负责、光模块备件按多少备、一期 BOM 怎么分期才不贬值。
本篇补的是 04 互联 与 24 成本 之间的空洞:业务 → 容量 → 电力/冷却 → 布线/光模块 → 交换机采购 → RDMA 交割 → BOM/预算。协议与 NCCL 调参仍以 04 为准;token 账单与 PUE 概念以 24 为准;服务化与机房「上面」的部署面看 21 服务化。规格数字附可核来源;其余演算输入明确标为假设,不代表实测性能或厂商合同价。
〇、30 秒版
- 脏活是容量问题,不是采购清单问题:先从业务推卡数与机柜功率,再反推进线、冷却、端口与光模块。
- 电力与冷却决定代际上限:风冷机柜常见直觉上限远低于 NVL72 级整柜功耗;上高密柜先问液冷与进线,再谈网络品牌。
- 光纤/光模块是被低估的 CAPEX 与故障源:DAC/AOC/可插拔模块按距离选型;备件、兼容白名单、温度与变更纪律决定能不能长稳。
- 交换机采购 ≠ 协议课:IB vs RoCE 看 TCO、运维复用、无损能力与锁定;拓扑(Leaf-Spine / Rail)直接改台数与线缆数。见 04。
- 分期扩容:1 柜试点 → 一叶 → 一 Pod;每阶段有电力/RDMA/光模块门禁,避免按终态一次性囤货。
安全边界(必读):本文只做规划沟通与交割清单,不替代电力设计院设计、供电局批复,以及持证专业人员的操作。文中任何「演练 / 故障注入」均须经业务、网络与设施责任人批准,在隔离试点或维护窗口内按 runbook 执行,并先确认回退与人员安全。不要把本文当成可照做的带电施工步骤。
配图说明:架构图(fig1–10)为本文绘制,图内使用英文短标签;小屏可点击图打开 SVG 原图放大。实拍来自 Wikimedia Commons,许可与署名见
images/photos/ATTRIBUTION.txt。
一、为啥单独讲脏活
1.1 和 04 / 24 / 21 怎么分工
| 篇 | 回答什么 | 不回答什么 |
|---|---|---|
| 04 互联 | NVLink/IB/RoCE、拓扑、NCCL、fail-slow | 机房进线、PDU 电压、光纤施工、BOM 分期 |
| 24 成本 | token/卡时账、PUE 概念、合规安全 | 业务→机柜功率的可复算漏斗、交换机采购表 |
| 21 服务化 | 推理服务部署、弹性、多租户 | 机柜土建与光模块库存策略 |
| 本篇 31 | 设施规划脏活全链路 + 示例 BOM | 不替代设计院/供电局/持证操作;不给合同单价 |
1.2 谁该读
- 要把「明年 QPS / 训练 tokens」翻译成机房改造立项的人;
- 已经会配 NCCL,但第一次面对 PDU、MPO、CDU、光模块 RMA 的人;
- 采购/财务需要一张可复算假设表,而不是「听说要上液冷」的人。
GPU 单卡与机型基础仍看 02 GPU 入门;推理框架与算子见 29、30。
二、业务 → 容量:从 QPS 到机柜功率
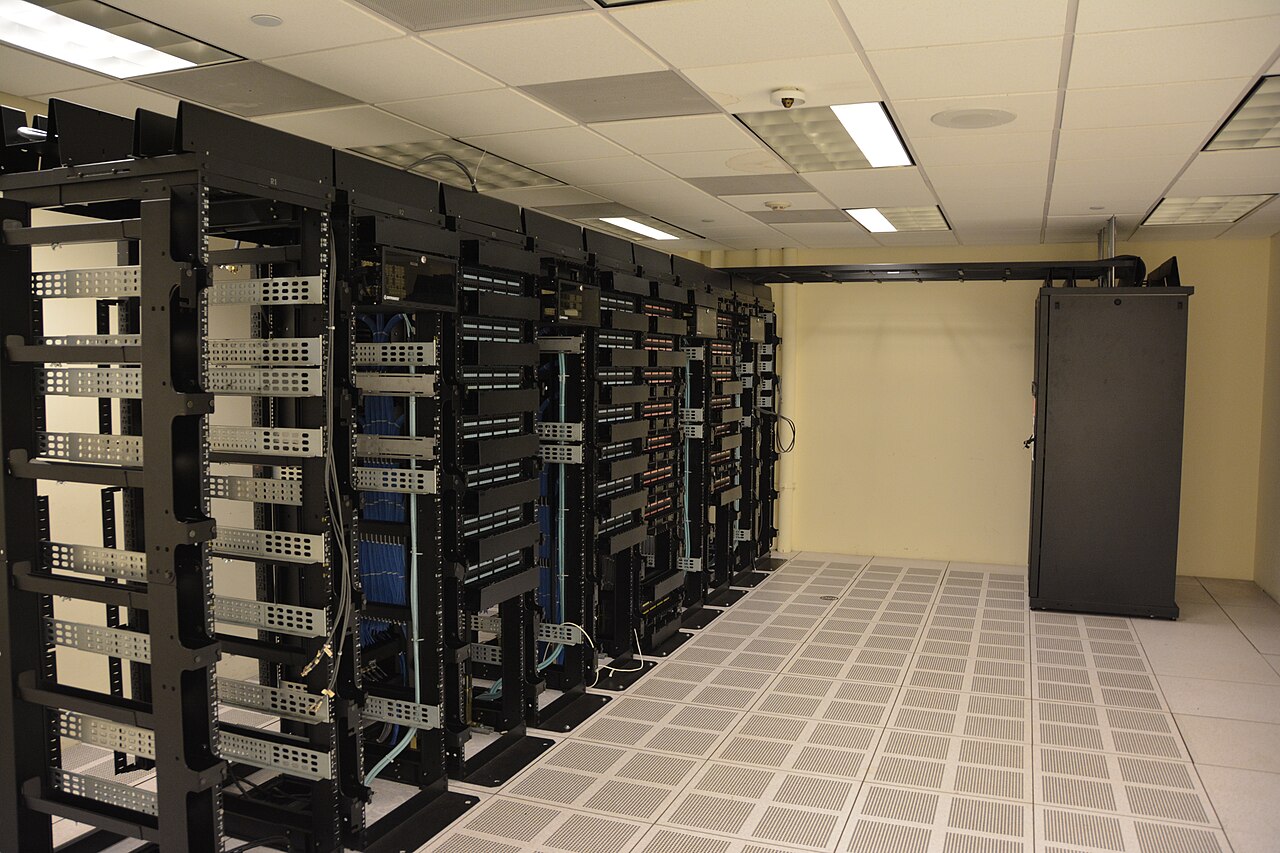
图注:数据中心机柜与通道实拍(示意密度与走道,非封闭冷通道特写,亦非本文假设柜功率)。照片:Carl Lender / Wikimedia Commons,CC BY 2.0。
2.1 先分三条业务线
| 业务形态 | 主约束 | 容量推法直觉 |
|---|---|---|
| 训练 | 吞吐(tokens/日)、MFU、并行度、检查点存储 | 卡数 ← 目标 tokens/日 ÷ 目标并行与 SLO 下单卡持续 tokens/日(吞吐已含该并行配置) |
| 推理 | QPS、并发、TTFT/TPOT、上下文长度 | 卡数 \(\leftarrow \lceil \frac{\text{QPS} \times T_{\text{out}}}{S_{\text{tok/s/gpu}}} \times (1+\alpha) \rceil\)(含 SLO 余量) |
| 混合 | 训练窗与推理峰重叠 | 分开算再取并集,别用平均值掩盖峰 |
「tok/s/卡」强烈依赖模型、量化、引擎与 batch——定性地图见 11、29、30;这里只把它当成你自己压测得出的输入,不要抄未标注条件的网文数字当设计依据。
训练侧还要额外问存储:检查点带宽、并行文件系统或对象存储是否成为第二瓶颈。脏活里「机房」若不含存储网络,训练一拉满就会在另一张网上堵死——本篇默认存储网单独规划,但立项时必须同表出现。
2.2 可复算粗公式(规划量级)
推理卡数(示意):
\[ N_{\text{gpu}} \approx \left\lceil \frac{\text{QPS} \times T_{\text{out}}}{S_{\text{tok/s/gpu}}} \times (1+\alpha) \right\rceil \]
- \(T_{\text{out}}\):单请求平均输出 token(输入侧还要另加 prefill 占用,严 SLO 时更保守);
- \(S\):单卡可持续输出吞吐(你的压测);
- \(\alpha\):单列的容量余量假设;本文演算可在 0.2–0.4 内选值,但不能替代故障后容量校验,也不是通用行业比例。
更严的做法是把 prefill 与 decode 分列:交互场景下 TTFT 约束可能逼你把 batch 做小,\(S\) 立刻下降——同一 QPS,卡数可能翻倍。这是 21 的服务化问题,但会直接传导到机柜功率。
训练卡数(示意):
\[ N_{\text{gpu}} \approx \left\lceil \frac{\text{Tokens}_{\text{target/day}}}{\text{Tokens}_{\text{per-gpu/day}}} \right\rceil \]
若压测给出目标并行配置下的集群持续吞吐,先除以卡数,得到单卡等效 tokens/s。单卡等效 tokens/日 = 实测单卡等效 tokens/s × 3600 × 每日有效运行小时;有效小时须扣除维护、排队、检查点等停顿。实测吞吐已包含 MFU、并行气泡与通信开销,不能再乘一次 MFU 或并行度。若从峰值 FLOPS 反推,则要另给精度、每 token 计算量与 MFU 假设,不能混用两条算法。并行效率见 06 与 04。固定目标产出下,MFU 越高,所需卡数越少;但增加卡数未必线性增加吞吐,扩容前要复测目标拓扑。
机柜与功率:
\[ \begin{aligned} N_{\text{rack}} &= \left\lceil \frac{N_{\text{gpu}}}{G_{\text{per-rack}}} \right\rceil \\ P_{\text{rack,IT}} &\approx P_{\text{servers}} + P_{\text{net-share}} \\ &\quad + P_{\text{storage-share}} \end{aligned} \]
这里的服务器、网络与存储功率都指设备输入端的有功功率;独立网络柜、存储柜也要计入全场 IT 总量,不能遗漏或重复分摊。CDU 泵、冷源与输配损耗单列为设施负载。若 CDU 与服务器共用柜内馈电,该馈电必须承受两者之和;但算 PUE 时,CDU 不进 IT 分母,否则会重复计入冷却。
能耗 / 电费粗估用同一统计周期的 IT 平均功率与能源口径 PUE:
\[ P_{\text{facility,avg}} \approx \Big(\sum P_{\text{rack,IT,avg}}\Big) \times \text{PUE}_{\text{period}} \]
\(\text{PUE}_{\text{period}}=E_{\text{facility}}/E_{\text{IT}}\)。不要拿某个低负载小时或冬季最佳点的 PUE 代表全年。
容量 / 进线对齐改用设计工况下的逐项负载,不乘一个「设计 PUE」:
\[ \begin{aligned} P_{\text{facility,design}} &= P_{\text{IT,design}} + P_{\text{cooling,design}} \\ &\quad + P_{\text{other,design}} + P_{\text{loss,design}} \end{aligned} \]
每项均以 kW 计,覆盖最不利冷却工况与业务峰值。进线、变压器与 UPS 的容量由设计院按各自供电范围、功率因数、冗余及扩容余量计算;UPS 不一定承载全场冷源。工程师要交出设备输入功率、负载曲线和故障后的运行要求,而不是用年平均功率替代设计峰值。
2.3 假设表示例 A:推理试点(虚构,非报价)
只演示算术:假设高峰 QPS=40、平均输出 400 tok/req,并人为给定单卡等效持续输出吞吐 \(S=2500\) tok/s,\(\alpha=0.3\)。这个吞吐不是实测,不对应任何 70B/FP8 性能承诺。真实立项须用目标模型、输入长度、并行配置和 TTFT/TPOT 约束下的压测值替换。
| 项 | 取值 | 说明 |
|---|---|---|
| 有效负载 | \(40\times400=16000\) tok/s | 高峰输出侧 |
| 卡数 | \(\lceil 16000/2500\times1.3\rceil=9\) → 规划 16 卡(两台 8 卡) | 取整到整机;故障储备另校验 |
| 机柜 | 1–2 柜起步 | 留给交换机/存储 |
| 单机功率参照 | 8×H100 SXM 的 GPU TDP 上限合计 5.6 kW;DGX H100 最大系统输入功率 10.2 kW | H100 规格 / DGX 用户指南,两种口径不能互换 |
| 柜功率 | 本文筛选假设:常规风冷 5–15 kW/柜;增强空气侧散热 20–30;液冷 40–120+ | 不是技术上限;同 §3.4 与图 3 |
两台 8 卡机不等于「坏一台仍满足 SLO」:上面的需求为 9 卡等效,故障后只剩 8 卡。要保住这份容量,需增加故障储备、使用另一池接管,或明确接受降级。若两台都按 10.2 kW 上限设计,同柜服务器输入已达 20.4 kW,还没算交换机;15 kW 托管柜放不下。
2.4 假设表示例 B:千卡训练(虚构,非报价)
| 项 | 取值 | 说明 |
|---|---|---|
| 目标 | 1024 卡训练集群 | 整数机柜友好 |
| 机型 | 8 卡/机 → 128 台 | |
| 机柜 | 若 4 机/柜 → 32 柜 IT;再加网络/存储柜 | 密度因液冷与布线而变 |
| 单卡 TDP | H100 SXM 可配置上限 700 W | 官方规格,不是平均输入功率 |
| GPU TDP 合计 | 1024 × 0.7 = 716.8 kW | 仅 GPU,不能据此选整机馈电 |
| 服务器设计功率参照 | 若采用 DGX H100 上限:128 × 10.2 = 1305.6 kW | 用户指南;4 台/柜为 40.8 kW,尚未含柜内网络 |
| IT 设计功率 | 1305.6 kW + 独立交换机/存储等设备输入功率 | 具体机型逐台核对;CDU、冷源单列设施负载 |
| IT 平均功率(独立假设) | 人为假设 0.80 MW | 仅为电费演算输入,不是由 GPU TDP 推导的实测值 |
| 设施平均功率(能耗粗估) | 0.80 × (1.15–1.30) = 0.92–1.04 MW | PUE 亦为示例假设,只用于电费 |
| 设施设计功率 / 进线 | IT 设计峰值 + 冷却/其它设施负载 + 损耗;交设计院 | 含 PF、冗余、扩容,不使用上面的平均功率 |
把漏斗从「两台推理机」换成「兆瓦级训练」,脏活从采购单变成能源与土建项目——这是本篇存在的理由。
2.5 业务增长怎么映射到扩容节奏
- 按 Q 增长:每季度重算 \(N_{\text{gpu}}\),但光模块与交换机按当年询价与厂商路线图评估是否值得提前囤(价格与供货波动快,不必按固定「半年」口号囤货);
- 按模型代际:同 QPS,上下文从 8k→128k,KV 与 prefill 可能逼你加卡或换并行,机柜功率跟着动;
- 按产品形态:Agent / 工具调用提升 tok/req(见服务化讨论),漏斗输入先变,再动设施。
三、电力与电压
3.1 常见路径(国内规划用语)
- 市电进线:10 kV / 35 kV 等(以供电局批复为准);
- 变压器:降到低压侧。国内机房常见 380/220 V,分别指线电压/相电压;国际材料还会写 400/230 V,北美项目可见 480/277 V 等系统,不是所有机房都采用同一档。三相四线含中性线,保护接地 PE 另按设计配置;PDU 输入电压与服务器 PSU 所需电压也要分开核对。
- UPS 或 HVDC:交流 UPS 路径成熟;HVDC(如 240 V / 336 V 级方案,具体以项目设计为准)减少变换级数、潜在更高效率,但生态与改造门槛要单独立项;
- 列头柜 / 机柜 PDU:三相或单相;电流等级按单柜 kW 选,见下表。
电压名义值可核对国家标准 GB/T 156—2017《标准电压》(国家市场监督管理总局 / 国家标准化管理委员会发布,修改采用 IEC 60038:2009,将其中的 230/400 V 改为中国标称值 220/380 V,此处为相/线电压顺序;可在国家标准全文公开系统检索标准号核对)。项目仍以当地现行规范与供电批复为准。
注意:电压等级、接地与消防规范以当地标准与设计院图纸为准;本文不替代设计院设计、供电局批复及持证专业人员操作。下文只给工程师对齐「该问供电/物业什么问题」的词汇表。
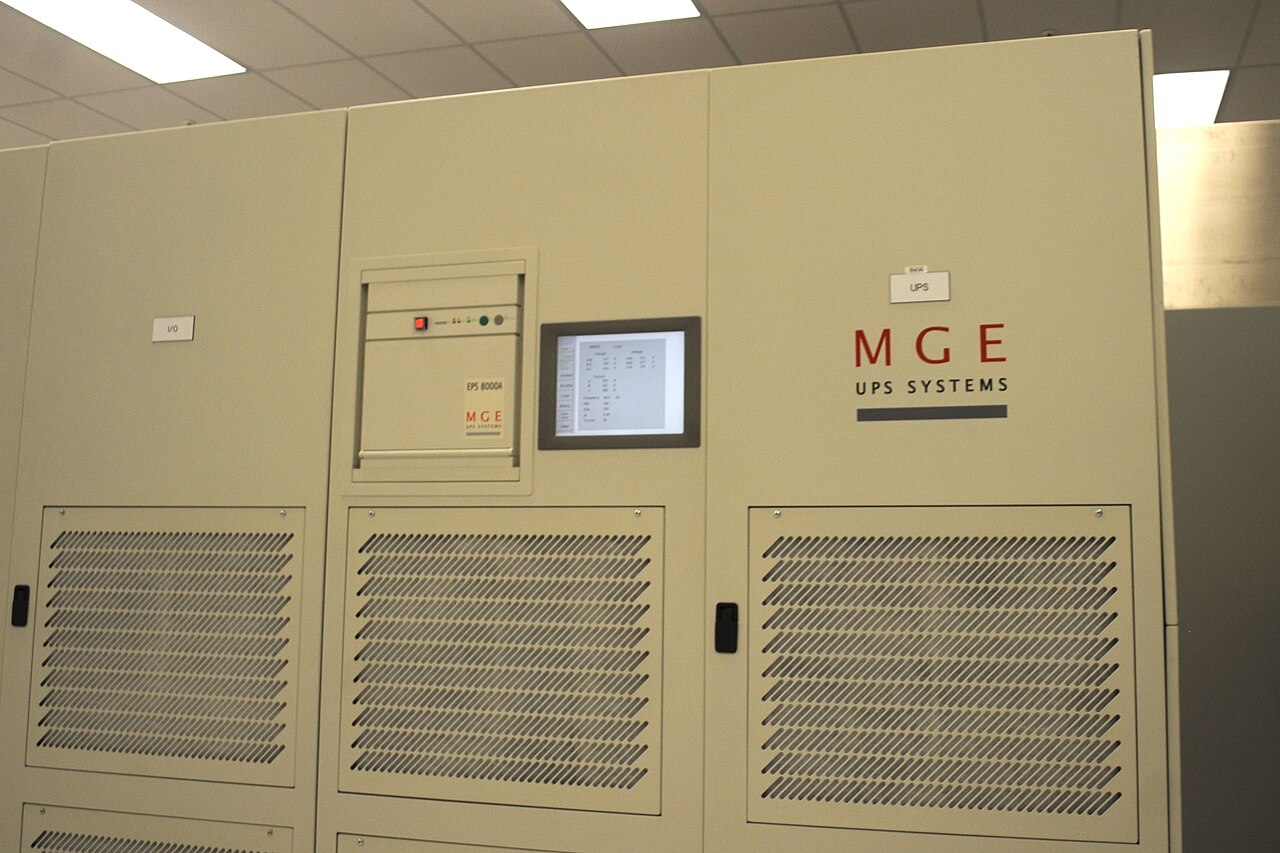
图注:NERSC 机房内 MGE UPS 设备外观(示意「UPS 在链路里长什么样」,非选型推荐)。照片:Derrick Coetzee / Wikimedia Commons,CC0 1.0。
3.2 机柜 PDU 与服务器电源的对接细节
- 单相 vs 三相:低密可单相;GPU 柜几乎总是往三相走,否则回路数爆炸。
- 冗余供电:服务器可能有双 PSU,也可能有多组 PSU。按厂商允许的 A/B 接法接不同 PDU / UPS 路,并校验失去一路后剩余馈电与 PSU 能否承载目标负载;不要只把正常时各承担一半画成「双电」。
- 浪涌与错序:施工验收要做相序、接地、空开匹配;GPU 整机上电冲击可大于稳态,ATS/UPS 选型要问清楚。
- 智能 PDU:逐插座计量对「哪台机器在偷电/异常」极有用;训推混部时建议上。
- 连接器口径:C19(16 A / 250 V 量级)适合服务器电源进线 / 低密;相对 C13 是「高规格」,但相对 60–120 kW 柜远远不够。高密柜按安培数选工业连接器(如 IEC 60309)、母线槽或多路馈电,不要把「C19 常见」读成「覆盖高密全区间」。
单柜有功功率与馈电电流(三相平衡、线电压 \(V_{\text{LL}}=380\) V;只作量纲估算):
\[ I_{\text{load}}=\frac{1000P_{\text{rack,kW}}}{\sqrt{3}\,V_{\text{LL}}\,\text{PF}},\qquad I_{\text{rated}}\ge\frac{I_{\text{load}}}{f} \]
下表统一假设 \(\text{PF}=0.95\)、连续负载可用比例 \(f=0.8\)。80% 是本表的保守假设,不是国内所有断路器/PDU 的通用强制规则;实际还要核对环境、线缆、保护配合和厂商额定条件。
| 单柜有功功率 | 满负载电流(每相) | 按上述假设的额定馈电等级示意 |
|---|---|---|
| 15–20 kW | 约 24–32 A | 32 A 只能支持约 16 kW;20 kW 需约 40 A 或更高 |
| 40–60 kW | 约 64–96 A | 约 80–125 A;工业连接器 / 母线槽 |
| 100–120 kW | 约 160–192 A | 约 200–250 A,或经设计的多路独立馈电 |
例如三相 32 A 对应 21.1 kVA;乘 \(f\) 与 PF 后仅约 16.0 kW。表中电流是单路承担所列功率时的每相电流,不能把 A/B 两路额定值相加当成冗余容量。服务器单相 PSU 的插座分相及一路故障后的相不平衡,还要单独校验。
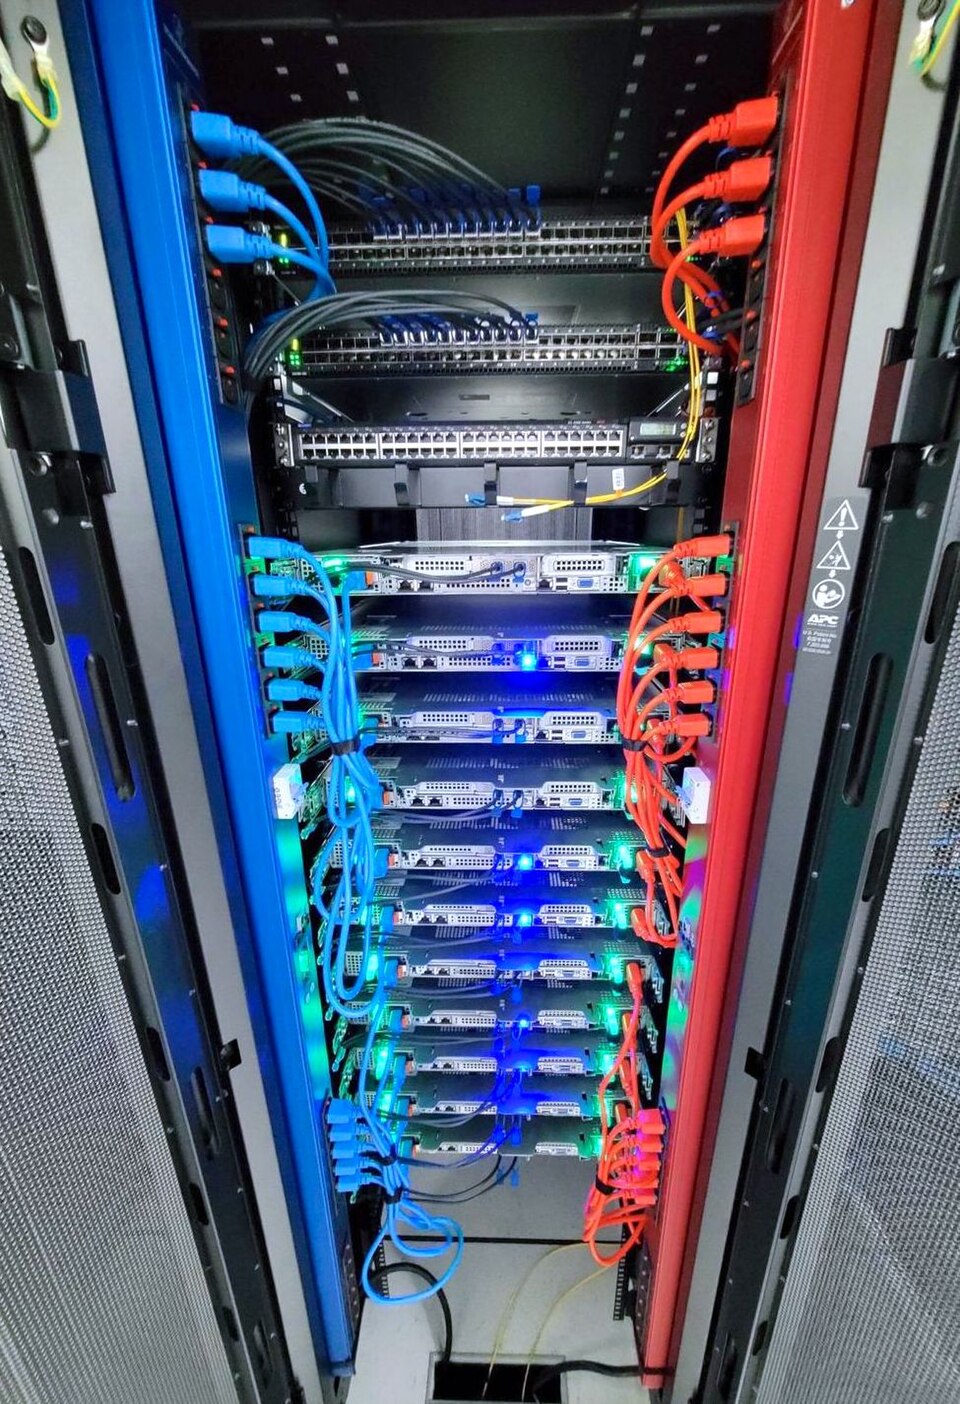
图注:机柜内竖直 PDU、A/B 双路馈电示意。照片:Schleifenbauer / Wikimedia Commons,CC BY-SA 4.0。
3.3 冗余对 CAPEX 的直觉
| 冗余 | 含义(简化) | 成本直觉 |
|---|---|---|
| N | 刚好够用 | 最低;单点故障即减容 |
| N+1 | 满足设计负荷需 N 个单元,再多 1 个同类单元 | 设备增量取决于 N;不等于多一条完整供电路 |
| 2N | 两套各自可承担全负荷的系统 | 冗余部分近似复制一套,不等于整个项目预算翻倍 |
冗余买的是可维护窗口与市电切换不掉作业。训练若不能接受整柜下电,N+1/2N 是业务连续性,不是运维洁癖。推理可降级服务时,可对「非核心池」降冗余以换 CAPEX——这要在 SLO 文档写死。
3.4 用单柜 kW 天花板反推代际
先用下面三档做本文的机房筛选假设,与 §2.3 / 图 3 一致;它们不是行业统一上限,也不能替代机房实测:
- 存量常规风冷:按 5–15 kW/柜询问可用余量;
- 增强空气侧散热:按 20–30 kW/柜询问气流、行级或后门换热方案。后门换热本身可能需要水路,不等于「不用液体」;做得好的专用方案也可能超出这个档;
- 液冷:按 40–120+ kW/柜询问水路、承重与配电。NVIDIA Mission Control 2.0 的 NVL72 规划示例给出 GB200 NVL72 满载约 120 kW,含节点与柜内交换/互联,不是仅 GPU 功率。
没有具体超节点的柜数、功率与冷却规格,就不要用「更高密」来承诺托管机房可接入。
容量反推(量纲写清):
对某一供电范围内的各类负载 \(j\),有功设计负载为 \(P_{j,\text{design}}\)(kW),同时系数为 \(\beta_j\),功率因数为 \(\text{PF}_j\)。用于早期沟通的保守粗算是:
\[ \begin{aligned} S_{\text{load}} &\approx\sum_j\frac{\beta_j P_{j,\text{design}}}{\text{PF}_j}\quad(\text{kVA}) \\ S_{\text{after-failure}} &\ge(1+m)S_{\text{load}} \end{aligned} \]
\(S_{\text{after-failure}}\) 是规定故障后的可用视在容量;\(m\) 是明确列出的扩容/设计余量;\(\beta_j\le1\) 表示负载峰值是否同时发生,不能换成可用容量侧的折扣而还叫同一个同时系数。对可能同步拉满的训练服务器,没有测量与调度约束证据时先取 \(\beta_{\text{IT}}=1\)。如果输入已是 kVA,就不要再除 PF。
例如某供电范围内 IT 设计有功功率为 100 kW、\(\beta=1\)、PF=0.95,则负载约 105.3 kVA;另留 20% 余量需要约 126.3 kVA 的故障后可用容量。这个例子未含冷却,不能当作全场进线需求。UPS 还须同时满足 kW 与 kVA 两项额定值;冗余方式、谐波、切换与保护配合仍由设计院核定。
反推问题清单:
- 故障后可用容量是否盖得住设计负载与余量(同时校验 kW / kVA,注明 PF 与 \(\beta\))?
- PDU 回路数与单路过流保护,是否匹配服务器 PSU 冗余与上表电流档?
- UPS 电池续航是「撑过 ATS 切换」还是「撑过短时市电」?训练作业 RTO 写进哪里?
- 柴发 / 市电双路是否在合同里?AI 负载爬坡曲线供电局是否接受?
训练电费分解公式见 24 §1.1 训练成本,超大规模集群电力与 PUE 背景见 24 §5 电力与 PUE;本篇强调物理可装与批复可获。
3.5 电压相关的沟通话术(给非电力背景的人)
- 别只说「要 380V」——要说清:每柜多少 kW、几路、冗余级别、上电时序;
- 别只说「要液冷」——要说清:一次侧冷吨、进水温度范围、是否允许水进 IT 区;
- 把 GPU 代际路线图(两年内是否可能上 NVL 级柜)提前给电力设计,否则变压器按风冷柜打满后再改,代价极高。
四、冷却:风冷天花板与液冷改造
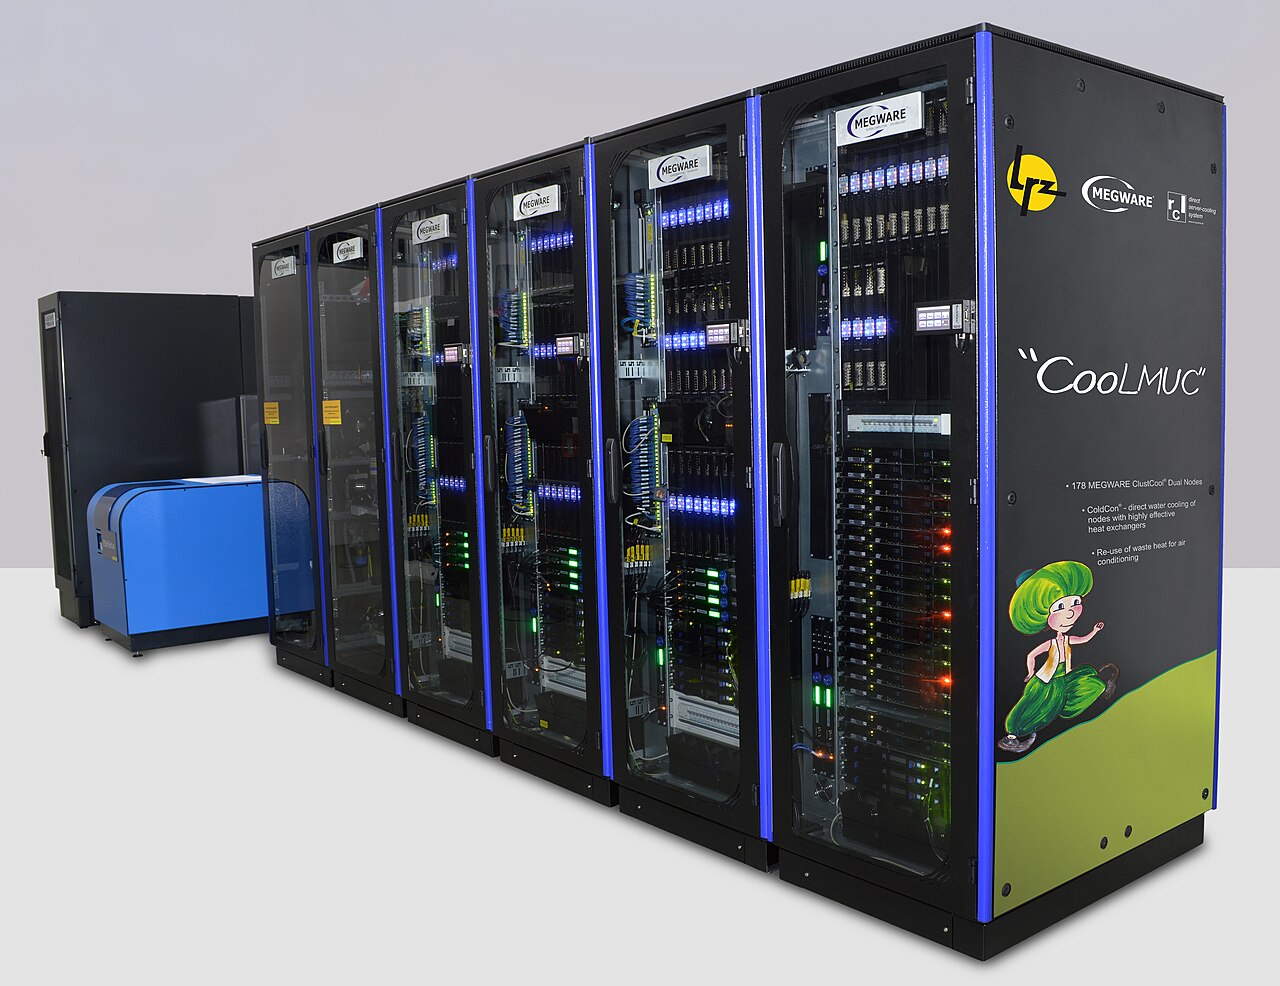
图注:LRZ CooLMUC 温水直冷 HPC 机柜实拍(冷板/换热器路线 + 较高供水温度策略;不是浸没)。照片:Megcluster / Wikimedia Commons,CC BY-SA 4.0。
4.1 风冷、冷板、浸没:先分清冷却对象
| 路径 | 热量怎么带走 | 改造时最先核对什么 |
|---|---|---|
| 风冷 | 芯片 → 散热器 → 空气 → 空调/换热器 | 送回风、热点、风量与冷源;柜功率筛选档见 §3.4 |
| 冷板直冷(direct-to-chip,D2C / DTC) | 芯片 → 冷板 → 二次侧冷却液 → CDU / 一次侧 | 服务器支持、供水温度、流量、压差、接头与漏液;未被冷板覆盖的部件仍要空气侧散热 |
| 浸没(immersion,单相 / 两相) | 设备浸在适配的介电冷却液中;单相循环换热,两相利用相变 | 材料兼容、液体与蒸气管理、吊装维护、厂商维保边界 |
| 温水策略 | 提高允许的供水温度,争取减少压缩机制冷或利用余热 | 不是独立冷却形态;能否采用取决于芯片入口温度限制、气候与换热温差 |
在 ASHRAE TC 9.9《Liquid Cooling Guidelines for Datacom Equipment Centers》 与 OCP(Open Compute Project)Cold Plate 规范语境中,D2C(direct-to-chip)与冷板直冷(DLC,direct liquid cooling)指冷却液流经芯片冷板带走热量,不能拿来指整机浸没(immersion);本文统一用「冷板直冷」与「浸没」,不混用未标准化缩写。照片 CooLMUC 是温水直冷案例,非浸没。
PUE 是全设施能源比,不是冷板或浸没的产品参数。没有案例的气候、负载率、一次侧设备、统计周期和测量边界,就不列「某路线固定 PUE 区间」;泵/风机、UPS 与输配都必须入账,余热利用应另列收益,不能简单从 PUE 分子扣掉。
4.2 CDU 与一二次管路
- 一次侧:冷却塔 / 干冷器 / 市政冷源;水质、结垢、冬季防冻是运维题;
- CDU:换热、泵、过滤、泄漏检测、旁路;CDU 本身要占机柜位与电力;
- 二次侧:机柜冷板回路;接头、盲插、滴水盘、漏液绳/托盘是高频点;
- 监控:进出水温度、压差、流量、漏液、泵状态进同一套告警,避免「IT 网管看不到水」。
别只问「CDU 能带多少柜」,要把热功率、流量、温差与压差写进同一张表。以水为介质做热平衡粗算:
\[ \dot m=\frac{Q_{\text{liquid}}}{c_p\Delta T},\qquad c_p\approx4.18\ \text{kJ/(kg}\cdot\text{K)} \]
若冷板回路实际要带走 100 kW 热量、允许水温升 10 K,则需约 2.39 kg/s,即约 144 L/min(水密度近似 1 kg/L)。这是方法演算,不是 CDU 选型值:含乙二醇等冷却液要换物性,实际流量还受机型最小流量、压降与泵曲线约束;机柜 100 kW IT 不一定全部进入液路,剩余热量仍须空气侧处理。CDU 的额定换热能力应核对指定一次/二次入口温度及故障后能力,不能把 CDU 的热 kW 当成泵的电 kW。
4.3 改造老机房 vs 新建
| 问题 | 老机房改造 | 新建 |
|---|---|---|
| 承重 | 液冷柜 + 水可能超原设计 | 按目标密度设计 |
| 净空与路由 | 管路打架是常态 | 可预留竖井 |
| 停机窗口 | 需要逐列迁移 | 可空场施工 |
| 投资节奏 | 分列改造,贴近业务 | 一次性 CAPEX 高 |
| 风险 | 漏水进存量设备 | 工期与需求错配 |
实务建议:P0 试点柜就按「最终冷却形态」做,不要风冷试点成功后再说「生产再改液冷」——两套验收标准会让经验作废。
4.4 和业务的衔接
- 推理小集群:逐柜验证气流与热点后,可能长期使用增强空气侧散热,不必因「GPU」三个字就上冷板;
- 训练 / NVL72 级:冷却立项往往早于交换机选型——否则设备到货无处可插;
- 混部:高密训练柜与低密推理柜分列,避免气流与管路互相拖累。
五、光纤与结构化布线
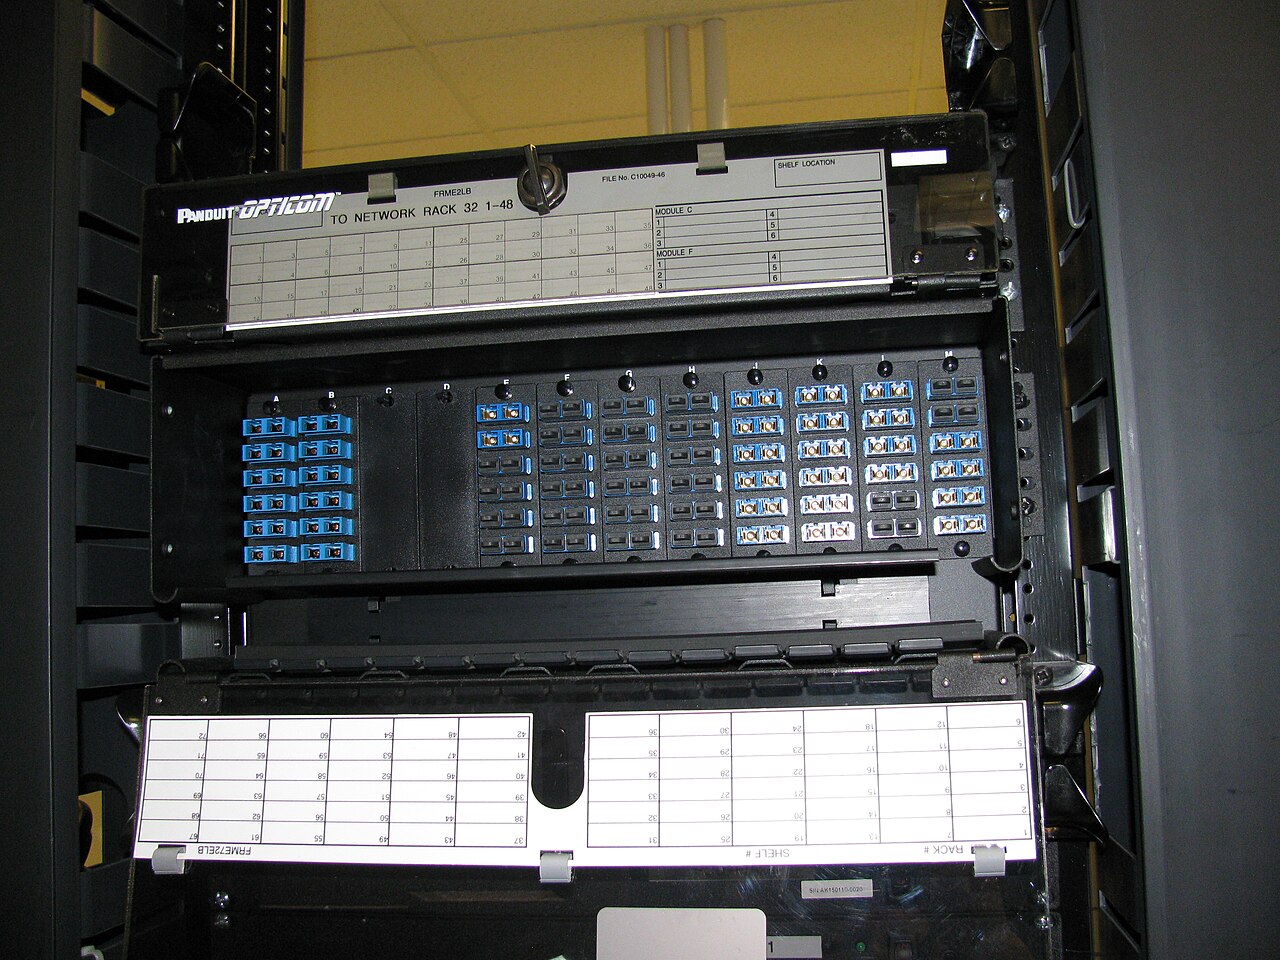
图注:机柜内光纤配线架正面(可见耦合器/端口面板;跳线在本角度不明显)。照片:Robert.Harker / Wikimedia Commons,CC BY-SA 3.0。
5.1 介质怎么选
| 介质 | 典型用途 | 备注 |
|---|---|---|
| 多模 OM3/OM4 | 支持相应多模光学规格的短距链路 | 距离随模块规格变化,不只看速率 |
| 多模 OM5 | 宽波多模光纤,可配合支持的短波波分方案 | 不是用了 OM5 就自动增加带宽或距离 |
| 单模 OS2 | 支持相应单模规格的短距或长距链路 | 距离、连接器与损耗预算按具体 PMD 核对 |
OM/OS 是光纤等级;LC、MPO 是连接器形式,MTP 是 MPO 兼容连接器品牌,不能与单模/多模并列成介质。施工图还要定清 MPO 纤序/极性方法 A/B/C、针脚公母、APC/UPC 端面与 Tx/Rx lane 映射,不能把「都叫 MPO」当成可直插互换。
距离与损耗预算要按模块规格留余量;「测得通光」不等于长稳时误码率可接受。粗算 \(L_{\text{channel}}=a\ell+\sum L_{\text{connector}}+\sum L_{\text{splice}}\)(dB),其中 \(a\) 是纤芯单位长度衰减、\(\ell\) 是长度;再校验 \(L_{\text{channel}}+M\le L_{\text{allowed}}\),\(M\) 为污染、维护等余量,允许损耗取具体光学规格。施工验收保留端面检查与插入损耗报告,OTDR 用于定位连接/熔接问题;上线后再看 FEC、不可纠正误码、链路重训与业务尾延迟。
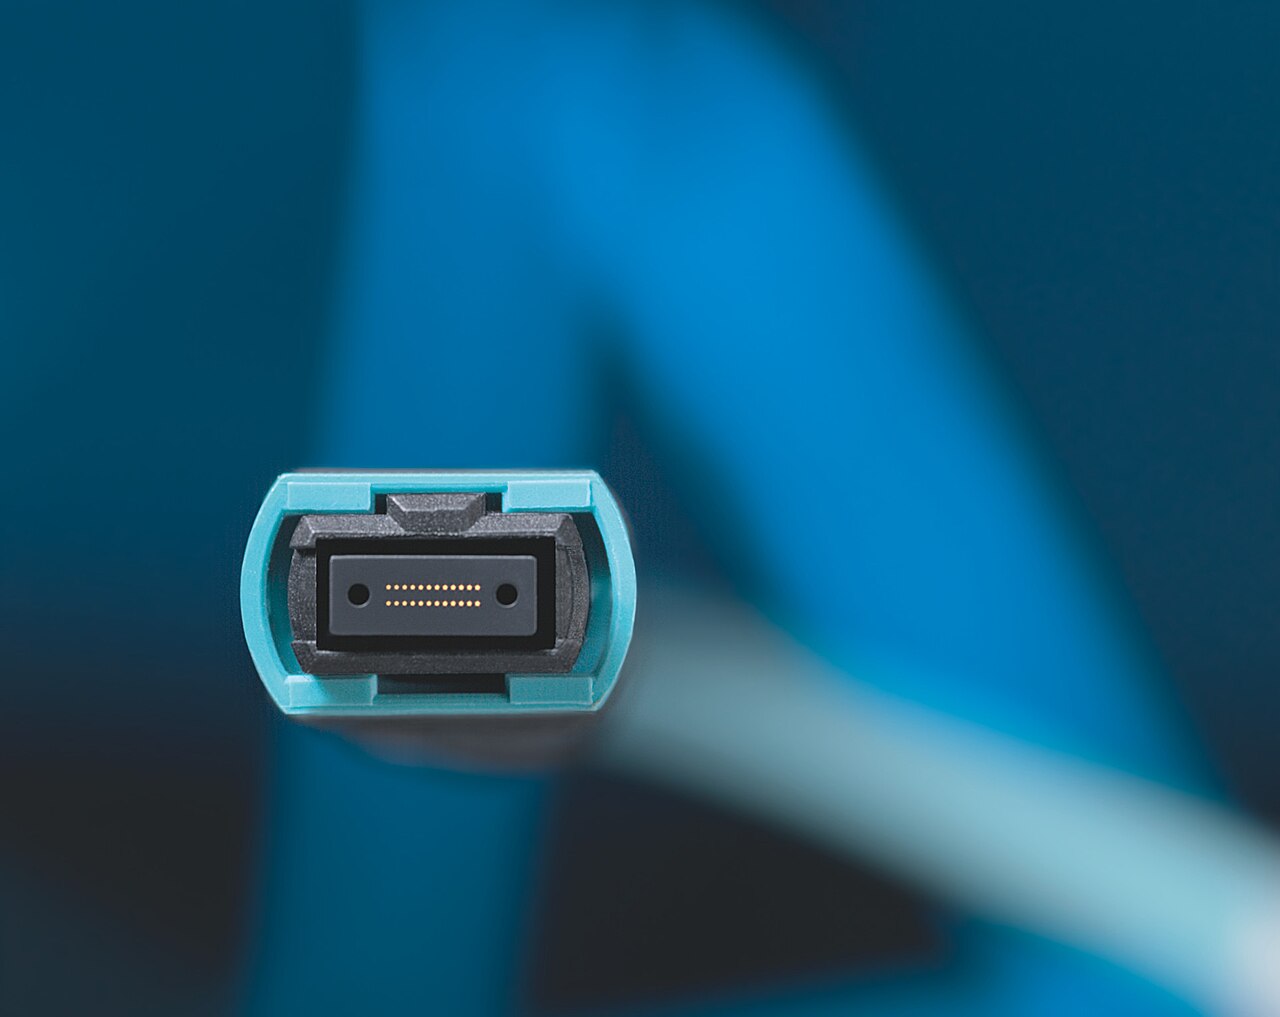
图注:24 纤 MPO 连接器特写——极性与端面清洁是脏活高频点。照片:Reichle & De-Massari / Wikimedia Commons,CC BY-SA 3.0 DE。
5.2 结构化层次
MDA(主配线区)→ HDA(水平配线区)→ EDA(设备配线区)→ 设备端口,是一种简化路由;小机房可以合并区域,并非每条链路都必须经过三级配线架。训练集群建议:
- 所有主干双路径(物理路由分离,不只是双模块);
- 标签含:机柜、端口、rail/链路角色、极性、长度、施工单据号;
- 变更走窗口;清洁端面进标准作业;禁止「临时跳一根先跑着」;
- 预留测试跳线与金样模块,避免生产口当实验室。
5.3 机柜内走线
- 前后门气流:线缆别挡 GPU 进风;
- 弯曲半径:MPO/高芯光纤按厂商最小半径,压扁=未来随机误码;
- 理线:按 rail/编号固定,后人 3am 排障才找得到;
- 电源线与光纤分槽,避免维护时误拔。
5.4 运维纪律(脏活核心)
脏端面常表现为误码、FEC 压力、重训或掉链;极性错误可能根本起不来链路。链路退化造成流量改道、拥塞后,才可能进一步触发 Pause 扩散或 fail-slow,不是「脏光纤必然产生 PFC」。定位时先对照物理误码与链路事件,再看队列、拥塞和作业 step(现象侧见 04)。生产光纤拔插也必须走变更窗口。
建议把「光链路变更」升级到与「生产数据库变更」同级的审批——听起来夸张,但对千卡作业便宜很多。
六、光模块与线缆
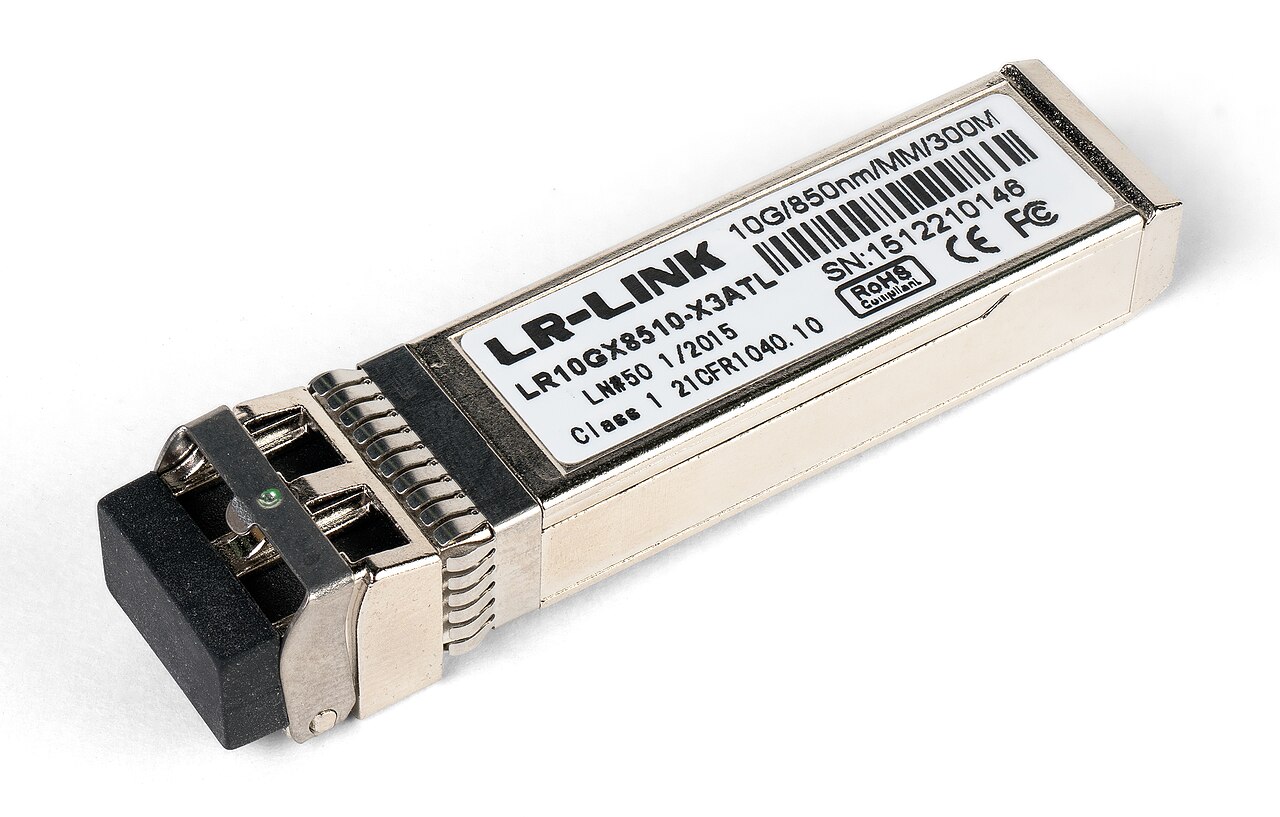
图注:10GBASE-SR SFP+ 可插拔光模块(形态示意;训推网常见为 QSFP28/QSFP-DD/OSFP 等同族更大封装)。照片:Dmitry Nosachev / Wikimedia Commons,CC BY-SA 4.0。
6.1 DAC / AOC / 可插拔
| 类型 | 距离直觉 | 优点 | 代价 |
|---|---|---|---|
| DAC | 柜内 / 邻柜短距,按速率及无源/有源 SKU 核对 | 无源款功耗低 | 粗硬;高速率可用距离更短 |
| AOC | 按 SKU 支持机房内不同距离 | 不另配可插拔模块 | 两端和线缆是一套组件,故障后通常整段换 |
| 光模块 + 光纤 | 短距也能用,跨配线架更灵活 | 光纤与模块可分开维护 | 库存 SKU 多,需兼容与损耗预算 |
例如 NVIDIA MCP4Y10 2×400G 无源 DAC仅列 0.5、1、1.5、2 m,不能把「DAC 可到 5 m」普遍套给 800G。柜内 DAC、列内 AOC、跨列模块加光纤可以混用,但每段仍需逐项核对端口与长度。
6.2 速率代际与端口匹配
规划讨论里常出现的档:100G → 200G → 400G → 800G。原则:
- 交换机逻辑端口、NIC、模块、线缆逐项匹配:封装、lane 数与速率、以太/IB 协议、FEC、光学 PMD、固件及 breakout 映射;800G→2×400G 不只是速率除二;
- 区分面板物理笼位与逻辑端口;支持相同标称速率也可能不能互插,散热、进风方向与面板密度都要核对;
- 04 提到可插拔模块功耗可逼近交换机本体——高密 800G 面板要算光模块总功耗与散热;
- 「追最新 lane 速率」未必利于长稳:有团队故意留在更成熟的 lane 代际以换抖动余量(04 亦有类似工程判断)。
6.3 兼容、锁定与备件
- 兼容与支持边界:区分「设备能识别」「长稳验证通过」与「厂商愿意保修」。第三方模块的报价收益,要与认证、RMA 和排障责任同表比较。
- 固件矩阵:模块型号/版本、NIC、交换机三个维度冻结进「已知好」表,不只记录速率。
- 备件:按 SKU、故障率、交期、RMA 周期和现场替换目标定数量;没有数据时至少覆盖关键 SKU 的替换与金样对照,不宣称一个固定百分比适合所有机房。
- 成本:按实际模块/线缆数量与当年询价填表;不要把无项目边界的占比当预算。
- 温度:按遥测找实际热位,核对模块额定温度与整机散热条件;不能仅凭「面板边缘」判断寿命。
6.4 库存与供应链脏活
- SKU 爆炸:同一速率不同封装(QSFP-DD/OSFP)、不同距离、不同厂商 → 库房灾难;能收敛就收敛;
- 到货周期:高峰年份光模块可能长交期——P0 就要锁试点 SKU;
- 报废策略:代际切换时明确「旧模块给非关键池 / 实验室」,别混进生产白名单。
七、交换机选型脏活
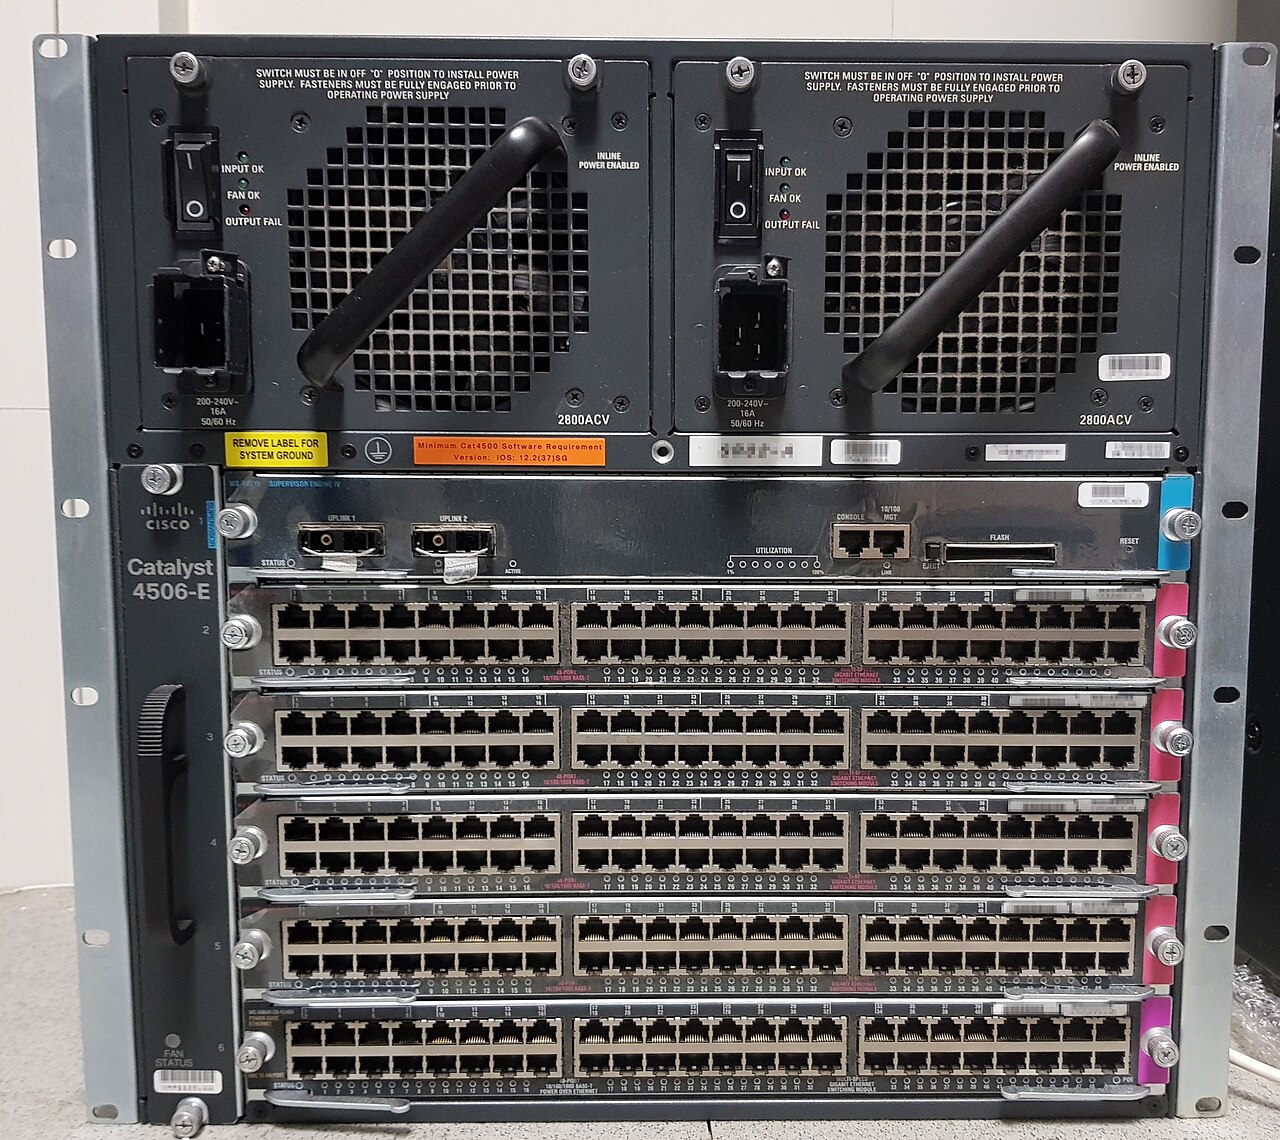
图注:机架式以太网交换机正面端口(示意面板与模块位;非训推网 IB/RoCE 选型推荐)。照片:X-Javier / Wikimedia Commons,CC BY-SA 4.0。
7.1 采购视角:IB vs RoCE(呼应 04,不重复协议课)
| 维度 | IB(如 Quantum 系) | RoCE / 以太(白牌或 Spectrum-X) |
|---|---|---|
| CAPEX | 按同速率、同拓扑完整 BOM 询价 | 同样包含 NIC、模块、许可、维保;不预设品牌价格排序 |
| 运维 | 独立 IB 管理栈与工具 | 可复用部分以太工具,但 RDMA 仍有新增能力要求 |
| 流控与拥塞 | 链路 credit 流控,仍需拥塞与故障管理 | 明确 PFC/ECN 策略、NIC 拥塞算法与队列映射;DCQCN 是一种选择,不是所有部署必选 |
| 锁定 | NIC/交换垂直整合深 | 多厂商但兼容矩阵复杂 |
| 公开部署证据 | 不拿单一案例推导价格优劣 | Meta SIGCOMM 2024 介绍其 RoCE 集群设计与运维,包含 Llama 3 训练部署;这不是 IB/RoCE 对照实验,也不能证明所有项目的 TCO 排序。文献:RDMA over Ethernet for Distributed Training at Meta Scale,作者稿 |
国产以太网白牌 + 自研 NIC/交换(阿里 HPN、腾讯星脉等公开材料)属于 RoCE 阵营的工程现实——细节见 04。
决策启发式(非教条):
- 已有强以太团队、要快速扩到万卡、预算紧 → 认真评估 RoCE;
- 小团队、深度绑定 NVIDIA 栈、希望采购已验证的整套交付与支持 → 认真评估 IB;
- 无论选谁:无损与线缆质量比品牌口号更能决定 MFU。
7.2 拓扑如何改「台数与线缆数」
- Leaf-Spine:服务器→Leaf,Leaf↔︎Spine 全互联;扩展清晰,线缆数随过订阅比变。
- Rail-optimized:常见做法是把每台服务器同编号 NIC 接到对应 rail,并匹配 GPU–NIC 亲和性;NCCL 尽量在 ring/tree 中使用同编号 NIC,减少 rail 间流量干扰,具体路径仍受通信器、算法和 GPU/rank 布局影响(NCCL_CROSS_NIC 文档)。leaf 端口池按 rail 拆分,跨 rail 的物理路由与可达性要明确,不能保证「所有 DP 都只在同一 rail」。
分别列 服务器–Leaf 与 Leaf–Spine。\(N\) 台各启用 8 个 400G 网络端口的服务器,对应 \(8N\) 条服务器链路;上联数另按拓扑与过订阅计算。DAC/AOC 按完整组件采购,点到点组件通常一条链路一条;一分二组件则按实际 SKU 展开,不能按两条链路买两条同款组件。
只有每条光链路两端都各占一个独立模块时,模块数才是 \(2\times\) 链路数。一个 800G twin-port 模块接两个独立 400G 模块,是两条光链路、三个模块;NVIDIA 连接示例明确同一 OSFP 内有两套收发引擎。采购表应先列逻辑端口,再映射物理笼位、模块与线缆 SKU,避免在 800G breakout 上重复买模块。
把 §2.4 的 128 台机展开成端口表(纯算术示例,上下联容量 1:1):
| 项 | 端口与数量推导 |
|---|---|
| 服务器端口 | 128 台 × 8 个 400G = 1024 条服务器–Leaf 链路 |
| Leaf | 每台 64 个逻辑 400G 端口,32 下联 + 32 上联;1024 ÷ 32 = 32 台 |
| Leaf–Spine | 32 台 Leaf × 32 上联 = 1024 条链路 |
| Spine | 每台 64 个逻辑 400G 端口;1024 ÷ 64 = 16 台,每 Leaf 到每 Spine 2 条 |
| 全光、独立单端口模块 | (1024 + 1024) × 2 = 4096 个模块,未含备件/存储/管理网 |
上面的端口总数同时对应两种截然不同的物理接线拓扑,选型前必须先明确是否允许跨 rail 直通:(1)Rail-only(8 个独立 2-Spine 孤岛) 把 32 台 Leaf 与 16 台 Spine 拆成 8 个物理隔离的子网(每 rail 4 台 Leaf 只连本岛 2 台 Spine,无跨 rail 互联路径),隔离性最强,但存在 zero cross-rail fabric path——跨编号 NIC 流量无法在网络层直达;(2)Rail-optimized Fat-Tree(共享 Spine 胖树) 同样要求每台 Leaf 的下联只接同编号 rail(不混接 8 个不同 rail),但 32 台 Leaf 依然全互联到全部 16 台共享 Spine(每 Leaf 到每 Spine 2 条上联),在保持同 rail 局部性的同时保留跨 rail 经共享 Spine 的 2 跳可达性。上表只证明端口可配与上下联容量 1:1,不保证实测无阻塞、单交换机故障后满带宽或作业不中断。buffer/headroom 也不能只比总 MB:每优先级预留须覆盖暂停传播期间在途数据(量级为链路速率 × 反应时间),再按 ASIC、MTU、线长与并发实测,不能把别家的 ECN/PFC 阈值直接搬来。
过订阅(oversubscription)能省端口,也可能拉长集合通信。推理池是否能接受,要按突发与尾延迟压测;大同步训练则要把省下的网络费用与作业时长放在同一张 TCO 表里。
7.3 规格检查清单(买之前)
- 端口速率与密度、是否支持你们的 breakout;
- Buffer 与 PFC 计数/遥测是否够训推突发;
- 管理面:CLI/API、固件升级路径、自动化(Ansible/厂商工具);
- 维保:4h/NBD、备机、备件所在地、是否含光模块;
- 供电与散热:交换机本体 + 满配光模块功耗 + 进风方向与机柜布局;
- 安全:控制面隔离、固件签名、账号与审计(训推网被横向打穿的代价极高)。
7.4 国产白牌 vs NVIDIA 系:工程取舍表
| 取舍点 | 白牌 / 国产以太方案 | NVIDIA Spectrum / Quantum |
|---|---|---|
| 单价与供货 | 按当年询价、认证范围与交期比较 | 同速率同拓扑询价,不能仅凭品牌排序 |
| 调参负担 | 更高(PFC/ECN 等) | IB 相对省心;Spectrum-X 仍要以太功底 |
| 人才市场 | 以太网人才多 | IB 专才更稀 |
| 长期演进 | UEC 等开放方向(见 04) | 与 CUDA/NCCL 路径黏着 |
| 适合 | 有网络工程深度的团队 | 要垂直整合与交付速度的团队 |
八、RDMA 端到端落地 Checklist
8.1 四分法
- 硬件:NIC 型号/固件、PCIe 拓扑、GPUDirect RDMA 是否在支持矩阵内;
- 驱动 / RDMA 栈:内核 RDMA
驱动或厂商发行版、RoCE GID、链路层、MTU 与 NCCL
实际数据路径;
NET/IB插件也服务 RoCE,不等于物理网络是 IB,更不单独证明 GPUDirect RDMA(GDR); - 交换机:若为 RoCE,核对 PFC/ECN 策略、优先级映射、ECMP、buffer 与告警;若为 IB,核对 fabric 管理、路由、credit/拥塞及错误计数,不照搬以太配置;
- 验收:单流/多流带宽与时延、丢包、长稳、训练 step 抖动。
8.2 配置归属(减少扯皮)
| 归属 | 典型内容 |
|---|---|
| 交换机队 | PFC/ECN、队列、ECMP、遥测、变更窗口 |
| 主机/平台队 | 所选 NIC 拥塞算法(如 DCQCN)、MTU、GID index、NCCL 环境变量、绑定 |
| 业务训推队 | 作业级超时、重试、MFU 门禁 |
把「谁有权限改 PFC」写进变更手册;多人可改且无审计,是生产事故的标配前情。
8.3 验收最低集(交割用)
记录本项目的:配置版本、拓扑、消息大小、并发、阈值生成方法,以及测试窗口内计数器增量基线(相对清零或相对历史)。
- verbs /
带宽:
ib_write_bw(或同级 RDMA verbs 工具)单流/多流;阈值按线速百分比与本项目历史基线定,并记录端口速率/MTU/PCIe 代数(普通 TCPiperf可作对照,不能替代 RDMA 验收); - 集合通信与 GDR:NCCL tests /
真实小作业按目标拓扑与消息大小达标;普通主机内存
ib_write_bw不能证明 GPU 直传,还需 GPU 缓冲区注册、支持矩阵与实际 GDR 路径日志/测试证据;相关控制见 NCCL GDR 文档; - 长稳窗口:项目可先约定 24–72h,覆盖持续高负载和突发,不宣称这能保证设备寿命;记录光模块温度、链路重训、CRC、FEC 不可纠正误码、作业吞吐与 step 的 P95/P99;
- 交换机侧:看同一窗口内 PFC/Pause 时长及计数增量、队列占用、丢包、ECN/CNP 与业务尾延迟。ECN 是拥塞控制信号,数量多不自动判失败;正常持续流控也可能使计数增长,门禁应是异常暂停、不可接受的丢包/尾延迟和作业失败,而不是「PFC≈0、ECN 少量」;
- 故障注入(前提):须经业务、网络与设施责任人批准,在隔离试点或维护窗口内按 runbook 执行,先确认回退与人员安全。网络侧可验证停用一条上联或隔离 Leaf 后的设计降级;UPS 切换和漏液告警演练只由设施专业人员按批准方案执行,不在生产柜主动放液或带电拔接。
8.4 与 04 的交叉:你在本篇只「交割」,细节回原篇
- NCCL 环境变量、GID、GDR、rail 拓扑原理 → 04;
- 本篇保证:立项有清单、验收有门禁、归属有名字。
九、BOM 与预算
9.1 CAPEX 拆分:先定义预算边界
| 大类 | 计数依据 | 防止漏算或双计 |
|---|---|---|
| GPU 服务器 | 机型 × 台数 | 若整机已含 NIC,不再把同一 NIC 加进网络账 |
| 交换机 + 额外 NIC | 拓扑端口表、备机与维保范围 | 另计满配模块的供电与散热 |
| 光模块 / 线缆 / 光纤 | 逐段链路表、配线图、备件 SKU | 模块按实际封装计数;施工和测试另列 |
| 电力 / 冷却改造 | 设计院工程量清单 | CDU 电功率与换热能力分开,核对托管费已包含什么 |
| 土建 / 弱电消防 / 托管费用 | 自建工程清单或托管合同 | 押金、一次性接入费与持续租金分开归类 |
没有同一代际、同一项目边界的报价,就不填「通用 CAPEX 百分比」。预算份额在同一分母下必须能加到 100%;重复纳入 NIC、混入托管租金,都会让看似精确的比例失真。
自建与托管的分界:托管省土建,但柜功率密度与液冷许可可能卡死代际;自建 CAPEX 高,换控制权。财务模型要显式比较「三年 TCO」,不要只比首年发票。
9.2 OPEX:电费可复算表
年电量费粗算(IT 平均功率以 kW 计,电价 \(t\) 以元/kWh 计,PUE 为年度能源比):
\[ \begin{aligned} C_{\text{elec/year}} &\approx P_{\text{IT,avg}} \times 8760 \\ &\quad \times \text{PUE} \times t \end{aligned} \]
| 假设(示例) | 值 | 来源标签 |
|---|---|---|
| IT 平均功率 | 200 kW | 规划假设 |
| PUE | 1.20 | 人为年度预算假设,含冷却/输配,不是液冷保证值 |
| 电价 | 0.40 元/kWh | 人为单点假设,不是区域行情或报价;按合同电价、时段与附加费用替换 |
| 年电量费(示例) | 200 × 8760 × 1.2 × 0.4 ≈ 84 万元 | 示例非报价;换电价/PUE 需重算 |
这行只算电量费;需量/容量电费、峰谷时段、税费及托管加价按合同另列,不能拿地区均价替代。再加维保、专线、人力、光模块更换与备件物流。选址比较用各候选机房的真实计费规则与预计负载曲线,同表比较三年 TCO。
9.3 分期扩容门禁
| 阶段 | 范围 | 进入下一阶段的门禁 |
|---|---|---|
| P0 | 1 柜试点 | 设施人员批准的电力切换验证;如液冷:漏液告警/联锁验证;RDMA 验收;光模块温度长稳(隔离/窗口/回退) |
| P1 | 一叶(完整小拓扑) | 集合通信按本项目阈值达标、变更流程跑通、备件到位 |
| P2 | 一 Pod(Spine+多叶) | 故障域演练、容量看板与业务 Q 对齐 |
切忌按终态一次性囤满最新模块——价格、供货与代际变化快,按项目询价与路线图复核。试点柜要覆盖最容易出问题的路径:液冷接头与告警(若采用)、MPO 极性、RoCE 拥塞及设施切换;验证按 §8.3 的批准范围执行。
9.4 示例 BOM 表(结构示意,非报价)
场景:16 卡推理试点柜 + 小规模 RoCE 叶,结构示意。
| SKU 角色 | 数量级 | 备注 |
|---|---|---|
| 8 卡 GPU 服务器 | 2 | 含 NIC |
| ToR / Leaf 交换机 | 示例 2 台 | NIC/rail 与故障后可达性要另画,不能仅凭台数认定冗余 |
| 服务器–Leaf:400G DAC(柜内短距) | 按完整组件 SKU + 本项目备件 | 点到点一条 DAC 含两端;breakout 按组件展开 |
| 服务器–Leaf:可插拔模块(替代 DAC) | 按物理笼位、单/双端口模块与备件计数 | 独立单端口两端各一时才是 \(2\times\) 链路数 |
| Leaf–Spine:DAC 或光模块/光纤 | 若试点无 Spine,此项为 0;扩容后另列 | 逻辑链路与物理 SKU 分开,双端口不重复计 |
| MPO 主干 / LC 跳线 | 按配线图 | 含标签与施工 |
| 智能 PDU | 2–4 | 看机柜供电架构 |
| CDU 份额 / 空气侧改造 | 按选定路线与工程量 | 无冷板时可无 CDU,但不能省略散热能力验收 |
| 监控(温湿度/漏液/电量) | 1 套起步 | 常被漏 |
| 人力(设计+施工+验收) | 1 个项目包 | 常被算漏 |
合计金额故意不写死——用你们当年询价填充;表的价值是不漏行。
9.5 预算评审时工程师该带的三张表
- 假设表:QPS/tokens、\(S\)、\(\alpha\)、PUE、电价、同时系数;
- 功率表:逐柜 IT 设计峰值、冷却/其它设施负载与损耗 → 各供电范围的故障后容量;另列平均功率电费账;
- BOM 表:按 P0/P1/P2 分行,标「本季下单 / 下季选项」。
缺任一表,会议会退化成「我觉得液冷比较好」。
十、踩坑清单与开放问题
10.1 踩坑清单
- 用网文 tok/s 直接定卡数,没有自己的压测与 SLO 余量;
- 只订 GPU,忘了光模块、光纤施工、PDU、CDU;
- 只算 GPU TDP,漏掉整机、网络、存储;或把 CDU 加进 IT 底数后又乘 PUE;
- RoCE 环境 PFC 乱开或阈值不当,训练一跑就 Pause 风暴;
- MPO 极性现场临时改,导致「有光无业务」排障三天;
- 白牌模块省小钱,在关键窗口无备件;
- 按终态一次采购,模块代际切换后库存报废;
- 试点柜只用最好路径,没测 UPS 切换与泄漏;
- 网络队与平台队对 DCQCN/PFC 归属不清,故障互相甩;
- 把托管「可上架」当成「可上 120 kW 液冷柜」;
- 过订阅省 spine,MFU 崩了再补线,工期与业务双爆;
- 训推混部共故障域,一次光模块抖动两摊业务一起红。
10.2 开放问题(留给作者/读者跟进)
- 你们区域供电局对 AI 机房增容的真实周期与同时系数如何批复?
- 800G/1.6T 时代,CPO/LPO 是否已进入可采购清单?(趋势见 04)
- UEC 与 Spectrum-X 在供应链的 2026–2027 可交付性?
- 国产液冷 CDU/冷板生态的维保半径是否覆盖机房城市?
- 训练与推理混部时,电力/网络故障域如何切分才不互相踩踏?
- 碳核算与绿电合约如何进入机房选型(政策与电价双驱动)?
十一、自建 vs 托管,与一周启动清单
11.1 自建 / 改造 / 托管怎么选
| 维度 | 托管机柜 | 存量机房改造 | 新建/租赁专用机房 |
|---|---|---|---|
| 上线速度 | 快(有现成柜) | 中 | 慢 |
| 柜功率上限 | 合同写死,改价高 | 取决于改造深度 | 可按目标密度设计 |
| 液冷 | 许多机房仍受限 | 冷板直冷可分列试点 | 可一次到位 |
| 运维责任 | 分界面多 | 全责 | 全责 |
| 适合 | 推理试点、不确定增长 | 已有物业与电力余量 | 千卡级训练、明确 2–3 年路线 |
增长不确定时,托管能减少提前投入;路线清晰且托管柜功率卡住代际时,再比较改造/新建的工期、现金流与三年 TCO。
11.2 与业务方的一页对齐稿(可直接贴立项)
- 业务:明年高峰 QPS / 日 tokens / SLO;模型与上下文假设;训推是否混部。
- 容量:卡数、机柜数、逐柜 IT 设计 kW、冷却/设施设计负载、故障后供电容量;平均功率与 PUE 只另列电费预算。
- 约束:现机房进线剩余、能否液冷、托管合同密度上限。
- 网络立场:IB 或 RoCE;拓扑 Leaf-Spine 或 Rail;端口代际。
- 分期:P0/P1/P2 范围、门禁、本季采购清单。
- 风险:供电批复周期、光模块交期、代际贬值、人才(谁会调 PFC)。
11.3 一周脏活启动清单(工程师可执行)
D1–D2 摸底
D3–D4 粗算
D5 对齐
D6–D7 试点设计
做完这一周,你就有资格谈预算;没做完就谈「上多少卡」,容易买回一堆插不进机房的盒子。
11.4 文档与图纸最小集
| 文档 | 用途 |
|---|---|
| 假设表 + 功率表 + BOM 表 | 立项与变更基线 |
| 机柜面布局图 | 施工与气流 |
| 配线矩阵(端口级) | 光纤/模块施工 |
| 网络逻辑图(含 rail) | 与 04 概念对齐 |
| 验收记录(含长稳) | 交割与追责 |
| 变更 runbook(PFC/光链路) | 降低 3am 事故面 |
11.5 和系列其它篇的阅读顺序建议
- 先 02 建立单机功率直觉;
- 再读本篇漏斗与电力/冷却;
- 并行读 04 把拓扑与 RDMA 原理补全;
- 用 24 把电费与 TCO 讲给财务听;
- 卡上软件栈回 21 / 29 / 30,全系列路线回到 大模型基础设施工程目录。
十二、小结
机房脏活的正确顺序是:业务 → 卡与柜功率 → 电力/冷却可行性 → 布线与光模块 → 交换机与 RDMA 交割 → 分期 BOM。协议细节回 04,电费与 PUE 账回 24,卡上服务回 21 / 29 / 30。
采购前最值得问的一句是:这批设备全部到货时,谁能证明它们有电可用、有热可排、网络能跑,故障后还能满足约定的服务目标?答案应落在功率表、端口表和验收记录里。
参考资料
规范与标准
- 国家市场监督管理总局 / 国家标准化管理委员会(SAMR):GB/T 156—2017《标准电压》(修改采用 IEC 60038:2009,220/380 V 中国标称电压体系;可在国家标准全文公开系统核对)。
- ASHRAE TC 9.9:Liquid Cooling Guidelines for Datacom Equipment Centers(液冷供水温度与数据中心冷却边界参考);Open Compute Project (OCP) Cold Plate / Liquid Cooling 规范。
- Fluke Networks 技术参考:OM1–OM5 与 OS1/OS2 光纤等级、12-Fiber MPO 极性方法 A/B/C。
厂商硬件与架构规格
- NVIDIA:H100 Tensor Core GPU 规格(可配置 TDP 上限 700 W)。
- NVIDIA:DGX H100 User Guide(最大系统输入功率 10.2 kW)。
- NVIDIA:Mission Control 2.0 Systems Administration Guide / FAQ(GB200 NVL72 满载整柜约 120 kW 规划示例)。
- NVIDIA Networking:MCP4Y10 2×400G 无源 DAC 规格(0.5–2 m)与 800G Twin-Port OSFP 连接示例。
- NVIDIA NCCL:User
Guide — Environment
Variables(
NCCL_CROSS_NIC与 GPUDirect RDMA 控制)。
核心论文
- Ganguly 等(Meta),RDMA over Ethernet for Distributed Training at Meta Scale,SIGCOMM 2024(作者稿 PDF)——大规模 RoCE 集群设计、拓扑取舍与 Llama 3 训练运维经验。
实拍图片与许可
- 本文 8 张设施、连接器与面板实拍均来自 Wikimedia
Commons,按各自 CC0 / CC BY / CC BY-SA
许可署名并仅作等比缩放,完整源页 URL、作者、许可条款与说明见
images/photos/ATTRIBUTION.txt。
上一篇:30:推理算子与内核 下一篇:32:AI 集群存储与分布式 KV 缓存系统
源码下载
本文相关源码已整理,共 2 个文件。
文章导航
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【大模型基础设施工程】04:互联与网络——NVLink、InfiniBand、RoCE 与国产替代
从 NVLink / NVL72 / UnifiedBus 到 InfiniBand、RoCEv2、UEC 1.0 与 rail-optimized 拓扑,系统拆解万卡集群互联的带宽账、拥塞控制、GPUDirect RDMA 与排查实操。
【大模型基础设施工程】24:成本、合规与安全
从卡时、电费到 AI Act 与 Prompt Injection——一份写给基础设施工程师的大模型成本、合规、安全三位一体手册。
【大模型基础设施工程】21:推理服务化
从单机引擎到生产集群:Gateway API Inference Extension(llm-d)、Dynamo、AIBrix、KServe、Ray Serve、PD 分离、KV-aware 路由、LoRA 多租户与冷启动优化全景工程实战。
【大模型基础设施工程】02:GPU 计算入门——SM、Tensor Core、HBM、NVLink
从 CPU 与 GPU 的架构差异出发,讲清楚 SM、Warp、Tensor Core、TMA、TMEM、HBM、NVLink 与 Roofline 的工程含义,并结合 FlashAttention、Triton 与国产算力栈建立 GPU 性能直觉。