在大模型集群里,存储系统往往在两个阶段同时拖垮 GPU 利用率:训练期数千张卡并行随机读语料、或者在步间同步写 TB 级检查点(Checkpoint)时,传统企业 NAS 的元数据锁与 TCP 网关瞬间打满;推理期长上下文请求切入多轮对话或 RAG 时,单机 HBM 装不下全部前缀状态,但如果不算清跨节点拉取字节数与算力重算的盈亏线,把 KV 卸载到廉价网络盘反而比重新 Prefill 更慢。
本篇从存储系统第一性原理出发,补全 10:Checkpoint 与故障容忍、11:推理引擎基础、21:推理服务化、28:DeepInfer 深度解析 与 31:机房脏活 之间的“数据面存储与分布式缓存”拼图;通用块存储、文件系统与云原生数据库存算分离架构见姊妹系列 存储工程索引 与 计算存储分离实践。全文所有解析计算曲线均明确标为 Analytical Model(解析模型,非实测基准),外部论文与开源仓库指标均保留原始前提与硬件条件。
〇、30 秒版
- 三类 I/O 负载把通用存储逼到极限:训练集高并发小块随机读打穿目录缓存与 Page Cache;万卡级 Checkpoint 写入以脉冲方式瞬时冲击元数据服务器(MDS);分布式 KV 缓存把存储从“离线归档”拉进毫秒级 TTFT 在线关键路径。
- DeepSeek 3FS
把“简化一致性”与“绕过内核栈”做到极致:无状态元数据服务托管给
FoundationDB,数据副本走 CRAQ(Terrace
& Freedman, USENIX ATC
2009)链式复制换取强一致下的水平线性读扩展,客户端以
USRBIO
共享内存环形缓冲区(
Ior/Iov)绕过 FUSE,存储节点以io_uring直驱 NVMe;公开 README 实测 180 节点在含训练后台流量下实现 \(6.6\text{ TiB/s}\) 聚合读吞吐。 - 分布式 KV
缓存已经从“前缀本地留存”演进为“集群级计算换存储池”:从
CachedAttention(USENIX ATC
2024)的层级异步预取、Mooncake(USENIX FAST
2025 Best Paper)以 KVCache 为中心的 PD 分离与全局调度,到
CacheBlend(ACM EuroSys 2025 Best
Paper)对非前缀 RAG 块只重算约 \(15\%\) 高偏差
token,再用 NVIDIA NIXL 把
UCX/GDS/POSIX/HF3FS收口为统一异步点对点张量传输接口。 - MLA 彻底改写 KV 卸载经济账:对照
70B GQA-8(\(320.0\text{ KiB/tok}\))与DeepSeek-V3/R1 MLA(61 层、\(512+64\) 维,\(68.6\text{ KiB/tok}\)),在相同的 H100 SXM5 FP8+BF16 50% MFU 解析模型下,MLA 让单块 \(6\text{ GB/s}\) 本地 NVMe 的盈亏长度从 \(29{,}059\text{ tok}\) 降至 \(3{,}905\text{ tok}\),同时让每 TiB 集群内存池多容纳 \(4.66\times\) 上下文。 - 生产落地的五个暗坑:多租户前缀共享的跨租户时序旁路(如
PROMPTPEEK, NDSS 2025)必须依赖请求级
cache_salt与实例隔离;小块 KV I/O 极易触发 MDS 元数据风暴(LMCache 默认chunk_size=256);朴素页级 LRU 会破坏前缀树局部性;Fail-Slow NVMe 尾延迟要求读超时直接回退重算;计算面与存储面 RDMA 混跑会引发 PFC 拥塞互锁。
一、为什么通用企业 NAS 与对象存储会栽在 AI 集群上
1.1 系列分工与本文边界
在深入具体存储系统前,先明确本篇与站内邻接文章的职责切分,避免把计算、调度与物理机房问题混在一张表里:
| 关联篇目 | 它负责回答什么 | 本篇 32 聚焦什么 |
|---|---|---|
| 10:Checkpoint 与故障容忍 | 训练态体量、Young-Daly 间隔、PyTorch DCP / ByteCheckpoint / TorchFT | Checkpoint 脉冲写盘对后端 MDS、副本协议与三层缓冲的存储压力 |
| 11:推理引擎基础 | MHA/GQA/MLA 字节估算、Roofline 与单机 KV 生命周期 | 跨出单卡 HBM 之后的五层分布式 KV 存储层次与传输盈亏公式 |
| 21:推理服务化 | K8s 控制面(llm-d/Dynamo/AIBrix)、PD
分离部署与 KV-aware 路由 |
支撑 PD 分离与跨副本复用的底层 KV 存储引擎、NIXL 与安全隔离 |
| 28:DeepInfer 深度解析 | V4.1-Flash 开源离线切片源码、SWA bounded replay 与未开源边界 | 补齐 DeepInfer README.md 外留给专用 3FS
集群的分布式 KV 后端原理 |
| 31:机房脏活 | 机柜功率、液冷、光模块 BOM 与 IB/RoCE 网卡验收 | 存储面与计算面 RDMA 隔离策略及机内 NVMe/NIC 带宽预算 |
| 计算存储分离实践 | Aurora/TiDB/Snowflake/ClickHouse 云原生数据库存算分离 | 面向张量与前缀树的 AI 专用存储(无 SQL 事务、重聚合带宽与零拷贝) |
1.2 AI 集群的三类极端 I/O 画像
传统企业 NAS(NFS/SMB)和标准对象存储(S3/OSS)针对的是办公文档共享、微秒级小事务或吞吐弹性优先的离线数仓。把它们直接塞进 AI 集群,会在三类典型负载上逐一失效:
- 训练集全局随机读(Random Dataset
Reads):多模态与预训练语料包含数千万至上亿条样本(Parquet
分片、WebDataset tar 包或细粒度索引文件)。每一个 epoch
开始时的全局 shuffle 会打破顺序局部性,导致数千个 DataLoader
进程同时发起高并发小块随机读与高频
open/stat。通用 NAS 的单主节点锁、内核 Page Cache 抖动(读一次即失效的缓存污染)以及 TCP 协议栈软中断拷贝,很快会把存储网关 CPU 压满,而后端 NVMe 阵列带宽却只跑出个位数百分比。 - 脉冲式同步检查点写入(Bursty Checkpoint
Writes):正如 10
篇 核算的,LLaMA-3 405B 级训练态约 \(6.48\text{ TB}\),DeepSeek-V3
671B 级超过 \(10\text{
TB}\)。即便经过本地内存快照异步化,数千个 rank
仍常在同一时间窗口内并发创建分片文件并落盘(如 PyTorch DCP
每个 rank 独立写
.distcp文件)。在缺乏本地 NVMe 缓冲或 rank 合并直写共享盘时,数千并发的open(O_CREAT)、rename与fsync会在数秒内锁死传统单个 POSIX 元数据服务器(MDS);对象存储虽然容量无上限,但高并发小对象PUT延迟毛刺同样会把慢节点拖成整组同步屏障的短板。 - 延迟敏感的分布式 KV 缓存加载与写回(Latency-Sensitive KV Load/Store):这是大模型推理独有的新型 I/O。与传统对象存储容忍几十到几百毫秒首字节延迟不同,一条 32K 上下文的 KV Cache 加载必须跑赢 GPU 重新算一遍 Prefill 的时间——窗口通常只有几十到数百毫秒,且单次读操作希望直接跨过主机内存或通过 RDMA 送入目标 GPU 显存。如果还按“应用写 POSIX 文件 → 内核 VFS → FUSE → TCP → 对象网关”路径流转,序列化与上下文切换损耗就会直接吃掉缓存收益。
| 负载类型 | I/O 方向与粒度 | 典型并发形态 | 通用企业 NAS / 对象存储的主要死因 |
|---|---|---|---|
| 语料随机读 | 只读;KB–MB 级随机偏移 | 数千 DataLoader 持续并发 | Page Cache 污染、单网关网卡/CPU 软中断打满 |
| Checkpoint 刷盘 | 脉冲写;GB–TB 级分片并发落盘 | 数千 rank 在保存窗口同时写 | POSIX MDS 锁竞争与 fsync
阻塞导致长尾掉队 |
| 分布式 KV 缓存 | 读写混合;块级(百 KB–百 MB)随机命中 | 毫秒级 SLO 敏感的异步拉取/写回 | VFS/FUSE 内核路径税与高 RTT 导致加载慢于重算 |
正是这三类互相冲突的要求——海量随机读 IOPS + TB 级脉冲写带宽 + 亚毫秒级零拷贝加载——催生了以 DeepSeek 3FS 为代表的 AI 原生并行文件系统,以及从本地 DRAM 一路铺到集群 RDMA 池的分布式 KV 缓存系统。
二、DeepSeek 3FS:面向 AI 集群的分布式并行文件系统
2.1 架构取舍:用现有强底座换极简系统复杂度
2025 年初 DeepSeek 开源了支撑其万卡训练与在线推理 KV
卸载的 3FS(Fire-Flyer File
System,deepseek-ai/3FS)。读懂 3FS
的关键,不是背诵它有多快,而是看清它刻意不做什么。
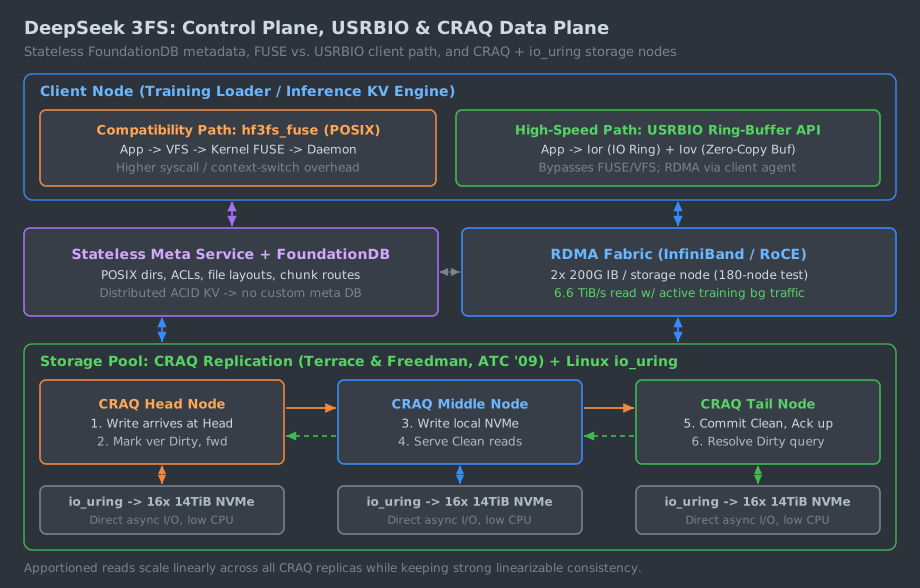
传统并行文件系统(如 Lustre、GPFS、CephFS)往往从零自研分布式元数据日志、复杂的细粒度字节锁管理器以及多级分层缓存策略。3FS 把架构拆成高度解耦的三个平面,各自只选一条经过验证的路径:
- 存算解耦的存储池与直驱
NVMe:存储节点(Storage Service)只负责把本地数十块
NVMe SSD
聚合为纯数据块池,不承担复杂的分布式文件目录事务;底层使用
Linux
io_uring异步提交磁盘读写,避开传统同步pread/pwrite线程池切换开销。 - 无状态元数据服务 + FoundationDB:3FS 的
meta_service本身是无状态的,POSIX 目录树、inode、权限与文件块条带化映射(chunk layout)全部作为事务性键值存进 FoundationDB。依靠 FoundationDB 成熟的分布式 ACID 事务与高并发微秒级读能力,3FS 直接绕过了从零编写 Paxos/Raft 元数据状态机的数年研发周期,也避免了单点 MDS 内存墙。 - CRAQ 强一致复制:存储副本层直接采用 CRAQ(Chain Replication with Apportioned Queries,Terrace & Freedman, USENIX ATC 2009),放弃了最终一致带来的业务侧纠偏复杂性,换取强一致语义下的水平线性读扩展。
2.2 CRAQ 的机制与强一致线性读扩展
CRAQ 源于经典的链式复制(Chain Replication, van Renesse & Schneider, OSDI 2004)。在原始 CR 中,所有写入必须从链头(Head)串行传播到链尾(Tail)才能提交,而所有读请求也只能发往 Tail——这保证了线性一致性(linearizability),但导致集群中 \(N-1\) 个前序副本在读密集负载下完全闲置。
Terrace 与 Freedman 在 USENIX ATC 2009 提出的 CRAQ 只加了一项核心改动就解锁了全链读并发:多版本 + Clean/Dirty 状态位:
- 链上每个节点可为一个数据块保存多个版本,新写入从 Head 顺着链路向 Tail 推进时,各节点先将新版本标记为 Dirty(未提交确认);
- 当写请求抵达 Tail 并落盘后,Tail 将该版本标记为 Clean(已提交),并沿链路反向通知前驱节点把对应版本翻转为 Clean;
- 客户端读取数据时,可由任意副本(Head、Middle 或 Tail)承接(即 Apportioned Queries)。如果该副本上最新版本是 Clean,直接本地返回——读吞吐随副本数线性增长;只有当恰巧撞上正在写入中的 Dirty 版本时,该副本才向 Tail 发起一次轻量的最新已提交版本号查询,再把对应已提交版本返给客户端,从而在不降级为最终一致的前提下保持读扩展性。
对 AI 集群来说,这种机制极其契合“语料写少读多、Checkpoint/KV 写入后不可变高频并发读”的访问分布:既让数据加载器和推理节点无需处理读到半截脏块的并发边界,又把每一台存储节点上的 NVMe 与网卡带宽全部吃满。
2.3 USRBIO 与 FUSE:绕开内核虚拟文件系统的两条路
POSIX 兼容性与极限吞吐在 Linux 存储栈上历来冲突。3FS 在客户端侧同时保留了两条通道:
- 通用兼容路径(
hf3fs_fuse):通过标准 FUSE 挂载为普通 POSIX 目录,PyTorchDataLoader、Pythonopen()或运维工具无需修改代码即可访问;但每次 I/O 都要穿过 VFS → 内核 FUSE 模块 → 用户态 FUSE 守护进程,伴随着上下文切换与内存拷贝税。 - 高性能零拷贝路径(
USRBIO,User-Space Ring-Based I/O):针对大模型数据预处理(如 Smallpond)与分布式 KVCache 这类延迟/带宽极端敏感的负载,3FS 提供了原生异步环形队列 API。应用进程与本地 3FS 客户端服务之间通过两类共享内存文件通信——Ior(I/O Ring,仅存放读写描述符的小型无锁环形队列) 与Iov(I/O Vector,映射实际载荷数据的共享内存缓冲区)。应用把批量读请求压入Ior,后台引擎通过 RDMA 直接把远程 NVMe 块拉进Iov,全程避开内核 VFS 路径与 FUSE 上下文切换。
根据 deepseek-ai/3FS 官方
README.md
公开的基准测试记录(注意其明确声明集群规模、网卡配置与后台干扰条件,不可直接外推为任意硬件上的绝对值):
- 聚合读吞吐峰值:在一个包含 180 个存储节点(每节点配置 \(2 \times 200\text{ Gbps}\) InfiniBand 网卡与 \(16 \times 14\text{ TiB}\) NVMe SSD)和 500+ 计算节点的集群上,在同时存在实际训练作业后台流量的条件下,3FS 测得约 \(6.6\text{ TiB/s}\) 的聚合读吞吐;
- KVCache 推理读场景:针对推理前缀 KV 缓存读负载,单客户端节点测得最高约 \(40\text{ GiB/s}\) 的峰值读取吞吐,足以逼近单机双 200G / 单 400G IB 链路的线速上限;
- 大规模洗牌排序(Smallpond GraySort):基于 3FS 与 DuckDB 构建的轻量数据引擎 Smallpond 在该底座上支撑了 TB 级语料洗牌,验证了强一致并行盘在数据工程侧的可用性。
2.4 横向对照:3FS vs. Lustre vs. WEKA vs. NVIDIA GPUDirect Storage
在真实机房采购与自建选型中,3FS 经常被拿来与传统 HPC
并行文件系统(Lustre)、商业 NVMe
并行软件栈(WEKA)以及数据直通路径 GPUDirect
Storage(GDS / cuFile)
放在一起比较。注意:GDS 是单机/网络直通 GPU
显存的数据通路规范,而非独立分布式文件系统,它可以运行在本地
NVMe、Lustre 或 WEKA 之上:
| 维度 | DeepSeek 3FS | Lustre(如 FSx / 自建) | WEKA Data Platform | NVIDIA GDS(cuFile) |
|---|---|---|---|---|
| 定位边界 | 开源 AI 原生分布式并行文件系统 | 经典 HPC 开源并行 POSIX 文件系统 | 商业 NVMe-native 软件定义并行存储 | 传输旁路栈:打通存储/NIC 到 GPU HBM 的直接 DMA |
| 元数据架构 | 无状态服务 + FoundationDB 分布式 ACID KV | 专用 MDS + MDT(历史版本偏单主或 DNE 分片扩展) | 分布式全对称元数据与数据分片 | 依赖底层本地 FS(ext4/XFS)或 PFS(Lustre/WEKA) |
| 一致与副本 | CRAQ 链式强一致,任意副本服务 Clean 读 | 分布式锁管理器(LDLM)维护 POSIX 强锁一致 | 分布式纠删码 / 内部事务一致 | 无副本管理;依赖调用方显式同步 |
| 高吞吐路径 | USRBIO(Ior/Iov
共享内存环)+ io_uring |
LNet RDMA + 客户端 POSIX / GDS 支持 | 自研用户态零拷贝客户端 + 原生 GDS 支持 | nvidia-fs.ko 内核驱动 +
cuFileBufRegister /
cuFileRead |
| 主要工程代价 | 需维护 FoundationDB 集群;原生性能依赖接入 USRBIO;截至本文基线生态尚不如 Lustre 通用 | 海量小文件创建与多客户端并发写锁竞争下易卡 MDS;运维调优复杂 | 商业软件授权成本与特定客户端内核依赖 | 仅加速“直读直写 GPU 显存”,受限于 PCIe/BAR 拓扑与显存注册缓冲成本 |
从 cuFile
编程模型看,当训练检查点加载器或推理缓存引擎希望直接把本地
O_DIRECT 文件或远端兼容 PFS 中的 KV 块送入 GPU
HBM 而绕过 CPU Bounce Buffer
时,必须按官方生命周期显式注册文件句柄与设备缓冲区,把页锁定(pinning)开销摊薄到初始化阶段而非每次
I/O:
cuFileDriverOpen()                         # 可选显式初始化 nvidia-fs / cuFile 驱动栈
  -> open(..., O_RDONLY | O_DIRECT)        # 打开绕过内核 Page Cache 的文件描述符
  -> cuFileHandleRegister(&fh, &descr)     # 注册为不透明 CUfileHandle_t 句柄
  -> cuFileBufRegister(d_ptr, size, 0)     # 预先锁定 GPU 显存缓冲,避免单次 I/O 锁页税
  -> cuFileRead(fh, d_ptr, sz, f_off, b_off) # 触发 P2PDMA / RDMA 直写入 GPU BAR 映射区
  -> cuFileBufDeregister / cuFileHandleDeregister / cuFileDriverClose
但若 KV 块本身只先卸载在远端集群的 CPU DRAM 中,GDS 无法直接跨越远端普通 DRAM,此时就需要下一节讨论的分布式 KV 池与跨介质传输引擎接力。
三、五层分布式 KV 缓存池:从 CachedAttention 到 Mooncake
单机推理引擎(如 vLLM
--enable-prefix-caching 或 SGLang 原生
RadixAttention)最先遇到的物理墙是 HBM
容量墙:正如 11
篇 核算的,4 张 80GB H100 跑
Llama-3-70B(TP=4)时,扣除权重与工作区仅余约
\(160\text{ GiB}\) 活跃 KV
空间,只能装下约 \(524\text{K}\)
token;一旦并发会话稍多或进入长多轮 Agent
轨迹,刚算好的系统前缀与历史对话就会在几分钟内被 LRU
驱逐。
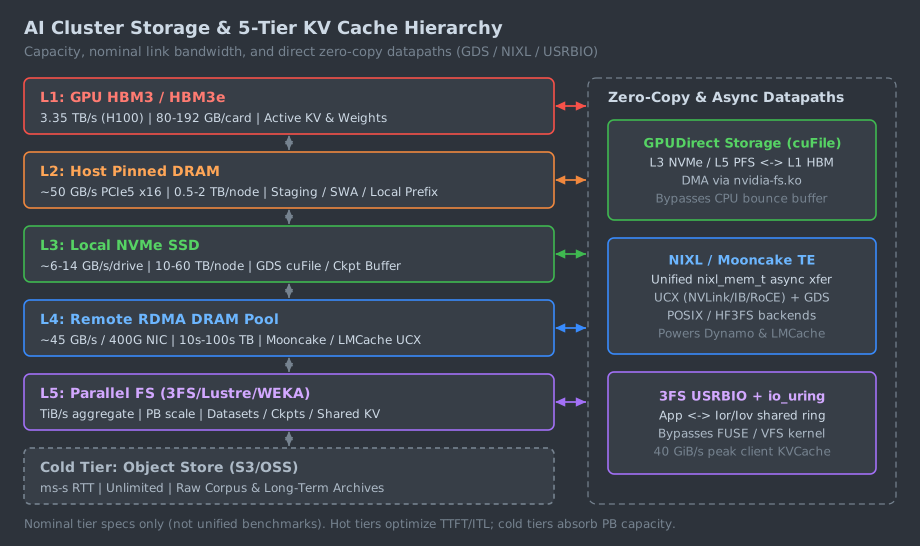
为了不把昂贵的 GPU 算力反复花在重算相同前缀上,生产架构演化出了清晰的五层存储与 KV 缓存层次(对应图 1):
- L1 GPU HBM(\(\sim 3.35\text{ TB/s}\) on H100,\(80\text{–}192\text{ GB/card}\)):存放当前步 Decode/Prefill 活跃工作的 Paged KV blocks。
- L2 本机 Host Pinned DRAM(\(\sim 50\text{ GB/s}\) PCIe 5.0 x16,\(0.5\text{–}2\text{ TB/node}\)):承接从 HBM 换出的温热前缀、DeepSeek SWA 本地滑动窗口状态,以及异步检查点快照缓冲区。
- L3 本机 NVMe SSD(单盘 \(\sim 6\text{–}14\text{
GB/s}\),单机 \(10\text{–}60\text{
TB}\)):通过
cuFileGDS 或io_uring承接本机冷前缀或本地检查点暂存。 - L4 远端 RDMA DRAM 池(单 \(400\text{G}\) NIC \(\sim 45\text{ GB/s}\),集群聚合数十至数百 TB):跨节点共享的分布式内存 KV 池,消除不同推理副本之间的重复 Prefill,是 PD 分离与 KV-aware 路由的共享底盘。
- L5 分布式并行文件系统(3FS / Lustre / WEKA,PB 级)与冷对象存储(S3/OSS):持久化万亿词元高频前缀、长程上下文磁盘缓存(如 DeepSeek API 默认开启的 Context Caching on Disk),以及原始数据集与归档检查点。
围绕如何让数据在这五层之间高速流转而不把调度拖垮,2024–2025 年学界与工业界出现了三个标志性系统:
3.1 CachedAttention(AttentionStore):多轮对话的层级异步预取
多轮对话的天然特征是“一轮计算后进入长达数秒到数十秒的人类阅读/思考间隔”。如果一直把对话 KV 钉在 HBM,显存利用率极低;如果直接丢弃,下一轮发来时又要重算全部历史。
CachedAttention(Gao et al., USENIX ATC 2024) 提出了 AttentionStore 分层存储框架,将冷温会话 KV 卸载到主机 DRAM 与本地磁盘,并用三项机制隐藏慢介质的访问延迟:
- 按层异步预取与流水保存(Layer-wise Pre-loading & Async Saving):在模型执行第 \(l\) 层注意力计算的同一时间窗口内,后台流异步将第 \(l+1\) 层或下一批请求的 KV 从 DRAM/SSD 预加载进 HBM,写盘同样按层异步流水下刷,用计算时间掩盖 PCIe / NVMe 延迟;
- 调度器感知放置与驱逐(Scheduler-Aware Placement & Eviction):打破操作系统黑盒 LRU,直接依据推理引擎的等待队列与预计下一次被调度时间决定哪些会话保留在 DRAM、哪些降级到磁盘;
- 位置编码解耦(Decoupled Positional Encoding):通过保存未绑定绝对位置偏移(pre-RoPE)的 Key 或按需重应用位置旋转,保证当长上下文发生截断或窗口滑动时,历史已缓存的 KV 仍可安全复用而不会因位置索引错位失效。
在论文评测配置下,CachedAttention 将多轮对话 TTFT 最高降低了 \(87\%\),提示词 Prefill 吞吐最高提升 \(7.8\times\);但在生产落地时须注意其关键前提——预取收益要求每层加载带宽能被该层前后向计算时间覆盖,且跨副本共享仍依赖上层一致性会话路由。
3.2 SGLang RadixAttention 与 HiCache
与按离散请求块哈希管理的路线不同,SGLang(Zheng et al., NeurIPS 2024) 在单机调度层引入了 RadixAttention:用一棵基数树(Radix Tree)统一维护所有系统提示词、Few-shot 样例、树状分支推理(Tree-of-Thought)与多轮对话的公共前缀,默认按叶子节点优先的 LRU 策略回收。
随后 SGLang 在工程上将其扩展为
HiCache(Hierarchical Cache,通过
--enable-hierarchical-cache 启用):以
GPU HBM 作为 L1、主机固定内存(--hicache-ratio
控制容量倍数)作为 L2、远端存储后端(Mooncake、3FS 或
NIXL)作为
L3,把单机基数树的树形前缀匹配能力延展至分布式外存,并开放了
--radix-eviction-policy(lru、lfu、slru、priority
等)以应对不同多租户与 Agent 访问分布。
3.3 Mooncake:以 KVCache 为中心的 PD 分离与全局池化
月之暗面与清华大学在 USENIX FAST 2025(获得 Erik Riedel Best Paper Award) 发表的 Mooncake(Trading More Storage for Less Computation),把这一思想从“单节点向内存/磁盘溢出”彻底推向了集群全局重构。
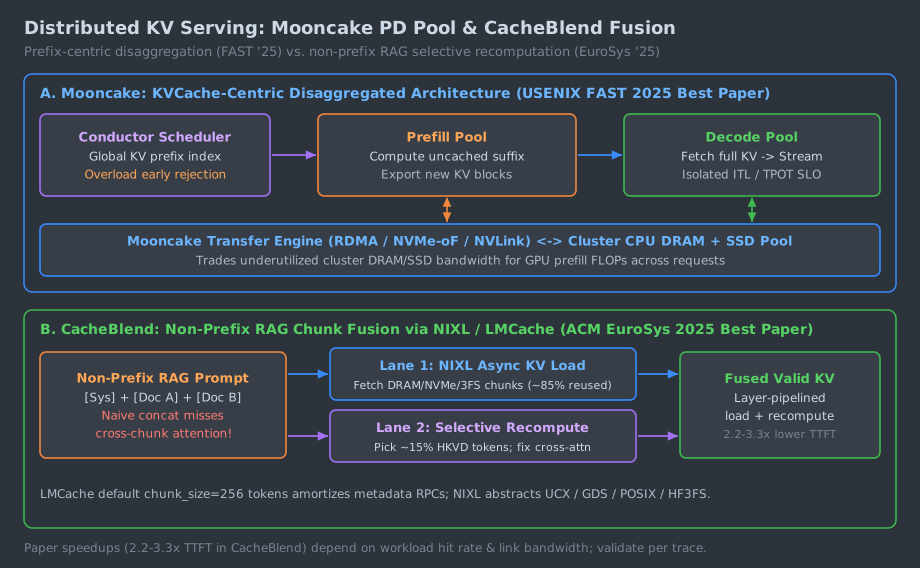
在支撑 Kimi 线上服务的架构里,Mooncake 观察到一个基础设施级浪费:GPU 服务器上往往配足了数百 GB 甚至上 TB 的 CPU DRAM、多块 NVMe SSD 与多张 RDMA 网卡,但在传统仅用 GPU 跑推理的集群里,这些主机 DRAM 与存储带宽大部分时间处于闲置状态。Mooncake 因此提出 KVCache-centric 架构(见图 3 上半部分):
- 全局集群 KV 池 + Transfer Engine:把所有节点的空闲 CPU DRAM 与 SSD 通过自研零拷贝 Transfer Engine(支持 RDMA、TCP、NVMe-oF 与 NVLink)串成一张统一的分布式内存/存储缓存网;
- Conductor 全局调度器:调度决策不再只看“哪个 Prefill 实例算力空闲”,而是以“请求前缀 KV 落在哪个节点 + 预测目标 Decode 池排队是否超时”为第一约束;
- 过载早期拒绝(Early Rejection):当突发长上下文流量冲击使得预测端到端生成间隔(TBT / ITL)必然违背 SLO 时,Conductor 直接在 Prefill 阶段之前早早拒绝低优先级或超预算请求,防止把昂贵的 Prefill GPU 算力白白烧在最终会超时丢弃的请求上。
这一设计确立了 2025 年之后大型推理集群的主流共识:在计算受限与长上下文负载下,把集群闲置 DRAM / SSD / RDMA 带宽交易为 GPU Prefill FLOPs,是最直接的系统级降本杠杆。
但 Mooncake 的工程演进也揭示了一个现实痛点:早期把全局 KV 元数据完全放在单个内存态 Conductor 中虽然路由快,但一旦 Conductor 发生进程重启或滚动升级,集群内既有的缓存可见性会瞬间归零(cache wipe),必须在重启后依靠全集群节点心跳重新上报目录,或为关键前缀元数据引入持久化重建路径。
相比之下,SGLang HiCache 在单机部署场景下无需部署独立全球调度进程,只需在启动引擎时打开层级开关与驱逐策略即可把本机主机内存和远端缓存后端挂进基数树管理:
python3 -m sglang.launch_server \
  --model-path Qwen/Qwen3-32B \
  --enable-hierarchical-cache \
  --hicache-ratio 2.0 \
  --radix-eviction-policy lfu
四、非前缀融合与跨引擎传输:LMCache、CacheBlend 与 NVIDIA NIXL
4.1 从“严格前缀匹配”到“非前缀 RAG 块融合”
无论是 vLLM APC、SGLang RadixAttention 还是 Mooncake,传统 KV 复用都有一条铁律:必须从第 0 个 token 开始逐位完全匹配(Exact Prefix Match)。然而在企业 RAG、多文档对比与动态工具注入场景中,同一个知识库文档片段(Chunk)经常在一次请求里排在第 1 位,在下一次请求里因为重排得分变化排到了第 3 位:
Request 1: [System Prompt] + [Doc A] + [Doc B] + [Query 1]
Request 2: [System Prompt] + [Doc C] + [Doc A] + [Query 2]
在标准自回归因果注意力下,Request 2 里的
[Doc A] 位于 [Doc C]
之后,它的原始 K/V 缓存(当初按紧跟在 System Prompt
后算出,或离线独立预先算好)完全缺乏对 [Doc C]
的交叉注意力依赖(cross-attention
mismatch)。如果硬把两段各自算好的 KV 直接拼在一起给 Decode
用,模型输出质量会断崖式下跌;如果全部回退重算,RAG
缓存命中率几乎归零。
CacheBlend(Yao et al., ACM EuroSys 2025 Best Paper Award) 给出了打破前缀枷锁的关键算法:
- 在每段文档 chunk 离线或首次前向时保存其独立 KV;
- 拼装新 RAG 请求时,CacheBlend 从第一个 Transformer 层起先比对少量 token 的 KV 偏差,筛选出受前序上下文影响最大的 High-KV-Deviation(HKVD)token(论文实验显示仅需约 \(15\%\) 的 token 比例);
- 对这 \(\sim 15\%\) 的高偏差 token 在线重新计算并融合更新其跨块注意力状态,其余约 \(85\%\) 的 token 直接复用从缓存拉回的预计算 KV,且将“加载剩余 KV 块”与“前几层局部重算”按层流水线重叠执行(见图 3 下半部分)。
在论文评测集与模型规模下,CacheBlend 相比全量重算将 TTFT
降低了 \(2.2\times\text{–}3.3\times\),吞吐提升
\(2.8\times\text{–}5\times\)
且几乎不损伤生成质量。它的开源工程载体是
LMCache(LMCache/LMCache,Cheng et al.,
arXiv:2510.09665,arXiv
预印本,未经同行评审)——一个已深度接入 vLLM
V1(通过 LMCacheConnectorV1,见 21 篇
§13.3)与 SGLang 的模块化企业级 KV
缓存层。在工程实现上,LMCache 刻意采用比单卡
PagedAttention 页(如 16/32 tokens)更大的传输分块,默认
chunk_size: 256
tokens,以此摊薄存储后端与远端查找的 RPC
元数据税;其同源前作 CacheGen(Liu et al., ACM
SIGCOMM 2024)
则针对跨广域或受限带宽链路进一步提供分布感知的 KV
压缩流式传输(压缩率约 \(3.5\times\text{–}4.3\times\),但引入编码/解码计算开销,适合网络远慢于本地内存的场景)。
4.2 NVIDIA NIXL:异构内存与存储的统一异步传输抽象
当集群里同时存在 vLLM、SGLang、TensorRT-LLM、LMCache 与
NVIDIA Dynamo 时,每个团队自己维护一套 RDMA Verbs、NVLink
IPC 和 GDS 胶水代码很快变成维护噩梦。NVIDIA
NIXL(NVIDIA Inference Transfer
Library,ai-dynamo/nixl)
正是为了把“分布式 KV 与张量点对点搬运”标准化为一个类似
MPI/NCCL 之于集合通信的通用传输层。
从代码抽象看,NIXL 的核心设计只有三层:
- 进程级统一代理(
nixlAgent)与抽象内存段(nixl_mem_t):推理进程或存储服务实例化一个nixlAgent,将本地 GPU VRAM、Host DRAM、本地文件描述符或对象/分布式存储句柄统一注册为描述符段(memory sections),对外暴露异步非阻塞的点对点传输请求句柄; - 运行时动态插件后端:NIXL
在运行时按源/目的介质类型与硬件链路自动路由到底层插件:
UCX:承载跨机 InfiniBand、RoCE、AWS EFA 与机内 NVLink 的零拷贝 GPU-to-GPU / CPU-to-GPU 点对点传输;GDS/GDS_MT:调用 NVIDIA Magnum IOcuFile(含多线程优化路径),打通本地 NVMe 或兼容 PFS 到 GPU VRAM 的直接 DMA;POSIX/io_uring:标准异步文件与主机内存 I/O;HF3FS:直接对接 DeepSeek 3FS 等高性能分布式文件系统的专用客户端集成;
- 跨层生态复用:NVIDIA Dynamo 用 NIXL
承载跨池 PD 分离 KV 直传;LMCache 则通过
nixl_backend配置(如POSIX、GDS、GDS_MT、HF3FS)把多级卸载与点对点 P2P 传输统一委托给 NIXL 执行。
以 LMCache 通过 NIXL 对接分布式文件目录(或切换为
GDS /
HF3FS)为例,核心配置字段集中在分块粒度
chunk_size 与 extra_config
下的驱动开关:
chunk_size: 256
nixl_buffer_size: 1073741824   # 1 GiB staging buffer for NIXL transfers
nixl_buffer_device: cpu        # cpu or cuda depending on GDS vs DRAM staging

extra_config:
  enable_nixl_storage: true
  nixl_backend: HF3FS          # Options: POSIX | GDS | GDS_MT | HF3FS
  nixl_file_pool_size: 64
nixl_path: /mnt/3fs/kv_cache/需要明确边界:NIXL 解决的是“怎么用最低
CPU/内存拷贝把张量从 A 介质搬到 B
介质”,它本身不负责前缀索引树、多租户配额或一致性哈希路由——控制面决策仍然归
Conductor、EPP/llm-d 或 LMCache 控制器管。
五、传输还是重算:解析盈亏模型与 Python 计算器
分布式 KV 缓存工程师最常犯的直觉错误是:“只要命中缓存,就一定比重新算快。”如果忽略模型激活参数量、注意力二次项与链路延迟/带宽,把 70B 模型的 KV 放到一条拥挤的 25GbE NAS 上加载,线上 P99 TTFT 反而会暴涨。
下面建立一个透明的 Analytical Model(解析模型,非实测 benchmark),把问题简化成可核对的封闭形式不等式:
\[ T_{\text{transfer}}(L) < T_{\text{prefill}}(L) \]
5.1 推导封闭形式盈亏公式
设一段被命中的历史上下文长度为 \(L\)(token 数),单 token 在目标格式下的 KV 字节数为 \(b_{\text{tok}}\)(Bytes/tok),存储或网络链路 \(k\) 的有效单流持续带宽为 \(B_k\)(B/s)、固定首字节建立/RPC/元数据开销为 \(t_{0,k}\)(s),则加载整段 KV 的解析时间为:
\[ T_{\text{transfer},k}(L) = t_{0,k} + \frac{L \cdot b_{\text{tok}}}{B_k} \]
而在 Prefill 端,一次长度为 \(L\) 的前向包含两部分主算力开销——与 \(L\) 成正比的线性投影与 FFN/MoE 激活矩阵乘(单 token 计 \(F_{\text{lin}} \approx 2 P_{\text{active}}\) FLOPs,在 FP8 GEMM 持续算力 \(P_{\text{fp8}}\) 下执行),以及与 \(L^2\) 成正比的因果自注意力(总计 \(C_{\text{attn}} \cdot L^2\) FLOPs,在 BF16 注意力持续算力 \(P_{\text{bf16}}\) 下执行):
\[ T_{\text{prefill}}(L) = \frac{F_{\text{lin}} \cdot L}{P_{\text{fp8}}} + \frac{C_{\text{attn}} \cdot L^2}{P_{\text{bf16}}} \]
对照 11 篇 §4.1–4.3 已对齐的物理字节口径,考察两个典型代表模型(均按 H100 SXM5 厂商稠密峰值 \(1{,}979\text{ TFLOP/s}\) FP8、\(989\text{ TFLOP/s}\) BF16,取保守 \(50\%\) 稳态计算利用率 MFU,且 KV 以常见 FP16/BF16 精度存放):
- Llama-3-70B(GQA-8,80 层,\(H_{\text{kv}}=8,
d_h=128\)),部署在
4×H100 SXM5 (TP=4)上:- 单 token KV 体积:\(b_{\text{tok}}^{\text{70B}} = 80 \times 2 \times 8 \times 128 \times 2\text{ B} = 327{,}680\text{ B} = \mathbf{320.0\text{ KiB/tok}}\);
- 算力项:\(F_{\text{lin}} \approx 140\text{ GFLOP/tok}\),\(C_{\text{attn}} = 2 \times 80 \times 8192 = 1{,}310{,}720\text{ FLOP/tok}^2\);系统持续算力 \(P_{\text{fp8}} = 3{,}958\text{ TFLOP/s}\)、\(P_{\text{bf16}} = 1{,}978\text{ TFLOP/s}\)。
- DeepSeek-V3 / R1(MLA,61 层,\(d_c=512, d_R^k=64\),37B
激活参数),部署在
8×H100 SXM5 (DP/EP=8)上:- 单 token KV 体积:\(b_{\text{tok}}^{\text{MLA}} = 61 \times (512 + 64) \times 2\text{ B} = 70{,}272\text{ B} \approx \mathbf{68.6\text{ KiB/tok}}\)(比 70B GQA-8 缩小 \(4.66\times\));
- 算力项:\(F_{\text{lin}} \approx 74\text{ GFLOP/tok}\);非吸收路径 Prefill 注意力(\(H_q=128, d_k=192, d_v=128\))给出 \(C_{\text{attn}} = 61 \times (192 + 128) \times 128 = 2{,}498{,}560\text{ FLOP/tok}^2\);系统持续算力(8 卡)为 \(P_{\text{fp8}} = 7{,}916\text{ TFLOP/s}\)、\(P_{\text{bf16}} = 3{,}956\text{ TFLOP/s}\)。
从斜率上就能一眼看出关键门槛:若希望在短上下文线性区(忽略
\(L^2\) 项与 \(t_0\))就让传输跑赢重算,链路有效带宽必须高于线性临界带宽
\(B_{\text{crit}} = b_{\text{tok}}
\cdot P_{\text{fp8}} / F_{\text{lin}}\)——对
4×H100 跑 70B 而言约为 \(9.26\text{ GB/s}\);对
8×H100 跑 DeepSeek-V3 而言约为 \(7.52\text{
GB/s}\)。当链路带宽低于这一斜率时,只有当长度 \(L\) 增长到二次注意力项压垮 GPU
时,传输才会重新追上并反超。
5.2 可复现 Python 计算器与实跑结果
下面这份纯标准库 Python 脚本(Python 3.10+
无第三方依赖)编码了上述解析模型;文中图 4
与下表所有数字均由同一组参数在本地 python3
实跑得出(如调整集群 MFU、开启 FP8 KV
量化或改变单节点网卡分享比例,只需修改对应常量即可重算):
from dataclasses import dataclass


@dataclass(frozen=True)
class ModelProfile:
    name: str
    kv_bytes_per_tok: int
    linear_flops_per_tok: float
    attn_flops_coeff: float
    fp8_tflops_sys: float
    bf16_tflops_sys: float

    def t_prefill_ms(self, seq_len: int) -> float:
        t_lin = (self.linear_flops_per_tok * seq_len) / (self.fp8_tflops_sys * 1e12)
        t_att = (self.attn_flops_coeff * (seq_len ** 2)) / (self.bf16_tflops_sys * 1e12)
        return (t_lin + t_att) * 1e3

    def t_transfer_ms(self, seq_len: int, bw_gb_s: float, t0_ms: float) -> float:
        return t0_ms + (self.kv_bytes_per_tok * seq_len / (bw_gb_s * 1e9)) * 1e3

    def breakeven_len(self, bw_gb_s: float, t0_ms: float, max_l: int = 500_000) -> int | None:
        for seq_len in range(1, max_l + 1):
            if self.t_transfer_ms(seq_len, bw_gb_s, t0_ms) < self.t_prefill_ms(seq_len):
                return seq_len
        return None


llama_70b = ModelProfile(
    name="Llama-3-70B (GQA-8, 4xH100 TP=4)",
    kv_bytes_per_tok=80 * 2 * 8 * 128 * 2,
    linear_flops_per_tok=2 * 70e9,
    attn_flops_coeff=2 * 80 * 8192,
    fp8_tflops_sys=4 * 1979.0 * 0.50,
    bf16_tflops_sys=4 * 989.0 * 0.50,
)
deepseek_mla = ModelProfile(
    name="DeepSeek-V3/R1 (MLA, 8xH100 DP/EP=8)",
    kv_bytes_per_tok=61 * (512 + 64) * 2,
    linear_flops_per_tok=2 * 37e9,
    attn_flops_coeff=61 * (192 + 128) * 128,
    fp8_tflops_sys=8 * 1979.0 * 0.50,
    bf16_tflops_sys=8 * 989.0 * 0.50,
)

tiers = [
    ("400G RDMA Pool", 45.0, 0.15),
    ("3FS / 200G Shared", 15.0, 0.50),
    ("Local NVMe 1xSSD", 6.0, 0.40),
    ("25GbE NAS / Obj", 2.5, 2.00),
]

for m in (llama_70b, deepseek_mla):
    cap_1tib = (1024 ** 4) // m.kv_bytes_per_tok
    print(f"=== {m.name} | {m.kv_bytes_per_tok:,} B/tok ({m.kv_bytes_per_tok / 1024:.1f} KiB/tok) | {cap_1tib:,} tok/TiB ===")
    for tname, bw, t0 in tiers:
        be = m.breakeven_len(bw, t0)
        print(f"  [{tname:18s} @ {bw:>4.1f} GB/s, t0={t0:.2f}ms] L* = {be} tok")
    for seq_len in (4096, 32768, 131072):
        tp = m.t_prefill_ms(seq_len)
        row = ", ".join(f"{n.split()[0]}={m.t_transfer_ms(seq_len, bw, t0):.1f}ms" for n, bw, t0 in tiers)
        print(f"  L={seq_len:>6d}: T_prefill={tp:>8.1f}ms | {row}")
在本地 python3
实际执行上述脚本得到的完整输出如下:
=== Llama-3-70B (GQA-8, 4xH100 TP=4) | 327,680 B/tok (320.0 KiB/tok) | 3,355,443 tok/TiB ===
  [400G RDMA Pool     @ 45.0 GB/s, t0=0.15ms] L* = 6 tok
  [3FS / 200G Shared  @ 15.0 GB/s, t0=0.50ms] L* = 37 tok
  [Local NVMe 1xSSD   @  6.0 GB/s, t0=0.40ms] L* = 29059 tok
  [25GbE NAS / Obj    @  2.5 GB/s, t0=2.00ms] L* = 144443 tok
  L=  4096: T_prefill=   156.0ms | 400G=30.0ms, 3FS=90.0ms, Local=224.1ms, 25GbE=538.9ms
  L= 32768: T_prefill=  1870.6ms | 400G=238.8ms, 3FS=716.3ms, Local=1790.0ms, 25GbE=4297.0ms
  L=131072: T_prefill= 16020.4ms | 400G=954.6ms, 3FS=2863.8ms, Local=7158.7ms, 25GbE=17181.9ms
=== DeepSeek-V3/R1 (MLA, 8xH100 DP/EP=8) | 70,272 B/tok (68.6 KiB/tok) | 15,646,511 tok/TiB ===
  [400G RDMA Pool     @ 45.0 GB/s, t0=0.15ms] L* = 20 tok
  [3FS / 200G Shared  @ 15.0 GB/s, t0=0.50ms] L* = 106 tok
  [Local NVMe 1xSSD   @  6.0 GB/s, t0=0.40ms] L* = 3905 tok
  [25GbE NAS / Obj    @  2.5 GB/s, t0=2.00ms] L* = 29811 tok
  L=  4096: T_prefill=    48.9ms | 400G=6.5ms, 3FS=19.7ms, Local=48.4ms, 25GbE=117.1ms
  L= 32768: T_prefill=   984.5ms | 400G=51.3ms, 3FS=154.0ms, Local=384.2ms, 25GbE=923.1ms
L=131072: T_prefill= 12075.9ms | 400G=204.8ms, 3FS=614.5ms, Local=1535.5ms, 25GbE=3686.3ms下表汇总同一组解析模型输出(Analytical Model,非实测基准;均假定 H100 SXM5 \(50\%\) 稳态 MFU、FP16/BF16 KV 精度):
| 介质与链路(有效带宽 \(B_k\),首包 \(t_{0,k}\)) | 70B GQA-8 盈亏 \(L^*\) | 70B @ \(32\text{K}\)(重算 \(1870.6\text{ ms}\)) | DeepSeek MLA 盈亏 \(L^*\) | MLA @ \(32\text{K}\)(重算 \(984.5\text{ ms}\)) |
|---|---|---|---|---|
| 400G RDMA DRAM 池(\(45.0\text{ GB/s}\),\(0.15\text{ ms}\)) | \(6\text{ tok}\) | \(238.8\text{ ms}\)(\(7.8\times\) 更快) | \(20\text{ tok}\) | \(51.3\text{ ms}\)(\(19.2\times\) 更快) |
| 3FS / 200G 共享客户端(\(15.0\text{ GB/s}\),\(0.50\text{ ms}\)) | \(37\text{ tok}\) | \(716.3\text{ ms}\)(\(2.6\times\) 更快) | \(106\text{ tok}\) | \(154.0\text{ ms}\)(\(6.4\times\) 更快) |
| 本地 NVMe 单盘(\(6.0\text{ GB/s}\),\(0.40\text{ ms}\)) | \(29{,}059\text{ tok}\) | \(1{,}790.0\text{ ms}\)(刚过临界) | \(3{,}905\text{ tok}\) | \(384.2\text{ ms}\)(\(2.6\times\) 更快) |
| 25GbE NAS / 对象网关(\(2.5\text{ GB/s}\),\(2.00\text{ ms}\)) | \(144{,}443\text{ tok}\) | \(4{,}297.0\text{ ms}\)(慢于重算) | \(29{,}811\text{ tok}\) | \(923.1\text{ ms}\)(刚好持平) |
5.3 为什么 MLA 让 RDMA 与 NVMe 卸载在经济上真正成立
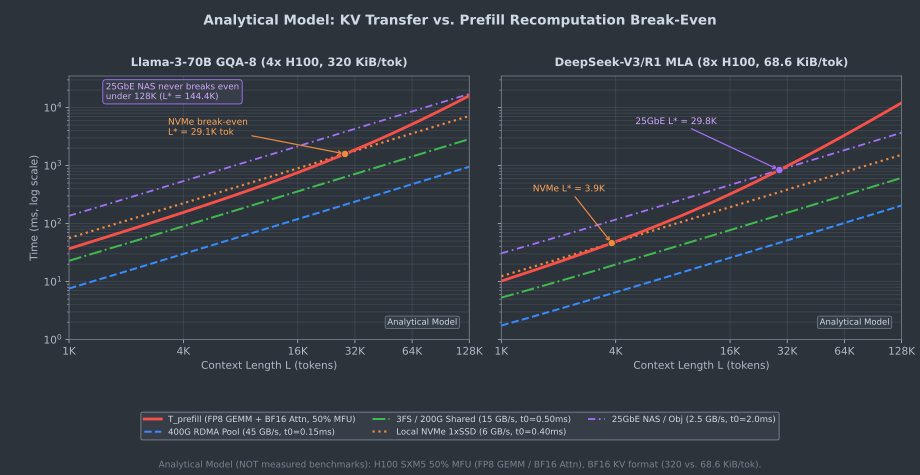
对照计算器输出与图 4,可以得出三条对集群采购极其扎实的结论:
- 同样 \(1\text{
TiB}\) 集群缓存池容量相差 \(4.66\times\):70B
GQA-8 每 TiB 只能驻留约 \(3.36\text{M}\)
token;换成 MLA(
68.6 KiB/tok)后直接跃升至 \(15.65\text{M}\) token。如果按 27 篇 §9.1 的混合精度(非 RoPE 维转 FP8、RoPE 维保留 BF16)或纯 FP8 落盘,单 token 体积还能再压低近半。 - 盘阵与网络盈亏门槛骤降:注意本模型给 DeepSeek-V3 配了 2 倍于 70B 的 GPU 算力(8 卡 vs 4 卡),这原本会让重算更具优势;即便如此,MLA 压缩出的极小传输载荷依然把单块 \(6\text{ GB/s}\) 本地 NVMe 的盈亏点从 \(29{,}059\text{ tok}\)(对 70B 而言 4K/8K 读取比直接重算更慢)拉低到 \(3{,}905\text{ tok}\)(\(4\text{K}\) 上下文加载 \(48.4\text{ ms}\) 已跑赢重算 \(48.9\text{ ms}\))。甚至在受限的 \(2.5\text{ GB/s}\)(25GbE NAS) 上,70B 在整个 128K 范围都不划算(需等到 \(144{,}443\text{ tok}\)),而 MLA 在 \(29{,}811\text{ tok}\) 处便实现盈利。
- RDMA / 3FS 是 4K–128K
全区间碾压项,但前提是避开块对齐碎片:在 \(15\text{–}45\text{ GB/s}\) 级
RDMA/3FS 通路上,虽然模型给出的理想 \(L^*\) 仅在几十至百余
token,实际生产受限于分块粒度(如 LMCache 默认
256token 块)与索引查询往返,通常在 512–1,024 token 以上才稳定合算;但一旦进入 32K–128K 区间,3FS 共享链路(\(154.0\text{ ms}\) / \(614.5\text{ ms}\))对比重算(\(984.5\text{ ms}\) / \(12{,}075.9\text{ ms}\))可压缩 \(6.4\times\) 至 \(19.7\times\) 的 TTFT 等待时间。
六、生产排雷与多租户 KV 安全边界
把分布式 KV 缓存池从测试脚本搬进线上多租户集群,真正引发故障或安全事件的往往不是带宽不够,而是五个典型系统边界:
6.1
多租户旁路泄露与 cache_salt 隔离
只要不同租户的请求共享同一个 Prefix Cache 或分布式 KV
池,就会立即打开时序旁路攻击(Timing
Side-Channel)的大门。PROMPTPEEK(Wu et
al., NDSS 2025) 与 InputSnatch(Zheng et
al., arXiv:2411.18191,arXiv
预印本,未经同行评审) 等研究已明确证实(对应如
vLLM 自动前缀缓存曾披露的风险条目
CVE-2025-46570):攻击者只需批量发送猜测前缀,通过测量服务器返回的
TTFT 差异(缓存命中毫秒级返回 vs 未命中全量重算),就能逐
token 探测并重构同池其他租户的系统提示词、商业知识库片段乃至
PII 输入。
vLLM 生态针对该问题的标准缓解手段是
cache_salt 参数:由可信 API
网关根据租户身份(tenant_id /
org_id)向推理请求注入不可预测且长度受限的
cache_salt
字符串,引擎将该盐值混入前缀哈希链第一个根 block
的密码学哈希输入中。由于哈希链逐块向下传递,不同盐值的请求哪怕文本前缀逐字相同,计算出的块键也完全正交,彻底阻断跨租户命中与时序探测:
flowchart LR
    ReqA["Tenant A Request + Same System Prompt"] --> GateA["API Gateway: Inject salt_a"]
    ReqB["Tenant B Probe + Same System Prompt"] --> GateB["API Gateway: Inject salt_b"]
    GateA --> HashA["Root Block Hash(salt_a, tokens_0..15)"]
    GateB --> HashB["Root Block Hash(salt_b, tokens_0..15)"]
    HashA --> SlotA["KV Pool Namespace A (Hit Allowed)"]
    HashB --> SlotB["KV Pool Namespace B (Isolated Miss)"]
但在网关与基础设施落地时必须守住两条补充底线:
- 禁止信任客户端透传原始
cache_salt:必须在网关剥离外部传入的同名字段并由服务端重新注入,同时限制长度——社区安全通报已指出,向引擎直接投喂数 MB 超大cache_salt字符串会阻塞单线程EngineCore调度循环,形成拒绝服务(DoS)向量; cache_salt不是完整的多租户内存沙箱:它只隔离逻辑块哈希,不隔离 GPU 物理显存页访问边界、进程地址空间或共享 Ray 集群信道。强合规与高安全等级的不可信多租户依然应当走独立推理实例或硬件级隔离(MIG / 独立 VPC 节点池)。
网关向内部推理引擎转发请求时的受控注入格式示例:
{
  "model": "deepseek-ai/DeepSeek-V3",
  "messages": [
    {"role": "system", "content": "Enterprise policy corpus..."},
    {"role": "user", "content": "Summarize clause 4.2"}
  ],
  "cache_salt": "tenant-a91f-hmac-v1-84c2e1"
}
6.2 小块元数据风暴
如果直接按 PagedAttention 内部 \(16\text{ token}\)
一页的粒度往远端内存池或 3FS 落盘,以 DeepSeek MLA
为例,单块仅 \(16 \times
68.6\text{ KiB} \approx 1.07\text{
MiB}\)(若按层分片则仅十余 KiB)。一次 \(32\text{K}\)
上下文请求会炸出数千次独立元数据写/查请求。生产实践务必把引擎内计算分页粒度(16–64
tok)与跨节点/落盘存储粒度(256–1,024
tok)解耦——LMCache 默认将 chunk_size
设为 256 tokens,3FS 配合
USRBIO Ior
批量环形提交合并大量随机块描述,正是为了防止 MDS
锁或 RDMA WQ 被碎块请求打爆。
6.3 前缀树感知驱逐 vs. 朴素 LRU
在基于页哈希表的传统池中启用朴素全局页级
LRU,会出现极致命的“误杀公共根前缀”现象:一旦某段共享前缀的中段块因某次扫描被错位挤出,后续所有依附该根节点的长尾部叶子块虽然还在缓存里,却因为前缀断链而全部变成无法匹配的死数据。因此现代分层
KV 池(SGLang RadixAttention /
HiCache、Mooncake)普遍采用前缀树感知的叶子优先驱逐(Leaf-First
Eviction):只允许驱逐当前没有活跃子节点且未被引用的叶子段,并结合
--radix-eviction-policy
引入访问频次(LFU)或租户 SLA 优先级权重。
6.4 Fail-Slow NVMe 尾延迟反噬
Gunawi 等人在 USENIX FAST 2018 发表的 Fail-Slow at Scale 系统统计了大规模生产系统中硬盘、SSD 与网卡的“亚健康降速故障”:设备没有彻底离线报错(fail-stop),而是因为 NAND GC 阻塞、PCIe 链路降速或过热降频跌入平时带宽的几分之一甚至几十分之一。在 CRAQ 链式写入或同步 KV 读取路径上,哪怕 180 台存储节点中只有 1 块 NVMe 发生数秒级读写毛刺,就会卡住整条请求的 TTFT。生产部署必须在客户端引入两项保险:
- 读超时自动熔断回退重算(Timeout-to-Recompute Fallback):根据第 5 节盈亏模型为每层介质设定硬超时(例如拉取 \(32\text{K}\) KV 超过对应模型重算时间 \(50\%\) 即中断读取,直接退回 GPU Prefill 算力兜底),并在观测面板持续追踪读超时回退次数与端到端命中净加速比;
- 后台健康巡检与对冲读(Hedged Reads):针对 3FS CRAQ 多副本读路径,长尾迟迟未回包时向另一健康副本发对冲读,同时结合盘级 SMART 磨损、NVMe 队列深度与读延迟 \(P_{99}\) 监控主动隔离降速盘。
6.5 存储面与计算面 RDMA 隔离
如 04:互联与网络
与 31:机房脏活
所述,训练的 AllReduce / All-to-All 与推理的 Wide-EP
通信极度敏感于微秒级尾延迟抖动;而 Checkpoint 脉冲写入和 3FS
聚合读取则是典型的“大象流(elephant flows)”。如果把 3FS /
Mooncake KV 流量与 NCCL / DeepEP 流量混在同一张物理 RoCE
网卡且共用同一 PFC 优先级队列(TC),一次大规模 Checkpoint
刷盘激发的 Pause 帧反压就会把整个 GPU 计算平面的 step time
拉崩。生产集群必须采用物理双网隔离(独立存储 NIC /
交换平面)或至少通过 Multus CNI + 独立 RDMA
HCA / 严格划分 PFC 队列与 ECN
阈值,将计算面流量与存储/KV
搬运流量隔离在互不反压的通道上,并同步采集网卡
rx_pause / tx_pause 帧计数与 ECN
标记率作为隔离验收指标。
七、学术谱系、路线争论与开放问题
7.1 学术谱系:一条跨越十六年的系统演进线
AI 存储与分布式 KV 缓存并不是凭空冒出的新概念,而是分布式强一致存储与操作系统页缓存思想在大模型负载下的交汇:
- 强一致扩展源头:CR(van
Renesse & Schneider, OSDI
2004)定义链式复制线性一致性边界 →
CRAQ(Terrace & Freedman,
USENIX ATC 2009)通过 Clean/Dirty
多版本解锁全副本读扩展 → DeepSeek 3FS 将
CRAQ 与 FoundationDB、
io_uring、USRBIO 组装为 AI 专用并行文件系统。 - 层级与跨请求 KV 缓存源头:vLLM PagedAttention(Kwon et al., SOSP 2023)解决单机显存碎片 → CachedAttention(Gao et al., USENIX ATC 2024)与 SGLang RadixAttention(Zheng et al., NeurIPS 2024)分别打通跨多轮层级异步卸载与前缀树复用 → CacheGen(Liu et al., ACM SIGCOMM 2024)探索 KV 压缩流式传输 → Mooncake(Qin et al., USENIX FAST 2025 Best Paper)把全集群空闲 DRAM/SSD/RDMA 整合为 KVCache 为中心的 PD 分离架构 → CacheBlend(Yao et al., ACM EuroSys 2025 Best Paper)突破前缀匹配限制实现非前缀 RAG 选择性部分重算。
7.2 主流系统横向对照与三条核心争论
| 系统 / 论文 | 出处与年份 | 核心优化对象 | 依赖假设 | 已知边界与局限 |
|---|---|---|---|---|
| CRAQ / 3FS | ATC 2009 / 开源 2025 | 高并发强一致文件与块级聚合吞吐 | RDMA 网络 + 密集本地 NVMe + FoundationDB | 原生性能依赖绕过 FUSE 改写 USRBIO;不内置推理前缀树语义 |
| CachedAttention | USENIX ATC 2024 | 多轮对话 CPU/磁盘分层卸载与预取 | 层计算可覆盖卸载传输时间 + 会话亲和 | 主要围绕多轮前缀场景,非跨租户随机组合块 |
| Mooncake | USENIX FAST 2025 | 集群级 KVCache 池化与 PD 调度 Goodput | 大规模 RDMA + 充裕闲置主机 DRAM/SSD | 全局 Conductor 状态维护与滚动升级容错复杂度高;依赖准确过载预测 |
| CacheBlend | ACM EuroSys 2025 | 非前缀 RAG 块跨上下文注意力融合 | 高偏差 token 集中在少数位置(\(\sim 15\%\)) | 极端长距离强全局耦合问答下,固定低重算比可能引发精度退化 |
| LMCache + NIXL | arXiv 2025(未经评审)/ 开源 | 跨引擎 KV 分层插件化与零拷贝异步传输 | 统一块大小(256)与匹配后端驱动(UCX/GDS/3FS) |
跨异构引擎/异构量化格式的 KV 张量布局仍缺乏通用互通 |
围绕这几类系统,当前工程与学术界存在三条尚未闭合的路线争论:
- 争论一:严格前缀匹配(vLLM APC / SGLang Radix / 3FS Disk) vs. 选择性重算融合(CacheBlend)。前者在系统提示词、多轮对话与代码库后缀追加上拥有零精度损失的确定性保证,极易对外给出 API 级计费承诺(如 DeepSeek 磁盘缓存命中降价至 \(1/30\text{–}1/50\));后者在多文档顺序打乱的 RAG 负载下极大拉高了缓存可命中率,但因为改变了内部注意力计算图,在大模型微调与复杂多跳推理上的精度边界仍需按业务评测验证。
- 争论二:本地 NVMe 缓冲层(CachedAttention / LMCache Local Disk) vs. 池化远端 RDMA DRAM(Mooncake Store)。当节点配备 PCIe 5.0 NVMe 阵列且集群缺乏高规格 RDMA 网络时,本地盘零网络开销、物理隔离性好,还能避免跨机网络拥塞;但本地盘把缓存局限在单节点作用域内,一旦负载均衡把请求打到另一台机器即退化为冷未命中。对于具备 200G/400G RDMA 与几十台规模的集群,远端 DRAM 池的统计复用率与扩展弹性通常压倒本地盘。
- 争论三:POSIX/FUSE
兼容性(
hf3fs_fuse/ 标准 Lustre) vs. 用户态零拷贝旁路(USRBIO / NIXL)。FUSE 让上层框架零改动直接跑通,但内核态/用户态往返拷贝在 \(40\text{ GiB/s}\) 级高并发 KV 读取下迅速成为 CPU 瓶颈;反过来,USRBIO 与 NIXL 各自引入了专门的共享内存注册模型或特定插件库依赖,把存储耦合进了引擎构建链路里。短期看“训练通用语料走 FUSE / POSIX,极热 KV 与大数据洗牌走 USRBIO / NIXL”仍将并存。
7.3 三个仍待解决的开放问题
- 跨引擎 KV
物理布局与量化缩放标准缺失:vLLM、SGLang、TensorRT-LLM
与 DeepInfer 各自定义了不完全兼容的 Paged KV
张量维度排序(如
[num_blocks, 2, num_kv_heads, block_size, head_dim]与分块布局差异)以及 FP8/MXFP4 block-scale 存放约定。即便 NIXL 已打通零拷贝传输,异构引擎副本之间仍然无法直接共享同一份远端 KV 池。 - 细粒度稀疏注意力(CSA/DSA/HiSparse)与存储级预取的耦合冲突:新一代长上下文模型(如 DeepSeek-V4 CSA、DSA)在解码期每步仅读取上万个压缩历史块中筛选出的 Top-k 少数块(如 \(1{,}024\) 块)。这种“高随机、极小粒度”的按索引读取模式与并行文件系统和 NVMe 依赖的“大块顺序预取”天然相悖——如何在存储控制面直接理解 Indexer 的局部性,避免每读取少量稀疏向量触发整块读取放大,是下一代存储与注意力协同设计的核心难题。
- 跨节点零拷贝 KV
池的密文完整性与微秒级开销矛盾:对于金融、政务与医疗等多租户云平台,
cache_salt只解决逻辑命中隔离,若合规要求存储在远端共享 DRAM 池或 3FS 盘阵上的 KV 块在静止与传输期必须加密且防篡改,如何在不回退到 CPU 软件加解密(破坏 GPUDirect / RDMA 零拷贝路径)的前提下完成线速校验,仍有待硬件 offload(如 DPU / NIC 内联加密)与引擎内存布局的联合验证。
八、选型与工程检查清单
不同体量的团队不需要一开始就全套自建 3FS 与全局 RDMA DRAM 池。按基础设施成熟度与负载特征收敛选型:
| 业务与集群特征 | 推荐存储与缓存基线 | 关键前提与不要盲目上的组件 |
|---|---|---|
| 单机 / 小规模集群(\(\le 8\) 卡,无 RDMA 存储网) | 本机 NVMe RAID 暂存 Checkpoint + 引擎原生 Prefix Cache(配本机 Host DRAM HiCache/LMCache) | 不要硬上分布式的 3FS 或 Mooncake 池,维护复杂度远超收益 |
| 中大规模在线推理(\(\ge 16\text{–}64\) 卡,多轮/RAG,有 200G/400G RDMA) | llm-d/Dynamo/SGLang Router +
Mooncake Store / LMCache + NIXL(UCX)
跨节点 DRAM 池;RAG 乱序场景评估 CacheBlend |
必开超时回退重算与网关注入
cache_salt;先压测实际前缀命中率与 \(L^*\) 盈亏点 |
| 万卡预训练 + 百万 QPS 级磁盘 Context Caching | 3FS(FoundationDB + CRAQ + USRBIO) 或同等级支持 GDS 的企业级并行存储(Lustre/WEKA)+ 本地 NVMe 写盘缓冲 | 必须物理隔离或队列隔离计算 RDMA 与存储 RDMA;为小文件检查点做 rank 聚合 |
上线前工程核对清单:
九、小结
AI 集群里的存储系统不再只是“把训练数据集存下来、把坏掉的
Checkpoint 救回来”的后台配角。从 DeepSeek
3FS 用 FoundationDB + CRAQ + io_uring
+ USRBIO 榨干裸盘与 RDMA 带宽,到 CachedAttention /
Mooncake / LMCache / CacheBlend / NIXL
把闲置主机内存、本地 NVMe
和分布式缓存池变成推理算力的替代品,存储工程的核心命题始终只有一句话:用更便宜的容量与更短的零拷贝数据路径,精准置换最昂贵的
GPU
算力与显存周期,并在多租户与硬件降速边界下守住确定的尾延迟与安全底线。
参考资料
规范与文档
- DeepSeek-AI.
deepseek-ai/3FSREADME 与 USRBIO 设计文档(UsrbIo.md)——本文引用的 180 存储节点(\(2 \times 200\text{ Gbps}\) IB + \(16 \times 14\text{ TiB}\) NVMe)、\(6.6\text{ TiB/s}\) 聚合读吞吐(含训练后台流量)与 \(40\text{ GiB/s}\) KVCache 客户端峰值读取口径均源于此仓库公开说明。 - NVIDIA. Magnum IO
GPUDirect Storage(
cuFileAPI 与nvidia-fs文档)——cuFileBufRegister、cuFileRead与 P2PDMA 零拷贝规范。 - NVIDIA / Dynamo.
ai-dynamo/nixl(NVIDIA Inference Transfer Library)——nixlAgent、nixl_mem_t及UCX/GDS/POSIX/HF3FS后端抽象文档。 - vLLM Project. Automatic
Prefix Caching 与多租户
cache_salt隔离文档 / 安全公告(CVE-2025-46570)——跨租户前缀哈希隔离边界与网关输入校验实践。
核心论文
- Terrace, J., & Freedman, M. J. Object Storage on CRAQ: High-Throughput Chain Replication for Read-Mostly Workloads. USENIX ATC 2009(承接 van Renesse & Schneider, Chain Replication for Supporting High Throughput and Availability, OSDI 2004)。
- Gunawi, H. S., et al. Fail-Slow at Scale: Evidence of Hardware Performance Faults in Large Production Systems. USENIX FAST 2018。
- Gao, B., et al. Cost-Efficient Large Language Model Serving for Multi-turn Conversations with CachedAttention. USENIX ATC 2024(提出 AttentionStore 分层缓存与层间异步预取)。
- Zheng, L., et al. SGLang: Efficient Execution of Structured Language Model Programs. NeurIPS 2024(提出 RadixAttention 前缀树缓存管理)。
- Liu, Y., et al. CacheGen: KV Cache Compression and Streaming for Fast Large Language Model Serving. ACM SIGCOMM 2024。
- Qin, R., Li, Z., et al. Mooncake: Trading More Storage for Less Computation — A KVCache-centric Architecture for Serving LLM Chatbot. USENIX FAST 2025(Erik Riedel Best Paper Award)。
- Yao, J., Li, H., Liu, Y., et al. CacheBlend: Fast Large Language Model Serving for RAG with Cached Knowledge Fusion. ACM EuroSys 2025(Best Paper Award)。
- Wu, G., Zhang, Z., et al. I Know What You Asked: Prompt Leakage via KV-Cache Sharing in Multi-Tenant LLM Serving(PROMPTPEEK). NDSS 2025。
- Zheng, X., Han, H., et al. InputSnatch: Stealing
Input in LLM Services via Timing Side-Channel Attacks.
2024(
arXiv:2411.18191,arXiv 预印本,未经同行评审)。 - Cheng, Y., Liu, Y., Yao, J., et al. LMCache: An
Efficient KV Cache Layer for Enterprise-Scale LLM
Inference.
2025(
arXiv:2510.09665,arXiv 预印本,未经同行评审)。
开源项目与源码
- deepseek-ai/3FS——Fire-Flyer
File System 开源实现(含
hf3fs_fuse、USRBIO 客户端、FoundationDB 元数据与 CRAQ 存储服务)。 - kvcache-ai/Mooncake——Mooncake Store 与 Transfer Engine(RDMA / NVMe-oF / NVLink 高速传输引擎)开源仓库。
- LMCache/LMCache——vLLM
LMCacheConnectorV1、CacheBlend 融合、默认chunk_size: 256分块与nixl_backend(POSIX/GDS/GDS_MT/HF3FS)集成实现。 - sgl-project/sglang——RadixAttention
与
HiCache(
--enable-hierarchical-cache、--radix-eviction-policy)实现。 - 站内延伸阅读:10:Checkpoint 与故障容忍、11:推理引擎基础、21:推理服务化、28:DeepInfer 深度解析、31:机房脏活、计算存储分离实践。
上一篇:31:机房脏活
下一篇:33:RLVR 与 Agentic 后训练基础设施实战
源码下载
本文相关源码已整理,共 1 个文件。
文章导航
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【大模型基础设施工程】10:Checkpoint 与故障容忍
万卡集群训练的故障统计、Xid 48/63/94/95 与 SDC 机理、Young-Daly 最优间隔、PyTorch DCP / ByteCheckpoint 异步存储,以及 TorchFT 与 NVRx 原地恢复工程。
【大模型基础设施工程】11:推理引擎基础
从 Prefill/Decode 两阶段、KV Cache、Roofline 拆解、Continuous Batching 到 PD 分离,系统讲清大模型推理的工程基础。
【大模型基础设施工程】21:推理服务化
从单机引擎到生产集群:Gateway API Inference Extension(llm-d)、Dynamo、AIBrix、KServe、Ray Serve、PD 分离、KV-aware 路由、LoRA 多租户与冷启动优化全景工程实战。
【大模型基础设施工程·特别篇】28:DeepInfer 深度解析——DeepSeek 生产推理引擎开源了什么
对照固定版本源码,拆解 DeepInfer 的离线用法、kernels、EP/EPLB、DSpark、SWA 与 ZOS:解释优化的条件和代价,区分开源引擎、完整服务及营收口径。