单轮对齐流水线与四模型显存账本,已经在 09:RLHF 与对齐流水线 与姊妹系列 强化学习与大模型后训练(特别是 13|RLVR 与 17|RL 训练基础设施)中拆解过。但当训练目标从 2K token 的单轮问答推向 16K–128K 长思维链(Long-CoT)RLVR 和 多轮工具调用 Agentic 后训练时,原有的同步集群拓扑会迅速失灵:几条迟迟不结束的极长推理轨迹把整批 GPU 锁死在空等状态,推理引擎的 FP8 内核与训练引擎的 BF16 反传之间哪怕隔零步也会悄悄变成离策略(off-policy)更新,成百上千个代码沙箱会在同一毫秒并发炸穿 CPU 节点。
本文不重复单轮 PPO/GRPO 的基础推导,而是专门解决长程推理与多轮智能体后训练中的五个硬核系统问题:长尾掉队气泡的量化边界、从共卡同步到解耦异步流式的五代架构演化、训推数值失配与策略稳定性(TIS / DAPO / GSPO / R3)、可验证沙箱舰队与多轮 Prefix KV 工程,以及热权重同步与线上观测。涉及集群性能或利用率曲线时,本文严格区分分析模型(Analytical Model)与引用自原论文的实测结论;未在本地多卡集群实测的数字绝不冒充实测,尚未经同行评审的预印本与技术笔记亦会逐一标注。
〇、30 秒版
- 为什么同步 RL 在长 CoT
下会掉进低利用率陷阱:长推理轨迹呈重尾分布,均值 5K
token 的任务里常混杂 32K–64K
的极长样本。在全局同步屏障下,批次耗时由 \(\max_{1 \le i \le B} L_i\)
决定;分析模型显示,在截断 32K 对数正态分布下并发 \(B=256\)
时,单波次同步槽位利用率跌至
16.2%,64K 帕累托重尾下更是跌至7.6%。 - 架构演进沿着“重分片消冗余 → 异步流式解耦 →
飞行中热更新”三条线推进:
HybridFlow / veRL(EuroSys 2025)用3D-HybridEngine消灭共卡显存冗余;THUDM/slime打通 Megatron-LM 与 SGLang 支撑 MoE 与 Partial Rollout;AReaL(arXiv 预印本,未经同行评审)与StreamRL(arXiv 预印本,未经同行评审)将生成与训练彻底解耦并引入长度排序调度;PipelineRL(arXiv 预印本 / TMLR 2025)进一步在不排空活跃请求的条件下直接将权重流式注入推理进程。 - 零陈旧度也会隐式变成 Off-Policy:即便同步执行(\(\tau = 0\)),推理引擎的 FP8 KV/GEMM、PagedAttention 归约顺序与训练端 BF16 之间的微小数值差异,会在长序列累积并翻转 MoE 顶层路由选择,导致 \(\pi_{\text{rollout}} \neq \pi_{\text{learner}}\)。工程上需要 TIS 截断重要性权重、DAPO(NeurIPS 2025)的非对称裁剪与动态采样、面向 MoE 的序列级 GSPO(arXiv 预印本,未经同行评审)以及 Rollout Routing Replay(R3)(arXiv 预印本,未经同行评审)兜底。
- 验证器不是廉价函数,而是突发有状态集群:数学规则校验受限于
SymPy解析超时与正则提取漏洞,代码/SWE-bench 任务则要求像SandboxFusion这样具备 cgroups/overlayfs 隔离与突发背压队列的容器验证舰队(沙箱运行时底层隔离机制衔接 35:Agent 沙箱运行时)。 - 多轮 Agentic RL
的核心不变量是前缀复用与增量分词:每轮工具调用后必须复用跨轮
KV 前缀(如 SGLang
RadixAttention)并仅对新增观测做增量 prefill,同时用增量追加 token ID(delta tokenization)替代整段重分词,严格对环境和工具观测施加loss_mask = 0。
一、长尾掉队气泡:16K–128K 长 CoT 如何拖垮同步屏障
在传统单轮对话 RLHF 里,绝大多数回答集中在几百到一两千 token,方差有限。进入 RLVR 推理训练后,模型自发涌现出验证、回溯与多分支试错,输出长度呈现典型重尾分布(heavy-tailed distribution):多数简单样本在 2,000–5,000 token 内输出答案并停止,而少量高难度题目会一路生成至 32,768 甚至 65,536–131,072 token 的上下文上限。在多轮工具使用 Agent 任务中,长尾不仅来自生成 token 数,还叠加了编译失败重试、单测挂起与环境超时。
1.1 同步屏障利用率的分析模型推导
考察一个典型同步采样步(在固定权重 \(\theta_k\) 下并行采样 \(B\) 条轨迹)。作一阶近似假设:各条轨迹长度 \(L_1, \dots, L_B\) 独立同分布于非负随机变量 \(L\)(受最大生成预算 \(L_{\max}\) 截断),单条轨迹耗时主要受自回归 decode 主导且正比于 \(L_i\)(忽略 prompt prefill、大并发下 KV 换出/驱逐以及 batch size 变化引起的每 token 耗时波动)。
在无跨步重填的同步屏障下,所有先完成生成的槽位必须停留在空闲态(或无法提前拉取下一权重 \(\theta_{k+1}\) 的任务),整步耗时由批次最大值决定:
\[T_{\text{sync}}(B) \propto L_{(B)} = \max_{1 \le i \le B} L_i\]
而整个批次完成的有用计算量仅为 \(\sum_{i=1}^B L_i\)。因此,同步单波次的期望有效槽位利用率(Effective Slot Utilization)可写为:
\[U_{\text{sync}}(B) = \mathbb{E}\left[\frac{\sum_{i=1}^B L_i}{B \cdot \max_{1 \le i \le B} L_i}\right] \approx \frac{\mathbb{E}[L]}{\mathbb{E}[L_{(B)}]}\]
利用极值分布恒等式,任意支承在 \([0, L_{\max}]\) 且累积分布函数为 \(F(x) = \mathbb{P}(L \le x)\) 的长度分布,其截断均值与极大值期望分别为:
\[\mathbb{E}[\min(L, L_{\max})] = \int_0^{L_{\max}} \bigl(1 - F(x)\bigr)\,dx\]
\[\mathbb{E}\left[\max_{1 \le i \le B} \min(L_i, L_{\max})\right] = \int_0^{L_{\max}} \bigl(1 - F(x)^B\bigr)\,dx\]
上式揭示了一个反直觉的系统退化现象:当并发 \(B\) 增大时,分母 \(\mathbb{E}[L_{(B)}]\) 单调逼近硬上限 \(L_{\max}\),而分子 \(\mathbb{E}[L]\) 保持不变。更雪上加霜的是 KV 显存时间积分的平方放大效应:一条长为 \(L_i\) 的轨迹占用的 KV 块数正比于 \(L_i\),且持续占据这些块长达 \(T_i \propto L_i\) 的时间,整段生命周期消耗的显存-时间积分 \(\int_0^{L_i} c \cdot t\,dt = \frac{1}{2} c L_i^2\) 与长度呈平方关系。在同步长尾期间,少数卡在 32K–64K 上的掉队请求不仅白白拖住算力,还会持续锁死大量物理 KV 页,迫使调度器在其余请求尚未排空时就遭遇显存压力。
1.2 连续批处理排空与分段中断的定量对比
现实中,如果一个训练步需要采集的总轨迹数 \(M\) 大于推理引擎并发槽位数 \(B\)(例如 \(M = 4B\)),vLLM/SGLang 会在同一步内部用连续批处理(continuous batching)把新 prompt 填进空出的槽位,直到本步最后一条任务入队后才进入尾段排空(tail drain)。但只要集群规模扩大到 \(B \to M\)(大规模多机并行采样常见情形),步内队列缓冲消失,系统立刻退化回上述 \(M = B\) 的纯屏障下界。
为了验证不同长尾形态与调度策略之间的量级差距,下面这段独立
Python 脚本直接数值积分计算三种重尾场景在并发槽位从 1 扩到
1024 时的精确分析模型利用率(完整绘图与 M=4B
固定种子排空模拟见同目录
make_figures.py):
# Python 3.10+, numpy >= 1.24
import math
import numpy as np


def lognorm_cdf(x: np.ndarray, median: float, sigma: float) -> np.ndarray:
    mu = math.log(median)
    z = (np.log(np.maximum(x, 1e-12)) - mu) / (sigma * math.sqrt(2.0))
    erf_vec = np.vectorize(math.erf, otypes=[float])
    return np.where(x <= 0.0, 0.0, 0.5 * (1.0 + erf_vec(z)))


def pareto_cdf(x: np.ndarray, xm: float, alpha: float) -> np.ndarray:
    safe_x = np.maximum(x, xm)
    return np.where(x < xm, 0.0, 1.0 - np.power(xm / safe_x, alpha))


def sync_utilization(
    cdf_fn, l_max: float, batch_sizes: list[int], n_grid: int = 25000
) -> tuple[float, list[float]]:
    xs = np.linspace(0.0, l_max, n_grid)
    cdf = cdf_fn(xs)
    mean_len = float(np.trapz(1.0 - cdf, xs))
    utils = [mean_len / float(np.trapz(1.0 - np.power(cdf, b), xs)) for b in batch_sizes]
    return mean_len, utils


batches = [1, 4, 16, 64, 256, 1024]
m_cot, u_cot = sync_utilization(lambda x: lognorm_cdf(x, 3072.0, 1.1), 32768.0, batches)
m_seg, u_seg = sync_utilization(lambda x: lognorm_cdf(x, 3072.0, 1.1), 8192.0, batches)
m_par, u_par = sync_utilization(lambda x: pareto_cdf(x, 1536.0, 1.35), 65536.0, batches)

print(f"LogNormal(med=3072, sigma=1.1, cap=32768) E[L]={m_cot:.1f}")
print(f"Partial(seg=8192) E[L_seg]={m_seg:.1f} | Pareto(xm=1536, alpha=1.35, cap=65536) E[L]={m_par:.1f}")
for b, uc, us, up in zip(batches, u_cot, u_seg, u_par):
    print(f"B={b:4d} | Sync32K={uc*100:5.1f}% | Partial8K={us*100:5.1f}% | Pareto64K={up*100:5.1f}%")
在本地 Python 3 环境实测执行上述脚本,得到如下输出:
LogNormal(med=3072, sigma=1.1, cap=32768) E[L]=5316.4
Partial(seg=8192) E[L_seg]=3874.7 | Pareto(xm=1536, alpha=1.35, cap=65536) E[L]=4744.8
B=   1 | Sync32K=100.0% | Partial8K=100.0% | Pareto64K=100.0%
B=   4 | Sync32K= 44.7% | Partial8K= 56.5% | Pareto64K= 44.7%
B=  16 | Sync32K= 24.8% | Partial8K= 47.6% | Pareto64K= 20.3%
B=  64 | Sync32K= 17.7% | Partial8K= 47.3% | Pareto64K= 10.7%
B= 256 | Sync32K= 16.2% | Partial8K= 47.3% | Pareto64K=  7.6%
B=1024 | Sync32K= 16.2% | Partial8K= 47.3% | Pareto64K=  7.2%
汇总上述数值积分结果与 make_figures.py
中固定种子 42 的 \(M=4B\)
连续批排空模拟,各调度范式在不同并发度下的分析模型表现如下(假定异步流式权重同步停顿开销
\(\delta_{\text{sync}} =
5\%\)):
| 调度范式(分析模型) | 分布与截断假设 | \(B=16\) | \(B=64\) | \(B=256\) | \(B=1024\) | 决定瓶颈的物理项 |
|---|---|---|---|---|---|---|
| Sync 32K 单波次 | LogNormal(中位 3072,\(\sigma=1.1\),上限 32K) | 24.8% |
17.7% |
16.2% |
16.2% |
\(\mathbb{E}[L] / L_{\max}\) 极值触顶 |
| Sync 64K 极重尾 | Pareto(\(x_m=1536\),\(\alpha=1.35\),上限 64K) | 20.3% |
10.7% |
7.6% |
7.2% |
极少数 64K 轨迹锁死全批 |
| Sync 32K + \(4\times\) 排空 | LogNormal 32K,\(M=4B\) 步内连续补槽 | 57.4% |
48.4% |
45.9% |
45.0% |
步末最后一批尾段排空 |
| Sync + Partial Rollout | LogNormal 32K,单波分段上限 \(L_{\text{seg}}=8192\) | 47.6% |
47.3% |
47.3% |
47.3% |
分段预算 \(L_{\text{seg}}\) 截断掉队峰值 |
| Async 解耦流式 | 跨步连续补槽 + \(\delta_{\text{sync}}=5\%\) 同步停顿 | 95.0% |
95.0% |
95.0% |
95.0% |
仅受同步停顿与 \(\eta\) 限流约束 |
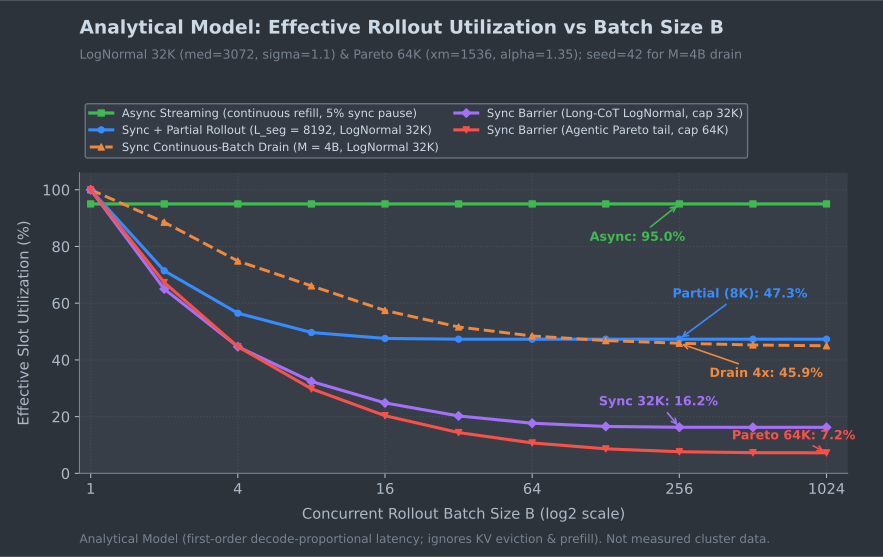
图 4(严格标注为 Analytical
Model,非实测集群数据)直观展示了同步长尾墙的严酷性:一旦单批并发达到
B=64 至 B=256,哪怕做了步内 4
倍队列排空,仍有超过半数的 GPU
槽位空转;只有把单波次最大等待时间切碎(Partial
Rollout)或彻底取消跨步屏障(异步流式),集群才能脱离掉队诅咒。
二、系统架构演进:从共卡同步到解耦异步流式
为了把图中的“掉队气泡”从 GPU 时间线上抹平,2024–2026 年的开源与研究级 RLVR 基础设施沿着控制平面、资源解耦与权重刷新机制经历了三代演进。下图的时序对比把共卡同步屏障、异步解耦 + Partial Rollout,以及飞行中权重热更新三条技术路线压在同一条时间轴上:
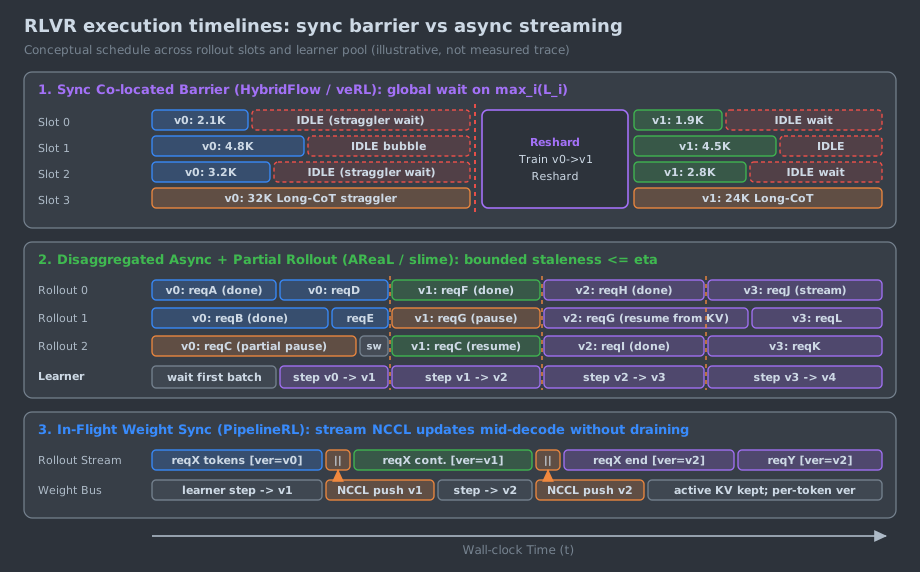
在具体系统实现上,当前具代表性的五个框架各有明确的拓扑假设与适用边界:
| 系统 / 论文 | 发表状态 | 资源与控制拓扑 | 长尾缓解核心机制 | 权重同步与陈旧度控制 | 核心假设与失效边界 |
|---|---|---|---|---|---|
| HybridFlow / veRL(Sheng 等,2025) | EuroSys 2025
正式发表(arXiv:2409.19256) |
单控数据流编排 + 多控后端;共卡时分复用 | 高吞吐 vLLM/SGLang 集成与灵活微批调度 | 3D-HybridEngine 零冗余原位重分片;\(\tau = 0\) |
假设单步内轨迹长度不过分悬殊;长尾严重时共卡切换仍受同步屏障拖累 |
| THUDM/slime(2025) | 开源生产框架(支撑 GLM 系列) | Megatron-LM 训练 + SGLang 原生推理路由 | 过量派发 + 主动中断回收(Partial Rollout) | CUDA IPC(共卡)或 NCCL 广播(分离) | 深度绑定 Megatron 与 SGLang 栈,非 Megatron 用户改造成本高 |
| AReaL(Fu 等,2025) | arXiv
预印本,未经同行评审(arXiv:2505.24298;另有
NeurIPS 2025 Poster 收录版本) |
推理节点池与训练节点池彻底异步解耦 | 中断长尾保存中间状态,跨版本恢复续写 | 异步推送 + 显式陈旧度上界 \(\lfloor N_r / B \rfloor \le i + \eta\) + 解耦 PPO | 依赖较大异步队列与合理的 \(\eta\) 配比;验证器过慢会反向阻塞样本入队 |
| StreamRL(Zhong 等,2025) | arXiv
预印本,未经同行评审(arXiv:2504.15930) |
异构资源池分离(支持跨机房生成/训练分离) | 输出长度排序器(Length Ranker)与偏斜感知调度 | 流水线流式重叠生成与更新,消除阶段气泡 | 假设长度预测器在策略持续演化下仍能保持相对排序精度 |
| PipelineRL(Piché 等,2025) | arXiv 预印本 / TMLR
2025(arXiv:2509.19128,OpenReview
可查) |
并发异步生成与训练服务 | 不排空进行中请求,持续满槽生成 | 飞行中权重更新(In-flight Weight Update)经 NCCL 直接注入 vLLM | 同一条轨迹内部不同 token 段由不同权重版本生成,依赖活跃 KV 仍近似有效 |
2.1 共卡混合数据流:HybridFlow / veRL 与 THUDM/slime
早期分离式架构(如 OpenRLHF,Hu
等,2024,arXiv:2405.11143,arXiv
预印本,未经同行评审)通过 Ray
把推理与训练隔离在不同节点池,代价值是同步交替模式下,Actor
训练时推理卡闲置、推理时训练卡闲置。
HybridFlow(开源实现为
veRL)(Sheng 等,EuroSys
2025,arXiv:2409.19256)针对单控制器
vs
多控制器的老难题给出了清晰解耦:传统单控制器虽然易于像写单机
PyTorch 脚本一样编排 PPO/GRPO
控制流,但所有中间张量回传控制节点会产生严重序列化与通信瓶颈;纯多控制器虽然算力扩展性好,却把分布式通信和强化学习逻辑焊死在一起,极难二次开发。HybridFlow
采用单控(控制流图调度)+ 多控(各 WorkerGroup
内部局部并行执行)混合编程模型,同时核心引入
3D-HybridEngine,在共卡时分复用模式下让
Actor 参数在训练态(FSDP 或 Megatron 的 TP+PP+DP
分片)与推理态(vLLM/SGLang 的 TP/DP
分片)之间做零冗余原位重分片(in-place
resharding),配合推理引擎的显存卸载/睡眠机制,使同一批
GPU 免去双份模型权重占用,原论文报告在多种 RLHF
配置下相对基线取得 \(1.53\times\) 至 \(20.57\times\) 吞吐提升。
面向千亿级 MoE 推理模型,清华知识工程实验室开源的
THUDM/slime
选择了一条“推理与训练引擎极致协同”的路径:训练后端直接锚定
Megatron-LM(原生支持大型 MoE 的
EP+TP+PP+CP),采样端原生绑定
SGLang(直接透传 --sglang-*
引擎参数与 RadixAttention 路由管理)。为了压平 MoE
长序列的尾部抖动,slime 支持基于中间数据缓冲的
Partial Rollout
机制:推理侧过量拉起采样请求,一旦收集够目标训练批就主动中止未结束的长尾任务,将半成品上下文及对应
token 序列存回缓冲,留待后续轮次直接续写而不是丢弃重算。
在所有异步或部分生成系统中,工程上还必须妥善处理参考模型(Reference
Model)的前向算力与 KL
策略取舍:一旦完全解耦生成与训练,完整长序列只在终局完成并进入训练批后,才由
Learner 侧或冻结的 Ref 节点一次性做整序列前向计算
ref_logprobs(由于无需自回归 KV
缓存,这一步属于高算术强度的稠密
prefill)。为压低千亿模型下的显存与前向消耗,社区出现两条分支:一是在训练端对静态
Ref 权重启用 CPU offload 或独立推理池异步打分;二是如
DAPO(Yu 等,NeurIPS
2025)那样在纯可验证规则奖励足够强时直接移除 KL
惩罚项(\(\beta = 0\)),将
Reference Model 从集群拓扑中彻底撤除。
2.2 完全解耦异步流式:AReaL、StreamRL 与 PipelineRL
当输出上限拉高到 32K–128K 且训练步与采样步耗时比随题目难度动态剧烈摆动时,共卡方案每轮终了的同步屏障再次成为瓶颈,促使系统彻底拆分生成与训练资源池:
AReaL(Fu 等,2025,
arXiv:2505.24298,arXiv 预印本,未经同行评审):将系统拆分为完全异步的 Rollout 节点群与 Trainer 节点群。由于两池并发跑在各自节奏上,若不加节制,Rollout 池可能提前攒出落后训练权重几十步的陈旧样本。AReaL 的控制器强制执行陈旧度上界约束:\[\left\lfloor \frac{N_r}{B} \right\rfloor \le i + \eta\]
其中 \(N_r\) 为已产出的轨迹总数,\(B\) 为单步训练批大小,\(i\) 为当前最新训练权重版本,\(\eta\) 为允许的最大版本落后容忍度(当 \(\eta = 0\) 时系统退化为严格同步;论文实验指出在 \(\eta \le 8\) 范围内能够基本无损地复现甚至略微超越同步基准的数学/代码表现,并相对同步系统最高实现 \(2.77\times\) 加速)。面对长尾请求,AReaL 允许中断未完成序列并在新权重就绪后恢复续写,目标函数层切换为解耦 PPO以兼容多版本混合样本。
StreamRL(Zhong 等,2025,
arXiv:2504.15930,arXiv 预印本,未经同行评审):从硬件算术强度差异出发,质疑“共卡即最优”的前提——decode 阶段极度受限于 HBM 访存带宽,而训练前向/反向则是 Tensor Core 算力密集型负载,让两类负载绑在同构卡上既喂不饱算力又浪费显存。StreamRL 原生面向异构分离与跨数据中心部署(例如高带宽低算力推理卡专职 rollout,高算力训练卡专职 learner),并通过流式生成(stream generation)打穿阶段等待气泡;针对长尾偏斜,它在线维护一个轻量级的输出长度排序器(output-length ranker),预测每条 prompt 的预期生成长度并实施偏斜感知调度(skewness-aware dispatching),把预期极长的样本优先错峰派发,论文在多种对比实验下报告最高 \(2.66\times\) 吞吐与 \(1.33\times\) 跨集群成本效益提升。注意其隐含假设:当策略模型在 RL 过程中思维长度发生剧烈漂移时,排序器必须持续在线校准,否则错判将重新引入尾部气泡。PipelineRL(Piché 等,2025,
arXiv:2509.19128,arXiv 预印本 / TMLR 2025):直指传统异步池的另一个隐痛——为了切换新版本权重,很多异步服务仍需“排空(drain)”在途请求或积压陈旧队列。PipelineRL 改造了 vLLM 底层 Worker(如注册init_actor_update_group与receive_weight_update),每当训练端产生新参数,就通过独立 NCCL 通信组直接把新权重注入正在进行自回归生成的推理引擎中——既不中断活跃请求,也不清空其已算好的 KV Cache,仅在单个 decode 步边界做极短暂停完成张量替换,同时为每个生成出的 token 精确标记其产生时的权重版本policy_version。借此把陈旧度控制在极窄窗口内,在最高 128 张 H100 上验证了约 \(2\times\) 的收敛效率提升。
三、训推数值失配与离策略修正:TIS、DAPO 与 GSPO
把采样与训练拆到两个独立引擎(例如 SGLang/vLLM 负责 rollout,FSDP/Megatron 负责 learner)后,工程团队很快遭遇了一个在单引擎原型上极难察觉的隐蔽故障:哪怕是在严格同步(\(\tau = 0\))、新权重刚刚拷贝完成的瞬间,推理引擎采出来的分布 \(\pi_{\text{rollout}}\) 与训练引擎重新前向算出的 \(\pi_{\text{learner}}\) 也并不一致。
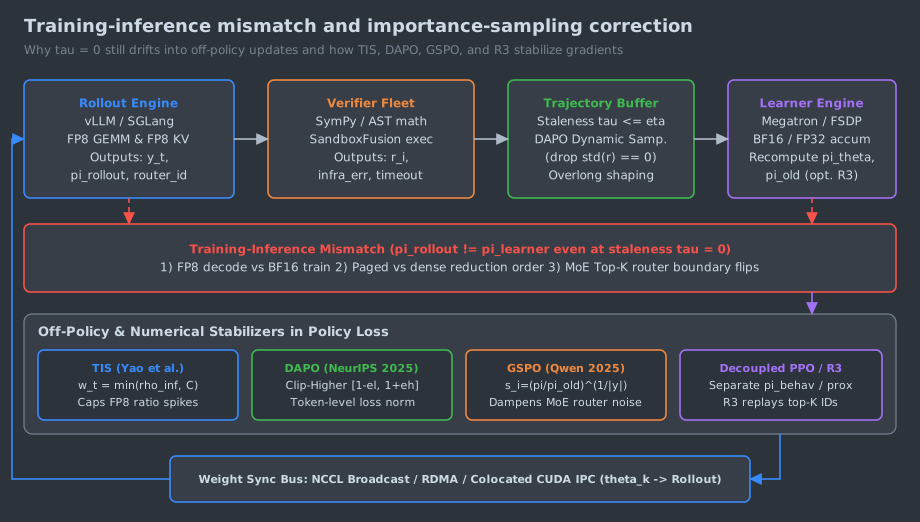
3.1 为什么零陈旧度也会隐式 Off-Policy
Yao 等人在 2025 年 8 月发布的技术研究笔记《Your Efficient RL Framework Secretly Brings You Off-Policy RL Training》(非同行评审技术研究笔记)系统指出了这个工程真相:在现代双引擎架构下,看似“完全同策略”的 GRPO/PPO 实际上从第一步起就在悄悄跑离策略训练。其物理根源有三层:
- 低精度量化与累加精度分叉:为了压低 32K–128K 长序列的 decode 显存占用并榨干 Tensor Core 吞吐,推理引擎普遍开启 FP8 GEMM 与 FP8 KV Cache;而训练侧为了反向传播梯度精度与优化器稳态,往往保持 BF16 权重前向与 FP32 累加。
- 算子实现与浮点归约顺序差异:推理 decode 调用分页注意力与分块归约内核(PagedAttention / FlashInfer),并且每步随动态批内请求进出改变并发形状(ragged batching);训练侧调用整序列稠密前向内核(FlashAttention)。由于 IEEE-754 浮点加法不满足结合律,不同的归约树顺序在单个线性层或注意力层造成 \(10^{-4}\) 至 \(10^{-3}\) 量级的 logits 偏移,经过几十层网络与数万自回归步,累积成可观的分布偏差。
- MoE 顶层门控路由翻转(Router Boundary Flip):这是大参数 MoE 模型在 RLVR 中最致命的炸药桶。当门控 softmax 给两个候选专家打出的分数十分接近时,FP8 与 BF16 之间微乎其微的数值差就足以让 Top-\(K\) 选择出现分叉——推理时 token \(t\) 走了专家 2,训练重算前向时却走了专家 8。完全不同的激活参数直接导致单个 token 的对数概率差 \(|\log \pi_{\text{learner}} - \log \pi_{\text{rollout}}|\) 飙升,使常规重要性比值 \(\rho_t\) 突破数倍甚至数十倍,进而触发梯度爆炸与策略崩溃。
更值得警惕的是长序列上的指数累积效应。整条轨迹的联合概率比等于逐 token 比值的连乘积:
\[\prod_{t=1}^{|y|} \rho_t = \exp\left(\sum_{t=1}^{|y|} \left(\log \pi_{\text{learner}}(y_t \mid x, y_{<t}) - \log \pi_{\text{rollout}}(y_t \mid x, y_{<t})\right)\right)\]
即便两端仅存在平均每个 token \(2 \times 10^{-3}\) 的微小正向对数概率偏移,累积到 \(|y| = 16384\) 步长推理链上,指数项之和便会高达 \(32.77\),使未归一化序列比值膨胀到 \(e^{32.77} \approx 1.70 \times 10^{14}\)。这正是为什么在长 CoT 场景下,不加逐 token 截断或序列长度归一化就跑标准序列级重要性采样必然触发数值溢出。
3.2 四类稳态修正器对比与核心公式
为同时压制上述数值失配(\(\tau=0\) 偏移)与异步流水线引入的版本滞后(\(\tau > 0\) 偏移),生产级 RLVR 栈通常组合使用以下四类修正机制:
| 算法 / 机制 | 代表出处 | 比率计算与裁剪粒度 | 针对的核心失效模式 | 系统工程代价与约束 |
|---|---|---|---|---|
| TIS(截断重要性采样) | Yao 等(2025,非同行评审技术笔记) | 逐 token 截断行为策略比值 \(\min(\rho_{\text{inf}}, C)\) | 抑制 FP8/BF16 精度差及异常路由引发的极端梯度尖峰 | 推理端必须落盘真实
rollout_logprobs;截断上限 \(C\) 换取有界偏差 |
| Rollout Routing Replay (R3) | Ma 等(2025,arXiv:2510.11370,arXiv
预印本,未经同行评审) |
专家路由索引强对齐 | 彻底消除 MoE 训推门控 Top-\(K\) 专家分叉 | 需修改推理与训练引擎回传并注入逐层
router_ids,增大轨迹元数据负载 |
| DAPO | Yu 等(NeurIPS
2025,arXiv:2503.14476) |
非对称裁剪 + 全局 token 归一化 + 动态过滤 + 软长度惩罚 | 早期熵坍缩、长错循环被 \(1/|o_i|\) 稀释、截断噪声 | Dynamic Sampling 推高题库过难/过易时的采样冗余倍数 |
| GSPO | Zheng 等(2025,arXiv:2507.18071,arXiv
预印本,未经同行评审) |
序列级几何平均比值 \(s_i(\theta)\) 与序列级裁剪 | MoE 长序列 token 级方差爆炸,免 R3 稳态训练 | 裁剪边界 \(\varepsilon\) 远小于 token 级;弱化了单序列内部细粒度步长区分 |
| Decoupled PPO | Hilton 等(NeurIPS 2022) / AReaL(2025) | 分离 \(\pi_{\text{behav}}\)(校正)与 \(\pi_{\text{prox}}\)(信任域) | 异步流水线跨多版本采样导致的过度裁剪 | 需同时维护近端锚点策略前向概率 |
(1)截断重要性采样(TIS)公式
推理引擎保存采样时的实际生成概率 \(\pi_{\text{rollout}}^{\text{infer}}\) 后,训练端不再把它混同于自身重算的 \(\pi_{\theta_{\text{old}}}^{\text{train}}\),而是以设定上界 \(C\)(工程常见 \(3.0\)–\(5.0\))对校正因子进行截断:
\[\nabla_\theta J_{\text{TIS}}(\theta) = \mathbb{E}_{x \sim \mathcal{D},\, y \sim \pi_{\text{rollout}}} \left[ \sum_{t=1}^{|y|} \min\left(\frac{\pi_{\theta_{\text{old}}}^{\text{train}}(y_t \mid x, y_{<t})}{\pi_{\text{rollout}}^{\text{infer}}(y_t \mid x, y_{<t})},\, C\right) \hat{A}_t \nabla_\theta \log \pi_\theta(y_t \mid x, y_{<t}) \right]\]
上式用受控的小偏差换取梯度方差的硬封顶,确保个别数值异常 token 不至于摧毁整步优化。
(2)DAPO 的四项协同机制
Yu 等人(NeurIPS
2025,arXiv:2503.14476)在开源基线中系统验证了单纯跑标准
GRPO 难以复现长 CoT 推理涌现的原因,并给出四项直接落地在
verl 中的改进:
Clip-Higher:将信任域裁剪拆解为非对称上下界 \([1-\epsilon_{\text{low}}, 1+\epsilon_{\text{high}}]\)(例如 \(\epsilon_{\text{low}} = 0.20\),\(\epsilon_{\text{high}} = 0.28\))。放宽上界让低概率探索词元在正优势下更容易获得提升,有效阻止策略熵过早跌零。
Dynamic Sampling:当某道题采出 \(G\) 条回答后若全对或全错(组内奖励标准差为 0),则相对优势全零、梯度为空。DAPO 直接剔除零方差组并持续补采直至凑足有效批。系统工程师必须警惕这一规则带来的算力反身放大效应:随着训练推进、题库通过率从 50% 向 85% 移动时,丢弃率会非线性飙升,若 Rollout 集群未留足过采样冗余,Learner 会因凑不满有效批而频繁饿死。
Token-Level Policy Gradient Loss:把外层除以单条长度 \(|o_i|\) 改为按整批全部有效 token 总数 \(\sum_{i=1}^G |o_i|\) 统一归一化,消除长错循环被 \(1/|o_i|\) 变相轻罚的结构偏置:
\[\mathcal{J}_{\text{DAPO}}(\theta) = \mathbb{E}\left[ \frac{1}{\sum_{i=1}^G |o_i|} \sum_{i=1}^G \sum_{t=1}^{|o_i|} \min\left(r_{i,t}(\theta)\hat{A}_i,\; \operatorname{clip}\left(r_{i,t}(\theta), 1-\epsilon_{\text{low}}, 1+\epsilon_{\text{high}}\right)\hat{A}_i\right) \right]\]
Overlong Reward Shaping(软过长惩罚):对于超过预期长度阈值 \(L_{\text{expected}} = L_{\max} - L_{\text{buffer}}\) 但尚未溢出硬上限 \(L_{\max}\) 的样本,施加连续线性负奖而非对截断样本一律判零或强惩罚:
\[r_{\text{overlong}}(L) = \min\left(-\frac{L - L_{\text{expected}}}{L_{\text{buffer}}} \cdot P_{\text{factor}},\; 0\right)\]
(3)GSPO 的序列级几何平均优化
Qwen 团队(Zheng
等,2025,arXiv:2507.18071,arXiv
预印本,未经同行评审)针对 MoE 长程训练指出:RLVR
的奖赏信号本来就只作用于整条序列,逐 token 乘除重要性比值在
16K
序列与稀疏路由双重叠加下必然产生高方差噪声。GSPO
直接把重要性比值与裁剪操作全部抬升到序列级几何均值:
\[s_i(\theta) = \left( \frac{\pi_\theta(y_i \mid x)}{\pi_{\text{old}}(y_i \mid x)} \right)^{\frac{1}{|y_i|}}\]
\[\mathcal{J}_{\text{GSPO}}(\theta) = \mathbb{E}\left[ \frac{1}{G} \sum_{i=1}^{G} \min\left( s_i(\theta) \hat{A}_i,\; \operatorname{clip}\left(s_i(\theta), 1-\varepsilon, 1+\varepsilon\right)\hat{A}_i \right) \right]\]
几何均值平滑掉了局部几个 token 的路由抖动,使 MoE 模型即使在未开启 R3 路由回放或存在轻度数值偏移时仍能保持平滑更新。因为序列几何平均天然缩小了比率波动幅度,GSPO 的序列级裁剪宽度 \(\varepsilon\) 通常需设置为远小于 token 级 PPO 0.2 的紧凑区间(数量级在 \(10^{-4}\) 至 \(10^{-3}\) 左右,具体以任务长度与学习率标定)。
(4)异步解耦目标(Decoupled PPO)
在 AReaL 等异步流式框架中,为防止 \(\pi_{\text{behav}}\)(旧采集版本)与
\(\pi_\theta\)
拉开后导致裁剪过死,目标函数借用 Hilton 等(NeurIPS
2022,arXiv:2110.00641)的双锚点拆解:
\[L_{\text{decoupled}}(\theta) = \mathbb{E}\left[ \min\left( \frac{\pi_\theta}{\pi_{\text{behav}}}\hat{A}_t,\; \operatorname{clip}\left(\frac{\pi_\theta}{\pi_{\text{prox}}}, 1-\epsilon, 1+\epsilon\right)\frac{\pi_{\text{prox}}}{\pi_{\text{behav}}}\hat{A}_t \right) \right]\]
其中信任域裁剪锚定在最新近端策略 \(\pi_{\text{prox}}\) 上,而分布偏差修正仍忠实除以实际采样策略 \(\pi_{\text{behav}}\)。
四、可验证奖励与沙箱验证舰队:确定性校验、突发隔离与防作弊
RLVR 拿掉了昂贵的 GPU 奖励模型,却在工程端引入了一个并发形态完全不同、同样可能成为集群单点瓶颈的子系统:可验证奖励与沙箱验证舰队(Verifier Fleet)。
4.1 数学符号校验 vs 突发代码测试沙箱
工程中两类验证任务对底座基础设施的压力截然不同:
- 数学与形式化验证(AST /
SymPy/ Lean):单次验证无外部网络与容器镜像依赖,耗时在毫秒到百毫秒级。其头号生产事故隐患是表达式化简 DoS——当模型在长思维链末尾输出超深嵌套分式、高次多项式或复杂三角恒等式时,直接在主事件循环中调用SymPy.simplify()可能把单个 Python 进程卡死数十秒甚至触发 OOM,瞬间堵死异步协程调度器。生产级数学验证服务必须遵循“由廉入贵”的四级流水线:正则提取与格式归一化 \(\to\) 有理数Fraction精确比对 \(\to\) 多点随机复数代入数值检验 \(\to\) 放在独立子进程且强制绑定秒级SIGKILL超时的SymPy符号等价判定。 - 代码与 SWE-bench 测试沙箱(如
SandboxFusion):以 ByteDance Seed 开源的SandboxFusion(支持 20 余种编程语言,内置 Linux namespaces、cgroups 与 overlayfs 隔离)为代表,这类沙箱不仅是有状态容器/微虚机池(底层容器与 MicroVM 运行时隔离细节详见 35:Agent 沙箱运行时),而且具备强烈的波峰脉冲特征:在训练推理波次集中收尾的几百毫秒内,海量轨迹同时吐出代码补丁,瞬间向沙箱集群砸入上千个并发gcc/cargo test/pytest请求。若缺乏异步消息缓冲队列、预热容器池与镜像层本地缓存,CPU 节点会迅速因为密集的容器挂载、磁盘 IOPS 竞争与进程上下文切换而雪崩。
4.2 分级超时、故障隔离与防作弊加固
要让验证舰队在千步训练中既不拖慢吞吐又不污染梯度,必须强制执行三项生产隔离约定:
- 分级超时与进程树收割:切忌只给整个验证
RPC 设一个粗糙的 60
秒总超时。工程上应拆为“环境准备与依赖拉取(如 5s)\(\to\) 编译阶段(如 15s)\(\to\) 单测运行(如
10s–30s)”三段独立预算,并将所有待测命令放进独立 PID
namespace 与 memory/CPU
cgroup。超时触发时,外层守护进程必须通过
cgroup.kill或进程组SIGKILL整棵清理,并立刻卸载回收临时 overlayfs 挂载点,防止“僵尸测试脚本”持续蚕食宿主机算力。 - 严格隔离设施故障(
infra_error)与策略错答(reward=0):当沙箱因节点磁盘打满、容器镜像拉取超时或队列过载而返回执行异常时,绝对禁止直接返回reward = 0。混入 GRPO 组内后,原本正确但倒霉碰到节点抖动的样本会被错误赋予负优势,持续向模型注入噪声梯度。正确设计是返回显式状态码:遇到infra_error自动执行有限次指数退避重试;重试仍失败则将该组或样本标记剔除,不参与本步梯度更新,并直接触发运维告警。 - 沙箱安全边界与 Specification Gaming 防御:RL 模型在强优化压力下会系统性地寻找测试框架与规则漏洞(13|RLVR 已总结过典型案例)。下表归纳了 RLVR 生产环境中最常出现的四类作弊路径及对应的基础设施防线:
| 攻击 / 作弊模式 | 具体行为表现 | 基础设施层拦截策略 |
|---|---|---|
| 测试框架篡改 / 早退逃逸 | 生成代码调用 sys.exit(0)
跳过后续断言,或猴子补丁替换
unittest/pytest 判分入口 |
编译与执行两阶段分离;测试 harness 以只读权限挂载并在独立子进程末尾汇总退出码与校验哈希 |
| 容器信息窥探 / 外网回传 | 在 SWE-bench 容器内遍历检索隐藏测试文件、读取环境变量或尝试外网拉取参考补丁 | 沙箱创建时完全禁用网络命名空间(zero egress)、剥离无关环境变量,隐藏测试文件仅在模型停止输出后注入验证阶段 |
| 资源耗尽型逃逸 | 故意写入 fork 炸弹、无限递归或分配巨量临时文件 | 强制配置
pids.max、memory.max、RLIMIT_FSIZE
与 seccomp 系统调用白名单 |
| 多解碰撞 / 格式化碰运气 | 在数学输出结尾堆砌多个
\boxed{A}、\boxed{B}
或篡改正则锚点 |
解析器严禁搜索“任意命中”,强制校验规范末尾唯一答案块,并对非法多框或格式逃逸施加显式负罚分 |
4.3 流式触发与脆弱测试隔离(Flaky Quarantine)
在架构编排上,切忌等整批 \(B\) 条轨迹全部 decode
结束后才统一发给验证舰队。同步等待全批结束后再拉起上千个代码沙箱,不仅会把容器调度延迟直接叠加在
max_i L_i
之后形成二次掉队气泡,还会制造最恶劣的磁盘与调度脉冲。正确做法是单条完成即刻流式投递:某条短序列第
10 秒一吐出 <eos>
就立刻送往异步沙箱验证,把 10–30
秒的编译与单测耗时隐藏在仍在继续解码的长序列后台里。
此外,真实代码仓库(如 SWE-bench
衍生数据集)常混有时间竞争、随机数依赖或环境状态敏感的脆弱测试(flaky
tests):同一份模型补丁连续跑两次测试,一次通过一次失败。若把脆弱题目直接放进
GRPO 组内,组内随机 0/1
抖动会被标准化成虚假的大幅度正负优势。生产数据管线应在入库前对题库执行多次无修改基准空跑(baseline
determinism
check)和定期失败复检,把不可复现通过的用例自动打入隔离池(quarantine),避免整个后训练梯度持续被环境随机噪声牵引。
五、多轮 Agentic Rollout 工程:状态交织、前缀缓存与 Token 掩码
单轮 RLVR 只需把 prompt 送入推理引擎一次 decode 到底;而面向代码仓库修复(SWE)、浏览器操作或检索推理的 Multi-Turn Agentic RL,实质上是把 19:Agent 框架工程 的状态机循环和 20:工具调用与 MCP 的工具协议搬进了高并发采样闭环里。
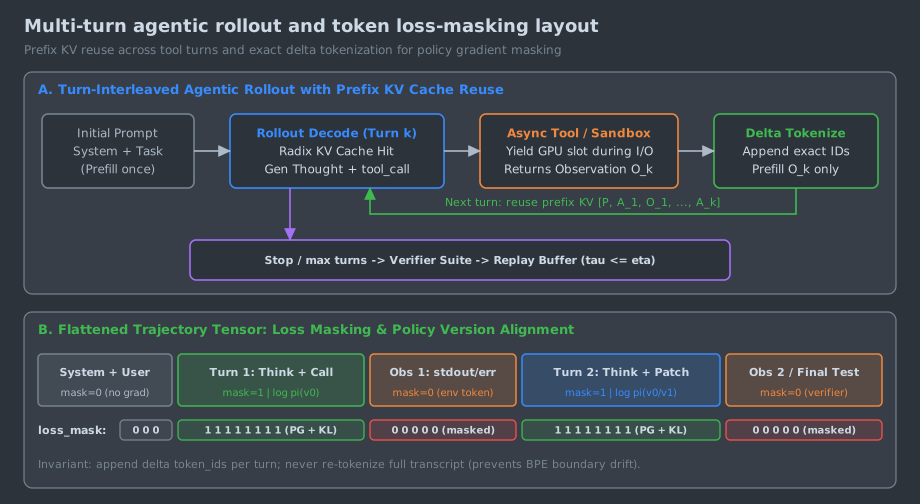
5.1 回合交织调度与跨轮 Radix KV 缓存复用
在多轮交互中,每条轨迹会在“GPU 自回归思考 + 发起工具调用(Action \(A_k\))”与“外部工具/容器执行返回结果(Observation \(O_k\))”之间反复横跳。这里潜藏两个直接决定硬件成本的调度开关:
- 异步槽位让渡(Slot Yielding):一次外部
pytest或代码编译往往耗时数秒。如果推理 Worker 在这数秒里一直把请求挂在 active running batch 上干等,宝贵的并发槽位会被活活占死。生产调度器应当在检测到模型输出工具调用停止符时立刻将请求从活跃批退避到外部异步协程,释放推理槽位给其他待采样任务;待沙箱回传 \(O_k\) 后再重新唤醒入队。 - 跨轮前缀 KV
复用(RadixAttention)与粘性路由:第 \(k+1\) 轮拼给模型的输入是 \([P, A_1, O_1, \dots, A_k,
O_k]\),其中前半截 \([P,
A_1, O_1, \dots, A_k]\) 的 KV
向量在上一轮刚刚算完。如果不做跨轮 KV
复用,每次工具返回后整段重算 prefill,计算复杂度会按轮数
\(K\) 呈 \(O(K^2)\) 急剧攀升。依托 SGLang
提出的 RadixAttention(Zheng
等,NeurIPS
2024,
arXiv:2312.07104)把已计算前缀的 KV 块按基数树组织在 HBM 或分层主机内存池中(集群级 KV 分层存储与跨节点卸载详见 32:AI 集群存储与分布式 KV 缓存系统),并在负载均衡层开启按trajectory_id的粘性路由,唤醒后的第 \(k+1\) 轮只需要对刚刚追加的那一小段观测 \(O_k\) 做增量 prefill,即可无缝衔接继续 decode。
这里存在一个外部 I/O 时长与 HBM 驻留窗口的硬件边界:如果某次外部编译耗时 25 秒,而推理节点的 HBM 基数缓存平均 LRU 寿命只有 12 秒,那么待沙箱返回时,此前缀 KV 已被新请求驱逐出显存。此时要么依赖 PCIe Gen5 / RDMA 把 KV 异步卸载到主机 DRAM 或分布式缓存层再回迁,要么按策略直接对未命中前缀重做一次并行 prefill。对于单轮工具调用响应偏慢(数十秒级)但前缀长达 32K–64K 的任务,主机内存级分层 KV 缓存往往能比纯显存重算更划算;相反,对于仅 4K 左右的短前缀,直接触发一次稠密 prefill 反而省去主机内存序列化与管理复杂度。
5.2 增量分词不变量与观测 Token 损失掩码
多轮轨迹拼装成训练 Tensor 送往 Learner 时,一个极其隐蔽却足以毁掉收敛的经典工程缺陷是全对话重分词边界漂移(Re-tokenization Boundary Drift)。
如果采样端只保留每轮交互的纯文本
messages,到训练端再统一调用
tokenizer.apply_chat_template(messages)
从头分词一次,相邻两轮文本交界处的空格、换行符或特殊控制符极易触发
BPE 贪心合并规则改变——导致事后分词出来的
token_ids 序列与推理引擎采样生成
rollout_logprobs 时的精确 token
序列对不上号!下面的最小可运行 Python
玩具示例直观复现了这种跨边界合并导致的错位,以及生产框架(如
veRL multi-turn
管线)采用的增量分词(Delta
Tokenization)标准解法:
# Python 3.10+ (演示 BPE 跨角色边界合并漂移 vs 增量分词)
TOY_VOCAB = {
    "<|im_start|>": 101,
    "\n": 10,
    "user": 20,
    "ok": 30,
    "\n<|im_start|>": 200,  # 换行与特殊角色标签合并
    "ok\n": 201,            # 助手末尾词与换行合并
}


def greedy_encode(text: str) -> list[int]:
    ids, i = [], 0
    keys = sorted(TOY_VOCAB.keys(), key=len, reverse=True)
    while i < len(text):
        matched = next((k for k in keys if text.startswith(k, i)), None)
        if matched is not None:
            ids.append(TOY_VOCAB[matched])
            i += len(matched)
        else:
            ids.append(ord(text[i]))
            i += 1
    return ids


turn_assistant = "ok"
turn_env_prefix = "\n<|im_start|>user\n"

# 正确做法(Delta Tokenization):各段独立编码后按 ID 拼接并同步生成 loss_mask
assistant_ids = greedy_encode(turn_assistant)
env_ids = greedy_encode(turn_env_prefix)
delta_ids = assistant_ids + env_ids
delta_mask = [1] * len(assistant_ids) + [0] * len(env_ids)

# 错误做法:先把多轮文本拼成完整字符串再整段重分词
retok_ids = greedy_encode(turn_assistant + turn_env_prefix)

print("delta_ids :", delta_ids)
print("delta_mask:", delta_mask)
print("retok_ids :", retok_ids)
print("id_match  :", delta_ids == retok_ids)
实测执行结果如下:
delta_ids : [30, 200, 20, 10]
delta_mask: [1, 0, 0, 0]
retok_ids : [201, 101, 20, 10]
id_match  : False
可以看到,整段重分词把助手输出末尾的 "ok"
与后续环境前缀开头的 "\n" 融合成了单 token
201,从而连带改变后续角色标签 ID(从
200 变成
101)。生产环境必须坚持一条硬不变量:推理引擎采样出多少
token ID 就原样记下多少 token ID,环境观测单独编码为增量 ID
片段严格追加,同时逐 token 维护
loss_mask——仅模型自身生成的
<think>、工具调用动作与最终答复标为
1;系统提示词、初始题干及所有
<tool_response> 返回文本统一标为
0,既不计入策略梯度损失,也不计入 KL
惩罚项。
面向多轮与异步 RLVR 的生产缓冲层,在 Rollout 与 Learner 之间应显式对齐以下轨迹张量契约:
| 张量字段 | 形状与典型精度 | 写入方 | 消费方与关键不变量 |
|---|---|---|---|
input_ids |
[T] / int64 |
Rollout + 环境拼接器 | 全程增量追加,严禁重分词覆盖历史段 |
loss_mask |
[T] / bool or
uint8 |
环境编排器 | 1
仅对应策略自主生成段;环境观测、系统提示与 padding 严格为
0 |
rollout_logprobs |
[T] / float32 |
Rollout 引擎 | 记录采样瞬间真实行为对数概率,供 TIS 校验 \(\tau=0\) 与 \(\tau>0\) 偏差 |
policy_version |
[T] 或分段标量 / int32 |
调度器 / Worker | 标记每个 token 生成时的权重版本,供陈旧度统计与飞行中热更新切片 |
routed_experts |
[T, L_moe, K] /
int16(可选) |
Rollout MoE 门控 | 仅开启 R3
时落盘;训练前向强制按该索引路由专家,压平边界翻转 |
需要注意,在多机分布式流水线中,rollout_logprobs
与 routed_experts 若不加压缩全部走 RPC
传回主控节点会迅速吃满序列化带宽。工程上通常将大张量直接写入共享对象存储或节点本地高速缓存,仅向调度器传递轻量轨迹句柄(handle),由
Learner 按批直拉。
5.3 多轮重放缓冲与回声陷阱(Echo Trap)
当交互轮次拉长且环境自带随机性(例如真实仓库构建或网页探索)时,多轮采样成本远高于单轮。RAGEN(Wang
等,2025,arXiv:2504.20073,arXiv
预印本,未经同行评审)通过 StarPO
多轮轨迹优化框架揭示了一个特有的训练退化故障——回声陷阱(Echo
Trap):在稀疏终局奖励条件下,模型往往会出现奖励方差骤降与梯度尖峰,退化为反复输出空洞不变的通用思考模板而无视工具报错内容。系统侧的缓解依赖带信噪比过滤的多轮重放缓冲区(StarPO-S):按任务初始状态多样性采样,并在入批前过滤掉奖励方差近零或交互轮次失控的低质量轨迹,而非简单把多轮缓冲区做成无条件先进先出队列。
六、权重热同步机制与系统可观测性
当 Learner 完成一次反向更新与优化器步进后,如何用最小停顿把数十 GB 乃至数百 GB 的参数 \(\theta_{k+1}\) 分发到全集群 Rollout 副本,是连接训练池与采样池的最后一道物理阀门。
6.1 三条物理权重同步路径的工程权衡
| 同步路径 | 典型采用系统 | 数据流与分片映射机制 | 典型通信域与停顿特征 | 核心工程陷阱 |
|---|---|---|---|---|
| 共卡原位重分片 + Sleep/Wake | veRL
(3D-HybridEngine)、vLLM Sleep
Mode |
llm.sleep() 卸载推理权重并清空/卸载 KV
释放显存 \(\to\)
训练完成后同卡组 all-gather / 指针重映射为推理
TP 分片 \(\to\)
llm.wake_up() |
无跨池网络带宽瓶颈;但训练期间推理完全暂停 | NCCL 通信器句柄和临时缓冲自身占用可观显存,切态不清理极易引发 OOM |
| 跨节点 NCCL / RDMA 广播 | OpenRLHF、slime(分离态)、PipelineRL |
训练端按分桶(bucket)把 Megatron/FSDP 分片聚合重组为推理 TP/EP 布局,经专有 NCCL Broadcast 组推送给推理 Worker | 受跨机 IB/RoCE 带宽制约;对于千亿级 MoE 参数,需靠分桶流水线掩盖聚合延迟 | 训练 TP/PP/EP 与推理 TP/EP 拓扑不一致时,需在初始化阶段严格注册张量切片映射表 |
| 同机显存直共享(CUDA IPC) | slime(同节点多进程)、定制共驻部署 |
训练进程与推理进程共驻同一物理节点,通过
cudaIpcGetMemHandle
把最新权重显存切片零拷贝映射进 SGLang/vLLM |
走 NVLink/PCIe 零主机内存中转,避开跨机网卡拥塞 | 必须严格同步跨进程显存块生命周期与地址对齐,指针释放错序会触发非法显存访问 |
在 PipelineRL 的飞行中热更新模式下,还有一个极易被忽略的跨版本 KV Cache 相容性张力:当模型权重 \(\theta_k\) 在一条请求生成到第 12,000 个 token 时被热替换成 \(\theta_{k+1}\),驻留在 PagedAttention 块表中的前 12,000 个历史 \(K, V\) 向量依然是由 \(\theta_k\) 的注意力投影矩阵算出来的,而第 12,001 个 token 的查询向量 \(Q\) 以及新增 \(K, V\) 则由 \(\theta_{k+1}\) 算出。在单步 RL 微调学习率极低(典型量级 \(10^{-6}\))时,相邻少数版本间的参数漂移尚可通过残差连接与平滑注意力度量容忍;但一旦热更新跨越过多优化步或学习率调大,历史 KV 语义偏移就会积累,此时必须限制单条长请求跨版本跨度或触发局部增量重计算。
对于千亿级 MoE 与跨节点分离部署,跨节点分桶 NCCL 权重同步通常按以下四阶段流水线执行以防止瞬时 OOM 与带宽空置:
- 参数聚合与分片重排(All-Gather & Reshard):Megatron 训练侧通常使用 TP+PP+EP+DP 四维混合切分,而 SGLang/vLLM 推理侧往往仅使用 TP+EP(或更高 TP)。训练端首先在内部组把切散的权重的若干层打成一个固定大小的连续缓冲区(bucket,例如 512MB–2GB),并转换投影矩阵布局(如合并 QKV 与门控投影格式)。
- 分桶流水线广播(Bucketed NCCL Broadcast):无需等全模型几百 GB 参数全部聚齐再发网,每拼满一个 bucket 就通过专用权重同步 NCCL 通信组向所有推理节点发起异步广播,下一桶张量聚合与当前桶网络发送互相掩盖。
- 显存峰值与桶大小权衡:
bucket_size设得太小会导致海量小张量集合通信调度开销激增;设得过大则会在训练节点与推理节点同时额外留出一大块临时连续显存缓冲,在长上下文 KV 几乎吃满显存时极易触发瞬间 OOM。 - 原子张量引用切换:推理引擎收到整桶数据后直接拷贝覆盖底层权重指针或触发
update_weights_from_distributed原地更新,无需重启 CUDA Graph(前提是网络拓扑与张量形状未变)。
6.2 RLVR 集群五层核心观测指标
沿用并扩展 17|RL 训练基础设施 的分层监控体系,面向长 CoT 与 Agentic RLVR 的生产集群应当实时跟踪以下五类关键指标:
| 指标类别 | 核心观测指标 | 异常信号与典型根因定位 |
|---|---|---|
| 槽位与步时分解 | rollout_slot_util、step_breakdown(Prefill
/ Decode / Sandbox Wait / Weight Sync) |
rollout_slot_util 跌破 30%
说明陷入长尾掉队气泡;若 Sandbox Wait 占主体,应检查 I/O
让渡是否生效及容器池并发上限 |
| 异步陈旧度分布 | staleness_mean、staleness_p99、per_traj_version_span |
staleness_p99 持续抬高表示 Rollout 吞吐相对
Learner 欠配;单条轨迹跨越版本数过宽时需收紧 \(\eta\) 或缩短 Partial Rollout
分段上限 |
| 训推对数概率漂移 | rollout_train_kl、\(\max_t |\log \pi_{\text{train}} - \log
\pi_{\text{rollout}}|\)、MoE 路由一致率 |
在 \(\tau=0\) 时该指标仍持续高于 \(10^{-2}\) 量级,优先排查 Delta Tokenization 边界错位、模板拼接差异与 FP8/MoE 数值漂移 |
| 有效梯度与裁剪率 | clip_fraction、dapo_discard_ratio(动态采样丢弃率)、entropy |
dapo_discard_ratio 飙升(如超过
0.7)意味着题库过易或过难、采样算力正在空烧;clip_fraction
暴涨配策略熵骤降提示需切 Clip-Higher 或序列级 GSPO |
| 验证舰队健康度 | verifier_queue_depth、verifier_timeout_rate、infra_error_rate |
infra_error_rate 上升时必须拦截对异常轨迹打
reward=0,立刻排查容器 OOM、overlayfs
句柄泄漏或 SymPy 进程卡死 |
工程排障时,最重要的一条联动判据是区分“训练算力不够”还是“题库信息密度耗尽”:当
rollout_slot_util 维持在 85%
以上但吞吐迟迟不升、dapo_discard_ratio
同步攀升且 verifier_queue_depth
接近零,瓶颈不在集群调度,而在提示词难度已经偏离当前策略的“可学区间”,此时盲目扩充推理卡只会按比例烧掉更多无效采样算力,必须立刻做在线难度重采样(curriculum
filtering)或更换高区分度题集。
七、生产选型决策与上线前核查
工业界落地 RLVR 与 Agentic 后训练时,不应一上来就堆叠最复杂的跨机房异步流式组件。下面的决策树从长尾特征、模型结构与硬件精度三个硬约束出发,给出可落地的架构收口路径:
flowchart TD
    S["Start: RLVR / Agentic Workload"] --> Q1{"Heavy-tail >= 16K or<br/>Multi-turn Tool I/O?"}
    Q1 -->|"No (<= 4K, fast AST)"| C1["Sync Colocated<br/>veRL (3D-HybridEngine)"]
    Q1 -->|"Yes"| Q2{"Model Architecture<br/>& Scale?"}
    Q2 -->|"Dense <= 70B"| C2["Async Decoupled Streaming<br/>AReaL / PipelineRL"]
    Q2 -->|"Large MoE >= 200B"| C3["Megatron + SGLang Stack<br/>slime / Async Partial Rollout"]
    C2 --> Q3{"FP8 Rollout or<br/>High Staleness?"}
    C3 --> Q3
    Q3 -->|"Yes"| A1["Enable TIS + DAPO or<br/>GSPO + Optional R3"]
    Q3 -->|"BF16 Sync / Tight ver"| A2["DAPO (Clip-Higher +<br/>Dynamic Sampling)"]
    A1 --> V["Add Async Verifier Fleet<br/>(SandboxFusion + Delta Tokenize)"]
    A2 --> V
放量跑满千步之前的五项上线前硬核查(Pre-Flight Check):
- 零步一致性基准校验:将学习率置零或关闭权重更新跑通一轮完整采样与训练前向,统计
rollout_train_kl与|logprob_infer - logprob_train|的 P99。若在此阶段就出现明显尖峰,多半是 Chat Template 特殊 token 拼接错误或重分词错位,必须先清零再开训。 - 多轮 Mask
逐位核验:抓取带报错堆栈与代码块的多轮样例,逐位核对
token_id、decoded_str与loss_mask,确认<tool_response>、system与 padding 位置全部严格为0且序列边界未产生 BPE 融合错位。 - 验证器故障注入演练:人为向代码沙箱注入死循环、内存爆涨脚本与
\(3\times\)
突发并发脉冲,验证
cgroup.kill能否在 SLA 内完整收割进程树,且超时故障被映射为infra_error剔除而非污染reward=0。 - DAPO 动态采样冗余核算:启用动态过滤零方差组的任务,Rollout 算力配比不能按“1 倍吞吐对接 1 倍吞吐”估算,必须结合目标数据集通过率分布预留 \(1.5\times\)–\(3\times\) 的过采样算力冗余,防止 Learner 频繁空等。
- 部分生成跨版本封顶保护:启用 Partial Rollout 或飞行中权重更新时,务必对单条超长轨迹设置最大允许跨越版本阈值,避免卡在极长尾部的请求拿着数十步之前的 KV 前缀继续拼接更新。
八、学术谱系、核心争论与开放问题
8.1 学术谱系:算法信任域与分布式系统双线交汇
现代 RLVR 与 Agentic 基础设施是算法稳定化理论与分布式流式系统两条主线交汇的产物:
- 算法与信任域演化线:从单步裁剪
PPO(Schulman
等,2017,
arXiv:1707.06347)与 InstructGPT 三阶段 RLHF(Ouyang 等,NeurIPS 2022)起步;到 DeepSeekMath(Shao 等,2024,arXiv:2402.03300,arXiv 预印本,未经同行评审)以 GRPO 移除高显存占用的 Critic 网络,以及 DeepSeek-R1(DeepSeek-AI,Nature 2025,arXiv:2501.12948)与 Kimi k1.5(Kimi Team,2025,arXiv:2501.12599,arXiv 预印本,未经同行评审)把可验证奖励推向长思维链与 128K 上下文;再到 DAPO(Yu 等,NeurIPS 2025)、GSPO(Zheng 等,2025,arXiv:2507.18071,arXiv 预印本,未经同行评审)以及借道 Decoupled PPO(Hilton 等,NeurIPS 2022)处理多版本异步偏差。 - 系统拓扑演化线:从 Ray 编排的分离式
OpenRLHF(Hu
等,2024,
arXiv:2405.11143,arXiv 预印本,未经同行评审),演进至共卡零冗余重分片的 HybridFlow / veRL(Sheng 等,EuroSys 2025);并在长尾掉队气泡倒逼下分化出支撑前缀树复用的 SGLang RadixAttention(Zheng 等,NeurIPS 2024)、完全异步解耦的 AReaL(Fu 等,2025,arXiv:2505.24298,arXiv 预印本,未经同行评审)、带长度排序调度的 StreamRL(Zhong 等,2025,arXiv:2504.15930,arXiv 预印本,未经同行评审)、飞行中权重注入的 PipelineRL(Piché 等,2025,arXiv:2509.19128,TMLR 2025),以及深耕 MoE 与多轮环境的 THUDM/slime 和 RAGEN(Wang 等,2025,arXiv:2504.20073,arXiv 预印本,未经同行评审)。
8.2 当前社区的三场核心争论
- 同步 On-Policy 纯净度 vs. 异步流式吞吐 +
重要性校正:以
HybridFlow同步共卡范式为代表的路径强调零陈旧度的同策略纯净语义,实验归因干净、排障直观;而AReaL、StreamRL与PipelineRL阵营则用数据证明,在 32K–128K 重尾场景下同步等待让大片高端 GPU 陷入低效空等是无法承受的 TCO 浪费,只要配合陈旧度上界 \(\eta\)、解耦 PPO 与 TIS 截断校正即可获取 \(2\times\) 以上加速而无损最终准确率。当前工程共识偏向分阶段切换:新奖励或新环境探索初期用同步跑稳基线,进入大规模长程放量阶段再切换至可控陈旧度的异步流式架构。 - Token 级精细修正(DAPO /
TIS)vs. 序列级优化(GSPO)在 MoE
中的取舍:
DAPO与TIS保留逐 token 粒度的概率比值与裁剪,适合向极长思维链局部关键转折步骤回传精细信号,但在 MoE 架构下容易因路由边界翻转诱发单 token 比率震荡,常需叠加复杂的R3路由回放改造推理与训练栈。GSPO(Zheng 等,2025,arXiv 预印本,未经同行评审)直接把比率抬升到序列几何平均,以牺牲部分序列内细粒度权重差异换取了免 R3 稳定 MoE 训练的简洁性。两者在超大规模多轮 Agent 任务上的长期样本效率孰优孰劣,仍有待更多跨模型家族的独立同口径基准来检验。 - Partial Rollout 跨版本续写
vs. 截断拼接偏差:Kimi k1.5、AReaL 与
slime利用暂停并恢复长轨迹有效抹除了掉队气泡,却让同一条 64K 轨迹的前后半段分别落在了不同权重版本 \(\theta_t\) 与 \(\theta_{t+k}\) 之下。工程上多用分段记录行为概率并限制跨版本跳数的启发式方案兜底,但异版本前缀拼接在极端长程自回归链条上引入的非平稳分布偏差,至今仍缺少严谨的理论边界刻画。
8.3 三个值得跟踪的开放问题
- 飞行中权重更新下的跨版本 KV Cache
语义退化界限:
PipelineRL等系统在不重置活跃请求 KV 缓存的前提下直接替换模型权重,使新生成 token 的查询向量去检索旧参数投影出的历史 \(K, V\) 向量。当上下文延伸至 128K 以上或遇到较大学习率更新步幅时,混合版本 KV 缓存何时突破注意力容错阈值并导致生成质量退化,目前缺乏系统性的定量界限实验(可围绕 MLSys 与 NeurIPS 高效系统方向持续追踪)。 - 随机环境故障下的多轮 Agentic
信用分配与模板坍缩:在持续数十轮的 SWE-bench
修复或动态网页交互中,偶发超时、外部 API
抖动与真实策略失误混杂;加之
RAGEN及其后续研究RAGEN-2(arXiv:2604.06268,arXiv 预印本,未经同行评审)指出的模板坍缩问题(模型在熵看似平稳下学会忽略环境输入并复读固定模板),如何在不引入重型过程奖励模型(PRM)的前提下以轻量信号定位真实瓶颈步骤,依然没有标准化答案。 - 异构训推内核(FP8 Inference vs. BF16 Training)的确定性对齐标准:只要推理端持续迈向 FP8/FP4 低比特与动态变批调度、训练端坚守 BF16/FP32 高精度梯度累加,训推对数概率失配就会长期存在。社区最终是能够依靠低开销的批归约确定性内核(batch-invariant kernels)从底层消弭差异,还是永久把这笔账交由上层的 TIS 与序列级 GSPO 消化,是 AI Infra 跨算子编译与强化学习优化层的长期核心命题。
九、小结
从 2K 单轮对齐跨向 16K–128K 长 CoT RLVR 与多轮 Agentic
后训练,基础设施工程师的精力重心已经从“把四个模型塞进显存”迁移到三件事:用异步解耦与
Partial Rollout 消灭重尾掉队气泡、用 TIS/DAPO/GSPO/R3
消化跨引擎数值和版本漂移、用强隔离突发沙箱与增量前缀缓存接管多轮外部环境交互。先在同步基线上把
rollout_train_kl 与多轮 loss_mask
校验跑干净,再沿着局部中断续写、异步解耦与 MoE
序列稳态算法渐进演进,是控制千卡级后训练集群工程风险最稳妥的路径。
交叉阅读:
- 09:RLHF 与对齐流水线——SFT、Reward Model、PPO 与 GRPO 基础公式及入门实操。
- 13|RLVR:可验证奖励如何训练推理能力与 17|RL 训练基础设施——姊妹系列对单轮 RLVR 动机与基础排障的展开。
- 19:Agent 框架工程与 20:工具调用与 MCP——多轮状态机编排、结构化约束解码与工具边界安全。
- 32:AI 集群存储与分布式 KV 缓存系统与 35:Agent 沙箱运行时——大规模 KV 缓存底座与隔离容器/微虚机运行时。
参考资料
规范与文档
- Yao 等,Your Efficient RL Framework Secretly Brings You Off-Policy RL Training,2025 年 8 月(非同行评审技术研究笔记)。系统分析 vLLM/SGLang 与 FSDP/Megatron 训推概率失配及 TIS 修正方法。
- vLLM Sleep Mode & Weight Transfer 官方文档,2025–2026 年核对。共卡睡眠卸载与在线权重更新机制说明。
- veRL
官方文档(Multi-Turn & DAPO Recipes),2025–2026
年核对。增量分词、多轮
loss_mask与 Soft Overlong Punishment 配置参考。 - SandboxFusion 官方文档,ByteDance Seed。多语言代码执行与容器/cgroup 隔离架构。
核心论文
- Schulman 等,Proximal Policy Optimization Algorithms,2017(arXiv 预印本,未经同行评审)。PPO 裁剪代理目标奠基工作。
- Ouyang 等,Training language models to follow instructions with human feedback,NeurIPS 2022。InstructGPT 三阶段 RLHF 工程范式确立。
- Hilton 等,Batch size-invariance for policy optimization,NeurIPS 2022(链接为 arXiv 预印本,已发表于 NeurIPS 2022)。解耦行为策略与近端锚点的理论来源。
- Zheng 等,SGLang: Efficient Execution of Structured Language Model Programs,NeurIPS 2024(链接为 arXiv 预印本,已发表于 NeurIPS 2024)。RadixAttention 跨请求/跨轮前缀 KV 复用机制出处。
- Shao 等,DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models,2024(arXiv 预印本,未经同行评审)。GRPO 算法提出。
- Hu 等,OpenRLHF: An Easy-to-use, Scalable and High-performance RLHF Framework,2024(arXiv 预印本,未经同行评审)。Ray + vLLM + DeepSpeed 分离式对齐系统工程基线。
- DeepSeek-AI,DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning,Nature 645, 633–638 (2025)(链接对应预印本与期刊条目)。长 CoT 纯 RLVR 推理涌现基线。
- Kimi Team,Kimi k1.5: Scaling Reinforcement Learning with LLMs,2025(arXiv 预印本,未经同行评审)。128K 长上下文 RL 与 Partial Rollout 缓冲续写实践。
- Sheng 等,HybridFlow: A
Flexible and Efficient RLHF Framework,EuroSys
2025(链接为 arXiv 预印本,已发表于 EuroSys
2025)。单控+多控混合架构与
3D-HybridEngine原位重分片来源。 - Yu 等,DAPO: An Open-Source LLM Reinforcement Learning System at Scale,NeurIPS 2025(链接为 arXiv 预印本,已发表于 NeurIPS 2025)。Clip-Higher、Dynamic Sampling、Token-Level PG Loss 与 Overlong Reward Shaping 四项改进出处。
- Zhong 等,StreamRL: Scalable, Heterogeneous, and Elastic RL for LLMs with Disaggregated Stream Generation,2025(arXiv 预印本,未经同行评审)。异构分离流式生成与输出长度排序调度器出处。
- Fu 等,AReaL: A Large-Scale Asynchronous Reinforcement Learning System for Language Reasoning,2025(所引为 arXiv 预印本,未经同行评审;该工作另收录于 NeurIPS 2025 Poster)。全异步解耦架构、陈旧度上界与解耦 PPO 来源。
- Piché 等,PipelineRL: Faster On-policy Reinforcement Learning for Long Sequence Generation,TMLR 2025 / arXiv 2025(OpenReview 可查)。飞行中 NCCL 权重热更新机制来源。
- Zheng 等,Group Sequence Policy Optimization,Qwen Team,2025(arXiv 预印本,未经同行评审)。序列级几何平均重要性比与 MoE 稳态优化来源。
- Ma 等,Stabilizing MoE Reinforcement Learning by Aligning Training and Inference Routers,2025(arXiv 预印本,未经同行评审)。Rollout Routing Replay(R3)路由回放机制出处。
- Wang 等,RAGEN: Understanding Self-Evolution in LLM Agents via Multi-Turn Reinforcement Learning,2025(arXiv 预印本,未经同行评审)。StarPO 多轮智能体 RL 与 Echo Trap 诊断出处。
开源项目与源码
- verl-project/verl——HybridFlow
官方开源仓库(已由
volcengine/verl迁至该组织),含3D-HybridEngine、DAPO 与多轮工具扩展实现。 - THUDM/slime——清华 THUDM 开源的 Megatron-LM + SGLang 大规模 MoE RLVR 框架。
- inclusionAI/AReaL——AReaL 异步强化学习推理框架开源实现。
- ServiceNow/PipelineRL——PipelineRL 基于 vLLM 与 NCCL 的飞行中权重更新实现。
- OpenRLHF/OpenRLHF——基于 Ray + vLLM + DeepSpeed 的经典分离式对齐框架。
- bytedance/SandboxFusion——ByteDance Seed 开源的多语言 LLM 代码执行验证沙箱。
- RAGEN-AI/RAGEN——面向多轮智能体强化学习的开源研究与诊断框架。
下一篇:34:多模态与视频生成(DiT / 全模态)推理基础设施
源码下载
本文相关源码已整理,共 1 个文件。
文章导航
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【大模型基础设施工程】09:RLHF 与对齐流水线
从 SFT、奖励模型、PPO/DPO 到 GRPO、DAPO、GSPO 与异步 RLVR 基础设施的全链路实践:拆解训推同步、权重一致性与主流框架拓扑。
【强化学习与大模型后训练】13|RLVR:可验证奖励如何训练推理能力
RLVR用规则或形式化验证器替代学习的奖励模型,以减少reward hacking、提高透明度,适用于数学、代码等具备ground truth的任务。
【强化学习与大模型后训练】17|RL 训练基础设施:采样-训练分离与 PPO 编排
从 rollout、奖励计算、价值估计到策略更新,拆解 LLM 在线 RL 的系统拓扑、资源瓶颈和同步边界。
【大模型基础设施工程·特别篇】32:AI 集群存储与分布式 KV 缓存系统
从 3FS、CRAQ 与 USRBIO 到 Mooncake、CacheBlend 与 NVIDIA NIXL:拆解训练数据/检查点与分布式 KV 缓存池的存储系统工程、传输盈亏公式与多租户安全边界。