当 Agent 从「只吐文本和 JSON」迈入
CodeAct、bash、仓库重构与桌面浏览器操作,执行环境便不再是辅助工具,而是一个由不可信输入驱动的远程代码执行(RCE)引擎。只要网页、邮件或第三方工具返回值里混入间接提示注入(Indirect
Prompt Injection),模型就可能把任意载荷翻译成合法的
python 或 curl
调用——此时决定系统会不会失守的,不是 System Prompt
里的禁止句,而是底层操作系统与虚拟化边界。
本篇专门拆解 Agent 不可信执行运行时(Untrusted Execution Runtime)与 OS / Hypervisor 隔离面,补齐系列中与编排、护栏、身份委托的工程拼图:不重复框架循环、MCP Schema、文本合规或 OAuth 协议,而是下沉到内核系统调用(syscall)、内存分页、块设备延迟与出向网络防火墙。文中引用论文均注明原始会议与测试前提;第 6 节的突发排队与预热池内存曲线为明确标注的参数化分析模型(Analytical Model),而非物理集群实测基准。
〇、30 秒版
- 标准容器
runc不是对抗多租户边界:所有容器共享同一套宿主机 Linux 内核(\(300+\) 个系统调用、io_uring、netfilter 与命名空间状态),叠加runc内部文件描述符泄漏(如 CVE-2024-21626),一次容器内越权即可直接穿透宿主机。 - 四层隔离光谱按硬件前提与系统调用税率选型:加固容器(
seccomp-bpf+ Landlock LSM)仅适合本地单租户兜底;gVisor Systrap 用SECCOMP_RET_TRAP与共享内存收窄宿主机内核暴露面且不依赖/dev/kvm;Firecracker / Kata Containers 提供独立 Guest 内核与硬件页表隔离;Wasm / V8 Isolates 虽有亚毫秒启动,却无法承载原生 Python C 扩展、git、多进程bash与 Chromium。 - 亚秒级恢复必须配套工作集预取与克隆后状态破除:Firecracker
快照配合
userfaultfd(UFFD)惰性换页虽能跳过初始化,却会在首次执行触发随机缺页风暴;REAP(ASPLOS 2021)通过记录稳定工作集并顺序预取大幅压低恢复延迟。凡是从同一快照并发克隆的沙箱,必须强制经VMGenID+virtio-rng重置内核熵池并重新注入 MAC/IP/主机名与时钟偏移,否则不同租户将生成重复的 TLS/SSH 密钥。 - 三类沙箱拓扑各自卡在不同瓶颈:短生命期验证器(如
SandboxFusion、SWE-bench)卡在突发并发与资源熔断;持久编码工作区卡在
virtiofs对git/npm大量小文件元数据的 FUSE 往返延迟(常需退回virtio-blk);浏览器与桌面环境(如 OSWorld)则需权衡 CDP 代理与全桌面Xvfb/Wayland,警惕无 GPU 节点下 SwiftShader CPU 光栅化打满算力。 - 无凭据沙箱(Secretless
Sandbox)是硬红线:沙箱环境变量与镜像内严禁存放上游
API Key 或云 AK/SK;由宿主机网络命名空间的
nftables/eBPF 封堵169.254.169.254、RFC 1918 私网段及直连 UDP 53 隧道,所有合规外联统一经过沙箱外 L7 代理完成域名白名单校验、防 DNS Rebinding 检查与短生命周期凭证注入。
一、威胁模型与为什么标准容器(runc)守不住边界
1.1 系列分工:控制面、身份面与执行面
在完整生产体系里,Agent 的安全性由控制编排、身份委托与隔离执行三张平面共同托底,各自职责边界如下:
| 专题篇目 | 负责平面 | 核心问题 | 不展开的边界 |
|---|---|---|---|
| 19:Agent 框架工程 / 20:工具调用与 MCP | 编排与工具协议 | StateGraph、Compaction、约束解码与 MCP 规范 | 内核隔离、VMM 沙箱与宿主机网络防火墙 |
| 24:成本、合规与安全 | 模型护栏与合规 | Prompt Guard、PII 脱敏、TEE 证明与监管口径 | MicroVM 快照分页、I/O 栈与克隆熵重置 |
| Agent 身份与安全 / 落地架构 | 身份与访问控制 | OAuth 2.1、RFC 8693 Token Exchange 与 OPA/Cedar 授权 | 不可信 RCE 运行时的 OS 与虚拟化隔离 |
| 33:RLVR 与 Agentic 后训练基础设施实战 | 后训练奖励调度 | GRPO/PPO 异步采样编排与验证沙箱吞吐 | 单沙箱内核逃逸、网络出向拦截与文件代理 |
| 本篇 35 | 不可信执行运行时 | OS/Hypervisor 隔离、快照恢复、存储/桌面拓扑与无凭据出向 | 不重复上层 Prompt 工程与 IdP 协议细节 |
1.2 不可信 Agent 运行时的四类核心攻击面
把容器当作「轻量虚拟机」是生产事故最常见的起点。面对大模型生成的任意代码与外部网页内容,执行层面对以下四类高危威胁:
- 提示注入直接升级为沙箱内 RCE:传统 Web
服务假定服务端代码可信、仅输入参数不可信;而在
CodeAct或终端工具里,攻击者通过间接注入控制的是整段待执行的 Python/Shell 逻辑。一旦运行在同一进程或裸宿主机上,读取~/.ssh、~/.aws或进程环境变量只需一行代码。 - 共享 Linux
内核攻击面与容器运行时漏洞:默认
Docker/
runc容器通过 Linux Namespace、cgroups 与seccomp-bpf隔离视图,但所有系统调用仍直接落入同一套宿主机内核。Linux x86_64 暴露超过 \(300\) 个系统调用,其中io_uring通过用户态与内核态共享环形缓冲区提交异步 I/O,不仅绕过传统按次拦截的seccomp参数检查,历史上也是高危本地提权(LPE)漏洞集中区(高安全生产节点常通过sysctl -w kernel.io_uring_disabled=2或显式seccomp规则彻底禁用);叠加nf_tables与非特权user_namespaces的提权链条,单点内核漏洞即可跨租户接管整台宿主机。即便内核本身无漏洞,运行时实现的边界缺陷同样致命——例如 2024 年 1 月披露的runcCVE-2024-21626(Leaky Vessels),因runc在创建或exec阶段未清理指向宿主机路径(如/sys/fs/cgroup)的内部文件描述符,恶意容器只需通过WORKDIR /proc/self/fd/<N>即可穿透chroot/挂载命名空间直接读写宿主机文件系统。 - 喧闹邻居与资源耗尽(Noisy-Neighbor
DoS):大模型生成的死循环并发进程(
fork炸弹)会耗尽宿主机全局 PID 空间;海量小文件写入或无限向tmpfs(本质占用宿主机页缓存与内存)刷写会诱发宿主机内存回收抖动、inode耗尽,直接拖垮同宿主机上其他正常租户或模型推理 Pod。 - 服务端请求伪造(SSRF)与云元数据凭证外泄:即便代码本身没有外网需求,若沙箱复用宿主机默认网桥路由,代码只需访问
http://169.254.169.254/latest/meta-data/(主流公有云实例元数据服务 IMDS,阿里云对应地址为100.100.100.200)即可窃取节点 IAM Role 临时凭证,或横向扫描同 VPC 内的 Redis、数据库与推理引擎内部端口。需要注意一个常见细节:AWS Firecracker 内置的 MMDS(MicroVM Metadata Service)默认处于禁用状态,只有在宿主机控制面显式开启并绑定网络接口后才会在 guest 侧响应,这与云 VM 默认挂载宿主角色 IMDS 的风险模型截然不同。
二、四层隔离光谱:加固容器、用户态内核、硬件 MicroVM 与 Wasm
选型的核心不是背「谁最安全」,而是把宿主机内核暴露面、虚拟化硬件前置条件、系统调用税率、以及对 Python/Git/浏览器生态的兼容性放到同一张账本上对齐。
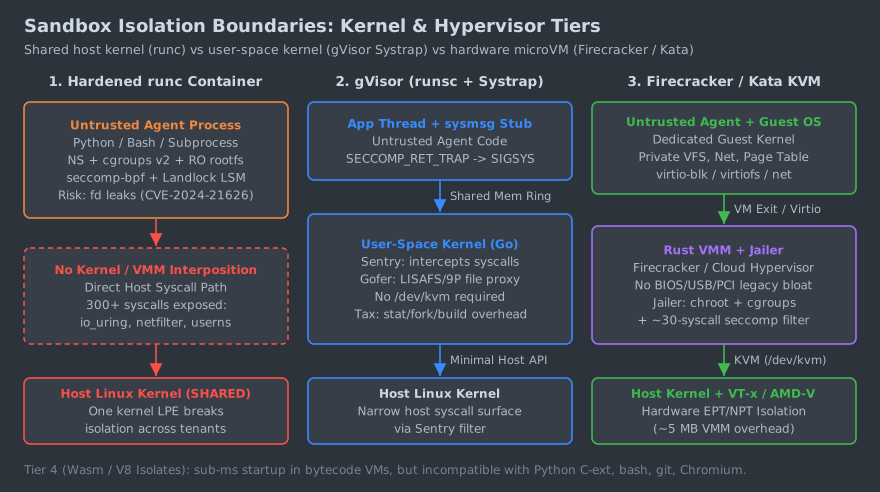
| 隔离层级 | 代表实现 | 核心边界机制 | 硬件前提 | 典型性能税 | 原生 Python C 扩展 / git / Chromium |
适用定位 |
|---|---|---|---|---|---|---|
| Tier 1:加固标准容器 | Rootless runc + seccomp +
Landlock / bubblewrap |
Namespace + cgroups v2 + --read-only +
系统调用黑/白名单 + 路径自限 |
无(任意 Linux) | 近原生(几乎零额外 syscall 税) | 完整兼容(受限于只读与能力裁剪) | 单租户本地开发工具防护(如 Claude Code 沙箱),不宜用于高对抗多租户云端 |
| Tier 2:用户态内核 | gVisor(runsc +
Systrap) |
Go 编写的 Sentry 拦截实现绝大多数 syscall;Gofer 通过 LISAFS/9P 代理文件 I/O | 无需 /dev/kvm(Systrap
基于 SECCOMP_RET_TRAP) |
高频
stat/fork/编译(Bazel)与小包网络存在用户态切换税 |
高兼容(极少数冷门内核特性或直接内核模块调用除外) | 无法开启嵌套虚拟化的公有云 VM 集群、高密度多租户代码解释器 |
| Tier 3:硬件 MicroVM | Firecracker / Kata Containers(Cloud Hypervisor) | KVM 硬件虚拟化(EPT/NPT)+ 独立 Guest 内核;Rust VMM + Jailer 纵深沙牢 | 需要
/dev/kvm(裸金属或支持嵌套虚拟化的云实例) |
CPU/内存近原生;I/O 受 virtiofs
元数据往返或 virtio-blk 影响 |
完整 OS
生态兼容(bash、git、任意
ELF、浏览器与桌面) |
多租户云端代码执行、持久编程工作区、桌面 Computer Use |
| Tier 4:语言与字节码隔离 | Wasm / WASI(wasmtime)、V8 Isolates |
线性内存沙箱 + Capability 接口导入,无直接 OS syscall | 无 | 冷启达亚毫秒至毫秒级,单机可密布数千实例 | 不兼容:无法直接运行 glibc Python C
扩展(numpy/torch)、bash、git、Chromium |
轻量 JS/TS/Rust 插件脚本、确定性纯逻辑工具胶水 |
2.1 Tier 1:加固容器与 Landlock LSM(本地防护的上限)
在不可用虚拟机且追求零开销的本地场景,可以通过叠加 Linux
原生机制收紧容器:开启非特权 Rootless
userns、挂载只读根文件系统(--read-only)、--cap-drop=ALL、收窄的
seccomp-bpf 白名单(默认禁用
io_uring、ptrace、bpf、kexec_load),以及
Landlock LSM(自 Linux 5.13
起合入主线的非特权路径访问控制模块,允许进程在执行不可信片段前自我剥夺文件读写能力;自
ABI v4 / Linux 6.7 起进一步支持对 TCP
bind/connect 端口进行限制)。例如
Anthropic 开源的 @anthropic-ai/sandbox-runtime
在 Linux 上便采用
bubblewrap(bwrap)命名空间隔离文件系统视图,并将网络出口桥接到宿主机侧的
Unix Domain Socket
代理。但只要共享同一个宿主机内核,加固容器就仍是同构内核风险模型——一旦面对未知第三方多租户提交的恶意载荷,必须上移到用户态内核或硬件
MicroVM。
2.2 Tier 2:gVisor Sentry、Gofer 与 Systrap 平台
gVisor(runsc)不试图修补宿主机系统调用的每条参数,而是直接在用户态用
Go 重写了一套实现了 Linux ABI 的内核
Sentry,并把所有宿主机文件系统访问剥离到独立进程
Gofer 中通过 LISAFS/9P 协议代理——即使
Sentry 被攻破,也受限于更窄的宿主机系统调用沙盒与 Go
内存安全。
gVisor 历史上提供过 ptrace(利用
PTRACE_SYSEMU,通用但每次 syscall
触发多次高昂上下文切换)和
KVM(利用硬件虚拟化加速拦截,但在未开放
/dev/kvm
嵌套虚拟化的普通公有云虚机上无法启用)两种平台。2023
年 4 月 gVisor 发布并默认启用 Systrap
平台,成为公有云环境落地的关键拐点:
- 用
SECCOMP_RET_TRAP替代ptrace:Systrap 为沙箱内应用线程安装seccomp-bpf过滤规则;当应用执行SYSCALL指令时,宿主机内核不执行该调用,而是向线程投递SIGSYS信号。 - 基于共享内存的
sysmsgstub 通信:每个沙箱线程附带一段轻量的sysmsg信号处理 stub 与备用信号栈,捕获SIGSYS后直接把寄存器上下文(syscall 号与参数)写入沙箱进程与 Sentry 共享的内存环形区域并挂起等待(经由 futex 等快速同步原语),由 Sentry 线程池从共享内存读取请求、模拟内核语义后再写回返回值唤醒应用线程。
这一架构让 gVisor 无需 /dev/kvm
即可跑在任意普通云虚机上,并大幅削减了原先
ptrace
的上下文切换惩罚。但在工程选型时必须看清代价边界:纯计算密集型任务(如矩阵运算、视频编码)几乎不跨
syscall 边界,性能接近原生;而大量频繁触发
stat / open / fork
的工作负载(如大型 C++/Rust
编译、数万个小文件的依赖树解析)仍会反复穿越用户态内核边界,表现显著慢于原生容器或配置得当的块设备
MicroVM。
2.3 Tier 3:Firecracker 与 Kata Containers(Cloud Hypervisor)
硬件辅助虚拟化(Intel VT-x / AMD-V 与 EPT/NPT 二级页表)为每个沙箱分配独立的 Guest Linux 内核,使逃逸者必须连续攻破「Guest 应用 \(\rightarrow\) Guest 内核 \(\rightarrow\) VMM 模拟设备 \(\rightarrow\) 宿主机 KVM 驱动」多层边界。
- Firecracker(Agache et al., USENIX NSDI
2020):AWS 为 Lambda 和 Fargate 打造的 Rust 专用
VMM。其核心哲学是激进裁剪遗留硬件模拟:彻底移除
BIOS、PCI 总线枚举(x86_64 上走基于内存映射 I/O 的
Virtio-MMIO)、USB、显卡、音频等攻击面,仅保留极简
virtio
设备(
virtio-net、virtio-block、virtio-vsock、串口、单键复位键盘,以及后续版本引入的virtio-rng熵设备与内置速率限制器)。在 NSDI 2020 原论文测试条件下,单台 Firecracker microVM 的 VMM 额外内存开销低于 \(5\text{ MB}\),冷启动进入 guestinit最快可达 \(125\text{ ms}\)(含控制面 API 配置约 \(150\text{ ms}\)),单宿主机可达每秒创建 \(150\) 个微虚机。生产部署必须配合其伴生二进制 Jailer:在移交执行权前完成chroot根目录隔离、切换非特权 UID/GID、绑定 cgroups 限额(现代 Linux 宿主机需显式指定--cgroup-version 2,否则默认为 v1)与独立网络命名空间(--netns);Firecracker 默认开启严格seccomp-bpf白名单(也可通过--seccomp-filter传入seccompiler-bin编译的自定义规则),将 VMM 进程可用的宿主机系统调用锁死在极小集合内:
jailer \
  --id sbx-0192a4 \
  --exec-file /usr/bin/firecracker \
  --uid 10001 --gid 10001 \
  --chroot-base-dir /srv/jailer \
  --netns /var/run/netns/sbx-0192a4 \
  --cgroup-version 2 \
  --cgroup cpu.max="200000 100000" \
  --cgroup memory.max=1073741824 \
-- --api-sock /run/firecracker.socket- Kata Containers:面向 OCI/Kubernetes
生态的轻量虚拟机方案(
containerd-shim-kata-v2),通过标准RuntimeClass接入 K8s 调度。其底层 VMM 可选 QEMU、Firecracker 或用 Rust 编写的 Cloud Hypervisor(kata-clh)。相较极端极简的 Firecracker,Cloud Hypervisor 支持标准 virtio-pci、设备热插拔与直通扩展,结合virtiofs(virtiofsd)或块设备将容器镜像根文件系统映射进 Guest,适合作为企业 Kubernetes 集群里同时承载普通编码工作区与重型持久化沙箱的统一运行时底座。
2.4 Tier 4:为什么 Wasm / V8 Isolates 无法替代通用 Agent 沙箱
在函数计算与边缘网关中,V8 Isolates(Cloudflare
Workers)和 WebAssembly(wasmtime +
WASI)能在亚毫秒内拉起隔离实例,内存占用以 MB 计。但在通用
Agent
场景下,这条路线存在结构性不兼容:大模型在数据分析、软件工程与自动化任务中默认依赖
Python 的 C-ABI
生态(numpy、pandas、scipy、lxml、cryptography
动态 .so 扩展)、任意预编译 Linux ELF
二进制工具链(ripgrep、sqlite3、ffmpeg)、多进程管道
bash、git 以及完整 Chromium
渲染引擎。尽管 Pyodide 等项目能将部分科学计算库重新编译到
Wasm,但第三方 PyPI C 扩展的长尾覆盖率、多进程
fork/exec 语义缺失与无标准 POSIX
套接字/桌面栈,决定了 Wasm/V8 Isolates 目前只适合受限的内置
DSL 或轻量插件胶水,而不能充当通用 Agent 代码解释器。
三、亚秒级拉起、快照分层与“克隆陷阱”
把每个沙箱跑进独立 MicroVM
解决了隔离问题,却立刻带来启动延迟账单:哪怕 Firecracker
内核引导只要 \(125\text{
ms}\),叠加上层根文件系统挂载、Python
解释器冷启动、import pandas
与百兆代码库检出,完整冷启动仍动辄消耗 \(1\text{–}3\text{
s}\)。在需要并发拉起数十个 RLVR
验证沙箱或交互式编码会话时,直接冷启动会让 Agent
首字节时间剧烈恶化。
3.1 快照恢复、CoW 存储与 Kubernetes 预热池
工业界以
E2B(e2b-dev/infra)和
kubernetes-sigs/agent-sandbox
为代表,形成了「模板快照 + 写时复制(CoW)+
预热池」三层加速架构:
- 运行时快照(Snapshot
Pause/Restore):预先冷启动一台标准模板
MicroVM,完成 Python/Node
环境初始化与仓库预热,并在客内启动轻量控制守护进程(如 E2B
的 Go 守护进程
envd,暴露文件读写、PTY 终端与进程执行 RPC);随后调用 FirecrackerCreateSnapshot冻结并导出内存文件vm.mem、vCPU/设备状态与块设备镜像。新会话到达时直接通过LoadSnapshot恢复运行态,跳过全部应用冷初始化,将拉起缩至百毫秒量级。 - CoW 分层块设备与 OverlayFS:为了避免每实例拷贝数 GB 根文件系统,底座采用 DeviceMapper thin-provisioning、OverlayFS 或按需流式块设备(NBD/overlaybd)实现只读基础层共享与实例级增量写入。
- 预热池与 K8s
agent-sandboxCRD:原生 K8s 为单次工具调用临时建删 Pod 会引发etcd写入压力、调度排队与 CNI IP 池抖动。SIG Apps 下的agent-sandbox项目引入了agents.x-k8s.ioAPI 组(SandboxTemplate、Sandbox、SandboxClaim与SandboxWarmPool):提前在节点维护一批已就绪的空闲沙箱,收到SandboxClaim后立即绑定分配。但预热池绝非免费午餐——每一个闲置待命实例都在实时占据宿主机真实物理内存(Reservation Tax),且若允许实例复用(而非销毁重建),极易把上一个会话的残留环境变量、/tmp文件或打开的套接字泄漏给下一个租户。
3.2
userfaultfd(UFFD)按需换页与 REAP
快照预取
当单个编程沙箱或桌面沙箱的内存快照达到 \(512\text{ MB}\) 乃至 \(4\text{ GB}\)
时,如果恢复阶段采用全量同步读取(Eager Load)把整份
vm.mem 搬进 RAM 再唤醒
vCPU,磁盘与网络带宽会重新把启动拖慢到秒级以上。因此
Firecracker 的 PUT /snapshot/load 接口支持两种
mem_backend.backend_type:直接文件映射
File(由宿主机内核直接对 vm.mem
缺页加载)与用户态缺页接管
Uffd(Linux 6.1+ 允许通过
/dev/userfaultfd 配合 Jailer
安全地向非特权进程暴露用户态缺页能力)。当选择
Uffd 时,backend_path
指向的不是内存文件本身,而是宿主机上的一个 Unix
Domain Socket:Firecracker 在初始化阶段通过
SCM_RIGHTS 把 userfaultfd
文件描述符传递给外部缺页处理守护进程,由该守护进程决定何时从本地
NVMe 或远端对象存储按需注入内存页:
{
  "snapshot_path": "/srv/snapshots/py312-base/vmstate.snap",
  "mem_backend": {
    "backend_type": "Uffd",
    "backend_path": "/run/fc/uffd-handler.sock"
  },
  "track_dirty_pages": true,
  "resume_vm": false
}
注意将 resume_vm 设为 false
可以在真正放行 vCPU 调度前先完成外部网络重新挂载与
VMGenID 注入,避免 Guest
在未重设边界前抢跑。
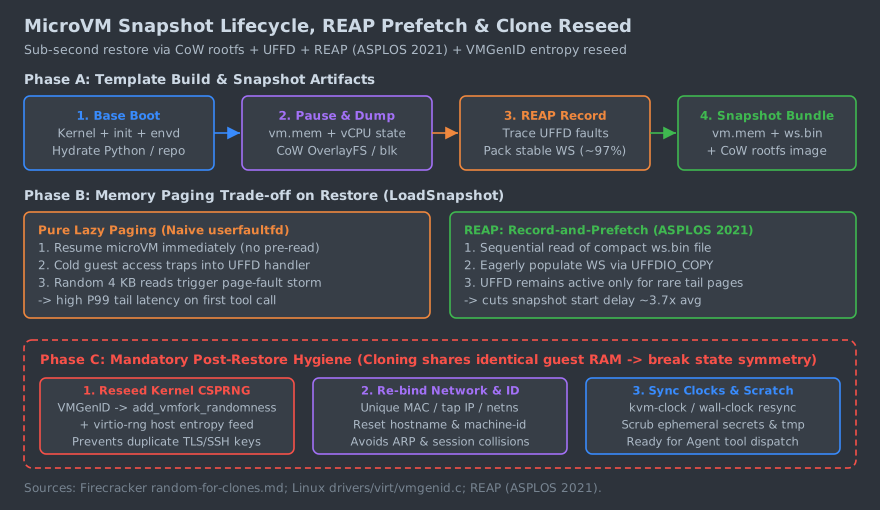
然而,朴素的 userfaultfd
按需换页(Pure Lazy
Paging)会制造严重的尾延迟陷阱。REAP(Record-and-Prefetch,Ustiugov
et al., ASPLOS
2021)系统性地测量了无服务函数与微虚机快照恢复行为,揭示了两个关键事实:
- 缺页风暴(Page-Fault
Storm):纯粹按需补页会把一次恢复拆成成千上万次随机
4 KB 缺页中断,每次 Guest 触及未加载内存页都必须触发 VM-Exit
\(\rightarrow\) Host UFFD
事件 \(\rightarrow\)
用户态守护进程读盘 \(\rightarrow\)
UFFDIO_COPY注入页表 \(\rightarrow\) VM-Entry 的完整往返,随机小块磁盘 I/O 吞噬了并发恢复吞吐。 - 工作集高度稳定:论文测量显示,函数跨调用实际访问的
Guest 物理内存工作集极为紧凑且稳定(约 \(97\%\)
的访问页面在不同输入调用间保持一致)。基于此,REAP
在首次记录阶段用
userfaultfd捕获执行轨迹并把工作集页打包为顺序紧凑文件(Working Set file);后续每次恢复前,先用单次大块顺序读把稳定工作集提前注入 Guest 内存,仅把极少数长尾冷页留给 UFFD 兜底。在 ASPLOS 2021 的测试设置下,REAP 将快照冷启动延迟平均降低了 \(3.7\times\)。
映射到 Agent 基础设施:静态基础工具模板(如
python3 + numpy + pytest)极度符合 REAP
的工作集稳定假设,先预取基础工作集再结合 UFFD
兜底可兼顾首响应与低内存峰值;而当用户进入多轮对话、动态
pip install
未知重型包时,工作集发生漂移,仍需依赖后台 UFFD
流式补页。
3.3 快照克隆的三大隐藏灾难与强制重置清单
只要平台开启「一份父快照并发克隆出 \(N\) 个沙箱」,就会面对系统工程里最隐蔽的安全性与正确性陷阱:所有克隆实例在唤醒那一毫秒拥有逐位完全一致的物理内存与内核态数据结构。如果不做强制后处理,会出现三类严重故障:
- PRNG 熵池复制灾难:Guest Linux
内核的密码学安全伪随机数生成器(CSPRNG)内部状态被原封不动写进了
vm.mem。唤醒后若不立刻重掺杂(reseed),100 个同时克隆出来的租户沙箱调用getrandom()或读取/dev/urandom将吐出一模一样的随机字节序列——直接导致跨租户生成相同的 TLS 会话临时密钥、相同的 SSH 主机密钥、可预测的 UUID 与临时文件名碰撞。- 工程解法(
VMGenID+virtio-rng):根据 Linux 内核drivers/virt/vmgenid.c(Linux 5.18+ ACPI 合入,后续扩展支持 ARM64 DeviceTree)与 Firecracker 官方docs/snapshotting/random-for-clones.md规范,VMM 在恢复快照时必须向虚拟VMGenID设备写入一个新的 128-bit 唯一随机代际 ID;Guest 内核驱动捕获变化通知后立即调用add_vmfork_randomness()触发crng_reseed()强制刷新内核熵池。同时建议挂载virtio-rng设备,从宿主机侧(如基于aws-lc-rs的宿主机随机源)向 Guest 持续补充新鲜熵,避免用户态库缓存或连续高并发取随机数时出现状态趋同。
- 工程解法(
- 网络身份与 MAC/IP 冲突:父快照内的网卡
MAC 地址、IP、路由表及
/etc/machine-id完全相同,若多个克隆沙箱接入同一宿主机二层网桥,会立刻触发 ARP 漂移与跨实例串包。每个克隆沙箱必须绑定独立宿主机netns+ 点对点tap/NAT 映射,或通过控制面/客内 Agent 在交付前动态重写 IP/主机名与清理本地连接池。 - 单调时钟与墙钟跳变(Clock
Skew):快照制作于昨天、恢复于今天,Guest
醒来时若内部仍保留昨日时间戳,会导致所有 HTTPS
客户端校验证书
NotBefore失败或 JWT 过期误判;而若强行跳跃系统时间,依赖CLOCK_MONOTONIC与CLOCK_REALTIME差值的用户态定时器和退避逻辑可能异常。恢复流水线必须在envd放行首条用户代码之前完成kvm-clock/ptp_kvm时间同步,并清理模板构建期残留的/tmp与认证缓存。
四、三类 Agent 沙箱拓扑与工作负载特征
把所有 Agent 工具请求塞进同一种沙箱模板,必然在并发成本、存储延迟或图形渲染开销上顾此失彼。生产集群通常需要按交互形态拆分出三类独立拓扑:
| 拓扑类别 | 代表系统 / 基准 | 典型生命周期 | 推荐存储后端 | 网络策略 | 核心基础设施瓶颈 |
|---|---|---|---|---|---|
| 1. 短生命期代码执行与 RLVR 验证器 | SandboxFusion(verl
集成)、SWE-bench(ICLR 2024) |
秒级至分钟级;即用即毁(Stateless) | 内存盘 tmpfs(带容量硬顶)+
只读共享镜像 |
完全断网(Air-gapped) | 突发千级并发调度、PID/内存硬熔断、宿主机进程回收速度 |
| 2. 持久交互式编程工作区 | Claude Code / OpenHands / Devin 工作区 | 小时至天级;支持挂起休眠与恢复 | 块设备 virtio-blk + CoW
增量快照(避开重度 virtiofs) |
默认拒绝 + 宿主机白名单 L7 代理 | git/npm
小文件元数据延迟、大仓库预热(Hydration)、休眠盘与内存计费 |
| 3. 浏览器与桌面 Computer-Use | OSWorld(NeurIPS 2024)、Playwright/CDP 代理、Computer Use | 分钟级至小时级;会话独占 | CoW OS 镜像 + 隔离下载临时卷 | 深度审计白名单代理 + 剪贴板/下载 DLP | Headless CDP 提权面、SwiftShader CPU 软渲染飙高 vs GPU 直通成本 |
4.1 拓扑一:短生命期无状态执行与 RLVR 验证器
在后训练 RLVR(如 GRPO 对同一问题并行采样 \(16\text{–}64\) 条代码轨迹)和大规模评测流水线中,沙箱呈现极端的脉冲式并发(Burst Concurrency):训练步间静默,一旦 rollout 完成瞬间涌入数千次单测或脚本执行。
- SandboxFusion(ByteDance):面向多语言(Python、C++、Go、Rust、Java
等)代码与数学验证的开源执行框架,常作为
verl等 RL 框架的异步 HTTP 奖励后端(/run_code),通过max_concurrent并发队列、memory_limit_mb(如 \(1024\text{ MB}\))与严格超时(如 \(10\text{ s}\))将模型生成中的无限循环、内存泄漏与恶意片段快速截断并返回stdout/stderr与退出码。在架构边界上需要明确:原生 SandboxFusion 侧重可控后训练/评测集群的高吞吐容器隔离,一旦把同一接口开放给完全不可信的公网多租户代码,仍应把底层 worker 置于 gVisor Systrap 或 Firecracker MicroVM 之内,并用外置网络命名空间彻底断网。 - SWE-bench(Jimenez et al., ICLR
2024):收录了来自 \(12\) 个真实 Python 仓库的 \(2{,}294\) 个真实 GitHub Issue
与 PR 测试套件。其标准评测 harness 为每个 Issue 构建独立
Docker 镜像环境并核验
Fail-to-Pass与Pass-to-Pass测试集——这说明即便在评测领域,只要进入真实软件工程依赖树,执行环境就必须容纳异构版本库(特定 Python/Conda/系统库)的批量隔离运行,且执行结束后必须无条件销毁(Stateless Destroy)以消除测试污染;大规模并行运行 SWE-bench 评测(或 RLVR 轨迹验证)时,常结合本地只读镜像缓存与远端无服务器沙箱池消除宿主机磁盘镜像解包争抢。
4.2
拓扑二:持久交互式编程工作区与 virtiofs
元数据陷阱
当 Agent 充当长周期结对工程师,在数百 MB 仓库中连续执行
git grep、npm install、cargo test
时,工程瓶颈立刻转移到文件系统元数据路径与休眠状态管理:
virtiofsvsvirtio-blk的真实差距:许多基于 Kata Containers 的平台默认启用virtiofs,直接把宿主机目录通过vhost-user+ FUSE 协议挂载进 Guest(由宿主机virtiofsd进程配合共享内存后端读写),省去制作块镜像的麻烦。但git status和npm install会在毫秒级连发数万至数十万次stat、lookup、open、close元数据系统调用。在严格的缓存一致性设置(如cache=none)下,大量元数据检查无法由 Guest 内核本地消化,必须通过 virtio 队列往返宿主机virtiofsd——社区大量实测反馈这类小文件密集操作在未调优virtiofs上可退化到原生盘的十分之一乃至更慢;即便调宽cache=auto/always以缓存 dentry 与 inode 属性,仍受限于宿主机侧一致性边界与共享内存配置复杂度。相比之下,把代码工作区放在 Guest 独占的virtio-blk块设备(格式化为 ext4/XFS)上,所有目录树缓存与 inode 锁完全留在 Guest 自己的内核页缓存内,只在实际刷盘或未命中块数据时跨越虚拟化边界。- 仓库预水合(Repo Hydration)与 CoW
块分层:为了兼顾
virtio-blk的原生元数据速度与百毫秒级拉起,持久编码平台通常构建「热仓库块快照」——后台定期为高频开源仓库或企业 monorepo 构建包含.git索引、node_modules或.venv的只读基础块镜像,用户会话启动时仅创建一个 LVM thin-provisioning / DeviceMapper CoW 可写叠加层挂入virtio-blk,再执行一次增量git fetch,把原本数分钟的冷克隆压缩为数秒。 - 闲置休眠(Idle
Hibernation):人类开发者常在多轮交互间离开数小时。保持
MicroVM 长期空转内存极不划算;正确做法是在空闲超时(如 \(5\text{–}15\text{
min}\))后触发静默快照,将
vm.mem与增量块设备 diff 落盘至对象存储,彻底释放宿主机内存与 vCPU,等下一条用户消息到达时通过 REAP/UFFD 在百毫秒级原地唤醒。
4.3 拓扑三:浏览器与桌面 Computer-Use 沙箱
桌面与网页自动化存在两条差异巨大的隔离路径,由 OSWorld(Xie et al., NeurIPS 2024)与现代 Browser Use / Computer Use 工程实践共同划出边界:
- Headless Chromium + CDP 代理 vs
全桌面虚拟机:
- DOM/无障碍树路线(Playwright / Browser
Use):通过 Chrome DevTools
Protocol(CDP) 控制无头浏览器,观测简洁的 DOM 或
Accessibility Tree,单轮 token
开销远低于像素流。但基础设施工程师容易忽略一个致命漏洞:直接把原始
CDP WebSocket 暴露给 Agent
几乎等同于放弃沙箱——攻击者可通过
Browser.*、Target.createTarget("file:///etc/passwd")或Page.setDownloadBehavior读写沙箱敏感路径甚至操控浏览器进程参数。生产必须架设CDP 过滤代理,剥离特权域并限定允许导航的 URL Scheme(仅https://)。此外,在 Docker 内运行 Chromium 时切忌习惯性加上--no-sandbox——这会直接关闭 Chromium 自己的渲染器多进程seccomp隔离;把浏览器装进配置完整命名空间的 MicroVM 才能在不拆掉内部渲染沙箱的前提下稳定运行。 - 完整桌面路线(OSWorld / Anthropic Computer
Use):OSWorld 在 NeurIPS 2024
Datasets & Benchmarks 轨道发布了 \(369\)
个跨应用真实桌面任务(Ubuntu/Windows),通过 QEMU/KVM
虚拟机(或带
/dev/kvm的 Docker 容器)隔离完整 OS,暴露 \(1920 \times 1080\) 桌面截图与 Accessibility Tree,并以虚拟机快照确保每次评测从同一纯净桌面起点复现。在 Linux 无头服务端承载桌面渲染时,通常依赖Xvfb(X Virtual Framebuffer)或无头 Wayland 合成器(如 headless Weston)配合 VNC/WebRTC 推流。
- DOM/无障碍树路线(Playwright / Browser
Use):通过 Chrome DevTools
Protocol(CDP) 控制无头浏览器,观测简洁的 DOM 或
Accessibility Tree,单轮 token
开销远低于像素流。但基础设施工程师容易忽略一个致命漏洞:直接把原始
CDP WebSocket 暴露给 Agent
几乎等同于放弃沙箱——攻击者可通过
- SwiftShader CPU
软渲染陷阱与硬件成本:在没有物理 GPU
的云主机上,Headless Chromium 与桌面窗口合成器会自动回退到
SwiftShader(Google CPU 端 Vulkan/OpenGL ES
实现)或 Mesa
llvmpipe。一旦网页包含复杂 WebGL、Canvas 动画或视频解码,CPU 占用率会瞬间打满多核且帧延迟暴增。但若为每个桌面沙箱挂载直通 GPU 或切分 vGPU,不仅单实例云资源成本成倍跃升,还会破坏纯 CPU MicroVM 的高密度装箱与通用内存快照能力(GPU 显存上下文极难透明迁移)。因此工程上通常将「纯表单/文本网页」锁在无头轻量浏览器池,仅对明确需要图形加速的会话按需路由至带虚拟 GPU 节点,同时对双向剪贴板同步与下载目录执行外发 DLP 检查。
五、零信任出向网络与无凭据沙箱(Secretless Sandbox)
沙箱隔离防住了「向下攻破宿主机」,但如果允许沙箱任意访问内网与公网,被提示注入控制的
Agent 依然可以把工作区源码直接 POST
到攻击者服务器,或顺着云内网横向渗透。
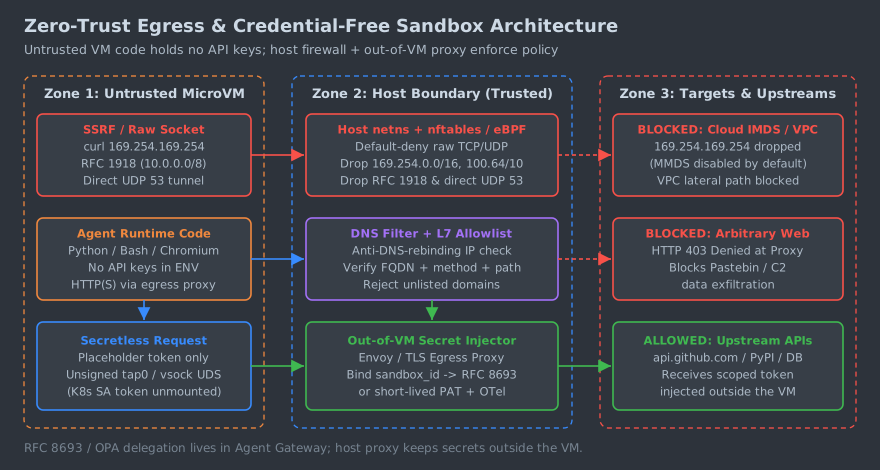
5.1 宿主机边界拦截与防 DNS Rebinding
任何写在沙箱内部的 iptables 或
HTTP_PROXY
环境变量都不能当作安全边界——拥有沙箱内 root 或
shell 权限的恶意代码可以轻松 unset HTTPS_PROXY
或直接构造 raw socket / UDP
隧道。网络控制面必须全部落在沙箱外部的宿主机网络命名空间(veth
/ tap 宿主机端):
- 内核态 L3/L4 默认拒绝(
nftables/ eBPF):出厂默认规则先drop一切直连公网 TCP/UDP 出向包,显式封堵链路本地元数据网段169.254.0.0/16(覆盖169.254.169.254)、运营商共享网段100.64.0.0/10(覆盖部分云内网元服务如100.100.100.200)以及全量 RFC 1918 私网地址段(10.0.0.0/8、172.16.0.0/12、192.168.0.0/16)与 IPv6 ULA (fc00::/7)/Link-Local (fe80::/10),同时拦截直连外部UDP/TCP 53端口,堵死基于 DNS 子域名编码的数据外泄信道。以下为宿主机每沙箱netns侧的参考nftables过滤策略模板(生产需按实际代理桥接网卡与 CIDR 调整):
table inet sandbox_egress {
  chain forward {
    type filter hook forward priority 0; policy drop;
    ct state established,related accept
    # 严禁访问云元数据、CGNAT 与全部 RFC 1918 私网
    ip daddr { 169.254.0.0/16, 100.64.0.0/10, 10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16, 127.0.0.0/8 } drop
    ip6 daddr { ::1/128, fc00::/7, fe80::/10 } drop
    # 阻断直连外部 UDP/TCP 53,防止 DNS 隧道外泄
    udp dport 53 drop
    tcp dport 53 drop
    # 仅放行来自沙箱 tap 接口前往宿主机 L7 出向代理端口的流量
    iifname "tap-sbx*" ip daddr 10.200.0.1 tcp dport 3128 accept
  }
}- 受控 DNS 解析与防 DNS
Rebinding:沙箱内所有域名解析收口到宿主机代理或隔离
DNS 解析器。在建立实际 TCP 连接前,代理必须对解析得到的目标
IP 再次核验——若攻击者控制的外网域名在第一次 TTL 过期后解析回
127.0.0.1或10.0.0.x(DNS Rebinding),代理在连接前直接拒绝建连。
5.2 沙箱外凭证注入(Out-of-VM Secret Injection)
在身份系列 落地架构 中,Agent Gateway 负责通过 RFC 8693 Token Exchange 获取代表用户的短生命周期最小权限令牌。落到执行沙箱这一层,必须贯彻无凭据沙箱(Secretless Sandbox)原则:
- 密钥零落地沙箱内部:沙箱内部进程、容器镜像与环境变量绝不出现真实
GitHub PAT、OpenAI API Key、数据库密码或云
AK/SK,只持有无特权的占位符(或通过受限
vsock/Unix Domain Socket 向宿主机代理发起请求)。 - 如何把密钥注入 HTTPS 流量:纯
HTTP CONNECT隧道代理只能看到目标域名而无法改写加密报文头,因此工程上存在两条显式边界路径:路径 A 是沙箱内明文 HTTP + 代理侧 TLS 升级——沙箱内 SDK(例如配置OPENAI_BASE_URL=http://proxy.internal/v1)经tap/Unix Socket 向宿主机代理发明文请求,由宿主机代理完成鉴权、注入真实Authorization头后再通过 HTTPS 转发上游;路径 B 是沙箱内注入受信任的组织内部拦截 CA 根证书,宿主机 TLS 代理仅对白名单内需要代签注入凭证的域名做 TLS 终结与头重写,而对证书固定(Certificate Pinning)或无需注入凭证的公共域名(如pypi.org)直接走普通 L7CONNECT透传,避免破坏端到端校验。所有代理放行与拒绝事件同步写入 OpenTelemetry 审计日志。
5.3
Kubernetes RuntimeClass
与最小权限沙箱清单示例
下面是一份可直接通过 Kubernetes Schema
校验的生产基线片段:通过 RuntimeClass
将调度路由到 Cloud Hypervisor 驱动的 Kata
MicroVM(kata-clh),借助
NetworkPolicy
封堵元数据与私网段、仅放行受控出口代理 CIDR,并在 Pod
内显式关闭
automountServiceAccountToken: false(防止沙箱内恶意代码直接读取
/var/run/secrets/kubernetes.io/serviceaccount/token
攻击集群 API Server):
apiVersion: node.k8s.io/v1
kind: RuntimeClass
metadata:
  name: kata-clh
handler: kata-clh
overhead:
  podFixed:
    memory: "128Mi"
    cpu: "250m"
scheduling:
  nodeSelector:
    sandbox-isolation: microvm-kvm
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: agent-sandbox-zero-trust-egress
  namespace: agent-sandboxes
spec:
  podSelector:
    matchLabels:
      app.kubernetes.io/component: untrusted-sandbox
  policyTypes:
    - Ingress
    - Egress
  ingress: [] # 禁止来自其他 Pod 的主动横向入向连接
  egress:
    # 仅允许访问宿主机/集群侧 L7 出向代理服务(示例 CIDR 需替换为集群真实代理网段)
    - to:
        - ipBlock:
            cidr: 10.96.10.0/24
      ports:
        - protocol: TCP
          port: 3128
    # 仅允许连接集群受控 DNS 解析器(若完全由代理代解析可进一步移除)
    - to:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: kube-system
          podSelector:
            matchLabels:
              k8s-app: kube-dns
      ports:
        - protocol: UDP
          port: 53
        - protocol: TCP
          port: 53
---
apiVersion: v1
kind: Pod
metadata:
  name: agent-code-runner-sample
  namespace: agent-sandboxes
  labels:
    app.kubernetes.io/component: untrusted-sandbox
spec:
  runtimeClassName: kata-clh
  automountServiceAccountToken: false
  enableServiceLinks: false
  restartPolicy: Never
  securityContext:
    runAsNonRoot: true
    runAsUser: 1000
    runAsGroup: 1000
    seccompProfile:
      type: RuntimeDefault
  containers:
    - name: runner
      image: ghcr.io/example/agent-python-runner:3.12-slim
      env:
        - name: HTTP_PROXY
          value: "http://10.96.10.10:3128"
        - name: HTTPS_PROXY
          value: "http://10.96.10.10:3128"
        - name: NO_PROXY
          value: "localhost,127.0.0.1"
      securityContext:
        allowPrivilegeEscalation: false
        readOnlyRootFilesystem: true
        capabilities:
          drop: ["ALL"]
      resources:
        requests:
          cpu: "500m"
          memory: "512Mi"
        limits:
          cpu: "2"
          memory: "1Gi"
      volumeMounts:
        - name: workspace
          mountPath: /workspace
        - name: tmpfs-run
          mountPath: /tmp
  volumes:
    - name: workspace
      emptyDir:
        sizeLimit: 2Gi
    - name: tmpfs-run
      emptyDir:
        medium: Memory
        sizeLimit: 256Mi
生产落地时还需注意两项边界:第一,标准 Kubernetes
NetworkPolicy 属于 L3/L4
放行,无法直接阻止沙箱绕过代理或做域名过滤,必须在节点网络插件(如
Cilium eBPF / nftables)和代理层配合实现
169.254.169.254/32 显式丢弃与 L7 FQDN
拦截;第二,enableServiceLinks: false
可以避免 Kubelet 把同命名空间 Service
IP/端口注入沙箱环境变量。
六、资源治理、突发容量分析模型与可观测账本
6.1 cgroups v2、IOPS 限流与计费可观测
多租户沙箱节点的稳定性依赖宿主机内核与 VMM 的硬配额收口:
- cgroups v2
与进程上限:为每个沙箱进程组设置
cpu.max、memory.max、memory.swap.max=0(防止 swap 抖动拖累同节点推理/沙箱)与严格的pids.max(如限制 \(256\text{–}512\) 个线程/进程),从根源封死fork炸弹。 - 设备级限流:Firecracker
内置令牌桶限流器,可对单实例
virtio-block的读写 IOPS 与字节吞吐带宽、virtio-net的网卡出向速率设定硬上限,避免单个异常循环写盘拖垮全宿主机 NVMe 队列深度。 - 计量与故障归因:结合 23:可观测性
的 Trace 框架,对每次沙箱执行记录
sandbox.tier(gvisor/kata/firecracker)、provision.mode(warm_pool/snapshot_reap/cold_boot)、provision.duration_ms、uffd.page_faults、峰值内存驻留rss_mb、出向 Proxy 域名拦截计数与exit_code。
6.2 参数化分析模型:突发延迟与预热池内存税
在容量规划时,平台团队常低估两笔互相咬合的账:预热池一旦被打穿后的尾延迟悬崖,以及不同工作负载维持 100% 预热池所需付出的闲置内存成本。以下使用一个明确假设的参数化分析模型(Analytical Model,非实测 benchmark)定量刻画二者的边界。
模型假设与公式:设单波同时到达的突发沙箱请求数为 \(B \in [1, 128]\)。冷启动单实例耗时 \(T_{\text{cold}} = 1{,}200\text{ ms}\)(宿主机并发引导槽位 \(C_{\text{cold}} = 16\));REAP/UFFD 快照恢复单实例耗时 \(T_{\text{snap}} = 180\text{ ms}\)(并发恢复槽位 \(C_{\text{snap}} = 32\));预热池深度为 \(W = 32\) 个就绪实例,命中池内分配控制面耗时 \(T_{\text{claim}} = 25\text{ ms}\),超出 \(W\) 的溢出请求回落到快照恢复队列。按离散波次排队计算最坏情况供给延迟:
\[ L_{\text{cold}}(B) = \left\lceil \frac{B}{C_{\text{cold}}} \right\rceil T_{\text{cold}}, \qquad L_{\text{snap}}(B) = \left\lceil \frac{B}{C_{\text{snap}}} \right\rceil T_{\text{snap}} \]
\[ L_{\text{pool}}(B) = \begin{cases} T_{\text{claim}}, & B \le W \\ \left\lceil \dfrac{B - W}{C_{\text{snap}}} \right\rceil T_{\text{snap}} + T_{\text{claim}}, & B > W \end{cases} \]
对于峰值需求 \(B_{\text{peak}} = 1{,}000\) 实例的集群,若保留比例为 \(p = W / B_{\text{peak}}\) 的闲置预热池,三类沙箱按单实例常驻内存(Python 执行器 \(192\text{ MB}\)、持久编码工作区 \(512\text{ MB}\)、桌面浏览器 \(1{,}536\text{ MB}\))折算的静态空闲内存占坑为 \(M_{\text{idle}} = p \cdot B_{\text{peak}} \cdot M_{\text{rss}}\)。可通过如下独立 Python 片段直接复算各档位精确值(下表与图 4 均由同一计算逻辑生成):
import math


def worst_case_latency_ms(burst: int, w_pool: int = 32) -> tuple[int, int, int]:
    cold = math.ceil(burst / 16) * 1200
    snap = math.ceil(burst / 32) * 180
    if burst <= w_pool:
        pool = 25
    else:
        pool = math.ceil((burst - w_pool) / 32) * 180 + 25
    return cold, snap, pool


for b in (1, 16, 32, 33, 64, 96, 128):
    c, s, p = worst_case_latency_ms(b)
    print(f"B={b:3d}: cold={c:4d} ms, snap_reap={s:3d} ms, warm_pool(W=32)={p:3d} ms")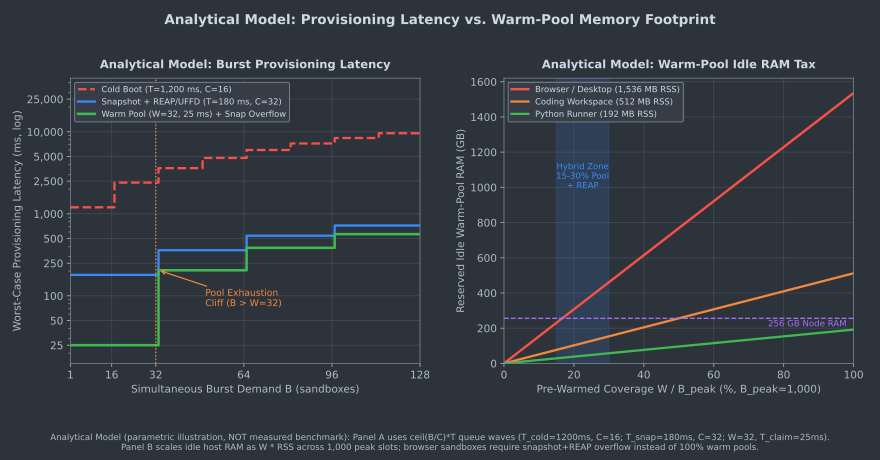
执行上述参数化分析模型可得清晰的数量级拐点:
| 突发并发 \(B\) | 冷启动 \(L_{\text{cold}}\) | REAP 快照恢复 \(L_{\text{snap}}\) | 预热池(\(W=32\))+ 溢出 \(L_{\text{pool}}\) | 工程含义 |
|---|---|---|---|---|
| \(1\text{–}16\) | \(1{,}200\text{ ms}\) | \(180\text{ ms}\) | \(25\text{ ms}\) | 池内秒级分配,交互体感极佳 |
| \(32\) | \(2{,}400\text{ ms}\) | \(180\text{ ms}\) | \(25\text{ ms}\) | 恰好打满预热池容量边界 |
| \(33\) | \(3{,}600\text{ ms}\) | \(360\text{ ms}\) | \(205\text{ ms}\) | 预热池耗尽悬崖(\(B > W\)):第 33 个请求瞬间跳回快照恢复速度 |
| \(64\) | \(4{,}800\text{ ms}\) | \(360\text{ ms}\) | \(205\text{ ms}\) | 快照流水线决定溢出吞吐天花板 |
| \(128\) | \(9{,}600\text{ ms}\) | \(720\text{ ms}\) | \(565\text{ ms}\) | 若无 REAP 级快照恢复,全冷启动将退化近 10 秒 |
右图进一步揭示了全预热策略的内存天花板:按 \(B_{\text{peak}} = 1{,}000\) 计,\(100\%\) 全预热 Python 执行器仅占 \(192.0\text{ GB}\) 闲置内存,而持久工作区达 \(512.0\text{ GB}\)、桌面/浏览器沙箱则飙升至 \(1{,}536.0\text{ GB}\)(远超单台 \(256\text{ GB}\) 服务器内存上限)。因此容量工程上的核心准则并非追求 \(100\%\) 命中预热池,而是按两条互补规则定容:
- 预热池深度 \(W\) 瞄准稳态短时突发的 P95 到达量(而非历史极值峰值):在该参数模型下,保持 \(15\%\text{–}30\%\) 覆盖率(例如 \(W = 200\) 时,Python 仅占 \(38.4\text{ GB}\)、工作区 \(102.4\text{ GB}\)、桌面 \(307.2\text{ GB}\))即可拦截日常绝大多数交互式毛刺。
- 溢出斜率完全由快照并发槽位 \(C_{\text{snap}}\) 与 \(T_{\text{snap}}\) 决定:当突发超出 \(W\)(\(B > W\)),真正避免雪崩的不是继续加内存囤积预热池,而是通过 REAP 顺序预取把 \(T_{\text{snap}}\) 压进 \(200\text{ ms}\) 内,并给宿主 NVMe 留足并发恢复槽位 \(C_{\text{snap}}\)。若模型中单实例恢复因缺失 REAP 退化到 \(T_{\text{snap}} = 900\text{ ms}\) 级随机缺页,则同样 \(B = 128\) 突发下的溢出延迟会同步放大 \(5\times\)。
七、学术谱系、活跃争论与开放问题
7.1 学术谱系与演进分叉
现代 Agent 执行沙箱并非从零发明,而是沿三条经顶会同行评审确立的系统研究主线演化分叉:
- 轻量硬件虚拟化奠基:Firecracker(Agache et al., USENIX NSDI 2020)证明了通过 Rust VMM 剥离遗留模拟设备并收窄 Virtio 接口,可以在保留 KVM 硬件页表隔离的前提下把单个 VM 开销压进容器量级(\(<5\text{ MB}\)、百毫秒级启动)。
- 快照状态化与按需恢复演进:Catalyzer(Du
et al., ASPLOS 2020)在 gVisor
上系统化提出去初始化快照恢复与
sfork沙箱分支原语;REAP(Ustiugov et al., ASPLOS 2021)随后定量解剖了服务器无状态快照的userfaultfd缺页风暴,利用工作集稳定性将顺序预取引入生产冷启路径,构成了今日 E2B 等云沙箱的理论基石。 - Agent 任务驱动沙箱拓扑分化:SWE-bench(Jimenez et al., ICLR 2024)把真实代码仓库与多版本隔离测试套件推成软件工程基准;OSWorld(Xie et al., NeurIPS 2024)则把评估扩展到完整 Ubuntu/Windows 桌面虚拟机的跨应用交互与快照复位,促使沙箱平台从单一「代码解释器」分裂出无状态验算器、持久块工作区与桌面浏览器三条并行设施栈。
7.2 工程与学界的三项活跃争论
- KVM MicroVM vs gVisor Systrap(硬件边界 vs
无嵌套虚拟化普适性):
- MicroVM
派认为只有硬件页表(EPT/NPT)和独立 Guest
内核才配承接不可信代码多租户隔离,且对高频文件元数据/
fork任务税率更低(代表实践:Firecracker NSDI 2020、Katakata-clh); - Systrap
派指出大量云原生集群运行在未开放
/dev/kvm嵌套虚拟化的标准云虚机上,购买裸金属实例会大幅抬高运维门槛与碎片成本,而 Systrap 凭借SECCOMP_RET_TRAP+ 共享内存已将绝大多数 syscall 税率压入可接受区间(gVisor 2023 发布及 Google 托管无服务器实践)。工程分水岭很明确:能拿裸金属或嵌套 KVM 的强对抗多租户走 MicroVM;受限于普通云 VM 的容器集群优先用 gVisor Systrap。
- MicroVM
派认为只有硬件页表(EPT/NPT)和独立 Guest
内核才配承接不可信代码多租户隔离,且对高频文件元数据/
- 全量预读(Eager Load)vs
userfaultfd惰性恢复(Lazy Paging):- 全量预读启动延迟高,但一旦唤醒便无运行时缺页抖动;纯 UFFD 恢复号称「百毫秒拉起」,却把延迟暗暗转移到业务代码首次触摸内存页时的尾延迟飙升(REAP ASPLOS 2021 的核心反例)。当前工业折中是以 REAP 式热工作集顺序预取 + UFFD 尾页兜底替代两个极端。
- 单次调用即毁(Ephemeral per-call)vs
长生命期有状态工作区(Long-lived stateful):
- Ephemeral 派(如 RLVR Verifier 与 SWE-bench
评测)追求零状态漂移与绝对复现,但每轮重复
git clone和安装依赖浪费大量带宽;Stateful 派(编程 Agent 工作区)保留本地增量构建缓存提升多轮速度,却带来了环境状态污染、virtiofs性能陷阱与休眠计费复杂度。
- Ephemeral 派(如 RLVR Verifier 与 SWE-bench
评测)追求零状态漂移与绝对复现,但每轮重复
7.3 三个尚未彻底解决的开放问题
- 多租户 GPU 直通沙箱与亚秒级显存快照:当
Agent 执行本地 CUDA Kernel 调优(参见 30:推理算子与内核)、实时视频处理或高帧率
WebGL 桌面任务时,CPU MicroVM
无法提供足够图形/张量算力;而传统 NVIDIA MIG/vGPU
切分粒度较粗,驱动栈(内核模块 + CUDA 运行时)暴露了远大于
virtio的攻击面,且缺乏类似 CPUvm.mem+ REAP 的亚秒级 GPU 状态快照迁移原语(可追踪 OSDI/SOSP 虚拟化及机密 GPU 计算 TEE-I/O 方向演进)。 - 可验证的文件系统差分与事务化回滚(Verifiable FS
Diffs & Undo):现有沙箱大多在执行后靠
git diff检查文本变更,难以对包含二进制构建产物、SQLite 数据库写改与多子进程并发副作用的工作区给出原子级、低开销且可密码学验证的状态差分与瞬时回滚(Undo),限制了上层 Agent 对非幂等动作的补偿能力。 - 跨网络 I/O 与非确定性时钟的位级确定性重放(Deterministic Replay):无论是 RLVR 奖励排查还是线上安全事件取证,工程师都需要精确复现某次出错轨迹;但只要沙箱与外部代理网络通信、读取真实墙钟或存在多线程调度,常规 VM 快照恢复便无法保证复现结果一致。如何把轻量级 record-and-replay 虚拟化层与确定性网络存根(Stubbing)低开销嵌入高频沙箱,仍缺乏成熟的开源标准实现。
八、生产选型决策与排障自检清单
选型可先按「云硬件前提 \(\rightarrow\) 任务拓扑」两条约束收敛:
flowchart TD
  Start["Untrusted Agent Workload"] --> Q1{"Has /dev/kvm?"}
  Q1 -- "No (Standard Cloud VM)" --> GV["Tier 2: gVisor runsc (Systrap)"]
  Q1 -- "Yes (Bare-metal / Nested KVM)" --> Q2{"Workload Topology?"}
  Q2 -- "Ephemeral Code / RLVR" --> FC["Firecracker + tmpfs + Air-gapped"]
  Q2 -- "Persistent Coding Repo" --> BLK["Kata (CLH) / Firecracker + virtio-blk + REAP"]
  Q2 -- "Browser / Desktop GUI" --> GUI{"Need Full Desktop OS?"}
  GUI -- "No (DOM / Web Only)" --> CDP["MicroVM + Headless Chromium + CDP Proxy"]
GUI -- "Yes (Cross-App GUI)" --> X11["KVM Desktop VM (Xvfb/Wayland) + Snapshot"]常见故障排查对照表:
| 故障现象 | 常见底层根因 | 工程修复动作 |
|---|---|---|
| 快照拉起百毫秒,但首次运行 Python 脚本 P99 达数秒 | userfaultfd 纯惰性缺页触发随机 4 KB
缺页风暴 |
采集模板稳态工作集并改用 REAP 式顺序预取后再暴露
UFFD |
| 并发克隆沙箱出现 TLS 握手冲突或重复临时 UUID | 共享父内存快照导致内核 CSPRNG 熵池未重置 | 恢复时向 VMGenID 写入新 ID 触发
add_vmfork_randomness() 并挂
virtio-rng |
编码工作区 git status /
npm install 比本地慢一个数量级 |
Kata 默认 virtiofs
(cache=none) 往返 virtiofsd
元数据税 |
切换 Guest 独占 virtio-blk(ext4/XFS)+
仓库基础块镜像 CoW 挂载 |
容器内 Chromium 启动报错后开发人员加上
--no-sandbox |
缺失用户命名空间或挂载权限,加参数直接废除渲染器沙箱 | 将浏览器放入独立内核的 MicroVM 或补全
seccomp/userns 权限而非禁用沙箱 |
| 无 GPU 宿主机上浏览器沙箱 CPU 长期飙至 100% | WebGL/Canvas 页面触发 SwiftShader CPU 软件光栅化 | 拆分静态 DOM 池与 GPU 加速桌面池;仅复杂图形会话路由至 GPU 节点 |
已配 HTTP_PROXY 却依然抓到沙箱访问内网或
IMDS |
沙箱内代码主动 unset 环境变量或直连原始
IP/UDP 53 |
将默认拒绝与 169.254.0.0/16/RFC 1918
封堵下沉到宿主机 netns
nftables/eBPF |
上线前 10 项工程自检:
- 内核与运行时边界:确认未在多租户生产把
runc当强隔离防线;宿主内核禁用或以seccomp拦截io_uring;升级runc修复 CVE-2024-21626 类文件描述符泄漏。 - K8s 凭据剥离:所有沙箱 Pod 强制设置
automountServiceAccountToken: false与enableServiceLinks: false,同时配置readOnlyRootFilesystem: true与capabilities.drop: ["ALL"]。 - 快照克隆防重:如果启用 MicroVM
快照克隆,验证 Guest 内核已启用
VMGenID(Linux \(\ge 5.18\) ACPI 或带对应 ARM64 驱动),且每次恢复均注入新生成 ID、挂载virtio-rng并重置 MAC/IP/主机名与时钟。 - 缺页风暴评估:对于 \(>512\text{ MB}\)
内存模板开启
userfaultfd时,压测首次调用 P99;若存在明显毛刺,引入类似 REAP 的冷启工作集顺序预取。 - 预热池容量边界:根据第 6 节模型核算突发峰 \(W\) 耗尽后的回落斜率与闲置内存成本,避免对重内存桌面沙箱盲目开 \(100\%\) 预热池。
- 存储与小文件匹配:运行
git/npm/cargo的持久编码工作区若遇编译与检出奇慢,核查是否误用了低缓存配置的virtiofs,优先切换virtio-blk+ CoW 块快照。 - 出向网段与 IMDS 封堵:在宿主机
netns/eBPF 层显式drop169.254.0.0/16、100.64.0.0/10、RFC 1918 私网段及直连 UDP 53;确认 Firecracker MMDS 如无需使用保持禁用。 - 无凭据代理与 DNS 防御:验证沙箱
env与镜像内无任何上游 API Secret;L7 出向代理在建连前执行解析后 IP 核验(防 DNS Rebinding)并强制域名/方法白名单。 - 浏览器与桌面陷阱:无头浏览器严禁盲加
--no-sandbox,且必须通过 CDP 代理拦截特权调试域;GPU-less 节点跑大量 WebGL/Canvas 页面时监控 SwiftShader CPU 抢占,并对下载目录和剪贴板开启 DLP。 - 资源硬熔断:cgroups v2 配齐
memory.max、memory.swap.max=0、pids.max与cpu.max;对virtio-blk/virtio-net启用令牌桶限流。
九、小结
Agent 基础设施的四块拼图至此闭环:19 与 20 规范模型如何规划与调用工具,Agent 身份与安全 界定代理代表谁、持有哪些最小委托权限,24 用输入/输出护栏与合规框架挡住已知风险,而本篇拆解的沙箱与隔离运行时则确保当前面三层防线被新型间接注入突破、模型在执行器内拿到任意代码执行权时,爆炸半径依然被物理与操作系统边界死死锁在一台无凭据、可瞬时销毁的 MicroVM 之内。
工程落地的三条底线:不依赖共享宿主机内核的容器做多租户对抗边界;不在无
VMGenID/网络重绑定和 REAP
式预取验证的前提下盲目克隆快照;不把任何上游密钥放进沙箱进程可见的环境变量或内存空间。
参考资料
规范与文档
- Linux Kernel Documentation & Source:
drivers/virt/vmgenid.c(Virtual Machine Generation ID 与add_vmfork_randomness(),Linux 5.18+);Linux Landlock LSM Documentation(ABI v1–v4);kernel.io_uring_disabledsysctl 规范。 - AWS Firecracker Documentation: Snapshotting
& Randomness for Clones
(
docs/snapshotting/random-for-clones.md)、Jailer & Seccomp Setup 与 MMDS User Guide。 - gVisor Official Blog & Docs: Systrap: A New gVisor Platform(2023-04)与 Platforms Guide。
- Kubernetes SIG Apps & Kata Containers Docs: RuntimeClass
Specification、Kata
Containers Architecture & Storage (
virtiofs/virtio-blk)。 - Snyk / OCI Security Advisory: CVE-2024-21626
(“Leaky Vessels”): runc process.cwd & leaked fds
container breakout(2024-01,于
runc >= 1.1.12修复)。
核心论文
- Agache, A., Brooker, M., Iordache, A., Liguori, A., Neugebauer, R., Piwonka, P., & Popa, D.-M. Firecracker: Lightweight Virtualization for Serverless Applications. USENIX NSDI 2020.
- Du, D., Yu, T., Xia, Y., Zang, B., Yan, G., Qin, C., Wu, Q., & Chen, H. Catalyzer: Sub-millisecond Startup for Serverless Computing with Initialization-less Booting. ACM ASPLOS 2020.
- Ustiugov, D., Petrov, P., Kogias, M., Bugnion, E., & Grot, B. Benchmarking, Analysis, and Optimization of Serverless Function Snapshots (REAP). ACM ASPLOS 2021.
- Jimenez, C. E., Yang, J., Wettig, A., Yao, S., Pei, K., Press, O., & Narasimhan, K. SWE-bench: Can Language Models Resolve Real-World GitHub Issues? ICLR 2024(Oral).
- Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments. NeurIPS 2024(Datasets and Benchmarks Track).
开源项目与源码
- Firecracker: https://github.com/firecracker-microvm/firecracker
- gVisor (
runsc): https://github.com/google/gvisor - Kata Containers & Cloud Hypervisor: https://github.com/kata-containers/kata-containers · https://github.com/cloud-hypervisor/cloud-hypervisor
- E2B Infrastructure
(
e2b-dev/infra): https://github.com/e2b-dev/infra(Firecracker +userfaultfd+envd+nftables节点编排参考实现) - Kubernetes SIG Apps Agent Sandbox
(
kubernetes-sigs/agent-sandbox): https://github.com/kubernetes-sigs/agent-sandbox - ByteDance SandboxFusion: https://github.com/bytedance/SandboxFusion(多语言代码执行与 RLVR 异步验证服务)
- Anthropic Sandbox Runtime
(
@anthropic-ai/sandbox-runtime): https://github.com/anthropics/sandbox-runtime(本地bubblewrap/OS 命名空间与 Unix Domain Socket 代理沙箱)
上一篇:34:多模态与视频生成(DiT / 全模态)推理基础设施
源码下载
本文相关源码已整理,共 1 个文件。
文章导航
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【大模型基础设施工程】19:Agent 框架工程
从 ReAct 与 Workflows/Agents 光谱到 LangGraph、Claude Agent SDK、OpenAI Agents SDK、Google ADK、Microsoft Agent Framework,解析状态图、Skills、MCP/A2A 协议与沙箱隔离。
【大模型基础设施工程】20:工具调用与 MCP
深入 Function Calling、Pre-Softmax 约束解码(XGrammar / llguidance)、MCP 2025-06-18/11-25(Streamable HTTP / OAuth 2.1 RFC 9728/8707 / Tasks)与工具安全边界。
【大模型基础设施工程】24:成本、合规与安全
从卡时、电费到 AI Act 与 Prompt Injection——一份写给基础设施工程师的大模型成本、合规、安全三位一体手册。
【大模型基础设施工程·特别篇】33:RLVR 与 Agentic 后训练基础设施实战
围绕长 CoT RLVR 与多轮 Agentic 后训练,拆解长尾掉队气泡、HybridFlow/slime/AReaL/StreamRL/PipelineRL 异步架构、训推数值失配(DAPO/GSPO/TIS)、验证沙箱与权重热同步工程。