把视觉理解、视频扩散生成和实时语音对话直接塞进现网的纯文本推理集群,通常会第一时间暴露出三类难以靠调参解决的故障:一张高分辨率截图把同批正在流式输出的文本请求卡出数百毫秒毛刺;一条 1080p 视频在去噪全部跑完后,死在最后一步 3D VAE 解码的显存溢出(OOM);一条语音对话因为级联等待停顿和半双工锁死,端到端响应退化到 1–2 秒。
根因在于纯文本连续批处理(Continuous Batching)引擎——包括我们在 11:推理引擎基础 与 21:推理服务化 中拆解的标准 PD 分离与 PagedAttention 调度器——只围绕“逐 token 自回归步进 + 单调追加 KV Cache”这一种物理契约设计。一旦进入多模态与全模态(Omni-Modal)领域,基础设施面对的是三套计算图、访存特征与实时性约束截然不同的推理栈:VLM / Any-to-Any 理解、Video DiT 扩散生成与全双工语音流式。本文沿资源隔离、并行切分、近似加速与硬实时调度四条主线,逐层拆解这三套推理栈的成本账本、开源工程落地与学术边界。
〇、30 秒版
- 纯文本引擎失灵的物理根源:VLM 编码器脉冲破坏单步迭代预算造成队头阻塞;Video DiT 是非自回归的 \(O(N^2)\) 双向全注意力与 5D 卷积 VAE 解码,不适用单调 KV 追加;全双工语音则受限于固定 80 ms 帧节拍(frame tick)与插话回滚,吞吐优先调度会让音频流断帧。
- VLM 理解栈走向 EPD 分离:将
Encode(ViT/Audio)、Prefill 与 Decode
解耦为独立伸缩池(vLLM
ECConnector、NVIDIA Dynamo + NIXL、Cornserve 的 Model Fission),配合视觉嵌入缓存跳过重复编码;生产级服务仍需补齐独立 VE 负载均衡(正如 28:DeepInfer 暴露的开源边界),且小图场景存在序列化/网络反超风险。 - Video DiT 的核心账本是平方注意力与 3D VAE 尖峰:以 Wan2.1-14B 类参数做解析推导,50 步 CFG=2 下 480p 2s(14,040 token)Attention 占总算力 27.6%,而 1080p 10s(334,560 token)飙升至 10.17 EFLOPs、Attention 占比达 90.1%;末端 3D VAE 解码仅中间特征就能吃掉 40+ GB 显存,必须依赖时空分块(Tiling)且不能盲目 FP8 量化。
- DiT 加速靠 4D
混合并行与条件时序缓存:
xDiT组合CFG × USP(Ulysses × Ring)与PipeFusion(1 步过期激活的 patch 流水线,适配 PCIe/以太网);TeaCache(CVPR 2025)通过时间步调制输入 L1 差值与多项式重标定自适应跳过重复步,但步数蒸馏压到 4–8 步后,过期激活与缓存跳步的画质退化会急剧放大。 - 全双工语音绕开级联停顿:级联
VAD → ASR → LLM → TTS累积 800–2,000 ms 延迟;原生方案走 Moshi(Mimi 12.5 Hz 编解码 + 7B Temporal/Depth Transformer + 内心独白)或 Qwen2.5-Omni(Thinker-Talker + TMRoPE + 滑窗 DiT),运行时围绕 WebRTC 20 ms Opus 封包、抖动缓冲与插话(barge-in)KV 回滚守住 P99 尾延迟。
一、为什么纯文本连续批处理引擎在多模态下会失灵
在 11:推理引擎基础 中,文本推理的优化围绕两条假设成立:所有请求共享同一个 Transformer 主干;每步 Decode 只追加 1 个 token 的 KV Cache,因此调度器可以把多条请求精确打包进 20–40 ms 一次的迭代步。而在 25:大模型基础设施未来 梳理的世界模型、多模态理解与实时交互浪潮下,三类多模态工作负载从不同维度击穿了纯文本调度器的基本前提:
| 维度 | VLM / Any-to-Any 理解 | Video DiT 视频生成 | 全双工语音流式(Omni Speech) |
|---|---|---|---|
| 执行图结构 | 异构有向无环图(Media Decode → ViT → LLM P/D → 可选生成器) | 3D VAE Encoder(I2V) → \(S\) 步双向 DiT 迭代去噪 → 3D VAE Decoder | 连续双向流(Mimi/音频编码 → 固定节拍 AR/Thinker → 流式声码器) |
| 序列与内存尖峰 | 单张高分图可膨胀至数千 token,1 分钟视频可达万级;ViT 中间激活脉冲大 | 潜空间序列 \(N_{\text{lat}}\) 达 \(1.4\times 10^4\text{–}3.3\times 10^5\);无递增 KV,但末端 3D VAE 5D 激活暴涨 | 音频帧率低(如 12.5 Hz),KV 总量小,显存主要消耗在权重常驻与并行流式状态 |
| 对纯文本调度器的破坏 | CPU 解码/resize 阻塞事件循环;ViT 独占 GPU 引发 Decode 队头阻塞(HoL) | 无法与文本请求混批;长序列无因果掩码,不能用单调前缀树或逐 token 抢占 | 追求大 batch 吞吐会击穿 80 ms 帧期限;用户随时插话要求中断与状态回滚 |
| 首要 SLO 指标 | TTFT、Decode ITL P99 | 整片端到端生成耗时(数十秒至分钟级)与显存峰值 | 音频首包延迟(\(<250\text{ ms}\))与 P99 帧按时交付率(zero underrun) |
具体到现场故障模式,三套系统的失灵方式截然不同:
- VLM 理解破坏的是迭代周期一致性:纯文本引擎假定一条 2,000 token 的 Chunked Prefill 可以在数毫秒内被切片让位给在途 Decode。但当同一 Worker 收到包含多张高分截图的请求时,CPU 端图像解码先吃紧 Python 异步循环,接着 ViT 编码器作为独立大前向算子一次性占用 SM 和显存工作区,在途纯文本请求的 ITL 立刻从 25 ms 跳变到数百毫秒,引发典型的跨模态队头阻塞(Cross-Modal Head-of-Line Blocking)。
- Video DiT 破坏的是“KV 递增 + 因果前缀”抽象:DiT 既没有单调递增的 KV Cache,也不存在因果掩码下三角稀疏性。每一步去噪都要在全部 \(N_{\text{lat}}\) 个时空 token 上重算完整的双向 \(Q, K, V\),且工作集瓶颈不在权重搬运,而在平方级时空注意力算力与结尾阶段 3D VAE 还原像素时的巨型 5D 卷积激活张量。
- 全双工语音破坏的是“吞吐优先”排队论:文本服务端习惯靠攒批把 GPU 利用率推高,容忍单请求百毫秒排队;语音通话必须对齐音频编解码器的固定时间片(如每 80 ms 交付一帧语音 token),任何超期都会直接听成电流爆音或停顿。前缀与 KV 跨节点池化复用基础见 32:存储分层 KV Cache,下文分别拆解这三套推理栈。
二、VLM 理解栈与 EPD(Encode-Prefill-Decode)分离
2.1 动态分辨率 ViT 的 Token 爆炸与 CPU 前处理瓶颈
早期固定分辨率视觉编码器(例如将所有图片强制缩放到 \(336 \times 336\))只需固定数量的视觉 token,但会丢失文档 OCR、界面截图与密集表格的细粒度文字。现代 VLM 普遍转向两条动态分辨率路线:
- 切块网格路线(AnyRes):以 LLaVA-NeXT 为代表,保留一张低分辨率全局缩略图,再按原图长宽比切分为 \(2 \times 2\) 等局部子图,全部独立送入 ViT,视觉 token 数按激活子图网格数倍增。
- 原生动态分辨率路线:以
Qwen2-VL(Wang、Bai
等,
arXiv:2409.12191,arXiv 预印本,未经同行评审)与 Qwen2.5-VL(Bai 等,arXiv:2502.13923,arXiv 预印本,未经同行评审)为代表,ViT 以 \(14 \times 14\) 像素切分 patch 并采用 2D/M-RoPE,随后通过 MLP Patch Merger 将空间相邻的 \(2 \times 2\) 块合并为 1 个进入 LLM 的视觉 token,即每 \(28 \times 28\) 像素对应 1 个 LLM 视觉 token。
按 \(28 \times 28\) 对齐粒度可直接算出输入载荷量级(按 BF16 每元素 2 字节计算):
| 输入形态 | 分辨率与帧数 | 视觉 token 数 \(N_{\text{vis}}\) | BF16 嵌入大小(\(D=3584\)) | BF16 嵌入大小(\(D=5120\)) | 基础设施含义 |
|---|---|---|---|---|---|
| 缩略图 / 图标 | \(224 \times 224\)(1 帧) | 64 | 0.459 MB(458.8 KB) | 0.655 MB | 算力极轻,远程拆池的 RPC 与序列化开销易反超本地编码 |
| 高分 UI 截图 | \(1960 \times 1400\)(1 帧) | 3,500 | 25.09 MB | 35.84 MB | ViT 激活脉冲明显,需与 Decode 池隔离避免拖垮 ITL |
| 短视频抽帧 | \(560 \times 560\)(60 帧,时域 stride 2) | 12,000 | 86.02 MB | 122.88 MB | CPU 解码与 ViT 计算双双成为瓶颈,跨池必须走 RDMA 零拷贝 |
在请求进入 GPU 之前,瓶颈往往先出现在 CPU
侧:libjpeg/PNG/H.264
解码、色彩空间转换、动态按 28 的倍数缩放与归一化都会消耗可观
CPU 周期。在传统单进程引擎里,多核图像处理如果直接挤占 API
Server 与 Scheduler 所在主机
CPU,会导致网络协程心跳抖动;而在 GPU 侧,单次 12,000 token
的 ViT 密集前向会瞬间打满 SM 与激活工作区,Chunked Prefill
也无法在不破坏整张图全空间自注意力的前提下把单张图片拆成多轮微步。
2.2 EPD 分离、Vision Embedding Cache 与 Cornserve Model Fission
继纯文本 PD 分离(DistServe,Zhong 等,OSDI 2024;Mooncake,Qin 等,USENIX FAST 2025 Best Paper)之后,多模态服务进一步演进为 EPD(Encode-Prefill-Decode)三层分离:
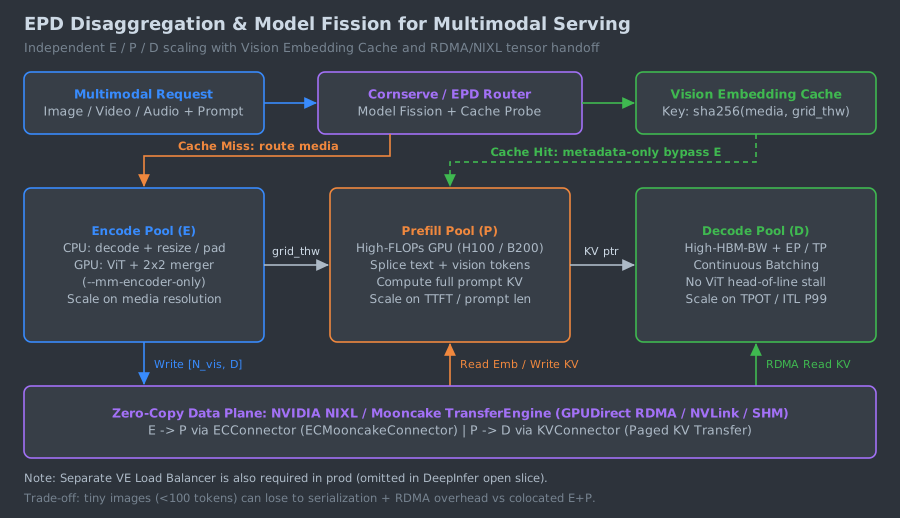
图 1 展示了生产级 EPD 的三条核心机制:
- 三池独立算力选型与弹性伸缩:Encode Pool(E)只加载轻量的图像前处理与 ViT 编码器,可以部署在显存较小但单卡算力性价比更高的计算卡(如 L40S / H20)上,按媒体分辨率和输入 QPS 独立扩缩;Prefill Pool(P)专攻高算力长上下文融合;Decode Pool(D)专攻高 HBM 带宽与连续批处理(参见 21:推理服务化)。
- Vision Embedding
Cache(视觉嵌入缓存):在多轮图文问答、Agent
重复截图对比、或大量用户询问同一份商品视频/海报时,图片字节流往往跨请求不变。前端路由按标准化键查询分布式视觉嵌入缓存:一旦命中,直接跳过
E 池,仅向 P 池转发轻量元数据(
grid_thw形状与缓存指针,即 metadata-only routing),将视觉特征直接从内存池拉入 LLM 输入槽位。缓存键构造必须包含模型权重版本、grid_thw与spatial_merge参数——如果只对原始媒体字节做哈希,同一张图在不同分辨率上限策略下缩放成不同grid_thw时,就会把错误长度的嵌入切片塞进下游 LLM:
import hashlib


def vision_cache_key(
    media_bytes: bytes,
    model_id: str,
    model_rev: str,
    grid_thw: tuple[int, int, int],
    spatial_merge: int = 2,
) -> str:
    h = hashlib.sha256()
    for part in (model_id, model_rev, str(grid_thw), str(spatial_merge)):
        h.update(part.encode("utf-8"))
        h.update(b"\x00")
    h.update(media_bytes)
return h.hexdigest()- Model Fission
与组件共享(Cornserve):Cornserve(Chung、Ma
等,
arXiv:2603.12118,arXiv 预印本,未经同行评审,系统演示入选 ACM CAIS 2026)将这一拆分推广到任意输入输出的 Any-to-Any 模型(如同时挂载视觉编码器、音频编码器、LLM 主干与图像/音频生成头)。其核心思想是 Model Fission(模型裂变)与自动规划器 Cornfigurator:把单体多模态模型拆解为可跨工作流复用的独立微服务组件(例如多个业务共享同一套 ViT 编码微服务),通过记录-重放执行图追踪张量依赖,并基于离线算力/带宽画像决定哪些组件应当共池、哪些应当拆池。在其论文评测的多模态混合负载下,Cornserve 报告相比单体部署取得最高 \(3.81\times\) 吞吐提升与 \(5.79\times\) 尾延迟下降(属作者自测实验口径)。
2.3 跨池嵌入传输协议与生产真实边界
在开源工程侧,EPD 已形成清晰的数据面协议:
- vLLM EPD:通过
--mm-encoder-only让 E 实例彻底跳过分配 LLM 权重,并利用--ec-transfer-config指定 Encoder Cache 连接器。调试期可用ECSharedStorageConnector经共享目录或/dev/shm传递;生产环境则对接ECMooncakeConnector,底层调用 Mooncake TransferEngine 经 GPUDirect RDMA 或 TCP 零拷贝把[N_vis, D_llm]嵌入张量推送给 P/PD 节点。 - NVIDIA Dynamo + NIXL:Dynamo 支持
E/PD与全分离E/P/D两种拓扑,通过 NIXL(NVIDIA Inference Transfer Library)在E → P(视觉嵌入)与P → D(分页 KV 块)之间统一抽象跨卡传递——节点内自动走cudaIpc/ NVLink 共享句柄,跨节点走注册好 RDMA Memory Region 的 IB/RoCE 异步非阻塞读写。对 86–123 MB 的短视频嵌入而言,400 Gbps(50 GB/s)RDMA 传输理论仅耗 ~2–3 ms,无需经过主机 CPU 内存与用户态 Socket 反复拷贝。
下面是一组基于 vLLM 公开 EPD 文档结构的生产配置示例(以
ECMooncakeConnector
配置语义为例,未在本机 GPU
集群执行,实际部署需安装对应
mooncake-transfer-engine 并配置网卡/RDMA
设备):
# Encode 实例(Producer):仅挂载视觉编码器,跳过 LLM 主干权重
vllm serve Qwen/Qwen2.5-VL-7B-Instruct \
  --port 8001 \
  --mm-encoder-only \
  --ec-transfer-config '{
    "ec_connector": "ECMooncakeConnector",
    "ec_role": "ec_producer",
    "ec_connector_extra_config": {
      "mooncake_protocol": "rdma"
    }
  }'

# Prefill/Decode 实例(Consumer):接收外部视觉嵌入并融合文本前缀
vllm serve Qwen/Qwen2.5-VL-7B-Instruct \
  --port 8000 \
  --ec-transfer-config '{
    "ec_connector": "ECMooncakeConnector",
    "ec_role": "ec_consumer",
    "ec_connector_extra_config": {
      "mooncake_protocol": "rdma"
    }
  }'
需要特别指出一个容易被忽视的生产现实边界:正如我们在 28:DeepInfer 深度解析 第 2.2 节核对的源码与部署 Q&A 边界,DeepSeek 开源的离线引擎不仅把跨请求 KV 与 E/P/D 编排留在了包外,其部署 Q&A 还明确列出了一个同样未开源的关键组件——VE Load Balancer(视觉编码器负载均衡器)。原因很简单:文本负载均衡只需看 prompt token 数,而 E 池负载同时受图像数量、原生像素面积、视频抽帧数以及 CPU 解码队列积压影响;缺乏按视觉计算量加权的 VE 调度器与背压机制,EPD 只会把队头阻塞从 P/D 池转移到 E 池。
三、视频生成 DiT 的计算解剖:3D VAE、Patch 与 Attention 平方账
3.1 从 U-Net 到 3D 时空 DiT
文本理解只跑一次编码器外加自回归解码,而视频生成处于另一个极端。DiT(Scalable Diffusion Models with Transformers,Peebles & Xie,ICCV 2023 Oral)证明了用纯 Transformer 块配合自适应层归一化(AdaLN-Zero)替代传统卷积 U-Net 后,扩散模型具有可预测的算力扩展律。随后的工业级视频模型(如 Wan2.1 与 HunyuanVideo 系列)将该范式扩展到三维时空潜空间,由三部分组成:
- 因果 3D VAE(3D Causal VAE):把像素视频张量 \([3, T, H, W]\) 压缩进低维时空潜变量,典型压缩步长(stride)为时间 \(r_t = 4\)、空间 \(r_s = 8\)(例如 Wan-VAE 将像素压缩至 16 个潜通道,其中首帧独立编码以确保时间因果性,后续每 4 帧压缩为 1 个潜帧)。
- 3D Patchify 与位置编码:在送入 DiT 主干前,进一步按 \((p_t, p_s, p_s)\)(主流取 \(p_t = 1, p_s = p = 2\))切分潜空间 patch 并线性投影为序列向量,注入 3D RoPE。
- DiT 主干 + Flow Matching:每一去噪步在全体时空 token 上执行无因果掩码的双向自注意力(Bidirectional Self-Attention)、交叉注意力文本条件注入(Cross-Attention 或双流联合注意力)以及 SwiGLU MLP,并通过 Rectified Flow(Liu 等,ICLR 2023)沿 ODE 轨迹迭代 \(S\) 步完成去噪;若启用无分类器引导(CFG),每步通常需同时前向计算条件分支与无条件分支,带来 \(c_{\text{cfg}} = 2\) 倍计算。
3.2 潜空间序列长度与平方 Attention FLOPs 推导
给定像素尺寸 \((T, H, W)\)、3D VAE 压缩步长 \((r_t, r_s)\) 与空间 patch 大小 \(p\)(取 \(p_t = 1\)),进入 DiT 主干的潜空间序列总长度 \(N_{\text{lat}}\) 为:
\[N_{\text{lat}} = \left\lceil \frac{T}{r_t} \right\rceil \cdot \left\lceil \frac{H}{r_s p} \right\rceil \cdot \left\lceil \frac{W}{r_s p} \right\rceil\]
当首帧对齐满足 \(T = k \cdot r_t + 1\)(例如 16 fps 下 5 秒取 \(T = 81\) 帧)且 \(r_t = 4\) 时,因果 3D VAE 的时间潜帧数 \(1 + (T-1)/r_t = 21\),恰好与 \(\lceil 81 / 4 \rceil = 21\) 严格相等。再看 \(r_s = 8, p = 2\) 时,空间等效步长 \(r_s p = 16\),即每 \(4 \times 16 \times 16 = 1{,}024\) 个像素体素才映射为 1 个 DiT token。但即便经过千倍体素压缩,高分辨率长片段的 \(N_{\text{lat}}\) 依然迅速突破十万级。
先看显存与计算的双重矛盾:借助 FlashAttention 分块在线 Softmax,视频 DiT 不必在 HBM 中物化 \(O(N_{\text{lat}}^2)\) 大小的注意力分数矩阵,因此激活工作集随 \(N_{\text{lat}}\) 呈线性增长(即便 \(N_{\text{lat}} = 3.3\times 10^5\),在 \(d = 5120\) 下单层 \(Q,K,V,O\) 激活也只在数 GB 级);真正锁死吞吐的是不可绕过的 \(O(N_{\text{lat}}^2)\) 算力墙。以标准 MAC 转 FLOP(\(2\times\))口径统计,在每层 DiT 模块中(隐层维数 \(d_{\text{model}}\)、FFN 隐维 \(d_{\text{ffn}}\)、文本条件长 \(N_{\text{txt}}\)):
- 双向自注意力核心(\(Q K^\top\) 与 \(P V\)):因没有因果掩码的 \(1/2\) 稀疏三角形,必须算满全矩阵,\(QK^\top\) 与 \(PV\) 各耗 \(2 N_{\text{lat}}^2 d_{\text{model}}\) FLOPs,单层合计: \[\text{FLOPs}_{\text{attn, layer}} = 4 N_{\text{lat}}^2 d_{\text{model}}\]
- 线性投影与 SwiGLU MLP:自注意力 \(Q,K,V,O\) 投影耗 \(8 N_{\text{lat}}
d_{\text{model}}^2\);SwiGLU(含
gate、up、down三个投影矩阵)耗 \(6 N_{\text{lat}} d_{\text{model}} d_{\text{ffn}}\);交叉注意力耗 \(4 N_{\text{lat}} d_{\text{model}}^2 + 4 N_{\text{txt}} d_{\text{model}}^2 + 4 N_{\text{lat}} N_{\text{txt}} d_{\text{model}}\)。
跨 \(L\) 层、\(S\) 个去噪步及 CFG 系数 \(c_{\text{cfg}} \in \{1, 2\}\),自注意力二次方核心为:
\[\text{FLOPs}_{\text{attn}} = c_{\text{cfg}} \cdot S \cdot L \cdot 4 N_{\text{lat}}^2 d_{\text{model}}\]
令自注意力核心与按 \(N_{\text{lat}}\) 线性增长的投影/MLP 项相等,即可得到“Attention 超过 50% 总算力”的序列长度临界点 \(N_{\text{cross}}\):
\[N_{\text{cross}} \approx 3 d_{\text{model}} + 1.5 d_{\text{ffn}} + N_{\text{txt}}\]
3.3 可复现解析计算脚本与 480p / 720p / 1080p 量级账本
以 Wan2.1-T2V-14B 公开
config.json
参数(num_layers = 40、dim = 5120、ffn_dim = 13824、text_len = 512,BF16
权重约 \(28\text{
GB}\))代入上述公式,临界长度 \(N_{\text{cross}} \approx 3(5120) +
1.5(13824) + 512 = 36{,}608\) tokens。下面这段仅依赖
Python 标准库 math
的解析脚本在本机直接执行完毕(用于验证量级,非 GPU
实测 benchmark):
import math
from dataclasses import dataclass


@dataclass(frozen=True)
class DiTConfig:
    layers: int = 40
    dim: int = 5120
    ffn_dim: int = 13824
    n_txt: int = 512
    r_t: int = 4
    r_s: int = 8
    patch_s: int = 2
    fps: int = 16
    steps: int = 50
    cfg: int = 2


def analyze_clip(cfg: DiTConfig, width: int, height: int, duration_s: int) -> dict[str, float]:
    frames = duration_s * cfg.fps + 1
    n_t = math.ceil(frames / cfg.r_t)
    n_h = math.ceil(height / (cfg.r_s * cfg.patch_s))
    n_w = math.ceil(width / (cfg.r_s * cfg.patch_s))
    n_lat = n_t * n_h * n_w

    d = cfg.dim
    attn_core = 4 * (n_lat ** 2) * d
    linear_proj = 8 * n_lat * (d ** 2)
    swiglu_mlp = 6 * n_lat * d * cfg.ffn_dim
    cross_attn = 4 * n_lat * (d ** 2) + 4 * cfg.n_txt * (d ** 2) + 4 * n_lat * cfg.n_txt * d

    scale = cfg.cfg * cfg.steps * cfg.layers
    attn_pflops = scale * attn_core / 1e15
    tot_pflops = scale * (attn_core + linear_proj + swiglu_mlp + cross_attn) / 1e15
    # Analytical lower bound assuming H100 BF16 peak 989 TFLOP/s @ 50% MFU (0.4945 PFLOP/s)
    h100_1gpu_sec = tot_pflops / 0.4945
    return {
        "frames": frames,
        "n_lat": n_lat,
        "attn_pflops": attn_pflops,
        "tot_pflops": tot_pflops,
        "attn_pct": 100.0 * attn_pflops / tot_pflops,
        "h100_1gpu_sec": h100_1gpu_sec,
    }


cfg = DiTConfig()
for label, w, h in [("480p", 832, 480), ("720p", 1280, 720), ("1080p", 1920, 1080)]:
    for dur in (2, 5, 10):
        r = analyze_clip(cfg, w, h, dur)
        print(
            f"{label:5s} {dur:2d}s (T={r['frames']:3d}): N_lat={r['n_lat']:7,d} | "
            f"Attn={r['attn_pflops']:7.2f} PFLOPs ({r['attn_pct']:4.1f}%) | "
            f"Total={r['tot_pflops']:8.2f} PFLOPs | 1xH100@50%MFU={r['h100_1gpu_sec']:8.1f} s"
        )
上述脚本在 Python 3.12.3
环境实际执行输出如下:
480p   2s (T= 33): N_lat= 14,040 | Attn=  16.15 PFLOPs (27.6%) | Total=   58.47 PFLOPs | 1xH100@50%MFU=   118.2 s
480p   5s (T= 81): N_lat= 32,760 | Attn=  87.92 PFLOPs (47.2%) | Total=  186.38 PFLOPs | 1xH100@50%MFU=   376.9 s
480p  10s (T=161): N_lat= 63,960 | Attn= 335.13 PFLOPs (63.6%) | Total=  527.15 PFLOPs | 1xH100@50%MFU=  1066.0 s
720p   2s (T= 33): N_lat= 32,400 | Attn=  86.00 PFLOPs (46.9%) | Total=  183.38 PFLOPs | 1xH100@50%MFU=   370.8 s
720p   5s (T= 81): N_lat= 75,600 | Attn= 468.20 PFLOPs (67.4%) | Total=  695.14 PFLOPs | 1xH100@50%MFU=  1405.7 s
720p  10s (T=161): N_lat=147,600 | Attn=1784.69 PFLOPs (80.1%) | Total= 2227.55 PFLOPs | 1xH100@50%MFU=  4504.6 s
1080p  2s (T= 33): N_lat= 73,440 | Attn= 441.83 PFLOPs (66.7%) | Total=  662.29 PFLOPs | 1xH100@50%MFU=  1339.3 s
1080p  5s (T= 81): N_lat=171,360 | Attn=2405.52 PFLOPs (82.4%) | Total= 2919.63 PFLOPs | 1xH100@50%MFU=  5904.2 s
1080p 10s (T=161): N_lat=334,560 | Attn=9169.34 PFLOPs (90.1%) | Total=10172.87 PFLOPs | 1xH100@50%MFU= 20572.0 s
汇总为对照表如下(注:所有时间与算力均为基于 Wan2.1-14B 参数与 H100 SXM 989 TFLOP/s @ 50% MFU 假设的 Analytical Model 估算,不代表真实设备实测耗时会线性落在该下界):
| 分辨率预设 | 时长(16 fps 帧数 \(T\)) | 潜空间网格 \((N_t \times N_h \times N_w)\) | 序列长度 \(N_{\text{lat}}\) | 自注意力 FLOPs(PFLOPs) | 总计算量(PFLOPs) | Attention 占比 | 单卡 H100@50% MFU 估算耗时 |
|---|---|---|---|---|---|---|---|
| 480p (\(832 \times 480\)) | 2s (\(T=33\)) | \(9 \times 30 \times 52\) | 14,040 | 16.15 | 58.47 | 27.6% | 118.2 s |
| 480p (\(832 \times 480\)) | 5s (\(T=81\)) | \(21 \times 30 \times 52\) | 32,760 | 87.92 | 186.38 | 47.2% | 376.9 s |
| 480p (\(832 \times 480\)) | 10s (\(T=161\)) | \(41 \times 30 \times 52\) | 63,960 | 335.13 | 527.15 | 63.6% | 1,066.0 s |
| 720p (\(1280 \times 720\)) | 2s (\(T=33\)) | \(9 \times 45 \times 80\) | 32,400 | 86.00 | 183.38 | 46.9% | 370.8 s |
| 720p (\(1280 \times 720\)) | 5s (\(T=81\)) | \(21 \times 45 \times 80\) | 75,600 | 468.20 | 695.14 | 67.4% | 1,405.7 s |
| 720p (\(1280 \times 720\)) | 10s (\(T=161\)) | \(41 \times 45 \times 80\) | 147,600 | 1,784.69 | 2,227.55 | 80.1% | 4,504.6 s |
| 1080p (\(1920 \times 1080\)) | 2s (\(T=33\)) | \(9 \times 68 \times 120\) | 73,440 | 441.83 | 662.29 | 66.7% | 1,339.3 s |
| 1080p (\(1920 \times 1080\)) | 5s (\(T=81\)) | \(21 \times 68 \times 120\) | 171,360 | 2,405.52 | 2,919.63 | 82.4% | 5,904.2 s |
| 1080p (\(1920 \times 1080\)) | 10s (\(T=161\)) | \(41 \times 68 \times 120\) | 334,560 | 9,169.34 | 10,172.87 | 90.1% | 20,572.0 s |
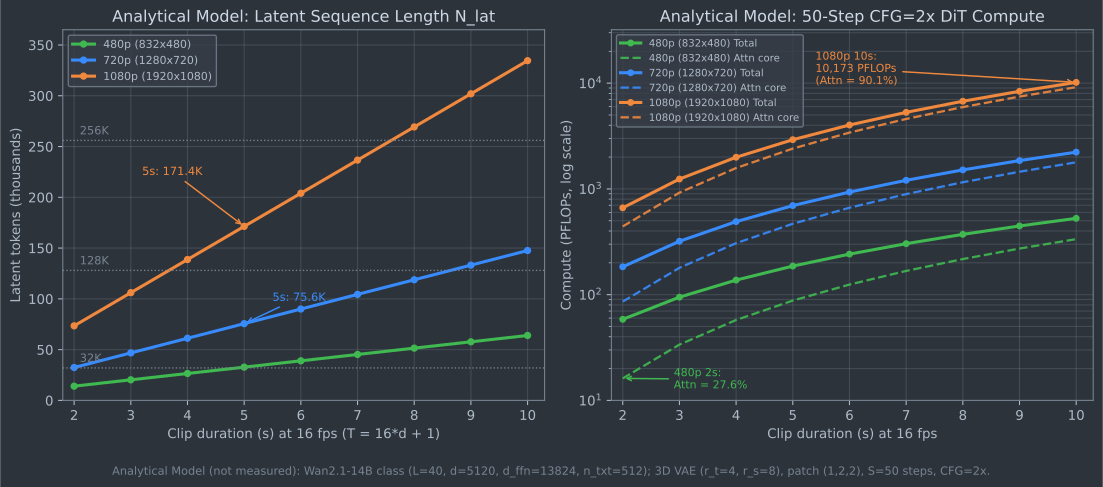
图 4 直观印证了基础设施选型的分水岭:在 480p 2s(14K token)档位,线性投影与 SwiGLU 仍占主导(72.4%);一旦跨过 \(N_{\text{cross}} \approx 36.6\text{K}\) tokens(例如 480p 5s 以上或任何 720p/1080p 视频),平方级的双向全注意力迅速接管整个耗时。1080p 10s 片段在 50 步 CFG=2 下需要 10.17 EFLOPs(约合单卡 H100 理论 50% MFU 跑 5.7 小时),因此生产视频生成几乎必须同时动用三条杠杆:多卡序列/流水线并行、步数压缩/时序缓存以及 低精度 Tensor Core。
四、多卡 DiT 并行推理:CFG、Ulysses、Ring、USP 与 PipeFusion
为了把 720p–1080p
的单次生成从数十分钟拉回十秒至一分钟级,以
xDiT(Fang
等,arXiv:2411.01738,arXiv 预印本,未经同行评审)为代表的
DiT 推理引擎将多种切分维度正交组合进同一套 GPU
进程网格。下面结合 16:长上下文工程
讨论过的序列并行基础,对比视频 DiT 场景下的五大机制:
- CFG
Parallel(无分类器引导并行):将每步去噪中的条件分支(Condition)与无条件分支(Uncondition)拆到两组独立
GPU 进程组并行前向,步末仅需 1 次
AllGather合并预测噪声即可。优势是通信极少、零精度损失;代价是并行度天然封顶为 \(2\)(且对 CFG 蒸馏后取消负提示的模型不再适用)。 - DeepSpeed-Ulysses(Jacobs
等,
arXiv:2309.14509,arXiv 预印本,未经同行评审):进入注意力前对 \(Q,K,V\) 执行All-to-All,把序列分片转置为注意力头分片 \([N_{\text{lat}}, H/P_u, d_h]\),本地跑完 FlashAttention 后再执行一次All-to-All转回序列分片。通信粒度小且算子保持完整长序列高利用,但并行度受限于注意力头数 \(P_u \le H\)(若采用 GQA 则受限于 \(n_{\text{kv}}\),否则须复制 KV),且跨机高频All-to-All极易拥塞交换机。例如 Wan2.1-14B 拥有 \(H=40\) 个注意力头,8 卡 CFG=2 时每组 4 卡跑 Ulysses(\(P_u=4 \mid 40\))刚好整除;但对 HunyuanVideo-13B(\(H=24\))或更少头的模型,跨双机 16 卡直接开纯 Ulysses 就会触发头数不足。 - Ring Attention(Liu 等,ICLR 2024):每张卡持有固定查询分片 \(Q_i\),沿环形拓扑 P2P 接力传递 \((K_j, V_j)\) 分块,配合在线 Softmax 增量归约。值得注意的是它与 16:长上下文工程 中 LLM Prefill 的差异:视频 DiT 执行的是无因果掩码的双向全注意力,不存在因果下三角矩阵引发的 50% 负载倾斜,因此均匀分块就能满载而无需 Zig-Zag 重排;但过小分块下 P2P 传递难以掩盖短序列算力。
- USP(Unified Sequence
Parallelism)(Fang &
Zhao,
arXiv:2405.07719,arXiv 预印本,未经同行评审):将序列并行构造成二维网格——节点内 NVLink 域跑 Ulysses(低延迟承受All-to-All且不超过头数上限),节点间 IB/RoCE 域跑 Ring Attention(以大粒度计算隐藏 P2P 延迟),在单机多卡扩展到多机时兼顾数学严格等价与高硬件利用率。例如双机 16 卡跑 720p 视频时,xDiT 常配置为CFG=2 × Ring=2(跨机)× Ulysses=4(机内 NVLink),既用尽每节点内部高带宽,又避开跨机All-to-All风暴。 - PipeFusion(Fang
等,
arXiv:2405.14430,2024 年 5 月作为 arXiv 预印本提出,后收录于 NeurIPS 2025):继承 DistriFusion(Li 等,CVPR 2024 Highlight)的“错位补丁(Displaced Patch)”思路,但将并行维度从单层复制权重改为跨 GPU 切分 DiT 层(流水线并行 \(P_{\text{pipe}}\))+ 将潜空间切分为 \(M\) 个不重叠 Patch 微批次:当第 \(t\) 步的 Patch \(P_k\) 流经某阶段计算 Self-Attention 时,复用上一步 \((t-1)\) 缓存的 \(K,V\) 过期激活(1-step stale activations)提供全局上下文,同时将本步激活的 P2P 发送与下一个 Patch 的本地计算重叠。流水线气泡占比为 \(\frac{P_{\text{pipe}} - 1}{M + P_{\text{pipe}} - 1}\),当切分 \(M = 16\) 个 Patch 时,4 卡气泡可压低至 \(3/19 \approx 15.8\%\),同时将单卡权重显存压缩为 \(1/P_{\text{pipe}}\),使 PCIe/普通以太网集群也能跑出高扩展性。
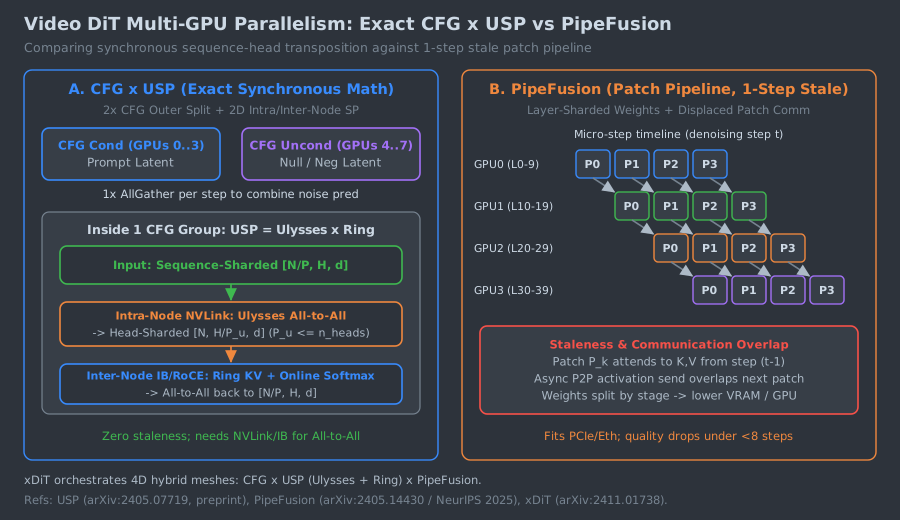
| 并行策略 | 切分维度 | 核心通信原语 | 头数约束 | 激活新鲜度 | 权重显存分摊 | 适配硬件互联 |
|---|---|---|---|---|---|---|
| CFG Parallel | 条件 / 无条件分支 | 每步 1 次 AllGather |
无(封顶 \(2\times\)) | 严格同步(0 过期) | 否(各卡全量权重) | 任意互联 |
| DeepSpeed-Ulysses | 序列 ↔︎ 注意力头 | 每层 2 次 All-to-All(含 \(Q,K,V,O\)) |
\(P_u \le n_{\text{kv}}\) | 严格同步(0 过期) | 否(常配合 ZeRO/TP) | 节点内 NVLink / NVSwitch |
| Ring Attention | 序列维均分 | 每层环形 P2P Send/Recv KV | 无 | 严格同步(0 过期) | 否 | IB / RoCE 或多节点互联 |
| USP(Ulysses × Ring) | 二维混合序列网格 | 节点内 All-to-All + 节点间 P2P Ring |
\(P_u \le n_{\text{kv}}\),总并行不限 | 严格同步(0 过期) | 否 | 多机 NVLink + IB/RoCE |
| PipeFusion | 层间流水线 + Patch 微批次 | P2P 异步传递相邻阶段 Patch 激活 | 无 | 1 步过期 \((t-1)\) \(K,V\) | 是(按层切分权重) | PCIe / 以太网无高速互联集群 |
在工程选型上,不存在“PipeFusion 全面替代 USP”或相反的单边结论,实际集群常按互联带宽与模型头数约束做三维网格映射:
- 单机 8 × H100/H200(NVLink
全互联):启用 CFG 时优先取
CFG=2 × Ulysses=4(要求模型注意力头数可被 4 整除,如 Wan2.1-14B 的 40 头与 HunyuanVideo-13B 的 24 头均满足),零过期激活且All-to-All全在 NVLink 域内消化;当采用 CFG 蒸馏模型关闭 CFG 后,直接开Ulysses=8或Ulysses=4 × Ring=2(例如 \(n_{\text{kv}} < 8\) 时)。 - 双机 16 卡(机内 NVLink + 机间
IB/RoCE):若跨机跑纯 Ulysses,高频
All-to-All会打满跨节点端口并触发头数不足;此时应锁定CFG=2 × Ring=2(跨机)× Ulysses=4(机内),把All-to-All严密关在机内 NVLink,跨机只走粒度较大的 P2P KV 环传。 - 8 卡 PCIe / 普通以太网主机(无 NVLink,或 30B+
DiT 权重塞不下单卡):此时
All-to-All通信会被 PCIe 根复合体和跨 NUMA 带宽卡死,应切换为CFG=2 × PipeFusion=4(或关闭 CFG 时PipeFusion=8)并将 Patch 微批数设为 \(M \ge 16\),用按层切分权重解开单卡显存约束,同时把激活 P2P 发送隐藏在流水线计算气泡下。
五、时序缓存、步数蒸馏与量化:TeaCache 的收益边界与 3D VAE 陷阱
5.1 从 DeepCache 到 TeaCache 的演进与边界
扩散推理相邻去噪步之间的特征演化存在显著时序冗余。DeepCache(Ma、Fang & Wang,CVPR 2024)最早在 U-Net 上利用这一特性,缓存高层分支特征并在后续步只轻量重算浅层;但把 DeepCache 直接搬到各向同性的 DiT 堆叠层上很快会碰壁——DiT 没有 U-Net 式的长跨距高低频跳连结构,而且不同时间步之间的激活变化幅度极不均匀,固定步长间隔复用极易在变化剧烈的早期或高频纹理阶段引入伪影。
TeaCache(Timestep Embedding Tells:
It’s Time to Cache for Video Diffusion Models,Liu
等,CVPR 2025
Highlight,arXiv:2411.19108)给出了更契合
DiT 结构的动态判定机制。设第 \(t\)
步经过首层时间步嵌入调制后的输入张量为 \(\tilde{x}_t\)(即代码中的
modulated_inp),TeaCache 用相对 \(L_1\)
差值经离线拟合的多项式重标定函数 \(P_c(\cdot)\)
近似真实模块输出漂移,并沿去噪步累加:
\[r_t = \frac{\|\tilde{x}_t - \tilde{x}_{t-1}\|_1}{\|\tilde{x}_{t-1}\|_1}, \qquad A_t = A_{t-1} + P_c(r_t)\]
当累计估计漂移 \(A_t <
\theta_{\text{rel}}\)(rel_l1_thresh)时,直接跳过全量
DiT Block
前向并复用上一次缓存的残差;一旦越过阈值则触发完整计算,更新缓存残差并将
\(A_t\)
清零。这一决策环路非常轻量,可用如下核心伪代码骨架(逻辑摘自
TeaCache
公开算法思路,仅作机制示意,非特定仓库源码)表达:
# TeaCache step-level accumulation & reset decision logic
rel_l1 = (modulated_inp - previous_modulated_input).abs().mean() / previous_modulated_input.abs().mean()
accumulated_rel_l1_distance += rescale_poly(rel_l1)
previous_modulated_input = modulated_inp

if accumulated_rel_l1_distance < rel_l1_thresh:
    hidden_states = hidden_states + cached_residual
else:
    cached_residual = run_full_dit_blocks(hidden_states, cond)
    hidden_states = hidden_states + cached_residual
    accumulated_rel_l1_distance = 0.0
需要严格区分论文亮点口径与生产边界:TeaCache 原论文在
Open-Sora-Plan 上报告了最高约 4.41× 加速且
VBench 评测得分仅下降 \(-0.07\%\)(论文给定阈值与提示词分布口径),随后被迅速集成至
Wan2.1、HunyuanVideo 与 vLLM-Omni 生态中提供约 1.5×–2.5×
实用加速。但在生产环境中必须清楚两点条件:第一,多项式系数与
rel_l1_thresh
强绑定具体模型权重与采样器调度,跨模型版本或大幅拉高引导强度后必须重标定;第二,TeaCache
在慢镜头、静态背景上表现优异,但遇到大幅度运镜、快速遮挡或精细肢体动作时,输入微小调制差仍可能掩盖高层语义重排,导致人物重影或动作涂抹。
5.2 步数蒸馏与加速组合的互斥效应
与免训练缓存平行的另一条加速主轴是流匹配与步数蒸馏。Rectified Flow(Liu、Gong & Liu,ICLR 2023)把曲线扩散路径拉直为近似直线的常微分方程轨迹;Consistency Models(Song 等,ICML 2023)与 DMD2(Improved Distribution Matching Distillation,Yin 等,NeurIPS 2024)进一步把 50 步采样与 CFG 压缩为 4–8 步无 CFG 推理(单次前向直接吞掉 \(2\times\) CFG 和 \(6\text{–}12\times\) 步数削减)。
基础设施工程师常犯的错误,是把“蒸馏模型 + TeaCache + PipeFusion”盲目叠加。当总去噪步数从 50 步压到 4–8 步时,相邻两步在 ODE 轨迹上跨越的时间步长 \(\Delta t\) 放大了一个数量级,连续步之间“变化平缓”的根本前提不复存在:此时再启用 1 步过期的 PipeFusion 或激进的 TeaCache 跳步,极易在第一两步就把结构错误锁死并传给最终画面。
5.3 DiT 骨干与 3D VAE 解码的量化不对称性及 OOM 陷阱
视频推理管线对低精度的容忍度呈现极端的组件不对称性:
- DiT Transformer 主干相对抗量化:在
ViDiT-Q(Zhao 等,ICLR
2025,
arXiv:2406.02540)的指标解耦混合精度方案下,视频 DiT 可实现近乎无损的 W8A8/FP8 推理(在 Hopper/Blackwell Tensor Core 上释放 \(2\times\) 峰值算力);SVDQuant(Li 等,ICLR 2025 Spotlight)更进一步把激活异常值从激活迁入权重,并通过一个 16-bit 低秩(SVD)旁路分支吸收异常权重奇异值,使 12B 级图像/视频扩散骨干可降至 W4A4 运行。 - 3D VAE 解码器对低精度极度敏感且最易 OOM:3D VAE 负责把高度压缩的 16 通道潜变量通过多层 3D 因果卷积、上采样与归一化还原回像素空间。一旦对 3D VAE 施加粗粒度 FP8/INT8 量化,卷积链路会把量化噪声在空间与时间维同时放大,表现为肉眼可见的帧间闪烁、色彩带状断层(banding)或网格块伪影。因此生产系统普遍将 3D VAE 钉死在 BF16(关键归一化层甚至保留 FP32)。
更隐蔽的故障在于 3D VAE 的末段显存尖峰。按 5 秒 16 fps(\(T = 81\) 帧)、BF16 每元素 2 字节计算,3D VAE 最后几级全分辨率上采样阶段仍维持 64–128 通道特征。若不做分块整段一次性解码,单张 128 通道中间特征张量就已经接近或超过单卡可用显存上限(加上 3D ResNet 的输入/输出/残差多缓冲并行驻留,实际峰值往往为单张量体积的 2–3 倍);开启 16 帧时序分块 + \(2 \times 2\) 空间分块(按 1.15 倍边界重叠余量估算,用于相邻块间线性交叉渐变 cross-fade blending 以消除接缝闪烁)后,中间激活峰值可被压减一个数量级以上:
| 分辨率(5s / 81 帧) | 最终 RGB 输出(BF16) | 未分块 128 通道中间张量(BF16) | 时空分块(16 帧 × \(2\times 2\),含 1.15× 重叠) | 工程保护动作 |
|---|---|---|---|---|
| 480p (\(832 \times 480\)) | 0.194 GB | 8.28 GB | 0.47 GB | 单卡可直接解码,仍建议开 VAE 切片防多并发峰值 |
| 720p (\(1280 \times 720\)) | 0.448 GB | 19.11 GB | 1.09 GB | 与 14B DiT 共驻 80 GB 卡时须先卸载 DiT 或开分块 |
| 1080p (\(1920 \times 1080\)) | 1.008 GB | 43.00 GB | 2.44 GB | 强制开启时序+空间 Tiling + 独立 VAE 池/权重换出 |
此外,在量化与缓存叠加部署上有一条常见工程踩坑:不能拿
BF16 模型拟合出的 TeaCache 多项式系数直接套用到 W4A4 或激进
FP8
量化后的模型上。量化本身会在每个去噪步引入截断噪声,改变浅层调制输入与深层残差之间的相对
\(L_1\)
映射斜率;生产上需要针对目标量化权重重新跑校准拟合多项式,或在低精度模型上适当收紧
rel_l1_thresh。
六、全双工语音与原生全模态流式:Moshi 与 Thinker-Talker 运行时
6.1
为什么级联式 VAD → ASR → LLM → TTS 会卡死在
800–2,000 ms
传统语音助手采用四段级联:端侧或网关先跑语音活动检测(VAD)等待说话停顿(仅尾静音确认窗口就耗去
200–500 ms),送入流式 ASR
转写文本(150–350 ms),再进文本 LLM 跑完
Prefill 到首 token(TTFT
200–600 ms),最后凑齐一个短句标点再送给流式
TTS
吐出首段音频(150–400 ms)。四段串行累加天然落入
800–2,000 ms
延迟区间。更致命的是半双工状态锁:一旦进入 TTS
播报阶段,系统无法一边继续听用户发出“嗯”“等一下”等反馈音,同时在进入文本后彻底丢弃了语气、停顿、笑声等副语言特征;用户插话时,调度器只能粗暴清空四套独立微服务的队列,重连上下文极易错位。
6.2 原生端到端架构:Moshi vs Qwen2.5-Omni
为了把交互延迟压进人类面对面交谈的 200 ms 量级并实现真·全双工(边听边说),2024–2025 年涌现出两条具有代表性的端到端路线:
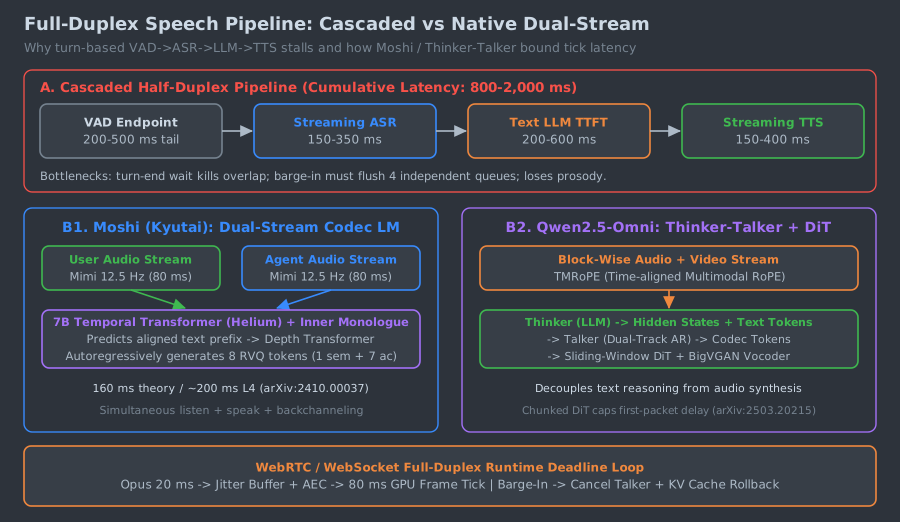
- Moshi(Kyutai,Défossez
等,
arXiv:2410.00037,arXiv 预印本,未经同行评审):走“极低帧率流式神经编解码 + 单一分层自回归语言模型”路线。- Mimi 流式编解码器:以 12.5 Hz(每帧 80 ms)将 24 kHz 音频压缩进 8 层残差矢量量化(RVQ)码本——第 1 层从自监督语音表征(WavLM)蒸馏语义信息,后 7 层编码声学细节与音色,总码率仅 \(12.5 \times 8 \times 11\text{ bits} = 1.1\text{ kbps}\)。
- 双流并行 + Temporal / Depth
Transformer:Moshi 基于 7B 参数
Helium 文本基座演化出 Temporal
Transformer,每 80 ms
节拍同时消费用户音频流与自身上一拍音频流;内部先生成时间对齐的文本前缀(Inner
Monologue,内心独白,确保语义连贯与流式 ASR/TTS
同源),再交给更小的 Depth Transformer
在同一帧内自回归预测 8 个 RVQ token。工程上意味着每个 80 ms
周期都要串行完成
1 次 7B Temporal 前向 + 8 次轻量 Depth 前向 + Mimi 流式声码器解码;论文报告其理论结构延迟为 160 ms(80 ms 帧长 + 80 ms 声学偏移),在单张 NVIDIA L4 上实测端到端延迟约 200 ms(论文自测口径)。
- Qwen2.5-Omni(Qwen
Team,
arXiv:2503.20215,arXiv 预印本,未经同行评审):面对同时输入音视频与输出文本+语音的全模态场景,采用 Thinker-Talker 解耦架构。- Thinker(LLM 主干)专职多模态感知融合与文本推理;Talker 是一个双轨自回归模型,直接读取 Thinker 的隐状态与文本输出流式生成音频编码 token,避免语音生成干扰文本推理质量。
- TMRoPE(Time-aligned Multimodal RoPE):在分块流式输入下,将音频与视频帧按真实时间戳交织编排三维旋转位置编码,保证唇音与事件时序对齐。
- 滑窗 DiT 声码器:利用限定感受野的 Sliding-Window DiT(分块流式注意力窗口)将音频 token 转为梅尔频谱并经 BigVGAN 合成波形,把长句语音的流式首包延迟封顶在局部窗口尺度,避免等整句说完才触发扩散解码。
| 架构路线 | 典型延迟结构 | 双工与副语言能力 | 音频表征与生成机制 | 显式文本轨道 | 运行时主要瓶颈 |
|---|---|---|---|---|---|
级联 VAD→ASR→LLM→TTS |
800–2,000 ms(四段串行累加) | 半双工轮次锁;丢失语气/笑声 | 独立 ASR 模型 + 独立 TTS/声码器 | 有(天然完整文本) | 尾静音判定窗口 + 4 队列状态同步 |
| Moshi(Kyutai) | ~160–200 ms(理论 160 ms / L4 实测 ~200 ms) | 真·全双工并行双流;支持自然抢话与附和 | Mimi 12.5 Hz(80 ms)8 层 RVQ;Temporal + Depth AR | Inner Monologue 时间对齐前缀 | 80 ms 内完成 1 步 Temporal + 8 步 Depth + 解码 |
| Qwen2.5-Omni | Thinker TTFT + 滑窗 DiT 首块延迟 | 音视频同步理解 + 流式语音输出 | Thinker → Talker 双轨 AR → 滑窗 DiT + BigVGAN | 有(Thinker 原生输出文本) | Thinker 与 Talker/DiT 的多阶段流水线编排与显存共存 |
6.3 WebRTC / WebSocket 全双工运行时工程账
在服务运行时层面,全双工语音引擎的瓶颈既不是大矩阵 FLOPs,也不是 HBM 容量(以 Moshi 12.5 Hz 计算,1 分钟对话仅产生 750 步 Temporal KV,1 小时仅 45,000 步),而是严格的周期性帧期限(Deadline Scheduling)与打断状态一致性:
sequenceDiagram
    participant U as Client WebRTC
    participant G as Gateway JitterBuffer
    participant W as Omni Worker (KV Cache)
    W->>G: Agent chunk t..t+4 (ahead of playback)
    G->>U: Play up to frame t_played
    U->>G: User speaks (Barge-In energy > threshold)
    G->>U: Clear client audio playout buffer
    G->>W: Abort Talker + playback_ack(t_played)
    W->>W: Rollback KV pointers to t_played
    U->>W: Stream new user audio frames
W->>U: Resume response from t_played- WebRTC 20 ms 封包、Jitter Buffer 与 80 ms GPU Tick 对齐:客户端经 WebRTC 发送 20 ms Opus 音频帧(WebRTC 底层自带硬件/软件回声消除 AEC,防止模型听见自己播出的声音形成自激回环)。服务端先在 Jitter Buffer 中吸收公网抖动——缓冲区设得太小会导致公网乱序/丢包直接引发 GPU 喂料断流,设得太大(如 \(>100\text{ ms}\))又会直接吃光 200 ms 的交互预算,生产常以自适应 20–60 ms 目标缓冲对齐每 4 帧(80 ms)一次的 GPU Tick 批前向;因此运行时 SLO 不再看均值 TPOT,而看 P99 单帧音频块处理耗时 \(\le 80\text{ ms}\)——只要有 1% 的帧超过 80 ms(例如同卡偶发 Python GC、CUDA Graph 未捕获分支或大型模态编码抢占),客户端音频环形缓冲区就会欠载(underrun)产生爆音卡顿。
- Barge-In(随时插话)与双游标 KV Cache
回滚:当用户开口打断智能体播报时,服务端往往已经超前生成了未来
200–500 ms 的音频数据包在途或排队。若直接把模型刚生成的全部
token 留在 KV Cache
里,模型会误以为“我已经把整句话说完了”,下一轮逻辑直接断层。生产级运行时必须维护“服务端生成步指针
generated_tick”与“客户端已播放回执played_tick”的双游标,在检测到插话时精确丢弃未播帧并把 KV 指针回滚至用户实际听到的最后一帧(下面状态机代码已在本机python3执行验证,输入 10 拍超前生成与第 4 拍打断,输出精确丢弃 6 拍 / 480 ms 并将kv_len回滚至 4):
class DuplexSessionState:
    def __init__(self, tick_ms: int = 80) -> None:
        self.tick_ms = tick_ms
        self.kv_len = 0
        self.generated_tick = 0
        self.played_tick = 0

    def step_generate(self, n_ticks: int) -> None:
        self.generated_tick += n_ticks
        self.kv_len += n_ticks

    def client_ack(self, played_tick: int) -> None:
        assert played_tick <= self.generated_tick
        self.played_tick = played_tick

    def on_barge_in(self) -> int:
        discarded = self.generated_tick - self.played_tick
        self.kv_len = self.played_tick
        self.generated_tick = self.played_tick
        return discarded


sess = DuplexSessionState()
sess.step_generate(10)   # 800 ms generated ahead into network / jitter buffer
sess.client_ack(4)       # User heard 320 ms (ticks 0..4) before barge-in
dropped = sess.on_barge_in()
assert dropped == 6 and sess.kv_len == 4
在实际引擎落地中,PagedAttention 块表只需释放
played_tick
之后新追加的尾页指针并修改序列长度元数据,无需像传统无状态推理那样重算整段历史上下文的
Prefill,即可在微秒级完成状态回滚。
七、学术谱系、路线争论与工程边界
7.1 关键演进谱系
回看过去三年多模态与视频生成基础设施的发展轨迹,三条子领域并非孤立演化,而是沿着清晰的学术分叉走向工程合流:
| 代表工作 | 年份与发表状态 | 解决的核心问题 | 依赖的工程假设与适用限制 |
|---|---|---|---|
| DiT(Peebles & Xie) | 2023,ICCV 2023 Oral | 用纯 Transformer 取代 U-Net 扩散主干 | 注意力复杂度随潜空间序列平方放大 |
| DeepCache(Ma 等) | 2024,CVPR 2024 | 跨去噪步复用 U-Net 高层跳连特征 | 依赖 U-Net 跳连结构,直接搬到 DiT 上易退化 |
| DistriFusion(Li 等) | 2024,CVPR 2024 Highlight | 空间切块复用上一步过期特征隐藏通信 | 各卡复制完整权重,对超大视频模型显存不友好 |
| Ring Attention(Liu 等) | 2024,ICLR 2024 | P2P 环传 KV 突破单卡超长序列显存墙 | 块粒度过小时 P2P 延迟无法被算力掩盖 |
| USP(Fang & Zhao) | 2024,arXiv 预印本(未经同行评审) | 节点内 Ulysses × 节点间 Ring 混合序列并行 | Ulysses 路数仍受 KV 头数整除约束,依赖高带宽互联 |
| PipeFusion(Fang 等) | 2024 预印本 / NeurIPS 2025 | 层间流水线 + Patch 微批次 + 1 步过期 KV | 假设相邻去噪步激活变化平缓;极少步数蒸馏下退化 |
| TeaCache(Liu 等) | 2025,CVPR 2025 Highlight | 时间步调制输入 \(L_1\) + 多项式重标定动态跳步 | 系数绑定模型与调度器;大幅度运动场景存在涂抹风险 |
| ViDiT-Q / SVDQuant | 2025,ICLR 2025(后者 Spotlight) | DiT 骨干 W8A8 / W4A4 低秩异常值吸收 | 仅适用于 DiT Transformer,不可直接照搬至 3D VAE |
| DistServe / Mooncake | 2024 OSDI / 2025 USENIX FAST | PD 分离与以 KV 为中心的 RDMA 池化架构 | 默认围绕文本 Prefill/Decode,未原生调度 ViT/DiT |
| Cornserve(Chung 等) | 2026,arXiv 预印本(未经同行评审) | Any-to-Any 模型裂变(Model Fission)与组件共享 | 依赖离线画像准确度;小负载场景需谨慎权衡拆池开销 |
| Moshi / Qwen2.5-Omni | 2024 / 2025,arXiv 预印本(未经同行评审) | 端到端全双工低帧率语音流与 Thinker-Talker 解耦 | 原生音频流在确定性内容护栏与工具审计上弱于文本级联 |
7.2 三场尚未收敛的工程争论
- 精确
CFG × USP同步 vsPipeFusion / TeaCache近似加速的画质边界:以 USP(arXiv:2405.07719)为代表的精确同步路线通过高速互联交换全量激活,保证与单卡数学结果逐比特对齐;而 PipeFusion(NeurIPS 2025)与 TeaCache(CVPR 2025)本质上都在赌“相邻去噪步的激活增量够小”。在 50 步慢采样场景下,二者在 VBench 等均值指标上确实几乎无损;但随着 DMD2(NeurIPS 2024)与 Consistency Models(ICML 2023)把采样步数压缩到 4–8 步,以及真实线上遇到高速转场或复杂物理碰撞时,近似路线缺乏轻量在线误差边界检测,正反两派在生产环境“默认开还是按白名单开”仍无统一共识。 - 全分离 EPD vs 共池单体 VLM
的小负载“网络税”反转:在 \(3{,}500\text{–}12{,}000\) 视觉
token 的高分截图和视频负载下,EPD 分离结合 Vision Embedding
Cache 能彻底保护 Decode ITL;但面对电商缩略图、OCR 小图等仅
\(224 \times 224\)
级别输入(在 \(28 \times
28\) 合并下仅 64 个 token、BF16
嵌入不足 460 KB),E 池编码耗时可能不足 1
毫秒,强行经过独立代理路由、缓存哈希探针、序列化与 RDMA
跨节点搬运,端到端 TTFT 反而可能劣于直接共池
E+P。因此 Cornserve 提出用Cornfigurator按真实请求尺寸分布决定拆池或共池,而非把 EPD 当成无条件银弹。 - 原生端到端 Speech-to-Speech vs 级联 / 解耦流水线的合规与工具可控性:Moshi 证明了跳过文本中转能够把响应延迟压进 ~200 ms 并保留细腻情绪;但在金融客服、医疗问诊及受严格监管(如 24 篇合规框架)的线上生产中,企业需要确定性的 RAG 注入、结构化 Function Calling 校验、敏感词实时阻断与逐句文本审计日志。纯端到端音频流很难在语音发出前同步做确定性文本护栏拦截,这也是 Thinker-Talker(保留显式文本轨道)以及“流式 ASR + 低 TTFT 文本 LLM + 超低首包流式 TTS”改良级联线依然长期并存的根本原因。
7.3 工程落地前的五条硬核查边界
无论团队切入上述哪一条推理栈,上线前至少应逐项核对以下五条硬边界,避免把单点基准测试结果直接当成线上承诺:
- VLM EPD 池核对视觉负载均衡与小图直通阈值:确认 VE 网关按图像像素面积/抽帧数而非请求条数做加权调度,并为 \(<256\text{ px}\) 缩略图配置旁路阈值,防止网络序列化拖垮 TTFT。
- DiT Ulysses 核对 \(n_{\text{kv}}\)
整除约束:上线前核查
num_attention_heads与 GQAnum_key_value_heads是否整除ulysses_degree,切勿跨慢速以太网开启大路数All-to-All。 - DiT 蒸馏与缓存核对互斥矩阵:对步数
\(S \le 8\)
的蒸馏模型默认禁用 1 步过期
PipeFusion与高阈值TeaCache;切换低精度权重后必须重拟合TeaCache多项式系数。 - 3D VAE 核对分块与精度隔离:禁止对 3D VAE 解码器直接套用未经校准的粗粒度 FP8;1080p 负载必须开启时空 Tiling 并在解码前释放或换出 DiT 显存占用。
- 全双工语音核对 P99 Tick
与回滚幂等性:在真实公网丢包/抖动压测下验收 P99
单帧延迟(\(\le 80\text{
ms}\))与并发打断测试,确认
playback_ack回滚后不会把未播放文本残留进多轮对话历史。
八、开放问题
- 跨异构执行周期的统一调度与显存复用:同一集群若同时承接全双工语音(硬实时 80 ms Tick)、VLM 理解(不规则秒级 Prefill)与视频 DiT(分钟级全卡组网 Gang Scheduling),静态划池会导致昼夜波谷卡时浪费,动态混部又会互相击穿 SLO。如何在不牺牲 P99 尾延迟期限的前提下,让推理编排层(如 Cornserve 后续演进与 OSDI/MLSys 异构服务研究)实现细粒度时间片抢占与权重弹性换入换出,仍是开放问题。
- 少步蒸馏模型上时序缓存与过期激活的在线退化检测:面向 4–8 步极速生成模型,目前尚缺乏开销远低于单步前向的“在线画质漂移探针”,能够在生成中途自动判定当前 prompt 是否触发了 TeaCache / PipeFusion 的结构崩塌并动态回退到精确步进(可结合 CVPR 2025 TeaCache 与时序一致性评测方向继续追踪)。
- Vision Embedding Cache 与分布式 Prefix KV Cache
的统一生命周期治理:目前 vLLM 中的
ECConnector(视觉嵌入缓存)与KVConnector(文本前缀 KV 缓存,见 32:存储分层 KV Cache)仍按各自独立的哈希空间、DRAM/NVMe 配额与淘汰策略运行。当同一多轮多模态会话既有历史图片嵌入、又有几十 K 文本前缀时,两套缓存的跨租户驱逐协同与统一 RDMA 内存注册协议尚未标准化。
九、小结
多模态与视频生成基础设施的核心,不是把图像、音频和视频强塞进纯文本的单一连续批处理循环,而是围绕各自的物理瓶颈拆池与重构:理解栈用 EPD 分离 + 视觉嵌入缓存 + 负载均衡的 VE 池隔离 ViT 脉冲,生成栈用 CFG × USP / PipeFusion 分摊二次方时空注意力、用 TeaCache / 步数蒸馏压减采样步、用 BF16 分块解码守住 3D VAE 的显存与精度底线,全双工语音栈则用 12.5 Hz 编解码或 Thinker-Talker 绕开级联停顿,在 80 ms 帧节拍与插话 KV 回滚上兑现实时体验。若要继续追入底层单机调优与服务化细节,可对照阅读 16:长上下文工程、21:推理服务化、28:DeepInfer 深度解析 与 32:存储分层 KV Cache。
参考资料
规范与文档
- vLLM Documentation, Disaggregated Encoder (EPD) User
Guide(
--mm-encoder-only、--ec-transfer-config、ECMooncakeConnector与ECSharedStorageConnector参数说明),https://docs.vllm.ai/。 - NVIDIA Dynamo & NIXL Documentation, Multimodal Encode-Prefill-Decode Disaggregation Architecture(E/PD 与 E/P/D 拓扑及 NIXL 传输抽象),https://github.com/ai-dynamo/dynamo。
- Wan-AI, Wan2.1-T2V-14B
公开模型配置(
config.json:dim=5120,ffn_dim=13824,num_heads=40,num_layers=40,text_len=512,Wan-VAE 4x8x8),https://huggingface.co/Wan-AI/Wan2.1-T2V-14B。 - DeepSeek-AI, DeepInfer
README.md与doc/inference_deployment_qa.md(commit5537415,开源边界与未开源 VE Load Balancer 说明),https://github.com/deepseek-ai/DeepInfer。
核心论文
- Peebles, W. & Xie, S. Scalable Diffusion Models with Transformers (DiT). ICCV 2023 (Oral).
- Liu, X., Gong, C. & Liu, Q. Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow. ICLR 2023.
- Song, Y. et al. Consistency Models. ICML 2023.
- Jacobs, S. A. et al. DeepSpeed Ulysses: System
Optimizations for Enabling Training of Extreme Long Sequence
Transformer Models. arXiv
预印本,未经同行评审
(
arXiv:2309.14509, 2023). - Liu, H. et al. Ring Attention with Blockwise Transformers for Near-Infinite Context. ICLR 2024.
- Li, M. et al. DistriFusion: Distributed Parallel Inference for High-Resolution Diffusion Models. CVPR 2024 (Highlight).
- Ma, X., Fang, G. & Wang, X. DeepCache: Accelerating Diffusion Models for Free. CVPR 2024.
- Zhong, Y. et al. DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving. OSDI 2024.
- Yin, T. et al. DMD2: Improved Distribution Matching Distillation for Fast Image Synthesis. NeurIPS 2024.
- Fang, J. & Zhao, S. USP: A Unified Sequence
Parallelism Approach for Long Context Generative AI.
arXiv 预印本,未经同行评审
(
arXiv:2405.07719, 2024). - Fang, J. et al. PipeFusion: Patch-level Pipeline
Parallelism for Diffusion Transformers Inference.
arXiv:2405.14430(2024 年 5 月预印本),后收录于 NeurIPS 2025. - Fang, J. et al. xDiT: an Inference Engine for
Diffusion Transformers (DiTs) with Massive Parallelism.
arXiv 预印本,未经同行评审
(
arXiv:2411.01738, 2024). - Défossez, A. et al. Moshi: a speech-text foundation
model for real-time dialogue. Kyutai, arXiv
预印本,未经同行评审
(
arXiv:2410.00037, 2024). - Wang, P., Bai, S. et al. Qwen2-VL: Enhancing
Vision-Language Model’s Perception of the World at Any
Resolution. arXiv 预印本,未经同行评审
(
arXiv:2409.12191, 2024);Bai, S. et al. Qwen2.5-VL Technical Report. arXiv 预印本,未经同行评审 (arXiv:2502.13923, 2025). - Qin, R. et al. Mooncake: Trading More Storage for Less Computation — A KVCache-centric Architecture for Serving LLM Chatbot. USENIX FAST 2025 (Best Paper Award).
- Liu, F. et al. Timestep Embedding Tells: It’s Time
to Cache for Video Diffusion Models (TeaCache).
CVPR 2025 (Highlight,
arXiv:2411.19108). - Li, M. et al. SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models. ICLR 2025 (Spotlight).
- Zhao, T. et al. ViDiT-Q: Efficient and Accurate
Quantization of Diffusion Transformers for Image and Video
Generation. ICLR 2025
(
arXiv:2406.02540). - Qwen Team. Qwen2.5-Omni Technical Report.
arXiv 预印本,未经同行评审
(
arXiv:2503.20215, 2025). - Chung, J.-W., Ma, J. J. et al. Cornserve: A
Distributed Serving System for Any-to-Any Multimodal
Models. arXiv 预印本,未经同行评审
(
arXiv:2603.12118, 2026;Demo 入选 ACM CAIS 2026).
开源项目与源码
- xDiT:支持 CFG、USP、PipeFusion 与混合 4D 并行的 DiT 分布式推理引擎。
- Cornserve:面向 Any-to-Any 多模态模型的 Model Fission 与分布式编排运行时。
- vLLM
/ vLLM-Omni:
ECConnector、--mm-encoder-onlyEPD 分离与多模态生成扩展。 - NVIDIA Dynamo / NIXL:多节点 E/P/D 分离编排与 RDMA/NVLink 推理传输库。
- TeaCache:时间步调制感知动态缓存官方实现及多项式重标定系数库。
- Moshi:Kyutai 开源的 Mimi 12.5 Hz 流式音频编解码器与双流全双工对话推理代码。
- Qwen2.5-Omni:Thinker-Talker 全模态模型与流式语音合成实现。
- Wan2.1:3D Causal VAE 与 1.3B / 14B 视频扩散 Transformer 开源权重与推理参考。
上一篇:33:RLVR 与 Agentic 后训练基础设施实战
源码下载
本文相关源码已整理,共 1 个文件。
文章导航
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【大模型基础设施工程】11:推理引擎基础
从 Prefill/Decode 两阶段、KV Cache、Roofline 拆解、Continuous Batching 到 PD 分离,系统讲清大模型推理的工程基础。
【大模型基础设施工程】16:长上下文工程
从 4K 到 1M+ 上下文的训练与推理工程全景:RoPE 与 YaRN 频率/温度修正、MQAR 召回下界与 Hybrid 架构(Gemma 3 / Qwen3-Next / Llama 4)、NSA 与 DeepSeek-V3.2 DSA、Zig-Zag Ring / Ulysses / USP 序列并行、MLA…
【大模型基础设施工程】21:推理服务化
从单机引擎到生产集群:Gateway API Inference Extension(llm-d)、Dynamo、AIBrix、KServe、Ray Serve、PD 分离、KV-aware 路由、LoRA 多租户与冷启动优化全景工程实战。
【大模型基础设施工程】25:大模型基础设施未来
主线收官与演进路线:从 2022–2026 四年拐点出发,梳理推理时 Scaling、RLVR、存储分层 KV、世界模型、Agentic OS、专用芯片与 800 VDC、混合架构、端侧、成本与合规趋势,并索引全系列 35 篇。