回测通常默认三件事:按中价(mid price)成交、自己的单子不推动价格、盘口永远有量可吃。实盘里每一笔非零数量的交易都要付价差、付冲击,还要承担被更知情的对手方逆向选择(adverse selection)的损失。常见误区是把这些都折成一个固定的「滑点 bp」:它把订单簿形状、信息不对称、流动性恢复速度三种机制混在一起,换品种、换时段、换规模就失效。本文回答一个具体问题:这些成本分别从订单簿的哪里来,用什么可计算的指标量出来。路线是从限价订单簿(Limit Order Book,LOB)的数据模型出发,把价差拆成四种口径并做结构分解,把流动性拆成四个维度,再讲订单流不平衡(OFI)、Kyle λ、PIN/VPIN 和 Hawkes 过程;价差分解、OFI 与 Kyle λ 都在币安 LTCUSDT 永续合约一天的真实盘口数据上复现,Hawkes 的估计陷阱用模拟数据演示。冲击成本模型的标定、Almgren-Chriss 最优执行、Implementation Shortfall 与 TCA 放在姊妹篇《交易成本模型》,本文只交代冲击的微结构来源。
速查表
| 概念 | 一句话定义 | 可计算指标 | 见 |
|---|---|---|---|
| L1 / L2 / L3 订单簿 | 按价格、时间排队的未成交限价单,三种聚合粒度 | best bid/ask、档量、队列位置 | 第一节 |
| 加权中价 / 微观价 | 用最优档量不平衡修正的中价 | \((q_b a + q_a b)/(q_a+q_b)\);Stoikov micro-price | 第一节 |
| 报价价差 | 挂出来的最优卖价减最优买价 | \(a_t - b_t\) | 第二节 |
| 有效价差 | 成交价偏离成交前中价的 2 倍 | \(2D_t(p_t - m_t)\) | 第二节 |
| 已实现价差 | 流动性提供者在 \(\Delta\) 之后真正留住的部分 | \(2D_t(p_t - m_{t+\Delta})\) | 第二节 |
| 价格冲击(逆向选择) | 成交后中价朝成交方向的漂移 | \(2D_t(m_{t+\Delta} - m_t)\) | 第二、五节 |
| 价差结构分解 | 订单处理、库存、逆向选择各占多少 | Roll、Glosten-Harris、Huang-Stoll 回归 | 第二节 |
| 流动性四维 | 紧度、深度、即时性、弹性 | 价差、档量、Amihud、冲击半衰期 | 第三节 |
| Kyle λ | 单位净订单流推动的价格 | \(\Delta p = \lambda Q + \varepsilon\) 的斜率 | 第三节 |
| OFI | 最优档上买方净增量减卖方净增量 | Cont-Kukanov-Stoikov 的 \(e_n\) 求和 | 第四节 |
| 永久 / 临时冲击 | 留在价格里的部分 / 之后回吐的部分 | markout 曲线、Hasbrouck VAR | 第五节;标定见第 18 篇 |
| PIN / VPIN | 成交来自知情交易者的概率 / 其成交量同步版本 | EKOP 极大似然;成交量桶失衡 | 第六节 |
| Hawkes 分支比 | 一个事件平均直接触发的后续事件数 | 指数核下 \(n = \alpha/\beta\) | 第七节 |
本文在真实数据和模拟数据上实际跑出的三个结论(脚本与环境见第二、四、七节):
- 币安 LTCUSDT 永续 2023-05-17 08:46 至 24:00(UTC),10 秒窗口内最优档 OFI 对中价变化的 \(R^2\) 为 0.61,同窗口带符号成交量只有 0.37。见第四节。
- 同一样本中,有效价差均值 1.58 bp,成交后 0.1 秒就有 1.04 bp 表现为价格冲击,5 分钟后升到 1.26 bp,流动性提供者留住的已实现价差只剩 0.33 bp。见第二节。
- 一个没有任何自激、只是强度在两档之间切换的泊松过程,用指数核 Hawkes 拟合出的分支比约 0.91。Hawkes「临界性」的解读要先排除这种伪临界。见第七节。
上一篇《市场结构:交易所、做市商、暗池、ECN》讨论交易场所和制度;本文把镜头推到撮合引擎门口的那张订单簿上,讨论微秒到分钟尺度。撮合本身怎么实现,见《撮合引擎实现》;本文关心的是撮合留下的痕迹该怎么读。
一、限价订单簿:所有微结构现象的载体
1.1 数据模型:三层抽象
订单簿在不同层次上呈现给不同消费者。把这一点搞清楚,可以避免大量「为什么我看到的数据和别人不一样」的混乱。
| 层级 | 内容 | 典型数据源 | 适合做什么 |
|---|---|---|---|
| L1 | 最优买价、最优卖价、最优档量 | 多数行情终端、Level-1 行情、币安
bookTicker |
计算中价、报价价差、最优档 OFI |
| L2 | 全部价格档的聚合数量(每档累计 qty,部分源带单数) | 沪深 Level-2、Nasdaq TotalView 聚合视图、币安
depth |
看深度、多档不平衡 |
| L3 | 每一笔单独订单(order id、到达时间、修改撤单事件) | Nasdaq TotalView-ITCH、CME MDP 3.0 MBO | 排队位置预测、Hawkes 估计、做市回测 |
L2 和 L3 的差别不只是分辨率:L2 把同一价格上的所有订单聚合成一个数字,丢掉了「我排在第几位」。要预测排队位置(queue position)的策略,例如做市挂单、被动执行算法,必须用 L3 或对 L2 做排队近似(见第 8.10 节)。做秒级方向预测的统计套利,L1/L2 通常够用,本文第二、四节的实证只用了 L1。
下图是一个 L2 快照的示意。100.04 这一档没有挂单,价差是 2 个 tick。

1.2 价格优先、时间优先
几乎所有连续竞价市场使用价格优先、时间优先(price-time priority)撮合:价格更优的订单先成交;同价位按到达时间先进先出(FIFO)。上交所、深交所《交易规则》对竞价交易都规定按价格优先、时间优先撮合;集合竞价阶段按「最大成交量」等原则确定单一成交价,同一价格内仍按时间先后成交。
时间优先在工程上有一个常被忽略的细节:改单是否保留优先级。以 CME Globex 为例,减少数量保留原队列位置,改价或增加数量视为新单重新排队;A 股委托不能修改,只能撤单后重新申报,重新排到队尾。各市场的具体语义见《订单类型与执行语义》。这条规则直接决定做市策略的挂单管理:任何「轻轻动一下报价」都要付出排队位置的代价。
1.3 队列位置的价值
排在队列前面有两重好处:更早成交、拿到价差;以及更少「最后才成交」。队尾订单往往恰好在该价位即将被吃穿、价格随即朝不利方向跳动时才成交,这就是逆向选择。Moallemi 与 Yuan 在 A Model for Queue Position Valuation in a Limit Order Book(工作论文,SSRN 2017)中把队列位置价值拆成两部分:静态部分是价差收益与逆向选择成本之差,越靠后越差;动态部分是保住位置的期权价值。他们的结论是,在大 tick 品种上,队列位置的价值可以与半个价差同量级。
由此推出的经验规则:tick 相对价格越大,价差越容易被钉在 1 个 tick、队列越长,排队位置越值钱;tick 相对价格越小,价差可以在多个 tick 间浮动,抢一个更优价位比排队更有效。A 股最小变动单位 0.01 元,30 元的股票一个 tick 约 3.3 bp,3 元的股票约 33 bp,后者是更「大 tick」的品种。本文实证用的 LTCUSDT 永续中价中位数 92.56 USDT、tick 0.01,97.7% 的盘口更新里价差恰好 1 个 tick,同样处于大 tick 状态。
1.4 隐藏单与冰山单
L2 看到的档量未必是真实供给:
- 隐藏单(hidden order):Nasdaq 等市场允许订单不在公开簿上展示但参与撮合,同价位排在显示订单之后。A 股没有隐藏单,所有订单都在公开簿上展示(见《订单类型与执行语义》第四节)。隐藏流动性对 OFI 是噪声源:最优档量没变,成交却发生了。
- 冰山单(iceberg order):只显示一部分,显示部分被吃完后从隐藏部分补一片到该价位队尾。公开簿上的表现是「同一档被吃完后立刻有同样大小的单子补上」。
识别冰山的一个工程启发式(经验判断,非文献结论):短窗口内同一价位反复出现「被吃完、立即补上相同数量」的模式。对做市策略,遇到冰山意味着价格被某个不可见的供给压住,按可见深度估计的冲击会偏大。
1.5 加权中价与微观价
中价 \(m = (a+b)/2\) 忽略了最优档的量。当买盘远厚于卖盘时,下一次价格变动更可能向上。常用的修正是按对侧挂单量加权的加权中价(weighted mid):
\[ p_{\text{w}} = \frac{q_b \cdot a + q_a \cdot b}{q_a + q_b} \]
其中 \(q_a, q_b\) 是最优卖、最优买的挂单量。\(q_b\) 大时权重落在 \(a\) 上,价格偏向卖价。图 1 右侧的例子里 \(q_b = 700\)、\(q_a = 500\),加权中价 100.042,高于中价 100.040。
Stoikov 在 The Micro-Price: A High-Frequency Estimator of Future Prices(Quantitative Finance, 18(12), 2018)中提出的 micro-price 与加权中价不同:它被定义为在当前不平衡和价差状态下、未来中价条件期望序列的极限,需要从数据里估计状态转移,而不是直接用上式。加权中价是更简单的启发式。两者的共同出发点「最优档不平衡包含短期价格方向信息」,正是第四节 OFI 的思想来源。
二、买卖价差:四种定义与结构分解
价差不是一个数字。报价价差、有效价差、已实现价差、价格冲击回答的是不同的问题,混用会让交易成本、做市收益和市场质量的讨论全部失焦。

2.1 报价价差(Quoted Spread)
\[ S^q_t = a_t - b_t \]
或归一化为相对价差 \(S^q_t / m_t\)。报价价差是「看到的成本」,不是「实际付出的成本」:单子可能吃穿多档,也可能用限价单在中价附近被动成交。
2.2 有效价差(Effective Spread)
\[ S^e_t = 2 D_t (p_t - m_t) \]
\(D_t \in \{+1, -1\}\) 是成交方向(买方主动为 \(+1\))。乘以 2 是为了与报价价差同量纲:恰好在最优价成交时 \(S^e_t = S^q_t\);吃穿多档时 \(S^e_t > S^q_t\)。
方向 \(D_t\) 常常拿不到,需要推断。最常用的是 Lee 与 Ready(Journal of Finance, 46(2), 1991)的算法:成交价高于中价标 \(+1\),低于中价标 \(-1\);恰好等于中价时用 tick test(与上一笔不同成交价比较,价升 \(+1\)、价降 \(-1\))。原文针对当时 NYSE 报价时间戳滞后的问题,建议用成交前 5 秒的报价,现代毫秒级数据不应照搬这一滞后。
币安 aggTrades
自带主动方标志(is_buyer_maker),可以直接检验报价规则。用成交前最近一条(严格早于成交时刻的)最优报价判断,LTCUSDT
样本 208,554
笔非中价成交里,报价规则与交易所标志一致的比例是
99.17%,恰好落在中价上的成交只有 0.05%。在价差被钉在 1 个
tick
的品种上,报价规则几乎就是真值;价差宽、成交常落在价差内部的品种上,误判率会高得多。沪深
Level-2
逐笔成交可以直接或通过买卖委托序号得到主动方向,字段定义以各所行情接口规范为准。
2.3 已实现价差(Realized Spread)
\[ S^r_t = 2 D_t (p_t - m_{t+\Delta}) \]
已实现价差衡量流动性提供者在 \(\Delta\) 之后真正留住的部分:如果买单成交后中价马上被推上去,做市商卖出的那部分价差就有一块被对手方的信息吃掉了。\(\Delta\) 的选择本身就是口径。SEC Rule 605 原先用 5 分钟;2024 年 3 月 SEC 通过的 Rule 605 修订要求在 50 毫秒、1 秒、15 秒、1 分钟和 5 分钟多个时点报告已实现价差,正是因为不同尺度上看到的逆向选择不同。
2.4 价格冲击(Price Impact)
\[ \text{Impact}_t = 2 D_t (m_{t+\Delta} - m_t) \]
由定义直接得到价差分解恒等式:
\[ S^e_t = S^r_t + \text{Impact}_t \]
有效价差的一部分作为提供流动性的补偿留给做市商(已实现价差),另一部分是被逆向选择的代价(冲击)。注意这里的「冲击」是单笔、固定 \(\Delta\) 的口径,在很短的 \(\Delta\) 上它混入了机械性的盘口消耗,不能直接等同于第五节的永久冲击。
2.5 真实数据:markout 曲线
下面用币安 USD-M 永续 LTCUSDT 在 2023-05-17
的公开历史数据(data.binance.vision
的 bookTicker 与 aggTrades
两个文件)计算四种价差。该日 bookTicker 文件从
08:46:22 UTC 开始,样本取与成交重叠的 15.23
小时:最优报价更新 2,143,612 条,主动成交(aggTrade)208,654
笔。方向用交易所的主动方标志,均值按成交笔数等权,单位是成交前中价的
bp,不含手续费。
| markout \(\Delta\) | 报价价差 | 有效价差 | 已实现价差 | 价格冲击 |
|---|---|---|---|---|
| 0.1 s | 1.130 | 1.584 | 0.543 | 1.040 |
| 1 s | 1.130 | 1.584 | 0.456 | 1.128 |
| 5 s | 1.130 | 1.584 | 0.515 | 1.068 |
| 15 s | 1.130 | 1.584 | 0.531 | 1.053 |
| 60 s | 1.130 | 1.584 | 0.371 | 1.212 |
| 300 s | 1.130 | 1.584 | 0.327 | 1.257 |
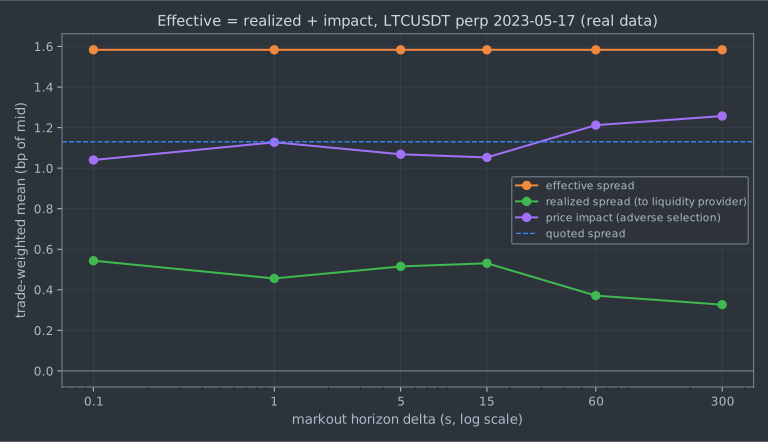
这张图回答「有效价差里多少是做市补偿、多少是逆向选择」。从表里能读出三件事:
- 有效价差高于报价价差(1.58 vs 1.13 bp)。12.5% 的成交有效价差大于当时的报价价差:一部分是吃穿多档(同一毫秒、同一方向的主动成交里 6.8% 触及不止一个价位),一部分是毫秒级时间戳下「严格早于成交」的报价已经略微过时。
- 0.1 秒内冲击就占了有效价差的三分之二。在价差钉在 1 tick 的市场上,一笔吃光最优档的主动单会让中价机械地移动半个 tick,这部分在恒等式里记作冲击,但它来自盘口消耗而不一定是信息。
- 1 秒处冲击(1.128)高于 5 秒和 15 秒,之后再上升到 1.257。短时超调有一部分会回吐,这是第五节「临时冲击」的直接证据;5 分钟时做市商每笔只留住 0.33 bp,扣掉手续费后是否为正取决于费率等级。
这只是一个合约、一天的数据,结论的作用是说明口径和量级关系,不能外推到其他品种或其他日期。
2.6 从成交价反推并分解价差:Roll → Glosten-Harris → Huang-Stoll
有效价差需要报价;没有报价、只有成交价时,可以从价格的统计结构里反推价差,再进一步把价差拆成成本来源。这一支文献的演进是:
Roll(Journal of Finance, 39(4), 1984)。假设有效价格随机游走、成交方向独立同分布且与价格新息无关,成交价在买卖价之间来回弹跳(bid-ask bounce),相邻价格变化的一阶自协方差为:
\[ \operatorname{Cov}(\Delta p_t, \Delta p_{t-1}) = -\frac{S^2}{4}, \qquad \hat{S} = 2\sqrt{-\widehat{\operatorname{Cov}}(\Delta p_t, \Delta p_{t-1})} \]
Roll 模型隐含价差全是订单处理成本:成交不改变有效价格。自协方差为正时(成交方向持续、存在信息冲击)估计量无定义。
Glosten 与 Harris(Journal of Financial Economics, 21(1), 1988)。把价差拆成会回吐的暂时部分和改变有效价格的逆向选择部分,并允许两者随成交量 \(V_t\) 线性变化:
\[ p_t = m_t + Q_t (c_0 + c_1 V_t), \qquad m_t = m_{t-1} + Q_t (z_0 + z_1 V_t) + \varepsilon_t \]
\(Q_t\) 是方向,\(c\) 项是暂时成本,\(z\) 项是逆向选择成本。这是「永久 vs 临时」区分在价差层面的第一个可估计模型。
Huang 与 Stoll(Review of Financial Studies, 10(4), 1997)。在一个统一框架里同时纳入订单处理、库存和逆向选择三部分。其基本模型是:
\[ \Delta p_t = \frac{S}{2} Q_t + (\lambda - 1)\frac{S}{2} Q_{t-1} + e_t \]
\(\lambda\) 是半价差里逆向选择加库存成本的份额,\(1-\lambda\) 是订单处理份额;要进一步分开库存与逆向选择,需要对成交方向的序列相关建模(原文的三方程扩展)。基本模型在方向已知时就是一个无截距的 OLS。
把 Roll 和 Huang-Stoll 基本模型都放到上面的 LTCUSDT 成交序列上(同一个脚本,实际运行输出,以下输出经删减):
Roll spread from aggTrades: 0.01322 USDT  vs mean quoted 0.01029 USDT
Huang-Stoll basic model on aggTrades: S_hat=0.01373 USDT  adverse-selection+inventory share lambda=0.602  order-processing share=0.398  R2=0.420
两种成交价估计量给出的价差(0.0132、0.0137 USDT)都接近有效价差(1.58 bp × 92.56 ≈ 0.0147 USDT),高于报价价差,与 2.5 节的观察一致。Huang-Stoll 的 \(\hat\lambda = 0.60\) 和 markout 表里冲击占有效价差的比例(0.1 秒 0.66、5 分钟 0.79)在同一量级,但两者口径不同:前者是逐笔价格变化的回归,后者依赖 \(\Delta\) 的选择。Roll 模型「价差全是订单处理」的假设在这个样本上显然不成立。
2.7 只有日级数据时的价差估计
做跨国、跨年代的横截面研究时,经常只有日级 OHLC。两个常用估计量:
Corwin 与 Schultz(Journal of Finance, 67(2), 2012)利用日内最高价与最低价:
\[ \hat{S}_{CS} = \frac{2(e^\alpha - 1)}{1 + e^\alpha}, \quad \alpha = \frac{\sqrt{2\beta} - \sqrt{\beta}}{3 - 2\sqrt{2}} - \sqrt{\frac{\gamma}{3 - 2\sqrt{2}}} \]
\(\beta\) 是相邻两日 \([\ln(H/L)]^2\) 之和,\(\gamma\) 是两日合并后的 \([\ln(H_{2d}/L_{2d})]^2\)。直觉是:日内最高价多为买方主动成交、最低价多为卖方主动成交,高低价比同时包含波动和价差,而波动部分随窗口长度线性增长、价差部分不增长,用一日和两日窗口就能把两者分开。
Abdi 与 Ranaldo(Review of Financial Studies, 30(12), 2017)引入收盘价,记 \(\eta_t = (\ln H_t + \ln L_t)/2\)、\(c_t = \ln C_t\):
\[ \hat{S}_{AR} = 2 \sqrt{\max\left(0,\ \mathbb{E}\left[(c_t - \eta_t)(c_t - \eta_{t+1})\right]\right)} \]
两者都只适合日级以上的横截面研究,不要用于日内策略。
2.8 代码:用 polars 计算四种价差
以下函数与同目录脚本 ofi_spread_analysis.py
中的实现一致(Python 3.12.10、polars 2.0.0、numpy
2.5.3、statsmodels 0.15.0,Windows
11)。脚本会自动下载上文的币安数据并输出本文所有真实数据表格。
import polars as pl

NS = 1_000_000_000

def estimate_spreads(trades: pl.DataFrame, quotes: pl.DataFrame, delta_s: float = 300) -> pl.DataFrame:
    """
    trades: ts(int64 ns), price(float64), qty(float64)
    quotes: ts(int64 ns), bid(float64), ask(float64)
    返回每笔成交的 quoted / effective / realized spread 与 price impact。
    """
    quotes = quotes.sort("ts").with_columns(
        (pl.col("ask") - pl.col("bid")).alias("S_q"),
        ((pl.col("ask") + pl.col("bid")) * 0.5).alias("mid"),
    )
    # 只取严格早于成交时刻的报价:同一毫秒的报价可能已经包含这笔成交
    aligned = trades.sort("ts").join_asof(
        quotes.select("ts", "S_q", "mid"), on="ts", strategy="backward", allow_exact_matches=False
    )
    aligned = aligned.with_columns(
        pl.when(pl.col("price") > pl.col("mid")).then(1)
        .when(pl.col("price") < pl.col("mid")).then(-1)
        .otherwise(0).alias("dir_lr"),
        (pl.col("ts") + int(delta_s * NS)).alias("ts_target"),
    )
    fwd = quotes.select(pl.col("ts").alias("ts_fwd"), pl.col("mid").alias("mid_fwd"))
    aligned = aligned.sort("ts_target").join_asof(
        fwd, left_on="ts_target", right_on="ts_fwd", strategy="backward"
    ).sort("ts")
    d = pl.col("dir_lr")
    return aligned.with_columns(
        pl.col("S_q").alias("quoted_spread"),
        (2 * d * (pl.col("price") - pl.col("mid"))).alias("effective_spread"),
        (2 * d * (pl.col("price") - pl.col("mid_fwd"))).alias("realized_spread"),
        (2 * d * (pl.col("mid_fwd") - pl.col("mid"))).alias("price_impact"),
    )
dir_lr 是 Lee-Ready
报价规则的方向;有交易所主动方标志时(如币安
is_buyer_maker),应当用标志替换它,2.5
节的表就是这样算的。两个对齐细节决定结果是否可信:
- 成交前报价用
join_asof(strategy="backward", allow_exact_matches=False)。毫秒时间戳下,同一毫秒内的报价更新可能已经反映了这笔成交。在 LTCUSDT 样本上把allow_exact_matches改成True,有效价差为负(成交价在中价「错误的一侧」)的成交从 0.83% 跳到 9.58%,有效价差与报价价差之比从 1.396 降到 0.961:允许同毫秒匹配会系统性地低估成交成本。 - \(m_{t+\Delta}\) 用「目标时刻之前最后一条报价」,同样是向后对齐。向前对齐会把还没发生的报价用进来。
allow_exact_matches  mean(eff/quoted)  share_eff>quoted  share_eff<0
              False             1.396            0.1246       0.0083
               True             0.961            0.0573       0.0958
Roll 估计量只需要成交价序列:
import numpy as np

def roll_spread(prices: np.ndarray) -> float:
    dp = np.diff(prices)
    cov = np.cov(dp[:-1], dp[1:], ddof=0)[0, 1]
    return float("nan") if cov >= 0 else 2.0 * np.sqrt(-cov)
三、流动性的四个维度
把流动性折成一个数字一直不可靠。Kyle(Econometrica, 53(6), 1985)把市场流动性描述为紧度(tightness)、深度(depth)、弹性(resiliency)三个方面;Harris 在 Trading and Exchanges(Oxford University Press, 2003)中用即时性(immediacy)、宽度(width)、深度、弹性四个维度。合起来:
| 维度 | 中文 | 衡量什么 | 典型指标 |
|---|---|---|---|
| Tightness / Width | 紧度 | 一笔小单的成交成本 | 报价价差、有效价差 |
| Depth | 深度 | 不动价位能成交的量;单位流量推动价格多少 | 最优档量、累计 5 档量、Kyle λ、Amihud |
| Immediacy | 即时性 | 能否立即成交 | 是否连续撮合、市价单成交时间 |
| Resiliency | 弹性 | 受冲击后恢复的速度 | 冲击半衰期、盘口补单速率 |
四个维度可以独立变化。大 tick 品种上紧度几乎是常数(LTCUSDT 样本 97.7% 的更新里价差是 1 tick),深度却在变:同一天里按 30 分钟窗口平均的最优档深度在 111 到 174 LTC 之间(第四节图中 (c) 的横轴)。只盯价差的成本模型看不到这类变化。
3.1 Kyle λ:把深度量化成一个斜率
Kyle(1985)的单期模型里,知情交易者与噪声交易者同时提交市价单,做市商只看到净订单流 \(x + u\),按线性规则定价:
\[ p = \mu + \lambda (x + u), \qquad \lambda = \frac{1}{2}\frac{\sqrt{\Sigma_0}}{\sigma_u} \]
\(\Sigma_0\) 是有效价值的先验方差,\(\sigma_u\) 是噪声交易量的标准差。λ 越大,同样的净订单流推动价格越多,市场越「浅」;噪声交易越多,知情交易者越容易隐藏,λ 越小。模型里这一冲击是永久的:价格因为订单流携带的信息而改变(第五节)。
实证上常用桶化回归 \(\Delta p_t = \lambda Q_t + \varepsilon_t\) 估计,\(Q_t\) 是窗口内带符号成交量:
import polars as pl
import statsmodels.api as sm

def estimate_kyle_lambda(trades: pl.DataFrame, quotes: pl.DataFrame, bucket_ms: int = 1000) -> dict:
    """
    trades: ts, qty, side(+1 买方主动,-1 卖方主动)
    quotes: ts, bid, ask
    每个桶的中价变化对净成交量做 OLS,标准误用 HAC(Newey-West)。
    """
    w = bucket_ms * 1_000_000
    q = quotes.with_columns(
        ((pl.col("ask") + pl.col("bid")) * 0.5).alias("mid"),
        (pl.col("ts") // w * w).alias("bucket"),
    )
    mid = q.group_by("bucket").agg(pl.col("mid").sort_by("ts").last())
    flow = (
        trades.with_columns((pl.col("ts") // w * w).alias("bucket"), (pl.col("side") * pl.col("qty")).alias("signed_qty"))
        .group_by("bucket")
        .agg(pl.col("signed_qty").sum())
    )
    df = (
        mid.join(flow, on="bucket", how="left")
        .sort("bucket")
        .with_columns(pl.col("signed_qty").fill_null(0.0), pl.col("mid").diff().alias("d_mid"))
        .drop_nulls()
    )
    X = sm.add_constant(df["signed_qty"].to_numpy())
    res = sm.OLS(df["d_mid"].to_numpy(), X).fit(cov_type="HAC", cov_kwds={"maxlags": 5})
    return {"lambda": float(res.params[1]), "t_hac": float(res.tvalues[1]), "r2": float(res.rsquared), "n": int(res.nobs)}
在 LTCUSDT 样本上用 1 秒桶的实际输出:
Kyle lambda (1 s): 2.800e-05 USDT per LTC, HAC t=17.1, R2=0.473, n=54209即 1 秒内净买入 1,000 LTC,中价平均上移约 0.028 USDT(2.8 个 tick)。几点口径:
- 桶长决定 λ 的含义。1 秒的 λ 是即时冲击,5 分钟的 λ 包含了盘口补单之后的吸收,两者不能直接比较。
- 高频回归残差有异方差和自相关,普通 OLS 的 t 统计量偏乐观,上面用了 Newey-West HAC 标准误。
- 开盘、收盘、新闻时段 λ 会跳升,做截面比较时要单独处理这些时段。
- 用 VAR 区分「非预期订单流」并估计长期累积响应(Hasbrouck, Journal of Finance, 46(1), 1991)的做法,以及 λ 与平方根律在不同时间尺度上的关系,见《交易成本模型》第三节。
3.2 Amihud 非流动性指标
低频研究里更常用 Amihud(Journal of Financial Markets, 5(1), 2002)的指标:
\[ \text{ILLIQ}_i = \frac{1}{N_i} \sum_{d=1}^{N_i} \frac{|r_{i,d}|}{\text{DVOL}_{i,d}} \]
\(r_{i,d}\) 是日收益率,\(\text{DVOL}_{i,d}\) 是日成交额。它和 Kyle λ 同源,都是「单位成交额对应的价格变动」,但只用日级数据就能算。Goyenko、Holden 与 Trzcinka(Journal of Financial Economics, 92(2), 2009)以 TAQ 高频数据计算的价格冲击为基准,比较多种低频流动性代理,Amihud 类指标是对价格冲击跟踪较好的一类。横截面因子与风险模型里用的「流动性」多半就是它。
3.3 弹性:冲击半衰期
弹性最常用的测量是冲击半衰期:一笔大额主动单之后,中价从冲击峰值回落一半所需的时间。做法:
- 筛出足够大的事件(例如成交量超过近期均值数倍的主动单簇)。
- 以事件时刻对齐(event time),取前后若干秒的中价序列。
- 对所有事件求 \(m(\tau) - m(0)\) 的均值曲线,拟合 \(m(\tau) = a + b e^{-\tau/T}\),半衰期 \(T_{1/2} = T \ln 2\)。
半衰期因品种、时段差异很大,没有可直接套用的数值,必须按自己的标的估计。Obizhaeva 与 Wang(Journal of Financial Markets, 16(1), 2013)的最优执行模型把盘口以指数速率补单写成参数,弹性在那里直接决定拆单节奏,这部分应用见第 18 篇。
3.4 即时性
在连续撮合、深度尚可的市场里,「愿意付报价价差就能马上成交」,即时性常常并入紧度讨论。以下场景里它是独立维度:
- 集合竞价:沪深开盘集合竞价(9:15–9:25)、收盘集合竞价(14:57–15:00)、港股开市前时段(POS)不连续撮合,只能等到撮合时刻。
- 暗池与 RFQ:要等对手匹配或多家报价返回,即时性以秒到分钟计。
- 熔断与临时停牌:期间无法成交。
在压力情景下回测的策略需要显式建模「来不及成交」,否则会低估尾部风险。
四、订单流不平衡(OFI)
Cont、Kukanov 与 Stoikov 在 The Price Impact of Order Book Events(Journal of Financial Econometrics, 12(1), 2014)中定义了订单流不平衡(Order Flow Imbalance,OFI)。他们的核心发现是:在短时间窗口内,价格变化主要由最优档上的供需不平衡驱动,而不是由成交量驱动。限价单、市价单、撤单都会改变最优档的可见量,OFI 把三类事件放进同一个有符号的量里。
4.1 定义
对第 \(n\) 次最优报价更新,记 \(P^b_n, q^b_n\) 为最优买价和量,\(P^a_n, q^a_n\) 为最优卖价和量:
\[ e_n = \mathbb{1}_{\{P^b_n \ge P^b_{n-1}\}} q^b_n - \mathbb{1}_{\{P^b_n \le P^b_{n-1}\}} q^b_{n-1} - \mathbb{1}_{\{P^a_n \le P^a_{n-1}\}} q^a_n + \mathbb{1}_{\{P^a_n \ge P^a_{n-1}\}} q^a_{n-1} \]
窗口内 \(\text{OFI}_k = \sum_{n \in k} e_n\)。拆开看:
- 买价不变时贡献 \(q^b_n - q^b_{n-1}\):买一挂单增加为正,被吃或撤单为负。
- 买价上移时贡献 \(+q^b_n\)(新的更高买价出现);买价下移时贡献 \(-q^b_{n-1}\)(原买一被吃光或撤光)。
- 卖方符号相反:卖一量增加、卖价下移为负。
4.2 与中价变化的线性关系
CKS 在 50 只美股的 NYSE TAQ 数据上回归
\[ \Delta m_k = \alpha + \beta\, \text{OFI}_k + \varepsilon_k \]
发现关系近似线性、斜率与最优档平均深度成反比(\(\beta \approx c / \text{depth}\)),且结论在不同时间尺度和股票之间稳定;论文报告 10 秒窗口下的平均 \(R^2\) 约 65%。他们同时发现,价格变化对成交量的回归噪声大得多;并论证线性 OFI 冲击加上一个尺度论证,可以推出经验上的「平方根」型价格变化与成交量关系。
在 LTCUSDT 样本上复现同一回归(\(\Delta m\) 以 tick 计,OFI 以 LTC 计,同时与带符号成交量做对照):
| 桶长 | 桶数 | OFI 斜率(tick/LTC) | \(R^2\)(OFI) | \(R^2\)(带符号成交量) |
|---|---|---|---|---|
| 1 s | 54,210 | 0.00234 | 0.600 | 0.473 |
| 5 s | 10,845 | 0.00230 | 0.638 | 0.395 |
| 10 s | 5,424 | 0.00225 | 0.614 | 0.373 |
| 30 s | 1,811 | 0.00218 | 0.540 | 0.424 |
| 60 s | 907 | 0.00203 | 0.486 | 0.476 |
按 30 分钟窗口分别估计 10 秒桶的斜率,再对窗口平均深度做双对数回归:31 个窗口,指数为 \(-0.741\),\(R^2 = 0.367\)。
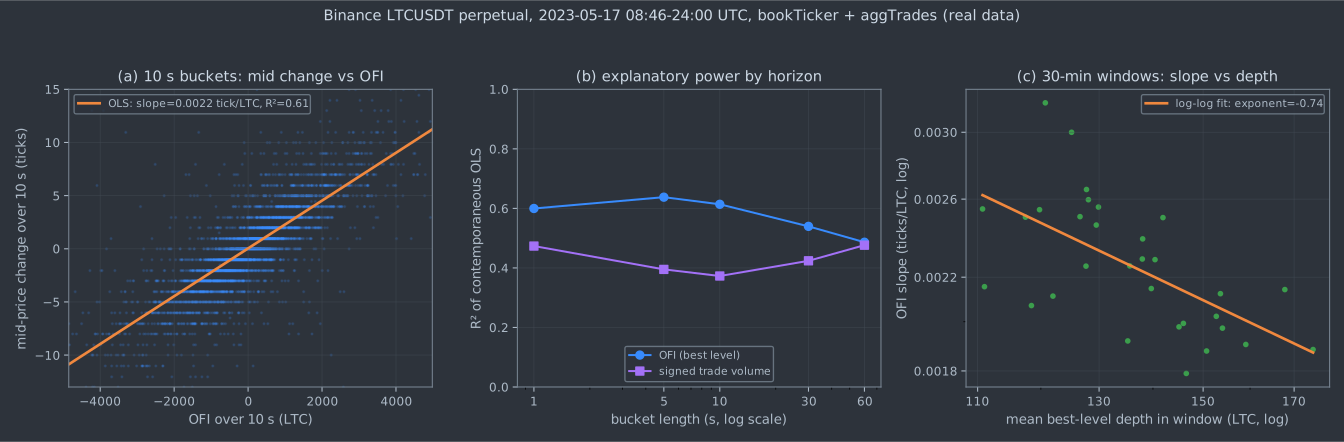
图 (a) 回答「OFI 与中价变化是不是线性」:中价变化是离散的半 tick 台阶,但条件均值沿回归线排列。图 (b) 回答「OFI 比成交量多解释多少」:1 到 10 秒尺度 OFI 的 \(R^2\) 比带符号成交量高 0.13 到 0.24,60 秒时两者接近,在这个样本里 OFI 的优势集中在 10 秒以内。图 (c) 回答「斜率是否随深度下降」:方向与 CKS 一致,但指数 \(-0.74\) 不等于 \(-1\),且只有 31 个点、拟合度一般,这里只能说「定性一致」。
注意这是同期关系,不是预测:同一窗口的 OFI 解释同一窗口的中价变化。把 OFI 当成下一窗口的预测信号,解释力会低很多,需要单独检验。
4.3 代码:用 polars 计算 OFI
与脚本 ofi_spread_analysis.py
中的实现一致,输入是每次最优报价更新后的一行(币安
bookTicker 正好是这个格式):
import polars as pl

def compute_ofi(book_events: pl.DataFrame, bucket_ns: int = 1_000_000_000) -> pl.DataFrame:
    """
    book_events: 每次最优报价更新一行,列 ts, bid, bid_qty, ask, ask_qty。
    返回每个桶的 OFI、中价变化、平均最优档深度和事件数。
    """
    df = book_events.sort("ts").with_columns(
        pl.col("bid").shift(1).alias("bid_p"),
        pl.col("ask").shift(1).alias("ask_p"),
        pl.col("bid_qty").shift(1).alias("bid_q_p"),
        pl.col("ask_qty").shift(1).alias("ask_q_p"),
        ((pl.col("bid") + pl.col("ask")) * 0.5).diff().alias("d_mid"),
    ).drop_nulls()

    df = df.with_columns(
        (
            (pl.col("bid") > pl.col("bid_p")).cast(pl.Float64) * pl.col("bid_qty")
            - (pl.col("bid") < pl.col("bid_p")).cast(pl.Float64) * pl.col("bid_q_p")
            + (pl.col("bid") == pl.col("bid_p")).cast(pl.Float64) * (pl.col("bid_qty") - pl.col("bid_q_p"))
        ).alias("e_bid"),
        (
            -(pl.col("ask") < pl.col("ask_p")).cast(pl.Float64) * pl.col("ask_qty")
            + (pl.col("ask") > pl.col("ask_p")).cast(pl.Float64) * pl.col("ask_q_p")
            - (pl.col("ask") == pl.col("ask_p")).cast(pl.Float64) * (pl.col("ask_qty") - pl.col("ask_q_p"))
        ).alias("e_ask"),
    ).with_columns((pl.col("e_bid") + pl.col("e_ask")).alias("ofi"))

    return (
        df.with_columns((pl.col("ts") // bucket_ns * bucket_ns).alias("bucket"))
        .group_by("bucket")
        .agg(
            pl.col("ofi").sum(),
            pl.col("d_mid").sum(),
            ((pl.col("bid_qty") + pl.col("ask_qty")) * 0.5).mean().alias("depth"),
            pl.len().alias("n_events"),
        )
        .sort("bucket")
    )
实现上三处最容易出错:
- 价格相等分支:\(P^b_n =
P^b_{n-1}\) 时 \(e_n\) 的买方部分是 \(q^b_n -
q^b_{n-1}\)。定义里两个指示函数同时为
1,代码要显式写成差值,不能只按
>、<分支。 - 符号:卖方各项与买方相反。写反之后 OFI 与中价变化呈负相关,同期回归同样能拿到很高的 \(|R^2|\),容易被误读。
- 价格比较用浮点相等:币安报价是十进制字符串转成的 float,同一价格的 float 表示一致;如果数据经过价格运算(例如复权),先换算成整数 tick 再比较。
4.4 OFI 的适用边界
- 集合竞价时段没有连续的最优报价,OFI 无定义,需要屏蔽。
- 隐藏流动性多的市场:成交吃的是不可见单时,最优档量不变而价格可能变化,OFI 的解释力下降。
- 极薄的盘口:单笔大单会造成最优档剧变,OFI 数值很大但只是孤立事件,同期回归会被少数点主导,需要稳健回归或截尾。
- 只用 L1:价格跳过多个空档时,最优档 OFI 看不到深档的变化,见 4.5 节。
4.5 多档 OFI
最优档 OFI 自然可以扩展到前 \(K\) 档。记 \(e^{(k)}_n\) 为第 \(k\) 档按同样规则计算的增量:
\[ \text{OFI}^{(k)}_t = \sum_{n \in t} e^{(k)}_n, \qquad \text{OFI}^{\text{agg}}_t = \sum_{k=1}^{K} w_k\, \text{OFI}^{(k)}_t \]
两项代表工作:Xu、Gould 与 Howison 的 Multi-Level Order-Flow Imbalance in a Limit Order Book(Market Microstructure and Liquidity, 4(3–4), 2018)在 6 只 Nasdaq 流动性股票上发现,每多纳入一档,同期中价变化回归的样本外拟合度都会提高;Cont、Cucuringu 与 Zhang 的 Cross-Impact of Order Flow Imbalance in Equity Markets(Quantitative Finance, 23(10), 2023)用主成分把前几档 OFI 合成一个 integrated OFI,同期回报回归的调整 \(R^2\) 从最优档 OFI 的约 71% 提升到约 87%,并发现纳入多档信息后,同期的跨资产 OFI 不再提供额外解释力,但滞后的跨资产 OFI 能改善短期收益预测。
工程上,深档的更新延迟和聚合口径在不同数据源之间不一致,档数越多对数据质量要求越高。一个常见的折中是只用前 2 到 3 档、权重随档位递减(例如 1.0、0.5、0.25),这是工程选择,权重应在自己的数据上用样本外拟合度来定。
五、冲击:永久与临时的微结构来源
第二节的价格冲击是单笔、固定 \(\Delta\) 的口径;做执行和容量估计时关心的是一笔大单(metaorder)拆成许多子单执行后的总冲击。两者共用一套概念:永久冲击是留在价格里的部分,临时冲击是执行结束后会回吐的部分。本节只讲这两个概念在订单簿里的来源;冲击模型的函数形式与标定(平方根律、Almgren-Chriss、propagator 模型)、最优执行轨迹、Implementation Shortfall 与 TCA 报表,见《交易成本模型:冲击成本、滑点、Implementation Shortfall 与 TCA》第三到五节。
5.1 临时冲击:盘口消耗与弹性
一笔主动单吃掉最优档后,价格机械地移到下一个有挂单的价位;如果吃穿多档,成交均价沿 L2 的累计深度曲线上升。这部分由订单簿形状决定,与信息无关。之后做市商和其他挂单者补单,盘口逐步恢复,中价部分回落,恢复速度就是第三节的弹性。
- 第 2.5 节 LTCUSDT 的 markout 表里,0.1 秒的冲击(1.04 bp)大部分是这种机械消耗:价差钉在 1 tick 时,吃光一侧最优档会让中价移动半个 tick;1 秒到 15 秒之间冲击从 1.128 回落到 1.053 bp,是超调后的部分回吐。
- CKS(2014)的「斜率与深度成反比」是同一机制在 OFI 层面的表述:最优档越厚,同样的净流量越难把它吃穿。
- Obizhaeva 与 Wang(2013)把「盘口按指数速率补单」写成模型参数,临时冲击按这个速率衰减;Bouchaud、Gefen、Potters 与 Wyart(Quantitative Finance, 4(2), 2004)的 propagator 模型则让每笔成交的冲击按幂律缓慢衰减。
5.2 永久冲击:订单流携带的信息
做市商无法区分对手方是否知情,只能从订单流里推断。买单多,说明有效价值更可能偏高,报价随之上移,并且不会因为执行结束而回落:
- Kyle(1985)里永久冲击对净订单流线性,斜率 λ 由信息不对称程度和噪声交易量决定(第 3.1 节)。
- Glosten 与 Milgrom(1985)里每一笔成交都让做市商的信念更新一次,价差本身就是逆向选择成本(第 6.1 节)。
- Hasbrouck(1991)用订单流与价格的 VAR,把「一单位非预期订单流对价格的长期累积响应」定义为永久冲击,这是实证里最常用的口径。
- 价差层面的对应物是第 2.6 节 Glosten-Harris 的 \(z\) 项和 Huang-Stoll 的 \(\lambda\)。
5.3 概念谱系
| 文献 | 冲击的含义 | 微结构机制 | 本系列哪里展开 |
|---|---|---|---|
| Kyle(1985) | 永久、对净订单流线性 | 知情交易者隐藏在噪声交易里 | 本文 3.1 节 |
| Glosten-Milgrom(1985) | 逐笔信念更新,价差即逆向选择成本 | 做市商贝叶斯定价 | 本文 6.1 节;第 25 篇 |
| Glosten-Harris(1988)、Huang-Stoll(1997) | 价差拆成暂时、库存、逆向选择 | 逐笔价格回归 | 本文 2.6 节 |
| Hasbrouck(1991) | 非预期订单流的长期累积响应 | VAR 识别 | 第 18 篇 |
| Almgren-Chriss(2000) | 永久(对累计量)与临时(对交易速率)作为模型输入 | 不建模盘口,只给函数形式 | 第 18 篇、第 23 篇 |
| Bouchaud et al.(2004) | 冲击按幂律传播核衰减 | 订单流长记忆与价格近随机游走并存 | 第 18 篇 |
| Tóth et al.(2011) | metaorder 总冲击近似 \(\propto \sqrt{Q/V}\) | 潜在流动性(latent liquidity)在价格附近线性增长 | 第 18 篇 |
| Obizhaeva-Wang(2013) | 临时冲击随盘口补单指数衰减 | 订单簿弹性 | 第 18 篇 |
| Cont-Kukanov-Stoikov(2014) | 价格变化 \(\propto\) OFI / 深度 | 最优档消耗 | 本文第四节 |
这张表的主线是:早期模型(Kyle、Glosten-Milgrom)从信息解释冲击,因此冲击是永久的;订单簿实证(Bouchaud 一支、CKS)从盘口消耗与补单解释,因此冲击有相当一部分会衰减;平方根律处在两者的交汇处,它描述的是大量子单累积之后的总冲击。哪种解释在什么尺度上占主导,取决于品种、时段和执行速度,这也是为什么冲击参数必须在自己的成交回报上标定(第 18 篇第三节给出拟合方法)。
六、价格发现:信息如何进入价格
6.1 Glosten-Milgrom 模型
Glosten 与 Milgrom(Journal of Financial Economics, 14(1), 1985)给出最早的逐笔信息不对称定价:
- 比例 \(\mu\) 的交易者知情,知道有效价值 \(V \in \{V_H, V_L\}\);其余 \(1-\mu\) 为噪声交易者,方向随机。
- 竞争性、风险中性的做市商只看到订单序列,零期望利润定价:
\[ a_t = \mathbb{E}[V \mid \text{buy at } t, \mathcal{F}_{t-1}], \qquad b_t = \mathbb{E}[V \mid \text{sell at } t, \mathcal{F}_{t-1}] \]
每一笔成交都把做市商的信念向成交方向更新一格,即使没有任何订单处理或库存成本,价差也严格为正:价差是信息成本。做市视角下的完整推导与 Avellaneda-Stoikov 模型,见《做市策略:Avellaneda-Stoikov 与库存管理》第二、三节。
6.2 PIN
Easley、Kiefer、O’Hara 与 Paperman(Journal of Finance, 51(4), 1996)把这一思想做成可估计的模型:每天以概率 \(\alpha\) 发生信息事件(坏消息的条件概率为 \(\delta\)),知情交易者以强度 \(\mu\) 到达,噪声买卖单各以强度 \(\varepsilon\) 到达,日买单数和卖单数服从泊松混合分布。知情交易概率为:
\[ \text{PIN} = \frac{\alpha \mu}{\alpha \mu + 2\varepsilon} \]
PIN 按日产出一个数字,适合横截面研究。工程上的两个问题:似然函数包含大量阶乘和指数项,直接计算容易数值溢出,需要在对数空间里展开;似然面有多个局部最优,需要多起点优化。另外,模型假设买卖单的到达只来自「知情」和「噪声」两类,做市商的大量双边报价成交、算法拆单的持续单边流都会被吸收到这两类里,解释 PIN 的水平时要谨慎。
6.3 VPIN 与闪崩预测之争
Easley、López de Prado 与 O’Hara(以下简称 ELO)在 Flow Toxicity and Liquidity in a High-Frequency World(Review of Financial Studies, 25(5), 2012)中提出 VPIN(Volume-Synchronized PIN)。它把时间桶换成成交量桶:每累计固定成交量 \(V\) 构成一个桶,用 bulk volume classification(BVC,按桶内价格变化的正态分布函数把成交量分成买卖两部分)得到 \(V^B_i, V^S_i\):
\[ \text{VPIN} = \frac{\sum_{i=1}^{n} |V^S_i - V^B_i|}{n V} \]
ELO 在 The Microstructure of the “Flash Crash”(Journal of Portfolio Management, 37(2), 2011)和 2012 年的 RFS 论文中报告,E-mini S&P 500 期货的 VPIN 在 2010 年 5 月 6 日闪崩之前已升到历史高位,并与未来短期波动在统计上相关,因此可以作为「订单流毒性」的实时预警。
这一结论引发了微结构领域一场有代表性的公开争论:
- 反驳:Andersen 与 Bondarenko 的 VPIN and the Flash Crash(Journal of Financial Markets, 17, 2014, pp. 1–46)在同一合约的逐笔数据上重新计算 VPIN,结论是:它对短期波动的预测力很弱;VPIN 在闪崩之后而不是之前才达到历史高点;其预测内容主要来自与成交强度之间的机械关系。
- 回应:ELO 在同期的 VPIN and the Flash Crash: A Rejoinder(Journal of Financial Markets, 17, 2014, pp. 47–52;工作论文版本题为 VPIN and the Flash Crash: A Comment)中认为,对方批评的是一套他们并不主张的方法、做了他们没有做过的分析、得出了他们没有下过的结论。
- 再回应:Andersen 与 Bondarenko 的 Reflecting on the VPIN Dispute(同刊同卷,pp. 53–64)指出 VPIN 按构造就与成交量和波动新息相关,控制当期成交量与波动后没有发现它对未来波动的增量预测力;VPIN 的性质强烈依赖交易分类方法,换成更贴近逐笔的分类,结果与 ELO 的描述方向相反。随后的 Assessing Measures of Order Flow Toxicity and Early Warning Signals for Market Turbulence(Review of Finance, 19(1), 2015)把 VPIN 与其他订单流指标放在同一基准下比较。
可以确定的事实是:VPIN 的数值依赖桶大小、BVC 的窗口和分布假设,跨品种比较必须按日均成交量归一;争论没有解决的是「在控制成交量和波动之后,VPIN 是否还有增量信息」。工程上的稳妥用法是把它当作与成交量、波动并列的监控量,而不是单独的自动减仓触发器。做市场景中按 VPIN 拉宽价差或撤单的实现,见第 25 篇第五节。
6.4 多市场的价格发现:Hasbrouck 信息份额
同一资产在多个市场交易时(交叉上市、ADR、同一币对在多个交易所),价格发现发生在哪里是一个可度量的问题。Hasbrouck(Journal of Finance, 50(4), 1995)的信息份额(Information Share,IS):
- 多个市场的价格协整,共享一个随机游走的有效价格;估计向量误差修正模型(VECM)。
- 有效价格新息的方差中,各市场价格新息贡献的比例即信息份额。
- 各市场新息相关时,Cholesky 分解的排序不同会给出不同结果,IS 实际给出的是上下界。
Gonzalo 与 Granger(Journal of Business & Economic Statistics, 13(1), 1995)的成分份额(component share)用误差修正系数做另一种分解。两者回答的问题不完全相同,实证上常常并列报告。
七、订单簿动力学:Hawkes 过程与临界性
把订单簿事件(成交、挂单、撤单、中价变化)看作时间点过程,自激的 Hawkes 过程(Hawkes, Biometrika, 58(1), 1971)是最常用的基线模型。
7.1 Hawkes 过程基础
指数核的一维 Hawkes 过程强度为:
\[ \lambda(t) = \mu + \sum_{t_i < t} \alpha e^{-\beta (t - t_i)} \]
\(\mu\) 是外生基线强度,\(\alpha\) 是每个事件带来的强度跳升,\(\beta\) 是衰减速率。核函数的积分
\[ n = \int_0^\infty \alpha e^{-\beta s}\, ds = \frac{\alpha}{\beta} \]
称为分支比(branching ratio):一个事件平均直接触发的后续事件数。\(n < 1\) 时过程平稳,长期平均强度为 \(\mu / (1 - n)\);\(n\) 也可以解读为事件中「由内生反馈产生」的比例。多维 Hawkes 用矩阵 \(\mathbf{A} \in \mathbb{R}^{K \times K}\) 描述 \(j\) 类事件对 \(i\) 类事件的激发。Bacry、Mastromatteo 与 Muzy 的 Hawkes Processes in Finance(Market Microstructure and Liquidity, 1(1), 2015)是金融应用的综述。
7.2 分支比接近 1 意味着什么
Hawkes 在微结构里最有争议的用法是把分支比当作「市场内生程度」的度量:
- Filimonov 与 Sornette,Quantifying Reflexivity in Financial Markets: Toward a Prediction of Flash Crashes(Physical Review E, 85, 056108, 2012):用指数核 Hawkes 拟合 1998–2010 年 E-mini S&P 500 期货的中价变化,外生驱动的比例从 1998 年的约 70% 降到 2007 年以后不足 30%,即分支比从约 0.3 升到 0.7 以上,并把它解释为市场离临界状态越来越近、闪崩风险上升。
- Hardiman、Bercot 与 Bouchaud,Critical Reflexivity in Financial Markets: A Hawkes Process Analysis(European Physical Journal B, 86(10), 2013):换成幂律核后,核积分在 1998–2011 年始终接近 1,变化的只是相关的时间尺度在缩短。结论是市场一直处于近临界状态,并没有因为交易自动化而变得「更自反」。
- Filimonov 与 Sornette,Apparent Criticality and Calibration Issues in the Hawkes Self-Excited Point Process Model(Quantitative Finance, 15(8), 2015):系统分析估计偏差,指出幂律核的设定本身会带来偏差;更重要的是,对强度发生切换的纯泊松过程拟合 Hawkes,会得到 \(n \approx 1\) 的伪临界值,而真实值是 0。
- Jaisson 与 Rosenbaum,Limit Theorems for Nearly Unstable Hawkes Processes(Annals of Applied Probability, 25(2), 2015)从另一个方向接受了「近临界」:估计结果经常只有核积分接近 1 的 Hawkes 才拟合得好;他们证明这类过程重标度后收敛到积分 CIR 过程,对应的价格模型收敛到 Heston 模型。El Euch、Fukasawa 与 Rosenbaum(Finance and Stochastics, 22(2), 2018)进一步在重尾核下推出粗糙波动率(rough volatility)与杠杆效应。在这条线上,近临界是连接微观订单流与宏观波动率特征的结构性质,而不是危机前兆。
把 Filimonov-Sornette 2015
的核心论点在模拟数据上复现一遍(脚本 hawkes_fit_demo.py,全部是模拟数据):前三行是真分支比
0.8 的指数核 Hawkes(\(\mu =
0.5\)、\(\alpha =
0.8\)、\(\beta =
1.0\)),后三行是没有任何自激、强度每
50 秒在 0.5 和 5.0 之间切换的泊松过程,观测窗口都是 5,000
秒。实际运行输出:
case                          n_events  mu_hat  alpha_hat  beta_hat  n_hat
hawkes n=0.8 seed=1               12732   0.518      0.785     0.985  0.797
hawkes n=0.8 seed=2               12475   0.474      0.776     0.958  0.810
hawkes n=0.8 seed=3               11957   0.477      0.741     0.925  0.801
switching Poisson seed=1          13760   0.247      0.455     0.500  0.911
switching Poisson seed=2          13884   0.241      0.472     0.516  0.914
switching Poisson seed=3          13705   0.245      0.473     0.519  0.911
模型设定正确时估计量是准的;强度的非平稳切换却被 Hawkes 解读成了 0.91 的「自激」。把滚动分支比当作风险指标之前,至少要做两件事:对日内季节性和制度切换去趋势或分段估计;用残差的时间变换检验(compensator 变换后应接近单位速率泊松过程)检查模型设定。
7.3 代码:一维 Hawkes 的极大似然估计
import numpy as np
from scipy.optimize import minimize

def hawkes_ll(params, ts, T):
    mu, alpha, beta = params
    if mu <= 0 or alpha < 0 or beta <= 0 or alpha >= beta:
        return 1e10
    n = len(ts)
    A = np.zeros(n)
    for i in range(1, n):
        A[i] = np.exp(-beta * (ts[i] - ts[i - 1])) * (1 + A[i - 1])
    log_lambda = np.log(mu + alpha * A)
    integral = mu * T + (alpha / beta) * np.sum(1 - np.exp(-beta * (T - ts)))
    return -(np.sum(log_lambda) - integral)

def fit_hawkes(ts: np.ndarray, T: float):
    """ts: 升序事件时间(秒),T: 观测窗口长度。"""
    x0 = np.array([len(ts) / T * 0.5, 0.5, 1.0])
    res = minimize(hawkes_ll, x0, args=(ts, T), method="Nelder-Mead",
                   options={"maxiter": 4000, "xatol": 1e-6, "fatol": 1e-6})
    mu, alpha, beta = res.x
    return {"mu": mu, "alpha": alpha, "beta": beta,
            "branching_ratio": alpha / beta, "log_lik": -res.fun}
实现要点:
- 约束 \(\alpha < \beta\)(即 \(n < 1\))保证平稳,否则强度发散、似然无意义。
- 用递推 \(A_i = e^{-\beta (t_i - t_{i-1})}(1 + A_{i-1})\) 计算 \(\sum_{t_j < t_i} e^{-\beta(t_i - t_j)}\),复杂度从 \(O(n^2)\) 降到 \(O(n)\)。
- 交易所时间戳只到毫秒时,大量事件同时刻;同时刻事件之间间隔为 0,会让核贡献偏大。常见做法是在同一时间戳内加微小均匀扰动,或改用离散时间的计数模型。
- 示例数据每次约 1.2 万到 1.4 万个事件,纯 Python 递推循环可以接受;百万级事件需要 numba 或向量化实现。
7.4 神经序列模型
近年的一支工作用深度网络直接从订单簿历史预测价格方向。Sirignano 与 Cont 在 Universal Features of Price Formation in Financial Markets: Perspectives from Deep Learning(Quantitative Finance, 19(9), 2019)中用美股数十亿条报价和成交训练 LSTM,发现在所有股票上联合训练的「通用」模型优于逐只股票训练的模型,并且对不在训练集里的股票同样有效;加入更长的价格和订单流历史能提高准确率,说明价格动态有路径依赖。他们的输入是原始订单簿状态序列,而不是 OFI 之类的手工特征。
可以把神经点过程看作「把 Hawkes 的固定参数核换成学出来的核」:能拟合任意衰减形状和跨事件类型的互激,代价是可解释性、数据量和推理延迟。把它接进生产路径要解决的是特征实时计算、推理延迟、模型监控与回滚,见《时间序列深度学习》。无论最后用什么模型,Hawkes 与 OFI 线性回归都应该作为基线保留,否则无法判断神经模型的增益是否来自过拟合。
八、工程实现:从原始行情到可分析数据
前面所有指标都假设本地订单簿是对的。这一节讲怎么让它对。
8.1 L2/L3 数据结构选择
| 数据类型 | 常见结构 | 关键操作复杂度 |
|---|---|---|
| L1 单档 | 当前 best 缓存 | \(O(1)\) |
| L2 聚合 | 有序映射
BTreeMap<Price, Qty>(Rust)或排序数组 |
\(O(\log K)\),\(K\) 为档位数 |
| L3 完整 | 价格层有序映射 + 每层双向链表 +
HashMap<OrderId, 节点> |
插入 \(O(\log K)\)、按 id 撤单 \(O(1)\) |
| 固定 tick L3 | 数组价格梯 + 每档 FIFO + best 指针 | 多数操作 \(O(1)\),best 档清空时需向外扫描 |
量化研究大多用 L1/L2;L3 主要给做市回测和撮合引擎自身用,见《撮合引擎实现》。
8.2 增量更新:snapshot + delta
主流深度行情采用「快照 +
增量」:启动时拉一份带序号的完整快照,之后每条增量带递增序号,序号不连续就重建。币安现货
depth
流的消息结构(字段名与官方文档一致,数值为示意):
{
  "e": "depthUpdate",
  "U": 157,
  "u": 160,
  "b": [["27000.10", "1.5"], ["27000.20", "0"]],
  "a": [["27001.00", "0.8"]]
}U、u 是该消息覆盖的首末 update
id,数量为 0 表示删除该价位。币安官方文档(binance-spot-api-docs,
How to manage a local order book
correctly)规定的流程是:先缓存增量,再拉快照;丢弃
u 小于等于快照 lastUpdateId
的增量;之后每条增量的 U 若大于本地 update id +
1,说明有丢失,必须丢弃本地簿重新开始。文档同时提醒,快照每侧最多
5,000 档,快照以外的价位在发生变化之前是看不到的。
8.3 对不上的三类常见根因
- 增量丢失未察觉:序号跳号但应用没有严格校验。修法:按上节规则校验,并定期与独立快照对账(8.6 节)。
- 时钟:用本机接收时间排序跨流事件,会把网络抖动带进事件顺序。修法:用交易所给的事件时间或撮合时间;多源合并时记录两种时间戳。
- 重连后未重置:断线重连后继续在旧簿上应用增量。修法:重连必清空内存簿,强制重新快照。
第 2.8 节的 allow_exact_matches
问题属于同一类:时间戳精度不够时,「先后」本身需要定义。
8.4 用 polars 回放 L2 增量
import polars as pl

def apply_l2_deltas(snapshot: pl.DataFrame, deltas: pl.DataFrame) -> pl.DataFrame:
    """
    snapshot: side(str: "B"/"A"), price(float64), qty(float64),起始状态。
    deltas:   ts(int64), side(str), price(float64), qty(float64),qty=0 表示该价位清空。
    返回每条增量之后的 (ts, bid, bid_qty, ask, ask_qty)。
    """
    book_bid, book_ask = {}, {}
    for row in snapshot.iter_rows(named=True):
        target = book_bid if row["side"] == "B" else book_ask
        if row["qty"] > 0:
            target[row["price"]] = row["qty"]

    out = []
    for row in deltas.sort("ts").iter_rows(named=True):
        target = book_bid if row["side"] == "B" else book_ask
        if row["qty"] == 0:
            target.pop(row["price"], None)
        else:
            target[row["price"]] = row["qty"]
        if not book_bid or not book_ask:
            continue
        bb, ba = max(book_bid), min(book_ask)
        out.append((row["ts"], bb, book_bid[bb], ba, book_ask[ba]))

    return pl.DataFrame(out, schema=["ts", "bid", "bid_qty", "ask", "ask_qty"], orient="row")
这个版本每条增量都在 Python 字典上操作,还每次用
max/min
扫描全部档位,只适合研究和小样本回放。价格能离散成整数 tick
下标时(A 股、港股、期货等固定 tick
市场;加密货币要先选定最小价格单位),可以用数组价格梯加
numba 编译热循环:
import numpy as np
from numba import njit

@njit(cache=True)
def apply_deltas_dense(prices_grid, qty_bid, qty_ask, ts, sides, idxs, qtys):
    """
    prices_grid: 等距价格栅格;qty_bid / qty_ask: 与栅格同长的当前挂单量(可含初始快照)
    sides: 0=买, 1=卖;idxs: 每条增量在栅格中的下标;qtys: 新数量,0 表示清空
    不处理交叉簿(bid >= ask),交叉时应触发重建。
    """
    n = len(ts)
    m = len(prices_grid)
    out_bid = np.empty(n); out_ask = np.empty(n)
    out_bq = np.empty(n); out_aq = np.empty(n)

    bb, ba = -1, m
    for i in range(m):
        if qty_bid[i] > 0:
            bb = i
    for i in range(m - 1, -1, -1):
        if qty_ask[i] > 0:
            ba = i

    for k in range(n):
        i = idxs[k]
        if sides[k] == 0:
            qty_bid[i] = qtys[k]
            if qtys[k] > 0 and i > bb:
                bb = i
            elif i == bb and qtys[k] == 0:
                while bb >= 0 and qty_bid[bb] == 0:
                    bb -= 1
        else:
            qty_ask[i] = qtys[k]
            if qtys[k] > 0 and i < ba:
                ba = i
            elif i == ba and qtys[k] == 0:
                while ba < m and qty_ask[ba] == 0:
                    ba += 1
        out_bid[k] = prices_grid[bb] if bb >= 0 else np.nan
        out_ask[k] = prices_grid[ba] if ba < m else np.nan
        out_bq[k] = qty_bid[bb] if bb >= 0 else 0.0
        out_aq[k] = qty_ask[ba] if ba < m else 0.0
    return out_bid, out_ask, out_bq, out_aq
开头两段循环从初始快照恢复 best 指针;如果省略,预先填入的快照档位不会被识别为最优档。两个版本在同一个 4 条增量的小例子上输出一致(numba 0.68.0)。加速倍数取决于 CPU、档位数和增量分布,需要在自己的数据上测。
8.5 数据治理常见坑
- 撤单与成交:L2 增量不区分「撤了 100」和「被吃了 100」。需要这个区分的特征(例如把 OFI 拆成挂单、撤单、成交三部分)必须用 L3,或把成交流与盘口流按时间联合解析。
- 跨品种时钟:做截面研究时各品种事件时间不一致,对齐用桶化时间而不是直接 join。
- 非连续交易时段:A 股开盘集合竞价期间没有连续的最优报价,价差和 OFI 类指标必须屏蔽这一段。
- 停牌与熔断:期间簿被冻结,但不同数据源对序号和心跳的处理不同,要能识别「虚假静止」。
- 公开历史数据的覆盖:本文使用的币安
bookTicker历史文件,2023-05-17 这一天从 08:46 UTC 才开始,而aggTrades覆盖全天。拼接多个数据源之前先检查各自的起止时间。
8.6 本地簿与独立快照对账
import polars as pl

def reconcile_book(local_book: dict, snapshot: pl.DataFrame, tol: float = 1e-9) -> dict:
    """
    local_book: {"bid": {price: qty}, "ask": {price: qty}},当前内存簿
    snapshot:   side(str: "B"/"A"), price, qty 的独立快照
    返回各类不一致的计数与样例,可接入告警。
    """
    diffs = {"missing_in_local": [], "missing_in_snap": [], "qty_mismatch": []}
    for side in ("bid", "ask"):
        snap_side = {row["price"]: row["qty"] for row in
                     snapshot.filter(pl.col("side") == side[0].upper()).iter_rows(named=True)}
        local_side = local_book[side]
        for p, q in snap_side.items():
            if p not in local_side:
                diffs["missing_in_local"].append((side, p, q))
            elif abs(local_side[p] - q) > tol:
                diffs["qty_mismatch"].append((side, p, local_side[p], q))
        for p in local_side:
            if p not in snap_side:
                diffs["missing_in_snap"].append((side, p, local_side[p]))
    return {
        "ok": all(len(v) == 0 for v in diffs.values()),
        "n_missing_local": len(diffs["missing_in_local"]),
        "n_missing_snap": len(diffs["missing_in_snap"]),
        "n_mismatch": len(diffs["qty_mismatch"]),
        "examples": {k: v[:5] for k, v in diffs.items()},
    }
对账时要注意快照只覆盖有限档位(币安每侧最多 5,000
档),本地簿里快照范围以外的价位应排除在比较之外,否则会被误报为
missing_in_snap。对账失败应触发本地簿重建,对账结果按时间落盘,长期观察失败率,作为行情链路的数据质量指标。
8.7 A 股的特殊处理
- 成交方向:沪深 Level-2 逐笔数据可以直接或通过买卖双方委托序号得到主动方,不需要 Lee-Ready 推断;集合竞价成交没有主动方,需要单独处理。字段定义以两所 Level-2 行情接口规范为准。
- 撤单事件:撤单作为独立事件发布,但两所放在不同的消息流里,接入时按各自规范解析。计算 OFI 时撤单是减量事件。
- 不能改单:只能撤单重报,队列位置随之丢失(第 1.2 节),这会改变做市挂单管理的成本结构。
- 涨跌停:触及涨停后卖单立即被吃、买单只能排队,价差与深度结构与未触板时完全不同,微结构估计应屏蔽或单独建模。
- 涨跌幅制度差异:科创板、创业板涨跌幅为 20%,新股上市前 5 个交易日不设涨跌幅;冲击参数要按板块分别估计。
- 跨市场同标的:A+H、ETF 与成分股需要分别维护订单簿,再做第 6.4 节的信息份额分析。
8.8 分层架构
| 层级 | 语言 | 职责 |
|---|---|---|
| 行情接入与本地簿 | C++ / Rust | 低延迟、确定性内存布局、零拷贝解析 |
| 特征计算与回放 | Rust / numba + Python | 向量化、跨核并行 |
| 研究与可视化 | Python(polars / pandas) | 快速迭代 |
在 Python 里直接订阅 WebSocket 并维护本地簿,单进程处理能力有限,在高流量品种上容易处理不过来、积压或丢消息,而盘口错误比模型偏差更难排查。较稳妥的做法是把「订阅、本地簿、序号校验」下沉到编译型语言,再把整理好的事件流交给 Python。低延迟系统的完整设计见《高频交易架构》。
8.9 微结构特征清单
| 特征 | 时间尺度 | 含义 | 适合的用途 | 本文位置 |
|---|---|---|---|---|
| 报价价差 \(S^q\) | 实时 | 小单成交成本 | 所有策略的成本基线 | 2.1 |
| 有效价差 \(S^e\) | 逐笔 | 实际付出成本 | 执行评估、TCA | 2.2 |
| 已实现价差 \(S^r\) | 50 ms 到 5 min | 做市留存收益 | 做市 PnL 拆解 | 2.3、2.5 |
| 加权中价 \(p_w\) | 实时 | 短期价格基准 | 做市报价、被动执行 | 1.5 |
| 最优档 OFI | 1 到 10 s | 同期价格变化的主要驱动 | 特征工程、冲击诊断 | 4.2 |
| 多档 OFI | 1 s 以上 | 深档供需变化 | 中高频特征 | 4.5 |
| Kyle λ | 1 s 到分钟 | 即时深度 | 容量评估 | 3.1 |
| Amihud ILLIQ | 日级 | 横截面流动性 | 因子与风险模型 | 3.2 |
| 冲击半衰期 | 事件级 | 弹性 | 大额执行节奏 | 3.3 |
| VPIN | 成交量桶 | 订单流失衡(毒性之争见 6.3) | 风险监控辅助 | 6.3 |
| Hawkes 分支比 | 滚动窗口 | 事件聚集程度(伪临界见 7.2) | 异常检测辅助 | 7.2 |
| 队列位置 | 实时 | 队列中的相对位置 | 做市、被动执行 | 1.3 |
一个低成本的监控做法:每天开盘后检查各特征相对自身历史分布的偏离和缺失情况。特征分布漂移往往比策略 PnL 更早暴露数据问题。
8.10 回测中的成交假设
高频与被动策略的回测,结果很大程度上取决于「我的限价单怎么成交」:
- 乐观成交:挂在最优价的单子,只要有反向成交到达就算成交。忽略排队,系统性高估成交率,并且漏掉第 1.3 节的逆向选择:真实情况下最容易成交的恰好是价格即将不利移动的时刻。
- 队列模拟:维护「我前面还有多少量」,反向成交吃完前面的才轮到我。需要 L3,或在 L2 上假设新挂单排在该价位已有量之后、撤单按比例从队列各处发生。
- 概率成交:按历史上「挂单后 N 秒内成交」的条件概率成交,介于两者之间。
市价单按报价价差加冲击估计成本,冲击参数怎么来见第 18 篇;回测引擎里如何嵌入这些假设见《回测引擎设计》;把乐观成交假设当真属于《回测陷阱》讨论的「回测结果不可信」的一类原因。
九、结论与边界
- 价差要先说口径再说数值。报价、有效、已实现、冲击四个量满足 \(S^e = S^r + \text{Impact}\),但后两者依赖 \(\Delta\)。LTCUSDT 样本里有效价差 1.58 bp,0.1 秒冲击 1.04 bp,5 分钟冲击 1.26 bp;短 \(\Delta\) 的冲击混有机械性的盘口消耗。
- 报价对齐是最容易被忽视的偏差源。毫秒时间戳下允许同一毫秒匹配,会把有效价差为负的成交比例从 0.8% 抬到 9.6%。
- 最优档 OFI 比成交量更能解释秒级中价变化。样本内 1 到 10 秒 \(R^2\) 0.60 到 0.64,带符号成交量 0.37 到 0.47;60 秒时两者接近。这是同期关系,不能直接当作预测信号。
- 永久冲击来自信息,临时冲击来自盘口消耗与补单。两者的函数形式与标定在第 18 篇,本文只负责解释它们在订单簿里从哪来。
- 毒性和临界性指标都有未决争论。VPIN 的预警能力在控制成交量与波动后存疑;Hawkes 分支比接近 1 既可能是结构性质,也可能是非平稳造成的伪临界(模拟中无自激过程估出 0.91)。
本文的实证只覆盖一个加密永续合约的一天,所有数值用于说明口径和量级关系,不代表其他品种、市场或时段。
十、开放问题
- 订单流毒性有没有稳健的增量预警信号? VPIN 之争留下的问题是:在控制当期成交量和波动之后,任何订单流失衡指标能否稳定地领先流动性危机。入口:Andersen 与 Bondarenko(Review of Finance, 2015)给出的比较框架。
- 市场是否真的处于临界态? 分支比的估计对核函数形式、非平稳性、时间戳精度都敏感(Filimonov 与 Sornette, 2015),而近临界又是连接微观订单流与粗糙波动率的关键假设(Jaisson 与 Rosenbaum, 2015;El Euch 等, 2018)。如何在非平稳、毫秒精度的数据上可靠估计内生程度,还没有公认方法。入口:Bacry、Mastromatteo 与 Muzy(2015)的综述。
- 毫秒尺度上如何区分机械冲击与信息冲击? Rule 605 修订后已实现价差要报告到 50 毫秒,但在这个尺度上,单笔吃光最优档造成的中价跳动与信息带来的价格修正在 markout 曲线里混在一起。需要 L3 数据把成交、撤单、补单分开,才能把第五节的两个概念分别测出来。
- 多档与跨资产 OFI 能迁移到哪些市场? Xu 等(2018)与 Cont 等(2023)的证据来自美股;加密市场多交易所并行、A 股不能改单且有涨跌停,深档与跨资产信息的价值是否同样成立,需要分市场重做。
十一、风险提示
- 本文的公式、代码和数据仅用于教学与研究,不构成投资建议。接入实盘前需要在独立的回放与撮合仿真环境中验证。
- Kyle λ、OFI 斜率、价差分解比例都是历史拟合量,交易规则变化(最小变动单位、涨跌停、费率、撮合规则)之后必须重新估计。
- 本文第二、四节的数值来自币安 LTCUSDT 永续一天的公开历史数据,不含手续费与资金费率,不能用于判断该品种做市或执行策略的盈亏。
- VPIN、Hawkes 分支比这类指标存在未决争论,适合作为人工监控的辅助量,不宜单独作为自动减仓或撤单的触发条件。
十二、参考资料
核心论文
- Kyle, A. S. (1985). Continuous Auctions and Insider Trading. Econometrica, 53(6), 1315–1335. doi:10.2307/1913210
- Glosten, L. R., & Milgrom, P. R. (1985). Bid, Ask and Transaction Prices in a Specialist Market with Heterogeneously Informed Traders. Journal of Financial Economics, 14(1), 71–100. doi:10.1016/0304-405X(85)90044-3
- Huang, R. D., & Stoll, H. R. (1997). The Components of the Bid-Ask Spread: A General Approach. Review of Financial Studies, 10(4), 995–1034. doi:10.1093/rfs/10.4.995
- Cont, R., Kukanov, A., & Stoikov, S. (2014). The Price Impact of Order Book Events. Journal of Financial Econometrics, 12(1), 47–88. doi:10.1093/jjfinec/nbt003,arXiv:1011.6402
- Easley, D., López de Prado, M., & O’Hara, M. (2012). Flow Toxicity and Liquidity in a High-Frequency World. Review of Financial Studies, 25(5), 1457–1493. doi:10.1093/rfs/hhs053
- Andersen, T. G., & Bondarenko, O. (2014). VPIN and the Flash Crash. Journal of Financial Markets, 17, 1–46. 工作论文版 CREATES RP 2011-50
- Hardiman, S. J., Bercot, N., & Bouchaud, J.-P. (2013). Critical Reflexivity in Financial Markets: A Hawkes Process Analysis. European Physical Journal B, 86(10), 442. doi:10.1140/epjb/e2013-40107-3,arXiv:1302.1405
- Filimonov, V., & Sornette, D. (2015). Apparent Criticality and Calibration Issues in the Hawkes Self-Excited Point Process Model: Application to High-Frequency Financial Data. Quantitative Finance, 15(8), 1293–1314. doi:10.1080/14697688.2015.1032544,arXiv:1308.6756
其他论文
- Roll, R. (1984). A Simple Implicit Measure of the Effective Bid-Ask Spread in an Efficient Market. Journal of Finance, 39(4), 1127–1139. doi:10.2307/2327617
- Glosten, L. R., & Harris, L. E. (1988). Estimating the Components of the Bid/Ask Spread. Journal of Financial Economics, 21(1), 123–142. doi:10.1016/0304-405X(88)90034-7
- Hasbrouck, J. (1991). Measuring the Information Content of Stock Trades. Journal of Finance, 46(1), 179–207. doi:10.1111/j.1540-6261.1991.tb03749.x
- Lee, C. M. C., & Ready, M. J. (1991). Inferring Trade Direction from Intraday Data. Journal of Finance, 46(2), 733–746. doi:10.1111/j.1540-6261.1991.tb02683.x
- Hasbrouck, J. (1995). One Security, Many Markets: Determining the Contributions to Price Discovery. Journal of Finance, 50(4), 1175–1199. doi:10.1111/j.1540-6261.1995.tb04054.x
- Gonzalo, J., & Granger, C. (1995). Estimation of Common Long-Memory Components in Cointegrated Systems. Journal of Business & Economic Statistics, 13(1), 27–35.
- Easley, D., Kiefer, N. M., O’Hara, M., & Paperman, J. B. (1996). Liquidity, Information, and Infrequently Traded Stocks. Journal of Finance, 51(4), 1405–1436. doi:10.1111/j.1540-6261.1996.tb04074.x
- Amihud, Y. (2002). Illiquidity and Stock Returns: Cross-Section and Time-Series Effects. Journal of Financial Markets, 5(1), 31–56.
- Bouchaud, J.-P., Gefen, Y., Potters, M., & Wyart, M. (2004). Fluctuations and Response in Financial Markets: The Subtle Nature of “Random” Price Changes. Quantitative Finance, 4(2), 176–190.
- Goyenko, R. Y., Holden, C. W., & Trzcinka, C. A. (2009). Do Liquidity Measures Measure Liquidity? Journal of Financial Economics, 92(2), 153–181. doi:10.1016/j.jfineco.2008.06.002
- Easley, D., López de Prado, M., & O’Hara, M. (2011). The Microstructure of the “Flash Crash”: Flow Toxicity, Liquidity Crashes, and the Probability of Informed Trading. Journal of Portfolio Management, 37(2), 118–128. doi:10.3905/jpm.2011.37.2.118
- Tóth, B., Lempérière, Y., Deremble, C., de Lataillade, J., Kockelkoren, J., & Bouchaud, J.-P. (2011). Anomalous Price Impact and the Critical Nature of Liquidity in Financial Markets. Physical Review X, 1(2), 021006. doi:10.1103/PhysRevX.1.021006
- Corwin, S. A., & Schultz, P. (2012). A Simple Way to Estimate Bid-Ask Spreads from Daily High and Low Prices. Journal of Finance, 67(2), 719–760. doi:10.1111/j.1540-6261.2012.01729.x
- Filimonov, V., & Sornette, D. (2012). Quantifying Reflexivity in Financial Markets: Toward a Prediction of Flash Crashes. Physical Review E, 85(5), 056108. doi:10.1103/PhysRevE.85.056108,arXiv:1201.3572
- Obizhaeva, A. A., & Wang, J. (2013). Optimal Trading Strategy and Supply/Demand Dynamics. Journal of Financial Markets, 16(1), 1–32. doi:10.1016/j.finmar.2012.09.001
- Easley, D., López de Prado, M., & O’Hara, M. (2014). VPIN and the Flash Crash: A Rejoinder. Journal of Financial Markets, 17, 47–52. doi:10.1016/j.finmar.2013.06.007
- Andersen, T. G., & Bondarenko, O. (2014). Reflecting on the VPIN Dispute. Journal of Financial Markets, 17, 53–64. 工作论文版 CREATES RP 2013-42
- Andersen, T. G., & Bondarenko, O. (2015). Assessing Measures of Order Flow Toxicity and Early Warning Signals for Market Turbulence. Review of Finance, 19(1), 1–54. doi:10.1093/rof/rfu041
- Bacry, E., Mastromatteo, I., & Muzy, J.-F. (2015). Hawkes Processes in Finance. Market Microstructure and Liquidity, 1(1), 1550005. doi:10.1142/S2382626615500057
- Jaisson, T., & Rosenbaum, M. (2015). Limit Theorems for Nearly Unstable Hawkes Processes. Annals of Applied Probability, 25(2), 600–631. doi:10.1214/14-AAP1005
- Abdi, F., & Ranaldo, A. (2017). A Simple Estimation of Bid-Ask Spreads from Daily Close, High, and Low Prices. Review of Financial Studies, 30(12), 4437–4480. doi:10.1093/rfs/hhx084
- Moallemi, C. C., & Yuan, K. (2017). A Model for Queue Position Valuation in a Limit Order Book. Working paper, SSRN 2996221(未经同行评审)。
- El Euch, O., Fukasawa, M., & Rosenbaum, M. (2018). The Microstructural Foundations of Leverage Effect and Rough Volatility. Finance and Stochastics, 22(2), 241–280. doi:10.1007/s00780-018-0360-z
- Stoikov, S. (2018). The Micro-Price: A High-Frequency Estimator of Future Prices. Quantitative Finance, 18(12), 1959–1966. doi:10.1080/14697688.2018.1489139
- Xu, K., Gould, M. D., & Howison, S. D. (2018). Multi-Level Order-Flow Imbalance in a Limit Order Book. Market Microstructure and Liquidity, 4(3–4), 1950011. doi:10.1142/S2382626619500114,arXiv:1907.06230
- Sirignano, J., & Cont, R. (2019). Universal Features of Price Formation in Financial Markets: Perspectives from Deep Learning. Quantitative Finance, 19(9), 1449–1459. doi:10.1080/14697688.2019.1622295,arXiv:1803.06917
- Cont, R., Cucuringu, M., & Zhang, C. (2023). Cross-Impact of Order Flow Imbalance in Equity Markets. Quantitative Finance, 23(10). doi:10.1080/14697688.2023.2236159,arXiv:2112.13213
- Hawkes, A. G. (1971). Spectra of Some Self-Exciting and Mutually Exciting Point Processes. Biometrika, 58(1), 83–90. doi:10.1093/biomet/58.1.83
书籍
- O’Hara, M. (1995). Market Microstructure Theory. Blackwell.
- Harris, L. (2003). Trading and Exchanges: Market Microstructure for Practitioners. Oxford University Press.
- Hasbrouck, J. (2007). Empirical Market Microstructure. Oxford University Press.
- Bouchaud, J.-P., Bonart, J., Donier, J., & Gould, M. (2018). Trades, Quotes and Prices: Financial Markets Under the Microscope. Cambridge University Press.
规范与文档
- 上海证券交易所《交易规则》;深圳证券交易所《交易规则》(竞价交易的价格优先、时间优先原则)。
- SEC, Rule 605 of Regulation NMS 修订(2024 年 3 月 6 日通过),已实现价差报告时点为 50 ms、1 s、15 s、1 min、5 min;摘要参见 Sidley Austin, SEC Adopts Amendments to Modernize Disclosure of Order Execution Information。
- Binance, binance-spot-api-docs: WebSocket Streams, How to manage a local order book correctly。
- Nasdaq, TotalView-ITCH 5.0 Specification。
数据与脚本
- Binance Public Data:data.binance.vision,
data/futures/um/daily/bookTicker/LTCUSDT/LTCUSDT-bookTicker-2023-05-17.zip与data/futures/um/daily/aggTrades/LTCUSDT/LTCUSDT-aggTrades-2023-05-17.zip。 ofi_spread_analysis.py:下载上述数据,输出第二、三、四节的所有真实数据表格,并生成spread-markout.svg与ofi-vs-mid-change.svg。统计量为确定性计算,重复运行输出一致。hawkes_fit_demo.py:第七节的 Hawkes 模拟与拟合(全部为模拟数据,固定随机种子)。- 运行环境:Windows 11,Python 3.12.10,polars 2.0.0,numpy 2.5.3,scipy 1.18.1,statsmodels 0.15.0,matplotlib 3.11.2,numba 0.68.0。
系列导航
延伸阅读
- 交易成本模型:冲击成本、滑点、Implementation Shortfall 与 TCA:本文第五节的冲击概念在那里变成可标定的平方根律、Almgren-Chriss 最优执行和 TCA 报表。
- 订单类型与执行语义:改单与队列优先级、冰山单与隐藏单在各市场的具体语义。
- 做市策略:Avellaneda-Stoikov 与库存管理:站在流动性提供者一侧看价差、逆向选择和 VPIN 触发撤单。
- 回测陷阱:前视偏差、过拟合、数据窥视与 Deflated Sharpe:报价对齐与成交假设之外,回测推断本身的偏差。
- 执行算法:TWAP、VWAP、POV、IS:把冲击模型变成拆单计划。
- 行情系统:本文第八节所依赖的行情接入与分发。
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【量化交易】量化交易全景:从信号到订单的工程链路
量化交易不是策略写得好就能赚钱,更难的是把数据、特征、因子、信号、组合、执行、风控、复盘这八段链路在工程上连成一条不漏数据、不串时间、不丢订单的流水线。本文是【量化交易】系列的总目录与读图,给出八段链路的输入输出、失败模式、不变量清单,并用研究流程图把从一个想法到一笔实盘订单之间所有该过的卡点串起来。
【量化交易】风险模型:Barra 多因子、风险归因、压力测试
股票数接近样本天数时,样本协方差会把最小方差组合的风险低估到真实值的约 1-N/T 倍。本文用 Barra 式因子模型降维,对比 Ledoit-Wolf 收缩与 eigenfactor 调整,配合欧拉风险归因、VaR/ES 回测和压力测试,用可运行的模拟代码给出各方法的偏差大小与适用边界。
【量化交易】交易成本模型:冲击成本、滑点、Implementation Shortfall 与 TCA
回测按收盘价成交,实盘却多付几十 bp。本文把交易成本拆成显性费用、滑点、冲击、机会成本四层,用平方根律标定、Almgren-Chriss 与 Implementation Shortfall 统一口径,附合成数据验证的 Python 代码和按 2026 年官方规则核对的四市场费率。
【量化交易】回测陷阱:前视偏差、过拟合、数据窥视与 Deflated Sharpe
回测 Sharpe 漂亮却上线失效,多半死于前视偏差、过拟合和数据窥视。本文给出前视偏差的三条机械自查规则,用可复现仿真说明零信号数据上挑出的最佳策略能通过 PSR 却被 DSR 拒掉,并附 Bonferroni、BH-FDR、DSR 的 Python 实现与 30 条上线前自检清单。