在 03|矩阵乘法的两种视角 里,我们把 \(AB\) 拆成了点积、列线性组合、行线性组合和外积之和四种看待方式。但真正进入 Transformer 架构后,问题不再是“矩阵怎么乘”,而是“为什么矩阵要这样设计”:为什么单头注意力把 \(d_{\text{model}} = 4096\) 压到 \(d_k = 128\) 后必须要用多头;为什么 LayerNorm 先减均值再除以标准差能稳住特征;为什么 RoPE 旋转位置编码不破坏向量模长;为什么 RNN 会梯度爆炸而残差连接不会;为什么 LoRA 和 DeepSeek MLA 能把参数或 KV Cache 压缩一个数量级。
MIT 教授 Gilbert Strang 在 18.06(《线性代数》)与 18.065(《数据科学中的线性代数》)里用五根支柱搭起了整张现代线性代数地图——四个基本子空间、正交投影、正交矩阵、特征值与正定矩阵、奇异值分解(SVD)。本文不铺陈枯燥的定理罗列,而是从几何直觉和最小手算例题出发,逐一推导这五根支柱的精确公式,并把每一根支柱直接焊进 Transformer 的具体模块中。
学习目标(学完你能独立回答)
- 给定任意矩阵 \(A \in \mathbb{R}^{m\times n}\)(如注意力打分矩阵 \(W_Q W_K^\top\)),能画出 Strang“四个基本子空间大图”,标清各自维度与正交补关系,并判别哪些特征方向落入零空间而被彻底屏蔽。
- 能从正交条件推导最小二乘投影矩阵 \(P = A(A^\top A)^{-1}A^\top\) 并完成 \(3\times 2\) 手算,据此证明 LayerNorm 的减均值操作等价于正交投影 \(I - \frac{1}{d}\mathbf{1}\mathbf{1}^\top\)。
- 能用矩阵幂 \(A^t = S\Lambda^t S^{-1}\)、SPD 黑塞条件数 \(\kappa = \lambda_{\max}/\lambda_{\min}\) 与 Eckart-Young 定理,解释 RNN 梯度命运、RoPE 保范保角、优化器 Zig-Zag 以及 LoRA / MLA / SVDQuant 的低秩压缩边界。
一、线性代数的灵魂:Gilbert Strang 的四个基本子空间
理解矩阵 \(A \in \mathbb{R}^{m\times n}\)(秩为 \(r \le \min(m, n)\)),不能只把它看成一张矩形数字表,而要看成把输入空间 \(\mathbb{R}^n\) 映射到输出空间 \(\mathbb{R}^m\) 的线性算子 \(\mathbf{x} \mapsto A\mathbf{x}\)。Strang 认为整门线性代数的核心(Big Picture),就是 \(\mathbb{R}^n\) 和 \(\mathbb{R}^m\) 内部分裂出的四个基本子空间:
| 子空间 | 所在空间 | 定义 | 维度 | 正交补搭档 |
|---|---|---|---|---|
| 行空间 \(C(A^\top)\) | \(\mathbb{R}^n\) | \(A\) 的行向量的所有线性组合 | \(r\) | \(C(A^\top) \perp N(A)\) |
| 零空间 \(N(A)\) | \(\mathbb{R}^n\) | 满足 \(A\mathbf{x} = \mathbf{0}\) 的全体解 | \(n - r\) | \(N(A) = C(A^\top)^\perp\) |
| 列空间 \(C(A)\) | \(\mathbb{R}^m\) | \(A\) 的列向量的所有线性组合 | \(r\) | \(C(A) \perp N(A^\top)\) |
| 左零空间 \(N(A^\top)\) | \(\mathbb{R}^m\) | 满足 \(A^\top \mathbf{y} = \mathbf{0}\) 的全体解 | \(m - r\) | \(N(A^\top) = C(A)^\perp\) |
这四个子空间构成线性代数基本定理的两半:第一部分(维度定理) 给出行秩等于列秩等于 \(r\),且 \(\dim C(A^\top) + \dim N(A) = n\)、\(\dim C(A) + \dim N(A^\top) = m\);第二部分(正交补定理) 给出两对严格的垂直分裂。
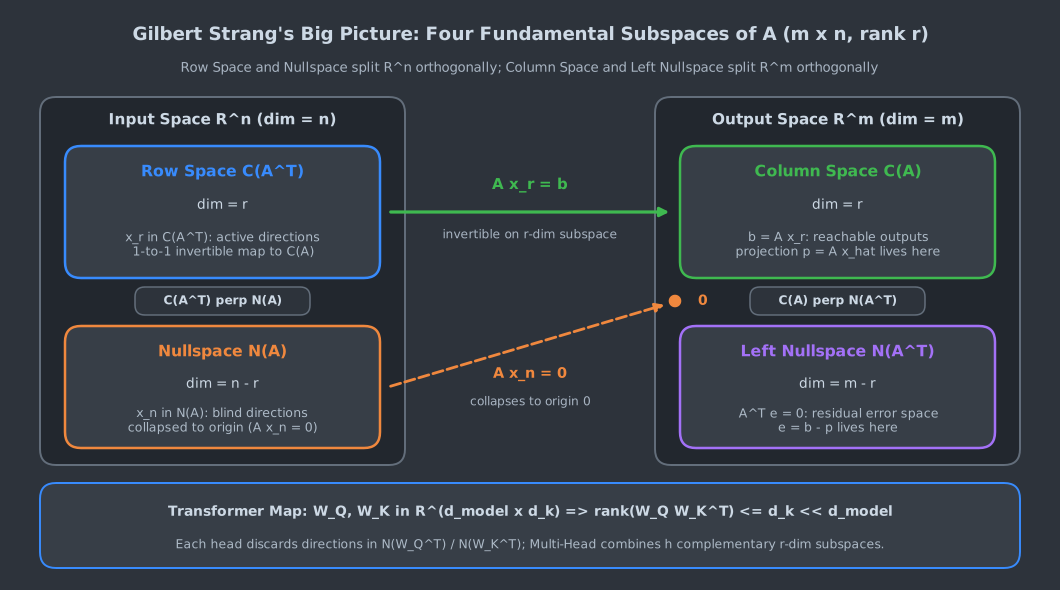
为什么 \(C(A^\top) \perp N(A)\) 必然成立?看定义即可一步证毕:若 \(\mathbf{x} \in N(A)\),则 \(A\mathbf{x} = \mathbf{0}\),展开矩阵按行做点积就是 \(A\) 的第 \(i\) 行与 \(\mathbf{x}\) 的点积全为 \(0\)。既然 \(\mathbf{x}\) 垂直于 \(A\) 的每一行,它就垂直于行的任意线性组合——即垂直于整个 \(C(A^\top)\)。同理,在输出端 \(A^\top \mathbf{e} = \mathbf{0}\) 意味着 \(\mathbf{e}\) 垂直于 \(A\) 的每一列,即 \(N(A^\top) \perp C(A)\)。
于是任何输入向量 \(\mathbf{x} \in \mathbb{R}^n\) 都可以唯一正交分解为 \(\mathbf{x} = \mathbf{x}_r + \mathbf{x}_n\),其中 \(\mathbf{x}_n \in N(A)\) 被矩阵直接抹零(\(A\mathbf{x}_n = \mathbf{0}\)),而 \(\mathbf{x}_r \in C(A^\top)\) 与输出列空间 \(C(A)\) 构成一一可逆映射。
跟着纸笔算一遍:\(2\times 3\) 矩阵的四子空间与正交分裂
考察秩 \(r = 2\) 的矩阵 \(A = \begin{pmatrix} 1 & 2 & 1 \\ 0 & 1 & 2 \end{pmatrix}\)(这里 \(m=2,\ n=3\)):
- 行空间与列空间维度:两行线性无关,故 \(r = 2\);\(C(A) = \mathbb{R}^2\) 占满输出空间,左零空间 \(N(A^\top) = \{\mathbf{0}\}\) 维度为 \(2 - 2 = 0\)。
- 求零空间 \(N(A)\)(\(3-2=1\) 维):解 \(A\mathbf{x} = \mathbf{0}\) 得 \(x_2 = -2x_3,\ x_1 = -2x_2 - x_3 = 3x_3\),取基向量 \(\mathbf{n} = (3, -2, 1)^\top\)。验证它与两行均垂直:\((1,2,1)\cdot(3,-2,1) = 0\),\((0,1,2)\cdot(3,-2,1) = 0\)。
- 验证输入分裂 \(\mathbf{x} = \mathbf{x}_r + \mathbf{x}_n\):取输入 \(\mathbf{x} = (5, 0, -1)^\top\),它在零空间方向上的分量系数为 \(\frac{\mathbf{n}^\top \mathbf{x}}{\mathbf{n}^\top \mathbf{n}} = \frac{15 + 0 - 1}{9 + 4 + 1} = 1\),因此: \[\mathbf{x}_n = \begin{pmatrix} 3 \\ -2 \\ 1 \end{pmatrix} \in N(A), \qquad \mathbf{x}_r = \mathbf{x} - \mathbf{x}_n = \begin{pmatrix} 2 \\ 2 \\ -2 \end{pmatrix} = 2\begin{pmatrix} 1 \\ 2 \\ 1 \end{pmatrix} - 2\begin{pmatrix} 0 \\ 1 \\ 2 \end{pmatrix} \in C(A^\top)\] 核对点积 \(\mathbf{x}_r^\top \mathbf{x}_n = 6 - 4 - 2 = 0\),且输出完全由行空间分量决定:\(A\mathbf{x} = A\mathbf{x}_r = (4, -2)^\top\)。
映射到 Transformer:秩上界与“零空间盲区”
在单头自注意力里,输入表示维度为 \(d_{\text{model}}\)(例如 \(4096\)),每个头把向量降维投影到 \(d_k\)(例如 \(128\)):\(W_Q, W_K \in \mathbb{R}^{d_{\text{model}}\times d_k}\)。如果写成全维度的双线性打分矩阵 \(M = W_Q W_K^\top \in \mathbb{R}^{d_{\text{model}}\times d_{\text{model}}}\),由矩阵乘法的秩不等式:
\[\operatorname{rank}(W_Q W_K^\top) \le \min(\operatorname{rank}(W_Q), \operatorname{rank}(W_K)) \le d_k \ll d_{\text{model}}\]
这意味着即使 \(W_Q, W_K\) 满列秩,单个注意力头也只能在 \(d_{\text{model}}\) 维空间中看到一个最多 \(d_k\) 维的行空间 \(C(W_Q^\top)\);其余至少 \(d_{\text{model}} - d_k = 3968\) 维的正交补全部落入 \(N(W_Q^\top)\)。对这一个头而言,零空间里的所有特征方向都是完全不可见的盲区。这正是 Transformer 必须使用多头注意力(Multi-Head Attention)的线性代数根因:让 \(h\) 个头分别占据不同的 \(d_k\) 维子空间,再通过输出投影 \(W_O \in \mathbb{R}^{hd_v \times d_{\text{model}}}\) 把多个子空间的信号拼回残差流(Residual Stream)。
同样地,嵌入矩阵 \(W_E \in \mathbb{R}^{|V|\times d_{\text{model}}}\)(\(|V| \gg d_{\text{model}}\))把词表空间映射进 \(\mathbb{R}^{d_{\text{model}}}\),其行空间维度最多为 \(d_{\text{model}}\);反过来解码头(Unembedding)把隐状态投回词表空间 \(C(W_U) \subseteq \mathbb{R}^{|V|}\) 时,所有合法 logits 永远受限于这个最多 \(d_{\text{model}}\) 维的子空间,这解释了为什么大词表语言模型依然会出现所谓“Softmax 瓶颈”。
二、正交投影、最小二乘与 LayerNorm
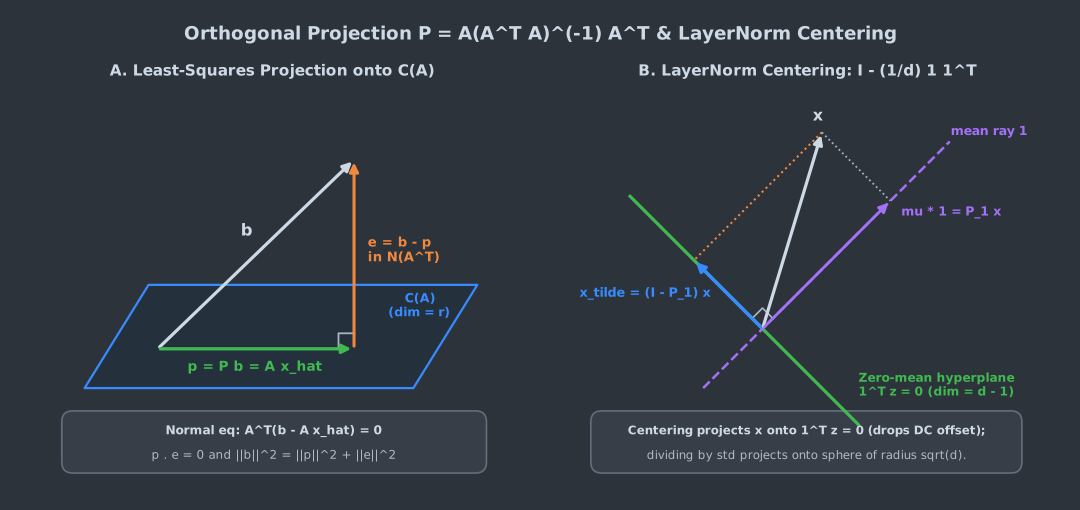
当一个观测向量 \(\mathbf{b} \in \mathbb{R}^m\) 根本不在列空间 \(C(A)\) 里时,方程 \(A\mathbf{x} = \mathbf{b}\) 无解。机器学习和数值分析每天都在做同一件事:在 \(C(A)\) 里找一个距离 \(\mathbf{b}\) 最近的向量 \(\mathbf{p} = A\hat{\mathbf{x}}\),使得误差 \(\mathbf{e} = \mathbf{b} - A\hat{\mathbf{x}}\) 的长度平方 \(\|\mathbf{e}\|_2^2\) 最小。
几何上,点到子空间最短的连线必须垂直于整个子空间 \(C(A)\)。根据第一节的正交补定理,垂直于 \(C(A)\) 的全体向量正是左零空间 \(N(A^\top)\),因此最优解充要条件就是正规方程(Normal Equations):
\[A^\top(\mathbf{b} - A\hat{\mathbf{x}}) = \mathbf{0} \implies A^\top A \hat{\mathbf{x}} = A^\top \mathbf{b}\]
当 \(A\) 列满秩(各列线性无关,等价于零空间只含零向量 \(N(A)=\{\mathbf{0}\}\))时,\(A^\top A\) 必然对称可逆——因为若 \((A^\top A)\mathbf{x} = \mathbf{0}\),两边左乘 \(\mathbf{x}^\top\) 得 \(\|A\mathbf{x}\|_2^2 = \mathbf{x}^\top A^\top A\mathbf{x} = 0 \implies A\mathbf{x} = \mathbf{0} \implies \mathbf{x} = \mathbf{0}\)。于是立刻解出最优系数与投影矩阵 \(P\):
\[\hat{\mathbf{x}} = (A^\top A)^{-1} A^\top \mathbf{b}, \qquad \mathbf{p} = A\hat{\mathbf{x}} = \underbrace{A(A^\top A)^{-1} A^\top}_{P} \mathbf{b}\]
正交投影矩阵 \(P\) 有两条代数“指纹”,做题与写代码都可以用它们验算: - 幂等性(Idempotence):\(P^2 = A(A^\top A)^{-1}(A^\top A)(A^\top A)^{-1}A^\top = A(A^\top A)^{-1}A^\top = P\)。投影一次已经落进 \(C(A)\),再投一次不动。 - 对称性(Symmetry):\(P^\top = (A^\top)^\top \big((A^\top A)^{-1}\big)^\top A^\top = A(A^\top A)^{-1}A^\top = P\)。正是对称性保证了投影误差 \(\mathbf{e} = (I - P)\mathbf{b}\) 满足 \(\mathbf{p}^\top \mathbf{e} = \mathbf{b}^\top P^\top (I - P)\mathbf{b} = \mathbf{b}^\top (P - P^2)\mathbf{b} = 0\)。
跟着纸笔算一遍:\(3\times 2\) 最小二乘正交投影
设子空间矩阵 \(A\) 与目标向量 \(\mathbf{b}\) 为:
\[A = \begin{pmatrix} 1 & 0 \\ 1 & 1 \\ 0 & 1 \end{pmatrix}, \qquad \mathbf{b} = \begin{pmatrix} 2 \\ 1 \\ 2 \end{pmatrix}\]
- 求 \(A^\top A\) 及其逆: \[A^\top A = \begin{pmatrix} 1 & 1 & 0 \\ 0 & 1 & 1 \end{pmatrix}\begin{pmatrix} 1 & 0 \\ 1 & 1 \\ 0 & 1 \end{pmatrix} = \begin{pmatrix} 2 & 1 \\ 1 & 2 \end{pmatrix}, \quad (A^\top A)^{-1} = \frac{1}{3}\begin{pmatrix} 2 & -1 \\ -1 & 2 \end{pmatrix}\]
- 解正规方程求 \(\hat{\mathbf{x}}\): \[A^\top \mathbf{b} = \begin{pmatrix} 1\cdot 2 + 1\cdot 1 + 0\cdot 2 \\ 0\cdot 2 + 1\cdot 1 + 1\cdot 2 \end{pmatrix} = \begin{pmatrix} 3 \\ 3 \end{pmatrix} \implies \hat{\mathbf{x}} = \frac{1}{3}\begin{pmatrix} 2 & -1 \\ -1 & 2 \end{pmatrix}\begin{pmatrix} 3 \\ 3 \end{pmatrix} = \begin{pmatrix} 1 \\ 1 \end{pmatrix}\]
- 算出投影 \(\mathbf{p}\)、误差 \(\mathbf{e}\) 与投影矩阵 \(P\): \[\mathbf{p} = A\hat{\mathbf{x}} = \begin{pmatrix} 1 \\ 2 \\ 1 \end{pmatrix}, \quad \mathbf{e} = \mathbf{b} - \mathbf{p} = \begin{pmatrix} 1 \\ -1 \\ 1 \end{pmatrix}, \quad P = A(A^\top A)^{-1}A^\top = \frac{1}{3}\begin{pmatrix} 2 & 1 & -1 \\ 1 & 2 & 1 \\ -1 & 1 & 2 \end{pmatrix}\]
- 三项勾股与正交验证:\(\mathbf{p}^\top \mathbf{e} = 1\cdot 1 + 2(-1) + 1\cdot 1 = 0\);\(A^\top \mathbf{e} = (0, 0)^\top\) 证实 \(\mathbf{e} \in N(A^\top)\);且 \(\|\mathbf{p}\|_2^2 + \|\mathbf{e}\|_2^2 = 6 + 3 = 9 = \|\mathbf{b}\|_2^2\),投影分解严格满足勾股定理。
特化为一维投影:LayerNorm 的零均值超平面几何
把矩阵 \(A\) 退化成全 \(1\) 列向量 \(\mathbf{1} = (1, 1, \dots, 1)^\top \in \mathbb{R}^d\),上式直接塌缩成一维投影矩阵:
\[P_{\mathbf{1}} = \frac{\mathbf{1}\mathbf{1}^\top}{\mathbf{1}^\top \mathbf{1}} = \frac{1}{d}\mathbf{1}\mathbf{1}^\top, \qquad P_{\mathbf{1}}\mathbf{x} = \left(\frac{1}{d}\sum_{i=1}^d x_i\right)\mathbf{1} = \mu \mathbf{1}\]
那么在 LayerNorm 的第一步“减去均值”时,到底发生了什么几何操作?它算的是互补投影:
\[\tilde{\mathbf{x}} = \mathbf{x} - \mu\mathbf{1} = \left(I - \frac{1}{d}\mathbf{1}\mathbf{1}^\top\right)\mathbf{x}\]
这正是把输入向量 \(\mathbf{x}\) 正交投影到法向量为 \(\mathbf{1}\) 的 \((d-1)\) 维零均值超平面 \(H = \{\mathbf{z} \in \mathbb{R}^d : \mathbf{1}^\top \mathbf{z} = 0\}\) 上。以 \(\mathbf{x} = (1, 2, 6)^\top\)(\(d=3\))为例:均值 \(\mu = 3\),\(P_{\mathbf{1}}\mathbf{x} = (3, 3, 3)^\top\),中心化向量 \(\tilde{\mathbf{x}} = (-2, -1, 3)^\top\) 严格满足 \(\mathbf{1}^\top\tilde{\mathbf{x}} = 0\);随后的方差归一化 \(\hat{\mathbf{x}} = \tilde{\mathbf{x}}/\sigma\)(这里 \(\sigma = \sqrt{14/3}\))把向量沿径向拉到半径为 \(\sqrt{d}\) 的超球面上。与之对照,LLaMA 采用的 RMSNorm 省去了向 \(H\) 投影的步骤,仅做径向缩放 \(\mathbf{x}/\text{RMS}(\mathbf{x})\),保留了均值的直流分量并减少一次跨维归约同步。
三、正交矩阵 \(Q^\top Q = I\):保范保角与 RoPE 的几何本质
如果一个方阵 \(Q \in \mathbb{R}^{d\times d}\) 的列向量两两正交且为单位向量,就称它为正交矩阵(Orthogonal Matrix),其代数定义极简却威力巨大:
\[Q^\top Q = Q Q^\top = I \iff Q^{-1} = Q^\top\]
正交矩阵的转置就是逆矩阵,这意味着它没有任何缩放或剪切失真,对任意 \(\mathbf{x}, \mathbf{y} \in \mathbb{R}^d\) 满足三条不变量:
- 模长不变(保范):\(\|Q\mathbf{x}\|_2^2 = (Q\mathbf{x})^\top(Q\mathbf{x}) = \mathbf{x}^\top Q^\top Q \mathbf{x} = \mathbf{x}^\top \mathbf{x} = \|\mathbf{x}\|_2^2\)。无论乘多少层正交矩阵,信号能量既不爆炸也不消失。
- 内积与夹角不变(保角):\((Q\mathbf{x})^\top(Q\mathbf{y}) = \mathbf{x}^\top Q^\top Q \mathbf{y} = \mathbf{x}^\top \mathbf{y}\)。所有成对点积保持原封不动。
- 奇异值全为 \(1\),特征值模长 \(|\lambda|=1\):由 \(Q\mathbf{v} = \lambda\mathbf{v}\) 取范数得 \(|\lambda|\|\mathbf{v}\|_2 = \|Q\mathbf{v}\|_2 = \|\mathbf{v}\|_2 \implies |\lambda|=1\)。
二维平面上最典型的正交矩阵是逆时针旋转 \(\theta\) 的矩阵(也是数值线性代数中的 Givens 旋转):
\[R(\theta) = \begin{pmatrix} \cos\theta & -\sin\theta \\ \sin\theta & \cos\theta \end{pmatrix}\]
逐元素验证正交性:第一列与第一列点积为 \(\cos^2\theta + \sin^2\theta = 1\),第一列与第二列点积为 \(-\cos\theta\sin\theta + \sin\theta\cos\theta = 0\),故 \(R(\theta)^\top R(\theta) = I\),且转置等于反向旋转 \(R(\theta)^\top = R(-\theta)\)。由角度相加公式直接得复合律:
\[R(m\theta)^\top R(n\theta) = R(-m\theta) R(n\theta) = R\big((n - m)\theta\big)\]
预告 RoPE:把绝对位置变成正交群上的相对旋转
在 41|位置编码演进 中主角是旋转位置编码(RoPE, Su et al., 2021/2024)。RoPE 把 \(d_k\) 维的 \(\mathbf{q}, \mathbf{k}\) 按每两维切分为 \(d_k/2\) 个平面,在第 \(m\) 个位置对第 \(j\) 个二维块乘以旋转矩阵 \(R(m\theta_j)\),即整体构造块对角正交矩阵 \(R_m = \operatorname{diag}(R(m\theta_1), \dots, R(m\theta_{d_k/2}))\)。由于 \(R_m\) 正交: - 位置编码不会改变 \(\mathbf{q}_m, \mathbf{k}_n\) 的模长,不会干扰点积方差缩放 \(\sqrt{d_k}\); - 计算注意力打分时,绝对位置通过转置自动消去,只剩下相对偏移 \((n-m)\):
\[(R_m \mathbf{q})^\top (R_n \mathbf{k}) = \mathbf{q}^\top R_m^\top R_n \mathbf{k} = \mathbf{q}^\top R_{n-m} \mathbf{k}\]
拿二维例子快速心算验证:取 \(\theta = \pi/2\),\(\mathbf{q} = (2, 1)^\top\) 在位置 \(m=1\),\(\mathbf{k} = (1, 3)^\top\) 在位置 \(n=2\)。先各自旋转:\(R_1\mathbf{q} = R(\pi/2)(2, 1)^\top = (-1, 2)^\top\),\(R_2\mathbf{k} = R(\pi)(1, 3)^\top = (-1, -3)^\top\),点积为 \((-1)(-1) + 2(-3) = -5\);再直接用相对角度 \(n-m=1\) 计算 \(\mathbf{q}^\top R(\pi/2)\mathbf{k} = (2, 1)\cdot(-3, 1)^\top = -6 + 1 = -5\),结果完全重合。工程实现中也不用真的构造 \(d_k \times d_k\) 的矩阵 \(R_m\),只需把每对分量 \((x_{2j}, x_{2j+1})\) 按 \((x_{2j}\cos m\theta_j - x_{2j+1}\sin m\theta_j,\ x_{2j}\sin m\theta_j + x_{2j+1}\cos m\theta_j)\) 逐元素计算即可,复杂度仅为 \(O(d_k)\)。
顺便一提,数值线性代数里还有另一类基础正交矩阵——Householder 反射矩阵 \(H = I - 2\mathbf{u}\mathbf{u}^\top\)(\(\|\mathbf{u}\|_2 = 1\))。不难口算 \(H^\top = H\) 且 \(H^2 = I - 4\mathbf{u}\mathbf{u}^\top + 4\mathbf{u}(\mathbf{u}^\top\mathbf{u})\mathbf{u}^\top = I\),所以它把向量沿法向 \(\mathbf{u}\) 的超平面做镜面反射,同样保持全部模长与内积不变,是做 QR 分解与正交初始化的常用工具。而在深度网络初始化中,Saxe 等人(ICLR 2014)正是利用“正交矩阵奇异值全为 \(1\)”这一性质提出正交初始化(Orthogonal Initialization),让信号在百层线性传播中既不缩小也不放大,达到所谓等距动力学(Dynamical Isometry)。
四、特征值、谱半径与对称正定矩阵(SPD)
对于方阵 \(A \in \mathbb{R}^{n\times n}\),如果存在非零向量 \(\mathbf{x}\) 使得矩阵作用在它身上只做纯伸缩不改变方向:
\[A\mathbf{x} = \lambda \mathbf{x}\]
就称 \(\lambda\) 为特征值,\(\mathbf{x}\) 为特征向量。当 \(A\) 有 \(n\) 个线性无关的特征向量时,把它们排成矩阵 \(S\) 的列,特征值排成对角阵 \(\Lambda\),就得到特征分解 \(AS = S\Lambda \implies A = S\Lambda S^{-1}\)。一旦把矩阵重复作用 \(t\) 次,中间的 \(S^{-1}S\) 全部抵消:
\[A^t = S \Lambda^t S^{-1}, \qquad A^t \mathbf{x}_0 = \sum_{i=1}^n c_i \lambda_i^t \mathbf{s}_i\]
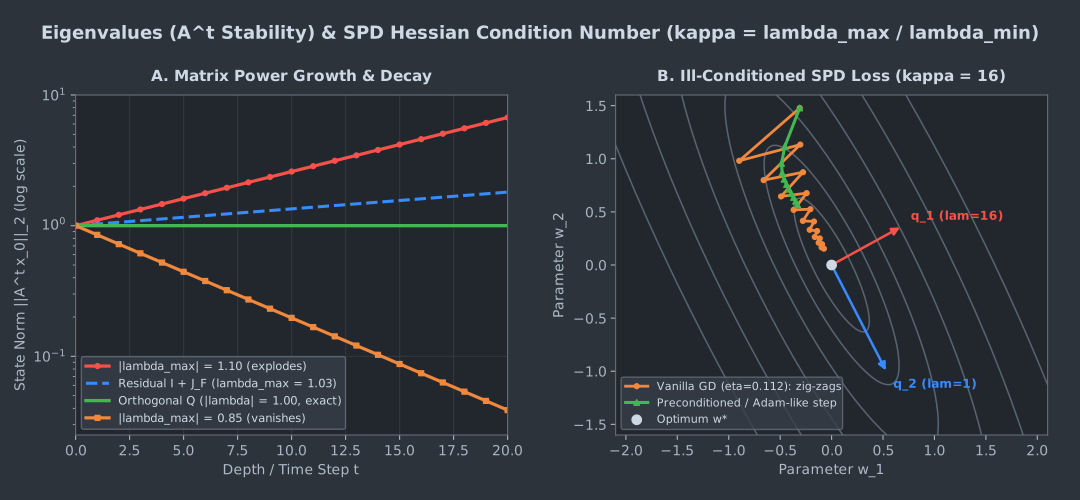
这一个公式主宰了深层网络与循环神经网络的生死。定义谱半径 \(\rho(A) = \max_i |\lambda_i|\),不同特征值区间决定了完全不同的层间动态:
| 雅可比矩阵结构 | 主导特征值模长 | 深度或时间步放大行为 | 在深度学习中的典型表现 |
|---|---|---|---|
| \(A^t\)(无门控 RNN) | \(|\lambda_{\max}| < 1\) | \(\lambda_{\max}^t \to 0\) 指数衰减 | 长程上下文信号与梯度迅速消失 |
| \(A^t\)(未约束循环) | \(|\lambda_{\max}| > 1\) | \(\lambda_{\max}^t \to \infty\) 指数发散 | 梯度爆炸,损失出现 NaN 尖峰 |
| \(Q^t\)(正交循环/RoPE) | 全部 \(|\lambda_i| = 1\) | \(\|Q^t \mathbf{x}_0\|_2 = \|\mathbf{x}_0\|_2\) | 范数精确守恒,适合保距变换 |
| \(I + J_F\)(Pre-LN 残差) | 围绕 \(1\) 小幅波动 | 梯度含恒等项 \(I\) 直通底层 | 百层 Transformer 无需繁琐预热即可稳训 |
残差连接 \(\mathbf{h}_{l+1} = \mathbf{h}_l + F(\text{LN}(\mathbf{h}_l))\) 的关键不在于改变了子层 \(F\) 本身,而在于把层间雅可比矩阵从乘性链 \(\prod_l J_{F_l}\) 改造成了加性恒等链 \(\prod_l (I + J_{F_l\circ \text{LN}})\)。Xiong 等人(ICML 2020)从谱范数与梯度的期望边界对比了 Post-LN 与 Pre-LN:Post-LN 把归一化套在主干加法外部,深层梯度仍需穿过连乘的归一化缩放因子,因此离输出层越远梯度越易衰减、高度依赖 warmup;Pre-LN 把残差主干保持为纯粹的恒等通路(特征值严格锚定在 \(1\)),使梯度直接穿过整个网络(见 24|残差连接)。
跟着纸笔算一遍:\(2\times 2\) 矩阵对角化与 \(A^{10}\)
考察对称矩阵 \(A = \begin{pmatrix} 0.8 & 0.3 \\ 0.3 & 0.8 \end{pmatrix}\) 与初始状态 \(\mathbf{x}_0 = \begin{pmatrix} 2 \\ 0 \end{pmatrix}\):
- 解特征方程 \(\det(A - \lambda I) = 0\): \[(0.8 - \lambda)^2 - 0.3^2 = 0 \implies 0.8 - \lambda = \pm 0.3 \implies \lambda_1 = 1.1,\quad \lambda_2 = 0.5\]
- 求单位正交特征向量: 对 \(\lambda_1 = 1.1\),\((A - 1.1I)\mathbf{q}_1 = \begin{pmatrix} -0.3 & 0.3 \\ 0.3 & -0.3 \end{pmatrix}\mathbf{q}_1 = \mathbf{0} \implies \mathbf{q}_1 = \frac{1}{\sqrt{2}}\begin{pmatrix} 1 \\ 1 \end{pmatrix}\); 对 \(\lambda_2 = 0.5\),由于对称矩阵不同特征值对应的特征向量必正交,立即得 \(\mathbf{q}_2 = \frac{1}{\sqrt{2}}\begin{pmatrix} 1 \\ -1 \end{pmatrix}\)。
- 按特征基展开算 \(A^{10}\mathbf{x}_0\): 注意到 \(\mathbf{x}_0 = (2, 0)^\top = (1, 1)^\top + (1, -1)^\top\),于是无需做 \(10\) 次矩阵乘法,直接写出: \[A^{10}\mathbf{x}_0 = 1.1^{10}\begin{pmatrix} 1 \\ 1 \end{pmatrix} + 0.5^{10}\begin{pmatrix} 1 \\ -1 \end{pmatrix} \approx 2.59374\begin{pmatrix} 1 \\ 1 \end{pmatrix} + 0.00098\begin{pmatrix} 1 \\ -1 \end{pmatrix} \approx \begin{pmatrix} 2.5947 \\ 2.5928 \end{pmatrix}\] 仅仅 \(10\) 步,小于 \(1\) 的模式(\(0.5^{10} \approx 1/1024\))几乎抹零,大于 \(1\) 的模式放大了 \(2.59\) 倍并彻底主宰状态向量。
对称正定矩阵(SPD)与优化器的曲率陷阱
实对称矩阵 \(S = S^\top\) 是最理想的一类方阵,谱定理(Spectral Theorem) 保证它永远有全为实数的特征值,且特征向量可以选成正交矩阵 \(Q\):\(S = Q \Lambda Q^\top\)。若进一步满足全部特征值 \(\lambda_i > 0\),把任意非零向量 \(\mathbf{x}\) 在正交特征基下写成 \(\mathbf{y} = Q^\top\mathbf{x}\),则二次型直接变成正权重平方和:
\[\mathbf{x}^\top S \mathbf{x} = (Q^\top\mathbf{x})^\top \Lambda (Q^\top\mathbf{x}) = \sum_{i=1}^{n} \lambda_i y_i^2 > 0\]
因此「所有特征值严格为正」「对所有 \(\mathbf{x}\neq \mathbf{0}\) 有 \(\mathbf{x}^\top S\mathbf{x} > 0\)」「消元主元全为正」「全部顺序主子式为正」四件事对实对称矩阵完全等价,满足其一即称为对称正定矩阵(SPD)。
在深度学习训练中,损失函数 \(L(\mathbf{w})\) 在局部极小值 \(\mathbf{w}^*\) 附近的二阶泰勒展开由黑塞矩阵(Hessian)\(H = \nabla^2 L(\mathbf{w}^*)\) 主导:
\[L(\mathbf{w}^* + \Delta) \approx L(\mathbf{w}^*) + \frac{1}{2}\Delta^\top H \Delta\]
当 \(H\) 为 SPD 时,等值面是一族椭球,第 \(i\) 个主轴半径反比于 \(\sqrt{\lambda_i}\)。定义条件数:
\[\kappa(H) = \frac{\lambda_{\max}}{\lambda_{\min}} \ge 1\]
如果 \(\kappa(H)\) 很大(狭长山谷),一阶梯度下降(SGD)固定步长受最陡方向限制(必须满足 \(\eta < 2/\lambda_{\max}\) 才不会在峭壁上发散),结果步长刚够在 \(\lambda_{\max}\) 方向来回反弹 Zig-Zag,而在平坦的 \(\lambda_{\min}\) 谷底每步只挪动微乎其微的距离。Adam 等自适应优化器通过二阶矩 \(\sqrt{v_t}\) 对坐标轴做近似对角预处理,相当于缩小了有效条件数 \(\kappa\),让陡峭方向降温、平坦方向加速。
五、奇异值分解(SVD)与 Eckart-Young 最优低秩逼近
特征分解要求矩阵必须是方阵,而且非对称矩阵还可能出现复数特征值或根本不可对角化。Transformer 里的权重矩阵几乎全是长方形(如 \(4096 \times 128\) 或 \(4096 \times 11008\))或非对称方阵,此时特征分解失效,必须请出 Strang 称为“线性代数之王”的奇异值分解(SVD)。
对任意 \(m \times n\) 实矩阵 \(A\)(秩为 \(r\)),永远存在两组正交基 \(U \in \mathbb{R}^{m\times m}\)、\(V \in \mathbb{R}^{n\times n}\) 以及对角矩阵 \(\Sigma \in \mathbb{R}^{m\times n}\),使得:
\[A = U \Sigma V^\top = \sum_{i=1}^{r} \sigma_i \mathbf{u}_i \mathbf{v}_i^\top, \qquad \sigma_1 \ge \sigma_2 \ge \cdots \ge \sigma_r > 0\]
SVD 把第一章的四个基本子空间用正交基一次性串起来:
| 子空间 | 维数 | 由 SVD 直接给出的标准正交基 | 几何作用 |
|---|---|---|---|
| 行空间 \(C(A^\top)\) | \(r\) | \(V\) 的前 \(r\) 列 \(\{\mathbf{v}_1,\dots,\mathbf{v}_r\}\) | 经过 \(A\) 后被拉伸 \(\sigma_i\) 倍映射到 \(C(A)\) |
| 零空间 \(N(A)\) | \(n - r\) | \(V\) 的后 \(n-r\) 列 \(\{\mathbf{v}_{r+1},\dots,\mathbf{v}_n\}\) | 奇异值为 \(0\),直接压缩至 \(\mathbf{0}\) |
| 列空间 \(C(A)\) | \(r\) | \(U\) 的前 \(r\) 列 \(\{\mathbf{u}_1,\dots,\mathbf{u}_r\}\) | 输出可达像空间,满足 \(A\mathbf{v}_i = \sigma_i\mathbf{u}_i\) |
| 左零空间 \(N(A^\top)\) | \(m - r\) | \(U\) 的后 \(m-r\) 列 \(\{\mathbf{u}_{r+1},\dots,\mathbf{u}_m\}\) | 与 \(C(A)\) 正交的最小二乘残差空间 |
SVD 的经典构造方法是先对对称半正定矩阵 \(A^\top A = V(\Sigma^\top \Sigma)V^\top\) 做实对称特征分解,得到奇异值 \(\sigma_i = \sqrt{\lambda_i(A^\top A)}\) 与右奇异向量 \(\mathbf{v}_i\),再由 \(\mathbf{u}_i = \frac{1}{\sigma_i} A\mathbf{v}_i\) 算左奇异向量。
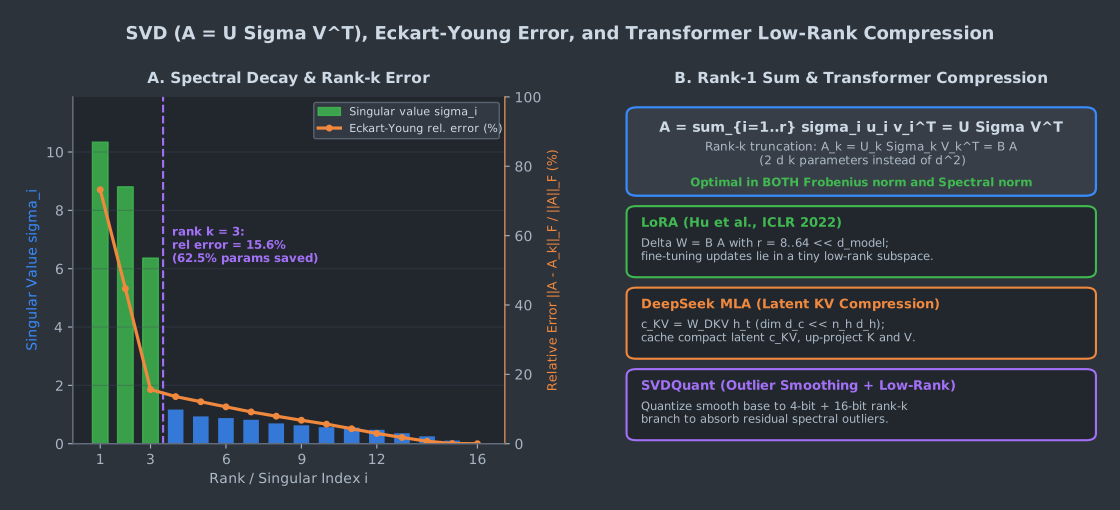
由 03|矩阵乘法的外积之和视角,SVD 把任意矩阵写成 \(r\) 个秩-\(1\) 矩阵的加权和。如果只保留前 \(k\) 项得到 \(A_k = \sum_{i=1}^k \sigma_i \mathbf{u}_i \mathbf{v}_i^\top\),Eckart-Young-Mirsky 定理证明了:在所有秩不超过 \(k\) 的矩阵 \(B\) 中,\(A_k\) 同时在弗罗贝尼乌斯范数(\(\|\cdot\|_F\))和谱范数(\(\|\cdot\|_2\))意义下误差最小:
\[\min_{\operatorname{rank}(B)\le k}\|A - B\|_F = \|A - A_k\|_F = \sqrt{\sum_{i=k+1}^{r}\sigma_i^2}, \qquad \min_{\operatorname{rank}(B)\le k}\|A - B\|_2 = \|A - A_k\|_2 = \sigma_{k+1}\]
跟着纸笔算一遍:非对称 \(2\times 2\) 矩阵 SVD 与秩-\(1\) 截断
考察非对称矩阵 \(A = \begin{pmatrix} 3 & 2 \\ -2 & 0 \end{pmatrix}\)。先检验它的特征方程:\(\lambda^2 - 3\lambda + 4 = 0\),判别式 \(\Delta = 9 - 16 = -7 < 0\),它在实数域上根本没有特征向量。但做 SVD 却格外干净:
- 算 \(A^\top A\) 及其特征值: \[A^\top A = \begin{pmatrix} 3 & -2 \\ 2 & 0 \end{pmatrix}\begin{pmatrix} 3 & 2 \\ -2 & 0 \end{pmatrix} = \begin{pmatrix} 13 & 6 \\ 6 & 4 \end{pmatrix}\] 特征方程 \(\lambda^2 - 17\lambda + 16 = 0 \implies \lambda_1 = 16,\ \lambda_2 = 1\),因此奇异值 \(\sigma_1 = 4,\ \sigma_2 = 1\)。
- 求右奇异向量 \(\mathbf{v}_1, \mathbf{v}_2\): \((A^\top A - 16I)\mathbf{v}_1 = \begin{pmatrix} -3 & 6 \\ 6 & -12 \end{pmatrix}\mathbf{v}_1 = \mathbf{0} \implies \mathbf{v}_1 = \frac{1}{\sqrt{5}}\begin{pmatrix} 2 \\ 1 \end{pmatrix}\),正交补得 \(\mathbf{v}_2 = \frac{1}{\sqrt{5}}\begin{pmatrix} -1 \\ 2 \end{pmatrix}\)。
- 算左奇异向量 \(\mathbf{u}_1, \mathbf{u}_2\): \[\mathbf{u}_1 = \frac{1}{4}A\mathbf{v}_1 = \frac{1}{4\sqrt{5}}\begin{pmatrix} 8 \\ -4 \end{pmatrix} = \frac{1}{\sqrt{5}}\begin{pmatrix} 2 \\ -1 \end{pmatrix}, \qquad \mathbf{u}_2 = \frac{1}{1}A\mathbf{v}_2 = \frac{1}{\sqrt{5}}\begin{pmatrix} 1 \\ 2 \end{pmatrix}\]
- 秩-\(1\) 最优逼近 \(A_1\) 与误差验算: \[A_1 = \sigma_1 \mathbf{u}_1 \mathbf{v}_1^\top = 4 \cdot \frac{1}{5}\begin{pmatrix} 2 \\ -1 \end{pmatrix}\begin{pmatrix} 2 & 1 \end{pmatrix} = \begin{pmatrix} 3.2 & 1.6 \\ -1.6 & -0.8 \end{pmatrix}\] 残差 \(A - A_1 = \begin{pmatrix} -0.2 & 0.4 \\ -0.4 & 0.8 \end{pmatrix}\),其弗罗贝尼乌斯范数 \(\|A - A_1\|_F = \sqrt{0.04 + 0.16 + 0.16 + 0.64} = 1.0 = \sigma_2\);能量保留率为 \(\sigma_1^2 / (\sigma_1^2 + \sigma_2^2) = 16/17 \approx 94.12\%\)。
六、从线性代数到 Transformer 架构:工程映射与学术争论
把上述五根支柱收拢到一张总表里,几乎能看清现代大语言模型每一个核心组件背后的数学约束:
| Strang 线性代数支柱 | 核心算子或定理 | Transformer / LLM 对应机制 | 直接工程后果 |
|---|---|---|---|
| 四个基本子空间与秩 | \(\operatorname{rank}(AB)\le \min(r_A,r_B)\) | 单头 \(W_Q W_K^\top\) 投到 \(d_k\) 维 | 存在 \(d_{\text{model}}-d_k\) 零空间盲区,必须多头并行 |
| 正交投影与对称幂等 | \(P = I - \frac{1}{d}\mathbf{1}\mathbf{1}^\top\) | LayerNorm 减均值中心化 | 抹除共享直流偏移,把向量压进零均值超平面 |
| 正交矩阵与旋转群 | \(Q^\top Q=I,\ R_m^\top R_n=R_{n-m}\) | RoPE 旋转位置编码 | 绝对编码相乘自动退化为相对偏移,且不改模长 |
| 特征值与谱半径 | \(A^t = S\Lambda^t S^{-1}\) | RNN 连乘 vs 残差 \(I+J_F\) | 残差把层间雅可比特征值锚在 \(1\) 附近,防止梯度消失 |
| SPD 与条件数 | \(\kappa = \lambda_{\max}/\lambda_{\min}\) | 损失曲面狭长山谷 vs Adam | 普通 GD 发生 Zig-Zag,Adam 做对角曲率预处理 |
| SVD 与 Eckart-Young | \(A_k = \sum_{i=1}^k \sigma_i \mathbf{u}_i\mathbf{v}_i^\top\) | LoRA、DeepSeek MLA、SVDQuant | 用 \(2dk\) 参数近似 \(d^2\) 矩阵,保留主导能量 |
学术脉络与核心争论:注意力到底是不是“低秩”的?
把 SVD 和 Eckart-Young 定理直接搬进 Transformer 工程,在过去五年催生了两条截然不同的研究分支,同时也存在明确的假设边界与争论:
- 权重更新与缓存的低秩化(强成立):Aghajanyan 等人(ACL 2021)在实验中测量了预训练语言模型微调时的“本征维度”,发现下游任务适配并不需要改变全部参数;Hu 等人(ICLR 2022)据此提出 LoRA,把权重增量参数化为低秩外积之和 \(\Delta W = BA\)(\(r \ll d_{\text{model}}\)),且初始化令 \(B = 0\)、\(A \sim \mathcal{N}(0, \sigma^2)\),保证训练第 \(0\) 步 \(\Delta W = 0\) 从而完全保留预训练模型原有子空间(详见 31|微调演进)。在推理显存侧,DeepSeek-V2(DeepSeek-AI,2024 arXiv 技术报告,未经同行评审)提出的 MLA(Multi-head Latent Attention) 利用低秩投影 \(W_{DKV}\) 把 KV 联合压缩成低维潜向量 \(\mathbf{c}_{KV}\),再通过矩阵乘法结合律把上投影矩阵 \(W_{UK}\) 提前吸收进查询矩阵 \(W_{UQ}\) 之中(\((\mathbf{q}^\top W_{UQ}^\top)(W_{UK}\mathbf{c}_{KV}) = (\mathbf{q}^\top (W_{UQ}^\top W_{UK}))\mathbf{c}_{KV}\)),从而在不解压完整 KV 的前提下完成多头注意力,大幅降低长上下文 KV Cache 占用;Li 等人(ICLR 2025)的 SVDQuant 则先用平滑因子抑制激活离群值,再在 4-bit 量化主干旁并联一个 16-bit 低秩奇异向量分支吸收量化残差。
- 注意力矩阵本身的低秩争论(存在硬下界):Wang 等人(arXiv 2020,Linformer,未经同行评审)观察到多层自注意力概率矩阵 \(P \in \mathbb{R}^{n\times n}\) 的奇异值快速衰减,据此把 \(K, V\) 沿序列长度维投影到低维 \(k \ll n\) 从而把复杂度降到 \(O(nk)\)。然而,Bhojanapalli 等人(ICML 2020)在同一时期严格证明了多头注意力的低秩瓶颈(Low-Rank Bottleneck):只要头维度 \(d_k < n\)(在长文本下几乎总是成立),单一注意力头的打分矩阵 \(Q_h K_h^\top\) 的秩就不可能超过 \(d_k\),根本无法表达任意高秩的上下文对齐模式(尤其是需要逐点精确检索的稀疏对齐)。更进一步,Dong 等人(ICML 2021)证明,没有残差连接和 FFN 的纯自注意力堆叠会以双指数速度退化成一个秩为 \(1\) 的矩阵,所有 token 表示塌缩成完全相同。
因此,工程上必须分清低秩假设适用在哪里:微调增量 \(\Delta W\) 和跨头的 KV 语义相关性高度冗余,适合 SVD / 低秩分解;而长序列精确检索任务中的上下文交互不能盲目压低单头秩,必须靠多头互补、残差通路和 FFN 非线性共同维持满秩表达力。
七、可运行 Python 实验室
下面这段纯 NumPy 脚本(已在 Python 3 + NumPy 1.26.4 环境实际运行)一次性验证本文四道手算例题的全部代数与数值性质:
import numpy as np

# 0. Four Fundamental Subspaces 2x3 orthogonal split
A0 = np.array([[1.0, 2.0, 1.0], [0.0, 1.0, 2.0]])
n_vec = np.array([3.0, -2.0, 1.0])
x_in = np.array([5.0, 0.0, -1.0])
x_n = (n_vec @ x_in) / (n_vec @ n_vec) * n_vec
x_r = x_in - x_n
print("=== 0. Four Fundamental Subspaces ===")
print("A0 @ x_n =", (A0 @ x_n).round(6), "x_r.x_n =", float(x_r @ x_n))
print("A0 @ x_in =", (A0 @ x_in).round(6), "A0 @ x_r =", (A0 @ x_r).round(6))

# 1. 3x2 Least-Squares Orthogonal Projection & LayerNorm Centering
A = np.array([[1.0, 0.0], [1.0, 1.0], [0.0, 1.0]])
b = np.array([2.0, 1.0, 2.0])
P = A @ np.linalg.inv(A.T @ A) @ A.T
x_hat = np.linalg.inv(A.T @ A) @ (A.T @ b)
p = P @ b
e = b - p
print("\n=== 1. Orthogonal Projection ===")
print("x_hat:", x_hat.round(6), "p:", p.round(6), "e:", e.round(6))
print("p.e =", float(p @ e), "||p||^2+||e||^2 =", float(p @ p + e @ e), "||b||^2 =", float(b @ b))
print("idempotent max|P^2-P| =", np.max(np.abs(P @ P - P)))

x = np.array([1.0, 2.0, 6.0])
d = len(x)
M = np.eye(d) - np.ones((d, d)) / d
x_centered = M @ x
print("LayerNorm centered:", x_centered.round(6), "sum =", float(x_centered.sum()))

# 2. Orthogonal Rotation (RoPE relative-offset invariance)
def rot2d(theta: float) -> np.ndarray:
    c, s = np.cos(theta), np.sin(theta)
    return np.array([[c, -s], [s, c]])

q = np.array([2.0, 1.0])
k = np.array([1.0, 3.0])
theta = np.pi / 2
lhs = float((rot2d(1 * theta) @ q) @ (rot2d(2 * theta) @ k))
rhs = float(q @ (rot2d((2 - 1) * theta) @ k))
print("\n=== 2. Orthogonal Rotation (RoPE) ===")
print("||R_1 q|| =", np.linalg.norm(rot2d(theta) @ q), "||q|| =", np.linalg.norm(q))
print("(R_1 q).(R_2 k) =", round(lhs, 6), "q.R_(2-1)k =", round(rhs, 6))

# 3. Eigenvalue Decomposition & A^10 Power
M_eig = np.array([[0.8, 0.3], [0.3, 0.8]])
lam, Q = np.linalg.eigh(M_eig)
x0 = np.array([2.0, 0.0])
x10_direct = np.linalg.matrix_power(M_eig, 10) @ x0
x10_spectral = Q @ np.diag(lam**10) @ Q.T @ x0
print("\n=== 3. Eigenvalues & A^10 ===")
print("eigenvalues:", lam.round(6), "kappa =", round(lam.max() / lam.min(), 6))
print("A^10 x0 direct:", x10_direct.round(6), "spectral:", x10_spectral.round(6))

# 4. Non-Symmetric SVD & Eckart-Young Rank-1 Truncation
B = np.array([[3.0, 2.0], [-2.0, 0.0]])
U, S, Vt = np.linalg.svd(B)
B1 = S[0] * np.outer(U[:, 0], Vt[0, :])
frob_err = np.linalg.norm(B - B1, ord="fro")
energy_ratio = (S[0]**2) / np.sum(S**2)
print("\n=== 4. SVD & Eckart-Young ===")
print("singular values:", S.round(6))
print("B1:\n", np.round(B1, 4))
print("||B - B1||_F =", round(float(frob_err), 6), "sigma_2 =", round(float(S[1]), 6))
print("rank-1 energy ratio =", round(float(energy_ratio), 6))
实际运行输出如下:
=== 0. Four Fundamental Subspaces ===
A0 @ x_n = [0. 0.] x_r.x_n = 0.0
A0 @ x_in = [ 4. -2.] A0 @ x_r = [ 4. -2.]

=== 1. Orthogonal Projection ===
x_hat: [1. 1.] p: [1. 2. 1.] e: [ 1. -1.  1.]
p.e = 0.0 ||p||^2+||e||^2 = 9.0 ||b||^2 = 9.0
idempotent max|P^2-P| = 1.1102230246251565e-16
LayerNorm centered: [-2. -1.  3.] sum = 0.0

=== 2. Orthogonal Rotation (RoPE) ===
||R_1 q|| = 2.23606797749979 ||q|| = 2.23606797749979
(R_1 q).(R_2 k) = -5.0 q.R_(2-1)k = -5.0

=== 3. Eigenvalues & A^10 ===
eigenvalues: [0.5 1.1] kappa = 2.2
A^10 x0 direct: [2.594719 2.592766] spectral: [2.594719 2.592766]

=== 4. SVD & Eckart-Young ===
singular values: [4. 1.]
B1:
 [[ 3.2  1.6]
 [-1.6 -0.8]]
||B - B1||_F = 1.0 sigma_2 = 1.0
rank-1 energy ratio = 0.941176
八、常见误区速查
- 误把列空间当成“矩阵所有的列”,忽视了零空间维度约束。当 \(d_k < d_{\text{model}}\) 时,\(W_Q W_K^\top\) 的行空间维度上限就是 \(d_k\),不是“学得好就能覆盖全空间”;多头注意力的必要性正源于单头的秩上限。
- 混淆对称特征分解与 SVD。对称实矩阵才有 \(S = Q\Lambda Q^\top\);Transformer 中的注意力矩阵 \(P\)、权重矩阵 \(W\) 绝大多数既非方阵也不对称,特征值可能是复数甚至不存在完整特征基,分析其能量分布和最优低秩截断必须用 SVD。
- 认为低秩近似只看奇异值大小而不看能量平方比。Eckart-Young 的弗罗贝尼乌斯误差由剩余奇异值的平方和开根号决定(\(\sqrt{\sum_{i>k}\sigma_i^2}\)),因此前 \(k\) 个奇异值在能量占比上的“平方聚集效应”比直接看 \(\sigma_i\) 更强;相反,在对抗扰动最坏方向上起作用的是谱范数 \(\sigma_{k+1}\)。
- 把特征向量的“同一组基”强加到任意线性层。特征分解 \(A = S\Lambda S^{-1}\) 要求输入和输出共用同一组基(\(S\) 和 \(S^{-1}\)),所以无法刻画维度不同的变换 \(W \in \mathbb{R}^{m\times n}\);SVD 则允许输入用一套正交基 \(V\)、输出用另一套正交基 \(U\),从而把「任何矩阵乘法」都拆成一次旋转(\(V^\top\))、一次逐轴缩放(\(\Sigma\))和另一次旋转(\(U\))。
课后作业与自测
- 概念辨析(子空间与零空间):设某模型 \(d_{\text{model}} = 4096\),单头维度 \(d_k = 128\)。求注意力打分二次型矩阵 \(M = W_Q W_K^\top \in \mathbb{R}^{4096\times 4096}\) 的行空间最大可能维度与零空间最小可能维度;为什么单靠加大训练数据量也无法消除单个头内的这种零空间盲区?
参考解答与评分要点(先独立推导再展开)
- 由秩不等式 \(\operatorname{rank}(W_Q W_K^\top) \le \min(\operatorname{rank}(W_Q), \operatorname{rank}(W_K)) \le d_k = 128\),行空间 \(C(M^\top)\) 维度至多为 \(128\)(2 分)。
- 由维度定理 \(\dim C(M^\top) + \dim N(M) = 4096\),零空间 \(N(M)\) 维度至少为 \(4096 - 128 = 3968\)(2 分)。
- 该秩上限由矩阵乘法张量维度几何本身决定,与优化器、数据量无关;单头只能改变 \(128\) 维子空间在 \(\mathbb{R}^{4096}\) 中的朝向,要覆盖不同模式必须依赖多头(Multi-Head)与残差流保留原始信息(2 分)。
- 纸笔推导与手算(投影矩阵与 LayerNorm
谱性质):
- 给定 \(A = \begin{pmatrix} 1 & 1 \\ 1 & -1 \\ 0 & 0 \end{pmatrix}\) 与 \(\mathbf{b} = \begin{pmatrix} 3 \\ 1 \\ 5 \end{pmatrix}\),手算投影矩阵 \(P = A(A^\top A)^{-1}A^\top\)、投影 \(\mathbf{p} = P\mathbf{b}\) 与误差 \(\mathbf{e} = \mathbf{b} - \mathbf{p}\);
- 证明 \(d\) 维 LayerNorm 中心化矩阵 \(M = I - \frac{1}{d}\mathbf{1}\mathbf{1}^\top\) 只有特征值 \(0\)(重数 \(1\))和 \(1\)(重数 \(d-1\))。
参考解答与评分要点(先独立推导再展开)
- \(A\) 两列正交,\(A^\top A = \begin{pmatrix} 2 & 0 \\ 0 & 2 \end{pmatrix}\),故 \(P = \frac{1}{2}AA^\top = \begin{pmatrix} 1 & 0 & 0 \\ 0 & 1 & 0 \\ 0 & 0 & 0 \end{pmatrix}\)(2 分)。
- \(\mathbf{p} = P\mathbf{b} = (3, 1, 0)^\top\),\(\mathbf{e} = (0, 0, 5)^\top\),满足 \(\mathbf{p}^\top\mathbf{e}=0\) 且 \(P^2 = P\)(2 分)。
- 对 \(\mathbf{v} = \mathbf{1}\),\(M\mathbf{1} = \mathbf{1} - \frac{d}{d}\mathbf{1} = \mathbf{0}\),故 \(\lambda = 0\)(特征空间为一维射线 \(\operatorname{span}(\mathbf{1})\));对任意满足 \(\mathbf{1}^\top \mathbf{z} = 0\) 的向量(组成 \(d-1\) 维超平面),\(M\mathbf{z} = \mathbf{z} - \frac{1}{d}\mathbf{1}(\mathbf{1}^\top \mathbf{z}) = \mathbf{z}\),故 \(\lambda = 1\) 的重数为 \(d - 1\)(3 分)。
- 正交矩阵与 RoPE 手算:证明正交矩阵 \(Q\) 的所有实特征值只能是 \(\pm 1\);再取 \(\theta = \pi/3\),\(\mathbf{q} = (2, 0)^\top\)(位置 \(m=2\)),\(\mathbf{k} = (1, \sqrt{3})^\top\)(位置 \(n=5\)),分别直接算 \((R_2\mathbf{q})^\top(R_5\mathbf{k})\) 与 \(\mathbf{q}^\top R((5-2)\theta)\mathbf{k}\) 核对结果。
参考解答与评分要点(先独立推导再展开)
- 设 \(Q\mathbf{v} = \lambda\mathbf{v}\)(\(\mathbf{v}\neq \mathbf{0}\)),两遍取欧氏范数平方得 \(\|Q\mathbf{v}\|_2^2 = \mathbf{v}^\top Q^\top Q\mathbf{v} = \|\mathbf{v}\|_2^2 = \lambda^2\|\mathbf{v}\|_2^2\),故实数 \(\lambda \in \{1, -1\}\)(2 分)。
- \((5-2)\theta = \pi\),因此 \(R(3\pi/3) = R(\pi) = -I\)。直接用相对旋转:\(\mathbf{q}^\top(-I)\mathbf{k} = -(2\cdot 1 + 0\cdot\sqrt{3}) = -2\)(2 分)。
- 分步检验:\(R_2\mathbf{q} = R(2\pi/3)(2, 0)^\top = (-1, \sqrt{3})^\top\);\(R_5\mathbf{k} = R(5\pi/3)(1, \sqrt{3})^\top = (2, 0)^\top\)(注意 \(\mathbf{k}\) 极坐标角为 \(\pi/3\),再加 \(5\pi/3\) 回到 \(2\pi\) 方向、模长 \(2\)),点积 \((-1)(2) + (\sqrt{3})(0) = -2\),完全一致(2 分)。
- SPD 曲率与优化步长:给定对称矩阵 \(H = \begin{pmatrix} 5 & 4 \\ 4 & 5 \end{pmatrix}\)。求其特征值,判定是否 SPD,计算条件数 \(\kappa(H)\) 与无动量梯度下降在二次函数 \(f(\mathbf{w}) = \frac{1}{2}\mathbf{w}^\top H\mathbf{w}\) 上不发散的最大理论步长 \(\eta_{\max} = 2/\lambda_{\max}\),并简述为什么此时容易发生 Zig-Zag。
参考解答与评分要点(先独立推导再展开)
- 特征方程 \((5-\lambda)^2 - 16 = 0 \implies \lambda_1 = 9,\ \lambda_2 = 1\)。所有特征值严格大于 \(0\) 且矩阵对称,故 \(H\) 为 SPD(2 分)。
- 条件数 \(\kappa(H) = 9/1 = 9\);最大稳定学习率 \(\eta_{\max} = 2/\lambda_{\max} = 2/9 \approx 0.222\)(2 分)。
- 若选取接近 \(2/9\) 的步长(如 \(\eta = 0.2\)),沿 \(\lambda_1=9\) 方向的收敛因子为 \(1 - 0.2\times 9 = -0.8\)(剧烈负号交替震荡),而沿 \(\lambda_2=1\) 方向每次仅缩小至 \(1 - 0.2\times 1 = 0.8\),形成横跨狭长山谷的 Zig-Zag(2 分)。
- SVD 误差与 LoRA 参数预算:设某 \(4\times 4\) 矩阵的奇异值为 \((10, 3, 0.5, 0.1)\)。分别计算秩-\(1\) 与秩-\(2\) 截断的精确相对弗罗贝尼乌斯误差 \(\|A - A_k\|_F / \|A\|_F\);若把 \(d_{\text{model}} = 4096\) 的方阵 \(W_Q\) 改用秩 \(r = 16\) 的 LoRA 增量 \(\Delta W = BA\) 微调,可训练参数占比是多少?
参考解答与评分要点(先独立推导再展开)
- 总能量 \(\|A\|_F^2 = 10^2 + 3^2 + 0.5^2 + 0.1^2 = 100 + 9 + 0.25 + 0.01 = 109.26\)(1 分)。
- 秩-\(1\) 截断:残差平方和 \(9 + 0.25 + 0.01 = 9.26\),相对误差 \(\sqrt{9.26 / 109.26} \approx 29.11\%\)(2 分)。
- 秩-\(2\) 截断:残差平方和 \(0.25 + 0.01 = 0.26\),相对误差 \(\sqrt{0.26 / 109.26} \approx 4.88\%\)(2 分)。
- LoRA 参数对比:\(B \in \mathbb{R}^{4096\times 16}, A \in \mathbb{R}^{16\times 4096}\) 共 \(2 \times 4096 \times 16 = 131{,}072\) 参数;全量 \(W_Q\) 为 \(4096^2 = 16{,}777{,}216\) 参数,占比 \(2r/d_{\text{model}} = 32/4096 = 1/128 \approx 0.781\%\)(2 分)。
参考资料
经典教材与课程
- Gilbert Strang. Introduction to Linear Algebra (5th ed.). Wellesley-Cambridge Press, 2016.(MIT 18.06 核心教材:Ch. 3 四个基本子空间、Ch. 4 正交投影、Ch. 6 特征值与对称正定矩阵、Ch. 7 SVD)
- Gilbert Strang. Linear Algebra and Learning from Data. Wellesley-Cambridge Press, 2019.(MIT 18.065 教材:Ch. 1 SVD 与 Eckart-Young、Ch. 2–3 条件数与优化、Ch. 7 神经网络超平面切分)
- Gilbert Strang. MIT OpenCourseWare 18.06 Linear Algebra 与 18.065 Matrix Methods in Data Analysis, Signal Processing, and Machine Learning 公开课讲义与视频。
- Gene H. Golub, Charles F. Van Loan. Matrix Computations (4th ed.). Johns Hopkins University Press, 2013.(Eckart-Young-Mirsky 定理与数值正交化标准参考)
核心论文与技术报告
- Hu E. J. et al. LoRA: Low-Rank Adaptation of Large Language Models. ICLR, 2022. arXiv:2106.09685
- Aghajanyan A., Zettlemoyer L., Gupta S. Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning. ACL, 2021. arXiv:2012.13255
- Su J. et al. RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing 568, 2024 (arXiv 2021). arXiv:2104.09864
- Bhojanapalli S. et al. Low-Rank Bottleneck in Multi-head Attention Models. ICML, 2020. arXiv:2002.07028
- Dong Y., Cordonnier J.-B., Loukas A. Attention is Not All You Need: Pure Attention Loses Rank Doubly Exponentially with Depth. ICML, 2021. arXiv:2103.03404
- Wang S. et al. Linformer: Self-Attention with Linear Complexity. arXiv 2020(预印本,未经同行评审). arXiv:2006.04768
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. arXiv 2024(技术报告,未经同行评审,Section 2.1 MLA). arXiv:2405.04434
- Li M. et al. SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models. ICLR, 2025. arXiv:2411.05007
- Xiong R. et al. On Layer Normalization in the Transformer Architecture. ICML, 2020. arXiv:2002.04745(Pre-LN vs Post-LN 层间雅可比与梯度范数边界)
- Saxe A. M., McClelland J. L., Ganguli S. Exact solutions to the nonlinear dynamics of learning in deep linear neural networks. ICLR, 2014. arXiv:1312.6120(正交初始化与等距动力学)
开源实现与可视化脚本
- 本文配套图表脚本:
make_figures.py(依赖 Python 3、NumPy 1.26、Matplotlib 3.6),输出images/03-5-strang-linear-algebra-fig1.svg至fig4.svg。 - NumPy
线性代数模块:
numpy.linalg.svd、numpy.linalg.eigh、numpy.linalg.matrix_power。
← 上一篇:03|矩阵乘法的两种视角 | 下一篇:04|函数与神经网络 → | 返回系列目录
源码下载
本文相关源码已整理,共 1 个文件。
文章导航
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【Transformer 与注意力机制】03|矩阵乘法的四种视角:Gilbert Strang 如何看透 QK^T 与特征融合
以 Gilbert Strang 矩阵乘法的四种等价视角(点积、列线性组合、行线性组合、秩 1 外积之和)拆解 C = AB,手算 2×3 乘 3×2 全四种视角,并直接映射到 QK^T、attn·V、LoRA 低秩、多头注意力秩瓶颈与 GPU 算术强度。
【Transformer 与注意力机制】02|向量、内积与正交投影:从箭头到 QK^T
从二维平面箭头出发,用余弦定理严格证明点积代数与几何定义等价,推导 Cauchy-Schwarz 与三角不等式,系统讲透 Gilbert Strang 一维正交投影矩阵与高维几何,最后用 NumPy 落到注意力打分矩阵 QK^T。
【Transformer 与注意力机制】31|微调演进:从全参数到 LoRA
从全参数微调的显存墙出发,用 Gilbert Strang SVD 与 Eckart-Young 定理揭示微调增量低秩的数学根源,严格推导 LoRA 前向、首步梯度与 alpha/r 缩放,并手算 3x3 验证。
【Transformer 与注意力机制】60|课程结业测试:三套阶段考卷、标准解答与知识查漏矩阵
仿 MIT 18.06/6.S191 闭卷手算风格的三套 Transformer 课程考卷(Quiz 1 100分、期中 100分、期末 120分),含精确分步标准解答、纯 Python 核验脚本与弱点章节回溯矩阵。