训练 GPT 类模型时,我们希望一条长度为 \(n\) 的序列在一次前向里同时产出
\(n\) 个「预测下一个
token」的损失;生成时,第 \(t\) 步又绝不能用到第 \(t\) 步之后的内容。Causal
mask(因果掩码)就是同时满足这两件事的那一行
tril。它常被当成实现细节,于是几类错误反复出现:以为
-1e9 比 -inf 更安全(在 fp16 下
-1e9 本身就会溢出成 -inf);以为带
KV cache 的 decode 直接传 is_causal=True
就行(PyTorch SDPA 按左上角对齐,单个 query
只能看到第一个键);以为 attention sink 是 causal mask
独有的产物(BERT 和 ViT
里也有)。本文先给速查表,再按「训练并行 → mask 形式 →
推理与 KV cache → 位置信息 → attention sink → 实现开销 →
踩坑 → 争论」的顺序展开,所有代码输出都在 PyTorch 2.14.1 CPU
上实际运行过。
一、速查:mask 形式与关键结论
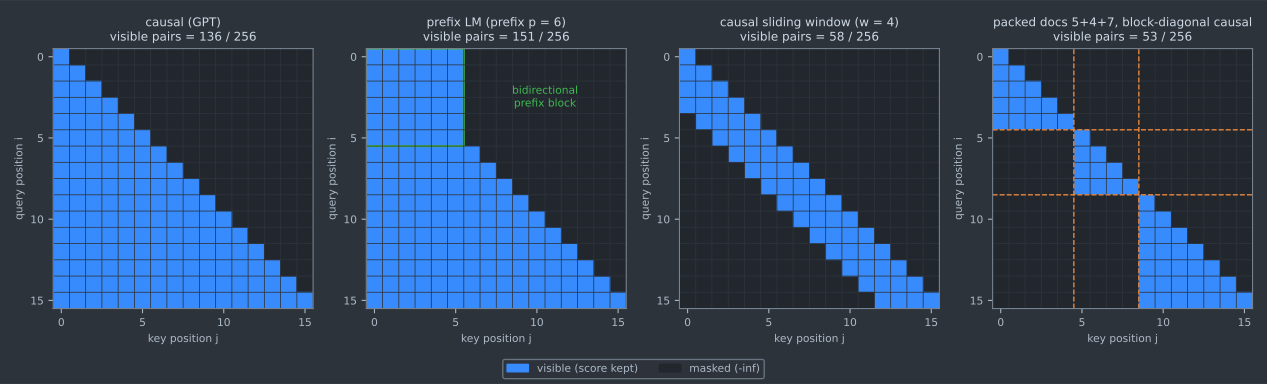
下表的「可见对数」以 \(n = 16\) 为例,数字与第三节的图一致(由同目录脚本计算)。
| Mask | 位置 \(i\) 能看到的键 \(j\) | \(n=16\) 可见对数 | 代表工作 | 常见实现入口 |
|---|---|---|---|---|
| Full(双向) | 全部 | 256 | BERT、T5 encoder | SDPA 默认(不传 mask) |
| Causal | \(j \le i\) | 136 | GPT、Llama | SDPA is_causal=True、flash-attn
causal=True |
| Padding | 非 pad 的键 | 随数据 | 所有变长 batch | attn_mask,与 causal 按「与」组合 |
| Prefix LM | \(j < p\) 或 \(j \le i\) | 151(\(p=6\)) | UniLM、T5 Prefix LM、GLM | 自定义 mask、FlexAttention |
| Causal 滑窗 | \(i-w < j \le i\) | 58(\(w=4\)) | Mistral 7B SWA | flash-attn window_size、HF
sliding_window |
| 滑窗 + sink | \(j < s\),或在滑窗内 | 随 \(s,w\) | StreamingLLM | KV cache 淘汰策略 |
| 文档内因果(packing) | \(j \le i\) 且同一文档 | 53(5+4+7) | Llama 3 预训练 | flash_attn_varlen_func、FlexAttention |
| Permutation | 当前排列中排在 \(i\) 之前的位置 | 随排列 | XLNet | 双流注意力 |
六条结论:
- Causal mask 加 teacher forcing,让一条序列的 \(n\) 个 next-token 损失在一次前向里算完,每层的串行步数是 \(O(1)\) 而不是 RNN 的 \(O(n)\),见第二节。
- 纯 causal 时每一行至少对角线可见,用
-inf不会出 NaN;NaN 来自「整行被屏蔽」,例如左 padding 或文档 mask 叠加 padding。-1e9在 fp16 下会溢出成-inf,并不比-inf更安全,见第七节。 - query 数少于 key 数时(带 KV cache 的 decode、chunked
prefill、投机解码校验),causal mask 应当右下角对齐;PyTorch
SDPA 的
is_causal=True按左上角对齐,flash-attn 从 2.1 起按右下角对齐,见第四节。 - Causal mask 本身携带位置信息:去掉位置编码的 causal LM 仍能学到绝对位置,同样设置下的双向 MLM 不收敛,见第五节。
- Attention sink 并非 causal mask 独有;causal mask 的作用是让「最前面的 token」成为最容易被训练成 sink 的位置,见第六节。
- FlashAttention 在 causal 模式下整块跳过上三角,需要计算的块比例趋近 \(1/2\);FlashAttention-2 论文报告相对不加 mask 约 1.7–1.8 倍加速,见第七节。
二、约束与训练并行
自回归分解:为什么不能看未来
自回归(autoregressive)模型把联合概率按链式法则分解:
\[P(x_1, \ldots, x_T) = \prod_{t=1}^{T} P(x_t \mid x_1, \ldots, x_{t-1})\]
分解本身对任何分布都成立。约束来自建模方式:如果网络用第 \(t\) 个位置的输出去估计 \(P(x_t \mid x_{<t})\),那么这个输出就不能依赖 \(x_t\) 及之后的 token。一旦依赖了,训练目标退化成「把输入里已有的答案抄到输出」,损失可以很低,但推理时并不存在未来 token,模型学到的东西用不上。
RNN 的隐藏状态 \(h_t = f(h_{t-1}, x_t)\) 在结构上只依赖过去,不需要 mask。Self-attention 让每个位置一步看到所有位置,这是它能并行、能建模长距离依赖的原因(见 14. Self-Attention),也是它默认会看到未来的原因。Causal mask 把「只看过去」从结构属性改成了一个显式约束。
Teacher forcing:并行的前提
Teacher forcing 一词来自 Williams 与 Zipser(Neural Computation 1989)对循环网络训练的讨论:训练时第 \(t\) 步的输入用真实的 \(x_{t-1}\),而不是模型自己上一步的输出。对 Transformer 来说,这意味着所有位置的「正确历史」在训练开始前就已经整齐地放在输入序列里了:位置 \(t\) 的历史就是输入的前 \(t\) 个 token。再加上 causal mask 保证位置 \(t\) 只聚合 \(1..t\),整条序列可以一次喂进网络,\(n\) 个位置的损失同时算出,一次反向更新全部参数。
代价是训练与推理条件不一致:训练时永远以真实前缀为条件,推理时以模型自己的输出为条件,误差可能逐步累积,这通常被称为 exposure bias。Bengio 等人(NeurIPS 2015)提出 scheduled sampling,训练中按逐渐增大的概率把真实 token 换成模型采样的 token。它天然要求先生成再训练,与「一次前向算完所有位置」冲突;Mihaylova 与 Martins(ACL 2019 SRW)为 Transformer 设计了两遍解码的近似版本来绕开这一点。主流大模型预训练仍使用 teacher forcing,这是由并行训练的需要决定的工程选择。
Mask 矩阵与 softmax
Causal mask 是一个 \(n \times n\) 的加性矩阵:
\[M_{ij} = \begin{cases} 0, & j \le i \\ -\infty, & j > i \end{cases}\]
\[A = \mathrm{softmax}\left(\frac{QK^\top}{\sqrt{d_k}} + M\right)\]
由于 \(\exp(-\infty) = 0\),上三角位置在 softmax 后权重为 \(0\),与原始分数大小无关;下三角位置照常归一化,每行和为 \(1\)。下图用固定随机种子算出了一组真实数值:左边是加 mask 后的分数,右边是 softmax 结果。第一行只有一个可见键,权重必然是 \(1.00\),这一点在第六节还会用到。

原始 Transformer 的三处 attention
Vaswani 等人(NeurIPS 2017)第 3.2.3 节描述了 encoder-decoder 中三处 attention 的用法,它们的 mask 不同:
| Attention 类型 | Causal mask | Padding mask | 说明 |
|---|---|---|---|
| Encoder self-attention | 否 | 是(source padding) | 双向 |
| Decoder self-attention | 是 | 是(target padding) | 严格因果 |
| Decoder cross-attention | 否 | 是(source padding) | \(Q\) 来自 decoder,\(K, V\) 来自 encoder |
Cross-attention 的键是完整的源序列,源序列在生成开始前已经全部已知,没有「未来」可言。BERT 只有第一种;GPT 类 decoder-only 模型只有第二种。
并行到底省了什么
Vaswani 等人的 Table 1 把 self-attention 与循环层的「串行操作数」分别记为 \(O(1)\) 和 \(O(n)\)。这里的 \(O(1)\) 依赖两个前提:teacher forcing 让输入事先已知,causal mask 让同一次计算不泄漏未来。去掉任意一个,训练要么退化成逐步生成,要么学到错误的目标。

需要注意,「并行」不等于「不浪费」。如果先算完整的 \(QK^\top\) 再把上三角置为 \(-\infty\),大约一半的乘加被算出来又扔掉。FlashAttention 一类实现会把这一半整块跳过,见第七节。
三、mask 的几种形式
下图把四种最常用的 mask 画在同一个 \(16 \times 16\) 网格上,蓝色是保留的分数,深色是被置为 \(-\infty\) 的位置。
Causal 与双向:GPT 与 BERT 的分叉
Vaswani 等人的模型是 encoder-decoder。Liu 等人(ICLR 2018,Generating Wikipedia)把输入和输出拼成一条序列,只用带 causal mask 的 decoder 做摘要;Radford 等人(OpenAI 2018,GPT)用 12 层 masked self-attention decoder 做生成式预训练再微调。BERT(Devlin 等人,NAACL 2019)走另一条路:去掉 causal mask,用 masked language modeling 训练双向 encoder,在 GLUE 等理解任务上超过了当时的 GPT。
此后的分歧不在「哪种 mask 更强」,而在训练目标与使用方式。Wang 等人(ICML 2022)在 5B 参数、170B token 规模上比较了 causal decoder、non-causal decoder 与 encoder-decoder:只做无监督预训练时,causal decoder 加自回归目标的零样本泛化最好;如果之后再做多任务提示微调,输入部分可双向、以 MLM 训练的模型表现最好。这组结论说明 mask 的选择与下游用法绑定,详见 40. 三大路线之争。
Prefix LM:UniLM、T5、GLM、UL2
Prefix LM 让前 \(p\) 个位置互相双向可见,之后的位置按 causal 规则生成,同时可以看到整个前缀:
\[M_{ij} = \begin{cases} 0, & j < p \ \text{或}\ j \le i \\ -\infty, & \text{其他} \end{cases}\]
这一谱系的几个节点:
- UniLM(Dong 等人,NeurIPS 2019)在同一个 Transformer 上用不同的 self-attention mask 同时训练双向、单向和 sequence-to-sequence 三种目标,seq2seq 目标对应的就是 prefix 形式。
- T5(Raffel 等人,JMLR 2020)第 3.2 节的 Figure 3 把 fully-visible、causal、causal with prefix 三种 mask 并列,Table 2 做了对照:在去噪目标下,encoder-decoder 的 GLUE 平均分为 83.28,prefix LM 为 81.82,纯 causal LM 为 74.70(引用数据,同等参数或计算量口径见原表)。
- GLM(Du 等人,ACL 2022)把被挖掉的片段作为 Part B 自回归生成,未被挖掉的上下文 Part A 内部双向可见,Part B 可以看到 Part A 和自己之前的片段。
- UL2(Tay 等人,ICLR 2023)把常规 span corruption、prefix LM 式的顺序去噪(S-denoiser)和极端去噪混合在一起训练,用模式 token 切换,并说明这套目标可用于 decoder-only 和 encoder-decoder 两种架构。
Prefix LM 的工程代价主要在 mask 形状随 \(p\) 变化、batch 内各样本 \(p\) 不同,以及与 KV cache 的冲突(见第四节)。
滑动窗口:Longformer 与 Mistral
滑动窗口让每个位置只看最近的 \(w\) 个位置,可见对数从 \(O(n^2)\) 降到 \(O(nw)\)。Longformer(Beltagy 等人,2020)在编码器场景下使用双向带状窗口,并给少量 token 加全局注意力。Mistral 7B(Jiang 等人,2023)在 decoder 中使用 causal 滑窗,\(W = 4096\);论文指出堆叠 \(k\) 层后,信息理论上能传播 \(W \times k\) 个 token,并配合大小为 \(W\) 的环形 KV cache(rolling buffer)。
窗口边界在不同实现里差一个位置:Hugging Face
masking_utils.sliding_window_overlay 的条件是
kv_idx > q_idx - sliding_window,含自身共
\(w\) 个键;flash-attn 的
window_size=(left, right) 让 query \(i\) 看 \([i-\text{left},
i+\text{right}]\),(left, 0) 含自身共
\(\text{left}+1\)
个键。迁移权重时需要核对这一点。
Packing 与文档内因果 mask
预训练常把多篇短文档拼成一条固定长度的序列(packing),以避免 padding。拼接之后有两种 mask 选择:
- 不做特殊处理:整条序列用一个 causal mask,后一篇文档可以看到前一篇。GPT-3(Brown 等人,NeurIPS 2020)附录 B 明确写到,多文档序列「不做任何特殊 mask」,只用 end-of-text token 分隔,让模型自己推断前后文无关。
- 文档内因果(intra-document causal):只保留 \(j \le i\) 且 \(i, j\) 属于同一文档的位置,得到图中第四个面板的块对角下三角。Llama 3 报告(2024)第 3.2 节写到,他们使用了阻止同一序列内不同文档互相注意的 mask,这一改动在标准预训练中影响有限,但在超长序列的继续预训练中很重要。
实现上,flash-attn 用
flash_attn_varlen_func(q, k, v, cu_seqlens_q, cu_seqlens_k, max_seqlen_q, max_seqlen_k, causal=True)
表达这种 mask,cu_seqlens
是各文档的累计长度,内核只在每篇文档内部做 causal
attention;Hugging Face 的
packed_sequence_mask_function
用「两个位置的文档编号相等」作为谓词。若位置编码要求每篇文档从
0 计数,还需要同时重置 position ids,这一点与 mask
是两件独立的事。两种选择孰优孰劣见第九节。
XLNet:顺序也可以换
Causal mask 的方向是约定。XLNet(Yang 等人,NeurIPS 2019)为每个样本采样一个分解顺序 \(\pi\),位置 \(i\) 只能看到 \(\pi\) 中排在它之前的位置,用双流注意力(two-stream attention)把「内容」和「要预测的位置」分开。这样模型在期望意义上看到了双向上下文,又保持了自回归分解。XLNet 论文报告在 20 个任务上超过 BERT;其实现与训练成本高于标准 causal LM,后续主流大模型没有采用这条路线。
四、推理:prefill、decode 与 KV cache
为什么 causal 模型的 KV cache 可以只追加
在 causal mask 下,位置 \(t\) 在每一层的表示只依赖 \(x_1, \ldots, x_t\)。由此可推出两点:
- 已生成 token 的 \(K, V\) 在后续步骤中不会改变,可以缓存,每步只追加一行。
- 两个请求只要前缀相同,它们在这段前缀上的 \(K, V\) 就完全相同,可以共享。
不缓存时,第 \(t\) 步重新计算长度为 \(t\) 的整段注意力,代价是 \(O(t^2 d)\),生成 \(n\) 个 token 共 \(O(n^3 d)\);缓存后第 \(t\) 步只有一个新 query 与 \(t\) 个键做点积,代价 \(O(td)\),共 \(O(n^2 d)\)。代价从计算转移到显存和带宽:每步都要读一遍完整的 KV cache,详见 49. KV Cache。
Prefill 需要 mask,单 token decode 通常不需要
推理分两段:prefill 一次性处理整个 prompt,prompt 内部仍需 causal mask,否则写入缓存的 \(K, V\) 与训练时的语义不一致;decode 每步只有一个新 query,它能看到的键就是缓存里的全部内容,不存在未来位置。
Meta 的 Llama 3 参考实现正是这样处理的。以下摘自
meta-llama/llama3 仓库
llama/model.py(commit 32b7ddc)中
Transformer.forward,第 284–297
行,注释保留原文:
mask = None
if seqlen > 1:
    mask = torch.full((seqlen, seqlen), float("-inf"), device=tokens.device)

    mask = torch.triu(mask, diagonal=1)

    # When performing key-value caching, we compute the attention scores
    # only for the new sequence. Thus, the matrix of scores is of size
    # (seqlen, cache_len + seqlen), and the only masked entries are (i, j) for
    # j > cache_len + i, since row i corresponds to token cache_len + i.
    mask = torch.hstack(
        [torch.zeros((seqlen, start_pos), device=tokens.device), mask]
).type_as(h)三处值得注意:seqlen == 1 时 mask 为
None;mask 用的是
-inf;有缓存时在左侧拼上 start_pos
列全零,使 mask 对齐到分数矩阵的右下角。同文件
Attention.forward 在 softmax 前把分数转为
fp32(F.softmax(scores.float(), dim=-1))。
单 token decode 不需要 causal mask,但 batch 推理时仍可能需要 padding mask;一次处理多个新 token 的场景(chunked prefill、投机解码的校验步)则需要带偏移的 causal mask。
query 少于 key 时,mask 要对齐右下角
当 query 长度 \(L\) 小于 key 长度 \(S\) 时,新来的 \(L\) 个 token 对应序列的最后 \(L\) 个位置,第 \(r\) 个 query 应看到前 \(S - L + r + 1\) 个键,即 mask 对齐矩阵右下角。不同库的默认值不同:
- PyTorch
F.scaled_dot_product_attention文档写明,is_causal=True在非方阵时采用 upper-left(左上角)对齐;右下角对齐要通过torch.nn.attention.bias.causal_lower_right(L, S)构造(该类在 2.14 文档中标注为 prototype)。 - flash-attn 在 2.1 版改变了
causal的语义:\(L \ne S\) 时对齐右下角,README 的 changelog 给出了 \(L=2, S=5\) 的对照。
在 PyTorch 2.14.1+cpu、Python 3.12.10、Windows 上运行:
import torch
import torch.nn.functional as F
from torch.nn.attention.bias import causal_lower_right

q = torch.ones(1, 1, 1, 4)              # decode step: 1 new query
k = torch.ones(1, 1, 5, 4)              # KV cache: 5 keys (4 cached + 1 new)
v = torch.eye(5).view(1, 1, 5, 5)       # one-hot values, so output == attention weights

for mask in (dict(is_causal=True), dict(attn_mask=causal_lower_right(1, 5))):
    out = F.scaled_dot_product_attention(q, k, v, **mask)
    print([round(x, 3) for x in out.flatten().tolist()])
[1.0, 0.0, 0.0, 0.0, 0.0]
[0.2, 0.2, 0.2, 0.2, 0.2]所有键的分数相同,正确结果应是 5
个键平分权重。is_causal=True 让这个 decode
query 只看到第一个键,程序不会报错,但生成结果是错的。
Prefix LM 与缓存的冲突
以下是推导,不是某篇论文的结论。在 prefix LM 中,前缀内部双向可见,前缀 token 的 \(K, V\) 依赖整个前缀。多轮对话里,如果把新一轮用户输入并入前缀,旧前缀 token 能看到的范围变了,它们的 \(K, V\) 也随之改变,缓存必须重算;只有把新内容当作 causal 部分追加,缓存才能复用,但这时新内容又失去了双向可见的待遇。纯 causal 模型没有这个问题,这是 decoder-only 在服务端更容易做缓存复用的一个原因。
五、与位置编码的交互
Causal mask 本身携带位置信息
Self-attention 对输入排列是等变的(见 14. Self-Attention),所以双向模型必须依赖位置编码。Causal mask 打破了这种对称:位置 \(t\) 能看到的键恰好有 \(t\) 个。举一个最简单的情形:如果某个头对所有可见键给出相同分数,位置 \(t\)(从 1 计数)的输出是
\[z_t = \frac{1}{t} \sum_{j=1}^{t} v_j,\]
其中第一个位置的值向量 \(v_1\) 权重为 \(1/t\)。只要 \(v_1\) 与其他值向量可区分,\(z_t\) 里就编码了 \(t\)。
Haviv 等人(Findings of EMNLP 2022)用实验验证了这一点:不加任何显式位置编码(NoPos)的 causal LM 在多个数据集、模型规模和序列长度上与带位置编码的模型接近;探针实验表明这类模型在网络内部学到了绝对位置;同样去掉位置编码的双向 MLM 不能收敛。作者的解释是 causal attention 让模型可以「数出」每个 token 有多少个前驱。Kazemnejad 等人(NeurIPS 2023)进一步从理论上证明 NoPE 能表示绝对和相对位置编码,并在一组推理类任务上发现 NoPE 的长度泛化优于 APE、RoPE、ALiBi 等显式方案。
所以「只有 mask、没有位置编码的模型分不清可见位置的先后」这一说法不成立:在 causal 设定下,位置信息可以从 mask 中学出来。主流大模型仍然使用 RoPE 等显式编码,二者是叠加关系,位置编码的细节见 21. 位置编码。
RoPE、ALiBi 与 mask 的叠加方式
RoPE 作用在 \(Q, K\)
上,mask 作用在分数上,两者在实现上互不干扰。ALiBi(Press
等人,ICLR 2022)给分数加一个与距离成正比的负偏置,与 mask
同为加性项,可以合并成一个 bias 矩阵;flash-attn 的
alibi_slopes 参数就是在 kernel
内部把这两件事一起做。ALiBi
的偏置让远处的分数变小,但不会变成 \(-\infty\),不能代替 causal
mask。
六、Position 0 与 attention sink
第一个位置的表示与上下文无关
在 causal mask 下,第一个位置在每一层都只能看到自己,softmax 只有一个元素,权重恒为 \(1\)。由归纳可得:第一个位置在每一层的隐藏状态只由第一个 token(以及它的位置编码)决定,与后面的内容无关。对于固定以 BOS 开头的模型,这个位置的 \(K, V\) 在所有输入上都相同,同时它又对后面所有位置可见。
这两个性质让第一个位置适合充当「不携带具体内容、又始终可见」的锚点。StreamingLLM 论文给出的解释与此一致:由于自回归建模的顺序性,初始 token 对后续所有 token 可见,而靠后的 token 只对有限的后续 token 可见,因此初始 token 更容易被训练成 attention sink。
StreamingLLM:窗口为什么会崩
Xiao 等人(ICLR 2024)研究流式生成:只保留最近 \(L\) 个 token 的 KV cache(窗口注意力)可以让显存恒定,但文本长度一旦超过缓存大小、最早的 token 被淘汰,困惑度立即飙升。他们观察到 Llama-2-7B 除最底下两层外,几乎所有层和头都大量关注初始 token;删去初始 token 的 KV 相当于移走 softmax 分母中的一大块,注意力分布随之偏移。
论文 Table 1 在 PG19 第一本书(65K token)上测 Llama-2-13B 的困惑度(引用数据):
| 缓存配置(初始 token + 最近 token) | PPL |
|---|---|
| 0 + 1024(纯窗口) | 5158.07 |
| 4 + 1020 | 5.40 |
| 4 个换行符 + 1020 | 5.60 |
把前 4 个 token 换成没有语义的换行符,效果也接近,说明起作用的是「位置在最前」而不是这些 token 的内容。StreamingLLM 据此保留 4 个初始 token 加滑动窗口,在 Llama-2、MPT、Falcon、Pythia 上稳定处理到 400 万 token,相对「滑窗重算」基线最高 22.2 倍加速;论文还发现预训练时加入一个专用 sink token,流式部署只需保留这一个 token。
GPT-2 small 实测
为了在本机复现这一现象,同目录的
images/attention_sink_gpt2.py 用
openai-community/gpt2(124M)对一段 131 个
token 的英文文本做一次前向,统计每层所有头、所有 \(t \ge 16\) 的 query
分给各个键的平均注意力。环境:Windows,Python 3.12.10,torch
2.14.1+cpu,transformers 5.19.0,eager
attention;前向计算是确定性的,只跑一次。

结果(脚本原样输出的数值):
- 均匀分配基线(\(1/(t+1)\) 的平均)为 0.018。第 0 层分给位置 0 的平均权重为 0.021,与基线接近。
- 从第 3 层起,位置 0 拿到 0.39 以上的平均权重,第 5–10 层在 0.55–0.69 之间,最高的第 7 层为 0.683。
- 位置 1 在所有层都不超过 0.018,说明集中的不是「靠前的若干 token」,而是第一个位置。
- 在文本前加一个
<|endoftext|>,让位置 0 换成另一个 token,各层数值几乎不变(第 7 层 0.687)。
这只是一个模型、一段文本的观测。GPT-2 使用可学习的绝对位置嵌入,本实验无法区分 sink 来自「第一个位置只看得到自己」还是来自位置 0 的嵌入本身;结论只能是:在这个模型上,sink 跟着位置走,而不是跟着 token 内容走。
Sink 从哪来:mask 决定落点,不决定有无
如果把 attention sink 完全归因于 causal
mask,会遇到反例。StreamingLLM 附录 H 在 BERT-base-uncased
上观察到注意力集中在 [SEP] 上;Darcet
等人(ICLR 2024)发现监督和自监督 ViT 中都有高范数的
artifact token,出现在信息量低的背景 patch
上,被模型挪作内部计算之用,加入专门的 register token
后问题消失。这两类模型都是双向注意力。
Gu 等人(ICLR 2025)系统研究了 sink 的成因:sink 在足够数据上有效优化之后才出现,在小模型中也普遍存在;sink 的位置与损失函数和数据分布高度相关;sink 更像一种 key bias,承接多余的注意力分数,对 value 的贡献可以很小;把 softmax 换成不做归一化的 sigmoid attention 后,在 1B 参数以内的模型中 sink 不再出现。综合这些证据,比较稳妥的表述是:softmax 归一化让模型需要一个「倾倒」多余注意力的地方,causal mask 让序列最前面的 token 成为最方便的候选。
七、实现与开销
四种写法
下面的显式实现与 PyTorch SDPA 的结果在数值误差内一致(PyTorch 2.14.1+cpu 实测):
import torch
import torch.nn.functional as F

def causal_attention_explicit(q, k, v):
    n = q.size(-2)
    visible = torch.ones(n, n, dtype=torch.bool, device=q.device).tril()
    scores = q @ k.transpose(-2, -1) / q.size(-1) ** 0.5
    scores = scores.masked_fill(~visible, float("-inf"))
    return scores.softmax(dim=-1) @ v

torch.manual_seed(0)
q, k, v = (torch.randn(2, 4, 128, 64) for _ in range(3))  # (batch, heads, seq, head_dim)
ref = causal_attention_explicit(q, k, v)
out = F.scaled_dot_product_attention(q, k, v, is_causal=True)
print(torch.allclose(ref, out, atol=1e-5), (ref - out).abs().max().item())
True 7.748603820800781e-07四种常见写法的取舍:
| 写法 | mask 是否物化为 \(n \times n\) | 适用场景 |
|---|---|---|
| 浮点 mask 加到分数上(Llama 3 参考实现) | 是,fp16 时 \(2n^2\) 字节 | 教学、参考实现 |
bool mask + masked_fill /
torch.where(HF eager 路径) |
是,\(n^2\) 字节 | 需要任意形状 mask 的 eager 实现 |
F.scaled_dot_product_attention(..., is_causal=True) |
融合 kernel 中不需要 | 训练和方阵 prefill |
flash-attn
flash_attn_func(q, k, v, causal=True, window_size=(-1, -1)) |
否,kernel 内按坐标判断 | CUDA 上的生产训练与推理 |
flash-attn 的签名摘自
Dao-AILab/flash-attention 仓库
flash_attn/flash_attn_interface.py(commit
00756db),需要 CUDA
GPU,本文没有在本机运行。显式 mask 的显存是平方增长的:\(n = 32768\) 时一个 bool mask 为
\(32768^2\) 字节,即 1
GiB;如果 packing 或 padding 导致每个样本的 mask
不同,还要再乘以 batch 大小。
数值:-inf、finfo.min
与整行屏蔽
数值稳定的 softmax 会先减去每行最大值。只有当一整行都是 \(-\infty\) 时,最大值也是 \(-\infty\),出现 \((-\infty) - (-\infty) = \mathrm{NaN}\)。纯 causal mask 每行至少保留对角线,不会触发这种情况;会触发的是左 padding 下 pad 位置的 query,或文档 mask 与 padding 叠加后的空行。下面用一个左 padding 的 3×3 例子对比两种填充值(同一环境实测):
import torch

scores = torch.zeros(3, 3, dtype=torch.float16)
causal = torch.ones(3, 3, dtype=torch.bool).tril()
key_is_pad = torch.tensor([True, False, False])  # left padding: position 0 is a pad token
visible = causal & ~key_is_pad

print(torch.tensor(-1e9, dtype=torch.float16), torch.tensor(-1e9, dtype=torch.bfloat16))
for fill in (float("-inf"), torch.finfo(torch.float16).min):
    probs = scores.masked_fill(~visible, fill).softmax(dim=-1)
    print(fill, [[round(x, 3) for x in row] for row in probs.tolist()])
tensor(-inf, dtype=torch.float16) tensor(-9.9824e+08, dtype=torch.bfloat16)
-inf [[nan, nan, nan], [0.0, 1.0, 0.0], [0.0, 0.5, 0.5]]
-65504.0 [[0.333, 0.333, 0.333], [0.0, 1.0, 0.0], [0.0, 0.5, 0.5]]三点结论:
-1e9超出 fp16 的表示范围(最大有限值 65504),转成 fp16 就是-inf;在 bf16 下它可以表示。所以「用-1e9避免 fp16 出 NaN」的说法不成立。torch.finfo(dtype).min避免了 NaN,但被整行屏蔽的那一行变成了对所有位置(包括未来位置)的均匀分布。这一行的输出没有意义,只能靠 loss mask 把它排除在外。Hugging Facemasking_utils的 eager 路径用的就是torch.finfo(dtype).min。- 非整行屏蔽的行,两种填充值结果相同。
FlashAttention 如何跳过上三角
FlashAttention 把 \(Q\) 和 \(K, V\) 切成块,在片上 SRAM 里逐块计算并在线更新 softmax 统计量,不物化 \(n \times n\) 矩阵。FlashAttention-2(Dao,ICLR 2024)第 3.1.1 节描述了 causal 情形的两点处理:所有列号都大于行号的块整块跳过,序列较长时约占一半;行号保证不小于列号的块不需要逐元素 mask,每一行块只有一个对角块需要。论文报告这带来相对不加 causal mask 约 1.7–1.8 倍的加速(引用数据)。
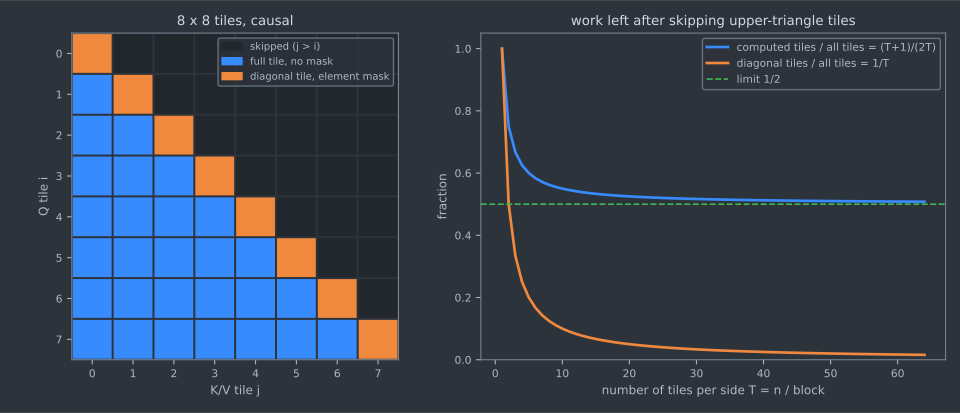
若每边有 \(T = n / B\) 个块,需要计算的块数与占比为
\[\frac{T(T+1)/2}{T^2} = \frac{T+1}{2T} \xrightarrow{T \to \infty} \frac{1}{2}.\]
对角块占比 \(1/T\),这些块要额外做逐元素判断,且块内仍有近一半的计算被丢弃,所以实测加速达不到 2 倍。这一部分是推导,与 FA2 报告的 1.7–1.8 倍方向一致,二者不是同一口径的对比。
FlexAttention:把 mask 写成函数
FlashAttention 的 kernel 只内置了 causal、滑窗、ALiBi
等少数几种模式,prefix LM 或文档 mask 需要别的写法。PyTorch
的 FlexAttention(Dong 等人,MLSys 2025)让用户写一个
mask_mod(b, h, q_idx, kv_idx) -> bool,create_block_mask
预先算出哪些块全空、哪些块需要逐元素判断,编译后的 kernel
跳过全空块。下面用 16 个 token、3 篇文档、块大小 4
演示(同一环境实测):
import torch
import torch.nn.functional as F
from torch.nn.attention.flex_attention import create_block_mask, flex_attention

doc_id = torch.tensor([0] * 5 + [1] * 4 + [2] * 7)  # 3 documents packed into 16 tokens
n = doc_id.numel()

def causal(b, h, q_idx, kv_idx):
    return kv_idx <= q_idx

def doc_causal(b, h, q_idx, kv_idx):
    return (kv_idx <= q_idx) & (doc_id[q_idx] == doc_id[kv_idx])

for mask_mod in (causal, doc_causal):
    bm = create_block_mask(mask_mod, B=None, H=None, Q_LEN=n, KV_LEN=n, device="cpu", BLOCK_SIZE=4)
    print(mask_mod.__name__, bm.to_dense()[0, 0].tolist(), f"sparsity={bm.sparsity():.2f}%")

torch.manual_seed(0)
q, k, v = (torch.randn(1, 2, n, 8) for _ in range(3))
dense = doc_causal(None, None, torch.arange(n)[:, None], torch.arange(n)[None, :])
ref = F.scaled_dot_product_attention(q, k, v, attn_mask=dense)
out = flex_attention(q, k, v, block_mask=create_block_mask(doc_causal, None, None, n, n, device="cpu", BLOCK_SIZE=4))
print("max abs diff vs SDPA:", (out - ref).abs().max().item())
以下输出删去了 flex_attention 未经
torch.compile 时打印的 UserWarning:
causal [[1, 0, 0, 0], [1, 1, 0, 0], [1, 1, 1, 0], [1, 1, 1, 1]] sparsity=37.50%
doc_causal [[1, 0, 0, 0], [1, 1, 0, 0], [0, 1, 1, 0], [0, 0, 1, 1]] sparsity=56.25%
max abs diff vs SDPA: 2.384185791015625e-07
块级 mask 中 1 表示该块需要计算。纯 causal 跳过 16 块中的 6 块(37.5%),文档 mask 跳过 9 块(56.25%),与 \((T+1)/(2T)\) 在 \(T=4\) 时的 \(10/16\) 一致。在 CPU、未编译的情况下 FlexAttention 走的是物化分数矩阵的参考实现,这里只验证正确性,不代表性能。
八、踩坑清单
以下每一条都写明了机制,可以对照上文的代码自查。
- Cross-attention 加了 causal mask。 源序列没有时间方向,加 causal mask 后第 \(i\) 个目标位置只能看到源序列前 \(i\) 个 token,长度不等时还会整行错位。
- Padding mask 与 causal mask 用「或」组合。 一个位置必须同时满足「不是未来」和「不是 pad」才可见,应当取「与」。
- 左 padding 产生 NaN。 pad 位置的 query
整行被屏蔽,用
-inf时该行为 NaN,若未被 loss mask 排除,梯度会传播 NaN,见第七节。 - Decode 时对非方阵调用
is_causal=True。 PyTorch SDPA 按左上角对齐,单个新 query 只看到第一个键,见第四节。 - 自写推理没有 prefill。 把 prompt 当成单个 token 处理或跳过 prompt 的 \(K, V\) 写入,后续 decode 的缓存里没有 prompt 信息。
- Packing 时只换了 mask,没换位置编号。 文档内 mask 阻止了跨文档注意力,但如果位置编码期望每篇文档从 0 开始,position ids 也要按文档重置。
- 滑窗推理淘汰了最早的 token。 窗口一旦滑过序列开头,困惑度可能骤升,见第六节 StreamingLLM 的 Table 1;需要保留初始 token,或使用预训练时带专用 sink token 的模型。
- 滑窗边界差一。 不同库对窗口是否包含自身的约定不同,迁移权重时按第三节核对。
- 把双向预训练模型直接加 causal mask 用于生成。 预训练时每个位置的表示都基于双向上下文,改成 causal 后输入分布变了,需要继续训练;Wang 等人(ICML 2022)的实验中,non-causal 模型要经过自回归目标的适配训练才能成为可用的生成模型。
九、争论与开放问题
争论一:packing 时要不要做文档内 mask
- 不做:GPT-3 依赖 end-of-text 分隔,认为模型能自行推断前后文无关,好处是实现简单、可以用标准 causal kernel。
- 做:Zhao 等人(ACL 2024)发现普通 causal mask 会让模型在预训练中接触前一篇文档的干扰信息,改用文档内因果 mask 后语言建模和下游任务都有提升;他们还发现把相关文档拼在一起(检索式构造的 BM25Chunk)能减少干扰。Llama 3 报告的结论更保守:标准预训练中影响有限,超长序列继续预训练中重要。
- 相关的另一条线:Ding 等人(ICML 2024)关注拼接后切分导致的文档截断,提出 Best-fit Packing 消除不必要的截断;Krell 等人(arXiv 2021,未经同行评审)讨论了如何让 packing 后的模型与不 packing 时在数学上等价。Barbero 等人(COLM 2025)报告 packing 方式会影响 sink 的形成。
这些结果来自不同规模、数据和评测,目前没有在同一设定下的大规模对照,答案可能依赖上下文长度和数据构成。
争论二:attention sink 是缺陷还是功能
- 视为缺陷:Bondarenko 等人(NeurIPS 2023)把量化中的激活离群值归因于注意力头想「什么都不做」,而 softmax 无法输出精确的 0,只能把注意力推到分隔符等 token 上,他们用 clipped softmax 和门控注意力缓解;Gu 等人(ICLR 2025)用不归一化的 sigmoid attention 消除了 1B 以内模型中的 sink;Qiu 等人(NeurIPS 2025)在 SDPA 输出后加按头的 sigmoid 门,在 1.7B dense 和 15B MoE 模型上观察到 sink 缓解和长上下文外推改善。
- 视为功能:Barbero 等人(COLM 2025)从信息传播角度论证,sink 让注意力头可以近似执行空操作,避免深层、长上下文下的过度混合(over-mixing);StreamingLLM 则直接利用 sink 做流式推理。
两派并不完全矛盾:前者说明可以换一种机制提供「空操作」,后者说明这种能力本身有用。去掉 sink 之后,依赖 sink 的流式推理、KV 压缩和量化技巧如何调整,是尚未系统回答的问题。
争论三:输入部分该不该双向
T5 的对照中 prefix LM 明显优于纯 causal LM,Wang 等人发现经过多任务微调后输入双向的模型最好;但只做无监督预训练时 causal decoder 的零样本表现最好,而且 causal 模型的 KV cache 可以只追加、前缀可以共享(第四节)。当前公开权重的主流大模型(Llama、Mistral 等)都采用纯 causal 的 decoder-only 结构,这是训练目标、推理成本和工程生态共同作用的结果,并不等于双向输入在表示上没有优势。
开放问题
- 隐式位置信息能走多远。 Haviv 等人和 Kazemnejad 等人说明 causal mask 能提供位置信息,后者在推理类任务上还观察到更好的长度泛化;但这些实验的规模远小于当前的长上下文模型,在数十万 token 的上下文中,「数前驱」得到的位置信号是否仍然可用,尚无定论。
- 无 sink 注意力在大规模下的代价。 Gu 等人的 sigmoid attention 结论限于 1B 以内,Qiu 等人的门控方案在 15B MoE 上有效;sink 被移除后,Barbero 等人担心的过度混合是否会在更深、更长的模型中出现,需要更大规模的对照实验。
- 任意 mask 的高效 kernel。 FlexAttention 把 mask 表达成函数并按块跳过,但块稀疏只在 mask 的非零区域足够「成块」时有效;对随机稀疏或每个样本形状都不同的 mask,块级跳过的收益和负载均衡仍然是工程上的开放问题。
十、小结与常见误解
Causal mask 是一个下三角约束,但它同时决定了三件事:训练能否一次前向算完所有位置;推理时缓存能否只追加、非方阵时该如何对齐;以及模型把多余注意力倒在哪里。回到系列总览的五个问题:它回答了问题 2 的一部分——Transformer 把 RNN 结构上的因果性改写成一个显式 mask,从而在保留自回归分解的同时把每层的串行步数降到 \(O(1)\);也补上了问题 3 中的一环——在 decoder-only 模型里,一个 token 每经过一层,只能聚合它自己及之前位置的信息。
常见误解:
- 「
-1e9比-inf安全。」 不成立。fp16 下-1e9就是-inf;NaN 的根源是整行屏蔽,不是-inf本身。 - 「Causal mask 让 Transformer 和 RNN 一样慢。」 训练时不会,teacher forcing 下所有位置并行;只有推理的 decode 是串行的。
- 「Decode 永远不需要 mask。」 单 token、无 padding 时不需要;多 token 校验、chunked prefill 和 batch padding 都需要,而且要右下角对齐。
- 「只有 mask 没有位置编码,模型分不清顺序。」 对 causal LM 不成立,NoPos 模型能学到绝对位置;对双向模型成立。
- 「Attention sink 是 causal mask 造成的。」 双向的 BERT 和 ViT 也有类似现象;causal mask 决定的是 sink 落在最前面的位置。
- 「FlashAttention 让 causal attention 快一倍。」 需计算的块比例趋近 \(1/2\),但 FA2 报告的加速约为 1.7–1.8 倍。
- 「Packing 只是数据工程,和 mask 无关。」 Packing 之后要决定是否屏蔽跨文档注意力,不同工作对此有不同结论,见第九节。
下一步
- 下一篇:18. 注意力的复杂度问题,看 \(O(n^2)\) 的计算和显存到底贵在哪里,以及为什么 FlashAttention 不是 \(O(n)\) 计算。
- 想看 mask 在完整 decoder 中的位置:23. Decoder 详解。
- 想看推理侧如何管理 KV cache:49. KV Cache。
- 想看分块与跳块的完整算法:42. FlashAttention;滑窗与稀疏 mask:43. 稀疏与局部注意力。
- 想看位置编码如何演进:41. 位置编码演进。
参考文献
核心论文
- Vaswani A., Shazeer N., Parmar N., Uszkoreit J., Jones L., Gomez A. N., Kaiser L., Polosukhin I. Attention Is All You Need. NeurIPS 2017. arXiv:1706.03762(Section 3.2.3、Table 1)
- Raffel C., Shazeer N., Roberts A., Lee K., Narang S., Matena M., Zhou Y., Li W., Liu P. J. Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. JMLR 21(140), 2020. arXiv:1910.10683(Section 3.2、Figure 3、Table 2)
- Haviv A., Ram O., Press O., Izsak P., Levy O. Transformer Language Models without Positional Encodings Still Learn Positional Information. Findings of EMNLP 2022. arXiv:2203.16634
- Xiao G., Tian Y., Chen B., Han S., Lewis M. Efficient Streaming Language Models with Attention Sinks. ICLR 2024. arXiv:2309.17453(Table 1、Appendix H)
- Gu X., Pang T., Du C., Liu Q., Zhang F., Du C., Wang Y., Lin M. When Attention Sink Emerges in Language Models: An Empirical View. ICLR 2025. arXiv:2410.10781
- Dao T. FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning. ICLR 2024. arXiv:2307.08691(Section 3.1.1 Causal masking)
- Zhao Y., Qu Y., Staniszewski K., Tworkowski S., Liu W., Miłoś P., Wu Y., Minervini P. Analysing The Impact of Sequence Composition on Language Model Pre-Training. ACL 2024. arXiv:2402.13991
其他论文与技术报告
- Williams R. J., Zipser D. A Learning Algorithm for Continually Running Fully Recurrent Neural Networks. Neural Computation 1(2):270–280, 1989.
- Bengio S., Vinyals O., Jaitly N., Shazeer N. Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks. NeurIPS 2015. arXiv:1506.03099
- Mihaylova T., Martins A. F. T. Scheduled Sampling for Transformers. ACL 2019 Student Research Workshop. arXiv:1906.07651
- Liu P. J., Saleh M., Pot E., Goodrich B., Sepassi R., Kaiser L., Shazeer N. Generating Wikipedia by Summarizing Long Sequences. ICLR 2018. arXiv:1801.10198
- Radford A., Narasimhan K., Salimans T., Sutskever I. Improving Language Understanding by Generative Pre-Training. OpenAI technical report, 2018. PDF
- Devlin J., Chang M.-W., Lee K., Toutanova K. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL 2019. arXiv:1810.04805
- Dong L., Yang N., Wang W., Wei F., Liu X., Wang Y., Gao J., Zhou M., Hon H.-W. Unified Language Model Pre-training for Natural Language Understanding and Generation. NeurIPS 2019. arXiv:1905.03197
- Yang Z., Dai Z., Yang Y., Carbonell J., Salakhutdinov R., Le Q. V. XLNet: Generalized Autoregressive Pretraining for Language Understanding. NeurIPS 2019. arXiv:1906.08237
- Brown T. B. et al. Language Models are Few-Shot Learners. NeurIPS 2020. arXiv:2005.14165(Appendix B,packing 说明)
- Du Z., Qian Y., Liu X., Ding M., Qiu J., Yang Z., Tang J. GLM: General Language Model Pretraining with Autoregressive Blank Infilling. ACL 2022. arXiv:2103.10360
- Wang T., Roberts A., Hesslow D., Le Scao T., Chung H. W., Beltagy I., Launay J., Raffel C. What Language Model Architecture and Pretraining Objective Work Best for Zero-Shot Generalization? ICML 2022. arXiv:2204.05832
- Tay Y. et al. UL2: Unifying Language Learning Paradigms. ICLR 2023. arXiv:2205.05131
- Beltagy I., Peters M. E., Cohan A. Longformer: The Long-Document Transformer. arXiv 2020,未经同行评审. arXiv:2004.05150
- Jiang A. Q. et al. Mistral 7B. arXiv 2023,技术报告. arXiv:2310.06825(Section 2,Sliding Window Attention、Rolling Buffer Cache)
- Llama Team, AI @ Meta (Grattafiori A., Dubey A. et al.). The Llama 3 Herd of Models. arXiv 2024,技术报告. arXiv:2407.21783(Section 3.2)
- Press O., Smith N. A., Lewis M. Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation. ICLR 2022. arXiv:2108.12409
- Kazemnejad A., Padhi I., Natesan Ramamurthy K., Das P., Reddy S. The Impact of Positional Encoding on Length Generalization in Transformers. NeurIPS 2023. arXiv:2305.19466
- Darcet T., Oquab M., Mairal J., Bojanowski P. Vision Transformers Need Registers. ICLR 2024. arXiv:2309.16588
- Bondarenko Y., Nagel M., Blankevoort T. Quantizable Transformers: Removing Outliers by Helping Attention Heads Do Nothing. NeurIPS 2023. arXiv:2306.12929
- Barbero F., Arroyo Á., Gu X., Perivolaropoulos C., Bronstein M., Veličković P., Pascanu R. Why do LLMs attend to the first token? COLM 2025. arXiv:2504.02732
- Qiu Z. et al. Gated Attention for Large Language Models: Non-linearity, Sparsity, and Attention-Sink-Free. NeurIPS 2025. arXiv:2505.06708
- Ding H., Wang Z., Paolini G., Kumar V., Deoras A., Roth D., Soatto S. Fewer Truncations Improve Language Modeling. ICML 2024. arXiv:2404.10830
- Krell M. M., Kosec M., Perez S. P., Fitzgibbon A. Efficient Sequence Packing without Cross-contamination: Accelerating Large Language Models without Impacting Performance. arXiv 2021,未经同行评审. arXiv:2107.02027
- Dao T., Fu D. Y., Ermon S., Rudra A., Ré C. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS 2022. arXiv:2205.14135
- Dong J., Feng B., Guessous D., Liang Y., He H. Flex Attention: A Programming Model for Generating Optimized Attention Kernels. MLSys 2025. arXiv:2412.05496
官方文档
- PyTorch 2.14 文档:
torch.nn.functional.scaled_dot_product_attention(is_causal的 upper-left 对齐说明) - PyTorch 2.14 文档:
torch.nn.attention.bias.CausalBias(causal_upper_left/causal_lower_right) - PyTorch 2.14 文档:
torch.nn.attention.flex_attention - flash-attention README:Changelog 2.1: Change behavior of causal flag
源码
- meta-llama/llama3,
llama/model.py,commit32b7ddc:Transformer.forward中的 mask 构造(第 284–297 行),Attention.forward中的 fp32 softmax。GitHub - Dao-AILab/flash-attention,
flash_attn/flash_attn_interface.py,commit00756db:flash_attn_func、flash_attn_varlen_func的签名与 causal 对齐说明。GitHub - huggingface/transformers,
src/transformers/masking_utils.py,commit6595731:causal_mask_function、sliding_window_overlay、packed_sequence_mask_function与 eager 路径的torch.finfo(dtype).min。GitHub
实验与工具
- 本文图表脚本:
images/gen_mask_figures.py(mask 矩阵、四种 mask 对比、分块跳过比例,依赖 numpy、matplotlib);images/attention_sink_gpt2.py(GPT-2 small attention sink 统计,依赖 torch、transformers、matplotlib)。 - 实验环境:Windows,Python 3.12.10,torch
2.14.1+cpu,transformers 5.19.0,matplotlib 3.11.2;模型
openai-community/gpt2。 - StreamingLLM 官方代码:mit-han-lab/streaming-llm
← 上一篇:16. Multi-Head Attention | 下一篇:18. 注意力的复杂度问题 →
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【Transformer 与注意力机制】59|推理退化:乱码、死循环与无意义文本为何不是同一种 bug
推理退化不是单一故障。死循环、乱码/控制字符、无意义数字串各自踩中注意力正反馈、数值溢出与词表边缘的不同路径。本文分清三种形态的触发条件与可观察信号,钉住 Softmax 马太效应、Attention Sink、Causal Mask 退路切断、FP16/量化与 KV Cache 污染,并给出架构到运行时的分层防线、争论与开放问题。
【Transformer 与注意力机制】42|FlashAttention:注意力计算的硬件级重写
FlashAttention 的关键不是近似注意力,也不是把公式改掉,而是重新安排标准 attention 在 GPU 内存层级里的计算路径。本文解释为什么标准 attention 的瓶颈常常是 HBM 读写,FlashAttention 如何用 tiling 和 online softmax 避免物化完整注意力矩阵,以及它为什么省显存、提吞吐,却没有消除 O(n²) 的根本复杂度。
【Transformer 与注意力机制】系列总览
从《Attention Is All You Need》出发把 Transformer 注意力机制、Q/K/V、多头注意力、位置编码、Causal Mask、Softmax、FFN、训练范式、模型变体、推理工程、可解释性、未来架构以及推理退化防御串成 59 篇深度博客。
【Transformer 与注意力机制】23|Decoder 详解:为什么它天生适合生成
把 Transformer decoder 拆开讲透:masked self-attention、cross-attention、FFN 三块子层如何串起来;训练时为什么能并行、推理时为什么必须串行;以及 decoder-only 为什么会成为 GPT 时代的主流路线。