数据比内存大时,排序只能分两步:先把能装进内存的一段排好写出,形成有序的 run,再把这些 run 归并起来。这个框架没有争议,有争议的是框架里的三件”经典优化”:用替换选择(replacement selection)把 run 拉长到内存的两倍;用败者树(tree of losers)代替堆做多路归并,把比较次数减半;用多阶段归并(polyphase merge)减少磁带数量不够时的搬运。三件事在教科书里都是对的,可 PostgreSQL 在 11 版删掉了替换选择、在 15 版删掉了多阶段归并,而 PostgreSQL、RocksDB、GNU sort 三个系统做多路归并都没有用败者树。
本文按”代价模型 → run 生成 → 归并时选最小值的结构 →
归并调度 → 两个生产实现 →
争论”的顺序,逐一说明这些优化省下的是什么、付出的是什么。文中所有自测数字都来自同目录
reproduce/
下的程序(环境见第二节”实验环境”),PostgreSQL 的行为以
REL_18_4 源码为准,GNU sort 以 coreutils v9.11
源码为准。

一、I/O 模型与排序下界
外部存储模型
Aggarwal 和 Vitter 在 1988 年的 CACM 论文里把问题抽象成外部存储模型(external memory model,也叫 I/O 模型或 DAM 模型):
- \(N\):待排序的记录数;
- \(M\):内存能放下的记录数;
- \(B\):一次 I/O 传输的记录数,即一个块(block);
- \(P\):一次能并行传输的块数,本文取 \(P = 1\)。
一次 I/O 必须读写磁盘上连续的 \(B\) 个位置;内存里的计算不计代价,只数 I/O 次数。论文还假设记录不可分割(indivisible),即记录整体搬运,不允许对记录做按位异或之类的拆分操作。
Aggarwal–Vitter 下界
论文的定理 3.1 给出了排序在最坏情况和平均情况下都成立、且上下界相差常数倍的 I/O 次数:
\[ \Theta\!\left(\frac{N}{PB}\cdot\frac{\log(1 + N/B)}{\log(1 + M/B)}\right). \]
取 \(P = 1\),并在 \(N \gg B\)、\(M \gg B\) 时略去 \(1+\),就是常见的写法 \(\Theta\!\left(\frac{N}{B}\log_{M/B}\frac{N}{B}\right)\)。有两点常被略过:
- 下界并不是只对比较排序成立。 论文只在 \(M\)、\(B\) 相对 \(N\) 极小(\(B\log(1+M/B) = o(\log(1+N/B))\))时才用到比较模型;其余情况下,下界来自”把记录搬到正确位置”本身,所以同样的界也约束置换(permuting)。论文由此得出,在绝大多数参数下,排序的主要 I/O 代价是搬运记录,而不是确定顺序。
- 下界依赖不可分割假设。 论文结尾把”去掉这个假设后下界是否仍然成立”列为开放问题(第七节)。
论文还证明,\(P = 1\) 时标准的多路归并排序在常数因子内达到这个界。
把公式翻译成趟数
对数项可以拆成两部分:
\[ \log_{M/B}\frac{N}{B} = \log_{M/B}\!\left(\frac{N}{M}\cdot\frac{M}{B}\right) = 1 + \log_{M/B}\frac{N}{M}. \]
“1” 是生成 run 的那一趟,\(\log_{M/B}(N/M)\) 是归并的趟数:装满-排序-写出会产生 \(R = \lceil N/M\rceil\) 个 run,内存放得下 \(M/B\) 个块缓冲,于是归并路数(fan-in)最多约为 \(k = M/B - 1\)(留一个块做输出缓冲)。每一趟都把全部数据读一遍、写一遍,总 I/O 为
\[ \frac{2N}{B}\left(1 + \left\lceil \log_k R \right\rceil\right). \]
举例:100 GiB 数据、4 GiB 内存,装满-排序-写出得到 \(R = 25\) 个 run。只要 fan-in \(k \ge 25\),一趟归并就够了,每个 run 的输入缓冲约为 \(4\ \text{GiB}/26 \approx 157\ \text{MiB}\)。总共两趟,读写量各 200 GiB。若按 \(B = 4\ \text{KiB}\) 代入下界公式,\(N/B = 25 \times 2^{20}\),\(M/B = 2^{20}\),对数项为 \(1 + \log_{2^{20}} 25 \approx 1.23\),它和实际的”2 趟”之间差的是 \(\Theta\) 里的常数与取整,二者并不矛盾。
模型省略的东西
模型把每次块传输记为同样的代价,现实中还要考虑两件事。
第一,\(B\)
应该按设备的有效传输单位来取,而不是按扇区或页面来取。每路缓冲太小,归并就会变成在
\(k\)
个文件之间来回的小块随机读。PostgreSQL 的
tuplesort.c
文件头注释专门讲了这一点:不预读的话,“there is no
sequentiality of access at all”,所以每个输入 tape
要一次读入约 workMem/M 字节(这里的 M 指输入
tape 数)。
第二,模型认为 CPU 是免费的。fan-in 大到几百上千时,选最小值的代价、以及 \(k\) 路缓冲带来的缓存未命中,都可能超过少做一趟 I/O 的收益。第五节会看到,PostgreSQL 正是出于这个理由把 fan-in 上限定为 500。
二、run 生成:装满排序与替换选择
装满-排序-写出
最直接的方法是装满-排序-写出(load-sort-store):读入 \(M\) 条记录,在内存里排好序,整体写出,重复直到输入读完。每个 run 恰好 \(M\) 条(最后一个可能更短),run 数为 \(\lceil N/M\rceil\),与输入分布无关,已经有序的输入也一样。
替换选择
替换选择用一个大小为 \(M\) 的优先队列持续地输出和吸收记录:
- 用前 \(M\) 条记录建堆;
- 弹出最小记录 \(x\),写到当前 run;
- 读入下一条记录 \(y\):若 \(y \ge x\),它还能排在当前 run 的后面,以当前 run 号入堆;否则以”下一个 run”的编号入堆(冻结);
- 堆顶的 run 号变化时,当前 run 结束,开始新 run。
堆的比较键是(run
号,key),所以冻结记录会自动沉到所有当前 run
的记录之后。下面是 reproduce/runs.c
中的核心循环(省略了轨迹打印):
/* reproduce/runs.c:replacement_selection(),有删减 */
typedef struct { uint64_t run; key_t64 key; } hent;

    uint64_t cur = 0;
    size_t len = 0;
    while (hn > 0) {
        hent top = h[0];
        if (top.run != cur) { runlen[nr++] = len; len = 0; cur = top.run; }
        out[o++] = top.key;
        len++;
        if (pos < n) {
            key_t64 x = in[pos++];
            /* 能接在刚输出的记录后面就留在当前 run,否则冻结到下一个 run */
            h[0] = (hent){x >= top.key ? cur : cur + 1, x};
        } else {
            h[0] = h[--hn];
        }
        if (hn > 0) sift_down(h, hn, 0);
    }
    if (len) runlen[nr++] = len;
用 \(M = 3\) 跑 12
条记录 50, 20, 80, 30, 90, 10, 70, 40, 60, 5, 15,
25,每一行是一次”输出一条、读入一条”之后的状态,方括号表示冻结到下一个
run 的记录(./runs trace 的输出):
| 输出 | 读入 | 之后的堆 | 当前 run |
|---|---|---|---|
| 20 | 30 | 30 50 80 | 0 |
| 30 | 90 | 50 80 90 | 0 |
| 50 | 10 | 80 90 [10] | 0 |
| 80 | 70 | 90 [10] [70] | 0 |
| 90 | 40 | [10] [40] [70] | 0 |
| 10 | 60 | 40 60 70 | 1 |
| 40 | 5 | 60 70 [5] | 1 |
| 60 | 15 | 70 [5] [15] | 1 |
| 70 | 25 | [5] [15] [25] | 1 |
| 5 | - | 15 25 | 2 |
| 15 | - | 25 | 2 |
| 25 | - | (空) | 2 |
三个 run 的长度是 5、4、3,第一个 run 比内存多出 2 条。堆里全是冻结记录时(第 5 行、第 9 行),当前 run 就结束了。输入读完后堆只出不进,最后一个 run 通常较短。
为什么是 2M:谱系与雪犁论证
替换选择的 run 长度问题有一条很长的谱系。Friend 在 1956 年的 JACM 综述里猜测 run 长度约为内存的两倍;Knuth 1963 年在 CACM 发表的短文 “Length of strings for a merge sort” 推导了各个 run 长度的生成函数;Gassner 1967 年在 CACM 发表的 “Sorting by replacement selecting” 给出结论:输入随机、\(N\) 足够大时,第一个 run 的期望长度是 \((e-1)M \approx 1.718M\),此后每个非末尾 run 的期望长度是 \(2M\)。
Knuth 在 TAOCP 第 3 卷 5.4.1 节用”环形跑道上的雪犁”解释 \(2M\),并注明这个比喻来自 E. F. Moore 的美国专利 2983904(1961):雪以均匀速率落在整条跑道上,雪犁以恒定速度绕圈清扫。到稳态时,雪犁前方的积雪厚度从零线性增长到最大,跑道上始终共有 \(M\) 单位的雪(内存里的 \(M\) 条记录),而雪犁绕一圈清走的雪是 \(2M\),也就是一个 run 的长度。对应到排序,“雪”是新读入的记录,“犁的位置”是当前 run 刚输出的键值:键值比它大的新记录还能赶上这一圈,比它小的只能等下一圈。
这条谱系到今天仍在延伸:按 Bender 等人的综述,Knuth 分析过严格交替生成升序 run 与降序 run 的变体,随机输入下期望 run 长度只有 \(3M/2\);Martinez-Palau 等人(PVLDB 2010)的 two-way replacement selection 启发式地选择方向,在混有升降段和逆序的输入上 run 显著变长;Bender 等人(ISAAC 2015)从在线算法角度证明严格交替升降是 2-竞争的,并且对确定性在线算法已经最优。
实测:run 长度
./runs lengths 取 \(M = 65536\)、\(N = 256M\),每种输入跑 3
个种子(三个种子结果几乎相同,下表列出范围):
| 输入 | 装满-排序-写出 run 数 | 替换选择 run 数 | 第一个 run / \(M\) | 中间 run 平均 / \(M\) |
|---|---|---|---|---|
| 随机 | 256 | 129 | 1.722 – 1.725 | 1.998 – 1.999 |
| 已排序 | 256 | 1 | 256 | - |
| 逆序 | 256 | 256 | 1.000 | 1.000 |
| 近似有序(每个键偏离原位不到 \(4M\)) | 256 | 76 | 2.599 – 2.610 | 3.404 |
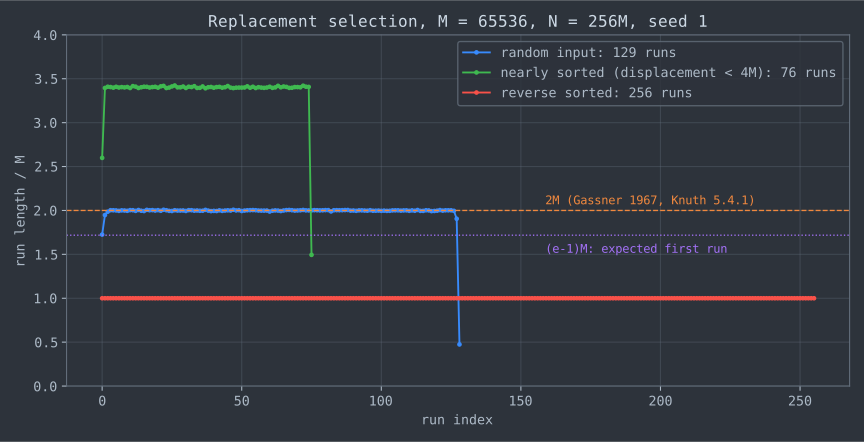
随机输入的第一个 run 与 \((e-1)M\) 相符,中间的 run 与 \(2M\) 相符,run 数减半。已排序输入只生成 1 个 run,完全不需要归并;而装满-排序-写出不管输入如何都是 256 个。逆序是替换选择的最坏情况:每条新记录都比刚输出的小,全部被冻结,每个 run 恰好 \(M\)。
代价:比较次数与缓存
同一组实验里,替换选择每条记录约 30.5 次键比较(每次 sift-down 每层 2 次,约 \(2\log_2 M\)),装满-排序-写出的快排约 18.5 次。更大的差别在访存:快排按分区顺序扫描数组,堆的 sift-down 每一层都跳到一个新的缓存行。
计时实验(./runs time,随机输入,\(N = 16M\),每种配置 5
次取中位数,整个程序跑 3 遍)用 taskset -c 10
绑在一个核上,但同一台机器上还有其他负载,只看相对趋势:
| \(M\) | 键数组 | 替换选择的堆 | 替换选择耗时 / 快排耗时(3 遍) |
|---|---|---|---|
| \(2^{16}\) | 512 KiB | 1 MiB | 2.11 – 2.13 |
| \(2^{22}\) | 32 MiB | 64 MiB | 4.73 – 4.85 |
堆只有 1 MiB 时,替换选择慢一倍左右;堆(64 MiB)超出 30 MiB 的 L3 以后,差距拉大到接近 5 倍。
这正是 PostgreSQL 放弃替换选择的理由。Peter Geoghegan
的补丁(提交 0711803775a3,PostgreSQL 9.6)改为只在第一个
run、且元组数较少时使用替换选择,发布说明写的是 “makes
better use of the CPU cache for typical cache sizes and data
volumes”,并新增参数 replacement_sort_tuples
控制阈值;提交 8b304b8b72b0(PostgreSQL
11)把替换选择和这个参数一起删掉,提交说明是:之前替换选择还能胜出的场景
“seem to have evaporated”。
代价之外,替换选择也有装满-排序-写出给不了的东西:输入越接近有序,run 越长,已排序的输入一趟都不用归并;它逐条吸收、逐条输出,可以和上游算子流水线化。这些好处要在”多一趟归并”真的很贵的时候才兑现,第七节再谈这个争论。
三、k 路归并:败者树、堆与有序数组
归并阶段每输出一条记录,都要在 \(k\) 个 run 的队头中找出最小的那条,再把该 run 的下一条补进来。可选的结构有三种:败者树、二叉堆和有序数组。
败者树
败者树(tree of losers)是锦标赛树的一种,Knuth 在 TAOCP 5.4.1 节把它用于替换选择和多路归并。\(k\) 个 run 的队头是叶子,每个内部节点记录在该节点比赛中输掉的那个 run,树根之上另存总冠军。
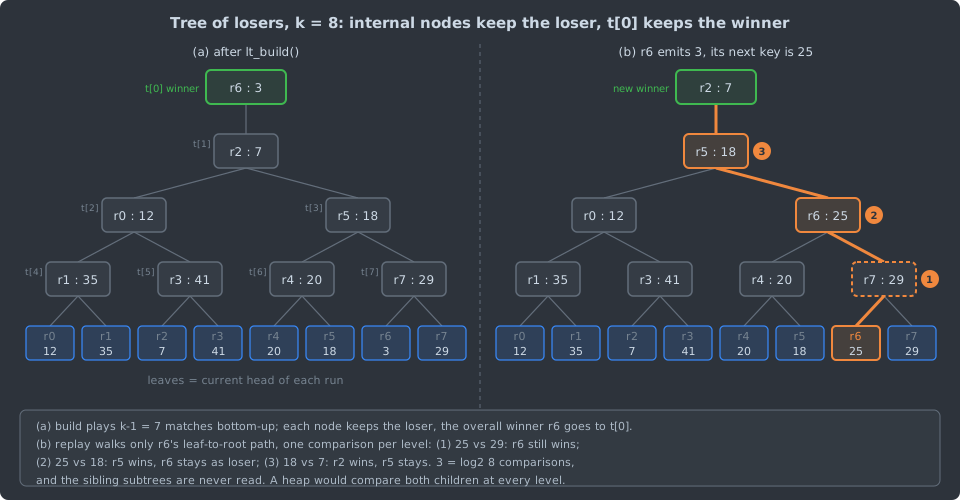
关键在于重赛只需要一条路径。冠军被取走后,新补入的记录只需沿自己的叶子到根的路径,逐层与该节点存放的输家比较一次:输家赢了就互换位置,否则继续上行。节点里存的恰好是”这条路径上曾经的对手中最强的那个”,所以兄弟子树无须读取。\(k\) 为 2 的幂时每输出一条记录恰好 \(\log_2 k\) 次比较。
下面是 reproduce/merge.c 中的实现。叶子
\(i\)
位于隐式完全二叉树的节点 \(k+i\),父节点是 \(\lfloor (k+i)/2
\rfloor\),对任意 \(k \ge
1\) 都成立;耗尽的 run 当作正无穷,键相等时编号小的
run 获胜,所以归并是稳定的:
/* reproduce/merge.c:t[0] 是冠军,t[1..k-1] 是各内部节点的输家 */
typedef struct { int k; int *t; Run *runs; } LoserTree;

static void lt_build(LoserTree *lt)
{
    int k = lt->k;
    int *w = malloc(2 * (size_t)k * sizeof *w); /* 每个节点的胜者 */
    for (int i = 0; i < k; i++) w[k + i] = i;
    for (int p = k - 1; p >= 1; p--) {
        int a = w[2 * p], b = w[2 * p + 1];
        if (lt_less(lt, a, b)) { w[p] = a; lt->t[p] = b; }
        else                   { w[p] = b; lt->t[p] = a; }
    }
    lt->t[0] = k > 1 ? w[1] : 0;
    free(w);
}

/* 冠军 s 所在的 run 前进了一条:沿它的叶子到根路径重赛 */
static void lt_replay(LoserTree *lt, int s)
{
    for (int p = (lt->k + s) >> 1; p > 0; p >>= 1) {
        if (lt_less(lt, lt->t[p], s)) { /* 节点里的输家更小:互换 */
            int tmp = lt->t[p];
            lt->t[p] = s;
            s = tmp;
        }
    }
    lt->t[0] = s;
}
建树自底向上打 \(k-1\) 场比赛,每个内部节点只比较一次。另一种常见写法是先把内部节点填成”负无穷”占位,再对每个叶子调用一次重赛;这种写法遇到占位节点时必须让占位者继续上行,如果写成”遇到占位就停下”,树里会留下错误的输家。
二叉堆与有序数组
二叉堆的 replace-top
从根往下走,每层先比较两个孩子,再用较小的孩子与新记录比较,最多
\(2\lfloor\log_2 k\rfloor\)
次,新记录落位即停。PostgreSQL 的
tuplesort_heap_replace_top()
就是这个循环(按注释对应 Knuth 的 Algorithm 5.2.3H)。
自底向上的变体(Wegener 在 1993 年把它用于 heapsort,称为 BOTTOM-UP-HEAPSORT)先沿”较小孩子”一路走到叶子,每层只比较一次,再从叶子往回找新记录的位置。
GNU sort 的 mergefps()
用的是第三种结构:数组 ord[]
按各路当前行排好序,ord[0]
就是最小的一路。输出后对补进来的新行做二分查找,再把它前面的元素整体前移一格:
/* coreutils v9.11 src/sort.c,mergefps(),有删减 */
      {
        size_t lo = 1;
        size_t hi = nfiles;
        size_t probe = lo;
        size_t ord0 = ord[0];
        size_t count_of_smaller_lines;

        while (lo < hi)
          {
            int cmp = compare (cur[ord0], cur[ord[probe]]);
            if (cmp < 0 || (cmp == 0 && ord0 < ord[probe]))
              hi = probe;
            else
              lo = probe + 1;
            probe = (lo + hi) / 2;
          }

        count_of_smaller_lines = lo - 1;
        for (size_t j = 0; j < count_of_smaller_lines; j++)
          ord[j] = ord[j + 1];
        ord[count_of_smaller_lines] = ord0;
      }
第一次探测固定在 ord[1],源码注释的说法是
“Optimize for the common case where the new line is
smallest”。比较次数约为 \(\log_2
k\),但前移是 \(O(k)\) 的。GNU sort
默认一次最多归并 16 路,这点移动开销可以忽略。
实测:每条记录的比较次数
./merge table 把 \(N = 2^{22}\) 条随机 64
位键均分成 \(k\) 个有序
run,统计四种结构每输出一条记录的键比较次数(3
个种子取中位数)。四种实现都通过了与 qsort
对照的自测(含大量重复键、空 run、非 2 的幂的 \(k\)),败者树和有序数组还检查了稳定性,并在
-fsanitize=address,undefined 下运行:
| \(k\) | \(\log_2 k\) | 败者树 | 堆(PostgreSQL 写法) | 自底向上堆 | 有序数组(GNU 写法) | 有序数组的元素移动 |
|---|---|---|---|---|---|---|
| 2 | 1 | 1.00 | 1.00 | 1.00 | 1.00 | 0.50 |
| 4 | 2 | 2.00 | 2.50 | 2.42 | 2.25 | 1.50 |
| 8 | 3 | 3.00 | 4.00 | 3.63 | 3.50 | 3.50 |
| 16 | 4 | 4.00 | 5.62 | 4.77 | 4.69 | 7.50 |
| 64 | 6 | 6.00 | 9.22 | 6.91 | 6.89 | 31.51 |
| 256 | 8 | 8.00 | 13.07 | 8.97 | 8.97 | 127.47 |
| 1024 | 10 | 10.00 | 17.02 | 10.99 | 11.05 | 511.27 |
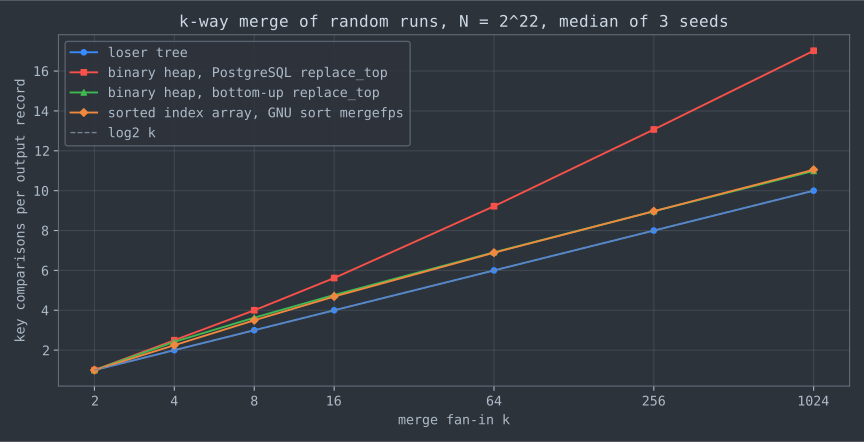
三点观察:
- 败者树与 \(\log_2 k\) 完全重合,这是它的结构保证。
- PostgreSQL 写法的堆从 \(k=16\) 时的 \(1.4\log_2 k\) 增长到 \(k=1024\) 时的 \(1.7\log_2 k\),始终不到 \(2\log_2 k\)。随机 run 里,新补入的记录往往比堆里多数记录都大,要沉到接近叶子,所以提前停下的机会不多,\(k\) 越大越是如此。“败者树比较次数是堆的一半”是按最坏情况说的,实测 \(k \ge 64\) 时败者树少 35% 到 41%。
- 自底向上堆只比败者树多约一次比较,有序数组的比较次数也在同一水平,但它的元素移动约为 \(k/2\),所以只适合小 \(k\)。
比较次数与时钟无关,但也不等于时间:一次键比较可能是一条整数指令,也可能是一次带排序规则(collation)的字符串比较。键比较越贵,这张表的差距就越接近真实开销的差距。
生产系统怎么选
| 系统(版本) | 归并时选最小值的结构 | 位置 |
|---|---|---|
| PostgreSQL 18.4 | 二叉堆,replace-top 与 delete-top | src/backend/utils/sort/tuplesort.c:tuplesort_heap_replace_top() |
| RocksDB 9.10.0 | 二叉堆 | table/merging_iterator.cc:MergingIterator
的 minHeap_(BinaryHeap) |
| GNU coreutils 9.11 sort | 有序下标数组加二分插入 | src/sort.c:mergefps() |
| libstdc++(GCC 16.1.1)并行模式 | 败者树,有稳定与不稳定、带哨兵与不带哨兵等多个变体 | include/c++/16.1.1/parallel/losertree.h,作者
Johannes Singler |
败者树在学术界和高性能库里一直有支持者。Graefe 在 ACM Computing Surveys 2006 年的综述 “Implementing Sorting in Database Systems” 中系统讨论了外部排序的工程技术;Do 和 Graefe 在 TODS 2023 的 “Robust and Efficient Sorting with Offset-value Coding” 中把败者树与偏移值编码(offset-value coding)结合起来,用前一次比较的结果减少后续比较,并报告了在 Google Napa 与 F1 Query 中的实现。这类工作针对的正是”比较很贵”的场景;PostgreSQL 则另走了一条路,用缩略键(abbreviated keys)让比较变便宜,但它在归并阶段会关掉缩略键(第五节)。
四、归并调度:fan-in、趟数与多阶段归并
平衡 k 路归并
平衡 \(k\) 路归并(balanced \(k\)-way merge)每趟把 run 按 \(k\) 个一组归并,run 数除以 \(k\),趟数为 \(\lceil\log_k R\rceil\),每趟搬运全部数据。在磁带时代,fan-in 受的是磁带机数量:\(T\) 台磁带机做平衡归并,一半读、一半写,fan-in 只有 \(T/2\)。
多阶段归并
Gilstad 在 1960 年东部联合计算机会议(Eastern Joint Computer Conference)上发表的 “Polyphase merge sorting” 提出了多阶段归并:\(T\) 台磁带机中 \(T-1\) 台做输入、1 台做输出,fan-in 为 \(T-1\);某台输入带读空时,它就成为下一阶段的输出带。要让每个阶段恰好有一台带先读空,初始 run 在各带上的数目必须满足(广义)斐波那契分布,不够就补空 run(dummy run)。Knuth 在 TAOCP 5.4.2 节给出了完整的 Algorithm D。
3 台磁带、13 个初始 run(\(13 =
8 + 5\),恰好是斐波那契分布)的过程如下,“5x2” 表示 5
个长度为 2 的 run(python3 polyphase.py trace
的输出):
| 阶段 | 本阶段归并次数 | 磁带 1 | 磁带 2 | 磁带 3 |
|---|---|---|---|---|
| 0(初始分布) | - | 8x1 | 5x1 | - |
| 1 | 5 | 3x1 | - | 5x2 |
| 2 | 3 | - | 3x3 | 2x2 |
| 3 | 2 | 2x5 | 1x3 | - |
| 4 | 1 | 1x5 | - | 1x8 |
| 5 | 1 | - | 1x13 | - |
每个阶段结束时恰好有一台带读空,再接着做下一阶段的输出带,任何时刻都没有磁带机闲着。5 个阶段共写出 50 个单位,相当于把全部数据搬了 \(50/13 \approx 3.85\) 遍;3 台磁带做平衡归并的 fan-in 只有 1,根本无法进行。
python3 polyphase.py table 比较同样 \(T\)
台磁带下,两种方法在归并阶段搬运数据的遍数(写出的记录数除以
\(N\),初始分布不计;多阶段归并的空
run 尽量均匀地放在各带开头,括号里是阶段数):
| 磁带数 \(T\) | \(R=100\) 平衡 | \(R=100\) 多阶段 | \(R=1000\) 平衡 | \(R=1000\) 多阶段 | \(R=10000\) 平衡 | \(R=10000\) 多阶段 |
|---|---|---|---|---|---|---|
| 3 | - | 7.13 (10) | - | 10.67 (15) | - | 13.83 (19) |
| 4 | 7 | 4.59 (7) | 10 | 6.92 (11) | 14 | 9.28 (15) |
| 6 | 5 | 3.39 (6) | 7 | 5.33 (10) | 9 | 7.13 (13) |
| 8 | 4 | 3.06 (6) | 5 | 4.71 (9) | 7 | 6.42 (12) |
| 10 | 3 | 2.77 (5) | 5 | 4.55 (8) | 6 | 6.10 (12) |
磁带少的时候,多阶段归并比平衡归并少搬 30% 以上;磁带增多后差距迅速缩小,\(T = 10\)、\(R = 10000\) 时平衡归并反而略少。
PostgreSQL 的”tape”是 logtape.c
在临时文件上模拟的逻辑磁带,多开一条只多占几 KB
内存。PostgreSQL 15 之前 tuplesort.c 实现的是
Algorithm D;Heikki Linnakangas 的提交
65014000b351(PostgreSQL 15)把它换成了平衡 \(k\)
路归并,提交说明是:多阶段归并的优势在于高效复用输入带做输出带,“but
that is irrelevant on modern hardware, when we can easily
emulate any number of tape
drives”。当前文件头注释说得更直接:“if we can have as many
tape drives as sorted runs, we can eliminate any repeated
I/O at all”。
五、PostgreSQL 18 的 tuplesort
以下以 PostgreSQL REL_18_4 为准。与本文相关的逻辑与
REL_17_9 相同,两者的差异只在 TRACE_SORT
条件编译和日志格式。
状态流转
Tuplesortstate
的状态(TupSortStatus)决定了一次排序走内存路径还是外部路径:
stateDiagram-v2
    [*] --> TSS_INITIAL
    TSS_INITIAL --> TSS_SORTEDINMEM: input ends within workMem, qsort
    TSS_INITIAL --> TSS_BOUNDED: LIMIT known, heap of bound tuples
    TSS_BOUNDED --> TSS_SORTEDINMEM: sort_bounded_heap()
    TSS_INITIAL --> TSS_BUILDRUNS: workMem exceeded, inittapes()
    TSS_BUILDRUNS --> TSS_FINALMERGE: runs fit on input tapes, no random access
    TSS_BUILDRUNS --> TSS_SORTEDONTAPE: merge passes until one run
    TSS_SORTEDINMEM --> [*]
    TSS_FINALMERGE --> [*]
TSS_SORTEDONTAPE --> [*]- 在
TSS_INITIAL里,元组先被放进未排序数组,输入结束时还没超出workMem,就用 qsort 在内存里排完。 - 超出后进入
TSS_BUILDRUNS:dumptuples()每次把内存里的元组整体快排、写成一个 run,每个 run 开一条新 tape,tape 数到达上限后按轮转追加。 mergeruns()实现平衡 \(k\) 路归并。如果调用者不需要随机访问、且剩下的 run 数不超过输入 tape 数,最后一趟不落盘,而是在调用者逐条取元组时现场归并(TSS_FINALMERGE)。源码注释写的是,这样 “saves one cycle of writing all the data out to disk and reading it in”。
fan-in 怎么定
/* PostgreSQL REL_18_4 src/backend/utils/sort/tuplesort.c,有删减 */
#define MINORDER        6       /* minimum merge order */
#define MAXORDER        500     /* maximum merge order */
#define TAPE_BUFFER_OVERHEAD        BLCKSZ
#define MERGE_BUFFER_SIZE           (BLCKSZ * 32)

int
tuplesort_merge_order(int64 allowedMem)
{
    int         mOrder;

    mOrder = allowedMem /
        (2 * TAPE_BUFFER_OVERHEAD + MERGE_BUFFER_SIZE);

    mOrder = Max(mOrder, MINORDER);
    mOrder = Min(mOrder, MAXORDER);

    return mOrder;
}
默认 BLCKSZ 为 8192 时,每路输入 tape 按
\(2 \times 8\ \text{KiB} + 256\
\text{KiB} = 272\ \text{KiB}\) 预算:默认的
work_mem = 4MB 得到 15 路,约 133 MiB
以上封顶为 500 路,不到 1.6 MiB 时取下限 6
路。源码注释给出了封顶的理由:“high order merges are quite
slow due to CPU cache effects; it can be faster to pay the
I/O cost of a multi-pass merge than to perform a single
merge pass across many hundreds of
tapes”。这是第一节”模型省略的东西”在真实系统里的体现。
优化器也用同一个函数估算代价:cost_tuplesort()(src/backend/optimizer/path/costsize.c)按
\(r =
\text{input\_bytes}/\text{sort\_mem\_bytes}\) 估计
run 数,取 \(\lceil \log r / \log
m \rceil\) 作为趟数,其中 \(m\) 是
tuplesort_merge_order()
的返回值,页面访问数估计为 \(2
\times \text{npages} \times
\text{趟数}\),并假设其中四分之三是顺序访问。这就是第一节的公式,只是
run 数按装满-排序-写出估计。
实测:trace_sort 日志里的 run 与归并趟
reproduce/pg_trace_sort.sh
在临时目录里起一个 PostgreSQL 18.4 实例,关闭并行,对
2,000,000 个随机 int8 执行
ORDER BY,从 trace_sort 日志里数
run 数和 “starting merge pass” 行:
work_mem |
run 数 | tape 数(fan-in) | 落盘的归并趟 | 最后一趟现场归并 | EXPLAIN 的 Sort Method |
|---|---|---|---|---|---|
| 64kB | 733 | 6 | 3(733 → 123 → 21 → 4) | 4 路 | external merge,Disk: 23536kB |
| 256kB | 184 | 6 | 2(184 → 31 → 6) | 6 路 | external merge,Disk: 23528kB |
| 1MB | 46 | 6 | 2(46 → 8 → 2) | 2 路 | external merge,Disk: 23496kB |
| 4MB | 12 | 15 | 0 | 12 路 | external merge,Disk: 23528kB |
| 16MB | 3 | 60 | 0 | 3 路 | external merge,Disk: 23504kB |
| 64MB | 0 | - | - | - | quicksort,Memory: 49153kB |
tape 数与上面的公式一致:4MB 时 \(\lfloor 4194304 / 278528 \rfloor =
15\),16MB 时为 60,1MB 及以下取下限
6。work_mem 从 64kB 调到 4MB,落盘的归并趟从 3
降到 0,每省一趟就少读写一遍约 23 MB 的临时文件。
1MB 那一行还能看出平衡归并的调度特点:46 个 run 分布在 6 条 tape 上,第一趟之后剩 8 个,第二趟之后剩 2 个,每一趟都搬运了全部数据。这是按日志中的 run 数推断的,本文没有单独统计字节数。第六节会看到,GNU sort 的调度只让一部分 run 多走一趟。
两个容易忽略的细节
- 归并阶段不用缩略键。
mergeruns()开头发现有缩略键转换器时,会把比较函数换回完整比较,注释说明原因:run 写到磁盘时没有保存缩略键,“we don’t care to regenerate them”。所以内存排序和 run 生成可以享受缩略键,归并阶段的每次比较都是完整比较,第三节比较次数的差别在这里是实打实的。 - 小内存下 tape 缓冲会挤占 run 的空间。
inittapestate()会先从可用内存中扣除 \(\text{maxTapes} \times \text{BLCKSZ}\) 的 tape 缓冲,注释解释了MAXORDER的另一层原因:每多一条 tape,生成 run 的内存就少一点,run 变多,归并也跟着变慢。
六、GNU sort 9.11
sort 是命令行里最常用的外部排序器。以下以
coreutils v9.11 的 src/sort.c 为准,本机
sort --version 也是 9.11。
- 内存预算:没有指定
-S时,default_sort_size()取”可用物理内存”与”物理内存的 1/8”中较大者,同时不超过物理内存的 3/4 和资源限制(RLIMIT_DATA、RLIMIT_AS)的一半;sort_buffer_size()再按输入文件大小估计实际需要的缓冲。 - run 生成:缓冲装满后用
sequential_sort()做内存中的归并排序(多线程时由sortlines()分给多个线程,线程数默认取 CPU 数与 8 的较小者,DEFAULT_MAX_THREADS = 8),结果写成临时文件,放在-T或TMPDIR指定的目录下,没有替换选择。 - 归并:
--batch-size默认 16(NMERGE_DEFAULT)。merge()在文件数超过 16 时先做尽可能多的满 16 路归并;如果剩下的文件放不进最后一个 16 路窗口,再做一次”尽量少”的短归并(源码注释:“Merge as few files as possible, to avoid needless I/O”),然后一次性归并进输出文件。打开文件遇到EMFILE时会关掉一路输入,先把已打开的几路归并到临时文件,再继续。 - 压缩:
--compress-program可以把临时文件交给外部压缩程序,用 CPU 换临时文件的写入量。
实测:fan-in 与临时文件写入量
reproduce/gnu_sort_io.sh 生成 1,000,000 行
16 位随机十六进制数(17,000,000 字节,固定种子),用
sort -S 1M --parallel=1 排序,同时用 strace
统计创建的临时文件数和写入临时文件的字节数,每次都用
cmp 核对输出与普通 sort 一致:
--batch-size |
临时文件数 | 写入临时文件的字节 | 相对输入的倍数 |
|---|---|---|---|
| 2 | 122 | 101,454,640 | 5.97 |
| 4 | 82 | 51,000,000 | 3.00 |
| 8 | 70 | 34,000,000 | 2.00 |
| 16(默认) | 66 | 30,712,200 | 1.81 |
| 32 | 63 | 25,775,808 | 1.52 |
| 128 | 62 | 17,000,000 | 1.00 |
fan-in 为 128 时临时文件只有初始 run,可见共有 62 个
run,写入量恰好是 1 倍输入。默认的 16 路按
merge() 的逻辑推演:先做 3 次满 16 路归并(48
个 run 变成 3 个文件),剩 14 个;最后一个窗口只剩 \(16 - 3 = 13\)
个空位,于是再做一次 \(14 - 13 + 1
= 2\) 路的短归并;最终 \(3
+ 1 + 12 = 16\) 个文件直接归并进输出。中间多写了
\(48 + 2 = 50\) 个 run,即
\(50/62 \approx 0.81\)
倍,加上生成 run 的 1 倍,正好是实测的 1.81。fan-in 为 2
时,62 个 run 要归并 \(\lceil\log_2 62\rceil = 6\)
趟,最后一趟直接写进输出文件,不计入临时写入,所以上限是
\(1 + 5 = 6\) 倍,实测 5.97
倍。
和第五节的 PostgreSQL 对照:PostgreSQL 每一趟都搬运全部数据,GNU sort 只让放不进最后一个窗口的那部分 run 多走一趟。
七、争论与开放问题
争论一:替换选择还值不值得
支持的一方:Larson 和 Graefe(SIGMOD 1998)研究了 run 生成阶段的内存管理;Larson(IEEE TKDE 2003)的 “External Sorting: Run Formation Revisited” 直接回应了”替换选择缓存局部性差”的批评,提出批量替换选择(batched replacement selection):先在内存里生成小的有序批次,再把批次归并成输出 run,同时支持变长记录。按论文摘要,在平均 100 字节的记录上,它比经典替换选择的 CPU 时间少约 50%,并且始终快于快排(但不总是快于 AlphaSort);run 数更少确实缩短了归并时间,而对总排序时间的影响取决于可用磁盘的数量。run 数减半、有序输入零归并、可以流水线化,这些好处在第二节都有实测。
反对的一方是 PostgreSQL 的两次提交:9.6 把替换选择限制在第一个 run,11 版彻底删除,理由是快排对 CPU 缓存更友好,而先前还能看到的收益 “seem to have evaporated”。第二节的计时在本机上给出了同样的方向:经典替换选择的堆超出 L3 后慢近 5 倍。本文没有实现 Larson 的批量版本,所以这组数字只否定经典实现,不否定批量替换选择。
两边的分歧可以归结为一个问题:多一趟归并有多贵。PostgreSQL 的 fan-in 可达 500,最后一趟又是现场归并,run 数减半往往省不下一趟落盘的归并;而在 fan-in 受限、或者输入基本有序的场景里,更长的 run 仍然有价值。这个问题没有定论,结论取决于内存大小、fan-in、磁盘数和输入的有序程度。
争论二:选最小值用败者树还是堆
第三节的实测表明,\(k \ge
64\) 时败者树比 PostgreSQL 写法的堆少 35% 到 41%
的比较,但 PostgreSQL、RocksDB 都用堆。堆的优势在工程上:run
耗尽时可以直接缩小堆(tuplesort_heap_delete_top()),而败者树要用哨兵占位;堆的代码也更短。当比较很贵时,Do
与 Graefe
的偏移值编码加败者树给出的是另一种思路:少做比较,并让每次比较更便宜。我没有查到两种路线在同一系统、同一负载下的公开对比。
开放问题
- 不可分割假设能否去掉。 Aggarwal 与 Vitter 在论文结尾提出:允许任意位操作、拆分记录之后,排序的 I/O 下界是否仍然成立?他们认为直觉上仍然成立,但没有证明。这个问题决定了”外部排序已经最优”这句话的适用范围。
- 读写代价不对称时如何设计。 Blelloch 等人(SPAA 2015)的 “Sorting with Asymmetric Read and Write Costs” 在外部存储模型里对写块收取 \(k > 1\) 倍的代价,给出的多路归并、采样排序等变体能渐近地减少写次数,代价是大约每写一块要读 \(k\) 块。第六节的 fan-in 实验是这个权衡最简单的形态:fan-in 从 2 升到 128,临时写入量从 5.97 倍降到 1 倍。在 SSD 的写放大与寿命约束下,这一路线的算法在工程上能落地到什么程度,仍缺少系统层面的评估。
规模上限:SortBenchmark
Sort Benchmark 最早由 Jim Gray
定义和主持,现由委员会维护。所有项目的记录都是 100 字节、前
10 字节为随机键,由 gensort 生成;MinuteSort 和
PennySort 最早定义在 AlphaSort 论文(Nyberg 等,SIGMOD
1994)中。截至本文查阅(2026-09-23,sortbenchmark.org
首页),GraySort 的纪录仍是 2016 年的 Tencent Sort:Daytona
组(要求通用排序代码)100 TB 用时 134 秒,即 44.8
TB/min;Indy 组 100 TB 用时 98.8 秒,即 60.7 TB/min,硬件为
512 个节点,每节点 4 块 NVMe SSD、100 Gb
网络。这些是分布式排序,跨机分区与 shuffle
留给系列的下一篇。
八、工程陷阱与选型
| 陷阱 | 后果 | 做法 |
|---|---|---|
| 以为归并 fan-in 越大越好 | 每路缓冲变小,读取变成多文件之间的小块随机读;选最小值的结构和缓存也跟着变慢 | 像 PostgreSQL 那样给每路留足预读缓冲(它按每路 272 KiB 预算,并封顶 500 路) |
调小 work_mem 省内存 |
第五节中 64kB 比 4MB 多出 3 趟落盘归并,每趟都完整读写一遍临时文件 | 用 EXPLAIN (ANALYZE) 看 Sort Method 是否为
external merge;只对大排序的会话单独调高
work_mem |
| 临时空间估计不足 | 排序中途磁盘写满 | 临时文件至少需要与数据量相当的空间,多趟时还有中间
run;PostgreSQL 用 temp_file_limit
限制单个会话,GNU sort 用 -T
指到空间足够的盘 |
| GNU sort 在多个小盘或慢盘上排大文件 | 默认 16 路,run 多时出现多趟归并 | 用 -S 给足内存减少 run 数,必要时增大
--batch-size;--compress-program
用 CPU 换临时写入量 |
| 依赖外部排序的稳定性 | PostgreSQL 的堆只按键比较,相等键的相对顺序不保证 | 需要确定顺序时把唯一列加进排序键;GNU sort 需要稳定时加
-s |
| 对大内存盲目使用替换选择 | 堆超出末级缓存后比快排慢数倍(第二节) | 默认用快排生成 run;输入明显有序、或 fan-in 受限到必须多走一趟时再考虑替换选择 |
| 自己实现败者树时逐个插入建树 | 插入顺序与节点编号不匹配时留下错误的输家 | 自底向上一次建树(第三节代码),并用重复键、空 run、非 2 的幂的 \(k\) 做对照测试 |
选型上,可以按”哪一项最贵”来判断:
- I/O 最贵(fan-in 受限、临时空间慢):尽量让 run 数不超过 fan-in,使归并一趟完成;此时 run 长度才是关键,替换选择和更大的内存都有价值。
- 比较最贵(长字符串、复杂排序规则):选最小值的结构值得换成败者树,或引入偏移值编码、缩略键这类让比较变便宜的技术。
- CPU 缓存最敏感(内存充足、SSD 较快):快排生成 run,fan-in 适中,接受偶尔多一趟归并,这就是 PostgreSQL 目前的选择。
九、参考资料
源码与提交
- PostgreSQL
REL_18_4:
src/backend/utils/sort/tuplesort.c(文件头注释、tuplesort_merge_order()、inittapes()、inittapestate()、selectnewtape()、mergeruns()、mergeonerun()、dumptuples()、tuplesort_heap_replace_top()),src/backend/utils/sort/logtape.c,src/backend/optimizer/path/costsize.c(cost_tuplesort());对照 REL_17_9。 - PostgreSQL 提交 0711803775a3 “Use quicksort, not replacement selection, for external sorting.”(9.6);8b304b8b72b0 “Remove replacement selection sort.”(11);65014000b351 “Replace polyphase merge algorithm with a simple balanced k-way merge.”(15)。
- PostgreSQL 9.6、11、15 Release Notes 中对应的 Sorting 条目。
- GNU coreutils
v9.11:
src/sort.c(NMERGE_DEFAULT、DEFAULT_MAX_THREADS、default_sort_size()、sort_buffer_size()、sequential_sort()、mergefps()、merge()、sort())。 - RocksDB
9.10.0:
table/merging_iterator.cc。 - libstdc++(GCC
16.1.1):
include/c++/16.1.1/parallel/losertree.h。
核心论文与书
- A. Aggarwal, J. S. Vitter, “The Input/Output Complexity of Sorting and Related Problems”, CACM 31(9):1116–1127, 1988.
- D. E. Knuth, The Art of Computer Programming, Volume 3: Sorting and Searching, 2nd ed., Addison-Wesley, 1998, Sections 5.4.1–5.4.2.
- E. H. Friend, “Sorting on Electronic Computer Systems”, JACM 3(3):134–168, 1956.
- D. E. Knuth, “Length of strings for a merge sort”, CACM 6:685–687, 1963.
- Betty Jane Gassner, “Sorting by replacement selecting”, CACM 10(2):89–93, 1967.
- R. L. Gilstad, “Polyphase merge sorting: an advanced technique”, Eastern Joint IRE-AIEE-ACM Computer Conference, 1960, pp. 143–148.
- G. Graefe, “Implementing Sorting in Database Systems”, ACM Computing Surveys 38(3), 2006.
其他论文
- P.-Å. Larson, G. Graefe, “Memory Management during Run Generation in External Sorting”, SIGMOD 1998, pp. 472–483.
- P.-Å. Larson, “External Sorting: Run Formation Revisited”, IEEE TKDE 15(4):961–972, 2003.
- X. Martinez-Palau, D. Dominguez-Sal, J. L. Larriba-Pey, “Two-way Replacement Selection”, PVLDB 3(1–2):871–881, 2010.
- M. A. Bender, S. McCauley, A. McGregor, S. Singh, H. T. Vu, “Run Generation Revisited: What Goes Up May or May Not Come Down”, ISAAC 2015, LNCS, pp. 703–714.
- I. Wegener, “BOTTOM-UP-HEAPSORT, a new variant of HEAPSORT beating, on an average, QUICKSORT (if n is not very small)”, Theoretical Computer Science 118(1):81–98, 1993.
- T. Do, G. Graefe, “Robust and Efficient Sorting with Offset-value Coding”, ACM TODS 48(1), 2023.
- G. E. Blelloch, J. T. Fineman, P. B. Gibbons, Y. Gu, J. Shun, “Sorting with Asymmetric Read and Write Costs”, SPAA 2015, pp. 1–12.
- C. Nyberg, T. Barclay, Z. Cvetanovic, J. Gray, D. Lomet, “AlphaSort”, SIGMOD 1994, pp. 233–242;期刊版 “AlphaSort: A cache-sensitive parallel external sort”, The VLDB Journal 4(4):603–627, 1995.
工程资料
- Sort Benchmark 首页,sortbenchmark.org(2026-09-23 查阅):GraySort 2016 Tencent Sort 纪录与通用规则。
实验
reproduce/runs.c:第二节的 run 长度、比较次数与计时。reproduce/merge.c:第三节的比较次数。reproduce/polyphase.py:第四节的多阶段归并轨迹与搬运量。reproduce/pg_trace_sort.sh:第五节的 PostgreSQL 实验。reproduce/gnu_sort_io.sh:第六节的 GNU sort 实验。reproduce/plot_figures.py:run-lengths.svg与merge-comparisons.svg;原始输出在reproduce/results/。
实验环境:Intel Core i9-12900K(L2 共 15 MiB、L3 30
MiB),WSL2 内核 6.6.87.2,GCC
16.1.1(-O2 -Wall -Wextra,另以
-fsanitize=address,undefined 跑过自测),Python
3.14.5,matplotlib 3.11.2,strace 7.0,GNU coreutils
9.11,PostgreSQL
18.4。除第二节的计时外,所有指标都是计数,与时钟无关;固定种子下重复运行结果一致。复现:
cd reproduce
gcc -O2 -Wall -Wextra -o runs runs.c && ./runs selftest && ./runs trace && ./runs lengths
taskset -c 10 ./runs time
gcc -O2 -Wall -Wextra -o merge merge.c -lm && ./merge selftest && ./merge table
python3 polyphase.py trace && python3 polyphase.py table
bash pg_trace_sort.sh /tmp/pg-trace-sort 55404
bash gnu_sort_io.sh /tmp/gnu-sort-io
系列导航: - 上一篇:基数排序 - 下一篇:并行排序:排序网络、并行归并、样本排序与 GPU 基数排序
相关阅读: - Join 算法:嵌套循环、排序归并与 Hybrid Hash 的代价和实现 - B+tree 与 LSM-tree:原地更新与异地更新的读、写、空间代价 - LSM 的 compaction 策略 - 缓存无关算法
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
排序算法专题:从 TimSort 到并行排序
把 TimSort、pdqsort、radix sort、external sort、parallel sort 与 benchmark 串成一条阅读路径。先读哪篇、什么时候选哪种排序,这一页讲清。
基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。
并行排序:排序网络、并行归并、样本排序与 GPU 基数排序
用 work/span 计数解释并行排序为何难以线性加速:串行归并与串行划分把并行度压在个位数,并行归并、Merge Path 与样本排序各自如何突破;再对照 libstdc++、oneTBB、Rayon、CUB 源码看生产实现的真实选择。
排序基准测试:比较次数、分支预测与输入分布
在 GCC 16 上对 9 种 int32 排序做精确比较计数与绑核计时(8 种输入分布、3 个进程取中位数):比较次数预测不了耗时,分支预测与输入结构决定排名;反复排序同一数组会把小数组耗时低估 2 到 6 倍。