关于基数排序(radix sort),最常见的说法是”它是 \(O(n)\) 的,打破了排序的 \(O(n\log n)\) 下界”。这句话有两处不准。第一,\(\Omega(n\log n)\) 是比较模型的下界,基数排序根本不在这个模型里,谈不上打破;它的代价是 \(\Theta\!\left(\frac{w}{r}(n+2^r)\right)\),其中 \(w\) 是键的位数、\(r\) 是每趟处理的位数,只有在 \(w\) 被当作常数时才”线性”。第二,按随机存取机(RAM)模型,\(r\) 应取 \(\log_2 n\) 左右,可实际实现几乎都停在 8 到 11 位,原因在缓存和 TLB,而不在算法本身。
本文回答四个问题:下界到底约束了什么;代价转移到了哪里;LSD、MSD
与原地的 American flag sort
各自付出什么;以及在真实机器上基数排序什么时候赢、什么时候输。文中的实测数据和缓存模拟都来自同目录下的
reproduce/(环境见第七节)。
一、比较下界约束的是什么
决策树模型
比较排序只能通过”\(a_i \le a_j\) 吗”这类问题获取输入的信息。把一个算法在所有输入上的比较过程展开,就是一棵决策树:内部节点是一次比较,叶子是一个输出排列。下面是 3 个元素的一棵决策树,6 个叶子对应 \(3! = 6\) 种排列:
graph TD
    A["a0 <= a1 ?"]
    A -- yes --> B["a1 <= a2 ?"]
    A -- no --> C["a0 <= a2 ?"]
    B -- yes --> D["order 0,1,2"]
    B -- no --> E["a0 <= a2 ?"]
    C -- yes --> F["order 1,0,2"]
    C -- no --> G["a1 <= a2 ?"]
    E -- yes --> H["order 0,2,1"]
    E -- no --> I["order 2,0,1"]
    G -- yes --> J["order 1,2,0"]
    G -- no --> K["order 2,1,0"]
正确的算法必须能区分全部 \(n!\) 种排列,所以叶子数至少为 \(n!\);高度为 \(h\) 的二叉树至多 \(2^h\) 个叶子,于是最坏情况下的比较次数
\[ h \ge \lceil \log_2 n! \rceil = n\log_2 n - n\log_2 e + O(\log n) = \Omega(n \log n). \]
这就是 CLRS 第 8.1 节的定理 8.1。作为对照,GCC 16 的
libstdc++ std::sort 排序 \(10^6\) 个随机
uint32_t 时做了 24,071,329 次比较,是 \(\log_2 (10^6)! \approx
18{,}488{,}885\) 的 1.30
倍(reproduce/bench.cpp 的 cmp
模式)。
基数排序在另一个模型里
基数排序做的是另一种操作:取出键的某几位 \(d\),拿它当数组下标去读写
count[d]。一次这样的操作可以把元素分到 \(2^r\) 个桶之一,携带 \(r\)
比特信息,而一次比较至多携带 1
比特。决策树论证不覆盖”用键的值做下标”,所以它对基数排序不成立,也就无所谓被打破。
更准确的模型是字长为 \(w\) 的 word RAM:键是 \(w\) 位整数,可以在常数时间内做移位、按位与和间接寻址。在这个模型里,整数排序的复杂度至今没有定论:
- Kirkpatrick 与 Reisch(TCS 1983)给出了随字长变化的上界;
- Andersson、Hagerup、Nilsson 与 Raman(STOC 1995,JCSS 1998)证明当 \(w \ge \log^{2+\varepsilon} n\) 时可以做到 \(O(n)\),一般情况下 \(O(n\log\log n)\);
- Han(STOC 2002)给出确定性 \(O(n\log\log n)\)、线性空间;Han 与 Thorup(FOCS 2002)给出期望 \(O(n\sqrt{\log\log n})\)。
对任意字长都能在线性时间内排序整数吗? 这仍是公开问题(第九节)。工程上的基数排序离这些理论算法很远,它依赖的只是:键长 \(w\) 固定且不大。
二、代价模型:一趟计数排序
基数排序的每一趟都是一次计数排序(counting sort)。CLRS 第 8 章注记引 Knuth 的说法:计数排序由 H. H. Seward 在 1954 年提出,把它与基数排序结合的想法也归于 Seward;从最低位开始的基数排序更早就是机械卡片分拣机操作员的惯用方法,最早的文献记载是 L. J. Comrie 1929 年描述打孔卡设备的文档。
一趟计数排序分三步,下图用十进制个位演示:
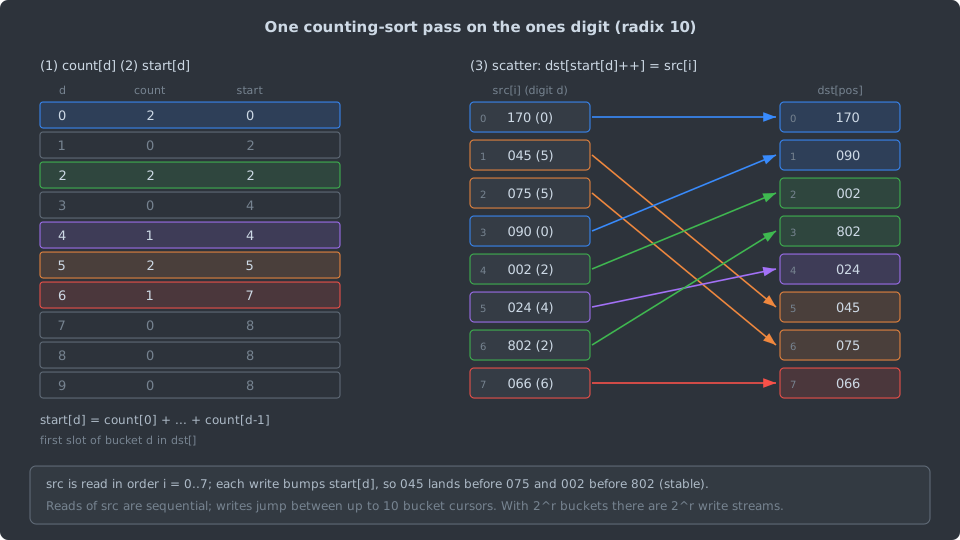
- 直方图:扫描一遍输入,统计每个数字值
\(d\) 出现的次数
count[d]。 - 排他前缀和:
start[d]是比 \(d\) 小的所有桶的元素总数,也就是桶 \(d\) 在输出数组里的第一个位置。 - 散布(scatter):按输入顺序读
src[i],写到dst[start[d]],再把start[d]加一。
第 3 步按输入顺序处理、每个桶的写指针只增不减,所以同一个桶里的元素保持原来的相对顺序,这一趟是稳定的。图中 045 在 075 之前、002 在 802 之前,输出里仍然如此。
一趟的代价是 \(\Theta(n + 2^r)\):\(n\) 次读写元素,加上初始化和扫描 \(2^r\) 个计数器。\(w\) 位的键需要 \(\lceil w/r \rceil\) 趟,总代价
\[ T(n) = \Theta\!\left(\frac{w}{r}\,(n + 2^r)\right). \]
CLRS 引理 8.4 在 RAM 模型下据此给出 \(r = \min(w, \lfloor \log_2 n \rfloor)\):\(r\) 再大,\(2^r\) 项开始超过 \(n\)。按这个结论,\(n = 10^7\) 的 32 位键应该取 \(r = 23\),两趟完成。第五节会看到,实际最优的 \(r\) 在 8 到 11 之间,\(r=16\) 的两趟方案比 \(r=8\) 的四趟慢 46%。RAM 模型把每次内存访问算成相同代价,这个假设在散布阶段不成立。
三、LSD:从最低位开始,依赖稳定性
LSD(least significant digit first)从最低位到最高位,每趟对整个数组做一次稳定的计数排序。仍用上图的 8 个三位数:
| 趟次 | 按哪一位 | 结果 |
|---|---|---|
| 输入 | 170, 045, 075, 090, 002, 024, 802, 066 | |
| 1 | 个位 | 170, 090, 002, 802, 024, 045, 075, 066 |
| 2 | 十位 | 002, 802, 024, 045, 066, 170, 075, 090 |
| 3 | 百位 | 002, 024, 045, 066, 075, 090, 170, 802 |
正确性的归纳不变量是:第 \(k\) 趟之后,数组按”最低 \(k\) 位组成的数”有序。第 \(k+1\) 趟按第 \(k+1\) 位分桶;第 \(k+1\)
位不同的两个键被放到正确的先后位置,相同的两个键靠稳定性保留第
\(k\)
趟建立的顺序。如果某一趟不稳定,这个不变量就断了。reproduce/test_radix.c
做过一个变异实验:把散布循环改成从后往前遍历(写指针仍然递增,于是每趟都把同桶元素的顺序颠倒),测试立即报出
722 处失败。
复现程序里的实现(reproduce/radix.c,函数
lsd_u32(),删去了参数检查):
/* One read of the input builds the histograms of every pass. */
for (size_t i = 0; i < n; i++) {
    uint32_t v = a[i];
    for (unsigned p = 0; p < passes; p++)
        hist[p * nb + ((v >> (p * bits)) & mask)]++;
}

uint32_t *src = a, *dst = tmp;
for (unsigned p = 0; p < passes; p++) {
    uint32_t *h = hist + p * nb;
    const unsigned shift = p * bits;

    /* Every key has the same digit: this pass would copy src verbatim. */
    if (h[(src[0] >> shift) & mask] == n)
        continue;

    uint32_t sum = 0;
    for (size_t d = 0; d < nb; d++) {
        uint32_t c = h[d];
        h[d] = sum;
        sum += c;
    }
    for (size_t i = 0; i < n; i++) {
        uint32_t v = src[i];
        dst[h[(v >> shift) & mask]++] = v;
    }
    uint32_t *t = src;
    src = dst;
    dst = t;
}
if (src != a)
    memcpy(a, src, n * sizeof *a);
三个常见的工程细节都在这里:
- 一次读出所有直方图。每趟的桶计数只依赖键的多重集合,与元素顺序无关,所以可以在第一遍扫描时把所有趟的直方图一起算出来。ClickHouse
的
radixSortLSDInternal()也是这样做的(src/Common/RadixSort.h,v26.9.2.8-stable)。 - 跳过平凡趟。某一位上所有键相同时,这一趟只是原样复制,可以直接跳过。键的值域很窄时(例如
32 位变量里只存了 16 位的值),一半的趟会被省掉,第七节的
narrow16分布就是这种情况。 - 乒乓缓冲(ping-pong buffer)。两块数组轮流做源和目标,只在趟数为奇数时最后复制一次。
LSD 的代价是 \(n\) 个元素的辅助空间,并且每趟都要扫描整个数组,不管前面几位是否已经把键区分开。
四、MSD 与 American flag sort
MSD:只看能区分键的前缀
MSD(most significant digit first)先按最高位分桶,再对每个桶递归处理下一位。桶里只剩 0 或 1 个键时就停止:
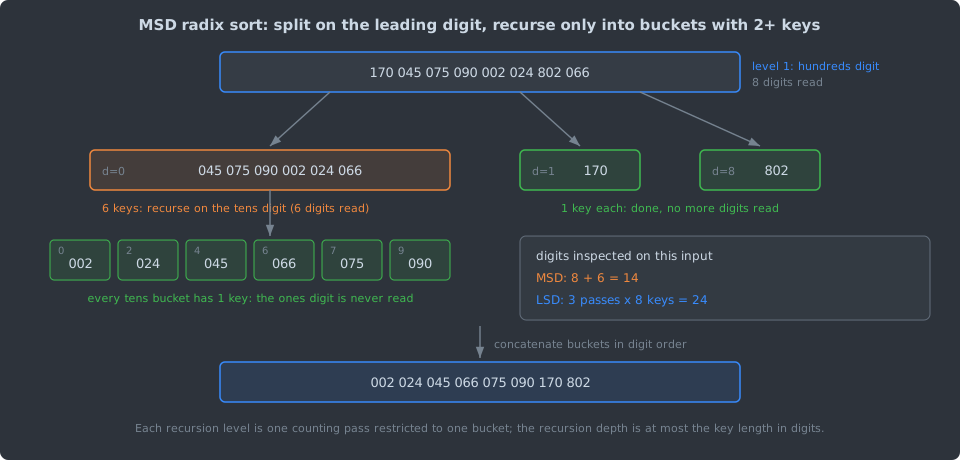
这组输入上,MSD 读了 \(8 + 6 = 14\) 个数字,LSD 读了 \(3 \times 8 = 24\) 个。McIlroy、Bostic 与 McIlroy 在 “Engineering Radix Sort” 的引言里把这一点说得很直接:基数排序只看足以把每个字符串与其余字符串区分开的那些字符,不可能看得更少。这让 MSD 天然适合变长字符串,也能在键很长但前缀就能区分时提前结束。
代价在递归的簿记上:每个桶都要一个 \(2^r\) 项的计数数组,桶变小后,扫描计数数组的 \(\Theta(2^r)\) 开销压过了 \(\Theta(n)\) 的有效工作。所有生产实现都在小桶上换用别的算法:
| 实现 | 换用条件 | 换用的算法 |
|---|---|---|
| ska_sort(commit 2c14d4b) | 元素数少于 128 | std::sort |
ClickHouse
RadixSort::radixSortMSDInternal() |
元素数不超过
INSERTION_SORT_THRESHOLD = 64 |
插入排序 |
| Boost.Sort spreadsort | 比较两种做法的最坏情况,选更优的一种 | 比较排序 |
本文 afs_u32() |
元素数不超过 64 | 插入排序 |
Boost.Sort 文档把
integer_sort、float_sort、string_sort
称为基数与比较的混合算法,并给出 float_sort
的最坏情况 \(O\!\left(N\left(\frac{\log_2(\text{range})}{s}
+ s\right)\right)\),其中 \(s\) 是
max_splits,默认 11。
American flag sort:原地置换
MSD 如果每层都用辅助数组,就需要 \(O(n)\) 额外空间。McIlroy、Bostic 与 McIlroy(Computing Systems 6(1), 1993)的 American flag sort 把它改成原地:先计数、算出每个桶的区间,再把元素沿置换环直接换到目标桶,论文称这一步为 “permute home”。名字来自荷兰国旗问题(Dutch national flag problem,把三种颜色分成三段)的类比:桶数为 256 的一般问题被称为美国国旗问题,论文说这些条纹要理解为各自带有标签,就像当初合众国各州的名字。论文注明 Knuth 第 5.2 节习题 13 有一个类似的算法,不需要计数数组,但情况分析更多,而且有 \(O(n)\) 个元素会被访问不止一次。
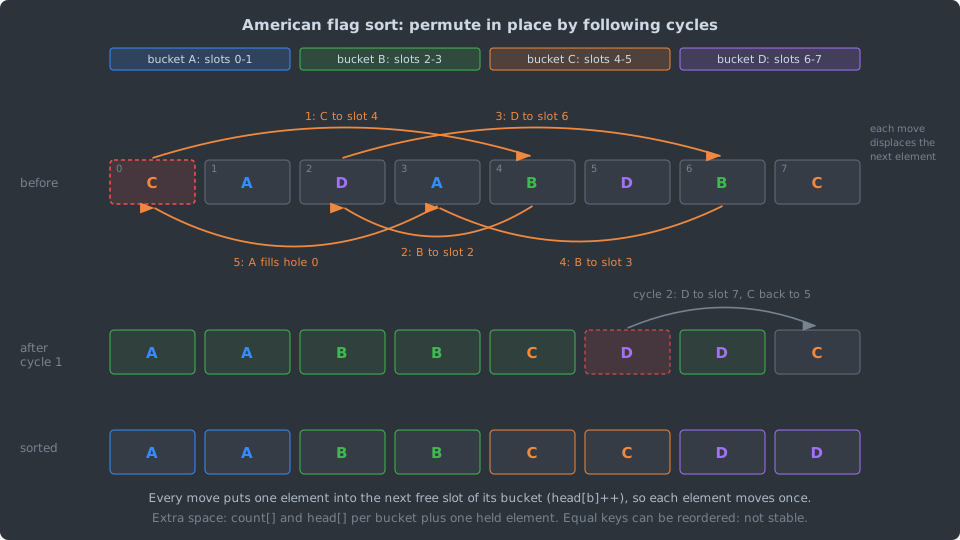
图中每个桶维护一个写指针
head[b],指向该桶里第一个”还不确定是否已归位”的槽。从
head[A] 取出元素 C,槽 0 成为空洞;C 被写到
head[C] 并让它加一,原来在那里的 B
被挤出;如此沿环前进,直到挤出一个属于 A
的元素,正好填回空洞。每次写入都把一个元素放进它最终所在的桶,之后不再移动。复现程序里的对应代码(reproduce/radix.c,函数
afs_rec()):
for (unsigned d = 0; d < 256; d++) {
    while (head[d] < tail[d]) {
        uint32_t v = a[head[d]];
        unsigned b = (v >> shift) & 0xff;
        if (b == d) {
            head[d]++;
            continue;
        }
        /* Follow the permutation cycle until an element of bucket d
         * comes back; it fills the hole at head[d]. */
        do {
            size_t pos = head[b]++;
            uint32_t t = a[pos];
            a[pos] = v;
            v = t;
            b = (v >> shift) & 0xff;
        } while (b != d);
        a[head[d]++] = v;
    }
}
额外空间只有
count、head、tail
三个 256
项数组和递归栈。代价是不稳定:同一个桶里的元素被置换打乱了顺序。
论文用字符串键测了三种字节 MSD(链表版、双数组版、American flag)与一个调优过的 quicksort:在 10,000 到 100,000 个键上,三种基数排序通常至少比 quicksort 快一倍,三者之间没有稳定的名次;论文推荐 American flag sort 作为通用选择。这些数据来自 DEC VAX 8550 等 1990 年代初的机器(论文 Figure 5.1、Table 5.1),不能直接外推到今天。
ska_sort:打破置换环的依赖链
Malte Skarupke 在 2016 年 12 月的博客 “I Wrote a Faster
Sorting Algorithm” 中发布了
ska_sort。按源码(ska_sort.hpp,commit
2c14d4b,2017-05-15),它是按字节的 MSD 基数排序,基数固定为
256,入口是
detail::inplace_radix_sort<128, 1024>:
- 元素少于 128 个,调用
std::sort; - 少于 1024 个,用经典的 American flag
sort(
american_flag_sort()); - 否则用他改写的
ska_byte_sort()。
ska_byte_sort()
的内层循环如下(有删减):
// ska_sort.hpp, commit 2c14d4b, UnsignedInplaceSorter::ska_byte_sort()
for (uint8_t * last_remaining = remaining_partitions + num_partitions,
             * end_partition = remaining_partitions + 1;
     last_remaining > end_partition;)
{
    last_remaining = custom_std_partition(remaining_partitions, last_remaining,
        [&](uint8_t partition)
    {
        size_t & begin_offset = partitions[partition].offset;
        size_t & end_offset = partitions[partition].next_offset;
        if (begin_offset == end_offset)
            return false;
        unroll_loop_four_times(begin + begin_offset, end_offset - begin_offset,
            [partitions = partitions, begin, &extract_key, sort_data](It it)
        {
            uint8_t this_partition = current_byte(extract_key(*it), sort_data);
            size_t offset = partitions[this_partition].offset++;
            std::iter_swap(it, begin + offset);
        });
        return begin_offset != end_offset;
    });
}
与 American flag sort
的区别在于:它不沿着一个环走到底,而是扫描每个未完成桶里的元素,把每个元素直接换到目标桶的写指针处,换进来的元素留到下一轮再看;已经填满的桶由
custom_std_partition
移出列表,直到最多剩一个桶。Skarupke
在博客里说,他测到这个版本的缓存缺失和执行的指令都比
American flag sort
多,实际却更快;他的解释是指令级并行(ILP):American flag
sort
沿环走时,每次交换都要等上一次交换挤出的元素,形成一条依赖链,而逐个扫描时相邻的交换彼此独立,可以同时在流水线里执行。这是作者的分析,本文没有用性能计数器复现;第七节的实测里,ska_sort
在 \(10^7\)
个均匀随机键上比本文的 American flag sort 快约
20%,与这个解释方向一致,但两者的实现细节还有其他差别,不能全部归因于
ILP。
ska_sort
的另一半工作是键的泛化:整数、浮点数、std::pair、元组、字符串和
std::vector
都能排序。对字符串、向量这类列表键,每深入一个元素就要多递归一层,源码用
recursion_limit(初值 16,见
ListInplaceSorter::sort_from_recursion())限制深度,用完就回退到
std::sort;整数路径没有这种限制,因为深度至多是键的字节数。
五、硬件视角:位宽为什么停在 8 到 11 位
散布阶段的读是顺序的,写却在 \(2^r\) 个写指针之间跳跃,相当于同时维护 \(2^r\) 条写流。每条写流在 L1 里至少占一个缓存行,在 TLB 里至少占一个页表项。\(2^r\) 超过这些容量时,几乎每次写都要缺失一次。
为了用与时钟无关的指标看清这一点,reproduce/cachesim.c
对一次散布做了按地址回放的模拟:\(n = 2^{22}\) 个均匀随机的 32
位键,每个元素访问
src[i]、count[d]、dst[count[d]]
各一次;L1D 取测试机 P 核的 48 KiB、12 路,L2 取 1.25
MiB、10 路(来自 sysfs),行大小 64 B,LRU、写分配;TLB
用两个模型参数:64 项和 2048 项、4 KiB
页,不对应某款 CPU 的真实 TLB。L2 和 TLB
的组索引用页号的哈希模拟物理页的放置,L1
的组索引位都在页内偏移里,按地址精确计算。模拟结果是确定的,连续运行输出逐字节一致。
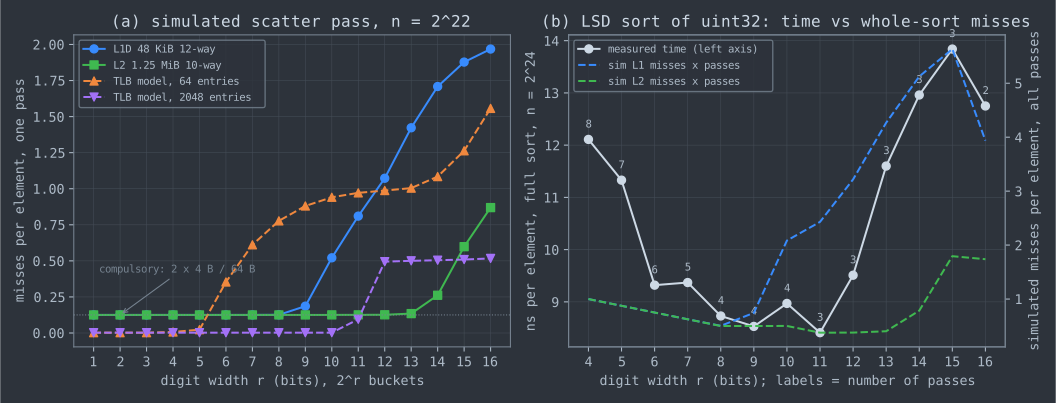
左图(一趟)的几个读数:
| \(r\) | 桶数 | L1 缺失/元素 | L2 缺失/元素 | 64 项 TLB 缺失/元素 | 2048 项 TLB 缺失/元素 |
|---|---|---|---|---|---|
| 4 | 16 | 0.125 | 0.125 | 0.007 | 0.002 |
| 8 | 256 | 0.126 | 0.125 | 0.777 | 0.002 |
| 10 | 1,024 | 0.521 | 0.125 | 0.941 | 0.002 |
| 11 | 2,048 | 0.810 | 0.126 | 0.971 | 0.095 |
| 12 | 4,096 | 1.073 | 0.126 | 0.987 | 0.494 |
| 16 | 65,536 | 1.968 | 0.869 | 1.557 | 0.517 |
\(0.125\) 是强制缺失:每个元素读 4 字节、写 4 字节,每 64 字节缺失一次。\(r \le 8\) 时,256 条写流加上 1 KiB 的计数数组远小于 L1 的 768 行,写入几乎都命中;\(r = 12\) 时 4096 条写流是 L1 行数的 5 倍多,每个元素的写和计数器访问都会缺失。64 项的 TLB 在 \(r = 8\) 时已经基本失效,这时靠更大的二级 TLB 兜底;2048 项的模型在 \(r = 11\) 开始抖动,\(r = 12\) 时约每两个元素缺失一次。
一趟的缺失数还要乘以趟数 \(\lceil 32/r \rceil\)。按整次排序累计,L1 缺失在 \(r=8\) 时最少(每元素 0.50 次),L2 缺失在 \(r = 11\) 和 12 时最少(0.38 次),\(r=16\) 时两者分别升到 3.9 和 1.7 次。右图是同一台机器上完整 LSD 排序 \(2^{24}\) 个键的实测(三轮中位数,单位 ns/元素):
| \(r\) | 4 | 6 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 16 |
|---|---|---|---|---|---|---|---|---|---|---|
| 趟数 | 8 | 6 | 4 | 4 | 4 | 3 | 3 | 3 | 3 | 2 |
| ns/元素 | 12.11 | 9.32 | 8.73 | 8.53 | 8.97 | 8.41 | 9.51 | 11.60 | 12.96 | 12.75 |
\(r = 8\) 到 11
之间的差异不超过 0.6 ns,小于三轮之间的波动(例如 \(r=11\) 的三轮是
8.25、9.47、8.41),可以看作同一档;\(r \ge 13\) 明显变慢,\(r=16\) 的两趟方案比 \(r=8\) 的四趟慢
46%。计时受多种因素影响,这张表只说明趋势:趟数少并不划算,一旦写流超出
L1 和 TLB 能承载的范围,每趟都变贵。ClickHouse 在
RadixSort::executeMSD()
的注释里记录过相似的经验:“For huge arrays without limit,
the radix 11 suddenly becomes better… but not for smaller
arrays.”(v26.9.2.8-stable,src/Common/RadixSort.h)
文献里缓解散布代价的办法大致有两类:
- 软件写合并(software write-combining):每个桶先写进一个缓存行大小的本地缓冲,满了再整行写出,写流数不变,但写出去的都是整行。Wassenberg 与 Sanders(Euro-Par 2011)结合虚拟内存和写合并,报告每趟吞吐至少达到系统峰值内存带宽的 89%。Polychroniou 与 Ross(SIGMOD 2014)系统比较了主存分区(partitioning)的各种实现,并用于大规模的比较排序与基数排序。
- 块级置换:IPS⁴o 与 IPS²Ra(Axtmann 等,ESA 2017;ACM TOPC 2022)先把元素分到每桶一个的缓冲块,块满后写回输入数组中已经分类过的区域,最后按块而不是按元素做置换,从而同时做到原地和缓存高效。
六、键变换:有符号数、浮点数与复合键
基数排序只认无符号整数的位序。其他类型要先映射成无符号键,并且映射必须保序:\(x < y \Rightarrow f(x) < f(y)\)。
有符号整数
补码表示下,负数的最高位是 1,按无符号比较会排到正数后面。把符号位取反(等价于加上 \(2^{w-1}\))就把 \([-2^{w-1}, 2^{w-1})\) 平移到了 \([0, 2^w)\):
static inline uint32_t i32_to_key(int32_t x) { return (uint32_t)x ^ 0x80000000u; }ska_sort 的 to_unsigned_or_bool(int) 用加
\(2^{w-1}\)
的写法,ClickHouse 的 RadixSortSignedTransform
用异或,两者等价。
IEEE 754 浮点数
binary32 是符号-数值表示:符号位为 0 时,位模式越大数越大;符号位为 1 时,位模式越大数越小。映射规则是:负数翻转全部 32 位,非负数只翻转符号位。
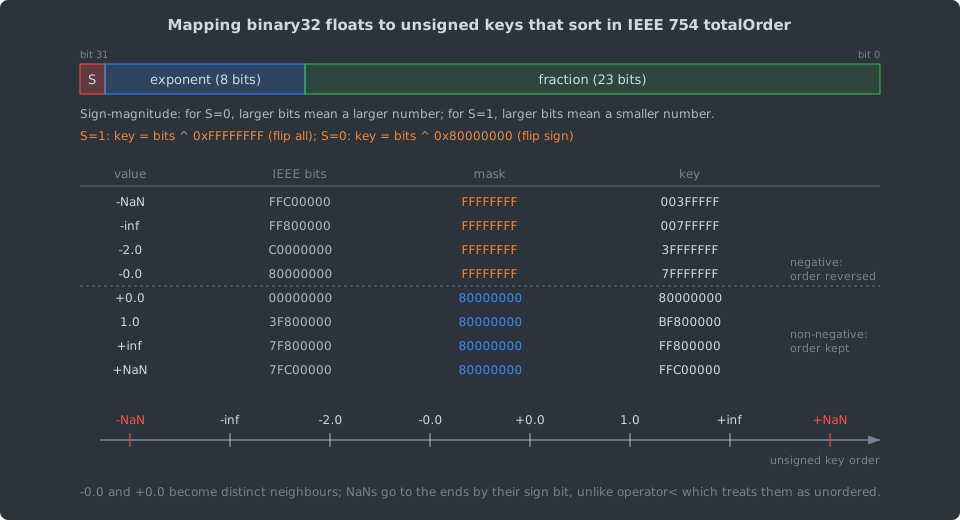
/* reproduce/radix.h */
static inline uint32_t f32_to_key(float f)
{
    uint32_t u;
    memcpy(&u, &f, sizeof u);
    uint32_t mask = (uint32_t)-(int32_t)(u >> 31) | 0x80000000u;
    return u ^ mask;
}
用 memcpy
取位模式可以避免违反严格别名规则。ska_sort 的
to_unsigned_or_bool(float) 和 ClickHouse 的
RadixSortFloatTransform 用的是同一个变换。
这个变换得到的顺序是 IEEE 754-2008 定义的 totalOrder:负
NaN < \(-\infty\) <
负数 < \(-0\) < \(+0\) < 正数 < \(+\infty\) < 正 NaN。Rust
标准库的 f32::total_cmp(1.62
起稳定)文档写明实现的就是这个谓词,源码(Rust
1.94.0,library/core/src/num/f32.rs)用的是等价的技巧:对负数翻转除符号位外的所有位,再按有符号整数比较。reproduce/test_radix.c
穷举了全部 \(2^{32}\)
个键,验证了逆变换正确、按键递增遍历时数值不减、只有 \(-0 \to +0\) 一对相等、负 NaN
全在最前、正 NaN 全在最后。
它和 operator<
的语义不同:< 认为 \(-0 = +0\),任何与 NaN
的比较都为假。含 NaN 的数组交给 std::sort
违反严格弱序的要求,行为未定义;基数排序则总是给出确定的位置。Boost.Sort
的 float_sort 文档专门说明了这一点:-0.0 与
0.0、NaN
由基数部分给出确定的顺序,而比较排序不保证它们的相对位置。如果业务要求”NaN
一律放最后”,还得单独处理:ClickHouse 的
ColumnVector::getPermutation()
在基数排序之后调用 moveNanToRequestedSide(),按
nan_direction_hint 把两端的 NaN
挪到要求的一侧。
复合键与规范化键
多列、升降序混合、带字符串的排序键,可以编码成一个按字节比较(memcmp)就能得到正确顺序的二进制串,这叫键规范化(key
normalization):整数转成大端并翻转符号位,降序列按位取反,字符串截取定长前缀,NULL
用一个前导字节编码。Graefe 的综述(ACM Computing Surveys
2006)讨论了数据库排序中的规范化键。编码之后,按字节的 MSD
基数排序和 memcmp 比较给出同样的顺序,DuckDB
2021 年的排序重写正是这样做的(见第八节)。
规范化键不能直接处理需要按语言规则比较的字符串排序规则(collation),通常要先把字符串转换成排序键,这一步本身就有代价。
七、实测:什么时候赢,什么时候输
环境与口径
- 机器:Intel Core i9-12900K,WSL2,内核 6.6.87.2;GCC/G++
16.1.1,
-O2;程序用taskset -c 9绑在一个 P 核的超线程上。机器上同时有其他任务在运行,负载约为 9,同一物理核的另一个超线程(CPU 8)也可能被占用,绝对数字只看相对趋势。 - 被测实现:libstdc++ 的
std::sort;ska_sort(commit 2c14d4b);本文的afs_u32()(American flag sort);本文的lsd_u32(),位宽 8、11、16。LSD 的辅助数组在计时外分配并预先写过。 - 输入:xorshift 生成的伪随机数,种子固定。每个点在一轮内重复 31 次(\(n \le 10^5\))或 7 次,取中位数;完整实验跑 3 轮,表中是三轮中位数的中位数。每次排序后都与参考结果比对。
- 复现:
cd reproduce && ./run_all.sh 9,然后python3 plot_figures.py(需要 matplotlib;运行前先按bench.cpp顶部的注释拉取 ska_sort)。原始输出在reproduce/results/bench.txt,汇总在results/summary.txt。
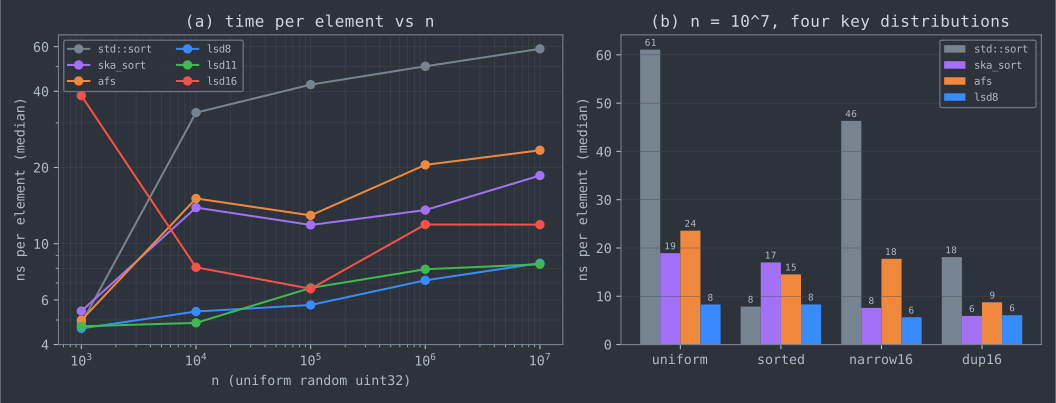
规模
均匀随机 uint32_t,单位 ns/元素:
| \(n\) | std::sort |
ska_sort | American flag | LSD 8 位 | LSD 11 位 | LSD 16 位 |
|---|---|---|---|---|---|---|
| \(10^3\) | 4.84 | 5.42 | 4.99 | 4.63 | 4.72 | 38.45 |
| \(10^4\) | 32.93 | 13.89 | 15.09 | 5.40 | 4.87 | 8.07 |
| \(10^5\) | 42.49 | 11.86 | 12.94 | 5.73 | 6.69 | 6.64 |
| \(10^6\) | 50.19 | 13.58 | 20.48 | 7.17 | 7.93 | 11.91 |
| \(10^7\) | 58.81 | 18.59 | 23.39 | 8.38 | 8.30 | 11.90 |
- 小规模打平。\(n = 1000\) 时 ska_sort 直接调用
std::sort(它在每个不足 128 个元素的桶上都这样做),各实现相差在 1 ns 以内;LSD 16 位慢 8 倍,因为两趟要初始化并扫描 \(2 \times 65536\) 个计数器,\(2^r\) 项远大于 \(n\),这正是代价公式里的 \(2^r\)。 - 大规模差距拉开。
std::sort每元素的时间随 \(\log n\) 增长,基数排序大致持平。\(n = 10^7\) 时 LSD 8 位比std::sort快 7.0 倍,ska_sort 快 3.2 倍。 - 原地要付代价。\(n = 10^7\) 时,非原地的 LSD 比原地的 ska_sort 快 2.2 倍,但多用了 \(n\) 个元素的内存。本文的 American flag sort 比 ska_sort 慢约 26%。
分布
\(n = 10^7\),单位 ns/元素:
| 分布 | std::sort |
ska_sort | American flag | LSD 8 位 |
|---|---|---|---|---|
| uniform:均匀随机 | 61.09 | 18.93 | 23.58 | 8.29 |
| sorted:已升序 | 7.87 | 17.01 | 14.53 | 8.31 |
| narrow16:值小于 \(2^{16}\) | 46.33 | 7.59 | 17.76 | 5.65 |
| dup16:只有 16 个不同的随机值 | 18.11 | 5.92 | 8.75 | 6.07 |
同一台机器上两次独立的均匀随机实验(上表和规模表的 \(10^7\) 一行,输入不同)中
std::sort 相差约 4%,这可以作为噪声的量级。
- 基数排序不利用已有的顺序。LSD
在已排序输入上的时间与随机输入相同,ska_sort
在已排序输入上比
std::sort慢一倍多。这不是实现缺陷:计数和散布与输入顺序无关。这里的”已排序”是排好序的随机键;如果键是连续整数 \(0..n-1\),各桶大小都是 2 的幂,LSD 的散布会撞上 L1 组冲突而明显变慢,见 排序基准测试 第四节。生产系统的做法是先探测:ClickHouse 在基数排序前先调用trySort()(内部是pdqsort_try_sort,识别已排序、接近排序和逆序),DuckDB v1.4 先用 vergesort 找已有的有序段。 - 值域窄时基数排序更快。
narrow16的高两个字节全为 0,LSD 跳过了两趟,比随机输入还快;ska_sort 在最高字节上只有一个非空桶,ska_byte_sort()的置换循环不执行,直接递归到下一个字节。 - 重复值多时比较排序也会变快,但本例只有 16 个不同值,基数排序每层都只剩少数几个非空桶,照样领先。这个分布对基数排序很”容易”,不能推广到一般的偏斜分布(第九节)。
64 位键(\(n =
10^7\),均匀随机):std::sort
59.69、ska_sort 19.48、LSD 8 位 19.33 ns/元素。LSD 要做 8
趟,每趟搬运的字节数也翻倍,优势缩小到与 ska_sort
持平。ska_sort 自带的 ska_sort_copy()
就是在趟数达到 8 时改用原地版本。
八、谱系与生产实现
| 年份 | 工作 | 贡献 |
|---|---|---|
| 1929 / 1954 | Comrie 的打孔卡文档;Seward(均经 Knuth、CLRS 转引) | 卡片机上的 LSD;计数排序及其与基数排序的结合 |
| 1993 | McIlroy、Bostic、McIlroy,Computing Systems | 字节 MSD 的三种实现,原地的 American flag sort |
| 2009 / 2011 | Satish 等(IPDPS 2009);Merrill 与 Grimshaw(Parallel Processing Letters 2011) | GPU 上的基数排序 |
| 2011 | Wassenberg 与 Sanders(Euro-Par 2011) | 写合并与虚拟内存,逼近内存带宽 |
| 2014 | Polychroniou 与 Ross(SIGMOD 2014) | 主存分区的系统比较 |
| 2016 | Skarupke,ska_sort | 按字节的原地 MSD,泛化到任意可分解键 |
| 2019 | Obeya 等,Regions Sort(SPAA 2019) | 用图结构刻画交换间的依赖,并行原地基数排序 |
| 2017 / 2022 | Axtmann 等,IPS⁴o / IPS²Ra(ESA 2017;ACM TOPC 2022) | 块级原地分区,同时服务样本排序与基数排序 |
| 2022 | Adinets 与 Merrill,Onesweep(arXiv:2206.01784,预印本,未经同行评审) | GPU 上单遍的 LSD 基数排序 |
几处生产代码:
- ClickHouse(v26.9.2.8-stable)。
src/Common/RadixSort.h同时实现稳定的 LSD 和支持部分排序(limit)的不稳定 MSD,每趟 8 位(PART_SIZE_BITS = 8),在 Intel CPU 上散布时用__builtin_prefetch预取后续元素的写位置。ColumnVector::getPermutation()对非大整数的数值列、无limit、行数在 256 到 \(2^{32}-1\) 之间时,先trySort(),失败才把(值,行号)对交给RadixSort::executeLSD(),排序结果是行号的排列,也就是间接排序。源码注释注明:降序或浮点列时 LSD 目前不稳定,因此要求稳定排序时这两种情况不走基数排序。 - DuckDB。2021 年的重写(Laurens
Kuiper,“Fastest Table Sort in the West”)把
ORDER BY的各列编码成可memcmp比较的二进制串,再对它做基数排序。2025 年 v1.4.0 又重写了一次(“Redesigning DuckDB’s Sort, Again”):用create_sort_key生成规范化键,排序流程是 vergesort(利用已有的有序段)、ska_sort(对键的前 64 位做原地 MSD 基数排序)、pdqsort 三级。博客给出的代价是:在 M1 Max 上单线程排序 1 亿个随机整数(五次取中位数),新实现比旧实现慢约 30%,原因是原地 MSD 替换了非原地 LSD,而旧实现占用的内存多得多。 - Boost.Sort spreadsort(Steven
Ross)。
integer_sort、float_sort、string_sort是 MSD 基数与比较排序的混合,按最坏情况选择每一步用哪种。 - PostgreSQL。17.9 的
src/backend/utils/sort/tuplesort.c没有基数排序,内存排序用lib/sort_template.h实例化的快速排序,按首个排序键datum1特化出qsort_tuple_unsigned、qsort_tuple_signed、qsort_tuple_int32等版本。
九、争论与开放问题
争论:基数排序真的比比较排序快吗
ska_sort 的博客标题是”比 std::sort
快一倍”,DuckDB 2021
年的博客说基数排序”非常快”,本文第七节的数据也支持这一点。但
Axtmann、Witt、Ferizovic 与 Sanders 在 TOPC 2022
的论文里得出的结论相反:论文摘要的原话是:他们的比较排序
IPS⁴o
“在很大范围的情形下甚至胜过最好的整数排序算法”;在剩下的许多情形中(往往是接近均匀的分布、较短的键或单线程),他们的原地基数排序
IPS²Ra 才是最好的。实验覆盖 21 个排序实现、6 种数据类型、10
种输入分布、4 台机器、4 种内存分配策略,输入规模跨 7
个数量级。正文里与本文相关的两点:
- IPS²Ra 在
uint32输入上比 IPS⁴o 快 1.37 倍,优势集中在均匀分布这类输入上; - 对重复值多或偏斜的分布(Zipf、指数分布,以及论文的 EightDup、RootDup),基数排序实现通常较慢。
两边并不矛盾,差在比较的对象和假设上。ska_sort
和本文的对照组是 std::sort
这样的单线程快速排序;IPS⁴o
本身是一种分布式排序(samplesort),同样按桶分区,只是用无分支的决策树代替取位,每个元素的分类代价从常数变成
\(\Theta(\log
k)\),换来与键分布无关的桶大小。本文只测了单线程和四种简单分布,正落在论文所说基数排序占优的区间里,不能用来反驳它的结论。
争论:原地还是非原地
非原地的 LSD 简单、稳定、写流规则,本文实测在 \(10^7\) 个 32 位键上比原地的 ska_sort 快 2.2 倍;代价是 \(n\) 个元素的额外内存。DuckDB 从 2021 年的非原地 LSD 换到 2025 年的原地 MSD,接受了单线程约 30% 的退步,换回的是内存占用。Regions Sort 和 IPS²Ra 则试图在并行环境下同时拿到原地和高吞吐。哪一边更好,取决于内存是否紧张、线程数和数据是否超出内存,没有统一答案。
开放问题
- Word RAM 上能否线性时间排序整数。 已知最好的结果是 Han 与 Thorup(FOCS 2002)的期望 \(O(n\sqrt{\log\log n})\) 和 Han(STOC 2002)的确定性 \(O(n\log\log n)\);Andersson 等(JCSS 1998)只在字长 \(w \ge \log^{2+\varepsilon} n\) 时做到 \(O(n)\)。对所有字长都能线性时间排序是否可能,仍未解决。
- 怎样让基数排序对分布稳健。 IPS⁴o/IPS²Ra
的实验表明,基数排序在偏斜和重复值多的输入上会掉队;生产系统用”先探测已有顺序、再按分区大小回退到比较排序”的启发式来补救(ClickHouse
的
trySort()、DuckDB 的 vergesort 与 pdqsort 回退、Boost spreadsort 按最坏情况选择)。何时从取位切换到比较、切换阈值怎样随硬件变化,目前靠经验常数(ska_sort 的 128 和 1024、ClickHouse 的 64 和 256),还没有公认的代价模型。
十、工程选型与陷阱
| 场景或陷阱 | 后果 | 做法 |
|---|---|---|
| 大量定长整数或浮点键,分布接近随机,内存充足 | 比较排序每元素的代价随 \(\log n\) 增长 | LSD 8 到 11 位;本文 \(n =
10^7\) 时比 std::sort 快 7 倍 |
| 内存紧张或需要原地 | LSD 需要 \(n\) 个元素的辅助数组 | ska_sort 这类原地 MSD,接受约 2 倍的差距(本文实测) |
| 输入可能已经有序或接近有序 | 基数排序不利用已有顺序,ska_sort 在已排序输入上比
std::sort 慢一倍多 |
先做线性时间的有序性探测,参考 ClickHouse
trySort()、DuckDB vergesort |
| 位宽取得太大 | 写流超出 L1 与 TLB,\(r=16\) 比 \(r=8\) 慢 46%;小数组上 \(2^r\) 个计数器的开销压过有效工作 | \(r\) 取 8 到 11;小 \(n\) 回退到插入排序或比较排序 |
| 有符号整数直接按位排序 | 负数排到正数后面 | 符号位取反 |
| 浮点数直接按位排序 | 负数顺序颠倒 | 负数翻转全部位、非负数翻转符号位;结果是 totalOrder,NaN 的位置按符号位决定 |
以为浮点基数排序与 std::sort 结果一致 |
\(-0\) 与 \(+0\) 的相对位置、NaN 的位置不同 | 明确要的是 totalOrder 还是”NaN 放一侧”,后者要额外处理 |
| LSD 某一趟不稳定 | 结果错误 | 散布按输入顺序进行,写指针递增 |
| 元素很大(例如 64 字节以上的结构体) | 每趟搬运整个元素,带宽被浪费 | 对(键,下标)对排序后再重排,ClickHouse 就是这样生成行号排列的 |
| 多列、降序、字符串键 | 基数排序只认无符号位序 | 编码成可 memcmp
的规范化键;按语言规则比较的字符串排序规则要先转换成排序键 |
十一、参考资料
规范与文档
- IEEE Std 754-2008, IEEE Standard for Floating-Point Arithmetic, totalOrder 谓词。
- Boost.Sort 文档,Spreadsort 与
float_sort(Steven Ross 等),boost.org。 - DuckDB 博客:Laurens Kuiper, “Fastest Table Sort in the West – Redesigning DuckDB’s Sort”, 2021-08-27;Laurens Kuiper, “Redesigning DuckDB’s Sort, Again”, 2025-09-24。
源码
- ska_sort,
ska_sort.hpp,commit 2c14d4bf7b667032ed28a481065f721385e33849:detail::inplace_radix_sort、UnsignedInplaceSorter::american_flag_sort()、ska_byte_sort()、to_unsigned_or_bool()、ListInplaceSorter::sort_from_recursion()。 - ClickHouse
v26.9.2.8-stable:
src/Common/RadixSort.h(RadixSort、RadixSortFloatTransform、RadixSortSignedTransform、radixSortLSDInternal()、radixSortMSDInternal()、executeMSD());src/Columns/ColumnVector.cpp(getPermutation()、moveNanToRequestedSide());base/base/sort.h(trySort())。 - Rust
1.94.0,
library/core/src/num/f32.rs:f32::total_cmp。 - PostgreSQL
17.9,
src/backend/utils/sort/tuplesort.c:qsort_tuple_unsigned等sort_template.h实例。
核心论文
- P. M. McIlroy, K. Bostic, M. D. McIlroy, “Engineering Radix Sort”, Computing Systems 6(1):5–27, 1993.
- T. H. Cormen, C. E. Leiserson, R. L. Rivest, C. Stein, Introduction to Algorithms, 3rd ed., MIT Press, 2009, Chapter 8(定理 8.1、引理 8.3 与 8.4、章末注记)。
- M. Axtmann, S. Witt, D. Ferizovic, P. Sanders, “In-Place Parallel Super Scalar Samplesort (IPSSSSo)”, ESA 2017, LIPIcs 87, 9:1–9:14.
- M. Axtmann, S. Witt, D. Ferizovic, P. Sanders, “Engineering In-place (Shared-memory) Sorting Algorithms”, ACM Transactions on Parallel Computing 9(1), 2022(arXiv:2009.13569)。
- O. Obeya, E. Kahssay, E. Fan, J. Shun, “Theoretically-Efficient and Practical Parallel In-Place Radix Sorting”, SPAA 2019.
- J. Wassenberg, P. Sanders, “Engineering a Multi-core Radix Sort”, Euro-Par 2011, LNCS 6853, 160–169.
其他论文
- D. Kirkpatrick, S. Reisch, “Upper bounds for sorting integers on random access machines”, Theoretical Computer Science 28(3):263–276, 1983.
- A. Andersson, T. Hagerup, S. Nilsson, R. Raman, “Sorting in Linear Time?”, STOC 1995;Journal of Computer and System Sciences 57(1):74–93, 1998.
- Y. Han, “Deterministic sorting in \(O(n\log\log n)\) time and linear space”, STOC 2002.
- Y. Han, M. Thorup, “Integer sorting in \(O(n\sqrt{\log\log n})\) expected time and linear space”, FOCS 2002.
- O. Polychroniou, K. A. Ross, “A comprehensive study of main-memory partitioning and its application to large-scale comparison- and radix-sort”, SIGMOD 2014.
- N. Satish, M. Harris, M. Garland, “Designing efficient sorting algorithms for manycore GPUs”, IPDPS 2009.
- D. Merrill, A. Grimshaw, “High Performance and Scalable Radix Sorting: A Case Study of Implementing Dynamic Parallelism for GPU Computing”, Parallel Processing Letters 21(2), 2011.
- A. Adinets, D. Merrill, “Onesweep: A Faster Least Significant Digit Radix Sort for GPUs”, arXiv:2206.01784, 2022(预印本)。
- G. Graefe, “Implementing sorting in database systems”, ACM Computing Surveys 38(3), 2006.
工程资料
- Malte Skarupke, “I Wrote a Faster Sorting Algorithm”, probablydance.com, 2016-12-27.
实验
reproduce/radix.c、radix.h:LSD、American flag sort 与键变换;test_radix.c:正确性测试(含 ASan/UBSan 与浮点键的 \(2^{32}\) 穷举)。reproduce/cachesim.c:第五节的缓存与 TLB 模拟;bench.cpp:第一、五、七节的计时与比较次数;run_all.sh、plot_figures.py:一键运行与作图;results/:原始输出。
系列导航: - 上一篇:pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort - 下一篇:外部排序:从 I/O 下界到 PostgreSQL 与 GNU sort
相关阅读: - 并行排序:排序网络、并行归并、样本排序与 GPU 基数排序 - 排序基准测试:比较次数、分支预测与输入分布 - 缓存无关算法:让硬件替你优化
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
排序算法专题:从 TimSort 到并行排序
把 TimSort、pdqsort、radix sort、external sort、parallel sort 与 benchmark 串成一条阅读路径。先读哪篇、什么时候选哪种排序,这一页讲清。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
外部排序:从 I/O 下界到 PostgreSQL 与 GNU sort
从 Aggarwal–Vitter 的 I/O 下界出发,用可复现实验比较替换选择与快排生成 run、败者树与堆的比较次数、多阶段与平衡归并的搬运量,再对照 PostgreSQL 18 与 GNU sort 9.11 源码说明今天为何多用快排、平衡归并和堆。
并行排序:排序网络、并行归并、样本排序与 GPU 基数排序
用 work/span 计数解释并行排序为何难以线性加速:串行归并与串行划分把并行度压在个位数,并行归并、Merge Path 与样本排序各自如何突破;再对照 libstdc++、oneTBB、Rayon、CUB 源码看生产实现的真实选择。