关于 pdqsort(pattern-defeating
quicksort),常见的说法有三种:它是 Rust
sort_unstable
的实现;它用荷兰国旗式的三路分区处理重复元素;它在所有输入分布上都最快。三种说法都不准确。Rust
从 1.81 起已经把 sort_unstable 换成了
ipnsort,pdqsort 只覆盖 1.20 到 1.80。pdqsort
处理重复键用的是两个二路分区函数,靠”当前
pivot
是否等于前驱”来切换,不做逐元素的相等比较。至于”最快”,论文自己就写明
TimSort 在带长 run
的输入上领先;本文实测中,先升后降和两段有序拼接的输入上,libstdc++
的 std::stable_sort 比 pdqsort 快 2
倍以上。
pdqsort 真正做的是在 introsort(快排 + 堆排序兜底 +
小数组插入排序)的骨架上改了四处启发式:用坏分区计数代替递归深度限制;前驱与
pivot 相等时改用
partition_left,把重复键的代价压到 \(O(nk)\);分区没有发生交换时试一次有限步插入排序,让有序输入变成线性;以及来自
BlockQuicksort
的块分区,消除分区中的分支预测失败。下文逐一对照参考实现
orlp/pdqsort
的 commit b1ef26a(2021-03-14)和 Peters
的论文(arXiv:2106.05123,预印本,未经同行评审),全部比较次数与计数器来自同目录的
reproduce/(第七节)。
一、从 introsort 到 pdqsort
introsort 的三件套
Hoare(The Computer Journal, 1962)的快速排序平均 \(O(n \log n)\),但 pivot 每次都选到极值时退化成 \(\Theta(n^2)\)。Musser 在 1997 年的 Software: Practice and Experience 论文中提出 introsort:照常做快排,同时记录递归深度,超过一个与 \(\log n\) 成正比的上限(常用 \(2\lfloor \log_2 n \rfloor\))就对当前子数组改用堆排序,从而保证 \(O(n \log n)\) 最坏复杂度。小数组交给插入排序。
libstdc++ 的 std::sort
至今仍是这个结构。以本文使用的 GCC 16.1.1
为例,bits/stl_algo.h 中
__introsort_loop 的深度上限是
std::__lg(__last - __first) * 2,长度不超过
_S_threshold = 16 的区间先留着不排,最后由
__final_insertion_sort 统一做一遍插入排序。
introsort 只解决了”最坏情况别太坏”,对输入模式没有感知:已经有序的数组照样做 \(\Theta(n \log n)\) 次比较;大量重复键时只能靠二路分区把相等元素均匀分到两边;深度计数器只看层数,不看某一层分得好不好。
pdqsort 改了哪四处
| 机制 | libstdc++ introsort | pdqsort(orlp, b1ef26a) | 针对的输入 |
|---|---|---|---|
| 回退到堆排序的条件 | 递归深度超过 \(2\lfloor\log_2 n\rfloor\) | 同一条递归路径上出现 \(\lfloor\log_2 n\rfloor\) 次坏分区(一侧不足 \(1/8\)) | 对抗输入、自相似模式 |
| 分区后发现分得很差 | 无动作 | 交换几个固定位置的元素,给下一次选 pivot 换一批候选 | 先升后降等规则模式 |
| 重复键 | 二路分区,相等元素分散两侧 | pivot 等于前驱时改用
partition_left,相等元素一次归位 |
少量不同值 |
| 分区没有发生交换 | 无动作 | 两侧各试一次最多移动 8 个元素的插入排序 | 升序、降序、末尾追加少量元素 |
| 分区内循环 | 按比较结果分支 | 算术类型 + std::less 时用 BlockQuicksort
块分区 |
随机数据上的分支预测失败 |
| 小数组 | 长度 \(\le 16\) 留到最后统一插入排序 | 长度 \(< 24\) 立即插入排序,非最左区间用无哨兵检查版本 | — |
主循环的完整决策路径如下图:

图中虚线是两条”回到循环开头”的路径:partition_left
之后直接 continue,处理剩下的大于 pivot
的部分;正常分区之后递归左半、在循环里处理右半。bad_allowed
按值传进每次递归,所以它是每条递归路径各自的预算,不是全局计数(论文第
4.1 节脚注 5)。
谱系
%%{init: {'theme': 'dark'}}%%
flowchart LR
    H["Hoare 1962<br/>quicksort"] --> M["Musser 1997<br/>introsort"]
    BM["Bentley and McIlroy 1993<br/>ninther pivot"] --> P
    KS["Kaligosi and Sanders 2006<br/>branch mispredictions"] --> BQ["Edelkamp and Weiss 2016<br/>BlockQuicksort"]
    HH["Hinnant, libc++ std::sort<br/>swapless partition check"] --> P
    M --> P["pdqsort<br/>code 2015, preprint 2021"]
    BQ --> P
    P --> R["Rust sort_unstable<br/>1.20 to 1.80"]
    P --> B["Boost.Sort 1.67+"]
    P --> G["Go sort 1.19+"]
    P --> L["libc++ std::sort 16+"]
    R --> I["ipnsort<br/>Rust 1.81+"]
pdqsort 的代码比论文早得多:orlp/pdqsort 仓库的首个提交是
2015-02-22,Rust 在 2017 年、Boost 在 2018
年就已经收录,论文到 2021 年 6 月才以预印本形式发布。论文第
2 节逐项交代了来源:pivot 用 median-of-3 加 Tukey 的
ninther(Bentley 与 McIlroy 在 1993 年的 “Engineering a Sort
Function” 中推广了它),块分区来自 Edelkamp 与
Weiß,无交换分区后做插入排序的技巧来自 Howard Hinnant 写的
libc++
std::sort。论文声称的新东西只有两项:坏分区计数(含模式破坏),以及重复键的处理方式。
二、主循环与 pivot 选择
主循环
下面是 reproduce/pdq.c
中的主循环。它是参考实现 pdqsort.h 中
pdqsort_loop 的 C 移植(int
键,分支版分区),第七节验证了它在全部测试输入上与参考实现的比较次数逐次相同。摘录删去了统计计数与模式破坏的具体交换:
/* reproduce/pdq.c,pdq_loop(),有删减 */
static void pdq_loop(int *begin, int *end, int bad_allowed, bool leftmost)
{
    for (;;) {
        ptrdiff_t size = end - begin;
        if (size < INSERTION_SORT_THRESHOLD) {          /* 24 */
            if (leftmost) insertion_sort(begin, end);
            else unguarded_insertion_sort(begin, end);
            return;
        }

        ptrdiff_t s2 = size / 2;
        if (size > NINTHER_THRESHOLD) {                 /* 128 */
            sort3(begin, begin + s2, end - 1);
            sort3(begin + 1, begin + (s2 - 1), end - 2);
            sort3(begin + 2, begin + (s2 + 1), end - 3);
            sort3(begin + (s2 - 1), begin + s2, begin + (s2 + 1));
            swap(begin, begin + s2);
        } else {
            sort3(begin + s2, begin, end - 1);
        }

        if (!leftmost && !lt(begin[-1], *begin)) {
            begin = partition_left(begin, end) + 1;
            continue;
        }

        bool already_partitioned;
        int *pivot_pos = partition_right(begin, end, &already_partitioned);
        ptrdiff_t l_size = pivot_pos - begin;
        ptrdiff_t r_size = end - (pivot_pos + 1);
        bool highly_unbalanced = l_size < size / 8 || r_size < size / 8;

        if (highly_unbalanced) {
            if (--bad_allowed == 0) {
                heap_sort(begin, end);
                return;
            }
            /* 交换 25% / 75% 附近的元素,见第三节 */
        } else if (already_partitioned
                   && partial_insertion_sort(begin, pivot_pos)
                   && partial_insertion_sort(pivot_pos + 1, end)) {
            return;
        }

        pdq_loop(begin, pivot_pos, bad_allowed, leftmost);
        begin = pivot_pos + 1;
        leftmost = false;
    }
}
入口 pdq_sort() 以 bad_allowed
\(= \lfloor \log_2 n
\rfloor\)、leftmost = true
调用它。参考实现总是递归左半、循环右半,而不是”递归较短的一侧”。栈深度仍是
\(O(\log
n)\):平衡分区让左半至多剩 \(7/8\),坏分区在一条路径上至多出现
\(\lfloor\log_2 n\rfloor\)
次,所以深度不超过 \(\log_{8/7} n
+ \log_2 n\)。实测 \(n =
10^6\) 时最大递归深度是 20(随机输入)到
27(先升后降)。Rust 和 Go
的移植改成了先递归较短的一侧。
leftmost
标记当前区间左边是否还有元素。不是最左区间时,begin[-1]
是某个祖先分区的 pivot,它不大于区间内任何元素(论文 Lemma
1),可以充当插入排序的哨兵,省掉内层循环的越界检查(论文第
5.1 节称其为 unguarded insertion sort,作者基准中带来 5% 到
15% 的提升)。它同时是第四节重复键检测的依据。
median-of-3 与 ninther
长度不超过 128
时,sort3(begin + s2, begin, end - 1)
把首、中、尾三个元素排好序,中位数落在
begin。长度超过 128 时做 ninther:
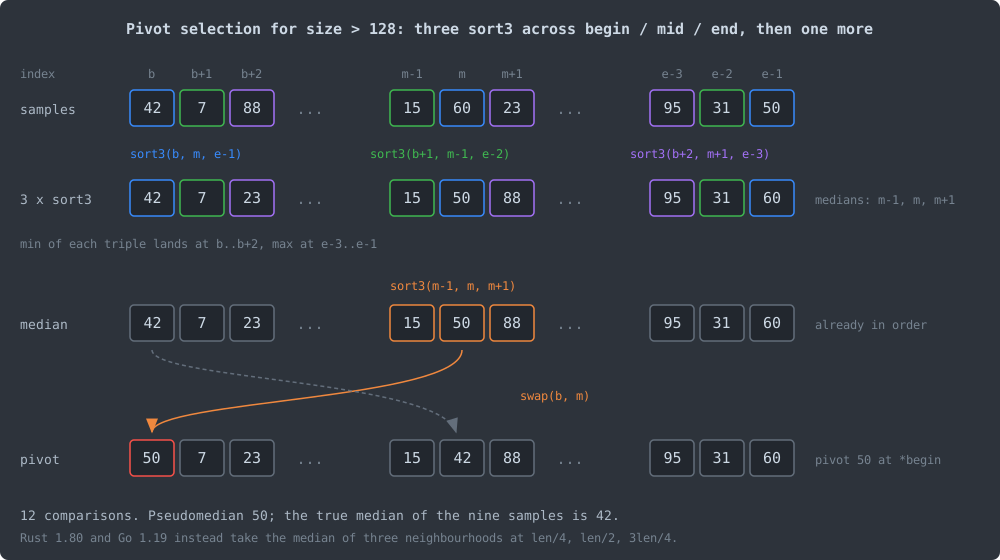
图中的数值是按这段代码逐步执行的结果:
- 前三次
sort3各取一个”开头、中间、结尾”的三元组,不是教科书里”三组相邻元素各取中位数”。每组的中位数落在中间区域的m、m-1、m+1,最小值留在开头,最大值留在结尾。 - 第四次
sort3取三个中位数的中位数,再换到begin。共 \(4 \times 3 = 12\) 次比较。 - 结果是伪中位数:这里选出了 50,九个样本的真中位数是 42。
- 副作用是分区的哨兵:
end - 1上一定是不小于 pivot 的元素,所以partition_right第一轮向右扫描可以不检查边界。
Rust 1.80 和 Go 1.19 的选法不同:在
len/4、len/2、3len/4
三处各取相邻三个元素的中位数(长度 \(\ge 50\)
时),再取三者中位数,并且数一数 sort2
发生了几次交换。12
次全交换说明这段数据很可能是降序,直接整体反转。这个技巧 Go
源码注释写明来自 Rust。
partition_right 与”已经分好”的信号
/* reproduce/pdq.c,与 pdqsort.h 的 partition_right 逻辑相同 */
static int *partition_right(int *begin, int *end, bool *already)
{
    int pivot = *begin;
    int *first = begin, *last = end;

    while (lt(*++first, pivot));
    if (first - 1 == begin)
        while (first < last && !lt(*--last, pivot));
    else
        while (!lt(*--last, pivot));

    *already = first >= last;
    while (first < last) {
        swap(first, last);
        while (lt(*++first, pivot));
        while (!lt(*--last, pivot));
    }

    int *pivot_pos = first - 1;
    *begin = *pivot_pos;
    *pivot_pos = pivot;
    return pivot_pos;
}
这是 Hoare 式的相向指针分区:first
找第一个不小于 pivot 的元素,last 找第一个小于
pivot 的元素,交换后继续。等于 pivot
的元素归右侧。几处细节决定了正确性:
- 只用
<。“不小于”写成!lt(x, pivot),整个分区只依赖严格弱序(strict weak ordering)。 - 第一次向右扫描不查边界,依赖上一节的哨兵;向左扫描只有在
first一步没动时才需要查边界,因为此后已交换过的元素会挡住指针。 already = first >= last在第一次交换之前就能算出:如果第一对”站错边”的元素根本不存在,这段数据已经按 pivot 分好了。这一次指针比较就是第五节乐观插入排序的触发信号。
三、坏分区计数与模式破坏
为什么阈值是 1/8
pdqsort 把一侧元素少于 \(\text{size}/8\) 的分区称为坏分区(bad partition)。选 \(1/8\) 的理由在论文第 4.1 节。设每次分区都把比例 \(p\) 的元素分到一侧,代价满足
\[ T(n, p) = n + T(pn, p) + T\big((1-p)n, p\big). \]
由 Akra–Bazzi 定理,对任意固定的 \(p \in (0, 1)\) 都有 \(T(n,p) = \Theta(n \log n)\)。论文引用 Yuval Filmus 的解,给出相对于完美对半分的放慢倍数
\[ \lim_{n \to \infty} \frac{T(n, p)}{T(n, \tfrac12)} = \frac{1}{H(p)}, \qquad H(p) = -p\log_2 p - (1-p)\log_2(1-p). \]
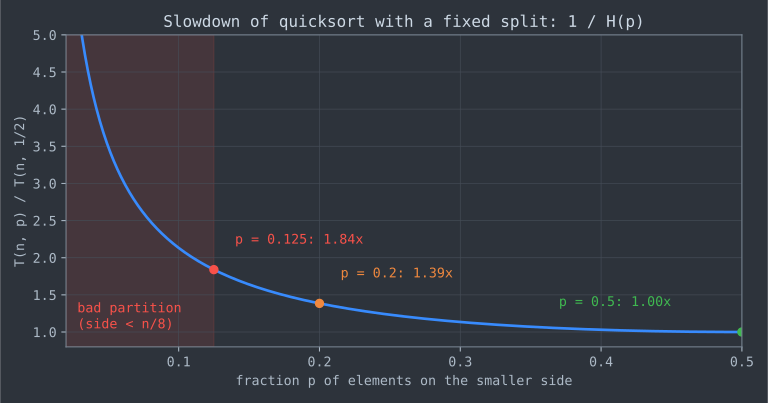
曲线说明两件事:
- 分割不必很准。一直按 80/20 分也只慢 39%,所以 pivot 从”好”改进到”很好”收益很小;从”一般”跌到”很差”代价却陡增(论文第 4.2 节)。
- \(p = 1/8\) 时 \(1/H(p) \approx 1.84\)。作者在自己的基准中观察到堆排序在随机数据上大约比快排慢一倍,于是把”坏分区”定义为”大致比改用堆排序还差”。\(1/8\) 还可以用一次移位算出。
“堆排序慢一倍”是作者机器上的经验值。在本文的机器上(第七节),对
\(10^6\) 个随机
int,堆排序比 libstdc++ std::sort
只慢 17%,比开启块分区的 pdqsort 慢 3.4
倍。阈值背后的这条假设依赖硬件和实现。
预算与复杂度上界
预算 bad_allowed 初值为 \(\lfloor \log_2 n
\rfloor\),每遇到一次坏分区减一,减到 0
就对当前子数组做堆排序。论文的证明分两部分:
- 坏分区:每条递归路径最多 \(\log n\) 层含坏分区,每层总工作量 \(O(n)\),合计 \(O(n \log n)\)(Lemma 5)。
- 好分区:最差的好分区也是固定比例 \(1/8\),由上面的递推式得 \(O(n \log n)\)(Lemma 6)。
两者加上堆排序本身的 \(O(n \log n)\),得到 pdqsort 的最坏复杂度 \(O(n \log n)\)(Theorem 2)。
与 introsort 的深度限制相比,论文的论据是:带模式的输入常常开头几次分得很差,几轮之后模式被打散;深度计数把这段”坏开头”算进层数里,容易过早退化成堆排序,而坏分区计数只在分区确实失衡时才扣预算。第七节的计数器给出一个量级参照:对 \(10^6\) 个随机排列,pdqsort 一共做了 68,604 次分区,其中 3,667 次是坏分区,没有一次用完预算。
模式破坏
遇到坏分区后,pdqsort 在两侧各交换几对元素,给下一轮的 pivot 选择换一批候选(论文第 4.2 节):
/* reproduce/pdq.c,pdq_loop() 中坏分区分支的左侧部分;右侧对称 */
if (l_size >= INSERTION_SORT_THRESHOLD) {
    swap(begin, begin + l_size / 4);
    swap(pivot_pos - 1, pivot_pos - l_size / 4);
    if (l_size > NINTHER_THRESHOLD) {
        swap(begin + 1, begin + (l_size / 4 + 1));
        swap(begin + 2, begin + (l_size / 4 + 2));
        swap(pivot_pos - 2, pivot_pos - (l_size / 4 + 1));
        swap(pivot_pos - 3, pivot_pos - (l_size / 4 + 2));
    }
}
被换走的正是下一轮 median-of-3 或 ninther
会读的首尾位置,换进来的是 25% 和 75%
分位附近的元素。整个过程是确定性的。论文的理由是随机化有三个代价:结果不可复现、访问模式不可预测、会破坏有益的模式(例如降序输入的线性行为)。论文也写明,如果需要随机快排那样的抗
DoS
保证,可以把候选换成随机位置,但仍应只在坏分区之后才换。Rust
1.80 和 Go 1.19 的 break_patterns 用 Marsaglia
的 xorshift
生成三个位置,种子是切片长度,所以同样是确定性的;Rust 1.80
的文档称之为 “some randomization … but with a fixed
seed”。
四、重复键:前驱相等时改用 partition_left
两个分区函数
pdqsort 有两个二路分区函数:partition_right
把等于 pivot 的元素放右侧,partition_left
把等于 pivot 的元素放左侧。两者都只用
<。规则只有一条:
如果当前区间有前驱(不是最左区间),并且选出的 pivot 不大于前驱,即
!(begin[-1] < pivot),就调用partition_left,并且不再处理左半;否则调用partition_right。
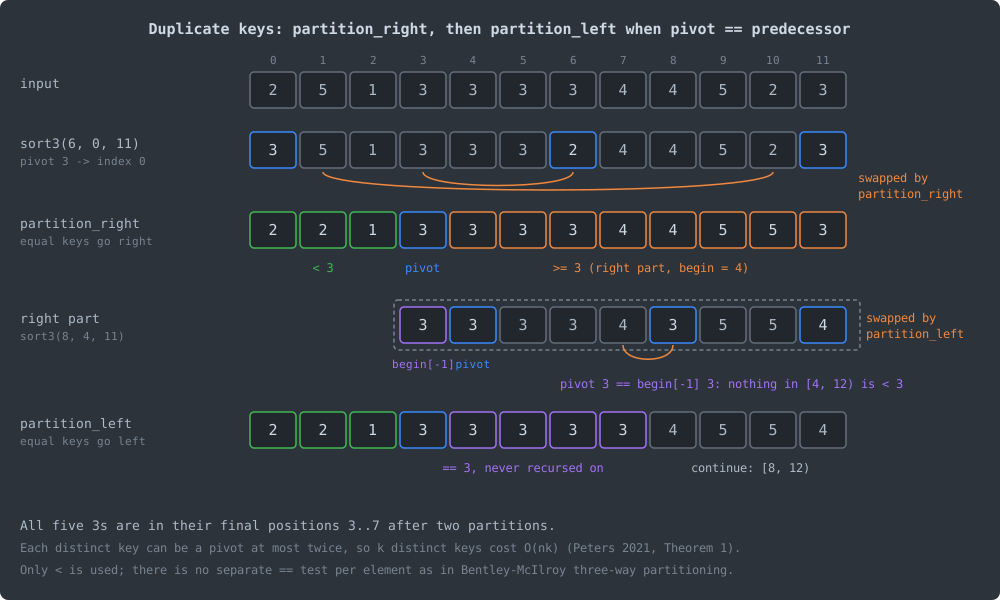
图中每一行都是按 pdq.c
的逻辑逐步执行的真实状态(为了画得下,忽略了长度小于 24
就插入排序的阈值):
- 第一轮
sort3(6, 0, 11)选出 pivot 3。partition_right把小于 3 的 2、2、1 放左边,所有等于 3 的元素都进了右半。 - 右半从下标 4 开始,前驱
begin[-1]就是刚才的 pivot 3。右半所有元素都 \(\ge 3\),所以右半里没有比前驱小的元素。 - 右半选出的 pivot 恰好也是 3,与前驱相等。这时
partition_left把”\(\le 3\)“的元素放左边,而右半里 \(\le 3\) 就等价于 \(= 3\)。左半因此全是 3,已经就位,不需要递归。 - 循环从下标 8 继续,只剩 4、5、5、4。
为什么是 O(nk)
论文第 3.1 节证明了这个过程的上界:
- 前驱一定是某个祖先分区的 pivot(Lemma 1)。
- 值 \(v\)
第一次被选为 pivot
时不可能等于前驱,因为此前没有等于 \(v\) 的 pivot,所以走
partition_right,所有等于 \(v\) 的元素都进入紧挨 \(v\) 的右侧区间(Corollary 1、Lemma 3)。 - 第二次选到等于 \(v\) 的 pivot 时,前驱必然就是
\(v\),走
partition_left,所有等于 \(v\) 的元素一次归位(Lemma 4)。
每个不同的值至多当两次 pivot,每次分区 \(O(n)\),所以有 \(k\) 个不同值时最坏 \(O(nk)\)(Theorem 1)。这是上界,\(k\) 很大时 \(O(n \log n)\) 仍然成立。
与三路分区的区别
Dijkstra 的荷兰国旗问题把数组分成小于、等于、大于三段。Bentley 与 McIlroy 的实现把相等元素先换到两端,分区结束后再换回中间;这要求每个元素额外做一次相等判断,无论输入里有没有重复键都要付这份代价(论文第 3 节)。pdqsort 的做法是平时只做普通的二路分区,只有在”pivot 等于前驱”这个 \(O(1)\) 的检查成立时才切换,相当于把三路分区摊到了两次二路分区上。论文摘要称其为”不需要三路比较的荷兰国旗问题新解”。
实测(第七节):\(10^6\)
个元素只有 1,000 个不同值时,partition_left
恰好被调用 1,000 次,比较次数是 libstdc++
std::sort 的 58%;只有 8 个不同值时调用 8
次,是 26%;全部相同时只调用 1 次,一共约 \(2n\) 次比较。
五、有序输入:无交换分区后的乐观插入排序
如果一次分区既平衡、又没有发生任何交换,pdqsort
就猜这段数据可能已经有序,对左右两侧各跑一次
partial_insertion_sort:
/* reproduce/pdq.c,与 pdqsort.h 的 partial_insertion_sort 逻辑相同 */
static bool partial_insertion_sort(int *begin, int *end)
{
    if (begin == end) return true;
    size_t moves = 0;
    for (int *cur = begin + 1; cur != end; ++cur) {
        int *sift = cur, *sift_1 = cur - 1;
        if (lt(*sift, *sift_1)) {
            int tmp = *sift;
            do { *sift-- = *sift_1; } while (sift != begin && lt(tmp, *--sift_1));
            *sift = tmp;
            moves += (size_t)(cur - sift);
        }
        if (moves > PARTIAL_INSERTION_SORT_LIMIT) return false;   /* 8 */
    }
    return true;
}
累计移动超过 8
个位置就放弃,已经做的移动不会撤销,不影响正确性,接着照常递归。两侧都成功就直接返回。论文第
5.2 节说明这个技巧来自 Howard Hinnant 的 libc++
std::sort,并指出三点:
- 只要 pivot 选法正确,它能让升序、降序、“升序末尾追加一个任意元素”三种输入在线性时间内排完。
- 误判的代价每次分区至多约 \(n\) 次操作;它只在分区平衡时触发,攻击者想反复触发它就得先让快排取得正常进展,而把 pdqsort 逼进堆排序本来就能让代价翻倍。
- 这套机制很脆弱(论文脚注 7):pivot 候选先被排序、中位数放到开头、无交换时再换回中间,偏离参考实现的一个小细节就可能丢掉线性保证。
实测中,升序输入只做了 1 次分区和 1 次成功的乐观插入排序,共约 \(2n\) 次比较;降序输入做了 3 次分区,第一次把整段大致翻转,之后两侧的乐观插入排序都成功,共约 \(3n\) 次比较。
它的边界同样清楚:只有整段有序时才有效。先升后降(organ)、两段升序拼接(merge)这类”由几段 run 组成”的输入,第一次分区就会发生交换,于是退回普通快排。论文第 6.2 节写明,pdqsort 能”击退”这些模式、不被它们拖慢,却不能像 TimSort 那样利用 run。
六、块分区:把分支变成数据
分支预测失败
Kaligosi 与 Sanders(ESA 2006)分析了快排的分支预测失败:pivot 越接近中位数,“元素是否小于 pivot”这个分支越接近抛硬币,随机 pivot 的快排平均产生 \(c \cdot n\log n + O(n)\) 次失败,常数 \(c\) 视预测器类型在 0.34 到 0.46 之间(据 Edelkamp 与 Weiß 论文引言的转述)。他们还观察到,故意选偏的 pivot 反而更快,因为分支变得可预测,并把”比偏斜 pivot 快排更快的原地排序”列为开放问题。
Edelkamp 与 Weiß 的 BlockQuicksort(ESA 2016;期刊版见
ACM JEA 24,
2019)回答了这个问题:把比较结果存进缓冲区,再按缓冲区交换,让控制流不再依赖数据。按其
arXiv 版摘要,在随机整数上比 GCC 的 std::sort
快 80%,对静态分支预测器平均至多 \(\varepsilon n\log n + O(n)\)
次分支预测失败。
两遍:先记下标,再成对交换
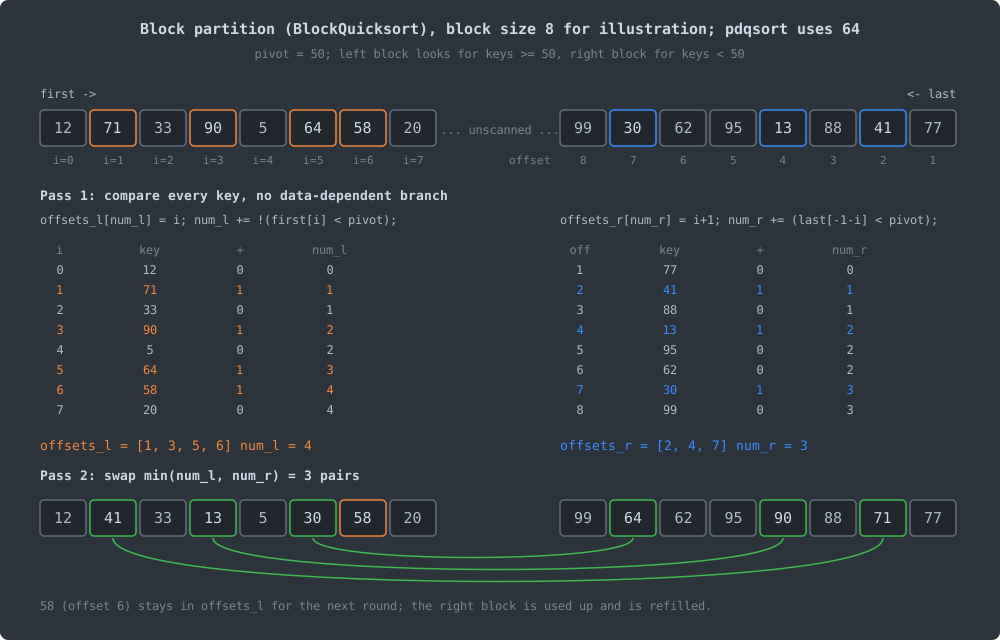
第一遍的关键是图中那行代码:每个元素都无条件写一次缓冲区,比较结果只决定计数器加 0 还是加 1。编译器可以把它编成不含条件跳转的指令序列,下面是参考实现中左块的填充循环:
// orlp/pdqsort b1ef26a, pdqsort.h, partition_right_branchless(),有删减
if (left_split >= block_size) {
    for (size_t i = 0; i < block_size;) {
        offsets_l[num_l] = i++; num_l += !comp(*first, pivot); ++first;
        offsets_l[num_l] = i++; num_l += !comp(*first, pivot); ++first;
        // ... 共展开 8 次
    }
}
第二遍按两个缓冲区中较少的那个数量成对交换,剩下的留到下一轮。实现上有两处与论文示意代码不同:
- 两边数量不等时,
swap_offsets用循环置换代替成对交换,每个元素只需两次移动而不是三次。数量相等时才逐对iter_swap,源码注释说这是为了让降序输入保持 \(O(n)\)。 - 块大小是 64,偏移用
unsigned char存,缓冲区按 64 字节缓存行对齐。论文脚注 9 说最优块大小取决于 CPU、缓存和数据类型;BlockQuicksort 论文和 Rust 1.80 都用 128。
只在比较本身无分支时才开
块分区只省掉”根据比较结果跳转”的分支。如果比较函数本身有分支(字符串、多字段结构体),收益就没了,还多了缓冲区读写。参考实现因此很保守:只有比较器是
std::less 或
std::greater、且元素是算术类型时,pdqsort()
才选块分区;其他情况要显式调用
pdqsort_branchless()。partition_left
从不使用块分区,因为它很少被调用,而且调用时已经是 \(O(n)\) 的情况(论文第 5.3
节)。
块分区也不是总赢。论文第 6.2 节提到,在 merge 这类分支预测器几乎总能猜对的输入上,传统分区明显更快。本文实测复现了这一点(第七节):organ 和 merge 输入上,块分区比分支版慢约 20%。
七、实测:比较次数、计数器与耗时
环境与口径
- 程序:
reproduce/bench.cpp调用参考实现pdqsort.h(fetch_pdqsort.sh按 commit b1ef26a 下载并校验 SHA-256)、libstdc++ 的std::sort/std::stable_sort/std::make_heap+std::sort_heap,以及reproduce/pdq.c的 C 移植。 - 环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,GCC
16.1.1(libstdc++ 同版本),
-O2。 - 输入:\(n = 10^6\) 个
int,分布沿用论文第 6.1 节。uniform 为打乱的 \(0..n-1\);asc、desc 为升序、降序;organ 为先升后降;merge 为两段升序拼接;sort90 为前 90% 已升序;dupsq、mod8、ones 分别只有 \(\lfloor\sqrt n\rfloor = 1000\)、8、1 个不同值。打乱用固定种子的 xorshift,与标准库实现无关。 - 对抗输入:按 McIlroy(SP&E
1999)的方法生成。排序过程中比较结果按需”冻结”,每次都让当前
pivot
候选尽量小,最后得到一个对该实现最坏的具体输入。killer_std
针对
std::sort,killer_pdq 针对 pdqsort。 - 比较次数用计数比较器统计,与时钟无关,连续三次运行输出逐字节一致。带计数的比较器不是
std::less,所以 pdqsort 在这一栏走的是分支版分区。最后一列核对 C 移植与参考实现的比较次数是否完全相同。
cd reproduce
sh fetch_pdqsort.sh
gcc -O2 -Wall -Wextra -o test_pdq test_pdq.c pdq.c && ./test_pdq
gcc -O2 -Wall -Wextra -c pdq.c
g++ -std=c++17 -O2 -Wall -Wextra -o bench bench.cpp pdq.o
./bench count 1000000
taskset -c 8 ./bench time 1000000 15
test_pdq 在 9 种输入模式、0 到 100,000
的长度上与 qsort 对拍(16,317 组),并在
-fsanitize=address,undefined 下同样通过。
比较次数
表中数值为比较次数除以 \(n\log_2 n\)(\(n = 10^6\) 时 \(\log_2 n \approx 19.93\)):
| 输入 | std::sort |
pdqsort | std::stable_sort |
堆排序 | C 移植与参考实现一致 |
|---|---|---|---|---|---|
| uniform | 1.186 | 1.111 | 0.995 | 1.018 | 是 |
| asc | 1.285 | 0.100 | 0.553 | 1.024 | 是 |
| desc | 0.910 | 0.151 | 0.466 | 1.041 | 是 |
| organ | 2.715 | 1.598 | 0.534 | 1.028 | 是 |
| merge | 2.657 | 1.611 | 0.578 | 1.024 | 是 |
| sort90 | 1.227 | 1.114 | 0.599 | 1.023 | 是 |
| dupsq | 1.008 | 0.585 | 0.994 | 1.018 | 是 |
| mod8 | 0.928 | 0.238 | 0.952 | 1.007 | 是 |
| ones | 0.865 | 0.100 | 0.553 | 0.976 | 是 |
| killer_std | 2.998 | 1.165 | 0.667 | 1.040 | 是 |
| killer_pdq | 1.683 | 1.994 | 0.680 | 1.039 | 是 |
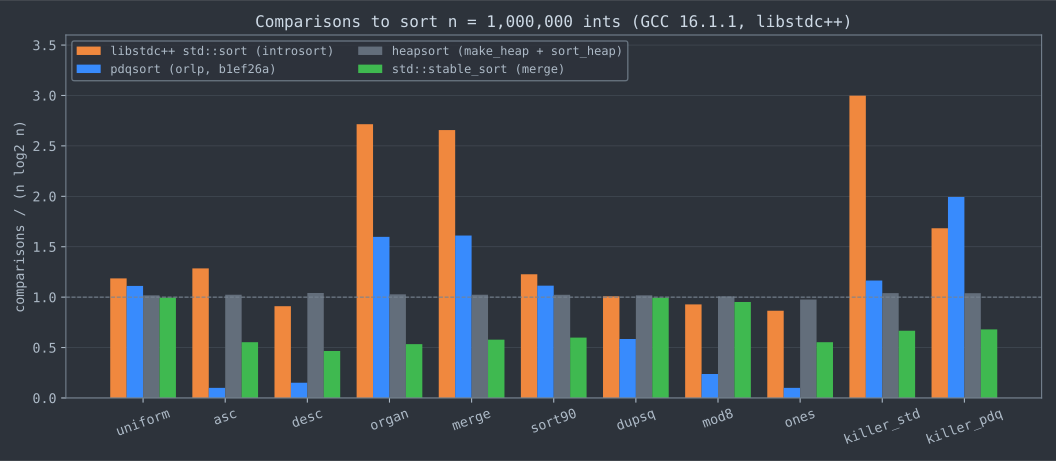
C 移植的计数器解释了这些数字(./bench count
输出的第二张表,节选):
| 输入 | 分区次数 | partition_left |
坏分区 | 乐观插入排序成功 | 堆排序(元素数) | 最大递归深度 |
|---|---|---|---|---|---|---|
| uniform | 68,604 | 0 | 3,667 | 0 | 0 | 20 |
| asc | 1 | 0 | 0 | 1 | 0 | 1 |
| desc | 3 | 0 | 0 | 2 | 0 | 2 |
| organ | 76,987 | 0 | 17,525 | 0 | 0 | 27 |
| sort90 | 70,103 | 0 | 7,090 | 86 | 0 | 24 |
| dupsq | 1,000 | 1,000 | 190 | 0 | 0 | 11 |
| mod8 | 8 | 8 | 1 | 0 | 0 | 4 |
| ones | 1 | 1 | 1 | 0 | 0 | 2 |
| killer_pdq | 19 | 0 | 19 | 0 | 1(999,896) | 2 |
几点观察:
- 有序和全等输入是线性的。 asc、ones 约
\(2n\) 次比较,desc 约
\(3n\),对应第四、五节描述的路径;
std::sort在这些输入上都要 \(0.87\) 到 \(1.29\, n\log_2 n\)。 - organ 和 merge 被”击退”但没被利用。
pdqsort 把 introsort 的 \(2.7\,
n\log_2 n\) 降到 \(1.6\),但仍是 \(\Theta(n\log n)\)
量级;
std::stable_sort是归并排序(libstdc++ 先按 7 个一组做插入排序再逐层合并),合并两段有序数据很便宜,只要 \(0.53\) 到 \(0.58\)。organ 上有 23% 的分区是坏分区,模式破坏在持续起作用,但没有一次用完预算。 - 对抗输入对两者都有效,只是代价被堆排序封顶。
killer_std 把
std::sort推到 \(3.0\, n\log_2 n\)。killer_pdq 让 pdqsort 连续 19 次(\(= \lfloor\log_2 10^6\rfloor\))坏分区,每次几乎只剥掉几个元素,最后对 999,896 个元素做堆排序,总比较次数约为单独堆排序的 1.9 倍,与论文第 5.2 节”最多让性能减半”的说法一致。两份对抗输入互不通用:pdqsort 排 killer_std 只要 \(1.17\),std::sort排 killer_pdq 是 \(1.68\)。 - 比较次数不等于时间。 随机输入上堆排序和
std::stable_sort的比较次数都比两种快排少,下面的计时却显示它们更慢;块分区版与分支版 pdqsort 执行同一套启发式,耗时却差了近 3 倍。
耗时
计时绑定在单个核心上(taskset -c 8),每项取
15
次的中位数,单位毫秒。机器上同时运行着其他负载,绝对值会有波动,只看相对趋势。其中
“pdqsort 块分区” 是
pdqsort(v.begin(), v.end())(std::less
+ int,自动选块分区),“pdqsort 分支版”
用一个等价的 lambda 比较器强制走
partition_right。
| 输入 | std::sort |
pdqsort 块分区 | pdqsort 分支版 | std::stable_sort |
堆排序 |
|---|---|---|---|---|---|
| uniform | 55.39 | 19.31 | 57.04 | 62.31 | 64.71 |
| asc | 5.73 | 0.36 | 0.42 | 5.64 | 28.95 |
| desc | 4.05 | 0.90 | 0.60 | 8.01 | 31.44 |
| organ | 31.03 | 20.01 | 16.79 | 6.87 | 32.73 |
| merge | 29.85 | 20.06 | 16.69 | 5.70 | 32.85 |
| sort90 | 22.83 | 16.97 | 22.42 | 11.39 | 35.56 |
| dupsq | 29.79 | 6.83 | 27.94 | 41.24 | 49.03 |
| mod8 | 12.74 | 3.08 | 7.93 | 20.28 | 29.68 |
| ones | 4.25 | 0.45 | 0.47 | 5.33 | 37.16 |
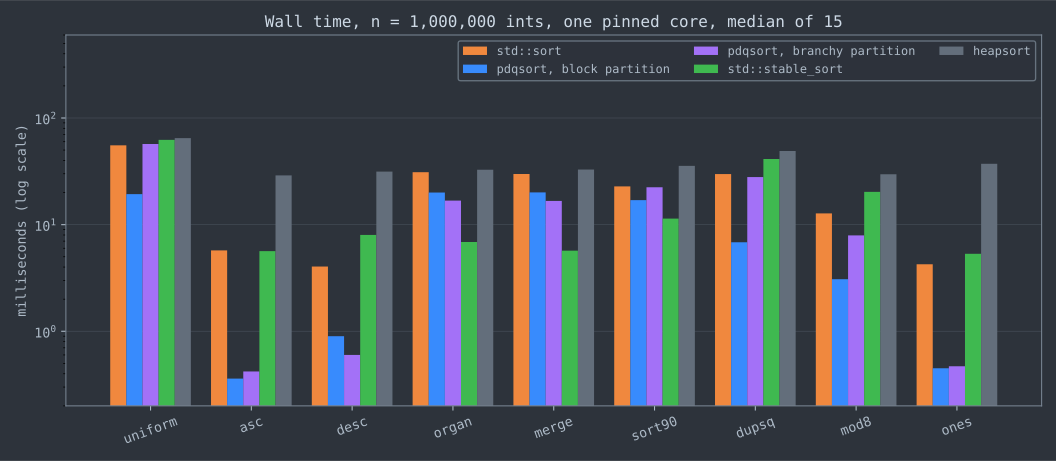
- 随机输入上,块分区版比
std::sort快约 2.9 倍。分支版反而比std::sort慢 3%,论文第 6.2 节报告的同类回退约 4.5%。pdqsort 的启发式本身不带来随机输入上的加速,加速几乎全部来自块分区。 - 重复键输入(dupsq、mod8)上,块分区与
partition_left叠加,比std::sort快 4 倍以上。 - organ 和 merge 上块分区比分支版慢约
20%,与论文的观察一致;这两种输入上最快的是
std::stable_sort,代价是 \(O(n)\) 的额外缓冲区。 - 堆排序在随机输入上比
std::sort慢 17%,远没有到论文说的”慢一倍”。第三节说过,这是 1/8 阈值背后的经验假设,换一台机器、换一种元素类型,结论就可能不同。
本文没有测 TimSort。它与 pdqsort 在同一组分布上的对比见论文附录 A,TimSort 的机制见本系列上一篇。
八、生产实现:Boost、Rust、Go、libc++
| 实现 | 版本 | 插入排序阈值 | pivot | 回退条件 | 模式破坏 | 块分区 | 降序处理 |
|---|---|---|---|---|---|---|---|
| orlp/pdqsort | b1ef26a | \(< 24\) | 首中尾;\(>128\) 用上文的 ninther | \(\lfloor\log_2 n\rfloor\) 次坏分区 | 固定位置交换 | 64,仅算术类型 +
std::less/std::greater |
乐观插入排序 |
Boost.Sort boost::sort::pdqsort |
1.67 起 | 24 | 同上 | 同上 | 同上 | 同上 | 同上 |
Rust slice::sort_unstable |
1.20 至 1.80 | \(\le 20\) | len/4、len/2、3len/4
邻域;\(\ge 50\) 用
ninther |
\(\lfloor\log_2 n\rfloor + 1\) 次 | xorshift,种子为长度 | 128,所有类型 | 12 次交换即整体反转 |
Go sort.Sort、sort.Slice |
1.19 起 | \(\le 12\) | 同 Rust | bits.Len(n) 次,即 \(\lfloor\log_2 n\rfloor +
1\) |
xorshift,种子为长度 | 不使用 | 同 Rust |
libc++ std::sort |
LLVM 16 起 | \(< 24\) | 与 orlp 相同 | 递归深度 \(2\lfloor\log_2 n\rfloor\) | 无 | 64 位 bitset,仅算术类型 + 简单比较器 | 乐观插入排序 |
几点说明,均以对应版本源码为准:
- Boost.Sort:
boost/sort/pdqsort/pdqsort.hpp在 tag boost-1.67.0 首次出现(1.66.0 中不存在),由 Orson Peters 于 2017-11-23 提交,常量与参考实现相同。 - Rust 1.20 至
1.80:1.20.0(2017-08-31)稳定了
sort_unstable,实现来自 PR #40601(2017-03 合入)。论文第 1 节提到这是 Stjepan Glavina 的移植。1.80.0 中它位于library/core/src/slice/sort.rs的quicksort()/recurse(),文件头注释写明基于 pdqsort。它与参考实现有几处实质差异:break_patterns放在下一轮循环开头执行;partial_insertion_sort改为”最多修正 5 对相邻逆序、长度小于 50 时不移动”;- 块分区对所有类型启用。
- Rust 1.81 起:PR #124032
把不稳定排序换成 Lukas Bergdoll 与 Orson Peters 的
ipnsort,稳定排序换成
driftsort。
slice/sort/unstable/mod.rs中的 ipnsort 先用find_existing_run检查整段是否已经有序或逆序,回退预算改为 \(2\lfloor\log_2 n\rfloor\)。1.81.0 的发布说明提醒,新实现在Ord不满足全序时可能 panic。 - Go:提交 72e77a7f41bb(“sort: use
pdqsort”)进入 Go 1.19,发布说明写的是 “rewritten to use
pattern-defeating quicksort”。源码注释写明 “without the
optimizations from BlockQuicksort”。Go 1.21 新增的
slices.Sort使用同一算法(pdqsortOrdered)。 - libc++ 16
起:
__algorithm/sort.h注释写明 “partly based on Orson Peters’ pattern-defeating quicksort”。它采用了 ninther、__partition_with_equals_on_left、无交换分区后的__insertion_sort_incomplete和 bitset 版块分区,但回退条件保留了 introsort 的深度计数,每层递归无条件减一,也没有模式破坏。LLVM 15 的同一文件中没有这些内容。
九、争论与开放问题
确定性还是随机化
McIlroy 1999 年的 “A Killer Adversary for Quicksort” 给出一种通用方法:只要排序是确定性的、只通过比较获取信息,就能在运行时构造出针对它的最坏输入。pdqsort 选择确定性,靠堆排序封顶,保证是 \(O(n\log n)\) 而不是常数。第七节的 killer_pdq 表明,对抗者仍能让它付出约两倍于堆排序的比较次数。论文第 4.2 节把随机候选留作可选项;Rust 与 Go 用长度做种子的 xorshift,本质上仍是确定性的,同样可以被针对。对于需要抗 DoS 的场景(例如对不可信输入排序的服务端),“可复现”与”不可预测”之间怎么取舍,这几个实现都没有提供开关。
坏分区计数还是深度限制
pdqsort 论文认为坏分区计数比深度限制”更精确”:深度计数会把模式被打散之前的几次坏分区算得过重,过早退化到堆排序。libc++ 16 却在采用 pdqsort 大部分组件的同时保留了深度计数。两种触发条件在真实输入上会有多大差别,论文只给了定性描述,没有给出单独比较这一项的实验;本文的实验也没有拆开这一项。
偏斜 pivot 与块分区
Kaligosi 与 Sanders 的结论是:对有分支的分区,偏离中位数的 pivot 反而更快。Edelkamp 与 Weiß 重做了这组实验(BlockQuicksort 论文 Figure 2):经典 Hoare 分区确实受益于偏斜 pivot,块分区则在精确中位数附近最快。pdqsort 同时容忍 \(1/8\) 以内的偏斜、又默认使用块分区,这两个取舍依据的是不同的代价模型。对于比较函数本身有分支的类型,哪一套模型更贴近现实,至今没有定论;参考实现干脆对这类类型关闭块分区。
不稳定排序能否利用 run
pdqsort 只对”整段有序”线性。第七节的 organ、merge、sort90 上,归并类算法明显更快,而这类”几段有序数据拼在一起”的输入在实际系统中很常见(例如追加写入的日志、多路结果拼接)。ipnsort 在入口加了一次整段 run 检测,Rust 1.81 的文档仍写明它通常比稳定排序快,部分有序的切片是例外。在保持原地、不分配内存的前提下,不稳定排序能否像 TimSort、Powersort 那样利用多段 run,仍是开放问题。
十、工程陷阱
| 陷阱 | 后果 | 做法 |
|---|---|---|
比较器不满足严格弱序(用
<=,或浮点数里有 NaN) |
参考实现依赖哨兵,扫描可能越界。reproduce/ub_demo.cpp
对 100 个相同元素用 <=
排序,AddressSanitizer 在 partition_right 的
while (comp(*++first, pivot)); 处报告
heap-buffer-overflow;Rust 1.81 起可能 panic |
只用 < 语义的比较器;浮点数用
total_cmp 或先剔除 NaN |
| 需要保持相等元素的相对顺序 | pdqsort 不稳定,相等元素的输出顺序取决于具体实现和版本 | 需要稳定时用
std::stable_sort、slice::sort、sort.Stable |
| 输入是几段有序数据拼接 | 只能”击退”模式,不能利用 run;第七节 organ 上比
std::stable_sort 慢 2.4 到 2.9 倍 |
用 TimSort、Powersort 或
std::stable_sort,或先检测 run |
| 自定义比较器或结构体键 | C++ 参考实现与 libc++ 都只对算术类型 + 默认比较器开块分区,随机输入上会损失大部分加速 | 比较函数确实无分支时,显式调用
pdqsort_branchless;或先提取整数键 |
| 输入可能被恶意构造 | 确定性 pivot 可以被针对,第七节 killer_pdq 使比较次数翻倍 | 在坏分区之后改用随机候选(论文第 4.2 节),或对不可信输入限流 |
| 自行移植时改动 pivot 选择或哨兵 | 可能丢掉有序输入的线性行为(论文脚注 7),或让无哨兵插入排序越界 | 以参考实现为准;用计数比较器与参考实现对拍比较次数,并在 sanitizer 下测试 |
十一、参考资料
源码与文档
- orlp/pdqsort,commit
b1ef26a55cdb60d236a5cb199c4234c704f46726(2021-03-14),
pdqsort.h:pdqsort_loop()、partition_right()、partition_right_branchless()、partition_left()、partial_insertion_sort()。 - Boost.Sort,tag
boost-1.67.0,
include/boost/sort/pdqsort/pdqsort.hpp。 - Rust
1.80.0,
library/core/src/slice/sort.rs:quicksort()、recurse()、choose_pivot()、break_patterns()、partial_insertion_sort()、partition_in_blocks();library/core/src/slice/mod.rs中sort_unstable的文档。 - Rust
1.81.0,
library/core/src/slice/sort/unstable/mod.rs:sort()、ipnsort();RELEASES.md中 1.81.0 与 1.20.0 两节;PR #40601、PR #124032。 - Go
1.19,
src/sort/sort.go、src/sort/slice.go、src/sort/zsortfunc.go:pdqsort_func()、choosePivot_func()、breakPatterns_func();提交 72e77a7f41bb;Go 1.19 Release Notes 中sort一节。Go 1.21,src/slices/sort.go、src/slices/zsortordered.go。 - LLVM
libc++,llvmorg-16.0.0,
libcxx/include/__algorithm/sort.h:__introsort()、__bitset_partition()、__partition_with_equals_on_left()、__use_branchless_sort。 - GCC 16.1.1
libstdc++,
bits/stl_algo.h:__introsort_loop()、__final_insertion_sort()、__merge_sort_with_buffer();bits/stl_heap.h:__adjust_heap()。
核心论文
- O. R. L. Peters, “Pattern-defeating Quicksort”, arXiv:2106.05123, 2021(预印本,未经同行评审)。
- D. R. Musser, “Introspective Sorting and Selection Algorithms”, Software: Practice and Experience 27(8), 983–993, 1997.
- S. Edelkamp, A. Weiß, “BlockQuicksort: Avoiding Branch Mispredictions in Quicksort”, ESA 2016, LIPIcs 57, 38:1–38:16;期刊版 ACM Journal of Experimental Algorithmics 24, 2019;arXiv:1604.06697。
- K. Kaligosi, P. Sanders, “How Branch Mispredictions Affect Quicksort”, ESA 2006, LNCS 4168, 780–791.
- C. A. R. Hoare, “Quicksort”, The Computer Journal 5(1), 10–16, 1962.
其他论文
- J. L. Bentley, M. D. McIlroy, “Engineering a Sort Function”, Software: Practice and Experience 23(11), 1249–1265, 1993.
- M. D. McIlroy, “A Killer Adversary for Quicksort”, Software: Practice and Experience 29(4), 341–344, 1999.
- J. W. Tukey, “The ninther, a technique for low-effort robust (resistant) location in large samples”, in Contributions to Survey Sampling and Applied Statistics, 251–257, 1978(经 Peters 论文引用)。
实验
reproduce/pdq.c、reproduce/pdq.h:参考实现的 C 移植,带分区、坏分区、堆排序回退等计数器。reproduce/test_pdq.c:与qsort对拍的正确性测试。reproduce/bench.cpp、reproduce/fetch_pdqsort.sh:第七节全部比较次数、计数器与耗时;原始输出在reproduce/results/。reproduce/ub_demo.cpp:比较器违反严格弱序时的越界演示。reproduce/plot_results.py、reproduce/plot_entropy.py、reproduce/draw_figures.py:本文插图。
系列导航: - 上一篇:TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略 - 下一篇:基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
相关阅读: - 无分支编程:当 if 成为性能杀手 - 排序基准测试:比较次数、分支预测与输入分布 - 并行排序:排序网络、并行归并、样本排序与 GPU 基数排序
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
排序算法专题:从 TimSort 到并行排序
把 TimSort、pdqsort、radix sort、external sort、parallel sort 与 benchmark 串成一条阅读路径。先读哪篇、什么时候选哪种排序,这一页讲清。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。
排序基准测试:比较次数、分支预测与输入分布
在 GCC 16 上对 9 种 int32 排序做精确比较计数与绑核计时(8 种输入分布、3 个进程取中位数):比较次数预测不了耗时,分支预测与输入结构决定排名;反复排序同一数组会把小数组耗时低估 2 到 6 倍。