关于 TimSort,流传最广的是三种说法:Python 和 Java 的默认排序都是 TimSort;它最坏 \(O(n \log n)\)、有序时 \(O(n)\),是被充分证明过的工业算法;它快是因为 galloping。三句话都只对一半。CPython 从 3.11 起已经把 TimSort 的合并顺序换成了 Munro 与 Wild 的 Powersort,Java 只对对象数组用 TimSort,基本类型数组用的是 Dual-Pivot Quicksort;TimSort 的最坏界在 2002 年被宣称、到 2015 年才有证明,而它的合并规则本身有一个 2015 年才被形式化验证发现、2018 年才在 OpenJDK 彻底修掉的缺陷;galloping 在随机输入上几乎不起作用,它的价值集中在”一侧连续胜出”的输入上。
本文按”版本谱系 → run 与 minrun → 两代合并策略 → 合并与
galloping → 实验 → 争论”的顺序展开。实现细节以 CPython
Objects/listobject.c 与
Objects/listsort.txt(v3.10.0 至 v3.15.0rc2)和
OpenJDK java/util/TimSort.java
为准;所有比较次数都来自同目录下的
reproduce/timsort_count.c,它在 11 类输入上与
CPython 3.10、3.12、3.14、3.15
的实测比较次数逐项相等(第八节)。
一、TimSort 在哪里,是哪一版
设计目标
Tim Peters 在 2002 年为 CPython 的
list.sort() 写了这个算法,替换此前的 samplesort
混合实现,设计文档就是 listsort.txt,随 Python
2.3 发布(“What’s New in Python 2.3” 记载
sort() 被 Tim Peters “extensively
rewritten”)。文档开头给出的目标很具体:在多种部分有序的输入上比较次数少于
\(\lg(n!)\),最少只要 \(n-1\) 次;在随机输入上和旧的
samplesort 一样快。它的前提同样具体:在 Python
里比较很贵,一次 __lt__
是一次动态分派的函数调用,而移动的只是指针。后文几乎每个设计选择都可以追溯到这个前提。
它是一个稳定的自然归并排序(natural mergesort):从左到右扫描,识别已有的有序段(run),太短的 run 用二分插入排序补到 minrun,然后把 run 压入一个待合并栈,按某种规则合并相邻 run。“按什么规则合并”正是二十年来改动最多的部分。
版本谱系
flowchart LR
  P23["CPython 2.3 (2003)<br/>timsort, Tim Peters"]
  FIX["CPython 2.7.10 / 3.4.4 (2015)<br/>merge_collapse fix"]
  PS["CPython 3.11<br/>powersort merge policy"]
  RUN["CPython 3.13<br/>non-strict descending runs"]
  MR["CPython 3.15<br/>minrun varies per run"]
  J7["Android, then OpenJDK 7 (2009 port)<br/>Object[] sort"]
  J11["OpenJDK 11 (2018)<br/>mergeCollapse fix"]
  V7["V8 7.0 (2018)<br/>Torque TimSort"]
  VP["V8 main (2026)<br/>PowerSort"]
  SW["Swift 5.0<br/>timsort, straight merge"]
  RS["Rust up to 1.80<br/>timsort-inspired slice::sort"]
  DS["Rust 1.81 (2024)<br/>driftsort"]
  DG["de Gouw et al.<br/>CAV 2015"]
  AU["Auger et al.<br/>ESA 2018"]
  MW["Munro and Wild<br/>ESA 2018"]
  P23 --> FIX --> PS --> RUN --> MR
  P23 --> J7 --> J11
  P23 --> V7 --> VP
  P23 --> SW
  P23 --> RS --> DS
  DG -.-> FIX
  AU -.-> J11
  MW -.-> PS
PS -.-> VP| 系统 | 版本 | 变化 | 依据 |
|---|---|---|---|
| CPython | 2.3 | list.sort() 改为 timsort |
What’s New in Python 2.3;listsort.txt |
| CPython | 2.7.10、3.4.4(2015) | merge_collapse() 增加对栈上第四个 run
的检查 |
源码对比:2.7.9、3.4.3 没有,2.7.10、3.4.4 有 |
| CPython | 3.11 | 合并顺序改为
powersort(powerloop()、found_new_run()) |
listsort.txt 引 bpo-34561;GH-28108 |
| CPython | 3.13 | 降序 run 由”严格递减”放宽为”非递增” | 3.13 listsort.txt “Runs” 一节 |
| CPython | 3.15(rc2) | minrun 逐 run 变化(Stefan Pochmann 2025 年方案) | 3.15 listsort.txt “Computing minrun” |
| OpenJDK | 7 | Arrays.sort(Object[])、Collections.sort
改用 TimSort |
提交 6804124(2009-07-29,“Easy port of timsort from
android”,@author Josh Bloch) |
| OpenJDK | 2013、2015 | 按不变量推算的栈长度两次调大:19→24(JDK-8011944)、40→49(JDK-8072909) | 提交记录 |
| OpenJDK | 11 | mergeCollapse() 采用与 CPython
相同的修复 |
JDK-8203864(2018-06-25);jdk-10-ga 没有,jdk-11-ga 有 |
| V8 | 7.0 / Chrome 70 | Array.prototype.sort 由 JS 实现的不稳定
quicksort 改为 Torque 实现的 TimSort |
V8 博客 “Getting things sorted in V8”(2018-09-28) |
| V8 | 主干,2026-04 | TimSort 改为 PowerSort | 提交 8899b945f6b9 “[builtins] Sorting: TimSort –> PowerSort” |
| Swift | 5.0 | 稳定排序实现为 “Timsort, modified to perform a straight merge”;4.2 是 introsort | stdlib/public/core/Sort.swift |
| Rust | 1.80 及以前 → 1.81 | slice::sort 由 “adaptive, iterative merge
sort inspired by timsort” 改为 driftsort |
各版本 slice::sort 文档 |
有三处常被写错。第一,Java 的 TimSort
从来只用于对象:Arrays.sort(int[])
等基本类型重载走
DualPivotQuicksort,而旧的归并排序仍可用系统属性
java.util.Arrays.useLegacyMergeSort
切回。第二,Swift 5.0 的实现去掉了 galloping(“straight
merge”),而且 5.0 的文档仍写着 “not guaranteed to be
stable”,到 6.0 的文档才改为 “guaranteed to be
stable”。第三,Rust 1.81 的 driftsort 不是 TimSort
的变体:文档说它 “combines the fast average case of
quicksort with the fast worst case and partial run detection
of mergesort”;同版本 sort_unstable 换成了
ipnsort。
V8 的 2018 年博客给出的理由和 CPython 同源:在 JavaScript 这类动态语言里,“a comparison operation is usually a magnitude more expensive than a memory access”,因为比较往往要调用用户代码。2026 年改用 PowerSort 的提交说明写的是宏基准持平(“macrobenchmarks are neutral”),而 TimSort 在对抗性输入上 “~50% above optimal”。
二、自然 run:检测、反转与稳定性
run 的定义
count_run()
从当前位置开始找最长的单调前缀。升序 run
是非递减的 \(a_0 \le a_1 \le
\cdots\);降序 run
找到后原地反转成升序。反转会打乱相等元素的相对次序,所以直到
3.12,降序 run 一直要求严格递减 \(a_0 > a_1 >
\cdots\):遇到相等元素就结束这个 run。
3.13 把降序 run 放宽成非递增 \(a_0 \ge a_1 \ge \cdots\),靠的是一个两次反转的技巧:扫描降序 run 时,把每一段全相等的子段先原地反转一次;最后整段反转时,这些子段被再反转一次,原有次序恢复。整段反转之后,如果紧接着的元素还能接上,run 继续向右延伸。
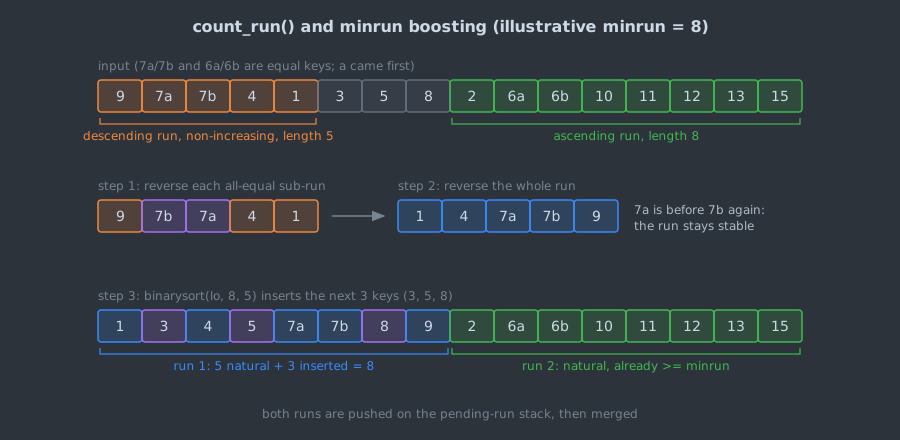
下面是 3.14 的 count_run()
的主体(删去断言与错误处理)。IF_NEXT_SMALLER
展开为
lo[n] < lo[n-1],IF_NEXT_LARGER
展开为 lo[n-1] < lo[n];CPython 只用
<,相等要靠两次比较都为假来推断。
/* CPython v3.14.0, Objects/listobject.c, count_run() */
for (n = 1; n < nremaining; ++n) {      /* try ascending run first */
    IF_NEXT_SMALLER
        break;
}
if (n == nremaining)
    return n;
if (n > 1) {                            /* ascending prefix of length n */
    IFLT(lo[0], lo[n-1])
        return n;                       /* really ascending: done */
    sortslice_reverse(slo, n);          /* all equal: treat as descending */
}
++n;
Py_ssize_t neq = 0;
for ( ; n < nremaining; ++n) {
    IF_NEXT_SMALLER {
        REVERSE_LAST_NEQ                /* reverse the all-equal sub-run */
    }
    else {
        IF_NEXT_LARGER                  /* descending run is over */
            break;
        else
            ++neq;                      /* not x < y and not y < x */
    }
}
REVERSE_LAST_NEQ
sortslice_reverse(slo, n);              /* transform to ascending run */
for ( ; n < nremaining; ++n) {          /* extend by an ascending suffix */
    IF_NEXT_SMALLER
        break;
}
return n;
代价是每个 run 多出一两次比较:升序前缀结束后要多比一次
lo[0] < lo[n-1],反转后要多试一次能否延伸。在
\(n = 10^6\)
的随机排列上,3.14 比 3.12 多 22,234 次比较(约
0.12%);收益在有大量重复键的降序输入上:每个值重复 4
次的非递增序列,3.12 要 5,096,957 次,3.14 只要 1,749,997
次(第八节)。后者恰好是 \(\frac{7}{4}n - 3\):每 4
个元素里 3 对相等、各花 2 次比较,1 对严格递减、花 1
次比较。
预排序程度的度量
“输入有多有序”有很多种度量,Estivill-Castro 与 Wood 1992 年的综述梳理了基于逆序数、run 数等度量的自适应排序算法。对自然归并排序最贴切的是 run 长度的熵。设输入被分成 \(r\) 个 run,长度 \(L_1, \ldots, L_r\),
\[ \mathcal{H} = \mathcal{H}\!\left(\frac{L_1}{n}, \ldots, \frac{L_r}{n}\right) = \sum_{i=1}^{r} \frac{L_i}{n} \lg \frac{n}{L_i} \le \lg r. \]
与这些 run 相容的排列有 \(\binom{n}{L_1, \ldots, L_r}\) 种,所以任何基于比较的算法在最坏情况下至少需要
\[ \lg(n!) - \sum_{i=1}^{r} \lg(L_i!) = n\mathcal{H} - O(n) \]
次比较(Barbay 与 Navarro 2013 年定理 2 的证明中给出形式化论证)。\(r = 1\) 时下界是 0,加上确认有序所需的 \(n-1\) 次,正好对应 TimSort 在已排序输入上的 \(n-1\) 次比较。Auger、Jugé、Nicaud、Pivoteau 证明 TimSort 的运行时间是 \(O(n + n\mathcal{H})\),这比 \(O(n \log n)\) 更能解释它在部分有序输入上的表现。
三、minrun 与二分插入排序
minrun 的取法
随机输入里自然 run 很短(期望长度约 2),直接合并会产生大量极短的合并。TimSort 设一个下限 minrun:自然 run 短于它时,用二分插入排序把后续元素补进来,直到长度达到 minrun(剩余元素不足时取剩余全部)。
minrun 的目标不是”让 run 适合缓存”,而是让合并树平衡:随机输入下 run 数大约是 \(n / \text{minrun}\),这个数最好恰好是 2 的幂,或略小于 2 的幂;若略大于 2 的幂,最后会出现一次极不平衡的合并。CPython 的做法是取 \(n\) 的最高 6 位作为 minrun,只要被移出的低位中有 1 就再加 1:
/* CPython v3.14.0, Objects/listobject.c; MAX_MINRUN is 64 */
static Py_ssize_t
merge_compute_minrun(Py_ssize_t n)
{
    Py_ssize_t r = 0;           /* becomes 1 if any 1 bits are shifted off */

    assert(n >= 0);
    while (n >= MAX_MINRUN) {
        r |= n & 1;
        n >>= 1;
    }
    return n + r;
}
于是 \(n < 64\) 时
minrun 就是 \(n\)(整个数组做一次二分插入排序);\(n\) 是 2 的幂时 minrun 恰为
32;其余情况 minrun 落在 \([32,
64]\),\(n /
\text{minrun}\) 是 2 的幂或严格小于某个 2
的幂。./timsort_count minrun 的输出:
| \(n\) | minrun | \(n/\text{minrun}\) | 3.15 的 run 数(长度范围) |
|---|---|---|---|
| 63 | 63 | 1.000 | 1(63) |
| 64 | 32 | 2.000 | 2(32) |
| 65 | 33 | 1.970 | 2(32–33) |
| 1,000 | 63 | 15.873 | 16(62–63) |
| 2,112 | 33 | 64.000 | 64(33) |
| 10,000 | 40 | 250.000 | 256(39–40) |
| 32,769 | 33 | 993.000 | 1,024(32–33) |
| 1,000,000 | 62 | 16,129.032 | 16,384(61–62) |
listsort.txt 用 \(n = 2112\)
解释了为什么不能固定取 32:\(2112
= 66 \times 32\),随机输入会得到 66 个长 32 的
run,前 64 个完美平衡地合并成 2048,最后剩下 2048 与 64
的合并,为了把 64 个元素放到位要移动 \(O(n)\) 个指针;取 minrun = 33
则恰好 64 个 run。Java 把常量 MIN_MERGE 定为
32,所以 minrun 落在 \([16,
32]\),源码注释说 “It was 64 in Tim Peter’s C
implementation, but 32 was empirically determined to work
better in this implementation”。
旧规则只保证第一层的 run 数接近 2 的幂。\(n = 32769 = 2^{15} + 1\) 时
minrun = 33,得到 993 个 run,并不是 2 的幂。3.15 采用了
Stefan Pochmann 在 2025 年提出的方案:理想的 run 长度是
\(n / 2^e\)(\(e\) 取使之小于 64
的最小值),它通常不是整数,于是像 Bresenham
画线那样累积小数部分,逐个决定这一段取下取整还是上取整。结果是每一层合并树上
run 数都是 2 的幂,至多出现两种相差 1
的长度,被合并的两段长度之差不超过 1。\(n = 315\) 时旧规则得到
40 40 40 40 40 40 40 35,新规则得到
39 39 40 39 39 40 39 40。实现用整数完成:每次加
\(n\)、对 \(2^e\) 取模、右移 \(e\) 位得到本段长度。
为什么是二分插入
binarysort()
用二分查找确定插入位置,比较次数是 \(O(\log k)\)
每元素,但数据移动仍是 \(O(k^2)\)。3.14
源码的注释解释了取舍:比较越贵,二分的优势越大;数据移动量反而不重要,因为
64 个指针”all fit in a corner of L1
cache”;而随机输入下二分查找的分支更难预测,所以它的”最坏情况”实际上是随机输入而不是逆序输入。同一处还保留了一段
#if 0 的普通插入排序,作为对照。
四、合并顺序(一):Tim Peters 的栈不变量与 2015 年的 bug
不变量与合并规则
待合并的 run
按出现顺序压在栈上。合并越晚,越有机会遇到长度相近的
run;合并越早,刚找到的 run 越可能还在缓存里,栈也越浅。Tim
Peters 的折中是维持两个不变量:记栈顶三个 run
的长度自底向上为 \(X, Y,
Z\)(listsort.txt 里叫
A、B、C),要求
\[ X > Y + Z, \qquad Y > Z. \]
若第一条不成立,就把 \(Y\) 与 \(X\)、\(Z\) 中较短的一个合并(相等时选 \(Z\));若只有第二条不成立,合并 \(Y\) 与 \(Z\);重复直到两条都成立。如果不变量对栈上每一组相邻三元都成立,从栈顶往下的长度至少按斐波那契数增长,栈深不超过 \(\log_\varphi (n / \text{minrun}) + O(1)\),\(\varphi \approx 1.618\)。CPython(至 3.10)据此把栈固定为 85 格,注释写着这足以排序约 \(32 \varphi^{85}\) 个元素(“good for an array with 2**64 elements”);Java 为了中等规模数组的开销,按数组长度选择 5、10、24 或 49 格。
问题在于原始实现只检查栈顶三个 run。合并一次之后,栈顶下方原本满足的不变量可能被破坏,而循环已经停止了。
de Gouw 等人的反例
2015 年,de Gouw、Rot、de Boer、Bubel、Hähnle 用 KeY 对
OpenJDK 的 TimSort
做形式化验证,在证明过程中发现栈不变量并不总被维护,并构造出反例。论文第
3 节用一串 run 长度说明了机制:

压入 30 前,栈 \([120, 80, 25,
20]\) 满足全部不变量。压入 30 后 \(25 \le 20 + 30\),合并 25 与 20
得到 \([120, 80, 45,
30]\)。此时栈顶三个满足 \(80 > 45 + 30\)、\(45 > 30\),原始规则停止;但
\(120 \le 80 +
45\),更深处的不变量已经不成立。不变量失效本身不影响结果的正确性,数组仍会被排好;受影响的是依赖不变量推算的栈容量。论文据此构造的最小触发输入有
67,108,864 个元素,需要 41 格栈,而当时 Java 的上限是
40,于是 pushRun() 写越界,抛出
ArrayIndexOutOfBoundsException。论文指出
CPython 有同样的缺陷,只是 85 格的余量让它更难触发。
修复是让条件也检查第四个 run。CPython 在 2.7.10 与 3.4.4 采纳了这一修复,3.10 的版本如下:
/* CPython v3.10.0, Objects/listobject.c */
static int
merge_collapse(MergeState *ms)
{
    struct s_slice *p = ms->pending;

    assert(ms);
    while (ms->n > 1) {
        Py_ssize_t n = ms->n - 2;
        if ((n > 0 && p[n-1].len <= p[n].len + p[n+1].len) ||
            (n > 1 && p[n-2].len <= p[n-1].len + p[n].len)) {
            if (p[n-1].len < p[n+1].len)
                --n;
            if (merge_at(ms, n) < 0)
                return -1;
        }
        else if (p[n].len <= p[n+1].len) {
            if (merge_at(ms, n) < 0)
                return -1;
        }
        else
            break;
    }
    return 0;
}
p[n+1] 是栈顶,merge_at(ms, i)
合并 p[i] 与 p[i+1]。第二行条件
p[n-2].len <= p[n-1].len + p[n].len
就是新增的检查。
Java 走了另一条路,又回到这条路
论文给出两种修法:恢复不变量,或者保留原算法、按真实最坏情况重新计算栈容量。OpenJDK
在 2015 年选了后者(JDK-8072909,把上限从 40 调到
49),依据是论文中”不变量不会在栈上相邻两处同时被破坏”的断言。2018
年 Auger、Jugé、Nicaud、Pivoteau
指出这条断言是错的,并给出了需要 50 格栈的输入;他们论文图 6
的 run 长度序列 \((109, 83, 25,
16, 8, 7, 26, 2, 27)\) 在原始规则下会停在 \([109, 83, 56, 28, 27]\),此时
\(109 \le 83 + 56\) 与
\(83 \le 56 + 28\)
两处相邻位置同时违反不变量(./timsort_count stack
可以逐步打印)。同年 JDK-8203864 把
mergeCollapse() 改成与 CPython
相同的修复版本,并在提交说明中致谢了两组作者;JDK 11
起两处修改同时存在,JDK 21 的栈上限仍是 49。
这段历史还有一个副产品:TimSort 的 \(O(n \log n)\) 最坏界在 2002
年的 listsort.txt 中只是宣称,第一个证明出自
Auger、Nicaud、Pivoteau 2015 年的技术报告,Auger 等人 2018
年的论文给出了更简洁的证明和 \(O(n
+ n\mathcal{H})\) 界。
五、合并顺序(二):Powersort
合并顺序就是一棵二叉树
把每次合并的代价记为两段长度之和,总合并代价 \(M = \sum (|A| + |B|)\),它同时是比较次数与数据移动量的上界。任意一种相邻合并顺序对应一棵以 run 为叶子的二叉树,\(M = \sum_i L_i \cdot \operatorname{depth}(i)\),这正是以 \(L_i / n\) 为权重的二叉搜索树的加权路径长度。所以”最优合并顺序”等价于”最优字母序二叉树”,而 Mehlhorn 早在 1970 年代就研究过近似最优的二叉搜索树:其中”Method 2”(二分启发式)总是把原始区间对半切,得到的树的代价不超过熵加一个常数。
Munro 与 Wild 在 ESA 2018 的论文里把这个构造改写成可以从左到右在线执行的形式,得到 powersort;同篇论文还给出了自顶向下的 peeksort。
run 边界的 power
对相邻两个 run,前者从下标 \(s_1\) 开始、长度 \(n_1\),后者长度 \(n_2\)。取两个 run 中点的归一化位置
\[ a = \frac{s_1 + n_1/2}{n}, \qquad b = \frac{s_1 + n_1 + n_2/2}{n}, \]
它们之间这个边界的 power 是使区间 \((a, b]\) 包含某个 \(j / 2^{\ell}\) 的最小 \(\ell\),也就是 \(a\) 与 \(b\) 的二进制展开第一次出现不同位的位置。power 就是这个边界在理想合并树中的深度,根的 power 为 1。CPython 用逐位模拟除法来算,避免依赖 count-leading-zeros 指令和双倍宽度的除法:
/* CPython v3.14.0, Objects/listobject.c */
static int
powerloop(Py_ssize_t s1, Py_ssize_t n1, Py_ssize_t n2, Py_ssize_t n)
{
    int result = 0;
    Py_ssize_t a = 2 * s1 + n1;  /* 2*a */
    Py_ssize_t b = a + n1 + n2;  /* 2*b */
    /* Emulate a/n and b/n one bit a time, until bits differ. */
    for (;;) {
        ++result;
        if (a >= n) {  /* both quotient bits are 1 */
            a -= n;
            b -= n;
        }
        else if (b >= n) {  /* a/n bit is 0, b/n bit is 1 */
            break;
        } /* else both quotient bits are 0 */
        a <<= 1;
        b <<= 1;
    }
    return result;
}
新 run 到来时,先算出它与栈顶 run 之间边界的 power,然后只要栈上次顶的 power 比它大就合并,最后才把新 run 压栈:
/* CPython v3.14.0, Objects/listobject.c, found_new_run() */
int power = powerloop(s1, n1, n2, ms->listlen);
while (ms->n > 1 && p[ms->n - 2].power > power) {
    if (merge_at(ms, ms->n - 2) < 0)
        return -1;
}
p[ms->n - 1].power = power;
于是栈上的 power 自顶向下严格递减,栈深不超过 \(\lfloor \lg n \rfloor +
1\)。3.11 起 MAX_MERGE_PENDING 从 85
改为 SIZEOF_SIZE_T * 8(64 位平台上是
64),注释的理由正是这个界。
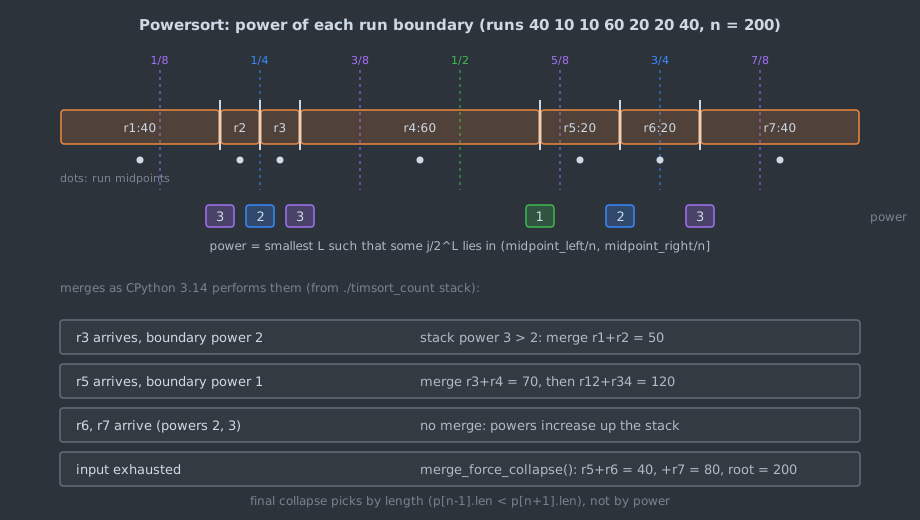
输入扫描完后,merge_force_collapse() 仍按
Tim 的老规则收尾:每次把次顶与它两侧中较短的一侧合并,不再看
power。
保证
Munro 与 Wild 的定理 6:powersort 的合并代价至多为 \(n\mathcal{H} + 2n\),比较次数至多为 \(n\mathcal{H} + 3n - r\),除合并缓冲区外只需 \(O(\log n)\) 个字的额外空间。与第二节的下界 \(n\mathcal{H} - O(n)\) 相比,只差一个线性项。
TimSort(修复后的 CPython 版本)的合并代价上界是 \(\frac{3}{2} n\mathcal{H} + O(n)\),常数 \(\frac{3}{2}\) 是紧的:上界由 Auger 等人证明(arXiv v3 第 4 节定理 11),匹配的下界来自 Buss 与 Knop 构造的输入族,其合并代价达到 \((\frac{3}{2} - o(1))\, n \lg n\)。Buss 与 Knop 的论文以”是否存在只看栈顶 \(k\) 个 run、合并代价为最优 \((1 + o_r(1))\) 倍的栈式归并”作为开放问题(Question 37);Munro 与 Wild 指出 powersort 以 \(k = 3\) 给出了肯定回答。
powersort 也不是最优的。listsort.txt
说得很直白:离线求最优合并顺序需要事先知道所有 run
的长度,而且代价随 run 数平方增长;它还记了一个”curious
factoid”:在文献中的各种策略里,只有 powersort 对任意 3 个
run 总能给出最优顺序。
在合并代价上到底差多少
./timsort_count cost 1000 7 只模拟 run
长度,不排序真实数据,比较两种规则的合并代价(CPython 3.10
的修复版 Tim 规则对 3.11 起的 powersort,两者收尾都用
merge_force_collapse()):
- 1,000 组各 200 个 run 的随机序列(每组的 run 长度都在 1–20 或 1–1000 中均匀取,约 10% 的 run 把随机部分放大 50 倍):合并代价与 \(n\mathcal{H} + n\) 之比的平均值,Tim 规则 0.9810,powersort 0.9412,平均差约 4%。
- 同一批序列里,Tim 规则最多比 powersort 贵 21.66%;反过来 powersort 最多比 Tim 规则贵 6.58%,powersort 并不在每个实例上都占优。
- 用爬山搜索专门找对 Tim 规则不利的序列,找到的最差比值是 1.2854(Tim 921,272,powersort 716,733,\(n\mathcal{H} = 703{,}073\),\(n = 95{,}905\))。
平均意义上两者差得不多,差别在最坏情况和可证明性。V8 提交说明里的”~50% above optimal”与理论上的 \(\frac{3}{2}\) 常数一致;这里的爬山搜索只找到 28.5%,逼近这个常数的输入要按证明专门构造。
六、合并本身:merge_at 的预裁剪与 merge_lo / merge_hi
先裁掉已就位的部分
merge_at() 合并相邻 run \(A\)、\(B\) 之前先做两次 galloping
查找(第七节):用 gallop_right(B[0], A) 找出
\(A\) 中不大于 \(B[0]\)
的前缀,这部分已经在最终位置;再用
gallop_left(A[-1], B) 找出 \(B\) 中不小于 \(A\)
最后一个元素的后缀,这部分也不用动。对部分有序的输入,这一步常常能把一次合并裁到很短,甚至完全跳过。
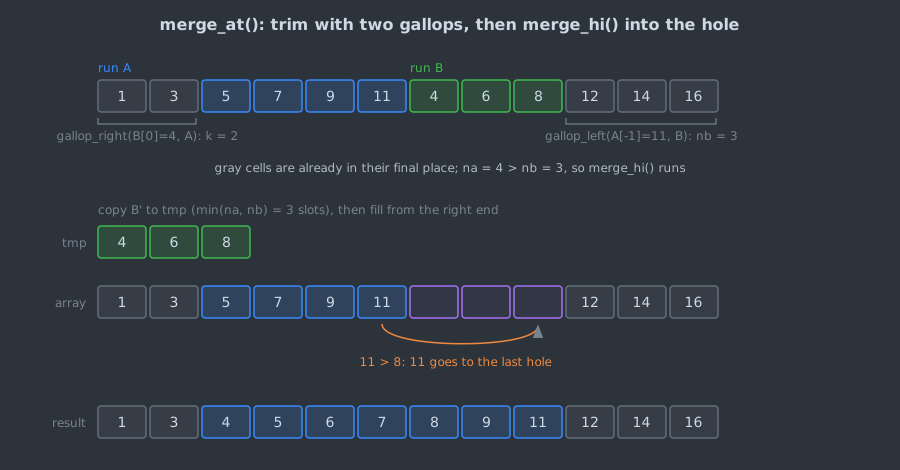
临时空间只取较短一侧
裁剪后若 \(|A| \le |B|\)
调用 merge_lo():把 \(A\)
复制到临时区,从左往右合并回原数组;否则调用
merge_hi():把 \(B\)
复制到临时区,从右往左合并。两者都只需要 \(\min(|A|, |B|)\)
的临时空间,所以整个排序的临时空间不超过 \(n/2\)
个指针;listsort.txt
说随机输入下通常就会用到这么多,结构明显的输入可能完全不需要堆内存。MergeState
里内嵌了 256 格的
temparray(MERGESTATE_TEMP_SIZE),小规模合并不调用
malloc。临时区不够时
merge_getmem() 先释放旧块再 malloc
新块,而不是
realloc,因为旧内容不需要保留。
Java 的对应实现把临时数组初始定为 256 或 \(n/2\) 中较小者,不够时在
ensureCapacity() 里扩到大于需求的最小 2
的幂,上限仍是 \(n/2\)。
七、Galloping 与 min_gallop
指数搜索
普通合并每输出一个元素比较一次。若 \(A\) 连续赢了很多次,说明 \(B[0]\) 在 \(A\) 里的位置很靠后,逐个比较很浪费。galloping 模式改用指数搜索:依次比较偏移 \(0, 1, 3, 7, 15, \ldots\)(\(2^k - 1\))处的元素,确定目标落在哪一段之后再二分。
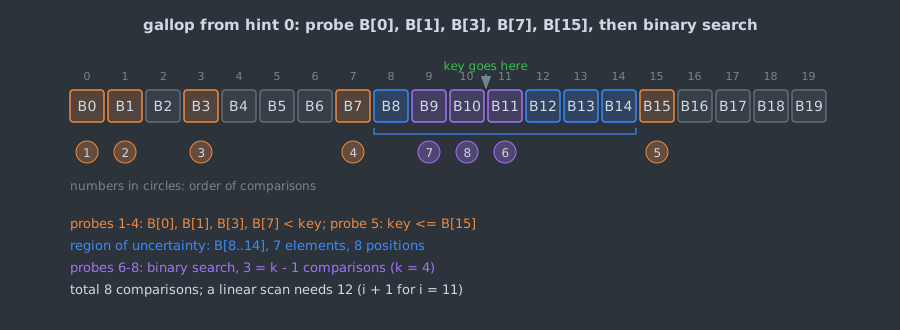
listsort.txt 给出了逐项比较:若 \(A[0]\) 应该放在 \(B[i]\),线性扫描要 \(i+1\) 次比较,galloping 要
\(2\lfloor \lg i \rfloor +
2\) 次(\(i \ge
1\))。
| \(i\) | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|
| 线性扫描 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 12 |
| galloping | 1 | 2 | 4 | 4 | 6 | 6 | 6 | 6 | 8 | 8 |
galloping 在 \(i = 2\)
和 \(i = 4\)
时反而多花比较,直到 \(i \ge
6\) 才稳定占优。文档把 \(i
= 2\) 时多出的一次比较称为 33% 的增幅,“comparisons
are expensive in Python”。所以不能一开始就
gallop,要等证据足够:某一侧连续赢满 min_gallop
次(初值 MIN_GALLOP = 7)才切换,两侧的一次
gallop 找到的段都短于 MIN_GALLOP
时退回逐个比较。listsort.txt 注明 galloping
思路来自 Demaine、López-Ortiz、Munro
关于自适应集合交并的工作,并指出 McIlroy 1993
年的论文更早把同一策略称为 exponential search。
自适应阈值
min_gallop 不是常量。CPython 在
merge_lo() 与 merge_hi()
里这样调整它:
/* CPython v3.14.0, Objects/listobject.c, merge_lo() */
++min_gallop;
do {
    min_gallop -= min_gallop > 1;
    ms->min_gallop = min_gallop;
    k = gallop_right(ms, ssb.keys[0], ssa.keys, na, 0);
    acount = k;
    /* ... copy k elements from A, then one from B ... */
    k = gallop_left(ms, ssa.keys[0], ssb.keys, nb, 0);
    bcount = k;
    /* ... copy k elements from B, then one from A ... */
} while (acount >= MIN_GALLOP || bcount >= MIN_GALLOP);
++min_gallop;           /* penalize it for leaving galloping mode */
ms->min_gallop = min_gallop;
进入 galloping 时先加 1,每轮减 1(不低于 1),离开时再加
1。净效果是:只 gallop 一轮就退出,阈值比进入前高 1;gallop
的轮数越多,阈值降得越低。Java 写法不同但净效果相同:每轮
minGallop--(不低于 0),离开时
minGallop += 2。min_gallop 保存在
MergeState
里,跨越多次合并延续。listsort.txt
对这套机制的评价很克制:随机数据上它让
min_gallop 涨到几乎不会进入 galloping,从而消除
galloping 的额外开销,在 ~sort
这类输入上又能降到 1,但”in all it’s a minor improvement
over using a fixed MIN_GALLOP value”。
第八节的实验把 galloping
模式整个关掉(nogallop
变体:min_gallop 初值设为 \(n+1\),merge_at()
的预裁剪保留),在随机输入上比较次数只多了 5 次(18,627,005
对 18,627,000),在 1% 元素被打乱的有序输入上则从 1,996,421
次涨到 12,620,117 次(6.3 倍)。galloping
的收益高度依赖输入。
八、实验:比较次数
实验环境与口径
- 程序:
reproduce/timsort_count.c,把 CPython 的排序逐函数移植到 C,键为long,每次<计数一次。count_run()、binarysort()、gallop_left()/gallop_right()、merge_lo()/merge_hi()、merge_at()、powerloop()、found_new_run()、merge_force_collapse()取自 v3.14.0,minrun_next()取自 v3.15.0rc2,严格降序的count_run()取自 v3.12.0,修复版merge_collapse()取自 v3.10.0。变体cpy310、cpy312、cpy314、cpy315分别对应 3.4.4–3.10、3.11–3.12、3.13–3.14、3.15 的组合,nogallop是关闭 galloping 模式的cpy314,topdown是教科书式自顶向下归并排序(不检测 run)。 - 编译运行:
gcc -O2 -Wall -Wextra -o timsort_count timsort_count.c -lm && ./timsort_count table 1000000 2025。-fsanitize=address,undefined下./timsort_count selftest通过,自检覆盖结果有序、是原数组的排列、相等键保持原次序。 - 校验:
reproduce/py_count.py用一个重载了__lt__并计数的包装类,让真实的 CPythonlist.sort()排序同一份输入(由./timsort_count dump生成)。在 \(n = 10^5\)、种子 2025 下,CPython 3.10.21、3.12.14、3.14.5、3.15.0rc2 在全部 11 类输入上的比较次数都与对应变体逐项相等;3.14.5 在 \(n = 10^6\)、种子 7 下也全部相等。自定义类会绕开 CPython 对同质int/float/str列表的特化比较函数,这只影响耗时,不影响比较了哪些元素对。 - 环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,GCC 16.1.1。
- 指标只有比较次数,与时钟无关;输入由固定种子的 splitmix64 生成,连续运行 3 次输出逐字节一致。本文不给耗时数据:CPython 的比较次数与耗时强相关,C/C++/Rust 里对整数排序的耗时则主要由数据移动和分支预测决定,那需要另一套实验。
输入族借用了 listsort.txt 的命名:
| 名称 | 构造 |
|---|---|
| random | \(0..n-1\) 的随机排列 |
| sorted / reversed | 升序 / 严格降序 |
| 3sort | 升序后随机交换 3 对 |
| +sort | 升序,末尾 10 个换成随机值 |
| %sort | 升序后随机替换 1% 的元素 |
| ~sort | 只有 4 种不同取值的随机序列 |
| =sort | 全部相等 |
| organ | 前半升序、后半降序 |
| runs64 | 64 个随机切分长度的升序 run |
| descdup | 非递增,每个值重复 4 次 |
结果
\(n = 1{,}000{,}000\),种子 2025,\(\lg(n!) = 18{,}488{,}885\);runs64 的下界 \(\lg(n!) - \sum \lg(L_i!) = 5{,}489{,}346\)。
| 输入 | cpy310 | cpy312 | cpy314 | cpy315 | nogallop | topdown |
|---|---|---|---|---|---|---|
| random | 18,605,431 | 18,604,766 | 18,627,000 | 18,621,264 | 18,627,005 | 18,675,523 |
| sorted | 999,999 | 999,999 | 999,999 | 999,999 | 999,999 | 9,884,992 |
| reversed | 999,999 | 999,999 | 999,999 | 999,999 | 999,999 | 10,066,432 |
| 3sort | 1,000,388 | 1,000,387 | 1,000,393 | 1,000,393 | 1,535,223 | 10,607,018 |
| +sort | 1,000,363 | 1,000,363 | 1,000,365 | 1,000,365 | 1,863,371 | 9,885,146 |
| %sort | 1,999,171 | 1,992,714 | 1,996,421 | 1,980,652 | 12,620,117 | 16,000,294 |
| ~sort | 5,693,662 | 5,693,941 | 5,710,384 | 5,701,847 | 13,617,458 | 16,709,859 |
| =sort | 999,999 | 999,999 | 999,999 | 999,999 | 999,999 | 9,884,992 |
| organ | 1,999,998 | 1,999,998 | 1,999,999 | 1,999,999 | 1,999,999 | 10,475,711 |
| runs64 | 6,862,354 | 6,673,339 | 6,673,402 | 6,673,402 | 6,703,482 | 13,211,296 |
| descdup | 5,096,779 | 5,096,957 | 1,749,997 | 1,749,997 | 1,749,997 | 10,530,000 |
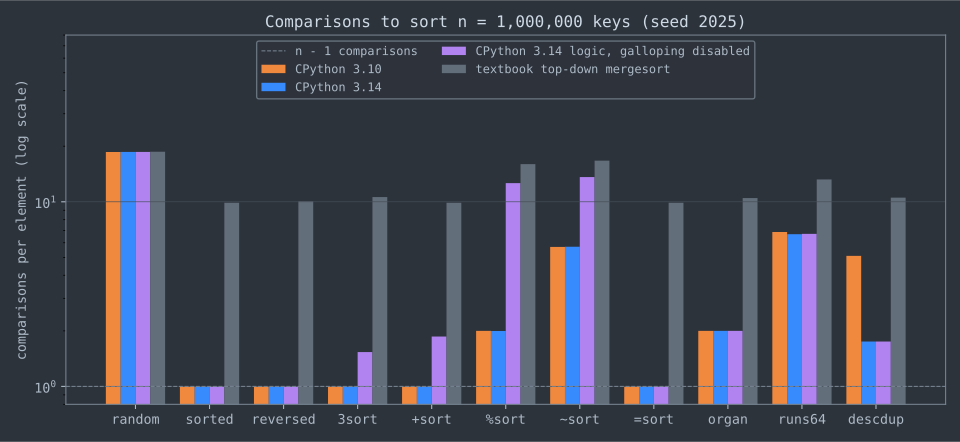
从表中可以读出:
- 随机输入上没有奇迹。 所有变体都在 \(\lg(n!)\) 之上 0.6%–1.0%:cpy310 多 0.63%,cpy314 多 0.75%,自顶向下归并多 1.01%。TimSort 的优势不在这里。
- 有序、逆序、全等输入恰好 \(n - 1\) 次,organ 是 \(2n-2\) 或 \(2n-1\) 次:识别两个 run 约 \(n\) 次,两个 run 的值域完全交错,一次合并再花约 \(n\) 次。自顶向下归并对这些输入仍要约 \(\frac{1}{2} n \lg n\) 次。
- 合并策略的差别只在 run 长度不均时显现。 runs64 上 Tim 规则(cpy310)比 powersort(cpy312)多 2.8% 的比较;其余输入两者几乎相同。powersort 的结果是下界的 1.22 倍,多出的部分主要是识别 run 的约 \(n\) 次比较。
- galloping 决定了”近乎有序”输入的表现。 关闭后,%sort 的比较次数变为原来的 6.3 倍、~sort 变为 2.4 倍,3sort 和 +sort 也各多 50% 以上;随机输入几乎不受影响。
- 3.13 的 run 检测改动在 descdup 上减少 65.7% 的比较,代价是随机输入上多 0.12%。3.15 的 minrun 改动在这组数据上影响很小(random −0.03%,%sort −0.8%)。
九、争论与开放问题
争论一:要不要换成可证明近优的合并策略
CPython 在 3.11、V8 在 2026 年换成了 powersort,OpenJDK 截至 JDK 21 仍是修复后的 Tim 规则加 49 格栈。换的理由是可证明性:powersort 的合并代价离下界只差线性项,栈深有简单的对数界,不会再出现”按不变量推算栈容量、结果不变量没被维护”这种错误。不换的理由也很实在:第五节的模拟里平均差距约 4%,最坏情况需要专门构造;V8 的提交说明也只说宏基准持平。Java 的对象排序被无数应用依赖,替换合并策略会改变比较器被调用的顺序,对那些违反契约的比较器来说,这意味着抛不抛异常可能随之改变。
争论二:该优化比较次数还是数据移动
TimSort
的每个细节都在省比较:二分插入、galloping、min_gallop
的自适应、预裁剪。这在 CPython 和 JavaScript
里是对的,比较要调用用户代码。换到可内联比较的场景,结论就变了:Java
对基本类型数组用 Dual-Pivot Quicksort;Swift 5.0 去掉了
galloping;Rust 1.81 的 driftsort
按文档的说法把快速排序的平均性能与归并排序的 run
检测结合起来。Munro 与 Wild 引用 Elmasry 与 Hammad
的实验指出,按逆序数自适应的排序算法只有在逆序极少(少于
1.5%)时才能在耗时上与普通实现竞争。Gelling、Nebel、Smith、Wild
的 Multiway Powersort(ALENEX
2023)则把目标换成减少内存传输,用 4 路合并代替 2
路合并。大家都同意”利用已有的
run”,分歧在于该最小化哪一种代价。
争论三:比较器不满足全序时怎么办
三种实现给出三种答案。Java 在
mergeLo()/mergeHi()
里检测到矛盾时抛
IllegalArgumentException("Comparison method violates its general contract!"),但能否检测到取决于输入,同一个错误的比较器可能在测试里通过、上线后才抛异常。Rust
1.81 的文档写明 slice::sort “may panic if the
implementation of Ord for T does
not implement a total order”。CPython
不抛异常:merge_lo()
的注释承认比较函数一致时某些状态不可能出现,“but we can’t
assume that it
is”,代码为这些状态留了出口,继续完成合并,结果的顺序没有定义。快速失败能暴露
bug,却把排序算法的实现细节变成了可观察行为;宽容处理更兼容,却让错误悄悄进入结果。
开放问题
- 在线合并策略离最优还有多远。 powersort(\(n\mathcal{H} + 2n\))、Jugé 的 Adaptive ShiversSort(SODA 2020)等策略都做到了 \(n\mathcal{H} + O(n)\),差别在线性项的常数、栈上要看几个 run、以及真实数据上的表现。只允许从左到右扫描一次、只看栈顶常数个 run 时,线性项的最优常数是多少,目前没有定论。
- 真实数据里 run 到底长什么样。 TimSort
的整个设计建立在”真实数据常常部分有序”之上,
listsort.txt给出的是作者的经验和几类合成输入。本文没有找到公开、可复现的大规模测量,说明生产环境中排序输入的 run 数、run 长度分布和重复键比例。 - 多路合并与存储层次。 Multiway Powersort 在作者的实验里有明显加速,但标准库要不要为此放弃 2 路合并的简单性,取决于元素大小、比较代价和缓存层次;本文核对的 CPython、OpenJDK、V8 源码都仍是 2 路合并。
十、工程陷阱与选型
| 陷阱 | 后果 | 做法 |
|---|---|---|
Java 比较器违反全序(如用 a - b
比较会溢出的整数,或比较浮点数时忽略 NaN) |
某些输入上 Collections.sort 抛
IllegalArgumentException,与数据有关,难以复现 |
用
Comparator.comparing、Integer.compare、Double.compare
组合比较器 |
Rust 用 partial_cmp().unwrap()
或手写的非全序 Ord 排序 |
1.81 起可能 panic | 浮点数用 f64::total_cmp;给
Ord 实现写全序性质测试 |
| 移植 TimSort 时照抄”按斐波那契增长推算”的固定小栈 | 原始合并规则下不变量不保证成立,栈会溢出(Java 2015 年与 2018 年两次踩中) | 用修复后的 merge_collapse(),或直接用
powersort,栈开 \(\lfloor \lg n
\rfloor + 1\) 格 |
在 key 函数或 __lt__
里修改正在排序的列表 |
CPython 抛
ValueError: list modified during sort |
先复制,或先算出键再排序 |
以为 Arrays.sort(int[]) 也是 TimSort |
基本类型数组走 Dual-Pivot Quicksort,性能特征不同 | 需要按对象语义排序时用包装类型或
List.sort,并注意装箱开销 |
| 在内存紧张的场景排序大列表 | 随机输入下临时区会达到 \(n/2\) 个指针 | 预留内存;或对可接受不稳定的数据用原地的不稳定排序 |
| 只用随机数据测试排序性能 | 看不到 TimSort 的自适应收益,也看不到 galloping 的作用 | 至少加入有序、逆序、局部扰动、大量重复键几类输入,并同时记录比较次数 |
以为 reverse=True 会破坏稳定性 |
不会:CPython 先反转列表、稳定排序、再反转,相等元素保持原次序 | 需要多键排序时,按次要键到主要键的顺序多次稳定排序即可 |
选型上,按比较代价和是否需要稳定来选:
| 场景 | 常见选择 | 决定性约束 |
|---|---|---|
动态语言的通用 sort |
TimSort 或 powersort 系(CPython、V8) | 比较要调用用户代码,比较次数主导耗时,语义上要求稳定 |
| JVM 对象排序 | TimSort(Tim 规则加修复) | 稳定性是 API 契约;兼容已有的比较器行为 |
| 基本类型数组 | Dual-Pivot Quicksort(Java)、ipnsort(Rust
sort_unstable) |
稳定性不可观察,数据移动和分支预测主导耗时 |
| 系统语言的稳定排序 | driftsort(Rust sort)、Swift 的无
galloping 版本 |
比较可内联,数据移动与分支预测的代价更突出 |
| 数据装不进内存 | 外部归并排序 | I/O 次数主导,见站内 外部排序 |
最后是三条判断,依据都在前文:
- TimSort 的核心是自然 run,不是 galloping。 有序、逆序、单峰输入上的 \(n - 1\) 与 \(2n - 2\) 次比较来自 run 检测和一次合并;galloping 只在”一侧连续胜出”时起作用,随机输入上几乎为零。
- 合并顺序的最初版本是启发式,后来被理论取代。
Tim 的不变量在实践中表现不错,但它的正确维护花了 13
年,它的最坏常数是 \(\frac{3}{2}\);powersort
用二十来行的
powerloop()给出了 \(n\mathcal{H} + 2n\) 的保证。 - 所有设计都以”比较很贵”为前提。 在这个前提成立的 CPython 和 JavaScript 里,TimSort 及其后继是好的默认;在比较很便宜的系统语言里,快速排序与 run 检测的混合更常见。
十一、参考资料
规范与文档
- Python Software Foundation, “What’s New in Python
2.3”:
list.sort()重写。 - Rust 标准库文档
slice::sort、slice::sort_unstable(1.80.0、1.81.0);“Announcing Rust 1.81.0”(2024-09-05)。
源码
- CPython
Objects/listobject.c与Objects/listsort.txt,tag v3.10.0、v3.11.0、v3.12.0、v3.13.0、v3.14.0、v3.15.0rc2:count_run()、binarysort()、merge_compute_minrun()、minrun_next()、merge_collapse()、powerloop()、found_new_run()、merge_force_collapse()、merge_at()、merge_lo()、merge_hi()、gallop_left()、gallop_right()、merge_getmem()、list_sort_impl()。 - CPython 2.7.9/2.7.10、3.4.3/3.4.4 的
merge_collapse()对比(bpo-23515);GH-28108(powersort,bpo-34561)。 - OpenJDK
src/java.base/share/classes/java/util/TimSort.java(jdk7、jdk-10-ga、jdk-11-ga、jdk-21):提交 6804124 “Easy port of timsort from android”;JDK-8011944;JDK-8072909;JDK-8203864。java/util/Arrays.java、DualPivotQuicksort.java。 - V8
third_party/v8/builtins/array-sort.tq;提交 8899b945f6b9 “[builtins] Sorting: TimSort –> PowerSort”(2026-04-20)。 - Swift
stdlib/public/core/Sort.swift(4.2、5.0、6.0)。
核心论文
- S. de Gouw, J. Rot, F. S. de Boer, R. Bubel, R. Hähnle, “OpenJDK’s Java.utils.Collection.sort() Is Broken: The Good, the Bad and the Worst Case”, CAV 2015, LNCS 9206.
- N. Auger, V. Jugé, C. Nicaud, C. Pivoteau, “On the Worst-Case Complexity of TimSort”, ESA 2018, LIPIcs 112;扩展版 arXiv:1805.08612v3(2019)。
- J. I. Munro, S. Wild, “Nearly-Optimal Mergesorts: Fast, Practical Sorting Methods That Optimally Adapt to Existing Runs”, ESA 2018, LIPIcs 112, 63:1–63:15;arXiv:1805.04154。
其他论文
- P. McIlroy, “Optimistic Sorting and Information Theoretic Complexity”, SODA 1993, pp. 467–474.
- E. D. Demaine, A. López-Ortiz, J. I. Munro, “Adaptive Set Intersections, Unions, and Differences”, SODA 2000.
- K. Mehlhorn, “A best possible bound for the weighted path length of binary search trees”, SIAM Journal on Computing 6(2), 1977.
- V. Estivill-Castro, D. Wood, “A survey of adaptive sorting algorithms”, ACM Computing Surveys 24(4), 1992.
- J. Barbay, G. Navarro, “On compressing permutations and adaptive sorting”, Theoretical Computer Science 513, 2013.
- N. Auger, C. Nicaud, C. Pivoteau, “Merge Strategies: from Merge Sort to TimSort”, 技术报告 hal-01212839, 2015.
- S. Buss, A. Knop, “Strategies for Stable Merge Sorting”, SODA 2019;arXiv:1801.04641。
- S. de Gouw, F. S. de Boer, R. Bubel, R. Hähnle, J. Rot, D. Steinhöfel, “Verifying OpenJDK’s sort method for generic collections”, Journal of Automated Reasoning, 2017.
- A. Elmasry, A. Hammad, “Inversion-sensitive sorting algorithms in practice”, ACM Journal of Experimental Algorithmics 13, 2009.
- V. Jugé, “Adaptive Shivers Sort: An Alternative Sorting Algorithm”, SODA 2020;arXiv:1809.08411。
- W. Cawley Gelling, M. E. Nebel, B. Smith, S. Wild, “Multiway Powersort”, ALENEX 2023;arXiv:2209.06909。
工程资料
- S. Zünd, “Getting things sorted in V8”, V8 博客, 2018-09-28。
实验
reproduce/timsort_count.c:第二、三、四、五、七、八节全部比较次数、minrun 表、栈演变与合并代价模拟的来源。reproduce/py_count.py:用真实 CPython 校验比较次数。reproduce/plot_compares.py、reproduce/draw_figures.py:本文插图。
系列导航: - 下一篇:pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
相关阅读: - 外部排序:从 I/O 下界到 PostgreSQL 与 GNU sort - 排序基准测试:比较次数、分支预测与输入分布 - 并行排序:排序网络、并行归并、样本排序与 GPU 基数排序
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
排序算法专题:从 TimSort 到并行排序
把 TimSort、pdqsort、radix sort、external sort、parallel sort 与 benchmark 串成一条阅读路径。先读哪篇、什么时候选哪种排序,这一页讲清。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
外部排序:从 I/O 下界到 PostgreSQL 与 GNU sort
从 Aggarwal–Vitter 的 I/O 下界出发,用可复现实验比较替换选择与快排生成 run、败者树与堆的比较次数、多阶段与平衡归并的搬运量,再对照 PostgreSQL 18 与 GNU sort 9.11 源码说明今天为何多用快排、平衡归并和堆。
排序基准测试:比较次数、分支预测与输入分布
在 GCC 16 上对 9 种 int32 排序做精确比较计数与绑核计时(8 种输入分布、3 个进程取中位数):比较次数预测不了耗时,分支预测与输入结构决定排名;反复排序同一数组会把小数组耗时低估 2 到 6 倍。