“哪个排序最快”通常有两种回答。一种来自教科书:比较排序的下界是
\(\Omega(n\log
n)\),比较次数越少越好。另一种来自博客里的 benchmark
表格:某个算法在某台机器上排第一。两种回答都经不起推敲。对
int32_t
来说,一次比较只要一条指令,决定耗时的往往是比较结果能不能被分支预测器猜中;而一张没有交代输入分布、编译参数和噪声的表格,换一台机器、换一种输入,排名就可能倒过来。
本文用同一套程序回答三个问题:
- 在 8 种输入分布上,各算法实际做了多少次比较?这个指标与时钟无关,可以精确复现。
- 比较次数与实际耗时的关系有多紧?
- 写排序 benchmark 时,哪些做法会系统性地得出错误数字?
所有数字都来自同目录下的
reproduce/:sort_bench.cpp
负责计数与计时,introsort_probe.cpp 探查
libstdc++ 的深度限制,run.sh
一键重跑,summarize.py
汇总,plot_figures.py
画图。本文不讨论多线程排序(见上一篇并行排序),也不讨论字符串、大对象或外部排序。
一、测什么、怎么测
环境
| 项目 | 值 |
|---|---|
| CPU | 12th Gen Intel Core i9-12900K,WSL2 虚拟机内可见 24 个逻辑 CPU(12 核 × 2 线程) |
缓存(lscpu) |
L1d 48 KiB/核,L2 1.25 MiB/核,L3 30 MiB 共享 |
| 内存 | WSL2 内可见 31 GiB(free -g) |
| 内核 | 6.6.87.2-microsoft-standard-WSL2 |
| 编译器与库 | GCC 16.1.1(libstdc++ 同版本),glibc 2.43 |
| 编译参数 | -std=c++20 -O2 -Wall -Wextra,不加
-march=native |
| 绑核 | taskset -c 12;逻辑 CPU 12 与 13
是同一物理核的两个超线程 |
计时期间机器上还有十几个其他任务在跑,CPU 13 也分配给了其他任务;它一旦忙起来,就会与本实验共享同一个物理核的执行单元和 L1/L2。WSL2 里也无法关闭睿频或固定频率。所以计时结果只用来看相对趋势和数量级;需要精确复现的结论都用第二节的比较次数来支撑。
算法
| 名称 | 来源 | 类型 |
|---|---|---|
std::sort |
libstdc++ 16.1.1 | introsort:三数取中快排,深度上限 \(2\lfloor\log_2 n\rfloor\),超限退回堆排序,最后做一次插入排序 |
std::stable_sort |
libstdc++ 16.1.1 | 归并排序:先对长度 7 的块做插入排序,再用临时缓冲区逐层归并 |
heapsort |
libstdc++ 的 std::make_heap +
std::sort_heap |
堆排序 |
pdqsort |
orlp/pdqsort,提交 b1ef26a |
pattern-defeating quicksort,普通分区 |
pdqsort_branchless |
同上,pdqsort_branchless() |
同一算法,BlockQuicksort 式无分支分区 |
timsort |
timsort/cpp-TimSort v3.0.1 | TimSort,mergeCollapse() 已包含 de Gouw
等人(2015)提出的合并栈不变量修正 |
radix_lsd |
本文自写 | LSD 基数排序,8 位一趟共 4 趟,需要 \(n\) 个元素的额外空间;某一趟所有键的该字节相同就跳过 |
american_flag |
本文自写 | 原地 MSD 基数排序(American flag sort),8 位一趟,桶小于 32 个元素时改用插入排序 |
insertion |
本文自写 | 插入排序,只测 \(n \le 10^4\) |
有两点要说明。第一,orlp 的 pdqsort()
会自己选分区方式:比较器是
std::less/std::greater、元素是算术类型时走无分支版本,否则走普通版本(pdqsort.h
中的 is_default_compare 分派)。表中的
pdqsort 行传入了一个 lambda
比较器,强制走普通分区;两行是同一个算法的两种分区实现。第二,两个基数排序都是本文自写的参考实现。american_flag
按 McIlroy、Bostic 和
McIlroy(1993)描述的”先计数、再循环置换回家”实现,不是
Skarupke 的 ska_sort;本文没有测试原版
ska_sort,因此不对它下结论。
第三方头文件由 run.sh 按固定提交下载并校验
SHA-256,不放进仓库。
输入分布
所有输入都用 std::mt19937_64 生成,主种子
42。
| 名称 | 构造 |
|---|---|
uniform |
全 int32_t 范围均匀随机 |
few_unique |
\(\lfloor\sqrt{n}\rfloor\) 个不同值(\(n=10^6\) 时 1000 个),均匀随机 |
sorted |
\(0, 1, \ldots, n-1\) |
reverse |
\(n-1, \ldots, 1, 0\) |
nearly_sorted |
有序数组上做 \(n/100\) 次随机位置交换 |
sorted_append |
前 99% 有序,末尾追加 1% 的随机值,模拟”有序日志后追加一批新记录” |
runs32 |
均匀随机后切成 32 段,每段各自排好序 |
pipe_organ |
先升后降:\(0, 1, \ldots, n/2, \ldots, 2, 1\) |
计时方法
一次计时采样的流程如下:
flowchart LR
    A["pristine buffer:<br/>batch x n elements,<br/>each array a distinct draw"] -->|"memcpy (not timed)"| B[work buffer]
    B --> C["timed loop:<br/>sort each of the batch arrays"]
    C --> D["ns per sort =<br/>elapsed / batch"]
B -.->|"warm-up sample only"| E["verify against<br/>std::sort result"]- 小数组单次排序只有几十纳秒,所以把 \(\text{batch} = \max(1, \lfloor 2^{18}/n \rfloor)\) 个数组放进同一个计时窗口,再除以 batch。每个计时窗口处理约 1 MiB 数据。
- batch 里的每个数组都用不同种子单独生成。第六节会说明,如果反复排序同一个数组,小数组的耗时会被低估 2 到 6 倍。
- 拷贝输入不计时;每格先做一次预热采样,并用它校验结果与
std::sort的输出逐元素相同。 - \(n \le 10^5\) 时每格采样 11 次,\(n = 10^6\) 时 7 次,\(n = 10^7\) 时 5 次。整个程序作为 3 个独立进程先后运行(3 轮)。文中引用的数字是 3 轮各自中位数的中位数。
- 正确性另有
--mode test:9 种算法 × 8 种分布,覆盖 \(n = 0\) 到 300 的每个长度以及若干较大长度,外加INT32_MIN/INT32_MAX极值,共 66,480 个用例。用-fsanitize=address,undefined和-O2各跑一遍,全部通过。
噪声有多大
summarize.py 对 107
个计时格统计了两种离散度:
| 指标 | 中位数 | p90 | 最大值 |
|---|---|---|---|
| 单轮内的四分位距 / 中位数 | 4.1% | 9.1% | 22.3% |
| 3 轮中位数的极差 / 中位数 | 14.0% | 43.8% | 103.8% |
同一进程内的采样很稳定,不同进程之间却可能差一倍。最差的一格是
pdqsort 排 sorted:3
轮的中位数分别是 0.332、0.346 和 0.691 ms,第 3
轮显然撞上了邻核干扰。只跑一个进程、在进程内部重复采样,会同时低估噪声、高估精度。
本文因此只采信两类计时结论:一类是 3
轮排名一致的结论,另一类是倍数远大于噪声的结论(下文据以下结论的倍数都在
1.5 倍以上,且 3
轮方向一致;差距小于这个量级的,只写”相差不大”)。实际情况是:在
\(n=10^6\) 的 8
种分布上,第一名在 3 轮中完全相同;前三名只有
sorted、sorted_append 和
runs32 这三种分布的第二、三名在某一轮互换。
二、与时钟无关的指标:比较次数
比较次数是确定的:给定输入和实现,每次运行都得到同一个数,不受频率、邻核和调度影响。--mode count
给每个比较排序套上一个计数比较器,在 \(n = 10^6\) 上连续运行 3
次,输出逐字节相同。
参照线是信息论下界。\(n\) 个互不相同的元素有 \(n!\) 种排列,每次比较最多把候选排列数减半,所以最坏情况和平均情况都至少需要
\[ \log_2 n! = n\log_2 n - n\log_2 e + O(\log n) \]
次比较。\(n = 10^6\) 时 \(\log_2 n!/n \approx 18.49\),而 \(\log_2 n \approx 19.93\)。
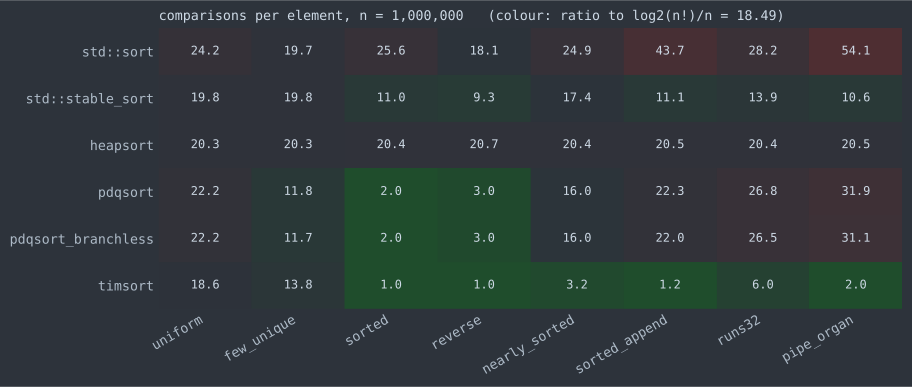
图中数字是每元素比较次数,颜色是它与 18.49 的比值(对数色阶)。几个值得逐一说明的格子:
| 分布 | std::sort |
std::stable_sort |
heapsort |
pdqsort |
pdqsort_branchless |
timsort |
|---|---|---|---|---|---|---|
uniform |
24.21 | 19.82 | 20.29 | 22.16 | 22.20 | 18.63 |
few_unique |
19.75 | 19.82 | 20.29 | 11.80 | 11.67 | 13.82 |
sorted |
25.60 | 11.02 | 20.40 | 2.00 | 2.00 | 1.00 |
sorted_append |
43.72 | 11.10 | 20.51 | 22.32 | 22.03 | 1.25 |
runs32 |
28.20 | 13.89 | 20.43 | 26.83 | 26.54 | 6.00 |
pipe_organ |
54.11 | 10.65 | 20.48 | 31.86 | 31.09 | 2.00 |
(每元素比较次数,\(n=10^6\);8 种分布的完整数据见
results/counts.csv。)
随机输入上,TimSort 离下界最近。 18.63
只比 18.49 多 0.8%。它在随机输入上找不到长
run,退化成”二分插入排序生成长度为 minrun
的短段,再逐层归并”。二分插入和归并都接近最优比较数。std::sort
的 24.21
对应三数取中快排的期望值:Sedgewick(1977)给出的主项是
\(\frac{12}{7} n\ln n \approx
1.188\, n\log_2 n\),\(n =
10^6\) 时约为每元素 23.7
次,与实测在同一水平;精确的低阶项还取决于小区间截断阈值和最后一趟插入排序,这里不展开。
libstdc++ 的堆排序约为 \(n\log_2 n\),不是教科书上的
\(2n\log_2 n\)。
教科书的下滤每层要比较两次:先比较两个孩子,再与父节点比较。libstdc++
的
__adjust_heap()(bits/stl_heap.h)每层只比较两个孩子,直接把空位下移到叶子,再用
__push_heap()
向上回填。这种”先沉到底、再上浮”的变体通常称为自底向上堆排序(bottom-up
heapsort)。Wegener(1993)分析过它,平均比较次数约为 \(n\log_2 n\);原始的堆排序出自
Williams(1964)。所以 heapsort
在所有分布上都稳定在 20.3 到 20.7
之间,对输入结构完全不敏感。
自适应排序在有序结构上的收益是数量级的。
TimSort 在 sorted 和 reverse
上各只比较 \(n-1\)
次:扫描一遍认出整段 run,反转降序 run 不需要比较。在
runs32 上是 6.00:先用约 \(n\) 次比较识别出 32 个
run,再做 \(\log_2 32 = 5\)
层平衡归并,每层约 \(n\)
次。这正好对应”按 run 长度计算的熵”\(n\mathcal{H}\)
这一类自适应下界(McIlroy 1993;Munro & Wild
2018)。pdqsort 在 sorted 上是 2.00、在
reverse 上是
3.00:它发现分区时一个元素都没动,就对两侧尝试”部分插入排序”,最多移动
8 个元素,成功就直接返回。
std::sort
在两种常见的结构化输入上比随机输入做了更多比较:pipe_organ
54.11,sorted_append 43.72,而
uniform 只有
24.21。原因在枢轴选择。__unguarded_partition_pivot()
从 first + 1、中点、last - 1
三个位置取中位数(bits/stl_algo.h)。在
pipe_organ 上这三个值是 1、500000、1,中位数是
1,第一次分区几乎什么都分不出去。introsort_probe.cpp
用同一个内部函数 std::__introsort_loop()
做了对照:
| 输入 | 深度上限 38(std::sort 的默认值) |
深度无上限 |
|---|---|---|
pipe_organ |
53.09 + 1.02 | 74.23 + 3.07 |
sorted_append |
42.28 + 1.44 | 83.33 + 2.08 |
(每元素比较次数,“快排循环 + 最后一趟插入排序”。)
如果深度上限从未触发,两列应当相同;右列明显更大,说明在默认设置下,这两种输入都有子区间耗尽了深度、退回了堆排序。introsort
的保证只是”最坏 \(O(n\log
n)\)“(Musser
1997),并不承诺常数;这里的常数是随机输入的 2.2 倍。pdqsort
在同样的输入上是 31 左右:它对大于 128 个元素的区间用
ninther(九数取中)选枢轴,分区结果一侧不足 \(1/8\)
时(highly_unbalanced)会交换几对固定位置的元素来打破模式,因此受影响较小,但也没有完全免疫。
重复值多时,pdqsort
的比较次数降到约一半(few_unique 上
11.8 对 std::sort 的
19.75)。当新枢轴等于祖先区间用过的枢轴时,pdqsort 用
partition_left
把所有等于枢轴的元素一次性归到左边,此后不再参与排序。Peters(2021)据此证明:有
\(k\)
个不同值时,最坏耗时是 \(O(nk)\)。
三、随机输入:规模曲线
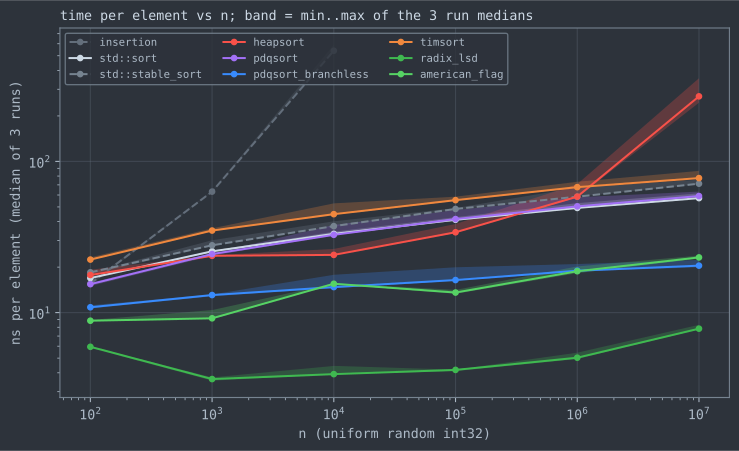
每元素耗时(ns,3 轮中位数):
| \(n\) | insertion |
std::sort |
stable_sort |
heapsort |
pdqsort |
pdqsort_bl |
timsort |
radix_lsd |
american_flag |
|---|---|---|---|---|---|---|---|---|---|
| \(10^2\) | 15.6 | 16.9 | 18.5 | 17.7 | 15.4 | 10.9 | 22.4 | 5.9 | 8.8 |
| \(10^3\) | 63.2 | 25.4 | 27.9 | 23.8 | 24.4 | 13.1 | 34.9 | 3.6 | 9.2 |
| \(10^4\) | 539.5 | 33.2 | 37.3 | 24.1 | 32.7 | 14.8 | 44.8 | 3.9 | 15.5 |
| \(10^5\) | 41.1 | 48.5 | 34.0 | 41.6 | 16.4 | 55.5 | 4.2 | 13.6 | |
| \(10^6\) | 49.3 | 58.4 | 58.5 | 50.4 | 18.9 | 67.6 | 5.0 | 18.8 | |
| \(10^7\) | 57.2 | 71.3 | 269.3 | 59.0 | 20.5 | 77.6 | 7.8 | 23.2 |
四个观察:
- 比较排序的每元素耗时大致随 \(\log n\) 线性增长,与
\(n\log n\)
的模型一致。\(n\) 每增大 10
倍,
std::sort每元素多出约 8 ns(7.8 到 8.5),pdqsort_branchless只多出 1.6 到 2.5 ns。 radix_lsd在所有规模上都最快。 \(n = 10^6\) 时 5.0 ns/元素,是std::sort的约 \(1/10\)(3 轮比值 9.1 到 10.5)。它的代价与 \(n\log n\) 无关,固定是 4 趟计数加分发。\(10^7\) 时升到 7.8 ns;此时输入数组加缓冲区共 80 MB,超过了 30 MiB 的 L3,这是最直接的解释,但本实验没有测缓存缺失。heapsort在 \(10^7\) 处从 58.5 跳到 269.3 ns/元素,涨了 4.6 倍,其他比较排序只涨了 8% 到 22%。节点 \(i\) 的孩子位于 \(2i+1\) 和 \(2i+2\),越往下层,父子在内存里相距越远;数据超出 L3 以后,下滤的几乎每一层都要访问一个新的缓存行。本实验没有采集缓存未命中计数,这是依据访问模式做的推断,但”数据量越过 L3 时才陡升”这一时间点与推断吻合。- 插入排序在 \(n =
100\) 时与
std::sort相当(15.6 对 16.9),到 \(10^3\) 已经慢了 2.5 倍。std::sort内部对 16 个元素以下的区间做插入排序(_S_threshold = 16),pdqsort 的阈值是 24。
四、输入分布改变排名
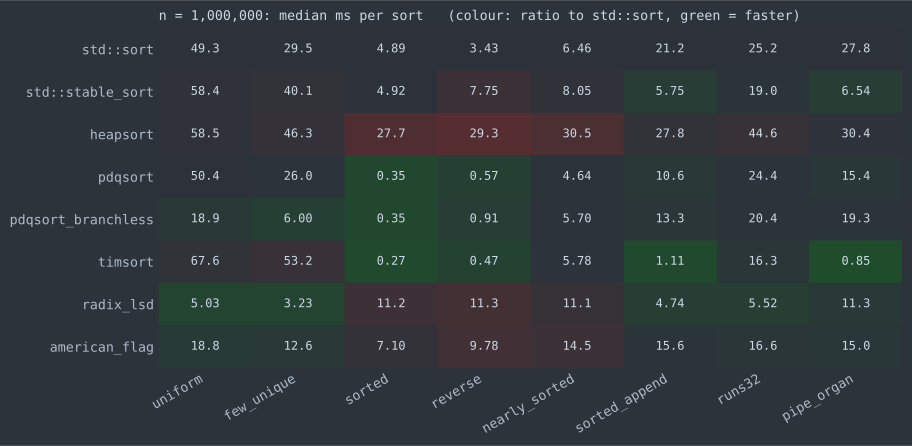
\(n = 10^6\),单位 ms,3 轮中位数:
| 分布 | std::sort |
stable_sort |
heapsort |
pdqsort |
pdqsort_bl |
timsort |
radix_lsd |
american_flag |
|---|---|---|---|---|---|---|---|---|
uniform |
49.3 | 58.4 | 58.5 | 50.4 | 18.9 | 67.6 | 5.03 | 18.8 |
few_unique |
29.5 | 40.1 | 46.3 | 26.0 | 6.00 | 53.2 | 3.23 | 12.6 |
sorted |
4.89 | 4.92 | 27.7 | 0.346 | 0.353 | 0.267 | 11.2 | 7.10 |
reverse |
3.43 | 7.75 | 29.3 | 0.573 | 0.906 | 0.470 | 11.3 | 9.78 |
nearly_sorted |
6.46 | 8.05 | 30.5 | 4.64 | 5.70 | 5.78 | 11.1 | 14.5 |
sorted_append |
21.2 | 5.75 | 27.8 | 10.6 | 13.3 | 1.11 | 4.74 | 15.6 |
runs32 |
25.2 | 19.0 | 44.6 | 24.4 | 20.4 | 16.3 | 5.52 | 16.6 |
pipe_organ |
27.8 | 6.54 | 30.4 | 15.4 | 19.3 | 0.850 | 11.3 | 15.0 |
没有一个算法在所有分布上都最快。第一名分成三组,3 轮完全一致:
- 没有顺序结构的输入(
uniform、few_unique,以及 run 较短的runs32)由radix_lsd赢,领先第二名 1.9 到 3.7 倍。 - 有长 run
的输入(
sorted、reverse、sorted_append、pipe_organ)由 TimSort 赢。sorted_append上它比std::sort快 19 倍:前 99% 是一个 run,末尾 1% 的随机值先被排成若干个 minrun 长度的段,再合并进来。 nearly_sorted由 pdqsort 赢,但领先不多。1% 的随机交换最多制造 \(2 \times 10^4\) 个错位元素,把长 run 切成平均只有几十个元素的碎片,TimSort 的比较次数仍然最少(每元素 3.16 次),但每一层归并都要搬动整个数组,耗时反而与 pdqsort 相当。
有三处结果与直觉不符:
std::stable_sort在sorted上和std::sort一样快(4.92 对 4.89 ms),但比 TimSort 慢 18 倍。libstdc++ 的归并排序不检测已有的 run,每层照常归并;在已排序数据上,每次归并都是一侧先耗尽,比较次数减半(每元素 11.02 次),但数据照样要搬动。radix_lsd在sorted、reverse、pipe_organ、nearly_sorted上约 11 ms,是uniform的 2.2 倍,3 轮都一样。这四种输入的键都落在 \([0, n)\) 的连续整数上,最高字节那一趟被跳过,工作量反而更少,时间却更长。sorted_append的前 99% 与sorted完全相同,却只要 4.74 ms。原因是 L1 缓存的组冲突,见本节末尾。std::sort在sorted_append上比较了更多次(第二节,每元素 43.7 对 24.2),用时却更短(21.2 对 49.3 ms)。下一节解释这一点。
基数排序在有序键上变慢:桶大小恰好是 2 的幂
先把慢的部分定位到具体哪一趟。reproduce/radix_conflict.cpp
的 --mode phases 对 radix_lsd
的直方图和每趟分发分别计时(绑核,21
次取均值,只看相对大小):uniform 上每趟分发约
1.1 ms;sorted 上第 1 趟(最低字节)只要 0.92
ms,第 2、3 趟却各要 4.1 到 4.3 ms;pipe_organ
只有第 2 趟慢(5.18 ms);sorted_append
每趟都在 0.8 到 1.1 ms。同一组调用里还用
getrusage 数了缺页:变慢的三种分布是 0
次,反倒是不慢的 uniform 有 976
次,所以变慢与内存分配无关。
慢的那几趟有一个共同点:桶的大小是 2 的幂,或者接近 2 的幂。键是 \(0, 1, \ldots, 10^6 - 1\) 时:
- 第 2 字节(位 8 到 15)的取值 \(c\) 对应 \(\lfloor v/256 \rfloor \bmod 256 = c\) 的所有 \(v\)。\(c < 66\) 的桶正好 4096 个元素,\(c > 66\) 的桶 3840 个。前 67 个桶的起点相距 \(4096 \times 4 = 16\) KiB,是 4 KiB 的整数倍;其余的桶相距 15 KiB,只在 4 个位置上轮换。
- 第 3 字节(位 16 到 23)只有 16 个取值,前 15 个桶各 65536 个元素,起点相距 256 KiB。
L1 用地址的第 6 到 11 位选组,这几位只取决于地址对 4 KiB
取模的结果(本机 L1d 为 48 KiB、12 路、64 组,读自
/sys/devices/system/cpu/cpu12/cache/index0/)。起点相距
4 KiB
整数倍的桶,写指针落在同一个组里。键又是按顺序排好的,所有桶的写指针同步前进,于是第
2 趟有 67 条写流同时争抢一个只有 12 路的组,其余 189
条分在另外 4 个组里,每组 47 或 48 条,同样远超 12
路;每写一次,都会把另一条流还没写满的缓存行挤出去。第 1
趟的桶大小是 3906 或 3907,不是 2 的幂,起点散在 64
个组里,不受影响。
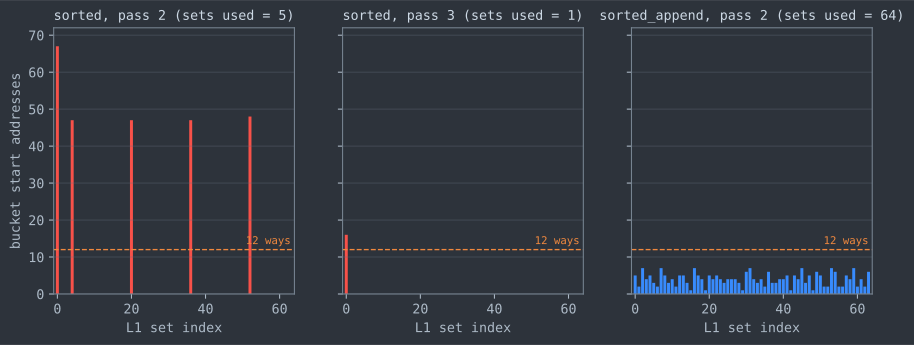
图中红柱表示该组的写流数超过了 12
路。sorted_append 末尾那 1%
的随机值给每个桶加了几十到几百个元素,把起点打散了。pipe_organ
的值几乎都出现两次,第 2 字节的桶是 4096 或 3584
个元素,同样撞组;它的第 3 字节只有 8 个桶,8 条流没有超过
12 路,所以只慢在第 2 趟。
reproduce/radix_conflict.cpp
从两个方向验证这个解释。--mode sim
把每一趟分发的写地址回放进上述 L1
模型(LRU、写分配、只计写)。这个模型与时钟无关,结果是确定的。--mode time
把同一份代码只改一处,在每个桶后面空出 16 个元素(下表
gap16),和不空(gap0)对比。
| 分布 | 第 2 趟桶起点所在的组数 | 第 3 趟桶起点所在的组数 | 模拟 L1 写缺失/元素(第 1、2、3 趟) | gap16 后(第 1、2、3 趟) |
|---|---|---|---|---|
uniform |
62 | 63 | 0.063、0.063、0.063 | 0.063、0.063、0.063 |
sorted |
5 | 1 | 0.063、1.000、1.000 | 0.063、0.063、0.063 |
sorted_append |
64 | 15 | 0.063、0.063、0.063 | 0.063、0.063、0.063 |
pipe_organ |
4 | 2 | 0.063、0.983、0.063 | 0.063、0.063、0.063 |
每元素 0.0625 次是写分配的下限:一个 64 字节的缓存行装 16
个
int32_t,只在第一次写入时缺失。sorted
的第 2、3 趟每写一个元素就缺失一次,是下限的 16
倍(uniform 还有第 4 趟,表中省略,也是
0.063)。
| 分布 | radix_lsd(ms) |
gap0(ms) | gap16(ms) |
|---|---|---|---|
uniform |
4.80 | 7.38 | 7.66 |
sorted |
11.21 | 13.65 | 6.63 |
sorted_append |
4.40 | 6.74 | 6.81 |
pipe_organ |
8.59 | 13.00 | 6.81 |
(3 个进程各 11 次采样,中位数的中位数,绑 CPU 12。gap0
和 gap16
用两块带间隔的缓冲区,最后还要按桶拷回原数组,所以比
radix_lsd 本身慢;只比较同一行里 gap0 与 gap16
的差别。这张表是另外一次运行的结果,绝对值与上面的主表不同。)
只改间隔,sorted 从 13.65 ms 降到 6.63
ms,pipe_organ 从 13.00 降到 6.81
ms,uniform 和 sorted_append
几乎不变。本机的 WSL2
没有暴露硬件性能计数器,所以这里用的是”组冲突模型 +
只改一个变量的对照”,而不是实测缺失数。这个现象给基准测试提了个醒:输入值域”太整齐”,同样会制造特殊的性能行为,而且与算法的比较次数、分支预测都无关。
五、比较次数不能预测耗时
把第二节的比较次数和第四节的耗时放在同一张图上:
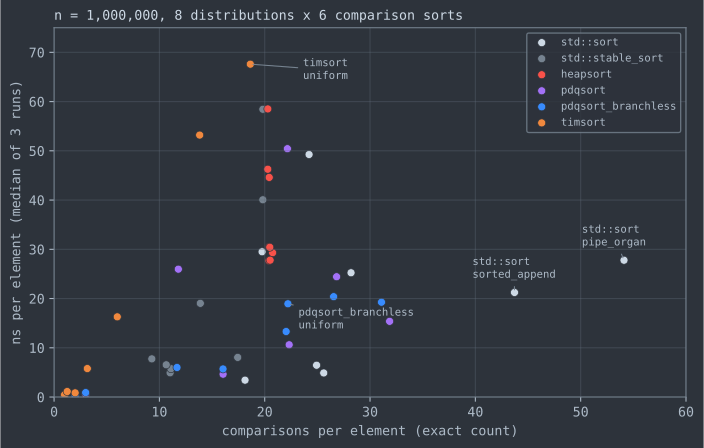
如果”比较次数 × 单次比较代价”是好模型,这些点应当落在一条过原点的直线附近。实际上它们没有单调关系。最能说明问题的是三组对照:
| 对照 | 每元素比较次数 | ms |
|---|---|---|
uniform:pdqsort 对
pdqsort_branchless |
22.16 对 22.20 | 50.4 对 18.9 |
uniform:timsort 对
std::sort |
18.63 对 24.21 | 67.6 对 49.3 |
std::sort:sorted_append 对
uniform |
43.72 对 24.21 | 21.2 对 49.3 |
第一组是同一个算法、同一个枢轴规则,比较次数几乎相同,耗时差
2.7 倍,唯一的区别是分区循环怎么写。普通版本(orlp/pdqsort
b1ef26a,pdqsort.h,partition_right(),删减):
while (first < last) {
    std::iter_swap(first, last);
    while (comp(*++first, pivot));
    while (!comp(*--last, pivot));
}每次比较的结果决定循环是否继续。在随机输入上,枢轴接近中位数,每个比较结果都接近五五开,分支预测器基本只能靠猜。无分支版本(同一文件,partition_right_branchless(),只保留左半块、删去循环展开):
for (size_t i = 0; i < block_size;) {
    offsets_l[num_l] = i++; num_l += !comp(*first, pivot); ++first;
}
比较结果不再控制跳转,而是变成一个 0 或
1,加到偏移计数上。一个块(block_size = 64)扫完之后,再按记下的偏移成对交换。循环的次数固定,分支总能预测对;代价是多写一个偏移数组。源码注释说明这段代码源自
Edelkamp 与 Weiß 的 BlockQuicksort。
这一现象最早由 Kaligosi 与 Sanders(ESA
2006)系统分析:枢轴越接近中位数,比较次数越少,但分支越难预测;故意选偏离中位数的枢轴,反而可能更快。Edelkamp
与 Weiß(ESA 2016,期刊版 ACM JEA
2019)的思路是把控制流和数据流分开,让比较结果根本不经过分支,并在随机整数上报告比
GCC std::sort 快
80%(论文数据,硬件与编译器版本与本文不同,不可直接比较)。本文测得的
2.6 倍(std::sort 对
pdqsort_branchless,3 轮比值 2.53 到
2.61)方向一致。
第二组里,TimSort
比较得最少,却是比较排序里最慢的。随机输入上它每层归并都要把一侧拷进临时缓冲区,“谁先输出”这个判断同样无法预测;galloping
模式在随机数据上也很少触发。对 int32_t
这种比较只要一条指令的类型,数据搬运和分支预测失败才是主要开销。反过来,如果比较本身很贵(字符串、Python
对象、通过函数指针调用的比较器),TimSort
省下的比较就会直接转化为时间,这也是 CPython 和 Java
对象数组选它的原因。本文只测了
int32_t,不能用这里的数据评价那种场景。
第三组说明同样的道理可以反向成立。sorted_append
的前 99%
已经有序,分区时绝大多数比较结果相同,分支几乎总能预测对。所以即使深度上限耗尽、退回了堆排序,总时间也只有随机输入的
43%。
六、benchmark 本身的陷阱
反复排序同一个数组
排小数组时,常见的写法是准备一份输入,在循环里”拷贝、排序”几千次。--mode pitfall
把这种写法与”每次用不同输入”做了对照:batch 为
4096,两种写法唯一的区别是 4096
个数组是否由同一个种子生成。
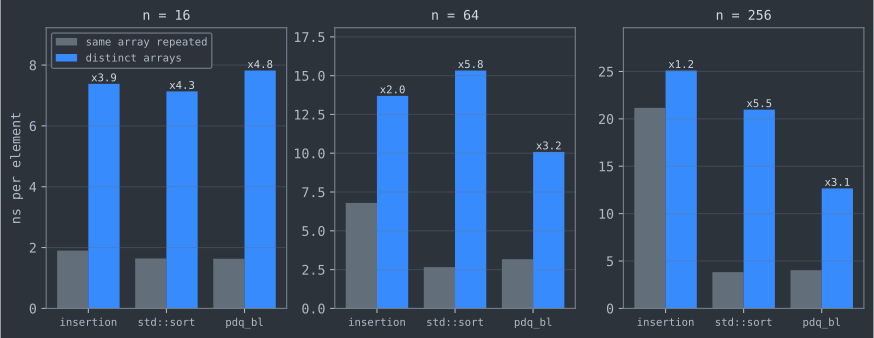
| \(n\) | 算法 | 同一数组(ns/次) | 不同数组(ns/次) | 倍数 |
|---|---|---|---|---|
| 16 | insertion |
30.4 | 118.1 | 3.9 |
| 16 | std::sort |
26.3 | 114.1 | 4.3 |
| 16 | pdqsort_branchless |
26.1 | 125.1 | 4.8 |
| 64 | insertion |
435.1 | 876.7 | 2.0 |
| 64 | std::sort |
170.0 | 981.2 | 5.8 |
| 64 | pdqsort_branchless |
202.8 | 645.4 | 3.2 |
| 256 | insertion |
5416.0 | 6425.4 | 1.2 |
| 256 | std::sort |
979.1 | 5368.5 | 5.5 |
| 256 | pdqsort_branchless |
1031.6 | 3241.6 | 3.1 |
反复排序同一个数组,每一次执行的分支序列完全相同,现代分支预测器能在几轮之后把它记住,于是测到的是”已经背熟答案”的速度。这个误差不是几个百分点,而是
2 到 6
倍,而且各算法受影响的程度不同,足以改变排名:在”同一数组”的写法下,\(n=64\) 时
std::sort 比 pdqsort_branchless
快,换成不同数组后结论反过来。\(n\)
增大时,插入排序的误差最先缩小,因为它的分支大多是”继续向左移”,本来就容易预测。
进程间噪声与估计量之争
第一节已经给出,本环境里进程间的差异(中位数 14%,最坏 104%)远大于进程内的差异(中位数 4%)。Mytkowicz 等人(ASPLOS 2009)说明了更隐蔽的一类偏差:环境变量的总长度、目标文件的链接顺序都会改变栈和代码的对齐,从而系统性地改变测量结果,而且多次运行也消除不了,因为每次运行的布局相同。本文没有随机化链接顺序和环境,这是一个已知的局限。
该用哪个统计量,学界并没有一致意见。Chen 与 Revels(arXiv
1608.04295,预印本)认为,对确定性的基准程序,外部干扰只会让时间变长,因此最小值是一个单峰、稳健的估计量,他们在
Julia 的 BenchmarkTools 里用最小值判断性能回退。Kalibera 与
Jones(ISMM
2013)则主张在”进程、迭代”等多个层次上安排重复,并报告带置信区间的效应大小,而不是只取单个数字。本文默认用中位数,同时在
results/time_summary.csv
里保留了最小值。在本文的数据上,两种估计量的结论基本一致:\(n=10^6\) 的 8 种分布里有 7
种的前三名完全相同;唯一的例外是 uniform,其中
american_flag 与
pdqsort_branchless 相差不到
1%,两个估计量给出的先后相反。std::sort 与
pdqsort_branchless 的比值,用中位数算是
2.60,用最小值算是 2.70。
其他几条
- 编译器优化:排序结果之后会被校验,本来就不会被删除;计时循环前后仍各加了一道
asm volatile("" : : "g"(p) : "memory")屏障,防止拷贝和排序被重排到计时区间之外。 - 正确性先于速度:本文每格计时都先校验一次输出。一个错误的”快排”可能恰好更快。
- 输入值域:基数排序的趟数取决于键的实际位宽,而本文的
radix_lsd会跳过所有键该字节都相同的那一趟。如果测试数据只取 \([-2n, 2n]\) 这样的窄值域,就会高估它在真实 32 位键上的表现。本文的uniform取全int32_t范围。反过来,\(0, 1, \ldots, n-1\) 这种过于整齐的键会让桶大小变成 2 的幂,引发第四节末尾的 L1 组冲突,又会低估它。
七、谱系与开放问题
三条谱系
本文测到的 8 个实现来自三条谱系,每条都能追到具体的论文或设计文档:
- 快速排序系:Hoare(1962)提出快排。Bentley
与 McIlroy(1993)为 Unix
qsort做的工程化引入了 ninther 选枢轴和三路分区。Musser(1997)的 introsort 加上深度上限和堆排序兜底,把最坏情况限制在 \(O(n\log n)\),这就是 libstdc++std::sort至今的结构。Edelkamp 与 Weiß(2016)的 BlockQuicksort 去掉了分区里依赖数据的分支。Peters 的 pdqsort(arXiv 2106.05123,预印本)综合了这些技术,并加入有序检测和等值分区。Go 1.19 的sort包和 Rust 1.20 至 1.80 的slice::sort_unstable都基于它,但分区方式不同。Go 的注释写明”没有采用 BlockQuicksort 的优化”,相当于本文的pdqsort行(Go 1.19src/sort/zsortfunc.go);Rust 1.80 对所有类型都用块分区partition_in_blocks(),更接近pdqsort_branchless行(library/core/src/slice/sort.rs)。两者的差别见pdqsort 一文。Rust 1.81 则改为 Bergdoll 与 Peters 的 ipnsort。 - 归并排序系:P. McIlroy(SODA
1993)用信息论复杂度刻画”利用已有顺序”的排序。Tim Peters
2002 年为 CPython 写 TimSort 时,在设计文档
Objects/listsort.txt里写道,McIlroy 论文中的归并排序在 galloping 策略上与 TimSort”很可能密切相关”。自适应排序该用哪种”有序程度”度量,Estivill-Castro 与 Wood(1992)的综述做了系统整理。de Gouw 等人(CAV 2015)在做形式化验证时发现,Java 版合并栈的不变量检查不完整,会导致数组越界,并给出修复;本文用的 cpp-TimSort v3.0.1 的mergeCollapse()已包含这一检查。Munro 与 Wild(ESA 2018)的 powersort 给出了可证明接近最优的合并顺序,CPython 3.11 起改用 powersort 的合并策略(v3.11.0Objects/listsort.txt)。这条线的细节见TimSort 一文。 - 基数排序系:McIlroy、Bostic 与
McIlroy(1993)给出了三种按字节排序的实现,其中原地的
American flag sort 就是本文
american_flag的原型。它与 Skarupke 的 ska_sort 等后续变体的差别见基数排序一文。
争论一:代价模型该数什么
教科书按比较次数衡量排序,第二节的数据也确实与经典分析吻合。但第五节表明,对廉价比较来说,比较次数与耗时几乎无关。Kaligosi 与 Sanders 的结论是,应该把分支预测失败次数纳入代价模型。BlockQuicksort 和 pdqsort_branchless 则用实现手段把这一项压到接近零,让比较次数重新变得有意义。Edelkamp 与 Weiß 重做了偏斜枢轴实验(BlockQuicksort 论文 Figure 2,32 位随机整数):GCC 的 Hoare 分区确实受益于偏斜枢轴,块分区却在精确中位数附近最快。也就是说,“好枢轴”是好是坏,取决于分区循环怎么写。两种立场都有实测支撑,分歧在于:该优化算法(换一个预测失败更少的分区策略),还是该优化实现(让同一策略不产生可预测性问题)。Kaligosi 与 Sanders 在 2006 年把”找到比偏斜枢轴快排更快的原地排序”列为开放问题,BlockQuicksort 是对它的一个回答。
争论二:基数排序能不能当默认
本文的数据对基数排序很有利:uniform 上
radix_lsd 比最快的比较排序快 3.8
倍。但这个结论依赖三个前提,每一个都可能不成立:键是定长整数、可以直接取字节;允许
\(n\)
个元素的额外空间(american_flag 不需要,但在
uniform 上耗时是 radix_lsd 的 3.7
倍);输入没有顺序结构(sorted 上
radix_lsd 比 TimSort 慢 42
倍)。标准库的排序接口只拿到一个比较器,拿不到键的位表示,这是
C++、Rust、Go 的默认排序都只能是比较排序的一个直接原因。
即使只看性能,结论也有反方。Axtmann、Witt、Ferizovic 与
Sanders(ACM TOPC 2022)在 21 个排序实现、10 种输入分布、4
台机器上做了交叉比较,摘要写道:他们的比较排序 IPS⁴o
在很大范围的情形下胜过最好的整数排序,原地基数排序只在剩下的许多情形中最好,这些情形往往是接近均匀的分布、较短的键或单线程。本文的
uniform 恰好同时满足这三条,所以本文的 3.8
倍只说明”基数排序在它最擅长的区域里赢了”,不能外推成”基数排序更快”。该文摘要还提醒,许多论文都宣称自己的排序”最好”,这些说法不可能同时成立;这与第六节的方法论问题是同一件事。
开放问题
- 能否同时利用 run 和重复值。 pdqsort
只识别”整段有序”和”分区后未移动”这两种结构,在
runs32和nearly_sorted上与std::sort相差不大;TimSort 能利用 run,却在few_unique上比pdqsort_branchless慢 8.9 倍。第四节的 8 种分布里,没有一个实现在两类结构上都接近最优。 - 怎样的 benchmark 分布才算有代表性。 本文的 8 种分布是人工构造的,排名随分布变化。至于真实负载里各种结构占多大比例,本文没有找到公开的测量数据。
- 可移植的结论。 本文只在一种 CPU、一个编译器上测过。分支预测器、缓存大小和 SIMD 宽度都会改变第五节的倍数,而 Mytkowicz 等人指出,连同一台机器上的内存布局都会改变结果。
八、在本文口径下怎么选
以下建议只适用于单线程、内存内、int32_t
这类定长整数键:
| 情况 | 本文数据支持的选择 | 依据 |
|---|---|---|
| 不需要稳定,输入无明显结构 | pdqsort_branchless,或能取到键时用 LSD
基数排序 |
uniform 上分别比 std::sort 快
2.6 倍和 9.8 倍 |
| 输入常常已排序、逆序或”有序加追加” | TimSort 类自适应归并 | sorted_append 上比 std::sort
快 19 倍 |
| 需要稳定排序 | 有长 run 时用 TimSort;否则
std::stable_sort 与 TimSort 相差不大 |
uniform 上 58.4 对 67.6
ms,sorted 上 4.92 对 0.267 ms |
| 重复值很多 | pdqsort,或基数排序 | few_unique 上 6.00 ms 与 3.23
ms,std::sort 为 29.5 ms |
| 担心对抗性输入 | 任何带深度上限的 introsort 或 pdqsort,都不会退化到 \(O(n^2)\) | 第二节:std::sort 在
pipe_organ 上退回堆排序,比较次数只到随机输入的
2.2 倍 |
| 不要直接用 | 单独的堆排序 | 所有分布上都不是前三,数据超过 L3 后每元素耗时是
std::sort 的 4.7 倍 |
如果你的键是字符串、比较器很贵,或者数据来自真实系统,本文的倍数不能直接套用,需要用自己的数据按第六节的方法重测。
九、复现
cd post/algorithms/06-sort-bench/reproduce
CPU=12 PY=/tmp/mplenv/bin/python ./run.sh
run.sh
依次执行:下载并校验两个第三方头文件,编译普通版与
ASan/UBSan 版,运行 66,480 个正确性用例,统计比较次数,运行
introsort_probe 和
radix_conflict --mode sim,然后在
$CPU 上跑 3 轮计时、3 轮 pitfall 实验、3 轮
gap0/gap16 对照和一次分阶段计时,最后汇总并重画本文的 5
张图。构建产物放在 $WORK(默认
/tmp/sort-bench),不写入仓库。需要 GCC 13
及以上或其他支持 C++20 concepts 的编译器、Python 3 和
matplotlib。一轮计时约 50 秒。
results/ 下的文件:env.txt
是环境信息,counts.csv
是比较次数,introsort_probe.txt
是深度上限探针,time_run{1,2,3}.csv 和
pitfall_run{1,2,3}.csv
是全部原始采样,time_summary.csv 和
pitfall_summary.csv
是汇总;radix_conflict_sim.csv、radix_conflict_time_run{1,2,3}.csv、radix_conflict_phases.csv
对应第四节末尾的组冲突实验。比较次数、探针和组冲突模拟的输出在任何机器上都应逐字节相同(前提是使用同一版本的
libstdc++);计时数字不会相同,要比较的是倍数和排名。
十、参考资料
源码(均为本文实际编译或阅读的版本)
- libstdc++(GCC 16.1.1):
bits/stl_algo.h中的std::sort、__introsort_loop()、__unguarded_partition_pivot()、__final_insertion_sort()、_S_threshold、__stable_sort()、_S_chunk_size;bits/stl_heap.h中的__adjust_heap()、__push_heap()。 - orlp/pdqsort,提交
b1ef26a55cdb60d236a5cb199c4234c704f46726:pdqsort.h中的pdqsort_loop()、partition_right()、partition_right_branchless()、partition_left()、is_default_compare。 - timsort/cpp-TimSort
v3.0.1:
include/gfx/timsort.hpp中的mergeCollapse()。 - CPython
v3.11.0:
Objects/listsort.txt(powersort 合并策略)。 - Go 1.19:
src/sort/zsortfunc.go;Rust 1.80:library/core/src/slice/sort.rs;Rust 1.81:library/core/src/slice/mod.rs中sort_unstable的文档注释(ipnsort)。
核心论文
- C. A. R. Hoare, “Quicksort”, The Computer Journal 5(1), 1962.
- J. L. Bentley, M. D. McIlroy, “Engineering a Sort Function”, Software: Practice and Experience 23(11), 1993.
- D. R. Musser, “Introspective Sorting and Selection Algorithms”, Software: Practice and Experience 27(8), 1997.
- K. Kaligosi, P. Sanders, “How Branch Mispredictions Affect Quicksort”, ESA 2006, LNCS 4168.
- S. Edelkamp, A. Weiß, “BlockQuicksort: Avoiding Branch Mispredictions in Quicksort”, ESA 2016, LIPIcs 57;期刊版 ACM Journal of Experimental Algorithmics 24, 2019;arXiv:1604.06697。
- O. R. L. Peters, “Pattern-defeating Quicksort”, arXiv:2106.05123, 2021(预印本)。
- P. McIlroy, “Optimistic Sorting and Information Theoretic Complexity”, SODA 1993.
- J. I. Munro, S. Wild, “Nearly-Optimal Mergesorts: Fast, Practical Sorting Methods That Optimally Adapt to Existing Runs”, ESA 2018, LIPIcs 112.
其他论文
- P. M. McIlroy, K. Bostic, M. D. McIlroy, “Engineering Radix Sort”, Computing Systems 6(1), 1993.
- J. W. J. Williams, “Algorithm 232: Heapsort”, CACM 7(6), 1964.
- I. Wegener, “BOTTOM-UP-HEAPSORT, a new variant of HEAPSORT beating, on an average, QUICKSORT (if n is not very small)”, Theoretical Computer Science 118, 1993.
- R. Sedgewick, “The Analysis of Quicksort Programs”, Acta Informatica 7(4), 1977.
- S. de Gouw, J. Rot, F. S. de Boer, R. Bubel, R. Hähnle, “OpenJDK’s Java.utils.Collection.sort() Is Broken: The Good, the Bad and the Worst Case”, CAV 2015.
- V. Estivill-Castro, D. Wood, “A Survey of Adaptive Sorting Algorithms”, ACM Computing Surveys 24(4), 1992.
- M. Axtmann, S. Witt, D. Ferizovic, P. Sanders, “Engineering In-place (Shared-memory) Sorting Algorithms”, ACM Transactions on Parallel Computing 9(1), 2022(arXiv:2009.13569)。
基准测试方法
- T. Mytkowicz, A. Diwan, M. Hauswirth, P. F. Sweeney, “Producing Wrong Data Without Doing Anything Obviously Wrong!”, ASPLOS 2009.
- T. Kalibera, R. Jones, “Rigorous Benchmarking in Reasonable Time”, ISMM 2013.
- J. Chen, J. Revels, “Robust Benchmarking in Noisy Environments”, arXiv:1608.04295, 2016(预印本)。
实验
reproduce/sort_bench.cpp、reproduce/introsort_probe.cpp、reproduce/radix_conflict.cpp、reproduce/run.sh、reproduce/summarize.py、reproduce/plot_figures.py:本文全部数字与图的来源。
系列导航: - 上一篇:并行排序:排序网络、并行归并、样本排序与 GPU 基数排序 - 下一篇:哈希表内部:链式、线性探测、Robin Hood 与生产实现的取舍
相关阅读: - TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略 - pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort - 基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort - 外部排序:从 I/O 下界到 PostgreSQL 与 GNU sort
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
排序算法专题:从 TimSort 到并行排序
把 TimSort、pdqsort、radix sort、external sort、parallel sort 与 benchmark 串成一条阅读路径。先读哪篇、什么时候选哪种排序,这一页讲清。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。