绝大多数”看起来很赚钱”的回测,输给实盘的原因不是 alpha 太弱,而是数据有问题。问题不在于行情条数缺失这类显而易见的脏数据,而在于一类更隐蔽的偏差:在某个时间点 \(t\),你给模型喂了一份当时根本不可能拿到的”事实”。这些事实可能来自未来才会公布的财报修订,可能来自当前指数成分回填到历史的”在册名单”,也可能来自一根用全样本均值算出来的 z-score。任何一条这种数据进入特征矩阵,回测就会被推上一条由信息泄漏(Information Leakage)撑起来的、平滑得不正常的净值曲线。
这种偏差有一个共同特点:它让回测看起来更稳、更平滑、夏普更高。换句话说,它是”看起来对”的方向上系统性偏差,而不是噪声。研究员靠肉眼很难分辨”这是真 alpha”还是”这是数据陷阱”——后者本来就是为了模仿前者长得像 alpha。能区分两者的,只有把陷阱的机制搞清楚,并把对应检查写进自动化流水线。
这一篇要讨论的,就是把数据从”看起来对”做到”真的对”的过程。范围限定在回测和因子研究阶段会遇到的几类典型陷阱:幸存者偏差(Survivorship Bias)、前视偏差(Look-Ahead Bias)、未来函数、数据窥视(Data Snooping)、复权陷阱、停牌与流动性陷阱、时区与日历对齐。每一类都会拆成”现象、机制、工程对策”三层来讲,并配上可以直接搬到工程里去落地的检查代码。
本文解决什么:回测里最常见的几类数据陷阱如何识别与工程防守。不讲什么:Walk-Forward / Purged CV 的切分数学(见 第 21 篇)、回测框架骨架(见 第 19 篇)、过拟合与未来函数的策略层复盘(见 第 20 篇)。
可复现边界
- 能本站直接跑:§2.5 PIT 财报库;§1.3 幸存者偏差仿真
survivorship_sim.py;§2.8 前视 vs PIT 仿真pit_vs_lookahead.py。两个脚本只依赖 numpy、pandas、matplotlib,种子固定为 20260501,加--plot会重新生成文中三张图,输出逐字节一致。- 不能本站代跑:依赖 Wind / Choice / CRSP / Compustat 的完整 A 股或美股退市全样本回测。文中所有仿真数字都来自合成数据,用于展示机制的方向和敏感度,不是市场收益估计。
- 数据从哪来:商用 PIT 与退市主数据见 §十「数据源」;免费层(tushare / akshare / yfinance)可跑原型,但指数成分历史、退市日、修订版本需读者自补或换源。
- 与前后篇分工:第 5 篇 管采集入库;本篇管进入研究后的偏差防守;第 7 篇 把约束落到特征库;第 20 篇 管推断层过拟合与 DSR。
本文延续 《行情、基本面、另类数据:采集、清洗、入库》 的视角:数据问题不是研究员一个人的事,而是数据团队、研究团队、回测框架共同的责任。这一篇关注的是数据进入研究后、产生分析偏差之前的最后一公里。下一篇 《特征仓库与因子治理》 会把这些约束落到一份工业级特征库上。
所有代码段都在 Python 3.11 + pandas 2.2 + numpy 1.26 下验证可运行。代码追求”演示陷阱本身”,不追求工业级性能。文中提到的 A 股、港股、美股事件均为公开市场公开信息,不构成对具体标的的判断。
一、幸存者偏差:你研究的从来不是历史本身
1.1 什么叫幸存者偏差
幸存者偏差有一个朴素的定义:当你的样本只包含”活到今天的对象”,而历史上确实存在但已经消失的对象被悄悄筛掉,你看到的统计规律就只是幸存者群体的规律,不是全体的规律。
放到 A 股、美股的语境里,“已经消失”包括下面这些情形:
- 退市(Delisting)。包括因业绩亏损、重大违规、私有化、兼并被吸收等原因从交易所摘牌。A 股退市制度过去十年大幅收紧,但仍有大量 ST、*ST 股票在历史上经历强制退市。美股的退市同样常见,并购、私有化和不再满足挂牌条件都会让代码从交易所消失。
- 兼并(Merger)。被并入另一家上市公司后,原代码不再交易,价格序列断在并购完成日。
- 私有化(Going Private)。控股股东通过要约收购把上市公司私有化退市。最典型如戴尔、双汇、分众。
- 借壳与重组。原代码可能保留,但实际承载的业务、财务报表、行业分类完全换了一家公司。从研究角度,借壳前后基本不能视为同一只股票。
- 重新分类。当前在某指数成分内,但历史上并不在;或当前已被剔除,但历史上长期是成分股。
只要数据库的快照只反映”现在存在的标的”,把历史回填出来的样本就缺少这些已经消失的标的,回测自动获得了一份”事先知道哪些公司活到了今天”的能力。
1.2 为什么这个偏差在 A 股没那么明显,但仍然不能忽略
业内常听到一种说法:“A 股退市比例低,幸存者偏差可以忽略。”这句话在 2018 年之前还说得过去,今天必须修正。
第一,注册制推进之后,常态化退市逐步形成。深交所、上交所每年都有数十家强制退市的案例。把样本回测拉到 2014 年起,含与不含这些标的的差异,已经能影响到组合层面的 IR(信息比率)。
第二,幸存者偏差不只是”退市”。把指数成分的历史快照固定为”当前成分”,是 A 股研究里更常见的版本。沪深 300 每半年定期调整一次样本,单次调整比例一般不超过 10%,十年累积下来,成分已大幅更替。如果用今天的沪深 300 成分回测十年前的”沪深 300 多空策略”,你研究的根本不是当时的沪深 300。
第三,借壳重组带来的代码连续、业务跳变问题,A 股尤其严重。同一个 stock_id 下,历史财务报表跨过借壳日,等于把两家公司的报表强行接成一条时间序列。任何基于 ROE、毛利率、资产周转率的因子,都会在借壳日附近出现极不合常理的跳变。
所以问题不是”A 股要不要管幸存者偏差”,而是”A 股的幸存者偏差有它自己的形态”。
1.3 偏差量级:一个可复现的仿真
真实市场的偏差量级取决于样本期、市场和因子,没有一个通用数字。学术上有两条可靠的线索:Brown、Goetzmann、Ibbotson 与 Ross(1992)证明,只保留存续基金会让业绩表现出虚假的持续性,即使真实业绩完全随机;Shumway(1997)发现 CRSP 在大量因业绩原因退市的股票上缺失退市月收益,他估计 NYSE/AMEX 这类退市的平均收益约为 \(-30\%\),Shumway 与 Warther(1999)对 Nasdaq 给出的估计约为 \(-55\%\)。
为了把机制拆开看,survivorship_sim.py
构造了一个合成面板:初始 800 只股票,每月新上市数服从
Poisson(6),共 240 个月。每只股票有一个困境分数 \(z\),它服从
AR(1),坏的收益冲击会推高 \(z\);月度退市概率为
\[ h_t = \frac{1}{1 + e^{-(A + B z_{t-1})}}, \quad A = -6,\ B = 1.3, \]
退市当月的收益在数据里缺失,模拟 CRSP 的状况。种子 20260501 下共上市 2216 只,退市 1109 只,存续 1107 只。若只用”今天还在册”的股票回测,第 0 个月的股票池只有 260 只,而当时实际在册的是 800 只。

更值得警惕的是第二张图。对同一个困境因子(做多高 \(z\)、做空低 \(z\) 的五分位多空组合),只改变”已退市股票怎么处理”:
| 处理口径 | 种子 20260501 年化 | 50 个种子中位数 [P10, P90] |
|---|---|---|
| 仅存续股票 | 13.63% | 10.19% [8.58%, 12.55%] |
| 全样本,退市月收益直接丢弃 | 7.18% | 6.45% [5.23%, 7.84%] |
| 全样本,退市月收益填 \(-30\%\) | 1.37% | 0.89% [−0.56%, 2.30%] |
| 全样本,退市月收益填 \(-55\%\) | −3.27% | −3.54% [−5.06%, −2.08%] |
| 全样本,退市月收益填 \(-100\%\) | −11.63% | −11.39% [−13.38%, −9.97%] |
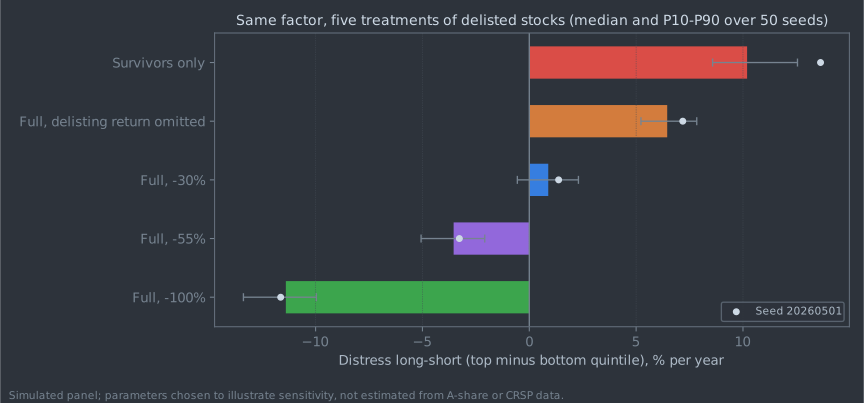
仿真里困境因子本身被设成有小幅正溢价(参数
LAM = 0.002),但退市收益的处理口径足以把它翻成显著为负。这正好落在困境溢价文献的核心争论上:Campbell、Hilscher
与
Szilagyi(2008)发现高违约风险股票的后续收益反而偏低。困境股恰恰是最容易退市的一群,所以这类结论天然依赖退市收益怎么处理,后续文献也普遍按
Shumway 的建议显式填补。教训有两条:
- 只用存续样本不只是”多算了一点收益”,它会系统性地删掉因子空头腿里最差的那批股票;
- 即使用了全样本,退市收益缺失也是独立的第二层偏差,必须显式选择填补口径,并把结果对口径做敏感度分析。
1.4 工程上怎么修
修这个偏差的关键,是把”标的全集”和”在某个 \(t\) 时点可交易的标的子集”分清楚。
第一步,建一张 securities_master
表,登记每一个曾经在交易所存在过的代码:
# securities_master 表的最小字段集
# stock_id        交易所代码 + 市场后缀(如 600519.SH)
# inception_date  上市首日
# delisting_date  退市日(NULL 表示仍在册)
# delisting_reason  退市原因:normal / suspended / ipo_failed / merger / privatization / restructure
# successor_id   被合并/借壳后的承接代码(用于做 corporate action 链路追踪)
第二步,每天生成一份
tradable_universe(t):
def tradable_universe(date, master, suspensions, st_flag):
    """
    返回在 date 这一天理论上可交易的代码集合。
    - 上市但未退市
    - 没有处于停牌
    - 不在策略约定的排除集合里(例如排除 ST)
    """
    alive = master[(master.inception_date <= date) &
                   ((master.delisting_date.isna()) | (master.delisting_date > date))]
    not_suspended = alive[~alive.stock_id.isin(suspensions.on(date))]
    if st_flag == "exclude":
        not_suspended = not_suspended[~not_suspended.is_st_at(date)]
    return set(not_suspended.stock_id)
第三步,回测引擎的”调仓步”必须用
tradable_universe(t)
做交集,而不是用全量代码做候选集。任何因子打分、组合优化的输入,也只能在
tradable_universe(t) 之内。
最后一步是审计。研究员提交策略时,回测框架要自动报告”过去十年里,组合里出现过多少个已退市代码、多少个被并购代码、多少个借壳代码”。这个数字不为零,说明你的样本里包含了真实的历史,而不是被筛过的历史;为零的话,要么是你的策略恰好不碰这些标的,要么就是你的样本被偏差污染了。
1.5 IPO 与”上市后第一个月”
幸存者偏差的另一个变种是 IPO 偏差。原始数据库通常在 IPO 后才把代码放进来,但放进来时已经是某个时点的”幸存者”——上市当日大幅破发被立刻撤回的、上市首周即停牌的,可能根本进不了你的数据库。
更细一点,新股上市初期的交易制度与普通股票不同,而且随板块和注册制改革而变:创业板、科创板以及 2023 年全面注册制后的主板新股,上市前 5 个交易日不设涨跌幅限制;此前主板新股首日涨幅上限为发行价的 44%。如果回测引擎按”普通股”来模拟新股,成交假设会全错。一个稳妥的做法是把上市后若干交易日内的标的从 universe 里剔除,具体窗口按板块规则设定,等价格形成机制恢复常态后再让策略接触。
1.6 借壳与重组:同一个代码,不同的公司
借壳上市(Reverse Merger)与吸收合并在 A 股的处理特别麻烦:代码、简称、实体三者可能各走各的路。一个公开的例子是 2015 年百视通(600637)换股吸收合并东方明珠(600832):600832 终止上市,存续的 600637 随后更名为”东方明珠”。如果数据库按简称或按”东方明珠”这个名字拼接历史,就会把两家公司的行情和报表接成一条序列;如果按代码拼接,600637 在合并前后又对应着规模和业务构成完全不同的实体。任何基于 ROE、毛利率、资产周转率的因子,都会在事件日附近出现不合常理的跳变。
工程上的处理是把”代码”和”实体”分开维护:
# 借壳重组事件表
# code            交易所代码(不变)
# event_date      重组完成日
# entity_id_pre   重组前实体的内部 id
# entity_id_post  重组后实体的内部 id
# notes           重组类型:reverse_merger / asset_swap / spinoff
研究流水线在拉数据时,按 entity_id
拉财报,按 code 拉行情;并在
event_date
处把财报序列截断或显式标记。一种保守的做法是:重组日之后设一段冷静期(例如
24
个月,具体长度按策略的财报回看窗口设定),期间不参与任何”基本面截面”,让市场充分反映新实体的盈利能力之后再入选。
1.7 一个常见的反模式
研究员有时会用
tushare、akshare、yfinance
直接拿”当前成分股 →
拉历史日线”。这条路径在原型阶段没问题,但只要把它接到回测,就立刻把幸存者偏差焊进去了。代码看起来很无辜:
# 反模式:用当前指数成分回测历史
import yfinance as yf
sp500_today = get_sp500_constituents()      # 只拿到了今天的成分
prices = yf.download(sp500_today, start="2010-01-01", end="2025-01-01")
# 任何用 prices 做的回测都已经被污染
正确做法是从有 PIT
历史成分的源头取数据:CRSP、Compustat、Bloomberg 的
INDX_MWEIGHT_HIST、Wind
的”指数成分历史”、自己维护的指数样本变更日志。如果只能用免费源,至少要落地一份”成分变更日志”,回测时按日期回放。
二、前视偏差:把未来才知道的事,用在过去的决策里
2.1 前视偏差的两种形态
前视偏差(Look-Ahead Bias)指的是:在 \(t\) 时刻做决策时,特征矩阵里出现了 \(t\) 时刻无法获取的信息。它有两种形态。
第一种是”时点错位”。比如基于 2024 年一季报的 ROE 算因子,但把这个因子的时间戳标在 2024-03-31(报告期末),实际公告日是 2024-04-25。在 03-31 到 04-25 之间,市场上没有人能看到这份报表,模型却拿来排序了。
第二种是”修订错位”。哪怕你用的是公告日,公司可能在 2024-08-15 因审计追溯调整了一季报里的某项数字。如果你的数据库只保留”最新值”,回测看到的是 2024 年 8 月之后才存在的修订值,而不是当时市场看到的初次披露值。修订有时候是大幅度的,比如把净利润下调 30%。
两种形态都属于前视,但工程上的修法不同。
2.2 时点错位:财报数据的”真实可用日”
财报数据有四个关键日期:
| 名称 | 含义 | 在 PIT 中的角色 |
|---|---|---|
| 报告期末 | 例如 2024-03-31 |
数据所属期间,不是可用日 |
| 公告日 | 报表正式披露的日期 | 严格意义上的”开始可用日” |
| 落库日 | 数据源解析入库的日期 | 真正进入研究环境的日期 |
| 修订日 | 后续重述(restatement)发生的日期 | 触发 PIT 版本切换 |
朴素回测把”报告期末”当成可用日,这就是最经典的前视。修法是把”开始可用日”统一用”公告日”,对要求更严的环境用”公告日 + 1 个交易日延迟”。在 A 股,年报、季报有上市公司延迟披露的情况,但披露时间窗的尾端会触发停牌或问询,进入研究阶段时按公告日是足够保守的。
下图展示同一份财报在不同口径下的可用区间:

红色窗是”前视”——朴素回测从报告期末就开始使用未来才会披露的数据。橙色窗是”仅按公告日”,避免了最严重的时点错位,但忽略了修订事件。绿色窗是
PIT(Point-In-Time)方案:一条记录绑定 (报告期, 修订版本号,
知晓时刻),回测在 \(t\)
时刻只能看到 知晓时刻 ≤ t 的版本里
报告期 最新的那条。
2.3 修订错位:要把”那时知道的”和”现在知道的”区分开
修订带来的偏差比时点错位更难察觉,因为大多数财务数据库默认覆盖最新值。研究员看到的不是当时市场看到的,而是事后审计、追溯调整、合并报表口径变化之后的”干净版本”。
这种”干净版本”对一类策略尤其致命:盈余惊喜(Earnings Surprise)、基本面动量、应计利润(Accruals)类。这些策略的 alpha 来源就是市场对披露质量、修订幅度的反应。如果你拿修订后的版本算”实际盈余 - 一致预期”,差额会被低估,alpha 看起来比真实更稳。
工程上的处理方法是上 PIT 库。每条财务记录至少四个键:
stock_idreport_period:所属报告期,例如2024Q1version:从 1 开始的修订版本号effective_from:这一版本对市场可见的起始时点
查询接口固定一个签名:“给我 \(t\) 时刻能看到的、\(stock\_id\) 的、报告期 ≤ \(t\) 的最新一版财报数据。”任何不走这个接口的查询都视作潜在前视。
2.4 行业分类与指数成分的 PIT
财报不是唯一会引入前视的字段。行业分类、指数成分、可融券标的、ST 标记,全都是带时间维度的属性。
行业分类(GICS、申万、中信)每年会做一次大调整,少数公司因主营业务变化会被重分类。如果你用今天的行业分类去回测十年前的”行业中性”组合,行业暴露的对冲就是错的,残差里混入了行业 beta。
指数成分的 PIT 比行业分类更敏感。沪深 300 每半年定期调整一次,单次调整比例一般不超过 10%(最多约 30 只)。任何”沪深 300 选股”或者”用沪深 300 做对冲”的回测,都必须按当时的成分。
可融券标的的 PIT
决定一类做空策略能不能成立。某段时间标的不在融券池,理论
alpha
再好也不能交易。这一项历史数据稀缺,但是上交所、深交所每天会披露
每日融资融券标的证券名单,可以日切落库。
工程上把这些字段统一封装成”时间序列属性”:每个属性表的查询都必须传
as_of
参数。底层实现可以是开闭区间表(每条记录带
start_date、end_date),查询时做范围匹配。
2.5 PIT 财报库的最小可运行实现
把上面这些原则落到代码上。下面是一份不带任何依赖的 PIT
财报库实现,演示了 as_of 查询的语义:
# pit_fundamental.py
# Python 3.11, 仅依赖标准库 + pandas
from __future__ import annotations
from dataclasses import dataclass
from datetime import date
import pandas as pd


@dataclass(frozen=True)
class FundamentalRecord:
    stock_id: str
    report_period: str        # 例如 '2024Q1'
    version: int              # 1 表示初次披露
    effective_from: date      # 该版本对外可见的起始日
    fields: dict              # 字段 -> 值,例如 {'revenue': 1.2e9, 'net_profit': 1.0e8}


class PITFundamentalStore:
    """最小可运行 PIT 财报库。
    所有写入都是 append-only:修订只新增 (stock_id, report_period, version+1) 的记录,
    不覆盖历史。读取时按 as_of 过滤出"当时可见的最新版本"。
    """

    def __init__(self) -> None:
        self._records: list[FundamentalRecord] = []

    # ---------- 写入 ----------
    def ingest(self, rec: FundamentalRecord) -> None:
        # 简单一致性检查:同一 (stock, period) 下 version 必须递增
        existed = [r for r in self._records
                   if r.stock_id == rec.stock_id
                   and r.report_period == rec.report_period]
        if existed and rec.version <= max(r.version for r in existed):
            raise ValueError(
                f"version 必须递增:{rec.stock_id} {rec.report_period} "
                f"已有最高版本 {max(r.version for r in existed)}"
            )
        self._records.append(rec)

    # ---------- 读取 ----------
    def as_of(
        self,
        stock_id: str,
        as_of_date: date,
        report_period: str | None = None,
    ) -> FundamentalRecord | None:
        """返回 as_of_date 时点对市场可见的、指定报告期的最新版本。
        report_period=None 时返回 as_of_date 之前最新报告期的最新版本。
        """
        candidates = [
            r for r in self._records
            if r.stock_id == stock_id
            and r.effective_from <= as_of_date
            and (report_period is None or r.report_period == report_period)
        ]
        if not candidates:
            return None
        if report_period is None:
            # 先按 report_period 取最大,再在该 period 内取最高 version
            latest_period = max(r.report_period for r in candidates)
            candidates = [r for r in candidates if r.report_period == latest_period]
        return max(candidates, key=lambda r: r.version)

    # ---------- 批量读取(构造横截面)----------
    def cross_section(
        self,
        stock_ids: list[str],
        as_of_date: date,
        field: str,
    ) -> pd.Series:
        """返回某个字段在 as_of_date 的横截面。"""
        out = {}
        for sid in stock_ids:
            rec = self.as_of(sid, as_of_date)
            if rec is not None and field in rec.fields:
                out[sid] = rec.fields[field]
return pd.Series(out, name=field)写入时区分初次披露与修订(DEMO01.SH
和下面的数值都是虚构的演示数据):
store = PITFundamentalStore()

# 初次披露:2024-04-25 公告 2024Q1 报表
store.ingest(FundamentalRecord(
    stock_id="DEMO01.SH",
    report_period="2024Q1",
    version=1,
    effective_from=date(2024, 4, 25),
    fields={"revenue": 4.66e10, "net_profit": 2.40e10},
))

# 中报附带的追溯调整:在 2024-08-15 重述了 Q1 净利润
store.ingest(FundamentalRecord(
    stock_id="DEMO01.SH",
    report_period="2024Q1",
    version=2,
    effective_from=date(2024, 8, 15),
    fields={"revenue": 4.66e10, "net_profit": 2.35e10},
))
回测时所有查询都强制带 as_of:
# 在 2024-05-10 看到的,是 v1
r1 = store.as_of("DEMO01.SH", date(2024, 5, 10))
assert r1.version == 1 and r1.fields["net_profit"] == 2.40e10

# 在 2024-04-20(公告前)看不到任何东西
assert store.as_of("DEMO01.SH", date(2024, 4, 20)) is None

# 在 2024-09-01 才能看到修订后的 v2
r2 = store.as_of("DEMO01.SH", date(2024, 9, 1))
assert r2.version == 2 and r2.fields["net_profit"] == 2.35e10
这一段不到 100 行的代码,已经覆盖了 PIT
库的核心语义:append-only 存储、按 as_of
检索、版本号显式化。生产环境再叠上索引、批量
IO、报表口径映射、缺失值处理就行,本质上都是在这个骨架上加包装。
2.6 一致预期数据的 PIT
卖方研究员(Sell-side Analyst)的盈利预测、目标价、评级,是”基本面动量”和”预期修正”类策略的关键输入。这一类数据天然带前视风险。原因有两条:
第一,预测发布日和数据库录入日之间有时差。Bloomberg、Wind、彭博的一致预期会在分析师发布之后几小时到一天内更新,但有些第三方数据源会”批量补数据”,把过去某个时段的预测重新写一遍。如果研究员用的是这种”补完整版”的数据,等于看到了未来若干天后才正式录入的预测。
第二,分析师覆盖关系本身是动态的。某券商今年覆盖、明年弃覆盖,一致预期的分母(覆盖人数)在变。如果用今天的”覆盖人数”做历史归一化,就把”未来还会有谁覆盖”这件事偷偷塞进了模型。
修法和财报一致:每一条预测带
analyst_id、forecast_date、effective_from,按
as_of
检索;覆盖关系用区间表(每个分析师对每个标的有
coverage_start、coverage_end)。
2.7 另类数据的 PIT:比财报更难
财报至少有规范化的公告日。另类数据(卫星图像、招聘数据、信用卡消费、新闻文本、社交情绪)的可用日就模糊得多。
新闻文本。新闻有”事件发生时间”和”消息发布时间”,两者经常不一致。比如某并购消息事实发生在 14:30,路透社 15:10 才发出,部分小型自媒体 16:00 才转出。如果你的因子用的是”消息发布时间”,要确认数据源是哪一个时间戳——用路透时间和用最早自媒体时间,对短期事件驱动策略的回测结果可能差一倍。
卫星图像。商业卫星的过境时间是固定的(每颗卫星在固定轨道上每隔几小时过一次),但图像处理、云层剔除、识别算法跑完,往往要 24-72 小时才有可用结果。把”图像采集时间”当作”特征可用时间”是典型前视;正确做法是把”管道处理完成时间”作为可用时间戳。
招聘 / 消费等结构化另类数据。这些数据通常按周/月聚合发布。如果数据源把”前一周的统计”在周一早上 10 点发布,那这一周的可用日就是周一 10 点之后,不是这一周的第一天。
落到工程上,所有另类数据都强制带
available_from
字段,不带这个字段的数据源不接入研究环境。
2.8 前视 vs PIT:一个能跑的对比
把前视偏差量化出来,最直接的办法是同一个策略、同一份财报,只换时间戳口径各跑一次。要让实验有意义,财报必须对价格有影响:如果价格和财报相互独立,两种口径的期望收益都是
0,对比不出任何东西。pit_vs_lookahead.py
的设定是:
- 50 只股票,2024 年全年日频,日收益 \(r_{i,t} \sim N(0, 0.012^2)\);
- 四期季报,每期净利润同比 \(g_i \sim N(0, 0.2^2)\),各期独立;
- 公告日当天,股价对财报做一次性反应:\(r_{i,\text{ann}} \mathrel{+}= 0.1\,(g_i - \bar g)\);
- 每周一收盘按”已知的最新一期 \(g\)“排序,做多前 10、做空后 10,权重各 \(\pm 0.1\),决策在下一交易日生效。
两种口径的唯一区别是”财报从哪天起算已知”:
def latest_known(reports, today, use_announcement):
    # 前视:报告期末(如 2024-03-31)就当作已知;PIT:公告日(如 2024-04-25)才已知
    known = [(ann if use_announcement else period_end, g)
             for period_end, ann, g in reports
             if (ann if use_announcement else period_end) <= today]
return max(known, key=lambda x: x[0])[1] if known else None运行结果(python pit_vs_lookahead.py):
seed=20260501
look-ahead cumulative return: 0.2575
PIT        cumulative return: 0.0976
gap                         : 0.1598
seeds 0..999: median look-ahead 0.2200, median PIT -0.0006
seeds 0..999: median gap 0.2196, P10 0.1075, P90 0.3265, share(gap>0) 0.995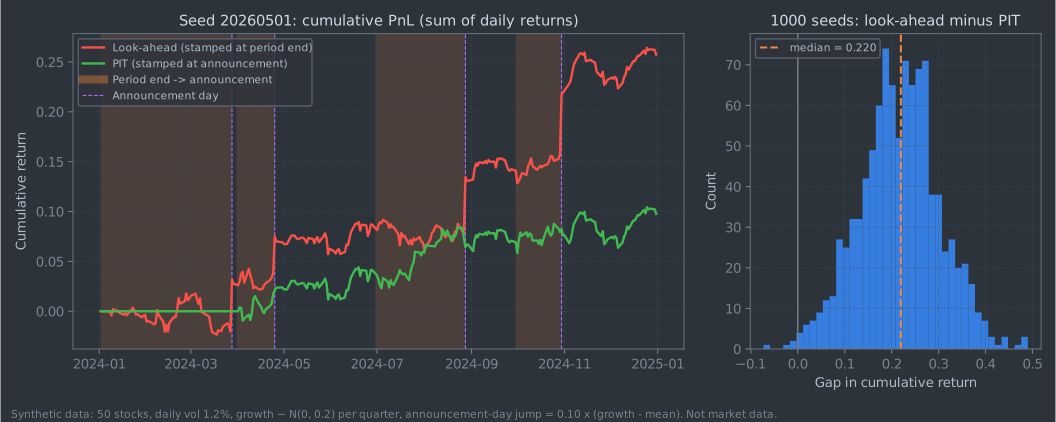
要点在 1000 个种子的汇总:PIT 版本的中位累计收益约为 0(\(-0.0006\)),这符合设定,因为公告日之后财报已经被价格吸收,不再有可交易信息;前视版本的中位收益是 0.22,99.5% 的种子里前视都更高。这 0.22 全部是泄漏:前视口径在报告期末到公告日之间提前按财报建仓,正好吃到公告日的跳空。种子 20260501 下 PIT 收益为 0.0976,只是该路径上的噪声。
合成数据把反应系数设得很干净,真实市场的财报反应有提前泄露、公告后漂移(PEAD)等复杂形态,差距的大小不能外推。但它准确地展示了偏差的形状:前视不是让收益”多一点”,而是能凭空造出一条本不存在的收益曲线。
三、未来函数:当代码逻辑里偷偷溜进了未来
3.1 什么是”未来函数”
未来函数(Future Function / Forward-Looking Function)是 A 股社区里用得很广的术语,本质就是:在生成 \(t\) 时刻特征的函数里,输入向量 \(x_t\) 实际依赖了 \(t' > t\) 的数据。前视偏差是数据层的问题,未来函数是计算层的问题,常常更难发现,因为它伪装在看似无害的代码里。
下面这几种是踩坑次数最多的。
3.2 全样本归一化
这是最经典的未来函数。研究员在做特征工程时习惯写:
# 反模式:用整段样本的均值和标准差去做 z-score
df["roe_z"] = (df["roe"] - df["roe"].mean()) / df["roe"].std()
df["roe"].mean()
是整段历史的均值,包含了未来。如果这个特征用在 2018 年 1
月的决策上,它已经”知道”2024 年 ROE
的均值在哪里。任何对均值漂移敏感的因子(估值、低波、动量)都会被这种归一化偷偷注入未来信息。
修法是把”全样本统计量”换成”扩展窗口”或”滚动窗口”:
# 正确:扩展窗口,t 时刻的统计量只用 t 之前的样本
mu = df["roe"].expanding(min_periods=252).mean()
sd = df["roe"].expanding(min_periods=252).std()
df["roe_z"] = (df["roe"] - mu) / sd
横截面归一化也要小心。在某一天对所有股票做截面 z-score 没问题,因为所有截面值都在 \(t\) 时刻同时可见;但是把”行业中位数”算进特征时,要确认”行业分类”用的是 PIT 版本,否则未来函数仍然会通过分类反映过来。
3.3 未来均值回归
这是一个稍微隐蔽的版本。研究员在做”价格回归到均线”的策略时,写了这种代码:
# 反模式:用整段历史拟合均值回归参数
half_life = (np.log(2) / np.log(np.abs(rho))).item()  # rho 来自整段 OU 拟合
rho 是 Ornstein-Uhlenbeck 拟合出的系数。如果
rho
用整段样本估,得到的半衰期已经包含未来信息。哪怕回测只用最近
N 天的均值,参数 rho 本身也偷看了答案。
修法是参数滚动重估。每个调仓节点用过去固定窗口估一次
rho,从此往后只用这一次估出来的值,到下一个节点再更新。这种”walk-forward”参数重估的代价是计算量上去了,但时间因果性是对的。
3.4 滚动窗口的越界
pandas.rolling
是高频踩坑点。默认行为是右对齐:x.rolling(20).mean()
在 \(t\) 这一行返回 \([t-19, t]\)
的均值,不包含未来,是安全的。但是下面这一行就有问题:
# 反模式:center=True 滚动窗口
ma = df["price"].rolling(20, center=True).mean()
center=True 会让 \(t\) 这一行的均值取自 \([t-9, t+10]\),直接用了未来的
10 行。可视化时图很漂亮,回测里就是泄漏。
shift
也是常见陷阱。研究员有时为了”避免使用同日数据”会写:
# 这里没问题:用昨天的收盘做信号,今天开盘成交
sig = df["close"].shift(1)
但是反过来这种:
# 反模式:把未来 1 期的 return 当 target,忘了把它从特征里隔离开
df["fwd_ret"] = df["close"].pct_change().shift(-1)
df["feat"] = df[["fwd_ret", "vol", "mom"]].sum(axis=1)  # fwd_ret 进了特征
把目标变量混进特征是机器学习上下游里最经典的泄漏。任何用 shift(负数) 构造的列都要立刻打上 “TARGET-ONLY” 标签,禁止进入特征流水线。
3.5 链式数据预处理的陷阱
更隐蔽的是预处理链:去极值、标准化、缺失值填充、行业中性化。每一步如果用了”全样本统计量”,都会注入未来。
例如缺失值填充:
# 反模式:用整段中位数填空
df["pe"] = df["pe"].fillna(df["pe"].median())
应当改成”截面填充”(用同一天同行业的中位数)或者”扩展窗口”。前者只跨横截面、不跨时间,是安全的;后者只用历史。
3.6 训练 / 测试切分中的泄漏
机器学习类策略里有几种常见的泄漏,本质都是”测试集的信息流回了训练集”。
标准化器的全局拟合。这是最常见的版本:
# 反模式:标准化器在全样本上 fit,再切分
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler().fit(X)              # X 包含训练 + 测试
X_train, X_test = train_test_split(scaler.transform(X), ...)
正确写法是先切分,再用训练集拟合 scaler,对测试集只 transform:
X_train, X_test = train_test_split(X, ...)
scaler = StandardScaler().fit(X_train)
X_train = scaler.transform(X_train)
X_test = scaler.transform(X_test) # 测试集不参与 fit特征选择的全局做法。卡方、信息熵、互信息这些特征筛选方法如果在全样本上跑,再切训练 / 测试,已经把测试集的标签泄漏到选特征这一步。
目标编码(Target Encoding)的泄漏。把类别变量替换为”该类别下目标变量的均值”是一种强力特征,但如果均值在全样本上算,已经看了测试集的 \(y\)。修法是用 KFold 内部目标编码,或者用 leave-one-out 编码。
时间序列 CV
的错误切分。KFold
默认随机打乱,对时间序列是错的——训练集里出现 \(t+1\)、测试集里是 \(t\),因果反了。必须用
TimeSeriesSplit、PurgedKFold、或者干脆
walk-forward。López de Prado 强调的”purge +
embargo”是更严格的版本:训练集在测试集前后都留一个
buffer,避免标签依赖跨集泄漏。
3.7 系统性预防:用类型/接口做约束
光靠人眼和 code review 防未来函数是防不住的,因为代码看起来都”对”。真正能压住的是把约束写进系统的接口。
第一种做法是在数据帧里显式带时间戳,所有横截面操作都必须以”同一时间戳”为边界:
def cross_section_zscore(df, value_col, group_col, ts_col):
    """对同一时间戳、同一分组内做 z-score,跨时间戳的均值绝不参与。"""
    grouped = df.groupby([ts_col, group_col])[value_col]
    return (df[value_col] - grouped.transform("mean")) / grouped.transform("std")
第二种做法是回测引擎在调用 signal 时,传入一个”只能看 \(t\) 之前”的视图:
class PITView:
    def __init__(self, df, t):
        self._df = df[df.index <= t]   # 只暴露 t 之前的数据
        self._t = t
    def __getitem__(self, key):
        return self._df[key]
研究员只能拿到这个视图,写不出未来函数。
第三种做法是引入”时点污染检查”。回测跑完后,把每天的特征矩阵和那一天的 PIT 数据流做一次 join,对不上就报警。这个开销不便宜,但能在 CI 阶段切实抓住未来函数。
四、数据窥视与多重检验:当回测变成”许愿池”
4.1 什么是数据窥视
数据窥视(Data Snooping)是另一种”用未来”,但这次”未来”是研究员自己的眼睛。流程是这样:
- 想到一个因子,回测看 IR;
- IR 不够好,调一调阈值、改一改窗口,再回测;
- 反复几十次,留下”看着最好”的那一组参数;
- 把它当成”发现的 alpha” 去上线。
整个过程没有任何一步用到了未来数据,但研究员的注意力一直在用未来——他在看的是”在我手里这段历史里,哪一组参数最幸运”。这就是 p-hacking 的过程。
4.2 多重检验为什么这么危险
经典统计的 5% 显著性,是单次假设检验的边界。如果你做了 100 次假设检验,期望会有 5 次纯靠运气过线。当一个因子工厂同时跑几百个候选因子,挑 IR 最高的那批,挑出来的因子被运气解释的概率非常高。
算一下就清楚:若 \(N\) 次检验相互独立、每次显著性水平为 \(\alpha\),在所有策略真实 Sharpe 都为 0 时,至少一次”显著”的概率是
\[ P = 1 - (1 - \alpha)^N . \]
\(\alpha = 5\%\) 时,\(N = 20\) 得 \(P \approx 64\%\),\(N = 100\) 得 \(P \approx 99.4\%\)。参数网格里的回测高度相关,有效独立次数小于 \(N\),但方向不变。Bailey 等人(2014)把这一点推广到 Sharpe 比率:给定试验次数,纯噪声里挑出的最大 Sharpe 的期望值随 \(N\) 增长。
4.3 工程上能做的几件事
预注册(pre-registration)。在跑回测之前,把假设、参数空间、显著性阈值写进一份不可改的文档(git commit 上 hash),事后看回测结果是否落在预设区间。任何在事后被改的范围,都要标记为”探索性”,不当成可信结论。
Deflated Sharpe Ratio。López de Prado 提出的修正:根据尝试次数和样本相关结构,对 Sharpe 做”通胀”折扣。公式涉及最大尝试次数 \(N\)、样本均值、样本偏度峰度。原始 Sharpe 需要打折之后再判断显著性。
保留集(hold-out)。把样本切成开发集、验证集、保留集。任何决策只用前两者;保留集只在最终上线决策前看一次。如果在保留集上表现塌陷,说明前两者上的”alpha”是过拟合。
步入式校验(walk-forward)。在每一个时间窗口上重新拟合参数、向前评估。最后看的是步进序列的总体表现,不是”在整段历史上最好的一组参数”。
Combinatorial Purged CV。López de Prado 又提出的版本,专为时间序列设计,避免训练集和测试集在时间上”挨着”导致的信息泄漏。
事先约定显著性阈值。如果你已经做了 N 次尝试,最低显著性应该按 Bonferroni 或 Holm 修正:\(\alpha' = \alpha / N\)。
4.4 一个常见的反模式
研究员在做”参数扫描”时常写出这种代码:
# 反模式:网格扫描后挑最优 Sharpe
results = []
for w in [5, 10, 20, 30, 60]:
    for thr in [0.5, 1.0, 1.5, 2.0]:
        for vol_cap in [0.05, 0.10, 0.20]:
            sr = backtest(w, thr, vol_cap).sharpe()
            results.append((w, thr, vol_cap, sr))
best = max(results, key=lambda x: x[-1])
5 × 4 × 3 = 60 组合,期望里大约会有 3 组靠运气拿到 5% 显著的 Sharpe。挑 best 出来,等于挑出”最幸运的一次”。修法是要么走 walk-forward,让每个时间窗里”独立”挑参数;要么把网格视为多重假设,在判定显著性时除以 60。
4.5 因子工厂的”出厂检验”
更工业一些的做法是把每个候选因子放到一条统一的”出厂检验”流水线上:
- 样本期划分。开发集(前 60%)、验证集(中 20%)、保留集(最后 20%)严格按时间切分。
- 基础统计。在开发集上算 IC、IR、换手率、覆盖率、分组单调性。任一指标不达标,淘汰。
- 稳健性。在验证集上重做基础统计,要求和开发集差距不超过预设阈值(比如 IR 衰减 ≤ 30%)。
- 正交性。和已有因子库做横截面回归,看残差 IR 是否仍显著。如果一个新因子 99% 被现有因子解释,没有上线价值。
- 保留集”一锤定音”。前面四步都通过的因子,在保留集上跑一次。这一次的结果不参与任何后续调整,结果就是结果。
- 多重检验修正。用 Bailey-López de Prado 的 Deflated Sharpe,按”今年家里跑过多少候选因子”做折扣。
这套流程不能保证留下的因子都是真的,但它把每一步淘汰的理由都记录下来,让”运气”至少要连续通过几道互相独立的关卡。Harvey、Liu 与 Zhu(2016)据此主张,新因子的 \(t\) 统计量门槛应从 2.0 提高到 3.0 左右。
4.6 我自己的判断
这是工程上最难根除的偏差之一。原因是研究员不写代码也在心里”网格搜”——他可能只看了一眼图就放弃了某个想法,但记住了。真正能防住数据窥视的不是工具,是研究流程:固定假设来源(先有理论或现象,再有因子),固定参数范围(落在文献或经验里,不每次都换),固定停止条件(达到预设 IR 就停手,不进一步调参)。这些都是流程纪律,不是代码能强制的。
4.7 一个真实尺度的反例
学术文献里被反复引用的一个例子是 Sullivan、Timmermann 与 White(1999)对技术分析规则的检验。他们在道琼斯工业指数约百年的日数据上检验了近 8000 条技术规则,用 White 的 Reality Check 自助法控制整个规则空间的数据窥视。结论有两层:在原始样本期内,最优规则即使经过修正仍然显著;但在 1987 年之后的样本外区间,这种优势消失了。也就是说,修正多重检验能告诉你”这是不是纯粹挑出来的”,却不能保证历史上真实存在的规律在未来继续有效。
这个结论对今天的研究员仍然有效——区别只是当年的”几千条技术规则”换成了今天的”几千个 ML 模型 + 特征组合”。如果你做了 1000 次回测之后挑出”看起来最好”的那一组,期望里大概率会挑到一个 IR=0 的策略。
五、复权陷阱:分红、配股、拆股下的价格连续性
5.1 为什么要复权
只要有分红、送股、配股、拆股、合股这些公司行为(Corporate Actions),股价的”原始序列”就不连续。最直观的例子:贵州茅台 2016 年度利润分配为每股派现 6.787 元(含税,10 派 67.87 元,不送转),股权登记日 2017 年 7 月 6 日、除息日 2017 年 7 月 7 日。7 月 6 日收盘 454.00 元,7 月 7 日开盘 447.21 元——账面看似跌了约 6.79 元,恰好等于每股分红,是纯粹的除息缺口而非真实下跌(\(454.00 - 6.787 \approx 447.21\))。如果直接对原始价格做收益率,这一天会算出一个莫名其妙的负收益,下一笔交易决策也会跟着偏。
复权(Adjustment)就是把这些公司行为造成的”价格断点”补平,让序列在”持续持有的总收益”意义上连续。
5.2 三种口径
| 口径 | 含义 | 适用场景 |
|---|---|---|
| 不复权 | 显示当时市场上真实的价格 | 实盘下单、看交易区间、画龙虎榜 |
| 前复权 | 以”今天”为基准,把历史价格按公司行为反向调整 | 看图、技术分析、形态识别 |
| 后复权 | 以”上市日”为基准,把未来公司行为正向应用到历史价格上 | 回测收益率、计算因子 |
三个口径反映同一段历史,区别只在”基准点”。前复权的优点是”今天的价格永远等于真实价格”,缺点是历史每发生一次新公司行为,整个历史序列都会被重写一次。后复权反过来,“上市日的价格永远等于真实价格”,未来每一次公司行为只在”今天往后”的序列里加一个倍数。
5.3 复权的常见误用
用前复权计算长期年化收益。前复权的”今日基准”会随每一次新公司行为变化,意味着同一段历史窗口在不同时点上看,数值不一样。如果你昨天的回测结果是 12.3%,今天因为某只股票分红,重新跑得到 12.1%,差距来源不是 alpha 变了,是基准变了。回测严格要求口径稳定,应该用后复权。
用不复权做收益率。这是初学者最常见的错误。除权日会出现一根虚假的”暴跌”K 线,把动量、反转因子全算坏。
前复权用于因子库。因子在不同日期重算时会得到不同的”历史值”。一个 PE-TTM 因子在前复权下,分母(每股盈余)保持原样,分子(价格)天天在变,PE 序列被”反复重写”,PIT 库根本无法稳定存储。
复权和价格在同一张表里却没标注。最危险的状态是:数据库里存了”close”
一列,谁也不知道是什么口径,研究员各自假设。这种事故的修法是字段命名强制带口径后缀:close_raw、close_fwd、close_bwd。
5.4 复权公式
A 股复权的标准公式来自交易所披露的除权除息事件。设某日除权除息,事件前一日收盘价 \(P_{\text{prev}}\),分红 \(D\)(每股税前)、送股比例 \(\beta\)(每 10 股送 \(\beta \times 10\))、配股比例 \(\gamma\)、配股价 \(P_c\)。除权参考价(理论值):
\[ P_{\text{adj}} = \frac{P_{\text{prev}} - D + P_c \times \gamma}{1 + \beta + \gamma} \]
后复权的累积因子从最早一天向今天累乘:
\[ F_t = \prod_{i \le t} \frac{P_{\text{prev},i}}{P_{\text{adj},i}} \quad \text{对每个除权日 } i \]
后复权价 = 原始价 × \(F_t\)。前复权则是把今天的因子设为 1,向历史反推。
落到代码上:
def back_adjust(prices: pd.Series, events: pd.DataFrame) -> pd.Series:
    """
    prices: 不复权收盘价,index 是交易日
    events: 公司行为表,columns = ['date', 'div', 'send', 'rights', 'rights_price']
    返回后复权价。
    """
    factor = pd.Series(1.0, index=prices.index)
    for _, e in events.sort_values("date").iterrows():
        d = e["date"]
        if d not in prices.index:
            continue
        prev_idx = prices.index.get_loc(d) - 1
        if prev_idx < 0:
            continue
        p_prev = prices.iloc[prev_idx]
        p_adj = (p_prev - e["div"] + e["rights_price"] * e["rights"]) \
                / (1 + e["send"] + e["rights"])
        ratio = p_prev / p_adj
        factor.loc[d:] *= ratio
    return prices * factor
这段代码经过删减只保留主路径,生产代码还要处理: - 现金分红的扣税口径(含税 vs 不含税,因机构持股周期不同而不同) - 配股是否实际认购(影响是否进入复权) - 异常事件(合股、缩股、回购注销、分立)
5.5 港股、美股的特殊情形
香港市场分红常见以”红股”(送股的港股版本)形式发放,比例不一定是整数股,复权时要按交易所披露的实际比例处理。港股还有一些上市公司会做”实物分派”——把子公司股票按比例分给原股东,这相当于一次反向的分立,复权公式要按”分派标的的市值 / 母公司市值”做比例调整。
美股的拆股(Stock Split)和合股(Reverse Split)频率比 A
股高。例如苹果 2014 年 7 拆 1、2020 年 4 拆 1,特斯拉 2020
年 5 拆 1、2022 年 3 拆
1。合股则常见于面值过低面临退市风险的股票,1-for-10
这种比例会让历史价格上一个数量级。这两类事件在
CRSP、Compustat 里有标准的事件代码(CRSP 里是
DISTCD),数据团队拉数据时要把这一列一起拉下来。
ADR(American Depositary Receipt)的复权是更细的坑——ADR 持有的是托管银行存放的境外股票”凭证”,每张 ADR 对应若干股原股,比例可能因托管行调整而变化(叫”ratio change”)。如果你做 A/H/ADR 三地价差套利,ADR 的 ratio change 必须当作一次特殊的复权事件处理。
5.6 工程对策
回测引擎默认用后复权,看图工具默认用前复权,下单网关用不复权。三套口径在数据层一次落库,每一份都有完整历史。任何模块跨口径读数据,必须经过显式转换函数,绝不允许假设”价格列就是后复权”。
六、停牌与流动性陷阱:账面成交的不是真实成交
6.1 停牌期持仓
A 股的停牌(Suspension)有两种:日内停牌(盘中临停)和跨日停牌(停牌一天到几个月不等,最长可以是借壳、重组事项中的”无限期停牌”)。重组停牌曾经动辄半年甚至一年。
停牌期间持仓出问题在于:账面市值通常按”停牌前最后一笔成交价”或”前收盘”标记,但你既不能加仓也不能减仓。复牌后跳空——尤其是借壳类、被并购类,跳空 50% 不算罕见。如果回测引擎默认”每天可以按收盘成交”,停牌区间的所有调仓信号都会被错误执行,复牌当日的盈亏也会被错误吸收。
修法是在 tradable_universe(t)
里把停牌标的剔除。具体到代码:
def can_trade(stock_id, t, suspension_table):
    if (stock_id, t) in suspension_table.full_day:
        return False
    return True
复牌当天是否可交易也要单独判断。深交所、上交所对复牌当日的交易制度不一样,部分情况下复牌首日只允许集合竞价或限定波动幅度。回测里不区分这一层会导致开盘秒成交被高估。
6.2 复牌跳空
跳空(Gap)本身不是偏差,是真实市场行为。但是当你的回测里出现了”组合在停牌期间持有了重组股,复牌后大涨 80%“,这部分收益要看是不是”按收盘价标记”在悄悄送钱。
工程上要做两件事:
- 用真实的复牌首日成交价(最优一笔成交、加权 VWAP)来标记停牌段的标记价格波动,而不是粗暴线性内插。
- 如果策略本身要刻意吃复牌跳空,要单独标注 “需要预测公司行为” 这一假设,并在因子归属上和”市场层面 alpha”分开。
6.3 涨跌停封单
A 股有涨跌停(Daily Price Limit)制度。涨停时,所有人都想买,挂买不一定能成;跌停时反过来。如果回测里”按收盘价成交”,等于假设你永远抢得到封单——这对小单可能近似成立,对组合级别的下单完全不成立。
工程上要在成交模拟里加约束:
def fill_with_limit(order, t, market_state):
    """
    简化的涨跌停成交模拟:
    - 涨停且 order 是买单:成交量 = min(挂单量, 残余封单量) * 概率折扣
    - 跌停且 order 是卖单:同上
    - 非涨跌停:按 VWAP 或冲击模型成交
    """
    if market_state.is_upper_limit(t) and order.side == "buy":
        return min(order.qty, market_state.queue_left(t) * 0.1)
    if market_state.is_lower_limit(t) and order.side == "sell":
        return min(order.qty, market_state.queue_left(t) * 0.1)
    return simulate_normal_fill(order, t, market_state)
0.1
这个系数代表”封单里能挤进去的概率”。具体值可以做日内 L2
数据的统计,也可以做悲观假设(0
成交)。涨跌停日的成交假设差一个数量级,对回测里”追涨型”或”反向博弈型”策略的影响极大。
6.4 异常成交与”擦边”价差
历史数据里偶尔会出现异常的”擦边”成交:1 股的成交把价格瞬间打到涨停或跌停,又在下一秒回到正常区间。这类成交进了日线 OHLC 的 high / low,但实际上不可交易。如果策略用 high / low 作为触发条件(比如”突破日内高点开仓”),这种擦边价格会触发幻影信号。
修法是在数据清洗阶段就把”瞬时异常 + 短时回归”的 tick 标记出来,落库的 OHLC 用”过滤后的 tick”重算。具体阈值(比如”价格偏离上一笔超过 5% 且 30 秒内回归”)要按市场和标的活跃度调。
6.5 流动性陷阱
流动性是另一个隐性陷阱。当你回测一个组合,理论交易额可能远超过该股票真实成交额。比如 A 股某只小盘股日成交 1 亿,组合按因子排序给它分配 1 亿仓位——你已经吃光了一天的流动性,事实上不可能成交。
工程对策:
- 限制单只标的最大单日交易额为该日成交额的某个比例(典型 5%~10%)。
- 把组合分散度纳入约束,避免少数标的吃光流动性。
- 在成交模拟里加冲击模型(Almgren-Chriss、Square-Root Law),不是免费成交。
七、时区与日历:跨市场对齐的细节
7.1 节假日与半日市
中国大陆 A 股周末和法定节假日不开盘。香港、美股、A 股的节假日体系不重合。每年春节、清明、五一、端午、国庆,A 股会休市;美股复活节五(Good Friday)、感恩节、独立日休市;港股大致跟随大陆但加进圣诞、元旦。
在跨市场策略里(典型场景:A/H 套利、ADR 套利),如果回测引擎按”自然日”对齐,会把”A 股放假、美股开盘”的日子算进每日收益,造成因子位移。正确的做法是按交易日历对齐(Trading Calendar),跨市场时取交集或并集,明确缺失日的处理规则。
半日市(Half-Day Trading)是另一种特殊情况。香港圣诞前夕、平安夜,美股感恩节后一天,都只交易半天。如果回测按”全天 VWAP”成交,半日市会得到错误的成交量基准。
7.2 夏令时
美国市场开盘时间在中国时区里随夏令时切换:3 月到 11 月按夏令时,对应北京时间 21:30 开盘;其余时间对应 22:30 开盘。如果你的”日终标记”统一在北京时间某个时刻 cut,跨夏令时切换那一周可能出现”今天的标记错过了开盘”或”今天标记包含了第二天的开盘”。
工程上的处理是把所有时间戳存为 UTC,落到具体市场时再转该市场的本地时区,永远不要在中间存”无时区”的字符串。pandas 里:
ts_utc = pd.Timestamp("2024-03-11 14:30", tz="America/New_York").tz_convert("UTC")7.3 跨市场对齐的两种策略
对齐到交集:只保留两边都开盘的交易日。优点是不需要插值;缺点是数据条目少、信号更新慢。
对齐到并集:两边任一开盘就保留。某市场休市当日的价格用”上一交易日收盘”前推。优点是信号更新及时;缺点是引入了”看似有变化”的虚假数据,要小心区分。
A/H 配对、A/美 ADR 套利、跨市场对冲建议先用交集做出第一版回测,再把并集对齐作为压力测试。
7.4 跨市场的调仓日”对齐窗口”
跨市场对冲(A/H、A 股 / 沪深 300 期货 / 富时 A50 期货)有一个细节:现货市场和期货市场的交易时段不重合。新加坡交易所的富时中国 A50 期货交易时段比 A 股长,除日盘外还有夜盘。如果对冲组合用 A 股收盘价标记 PnL、A50 用其当时的实时价,PnL 序列里会出现一个系统性的”时差错配 alpha”。
修法:把所有跨市场标记价格统一到一个共同时刻,比如”A 股 15:00 收盘”那一刻 A50 的最新成交。如果某市场那一刻没成交(节假日),用前一笔成交价并标注 stale。这种处理比”各取各的收盘”更接近实盘对冲的真实损益。
7.5 实盘与回测的时间对齐
回测里”今天 15:00 收盘后,下一个交易日 09:25
集合竞价下单”这种描述,落到代码必须是绝对时间戳。不要用”shift(1)
等于一个交易日”这种依赖于具体日历的写法。所有调仓事件都和市场日历显式对齐,再用
business_day_offset(calendar, t, n)
这样的函数前后跳。
八、工程对策:把陷阱钉进 CI
讲完了七类陷阱,最后一节给一份可以直接落到工程里的清单。
8.1 数据层:PIT 库的最低要求
- 每张时间序列表必须有三个时间维度:
event_date(事件实际发生时间)、effective_from(对市场可见的起始时点)、ingest_time(数据落库时间)。 - 修订走 append-only:
version递增,旧版本永不被覆盖。 - 任何”快照”(指数成分、行业分类、ST
标记、可融券标的、退市状态)都强制带
as_of查询接口。 - 对外只暴露
as_of(t)视图,禁止任何”全表 scan”用于建模。 - 数据完整性测试:随机抽 100 个 (stock, t) 组合,验证
as_of(t)返回的字段值等于”在 \(t\) 时点真实存在的版本”。
8.2 回测引擎:必须做的几件事
- 调仓步只接受
tradable_universe(t)作为候选集,不允许传入全量代码。 - 标记价格用后复权,但下单价用不复权 + 复权因子转换,绝不混用。
- 涨跌停、停牌的成交模拟必须显式开关,默认”保守”——封单不成交、停牌期不能交易。
- 流动性约束默认开启:单标的单日交易额 ≤ 当日成交额 × 5%。
- 所有特征函数必须接收
PITView而不是DataFrame,强制无法越界。
8.3 单元测试:要写哪些断言
把下面这几条断言写进 CI,每个数据库版本、每次因子库变更都跑一遍:
# 1. PIT 单调性:同一报告期,as_of 越新,看到的版本号不会变小
v1 = store.as_of(sid, t1, report_period=rp)
v2 = store.as_of(sid, t2, report_period=rp)  # t2 > t1
assert v1 is None or v2.version >= v1.version

# 2. 公告日不晚于落库日
assert all(rec.effective_from <= rec.ingest_time for rec in store)

# 3. 后复权因子单调非减(除非有合股/反向行为)
factor = back_adjust_factor(stock_id)
assert (factor.diff().fillna(0) >= -1e-9).all() or has_reverse_split(stock_id)

# 4. tradable_universe 的标的全部满足 inception <= t < delisting
for sid in tradable_universe(t):
    rec = master[sid]
    assert rec.inception_date <= t
    assert rec.delisting_date is None or rec.delisting_date > t

# 5. 价格列命名规范
for col in price_columns:
    assert col.endswith(("_raw", "_fwd", "_bwd")), f"未标注口径的价格列: {col}"

# 6. 特征函数不依赖未来
for feature in registered_features:
    out = feature(view_at(t))
    out_extended = feature(view_at(t, extended_with=future_data))
    assert (out == out_extended).all(), f"{feature.__name__} 依赖了未来"

# 7. 横截面操作的时间戳一致性
def check_cross_section_safety(df, value_col, ts_col):
    by_ts = df.groupby(ts_col)[value_col].agg(["count", "mean"])
    return all(c >= 1 for c in by_ts["count"])
第 6 条特别值得展开。它的实现方式是:在 t
时刻分别用”当时的视图”和”附加未来数据的视图”调用同一个特征函数,结果必须一致。如果未来数据进来后特征值变了,说明函数依赖了未来。这一条是抓未来函数最有效的自动化手段。
8.4 回测前自检清单
每次新策略上回测之前,研究员自己过一遍:
[ ] 标的池:用了 tradable_universe(t),不是当前在册的 universe?
[ ] 退市标的:过去 N 年里组合是否曾持有已退市代码?数量为 0 是异常?
[ ] 行情:复权口径是后复权?字段名带口径后缀?
[ ] 财报:用 PIT 库 as_of(t) 拉的,不是 latest snapshot?
[ ] 分类:行业分类、成分股都按 PIT 拉?
[ ] 信号:所有 rolling/expanding 的 min_periods 不为空?是否 center=False?
[ ] 归一化:z-score、winsorize 是横截面 + 同时间戳,不是全样本?
[ ] 缺失值:填充用截面或扩展窗口,不是全样本均值?
[ ] 调仓:避开了停牌、涨跌停封单情形?
[ ] 流动性:单标的交易额 / 当日成交额 ≤ 阈值?
[ ] 跨市场:日历对齐到交集,时区统一为 UTC?
[ ] 多重检验:参数尝试次数记录在案?是否做了 walk-forward?
[ ] 保留集:开发集、验证集、保留集是否分离?
[ ] 一致性:特征函数对"加未来数据"的视图返回值不变?
清单里的每一条不通过,都要研究员显式写理由,而不是”忽略后继续”。
8.5 灰度上线与回测一致性校验
回测做完到上线之间,还有一段”模拟盘”和”灰度盘”的过渡。这一段的核心目的是把”回测假设”和”实盘事实”对齐,把回测里没暴露的偏差晒出来。
具体的做法:
- 同算法双跑。回测引擎和实盘引擎跑同一份策略代码,回测用历史数据、实盘用当日数据。每天对比两边的”应下单清单”。出现差异就调查原因,要么是回测数据偏差,要么是实盘有新约束没建模。
- 滑点归因。每笔实盘成交都拆解成”理论价(中价)→ 实际成交价”的差额,并归因到价差成本、冲击成本、择时成本。把这套归因长期跑下去,能对回测的成交假设做经验校准。
- 影子组合。在实盘组合之外,跑一个”按回测假设成交”的影子组合,对比真实组合和影子组合的差异。如果影子组合长期跑赢真实组合一大截,说明回测的成交假设过于乐观;反过来则是过于保守。
这套机制不消除任何已有偏差,但能把”哪个假设错了”暴露出来,让数据团队和研究团队回去补回测引擎。
8.6 跨团队的责任划分
数据陷阱的修复不是某一个团队的事,要拆得清楚:
- 数据团队负责 PIT
库的语义正确(
as_of接口、append-only、版本号),负责数据完整性(退市样本、修订事件、公司行为),负责数据落库的时间戳准确。 - 回测团队负责回测引擎对 PIT
数据的正确消费(
PITView、tradable_universe、复权口径),负责成交模拟的保守假设,负责单元测试覆盖。 - 研究团队负责按”出厂检验”流程提交因子,负责在自检清单上签字,负责对因子的论据和假设负责。
- 风控 / 实盘团队负责回测与实盘的一致性校验,负责把实盘踩到的偏差反馈回数据 / 回测团队。
四个团队任意一个偷懒,整条链路都会出问题。这是一种典型的”系统性可靠性”问题,不是单点优化能解决的。
8.7 演练:用历史复盘抓陷阱
把过往的真实事故拿出来复盘,是让团队对数据陷阱形成肌肉记忆的最有效手段。每个季度挑一个事故,重建当时的数据流、信号流、下单流,让新研究员独立诊断。常见的演练题包括:
- 某只重组停牌的股票在停牌期间一直被打分高位,复牌跳空 70% 后组合”赚到”了一大笔,但实际不可能交易——研究员能不能在回测里识别这是假收益?
- 某券商一致预期数据被批量回填了过去三个月的预测,造成事件驱动策略 IR 突然飙升——能不能从数据落库时间戳上发现异常?
- 某只小盘股因为”被新指数纳入”过去一周大涨,但被纳入是数据库回填的”上帝视角”——能不能识别成分股变化的 PIT 漏洞?
这种演练比读规范有效得多,因为它把抽象的”前视”“幸存者”具体到一份 PnL 报告上。
8.8 一种更工程化的姿态
我自己的看法:数据陷阱里最重要的不是某一种偏差怎么修,而是”数据团队”和”研究团队”的接口设计。研究团队应该拿到的是一份”任何时刻 \(t\) 都不可能越界”的视图,而不是一份原始 CSV 让研究员自己注意时间因果性。后者把所有责任压在研究员身上,最后总会有人犯错。前者把约束写进系统接口,犯错的成本是”代码跑不起来”,而不是”上线两个月才发现 alpha 是假的”。
把数据陷阱钉进 CI,不是为了让研究员更舒服,而是为了让研究员的精力真的放在 alpha 上,而不是和数据捉迷藏。
九、开放问题
- 退市收益该填多少,没有中性答案。§1.3 的仿真说明,填补口径能让同一个因子从显著为正变成显著为负。Shumway(1997)、Shumway 与 Warther(1999)给出的 \(-30\%\)、\(-55\%\) 来自 1990 年代前的美股,A 股的退市路径(长期 *ST、退市整理期、转入退市板块后继续交易)完全不同。在 A 股上应该用退市整理期最后价格、退市板块价格,还是某个经验折扣,目前没有公认做法;可行的工程选择是把口径做成参数,报告结论对它的敏感度。
- A
股历史退市样本的可得性与口径统一。注册制后强制退市增多,但免费
API 对
delisting_date、最后交易价、重组承接代码的覆盖不完整;各 vendor 对”暂停上市 vs 终止上市”、吸收合并等事件的处理不一致。缺少像 CRSP 那样带 delisting return 的公共基准,行业尚无可审计的开源 PIT 退市主数据。 - 修正多重检验之后还剩下什么。Harvey、Liu 与 Zhu(2016)主张提高显著性门槛,Sullivan 等人(1999)却显示即使通过 Reality Check 的规则也会在样本外失效。数据窥视修正能识别”挑出来的运气”,但无法识别”真实存在过、后来被套利掉的规律”,两者在回测里长得一样。
- 借壳与吸收合并的
entity_id链路缺乏交接标准。行情按 code、基本面按 entity 已是共识,但各数据源对重组完成日、报表追溯起点标注不一,跨团队复现同一因子时仍靠手工维护映射表。
继续阅读
- 回测陷阱:未来函数、过拟合、幸存者偏差再审视:策略层如何复盘同类偏差。
- 行情、基本面、另类数据管线:PIT 与清洗的上游工程。
- 特征仓库与因子治理:本篇约束如何落到工业级特征库。
- Walk-forward 与 Purged CV:数据干净之后,验证切分怎么做才不泄漏。
- 量化交易系列索引:按角色选择阅读路径。
风险提示
本文讨论的是回测中的数据偏差与工程对策,不构成任何投资建议。文中提到的所有策略、参数、代码示例仅用于说明数据陷阱本身的机制,不代表任何具体可交易的策略。回测中再”干净”的数据,也无法保证未来收益。任何实盘使用都需自行承担风险,包括但不限于:模型对未来分布失效、流动性枯竭、监管政策变更、极端事件下系统不可用。文中代码均为最小可运行示例,未经工业级压力测试,不要在生产环境直接使用。
十、参考资料
论文
- Brown, S., Goetzmann, W., Ibbotson, R., & Ross, S. (1992). Survivorship Bias in Performance Studies. Review of Financial Studies.
- Carhart, M. (1997). On Persistence in Mutual Fund Performance. Journal of Finance.
- Shumway, T. (1997). The Delisting Bias in CRSP Data. Journal of Finance, 52(1).
- Shumway, T., & Warther, V. (1999). The Delisting Bias in CRSP’s Nasdaq Data and Its Implications for the Size Effect. Journal of Finance, 54(6).
- Campbell, J., Hilscher, J., & Szilagyi, J. (2008). In Search of Distress Risk. Journal of Finance, 63(6).
- Lo, A., & MacKinlay, A. C. (1990). Data-Snooping Biases in Tests of Financial Asset Pricing Models. Review of Financial Studies.
- Sullivan, R., Timmermann, A., & White, H. (1999). Data-Snooping, Technical Trading Rule Performance, and the Bootstrap. Journal of Finance.
- Bailey, D., Borwein, J., López de Prado, M., & Zhu, Q. (2014). Pseudo-Mathematics and Financial Charlatanism: The Effects of Backtest Overfitting on Out-of-Sample Performance. Notices of the American Mathematical Society.
- Harvey, C., Liu, Y., & Zhu, H. (2016). …and the Cross-Section of Expected Returns. Review of Financial Studies.
- Bailey, D., & López de Prado, M. (2014). The Deflated Sharpe Ratio: Correcting for Selection Bias, Backtest Overfitting, and Non-Normality. Journal of Portfolio Management.
书籍
- López de Prado, M. (2018). Advances in Financial Machine Learning. Wiley. 第 7 章 purged k-fold 交叉验证,第 11–12 章回测风险与组合式 purged CV,第 14 章回测统计量。
- Chan, E. (2013). Algorithmic Trading: Winning Strategies and Their Rationale. Wiley.
规范与文档
- 上海证券交易所《交易规则》《股票上市规则》。
- 深圳证券交易所《交易规则》《股票上市规则》。
- 中国证监会《上市公司信息披露管理办法》。
- CRSP US Stock Database Guide:完整退市样本的标杆数据集。
- Compustat Point-in-Time Database Guide:PIT 财务数据库的工业标准。
数据源
- Wind、Choice、聚源、同花顺 iFinD:A 股 PIT 财报与指数成分历史。
- tushare、akshare、yfinance:免费层数据,原型可用,落地需自补 PIT 与退市主数据。
- Bloomberg
INDX_MWEIGHT_HIST、BDS字段:指数成分历史。
实验 / 工具(本站可复现)
- §2.5
PITFundamentalStore、§2.8pit_vs_lookahead.py:标准库 + pandas,无外部行情依赖。 - §1.3
survivor-curves.svg:示意曲线,非回测输出;勿与 §2.8 玩具 PnL 混为一谈。
上下篇导航
- 上一篇:《行情、基本面、另类数据:采集、清洗、入库》
- 下一篇:《特征仓库与因子治理》
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【量化交易】行情与基本面数据管线:tick、bar、因子库
把量化系统里最容易藏雷的数据层从 tick 写到因子库走一遍:行情源接入与质量评估、tick 到 dollar bar 的 de Prado 式重采样、Parquet/Arrow/DuckDB/ClickHouse 列存选型、增量回填与断点续传、公司行动与前后复权、PIT 因子库与版本化查询、缺失监控与漂移检测;附 polars + pyarrow + duckdb 的可运行实现。
【量化交易】回测陷阱:前视偏差、过拟合、数据窥视与 Deflated Sharpe
回测 Sharpe 漂亮却上线失效,多半死于前视偏差、过拟合和数据窥视。本文给出前视偏差的三条机械自查规则,用可复现仿真说明零信号数据上挑出的最佳策略能通过 PSR 却被 DSR 拒掉,并附 Bonferroni、BH-FDR、DSR 的 Python 实现与 30 条上线前自检清单。
【量化交易】Walk-forward 与 Purged CV:时间序列正确切分
把「时间序列怎么做交叉验证」这件事拆到工程能落地的颗粒度:为什么 K-Fold 在金融数据上必然泄漏,Walk-Forward 的三种形态怎么选,Purged K-Fold 的 purge 规则与 embargo 长度怎么定,Combinatorial Purged CV 如何同时给出多条独立净值路径,外层选模型内层调参的嵌套 CV 怎么写,回测过拟合概率(PBO)怎么算。给出可直接接入 sklearn 的 PurgedKFold/CombinatorialPurgedCV/WalkForward 实现。
量化交易
从因子研究到生产执行的量化交易全栈工程。覆盖市场微结构、数据管线、因子构造、组合优化、回测方法论、执行算法、做市策略、高频架构到生产运维。面向策略研究员与工程师。