关于哈希表,流传着几句很顺口的话:“哈希表是 \(O(1)\) 的”;“Robin Hood 把最长探测距离从 \(O(\log n)\) 降到 \(O(\log\log n)\)”;“backward shift 删除是 Robin Hood 独有的优势,tombstone 只是负担”;“Go 的 map 是链式哈希”。这几句话要么缺了前提,要么已经过时。\(O(1)\) 是期望值,常数由负载因子决定,线性探测在负载 0.95 时一次未命中查找平均要看约 200 个槽位;\(\log\log n\) 的结论来自随机探测模型,放到线性探测上不成立;普通线性探测同样可以不用 tombstone 删除,而 tombstone 在理论上还有”反聚集”的一面;Go 从 1.24 起默认改用 SwissTable。
本文按”模型 → 链式 → 线性探测 → Robin Hood → 删除 →
SwissTable → 生产实现 →
争论”的顺序展开。文中所有探测次数都来自同目录
reproduce/
下的模拟程序,指标全部是计数,与时钟无关;所有实现细节都钉在具体版本的源码上。
一、问题模型:负载因子与”期望 \(O(1)\)”
哈希函数 \(h\) 把键映射到 \(\{0, 1, \ldots, m-1\}\),表里有 \(n\) 个键,负载因子(load factor)\(\alpha = n/m\)。经典分析假设简单均匀哈希:每个键的哈希值独立、均匀地落在 \(m\) 个位置上。这个假设在后文第八节会被重新审视。
冲突来得比直觉早。插入 \(k\) 个键后至少发生一次冲突的概率约为 \(1 - e^{-k(k-1)/(2m)}\),令它等于 \(1/2\) 得 \(k \approx \sqrt{2m\ln 2} \approx 1.18\sqrt{m}\):1024 个桶插入约 38 个键、65536 个桶插入约 302 个键时,冲突就已经比不冲突更可能。所以冲突处理不是边角情况,而是哈希表的主体。
处理冲突有两大流派。下图用同样 5 个键对比两种内存布局:
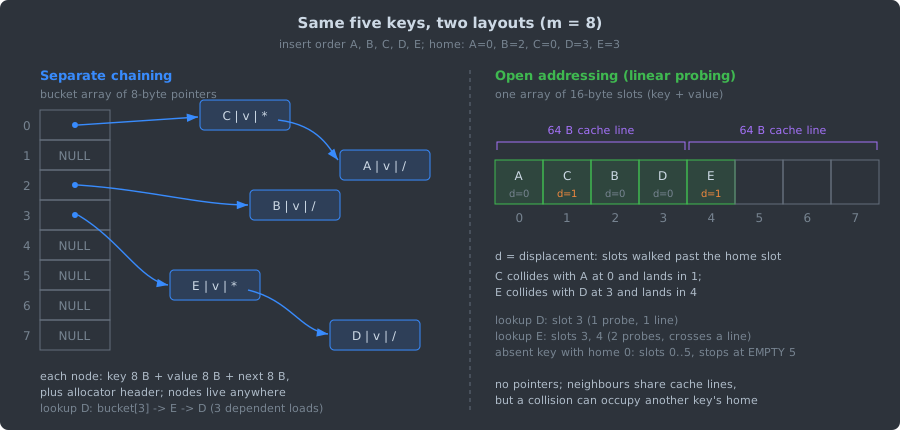
- 链式哈希(separate chaining):桶数组只存指针,冲突的键挂在同一条链上。图中查找 D 要先读桶 3,再读 E 的节点,再读 D 的节点,三次读取前后依赖。
- 开放寻址(open addressing):所有键都放在一个数组里,冲突时按探测序列找下一个空位。图中 C 的家(home,即 \(h(k)\) 指向的槽)是 0,被 A 占了,于是落在 1;E 被 D 挤到 4。槽里记的 \(d\) 是位移(displacement),即离家走了几步。代价是冲突的键会占用别人的家。
这两条路线的学术谱系大致如下:Peterson 在 1957 年的 IBM Journal of Research and Development 上发表了最早的开放寻址检索代价分析之一;Knuth 在 1963 年的未发表手稿中给出线性探测的精确分析,后来写进 TAOCP 第 3 卷 6.4 节;Celis、Larson 和 Munro 在 FOCS 1985 提出 Robin Hood 哈希;Yao 在 JACM 1985 证明均匀探测在一类方案中最优,并留下一个猜想,直到 2024 年才被推翻(第八节)。工程上的分叉点在 2017 年前后:Google 公开 SwissTable 的设计,之后 Rust(1.36)和 Go(1.24)的标准实现先后迁移过去。
二、链式哈希
代价
链式哈希在均匀假设下的代价很好算:成功查找平均检查 \(1 + \frac{n-1}{2m} \approx 1 + \frac{\alpha}{2}\) 个节点,未命中查找平均检查 \(\alpha\) 个节点。负载因子可以超过 1,删除只是摘链,不需要任何标记。最长链的长度在 \(\alpha\) 固定时约为 \(\log n / \log\log n\)(Gonnet 1981,转引自 Devroye 等 2004 年论文的引言),比开放寻址的最长探测序列短得多,第三节的实测也是如此。
真正的代价在内存访问上。每个节点单独分配,next
指针指向哪里由分配器决定,下一次读取必须等上一次读取完成。第三节用”触及多少条缓存行”近似这件事。
Java HashMap:链表加红黑树(JDK 21)
java.util.HashMap 是链式哈希。以 OpenJDK
jdk-21-ga 的
src/java.base/share/classes/java/util/HashMap.java
为准:默认容量
16(DEFAULT_INITIAL_CAPACITY),默认负载因子
0.75(DEFAULT_LOAD_FACTOR),桶下标用
(n - 1) & hash,其中 hash()
先把 hashCode() 的高 16 位异或到低 16
位((h = key.hashCode()) ^ (h >>> 16)),让容量较小时高位也能参与定位。
Java 8 起,单个桶过长时会从链表转成红黑树,动机见 JEP 180(Handle Frequent HashMap Collisions with Balanced Trees):大量键落进同一个桶时,查找从 \(O(n)\) 退化到 \(O(\log n)\),而不是一直线性扫描。三个常量共同决定何时转换:
// OpenJDK jdk-21-ga, java/util/HashMap.java(摘录)
static final int TREEIFY_THRESHOLD = 8;
static final int UNTREEIFY_THRESHOLD = 6;
static final int MIN_TREEIFY_CAPACITY = 64;

final void treeifyBin(Node<K,V>[] tab, int hash) {
    int n, index; Node<K,V> e;
    if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY)
        resize();
    else if ((e = tab[index = (n - 1) & hash]) != null) {
        // ... 把链表节点换成 TreeNode 并建树
    }
}
flowchart TD
A["putVal appends a node to a bin"] --> B{"bin now has more than 8 nodes?"}
B -- no --> L["keep the linked list"]
B -- yes --> C{"table length below 64?"}
C -- yes --> R["resize: double the table instead"]
C -- no --> T["treeifyBin: convert the bin to a red-black tree"]
T --> S{"during resize split: a half has at most 6 nodes?"}
S -- yes --> L
S -- no --> T几个容易说错的细节:
putVal里的判断是binCount >= TREEIFY_THRESHOLD - 1,追加的是第 9 个节点时才调用treeifyBin,即”链长超过 8”。- 表长小于 64 时
treeifyBin只扩容、不建树:小表里的长链更可能是表太小,而不是哈希冲突集中。 - 退化回链表有两条路径。扩容时
TreeNode.split()把一棵树拆成高低两半,某一半不超过 6 个节点(lc <= UNTREEIFY_THRESHOLD)就退化;删除时removeTreeNode()不看节点数,而是看树形(根的左子或右子为空、或左孙为空)判断”太小”。
Redis dict:链式加渐进式 rehash(Redis 7.4.2)
链式哈希的另一个工程问题是扩容:全量 rehash 是一次 \(O(n)\) 的停顿。Redis 的
dict 用两张表把这个停顿摊开。以 Redis 7.4.2 的
src/dict.h、src/dict.c 为准:
struct dict里有ht_table[2]、ht_used[2]和rehashidx,rehashidx == -1表示没有在 rehash。- 扩容条件在
_dictExpandIfNeeded():允许扩容时,元素数达到桶数(ht_used[0] >= DICTHT_SIZE(...),负载因子 1)就扩;有子进程做持久化时(DICT_RESIZE_AVOID)要等比例达到dict_force_resize_ratio(7.4.2 中为 4)才扩,以减少写时复制的内存页。 - 每次增删查在 rehash
期间顺带迁移:
_dictRehashStep()调用dictRehash(d, 1)迁移一个桶,最多跳过n*10个空桶;dictFind()若发现要查的键所在的旧桶还没迁移,就优先迁移这个桶(_dictBucketRehash())。dictRehashMicroseconds()提供按时间片批量迁移的接口。
flowchart TD
    A["dictAdd / dictFind / dictDelete"] --> B{"rehashidx != -1 ?"}
    B -- no --> N["use ht_table[0] only"]
    B -- yes --> C["migrate one bucket from ht_table[0] to ht_table[1]"]
    C --> D["search both tables; new keys go to ht_table[1]"]
    D --> E{"ht_used[0] == 0 ?"}
    E -- yes --> F["free old table, ht_table[1] becomes ht_table[0], rehashidx = -1"]
    E -- no --> G["continue on later operations"]
代价是 rehash 期间每次查找可能要看两张表。站内 Redis 字典与渐进式 rehash 对这部分有更完整的源码拆解。
三、线性探测:Knuth 公式与实测
探测序列
开放寻址的三种经典探测序列(第 \(i\) 次探测,\(i = 0, 1, 2, \ldots\)):
\[ \text{linear: } h(k) + i, \qquad \text{quadratic: } h(k) + c_1 i + c_2 i^2, \qquad \text{double: } h_1(k) + i \cdot h_2(k) \pmod m. \]
- 线性探测每次走一格,相邻探测大多落在同一条缓存行里。
- 二次探测打散了相邻的冲突,但同一个家的键仍走同一条序列(二次聚集,secondary clustering)。它也不保证遍历全表:\(m\) 为素数、取 \(c_1 = 0, c_2 = 1\) 时,前 \(\lceil m/2 \rceil\) 个探测位置两两不同,所以只有 \(\alpha < 1/2\) 时才能保证找到空位。\(m\) 为 2 的幂时改用三角数序列 \(h(k) + \frac{i(i+1)}{2}\),可以恰好遍历所有位置,SwissTable 在分组层面用的就是这种序列。
- 双重哈希用第二个哈希决定步长,要求 \(h_2(k)\) 与 \(m\) 互素(\(m\) 为 2 的幂时取奇数)。不同键的探测序列基本独立,行为接近均匀探测,但每一步都跳到新的缓存行。
一次聚集
线性探测的问题是一次聚集(primary clustering):连续被占用的一段槽位(下文称 run)会越长越快。
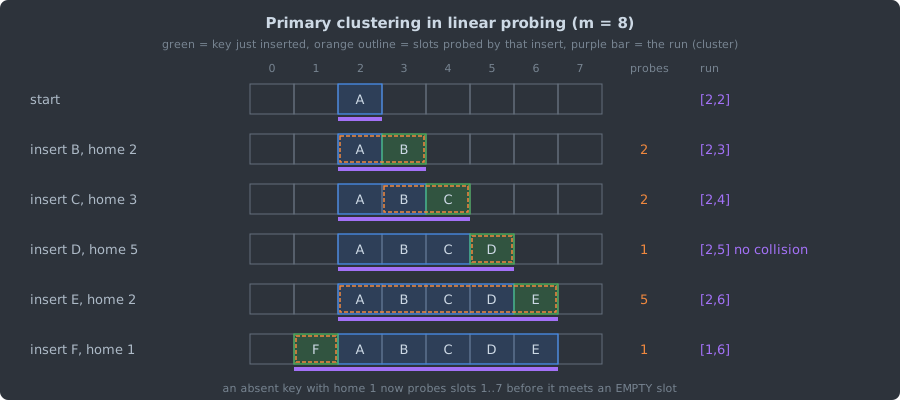
图中紫色条是 run。D 没有发生任何冲突,只因为落在 run 的紧邻位置,就把 run 延长了;E 的家在 run 的开头,要走过整个 run 才能落脚。一般地,一个长为 \(L\) 的 run 两侧都是空槽时,新键的家落在 run 内部或两侧那两个空槽上都会让它变长,概率是 \((L+2)/m\):run 越长,越容易继续变长。
Knuth 在 1963 年的手稿中给出了这个正反馈的精确代价(TAOCP 第 3 卷 6.4 节,Algorithm L 的分析)。在均匀哈希假设下,\(n, m \to \infty\)、\(\alpha\) 固定时,成功查找与未命中查找的平均探测次数为
\[ C_n \approx \frac{1}{2}\left(1 + \frac{1}{1-\alpha}\right), \qquad C'_n \approx \frac{1}{2}\left(1 + \frac{1}{(1-\alpha)^2}\right). \]
作为对照,均匀探测(每个键的探测序列是一个随机排列,双重哈希近似如此)的对应结果是 \(\frac{1}{\alpha}\ln\frac{1}{1-\alpha}\) 和 \(\frac{1}{1-\alpha}\)。未命中查找的差别最大:线性探测是 \((1-\alpha)^{-2}\) 量级,均匀探测是 \((1-\alpha)^{-1}\)。
实测:公式、最长探测与缓存行
实验环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,GCC
16.1.1。程序
reproduce/probe_sim.c,编译运行:
cd reproduce
gcc -O2 -Wall -Wextra -o probe_sim probe_sim.c -lm
./probe_sim > results/probe_sim.txt口径:\(m = 2^{20}\)
个槽,键是 splitmix64 生成的随机 64 位整数,哈希函数是
MurmurHash3 的 64 位
finalizer(fmix64,一个双射),家为哈希值的低
20 位;未命中查找用 20 万个不在表中的随机键。每个配置跑 5
个种子,平均值取 5 次的均值,最长位移取 5
次的中位数。输出是确定的,连续运行结果逐字节相同;程序也在
-fsanitize=address,undefined
下跑过,输出一致。缓存行按”每槽 16 字节(键和值各 8
字节)、每行 64 字节、表按行对齐”计数;链式哈希按”桶数组 1
行 + 每个节点 1 行”计数。这是一个访存模型,不是计时。
| \(\alpha\) | 线性:成功(实测 / 公式) | 线性:未命中(实测 / 公式) | 线性:最长位移 | 双重哈希:成功 / 未命中 | 双重哈希:最长位移 | 成功查找触及缓存行:线性 / 双重 / 链式 |
|---|---|---|---|---|---|---|
| 0.50 | 1.500 / 1.500 | 2.507 / 2.500 | 33 | 1.386 / 2.002 | 16 | 1.125 / 1.386 / 2.250 |
| 0.70 | 2.166 / 2.167 | 6.069 / 6.056 | 120 | 1.720 / 3.336 | 27 | 1.291 / 1.720 / 2.350 |
| 0.80 | 2.998 / 3.000 | 13.017 / 13.000 | 264 | 2.011 / 5.005 | 45 | 1.500 / 2.011 / 2.400 |
| 0.875 | 4.499 / 4.500 | 32.345 / 32.500 | 624 | 2.376 / 8.016 | 79 | 1.875 / 2.376 / 2.437 |
| 0.90 | 5.493 / 5.500 | 49.883 / 50.500 | 856 | 2.557 / 10.021 | 90 | 2.123 / 2.557 / 2.450 |
| 0.95 | 10.460 / 10.500 | 198.691 / 200.500 | 3286 | 3.155 / 20.002 | 179 | 3.365 / 3.155 / 2.475 |
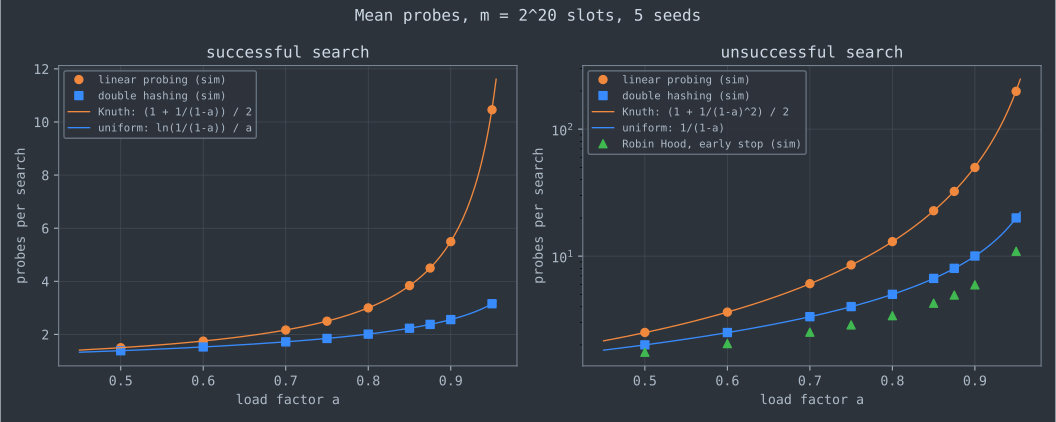
从表和图里能读出四件事:
- 公式成立。所有负载下实测与 Knuth 公式的差距都在 1% 以内(\(\alpha = 0.95\) 的未命中差约 0.9%,是有限表的效应)。双重哈希与均匀探测公式同样吻合。
- 未命中查找是线性探测的软肋。从 0.8 到 0.95,成功查找从 3 次涨到 10.5 次,未命中查找从 13 次涨到约 199 次。插入一个新键先要确认它不存在,代价与未命中查找相同。
- 探测次数多不等于访存多。按缓存行计,线性探测在 \(\alpha \le 0.9\) 时都比双重哈希少碰缓存行(0.9 时 2.12 对 2.56),到 0.95 才反超。链式哈希的”探测”最少(成功查找只看 1.25 到 1.48 个节点),但每次都要多读一次桶数组,而且节点之间是依赖读取。
- 最长探测序列很长。\(\alpha = 0.9\) 时线性探测平均只需 5.5 次,最长却有 856 次;同一张表若用链式哈希,最长链只有 8 个节点。
四、Robin Hood 哈希
规则
Celis、Larson 和 Munro 在 FOCS 1985 提出 Robin Hood 哈希,Celis 的博士论文(Waterloo,1986,技术报告 CS-86-14)给出了完整分析。规则只有一条:插入时沿探测序列前进,如果手里这个键的位移大于当前槽位住户的位移,就把住户换出来,带着它继续往前走。“劫富济贫”指的是离家近的键(富)把位置让给离家远的键(穷)。
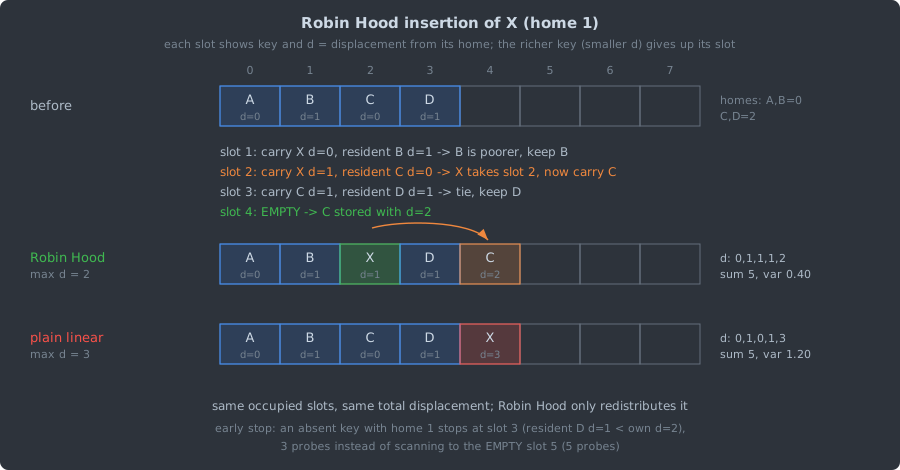
对照图中两种结果:占用的槽位完全相同(0 到 4),位移总和都是 5,Robin Hood 只是把位移重新分配了,最大位移从 3 降到 2,方差从 1.2 降到 0.4。
它改变了什么、没改变什么
Janson(ACM Transactions on Algorithms,2005)研究了线性探测的三种插入策略:先来先得(普通线性探测)、后来先得、Robin Hood。论文指出(并引述 Carlsson 等人与 Poblete、Viola 的结果),同一组键无论用哪种策略插入,被占用的槽位集合相同,因此位移总和相同;Robin Hood 在所有线性探测算法中使位移的方差最小。由此可得:
- 平均成功探测次数不变。上一节的表对 Robin Hood 同样成立。
- 不提前终止时,未命中探测次数也不变:它取决于从家到下一个空槽的距离,而空槽的位置与策略无关。
- 方差和最长位移大幅下降,并且可以提前终止未命中查找:Robin Hood 保证沿 run 前进时位移每步最多加 1,若当前住户的位移小于”我已经走的步数”,要找的键如果存在,早就应该出现在这里之前了。
probe_sim
对同一批键分别用两种策略建表,结果如下(\(m = 2^{20}\),5 个种子):
| \(\alpha\) | 平均成功探测(两者相同) | 位移方差:线性 / Robin Hood | 最长位移:线性 / Robin Hood | 未命中探测:扫到空槽 / Robin Hood 提前终止 |
|---|---|---|---|---|
| 0.50 | 1.500 | 1.58 / 0.67 | 33 / 10 | 2.507 / 1.751 |
| 0.70 | 2.166 | 9.44 / 2.24 | 120 / 16 | 6.069 / 2.517 |
| 0.80 | 2.998 | 35.48 / 5.42 | 264 / 27 | 13.017 / 3.397 |
| 0.875 | 4.499 | 153.93 / 14.66 | 624 / 42 | 32.345 / 4.935 |
| 0.90 | 5.493 | 302.55 / 23.17 | 856 / 50 | 49.883 / 5.941 |
| 0.95 | 10.460 | 2488.17 / 94.05 | 3286 / 86 | 198.691 / 10.923 |
提前终止的收益在高负载下最明显:\(\alpha = 0.9\) 时,未命中查找从约 50 次降到约 6 次,与成功查找处在同一量级。这也是 Robin Hood 能跑到高负载的主要原因。
\(\log\log n\) 的出处
常见的说法是”Robin Hood 的最长位移是 \(O(\log\log n)\),普通线性探测是 \(O(\log n)\)“。\(\log\log n\) 这个结论确实存在:Devroye、Morin 和 Viola(SIAM Journal on Computing,2004)证明最长查找时间以趋于 1 的概率落在 \(\log_2\log n + O(1)\) 附近。但他们的模型是随机探测:每个键的探测序列由独立、均匀分布在全表上的位置组成,更接近双重哈希,而不是线性探测。Celis 论文里的最长探测分析,按 Devroye 等人的引述,也是随机探测模型。
线性探测下没有这样的结论。实测中,Robin Hood 的最长位移随 \(\log_2 m\) 近似线性增长:
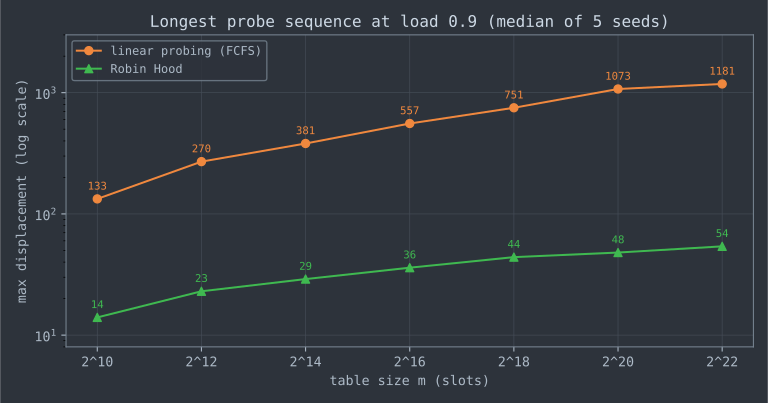
\(m\) 每扩大 4 倍,Robin Hood 的最长位移增加 4 到 9;若是 \(\log\log m\) 增长,从 \(2^{10}\) 到 \(2^{22}\) 只应增加 1 左右。Robin Hood 在线性探测上的收益是常数倍的:\(m \ge 2^{16}\) 时最长位移约为普通线性探测的 \(1/15\) 到 \(1/22\),但增长趋势并没有变成 \(\log\log n\)。Janson 的论文还顺带否定了另一个直觉:在随机探测下,“从平均位移附近开始双向查找”(centered probing)能加速,在线性探测下不能。
Rust 旧版 HashMap(1.0 到 1.35)
Rust 标准库在 1.36 之前用的就是 Robin Hood 线性探测。以
Rust 1.35.0 的
src/libstd/collections/hash/map.rs 为准:
- 负载上限约
90.9%:
raw_cap >= len * 1.1,容量换算为(raw_cap * 10 + 10 - 1) / 11。源码注释的理由是:希望一次查找平均只碰一到两条缓存行的哈希值。 - 每个槽保存完整哈希值,位移由哈希值和槽位现算,不单独存储。
- 默认哈希是 SipHash-1-3。按 Rust 的
RELEASES.md,1.11.0(2016-08)把默认哈希从 SipHash-2-4 改为 1-3。 - 有一个”自适应提前扩容”:探测位移达到
DISPLACEMENT_THRESHOLD = 128、且表至少半满时,不等容量用完就扩容,用来抵御退化输入。注释引用 Viola 2005 年的 Robin Hood 位移分布公式,估算正常输入在 0.909 负载下超过 128 的概率约为 \(1.6 \times 10^{-11}\)。
1.36.0(2019-07-04)的发布说明写明:“HashMap’s
implementation has been replaced with
hashbrown::HashMap implementation”,也就是
SwissTable(第六节)。
实现
reproduce/rh_map.c 是一个完整的 Robin Hood
表(uint64_t 到 uint64_t,负载上限
0.7,容量为 2 的幂)。psl[i] 为 0 表示空槽,为
\(d+1\) 表示位移为 \(d\),一个数组同时编码”空不空”和”离家多远”;用
uint32_t
存,位移不可能超过容量,不存在溢出。核心三个函数如下(摘自
reproduce/rh_map.c,省略了创建、扩容与校验函数):
/* reproduce/rh_map.c(摘录) */
static int rh_place(RHMap *m, uint64_t key, uint64_t value)
{
    size_t mask = m->capacity - 1;
    size_t idx = rh_hash(key) & mask;
    uint32_t dist = 1;

    for (;;) {
        if (m->psl[idx] == 0) {
            m->keys[idx] = key;
            m->values[idx] = value;
            m->psl[idx] = dist;
            m->size++;
            return 1;
        }
        if (m->psl[idx] == dist && m->keys[idx] == key) {
            m->values[idx] = value;
            return 0;
        }
        if (m->psl[idx] < dist) {
            uint64_t tk = m->keys[idx], tv = m->values[idx];
            uint32_t tp = m->psl[idx];
            m->keys[idx] = key;
            m->values[idx] = value;
            m->psl[idx] = dist;
            key = tk;
            value = tv;
            dist = tp;
        }
        dist++;
        idx = (idx + 1) & mask;
    }
}

uint64_t *rh_lookup(const RHMap *m, uint64_t key)
{
    size_t mask = m->capacity - 1;
    size_t idx = rh_hash(key) & mask;
    uint32_t dist = 1;

    for (;;) {
        if (m->psl[idx] < dist)
            return NULL;
        if (m->psl[idx] == dist && m->keys[idx] == key)
            return &m->values[idx];
        dist++;
        idx = (idx + 1) & mask;
    }
}

int rh_delete(RHMap *m, uint64_t key)
{
    uint64_t *v = rh_lookup(m, key);
    if (!v) return 0;
    size_t mask = m->capacity - 1;
    size_t idx = (size_t)(v - m->values);

    for (;;) {
        size_t next = (idx + 1) & mask;
        if (m->psl[next] <= 1) {
            m->psl[idx] = 0;
            m->size--;
            return 1;
        }
        m->keys[idx] = m->keys[next];
        m->values[idx] = m->values[next];
        m->psl[idx] = m->psl[next] - 1;
        idx = next;
    }
}
三处细节:
- 查找里一句
psl[idx] < dist同时处理了”遇到空槽”(0 小于任何dist)和”提前终止”两种情况。 - 键只可能待在
psl等于当前dist的槽里,所以先比位移再比键;一旦发生交换,手里拿的是已在表中的键,后面不可能再命中。 - 删除时后移(backward shift)遇到空槽或
psl == 1(已经在家)的键就停,删完没有任何标记。
reproduce/rh_test.c 对它做差分测试:200
万次随机插入、更新、删除、查找,与直接寻址数组逐次比对,每
65536 步检查一次不变量(每个键的位移与家一致;相邻槽位
psl 最多加 1;空槽之后的键必须在家)。
gcc -O2 -Wall -Wextra -o rh_test rh_test.c rh_map.c && ./rh_test
gcc -O1 -g -fsanitize=address,undefined -Wall -Wextra -o rh_test_san rh_test.c rh_map.c && ./rh_test_san
两种编译方式都输出
ok: 2000000 ops, final size 6013, capacity 16384。把删除的停止条件故意改成
psl[next] == 0 后,测试在第 549
步报错,说明它能抓住后移逻辑的错误。
五、删除:tombstone、Algorithm R 与 backward shift
为什么不能直接清空
开放寻址里,查找遇到空槽就停。把被删的槽直接标成空,会切断经过它的探测路径:
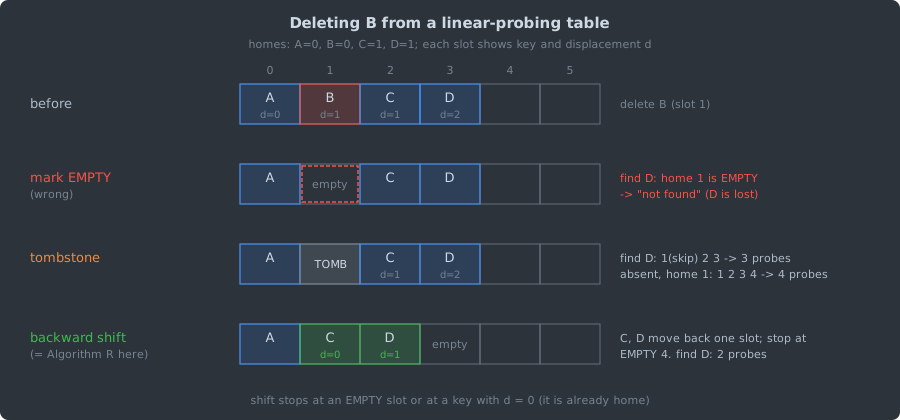
图中给出两种正确做法:
- tombstone(墓碑):把槽标成”已删除”。查找把它当作占用、继续往前;插入可以复用它。代价是墓碑会一直拉长未命中查找,直到重建。
- 往回移动:把后面的键往前挪,填上空洞,删完表里没有任何标记。
往回移动不是 Robin Hood 独有的。Knuth 在 TAOCP 6.4 节给出过普通线性探测的删除算法 Algorithm R:从空洞 \(i\) 往后扫,对槽 \(j\) 中家为 \(r\) 的键,只要 \(i\) 落在它的探测路径 \(r, r+1, \ldots, j\) 上,就把它移到 \(i\),空洞随之移到 \(j\),直到遇见空槽。Robin Hood 的版本更简单:由于”位移每步最多加 1”的不变量,后面的键可以无条件整体前移一格,遇到空槽或位移为 0 的键就停。两者都依赖”探测序列是连续的”,所以双重哈希和 SwissTable 只能用墓碑。
实测:墓碑的两面
reproduce/churn_sim.c 把一张 \(m = 2^{18}\) 的线性探测表填到
\(\alpha = 0.75\),然后执行
\(8n\)
对”随机删除一个已有键、插入一个新键”,键数保持不变。比较四种删除策略:
- 墓碑,不重建:插入复用路径上的第一个墓碑;空槽少于 0.5% 时停止实验。
- 墓碑,7/8 时原地重建:有效键加墓碑达到 \(7/8 \cdot m\) 时用现有键重建整张表,阈值仿照 Abseil 的增长预算。
- Algorithm R。
- Robin Hood backward shift。
每 \(n/32\) 对操作采样一次:未命中查找(必须扫到真正的空槽)的平均探测数,以及插入找到落脚点(第一个空槽;墓碑策略下是第一个空槽或墓碑)的平均探测数。各用 2 万个随机新键,3 个种子取中位数。
gcc -O2 -Wall -Wextra -o churn_sim churn_sim.c && ./churn_sim > results/churn_sim.txt
python3 plot_churn.py results/churn_sim.txt ../deletion-churn.svg   # 需要 matplotlib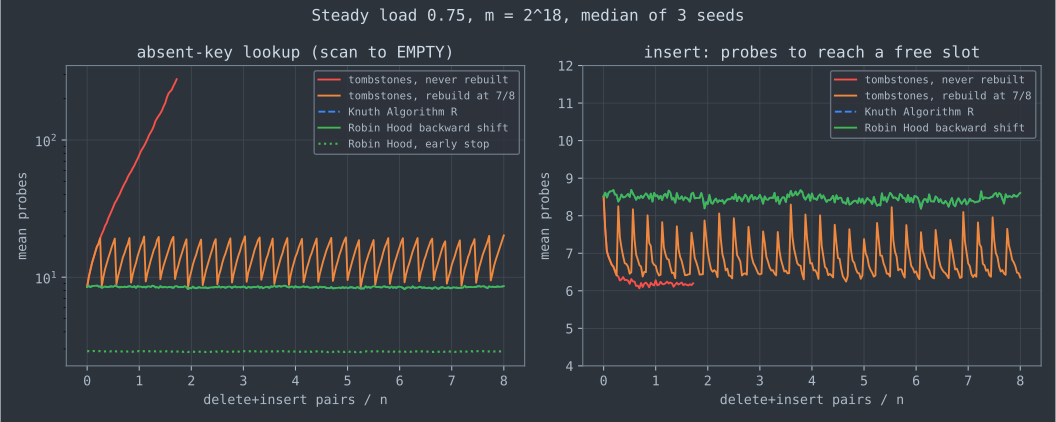
| 策略 | 墓碑占比 | 未命中查找探测数 | 插入落脚探测数 |
|---|---|---|---|
| 墓碑,不重建(\(0.5n\) 对后) | 17.5% | 32.5 | 6.19 |
| 墓碑,不重建(\(1.72n\) 对后停止) | 24.5% | 277.6 | 6.20 |
| 墓碑,7/8 重建(\(n\) 对之后的全部采样) | 0 到 12.4% | 8.4 到 20.2,均值 14.2 | 6.25 到 8.30,均值 6.80 |
| Algorithm R | 0 | 8.2 到 8.7,均值 8.46 | 同左 |
| Robin Hood backward shift | 0 | 8.46;提前终止 2.87 | 同左 |
几点观察:
- Algorithm R 与 Robin Hood 的前两列逐点相同。这不是巧合:线性探测下占用集合只由键的集合决定,两种方法删完之后的占用集合都等于”只插入现存键”的结果,所以一直停在 Knuth 公式的稳态(\(\alpha = 0.75\) 时未命中 8.5 次)。Robin Hood 相对 Algorithm R 的额外收益来自提前终止,而不是来自”没有墓碑”。
- 不重建的墓碑会耗尽空槽。插入只会消耗空槽或墓碑,删除只会制造墓碑,空槽数单调不增;空槽越少,未命中查找越长。\(1.72n\) 对操作后空槽只剩 0.5%,未命中查找已经要 278 次。
- 墓碑让插入落脚更快。两种墓碑策略下,插入找到落脚点只要约 6.2 次,比无墓碑的 8.5 次少。墓碑散布在 run 中间,新键更早遇到可以复用的位置,这正是 Bender、Kuszmaul 和 Kuszmaul(FOCS 2021)所说的墓碑”反聚集”效应。
- 两者的代价落在不同操作上:插入新键若不能事先确定键不存在,仍然要先做一次未命中查找,那一步会被墓碑拖慢。本实验的插入之所以能直接落脚,是因为新键由随机数生成,已知不在表中。
生产实现怎样对付墓碑
- Abseil(20240722.0,
raw_hash_set.cc):EraseMetaOnly()先调用WasNeverFull(),数一数包含该槽位的连续非空槽是否不足 16 个;若不足,说明没有任何 16 槽探测窗口在这里满过,也就没有探测序列越过这里,直接写成kEmpty,否则写kDeleted。增长预算用完时,若size * 32 <= capacity * 25,调用DropDeletesWithoutResize()原地清除墓碑,否则扩容。 - Go
1.24(
internal/runtime/maps):删除时如果所在的 group 还有空槽,直接标空,否则留墓碑;插入优先复用墓碑。墓碑只在扩容时清除。table.rehash()的注释解释了为什么不做原地重建:遍历是按槽位顺序从随机起点走的,原地重排会破坏正在进行的遍历,而 Go 的 map 允许边遍历边修改。 - CPython 3.13:
dk_indices里的DKIX_DUMMY(-2)就是墓碑,对应的dk_entries条目键值置空;两者都要等dictresize()重建时才回收(第七节)。
六、SwissTable:先比元数据,再比键
设计
SwissTable 由 Google 的 Matt Kulukundis 等人设计,在
CppCon 2017 的报告 “Designing a Fast, Efficient,
Cache-friendly Hash Table, Step by Step” 中公开,随后作为
Abseil 的 absl::flat_hash_map /
absl::node_hash_map 开源,设计说明见 abseil.io
的 “Swiss Tables Design
Notes”。它仍是开放寻址,关键变化是为每个槽维护 1
字节控制字节(control
byte),先在控制字节上批量筛选,只对少数候选比较完整的键。
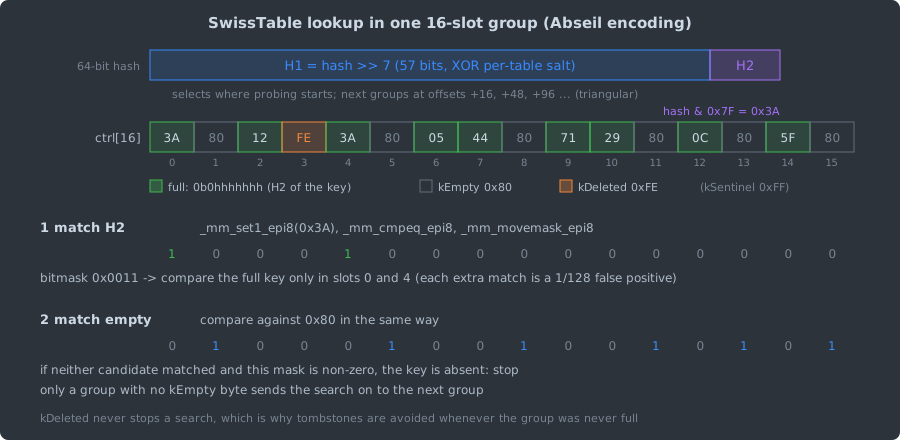
以 Abseil 20240722.0 的
absl/container/internal/raw_hash_set.h
为准:
- 控制字节:
kEmpty = -128(0x80)、kDeleted = -2(0xFE)、kSentinel = -1(0xFF),满槽为0b0hhhhhhh,低 7 位是 H2。 H2(hash) = hash & 0x7F;H1(hash, ctrl) = (hash >> 7) ^ PerTableSalt(ctrl),同一个哈希在不同表里的探测起点不同。probe_seq::next()执行index_ += Width; offset_ += index_;,以组宽为单位的三角数探测,组宽在 SSE2 上是 16。- 负载上限由
CapacityToGrowth()给出:容量减去容量的 \(1/8\),即 \(7/8\)。
一次组内查找就是图中两步:用
_mm_set1_epi8、_mm_cmpeq_epi8、_mm_movemask_epi8
得到 H2
匹配掩码,逐个比较候选键;再求空槽掩码,本组有空槽而键没找到,就可以停止。kDeleted
不会让查找停下,所以上一节的”能不写墓碑就不写”很重要。Rust
的 hashbrown 与 Abseil 的思路相同,但控制字节编码不同(空槽
0xFF、删除
0x80),不要把两者混为一谈。组内细节、SIMD
抽象与 Abseil 源码拆解见 SwissTable
原理。
分组探测的计数模型
probe_sim 的实验 C 模拟一个简化的
SwissTable:\(m = 2^{20}\)
个槽,按组对齐(Abseil 的探测窗口可以从任意槽开始,Go 1.24
按组对齐),组间三角数探测,7 位
H2。统计每次查找访问的组数,以及 H2
误匹配导致的多余键比较次数。
| \(\alpha\) | 16 路:成功 / 未命中访问组数 | 16 路:成功 / 未命中多余键比较 | 8 路:成功 / 未命中访问组数 | 8 路:成功 / 未命中多余键比较 |
|---|---|---|---|---|
| 0.50 | 1.001 / 1.009 | 0.031 / 0.063 | 1.009 / 1.061 | 0.016 / 0.034 |
| 0.70 | 1.016 / 1.146 | 0.045 / 0.102 | 1.058 / 1.385 | 0.024 / 0.062 |
| 0.80 | 1.048 / 1.457 | 0.055 / 0.148 | 1.127 / 1.915 | 0.031 / 0.099 |
| 0.875 | 1.106 / 2.125 | 0.066 / 0.237 | 1.232 / 2.942 | 0.039 / 0.165 |
| 0.95 | 1.263 / 4.960 | 0.089 / 0.597 | 1.481 / 7.075 | 0.056 / 0.426 |
在 \(7/8\) 的负载上限处,16 路分组的命中查找平均只访问 1.1 组,未命中 2.1 组,多余的键比较不到 0.25 次;同样负载下,线性探测的未命中查找要逐个检查约 32 个槽。未命中查找一旦遇到”本组有空槽”就能停,这起到的作用与 Robin Hood 的提前终止相同,但不需要在插入时搬动键。
这张表比较的是计数,单位也不同:一次”访问组”包含一次 16 字节加载和若干条 SIMD 指令,一次线性探测是一次 8 字节比较。两者在真实硬件上谁快,要看键的大小、哈希函数和表是否在缓存里,本文不给计时结论。
七、生产实现对照
| 实现 | 版本 | 结构 | 扩容阈值 | 删除 | 源码 |
|---|---|---|---|---|---|
CPython dict |
3.13 | 索引数组上的开放寻址 + 按插入顺序的条目数组,perturb 探测 | 条目数达到 \(\frac{2}{3}\)
容量(USABLE_FRACTION) |
DKIX_DUMMY 墓碑 |
Objects/dictobject.c |
Java HashMap |
JDK 21 | 链式,长桶转红黑树 | 0.75 | 摘链 | java/util/HashMap.java |
Go map |
1.23 | 8 槽 bucket + overflow 链,渐进式搬迁 | 平均每 bucket 6.5 个键 | 清空槽位 | src/runtime/map.go |
Go map |
1.24 | SwissTable(8 槽 group)+ 可扩展哈希目录 | 每张表 \(7/8\) | 组内有空槽则标空,否则墓碑 | src/internal/runtime/maps/ |
absl::flat_hash_map |
20240722.0 | SwissTable(SSE2 下 16 槽 group) | \(7/8\) | 能标空则标空,否则墓碑,必要时原地清理 | absl/container/internal/raw_hash_set.{h,cc} |
Rust HashMap |
1.0 到 1.35 | Robin Hood 线性探测 | \(10/11\) | backward shift | src/libstd/collections/hash/map.rs |
Rust HashMap |
1.36 起 | hashbrown(SwissTable) | 见 hashbrown 源码 | 墓碑 | hashbrown crate |
Redis dict |
7.4.2 | 链式,双表渐进 rehash | 负载 1;有子进程时为 4 | 摘链 | src/dict.c |
CPython dict:紧凑布局与 perturb 探测
Objects/dictobject.c 文件开头写明 “As of
Python 3.6, this is compact and ordered”,思路来自 Raymond
Hettinger 2012 年在 python-dev 上的提议;3.7
起插入顺序成为语言规范的一部分。
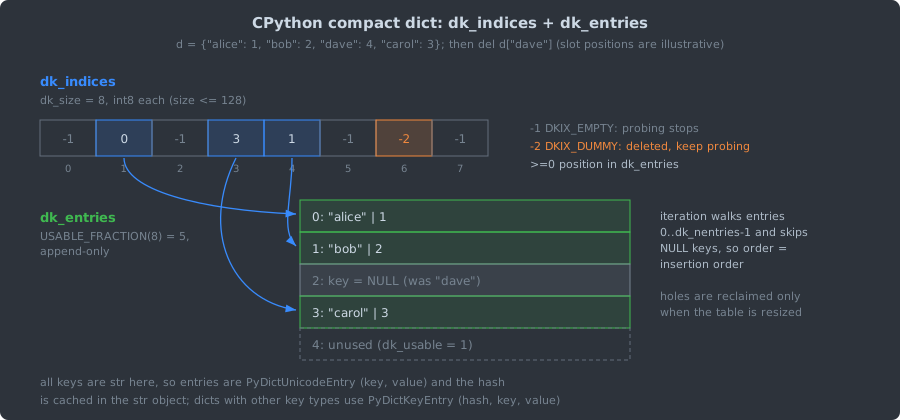
- 哈希表本体是
dk_indices,元素宽度随表大小变化:dk_size <= 128用 int8,到 \(2^{15}\) 用 int16,到 \(2^{31}\) 用 int32,更大用 int64。 dk_entries的长度是USABLE_FRACTION(dk_size),即(n << 1) / 3,所以负载上限是 \(2/3\)。条目只追加不移动,迭代顺序就是插入顺序。- 删除把索引槽写成
DKIX_DUMMY,条目的键值置空;空洞在dictresize()时回收。 - 所有键都是
str时,条目用不带哈希字段的PyDictUnicodeEntry(哈希缓存在str对象里);其他情况用含me_hash的PyDictKeyEntry。
探测序列不是线性也不是二次,而是 perturb 递推:
/* CPython v3.13.0, Objects/dictobject.c, lookdict_index() */
static Py_ssize_t
lookdict_index(PyDictKeysObject *k, Py_hash_t hash, Py_ssize_t index)
{
    size_t mask = DK_MASK(k);
    size_t perturb = (size_t)hash;
    size_t i = (size_t)hash & mask;

    for (;;) {
        Py_ssize_t ix = dictkeys_get_index(k, i);
        if (ix == index) {
            return i;
        }
        if (ix == DKIX_EMPTY) {
            return DKIX_EMPTY;
        }
        perturb >>= PERTURB_SHIFT;
        i = mask & (i*5 + perturb + 1);
    }
    Py_UNREACHABLE();
}
PERTURB_SHIFT 为
5。源码里那段长注释解释了原因:CPython
的整数哈希就是整数本身,hash(i)
对连续整数是连续的,用低位直接定位时连续整数完全不冲突,这比随机哈希还好;但像
[i << 16 for i in range(20000)]
这样的键,低 15 位全相同,全部落到同一个槽。递推 \(j \leftarrow 5j + 1 \bmod 2^k\)
能遍历所有槽,再把 perturb
逐步右移加进去,让高位也参与探测;perturb
最终变成 0,退化为纯 \(5j+1\),仍然保证能找到空槽。str
和 bytes 的哈希是带随机种子的 SipHash:3.13 的
Include/pyhash.h 中默认算法为
Py_HASH_SIPHASH13。
Go:从 bucket 链到 SwissTable
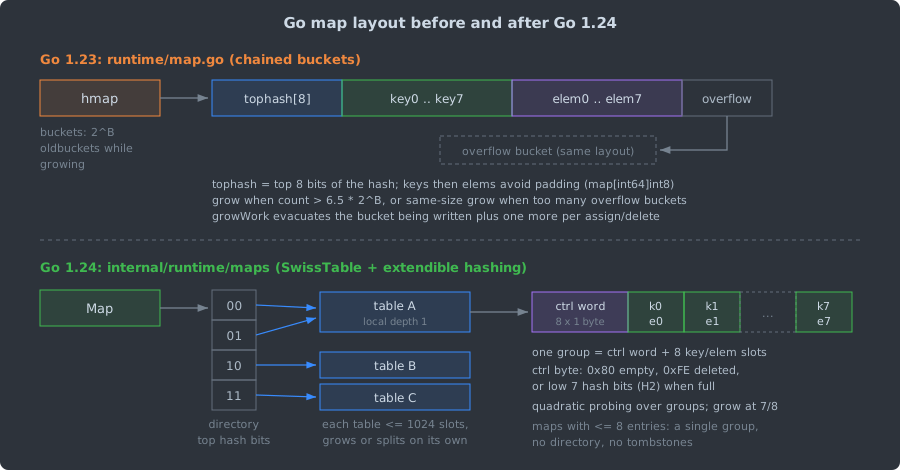
Go 1.23(src/runtime/map.go):
- 每个 bucket 8
个槽(
abi.MapBucketCount),tophash[8]存哈希的高 8 位,先比 tophash 再比键。 - 8 个键连续存放、8
个值连续存放,源码注释说这比键值交错复杂,但能消掉
map[int64]int8这类类型的填充字节。 overLoadFactor()在键数超过 \(6.5 \times 2^B\) 时翻倍扩容(loadFactorNum/loadFactorDen即 \(8 \times 13/16\));tooManyOverflowBuckets()触发等量扩容,用来整理删除后留下的长 overflow 链。- 扩容是渐进的:
mapassign()和mapdelete()调用growWork(),先搬迁当前要写的 bucket 对应的旧 bucket,再多搬一个h.nevacuate。搬迁会移动键值;Go 语言本来就不允许对 map 元素取地址(&m[k]无法通过编译),实现可以自由搬动元素。 - 每个 map 创建时生成随机种子
h.hash0。
Go
1.24(src/internal/runtime/maps/,发布说明称可用
GOEXPERIMENT=noswissmap 关闭):
- 一个 group 是 8 字节控制字加 8 个槽;控制字节
0x80为空、0xFE为删除,满槽存 H2。H2 与 Abseil 一样取哈希低 7 位,H1 取高 57 位;Abseil 给 H1 异或每张表的盐值,Go 则让每个 map 的随机种子m.seed参与哈希计算。 - 组间二次探测(
probeSeq.next()中offset = (offset + index) & mask),每组平均负载上限maxAvgGroupLoad = 7,即 \(7/8\)。 - 为了保留渐进扩容,map 由多张表组成,每张表不超过
maxTableCapacity = 1024个槽,用哈希高位经目录选表(可扩展哈希,extendible hashing)。单张表扩容时一次搬完,但一次最多搬 1024 个槽;超过上限就分裂成两张表。 - 不超过 8 个元素的小 map 直接就是一个 group,没有目录,也不会有墓碑。
发布说明把新 map 列为 Go 1.24 运行时平均 2% 到 3% CPU 开销下降的原因之一(与小对象分配、运行时互斥锁的改进合计),没有单独给出 map 的收益。
八、争论与开放问题
争论一:线性探测需要多”随机”的哈希函数
Knuth 公式假设哈希值完全随机,生产系统用的是固定的快速函数。Pagh、Pagh 和 Ružić(STOC 2007,SIAM Journal on Computing 2009)证明:只用两两独立(pairwise independent)的哈希族,线性探测的期望代价可能是对数级;用 5 阶独立(5-wise independent)就能保证每次操作期望常数时间。Pătraşcu 和 Thorup(ICALP 2010)给出匹配的下界:他们构造了一个 4 阶独立的哈希函数,使某些键的期望查找时间为对数级,并指出很快的 2 阶独立 multiply-shift 在这类应用中会严重失效。Pătraşcu 和 Thorup 在 STOC 2011 又证明,只有 3 阶独立的简单 tabulation 哈希也能让线性探测达到期望常数时间,说明”独立阶数”并不是唯一的判据。
工程上的做法各不相同。CPython
有意让整数哈希保持规则,把打散的工作交给 perturb
探测;Abseil、Rust、Go
都用强混合的哈希函数并加入随机种子,Rust 默认的 SipHash-1-3
还以抵御哈希洪泛攻击(hash
flooding)为设计目标。第三节的实验用的是 fmix64
这种双射混合函数和随机键,这正是”接近理想”的情形;键有规律、混合函数又弱时,线性探测的退化比第三节的表严重得多。哪一类哈希函数在真实键分布上”足够好”,目前主要靠经验和测试,理论与实践之间仍有空隙。
争论二:墓碑是负担还是资产
教科书把墓碑当作必须定期清理的负担,第五节的未命中查找曲线也支持这一点。Bender、Kuszmaul 和 Kuszmaul(FOCS 2021)从另一面论证:删除留下的墓碑有反聚集(anti-clustering)作用,可以抵消一次聚集。经典分析认为负载 \(1 - 1/x\) 时插入的期望代价是 \(\Theta(x^2)\);他们证明,只要删除的实现细节做对,即使表一直处在 \(1 - \Theta(1/x)\) 的负载,每次操作的期望均摊代价也只有 \(\tilde{O}(x)\)。他们还提出 graveyard hashing,在任意操作序列上完全消除一次聚集:当前负载为 \(1 - 1/x\) 时,每次操作的期望代价为 \(O(x)\)。
第五节的实验在两边都给出了证据:墓碑让插入落脚从 8.5
次降到约 6.2 次,同时让必须扫到空槽的未命中查找从 8.5 次涨到
14 次(有重建)乃至 278
次(无重建)。结论取决于负载里”插入已知的新键”和”查找不存在的键”各占多少。Abseil
的 WasNeverFull() 和 Go
的”组内有空就不留墓碑”选择尽量少留墓碑,graveyard hashing
目前还停留在论文里。
争论三:Robin Hood 为什么在工程上让位
Robin Hood
在理论上很漂亮:线性探测里方差最小、未命中查找可以提前终止、删除不用墓碑。但
Rust 在 1.36 换成了 hashbrown,Go 1.24、Abseil 选的也都是
SwissTable。第四、六节的计数给出了一种解释:两者都把未命中查找压到了常数量级(\(7/8\) 负载下,Robin Hood 约 5
个槽,SwissTable 约 2 个组),但 SwissTable
靠元数据筛选做到这一点,插入时不需要搬动键,也就不需要为每次插入付出交换的写入代价。插入搬动元素还带来实现上的约束,例如
Rust 旧实现要用 DISPLACEMENT_THRESHOLD
防范长位移。这是本文基于计数的推断;要确认代价的真实比例,需要在同一硬件上对两种生产级实现计时,本文没有这样的数据。
开放问题
- 不重排的开放寻址还能多快? Yao 的 “Uniform Hashing is Optimal”(JACM 1985)在一类开放寻址方案中证明了均匀探测的最优性,并留下一个核心猜想。Farach-Colton、Krapivin 和 Kuszmaul(FOCS 2024,arXiv:2501.02305)推翻了这个猜想:即使不随时间重排元素,也能构造出期望查找复杂度(均摊与最坏情况)远好于此前认为可能的开放寻址表,并给出匹配的下界。这些构造在真实硬件上的常数、缓存行为和实现复杂度,仍有待工程上的检验。
- SwissTable 的分组探测该怎么分析? 经典理论针对逐槽探测;分组探测的代价是”访问组数加误匹配次数”,而且依赖 H2 位数、组宽与是否对齐。第六节只有模拟数据,文献中还缺少与 Knuth 公式同样精确的闭式分析。
- 多大比例的删除值得原地清理? Abseil 以 \(25/32\) 为界决定原地清理还是扩容,Go 1.24 因为遍历语义完全放弃了原地清理。在删改频繁、又要求遍历稳定的场景里,怎样兼顾两者还没有定论。
九、工程陷阱与选型
| 陷阱 | 后果 | 做法 |
|---|---|---|
| 开放寻址表负载设得过高 | 线性探测在 0.95 时未命中查找约 199 次(第三节),插入新键也要付这个代价 | 线性探测把上限放在 0.7 到 0.8;需要高负载时用 Robin Hood 的提前终止或 SwissTable 的分组元数据 |
| 线性探测配弱哈希或规则的键 | run 快速拉长,理论上两两独立的哈希族可导致对数级代价 | 用强混合函数(如
fmix64);面向不可信输入时用带随机种子的
SipHash 一类函数,见 密码学哈希与非密码学哈希 |
| 用墓碑删除却从不重建 | 空槽单调减少,未命中查找无限变长(第五节:\(1.72n\) 次删改后 278 次) | 以”有效键加墓碑”计负载并触发重建;线性探测可改用 Algorithm R 或 Robin Hood 的后移删除 |
| 把删除直接写成空槽 | 截断探测路径,已存在的键查不到 | 墓碑、后移删除,或 SwissTable 的”组内从未满过才标空” |
| 保存开放寻址表里元素的指针 | 插入触发扩容、Robin Hood 交换或后移删除后指针悬空 | 不跨修改保存指针;需要地址稳定时用节点式容器(如
absl::node_hash_map、std::unordered_map) |
以为 Java HashMap 链长到 8 就会建树 |
表长小于 64 时只会扩容 | 知道 MIN_TREEIFY_CAPACITY = 64;键实现
Comparable 能让树内查找更有效 |
| 在延迟敏感的服务里全量 rehash 大表 | 一次 \(O(n)\) 的停顿 | 预分配容量;或用 Redis 式双表渐进迁移、Go 1.24 式分表扩容,把停顿切碎 |
| 依赖 Go map 的遍历顺序 | 遍历起点是随机的,结果不稳定 | 需要顺序时先取键再排序 |
选型上,按约束来选:
| 场景 | 常见选择 | 决定性约束 |
|---|---|---|
| 通用内存哈希表,键值小、追求吞吐 | SwissTable 类(Abseil、hashbrown、Go 1.24) | 高负载下的未命中查找代价、缓存行利用 |
| 元素地址必须稳定,或键值很大 | 链式或节点式开放寻址 | 扩容与重排不能移动元素 |
| 需要插入顺序 | CPython 式紧凑字典(索引数组 + 条目数组) | 迭代顺序、迭代时的访存 |
| 单线程服务里的大字典,要求无长停顿 | 链式 + 渐进 rehash(Redis) | 扩容停顿必须摊到每次操作 |
| 教学或需要最坏查找可控的简单实现 | Robin Hood 线性探测 | 实现短、方差小、删除无墓碑 |
十、参考资料
源码与文档
- CPython
v3.13.0:
Objects/dictobject.c(文件头注释、PERTURB_SHIFT、USABLE_FRACTION、lookdict_index()、delitem_common());Include/pyhash.h(Py_HASH_ALGORITHM);Include/internal/pycore_dict.h(PyDictKeyEntry、PyDictUnicodeEntry)。 - OpenJDK
jdk-21-ga:src/java.base/share/classes/java/util/HashMap.java(hash()、putVal()、treeifyBin()、TreeNode.split()、removeTreeNode())。 - JEP 180: Handle Frequent HashMap Collisions with Balanced Trees。
- Go
1.23.0:
src/runtime/map.go(bmap、overLoadFactor()、tooManyOverflowBuckets()、growWork())。 - Go
1.24.0:
src/internal/runtime/maps/map.go、table.go、group.go(包注释、probeSeq、maxAvgGroupLoad、maxTableCapacity、table.rehash());Go 1.24 Release Notes, Runtime 一节。 - Abseil
20240722.0:
absl/container/internal/raw_hash_set.h(ctrl_t、H1()、H2()、probe_seq、CapacityToGrowth())、raw_hash_set.cc(WasNeverFull()、EraseMetaOnly()、DropDeletesWithoutResize());Abseil, “Swiss Tables Design Notes”。 - Rust
1.35.0:
src/libstd/collections/hash/map.rs(DefaultResizePolicy、DISPLACEMENT_THRESHOLD);RustRELEASES.md(1.11.0 默认哈希改为 SipHash-1-3,1.36.0 改用 hashbrown)。 - Redis
7.4.2:
src/dict.h(struct dict)、src/dict.c(_dictExpandIfNeeded()、dictRehash()、_dictRehashStep()、dictFind()、dictRehashMicroseconds())。
核心论文
- W. W. Peterson, “Addressing for Random-Access Storage”, IBM Journal of Research and Development 1(2), 1957.
- D. E. Knuth, The Art of Computer Programming, Vol. 3: Sorting and Searching, 2nd ed., Section 6.4, Addison-Wesley, 1998(线性探测分析最早见于其 1963 年未发表手稿 “Notes on ‘open’ addressing”)。
- P. Celis, P.-Å. Larson, J. I. Munro, “Robin Hood Hashing”, FOCS 1985.
- A. C. Yao, “Uniform hashing is optimal”, Journal of the ACM 32(3), 1985.
- S. Janson, “Individual displacements for linear probing hashing with different insertion policies”, ACM Transactions on Algorithms 1(2), 2005.
- M. A. Bender, B. C. Kuszmaul, W. Kuszmaul, “Linear Probing Revisited: Tombstones Mark the Demise of Primary Clustering”, FOCS 2021.
- M. Farach-Colton, A. Krapivin, W. Kuszmaul, “Optimal Bounds for Open Addressing Without Reordering”, FOCS 2024(arXiv:2501.02305)。
其他论文
- P. Celis, “Robin Hood Hashing”, PhD thesis, University of Waterloo, 1986(技术报告 CS-86-14)。
- L. Devroye, P. Morin, A. Viola, “On Worst-Case Robin Hood Hashing”, SIAM Journal on Computing 33(4), 2004.
- A. Pagh, R. Pagh, M. Ružić, “Linear probing with constant independence”, STOC 2007;期刊版 SIAM Journal on Computing, 2009.
- M. Pătraşcu, M. Thorup, “On the k-Independence Required by Linear Probing and Minwise Independence”, ICALP 2010.
- M. Pătraşcu, M. Thorup, “The Power of Simple Tabulation Hashing”, STOC 2011.
工程资料
- M. Kulukundis, “Designing a Fast, Efficient, Cache-friendly Hash Table, Step by Step”, CppCon 2017.
- R. Hettinger, python-dev
邮件列表,2012-12,紧凑字典提议(CPython
dictobject.c文件头引用)。
实验
reproduce/probe_sim.c:第三、四、六节的探测计数与缓存行模型;reproduce/plot_probes.py生成probe-length-vs-load.svg、max-displacement-growth.svg。reproduce/churn_sim.c:第五节的删除实验;reproduce/plot_churn.py生成deletion-churn.svg。reproduce/rh_map.c、rh_map.h、rh_test.c:第四节的 Robin Hood 实现与差分测试。reproduce/results/:上述程序的原始输出。
系列导航: - 上一篇:排序基准测试:12 种排序算法在不同数据分布下的实测 - 下一篇:Cuckoo Hashing:用两个位置换取最坏情况常数查找
相关阅读: - SwissTable 原理:控制字节与 SIMD 分组探测 - 密码学哈希与非密码学哈希 - 并发哈希表 - Redis 字典与渐进式 rehash
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
Swiss Table:控制字节、分组探测与墓碑——对照 Abseil、Go 与 hashbrown 源码
对照 Abseil 20260817.0、Go 1.26.8 与 hashbrown 0.17.1 源码,拆解 Swiss table 的控制字节编码、SIMD/SWAR 分组匹配、三角探测、删除与 rehash 策略,并用可复现实验测量探测长度、墓碑代价与每元素内存。
Cuckoo Hashing:用两个位置换取最坏情况常数查找
从 Pagh–Rodler 的两表插入与 cuckoo 图出发,用可复现实验核对失败概率、stash、d-ary 与分桶的负载阈值和两种插入搜索的代价,再对照 MemC3、libcuckoo、DPDK、OVS 源码说明并发读写怎样避免假未命中。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。