选哈希函数时常听到三句话:「给 MurmurHash 加个随机种子就能防哈希洪泛」「SipHash 是一种更快的密码学哈希」「Abseil 的哈希表用的是 wyhash」。第一句在 2012 年就被针对带种子 MurmurHash 的公开攻击推翻;第二句与 SipHash 论文的原话相反,论文明确写着 SipHash 不追求、也不具备抗碰撞性;第三句只对 Abseil 20250512.0 及更早的版本成立,而且即使在那些版本里,也只覆盖长于 16 字节的输入。
三句话错在同一个地方:没有先问清这个哈希函数对谁、承诺了什么。本文先把承诺分成三种契约,再逐一看密码学哈希的安全定义和两种迭代构造(Merkle–Damgård 与海绵),然后回到哈希表:雪崩测试能说明什么、不能说明什么,哈希洪泛(hash flooding)为什么需要带密钥的伪随机函数,以及 CPython、Rust、Go、Abseil 在钉定版本里的实际选择。
文中所有实验数字都来自同目录的
reproduce/,包括长度扩展伪造、雪崩偏差矩阵、哈希洪泛的比较次数和短键速度,实验环境见第五节。哈希表本身的结构(链式、线性探测、SwissTable)见
哈希表内部:链式、线性探测、Robin
Hood 与生产实现的取舍,XXH3 与 wyhash
的内部实现和提速手段见 XXH3 与 wyhash:SIMD
累加器和 128 位标量乘法两条提速路线,本文不重复。
一、三种契约

图中三列的差别在于攻击者模型:
- 非密码学哈希(non-cryptographic hash)不假设攻击者。它只承诺:对不是针对它构造的键,输出分布均匀,输入改动一位会带动大约一半输出位翻转。这类函数的”种子”(seed)只是让不同进程的哈希值不同,没有任何保密性要求。检验手段是 SMHasher 这类统计测试。
- 带密钥的伪随机函数(pseudorandom function,PRF)允许攻击者自适应地选择输入,甚至看到输出,但拿不到密钥。承诺是:在不知道密钥时,输出与一个真随机函数在计算上不可区分。SipHash 论文把自己定位在这里(Aumasson & Bernstein, INDOCRYPT 2012, §1、§3)。
- 密码学哈希(cryptographic hash)没有任何秘密,攻击者知道函数、所有输入和输出。承诺是第二节的三条性质。
哈希表面对的攻击者是:能决定插入哪些键,可能通过响应时间或遍历顺序间接看到桶号,但不知道进程启动时生成的密钥。这正是 PRF 的模型,而不是密码学哈希的模型。所以哈希表的”安全默认”是 SipHash 这类 PRF,而不是 SHA-256:后者对哈希表来说既太慢(第五节实测 8 字节键比 SipHash 慢约 4.6 到 7 倍),又在防什么的问题上答非所问,因为它的安全性不依赖任何秘密,攻击者完全可以离线穷举出落进同一个桶的键。
二、密码学哈希的三条安全性质
定义
设 \(H: \{0,1\}^* \to \{0,1\}^n\)。按 Rogaway 与 Shrimpton(FSE 2004)的整理,三条经典性质是:
- 抗原像(preimage resistance):随机选 \(x\),给出 \(y = H(x)\),难以找到任何 \(x'\) 使 \(H(x') = y\)。
- 抗第二原像(second-preimage resistance):随机选 \(x\) 并把 \(x\) 本身交给攻击者,难以找到 \(x' \ne x\) 使 \(H(x') = H(x)\)。
- 抗碰撞(collision resistance):难以找到任意一对 \(x \ne x'\) 使 \(H(x) = H(x')\)。
对一个理想的 \(n\) 位函数,前两条的通用攻击是穷举,期望约 \(2^n\) 次计算;抗碰撞的通用攻击是生日攻击,约 \(\sqrt{\pi/2} \cdot 2^{n/2}\) 次。FIPS 202 的 Table 4 按这个口径给出 SHA-256 与 SHA3-256 的安全强度:抗碰撞 128 位,抗原像与抗第二原像 256 位。
三者的关系
flowchart LR
    CR["collision resistance"] -->|"always implies"| SPR["second-preimage resistance"]
    CR -.->|"only if H compresses enough"| PR["preimage resistance"]
SPR -.->|"only if H compresses enough"| PR- 抗碰撞蕴含抗第二原像:谁能找到第二原像 \(x'\),谁就拿到了一对碰撞 \((x, x')\)。
- 抗碰撞不一般地蕴含抗原像:\(n\) 位输入上的恒等函数没有任何碰撞,却可以一眼求逆。只有当定义域远大于值域时,抗碰撞才能推出抗原像,Rogaway 与 Shrimpton 把这类依赖压缩比的推论称为”临时的”(provisional)蕴含。
- 形式化上还有一个陷阱:对一个固定的无密钥函数,碰撞必然存在,所以”存在一个高效算法输出碰撞”平凡成立,严格的抗碰撞定义只能针对带密钥的函数族。Rogaway 在 VIETCRYPT 2006 的 “Formalizing Human Ignorance” 里提出的办法是:不宣称碰撞找不到,而是给出显式归约,即”谁能攻破上层方案,谁就能构造出 \(H\) 的碰撞”。
三条性质会分别失效。MD5 的碰撞早在 2004 年就被构造出来(Wang & Yu, EUROCRYPT 2005),但它的原像攻击至今仍接近穷举:Sasaki 与 Aoki(EUROCRYPT 2009)的全轮 MD5 原像攻击需要 \(2^{123.4}\) 次计算。所以”MD5 已被攻破”指的是抗碰撞性,这足以让它退出签名和证书,但不意味着它的每条性质都塌了。
碰撞攻击怎样走到实战
| 年份 | 事件 | 出处 |
|---|---|---|
| 2004–2005 | Wang 等人构造出 MD5 碰撞 | Wang & Yu, EUROCRYPT 2005 |
| 2005 | 全轮 SHA-1 碰撞攻击,复杂度低于 \(2^{69}\) | Wang, Yin & Yu, CRYPTO 2005 |
| 2008 | 用 MD5 选择前缀碰撞伪造出可用的 CA 证书(25C3 演示) | Stevens et al., CRYPTO 2009 |
| 2012 | Flame 恶意软件用一种新的 MD5 选择前缀碰撞伪造微软代码签名证书 | Stevens, “Counter-Cryptanalysis”, CRYPTO 2013 |
| 2017 | 第一对实际的 SHA-1 碰撞(SHAttered),约 \(9 \times 10^{18}\) 次 SHA-1 计算,相当于 6500 CPU 年加 110 GPU 年 | Stevens et al., CRYPTO 2017;shattered.io |
| 2019–2020 | SHA-1 选择前缀碰撞,2020 年达到实用规模并用于伪造 PGP 信任链 | Leurent & Peyrin, EUROCRYPT 2019;USENIX Security 2020 |
“选择前缀”(chosen-prefix)碰撞比普通碰撞强:攻击者可以先任意指定两段不同的前缀,再为它们各自补上后缀使哈希相同。伪造证书需要的正是这种能力,因为两份证书的主体信息必须不同。
三、Merkle–Damgård 构造与长度扩展
构造
Merkle 与 Damgård 在 CRYPTO ’89 上各自独立发表了同一种构造(Merkle, “One Way Hash Functions and DES”;Damgård, “A Design Principle for Hash Functions”):给定一个定长的压缩函数 \(f: \{0,1\}^n \times \{0,1\}^b \to \{0,1\}^n\),把消息填充后切成 \(b\) 位的块 \(m_1, \ldots, m_\ell\),然后
\[ h_0 = IV, \qquad h_i = f(h_{i-1}, m_i), \qquad H(M) = h_\ell. \]
填充里写入原始消息长度,这一步称为 MD 强化(MD
strengthening)。它保证了该构造的核心定理:若 \(f\) 抗碰撞,则 \(H\) 抗碰撞。证明是从
\(H\)
的一对碰撞倒着走链:由于最后一块包含长度,两条链要么在某一步给出
\(f\)
的碰撞,要么逐块完全相同,而后者与 \(M \ne M'\)
矛盾。MD5、SHA-1、SHA-2 都是这个结构。SHA-256 取 \(n = 256\)、\(b = 512\),填充规则是追加
0x80、若干零字节、再追加 64
位大端的比特长度(FIPS 180-4,
§5.1.1)。
压缩函数内部是 64 轮运算,本文复现程序里的实现如下(摘自
reproduce/sha256.h 的
sha256_compress(),省略了消息扩展):
for (int i = 0; i < 64; i++) {
    uint32_t t1 = hh + (ror32(e, 6) ^ ror32(e, 11) ^ ror32(e, 25)) + ((e & f) ^ (~e & g)) +
                  sha256_k[i] + w[i];
    uint32_t t2 = (ror32(a, 2) ^ ror32(a, 13) ^ ror32(a, 22)) + ((a & b) ^ (a & c) ^ (b & c));
    hh = g; g = f; f = e; e = d + t1;
    d = c; c = b; b = a; a = t1 + t2;
}
h[0] += a; h[1] += b; h[2] += c; h[3] += d;
h[4] += e; h[5] += f; h[6] += g; h[7] += hh;
最后两行是前馈(feed-forward):把这一轮的输入状态加回输出,使
\(f\)
即使在内部置换可逆时也难以求逆。test_vectors 用
FIPS 180-4 的样例和 2000 个随机长度输入与 OpenSSL 3.6.2
对照,结果一致。
长度扩展攻击
结构上的问题出在最后一步:SHA-256 的输出就是最后的链接变量 \(h_\ell\),完整的 256 位内部状态直接暴露给了外部。
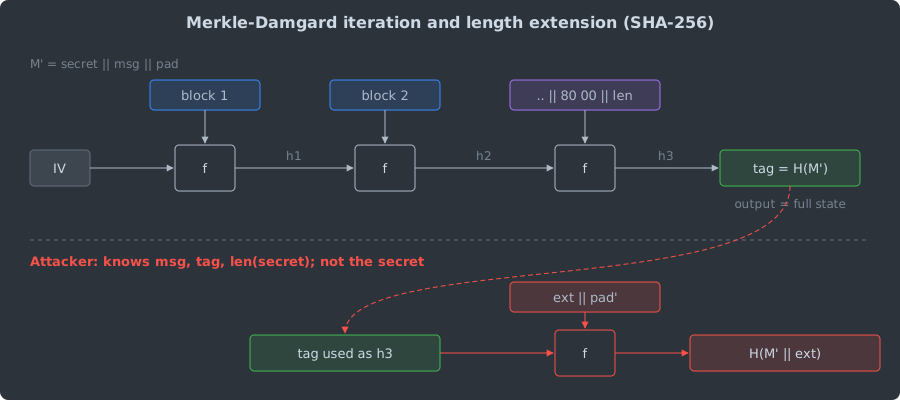
设服务端用 \(t = \mathrm{SHA256}(\mathit{secret} \,\|\, \mathit{msg})\) 做消息认证。攻击者知道 \(\mathit{msg}\)、\(t\) 和秘密的长度,不知道秘密本身。他可以:
- 按秘密长度加 \(|\mathit{msg}|\) 算出服务端当时用的填充 \(\mathit{pad}\);
- 把 \(t\) 拆回 8 个 32 位字,当作链接变量;
- 从这个状态继续吸收任意后缀 \(\mathit{ext}\),并按总长度 \(|\mathit{secret}| + |\mathit{msg}| + |\mathit{pad}| + |\mathit{ext}|\) 写最后的填充。
得到的就是 \(\mathrm{SHA256}(\mathit{secret} \,\|\,
\mathit{msg} \,\|\, \mathit{pad} \,\|\,
\mathit{ext})\)。攻击代码的核心只有几行(reproduce/lenext.cc,attacker_forge()):
sha256_ctx c;
for (int i = 0; i < 8; i++)
    c.h[i] = (uint32_t)tag[4 * i] << 24 | (uint32_t)tag[4 * i + 1] << 16 |
             (uint32_t)tag[4 * i + 2] << 8 | tag[4 * i + 3];
c.total = secret_len + n + padn; /* a multiple of 64 */
c.n = 0;
sha256_update(&c, ext, strlen(ext));
sha256_final(&c, out_tag);
程序里服务端的秘密是一个 25 字节的字符串,攻击函数拿不到它,只从 1 开始逐个猜秘密长度,每猜一次就把伪造结果交给服务端验证。实际输出:
original msg : user=alice&role=guest
original tag : 71caef4cd7e6ca257f4c4402478ff49c51e5d33597628b0b3b733880fbcf377d
secret length guess 25 accepted after 25 tries
forged msg   : 757365723d616c69636526726f6c653d677565737480000000000000000000000000000000017026726f6c653d61646d696e (50 bytes)
forged tag   : 82fe92e757aff2e473366632b96d24770aca0a200eeab6416592987b1c2b1b3f
forgery ACCEPTED by server
伪造消息是原消息、18
字节的”胶水”填充(80、若干
00、以及 0x170 = 368 位 = 46
字节的长度)和
&role=admin。如果服务端的解析器取同名参数的最后一个值,这条消息就把角色改成了
admin。
修补办法有三类:
- HMAC(Bellare, Canetti & Krawczyk, CRYPTO ’96;RFC 2104):\(\mathrm{HMAC}(K, m) = H\big((K' \oplus \mathit{opad}) \,\|\, H((K' \oplus \mathit{ipad}) \,\|\, m)\big)\)。外层哈希的输入是内层摘要,攻击者即使扩展了内层,也算不出外层。
- 截断输出:SHA-384、SHA-512/256 只输出部分状态,攻击者缺少被截掉的位,无法恢复链接变量。
- 换构造:SHA-3、BLAKE2、BLAKE3 的输出都不是完整内部状态,不受长度扩展影响。
迭代结构的其他代价
长度扩展不是 Merkle–Damgård 唯一的结构性弱点。两篇论文说明,迭代让”通用攻击”比理想函数便宜:
- 多碰撞(multicollision):Joux(CRYPTO 2004)指出,连续找 \(k\) 次单块碰撞,每次从上一次的公共链接变量出发,就能拼出 \(2^k\) 条哈希相同的消息,总代价只有约 \(k \cdot 2^{n/2}\),而理想函数上找 \(2^k\) 重碰撞要贵得多。一个推论是:把两个迭代哈希拼接成 \(H_1(M) \,\|\, H_2(M)\),碰撞安全性并不比较强的那个高多少。第六节对 DJBX33A 和 MurmurHash3 的哈希洪泛,用的正是这种”逐段碰撞、组合放大”的思路。
- 长消息第二原像:Kelsey 与 Schneier(EUROCRYPT 2005)证明,对 \(2^k\) 块长的消息,Merkle–Damgård 哈希的第二原像只需约 \(k \cdot 2^{n/2+1} + 2^{n-k+1}\) 次计算,低于 \(2^n\)。
四、海绵构造、SHA-3 与 BLAKE3
从 SHA-1 危机到 FIPS 202
2005 年的 SHA-1 攻击之后,NIST 在 2007 年公开征集新的哈希标准。2012 年 Keccak(Bertoni、Daemen、Peeters、Van Assche)胜出,2015 年以 FIPS 202 发布为 SHA-3。SHA-2 至今没有被实际攻破,SHA-3 的意义在于提供一个结构上完全不同的备份:即使针对 Merkle–Damgård 或 SHA-2 压缩函数的分析取得突破,SHA-3 也不受连带影响。
海绵构造
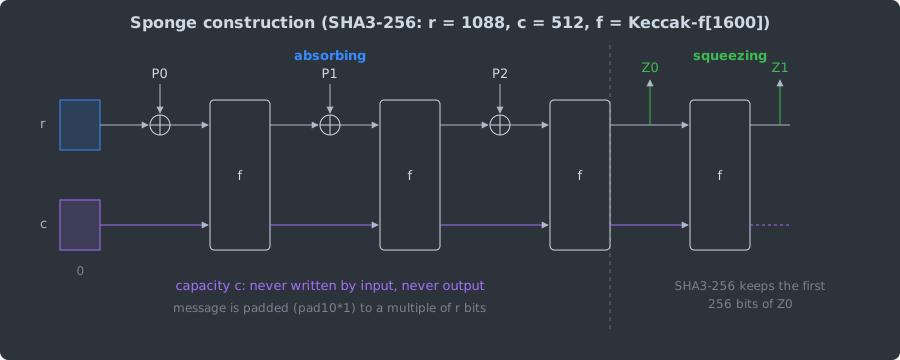
海绵构造(sponge construction)基于一个固定宽度的置换 \(f\),SHA-3 用的是 \(b = 1600\) 位的 Keccak-\(f\)[1600]。状态分成两段:\(r\) 位的比特率(rate)和 \(c\) 位的容量(capacity),\(r + c = b\)。
- 吸收(absorbing):消息按 pad10*1 规则填充到 \(r\) 的整数倍,每块异或进状态的前 \(r\) 位,再对整个状态做一次 \(f\)。
- 挤压(squeezing):从前 \(r\) 位读输出,不够就再做一次 \(f\) 继续读。SHA3-256 取 \(r = 1088\)、\(c = 512\),只读一次、取前 256 位。
Bertoni 等人(EUROCRYPT 2008)证明,只要 \(f\) 是随机置换,海绵构造与随机预言机(random oracle)的不可区分性界在 \(2^{c/2}\) 量级。换句话说,安全强度由容量决定:SHA3-256 的 \(c = 512\) 对应 256 位的通用安全界,再和输出长度决定的 \(2^{128}\) 碰撞、\(2^{256}\) 原像取较小者。
长度扩展在这里行不通:输出只来自比特率部分,攻击者拿到摘要后仍缺 \(c\) 位容量,无法恢复完整状态继续吸收。所以对 SHA-3,\(H(K \,\|\, m)\) 本身就可以当 MAC 用;NIST SP 800-185 进一步把它标准化为 KMAC,加上了域分隔和长度编码。
Keccak-\(f\)[1600] 把状态看成 \(5 \times 5\) 个 64 位字,做 24 轮,每轮五步:\(\theta\)(列奇偶扩散)、\(\rho\)(字内旋转)、\(\pi\)(字的位置置换)、\(\chi\)(唯一的非线性步骤,\(a_x \leftarrow a_x \oplus (\lnot a_{x+1} \land a_{x+2})\))和 \(\iota\)(异或轮常数,打破轮间对称)。
BLAKE2 与 BLAKE3
另一条路线是保留”压缩函数加链接变量”,但修掉 Merkle–Damgård 的暴露问题。BLAKE2(Aumasson, Neves, Wilcox-O’Hearn & Winnerlein, ACNS 2013;RFC 7693)源自 SHA-3 决赛算法 BLAKE,最后一块用专门的终结标志处理,不受长度扩展影响。
BLAKE3(O’Connor, Aumasson, Neves & Wilcox-O’Hearn, 2020)按规范文档的说法有三处主要变化:
- 把输入切成 1 KiB 的块(chunk),作为一棵二叉 Merkle 树的叶子,各块独立压缩,并行度等于块数;
- 压缩函数沿用 BLAKE2s,但轮数从 10 减到 7;
- 只有一个算法、没有变体,用哈希、带密钥哈希和密钥派生三种模式代替 BLAKE2 的参数块,并内建可扩展输出(XOF)。
它的目标安全强度与 BLAKE2s 相同,是 128 位。BLAKE3 规范是设计者发布的文档,不是经同行评审的论文;把轮数减到 7 的依据是设计者对既有 BLAKE/BLAKE2 分析结果的解读,这一点在规范里写得很清楚,是否足够保守是可以争论的。
五、非密码学哈希的质量:雪崩测试与它的边界
实验环境
- CPU:Intel Core i9-12900K(
lscpu),支持 AVX2 与 SHA-NI;WSL2,内核 6.6.87.2;GCC 16.1.1,-O2 -Wall -Wextra -std=c++17 -march=native。 - 被测实现:xxHash v0.8.3、wyhash “final version
4.3”(仓库 commit
e4764a0b)、SMHasher 仓库中的 MurmurHash3 参考实现、OpenSSL 3.6.2 的 SHA-256;SipHash、FNV-1a、DJBX33A 与 SHA-256(仅用于雪崩和长度扩展)是reproduce/里的实现。第三方源码由fetch_deps.sh按固定 commit 下载并校验 SHA-256。 - 雪崩与哈希洪泛实验只统计比特翻转次数和键比较次数,与时钟无关;随机数由固定种子的 splitmix64 生成,重复运行输出逐字节一致。
- 速度实验用
taskset -c 9绑核,每个格子取 5 次测量的中位数,整个程序跑 3 遍再逐格取中位数。机器上同时有其他负载,速度数字只看相对趋势。 - 运行:
cd reproduce && ./run_all.sh 9,全部输出写入reproduce/results/,图由plot_avalanche.py与plot_hashdos.py生成。
严格雪崩准则与测量口径
Webster 与 Tavares(CRYPTO ’85)为 S 盒提出了严格雪崩准则(Strict Avalanche Criterion,SAC):翻转任意一个输入位,每个输出位都以 \(1/2\) 的概率翻转。把它当作测量量:对 \(N\) 个随机输入,记输入位 \(i\) 翻转时输出位 \(j\) 翻转的比例为 \(P_{ij}\),偏差定义为
\[ b_{ij} = \left| 2 P_{ij} - 1 \right|. \]
这正是 SMHasher 的 AvalancheTest
使用的量:原版 SMHasher 对每种键长做 300000
次重复,只要最差的 \(b_{ij}\) 超过 1%(源码常量
AVALANCHE_FAIL)就判失败。\(N\)
有限时,即使是理想函数,\(b_{ij}\) 也有抽样噪声,均值约为
\(\sqrt{2/\pi} /
\sqrt{N}\)。所以下表额外放了一行
ideal:用随机数代替哈希差值,给出同样 \(N\) 下的噪声底。
| 函数 | 8 字节键平均偏差 | 8 字节键最差偏差 | 32 字节键平均偏差 | 32 字节键最差偏差 |
|---|---|---|---|---|
| ideal(噪声底) | 0.078% | 0.352% | 0.155% | 0.738% |
| FNV-1a 64 | 29.598% | 100.000% | 12.938% | 100.000% |
| DJBX33A(64 位) | 83.766% | 100.000% | 61.637% | 100.000% |
| MurmurHash3 x86_32 | 0.079% | 0.410% | 0.156% | 0.924% |
| MurmurHash3 x64_128(低 64 位) | 0.076% | 0.359% | 0.155% | 0.714% |
| XXH64 | 0.077% | 0.345% | 0.156% | 0.731% |
| XXH3_64bits | 0.077% | 0.360% | 0.154% | 0.862% |
| wyhash 4.3 | 0.078% | 0.357% | 0.155% | 0.775% |
| SipHash-1-3 | 0.079% | 0.414% | 0.156% | 0.850% |
| SipHash-2-4 | 0.078% | 0.324% | 0.154% | 0.802% |
| SHA-256(前 64 位) | 0.078% | 0.444% | 0.153% | 0.861% |
8 字节键 \(N = 2^{20}\),32 字节键 \(N = 2^{18}\),两种配置的”输入位翻转”总次数都是 \(2^{26}\)。下图是 8 字节键的四个偏差矩阵:
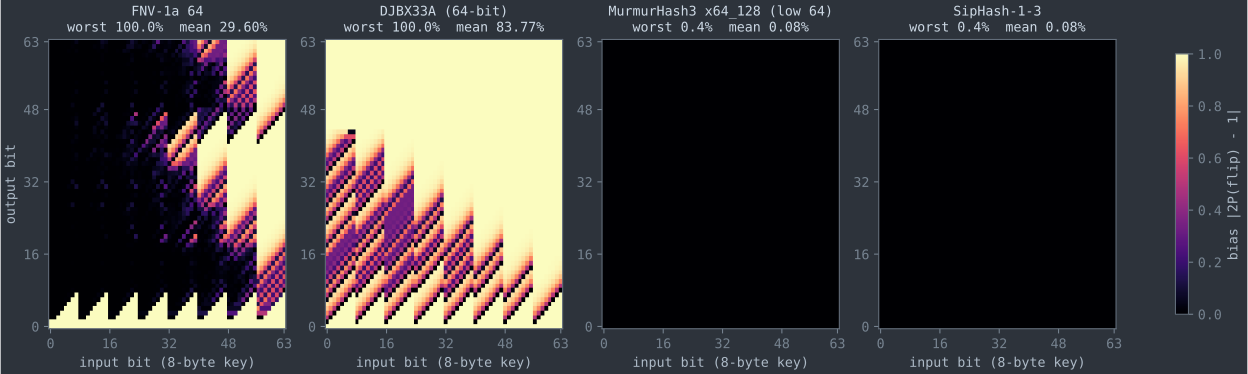
可以读出两件事。
第一,FNV-1a 和 DJBX33A 的最差偏差都是 100%,出在”输入位
0 到输出位 0”,原因是代数结构而不是运气。FNV-1a 每步做 \(h \leftarrow (h \oplus c) \cdot
p\),DJBX33A 每步做 \(h
\leftarrow 33h +
c\),乘数都是奇数,而奇数乘法和加法都不改变最低位的奇偶关系:输出的第
0 位恒等于各字节第 0
位的异或(再加一个常数)。所以翻转任何一个字节的最低位,输出最低位必然翻转。用
h & (m - 1)
取桶号时,最低位正是最先用到的位。
第二,也是更重要的一点:MurmurHash3、XXH64、XXH3、wyhash 的偏差与 SipHash、SHA-256 以及 ideal 噪声底处在同一水平。在这个测试的分辨率下,看不出”非密码学”和”密码学”的区别。第六节会展示,恰恰是雪崩表现无可挑剔的 MurmurHash3,存在与种子无关的碰撞族。雪崩测试回答的是”对随机输入混合得好不好”,不回答”攻击者能不能找到碰撞”。
SMHasher 与 SMHasher3
SMHasher 由 MurmurHash 的作者 Austin Appleby 编写,包括雪崩、比特独立性(BIC)、差分、稀疏键、循环键、种子等一系列统计测试。Reini Urban 的分支(rurban/smhasher)加入了更多测试和一张覆盖上百个函数的结果表;Frank J. T. Wojcik 在它的基础上开发了 SMHasher3,按其 README,主要改进是修正若干严重缺陷、为所有测试报告 p 值、改进部分测试的统计基础、统一各哈希实现并提升速度。
这些工具很适合发现 FNV、DJB 这类结构性缺陷,但它们测的都是”非对抗”输入。通过全部测试只说明函数在这些输入分布上像随机函数,不说明它能抵御专门构造的输入。
速度:安全性的价格
单次调用的耗时(ns,输入都在 L1/L2 中,调用之间互不依赖):
| 函数 | 8 B | 16 B | 32 B | 64 B | 256 B | 4096 B |
|---|---|---|---|---|---|---|
| FNV-1a 64 | 3.68 | 8.20 | 16.61 | 36.28 | 207.49 | 3716.31 |
| MurmurHash3 x64_128 | 5.97 | 4.94 | 6.40 | 9.41 | 28.61 | 432.98 |
| XXH64 | 3.05 | 4.22 | 7.38 | 9.57 | 20.67 | 245.21 |
| XXH3_64bits | 2.23 | 1.99 | 2.68 | 4.12 | 17.66 | 89.32 |
| wyhash 4.3 | 2.51 | 2.54 | 3.22 | 4.22 | 9.70 | 145.53 |
| SipHash-1-3 | 6.87 | 8.35 | 11.31 | 16.73 | 52.56 | 754.20 |
| SipHash-2-4 | 10.47 | 12.76 | 17.86 | 28.42 | 89.62 | 1303.75 |
| SHA-256(OpenSSL,低层 API) | 48.11 | 48.32 | 47.22 | 70.92 | 154.64 | 1852.10 |
按比例看:
- 8 到 32 字节的短键上,SipHash-1-3 是 wyhash 的 2.7 到 3.5 倍,绝对差值每次调用 4 到 8 ns;SipHash-2-4 又比 SipHash-1-3 慢约 1.5 倍。
- 4 KiB 输入上差距拉大:XXH3 约 46
GB/s(
-march=native启用了 AVX2 路径),wyhash 约 28 GB/s,SipHash-1-3 约 5.4 GB/s,SipHash-2-4 约 3.1 GB/s,SHA-256 约 2.2 GB/s。 - SHA-256 在短键上被固定开销支配:即使只有 8
字节,也要处理一整个 64 字节的块。它在 8 字节键上比
SipHash-1-3 慢约 7 倍,比 SipHash-2-4 慢约 4.6
倍。这里用的是
SHA256_Init/Update/Final低层接口:OpenSSL 3 的一次性SHA256()每次调用都要取一次 EVP 实现,短输入上测到的主要是这部分接口开销,而不是算法本身。 - FNV-1a 逐字节处理,从 64 字节起比表中所有按字处理的函数都慢。
这张表是微基准:输入常驻缓存,调用之间没有依赖。哈希表里一次查找还包括取桶、比较键和可能的缓存未命中,哈希函数在整次操作里占多大比例,要在具体负载上测量。
六、哈希洪泛:从确定性哈希到带种子的哈希
代价模型
链式哈希表里,若 \(n\) 个键全部落进同一个桶,第 \(i\) 次插入要先和已有的 \(i-1\) 个键逐一比较(检查是否重复),总比较次数是
\[ \sum_{i=1}^{n} (i - 1) = \frac{n(n-1)}{2}. \]
而 \(n\) 个键均匀散列到 \(m\) 个桶时,期望比较次数约为 \(n^2 / (2m)\)。开放寻址表的退化形式不同,但同样是从期望常数变成线性。攻击者只需发送 \(n\) 个键,就迫使服务端做 \(\Theta(n^2)\) 的工作。
历史
- 1999 年:Bernstein 的 dnscache
第一版源码里出现了
if (++loop > 100) return 0; /* to protect against hash flooding */,这是 “hash flooding” 一词的最早出处(SipHash 论文 §7)。办法是给每条链设上限,对缓存可行,对必须保存全部数据的应用不适用。 - 2003 年:Crosby 与 Wallach 在 USENIX Security 上发表 “Denial of Service via Algorithmic Complexity Attacks”,演示了针对 Squid、Perl 等的攻击,并建议用带秘密密钥的全域哈希(universal hashing,Carter & Wegman, JCSS 1979)代替公开函数。
- 2011 年 12 月:Klink 与 Wälde 在 28C3 上展示,PHP、Java、Python、Ruby、V8 等平台的 Web 框架仍然可以用一个 POST 请求打满 CPU。SipHash 论文引用他们的数据:500 KB 精心构造的 POST 数据让一台 PHP 5 服务器耗掉整整一分钟 CPU 时间。
oCERT-2011-003 公告列出的修复版本(做法一栏来自各项目自己的发布说明):
| 平台 | 修复版本 | 做法 |
|---|---|---|
| PHP | 5.3.9(2012-01-10) | 新增 max_input_vars 限制请求参数个数(PHP 5
ChangeLog) |
| Python | 2.6.8、2.7.3、3.1.5、3.2.3 | 加入 -R
哈希随机化,默认关闭(公告原文);3.3 起默认开启 |
| Ruby | 1.8.7-p357;1.9.x 列为已修复 | 公告未说明 |
| JRuby | 1.6.5.1 | 公告未说明 |
| Tomcat、Jetty、Rack | 7.0.23、7.6.0.RC3、1.4.0 等 | 公告未说明 |
| Java、V8、Rubinius | 公告标为 N/A | Java 的 String.hashCode() 公式写在 API
规范里,无法在不破坏兼容的前提下更换 |
DJBX33A:等价子串与组合放大
PHP 5 的 zend_inline_hash_func()(PHP
5.3.8,Zend/zend_hash.h)是 DJBX33A:从 5381
开始,每个字节做 \(h \leftarrow
33h + c\),类型是 ulong,在 64 位 Linux
上即 64 位。对长度为 \(L\)
的串 \(s\),
\[ H(s) = 33^{L} h_0 + \sum_{i=1}^{L} 33^{L-i} c_i . \]
两个字符的块 “Ez” 与 “FY” 贡献相同:\(69 \times 33 + 122 = 70 \times 33 + 89 = 2399\)。所以 \(\{\text{Ez}, \text{FY}\}^k\) 中的 \(2^k\) 个等长串哈希值全部相同,而且这个结论与初值 \(h_0\) 无关:把 5381 换成一个随机种子,碰撞照样成立。这是第三节 Joux 多碰撞的一个极简版本:找一次块碰撞,组合出指数多个碰撞。
为什么”加随机种子”不够
Python 在 2012 年的第一轮修复里给 FNV
变体加了随机前缀和后缀。Aumasson 与 Bernstein 在 SipHash
论文附录 B
里给出一段脚本:只需两个哈希输出(hash("\0") 与
hash("\0\0")),就能解出 Python 2.7.3 和 3.2.3
的 128 位随机化密钥。PEP 456
据此认定这种随机化”不能抵御攻击”,Python 3.4 改用
SipHash。
更一般的问题是与种子无关的碰撞。Aumasson、Bernstein 与 Boßlet 在 2012 年 11 月公开了针对 MurmurHash2、MurmurHash3 的概念验证代码(12 月又在 29C3 上报告,PEP 456 引用了这次报告,并指出 CityHash 有类似弱点),oCERT-2012-001 列出受影响的实现:Ruby(MurmurHash2,1.9.3-p327 修复)、JRuby(1.7.1 修复)、Rubinius(MurmurHash3),以及 JDK 7 中默认关闭的替代字符串哈希,编号 CVE-2012-5370 至 CVE-2012-5373。Ruby 的修复就是换成 SipHash。
原理可以用 MurmurHash3_x86_32 演示。它每处理一个 4 字节块 \(k\),先做可逆变换 \(f(k) = \mathrm{rotl}(k \cdot c_1, 15) \cdot c_2\),再更新状态 \(h \leftarrow \mathrm{rotl}(h \oplus f(k), 13) \cdot 5 + C\)。种子只是 \(h\) 的初值。
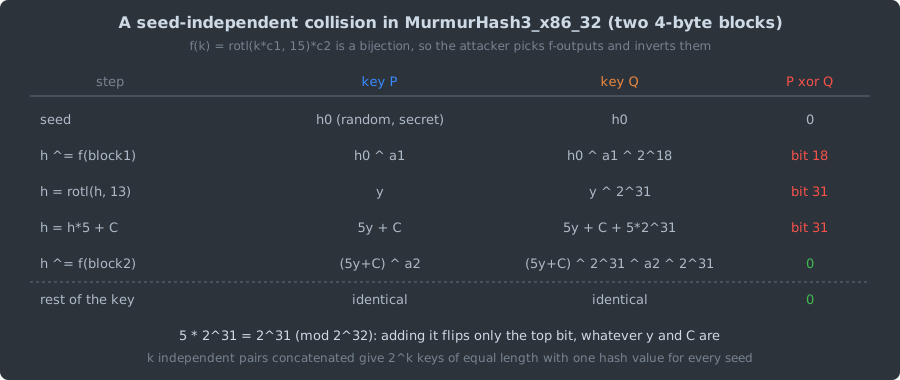
构造一对 8 字节的键 \(P = (x_1, x_2)\) 和 \(Q = (x_1', x_2')\):
- 任取 \(a_1\),令 \(f(x_1) = a_1\)、\(f(x_1') = a_1 \oplus 2^{18}\)。因为 \(f\) 是双射,\(x_1, x_1'\) 可以直接求逆得到。异或进状态后,两边只差第 18 位。
- 左旋 13 位后差在第 31 位。设此时一边是 \(y\),另一边就是 \(y \oplus 2^{31} = y + 2^{31} \pmod{2^{32}}\)。乘 5 后差为 \(5 \cdot 2^{31} \equiv 2^{31} \pmod{2^{32}}\),加常数 \(C\) 不改变这一点。所以第一块处理完,两边无论种子是多少都只差最高位。
- 第二块令 \(f(x_2') = f(x_2) \oplus 2^{31}\),异或之后差被抵消,两边状态完全相同。
\(k\)
对独立构造的块对拼接起来,就得到 \(2^k\)
个等长的键,对任意种子哈希值都相同。这是本文按同一思路推导的构造,不是那次攻击原始代码的复刻;reproduce/hashdos.cc
里的 murmur_pair() 实现了它,并用 SMHasher
的参考实现在 1000 个随机种子下验证了 \(2^{15}\) 个 120
字节的键全部碰撞。
实测:比较次数
表有 \(m = 2^{16}\)
个桶、链式解决冲突,每种组合换一个新的随机种子或密钥,插入
\(n = 2^{15}\)
个互不相同的键(reproduce/results/hashdos.txt):
| 键集合 | DJBX33A(随机初值) | MurmurHash3_x86_32(随机种子) | SipHash-1-3(随机密钥) |
|---|---|---|---|
| Ez/FY 组合(30 字节) | 536,854,528(最长链 32768) | 8,128 | 8,296 |
| Murmur 差分对组合(120 字节) | 9,149 | 536,854,528(最长链 32768) | 8,127 |
| 随机可打印串(120 字节) | 8,122 | 8,175 | 8,160 |
\(536{,}854{,}528 = 2^{15}(2^{15} - 1)/2\),正好是全部落进一个桶的理论值;其余格子都接近 \(n^2 / (2m) = 8192\)。下图是 \(n\) 从 \(2^8\) 到 \(2^{15}\) 的比较次数。因为实验固定了桶数,均匀散列的 \(n(n-1)/(2m)\) 同样随 \(n\) 平方增长,所有曲线在双对数坐标上斜率都接近 2,区别在常数:全碰撞时少了除以 \(m = 65536\) 这一步,差出四个多数量级。真实的哈希表会随 \(n\) 扩容、让 \(m\) 与 \(n\) 同阶,均匀情况下每次插入是常数,全碰撞情况下仍是线性。
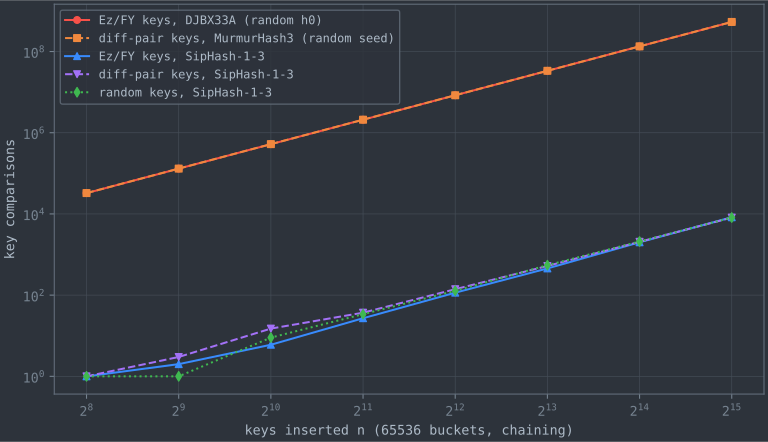
每组键只对它瞄准的那个函数有效:Ez/FY 键对 MurmurHash3 和 SipHash 毫无威胁,Murmur 差分对也打不动 DJBX33A。攻击者需要的是目标函数的结构,种子挡不住结构。
强 PRF 能挡住什么、挡不住什么
SipHash 论文 §7 还给出了两个更细的论证。
- 为什么全域哈希不够:Crosby 与 Wallach 建议的 \(H(m) = \sum m_i k_i\) 是线性的。只要攻击者能通过时间差判断两个键是否同桶,猜出一个碰撞 \(m'\) 后,\(m\) 加上 \(m' - m\) 的任意倍数都会继续碰撞,再猜几次就能用高斯消元解出密钥模桶数的值。全域哈希的保证只在”键与函数的选择相互独立”时成立,自适应的攻击者破坏了这个前提。
- 为什么强 PRF 也不是零风险:即使 \(H\) 是强 PRF,攻击者仍可盲猜:大约 \(\sqrt{m}\) 次猜出第一个碰撞,之后每多一个碰撞要约 \(m\) 次。凑出 \(n\) 个同桶键需要发送约 \(n \cdot m \approx n^2\) 个串,于是 CPU 放大倍数被限制在攻击流量的平方根,而弱哈希的放大倍数与流量成正比。
所以 PRF
的作用是把放大倍数从线性压到平方根,而不是彻底消灭攻击。限制单次请求的键数量(PHP
的 max_input_vars)、把长链树化(Java 8,见 哈希表内部
第二节),这类结构性措施在有了 SipHash 之后依然有意义。
七、SipHash
定义
SipHash-\(c\)-\(d\) 接受 128 位密钥 \((k_0, k_1)\) 和任意长度的字节串,输出 64 位(Aumasson & Bernstein, INDOCRYPT 2012, §2):
- 四个 64 位状态字用密钥与常数初始化,常数是 ASCII 串 “somepseudorandomlygeneratedbytes”。论文说明这个值没有特殊之处,只是要让 \(v_0, v_1\) 与 \(v_2, v_3\) 不对称。
- 消息按小端切成 64 位字,最后一个字装入剩余的 0 到 7 个字节,最高字节写入 \(\text{len} \bmod 256\)。每个字 \(m_i\) 先异或进 \(v_3\),做 \(c\) 轮 SipRound,再异或进 \(v_0\)。
- 终结时 \(v_2 \oplus\)
0xff,做 \(d\) 轮 SipRound,输出 \(v_0 \oplus v_1 \oplus v_2 \oplus v_3\)。
一轮 SipRound 是 4 次加法、4 次异或、6
次循环移位,没有乘法、查表和数据相关的分支(reproduce/siphash.h):
#define SIPROUND                                            \
    do {                                                    \
        v0 += v1; v1 = rotl64(v1, 13); v1 ^= v0;            \
        v0 = rotl64(v0, 32);                                \
        v2 += v3; v3 = rotl64(v3, 16); v3 ^= v2;            \
        v0 += v3; v3 = rotl64(v3, 21); v3 ^= v0;            \
        v2 += v1; v1 = rotl64(v1, 17); v1 ^= v2;            \
        v2 = rotl64(v2, 32);                                \
    } while (0)
压缩循环与终结部分:
for (; p != end; p += 8) {
    uint64_t m;
    memcpy(&m, p, 8);
    v3 ^= m;
    for (int i = 0; i < c; i++) SIPROUND;
    v0 ^= m;
}
/* ... 最后一个字 b 同样处理 ... */
v2 ^= 0xff;
for (int i = 0; i < d; i++) SIPROUND;
return v0 ^ v1 ^ v2 ^ v3;
test_vectors 用官方仓库的 64 个 SipHash-2-4
测试向量(密钥 00..0f,消息 00..3e
的各个前缀)逐一核对,并复现了论文附录 A 的 15 字节样例
a129ca6149be45e5。
论文承诺了什么
- 参数:论文 §3 写的是,\(c \ge 2\)、\(d \ge 4\) 时预期达到同等密钥长度和输出长度下的最大 PRF 安全性;SipHash-2-4 是”快速方案”,SipHash-4-8 是”保守方案”;更小的参数(1-0、1-1、1-2 等)是留给密码分析的靶子。
- 不抗碰撞:原文是 “SipHash is not meant to be, and (obviously) is not, collision-resistant”。输出只有 64 位,知道密钥的人用生日攻击约 \(2^{32}\) 次就能找到碰撞。它的安全性完全依赖密钥保密,这也是它适合哈希表、不适合做无密钥摘要的原因。
- 安全上限:密钥 128 位,暴力恢复密钥平均 \(2^{127}\) 次;作为 MAC 时,盲猜标签的成功率是每次 \(2^{-64}\)(§3、§5)。
- 第三方分析:Dobraunig、Mendel 与 Schläffer(SAC 2014)做了第一份公开的第三方差分分析,找到一条概率为 \(2^{-236.3}\) 的 SipHash-2-4 差分特征,以及一个仅针对终结部分、复杂度可实用的区分器;作者明确表示这些结果不威胁 SipHash-2-4 的安全性。
SipHash-1-3 的位置
SipHash-1-3 不在论文的推荐之列,但被广泛采用:Rust
1.11.0(2016-08)把标准库 HashMap 的默认哈希从
SipHash-2-4 换成 1-3(RELEASES.md,PR
#33940);CPython 3.11 也把
str、bytes 的默认哈希改为
siphash13,What’s New 的说法是它”与 siphash24
有相近的安全性质,在长输入上稍快”(bpo-29410)。第五节的实测里,1-3
在 8 字节键上比 2-4 快约 1.5 倍。公开的第三方分析集中在 2-4
上,1-3
的安全余量没有同等深度的论证,第九节会回到这一点。
八、生产实现对照
以下按钉定版本的源码或官方文档:
| 实现 | 版本 | 字节串默认哈希 | 密钥或种子 |
|---|---|---|---|
| CPython | 3.3 | 带随机前缀和后缀的 FNV 变体 | 进程启动时随机,默认开启;可被两个输出解出(SipHash 论文附录 B) |
| CPython | 3.4–3.10 | SipHash-2-4(PEP 456) | 128 位,进程级随机,PYTHONHASHSEED
可固定 |
| CPython | 3.11 起 | SipHash-1-3(Include/pyhash.h 中
Py_HASH_ALGORITHM 默认为
Py_HASH_SIPHASH13) |
同上;本机 3.14.5 的 sys.hash_info 为
algorithm='siphash13'、seed_bits=128 |
| Rust std | 1.11.0 起 | SipHash-1-3(此前自 0.4 起为 SipHash-2-4) | RandomState 随机密钥 |
| hashbrown(crate) | 0.17.1 | 默认特性 default-hasher 下为
foldhash::fast::RandomState;src/map.rs
文档写明”随时可能改变”,且”通常不能抵御 HashDoS
之类的攻击” |
随机状态;不影响标准库 HashMap,后者仍用
SipHash-1-3 |
| Go runtime | 1.26.8 | amd64 上有 AES、SSSE3、SSE4.1,或 arm64 上有 AES
时用基于 AES 轮函数的 aeshash;否则用
hash64.go 中”受 wyhash 启发”的
memhashFallback |
alginit() 用 bootstrapRand()
初始化密钥;每个 map 另有随机种子 |
| Abseil | 20240722.0 | 长于 16 字节且有 128 位整数时用
LowLevelHash,头文件注释称其”紧密基于某个版本的
wyhash,但不保证与之兼容”;否则用 CityHash64 |
见下一行 |
| Abseil | 20260817.0 | 32 字节以内:有 SSE4.2 或 ARM CRC 时用 CRC32C 指令加 128
位乘法混合,否则用乘法混合;超过 32 字节:有 AES 指令时用
AES 轮函数,否则用 Mix32Bytes()
的乘法混合;low_level_hash.h 已在 20250814.0
删除 |
Seed() 返回全局变量 kSeed
的地址,依赖 ASLR;注释写明”目前不是安全特性” |
| Java | JDK 8 起 | String.hashCode() 为 API
规范规定的固定多项式 \(s_0
31^{n-1} + \cdots + s_{n-1}\) |
无;靠 HashMap 链表树化兜底(JEP 180) |
几点说明:
- “Abseil 用 wyhash” 只描述了 20250512.0
及更早版本中长于 16 字节的输入,并且 Abseil 自己强调不保证与
wyhash 兼容。当前版本(20260817.0)的
absl/hash/internal/下已经没有low_level_hash.h,源码里也找不到 wyhash 字样。 - Go 与 Abseil 都没有宣称 PRF 安全性。Go
的 AES 路径用的是随机密钥,但本文没有找到针对
aeshash的公开密码分析;Abseil 的注释说得很直白:“A true random seed costs more and we don’t need to pay for that right now”。 - wyhash 本身也在变:仓库的
wyhash标签指向 “final version 3”,master 是 “final version 4.3”,两者的常数_wyp和终结步骤都不同,同一输入的输出不同。需要把哈希值持久化或跨进程比对时,这类”不保证兼容”的函数都不合适。
九、争论与开放问题
争论一:语言默认的哈希该不该是 PRF
一方以 SipHash 论文 §7 为代表:只要应用可能把外部输入当键,默认哈希就应该是强 PRF,因为几乎不可能审计所有应用有没有通过遍历顺序、响应时间暴露桶号。CPython 与 Rust 标准库采纳了这个立场,并为此付出第五节那样的短键开销。
另一方以 Abseil、hashbrown 的默认设置为代表:用更快的混合函数加一个廉价的随机化,防止用户依赖具体哈希值,把抗攻击的责任交给真正面对不可信输入的场景。Abseil 在源码注释里明确把种子定位为”目前不是安全特性”,但”为升级到真正的进程级随机种子留了门”;hashbrown 的文档直接写明默认哈希”通常不能抵御 HashDoS”。
两边的证据不对称:前者有论文和 2011–2012 年的真实攻击;后者的依据主要是性能,公开的数据通常是厂商或维护者自己的基准。第五节的微基准显示差距在短键上是每次几纳秒,这个差距在整次表查找里占多大比例,取决于负载,本文没有这样的数据。
争论二:修函数还是修结构
dnscache 给链长设上限,PHP 限制参数个数,Java 8 把长链树化,这些都不改哈希函数,而是限制最坏情况的代价。Java 的做法把单桶最坏查找从 \(O(n)\) 降到 \(O(\log n)\),但前提是键可比较,而且代价是更复杂的实现。SipHash 论文的分析说明,即使换了强 PRF,攻击者盲猜的放大倍数仍是流量的平方根。两类措施解决的是不同层面的问题,互相替代不了。
开放问题
- “足够好的非密码学哈希”没有形式化定义。 统计测试只能证伪,不能证明;MurmurHash3 通过 SMHasher 却有种子无关碰撞,就是反例。哈希表到底需要多弱的性质才能抵御能观察时间的攻击者?SipHash 论文认为”达到这种不可预测性并不比达到完整 PRF 容易多少”,但这是一个判断,不是定理。可读入口是 SipHash 论文 §7 与 Carter–Wegman 的全域哈希理论。
- SipHash-1-3 的安全余量。 它已是 Rust 与 CPython 的默认,但论文的安全声明只覆盖 \(c \ge 2\)、\(d \ge 4\),公开的第三方分析(Dobraunig et al., SAC 2014)也以 2-4 为对象。1-3 在哈希表威胁模型下是否足够,目前主要靠设计者的非正式意见和”尚无攻击”来支撑。
- 基于 AES 轮函数的哈希是否满足 PRF 要求。 Go 与 Abseil 都在用 AES 指令做混合,但两者都没有给出安全声明,本文也没有找到针对它们的公开分析。
十、工程选型与常见错误
flowchart TD
    A["Do attackers choose or influence the keys?"] -->|"yes"| B["Hash table keys?"]
    A -->|"no"| C["Must the value be stable across versions or processes?"]
    B -->|"yes"| D["Keyed PRF: SipHash with a per-process random key, plus limits on key count"]
    B -->|"no, need a MAC"| E["HMAC-SHA-256, KMAC or keyed BLAKE3"]
    C -->|"yes"| F["A specified function with a frozen output: SHA-256, BLAKE3, or XXH64 / XXH3 when no adversary exists"]
    C -->|"no"| G["Fast non-crypto hash: wyhash, XXH3, or the library default"]
图中”库默认”指 Abseil、hashbrown 等已经带随机化的实现;它们适合可信输入,面对不可信输入时要按第八节确认默认哈希到底是什么。
| 错误 | 后果 | 做法 |
|---|---|---|
| 用固定或”随机种子”的非密码学哈希处理外部输入的键 | 种子无关的碰撞族依然有效(第六节,MurmurHash3 与 DJBX33A 各 5.4 亿次比较) | 用带随机密钥的 SipHash;同时限制单个请求的键数 |
| 用 \(\mathrm{SHA256}(\mathit{secret} \,\|\, \mathit{msg})\) 当 MAC | 长度扩展伪造(第三节,猜 25 次秘密长度即成功) | HMAC-SHA-256、KMAC 或 BLAKE3 带密钥模式 |
用 h & (m - 1) 配 FNV-1a 或
DJBX33A |
最低位是各字节最低位的异或,雪崩偏差 100% | 换混合充分的函数,或在取模前再做一次混合 |
| 把 wyhash、Abseil 哈希值写入磁盘或网络协议 | 版本升级后哈希值改变(wyhash final 3 与 4.3 常数不同;Abseil 不保证兼容) | 持久化用有规范、输出冻结的函数 |
| 把”通过 SMHasher”当作安全证明 | 统计测试不覆盖对抗输入 | 区分”质量”与”抗攻击”两个问题 |
| 把 SipHash 当作抗碰撞的摘要 | 64 位输出,知道密钥时约 \(2^{32}\) 次就有碰撞 | 需要无密钥摘要时用 SHA-256 / SHA-3 / BLAKE3 |
| 用 SHA-256 做哈希表的哈希 | 短键上比 SipHash 慢 4.6 到 7 倍,且不防离线构造的同桶键 | 哈希表用 PRF;SHA-256 留给签名和内容寻址 |
| 用快速哈希存储口令 | SHA-256 这样的函数本来就被设计得很快,利于暴力破解 | 用 Argon2id、scrypt 或 bcrypt 这类专用口令哈希 |
十一、参考资料
规范与文档
- NIST, FIPS 180-4, Secure Hash Standard (SHS), 2015.
- NIST, FIPS 202, SHA-3 Standard: Permutation-Based Hash and Extendable-Output Functions, 2015.
- NIST, SP 800-185, SHA-3 Derived Functions: cSHAKE, KMAC, TupleHash and ParallelHash, 2016.
- H. Krawczyk, M. Bellare, R. Canetti, RFC 2104, HMAC: Keyed-Hashing for Message Authentication, 1997.
- M.-J. Saarinen, J.-P. Aumasson, RFC 7693, The BLAKE2 Cryptographic Hash and Message Authentication Code (MAC), 2015.
- J. O’Connor, J.-P. Aumasson, S. Neves, Z. Wilcox-O’Hearn, BLAKE3: one function, fast everywhere,规范文档(版本 20211102173700)。
- C. Heimes, PEP 456, Secure and interchangeable hash algorithm(Python 3.4)。
- Python 文档:What’s New In Python
3.3(哈希随机化默认开启);What’s New In Python
3.11(
siphash13,bpo-29410)。 - Rust
RELEASES.md:Version 0.4(2012-10-15)与 Version 1.11.0(2016-08-18)条目。 - oCERT-2011-003, multiple implementations denial-of-service via hash algorithm collision, 2011.
- oCERT-2012-001, multiple implementations denial-of-service via MurmurHash algorithm collision, 2012.
- PHP 5 ChangeLog,Version
5.3.9(2012-01-10):
max_input_vars。 - OpenJDK JEP 180, Handle Frequent HashMap Collisions with Balanced Trees(JDK 8)。
源码
- Abseil:
absl/hash/internal/low_level_hash.h于 tag 20230802.0、20240722.0、20250512.0;absl/hash/internal/hash.h于 20240722.0;absl/hash/internal/hash.h、hash.cc于 20260817.0。 - Go
1.26.8:
src/runtime/alg.go(alginit)、src/runtime/hash64.go(memhashFallback)。 - CPython
3.11:
Include/pyhash.h(Py_HASH_ALGORITHM)。 - hashbrown
0.17.1:
src/hasher.rs、src/map.rs、Cargo.toml。 - PHP
5.3.8:
Zend/zend_hash.h(zend_inline_hash_func)。 - veorq/SipHash @
32d0676:参考实现与vectors.h。 - aappleby/smhasher
@
61a0530:src/MurmurHash3.cpp、src/AvalancheTest.h。 - Cyan4973/xxHash v0.8.3:
xxhash.h。 - wangyi-fudan/wyhash @
e4764a0b(final version 4.3)与 tagwyhash(final version 3):wyhash.h。 - SMHasher3(Frank J. T.
Wojcik):
README.md。
核心论文
- R. C. Merkle, “One Way Hash Functions and DES”, CRYPTO ’89, LNCS 435, pp. 428–446.
- I. B. Damgård, “A Design Principle for Hash Functions”, CRYPTO ’89, LNCS 435, pp. 416–427.
- P. Rogaway, T. Shrimpton, “Cryptographic Hash-Function Basics: Definitions, Implications, and Separations for Preimage Resistance, Second-Preimage Resistance, and Collision Resistance”, FSE 2004, LNCS 3017, pp. 371–388.
- G. Bertoni, J. Daemen, M. Peeters, G. Van Assche, “On the Indifferentiability of the Sponge Construction”, EUROCRYPT 2008, LNCS 4965, pp. 181–197.
- S. A. Crosby, D. S. Wallach, “Denial of Service via Algorithmic Complexity Attacks”, 12th USENIX Security Symposium, 2003.
- J.-P. Aumasson, D. J. Bernstein, “SipHash: a fast short-input PRF”, INDOCRYPT 2012, LNCS 7668, pp. 489–508;IACR ePrint 2012/351.
- A. F. Webster, S. E. Tavares, “On the Design of S-Boxes”, CRYPTO ’85, LNCS 218, pp. 523–534.
其他论文
- J. L. Carter, M. N. Wegman, “Universal Classes of Hash Functions”, JCSS 18(2), 1979, pp. 143–154.
- M. Bellare, R. Canetti, H. Krawczyk, “Keying Hash Functions for Message Authentication”, CRYPTO ’96, LNCS 1109, pp. 1–15.
- P. Rogaway, “Formalizing Human Ignorance: Collision-Resistant Hashing without the Keys”, VIETCRYPT 2006, LNCS 4341, pp. 211–228.
- A. Joux, “Multicollisions in Iterated Hash Functions. Application to Cascaded Constructions”, CRYPTO 2004, LNCS 3152, pp. 306–316.
- J. Kelsey, B. Schneier, “Second Preimages on n-Bit Hash Functions for Much Less than \(2^n\) Work”, EUROCRYPT 2005, LNCS 3494, pp. 474–490.
- X. Wang, H. Yu, “How to Break MD5 and Other Hash Functions”, EUROCRYPT 2005, LNCS 3494, pp. 19–35.
- X. Wang, Y. L. Yin, H. Yu, “Finding Collisions in the Full SHA-1”, CRYPTO 2005, LNCS 3621, pp. 17–36.
- Y. Sasaki, K. Aoki, “Finding Preimages in Full MD5 Faster Than Exhaustive Search”, EUROCRYPT 2009, LNCS 5479, pp. 134–152.
- M. Stevens, A. Sotirov, J. Appelbaum, A. Lenstra, D. Molnar, D. A. Osvik, B. de Weger, “Short Chosen-Prefix Collisions for MD5 and the Creation of a Rogue CA Certificate”, CRYPTO 2009, LNCS 5677, pp. 55–69.
- M. Stevens, “Counter-Cryptanalysis”, CRYPTO 2013, LNCS 8042, pp. 129–146.
- M. Stevens, E. Bursztein, P. Karpman, A. Albertini, Y. Markov, “The First Collision for Full SHA-1”, CRYPTO 2017, LNCS 10401, pp. 570–596.
- G. Leurent, T. Peyrin, “From Collisions to Chosen-Prefix Collisions Application to Full SHA-1”, EUROCRYPT 2019, LNCS 11478, pp. 527–555.
- G. Leurent, T. Peyrin, “SHA-1 is a Shambles: First Chosen-Prefix Collision on SHA-1 and Application to the PGP Web of Trust”, USENIX Security 2020.
- J.-P. Aumasson, S. Neves, Z. Wilcox-O’Hearn, C. Winnerlein, “BLAKE2: Simpler, Smaller, Fast as MD5”, ACNS 2013, LNCS 7954, pp. 119–135.
- C. Dobraunig, F. Mendel, M. Schläffer, “Differential Cryptanalysis of SipHash”, SAC 2014, LNCS 8781, pp. 165–182;IACR ePrint 2014/722.
工程资料
- A. Klink, J. Wälde, “Efficient Denial of Service Attacks on Web Application Platforms”, 28C3, 2011.
- J.-P. Aumasson, D. J. Bernstein, M. Boßlet, “Hash-flooding DoS reloaded: attacks and defenses”, 29C3, 2012.
- shattered.io:SHAttered 攻击的计算量说明。
实验
reproduce/test_vectors.cc:SipHash-2-4 官方向量与 SHA-256 对照 OpenSSL。reproduce/lenext.cc:第三节长度扩展伪造。reproduce/avalanche.cc、plot_avalanche.py:第五节雪崩偏差表与热力图。reproduce/speed.cc、median_speed.py:第五节速度表。reproduce/hashdos.cc、plot_hashdos.py:第六节比较次数表与曲线。reproduce/run_all.sh:下载依赖、编译并运行以上全部实验。
系列导航: - 上一篇:Bloom Filter 家族:从位数组到 Ribbon,每键位数离下界还差多少 - 下一篇:XXH3 与 wyhash:SIMD 累加器和 128 位标量乘法两条提速路线
相关阅读: - 哈希表内部:链式、线性探测、Robin Hood 与生产实现的取舍 - Swiss Table:控制字节、分组探测与墓碑 - 完美哈希 - Merkle 树与认证数据结构 - 密码学哈希函数:MD5→SHA-2→SHA-3 的进化之路 - MAC 与 HMAC:消息认证的正确姿势
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【密码学百科】密码学哈希函数:MD5→SHA-2→SHA-3 的进化之路
密码学哈希函数是现代密码学的瑞士军刀——本文从安全属性的形式化定义出发,追溯从 MD5 到 SHA-3 的演进历程,剖析碰撞攻击的原理与海绵构造的革命
素性测试与素数生成:Miller-Rabin、BPSW 与 OpenSSL/FIPS 186-5
用可复现实验核对 Miller-Rabin 的 1/4 界、平均情况误判率和 64 位确定性底数,梳理 BPSW 与 AKS 的谱系,并对照 OpenSSL 3.6.2 源码与 FIPS 186-5 说明 RSA 素数实际做几轮测试、为什么够用。
【密码学百科】MAC 与 HMAC:消息认证的正确姿势
加密保证机密性,但不保证完整性——消息认证码(MAC)是防止篡改的关键工具。本文深入 HMAC 的构造与安全性证明,对比 CBC-MAC、GMAC、Poly1305 等方案
Swiss Table:控制字节、分组探测与墓碑——对照 Abseil、Go 与 hashbrown 源码
对照 Abseil 20260817.0、Go 1.26.8 与 hashbrown 0.17.1 源码,拆解 Swiss table 的控制字节编码、SIMD/SWAR 分组匹配、三角探测、删除与 rehash 策略,并用可复现实验测量探测长度、墓碑代价与每元素内存。