键集合事先完全已知、之后不再变化时,能不能造一个在这组键上没有任何冲突的哈希函数?答案是能,而且有两种很不一样的造法,对应两个不同的问题:
- 静态字典:给定 \(n\) 个键,查询”\(x\) 在不在集合里、对应什么值”,要求最坏情况 \(O(1)\)。Fredman、Komlós 和 Szemerédi(FKS)1984 年的两级方案用 \(O(n)\) 个字的空间做到了两次访存,代价是表里要存键本身。
- 最小完美哈希函数(Minimal Perfect Hash Function,MPHF):只要求把 \(n\) 个键双射到 \(\{0, \ldots, n-1\}\),不存键,也不回答成员查询。它的空间下界约为 \(\log_2 e \approx 1.443\) bits/key,近二十年的研究几乎都在和这个常数较劲。
常见的误解有三个:以为 GCC 用 gperf 识别 C 关键字(GCC
15.1 用的是普通的标识符哈希表,第七节);以为 MPHF
可以直接回答”在不在”(它对集合外的键会返回一个合法下标,第一节);以及把不同论文、不同条件下的
bits/key 放进一张表直接排名(第六节)。本文依次讲
FKS、空间下界、基于随机超图的 CHM/BDZ、hash-and-displace
一族(CHD、PTHash)、BBHash 与 RecSplit,最后回到 gperf 3.3
的实际算法。文中所有自测数字来自同目录
reproduce/
下的程序(环境见第四节开头),全部是与时钟无关的计数;外部数据都注明出处。
一、定义:PHF、MPHF 与静态字典
设全集为 \(U\),\(|U| = u\),键集合 \(S \subseteq U\),\(|S| = n\)。函数 \(h: U \to \{0, \ldots, m-1\}\) 若在 \(S\) 上是单射,就称为 \(S\) 的完美哈希函数(Perfect Hash Function,PHF);若 \(m = n\),就是 MPHF。\(\alpha = n/m\) 叫负载因子。
两点容易混淆:
- \(h\) 定义在整个 \(U\) 上。对 \(x \notin S\),\(h(x)\) 仍然是 \([0, m)\) 里的某个数。要判断成员关系,必须在 \(h(x)\) 指向的位置存键(或指纹)再比较一次。gperf 生成的查找函数、FKS 的第二级表都这么做;而 MPHF 文献里的 bits/key 不含键本身。
- “零冲突”只对构造时给定的 \(S\) 成立。增删一个键,一般要整体重建。Dietzfelbinger 等人的动态完美哈希不在本文范围。
| 目标 | 存不存键 | 典型空间 | 典型用途 |
|---|---|---|---|
| 静态字典(FKS) | 存 | \(O(n)\) 个机器字 | 最坏 \(O(1)\) 的成员查询 |
| PHF,\(\alpha < 1\) | 不存 | 低于 \(\log_2 e\) bits/key(第三节) | 给键分配槽位,允许少量空槽 |
| MPHF,\(\alpha = 1\) | 不存 | \(\ge \log_2 e \approx 1.443\) bits/key | 把字符串键映射成紧凑的数组下标 |
二、FKS:两级表与 \(\sum b_i^2\)
从 Tarjan–Yao 到 FKS
Tarjan 和 Yao(CACM 1979,“Storing a sparse table”)已经用”行位移”把稀疏表压成 \(O(n)\) 空间,但查找时间依赖全集大小 \(u\) 与 \(n\) 的关系,只在 \(u\) 相对 \(n\) 不太大时才是常数。Fredman、Komlós 和 Szemerédi 的 “Storing a Sparse Table with \(O(1)\) Worst Case Access Time” 先在 FOCS 1982 发表,再刊于 JACM 31(3),1984。它对任意全集给出 \(O(n)\) 空间、最坏常数时间的静态字典,思路是两级哈希。
下面按教科书常用的参数(CLRS 第 11.5 节)叙述,并配合 Carter–Wegman(JCSS 1979)的全域哈希族:
\[ h_{a,b}(x) = \big((a x + b) \bmod p\big) \bmod m,\qquad 1 \le a < p,\ 0 \le b < p, \]
\(p\) 为大于所有键的素数。该族满足:对任意 \(x \ne y\),\(\Pr[h(x) = h(y)] \le 1/m\)。
为什么不能一级搞定
把 \(n\) 个键扔进 \(m\) 个槽,冲突对数的期望是
\[ E[\#\text{collisions}] \le \binom{n}{2} \frac{1}{m}. \]
取 \(m = n^2\) 时它小于 \(1/2\),由 Markov 不等式,随机抽一个 \(h\) 就有至少 \(1/2\) 的概率无冲突。反过来,要让随机抽的函数以常数概率无冲突,\(m\) 必须是 \(\Theta(n^2)\) 量级(生日问题)。注意这是对”随机抽”的要求,不是”不存在更小的完美函数”:第三节会看到,只要允许存几个 bit 的描述,\(m = n\) 也能做到。
两级结构
FKS 的办法是只在小范围内付平方代价:
- 第一级用 \(h\) 把键分进 \(m = n\) 个桶,桶 \(i\) 有 \(b_i\) 个键;若 \(\sum_i b_i^2 \ge 4n\) 就换一个 \(h\)。
- 桶 \(i\) 拥有 \(s_i = b_i^2\) 个槽的子表和自己的 \(h_i\),换 \(h_i\) 直到它在桶内无冲突。
第一级的期望:\(\sum_i b_i^2 = n + 2\cdot\#\text{collisions}\),所以
\[ E\Big[\sum_i b_i^2\Big] \le n + 2\binom{n}{2}\frac{1}{n} = 2n - 1, \]
由 Markov 不等式 \(\Pr[\sum b_i^2 \ge 4n] < 1/2\),期望不到 2 次就能选到合格的 \(h\)。第二级每个桶的成功概率至少 \(1/2\)。总空间是 \(n\) 个桶头加不到 \(4n\) 个槽,即 \(O(n)\) 个字。

图中的数据来自 ./fks --demo 3
的真实输出。有三点需要看:
- 桶头记录 \((a_j, b_j)\)、偏移和 \(s_j\),所有子表拼在同一个槽数组里,空桶不占槽。这 8 个键共用 16 个槽,\(\sum b_i^2 = 1+1+1+9+4 = 16 < 32\)。
- 桶 5 的 3 个键落在子表的第 2、3、8 格,9 个格子里只用了 3 个,这就是 \(b_i^2\) 带来的浪费;换来的是随机选 \(h_5\) 时很快成功。
- 查找 38 恰好是两次哈希、两次读内存(桶头、槽)和一次键比较。集合外的键要么落进空桶,要么落到空槽或别的键上,比较失败即返回”不存在”。
实现与实测
reproduce/fks.c 取 \(p = 2^{61}-1\),用 128 位乘法和
Mersenne
素数的折叠求模。构造的核心是两个重试循环(摘自该文件
fks_build(),有删减):
do {
    f->level1_tries++;
    f->h1 = cw_random(&rng);
    memset(cnt, 0, (size_t)n * sizeof *cnt);
    for (uint32_t i = 0; i < n; i++)
        cnt[cw_hash(f->h1, keys[i], n)]++;
    sumsq = 0;
    for (uint32_t j = 0; j < n; j++)
        sumsq += (uint64_t)cnt[j] * cnt[j];
} while (sumsq >= 4ULL * n);
...
for (;;) {
    tries++;
    bk->h = cw_random(&rng);
    for (uint32_t s = 0; s < bk->size; s++)
        sub[s] = EMPTY;
    uint32_t k;
    for (k = 0; k < b; k++) {
        uint64_t x = grouped[start[j] + k];
        uint32_t pos = cw_hash(bk->h, x, bk->size);
        if (sub[pos] != EMPTY)
            break;
        sub[pos] = x;
    }
    if (k == b)
        break;
}
对每个规模用 5 个种子构造,并验证全部键可查到、另取 \(10^6\) 个随机非键全部查不到(中位数):
| \(n\) | 第一级尝试次数 | \(\sum b_i^2 / n\) | 第二级平均尝试次数/非空桶 | 最大桶 \(b_i\)(5 次中最大) |
|---|---|---|---|---|
| \(10^3\) | 1 | 2.0100 | 1.149 | 5 |
| \(10^5\) | 1 | 1.9994 | 1.155 | 8 |
| \(10^6\) | 1 | 1.9993 | 1.156 | 9 |
\(\sum b_i^2/n\) 紧贴理论值 \(2 - 1/n\),15 次构造里第一级都是一次成功,远低于 \(4n\) 的门槛;第二级平均 1.16 次,比”至少 1/2 成功率”推出的 2 次上界好,因为大多数桶只有一个键,必然一次成功。
空间要按字算。本实现每个桶头 24 字节,槽约 \(2n\) 个、每个 8 字节,合计约 40 字节/键,而且其中 16 字节是键本身。FKS 解决的是”最坏两次访存的字典”,不是”最小的函数描述”;把它和 MPHF 的 bits/key 放进同一列比较没有意义。
三、空间下界:为什么是 \(\log_2 e\)
MPHF 不存键,那它最少要多少 bit?计数论证来自 Mehlhorn(FOCS 1982,“On the program size of perfect and universal hash functions”)和 Fredman、Komlós(SIAM J. Algebraic Discrete Methods 5(1),1984),2025 年的综述(Lehmann 等,见第六节)给了简明版本:
- 固定一个函数 \(f: U \to [n]\)。它对某个 \(n\) 元集合是 MPHF,当且仅当该集合在每个原像 \(f^{-1}(i)\) 里恰好取一个元素,这样的集合有 \(\prod_i |f^{-1}(i)|\) 个,原像大小都为 \(u/n\) 时取最大值 \((u/n)^n\)。
- 可能的输入集合共有 \(\binom{u}{n}\) 个,所以至少需要 \(\binom{u}{n} / (u/n)^n\) 个不同的函数,描述它至少要
\[ \log_2 \frac{\binom{u}{n}}{(u/n)^n} \xrightarrow{u \to \infty} \log_2 \frac{n^n}{n!} = n \log_2 e - \tfrac{1}{2}\log_2(2\pi n) - o(1) \]
bit。按精确式计算(reproduce/plot_space.py),每键下界在
\(n = 16\) 时是 1.234
bit,\(n = 1000\) 时 1.436
bit,\(n = 10^6\) 时 1.4427
bit。
允许空槽时下界会降低。负载因子为 \(\alpha\) 的 PHF,每键至少
\[ \log_2 e + \Big(\frac{1}{\alpha} - 1\Big)\log_2(1 - \alpha) \]
bit。\(\alpha = 0.5\) 时约 0.443,\(\alpha = 0.81\) 时 0.881,\(\alpha = 0.99\) 时 1.376。CHD 论文图 1 标注的下界 0.88、1.07、1.38、1.44(对应 \(\alpha = 0.81, 0.90, 0.99, 1.00\))与此式一致。
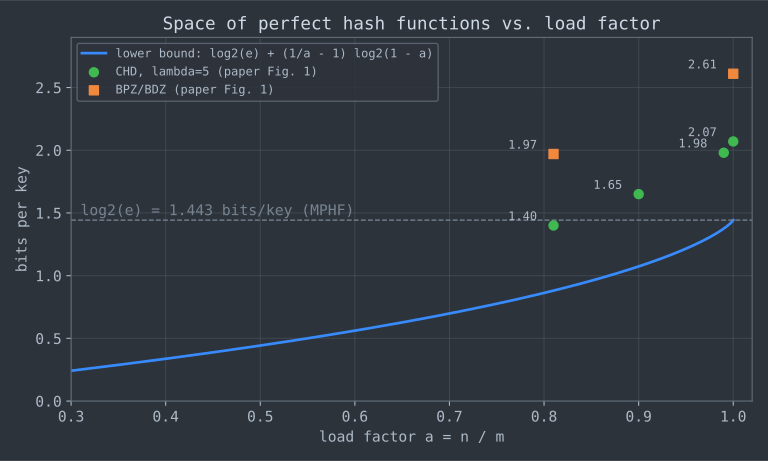
图中的点是论文数据,不是本站实测。实际方案离曲线还有 0.5 到 1 bit 左右的距离,而且越靠近 \(\alpha = 1\),下界本身越陡。
四、随机超图:CHM 与 BDZ
实验环境
以下各节的自测都在同一环境下完成:Intel Core
i9-12900K,WSL2 内核 6.6.87.2,GCC 16.1.1,编译参数
-O2 -Wall -Wextra(另用
-fsanitize=address,undefined
跑过小规模输入);Python 绘图用
matplotlib。程序都使用固定种子,指标是成功率、尝试次数和 bit
数,与时钟无关,不报告任何耗时。
cd reproduce
gcc -O2 -Wall -Wextra -o fks fks.c && ./fks
gcc -O2 -Wall -Wextra -o graphs graphs.c -lm && ./graphs > results/graphs.txt
gcc -O2 -Wall -Wextra -o hd hd.c -lm && ./hd 1000000
gcc -O2 -Wall -Wextra -o bbhash_sim bbhash_sim.c -lm && ./bbhash_sim
python plot_peel.py && python plot_space.py
./run_gperf.sh
CHM:无环随机图
Czech、Havas 和 Majewski(IPL 43(5),1992)把每个键看成一条边 \(\{f_1(x), f_2(x)\}\),顶点数 \(m = cn\),\(c > 2\)(常用 2.09)。如果这张随机图无环,就可以沿着每棵树给顶点赋值 \(g\),使
\[ h(x) = \big(g(f_1(x)) + g(f_2(x))\big) \bmod n \]
等于任意事先指定的值,所以 CHM 天然是保序的。代价是 \(g\) 的每个值要 \(\log_2 n\) bit,总空间约 \(2.09\, n \log_2 n\) bit(综述 Table 1)。\(c > 2\) 的门槛来自随机图理论:平均度数 \(2n/m = 2/c\) 小于 1 时,环的数目近似服从 Poisson 分布,图以常数概率无环。
Botelho、Pagh 和 Ziviani(WADS
2007)对二分图版本(两个哈希各占一半顶点)给出无环概率 \(\sqrt{1 - (2/c)^2}\),\(c = 2.09\) 时为 0.29,他们在
\(n = 10^7\) 上实验得到
0.294。graphs.c 的 E1 用 \(n = 10^5\) 复现:
| \(c\) | 次数 | 实测无环比例 | \(\sqrt{1-(2/c)^2}\) |
|---|---|---|---|
| 2.09 | 2000 | 0.301 | 0.290 |
| 2.50 | 1000 | 0.586 | 0.600 |
| 3.00 | 1000 | 0.763 | 0.745 |
三组差异都在两个标准差以内(\(c = 2.09\) 时标准差约 0.010)。\(c = 2.09\) 意味着平均要试 3 次多才能得到一张可用的图。
MWHC/BDZ:三部超图与剥离
Majewski、Wormald、Havas 和 Czech(The Computer Journal 39(6),1996)把边换成 3 个顶点的超边。三部超图不再谈”环”,而是看能否剥离(peeling):反复找一个度为 1 的顶点,删掉它唯一所在的边;若最后删光所有边,就称可剥离。每条边被删时都带走一个”自由顶点”,此后不再有边碰它。
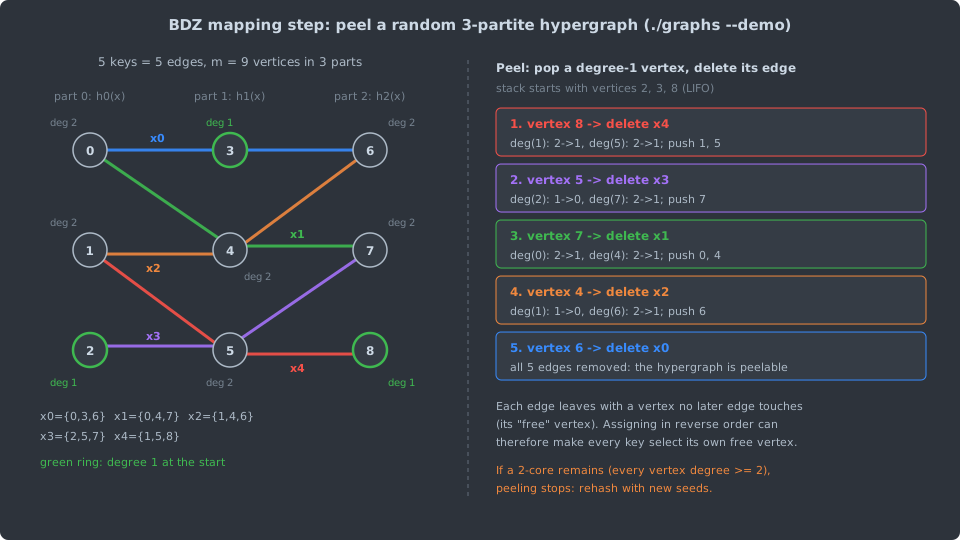
图中的例子与 ./graphs --demo
的输出一致。实现用”度数 + 相邻边编号异或”找出度为 1
的顶点所在的唯一边,整个剥离是线性时间。
Botelho、Pagh、Ziviani 的 BDZ(论文和综述里也叫 BPZ)在剥离之后不再存 \(\log_2 n\) bit 的值,每个顶点只存 \(g[v] \in \{0,1,2,3\}\),查询时
\[ h(x) = v_i(x),\qquad i = \big(g[v_0] + g[v_1] + g[v_2]\big) \bmod 3, \]
也就是用 2 bit/顶点选出三个候选顶点中的一个。赋值按逆剥离顺序进行:处理某条边时,它的自由顶点还没被任何已处理的边碰过,可以自由设值,让和的余数恰好指向自己;未被使用的顶点保持 3(模 3 等于 0,同时标记”未用”)。上例的赋值过程:
| 处理次序 | 边 | 自由顶点(所在部 \(j\)) | 另两个顶点的 \(g \bmod 3\) | \(g[v] = (j - \text{和}) \bmod 3\) | \(h(x)\) |
|---|---|---|---|---|---|
| 1 | x0 | 6(\(j=2\)) | \(g_0 = 3 \to 0\),\(g_3 = 3 \to 0\) | 2 | 6 |
| 2 | x2 | 4(\(j=1\)) | \(g_1 = 3 \to 0\),\(g_6 = 2\) | \((1-2) \bmod 3 = 2\) | 4 |
| 3 | x1 | 7(\(j=2\)) | \(g_0 \to 0\),\(g_4 = 2\) | 0 | 7 |
| 4 | x3 | 5(\(j=1\)) | \(g_2 \to 0\),\(g_7 = 0\) | 1 | 5 |
| 5 | x4 | 8(\(j=2\)) | \(g_1 \to 0\),\(g_5 = 1\) | 1 | 8 |
5 个键落到 5 个不同的顶点,得到 PHF;再对”\(g \ne 3\) 的顶点”做 rank,顶点
4、5、6、7、8 依次映射为 0 到 4,就得到
MPHF。对应代码(reproduce/graphs.c):
static void bdz_assign(const graph_t *g, uint8_t *lab)
{
    memset(lab, 3, g->m);
    for (uint32_t i = g->n; i-- > 0;) {
        uint32_t e = g->order[i];
        int j = g->free_pos[i];
        const uint32_t *ev = &g->v[(size_t)e * 3];
        int sum = 0;
        for (int k = 0; k < 3; k++)
            if (k != j)
                sum += lab[ev[k]] % 3;
        lab[ev[j]] = (uint8_t)(((j - sum) % 3 + 3) % 3);
    }
}

static uint32_t bdz_phf(const graph_t *g, const uint8_t *lab, uint32_t e)
{
    const uint32_t *ev = &g->v[(size_t)e * 3];
    int i = (lab[ev[0]] + lab[ev[1]] + lab[ev[2]]) % 3;
    return ev[i];
}
1.23 从哪里来
3 部超图可剥离的阈值约为 \(n/m
= 0.8185\),即 \(c = m/n
\approx 1.222\);MWHC 1996 年推测了这个阈值,约十年后
Molloy(Random Structures & Algorithms
27(1),2005)证明了随机超图 2-core
出现的阈值,与推测值吻合(据上述综述)。graphs.c
的 E2 扫描 \(c\) 从 1.15 到
1.31:
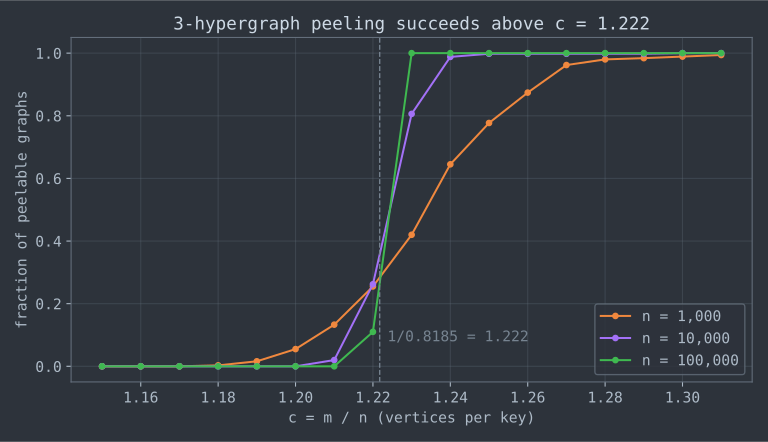
- \(n = 10^5\)(每点 200 次):\(c = 1.22\) 时成功率 0.110,\(c = 1.23\) 时已是 1.000。
- \(n = 10^3\)(每点 1000 次):过渡区很宽,从 \(c = 1.19\) 的 0.016 到 \(c = 1.27\) 的 0.962;而且 \(c = 1.31\) 时仍有 0.6% 失败。失败来自重边:两个键落到同一个三元组,概率约 \(n^2 / (2(m/3)^3) \approx 0.006\),与实测吻合。小集合用 BDZ 要么把 \(c\) 放大,要么准备好多次重试。
E3 用 \(n = 10^6\)、\(c = 1.23\) 构造 5 次,每次都是第一次尝试就可剥离,PHF 与 rank 后的 MPHF 都通过了双射校验。标签部分 \(2 \times 1.23 = 2.46\) bits/key;BDZ 论文 Table 3 报告加上 rank 结构的 MPHF 为 2.62 bits/key,把 3 值标签按 \(\log_2 3\) 打包的 PHF(\(m = 1.23n\))为 1.95 bits/key。
五、hash-and-displace:从 Pagh 到 CHD 与 PTHash
谱系
“先分桶、再给每个桶找一个位移”这条线同样可以追溯到 Tarjan–Yao 1979。Pagh(WADS 1999,“Hash and Displace”)用 \(h(x) = (f(x) + d_{g(x)}) \bmod n\),桶按大小从大到小处理,查询只需两次访存;按 CHD 论文的总结,Pagh 的分析要求桶数大于 \(n\),空间约 \((2+\epsilon)\log_2 n\) bits/key。Fox、Chen、Heath(SIGIR 1992)的 FCH 更早用了”倾斜”的分桶:60% 的键进 30% 的桶,让先处理的大桶更容易放。
Belazzougui、Botelho、Dietzfelbinger 的 CHD(ESA 2009,“Hash, Displace, and Compress”)做了两个改动:
- 桶 \(B_i\) 里的键放到 \((f_1(x) + d_0 f_2(x) + d_1) \bmod m\),按 \((0,0), (0,1), \ldots, (0,m-1), (1,0), \ldots\) 的固定顺序尝试位移对,只存第一个成功的对在序列中的下标;
- 从小序号开始试,序号序列的熵就低,再用 simple dense coding 压缩,同时保留 \(O(1)\) 随机访问。
它的摘要给出:\(m = 1.23n\) 时 1.4 bits/key,\(m = 1.01n\) 时 1.98 bits/key;MPHF 则是在 PHF 之上加一个支持 rank/select 的简洁结构,论文图 1(d) 中 \(\lambda = 5\) 时为 2.07 bits/key,同图中的 BPZ 为 2.61。\(\lambda\) 是平均桶大小,桶数 \(r = \lceil n/\lambda \rceil\)。
Pibiri 和 Trani 的 PTHash(SIGIR 2021)回到 FCH 的倾斜分桶,把位移改成 XOR:\(\big(h(x, s) \oplus h(v_i, s)\big) \bmod m\),并允许为 pilot 数组换用不同的编码(固定宽度、字典、Elias–Fano 等)。\(\alpha < 1\) 时,落在 \([n, m)\) 的位置经一个用 Elias–Fano 存的 \(m - n\) 项表重映射回 \([0, n)\)。论文摘要称查询比同等空间的方案快 2 到 4 倍。
构造循环用下图表示(CHD 与 PTHash 共用这个骨架,区别在分桶函数、位移形式和编码):
flowchart TD
    A["hash every key: bucket g(x), fingerprint h(x)"] --> B["sort buckets by size, largest first"]
    B --> C["take next bucket B_i"]
    C --> D["pilot l = 0"]
    D --> E["p(x) = slot(h(x), l) for all x in B_i"]
    E --> F{"all slots free and distinct?"}
    F -- no --> G["l = l + 1"]
    G --> E
    F -- yes --> H["pilot[i] = l, mark slots taken"]
    H --> I{"buckets left?"}
    I -- yes --> C
    I -- no --> J["encode pilot[]; if m > n build remap for slots >= n"]
大桶先放,因为此时表还空;轮到小桶时表已接近满,单个键找空位要试 \(1/(1-\text{load})\) 次左右,但小桶的”所有键同时有空位”概率下降得慢。平均桶越大,pilot 越少、每个 pilot 的熵越低,但构造越费力;综述 Table 5 把这类方法的构造时间写成 \(O(n e^{\lambda}/\lambda)\)。
实测:\(\lambda\) 与 \(\alpha\) 的代价
reproduce/hd.c 实现了这个骨架:CHD
式均匀分桶,pilot 从 0 起递增,槽位用 PTHash 式的 XOR
位移。输出三种空间估计:pilot 序列的零阶经验熵 \(H_0\)(理想熵编码的估计,不含模型本身)、Elias-gamma
前缀码长度(具体可算、但不支持随机访问),以及 \(\alpha < 1\) 时重映射表的
Elias–Fano 大小。\(n =
10^6\),3 个种子取中位数,每次都校验了双射:
| \(\alpha\) | \(\lambda\) | 尝试次数/键 | \(H_0\) bits/key | gamma bits/key | 重映射 EF bits/key | 最大 pilot |
|---|---|---|---|---|---|---|
| 1.00 | 1 | 13.87 | 2.955 | 3.014 | 0 | 926,817 |
| 1.00 | 2 | 15.81 | 2.380 | 2.604 | 0 | 637,280 |
| 1.00 | 3 | 23.66 | 2.136 | 2.560 | 0 | 2,617,115 |
| 1.00 | 4 | 56.81 | 2.016 | 2.585 | 0 | 1,584,112 |
| 1.00 | 5 | 214.64 | 1.939 | 2.623 | 0 | 1,999,561 |
| 0.99 | 1 | 4.47 | 2.835 | 2.897 | 0.091 | 710 |
| 0.99 | 2 | 5.78 | 2.271 | 2.484 | 0.091 | 690 |
| 0.99 | 3 | 11.86 | 2.041 | 2.433 | 0.091 | 2,479 |
| 0.99 | 4 | 33.77 | 1.932 | 2.456 | 0.091 | 9,871 |
| 0.99 | 5 | 119.96 | 1.861 | 2.492 | 0.091 | 55,464 |
几个结论:
- \(\lambda\) 从 4 到 5,构造工作量翻了近 4 倍(\(\alpha = 1\) 时每键 56.8 次到 214.6 次),而 \(H_0\) 只降了 0.08 bit。这是这一族方法的基本权衡。
- \(\alpha = 1\) 的代价集中在最后几个桶:只剩几个空槽时,单键桶要试上百万次(最大 pilot 约 \(10^6\) 量级,与 \(n\) 同阶)。\(\alpha = 0.99\) 只多留 1% 的空槽,\(\lambda = 5\) 的尝试次数降到 120 次/键,最大 pilot 降为原来的 1/36,重映射只多花 0.091 bit/key。这就是 CHD(用 rank/select)和 PTHash(用重映射表)都先造 \(\alpha < 1\) 的 PHF、再转成 MPHF 的原因。
- 编码决定落地空间。同样的 pilot 序列,gamma 码在 \(\lambda = 5\) 时反而比 \(\lambda = 3\) 更大,因为少数巨大的 pilot 各要 \(2\log_2 v\) bit。可与 CHD 论文对照的是 \(\alpha = 0.99\)、\(\lambda = 5\) 一行:本实验 \(H_0\) 为 1.861,论文用 SDC 实际编码的 PHF 为 1.98 bits/key,差距就是可随机访问编码的开销;\(H_0\) 加重映射为 1.952 bits/key,同样只是理想编码下的估计。\(H_0\) 本身在样本少时偏低:同一配置 \(n = 10^5\) 时是 1.880,\(n = 10^6\) 时是 1.939。
实现时遇到一个坑:若槽位直接取 \(h(x) \oplus H(\ell)\)
的高位(multiply-shift
规约),同桶两个键的哈希值高位相同时,XOR 同一个 \(H(\ell)\)
不改变这个事实,于是对所有 \(\ell\)
都冲突,构造永远停不下来。\(n =
5000\)、\(\lambda =
4\) 时就触发了。hd.c 在 XOR
之后再做一次混合,PTHash 论文用的则是对 \(m\) 取模。
六、BBHash、RecSplit 与近年的空间竞赛
BBHash:分层指纹
Limasset、Rizk、Chikhi、Peterlongo 的 BBHash(SEA 2017)思路最简单:第 \(i\) 层把剩下的 \(n_i\) 个键哈希进 \(\gamma n_i\) 个 bit,独占一个位置的键就在这一层定下来,其余进下一层。查询时找到第一个”自己那一位为 1”的层,再对所有层拼起来的位图做 rank。
每个位置接收的键数近似 Poisson\((1/\gamma)\),一个键独占位置的概率是 \(e^{-1/\gamma}\),于是 \(n_{i+1} = n_i (1 - e^{-1/\gamma})\),总 bit 数
\[ \gamma n \sum_{i \ge 0} \big(1 - e^{-1/\gamma}\big)^i = \gamma e^{1/\gamma} n. \]
reproduce/bbhash_sim.c(\(n = 10^6\),3
个种子中位数,不含 rank 结构):
| \(\gamma\) | 层数 | 实测 bits/key | \(\gamma e^{1/\gamma}\) | 第 0 层安放比例 |
|---|---|---|---|---|
| 1.0 | 30 | 2.718 | 2.718 | 36.81% |
| 1.5 | 19 | 2.920 | 2.922 | 51.30% |
| 2.0 | 15 | 3.297 | 3.297 | 60.71% |
| 5.0 | 8 | 6.104 | 6.107 | 81.90% |
\(\gamma = 1\) 空间最省,但层数最多,更多的键要到深层才能定位;\(\gamma\) 增大时第 0 层就能安放更多键,代价是每键 bit 数上升。BBHash 论文摘要报告:\(10^{10}\) 个键、8 线程、不到 7 分钟、5 GB 内存,结果 3.7 bits/key。
RecSplit 与之后
Esposito、Graf、Vigna 的 RecSplit(ALENEX 2020)把键先分成大桶,桶内递归地找”把集合按固定比例劈开”的种子,直到叶子只有 \(\ell\) 个键,再对叶子暴力搜一个双射种子。摘要写明:构造是期望线性时间,查询期望常数时间,可做到 1.56 bits/key(距下界 8.3%),代价是每键构造时间不到 2 ms。换句话说,RecSplit 以极高的构造常数换空间,而不是渐进复杂度更差。
之后的工作继续压空间:ShockHash(Lehmann、Sanders、Walzer,ALENEX 2024)把叶子的暴力搜索换成”找一个让叶子里的键能放进两选 cuckoo 表的种子,再用每键 1 bit 的 retrieval 结构记下选了哪个位置”,需要尝试的种子数从 \(e^\ell\) 量级降到约 \((e/2)^\ell\);Consensus-RecSplit(Lehmann 等,arXiv:2502.05613,预印本)在综述的测量中达到 1.444 bits/key。
同口径数据
不同论文的 bits/key
用的数据集、编码和硬件都不同,直接放进一张表会误导。Lehmann、Mueller、Pagh、Pibiri、Sanders、Vigna、Walzer
的综述 “Modern Minimal Perfect Hashing: A
Survey”(arXiv:2506.06536
v3,预印本,未经同行评审)在同一台机器上测了主要实现。以下摘自其
Table 6:\(n = 10^8\)
个长度 10 到 50 的随机字符串,单线程,Intel i7-11700 锁定
2.5 GHz,GCC 14.2
-O3 -march=native,实现版本截至
2025-10-12(引用数据,未在本站复现):
| 方法与配置 | bits/key | 构造 ns/key | 查询 ns |
|---|---|---|---|
| FCH,\(c = 7\) | 7.000 | 1,100 | 97 |
| CHD,\(\lambda = 6\) | 2.007 | 18,336 | 346 |
| PTHash,\(\lambda = 6\),\(\alpha = 0.95\),EF | 2.150 | 1,125 | 119 |
| PtrHash,\(\lambda = 3\) | 2.990 | 141 | 45 |
| PHast,\(S = 7\),\(\lambda = 3.7\) | 1.998 | 750 | 43 |
| BBHash,\(\gamma = 1.5\) | 3.293 | 273 | 173 |
| RecSplit,\(\ell = 8\),\(b = 100\) | 1.793 | 1,629 | 212 |
| RecSplit,\(\ell = 14\),\(b = 2000\) | 1.584 | 290,374 | 252 |
| ShockHash-RS,\(\ell = 40\),\(b = 2000\) | 1.551 | 4,128 | 320 |
| Consensus,\(k = 32768\),\(\varepsilon = 0.0005\) | 1.444 | 71,301 | 445 |
同一行里空间、构造、查询三个量此消彼长:最接近下界的 Consensus 查询最慢、构造也很贵;查询最快的 PHast、PtrHash 空间在 2 到 3 bits/key;CHD 在这台机器上构造和查询都不占优。BBHash 的 3.293 比上表模拟的 2.920 多出的部分,是 rank 结构和实现开销。
七、gperf:给几十个字符串造一个函数
真实算法(gperf 3.3)
GNU gperf 由 Douglas C. Schmidt 编写(论文 “GPERF: A
Perfect Hash Function Generator”,Second USENIX C++
Conference,1990),其思路受 Keith Bostic 约 1984 年发到
net.sources 的程序启发,Bruno Haible
后来增强并优化了搜索算法(手册 Contributors
一节)。它解决的是另一个尺度的问题:几十到上千个关键字,生成一段可直接编译的
C/C++ 代码。它的哈希函数形态与 Cichelli(CACM 1980,“Minimal
Perfect Hash Functions Made Simple”,gperf 手册参考文献
[3])的”长度加若干字符的关联值”同源。gperf 3.3 源码
src/search.cc 开头的注释给出了一般形式:
\[ \text{hash}(w) = \text{len}(w) + \sum_{i \in \text{Pos}} \text{asso\_values}\big[w[i] + \text{alpha\_inc}[i]\big] \]
长度项默认计入,可用 -n
关闭。搜索分三步,每一步都要求一个在关键字集合上单射的投影:前两步保证选出的字符多重集互不相同,第三步再给字符赋值:
flowchart TD
    K["keyword set"] --> P["step 1: pick byte positions Pos so that the tuples differ"]
    P --> A["step 2: pick alpha_inc so that the multisets differ"]
    A --> S["step 3: order the characters into steps, each step refines the partition"]
    S --> V["choose asso_values for this step's characters"]
    V --> T{"keywords in each equivalence class have distinct partial sums?"}
    T -- no --> N["next value: + jump; if range exhausted, double asso_value_max"]
    N --> T
    T -- yes --> M{"more steps?"}
    M -- yes --> V
M -- no --> O["emit hash(), wordlist[], lookup()"]第三步是关键。find_asso_values()
的注释写明,思路是”每次确定一个或几个字符的关联值,使已做的选择以后永远不需要撤销”:把”剩余未定字符的多重集相同”的关键字归为一个等价类,同一类里的关键字将来会加上完全相同的值,所以只要它们当前的部分和互不相同,最终哈希值就互不相同。每一步按
initial + iter * jump 枚举候选值(默认
jump 为 5,须为奇数),取值范围是 2
的幂;枚举完还找不到,就把范围 asso_value_max
加倍,而不是回溯。常见的”gperf 基于图着色”一说,与 3.3
的源码不符。
实跑一次
reproduce/keywords.gperf 定义了 16 个 C
关键字,run_gperf.sh 下载 gperf 3.3(校验
SHA-256)、生成 keywords.h,再用
test_keywords.c 检查 16 个关键字全部命中、24
个近似词(iff、While、brake、do
等)全部被拒:
GNU gperf 3.3
16 keywords found, 24 non-keywords rejected, 0 errors
生成的哈希函数如下(gperf 3.3 输出,删去了 256 项
asso_values 表的数值和 fallthrough
属性的宏判断):
#define TOTAL_KEYWORDS 16
#define MIN_WORD_LENGTH 2
#define MAX_WORD_LENGTH 8
#define MIN_HASH_VALUE 2
#define MAX_HASH_VALUE 21
/* maximum key range = 20, duplicates = 0 */

static unsigned int
keyword_hash (register const char *str, register size_t len)
{
  static const unsigned char asso_values[] = { /* 256 entries */ };
  register unsigned int hval = len;

  switch (hval)
    {
      default:
        hval += asso_values[(unsigned char)str[2]];
      /*FALLTHROUGH*/
      case 2:
        hval += asso_values[(unsigned char)str[1]];
        break;
    }
  return hval;
}
要点:
- gperf 自动选中了第 2、3 个字符(
-d调试输出里是 “Computed positions: 2, 3”),没有用首字符。长度为 2 的词只加第 2 个字符。 - 用到的字母关联值只有 0、5、10、15,正是
jump = 5的倍数;没出现的字符值为 22,即MAX_HASH_VALUE + 1,保证它们的和落在表外。调试输出显示第三步分了 11 步,每步 1 到 4 次尝试。 - 哈希值范围是 2 到 21,20 个位置放 16 个词,不是最小的。gperf 手册 “Static search structures and GNU gperf” 一章直言:非最小的 PHF 在实践中常常更快,因为稀疏表更容易直接碰到空项,省掉字符串比较。
- 查找函数先查长度范围,再查
key <= MAX_HASH_VALUE;因为输入里写了%compare-lengths,还会比对lengthtable[key],最后比首字符和memcmp。完美哈希只保证”至多一次探测”,成员判定仍然靠这次比较。
手册的 “Known Bugs and Limitations” 一章说明了适用规模:约 1000 个关键字的中小集合很快,3.0 起也能处理超过 15,000 个关键字,但生成的表和目标代码可能很大。百万级键集合应该换用第五、六节的方法。
谁在用,谁没用
gperf 手册 Introduction 至今写着它为 GNU C、GNU C++ 等编译器生成关键字识别器,这是 1990 年前后的描述。GCC 15.1 的现状:
/* GCC 15.1, gcc/c/c-parser.cc, c_parse_init(),有删减 */
  for (i = 0; i < num_c_common_reswords; i++)
    {
      /* If a keyword is disabled, do not enter it into the table
     and so create a canonical spelling that isn't a keyword.  */
      if (c_common_reswords[i].disable & mask)
    continue;

      id = get_identifier (c_common_reswords[i].word);
      C_SET_RID_CODE (id, c_common_reswords[i].rid);
      C_IS_RESERVED_WORD (id) = 1;
      ridpointers [(int) c_common_reswords[i].rid] = id;
    }
关键字表 c_common_reswords[] 在
gcc/c-family/c-common.cc,启动时把每个关键字插入普通的标识符表,并在标识符节点上打标记。词法分析器本来就要把每个标识符插入
libcpp 的哈希表(libcpp/symtab.cc 的
ht_lookup_with_hash(),开放寻址加双重哈希),查到节点时顺带读出关键字标记,不需要单独的完美哈希。GCC
仍在用 gperf 的地方是 C++
前端:gcc/cp/Make-lang.in
里有两条维护者规则,从 cfns.gperf(标准 C
库函数名,供 nothrow_libfn_p 判断)和
std-name-hint.gperf(std::
名字到头文件的提示)生成头文件。
其他可核对的例子:
- Go:go1.24.0 的
src/cmd/compile/internal/syntax/scanner.go手写了一个完美哈希,hash(s) = (uint(s[0])<<4 ^ uint(s[1]) + uint(len(s))) & 63,表keywordMap有 64 项,init()里若发现冲突就panic("imperfect hash");查到后还要比较字符串。而标准库go/token的Lookup()用的是普通map。 - systemd:v257 的
src/basic/meson.build用 gperf 为地址族、ARPHRD_*、capability、errno 名字生成*-from-name.h;unit 文件的配置项解析表也由src/core/load-fragment-gperf.gperf.in生成。 - Rust
phfcrate:v0.13.1 的 README 说明它使用 CHD 算法,在编译期为静态 map 生成完美哈希。
八、争论与开放问题
争论一:空间还是查询速度
RecSplit 一线以空间为首要目标(摘要:1.56 bits/key,距下界 8.3%),ShockHash、Consensus 沿着这条线把空间压到 1.444。PTHash 论文则主张查询时间同样关键,它的摘要强调比同等空间的方案快 2 到 4 倍;综述 Table 6 里 PHast、PtrHash 的查询只有 43 到 45 ns,空间在 2 到 3 bits/key,而 1.444 bits/key 的 Consensus 查询是 445 ns。两边的数据都来自同一份测量,结论取决于应用:键数到 \(10^9\) 以上、MPHF 本身就有数百 MB 并且要常驻内存或随数据分发时,0.5 bit/key 是实打实的收益;查询在热路径上时,一次多出的缓存未命中可能更贵。综述在同一台机器上给出了 Pareto 前沿,但它是预印本,各实现也在持续更新,这张表只代表 2025 年 10 月的状态。
争论二:到底要不要”最小”和”不存键”
gperf 手册认为非最小的 PHF 往往更快。当应用本来就要存键(为了拒绝集合外的查询)时,函数本身 2 bit 与键的几十字节相比可以忽略,这时 FKS 式的”多留空槽、查询直达”或者普通的开放寻址表可能更划算。MPHF 的优势场景是键不必存、或者只存短指纹:把字符串映射成稠密 ID 再索引外部数组,例如 BBHash 论文面向的海量 k-mer 集合。
开放问题
- bucket placement 的空间刻画。综述的渐近性能一节指出,PHast 的空间随 \(\lambda\) 变化的规律仍是开放问题;本文第五节的实验也显示,pilot 的熵、编码方式和构造工作量之间的关系只能靠实验描述。
- 接近下界时构造成本能降到多少。ShockHash 把叶子搜索从 \(e^\ell\) 降到 \((e/2)^\ell\) 量级,但表中 1.5 bits/key 附近的配置构造仍要每键数微秒到数百微秒;在离下界只差百分之几时同时做到线性、低常数的构造,还没有公认的答案。入口是上述综述渐近性能一节的对比(Table 5)。
- 更高的剥离阈值尚未用上。综述提到,换一种超边分布可以把 3-uniform 超图的剥离阈值从 0.8185 提高到约 0.9179(Walzer 2021、2025),与可定向阈值相同;综述写明据其所知这还没有被用于 MPHF 构造。
九、工程选型
| 场景 | 常见选择 | 决定因素 |
|---|---|---|
| 几十到几千个编译期已知的字符串,需要成员判定 | gperf,或像 Go 那样手写小表 | 生成代码可读、无运行时依赖;不需要追求最小 |
| 已有全局标识符表(编译器、解释器) | 在表节点上打关键字标记 | 查找已经发生,不必再多一个结构(GCC) |
| 静态键值表,要最坏两次访存,愿意存键 | FKS 式两级表 | 约 \(2n\) 个槽加桶头;构造期望线性 |
| 大规模字符串到稠密 ID,查询在热路径 | PTHash、PtrHash、PHast 一类 | 查询一次左右的访存,2 到 3 bits/key |
| 大规模、空间最敏感、可离线构造 | RecSplit、ShockHash、Consensus 一类 | 1.5 bits/key 附近,构造和查询都更贵 |
| 构造要快、实现要短 | BBHash 一类分层指纹方法 | 3 bits/key 左右或以上;层数随 \(\gamma\) 变化 |
几个陷阱:
- MPHF 对集合外的键不会报错。需要成员判定时必须存键或指纹,并把这部分空间算进预算。
- 键集合一变就要重建。更新不频繁时可以离线重建后原子切换;频繁更新就用普通哈希表。
- 构造依赖哈希函数”足够随机”的假设。BDZ、CHD 的分析都假设完全随机的哈希函数;如果键的原始哈希有大量碰撞(例如取了一个 32 位哈希再扩展),构造可能反复失败。第五节的高位 XOR 问题就是一个具体的例子。
- 小集合上的概率性方法要预留重试:第四节中 \(n = 1000\) 的超图即使 \(c = 1.31\) 也有 0.6% 的失败率。
十、参考资料
规范与文档
- GNU gperf 3.3
手册(
doc/gperf.texi):Contributors、Introduction、Static search structures and GNU gperf、Known Bugs and Limitations with gperf、Bibliography 各章。
源码
- GNU gperf 3.3(
gperf-3.3.tar.gz,SHA-256fd87e0ab…9604ad8):src/search.cc文件头 Theory 注释、Search::find_positions()、Search::find_asso_values()、Search::prepare_asso_values();src/options.cc中DEFAULT_JUMP_VALUE。 - GCC
releases/gcc-15.1.0:
gcc/c-family/c-common.cc(c_common_reswords[])、gcc/c/c-parser.cc(c_parse_init())、libcpp/symtab.cc(ht_lookup_with_hash())、gcc/cp/Make-lang.in、gcc/cp/cfns.gperf、gcc/cp/std-name-hint.gperf。 - Go
go1.24.0:
src/cmd/compile/internal/syntax/scanner.go(hash()、keywordMap)、src/go/token/token.go(Lookup())。 - systemd
v257:
src/basic/meson.build、src/core/load-fragment-gperf.gperf.in。 - rust-phf v0.13.1:
README.md。
核心论文
- M. L. Fredman, J. Komlós, E. Szemerédi, “Storing a Sparse Table with \(O(1)\) Worst Case Access Time”, Journal of the ACM 31(3):538–544, 1984(FOCS 1982 预发)。
- K. Mehlhorn, “On the program size of perfect and universal hash functions”, FOCS 1982, 170–175.
- Z. J. Czech, G. Havas, B. S. Majewski, “An optimal algorithm for generating minimal perfect hash functions”, Information Processing Letters 43(5):257–264, 1992.
- F. C. Botelho, R. Pagh, N. Ziviani, “Simple and Space-Efficient Minimal Perfect Hash Functions”, WADS 2007, LNCS 4619:139–150.
- D. Belazzougui, F. C. Botelho, M. Dietzfelbinger, “Hash, Displace, and Compress”, ESA 2009, LNCS 5757:682–693.
- E. Esposito, T. Mueller Graf, S. Vigna, “RecSplit: Minimal Perfect Hashing via Recursive Splitting”, ALENEX 2020, 175–185.
- G. E. Pibiri, R. Trani, “PTHash: Revisiting FCH Minimal Perfect Hashing”, SIGIR 2021, 1339–1348.
- H.-P. Lehmann, T. Mueller, R. Pagh, G. E. Pibiri, P. Sanders, S. Vigna, S. Walzer, “Modern Minimal Perfect Hashing: A Survey”, arXiv:2506.06536 v3, 2025(预印本)。
其他论文
- R. E. Tarjan, A. C.-C. Yao, “Storing a sparse table”, CACM 22(11):606–611, 1979.
- J. L. Carter, M. N. Wegman, “Universal classes of hash functions”, JCSS 18(2):143–154, 1979.
- M. L. Fredman, J. Komlós, “On the Size of Separating Systems and Families of Perfect Hash Functions”, SIAM J. Algebraic Discrete Methods 5(1):61–68, 1984.
- R. J. Cichelli, “Minimal Perfect Hash Functions Made Simple”, CACM 23(1):17–19, 1980.
- E. A. Fox, Q. F. Chen, L. S. Heath, “A faster algorithm for constructing minimal perfect hash functions”, SIGIR 1992, 266–273.
- B. S. Majewski, N. C. Wormald, G. Havas, Z. J. Czech, “A Family of Perfect Hashing Methods”, The Computer Journal 39(6):547–554, 1996.
- Z. J. Czech, G. Havas, B. S. Majewski, “Perfect hashing”, Theoretical Computer Science 182(1–2):1–143, 1997(综述)。
- R. Pagh, “Hash and Displace: Efficient Evaluation of Minimal Perfect Hash Functions”, WADS 1999, LNCS 1663:49–54.
- M. Molloy, “Cores in random hypergraphs and Boolean formulas”, Random Structures & Algorithms 27(1):124–135, 2005.
- A. Limasset, G. Rizk, R. Chikhi, P. Peterlongo, “Fast and Scalable Minimal Perfect Hashing for Massive Key Sets”, SEA 2017(arXiv:1702.03154)。
- H.-P. Lehmann, P. Sanders, S. Walzer, “ShockHash: Towards Optimal-Space Minimal Perfect Hashing Beyond Brute-Force”, ALENEX 2024, 194–206.
- R. Groot Koerkamp, “PtrHash: Minimal Perfect Hashing at RAM Throughput”, SEA 2025, LIPIcs 338, 21:1–21:21.
- P. Beling, P. Sanders, “PHast – Perfect Hashing made fast”, arXiv:2504.17918, 2025(预印本)。
- H.-P. Lehmann 等, “Combined Search and Encoding for Seeds, with an Application to Minimal Perfect Hashing”, arXiv:2502.05613, 2025(预印本)。
- D. C. Schmidt, “GPERF: A Perfect Hash Function Generator”, Second USENIX C++ Conference, 1990.
实验
reproduce/fks.c:第二节的 FKS 实现与统计,--demo 3生成fks-two-level.svg的数据。reproduce/graphs.c:第四节的无环概率(E1)、剥离阈值(E2)与 BDZ 构造校验(E3),--demo对应bdz-peeling.svg;plot_peel.py画peel-threshold.svg。reproduce/hd.c:第五节的 hash-and-displace 实验。reproduce/bbhash_sim.c:第六节的 BBHash 层数与空间。reproduce/plot_space.py:第三节的下界数值与space-lower-bound.svg。reproduce/keywords.gperf、tokens.h、test_keywords.c、run_gperf.sh:第七节的 gperf 实验。reproduce/results/:上述程序的原始输出。
系列导航: - 上一篇:SwissTable:SIMD 加速的开放寻址哈希表 - 下一篇:一致性哈希:哈希环、Jump Hash 与 Maglev
相关阅读: - 哈希表内部:冲突处理与负载因子 - Cuckoo Hashing:两个候选位置与踢出路径 - Bloom Filter 家族 - 哈希函数设计:密码学与非密码学哈希
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
基数排序:绕开比较下界的代价,从 LSD、American flag sort 到 ska_sort
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。
外部排序:从 I/O 下界到 PostgreSQL 与 GNU sort
从 Aggarwal–Vitter 的 I/O 下界出发,用可复现实验比较替换选择与快排生成 run、败者树与堆的比较次数、多阶段与平衡归并的搬运量,再对照 PostgreSQL 18 与 GNU sort 9.11 源码说明今天为何多用快排、平衡归并和堆。