谈 SIMD
字符串处理,常听到四种说法:“向量化能让字符串处理快 10
倍”“多读几个字节没关系,glibc 也这么干”“SSE4.2
有专用的字符串指令,glibc 的 strstr
就用它”“simdjson
快是因为用了无进位乘法”。这四句都不准确。加速比取决于数据在哪一级存储:本文实测
AVX2 版 memchr 在 L1 内比逐字节循环快约 39
倍,数据在内存里时只快约 5.7 倍。越界读确实是 glibc
的做法,但它依赖对齐加载不跨页这一条件;照着写一个非对齐版本,字符串贴着不可读页结尾时,201
个长度里有 195 个会段错误。glibc 早在 2013 年就把基于
PCMPISTRI 的 strstr 换掉了,提交说明称这条指令
“quite ineffective”。simdjson
论文自己的消融实验显示,把无进位乘法换成 6 次移位异或后,13
个测试文件里只有 4 个的第一阶段变慢达到 0.05
周期/字节,而换掉下标提取的影响在 11
个文件上达到这个量级。
本文只讨论字节扫描,也就是在一段内存里找出某些字节的位置,以及这些位置的含义依赖上下文(引号、转义)时怎么处理。按四个问题展开:比较加
movemask 的基本范式、越界读的边界条件、PCMPxSTRx
该不该用、带引号和转义的扫描怎么用位运算完成。以下话题不重复展开:strchr/strstr
的首尾字节过滤与跨块进位见 SIMD 加速字符串查找(strchr /
strstr)系统指南;pshufb
查表分类、Base64、前缀和与流压缩见 SIMD
算法设计模式;多模式匹配的 Teddy 与 FDR 见 AC
自动机:失败链接、输出链接与转移表布局 第八节;UTF-8
的向量化验证见下一篇 Unicode
文本算法:UTF-8
编解码与验证、规范化、字素簇与双向文本安全。
实验代码在同目录
reproduce/,环境与口径见第三节。
一、基本范式:比较、movemask、tzcnt
逐字节查找的标量循环每个字节做一次比较和一次分支。向量版把
16 或 32
个字节装进一个寄存器,一条比较指令得到逐字节的结果,再用
movemask 把结果压成一个整数,最后用”数尾随零”(trailing zero
count,tzcnt)得到第一个命中位置:
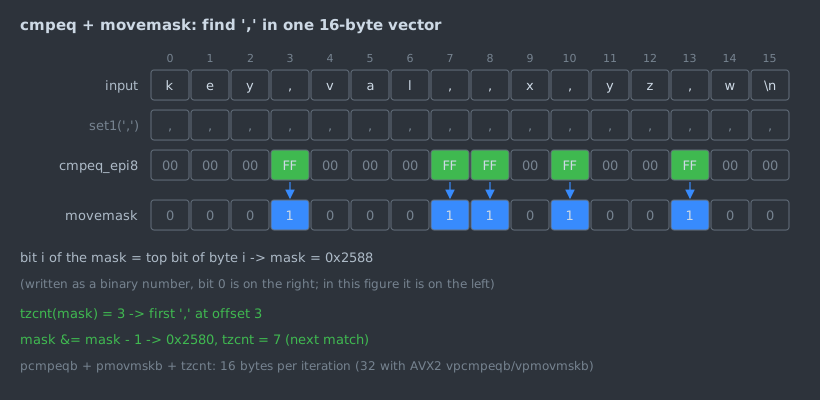
_mm_set1_epi8(',')把目标字节广播到 16 个通道。_mm_cmpeq_epi8(pcmpeqb)逐字节比较,相等的通道置0xFF,否则置0x00。_mm_movemask_epi8(pmovmskb)取每个字节的最高位,第 \(i\) 个字节对应掩码的第 \(i\) 位。图里第 0 位画在最左边,写成二进制数时它在最右边,这是读这类掩码最容易搞反的地方。tzcnt给出最低的置位,也就是第一个命中;mask &= mask - 1清掉最低位,就能继续取下一个命中,这是第五节提取所有下标时的基本循环。
对应的 SSE2 代码(reproduce/simd.c 中的
memchr_sse2):
const char *memchr_sse2(const char *s, int c, size_t n)
{
    const __m128i t = _mm_set1_epi8((char)c);
    size_t i = 0;
    for (; i + 16 <= n; i += 16) {
        __m128i v = _mm_loadu_si128((const __m128i *)(s + i));
        unsigned m = (unsigned)_mm_movemask_epi8(_mm_cmpeq_epi8(v, t));
        if (m)
            return s + i + __builtin_ctz(m);
    }
    for (; i < n; i++)
        if ((unsigned char)s[i] == (unsigned char)c)
            return s + i;
    return NULL;
}
尾部循环里的 (unsigned char) 不是装饰。C
标准规定 memchr 把 c 转成
unsigned char 再比较;如果写成
s[i] == c,在 char
有符号的平台上,查找 0xFF
这类高位字节会失败。向量路径用 (char)c
广播后按位比较,不受符号影响,所以这类错误只会出现在标量尾部,短输入才暴露。对拍程序让
c 在 0 到 255
之间随机取值,就是为了覆盖它。
这几条指令很便宜。按 uops.info 对 Alder Lake-P(即本机
i9-12900K 的性能核)的测量,256 位 vpcmpeqb
延迟 1 周期、每周期可发射两条;vpmovmskb
延迟不超过 4 周期、每周期一条,只能走 0 号端口。每 32
字节只需要一条
movemask,所以单字节查找的计算开销很低,真正的上限来自加载带宽和缓存层级(第三节)。
AVX2 版本的主循环照 glibc 的写法一次处理 4 个向量:4
次比较结果先用 vpor 合并,只做一次 movemask
和一次分支;命中后才回头逐个检查是哪一个向量。glibc 2.42 的
sysdeps/x86_64/multiarch/memchr-avx2.S 中
L(loop_4x_vec)
就是这个结构,strlen-avx2.S 更进一步,用
vpminub 把 4
个向量取最小值后只比较一次:一组字节里有
0,当且仅当它们的最小值是 0。
二、越界读:glibc 为什么敢多读,照抄为什么会崩
问题出在哪一次加载
向量加载一次读 16 或 32
字节,而字符串的结尾不一定对齐到向量宽度。memchr
有长度参数,只要不读 \([s,
s+n)\) 之外就行;strlen
不知道长度,只有读到 NUL
才知道该停,最后一次加载几乎总会越过结尾。越界读本身不一定出错,出错的条件是越过的部分落在一个不可读的页上。内存保护的粒度是页(x86-64
上通常 4096
字节),所以只要加载不跨页,读到的字节就和字符串在同一页,而这一页是可读的。
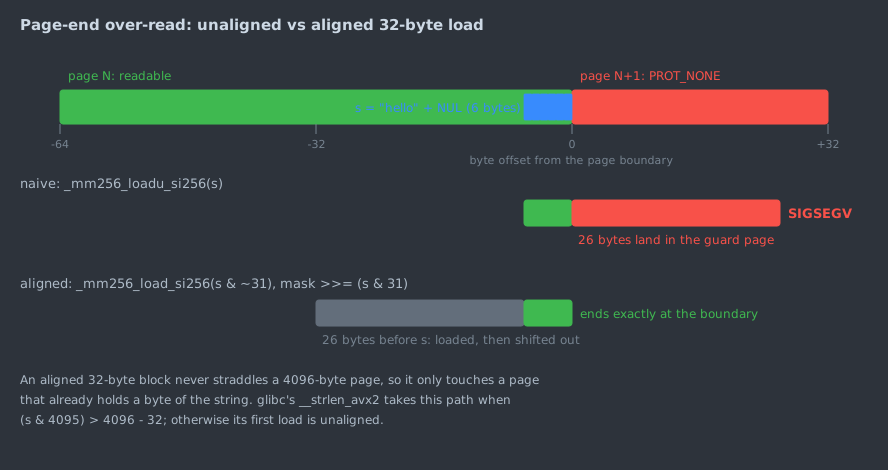
图中的字符串占可读页的最后 6 个字节(含 NUL)。朴素写法从
s 开始做 32 字节非对齐加载,其中 26
字节落进下一页,触发段错误。对齐写法把地址向下对齐到 32
字节边界:4096 是 32 的倍数,所以一个对齐的 32
字节块不可能跨页;它多读的是 s 之前的 26
个字节,这些字节在同一页上,读到后把掩码右移
s & 31 位丢掉即可。之后每次前进 32
字节,只有在前面没找到 NUL
时才读下一块,也就是说每一块里至少有一个字节属于字符串,它所在的页必然可读。
glibc 2.42 的写法
strlen 的 AVX2
实现先判断第一次非对齐加载会不会跨页,只有会跨页时才走对齐路径。以下摘自
glibc 2.42
sysdeps/x86_64/multiarch/strlen-avx2.S 的
__strlen_avx2,删去了
strnlen/wcslen
的条件编译分支:
    movl    %edi, %eax
    movq    %rdi, %rdx
    vpxor   %xmm0, %xmm0, %xmm0
    andl    $(PAGE_SIZE - 1), %eax
    /* Check if we may cross page boundary with one vector load.  */
    cmpl    $(PAGE_SIZE - VEC_SIZE), %eax
    ja  L(cross_page_boundary)
    ...
L(cross_page_boundary):
    /* Align data to VEC_SIZE - 1.  */
    orq $(VEC_SIZE - 1), %rdi
    VPCMPEQ -(VEC_SIZE - 1)(%rdi), %ymm0, %ymm1
    vpmovmskb %ymm1, %eax
    /* Remove the leading bytes. sarxl only uses bits [5:0] of COUNT
       so no need to manually mod rdx.  */
    sarxl   %edx, %eax, %eax
VEC_SIZE 是 32,PAGE_SIZE 是
4096。(s & 4095) > 4096 - 32 时,从
s 开始的 32 字节会跨页,于是改用
(s | 31) - 31 这个对齐地址加载,再用
sarx 按 s
的低位右移掉前导字节,与图中的对齐写法一致。memchr-avx2.S
入口有同样的三条指令;它在 \(n \le
32\) 时也照样整向量比较,然后用 tzcnt
的结果与 \(n\)
比较,超出长度的命中当作没找到。本机运行的是 glibc
2.43,这两个文件从 2.42 到 2.43 只改了版权年份。
memchr 敢在 \(n\)
很大、目标很早出现时这样读,还有一层标准依据。C11(N1570)7.24.5.1
规定 memchr “shall behave as if it reads the
characters sequentially and stops as soon as a matching
character is found”,所以调用者可以传一个大于对象实际长度的
\(n\),只要目标字节在对象内。一个从
s 开始按 32
字节非对齐步进、只在最后一块做长度检查的实现,在这种调用下同样可能读进不可访问页;glibc
的对齐主循环不会。本文 reproduce/ 里的
memchr_avx2 只保证不读 \([s, s+n)\)
之外,没有满足这条语义,不能直接替换 libc 的
memchr。
实测:朴素版本几乎总会崩
reproduce/test_scan.c 用 mmap
申请两页,把第二页 mprotect 成
PROT_NONE,再把长度为 0 到 200
的字符串放在第一页末尾,使 NUL
恰好是可读页的最后一个字节。朴素
strlen_avx2_naive(每次从 s + 32k
做非对齐加载)在子进程里运行:
page-end: 201 lengths (0..200), string ends at a PROT_NONE page
  strlen_avx2_naive: SIGSEGV for 195 lengths; first length without fault: 31
只有 6 个长度不崩:31、63、95、127、159、191,也就是
len + 1 恰好是 32
的倍数、最后一次加载正好止于页尾的情况。“越界读只影响短字符串”的直觉是错的:只要字符串贴着页尾,任何长度都会出事。对齐版
strlen_avx2_aligned、以及本文所有带长度参数的扫描函数,在同一组页尾测试里全部通过。
三种不越界的写法
- 只在界内加载,尾部重叠。
有长度参数时,主循环只做完整的界内加载;剩下不足 32
字节时,把最后一次加载的起点退回到 \(s + n -
32\),与已检查过的字节重叠,再把掩码右移掉重叠部分。只有
\(n < 32\)
时才退回逐字节。
memchr_avx2的尾部就是这样写的:
    if (n >= 32) {
        /* overlapping load of s[n-32, n); drop the bytes already checked */
        uint32_t m = eq_mask32(_mm256_loadu_si256((const __m256i *)(s + n - 32)), t);
        m >>= i - (n - 32);
        return m ? s + i + __builtin_ctz(m) : NULL;
    }
对齐加载,允许在页内多读。 这是 glibc 的办法,也是无长度的
strlen唯一的向量化办法。代价在下一小节。把尾块复制到填充缓冲区,或者要求调用者留出填充。 simdjson 两者都用:第一阶段的
buf_block_reader::get_remainder()(simdjson 4.0.7src/generic/stage1/buf_block_reader.h)把最后不足 64 字节的部分memcpy到一个先用空格0x20填满的块里;include/simdjson/base.h定义SIMDJSON_PADDING = 64,注释要求输入缓冲区可读到buf + SIMDJSON_PADDING,并自称 “this is a stopgap”。本文的 CSV 和 JSON 扫描器用复制法,尾块用 0 填充,因为 NUL 在这两种格式里都不是特殊字符。
对齐多读的代价:C 语义与 AddressSanitizer
页粒度保护是硬件和操作系统层面的事实,C 语言不承认它。在 C 的抽象机里,读对象之外的字节就是未定义行为,不管那个字节在不在同一页。glibc 用汇编写这些函数,绕开了编译器对 C 语义的推理;用 intrinsics 在 C 里写同样的逻辑,实际能工作,但编译器和检查工具都有理由把它当成错误。
AddressSanitizer
就是这样看的。reproduce/asan_demo.c 对一个
malloc(6) 得到的 "hello"
调用对齐版 strlen,用
-fsanitize=address
编译并去掉豁免属性后,输出如下(地址和进程号已替换):
==PID==ERROR: AddressSanitizer: heap-buffer-overflow on address ADDR
READ of size 32 at ADDR thread T0
ADDR is located 16 bytes before 6-byte region [ADDR,ADDR)
这次分配得到的地址只按 16 字节对齐,于是对齐加载从对象前
16 字节开始,读到了 ASan
在堆块左侧布置的红区(redzone)。ASan 拦截了 libc 的
strlen、memchr,按函数语义检查访问范围(对一个没有
NUL 结尾的 6 字节堆块调用
strlen,报告的越界地址正好是第 7 个字节),不管
libc 内部实际多读了什么,所以调用 libc
不会报错;自己写的多读代码需要加
__attribute__((no_sanitize_address))
豁免,reproduce/simd.c
就是这样做的。豁免的代价是这个函数里真正的越界读也不再被检查,所以本文另外用守护页测试覆盖它。整套对拍在
-fsanitize=address,undefined 下也全部通过。
三、吞吐:加速比取决于数据在哪一级存储
实验环境与口径
- CPU:Intel Core i9-12900K(Alder Lake,支持
AVX2、SSE4.2、PCLMULQDQ;
lscpu的标志里没有 AVX-512),WSL2 内核 6.6.87.2,GCC 16.1.1,glibc 2.43。 - 运行:
cd reproduce && ./run.sh 11。脚本在临时目录里编译、运行普通版和 ASan+UBSan 版对拍、ASan 演示和基准,输出存为results/run.txt。本节所有数字取自该文件。 - 编译:SIMD 代码用
-O2 -mavx2 -mpclmul -msse4.2;标量参考实现用-O2 -fno-tree-vectorize -fno-tree-loop-distribute-patterns,原因见下文;“自动向量化”一行是同一份标量源码用-O3 -mavx2另编一份。 - 计时:
taskset -c 11绑定逻辑 CPU 11,每个配置先预热一次,再跑 11 轮取中位数,每轮处理 64 MiB。机器上同时有其他任务在运行,只看相对趋势。共做了 6 次完整运行:受内存带宽限制的 64 MiB 一列波动最大,最多约 15%;glibcstrlen16 KiB 一格有一次只有 150 GB/s,其余 5 次在 207 到 212 之间;其余各格与本文表格相差在 8% 以内。 - 输入:
memchr与”4 字节任意匹配”的缓冲区全是'a',目标字节不存在,测的是完整扫描。CSV 和 JSON 用程序生成(第五节),16 KiB 与 1 MiB 两列扫描同一份 16 MiB 数据的前缀。
memchr 与 strlen
| 实现(GB/s) | 16 KiB | 1 MiB | 64 MiB |
|---|---|---|---|
标量,-O2 |
4.80 | 4.82 | 4.61 |
同一标量源码,-O3 -mavx2 |
93.90 | 90.78 | 22.18 |
| SSE2,每次 16 字节 | 49.79 | 51.10 | 20.81 |
| AVX2,每次 4×32 字节 | 186.01 | 124.60 | 26.14 |
glibc 2.43
memchr(__memchr_avx2) |
178.85 | 125.00 | 25.06 |
| 实现(GB/s) | 16 KiB | 1 MiB |
|---|---|---|
标量 strlen,-O2 |
4.86 | 4.85 |
| AVX2 对齐版,每次 1×32 字节 | 143.17 | 117.82 |
glibc 2.43
strlen(__strlen_avx2) |
208.07 | 155.39 |
几点观察:
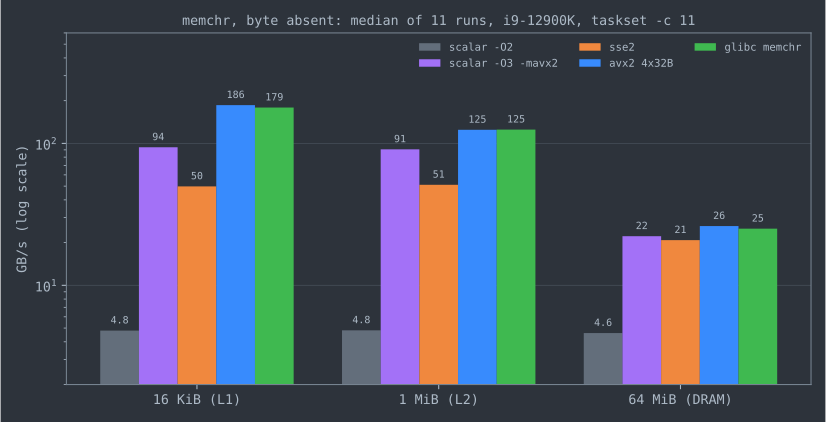
- “快多少倍”没有固定答案。 数据在 L1 里时,手写 AVX2 比标量快约 39 倍;到 64 MiB,所有向量版本都挤在 21 到 26 GB/s,受内存带宽限制,比标量只快约 5.7 倍。标量版在三种规模下都是 4.6 到 4.8 GB/s,它从来不是内存瓶颈。
- 展开比指令宽度更重要。 每次只处理 16
字节的 SSE2 版本在 L1 和 L2 都停在约 50 GB/s,每 16
字节一次分支和循环开销限制了它;AVX2 每次 128 字节、4
个比较结果合并后只分支一次,L1 内快了 3.7
倍。
strlen上同理:本文每次一个向量的对齐版比 glibc 的 4 向量展开慢约 25% 到 30%。 - 本文手写的 memchr 与 glibc
相当,这不说明它能替代 glibc。 glibc
版本还处理了第二节的顺序读语义、
wmemchr/rawmemchr变体、RTM 与 EVEX 分派,以及短输入的分支布局。
编译器做了什么
标量参考实现的编译参数不是随手加的。GCC 16.1.1 在
-O2 下把 strlen_scalar
的循环整个替换成了 call strlen@PLT(Clang
22.1.6 替换成尾调用 jmp strlen@PLT),不加
-fno-tree-loop-distribute-patterns 的话,“标量
strlen”测出来就是 glibc 的速度。在 -O3 -mavx2
下,GCC
会向量化带长度上界的早退循环,-fopt-info-vec
报告 “loop vectorized using 32 byte vectors and unroll
factor 32”,memchr 因此从 4.8 GB/s 升到 94
GB/s,约为手写版本的一半;-O2
不做这个变换,Clang 22.1.6 在 -O2 -mavx2
下也没有向量化这个循环。关掉模式替换后,没有长度参数的
strlen 循环在 GCC -O3 -mavx2
下也没有被向量化:编译器无法证明读到 NUL
之后的字节是安全的,而第二节的页内多读正是它不能替程序员做的假设。
四、PCMPISTRI 与 PCMPESTRI:通用,但慢
一条指令能做什么
SSE4.2
加入了四条”打包字符串比较”指令:PCMPESTRI、PCMPESTRM、PCMPISTRI、PCMPISTRM。名字里的
E 表示显式长度(两个操作数的长度放在
EAX、EDX),I 表示隐式长度(遇到 0
元素即结束);结尾的 I 返回第一个或最后一个命中的下标(写入
ECX),M
返回掩码。立即数控制字节的四个字段是:位 1:0
选元素类型(有无符号的字节或字);位 3:2 选聚合方式,即
equal
any(第二个操作数的每个元素是否等于第一个操作数中的任意一个)、ranges(是否落在第一个操作数给出的若干区间内)、equal
each(逐元素相等)、equal ordered(子串匹配);位 5:4
选结果是否取反以及是否只对有效元素取反;位 6
选输出最低还是最高的命中位置。完整定义见 Intel SDM 第 2
卷中这四条指令共用的 “Imm8 Control Byte Operation”
一节。
一条 PCMPISTRI 就能回答”这 16
个字节里,第一个等于
,、\n、"、\r
之一的字节在哪里”,集合最多 16
个字节,而且可以在运行时变化。reproduce/simd.c
中 find_any4_pcmpistri 的核心是:
    const __m128i st = _mm_setr_epi8(set[0], set[1], set[2], set[3],
                                     0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0);
    ...
        int k = _mm_cmpistri(st, v, _SIDD_UBYTE_OPS | _SIDD_CMP_EQUAL_ANY |
                                     _SIDD_LEAST_SIGNIFICANT);
        if (k < 16)
            return i + (size_t)k;
隐式长度有一个陷阱:数据操作数里出现 0
字节时,比较在那里截止。这个函数因此只适用于不含 NUL
的数据;要处理任意二进制数据,得用显式长度的
PCMPESTRI,而它更慢。
代价
uops.info 对 Alder Lake-P 的测量结果:
| 指令 | 延迟(周期) | 倒数吞吐(周期/条) | μop 数 |
|---|---|---|---|
PCMPISTRI xmm, xmm, imm8 |
\(\le 11\) | 3 | 3,全部在 0 号端口 |
PCMPESTRI xmm, xmm, imm8 |
16(长度操作数) | 4 | 8,其中 4 个来自微码序列器 |
VPCMPEQB ymm, ymm, ymm |
1 | 0.5 | 1 |
VPMOVMSKB r32, ymm |
\(\le 4\) | 1 | 1,0 号端口 |
同样找 4 个字节中的任意一个,PCMPISTRI 每 3
个周期处理 16 字节;AVX2 用 4 次 vpcmpeqb、3 次
vpor 和 1 次 vpmovmskb 处理 32
字节。实测(GB/s,目标不存在):
| 实现 | 16 KiB | 1 MiB |
|---|---|---|
标量,-O2 |
1.95 | 1.95 |
同一标量源码,-O3 -mavx2 |
22.38 | 21.88 |
SSE4.2 PCMPISTRI,每次 16 字节 |
25.21 | 25.81 |
| AVX2,4 次比较合并,每次 32 字节 | 53.39 | 54.08 |
两列几乎一样,说明瓶颈在指令而不在缓存。AVX2
版快一倍左右;集合只有几个字节时,逐个比较再合并比
PCMPISTRI 更划算。PCMPISTRI
的优势在集合大、而且运行时才知道的场合,这时 AVX2
的替代方案是用 vpshufb 按高低半字节查两张 16
项表做分类(见 SIMD
算法设计模式 的 pshufb 一节),simdjson
就用这种方法一次分类 6 个结构字符和 4 个空白字符(论文 3.1.2
节)。
glibc 的取舍
glibc 2.11(2009)的 NEWS 记载,H.J. Lu 为 x86-64
加入了一批 SSE2/SSE4.2 字符串函数,包括
strstr、strcasestr、strcspn、strpbrk、strspn、strcmp。2013
年 12 月,Ondřej Bílka 的提交 584b18eb4df6 “Add strstr with
unaligned loads. Fixes bug 12100.” 删除了 SSE4.2 版
strstr,说明是:
A sse42 version of strstr used pcmpistr instruction which is quite ineffective. A faster way is look for pairs of characters which is uses sse2, is faster than pcmpistr and for real strings a pairs we look for are relatively rare.
For linear time complexity we use buy or rent technique which switches to two-way algorithm when superlinear behaviour is detected.
bug 12100 出现在 glibc 2.19 NEWS 的已修复列表里。到 glibc
2.42,sysdeps/x86_64/multiarch/strstr.c 的
ifunc 只在
__strstr_sse2_unaligned(字符对过滤)和
__strstr_generic(string/strstr.c)之间选择,已经没有
PCMPxSTRx 版本。字符对过滤的细节见 SIMD 加速字符串查找(strchr /
strstr)系统指南。
PCMPISTRI 并没有从 glibc 消失。2.42 的
strcspn、strspn、strpbrk
仍有 SSE4.2 版本(strpbrk-sse4.c 直接包含
strcspn-sse4.c),ifunc-sse4_2.h
里的注释说明了保留的理由:
This function uses the
pcmpstrisse4.2 instruction which can be slow on some CPUs. This normally would be guarded by a Slow_SSE4_2 check, but since there is no other optimized implementation its best to keep it regardless.
这几个函数的”集合”是调用者传入的任意字符串,正是
PCMPxSTRx 最擅长的场合。strcmp 的 SSE4.2
版本仍在,但 ifunc 只在没有 AVX2 且 CPU 没被标记为
Slow_SSE4_2 时才选它。
学术界用过同样的指令。Mühlbauer 等人的 Instant
Loading(PVLDB 6(14),2013)用 _mm_cmpistri 的
equal any 模式每次 16 字节寻找 CSV 分隔符,长字段则把 4 次
_mm_cmpistrm 的结果拼成 64
位掩码,再数尾随零。那是 AVX2
普及之前的选择;第五节的做法与它的差别,在于用整块掩码而不是”找下一个分隔符”的循环。
五、带上下文的扫描:引号、转义与前缀异或
从”找下一个”到”整块掩码”
前几节的扫描都是无状态的:一个字节是不是逗号,只看它自己。CSV
和 JSON 不是这样:引号内的逗号不是分隔符,\"
不是字符串边界,而 \\"
又是。逐字节状态机天然处理这种依赖,但它每个字节一次分支,而且状态串行传递,无法并行。
把文本转成”每个字节一位”的位流再用整数运算处理,这个思路可以追溯到
Cameron、Herdy 和 Lin 的 Parabix(CASCON
2008),他们用并行位流解析
XML,后来又把同一思路用于正则匹配(Cameron 等,PACT
2014)。Mytkowicz、Musuvathi 和 Schulte(ASPLOS
2014)给出了一般有限状态机的数据并行化方法:对每个输入符号枚举从所有可能状态出发的转移,以此打破迭代间的依赖,基准包括正则匹配、Huffman
解码和 HTML 词法分析。在 JSON 上,按 simdjson 论文第 2
节的概括,Li 等人的 Mison(PVLDB 10(10),2017)先用 SIMD
比较生成引号、反斜杠、冒号等字符的位图,再用
popcnt
数引号前面的反斜杠个数来判断转义,但后续步骤仍是带分支的循环。Langdale
和 Lemire 的 simdjson(The VLDB Journal
28(6),2019)把第一阶段做成基本无分支、每字节代价固定的位运算序列,论文第
3.1 节逐步给出了算法,并在 3.1.1 节与 Mison 对比。
下面按 CSV、JSON 的顺序,把这套位运算写成可运行的代码,并与逐字节状态机对拍。
CSV:引号状态就是前缀异或
先只考虑一条规则:每遇到一个
",“是否在引号内”的状态就翻转一次。设 \(q_j\) 表示第 \(j\) 个字节是否为引号,\(c\) 是上一块结束时的状态,则第
\(i\)
个字节是否在引号内为
\[ \mathrm{inq}_i = c \oplus \bigoplus_{j=0}^{i} q_j . \]
这就是异或的前缀和。对一个 64
位的引号掩码,它可以用一次无进位乘法(carry-less
multiplication,PCLMULQDQ)算出。无进位乘法把普通乘法里的加法换成异或:
\[ a \otimes b = \bigoplus_{i=0}^{63} a_i \cdot (b \ll i). \]
取 \(b\) 为全 1,\((b \ll i)\) 的第 \(k\) 位在 \(k \ge i\) 时为 1,所以乘积低 64
位的第 \(k\) 位是 \(\bigoplus_{i \le k}
a_i\),正好是前缀异或。simdjson 的
prefix_xor()(include/simdjson/haswell/bitmask.h)就是
_mm_clmulepi64_si128(bitmask, all_ones, 0)。
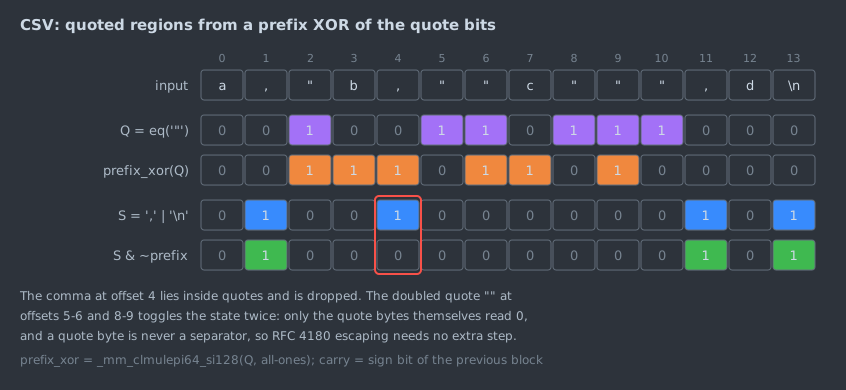
图中的第二个字段是 "b,""c""",按 RFC 4180 第
2 节第 7 条,引号字段内的 ""
表示一个字面引号,字段值是
b,"c"。这条转义规则不需要额外处理:""
让状态连续翻转两次,只有两个引号字节本身读到
0,而引号字节不可能是分隔符,所以 S & ~inq
的结果不受影响。块与块之间只需要传递 1
位状态:把本块结果的最高位符号扩展成全 0 或全
1,异或到下一块。
size_t csv_seps_simd(const char *buf, size_t n, uint32_t *out, int *open_quote)
{
    char tmp[64];
    uint64_t prev_inq = 0; /* all ones if the previous block ended inside quotes */
    size_t cnt = 0;
    for (size_t i = 0; i < n; i += 64) {
        block64 b = load_block(buf, n, i, tmp);
        uint64_t quote = eq64(b, '"');
        uint64_t sep = eq64(b, ',') | eq64(b, '\n');
        uint64_t inq = prefix_xor_clmul(quote) ^ prev_inq;
        prev_inq = (uint64_t)((int64_t)inq >> 63);
        cnt = emit(sep & ~inq, i, out, cnt);
    }
    *open_quote = (int)(prev_inq & 1);
    return cnt;
}
eq64 把两个 32 字节比较结果的 movemask 拼成
64 位;emit 就是第一节的 tzcnt 加
bits &= bits - 1
循环;load_block 在最后一块把剩余字节复制进 0
填充的缓冲区。
“每个引号都翻转”是 RFC 4180
合法输入上的正确语义,但它不是所有 CSV 读取器的语义。Python
3.14.5 的 csv.reader 把 a"b,c 读成
['a"b', 'c']:未加引号字段中间的 "
被当作普通字符。按奇偶翻转的扫描器会认为这个引号开启了一个引号区,后面的逗号全部失效,直到下一个引号出现。逐字节状态机可以只在字段开头识别引号,位运算版本要复现这种宽松语义,就得额外计算”字段起始位置”的掩码。
JSON:先找出被转义的字节
JSON 的字符串里,"
可以被反斜杠转义,反斜杠本身也可以被转义。判断规则是:一个字节前面紧挨着的连续反斜杠如果是奇数个,它就是被转义的。simdjson
第一阶段的数据流如下,每 64 字节一块,块间只传两个 1
位状态:
flowchart LR
    B["backslash mask"] --> E["escaped mask"]
    C1(["carry: next_is_escaped"]) --> E
    Q["quote mask"] --> U["quote AND NOT escaped"]
    E --> U
    U --> P["prefix_xor via PCLMULQDQ"]
    C2(["carry: prev_in_string"]) --> P
    P --> S["in_string"]
    O["op mask: braces, brackets, colon, comma"] --> M["marks"]
    S --> M
    U --> M
    M --> X["index extraction: tzcnt loop"]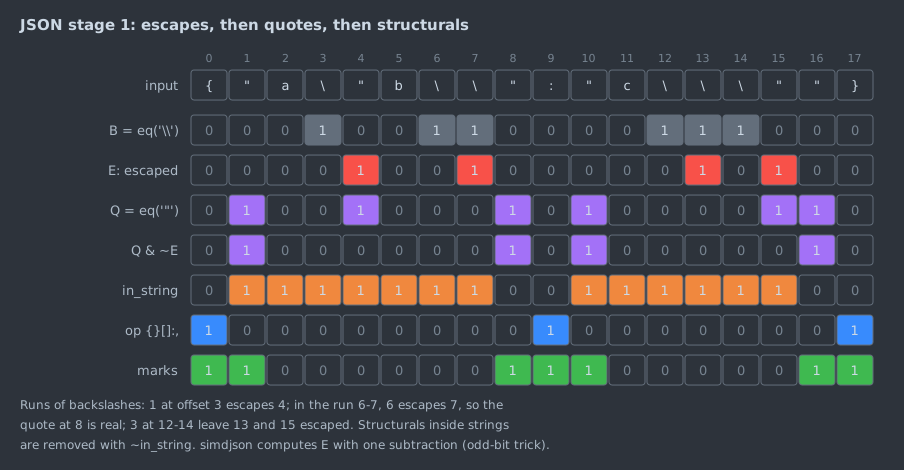
图里偏移 3 的单个反斜杠转义了偏移 4 的引号;偏移 6、7
两个反斜杠中,6 转义了 7,所以偏移 8
的引号是真的字符串结尾;偏移 12 到 14 三个反斜杠中,13 和 15
被转义,偏移 15 的引号是字面字符,16 才是结尾。整个对象是
{"a\"b\\":"c\\\""},键为
a"b\,值为 c\"。
论文图 3
用加法进位来识别奇数长度的反斜杠序列:先取每段序列的起点,按起点在奇数位还是偶数位分成两组,把起点加到反斜杠掩码上,进位会停在序列末尾的下一位,再按末尾的奇偶筛选。simdjson
4.0.7 把它压缩成了一次减法,以下摘自
src/generic/stage1/json_escape_scanner.h 的
next_escape_and_terminal_code(),删去了注释:
    uint64_t maybe_escaped = potential_escape << 1;
    uint64_t maybe_escaped_and_odd_bits     = maybe_escaped | ODD_BITS;
    uint64_t even_series_codes_and_odd_bits = maybe_escaped_and_odd_bits - potential_escape;
    return even_series_codes_and_odd_bits ^ ODD_BITS;
ODD_BITS 是
0xAAAAAAAAAAAAAAAA,即所有奇数位。调用方
next() 传入的是
backslash & ~next_is_escaped(上一块末尾留下的转义先扣掉),再用
escaped = code ^ (backslash | next_is_escaped)
得到被转义字节,escape = code & backslash
的最高位就是下一块的 next_is_escaped。随后
json_string_scanner::next()(同目录
json_string_scanner.h)做三件事:quote = in.eq('"') & ~escaped,in_string = prefix_xor(quote) ^ prev_in_string,再把
in_string
符号扩展成下一块的状态。reproduce/simd.c 的
json_escaped_bits() 和
json_marks_simd() 照搬了这套算术,只把 simdjson
的 vpshufb 分类换成了 6 次比较。
这里有一个语义选择:反斜杠在字符串外面也按转义处理。字符串外出现反斜杠本来就是非法 JSON,第一阶段不判断合法性,留给第二阶段报错。本文的标量参考实现采用同样的约定,对拍才有意义。
实测:瓶颈从分类转到下标提取
生成器 gen_csv 每行 8
个字段,数字、单词和带逗号、""、换行的引号字段按
4:4:2 的比例混合,平均每 64 字节 8.89
个分隔符;gen_json 生成对象数组,字符串里带
\n、\"、\\
和看起来像结构字符的内容,平均每 64 字节 19.53
个标记。结果(GB/s):
| 实现 | 16 KiB | 1 MiB | 16 MiB |
|---|---|---|---|
| CSV,逐字节状态机 | 2.53 | 0.71 | 0.70 |
| CSV,位运算 | 7.41 | 5.61 | 5.14 |
| JSON,逐字节状态机 | 1.88 | 1.49 | 1.49 |
| JSON,位运算 | 4.67 | 3.26 | 3.10 |
| JSON,位运算但只计数、不写下标 | 15.46 | 14.51 | 10.98 |
- 16 KiB 一列不可信。 标量 CSV 在 16 KiB
上比 1 MiB 快 3.6
倍,而标量版每字节要好几个周期,远没到任何一级缓存的带宽上限;第三节的标量
memchr从 16 KiB 到 64 MiB 都是 4.6 到 4.8 GB/s,也说明逐字节循环不受缓存层级影响。reproduce/bench_predictor.c进一步排除缓存因素:反复扫同一段 16 KiB 时标量 CSV 为 2.51 GB/s;在两段不同的 16 KiB 之间轮换(共 32 KiB,仍在 Golden Cove 核心 48 KiB 的一级数据缓存内)时降到 1.03;64 KiB 时 0.82。数据仍在 L1,变的只是分支序列能否重复,这符合”分支预测器记住了 16 KiB 输入的分支历史”的解释。本机在 WSL2 下无法使用性能计数器,这个解释没有用分支失误计数直接验证。数据相关分支多的代码,小输入反复计时会高估性能,本文的结论只看后两列。 - CSV 快 7.3 倍,JSON 只快 2 倍。
两者的分类代价相近,区别在标记密度:JSON 每 64 字节要写出
19.5 个下标,
emit循环每个下标一次tzcnt、一次存储、一次分支,这部分主导了时间。只计数不写下标时,JSON 扫描达到 10.98 GB/s,是写下标版本的 3.5 倍。 - 与论文的消融一致。 simdjson 论文附录 B
的表 12
给出了第一阶段每字节周期数的消融(Skylake),并说明测量标准误约
0.02 周期/字节,小于 0.05 的差异不一定显著。把无进位乘法换成
mask ^= mask << 1、<< 2直到<< 32共 6 次移位异或后,13 个文件里只有 marine ik、mesh、mesh.pretty、twitterescaped 4 个的差异达到 0.05,最大的是 mesh(0.90 到 1.07);twitter 从 0.90 到 0.92,在误差范围内。把优化过的下标提取换成朴素的tzcnt循环后,11 个文件的差异达到 0.05,twitter 从 0.90 到 1.14,random 从 1.22 到 1.57。无进位乘法是这套方法里最显眼的技巧,下标提取则是更大的开销来源。本文的emit正是论文所说的朴素写法。simdjson 4.0.7 的bit_indexer::write()(src/generic/stage1/json_structural_indexer.h)先用popcount算出置位个数,再每次无条件写 4 个下标,允许写出有效范围外的多余值,每 4 个之间才判断一次是否继续,超过 24 个以后退回逐个写的循环。
六、怎样读 simdjson 论文里的数字
simdjson 的数字常被脱离语境地引用,这里把论文的条件和本文的条件并排放一下。
硬件与口径。 论文表 3
列了两台机器:Intel i7-6700(Skylake,基频 3.4 GHz,睿频 3.7
GHz,DDR4-2133)和 i3-8121U(Cannon Lake,2.2
GHz)。编译器为 GCC
9.1,-O3 -march=native,单线程,关闭超线程,文档预先读入内存。表
10 的吞吐是”解析并验证”的完整过程,包括 UTF-8
验证、数字和字符串解析,以及生成解析结果(tape)。
Skylake 上的完整解析(表 10,GB/s)。 选四个文件和四个解析器:
| 文件 | simdjson | RapidJSON | sajson | nlohmann/json |
|---|---|---|---|---|
| 2.2 | 0.45 | 1.0 | 0.10 | |
| gsoc-2018 | 3.2 | 0.51 | 1.1 | 0.12 |
| canada | 1.1 | 0.43 | 0.76 | 0.05 |
| marine ik | 0.94 | 0.45 | 0.67 | 0.06 |
表中 RapidJSON 是默认模式,原地解析(insitu)模式在 twitter 上为 0.72;sajson 是静态分配模式,动态分配模式在 twitter 上为 0.73;nlohmann/json 在论文里标为 “JSON for Modern C++”。simdjson 的优势随文件变化很大:数字密集的 canada、marine ik 上只比 RapidJSON 快约 2 到 2.6 倍,字符串和结构字符为主的 gsoc-2018 上快 6 倍多。论文表 13 另测了一个 84 MB 的大文件,simdjson 在 Skylake 上为 1.4 GB/s。
指令数(表 8)。 每字节指令数的平均值:simdjson 8.3,RapidJSON 18.7,sajson 14.7。论文第 4.4 节据此说 simdjson 大约只用一半的指令;它用的向量指令更多,但标量指令少得多。
两个阶段各占多少。 论文图 8 按阶段分解了每字节周期数:第一阶段不含 UTF-8 验证的部分在各文件上为 0.5 到 1 个周期,论文第 4.3 节据此称大约一半的周期花在第一阶段。表 12 中 twitter 第一阶段为 0.90 周期/字节,若按 3.4 GHz 折算约 3.8 GB/s。
为什么不能拿本文的数字去比。 本文
json_marks_simd 在 i9-12900K 上 16 MiB 输入为
3.10 GB/s,看起来比上面折算的 3.8 GB/s
还慢,但两者不是同一件事:
- 本文只做了第一阶段的一部分。没有 UTF-8
验证,没有识别空白和”伪结构字符”(论文第 3.1.3
节,用来定位数字、
true等原子值的起点),也没有用vpshufb查表分类。 - 下标提取用的是论文消融实验里的朴素循环,第五节已经说明这一步是主要开销。
- 输入是合成数据,标记密度(每 64 字节 19.5 个)和论文的真实文件不同。
- CPU、编译器、库版本都不同。论文测的是 AVX2 实现,并把
AVX-512 列为未来工作;simdjson 4.0.7 在 x86-64
上会在运行时于
icelake(AVX-512)、haswell(AVX2)、westmere(SSE4.2)和fallback之间选择,另有arm64、ppc64、lsx/lasx后端。
要知道 simdjson 在本机上多快,只能跑它自带的基准程序。本文没有跑,因此不给出 simdjson 在 12900K 上的数字。本文数字能支持的只是相对结论:在同一台机器、同一份输入上,位运算版本的第一阶段子集比逐字节状态机快约 2 倍,把下标提取去掉后快约 7 倍。
七、争论与开放问题
页内多读算不算合法
这件事在不同层面上有不同答案。在 x86-64
的硬件层面,内存保护以页为单位,对齐加载不跨页就不会因多读而出错,glibc
的汇编依赖的正是这一点。在 C 语言层面,N1570 6.5.6p8
规定指针运算越过数组末尾一个元素以外、或对末尾之后的位置解引用是未定义行为,所以本文
strlen_avx2_aligned 这样的 C
代码即使在硬件上安全,编译器也没有义务保留程序员的意图;本文用编译器内建函数写加载,再用
no_sanitize_address 属性关掉 ASan
插桩,只是让工具不报告,不是让它合法。
simdjson
的两份文档正好代表了两种态度。doc/performance.md
的 “Free Padding”
一节说,只要不跨出已分配的页,现代系统上”可以安全地”读过缓冲区末尾,并给出了按页大小判断是否需要复制的示例代码,同时承认
valgrind 和各类 sanitizer
会把这种行为标为不安全,建议只有”愿意压制 sanitizer
警告的专家”才这么做。另一方面,include/simdjson/base.h
把 SIMDJSON_PADDING 称为 “a stopgap”,并指向
Lemire 本人 2019 年开的 issue #174 “do away with
padding”,其中写道填充 “is not genuinely required. In time,
it should be removed.”。
硬件内存标签让这个问题变得更具体。glibc 2.42 的
sysdeps/aarch64/libc-mtag.h 把 Arm MTE
的标签粒度定义为 16 字节,同版本的
sysdeps/aarch64/strlen.S 和
memchr.S 注明 “MTE compatible”,它们只做 16
字节对齐的加载。启用内存标签后,“不跨页就安全”的前提缩小成了”不跨
16 字节粒度就安全”,x86 上 32 字节、64
字节的对齐多读不能照搬过去。页内多读是一个依赖平台保护粒度的约定,而不是一个可移植的算法性质。
通用指令还是组合指令
PCMPxSTRx
的设计目标是用一条指令覆盖多种字符串操作,代价是多个 μop
和较长的延迟。glibc 对它的处理并不一致:2013 年从
strstr 中删除,理由是 “quite ineffective”;但
2.42 的 strcspn、strspn
仍然保留它,理由是”没有别的优化实现”。第四节的实测支持前一种判断:集合只有
4 个字节时,AVX2 四次比较比 PCMPISTRI
快一倍。集合大且在运行时才确定时,PCMPISTRI
的对手是 vpshufb
半字节查表,后者需要先根据集合构造两张 16
项表,而两张表按位与的结果只有 8
位,并不是任意集合都能精确表示(pshufb
查表本身见 SIMD
算法设计模式
第三节)。两者在随机集合上的交叉点,本文没有测。
SIMD 过滤与最坏情况保证
SIMD
让”先粗筛、再逐个验证”的做法很快,但过滤器本身不提供最坏情况保证。glibc
在这件事上走过两个来回。584b18eb4df6
引入字符对过滤时就附带了 “buy or rent”
机制:检测到超线性行为时切换到双向算法(Two-Way)。2022 年 6
月加入的 AVX-512 版
strstr(5082a287d5e9)没有这层保护,在 2024 年
3 月被 Adhemerval Zanella 的提交 721314c980ed
删除。提交说明指出它是暴力匹配,“never skips
ahead”,并引用了 Wilco 在 “Difficult bruteforce needle”
用例上的测量:needle 从 1024 字节增至 4096 字节、haystack 从
64 KiB 增至 1 MiB 时,它的耗时增长了 65 倍;同样条件下
__strstr_generic 只增长约 7.6 倍,1 MiB
一组中两者相差约 25000
倍。平均情况快、最坏情况退化成平方,这是所有 SIMD
过滤型算法都要回答的问题,详见 SIMD 加速字符串查找(strchr /
strstr)系统指南。
两状态以外的上下文
前缀异或只能处理”每个标记翻转一次状态”的两状态自动机。JSON 靠”先算转义、再算引号”两步化解了反斜杠与引号的交互,CSV 的 RFC 4180 语义也恰好是两状态的。但第五节提到的宽松 CSV 语义、带注释的格式、多种引号字符的格式,状态数一多,位运算的构造就不再显然。一般化的方向有两条:Mytkowicz 等人枚举所有起始状态的转移,把状态机的组合变成可并行的归约;Ge 等人(SIGMOD 2019)在分布式 CSV 解析中不枚举,而是推测每个数据块起点处的上下文,论文认为由于 CSV 的语法和统计性质,推测”很少失败”,失败时能可靠地检测出来。两种方法都没有直接给出单核 SIMD 内核,如何把多状态格式的扫描做到 simdjson 第一阶段那样的每字节固定代价,仍是开放问题。
八、工程陷阱
| 陷阱 | 后果 | 本文的处理与检测 |
|---|---|---|
| 从字符串起点起做非对齐向量加载 | 字符串贴着不可读页结尾时段错误,201 个长度里 195 个出错 | 对齐加载或有界加载;mmap
加保护页的页尾测试 |
| 对齐多读写在 C 代码里 | C 语义上是未定义行为,ASan 报 heap-buffer-overflow | no_sanitize_address
只用于确认过的函数,并单独保留一个会被 ASan 抓到的演示 |
有界 memchr 用重叠尾块 |
读到第一个匹配之后的字节,不满足 C11 7.24.5.1 的顺序读语义 | 调用者必须保证整个 [s, s+n)
可读;需要顺序读语义时换成对齐加载 |
PCMPISTRI 的隐式长度 |
数据里的 0 字节会让比较提前截止 | 只用于不含 NUL 的文本;二进制数据用
PCMPESTRI 或比较合并 |
_mm256_movemask_epi8 返回
int |
直接转成 uint64_t 时,第 31 位为 1
会符号扩展,高 32 位全变成 1 |
先转 uint32_t 再拼接 |
对 0 求 __builtin_ctz |
结果未定义 | 循环条件先判断掩码非零 |
| 忘记跨块传递引号和转义状态 | 字符串或引号字段跨越 64 字节边界时,整块分类反转 | 符号扩展传递 1 位状态;对拍输入长度到 1499 字节,覆盖多块 |
| 位运算语义与宽松解析器不同 | 字段中间的孤立引号让后续分隔符全部失效 | 标量参考实现与位运算版本采用相同的翻转语义,并在文中写明差异 |
| 编译器把标量循环换成库函数 | “标量基线”实际测的是 glibc | -fno-tree-loop-distribute-patterns,并检查生成的汇编 |
| 小输入反复计时 | 分支多的标量代码被分支预测器高估数倍 | 同时报告 1 MiB 与 16 MiB,并用轮换窗口的实验确认 |
九、参考资料
规范与文档
- ISO/IEC 9899:2011 委员会草案
N1570:6.5.6p8(指针运算与越界解引用)、7.24.5.1(
memchr)。 - RFC 4180, “Common Format and MIME Type for Comma-Separated Values (CSV) Files”, 2005,第 2 节。
- Intel 64 and IA-32 Architectures Software Developer’s Manual, Volume 2:“Imm8 Control Byte Operation for PCMPESTRI / PCMPESTRM / PCMPISTRI / PCMPISTRM”。
- uops.info:
PCMPISTRI (XMM, XMM, I8)、PCMPESTRI (XMM, XMM, I8)、VPCMPEQB (YMM, YMM, YMM)、VPMOVMSKB (R32, YMM)、PCLMULQDQ (XMM, XMM, I8)的 Alder Lake-P 测量结果。 - simdjson 4.0.7,
doc/performance.md的 “Free Padding” 一节。
源码
- glibc
2.42,
sysdeps/x86_64/multiarch/memchr-avx2.S、strlen-avx2.S、ifunc-evex.h(memchr的分派)、ifunc-avx2.h(strlen的分派)、ifunc-sse4_2.h、strstr.c、strcspn-sse4.c、strpbrk-sse4.c;sysdeps/aarch64/strlen.S、memchr.S、libc-mtag.h。本机运行的是 glibc 2.43,其中上述 x86-64 文件相对 2.42 只有版权年份的改动,strstr.c另有一处 Clang 编译修复。 - glibc 提交 584b18eb4df6 “Add strstr with unaligned
loads. Fixes bug 12100.”(Ondřej
Bílka,2013-12-14);5082a287d5e9(AVX-512
strstr,2022-06-06);721314c980ed “x86_64: Remove avx512 strstr implementation”(Adhemerval Zanella,2024-03-21)。glibc 2.11 与 2.19 的NEWS。 - simdjson
4.0.7,
include/simdjson/base.h(SIMDJSON_PADDING)、include/simdjson/haswell/bitmask.h(prefix_xor)、src/generic/stage1/json_escape_scanner.h、json_string_scanner.h、json_structural_indexer.h、buf_block_reader.h;issue #174 “do away with padding”。 - CPython 3.14.5,
csv模块(用于验证宽松引号语义)。
核心论文
- G. Langdale, D. Lemire, “Parsing gigabytes of JSON per second”, The VLDB Journal 28(6), 2019, 941–960. doi:10.1007/s00778-019-00578-5;arXiv:1902.08318。
- R. D. Cameron, K. S. Herdy, D. Lin, “High performance XML parsing using parallel bit stream technology”, CASCON 2008.
- Y. Li, N. R. Katsipoulakis, B. Chandramouli, J. Goldstein, D. Kossmann, “Mison: A fast JSON parser for data analytics”, PVLDB 10(10), 2017, 1118–1129.
- T. Mühlbauer, W. Rödiger, R. Seilbeck, A. Reiser, A. Kemper, T. Neumann, “Instant loading for main memory databases”, PVLDB 6(14), 2013, 1702–1713.
其他论文
- T. Mytkowicz, M. Musuvathi, W. Schulte, “Data-parallel finite-state machines”, ASPLOS 2014;ACM SIGPLAN Notices 49(4), 529–542.
- R. D. Cameron, T. C. Shermer, A. Shriraman, K. S. Herdy, D. Lin, B. R. Hull, M. Lin, “Bitwise data parallelism in regular expression matching”, PACT 2014, 139–150.
- C. Ge, Y. Li, E. Eilebrecht, B. Chandramouli, D. Kossmann, “Speculative distributed CSV data parsing for big data analytics”, SIGMOD 2019, 883–899.
- J. Keiser, D. Lemire, “Validating UTF-8 in less than one instruction per byte”, Software: Practice and Experience 51(5), 2021, 950–964(simdjson 第一阶段 UTF-8 验证的后续工作)。
实验
reproduce/simd.c、scalar.c、scan.h:本文全部 SIMD 内核与标量参考实现。reproduce/test_scan.c:与标量版和 glibc 对拍、页尾保护页测试、朴素strlen段错误计数;reproduce/asan_demo.c:对齐多读被 ASan 捕获的演示。reproduce/bench_scan.c、bench_predictor.c、gen.h:第三、四、五节的吞吐数据和分支预测实验。reproduce/run.sh:完整复现命令;reproduce/results/run.txt:本文引用的那次运行的完整输出。reproduce/make_figs.py:由代码计算掩码并生成第一、二、五节的示意图;reproduce/plot_bench.py:由results/run.txt生成memchr-throughput.svg。
系列导航: - 上一篇:字符串哈希:Rabin-Karp、滚动哈希与内容定义分块 - 下一篇:Unicode 文本算法:UTF-8 编解码与验证、规范化、字素簇与双向文本安全
相关阅读: - XXH3 与 wyhash:SIMD 累加器和 128 位标量乘法两条提速路线 - SIMD 算法设计模式 - SIMD 加速字符串查找(strchr / strstr)系统指南 - AC 自动机:失败链接、输出链接与转移表布局
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
XXH3 与 wyhash:SIMD 累加器和 128 位标量乘法两条提速路线
对照 xxHash v0.8.3 与 wyhash final4 源码拆解两者的内层循环,用逐位一致的复现程序和 i9-12900K 实测说明:AVX2 版 XXH3 在缓存内领先,默认 SSE2 构建反而慢于 wyhash,两者都有已知的乘零多重碰撞。
SIMD 加速字符串查找(strchr / strstr)系统指南
面向工程实践的SIMD字符串查找优化完全指南:SSE2/AVX2/AVX-512并行比较原理,位掩码技巧,跨块与页边界安全处理,strchr/strstr高性能实现,包含完整代码示例和性能陷阱分析
Swiss Table:控制字节、分组探测与墓碑——对照 Abseil、Go 与 hashbrown 源码
对照 Abseil 20260817.0、Go 1.26.8 与 hashbrown 0.17.1 源码,拆解 Swiss table 的控制字节编码、SIMD/SWAR 分组匹配、三角探测、删除与 rehash 策略,并用可复现实验测量探测长度、墓碑代价与每元素内存。
算法工程索引
汇总本站算法工程相关文章,覆盖排序、哈希、树、字符串、近似数据结构、SIMD、随机化与编译器相关算法。