判断两个子串是否相等、在文本里找一个模式、在备份里找出重复的数据块,都可以用同一个办法:把一段字节压成一个整数,先比整数,整数相等时再决定要不要比原文。这个整数能在窗口滑动时 \(O(1)\) 更新,就叫滚动哈希(rolling hash)。
这套办法流传最广的三种说法都有问题。
- “选一个大素数当模数、固定一个基数就够安全”。Karp 和 Rabin 1987 年证明的碰撞界,前提是参数在输入确定之后才随机选出;参数一旦固定,就存在必然碰撞的输入。本文实测:对 \(2^{64}\) 自然溢出的多项式哈希,长度 1024 的 Thue–Morse 串与它的反码对十万个随机奇数基全部碰撞。
- “rsync 用的是内容定义分块”。rsync 的接收方按固定长度切块,发送方在每个字节偏移上滚动计算弱校验和;按内容决定块边界的做法来自 2001 年的 LBFS。
- “内容定义分块的滚动哈希必须足够好”。它只用来决定切点,块的身份另由密码学哈希负责。FastCDC 用的 Gear 哈希每字节只有一次移位和一次加法,只要有效窗口够长,论文测得的去重率与 Rabin 分块相差不到 1.5%。真正的风险在另一面:加密备份里,块边界的位置本身会泄漏明文信息,Borg、Restic 等系统用来隐藏边界的密钥已被 CCS 2025 的论文恢复出来。
本文按”定义 → 原始论文的保证 → 固定参数的攻击 → GF(2)
上的 Rabin 指纹 → 为速度设计的 Buzhash 与 Gear → rsync →
内容定义分块 →
争论”的顺序展开。碰撞率、块大小分布、边界漂移都来自同目录
reproduce/
下的程序(环境见第三节)。哈希表层面的哈希洪泛与 SipHash
见站内 密码学哈希与非密码学哈希,多模式匹配的自动机做法见
AC
自动机,本文不重复。
一、多项式哈希与滚动更新
定义
把字符串 \(s = s_0 s_1 \cdots s_{m-1}\) 的每个字节看成一个数字,取基数 \(b\) 和模数 \(p\),多项式哈希(polynomial hash)定义为
\[ H(s) = \left( \sum_{j=0}^{m-1} s_j \, b^{\,m-1-j} \right) \bmod p . \]
也就是把 \(s\) 当成一个 \(b\) 进制数再对 \(p\) 取模,用 Horner 法逐字节计算:\(h \leftarrow (h \cdot b + s_j) \bmod p\)。
滚动更新
窗口从 \(s[i, i+m)\) 移到 \(s[i+1, i+m+1)\) 时,最高位的 \(s_i\) 离开,其余各位整体升一位,新字节 \(s_{i+m}\) 进入最低位:
\[ H_{i+1} = \bigl( (H_i - s_i \cdot b^{\,m-1}) \cdot b + s_{i+m} \bigr) \bmod p . \]
\(b^{m-1} \bmod p\) 预先算好,每步就是一次乘、一次减、一次加,与 \(m\) 无关。
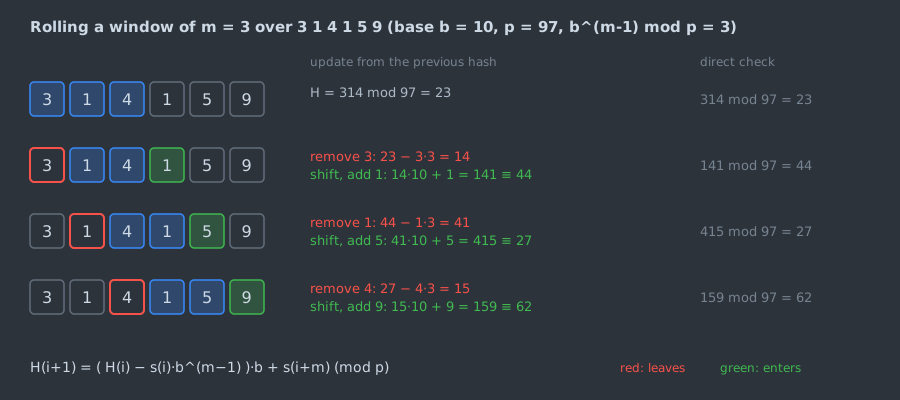
图中取 \(b = 10\)、\(p = 97\),这样窗口内容本身就是十进制数,便于核对。\(b^{m-1} \bmod p = 100 \bmod 97 = 3\),所以”移除最高位”就是减去该数字的 3 倍。第二行从 \(H = 23\) 出发:减去 \(3 \times 3\) 得 14,乘 10 加 1 得 141,模 97 得 44,与右侧直接计算 \(141 \bmod 97\) 相同。红框是离开窗口的数字,绿框是进入的数字。
子串哈希
同一个性质还能 \(O(1)\) 取出任意子串的哈希。预处理前缀哈希 \(h_0 = 0\)、\(h_{k+1} = (h_k \cdot b + s_k) \bmod p\),则
\[ H(s[i, j)) = \bigl( h_j - h_i \cdot b^{\,j-i} \bigr) \bmod p . \]
竞赛里用它配合二分求最长公共前缀、判回文、比较循环移位,Pachocki 与 Radoszewski(Olympiads in Informatics 2013)列举了多道这样的题目。
实现
下面是 reproduce/rk.c 中的搜索函数。模数取
Mersenne 素数 \(p = 2^{61} -
1\):两个小于 \(p\)
的数相乘后,用 \(2^{61} \equiv 1
\pmod p\)
把高位折回低位,不需要除法。基数由调用者在读入输入之后随机选取,这一点是后文所有保证的前提。
/* reproduce/rk.c:随机基数、模 2^61-1 的 Rabin-Karp(删去了 addmod/submod 与测试代码) */
#define P61 ((1ULL << 61) - 1)

static uint64_t mulmod(uint64_t a, uint64_t b)          /* a, b < P61 */
{
    unsigned __int128 x = (unsigned __int128)a * b;
    uint64_t r = (uint64_t)(x & P61) + (uint64_t)(x >> 61);
    return r >= P61 ? r - P61 : r;
}

static size_t rk_search(const unsigned char *txt, size_t n,
                        const unsigned char *pat, size_t m, uint64_t base,
                        void (*cb)(size_t pos, void *arg), void *arg)
{
    if (m == 0 || m > n) return 0;
    uint64_t hp = 0, ht = 0, top = 1;                   /* top = base^(m-1) */
    for (size_t i = 0; i < m; i++) {
        hp = addmod(mulmod(hp, base), pat[i]);
        ht = addmod(mulmod(ht, base), txt[i]);
        if (i) top = mulmod(top, base);
    }
    size_t false_hits = 0;
    for (size_t i = 0; ; i++) {
        if (ht == hp) {
            if (memcmp(txt + i, pat, m) == 0) cb(i, arg);
            else false_hits++;
        }
        if (i + m == n) break;
        ht = submod(ht, mulmod(txt[i], top));           /* drop txt[i]      */
        ht = addmod(mulmod(ht, base), txt[i + m]);      /* shift, add new   */
    }
    return false_hits;
}
命中后用 memcmp
验证,所以结果永远正确,碰撞只影响时间。测试程序在 2
万组随机文本(字母表大小 1 到
3,便于制造大量真匹配)上与朴素搜索逐位置比对,结果一致,没有出现验证失败的哈希命中:
gcc -O2 -Wall -Wextra -o rk rk.c && ./rk
# ok: 20000 random tests agree with naive search, 0 false hash hits
期望时间是 \(O(n + m)\),前提是虚假命中很少;最坏情况下每个窗口都命中又都在末尾才失配,退化为 \(O(nm)\)。和 KMP、Boyer-Moore 相比,它的长处不在单模式的最坏界,而在两件事:能直接推广到二维矩阵匹配(Karp–Rabin 原文第 4 节),以及哈希值可以当作子串的”名字”放进哈希表,用于同长度多模式匹配、重复子串检测和去重。
二、Karp–Rabin 1987:随机选的是素数
Karp 与 Rabin 的论文 “Efficient randomized pattern-matching algorithms” 发表于 IBM Journal of Research and Development 31(2), 1987。今天说到 Rabin-Karp,多数人指”固定模数、固定或随机基数”的多项式哈希,原文的构造不是这样。下面沿用原文记号:模式 \(X\) 长 \(n\) 位,文本 \(Y\) 长 \(m\) 位,共有 \(t = m - n + 1\) 个对齐位置。
原文的指纹
原文在比特串上工作。把 \(X \in \{0,1\}^n\) 读成二进制整数 \(H(X)\),指纹(fingerprint)取
\[ H_p(X) = H(X) \bmod p , \]
其中 \(p\) 是从不超过 \(M\) 的素数中均匀随机选出的素数。基数固定为 2,随机性全部放在模数上。滚动更新是第一节公式取 \(b = 2\) 的特例:
\[ a(i+1) = \bigl( (a(i) - 2^{n-1} y_i) \cdot 2 + y_{i+n} \bigr) \bmod p . \]
定理 3 的证明思路
位置 \(r\) 发生假匹配,当且仅当 \(p\) 整除非零整数 \(|H(X) - H(Y(r))|\)。把所有不匹配位置上的这些差乘起来,乘积小于 \(2^{nt}\)。原文引理 1 说,当 \(u \ge 29\) 时,不超过 \(u\) 的全体素数之积大于 \(2^u\),所以一个小于 \(2^{nt}\) 的正整数,不同素因子个数少于 \(\pi(nt)\)。\(p\) 从 \(\pi(M)\) 个素数里均匀选取,于是在 \(nt \ge 29\) 时,
\[ \Pr[\text{至少一次假匹配}] \le \frac{\pi(nt)}{\pi(M)} . \]
取 \(M = nt^2\),推论 4(a) 给出上界 \(2.511 / t\)。指纹不超过 \(nt^2\),只需 \(\log_2(nt^2)\) 位,和一个指针同一量级,所以原文可以假设取指纹、比较指纹都是常数时间。
这个界对每一个输入都成立,概率只来自 \(p\) 的选取。换一个说法:对手先写下 \(X\) 和 \(Y\),算法再选 \(p\)。若 \(p\) 在输入之前就公开固定,对手只要让某个差恰好是 \(p\) 的倍数即可,界不再成立。第四节的攻击都利用了这一点。
原文里常被忽略的部分
- 遇到假匹配就换素数。原文算法 3 在一次假匹配后重新随机选素数,从当前位置重新初始化。第 5 节把它称为”hedge against catastrophe”:即使运气差,也不会一直碰撞下去。今天的代码几乎都改成”命中后比较原文”,这同样保证正确性,但也让最坏情况退化成 \(O(nm)\)。
- 随机素数的代价。选一个 \(M\) 以内的随机素数,要先随机取数再做素性检验,按素数定理期望要试 \(O(\ln M)\) 次。固定 \(p\)、随机选基数更省事,代价是换成另一个概率界(第三节)。
- 二维与矩阵指纹。第 4 节把滚动更新推广到二维模式匹配。第 6 节给出另一族指纹 \(K_p\):一个从比特串到模 \(p\) 的 \(2 \times 2\) 幺模矩阵的同态,串的拼接对应矩阵相乘。每个指纹要存四个模 \(p\) 整数,防假匹配的效果与 \(H_p\) 相当(推论 10 的界为 \(6.971/t\));滚动时左乘离开字符的逆矩阵、右乘进入字符的矩阵即可,不需要 \(2^{n-1}\) 这个系数。第 7 节讨论不规则形状的模式。
三、随机基的 \((n-1)/p\) 界、紧性与生日效应
界的推导
现代写法固定一个素数 \(p\),在 \(\{0, 1, \ldots, p-1\}\) 中均匀随机选基数 \(b\)。设 \(S \ne T\) 长度都为 \(n\),字符值都小于 \(p\)。两者碰撞当且仅当 \(b\) 是
\[ D(x) = \sum_{j=0}^{n-1} (s_j - t_j) \, x^{\,n-1-j} \]
在 \(\mathbb{Z}_p\) 中的根。\(S \ne T\) 保证 \(D\) 不是零多项式,次数至多 \(n-1\);域上非零多项式的根数不超过它的次数,所以
\[ \Pr_b \bigl[ H_b(S) = H_b(T) \bigr] \le \frac{n-1}{p} . \]
这是 Schwartz–Zippel 引理的单变量情形。推导里有两个容易漏掉的前提:
- 长度必须相等。若字节值从 0 开始编码,“a” 与 “\0a” 的多项式完全一样,碰撞概率是 1。所以要么先比较长度,要么把字节映射到 \(1..256\)。
- 界针对一对串。比较 \(t\) 对串时,用并集界得到 \(t(n-1)/p\);两两比较 \(k\) 个串要乘上 \(\binom{k}{2}\),这就是下文的生日效应。
取 \(p = 2^{61} - 1\)、\(n = 10^6\),单对碰撞概率不超过 \(4.3 \times 10^{-13}\)。
界是紧的
\((n-1)/p\) 不是宽松的估计。dacin21 在 Codeforces 的一篇长文(2018)中指出:当 \((n-1) \mid (p-1)\) 时,取 \(S = \texttt{b}\,\texttt{a}^{n-1}\)、\(T = \texttt{a}^{n-1}\,\texttt{b}\),差多项式正好是 \(D(x) = x^{n-1} - 1\)(相差一个常数因子)。\(\mathbb{Z}_p^*\) 是 \(p-1\) 阶循环群,其中恰有 \(n-1\) 个元素满足 \(x^{n-1} = 1\),所以恰好有 \(n-1\) 个基数让两串碰撞。
本文所有实验的环境:Intel Core i9-12900K,WSL2(Linux
6.6.87.2),GCC 16.1.1 -O2,Go 1.26.4,用
taskset
绑定在单个核心上。随机数全部来自固定种子,重复运行输出相同;命令见
reproduce/run.sh,原始输出在
reproduce/results/。
实验 E2 在 \(p = 65537\)(\(p - 1 = 2^{16}\))下枚举全部 65537 个基数,逐一计数碰撞的基数:
| 串对 | 长度 \(n\) | 碰撞的基数个数 | 上界 \(n-1\) |
|---|---|---|---|
| \(\texttt{ba}\cdots\texttt{a}\) 与 \(\texttt{aa}\cdots\texttt{ab}\) | 4097 | 4096 | 4096 |
| Thue–Morse 串 \(\tau_{12}\) 与其反码 | 4096 | 2048 | 4095 |
| 32 对随机串,平均(最大) | 4097 | 0.97(4) | 4096 |
第一行正好顶到上界,碰撞概率 \(4096/65537 \approx 6.25\%\)。第三行说明随机串对远达不到上界,平均约一个根:若差多项式的值在 \(\mathbb{Z}_p\) 上近似均匀,每个 \(x\) 是根的概率约为 \(1/p\),\(p\) 个候选合计约 1 个。上界描述的是对手挑选的最坏输入,平均情况不是它要回答的问题。第二行的 Thue–Morse 串在下一节还会出现。
生日效应
“单对碰撞概率很小”不等于”一组串里没有碰撞”。把 \(k\) 个互不相同的串放进一个哈希集合去重,会比较 \(\binom{k}{2}\) 对;即使哈希值像均匀随机数一样分布,期望碰撞对数也有 \(k(k-1)/(2p)\)。Pachocki 与 Radoszewski 给出,当 \(k \ge 1.2\sqrt{p}\) 时至少有一对碰撞的概率超过 \(1/2\);对 \(p = 10^9 + 7\),这个门槛只有约 3.8 万个串。
实验 E3 用竞赛代码里常见的参数(基数 131,模数 \(10^9 + 7\)),对 \(k\) 个随机的 16 字节小写字母串统计碰撞对数,每个 \(k\) 用 5 个种子:
| \(k\) | 期望 \(k(k-1)/(2p)\) | 实测碰撞对数(5 个种子) | 同一批串,随机基模 \(2^{61}-1\) |
|---|---|---|---|
| \(10^4\) | 0.05 | 0, 0, 0, 1, 0 | 0 |
| \(3 \times 10^4\) | 0.45 | 1, 0, 3, 1, 0 | 0 |
| \(10^5\) | 5.00 | 4, 5, 9, 9, 4 | 0 |
| \(3 \times 10^5\) | 45.00 | 43, 46, 57, 47, 52 | 0 |
实测值围绕期望值波动,符合泊松分布的量级。这里的基数是固定的,但输入串是随机生成的,并非对手构造,所以哈希值表现得像均匀分布。对 30 万个串去重,32 位量级的模数平均会把约 45 对不同的串误判为相同;换成随机基模 \(2^{61}-1\),按均匀模型期望碰撞对数约 \(2 \times 10^{-8}\),按 \((n-1)/p\) 的最坏界算也不超过 \(3 \times 10^{-7}\)。
双模数与”独立”
常见的补救办法是同时算两个哈希。只有当两组参数独立随机时,碰撞概率才能相乘成 \(\bigl((n-1)/p\bigr)^2\)。两组参数都是写死的常量时,乘积界无从谈起。dacin21 的文章描述了三种具体攻击:对 32 位素数加固定基,用生日攻击;对更大的固定素数,用”树攻击”逐层合并差值;对多组固定参数同时攻击,用格基约化。这是一篇 B 级来源,但构造过程完整,可以自己复现。结论是:一个 61 位的随机基数,比两个写死的 32 位模数更可靠,也更快。
四、固定参数怎样被攻破:Thue–Morse 与 \(2^{64}\)
为什么 \(2^{64}\) 诱人又危险
用 uint64_t 直接累乘、任其溢出,相当于模
\(2^{64}\),省掉所有取模运算,竞赛里称为”自然溢出”。问题在于
\(\mathbb{Z}_{2^{64}}\)
不是域,第三节”非零多项式根数不超过次数”的论证不成立。偶数基数最直观:若
\(b = 2^s c\),则 \(b^{64} \equiv
0\),只要两个串的最后 64
个字符相同,前面怎么改都碰撞。奇数基数则要用 Thue–Morse
串。
Thue–Morse 构造
Thue–Morse 串(Thue–Morse sequence)从 \(\tau_0 = \texttt{a}\) 开始,\(\tau_{k+1} = \tau_k \, \bar\tau_k\),其中 \(\bar\tau\) 表示把 \(\texttt{a}\)、\(\texttt{b}\) 互换。等价地,\(\tau_k\) 的第 \(i\) 位为 \(\texttt{b}\) 当且仅当 \(i\) 的二进制表示中 1 的个数为奇数,长度为 \(2^k\)。
记 \(D_k = H(\bar\tau_k) - H(\tau_k)\),\(H\) 按第一节的定义(高位在前)。由 \(\tau_{k+1} = \tau_k \bar\tau_k\) 得 \(H(\tau_{k+1}) = H(\tau_k)\, b^{2^k} + H(\bar\tau_k)\),\(H(\bar\tau_{k+1}) = H(\bar\tau_k)\, b^{2^k} + H(\tau_k)\),两式相减得 \(D_{k+1} = D_k\,(b^{2^k} - 1)\)。又 \(D_0 = \texttt{b} - \texttt{a} = 1\),所以
\[ D_k = \prod_{i=0}^{k-1} \bigl( b^{2^i} - 1 \bigr) . \]
\(b\) 为奇数时每个因子都是偶数,乘积里 2 的幂次随 \(k\) 平方增长。Pachocki 与 Radoszewski(2013)的定理 1 证明 \(2^{k(k+1)/2} \mid D_k\),于是 \(k = 11\)(长度 2048)时 \(D_k \equiv 0 \pmod{2^{64}}\),与 \(b\) 无关。
这个界还能再收紧。用 2-adic 赋值的升幂引理(lifting the exponent):对奇数 \(b\) 和 \(i \ge 1\),
\[ v_2\bigl(b^{2^i} - 1\bigr) = v_2(b-1) + v_2(b+1) + i - 1 \ge i + 2 , \]
因为 \(b-1\) 与 \(b+1\) 是相邻偶数,其中一个被 4 整除。再加上 \(v_2(b - 1) \ge 1\),得到
\[ v_2(D_k) \ge 1 + \sum_{i=1}^{k-1} (i + 2) = 1 + \frac{(k-1)(k+4)}{2} . \]
\(k = 10\) 时右边恰好是 64:长度 1024 的 Thue–Morse 串对任何奇数基数都在模 \(2^{64}\) 下碰撞,比 Pachocki 的界短一半。当 \(b \equiv 3 \pmod 8\) 时 \(v_2(b-1) = 1\)、\(v_2(b+1) = 2\),各项等号同时成立,所以这个下界在所有奇数基上是精确的最小值。
实测
实验 E1 对每个 \(k\) 随机取 10 万个奇数基,统计模 \(2^{64}\) 下碰撞的基数,同时记录 \(v_2(D_k)\) 的最小值(封顶 64),并用同一批串在随机基模 \(2^{61}-1\) 下对照:
| \(k\) | 长度 | 模 \(2^{64}\) 碰撞 | 最小 \(v_2(D_k)\) | \(1 + (k-1)(k+4)/2\) | 模 \(2^{61}-1\) 碰撞 |
|---|---|---|---|---|---|
| 6 | 64 | 573 / 100000 | 26 | 26 | 0 |
| 7 | 128 | 3097 / 100000 | 34 | 34 | 0 |
| 8 | 256 | 12405 / 100000 | 43 | 43 | 0 |
| 9 | 512 | 24978 / 100000 | 53 | 53 | 0 |
| 10 | 1024 | 100000 / 100000 | 64 | 64 | 0 |
| 11 | 2048 | 100000 / 100000 | 64 | — | 0 |
| 12 | 4096 | 100000 / 100000 | 64 | — | 0 |
最小值与公式逐行相等。\(k < 10\) 时也有一部分基数碰撞,那是 \(v_2(b \pm 1)\) 偏大的基数(例如 \(b \equiv 1 \pmod{2^j}\))让某些因子多贡献了 2 的幂次。
这套构造在竞赛圈叫 anti-hash 测试,Pachocki 的论文引用了 Akhmedov 2012 年在 Codeforces 上的讨论。它对素数模同样有用:第三节 E2 里 \(\tau_{12}\) 在 \(p = 65537\) 下有 2048 个碰撞基数,因为 \(D_{12}\) 的根就是满足 \(x^{2^{11}} = 1\) 的元素,而 \(p - 1 = 2^{16}\) 恰好含有足够多的 2 的因子。换成 \(p = 10^9 + 7\)(\(p - 1 = 2 \times 500000003\)),满足条件的只有 \(\pm 1\)。
工业代码里的固定参数
固定参数不等于错误,要看哈希命中之后做什么。Go 1.26.4 的
internal/bytealg 用固定基 16777619、模 \(2^{32}\) 的 Rabin-Karp 实现
IndexRabinKarp,每次命中都用 ==
比较原文,结果总是正确的。internal/stringslite.Index
只在暴力比较失败次数超过 4 + i>>4
之后才切换到它,它本身就是性能兜底路径,不承担安全责任。
真正危险的是把哈希值当作身份:用 64 位哈希代替字符串做去重、做缓存键,或者用固定参数的哈希表接收外部输入。前者在对抗输入下可以被直接构造碰撞,后者会退化成哈希洪泛(hash flooding),后一种问题和 SipHash 等带密钥哈希的设计,见 密码学哈希与非密码学哈希。
五、Rabin 指纹:GF(2) 上的随机不可约多项式
定义与碰撞界
Rabin 1981 年的哈佛技术报告 TR-15-81 “Fingerprinting by Random Polynomials” 换了一个代数结构。把比特串 \(A = (a_1, \ldots, a_m)\) 看成 GF(2) 上的多项式 \(A(t) = a_1 t^{m-1} + \cdots + a_m\),随机选一个 \(k\) 次不可约多项式 \(P(t)\),指纹定义为
\[ f_P(A) = A(t) \bmod P(t) , \]
结果是一个 \(k\) 位的比特串。GF(2) 上加法就是异或,没有进位,模 \(P\) 的约化可以按字节查表完成,这是它在软件里快的原因。
碰撞分析和第三节平行。\(A \ne B\) 碰撞当且仅当 \(P\) 整除非零多项式 \(A(t) - B(t)\),后者次数小于 \(m\),至多有 \(m/k\) 个互不相同的 \(k\) 次不可约因子。而 GF(2) 上 \(k\) 次不可约多项式的个数大于 \((2^k - 2^{k/2})/k\)(Broder 1993),所以
\[ \Pr_P \bigl[ f_P(A) = f_P(B) \bigr] \le \frac{m/k}{(2^k - 2^{k/2})/k} = \frac{m}{2^k - 2^{k/2}} \approx \frac{m}{2^k} . \]
Broder 在 “Some applications of Rabin’s fingerprinting method” 里给出了多串版本:\(n\) 个长度不超过 \(m\) 位的串中出现任意碰撞的概率不超过 \(n^2 m / 2^k\)。取 \(k = 64\)、\(m = 2^{23}\)(1 MiB)、\(n = 2^{20}\),上界为 \(2^{-1}\),不能拿来当块的身份。LBFS 就用 SHA-1 标识块,Rabin 指纹只负责决定在哪里切(第八节)。
Rabin 建议 \(k\) 取素数(报告中举了 31、61 等)。原因之一是素数次数下判定不可约很便宜。\(t^{2^k} - t\) 恰好是全体次数整除 \(k\) 的不可约多项式之积(各出现一次)。\(k\) 为素数时,这些因子的次数只有 1 和 \(k\);而一次不可约多项式只有 \(t\) 与 \(t+1\) 两个。所以当 \(k \ge 3\) 时,\(k\) 次多项式 \(P\) 不可约当且仅当 \(t^{2^k} \equiv t \pmod{P}\),只需 \(k\) 次模 \(P\) 平方。随机取一个 \(k\) 次多项式,它不可约的概率约为 \(1/k\),期望试 \(k\) 次左右就能找到。
与 CRC 的区别
CRC 的计算方式和 Rabin 指纹几乎一样,都是 GF(2) 上模一个多项式。区别在于 CRC 的多项式是公开的固定值,它只保证检出特定类型的随机错误(比如一定长度内的突发错误),对刻意构造的输入没有保证:只要让 \(A - B\) 是生成多项式的倍数即可。Rabin 指纹的碰撞界完全来自多项式的随机选取。这一点和第二节一样:保证来自输入确定后才抽取的随机数,不来自某个”好”常数。
restic:每个仓库一个随机多项式
restic 是少数完整照 Rabin
原意实现的系统。restic/chunker v0.4.0(restic
v0.17.3 的 go.mod 所钉版本)的
RandomPolynomial 随机生成 53
次多项式,设置最高位和常数项后调用
Irreducible() 检验,不可约才返回。restic
v0.17.3 的 CreateConfig
在建仓库时调用它,结果存进仓库配置的
chunker_polynomial
字段,所以每个仓库的切点不同。
滚动更新是查两张表:out[b] 是字节 \(b\) 后跟 63
个零字节的指纹,异或上它就把离开窗口的字节抵消掉;mod[i]
同时包含”高 8 位对 \(P\)
的余数”和”这 8 位本身”,一次异或既约化又清掉溢出位。下面是
chunker.go 的内层循环:
// github.com/restic/chunker v0.4.0, chunker.go(节选)
for _, b := range buf[c.bpos:c.bmax] {
    // slide(b)
    // limit wpos before to elide array bound checks
    wpos = wpos % windowSize
    out := win[wpos]
    win[wpos] = b
    digest ^= uint64(tab.out[out])
    wpos++

    digest = updateDigest(digest, polShift, tab, b)
    // end manual inline

    add++

    if (digest&c.splitmask) == 0 || add >= maxSize {
        if add < minSize {
            continue
        }
        // ... 在此处切出一个块并 reset() ...
    }
}

func updateDigest(digest uint64, polShift uint, tab *tables, b byte) (newDigest uint64) {
    index := digest >> polShift
    digest <<= 8
    digest |= uint64(b)

    digest ^= uint64(tab.mod[index])
    return digest
}
窗口 windowSize 为 64
字节,splitmask 取低 20 位,最小块 512
KiB、最大块 8 MiB,平均约 1 MiB(第八节核对)。
git 的增量压缩:固定表也够用
git v2.46.0 的 diff-delta.c(Nicolas Pitre
改写,受 LibXDiff 启发)也用 Rabin
风格的滚动哈希,但用途是找增量压缩的匹配位置。它把源对象每
16
字节(RABIN_WINDOW)的块做一次哈希建索引,再在目标对象上逐字节滚动:
/* git v2.46.0, diff-delta.c,create_delta() 内层 */
val ^= U[data[-RABIN_WINDOW]];
val = ((val << 8) | *data) ^ T[val >> RABIN_SHIFT];
i = val & index->hash_mask;
表 T 和 U
是写死的常量,但这里不需要随机性:每个候选位置随后逐字节比较并向后扩展,哈希只影响找到匹配的速度。对病态输入,它用
HASH_LIMIT(64)限制每个桶的条目数,保证最坏时间,这是性能防御,与碰撞概率无关。
六、为速度而生:Buzhash 与 Gear
Buzhash:循环多项式
Buzhash 出自 Robert Uzgalis(署名 “BUZ”)的讲义。它先准备一张 256 项、每项 32 位的随机表 \(T\),要求每个比特位上恰好一半的项为 1;然后每读一个字符,把哈希循环左移 1 位再异或上表项。记 \(\mathrm{rot}^j\) 为循环左移 \(j\) 位,长度为 \(n\) 的窗口的哈希是
\[ h = \bigoplus_{j=0}^{n-1} \mathrm{rot}^{\,n-1-j}\bigl(T[s_j]\bigr) , \]
滚动时 \(h' = \mathrm{rot}^1(h) \oplus \mathrm{rot}^{\,n}(T[s_{\text{out}}]) \oplus T[s_{\text{in}}]\)。没有乘法、没有进位,每字节三次查表或移位。在 GF(2) 的语言里,循环左移就是乘以 \(t\) 再模 \(t^L + 1\),所以文献里也叫循环多项式(cyclic polynomial)。\(t^L + 1\) 在 \(L > 1\) 时可约,这是它和 Rabin 指纹的根本区别。
可约带来周期性。\(\mathrm{rot}^L\) 是恒等映射,所以距离恰好为 \(L\) 的两个相同字符会互相抵消。Uzgalis 自己写道,如果键经常以 32 个字符为周期重复,这组输入就散列不好;他的 Java 版本也是按长度小于 65 个字符的键设计的。
borg 1.4.1 的 _chunker.c 用的就是 32 位
Buzhash,窗口 4095
字节,文件头注释把这些问题写得很清楚:
- 哈希本来是为不超过 32 字节的输入设计的,而分块器用在 4095 字节的窗口上。窗口里任何相隔 32 字节的重复字节都可能抵消,例如在 “X <任意 31 字节> X” 中,后一个 X 抵消前一个 X 的影响。
- BUZ 要求表的每一位上 0/1 各占一半,但代码里写死的表并不满足。
- 窗口大小若能被 64 整除,种子会完全抵消掉,所以选了 4095。
最后一条和密钥有关。borg 把每个仓库的
chunk_seed
异或进整张表(table[i] = table_base[i] ^ seed)。注释也承认,整表异或一个常数等价于给哈希输出异或另一个常数;种子本身加密存储,作者认为它”仍然有用”。第九节会看到,这个判断在
2025 年被推翻了。
理论上的天花板
Lemire 与 Kaser 在 “Recursive n-gram hashing is pairwise independent, at best”(Computer Speech & Language 2010)中系统比较了几类可滚动的 n-gram 哈希。对任意递归(可滚动)哈希,他们证明其至多两两独立(pairwise independent),不可能三两独立。在这一族里:
- 用不可约多项式的一般多项式哈希(即 Rabin 指纹那一类)可以做到两两独立;
- 循环多项式哈希要求字长 \(L \ge n\),\(n\) 为偶数时连均匀都做不到,而且从不两两独立;丢弃 \(n - 1\) 个连续比特后,剩下的比特才两两独立。
也就是说,Buzhash 的速度是用独立性换来的。对分块来说这通常够用,因为切点只需要在自然数据上”看起来随机”;对需要概率保证的场合(相似度估计、去重身份)则不够。
Gear:只有移位和加法
Gear 哈希来自 Xia 等人的 Ddelta(Performance Evaluation 2014),FastCDC 沿用了它。它用 256 项 64 位随机表 \(G\),每字节只做
\[ \mathit{fp} \leftarrow (\mathit{fp} \ll 1) + G[b] \pmod{2^{64}} . \]
它没有显式的”移出”操作:\(k\) 步之前加入的 \(G[b]\) 已被左移 \(k\)
位,加法的进位只向高位传播,所以 \(\mathit{fp}\) 的第 \(j\) 位只取决于最近 \(j + 1\)
个字节。窗口宽度因此由判定掩码决定:只看低 13
位,切点就只取决于最近 13 个字节。FastCDC 把掩码的 1
分散到高位(论文算法 1 的
MaskA = 0x0000d90303530000,最高位是第 47
位),让判定依赖最近 48 个字节,与 LBFS 的 48
字节窗口相当。FastCDC 论文第 3 节指出,低 13 位掩码让 Gear
分块的窗口只剩 13 字节,而 Rabin 分块是 48 字节;第 4.2
节提出”往掩码里补零”来扩大窗口。论文表 3 显示,未补零的 Gear
分块在 TAR、WEB、VMA 三个数据集上去重率明显偏低,FastCDC 与
Rabin 分块的差距只有约 \(\pm 0.1\%
\sim 1.4\%\)。
第八节的实验在随机数据上比较这几种哈希,块大小分布几乎一样;它们的差别要在有结构的真实数据上才会显出来,本文没有做这部分实验。
七、rsync:固定分块加逐字节滚动,不是内容定义分块
rsync 常被说成内容定义分块的起点,这不准确。它解决的问题是:B 有旧文件,A 有新文件,两者之间带宽很低,怎样只传差异。Tridgell 与 Mackerras 1996 年的技术报告 TR-CS-96-05 给出算法,Tridgell 1999 年的博士论文 “Efficient Algorithms for Sorting and Synchronization” 第 3 章做了完整分析。
sequenceDiagram
    participant B as B (has old file)
    participant A as A (has new file)
    Note over B: cut old file into fixed blocks of L bytes
    B->>A: per block: weak rolling checksum + strong checksum
    Note over A: roll the weak checksum over EVERY byte offset
    Note over A: weak hit? then compute strong checksum to confirm
    A->>B: stream of "copy block j" tokens and literal bytes
    Note over B: rebuild new file from old blocks + literals
块边界只在 B 的旧文件上,而且是固定长度;A 这一侧没有块边界,它在每个字节偏移上都试一次。这样即使 A 的文件在开头插入了一个字节,旧文件的每个块仍能在偏移 1 处被找到。代价是 A 要在每个偏移上算一次弱校验和并查一次表,所以弱校验和必须能 \(O(1)\) 滚动。
弱校验和
论文第 3.2.5 节的快速签名对块 \(a_k, \ldots, a_{k+L-1}\) 定义
\[ r_1(k, L) = \sum_{i=0}^{L-1} a_{i+k} \bmod M, \qquad r_2(k, L) = \sum_{i=0}^{L-1} (L - i)\, a_{i+k} \bmod M , \]
\(r = r_1 + M r_2\),\(M = 2^{16}\),共 32 位。滚动更新是
\[ r_1(k+1, L) = r_1(k, L) - a_k + a_{k+L}, \qquad r_2(k+1, L) = r_2(k, L) - L\, a_k + r_1(k+1, L) . \]
论文脚注说,这一形式由 Paul Mackerras 提出,思路来自 zlib 的 Adler 校验和,并与 Karp-Rabin 的哈希有相似之处。它不是多项式哈希:\(r_2\) 的权重是线性的 \(L - i\),不是 \(b^{L-1-i}\),也没有任何随机参数。它只是一个初筛,弱校验和命中后还要用强校验和确认。
rsync v3.4.1 的实现与此一致。checksum.c 的
get_checksum1 返回
(s1 & 0xffff) + (s2 << 16);match.c
滚动时先做
s1 -= map[0] + CHAR_OFFSET; s2 -= k * (map[0] + CHAR_OFFSET);,CHAR_OFFSET
定义为 0。强校验和由两端协商,v3.4.1 的默认优先顺序是
xxh128、xxh3、xxh64、md5、md4。
块大小
论文第 3.3 节假设两个文件只有 \(Q\) 处差异、每处短于一个块,且彼此相距超过一个块。弱签名 4 字节、强签名 16 字节、匹配标记 4 字节时,传输量的主要部分是
\[ t(L) = \frac{24 n}{L} + Q (L - 4) , \]
在 \(L = \sqrt{24 n / Q}\) 处取最小。另一个约束是最坏情况:两个文件毫无共同块时,签名本身就是额外开销,要把它控制在文件大小的 1% 以内,块至少要 2000 字节。
rsync v3.4.1 的
generator.c(sum_sizes_sqroot)用的是简化版:未指定
--block-size 时,文件不超过 \(700^2\) 字节时块长取
700(BLOCK_SIZE),更大的文件取约 \(\sqrt{\text{len}}\)
并向下对齐到 8 的倍数,协议版本 30 以上上限为 128
KiB(MAX_BLOCK_SIZE)。所以”rsync 平均块 700
字节”的说法只对小于约 478 KiB 的文件成立,700
实际上是块长的下限。
和内容定义分块的区别
| rsync | 内容定义分块 | |
|---|---|---|
| 块边界 | 只在接收方旧文件上,固定长度 | 两侧都有,由内容决定 |
| 滚动哈希的作用 | 在每个偏移上查找已知块 | 决定哪里切一刀 |
| 对插入的反应 | 旧块仍能在新偏移处找到 | 只有插入点所在块改变 |
| 需要的交互 | 每次同步都要双方参与 | 块可以脱离对方单独索引和存储 |
最后一行是关键区别。rsync 的每一次同步都要接收方先发出签名;内容定义分块切出的块可以用哈希值命名、长期存进仓库,两份从未见过面的文件,只要内容相同,切出的块也相同。这正是去重存储需要的性质。
八、内容定义分块:从 LBFS 到 FastCDC
LBFS 的切分规则
内容定义分块(content-defined chunking,CDC)由 Muthitacharoen、Chen 与 Mazières 的低带宽网络文件系统 LBFS(SOSP 2001)带入存储系统。论文的规则是:对文件中每个重叠的 48 字节区域计算 Rabin 指纹,模数是一个预先确定的不可约多项式;当指纹的低 13 位等于某个选定的魔数时,这里就是一个断点(breakpoint)。在随机数据上,每个位置成为断点的概率是 \(2^{-13}\),期望块长 8 KiB。为了防止病态情况,LBFS 规定块长最小 2 KiB、最大 64 KiB,并指出一长串零字节永远不会产生断点,只能靠最大长度强制切开。块用 SHA-1 标识,LBFS 用它在服务端的数据库里查找已有的块。
LBFS 的相关工作部分引用了 Manber 1994 年在大型文件系统里找相似文件的工作,以及 Brin 等人 1995 年的拷贝检测。用子串指纹判断文档相似的研究后来还有 winnowing(Schleimer 等,SIGMOD 2003)和 MinHash,后者见 MinHash 与 SimHash。
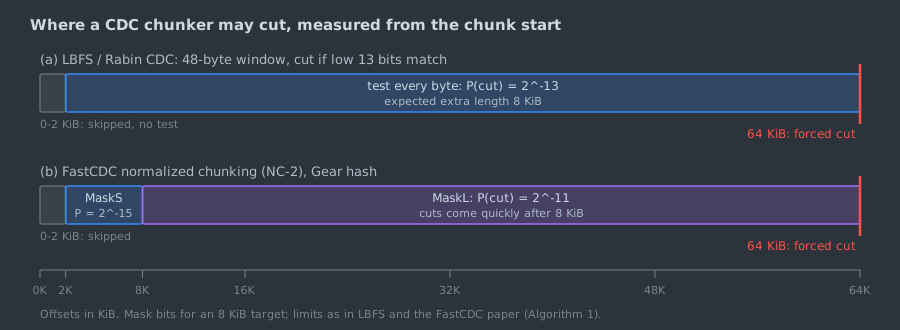
上图的横轴是从当前块起点算起的偏移。一个块的长度由三件事决定:最小长度之前完全不做判定;之后每个字节独立地以一定概率切开;到最大长度强制切开。FastCDC 的归一化分块(下半部分)把判定概率做成两段,后文再讲。
为什么插入一个字节只影响一个块
切点只取决于切点前一个窗口的内容。在某处插入一个字节,只有窗口覆盖到插入点的那些位置,切点判定才会改变;插入点之后再过一个窗口长度,判定又和原来完全一致,于是块边界重新和旧文件对齐。
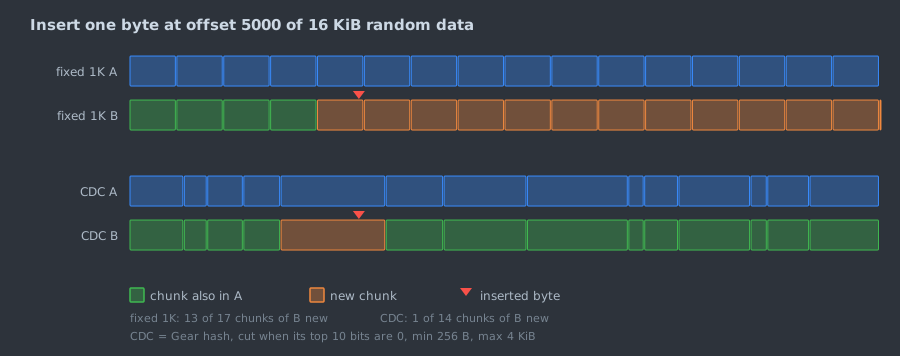
上图由 reproduce/draw_figures.py
实际切分生成(Gear 哈希,最高 10 位为 0 时切开,块长 256 B
到 4
KiB)。固定分块时,插入点之后的每个块都整体后移一个字节,内容全部变了;CDC
只有包含插入点的块变了,它后面的切点位置随数据一起后移一个字节,块的内容和旧文件完全相同。
块长服从截断的几何分布
把”每个位置以概率 \(q = 2^{-13}\) 独立切开”当作模型,不设上下限时块长服从几何分布,均值 \(1/q = 8192\),标准差也约为 \(1/q\)。小块非常多:长度小于 4 KiB 的概率是 \(1 - (1-q)^{4096} \approx 1 - e^{-1/2} \approx 39.3\%\)。
加上最小长度 \(m_{\min}\) 和最大长度 \(m_{\max}\) 后,均值变为
\[ E[\text{len}] = m_{\min} + \frac{1}{q} \Bigl( 1 - (1 - q)^{\,m_{\max} - m_{\min}} \Bigr) . \]
取 LBFS 的参数 \(m_{\min} = 2048\)、\(m_{\max} = 65536\),得 \(E \approx 10236\)。也就是说,“低 13 位、期望 8 KiB”加上 2 KiB 下限后,实际平均块长约 10 KiB;小于 4 KiB 的比例降到 \(1 - (1-q)^{2048} \approx 22.1\%\),撞到 64 KiB 上限的比例约 \((1-q)^{63488} \approx 0.043\%\)。
这个模型把切点判定当作独立事件。相邻位置的窗口大部分重叠,判定其实不独立,但对随机数据,好的滚动哈希在相邻位置上的输出足够接近独立,下面的实测和模型吻合。
FastCDC 的三处改动
Xia 等人的 FastCDC(USENIX ATC 2016)在 Gear 哈希的基础上做了三件事:
- 简化并加强哈希判定:掩码补零扩大有效窗口(第六节),判定写成
!(fp & mask),省掉与魔数的比较。 - 跳过切点:最小块长以内不计算哈希,直接跳过。
- 归一化分块(normalized chunking):以目标块长 8 KiB 为界,之前用 1 更多的 MaskS(NC-2 时 15 位,切开概率 \(2^{-15}\)),之后用 1 更少的 MaskL(11 位,概率 \(2^{-11}\))。小块被压制,大块很快被切掉,分布向目标值集中。NC-1、NC-2、NC-3 分别对应 (14, 12)、(15, 11)、(16, 10) 位。
论文在 i7-4770 上报告 FastCDC 比最好的开源 Rabin 分块快约 10 倍、比 Gear 和 AE 分块快约 3 倍,去重率接近 Rabin 分块。2020 年 TPDS 的扩展版加入了每次滚动两个字节的做法。
实验:块长分布
reproduce/cdc_sim.c 实现了六种分块器,都以 8
KiB 为目标(13 位掩码),除 rabin-unbounded
外都用 LBFS 的 2 KiB 最小、64 KiB 最大:
rabin:GF(2) 上随机 53 次不可约多项式、48 字节窗口,按 restic 的办法查表滚动,低 13 位为 0 时切开;buzhash:64 位 Buzhash,48 字节窗口;gear:Gear 哈希,低 13 位为 0 时切开(窗口实际只有 13 字节);fastcdc-nc0:Gear 加 FastCDC 的MaskA,不做归一化;fastcdc-nc2:FastCDC 论文算法 1,NC-2;fixed-8k:8 KiB 固定分块,作为对照。
D1 在 64 MiB 随机数据上统计块长(字节):
| 分块器 | 块数 | 均值 | 标准差 | p5 | p50 | p95 | 最大 | 小于 4 KiB | 等于上限 |
|---|---|---|---|---|---|---|---|---|---|
| rabin-unbounded | 8115 | 8268 | 8285 | 455 | 5580 | 25266 | 78550 | 39.7% | 0% |
| rabin | 6468 | 10374 | 8288 | 2547 | 7763 | 27391 | 65536 | 22.3% | 0.02% |
| buzhash | 6529 | 10278 | 8251 | 2473 | 7759 | 26735 | 65536 | 22.1% | 0.06% |
| gear | 6647 | 10095 | 8049 | 2454 | 7699 | 26313 | 65536 | 22.8% | 0.05% |
| fastcdc-nc0 | 6613 | 10146 | 8124 | 2481 | 7622 | 26129 | 65536 | 22.0% | 0.06% |
| fastcdc-nc2 | 7165 | 9366 | 2788 | 3750 | 9247 | 14017 | 25137 | 5.8% | 0% |
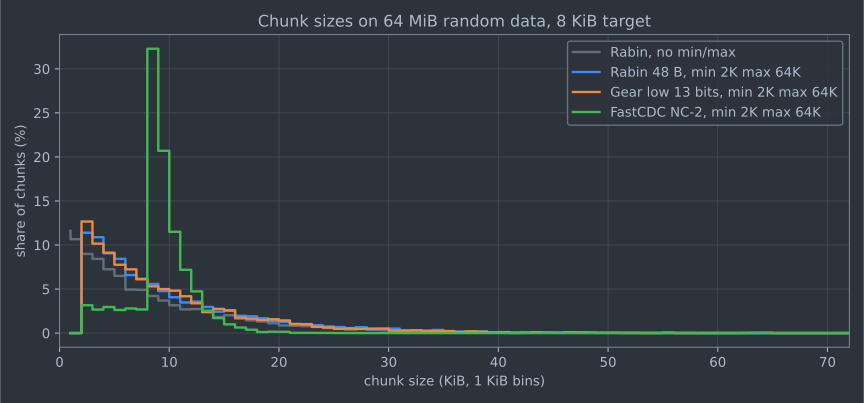
前五行与几何分布模型一致:无界时均值 8268、小块 39.7%(模型 8192、39.3%);有界时均值约 10.1 到 10.4 KiB,小块约 22%(模型 10236、22.1%)。四种哈希在随机数据上几乎没有差别。归一化分块把标准差从约 8 KiB 压到 2.8 KiB,p5 到 p95 的区间从 2.5 到 27 KiB 收窄到 3.7 到 14 KiB,最大块只有 25 KiB,一次都没有撞到上限。
实验:插入后的重复率与全零数据
D2 在 64 MiB 随机数据 A 的基础上构造 B,统计 B 中有多少块在 A 里找不到:
| 分块器 | 在偏移 1000000 插入 1 字节 | 随机插入 100 个字节 |
|---|---|---|
| rabin | 1 块,11686 B | 100 块,1722392 B |
| buzhash | 1 块,6563 B | 99 块,1703365 B |
| gear | 1 块,20203 B | 99 块,1811207 B |
| fastcdc-nc0 | 1 块,34701 B | 98 块,1448147 B |
| fastcdc-nc2 | 1 块,20157 B | 99 块,1020421 B |
| fixed-8k | 8071 / 8193 块,66109441 B | 8040 / 8193 块,65855588 B |
所有 CDC 变体都只为每次插入多存一个块左右,固定分块在第一次插入之后几乎全部作废。块数略少于 100,可能是有的插入落进了同一个块。
新增字节数比”100 个平均块长”大不少,这是检查悖论(inspection paradox):插入点落进某个块的概率与块长成正比,被命中的块的期望长度是
\[ \frac{E[L^2]}{E[L]} = E[L] + \frac{\mathrm{Var}[L]}{E[L]} . \]
代入 D1 的数据,rabin 为 \(10374 + 8288^2 / 10374 \approx
16995\),乘 100 约 1.70 MB,实测 1.72
MB;fastcdc-nc2 为 \(9366 + 2788^2 / 9366 \approx
10196\),乘 100 约 1.02 MB,实测 1.02
MB。buzhash 同样吻合;gear 与
fastcdc-nc0 分别预测 1.65 MB 与 1.67 MB,实测
1.81 MB 与 1.45 MB,偏差约 10% 与 13%,100
次插入的样本只能给出这个精度。所以归一化分块的收益主要来自方差变小:块长越集中,一次修改连带作废的数据越少。
D3 用 8 MiB 全零数据检验病态输入。rabin 切出
4096 个 2048 字节的块,其余分块器都切出 128 个 64 KiB
的块。原因是全零窗口的 Rabin 指纹恒为
0,而本文的判定条件是”低 13 位等于
0”,于是每到最小块长就切一刀。LBFS
把判定条件设成等于一个非零魔数,零串永远不会产生断点,只会被最大块长切开,这和论文的描述一致。
核对 restic 的真实分块器
reproduce/restic_check 直接调用
restic/chunker
v0.4.0,用一个固定种子导出的多项式(0x3eb00e4c9c9e35,53
次,不可约):8 MiB 全零切出 16 个 524288
字节的块,全部等于最小块长,与 D3 中 rabin
的行为相同;64 MiB 随机数据切出 42 个块,除末尾块外平均
1615525 字节,截断几何分布模型给出 1572284 字节,42
个样本的误差范围内一致。
实验:吞吐量
D4 在 64 MiB 随机数据上各跑 5 次取中位数(单位 MiB/s,数据已在内存,只计分块):
| rabin | buzhash | gear | fastcdc-nc0 | fastcdc-nc2 |
|---|---|---|---|---|
| 693 | 1877 | 2765 | 2817 | 2859 |
在这台机器和本文的实现下,Gear 系列比查表的 Rabin 快约 4 倍,比 Buzhash 快约 1.5 倍;FastCDC 的跳过和掩码技巧在 Gear 之上只多了约 3%。论文报告的约 10 倍对比的是另一套 Rabin 实现和另一代 CPU,两组数字不能直接比较,这里只能确认趋势。
生产系统的参数
| 系统(版本) | 滚动哈希 | 窗口 | 最小 / 最大 | 判定 | 目标均值 | 截断模型均值 |
|---|---|---|---|---|---|---|
| LBFS(SOSP 2001) | Rabin,固定多项式 | 48 B | 2 KiB / 64 KiB | 低 13 位等于魔数 | 8 KiB | 约 10 KiB |
| restic/chunker v0.4.0 | Rabin,每仓库随机 53 次多项式 | 64 B | 512 KiB / 8 MiB | 低 20 位为 0 | 1 MiB | 约 1.5 MiB |
| borg 1.4.1(文件数据) | 32 位 Buzhash,表异或仓库种子 | 4095 B | 512 KiB / 8 MiB | 低 21 位为 0 | 2 MiB | 约 2.45 MiB |
| borg 1.4.1(元数据流) | 同上 | 4095 B | 32 KiB / 512 KiB | 低 17 位为 0 | 128 KiB | 约 157 KiB |
| FastCDC 论文 NC-2 | Gear | 48 至 50 B | 2 KiB / 64 KiB | MaskS 15 位,MaskL 11 位 | 8 KiB | D1 实测 9366 B |
borg 的参数来自 constants.py 的
CHUNKER_PARAMS = (buzhash, 19, 23, 21, 4095) 与
ITEMS_CHUNKER_PARAMS = (buzhash, 15, 19, 17, 4095),四个数分别是最小块长、最大块长、掩码位数的以
2 为底的指数和窗口大小。FastCDC
的窗口由掩码最高位决定:MaskL 最高位是第 47
位,MaskS 是第 49 位。最后一列除 FastCDC
外按本节的截断几何分布公式计算。borg 的最大块长只是均值的约
3.3 倍,按模型约 2.4% 的块会撞到 8 MiB 上限,比 LBFS
参数下的 0.04% 高得多。
九、争论与开放问题
自然溢出还是素数模
竞赛圈对 \(2^{64}\) 自然溢出的争论已经有了结论:第四节的构造对任何奇数基数都成立,随机化基数救不了它,只能换模数。反对素数模的理由通常是速度,但 \(2^{61} - 1\) 只多一次 128 位乘法和两次加法。真正值得讨论的是”对手是谁”:若输入不可能被针对(例如离线处理自己生成的数据),固定参数加命中后验证是合理的工程选择;若输入来自对手(竞赛的 hack 阶段、公网服务),参数必须在运行时随机选取,且对手看不到。
CDC 需要多好的哈希
这个问题没有定论。一方的证据是 FastCDC 论文表 3:13 字节窗口的 Gear 分块在 TAR、WEB、VMA 上去重率明显变差,论文把原因归于滑动窗口太小。另一方的证据是,补零把窗口扩到 48 字节后,Gear 与 Rabin 的去重率只差 \(\pm 0.1\% \sim 1.4\%\),尽管 Gear 在 Lemire–Kaser 的意义下连两两独立都谈不上。borg 的 Buzhash 有已知的 32 字节周期抵消,至今也没有公开数据显示它损害了去重率。
目前的理解是:切点只要在自然数据上”足够随机”、窗口足够长即可,独立性这类理论指标几乎不影响去重率。但评估大多出自提出新算法的论文,使用各自的数据集,缺少公认的基准。本文只在随机数据上做了实验,也回答不了这个问题。
带密钥的 CDC 并不保密
加密备份里,块的内容被加密了,块的长度和边界却看得见。如果切点只由公开算法决定,攻击者可以把已知文件的块长序列当作指纹,判断备份里是否有这个文件。所以 restic 为每个仓库随机选多项式,borg 把种子异或进 Buzhash 的表,都是想让切点依赖一个秘密。
Truong、Merz、Scarlata、Günther 与 Paterson 的 “Breaking and Fixing Content-Defined Chunking”(ACM CCS 2025)表明这些秘密守不住。他们对 Borg、Bupstash、Duplicacy、Restic、Tarsnap 给出了密钥恢复攻击:
- Borg:秘密的有效熵只有 21 比特,已知一个块的明文就能恢复。这与 borg 源码注释自己承认的性质一致:整表异或一个常数,等于给输出异或另一个常数,而切点只看低 21 位。
- Restic:Rabin 指纹对输入是 GF(2) 上线性的,观察足够多触发切分的窗口后,在 \(\mathbb{F}_2\) 上解线性方程组即可恢复多项式。
Rabin 1981 年的碰撞界说的是”对手不知道 \(P\) 时碰撞概率很小”,从没说过”看到切分结果后对手仍不知道 \(P\)“。第二节到第五节的随机参数,保证的都是前一件事。论文提出的修复是先用全域哈希(universal hash)压缩窗口、再过一个伪随机函数(例如截断的分组密码)做判定。Alexeev、Percival 与 Zhang 的预印本”Chunking Attacks on File Backup Services using Content-Defined Chunking”(IACR ePrint 2025)也分析了 Tarsnap 等服务的分块器,文中提到 Tarsnap 1.0.41 已加入 PADME 填充和禁止小字母表循环等缓解措施。
开放问题
- CDC 的安全定义。即使切点由伪随机函数决定,块长序列仍然泄漏信息。允许泄漏多少、怎样用填充换取隐私、代价多大,还没有被普遍接受的形式化定义。
- 去重率的理论模型。几何分布模型能解释随机数据上的块长,却解释不了真实数据上 Gear 窗口过短为什么掉去重率,更无法事先预测一个数据集的去重率。
- 多项式哈希的最坏情况构造。随机基的 \((n-1)/p\) 界是紧的,但对具体的固定参数,找到碰撞对的最短长度和最快算法(生日攻击、树攻击、格基约化之间的取舍)仍主要见于竞赛社区的博客,缺少系统的学术整理。
十、工程选型与常见错误
| 场景 | 推荐做法 | 常见错误 |
|---|---|---|
| 单模式匹配、子串比较 | 模 \(2^{61}-1\)、运行时随机选基,命中后比较原文 | 模 \(2^{64}\) 自然溢出;固定基数加固定小素数 |
| 用哈希值代替串做去重 | 按生日界选位数,必要时换用密码学哈希 | 只看单对碰撞概率,忽视 \(\binom{k}{2}\) 对比较 |
| 双哈希 | 两组参数都在运行时独立随机 | 两个写死的 32 位模数,以为概率自动相乘 |
| 字节编码 | 先比较长度,或把字节映射到 \(1..256\) | 字节 0 让 “a” 与 “\0a” 碰撞 |
| 增量同步(两端在线) | rsync 式固定块加逐字节弱校验和 | 把 rsync 当成内容定义分块 |
| 去重存储 | Gear/FastCDC 或 Rabin CDC,设最小、最大块长,用密码学哈希标识块 | 不设最大块长,零串等低熵数据切不开;用 64 位指纹当块的身份 |
| 加密备份 | 把块长泄漏当作威胁建模的一部分 | 以为给分块器加一个种子就能隐藏边界 |
| 哈希表接收外部输入 | 带密钥的哈希(见第 13 篇) | 用可滚动的多项式哈希做表的散列函数 |
十一、参考资料
源码(版本均已钉住)
- restic/chunker
v0.4.0(
https://github.com/restic/chunker):chunker.go(windowSize、MinSize、MaxSize、splitmask、fillTables()、Next()、updateDigest());polynomials.go(RandomPolynomial()、DerivePolynomial()、Irreducible())。 - restic v0.17.3:
go.mod(钉住 chunker v0.4.0);internal/restic/config.go(CreateConfig()与ChunkerPolynomial字段)。 - borg
1.4.1:
src/borg/_chunker.c(文件头注释、buzhash_init_table()、buzhash_update()、切分主循环);src/borg/constants.py(CHUNKER_PARAMS、ITEMS_CHUNKER_PARAMS、HASH_WINDOW_SIZE);src/borg/crypto/key.py(chunk_seed)。 - rsync
v3.4.1:
rsync.h(BLOCK_SIZE、MAX_BLOCK_SIZE、CHAR_OFFSET);generator.c(sum_sizes_sqroot());checksum.c(get_checksum1()、强校验和协商顺序);match.c(滚动更新)。 - git
v2.46.0:
diff-delta.c(RABIN_WINDOW、RABIN_SHIFT、HASH_LIMIT、create_delta_index()、create_delta())。 - Go
1.26.4:
src/internal/bytealg/bytealg.go(PrimeRK、HashStr()、IndexRabinKarp());src/internal/stringslite/strings.go(Index())。
核心论文
- R. M. Karp, M. O. Rabin. Efficient randomized pattern-matching algorithms. IBM Journal of Research and Development 31(2):249–260, 1987. doi:10.1147/rd.312.0249
- M. O. Rabin. Fingerprinting by random polynomials. Technical Report TR-15-81, Center for Research in Computing Technology, Harvard University, 1981.
- A. Muthitacharoen, B. Chen, D. Mazières. A low-bandwidth network file system. SOSP 2001, 174–187. doi:10.1145/502034.502052
- Xia, Zhou, Jiang, Feng, Hua, Hu, Liu, Zhang. FastCDC: a fast and efficient content-defined chunking approach for data deduplication. USENIX ATC 2016, 101–114.
- A. Tridgell. Efficient Algorithms for Sorting and Synchronization. PhD thesis, Australian National University, 1999.
- A. Tridgell, P. Mackerras. The rsync algorithm. Technical Report TR-CS-96-05, Australian National University, 1996.
- Truong, Merz, Scarlata, Günther, Paterson. Breaking and fixing content-defined chunking. ACM CCS 2025, 2294–2308. doi:10.1145/3719027.3744870;IACR ePrint 2025/558.
其他论文
- A. Z. Broder. Some applications of Rabin’s fingerprinting method. In Sequences II: Methods in Communication, Security, and Computer Science, Springer, 1993, 143–152.
- D. Lemire, O. Kaser. Recursive n-gram hashing is pairwise independent, at best. Computer Speech & Language 24(4):698–710, 2010. doi:10.1016/j.csl.2009.12.001;arXiv:0705.4676
- J. Pachocki, J. Radoszewski. Where to use and how not to use polynomial string hashing. Olympiads in Informatics 7:90–100, 2013.
- W. Xia 等. Ddelta: a deduplication-inspired fast delta compression approach. Performance Evaluation 79:258–272, 2014.
- W. Xia 等. The design of fast content-defined chunking for data deduplication based storage systems. IEEE Transactions on Parallel and Distributed Systems, 2020.
- S. Schleimer, D. S. Wilkerson, A. Aiken. Winnowing: local algorithms for document fingerprinting. SIGMOD 2003, 76–85. doi:10.1145/872757.872770
- U. Manber. Finding similar files in a large file system. USENIX Winter 1994 Technical Conference.
- S. Brin, J. Davis, H. Garcia-Molina. Copy detection mechanisms for digital documents. SIGMOD 1995.
- Alexeev, Percival, Zhang. Chunking attacks on file backup services using content-defined chunking. IACR ePrint, 2025(预印本)。
工程资料
- dacin21(Daniel Rutschmann). On the mathematics behind
rolling hashes and anti-hash tests. Codeforces 博客 entry
60442,
2018(
https://codeforces.com/blog/entry/60442)。 - R. Uzgalis(BUZ). 关于 Buzhash
的讲义页面(
http://www.serve.net/buz/Notes.1st.year/HTML/C6/rand.012.html,borg_chunker.c注释中引用的地址)。 - Akhmedov 2012 年在 Codeforces 上关于 Thue–Morse 反哈希测试的讨论,经 Pachocki 与 Radoszewski 的论文转引,本文未直接核对原帖。
实验
- 本文目录下的
reproduce/:rk.c(Rabin-Karp 与朴素搜索对拍)、hash_collide.c(E1 Thue–Morse、E2 紧性、E3 生日效应)、cdc_sim.c(D1 到 D4:块长分布、插入后的重复率、全零数据、吞吐量)、restic_check/(调用 restic/chunker v0.4.0 的核对程序)、draw_figures.py与plot_chunk_sizes.py(生成本文四张图)、run.sh,以及results/中的原始输出。
系列导航: - 上一篇:编辑距离与模糊匹配:Wagner-Fischer、位并行与 Levenshtein 自动机 - 下一篇:SIMD 字节扫描:memchr 的页边界、PCMPISTRI 的代价与 JSON/CSV 的引号掩码
相关阅读: - 密码学哈希与非密码学哈希:安全定义、迭代构造与哈希洪泛 - AC 自动机:失败链接、输出链接与转移表布局 - MinHash 与 SimHash:近重复检测的相似度草图与候选生成
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
字符串匹配算法选型索引
字符串匹配算法工程选型:KMP、Boyer-Moore(BM)、Rabin-Karp、AC 自动机、后缀数组、SIMD 与模糊匹配——按场景选算法,附本站深度文章导航。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。