给定 \(k\)
个模式串和一段长为 \(n\)
的文本,找出所有模式的所有出现位置。逐个模式各扫一遍文本,代价随
\(k\)
线性增长:本文实验里,对 1 MiB 随机字节文本调用 1000 次
glibc memmem,每字节约 77 ns,而位图 NFA 或满表
DFA 形式的 AC 自动机在同样输入上约为每字节 5 ns。Aho 与
Corasick 1975 年的论文把扫描代价变成与 \(k\)
无关的”每个文本字符不到两次状态转移”。
围绕 AC 自动机流传的几种说法都需要修正。“AC 是 \(O(n)\) 的,所以快”只说对了一半:状态数上到十万量级后,决定速度的是转移表的布局和缓存占用,同一个自动机换一种存法,扫描速度可以差三四倍(第七节)。“Hyperscan 用 SIMD 加速 AC”是错的:Hyperscan 的字面量匹配器是 FDR 和 Teddy,论文把 AC 当作对比基线(第八节)。“输出时间是 \(O(n+z)\),所以没有问题”也要看 \(z\):它可以达到 \(nk\) 量级(第五节)。
KMP 的失败函数本站在 字符串匹配算法:KMP 与
Boyer-Moore(BM)详解 里讲过,单模式与多模式的选型见 字符串匹配算法选型索引。本文只讲多模式的部分:goto、失败、输出三个函数怎样构造(第一到五节),DFA
化与四种转移表布局的内存和扫描代价(第六、七节),生产系统在钉住版本的源码里实际怎么做(第八节),以及仍有争议的问题(第九节)。实验程序是同目录的
reproduce/ac.c,所有布局都与朴素多模式匹配做了差分测试。
一、问题与记号
模式集 \(P=\{p_1,\dots,p_k\}\),总长 \(m=\sum_i |p_i|\);文本 \(T=T[0..n-1]\);字母表 \(\Sigma\),大小 \(\sigma\)(字节串时 \(\sigma=256\));输出总数记为 \(z\)。本文默认标准语义(standard semantics):报告所有二元组 \((i,j)\),使 \(p_i\) 恰好在位置 \(j\) 结束,允许重叠。第九节再讨论最左优先等其他语义。
朴素做法对每个模式各扫一遍,最好情况也是 \(\Theta(kn)\) 次字符比较量级;原论文第 5 节正是用这一点说明动机。AC 自动机的结论是:
- 构造时间与 \(m\) 成正比(原文 Theorem 3、4,前提是 goto 查询为常数时间);
- 扫描时状态转移少于 \(2n\) 次,与 \(k\) 无关(原文 Theorem 2);
- 再加上报告 \(z\) 个结果的代价。
自动机的状态就是 Trie 的结点,每个状态代表一个字符串,即某个模式的前缀。整个算法围绕一个不变式(原文 Lemma 3):读完 \(T[0..j]\) 后,自动机所在状态代表的,是 \(T[0..j]\) 的后缀中同时是某个模式前缀的最长者。失败函数负责在失配时维持这个不变式,输出函数负责从这个状态读出所有在 \(j\) 结束的模式。
二、goto 函数:模式集的 Trie
goto 函数(goto function)\(g(s,a)\) 就是模式集的 Trie:从根出发,沿字符边走,每个模式对应一条路径,终点标记为接受状态。原文 Algorithm 2 按模式顺序插入,新结点依次编号。对 \(\{he, she, his, hers\}\) 得到 10 个状态:
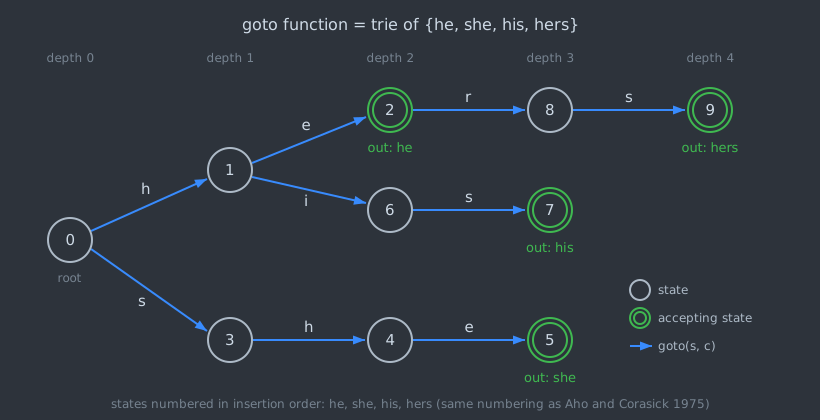
编号与原论文 Figure 1 一致,后文的失败函数值可以直接和原文对照。原文还规定根上所有没有出边的字符都回到根自己,即对所有 \(a\),\(g(0,a)\ne \text{fail}\)。这条自环保证每个文本字符恰好完成一次 goto 转移,后面的复杂度证明要用到它。
Trie 的存法决定了后文所有布局的差别。原文第 5 节已经列出三种:二维数组(常数时间查询,内存 \(S\times\sigma\)),每个状态一张只含非失败值的线性表,以及二者折中,把最常用的状态(例如状态 0)存成直接索引表、其余状态存成线性表;另外还提到可以用二叉搜索树。半个世纪后的生产实现仍在这几种之间取舍。
三、失败函数:按 BFS 层序计算
定义与 KMP 的关系
失败函数(failure function)\(f(s)\) 指向这样一个状态:它代表 \(s\) 所代表字符串的最长真后缀,并且这个后缀是某个模式的前缀(原文 Lemma 1)。在状态 \(s\) 读到字符 \(a\) 而 \(g(s,a)\) 不存在时,自动机退到 \(f(s)\) 再试,直到成功或回到根。
模式集只有一个模式时,Trie 退化成一条链,\(f\) 就是 KMP 的前缀函数。原文明确说 Algorithm 1 仿照 KMP 算法设计,也可以看作 Knuth 书中 Trie 查找的推广;原文还提到 Hopcroft 与 Karp 未发表的一个类似方案,用来找任一关键字的第一次出现。前缀函数本身的推导见 KMP 与 Boyer-Moore,这里只讲多模式带来的变化:后缀可能落在另一条分支上,所以失败链接会跨分支。
构造:为什么是 BFS
\(f(s)\) 代表的串比 \(s\) 短,所以 \(f(s)\) 的深度严格小于 \(s\)。按深度从小到大(BFS 层序)处理,算 \(f(s)\) 时所有更浅的状态都已就绪。设 \(s=g(r,a)\),从 \(t=f(r)\) 开始沿失败链往上找第一个有 \(a\) 出边的状态:
\[ f(s)=g(t^\ast,a),\qquad t^\ast=\text{沿 } f(r), f(f(r)),\dots \text{ 找到的第一个满足 } g(t,a)\ne\text{fail} \text{ 的状态} \]
根对所有字符都有出边,所以这个查找一定终止。深度为 1 的状态失败链接都指向根。
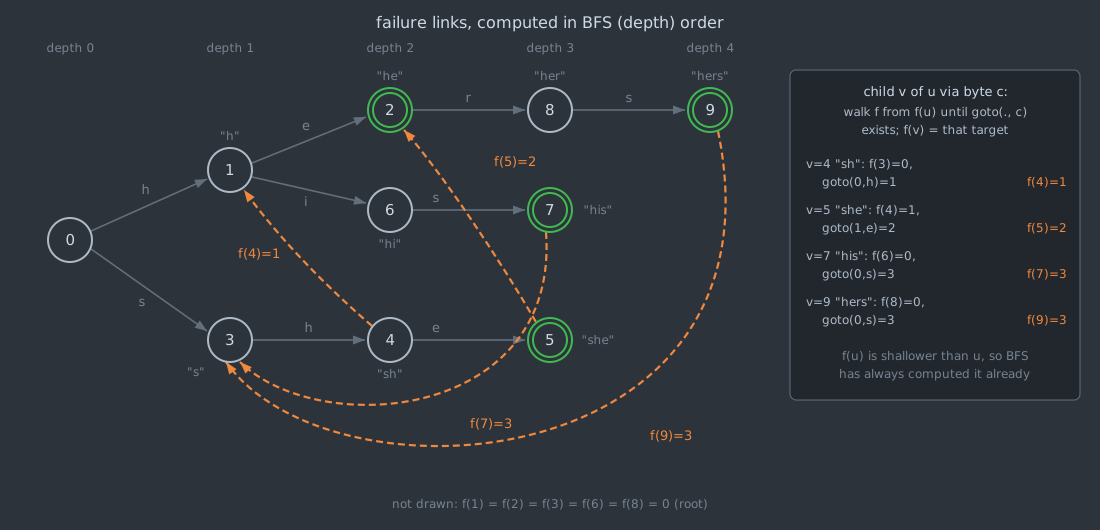
以 \(f(5)\) 为例:\(5=g(4,e)\),\(f(4)=1\),而 \(g(1,e)=2\) 存在,所以 \(f(5)=2\),即 “she” 的最长真后缀中是模式前缀的是 “he”。\(f(9)\):\(9=g(8,s)\),\(f(8)=0\),\(g(0,s)=3\),所以 \(f(9)=3\)。算出来的 \(f(1..9)=0,0,0,1,2,0,3,0,3\),与原文 Figure 1(b) 相同。
reproduce/ac.c 的构造与原文 Algorithm 3
一一对应(摘自
ac_build(),删去了数组分配):
while (head < tail) {
    int32_t u = a->bfs[head++];
    for (int32_t v = a->n[u].first_child; v >= 0; v = a->n[v].next_sibling) {
        uint8_t c = a->n[v].label;
        int32_t f = 0;
        if (u != 0) {
            f = a->n[u].fail;
            while (f != 0 && trie_child(a, f, c) < 0)
                f = a->n[f].fail;
            int32_t g = trie_child(a, f, c);
            f = g >= 0 ? g : 0;
        }
        a->n[v].fail = f;
        a->n[v].out_link = a->n[f].out_head >= 0 ? f : a->n[f].out_link;
        a->bfs[tail++] = v;
    }
}
内层 while
的总执行次数是有界的:固定一个模式,沿它的路径逐层计算时,变量
f 的深度每下一层最多加
1,每次沿失败链后退至少减
1,所以对这个模式的后退总次数不超过 \(|p_i|\)。对所有模式求和,内层循环总共不超过
\(m\) 次(原文 Theorem 4
的论证)。前提是 trie_child
为常数时间;若出边存成有序数组用二分查找,构造变成 \(O(m\log\sigma)\)。Dori 与
Landau(IPL 2006)给出了整数字母表上与 \(\sigma\)
无关的线性时间构造。
原文还指出 Algorithm 3 的 \(f\) 不是最优的:在状态 4 读到的字符不是 e 时会退到 1,但状态 1 上唯一可能成功的 e 已经被排除,这一步是多余的。原文给出的改进 \(f'\) 推广了 KMP 中的 next 函数,而彻底消除失败转移的办法是第六节的 DFA。
四、搜索:每字节一次 goto,失败转移总数少于 n
搜索过程(原文 Algorithm
1):对每个文本字符,先沿失败链后退直到 goto 成功,再走一步
goto,然后报告当前状态的输出。在 “ushers” 上运行
./ac demo,逐字符轨迹如下(位置从 0 计,匹配写成"模式@起始位置“):
| 位置 | 字符 | 状态变化 | 失败转移 | 报告 |
|---|---|---|---|---|
| 0 | u | 0 → 0 | 0 | |
| 1 | s | 0 → 3 | 0 | |
| 2 | h | 3 → 4 | 0 | |
| 3 | e | 4 → 5 | 0 | she@1,he@2 |
| 4 | r | 5 → 2 → 8 | 1 | |
| 5 | s | 8 → 9 | 0 | hers@2 |
这与原文 Figure 2 的状态序列 0 0 3 4 5 (2) 8 9 相同。位置 4 上,\(g(5,r)\) 失败,退到 \(f(5)=2\),再由 \(g(2,r)=8\) 前进,一个字符用了两次转移。
2n 界
定理(原文 Theorem 2):搜索长为 \(n\) 的文本,状态转移总数少于 \(2n\)。
证明:以当前状态的深度作势能。每个字符恰好一次 goto 转移,深度最多加 1(根上的自环不加);每次失败转移深度至少减 1。深度始终非负,而第 \(j\) 个字符上的失败转移只能消耗前 \(j-1\) 个字符积累的深度,所以失败转移总数 \(F\le n-1\),总转移数 \(n+F<2n\)。\(\blacksquare\)
这是摊还界。单个字符上的失败转移可以多达当前深度 \(d\)
次,原文脚注特别说明了这一点,并提到单模式时 KMP
可以把它压到 \(O(\log
d)\)。./ac worst 64 1048576
构造了这种情况:模式 \(a^{64}\),文本 \((a^{64}b)^\ast\)。每个 b
都要把整条失败链走完:
| 模式 | 平均每字节失败转移 | 单字节最多失败转移 |
|---|---|---|
| \(a^{16}\) | 0.9412 | 16 |
| \(a^{64}\) | 0.9846 | 64 |
| 随机,\(\sigma=4\),\(k=10{,}000\) | 0.8557 | 6 |
| 随机,\(\sigma=256\),\(k=10{,}000\) | 0.9982 | 3 |
平均值都在 1
以下,与定理一致;但对按包处理、有单包时延要求的系统,单字节
64 次后退是真实存在的尖峰。随机输入的最后两行也值得注意:NFA
形式几乎每个字节都要做一次失败转移;除了根状态的直接查表,每字节还要在非根状态上做约
1.86 次(\(\sigma=4\))或
1.26 次(\(\sigma=256\))goto 查询,对应
Snort bnfa_search.c 文件头注释里的说法:“NFA
可能需要 DFA 两倍的状态转移”。
五、输出函数:输出链接与 z 的上界
一个状态可能要报告多个模式
到达状态 5(“she”)时,除了 she 本身,它的后缀 he 也是模式。一般地,状态 \(s\) 应报告的模式集合是 \(s\) 自己的模式,加上失败链 \(f(s), f(f(s)),\dots\) 上所有接受状态的模式。原文 Algorithm 3 在算出 \(f(s)\) 后执行 \(output(s)\leftarrow output(s)\cup output(f(s))\),所以 Figure 1(c) 里 \(output(5)=\{she, he\}\)。Theorem 4 的证明补充说,两个集合此时不相交,用链表表示可以常数时间合并。
现代实现通常把这件事写成显式的输出链接(output link,也叫 dictionary suffix link):
\[ out(s)=\begin{cases} f(s), & f(s) \text{ 是接受状态}\\ out(f(s)), & \text{否则}\end{cases} \]
它跳过失败链上不报告任何东西的状态。报告时先输出 \(s\) 自己的模式,再沿 \(out\)
走到根为止,每一步都至少输出一个模式,所以报告代价是 \(O(1+\text{输出数})\)。如果不建输出链接、在每个位置沿失败链逐个检查,那么没有任何匹配的字节也可能付出与深度成正比的代价。\(out\) 同样按 BFS
层序计算,就是第三节代码里 out_link
那一行。原文的”链表共享尾部”与输出链接在效果上等价,只是后者不复制、不修改链表,便于把输出存成只读数组。
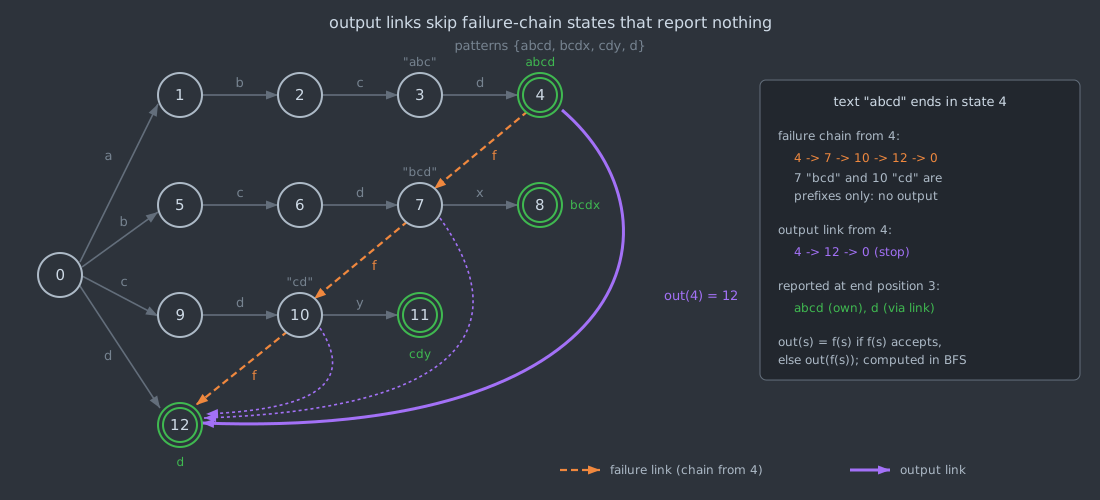
./ac demo 的第二组例子验证了这张图:在
“abcd” 上,位置 3 到达状态 4,报告 abcd@0 和 d@3,访问了 2 个输出结点,而失败链上的
7、10 没有被访问。
输出总数可以是 nk 量级
在同一个结束位置 \(j\),所有匹配都是 \(T[0..j]\) 的后缀,长度互不相同。所以若模式集有 \(L\) 种不同长度,则 \(z\le nL\le nk\)。原文第 5 节给了达到这个量级的例子:\(P=\{a,a^2,\dots,a^k\}\),文本 \(a^n\),此时
\[ z=\sum_{i=1}^{k}(n-i+1)=nk-\frac{k(k-1)}{2}. \]
./ac worst 在 \(n=2^{20}\)
上的实测与公式一致:\(k=16\) 时 \(z=16{,}777{,}096\),\(k=64\) 时 \(z=67{,}106{,}848\),输出链接的访问次数与
\(z\)
相等。原文的态度是:任何算法都必须输出同样多的结果,所以比较算法应该看识别位置的代价。工程上的出路是改需求:只需要计数或只需要判断是否命中时,BFS
时顺手算出 \(cnt(s)=|own(s)|+cnt(out(s))\),扫描时每字节一次加法即可,count_only
一列在两个最坏例子上得到了同样的 \(z\)。IDS
这类系统面对的是可被攻击者控制的文本,输出爆炸和失败链尖峰都属于需要预先设防的输入,见第九节。
六、DFA 化:预先走完所有失败转移
原文第 6 节用确定有限自动机(Deterministic Finite Automaton,DFA)的转移函数 \(\delta\) 取代 goto 和失败函数,Algorithm 4 按 BFS 层序计算:
\[ \delta(s,a)=\begin{cases} g(s,a), & g(s,a)\ne\text{fail}\\ \delta(f(s),a), & \text{否则}\end{cases} \]
\(f(s)\)
更浅,所以它的整行在处理 \(s\)
时已经算好。实现上最直接的写法是整行复制再覆盖(摘自
ac_build()):
for (int32_t i = 1; i < ns; i++) {
    int32_t u = a->bfs[i];
    int32_t *row = a->dfa + (size_t)u * 256;
    const int32_t *frow = a->dfa + (size_t)a->n[u].fail * 256;
    memcpy(row, frow, 256 * sizeof(int32_t));
    for (int32_t j = a->sp_off[u]; j < a->sp_off[u + 1]; j++)
        row[a->sp_lab[j]] = a->sp_to[j];
}
构造时间和空间都是 \(\Theta(S\sigma)\),\(S\)
为状态数。例子中各状态指向非根状态的转移如下,带星号的是 DFA
构造新增、Trie 里没有的边(./ac demo
输出):
| 状态 | 转移 |
|---|---|
| 0 | h→1,s→3 |
| 1 | e→2,i→6,h→1*,s→3* |
| 2 | r→8,h→1*,s→3* |
| 3 | h→4,s→3* |
| 4 | e→5,h→1*,i→6*,s→3* |
| 5 | h→1*,r→8*,s→3* |
| 6 | s→7,h→1* |
| 7 | h→4*,s→3* |
| 8 | s→9,h→1* |
| 9 | h→4*,s→3* |
与原文 Figure 3 对照:原文用”其余字符转到 0”的默认项压缩存储这张表,并指出这样存仍比 goto 函数占地方,因为每个状态都继承了失败链上多个状态的边。
DFA 保证每个字符恰好一次转移。原文对收益的估计很克制:最多减少 50% 的状态转移,但”实际中几乎不可能达到”,因为典型应用大部分时间停在没有失败转移的状态 0。原文第 7 节还报告,他们的书目检索程序允许关键字前后带标点类,这会产生出边很多的状态,使 DFA 版本更占空间、在某些应用里不那么有吸引力。
内存是 DFA 的主要代价。每状态 256 个 4
字节表项,就是每状态 1 KiB。本文随机模式集在 \(\sigma=256\)、\(k=10{,}000\) 时有 109,140
个状态,满表约 112 MB;状态数超过 \(2^{16}\),也无法改用 16
位表项。Suricata 8.0.0 的 util-mpm-ac.c
正是这种满表:SCACCreateDeltaTable() 建 256
列的表,状态数小于 \(2^{16}\) 时用 16 位表项,否则用
32 位,文件头注释直说这个实现”heavy on memory”。
七、转移表压缩:四种布局的内存与扫描代价
四种布局
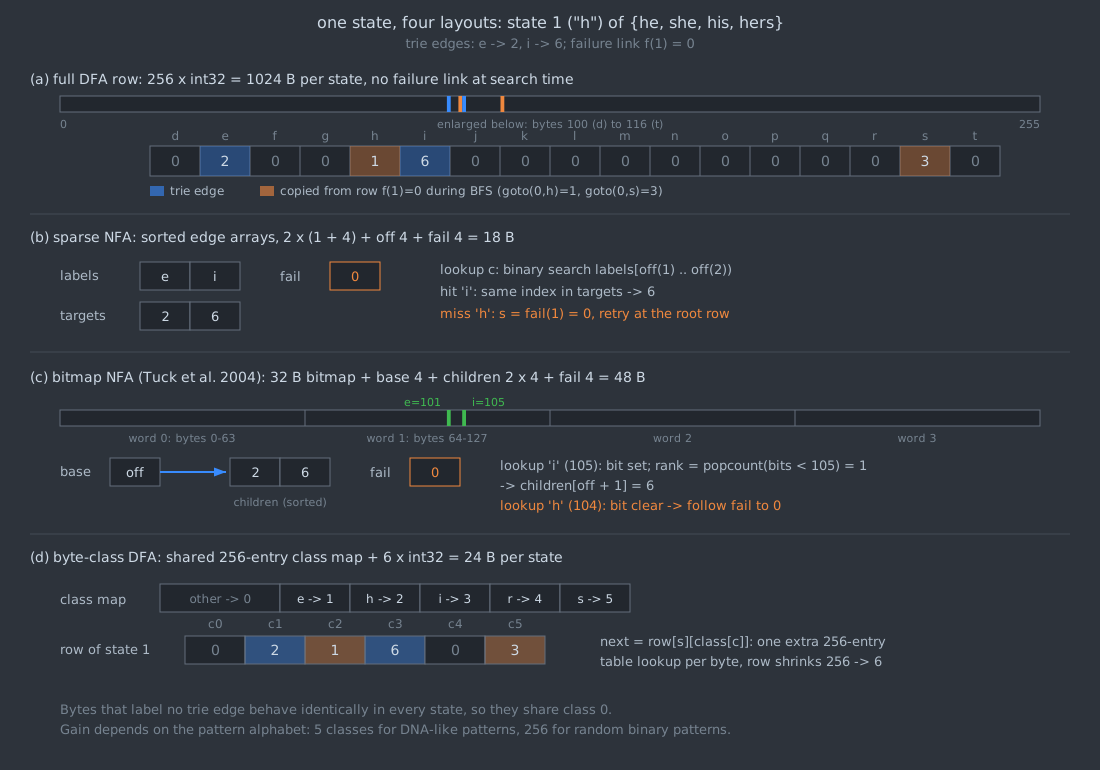
- 满表 DFA:一次访存完成一次转移,每状态 \(4\sigma\) 字节。
- 稀疏
NFA:每状态一段有序的(标签,目标)数组,失配走失败链接。每条边
5 字节。Snort 2 的
bnfa_search.c是这一路线:压缩稀疏数组,状态出边多于 5 条时改用二分查找,根状态保留完整的 256 项表。本文的实现同样给根一张完整的表。 - 位图 NFA:Tuck、Sherwood、Calder 与 Varghese(INFOCOM 2004)借鉴 IP 查找中的树位图,每状态存 256 位出边位图和指向子结点数组的指针,用 popcount 求字符在子结点中的序号。他们报告在 32 位指针下,结点从 1028 字节降到 44 字节;配合对 Trie 下层的路径压缩,Snort 规则集的内存从 53.1 MB 降到 1.09 MB。代价是必须用带失败链接的形式,论文自己说这使每字符最坏工作量翻倍。
- 字节类
DFA:不出现在任何模式里的字节在所有状态上行为相同,可以合并成一个类。Rust
aho-corasickcrate 的DESIGN.md称字节类(equivalence classes)与预乘状态 ID 总是开启:全是 ASCII 字母的模式集只需 53 个类,代价是每字节多查一次 256 项的映射表。本文的实现只做最简单的合并(所有未用字节归入类 0),不是最优的等价类划分。
所有布局还要存每个状态的输出入口(4 字节)。下表的字节数都包含它。
实验环境与口径
- 程序:
reproduce/ac.c,在reproduce/下执行sh run.sh 7,即gcc -O2 -Wall -Wextra -o ac ac.c后依次运行demo、test、stats、worst和bench,计时部分用taskset -c 7绑核。另用-O1 -g -fsanitize=address,undefined编译跑过测试、统计和基准,没有报告。 - 正确性:
./ac test 5000 1生成 5000 组随机用例,字母表大小取 1、2、3、4、26、256,\(k\) 取 1 到 40,含重复模式、互为前缀和互为后缀的模式,文本长至 3000。稀疏 NFA、位图 NFA、满表 DFA、字节类 DFA、分块流式 DFA(跨块保留状态)和只计数版本全部与朴素多模式匹配逐条一致,共比较 33,652,966 个匹配;同时检查失败转移总数不超过 \(n\)。 - 输入:\(k\) 个长 8 到 16 的随机模式,文本 1 MiB 随机串,种子 1。\(\sigma=4\) 模拟 DNA 这类小字母表,\(\sigma=256\) 是随机字节。
- 环境:Intel Core i9-12900K,
lscpu报告 L1d 每核 48 KiB、L2 共 15 MiB(12 个实例)、L3 30 MiB;WSL2 内核 6.6.87.2,GCC 16.1.1。 - “触及字节”是与时钟无关的指标:模拟一次完整扫描,统计每种布局访问到的不同 64 字节缓存行数,再乘以 64,近似扫描的工作集。
- 计时:每个配置运行 5 次取中位数,整个脚本运行 3 次,图表取 3 个中位数的中位数。机器上同时有其他负载,同一配置在两轮脚本之间最多相差一倍,计时只看相对趋势。
内存与工作集
单位 MB 为 \(10^6\)
字节(./ac stats 输出):
| 配置 | 状态数 | 满表 DFA | 字节类 DFA | 稀疏 NFA | 位图 NFA | 触及字节:满表 / 字节类 / 稀疏 / 位图 |
|---|---|---|---|---|---|---|
| \(\sigma=4\),\(k=1000\) | 7,873 | 8.09 | 0.19(5 类) | 0.13 | 0.38 | 0.37 / 0.17 / 0.13 / 0.32 |
| \(\sigma=4\),\(k=10{,}000\) | 61,258 | 62.97 | 1.47(5 类) | 1.04 | 2.94 | 2.54 / 1.27 / 1.04 / 2.38 |
| \(\sigma=256\),\(k=1000\) | 11,144 | 11.46 | 11.46(256 类) | 0.19 | 0.54 | 1.19 / 1.19 / 0.17 / 0.22 |
| \(\sigma=256\),\(k=10{,}000\) | 109,140 | 112.20 | 112.20(256 类) | 1.86 | 5.24 | 8.46 / 8.46 / 1.52 / 1.78 |
满表 DFA 的总大小没有意义,要看的是扫描真正碰到的部分:随机文本下大部分状态从未被访问,\(\sigma=256\)、\(k=10{,}000\) 时 112 MB 的表只触及 8.46 MB,但这仍是稀疏 NFA 的 5.6 倍。随机字节模式用遍了 256 个字节值,字节类合并不起作用;\(\sigma=4\) 时它把行宽从 256 压到 5,工作集降到满表的一半。
扫描速度
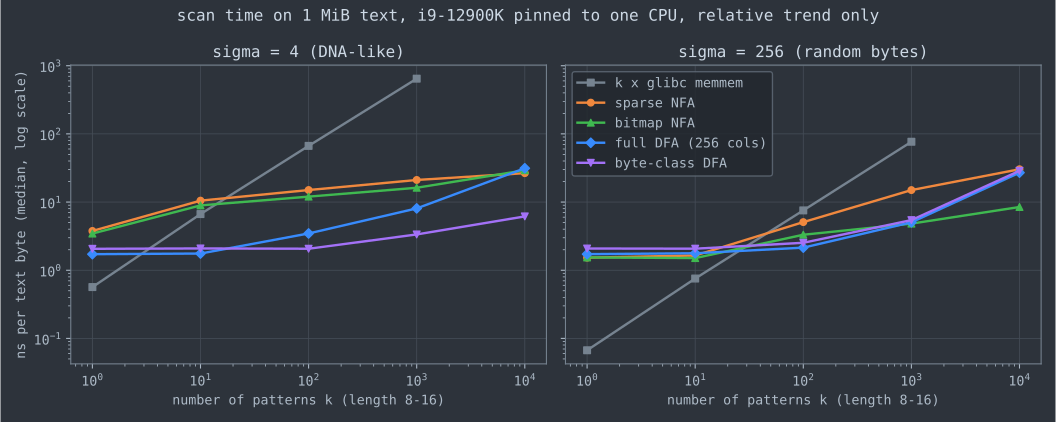
几个关键点(每字节纳秒数,中位数):
| 配置 | \(k\) 次 memmem | 稀疏 NFA | 位图 NFA | 满表 DFA | 字节类 DFA |
|---|---|---|---|---|---|
| \(\sigma=4\),\(k=1000\) | 646 | 21.1 | 16.2 | 8.1 | 3.4 |
| \(\sigma=4\),\(k=10{,}000\) | 未测 | 26.6 | 29.3 | 31.3 | 6.2 |
| \(\sigma=256\),\(k=1000\) | 76.7 | 15.0 | 4.8 | 5.0 | 5.4 |
| \(\sigma=256\),\(k=10{,}000\) | 未测 | 30.3 | 8.5 | 27.0 | 28.8 |
对这组结果的解读:
- 小 \(k\)
时逐个模式扫更快。 \(k=1\) 时 glibc
memmem每字节 0.07 ns(\(\sigma=256\)),AC 的任何布局都要 1.5 ns 以上:逐字节查表的依赖链比不过memmem的跳跃和向量化。\(\sigma=256\) 时交叉点在 \(k=10\) 与 \(100\) 之间,\(\sigma=4\) 时在 1 与 10 之间(小字母表上memmem的候选位置多)。这也是 GNU grep 只有一个模式时用 Boyer-Moore、多个模式才用 AC 的原因(第八节)。 - 工作集能否留在缓存里,决定了满表 DFA 的成败。 \(k=1000\) 时满表 DFA 在两种字母表上都是最快或接近最快;\(k=10{,}000\) 时它的工作集(2.5 MB 与 8.5 MB)超出每核 L2,速度掉到与 NFA 相当甚至更慢。字节类 DFA 在 \(\sigma=4\) 上把工作集压到 1.27 MB,保住了 6 ns 的速度。
- 工作集最小不等于最快。 \(\sigma=256\)、\(k=10{,}000\) 时稀疏 NFA 触及的字节最少,却是最慢的:浅层状态有几十条出边,二分查找的分支难以预测。位图 NFA 的查询没有数据相关分支,工作集只比稀疏 NFA 大 17%,最终最快。\(\sigma=4\) 时每个状态最多 4 条出边,二分查找很便宜,位图反而因为每状态 32 字节的位图而更占缓存,两者持平。
- 这些是一台机器、随机模式、随机文本上的结果。真实规则集的前缀共享更多,真实流量也不是均匀随机的,不能把数字外推到具体系统。能外推的是方法:先看状态数和工作集,再选布局。
八、生产实现:钉住版本核对
下表每一行都对应到具体版本的文件和函数。
| 系统与版本 | 实际做法 | 出处 |
|---|---|---|
| GNU grep 3.11 | grep -F 只有一个模式时用
Boyer-Moore,多个模式时用 AC;Trie 的出边存在 AVL 树里;AC
扫描找到第一个匹配即停,需要时再向右扩展成最左最长匹配 |
src/kwset.c:kwsprep() 注释
“Use Boyer-Moore if just one pattern, Aho-Corasick
otherwise”,acexec_trans() |
| GNU grep 2.26(2016-10-02) | 多模式 grep -F 从 Commentz-Walter 换成
AC,NEWS 称”通常快得多” |
grep 3.11 源码包中的 NEWS |
| Snort 2.9.20 | 代码默认 ac-bnfa(稀疏 NFA);随发行包的
snort.conf 却显式配置
search-method ac-split,即满表 AC 加上把
any-any 规则组拆开;可选关键字有
ac-std、ac-bnfa、ac、ac-nq、acs、ac-banded、ac-sparsebands、lowmem
等,没有 “ac-full” |
src/fpcreate.c:fpSetDefaults()、fpSetDetectSearchMethod();etc/snort.conf
第 198 行 |
| Snort 2.9.20 | acsmx2.c 支持
full、sparse、banded、sparse-banded
四种存储格式;文件头注释称压缩格式在纯基准测试中缓存表现更好,但在
Snort 整体上看不到提升,因为其他处理会把缓存冲掉 |
src/sfutil/acsmx2.c 文件头注释 |
| Snort 3.9.0.0 | search_method 默认
ac_bnfa;搜索引擎目录下有
ac_bnfa、ac_full、hyperscan
三种 |
src/main/modules.cc,src/search_engines/ |
| Suricata 8.0.0 | mpm-algo: auto:编译时带 Hyperscan 就用
hs,否则用 ac;ac 是
256 列满表 DFA,按状态数选 16 位或 32 位表项 |
suricata.yaml.in;src/util-mpm-ac.c:SCACCreateDeltaTable() |
| Hyperscan 5.4.2 | 字面量匹配由 FDR(带桶的扩展 shift-or 加 SIMD,命中后再验证)和 Teddy(基于 PSHUFB 的小模式集匹配)完成,运行时没有 AC | src/fdr/fdr.c、src/fdr/teddy.c、src/fdr/teddy_avx2.c;Wang
等,NSDI 2019,第 4.1、5 节 |
Rust aho-corasick 1.1.3 |
自动选择:模式不超过 100 个且不同时需要锚定与非锚定起点时建 DFA;否则建连续 NFA(contiguous NFA,单块内存、靠近起点的状态稠密存储);再不行才用非连续 NFA;字节类和预乘状态 ID 总是开启 | src/ahocorasick.rs:build_auto();DESIGN.md |
| ClamAV 1.4.3 | 带通配符、逻辑签名、签名选项或特殊偏移的签名进 AC
匹配器,其余用 Boyer-Moore;AC 只把模式的前至多
ac_maxdepth 个字节插入 Trie,默认最小深度
2、最大深度 3 |
libclamav/readdb.c:cli_add_content_match_pattern();libclamav/matcher-ac.c:cli_ac_addpatt();libclamav/default.h |
几点观察:
- “Snort 默认用哪种 AC”要分开回答。
代码里的默认值(2.9.20 的
fpSetDefaults()、3.9.0.0 的modules.cc)是稀疏的 bnfa;2.9.20 随包配置文件选的是满表的ac-split。读者看到的实际行为取决于用了哪份配置。 - Hyperscan 不是”加速版 AC”。 论文第 2 节把 AC 的问题概括为内存占用大导致频繁缓存未命中,以及逐字节的顺序依赖;第 4.1 节的 FDR 是另一类算法。论文第 6.3 节在 Xeon Platinum 8180 单核、Hyperscan v5.0 上,用 ET-Open 和 Talos 规则集中 1k 到 26k 个字面量测得 FDR 比 AC 快 4.2 到 8.8 倍(随机包)和 3.2 到 8.2 倍(真实流量)。论文第 2 节同时说明,Snort 和 Suricata 用 AC 做多模式预过滤。
- Rust crate 默认不用 DFA。
DESIGN.md的理由是:连续 NFA 的内存比 DFA 少几个数量级,构建只比非连续 NFA 稍慢,搜索速度”通常相当接近”DFA。与第七节的测量方向一致:状态数大时满表 DFA 不占优。
九、争论与开放问题
SIMD 过滤器会不会取代自动机
一方的证据来自网络安全场景。DFC(Choi 等,NSDI 2016)先用几张小位图过滤候选位置,再做完整比较;Hyperscan 论文引用 DFC 相对 AC 的 2 到 3.6 倍加速,并报告 FDR 相对 AC 的 3.2 到 8.8 倍加速。二者的共同点是:把”每字节一次依赖前一状态的查表”换成可以向量化、访存集中在小表上的过滤,再对少量候选做验证。
另一方的证据来自通用库。Rust aho-corasick
1.1.3 的 DESIGN.md 说明 Teddy
只在模式较少(文档说”比如少于 100 个”)时效果好,需要
SSSE3、AVX2 或 NEON,文本短于 16 到 34 字节时改用
Rabin-Karp;模式多时仍由自动机完成搜索。GNU grep 3.11
的多模式 -F 也仍是
AC。过滤类算法的效果取决于候选位置的密度:模式多、模式短或文本与模式相似时,验证阶段会变成主要开销。
Snort 2 acsmx2.c
的文件头注释给这场争论添了一个限定:压缩格式在单独的基准测试里缓存表现更好,放进完整系统后却看不到整体提升。孤立的匹配器基准测试(包括本文第七节的)高估了缓存友好设计的收益,因为真实系统里匹配器与解码、规则验证等处理争用同一块缓存。在给定模式集和流量分布时预测哪种匹配器更快,目前没有公认的代价模型,Hyperscan
这类系统依赖编译期的启发式来选择。
满表 DFA 值不值得
原文估计 DFA 最多省一半转移,而且”实际中几乎不可能达到”;Snort 的 bnfa 注释说 NFA 可能需要两倍的转移;Rust crate 只在不超过 100 个模式时才建 DFA。第七节的测量显示答案取决于工作集:\(k=1000\) 时满表 DFA 是最快的布局之一,\(k=10{,}000\)、\(\sigma=256\) 时位图 NFA 比它快约 3 倍。沿着”用默认转移压缩 DFA”这条线,Kumar 等人的 D2FA(SIGCOMM 2006)把类似失败链接的默认转移推广到正则表达式 DFA,用有界的额外访存换取转移数的大幅减少。AC 的失败链接可以看作这类设计最早的特例。
匹配语义
教科书的 AC
报告所有匹配,包括重叠的。正则引擎和词典分词往往需要最左优先(leftmost-first,Perl
风格)或最左最长(leftmost-longest,POSIX 风格)语义。Rust
crate 的 DESIGN.md
描述了代价:支持最左语义时,构造阶段只保留一部分失败转移,所以同一个自动机不能再做重叠搜索;流式搜索目前只支持标准语义,还必须缓存至少一个最长模式长度的文本。GNU
grep 的 acexec_trans() 则是在标准 AC
找到第一个匹配后停下,再按需要扩展成最左最长匹配。同一个模式集,语义不同,自动机本身就不同,这一点在把
AC 嵌入正则引擎时最容易出错。
对抗输入
Tuck 等人(2004)明确提出,IDS 的匹配器要按最坏情况设计,否则攻击者可以构造最坏情况的包流让 IDS 过载,趁机把真实攻击流量混过去。对 AC 来说,最坏情况有两处:NFA 形式下单字节的失败转移可以多达当前深度(第四节的 \(a^{64}\) 实验中单字节 64 次),DFA 可以消除它;输出总数可以达到 \(nk\) 量级(第五节),这与布局无关,只能靠改需求(计数、每条规则只报一次、给输出设上限)来限制。
动态字典
AC
自动机是静态结构:插入一个模式可能改变很多状态的失败链接和
DFA 行。本文核对的实现都是先收集全部模式再一次构建:grep 的
kwsincr() 逐个加入模式,最后由
kwsprep() 统一计算;Rust crate
的构建器产出不可修改的自动机。支持插入和删除的字典匹配是专门的研究方向,Amir、Farach、Galil、Giancarlo
与 Park 的”Dynamic dictionary matching”(JCSS
1994)是这一方向的代表工作。在规则频繁更新的系统里,重建时间和重建期间的内存峰值同样是设计约束。
十、工程选型
- 模式少(几个到十几个):先试逐个模式用
memmem或 SIMD 过滤器扫。第七节里 \(k\le 10\)、\(\sigma=256\) 时逐个memmem比任何 AC 布局都快。Rust crate 的预过滤默认开启,这个区间正是 Teddy 效果好的范围。 - 模式几十到上千:AC 开始占优。状态数在几万以内、满表放得进 L2 时,满表 DFA 最简单也最快;模式只用到少量字节值时,用字节类把行宽压下去。
- 状态数十万量级:不要默认满表 DFA。先测工作集(第七节的”触及字节”指标只需一次模拟扫描),在稀疏、位图、字节类之间选;分支不可预测的二分查找可能抵消工作集小的好处。静态词典还可以考虑 Aoe(IEEE TSE 1989)的双数组 Trie 这类紧凑布局。
- 输出:一定建输出链接;只需要计数或只需要判断是否命中时,预先算 \(cnt(s)\),不要逐个报告。
- 语义:确认调用方要的是全部重叠匹配还是最左匹配,再选实现;流式场景要跨块保存自动机状态,
reproduce/ac.c的测试覆盖了这一点。 - 安全场景:按最坏输入评估单字节延迟和输出量,别只看随机流量下的平均吞吐。
十一、参考资料
规范与文档
- GNU grep 3.11 源码包,
NEWS:release 2.26(2016-10-02)条目,grep -F多模式改用 Aho-Corasick。 - Rust
aho-corasick1.1.3,DESIGN.md:NFA/DFA 选择、字节类、预乘状态 ID、匹配语义、重叠与流式搜索、预过滤器。 - Suricata
8.0.0,
suricata.yaml.in:mpm-algo配置项说明。
源码
- GNU grep
3.11,
src/kwset.c:kwsprep()、kwsincr()、acexec_trans()。 - Snort
2.9.20,
src/fpcreate.c:fpSetDefaults()、fpSetDetectSearchMethod();etc/snort.conf;src/sfutil/bnfa_search.c、src/sfutil/acsmx2.c文件头注释。 - Snort
3.9.0.0,
src/main/modules.cc(search_method参数);src/search_engines/ac_bnfa.cc、ac_full.cc、hyperscan.cc。 - Suricata
8.0.0,
src/util-mpm-ac.c:SCACCreateGotoTable()、SCACCreateFailureTable()、SCACCreateDeltaTable()。 - Hyperscan
v5.4.2,
src/fdr/fdr.c、src/fdr/teddy.c、src/fdr/teddy_avx2.c。 - Rust
aho-corasick1.1.3,src/ahocorasick.rs:build_auto()。 - ClamAV
1.4.3,
libclamav/default.h;libclamav/matcher-ac.c:cli_ac_addpatt();libclamav/readdb.c:cli_add_content_match_pattern()。
核心论文
- A. V. Aho, M. J. Corasick, “Efficient string matching: an aid to bibliographic search”, Communications of the ACM 18(6), 1975, 333–340.
- D. E. Knuth, J. H. Morris, Jr., V. R. Pratt, “Fast pattern matching in strings”, SIAM Journal on Computing 6(2), 1977, 323–350.
其他论文
- B. Commentz-Walter, “A string matching algorithm fast on the average”, ICALP 1979, LNCS 71, 118–132.
- J.-I. Aoe, “An efficient digital search algorithm by using a double-array structure”, IEEE Transactions on Software Engineering 15(9), 1989, 1066–1077.
- A. Amir, M. Farach, Z. Galil, R. Giancarlo, K. Park, “Dynamic dictionary matching”, Journal of Computer and System Sciences 49(2), 1994, 208–222.
- N. Tuck, T. Sherwood, B. Calder, G. Varghese, “Deterministic memory-efficient string matching algorithms for intrusion detection”, IEEE INFOCOM 2004, vol. 4, 2628–2639.
- S. Kumar, S. Dharmapurikar, F. Yu, P. Crowley, J. Turner, “Algorithms to accelerate multiple regular expressions matching for deep packet inspection”, ACM SIGCOMM 2006, 339–350.
- S. Dori, G. M. Landau, “Construction of Aho Corasick automaton in linear time for integer alphabets”, Information Processing Letters 98(2), 2006, 66–72.
- B. Choi, J. Chae, M. Jamshed, K. Park, D. Han, “DFC: Accelerating string pattern matching for network applications”, USENIX NSDI 2016.
- X. Wang, Y. Hong, H. Chang, K. Park, G. Langdale, J. Hu, H. Zhu, “Hyperscan: A fast multi-pattern regex matcher for modern CPUs”, USENIX NSDI 2019.
实验
reproduce/ac.c:稀疏 NFA、位图 NFA、满表 DFA、字节类 DFA 四种布局,朴素匹配差分测试、流式分块测试、只计数版本,以及demo、stats(状态数、字节数、触及字节、失败转移计数)、worst(失败链尖峰与输出爆炸)、bench(计时)。reproduce/run.sh:完整复现命令,参数为绑定的 CPU 编号;原始输出在reproduce/results/。reproduce/plot_bench.py:汇总results/bench{1,2,3}.txt并生成ac-bench.svg。
系列导航: - 上一篇:后缀数组:倍增、SA-IS、LCP 与增强后缀数组 - 下一篇:BWT 与 FM-index:从 bzip2 到基因组比对
相关阅读: - 字符串匹配算法:KMP 与 Boyer-Moore(BM)详解 - 字符串匹配算法选型索引 - SIMD 字节扫描:memchr 的页边界、PCMPISTRI 的代价与 JSON/CSV 的引号掩码 - 正则表达式理论:从形式语言到自动机实现 - DFA 最小化:词法分析器生成的核心
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
字符串匹配算法选型索引
字符串匹配算法工程选型:KMP、Boyer-Moore(BM)、Rabin-Karp、AC 自动机、后缀数组、SIMD 与模糊匹配——按场景选算法,附本站深度文章导航。
Unicode 文本算法:UTF-8 编解码与验证、规范化、字素簇与双向文本安全
UTF-8 的位布局、合法序列与最大子部分替换,Hoehrmann DFA 与 Keiser–Lemire SIMD 验证,再到规范化、字素簇、大小写折叠和 Trojan Source;编解码器经全部 2^32 个四字节串穷举测试。
字符串匹配算法:KMP 与 Boyer-Moore(BM)详解
KMP、Boyer-Moore(BM 算法)字符串匹配:暴力法对比、失配函数、Sunday 变体与工程性能——字符串匹配算法选型必读。
DFA 最小化:词法分析器生成的核心
每个正则表达式引擎背后,都有一个 DFA 最小化算法在工作。