关于 Burrows-Wheeler 变换(Burrows-Wheeler Transform,BWT),常见的说法有三种:“BWT 能压缩数据”;“FM-index 的搜索时间与文本长度无关”;“BWA 就是一个 FM-index”。第一句不对:BWT 只是把字符重新排列,长度一个字节都不少,Burrows 和 Wheeler 在原始报告的摘要里就写明 “The transformation does not itself compress the data”。第二句只对计数成立,要报告每次出现的位置还得额外付出采样间隔那么多步。第三句漏掉了大半:BWA-MEM 只用 FM-index 找种子,比对质量靠的是后面的 Smith-Waterman 延伸。
本文回答四个问题:一个排列为什么能只凭一列字符还原(LF 映射);bzip2 1.0.8 实际是怎样围绕 BWT 搭流水线的;FM-index 怎样用 rank 查询在 \(O(m)\) 步内计数、又怎样用采样后缀数组定位;BWA 0.7.18 的源码在哪些地方和论文里的”标准做法”不同。后缀数组本身的构造(倍增、SA-IS)和基于后缀数组的二分搜索由系列的 后缀数组 负责,这里把后缀数组当作已知输入。
文中所有实验数字都来自同目录的
reproduce/fm.c 和
reproduce/run.sh,指标全部与时钟无关(游程数、熵、LF
步数、压缩后字节数),环境见第三节。
一、定义:排序所有旋转,取最后一列
给定长度为 \(n-1\)
的文本,末尾追加一个比所有字符都小、且只出现一次的哨兵
$,得到长度为 \(n\) 的 \(T\)。把 \(T\) 的 \(n\)
个循环旋转按字典序排序,排成一个 \(n \times n\) 的矩阵 \(M\);第一列记为 \(F\),最后一列记为 \(L\)。\(L\) 就是 BWT 的输出。
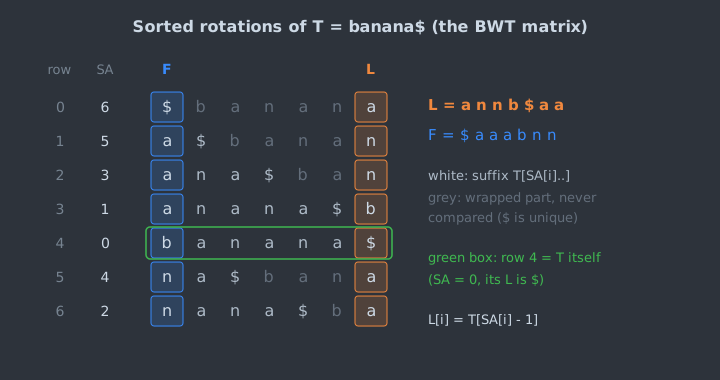
图里有三处值得看:
- 旋转顺序就是后缀顺序。 因为
$唯一且最小,两个旋转在比较到$之前一定已经分出大小,$之后绕回来的灰色部分永远不参与比较。所以第 \(i\) 行以后缀 \(T[\mathrm{SA}[i]..]\) 开头,排序旋转等价于构造后缀数组 \(\mathrm{SA}\)。Burrows 和 Wheeler 在报告第 4.1 节正是用”追加 EOF 后排序后缀”来实现旋转排序的。 - \(L\) 可以直接从后缀数组读出:
\[ L[i] = T\big[(\mathrm{SA}[i] - 1) \bmod n\big]. \]
第 \(i\)
行的最后一个字符,就是该后缀在原文本中的前一个字符。banana$
的 \(\mathrm{SA} =
(6,5,3,1,0,4,2)\),于是 \(L
= \texttt{annb\$aa}\)。 - \(F\) 不需要存。 它只是
\(T\)
的字符排序,由每个字符的出现次数就能还原。记 \(C[c]\) 为 \(T\) 中严格小于 \(c\) 的字符个数,则 \(F\) 中 \(c\) 占据的行是 \([C[c],\ C[c+1])\)。本例中 \(C[\$]=0,\ C[a]=1,\ C[b]=4,\
C[n]=5\)。
这个变换由 David Wheeler 在 1983 年于 AT&T
贝尔实验室发现,但当时没有发表;公开文本是 Burrows 与
Wheeler 在 1994 年 5 月 10 日发布的 DEC SRC Research Report
124(报告第 1 节自述)。报告里的原始定义没有哨兵:对原串的
\(N\) 个旋转排序,输出
\(L\) 以及原串所在的行号
\(I\)。bzip2
沿用的就是这种不带哨兵的形式,行号叫
origPtr(第三节)。
二、LF 映射与逆变换
只拿到 \(L\) 为什么能还原 \(T\)?关键是 \(L\) 和 \(F\) 之间的一条对应关系。
LF 映射
引理(LF 映射)。 对任意字符 \(c\),\(L\) 中第 \(k\) 个 \(c\)(按行号从上往下数,从 0 开始)与 \(F\) 中第 \(k\) 个 \(c\) 是 \(T\) 中同一个字符。于是第 \(i\) 行的最后一个字符 \(c = L[i]\) 在 \(F\) 中位于第
\[ \mathrm{LF}(i) = C[c] + \mathrm{occ}(c, i) \]
行,其中 \(\mathrm{occ}(c, i)\) 是 \(L[0..i-1]\) 中 \(c\) 的个数,即 \(L\) 上的 rank 查询。
证明。 设 \(i < j\) 且 \(L[i] = L[j] = c\),第 \(i\)、\(j\) 行的旋转分别是 \(R_i < R_j\)。把它们各自向右转一位,得到 \(cR_i[0..n-2]\) 和 \(cR_j[0..n-2]\),这两个旋转都以 \(c\) 开头,而且恰好是 \(L\) 中这两个 \(c\) 在 \(F\) 中所在的行。它们首字符相同,大小由 \(R_i[0..n-2]\) 与 \(R_j[0..n-2]\) 决定。两个不同的旋转不可能在前 \(n-1\) 个字符上全等(否则剩下的一个字符也相等,两者就是同一个旋转),因此 \(R_i < R_j\) 已经在前 \(n-1\) 个字符上决出,右转后仍保持 \(cR_i[0..n-2] < cR_j[0..n-2]\)。所以以 \(c\) 结尾的行,右转后按原来的相对顺序落在 \(F\) 中 \(c\) 的那一段里,第 \(k\) 个对应第 \(k\) 个。\(\blacksquare\)
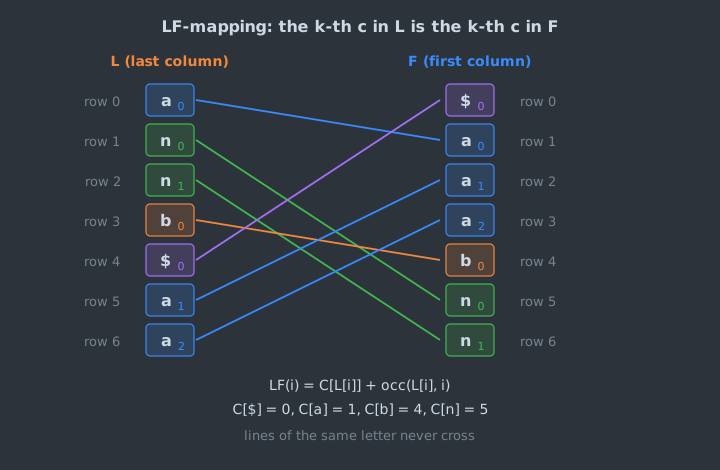
图中同色的线互不交叉,这就是”相对顺序不变”。例如 \(L[5] = a\) 是 \(L\) 中第 1 个
a(第 0 个在第 0 行),\(\mathrm{LF}(5) = C[a] +
\mathrm{occ}(a, 5) = 1 + 1 = 2\),它是 \(F\) 中第 1 个
a。
这个公式并不是 FM-index 的发明。Burrows 和 Wheeler 的报告第 4.2 节已经给出逆变换的两遍扫描:第一遍算出 \(P[i]\)(\(L[i]\) 在 \(L[0..i-1]\) 中出现的次数)和 \(C\),第二遍用 \(T[i] = P[i] + C[L[i]]\) 跳转。\(P[i]\) 就是 \(\mathrm{occ}(L[i], i)\)。FM-index 的贡献在于:不再为每个位置存一个 \(P[i]\),而是在压缩后的 \(L\) 上支持任意 \((c, i)\) 的 rank 查询(第四、五节)。
逆变换
第 0 行是 $ 开头的那一行,它的 \(L[0]\) 是 \(T\) 中 $
前面的字符,也就是文本的最后一个字符。每走一步
LF,就回到原文本中的前一个位置:
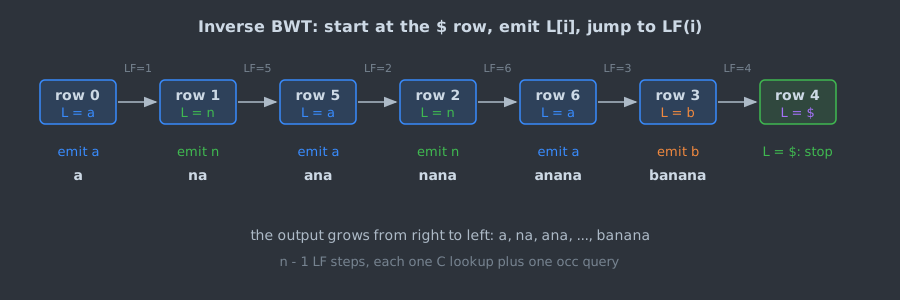
对应的代码(摘自 reproduce/fm.c,符号 0 表示
$,其余字节映射为 1 到 256):
static int lf(const FM *f, int i)
{
    int c = f->L[i];
    return f->C[c] + occ(f, c, i);
}

/* Recover t[0..n-1] (t[n-1] = '$') by walking LF from row 0, the '$' row. */
static void fm_inverse(const FM *f, int *t)
{
    int i = 0;
    t[f->n - 1] = 0;
    for (int j = f->n - 2; j >= 0; j--) {
        t[j] = f->L[i];
        i = lf(f, i);
    }
}
逆变换共 \(n-1\)
步,每步一次 \(C\)
查表和一次 \(\mathrm{occ}\)。若像原始报告那样预先算好整张
\(P\) 数组,每步 \(O(1)\),总时间 \(O(n)\),代价是每个位置多存一个整数。bzip2
在这里提供了两档:默认的解压内存约为 \(100\text{k} + 4 \times\)
块大小;-s 改用 16 位加 4
位拼成的数组(decompress.c 中的
ll16 与 ll4),降到 \(100\text{k} + 2.5 \times\)
块大小,手册说明代价是速度大约减半。
没有哨兵时(bzip2
的形式),若原串是某个子串的整数次重复,会出现完全相同的旋转。报告第
2 节指出逆变换依然正确,只是 LF
序列会重复访问同一批行。reproduce/fm.c
的测试专门生成了周期串,用原始报告的 \(P\)、\(C\)
两遍扫描做无哨兵逆变换,2000 轮全部还原成功。
三、BWT 之后为什么好压缩:bzip2 1.0.8 的实际流水线
聚簇效应
报告第 3 节用英文里的 the 解释:所有以
he
开头的旋转在排序后挨在一起,它们的最后一个字符大多是
t。\(L\)
中某一段因此集中出现少数几种字符,而
move-to-front(MTF,Bentley、Sleator、Tarjan 与 Wei,CACM
1986)编码正好擅长这种局部性:每个字符输出它在最近使用列表中的位置,再把它移到表头,连续重复的字符就变成一串
0。报告里的例子是:初始列表为 \((a, b, c, r)\),对 \(L = \texttt{caraab}\) 编码得到
\((2, 1, 3, 1, 0,
3)\)。
这种聚簇能实测。fm stats 对输入做与 bzip2
相同的无哨兵循环 BWT,统计 \(L\) 的游程数 \(r\),再对 \(L\) 做
MTF(列表只含实际出现的字节,与 bzip2 一致),统计 0
的比例和 MTF 输出的零阶经验熵 \(H_0\):
| 输入 | 字节数 | \(H_0(T)\)(bit/字节) | 原文游程数 | BWT 游程数 \(r\) | \(n/r\) | MTF 输出为 0 | \(H_0\)(MTF)(bit/字节) | bzip2 -9
实际(bit/字节) |
|---|---|---|---|---|---|---|---|---|
bzip2 手册 manual.html |
126,958 | 5.046 | 121,635 | 35,185 | 3.61 | 72.3% | 1.980 | 1.69 |
bzip2 源码 blocksort.c |
30,713 | 4.611 | 22,482 | 8,572 | 3.58 | 72.1% | 2.058 | 1.92 |
| 随机 DNA | 1,000,000 | 2.000 | 750,419 | 750,364 | 1.33 | 25.0% | 2.000 | 2.19 |
| 高度重复 DNA | 1,000,000 | 2.000 | 750,436 | 12,660 | 78.99 | 98.7% | 0.118 | 0.19 |
实验口径:两个文本文件取自 bzip2 1.0.8
源码包(run.sh 下载并校验 SHA-256);随机 DNA
为均匀的 ACGT,种子 1;高度重复 DNA 是同一段 10,000
碱基随机序列的 100 份拷贝,每个碱基以 1‰
概率替换为随机碱基,种子 1。最后一列是系统自带 bzip2 1.0.8
的 -9 输出字节数乘 8 再除以输入字节数。环境为
Intel Core i9-12900K、WSL2 内核 6.6.87.2、GCC
16.1.1,编译参数
-O2 -Wall -Wextra;程序不计时,连续运行 3
次输出逐字节一致。
读这张表时注意三点:
- 文本上,BWT 把游程数压到原来的约三分之一到四成,MTF 输出七成以上是 0,零阶熵从约 5 bit/字节降到约 2 bit/字节。bzip2 真正的熵编码(下文的零游程编码加多表 Huffman)比零阶熵估计还要再好一截,最终是 1.69 和 1.92 bit/字节。
- 随机数据上 BWT 毫无帮助。 随机 DNA 的游程数几乎不变,bzip2 输出 2.19 bit/碱基,比直接用 2 bit 打包还大。BWT 利用的是上下文可预测性,没有可预测性就没有收益。
- 重复数据上游程数随重复度骤降。 100 份近似拷贝让 \(n/r\) 达到 79,这正是第八节 r-index 一类结构的出发点。
压缩率的理论解释来自 Manzini(JACM 2001):他在不假设信源模型的前提下,证明了 BWT 加 MTF 的原始算法以及加游程编码的变体,其压缩率在最坏情况下都能用输入的 \(k\) 阶经验熵 \(H_k\) 界住,对任意 \(k \ge 0\) 成立。此前的分析都假设输入来自有限阶马尔可夫信源。
bzip2 的流水线
bzip2 的手册自己说得很清楚:“bzip2 is not research
work”,它是把现有想法工程化;手册列出的四份核心文献是
Burrows-Wheeler 报告、Hirschberg 与 LeLewer
的前缀码解码、Wheeler 的多表 Huffman 程序
bred3,以及 Bentley 与 Sedgewick
的字符串排序论文。按 1.0.8 源码,一个块的处理顺序如下:
flowchart TD
    A["input bytes"] --> B["RLE1 in bzlib.c: a run of 4..255 equal bytes becomes 4 bytes + one count byte"]
    B --> C["block: at most 100000 x k - 19 bytes after RLE1, k = 1..9"]
    C --> D["BZ2_blockSort: sort cyclic rotations, record origPtr"]
    D --> E["generateMTFValues: MTF over symbols in use, zero runs coded as RUNA / RUNB, then EOB"]
    E --> F["sendMTFValues: 2 to 6 Huffman tables, a selector for every 50 symbols"]
    F --> G["block header: magic, block CRC, randomised bit, origPtr in 24 bits"]
与常见的”BWT、MTF、RLE、Huffman 四步”相比,有几处出入:
- 游程编码有两次,而且第一次在 BWT 之前。
bzlib.c的ADD_CHAR_TO_BLOCK和add_pair_to_block()把 4 到 255 个相同字节写成 4 个字节加一个计数字节(值为长度减 4)。BWT 之后的”游程编码”只针对 MTF 输出中的 0,并且合并在generateMTFValues()里:一段 0 的长度用BZ_RUNA、BZ_RUNB两个符号按双射二进制(RUNA 为 1、RUNB 为 2,低位在前)写出。这正是原始报告第 5 节建议的”用一个表示游程长度的码代替一串 0”。 - MTF
列表只包含块中出现过的字节(
unseqToSeq映射),字母表大小是实际用到的符号数加 RUNA、RUNB 和块结束符 EOB。 - Huffman 不是一张表。
sendMTFValues()按 MTF 符号数选 2 到 6 张码表(少于 200 个符号用 2 张,至少 2400 个用 6 张),每 50 个符号(BZ_G_SIZE)用一个 selector 指定码表,码长上限 23(BZ_MAX_CODE_LEN)。 - 块大小以十万字节为单位。
-1到-9对应 100,000 到 900,000 字节(默认-9),bzlib.c中的上限是nblockMAX = 100000 * blockSize100k - 19,而且这是 RLE1 之后的字节数。手册给出的内存估算是压缩 \(400\text{k} + 8 \times\) 块大小、解压 \(100\text{k} + 4 \times\) 块大小(-s时为 \(2.5 \times\))。
块越大,BWT 能看到的上下文越多。原始报告的 Table 2 给出了
Calgary 语料 book1 在不同块大小下的压缩率:1 KB
时 4.34 bit/字符,64 KB 时 3.00,256 KB 时 2.68,750
KB(整个文件)时 2.49;在 1 亿字节级的 Hector
语料上,块增大到约 1 亿字节时降到 2.01。bzip2 手册在介绍
-1 到 -9
时也提醒,更大的块收益递减很快,“大部分压缩来自前两三百 KB
的块大小”。
旋转排序:bzip2 自己的实现
bzip2
没有使用通用的后缀数组构造算法。blocksort.c 的
BZ2_blockSort() 分两条路:
- 块小于 10,000 字节时直接用
fallbackSort(),源码注释称之为 “exponential radix sort”,受 Manber-Myers 后缀数组构造启发,也就是倍增思想。 - 否则用
mainSort():先按前两个字节基数排序,再对每个桶用mainQSort3()(注释写明实现的是 Bentley 与 Sedgewick 的三路字符串快排)加mainSimpleSort()(希尔排序)。排序过程中消耗一个工作量预算budget = nblock * ((wfact-1) / 3),预算耗尽说明输入”too repetitive”,改走fallbackSort()。
这套”快路径加倍增兜底”的设计是 0.9.5 引入的,此前 bzip2
靠随机化扰动块内容来避开坏情况;compress.c
注释写明,从 0.9.5 起随机化位总是写
0,解码端仍保留处理能力以兼容旧文件。排序完成后,origPtr
就是 ptr[i] == 0 的那个 \(i\),以 24 位写入块头。
四、FM-index:用 rank 查询做 backward search
Ferragina 和 Manzini 在 FOCS 2000 的论文 “Opportunistic Data Structures with Applications” 中提出了后来被称为 FM-index 的结构。摘要给出的界是:文本 \(T[1,u]\) 以每字符 \(O(H_k(T)) + o(1)\) 比特存储(对任意固定 \(k\)),查找模式 \(P[1,p]\) 的全部 \(occ\) 次出现耗时 \(O(p + occ\log^{\epsilon} u)\)。期刊版(JACM 2005,“Indexing Compressed Text”)把第一种结构的空间写成 \(5nH_k(T) + o(n)\) 比特、时间 \(O(p + occ \log^{1+\epsilon} n)\)。“opportunistic” 指文本越可压缩,索引越小,而查询不显著变慢。
它由三部分组成:\(C\) 数组(\(\sigma\) 个整数)、支持 \(\mathrm{occ}(c, i)\) 的 \(L\)(第五节讨论怎么存)、以及用于定位的采样后缀数组(第六节)。原文本不必另存,第二节的逆变换就能把它还原出来。
区间不变量
模式 \(P[0..m-1]\) 在 \(T\) 中的出现,一一对应于 BWT 矩阵中以 \(P\) 开头的行,这些行在排序矩阵里连续,构成一个区间 \([lo, hi)\)。backward search 从 \(P\) 的最后一个字符开始,每次在左边加一个字符,维护不变量:
处理完 \(P[k..m-1]\) 后,\([lo, hi)\) 恰好是以 \(P[k..m-1]\) 开头的行。
加上字符 \(c = P[k-1]\) 时:以 \(cP[k..m-1]\) 开头的行,左转一位后以 \(P[k..m-1]\) 开头、以 \(c\) 结尾;反过来,区间内 \(L[i] = c\) 的行经 LF 右转一位后正好以 \(cP[k..m-1]\) 开头。所以新区间就是 \(\{\mathrm{LF}(i) : lo \le i < hi,\ L[i] = c\}\)。由 LF 引理,同一字符的 LF 保序,这些像是 \(F\) 中 \(c\) 段里连续的一截,起点跳过了区间之前的 \(\mathrm{occ}(c, lo)\) 个 \(c\):
\[ lo' = C[c] + \mathrm{occ}(c, lo), \qquad hi' = C[c] + \mathrm{occ}(c, hi). \]
\(lo' \ge hi'\)
时模式不出现。\(P\) 不含
$,所以”旋转以 \(P\) 开头”与”后缀以 \(P\)
开头”等价,匹配不会绕过文本末尾。
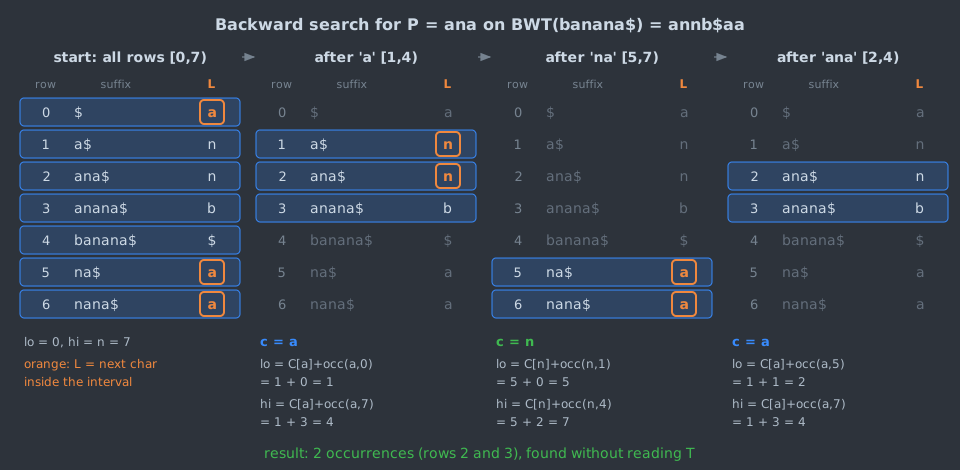
图中每一栏橙色框出的 \(L\) 字符,就是下一步会被 LF
带走的那些行。例如第二栏区间 \([1,4)\) 内有两个
n(第 1、2 行),加入 n
后它们被映射到 \(F\) 中
n 段的第 5、6 行。最终区间 \([2,4)\) 含 2
行,ana 出现 2 次;整个过程只查了 \(C\) 和 \(\mathrm{occ}\),没有读原文本。
对应代码(摘自 reproduce/fm.c):
/* Backward search: rows [*lo, *hi) are the suffixes prefixed by p[0..m-1]. */
static int fm_count(const FM *f, const int *p, int m, int *lo, int *hi)
{
    int s = 0, e = f->n;
    for (int k = m - 1; k >= 0 && s < e; k--) {
        int c = p[k];
        s = f->C[c] + occ(f, c, s);
        e = f->C[c] + occ(f, c, e);
    }
    *lo = s; *hi = e;
    return e > s ? e - s : 0;
}
对拍
./fm test 2000 生成 2000
段随机文本(字母表大小取 1、2、4、26、255,长度 1 到
3000,三分之一是周期串),每段查 60
个模式(一半取自文本的子串,一半随机生成、可能包含文本中没有的字符),逐一与朴素的逐位置比较计数对照,并用两种采样方式定位全部出现、排序后与朴素结果比较;同时检查带哨兵的逆变换、无哨兵的循环逆变换,以及长度不超过
400 时用朴素旋转排序核对后缀数组。结果:
rounds=2000 queries=120000 located=30160824 inverse=2000 cyclic_inverse=2000 naive_sa_checks=516 failures=0同一程序用 -fsanitize=address,undefined
编译后跑 300 轮,没有报错。
复杂度要看清楚是什么的复杂度
计数要 \(m\) 轮,每轮两次 \(\mathrm{occ}\),总共 \(2m\) 次 rank 查询。若 rank 是 \(O(1)\),计数就是 \(O(m)\),与 \(n\) 无关。作为对照,后缀数组上的二分查找需要 \(O(m\log n)\) 次字符比较,借助 LCP 信息可降到 \(O(m + \log n)\)(Manber 与 Myers,SIAM J. Comput. 1993;细节见 后缀数组)。
“与 \(n\) 无关”只说明操作次数,没有说明每次操作的代价。每一轮的 \(lo\)、\(hi\) 可能落在 \(L\) 的任意位置,文本大到远超缓存时,一次 rank 基本就是一次缓存未命中。BWA-MEM2(Vasimuddin 等,IPDPS 2019)在保持输出与 BWA-MEM 完全一致的前提下重写了几个核心内核,摘要列出的手段包括改善缓存复用、软件预取和 SIMD,端到端计算时间在单线程上最多快 3.5 倍(论文数据,未在本站复现)。FM-index 在实际系统中的主要成本是访存,而不是指令数。
五、occ 怎么存:checkpoint、位向量 rank 与小波树
最直接的办法是为每个位置、每个字符存一个计数,空间 \(\sigma n\) 个整数,远大于文本本身。实际实现都在”存多少计数”和”查询时扫多少字符”之间取舍。
checkpoint 加扫描
每隔 \(b\)
个位置存一份全部字符的累计计数,查询 \(\mathrm{occ}(c, i)\) 时取 \(\lfloor i/b \rfloor\)
处的计数,再扫描不超过 \(b\)
个字符。reproduce/fm.c 取 \(b =
64\),这是教学用的写法。
BWA 0.7.18 针对 DNA
把这一思路做到了缓存行粒度。bwt.h 定义
OCC_INTERVAL 为
128(OCC_INTV_SHIFT 7),宏
bwt_occ_intv() 表明存储布局是:每 128
个碱基,先放 4 个
bwtint_t(uint64_t)计数,紧跟这
128 个碱基的 2 bit 编码,合计 \(32
+ 32 = 64\) 字节,也就是每个碱基 4
bit。bwt_occ() 取出 checkpoint 后,用
__occ_aux() 以位运算(SWAR)数 64 位字中某个 2
bit 符号的个数,并非调用
__builtin_popcountll。$ 不存入
BWT,而是记下它所在的行号
primary,查询时对行号做一次修正。
位向量 rank 与小波树
字母表是二元时,\(\mathrm{occ}\) 就是位向量上的 \(\mathrm{rank}_1\)。Jacobson(FOCS 1989)给出了用 \(o(n)\) 比特额外目录实现常数时间 rank 的构造:大块存绝对计数,小块存相对计数,块内用查表或 popcount 收尾。
一般字母表可以用小波树(wavelet tree,Grossi、Gupta 与 Vitter,SODA 2003)化归为位向量:根节点把字母表一分为二,用一个位向量记录每个字符属于哪一半,再把两半的子序列分别递归下去。
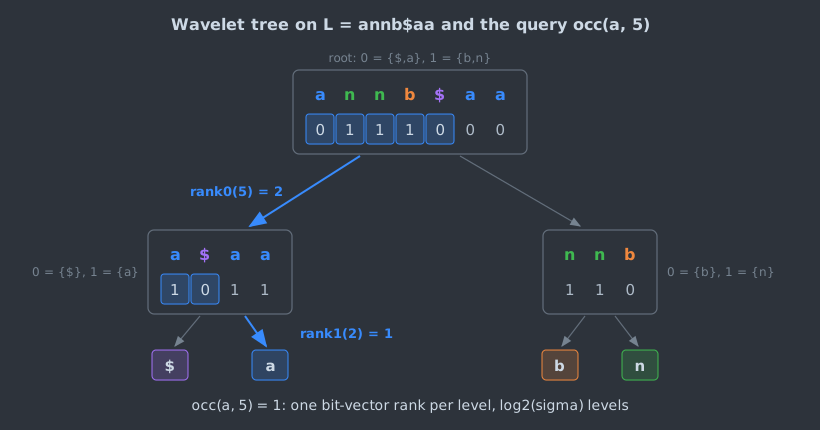
查询 \(\mathrm{occ}(a,
5)\):a 属于根的左半,根节点前 5 位
01110 中有 2 个 0,转到左孩子的前 2
位;a 属于左孩子的右半,前 2 位 10
中有 1 个 1,答案是 1。核对:\(L[0..4] = \texttt{annb\$}\)
中确实只有一个 a。每层一次位向量 rank,树高
\(\lceil\log_2\sigma\rceil\),所以
\(\mathrm{occ}\) 是 \(O(\log\sigma)\),backward
search 变为 \(O(m\log\sigma)\)。位向量总长
\(n\lceil\log_2\sigma\rceil\)
比特,Navarro 的综述 “Wavelet Trees for All”(JDA
2014)讨论了用压缩位向量把空间进一步降到接近 \(nH_0\) 的做法,以及小波树在
FM-index 之外的用途。
DNA 的 \(\sigma = 4\),BWA 这种”2 bit 打包加 checkpoint”的专用布局比小波树少一层间接访问;字母表大的场景(自然语言文本、蛋白质序列)才更需要小波树。
六、定位:采样后缀数组
backward search 给出的是行区间,要报告出现位置,还需要这些行的 \(\mathrm{SA}\) 值。完整的后缀数组要 \(n\lceil\log_2 n\rceil\) 比特,比压缩后的 BWT 大得多。解决办法是只存一部分 \(\mathrm{SA}\) 值,其余的靠 LF 走过去:\(\mathrm{LF}(i)\) 所在行的后缀恰好从 \(\mathrm{SA}[i] - 1\) 开始,所以从第 \(i\) 行走 \(k\) 步 LF 到达一个存了值的行 \(j\),就有
\[ \mathrm{SA}[i] = \mathrm{SA}[j] + k. \]
按文本位置采样
Ferragina 和 Manzini 的做法相当于只保留文本位置是 \(d\) 的倍数的后缀,即 \(\mathrm{SA}[i] \bmod d = 0\) 的行。每走一步 LF,文本位置减一,因此至多 \(d - 1\) 步必然碰到一个采样点。代价是要用一个 \(n\) 比特的位向量标记哪些行被采样,再用 rank 算出样本在数组中的下标。
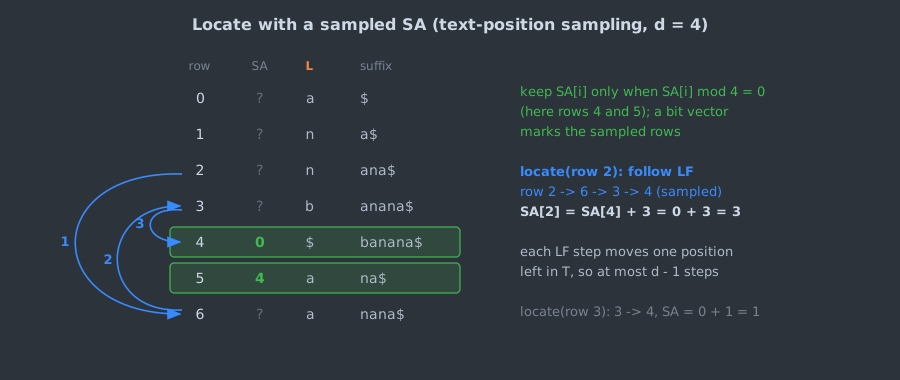
这张图接着第四节的例子:ana 的区间是第 2、3
行。第 2 行走了 3 步,恰好达到 \(d
- 1\) 的上界。代码(摘自
reproduce/fm.c):
static int ts_locate(const TextSample *s, const FM *f, int i, int *steps)
{
    int k = 0;
    while (!(s->bits[i / 64] >> (i % 64) & 1)) { i = lf(f, i); k++; }
    uint64_t below = s->bits[i / 64] & ((1ULL << (i % 64)) - 1);
    *steps = k;
    return s->val[s->blk[i / 64] + __builtin_popcountll(below)] + k;
}
BWA 的做法:按行号采样
BWA 0.7.18 没有这样做。bwtindex.c 的
bwa_idx_build() 调用
bwt_cal_sa(bwt, 32),只为行号是 32
的倍数的行保存 \(\mathrm{SA}\)
值;查询函数如下(源码原样摘录):
/* BWA v0.7.18, bwt.c, bwt_sa() */
bwtint_t bwt_sa(const bwt_t *bwt, bwtint_t k)
{
    bwtint_t sa = 0, mask = bwt->sa_intv - 1;
    while (k & mask) {
        ++sa;
        k = bwt_invPsi(bwt, k);
    }
    /* without setting bwt->sa[0] = -1, the following line should be
       changed to (sa + bwt->sa[k/bwt->sa_intv]) % (bwt->seq_len + 1) */
    return sa + bwt->sa[k/bwt->sa_intv];
}
好处是不需要位向量:判断一行是否被采样只要看行号的低位,样本下标就是
\(k / d\)。坏处是失去了
\(d - 1\) 步的保证,LF
走到哪些行事先无法控制。注释里的取模也不是多余的:行走可能穿过
$ 所在的行,从文本位置 0 绕回末尾,BWA 用把
sa[0] 置为 \(-1\)
的技巧抵消这一绕回,reproduce/fm.c 的
rs_locate() 则直接对 \(n\) 取模。
两种方案在 \(d = 32\)、样本数相同时的实测(对全部 \(n\) 行逐一定位,统计 LF 步数):
| 输入 | 行数 | 样本数(两种相同) | 按文本位置:平均步数 | 最大 | 按行号:平均步数 | 最大 |
|---|---|---|---|---|---|---|
manual.html |
126,959 | 3,968 | 15.50 | 31 | 31.56 | 270 |
blocksort.c |
30,714 | 960 | 15.50 | 31 | 29.22 | 177 |
| 随机 DNA | 1,000,001 | 31,251 | 15.50 | 31 | 31.13 | 330 |
| 高度重复 DNA | 1,000,001 | 31,251 | 15.50 | 31 | 31.47 | 370 |
按文本位置采样的平均值正好是 \((d-1)/2 = 15.5\),最大值是 \(d - 1 = 31\),这是由构造保证的。按行号采样的平均步数约为 30,接近两倍;最大值达到数百步。一个粗略的解释是:若把 LF 访问到的行看成随机行,每一步命中采样行的概率是 \(1/d\),步数近似服从几何分布,均值为 \(d - 1 = 31\),尾部概率约为 \((1 - 1/d)^k\),在 \(10^6\) 行中出现几百步的行并不意外。这个近似与实测相符,但它不是证明。
所以这是一笔空间换步数的账。以 64 位样本、\(d = 32\) 计,样本本身占每行 2
bit;按文本位置采样还要再加每行 1 bit 的位向量和它的 rank
目录,BWA 省掉了这部分,代价是平均多走一倍的 LF
步、且没有最坏情况上界。BWA-MEM
对出现次数过多的种子另有限制:bwa mem -c 默认
500,“skip seeds with more than INT
occurrences”(fastmap.c),不会为高重复种子逐个定位。
七、基因组比对:BWA 与 Bowtie 实际用了什么
谱系
FM-index 进入基因组学并非始于某一个工具。Lam 等人的 BWT-SW(Bioinformatics 2008)用压缩索引做局部比对;2009 年,面向二代测序短读段的三个工具几乎同时发表:
- Bowtie(Langmead、Trapnell、Pop 与 Salzberg,Genome Biology,2009 年 3 月):摘要称对人类基因组每 CPU 小时比对超过 2500 万条读段,内存约 1.3 GB,并提出了允许错配的质量感知回溯(quality-aware backtracking)。这是 2009 年硬件上的论文数据。
- BWA(Li 与 Durbin,Bioinformatics,2009 年 5 月在线发表):在 backward search 上做允许错配和空位的回溯搜索,摘要称比 MAQ 快约 10 到 20 倍、准确度相近。
- SOAP2(R. Li 等,Bioinformatics,2009 年 6 月在线发表),同样基于 BWT 索引。
之后的代表性演进是 Li 在 2012 年提出的 FMD-index(Bioinformatics 2012,fermi 组装器论文),它支持序列的双向扩展,并给出了查找全部超级最大精确匹配(super-maximal exact match,SMEM)的快速算法;BWA-MEM(Li,arXiv:1303.3997,2013,预印本,未经同行评审)用 SMEM 作种子。摘要称它适用于 70 bp 到几 Mb 的序列,并能自动在局部与端到端比对之间选择。
BWA 0.7.18 源码里的几个事实
- 索引的是正反两条链。
bwa_idx_build()第一次调用bns_fasta2bntseq(fp, prefix, 0)时for_only = 0,把反向互补序列接在正向序列后面,再对拼接结果建一个 BWT。这就是 FMD-index 能双向扩展的基础:在同一个索引里,一条链上的向右扩展等价于另一条链上的向左扩展。 - 构造算法按长度切换。 未指定
-a时,拼接后长度l_pac超过 50,000,000 用bwtsw(bwt_gen.c,文件头标注 2004 年 Wong Chi Kwong 的 BWT 构造代码),否则用is(is.c,来自 Yuta Mori 2008 年的 sais-lite,即 SA-IS)。 - SA 采样间隔固定为
32,采样方式是上一节的按行号;occ 的
checkpoint 间隔为
128,布局见第五节。按这两个常数,
.bwt约占每个索引碱基 4 bit,.sa约占 2 bit(64 位样本每 32 行一个);这是从源码常量推算的,未实测。 - BWA-MEM
的流程:
mem_collect_intv()调用bwt_smem1a()收集 SMEM 区间,默认最小种子长度 19(bwamem.c中min_seed_len = 19),用bwt_sa()把区间里的行换成参考序列坐标,成链后调用ksw_extend2()做带仿射空位罚分的延伸。FM-index 负责的是种子,不是整条比对。
八、争论与开放问题
种子该用 FM-index 还是哈希
FM-index 的长处是能在很小的内存里枚举任意长度的精确匹配,SMEM 这种变长种子离不开它。但同一位作者后来的 minimap2(Li,Bioinformatics 2018)改用 minimizer 哈希索引做稀疏的定长种子,摘要称它在准确度相当时比主流短读段比对工具快 3 到 4 倍,比长读段比对工具快 30 倍以上。另一边,BWA-MEM2(2019)选择保留 FM-index 和 BWA-MEM 的输出,把力气花在缓存和 SIMD 上。两条路线各有论文数据支持,它们的对比依赖各自选的数据集和准确度口径,目前没有一组公认的基准能裁决”种子索引应该用哪种”。从机制上能说的是:两类种子都要求精确匹配,测序错误会把精确匹配切短,错误率越高,能达到 19 bp 这类最小种子长度的 SMEM 越少;两者的差别在于变长种子要靠 FM-index 逐字符扩展,而定长 minimizer 只需一次哈希查表。
bzip2 作者对自己格式的反思
bzip2 手册里有一节 Seward 对文件格式的反思,他认为几处设计在事后看来并不必要:第一步的 RLE1 “entirely irrelevant”,原本是为了防止排序遇到长串重复字符时退化,而原始报告的 Q6a、Q6b 步骤已经说明块排序本身可以处理这种情况;随机化机制也没有必要;块的压缩后长度没有记录在流里,导致解压实现很绕;CRC32 可以换成更快的 Adler-32。他的结论是 bzip2 的格式”在我充分理解其性能后果之前就冻结了”。今天的 bzip2 流水线因此不能当作”BWT 压缩器的最优设计”来读,它是一个格式冻结后的工程产物。原始报告第 6 节也承认,逐字节的 MTF 本身会带来损失,块再大也不会逼近理论最优。
BWT 游程数 \(r\) 与 LZ77 的关系
第三节的表里,高度重复 DNA 的 \(n/r\) 达到 79。以 \(r\) 为空间单位的索引由此而来:Gagie、Navarro 与 Prezza 的 r-index(SODA 2018,期刊版 JACM 2020)在 \(O(r)\) 个字的空间内支持定位,适合同一物种大量基因组组成的高重复集合。长期悬而未决的是 \(r\) 与其他重复度量之间的关系:Kempa 与 Kociumaka 在 FOCS 2020 的 “Resolution of the Burrows-Wheeler Transform Conjecture” 摘要中写道,此前对 \(r\) 没有已知的非平凡上界,而几乎所有其他压缩方法都已证明与 LZ77 解析的短语数 \(z\) 相差至多多对数因子;他们证明了对任意文本 \(r = O(z\log^2 n)\)。这把 BWT 类索引的空间与 LZ77 可压缩性联系了起来,但对具体数据集而言,\(r\) 和 \(z\) 的实际比值仍要靠测量。
九、工程上容易出错的地方
| 问题 | 后果 | 做法 |
|---|---|---|
用 qsort 加 strcmp 排后缀 |
重复度高的输入上比较退化为逐字符长比较 | 用 SA-IS 或 libdivsufsort 一类算法(见 后缀数组),或像 bzip2 那样设工作量预算并切换到倍增 |
| 哨兵与输入字符冲突 | 旋转顺序不再等于后缀顺序,LF 行走提前终止或越界 | 把字节映射到 1 到 256、用 0
作哨兵(reproduce/fm.c),或像 bzip2
那样不用哨兵而保存 origPtr |
| 按行号采样时忘记取模 | 穿过 $ 行的定位结果超出文本长度 |
对 \(n\) 取模,或采用
BWA 把 sa[0] 置为 \(-1\) 的技巧 |
| 以为定位与计数一样快 | 每次出现要额外走至多 \(d-1\) 步(按行号采样时没有上界),高重复模式的定位开销与出现次数成正比 | 先计数、再决定是否定位;给出现次数设上限(BWA-MEM 的
-c 500) |
| 行号与 SA 值用 32 位整数 | 文本超过 \(2^{31}\) 时溢出,人类基因组正反两链就超过这个长度 | 用 64 位(BWA 的 bwtint_t 是
uint64_t) |
| 用 bzip2 压缩接近随机的数据 | 随机 DNA 上是 2.19 bit/碱基,比 2 bit 打包还大 | 先确认数据有上下文可预测性;DNA 直接用 2 bit 编码 |
| 把 \(O(m)\) 当成实际耗时 | 大文本上每次 rank 都可能是一次缓存未命中 | 让 checkpoint 与 BWT 同处一个缓存行(BWA 的 64 字节布局),批量查询并预取 |
十、参考资料
规范与文档
- bzip2 1.0.8 手册(源码包中的
manual.xml、bzip2.txt):块大小与内存估算、-s选项、文件格式反思一节、延伸阅读列表。
源码
- bzip2
1.0.8(
https://sourceware.org/pub/bzip2/bzip2-1.0.8.tar.gz,SHA-256ab5a03176ee106d3f0fa90e381da478ddae405918153cca248e682cd0c4a2269):bzlib.c的ADD_CHAR_TO_BLOCK、add_pair_to_block()、nblockMAX;compress.c的BZ2_compressBlock()、generateMTFValues()、sendMTFValues();blocksort.c的BZ2_blockSort()、mainSort()、mainQSort3()、fallbackSort();bzlib_private.h的BZ_RUNA、BZ_RUNB、BZ_N_GROUPS、BZ_G_SIZE;decompress.c的smallDecompress路径。 - BWA
v0.7.18(
https://github.com/lh3/bwa,tagv0.7.18):bwt.h的OCC_INTERVAL、bwt_occ_intv()、bwtint_t;bwt.c的bwt_occ()、__occ_aux()、bwt_sa()、bwt_cal_sa();bwtindex.c的bwa_idx_build();bntseq.c的bns_fasta2bntseq();bwamem.c的mem_collect_intv()、min_seed_len;fastmap.c的-c选项。
核心论文
- M. Burrows, D. J. Wheeler, “A Block-sorting Lossless Data Compression Algorithm”, DEC Systems Research Center, Research Report 124, 1994-05-10.
- P. Ferragina, G. Manzini, “Opportunistic Data Structures with Applications”, FOCS 2000, 390–398.
- P. Ferragina, G. Manzini, “Indexing Compressed Text”, Journal of the ACM 52(4), 2005, 552–581.
- G. Manzini, “An Analysis of the Burrows-Wheeler Transform”, Journal of the ACM 48(3), 2001, 407–430.
- H. Li, R. Durbin, “Fast and Accurate Short Read Alignment with Burrows-Wheeler Transform”, Bioinformatics 25(14), 2009, 1754–1760.
- B. Langmead, C. Trapnell, M. Pop, S. L. Salzberg, “Ultrafast and Memory-efficient Alignment of Short DNA Sequences to the Human Genome”, Genome Biology 10(3), 2009, R25.
其他论文
- J. L. Bentley, D. D. Sleator, R. E. Tarjan, V. K. Wei, “A Locally Adaptive Data Compression Scheme”, Communications of the ACM 29(4), 1986, 320–330.
- J. L. Bentley, R. Sedgewick, “Fast Algorithms for Sorting and Searching Strings”, SODA 1997.
- U. Manber, G. Myers, “Suffix Arrays: A New Method for On-line String Searches”, SIAM Journal on Computing 22(5), 1993, 935–948.
- G. Jacobson, “Space-efficient Static Trees and Graphs”, FOCS 1989, 549–554.
- R. Grossi, A. Gupta, J. S. Vitter, “High-order Entropy-compressed Text Indexes”, SODA 2003, 841–850.
- G. Navarro, “Wavelet Trees for All”, Journal of Discrete Algorithms 25, 2014, 2–20.
- T. W. Lam, W. K. Sung, S. L. Tam, C. K. Wong, S. M. Yiu, “Compressed Indexing and Local Alignment of DNA”, Bioinformatics 24(6), 2008, 791–797.
- R. Li, C. Yu, Y. Li, T.-W. Lam, S.-M. Yiu, K. Kristiansen, et al., “SOAP2: an Improved Ultrafast Tool for Short Read Alignment”, Bioinformatics 25(15), 2009, 1966–1967.
- H. Li, “Exploring Single-sample SNP and INDEL Calling with Whole-genome de novo Assembly”, Bioinformatics 28(14), 2012, 1838–1844.
- H. Li, “Aligning Sequence Reads, Clone Sequences and Assembly Contigs with BWA-MEM”, arXiv:1303.3997, 2013(预印本)。
- H. Li, “Minimap2: Pairwise Alignment for Nucleotide Sequences”, Bioinformatics 34(18), 2018, 3094–3100.
- Md. Vasimuddin, S. Misra, H. Li, S. Aluru, “Efficient Architecture-Aware Acceleration of BWA-MEM for Multicore Systems”, IPDPS 2019, 314–324.
- T. Gagie, G. Navarro, N. Prezza, “Optimal-Time Text Indexing in BWT-runs Bounded Space”, SODA 2018, 1459–1477;期刊版 “Fully Functional Suffix Trees and Optimal Text Searching in BWT-Runs Bounded Space”, Journal of the ACM 67(1), 2020.
- D. Kempa, T. Kociumaka, “Resolution of the Burrows-Wheeler Transform Conjecture”, FOCS 2020, 1002–1013.
实验
reproduce/fm.c:BWT、逆变换(带哨兵与无哨兵)、checkpoint occ、backward search、两种 SA 采样,以及对拍、统计与数据生成;编译gcc -O2 -Wall -Wextra -o fm fm.c -lm。reproduce/run.sh:下载并校验 bzip2 源码包、生成两份 DNA 数据、运行全部实验;参考输出在reproduce/results/stats.txt。reproduce/draw_figures.py:从banana$计算并生成本文全部分步 SVG 图。
系列导航: - 上一篇:AC 自动机:失败链接、输出链接与转移表布局 - 下一篇:编辑距离与模糊匹配:Wagner-Fischer、位并行与 Levenshtein 自动机
相关阅读: - 后缀数组:倍增、SA-IS、LCP 与增强后缀数组 - Huffman 编码与 DEFLATE - LZ77、LZ78 与 LZW:字典从哪里来,最长匹配怎么找 - 算术编码、Range Coder 与 ANS:分数比特的记账方式与精度损失
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
后缀数组:倍增、SA-IS、LCP 与增强后缀数组
后缀数组用 4n 字节代替后缀树。本文用对拍过的 C 实现推演倍增、SA-IS 与 Kasai LCP,统计三种二分搜索的字符比较次数,并与 libdivsufsort、libsais 实测构造时间和工作内存。
整数压缩:varint、Golomb、PForDelta 与 SIMD 位打包,倒排表里每个整数花几比特
以倒排表的 d-gap 为对象,在两份真实语料和伯努利合成表上实测 varint、Elias、Golomb/Rice、插值编码、Elias-Fano、Simple、PFOR、Stream VByte、BP128 的每整数比特数与下界之差,并在共享 2 vCPU 上测解码的相对速度。
时序数据压缩:delta-of-delta、XOR 浮点编码与十进制数据上的失效
拆解 Gorilla 的时间戳 delta-of-delta 与浮点 XOR 编码,对照 Prometheus、InfluxDB、VictoriaMetrics 钉版本源码,用节点采集数据和 ALP 数据集实测每个值花多少比特,并说明 XOR 在十进制数据上失效的原因与 Chimp、Elf、ALP 的改法。
列式压缩:轻量编码怎么选、Parquet 与 ORC 怎么写、编码数据上怎么算
对照 Parquet 2.11 规范与 Arrow、ORC 源码拆开字典、RLE/位打包混合、DELTA 与 RLEv2,讲清写入器何时放弃字典;在 TPC-H lineitem 上按字节比较 Parquet、ORC 与级联选择,并数出在编码数据上执行省下的工作。