用户在搜索框里敲了
pytohn,系统要在词典里找出”差不多”的词。这件事分两层:先定义两个字符串差多少,再在几万到几百万个词里快速找出差得少的那些。围绕它有几种流传很广的说法,都只对一半:
- “Lucene、SymSpell、git 用的都是 Damerau-Levenshtein 距离。”它们实际实现的是受限版本 OSA(optimal string alignment)。OSA 与真正的 Damerau-Levenshtein 距离结果不同,而且 OSA 不满足三角不等式。
- “BK-tree 让模糊查找几乎不用算距离。”在本文 82,769 词的英文词典上,\(k=2\) 时 BK-tree 每次查询仍要算 18% 的词;\(k=3\) 时它比加了长度过滤的暴力扫描还慢。
- “编辑距离总有一天会有远快于平方的算法。”在强指数时间假设(SETH)下,精确计算不存在 \(O(n^{2-\delta})\) 算法(Backurs & Indyk,STOC 2015)。
本文先给出定义和算法谱系(第一、二节),再讲
Wagner-Fischer 填表与回溯、带状 DP、Myers
位并行(第三到五节),然后讲转置操作带来的 OSA 与真
Damerau-Levenshtein
之争(第六节)和三种词典索引(第七节)。第八节的数据全部来自同目录的
reproduce/:所有实现都与朴素 DP 和穷举 BFS
对拍,词典实验统计的是距离计算次数、访问的 Trie
节点数这类与时钟无关的量。第九节核对 Lucene
9.12.0、Elasticsearch 8.15.0、SymSpell 6.7.3 和 git 2.46.0
的源码,第十节讨论下界与开放问题。
一、定义:三种操作与它们构成的度量
Levenshtein 距离
给定字母表 \(\Sigma\) 上的字符串 \(s\)(长 \(m\))和 \(t\)(长 \(n\)),编辑距离(edit distance)是把 \(s\) 变成 \(t\) 所需的最少操作次数。Levenshtein 距离允许三种单位代价操作:
- 插入(insertion)一个字符;
- 删除(deletion)一个字符;
- 替换(substitution)一个字符为另一个字符。
这个距离以 Levenshtein 命名。他 1965 年的论文《Binary codes capable of correcting deletions, insertions, and reversals》发表在《苏联科学院报告》(Doklady Akademii Nauk SSSR)第 163 卷,1966 年英译本发表在 Soviet Physics Doklady 第 10 卷。论文研究的是能纠正删除、插入和二进制位翻转的码,编辑距离是其中的工具。
记 \(D_{i,j} = d(s_{1..i}, t_{1..j})\),递推式是
\[ D_{i,0} = i,\qquad D_{0,j} = j,\qquad D_{i,j} = \min\bigl(D_{i-1,j} + 1,\; D_{i,j-1} + 1,\; D_{i-1,j-1} + [s_i \ne t_j]\bigr), \]
其中 \([s_i \ne t_j]\) 在两字符不同时为 1,否则为 0。三项分别对应删除 \(s_i\)、插入 \(t_j\)、匹配或替换。最后一步操作只能是这三种之一,去掉它就是一个更小的子问题,所以递推正确。\(d(s,t) = D_{m,n}\)。
为什么它是度量
把所有字符串看成图的顶点,一次操作连一条边。三种操作都可逆(插入的逆是删除,替换的逆还是替换),所以这是无向图,编辑距离就是图上的最短路长度。最短路距离天然满足度量公理:
\[ d(s,t) \ge 0,\qquad d(s,t) = 0 \iff s = t,\qquad d(s,t) = d(t,s),\qquad d(s,u) \le d(s,t) + d(t,u). \]
三角不等式来自”先走到 \(t\) 再走到 \(u\)“本身就是一条从 \(s\) 到 \(u\) 的路。第七节的 BK-tree 剪枝完全依赖这一条。后面会看到,OSA 恰恰因为不是任何图上的最短路距离而失去了它。
两个简单的界在后面反复出现:
\[ |m - n| \;\le\; d(s,t) \;\le\; \max(m, n),\qquad D_{i,j} \ge |i - j|. \]
下界是因为每次操作最多改变长度 1;上界是先替换 \(\min(m,n)\) 个位置再补齐长度。
变体
| 距离 | 操作 | 是否度量 | 典型用途 |
|---|---|---|---|
| Hamming | 替换(仅等长串) | 是 | 纠错码、等长签名 |
| indel 距离(LCS 距离) | 插入、删除 | 是 | diff:等于 \(m +
n - 2\,\mathrm{LCS}(s,t)\) |
| Levenshtein | 插入、删除、替换 | 是 | 拼写纠错、模糊查询 |
| OSA(受限 Damerau) | 再加相邻转置,但转置过的子串不能再编辑 | 否 | Lucene、SymSpell、git 的实际实现 |
| Damerau-Levenshtein | 插入、删除、替换、相邻转置,无限制 | 是 | 打字错误建模 |
加入转置的动机来自 Damerau(CACM 1964)。Morgan(CACM 1970)引用了他的原话:在因拼写错误被系统拒收的条目里,“超过 80% 属于四类单一错误之一”,即错一个字母、少一个字母、多一个字母、相邻两字母对调。这是 Damerau 那批数据上的观察,不是普适规律;第八节会用维基百科编辑的 2,429 个拼写错误给出另一组统计。
二、谱系:从 1965 年的纠错码到 SETH 下界
flowchart LR
  subgraph def["1964-1975: definitions and the DP"]
    direction TB
    DA["Damerau 1964<br/>four single-error classes"]
    LE["Levenshtein 1965/1966<br/>deletions, insertions, reversals"]
    WF["Wagner-Fischer 1974<br/>O(mn) DP + traceback"]
    LW["Lowrance-Wagner 1975<br/>transpositions, true DL"]
    HI["Hirschberg 1975<br/>linear-space alignment"]
  end
  subgraph fast["1980-2003: exploiting structure"]
    direction TB
    MP["Masek-Paterson 1980<br/>Four Russians"]
    UK["Ukkonen 1985<br/>band, O(d min(m,n))"]
    MY86["Myers 1986<br/>O(ND) diff"]
    MY99["Myers 1999<br/>bit-vector"]
    HY["Hyyro 2003<br/>bit-vector OSA"]
  end
  subgraph dict["1973-2012: searching a dictionary"]
    direction TB
    BK["Burkhard-Keller 1973<br/>metric tree"]
    SM["Schulz-Mihov 2002<br/>Levenshtein automata"]
    LU["Lucene 4.0<br/>automaton FuzzyQuery"]
    SS["SymSpell 2012<br/>symmetric delete"]
  end
  subgraph lb["2015-2020: limits"]
    direction TB
    BI["Backurs-Indyk 2015<br/>no O(n^(2-d)) under SETH"]
    AP["CDGKS 2018<br/>Andoni-Nosatzki 2020<br/>constant-factor approx."]
  end
  LE --> WF
  DA --> LW
  WF --> LW
  WF --> HI
  WF --> MP
  WF --> UK
  UK -.-> MY86
  UK --> MY99
  MY99 --> HY
  BK ~~~ SM
  SM --> LU
  LU ~~~ SS
  WF --> BI
BI --> AP定义与动态规划。Levenshtein 距离的动态规划在多个领域被独立发现过:语音识别、分子生物学和计算机科学各有一套,Kruskal 在 1983 年的 SIAM Review 综述《An Overview of Sequence Comparison》里专门梳理了这段历史。计算机科学里的标准引用是 Wagner 与 Fischer 的《The String-to-String Correction Problem》(JACM 1974),它给出了 \(O(mn)\) 的填表算法和回溯出编辑序列的方法。一年后 Lowrance 与 Wagner(JACM 1975)把相邻转置加进来,给出了真正的 Damerau-Levenshtein 距离的算法(第六节)。Hirschberg(CACM 1975)用分治把求最优比对所需的空间降到线性,那篇论文写的是 LCS,思路同样适用于编辑距离。
利用结构加速。Masek 与 Paterson(JCSS
1980)用”四个俄罗斯人”(Four
Russians)技巧把有限字母表上的最坏时间降到 \(O(n^2/\log
n)\)。另一条路线利用”距离小”这个条件:Ukkonen(Information
and Control 1985)证明只需计算对角线附近的带状区域,时间是
\(O(d \cdot
\min(m,n))\),\(d\)
为距离(第四节)。Myers 1986 年的 \(O(ND)\)
算法(Algorithmica)解的是 indel 距离与最短编辑脚本,是今天
git diff 默认算法的出处。Myers 1999
年的位并行算法(JACM)则把 DP
的一整列塞进机器字(第五节),Hyyrö(Nordic Journal of
Computing 2003)把它推广到 OSA。
在词典里查找。Burkhard 与 Keller(CACM
1973)的度量树只用三角不等式剪枝,不关心距离的具体定义。Schulz
与 Mihov(IJDAR 2002)为固定的 \(k\) 构造识别”与模式距离不超过
\(k\)
的所有串”的确定性自动机,Mihov 与 Schulz(Computational
Linguistics 2004)又把它与词典自动机结合。Lucene 4.0
用这套方法重写了
FuzzyQuery。SymSpell(Garbe,2012)走了另一条路:只做删除,用空间换时间(第七节)。
下界。Backurs 与 Indyk(STOC 2015;SIAM Journal on Computing 2018)证明:若编辑距离能在 \(O(n^{2-\delta})\) 时间内算出,则 SETH 不成立。同年 Abboud、Backurs、Vassilevska Williams 和 Bringmann、Künnemann(均为 FOCS 2015)把类似结论推广到 LCS 等问题。精确算法的路基本被堵住后,研究转向近似:Chakraborty、Das、Goldenberg、Koucký、Saks(FOCS 2018)给出第一个真正次平方时间的常数倍近似,Andoni 与 Nosatzki(FOCS 2020)把时间压到 \(n^{1+\varepsilon}\)(第十节)。
三、Wagner-Fischer:填表与回溯
填表
按递推式逐行填一个 \((m+1)\times(n+1)\)
的表即可。下图是 kitten 到 sitting
的完整表,数值由 reproduce/draw_figures.py
计算,与 ./ed_test example 的输出一致:
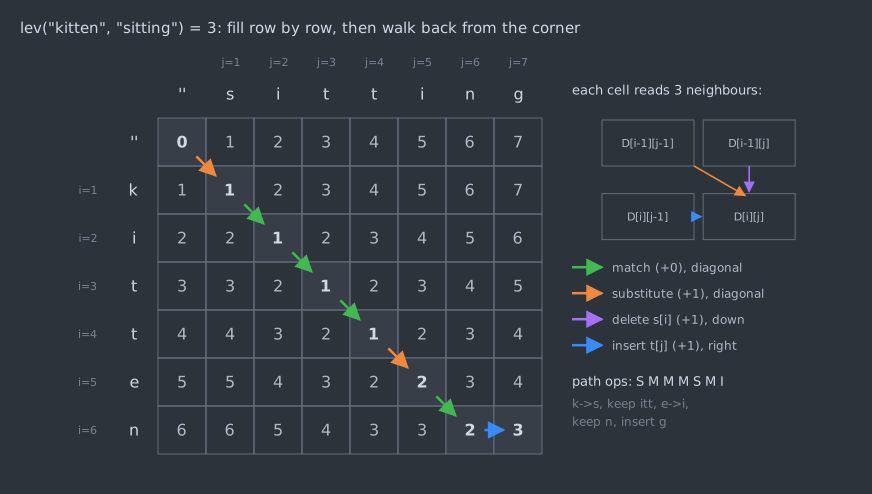
每个格子只读三个邻居:左上(匹配或替换)、上(删除 \(s_i\))、左(插入 \(t_j\))。所以可以按行、按列或按反对角线填,反对角线上的格子互不依赖,这是 GPU 和 SIMD 实现的出发点。
reproduce/ed.h
里的实现(lev_matrix(),未删减):
/* D has (m+1)*(n+1) ints, row-major; D[i*(n+1)+j] = lev(s[0..i), t[0..j)) */
static inline int lev_matrix(const uchar *s, int m, const uchar *t, int n, int *D)
{
    int w = n + 1;
    for (int i = 0; i <= m; i++) D[i * w] = i;
    for (int j = 0; j <= n; j++) D[j] = j;
    for (int i = 1; i <= m; i++)
        for (int j = 1; j <= n; j++)
            D[i * w + j] = min3(D[(i - 1) * w + j] + 1,          /* delete s[i-1] */
                                D[i * w + j - 1] + 1,            /* insert t[j-1] */
                                D[(i - 1) * w + j - 1] + (s[i - 1] != t[j - 1]));
    return D[m * w + n];
}
回溯出编辑序列
距离之外常常还要知道”怎么改”。从 \((m,n)\)
出发,每一步找一个能解释当前值的邻居:若 \(D_{i,j} = D_{i-1,j-1} + [s_i \ne
t_j]\) 就走对角线,否则若 \(D_{i,j} = D_{i-1,j} + 1\)
就向上(删除),否则向左(插入)。lev_traceback()
按”对角线、删除、插入”的顺序打破平局,kitten 到
sitting 得到 SMMMSMI:替换 k 为
s,保留 itt,替换 e 为 i,保留 n,插入 g,共 3 次操作。
最优编辑序列一般不唯一,平局顺序决定返回哪一条。这在
diff
这类要给人看的场景里很重要,但不影响距离本身。测试程序对 30
万对随机串检查了回溯结果:把操作序列应用到 \(s\) 上必须恰好得到 \(t\),并且代价等于 \(D_{m,n}\)。
空间
只要距离、不要序列时,第 \(i\) 行只依赖第 \(i-1\) 行,一行 \(n+1\)
个整数加一个保存左上角的临时变量就够了(lev_row())。空间是
\(O(\min(m,n))\)(让短串做列),时间不变。要序列又要线性空间时用
Hirschberg
的分治:从两端各算一半,找到最优路径穿过中间行的位置,再递归两半,时间仍是
\(O(mn)\),常数约翻倍。
\(O(mn)\) 对拼写纠错的短词无所谓,对两份各 10 万字符的文本就是 \(10^{10}\) 个格子。后面两节是两种不改变最坏复杂度、但在实际输入上快几倍到几十倍的办法(第八节实测)。
四、只关心距离不超过 \(k\):带状 DP 与 Ukkonen
模糊查找几乎从不需要精确距离,只需要回答”是否 \(\le k\)“。这时可以只算一条带子。
为什么只算带子是安全的
由第一节的界 \(D_{i,j} \ge |i-j|\),凡是 \(|i-j| > k\) 的格子值都已经大于 \(k\)。DP 路径上的值单调不减(每一步加 0 或 1),所以代价不超过 \(k\) 的路径上每个格子都 \(\le k\),也就都在 \(|i-j| \le k\) 的带子里。把带外格子当作 \(k+1\) 处理,带内凡是真实值 \(\le k\) 的格子都不受影响,结果是 \(\min(d, k+1)\)。
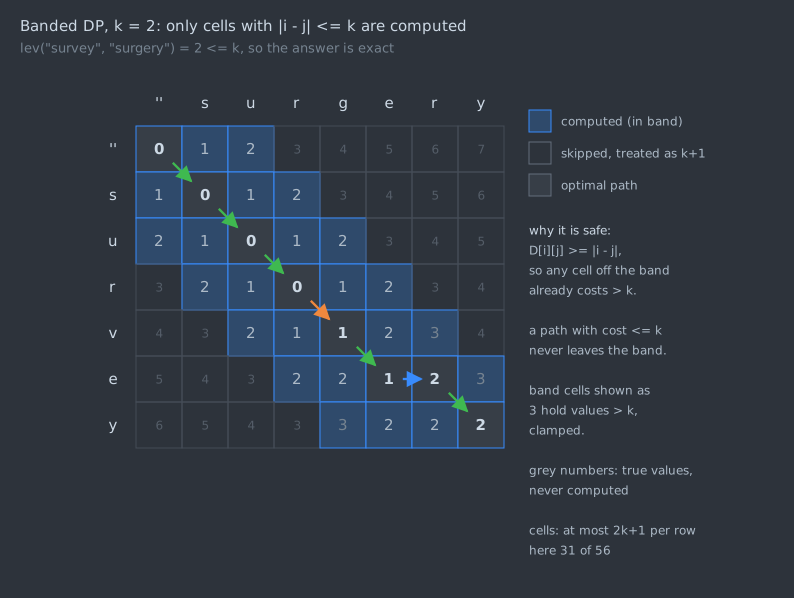
图中 survey 与 surgery 的距离是
2,带宽 \(2k+1 = 5\),56
个格子只算了 31 个。带内显示为 3 的格子真实值大于 \(k\),被截断。
还有一个提前退出:若某一行带内所有值都 \(>
k\),任何路径都要穿过这一行,结果一定 \(>
k\),可以直接返回。lev_band()
的核心循环(摘自
reproduce/ed.h,省略了初始化):
    for (int i = 1; i <= m; i++) {
        int lo = i - k > 1 ? i - k : 1;
        int hi = i + k < n ? i + k : n;
        /* ... diag / row[0] set up for this row ... */
        for (int j = lo; j <= hi; j++) {
            int up = row[j];                /* row[i+k] still holds INF */
            int v = min3(up + 1, row[j - 1] + 1, diag + (s[i - 1] != t[j - 1]));
            if (v > INF) v = INF;
            diag = up;
            row[j] = v;
            if (v < rowmin) rowmin = v;
        }
        if (cells) *cells += hi - lo + 1;
        if (rowmin > k) return INF;         /* every path crosses row i */
    }
每行最多 \(2k+1\) 格,时间 \(O(k \cdot \min(m,n))\);若 \(|m-n| > k\),一个格子都不用算。
距离未知时:倍增
要精确距离又事先不知道它多大时,从 \(k = \max(1, |m-n|)\) 开始调用
lev_band(),结果 \(> k\) 就把 \(k\)
翻倍重试(lev_ukkonen())。设真实距离为 \(d\),最后一轮的 \(k <
2d\),各轮代价是等比数列,总代价是 \(O(d \cdot \min(m,n))\),与
Ukkonen(1985)给出的界同阶。
代价是常数。两个串很像时,这比全表便宜得多;两个串毫无关系时,\(d\) 接近 \(n\),倍增要多做几轮,反而比全表贵。第八节的数据是:4 字母随机串上,倍增算的格子数是全表的 2.0 到 2.1 倍;5% 随机编辑的相似串上只有全表的 12% 到 22%。
带状 DP 的”对角线”视角还能再往前走一步:只记录每条对角线上代价为 \(e\) 时沿匹配字符能走到的最远位置,这就是 Myers 1986 年 \(O(ND)\) 算法的思路(Ukkonen 1985 年的论文里有同样的想法)。本文不展开这条线,只用它说明:编辑距离的难度取决于 \(d\),第十节的平方下界针对的是 \(d\) 与 \(n\) 同阶的最坏情况。
五、把一整列塞进机器字:Myers 与 Hyyrö 的位并行算法
相邻格子只差 \(-1\)、\(0\)、\(+1\)
DP 表有一个比数值本身更紧的结构:同一列相邻两格之差 \(\Delta v_{i,j} = D_{i,j} - D_{i-1,j}\) 只能是 \(-1\)、\(0\)、\(+1\),同一行相邻两格之差 \(\Delta h_{i,j} = D_{i,j} - D_{i,j-1}\) 也一样。原因是 \(D_{i,j} \le D_{i-1,j} + 1\)(多删一个字符),且 \(D_{i-1,j} \le D_{i,j} + 1\):从 \(s_{1..i}\) 与 \(t_{1..j}\) 的最优对齐里拿掉 \(s_i\),若它原本被删除,代价减 1;若它原本与某个 \(t_l\) 对齐,改成插入 \(t_l\),代价至多加 1。行方向同理。
于是一列可以不存数值,只存 \(m\) 个差分,用两个 \(m\) 位的字编码:
\[ P_v[i] = [\Delta v_{i,j} = +1],\qquad M_v[i] = [\Delta v_{i,j} = -1]. \]
第 0 列的差分全是 \(+1\),所以初始 \(P_v\) 全 1、\(M_v\) 全 0。第 \(m\) 行的值 \(D_{m,j}\) 单独用一个整数
score 跟踪。
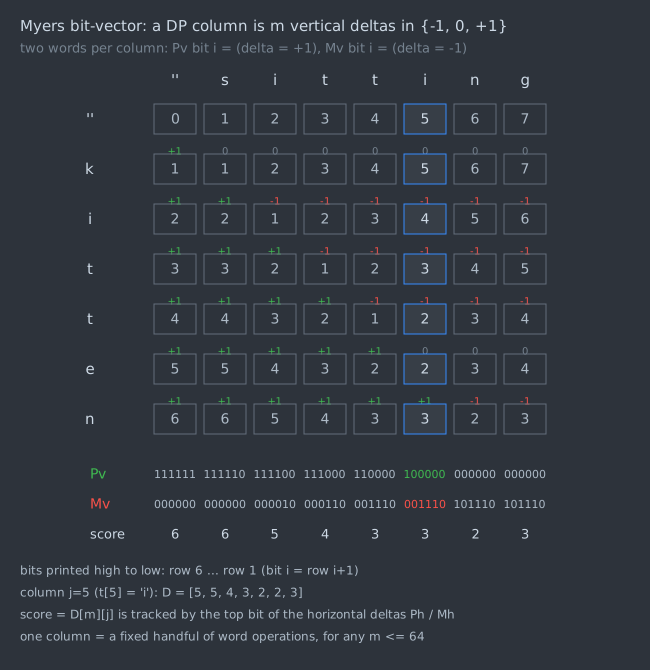
图中高亮的第 5 列从上到下是 \(5,5,4,3,2,2,3\),差分为 \(0,-1,-1,-1,0,+1\),按”高位是第 6 行”打印就是 \(P_v = 100000\)、\(M_v = 001110\)。
一列的更新
Myers(JACM 1999)推导出:已知第 \(j-1\) 列的 \(P_v, M_v\) 和字符 \(t_j\) 的匹配掩码 \(\mathit{Eq}\)(第 \(i\) 位表示 \(s_i =
t_j\)),可以用固定的几条位运算算出第 \(j\)
列。唯一不显然的是一次加法:沿着一列,“水平差分为 \(-1\)”会顺着匹配位向下传播,这种传播正好是二进制加法的进位链。下面是
reproduce/ed.h 中 myers64_peq()
的循环体,写法采用 Hyyrö 整理后的形式:
    for (int j = 0; j < n; j++) {
        uint64_t eq = peq[t[j]];
        uint64_t xv = eq | mv;
        uint64_t xh = (((eq & pv) + pv) ^ pv) | eq;
        uint64_t ph = mv | ~(xh | pv);      /* horizontal +1 */
        uint64_t mh = pv & xh;              /* horizontal -1 */
        if (ph & last) score++;
        else if (mh & last) score--;
        ph = (ph << 1) | 1;                 /* row 0: D[0][j] - D[0][j-1] = +1 */
        mh <<= 1;
        pv = mh | ~(xv | ph);
        mv = ph & xv;
    }
peq[c] 是预处理好的”字符 \(c\) 在 \(s\) 中出现位置”的位图,只依赖
\(s\)。\(m \le 64\)
时每列是固定的十几次字运算,与 \(m\) 无关,总时间 \(O(n)\);一般情况是 \(O(\lceil m/w\rceil n)\),\(w\)
为字长。ph = (ph << 1) | 1 里的
| 1 对应第 0 行 \(D_{0,j} = j\) 的水平差分恒为
\(+1\)。测试时把它删掉,穷举测试中有
91,421 对算错。
超过 64 位:分块与进位
\(m > 64\)
时把一列切成 \(\lceil
m/64\rceil\)
个字。块与块之间要传两样东西:加法的进位,以及块底边的水平差分
\(h \in
\{-1,0,+1\}\),它就是下一块的”第 0
行”。myers_block() 把 \(h\) 作为输入,并按 \(h\) 的符号给下一块的
ph/mh 最低位补
1;删掉这一步,测试中有 43,481
对算错。这是位并行实现里最容易写错的地方。
Myers 原文解的是近似串匹配(在长文本里找与模式距离 \(\le k\) 的位置),与求两个串的全局距离只差边界条件:前者第 0 行全是 0,后者第 0 行是 \(0,1,2,\dots\)。本文的全局版本在 30 万对随机串上与朴素 DP 逐一比较,全部一致。
Hyyrö 的 OSA 位并行
Hyyrö(Nordic Journal of Computing 2003)把位并行推广到
OSA。转置对应”从 \((i-2,j-2)\) 跳到 \((i,j)\)“,在差分表示里只需给对角零差分向量
\(D_0\)
多加一项:当前列的匹配位左移一位后,与上一列的匹配掩码相与,并排除本来就是对角零的位置。osa_bitpar64()
中这一行是
uint64_t tr = ((~d0 & pm) << 1) & pm_prev;删掉 tr,程序退化为 Levenshtein,测试中有
12,428 对 OSA 距离算错。Hyyrö 给出的时间界是 \(O(\lceil d/w\rceil m + \lceil
n/w\rceil\sigma)\),其中 \(\sigma\) 是字母表大小。真正的
Damerau-Levenshtein
需要”上次在哪里见过这个字符”的全局信息(第六节),多出的这一项不再是局部的位运算,本文只实现了它的
DP 版本。
六、加上转置:OSA 与真正的 Damerau-Levenshtein
两种”加转置”的写法
最直接的做法是在递推式里加一项:若 \(s_{i-1}s_i = t_j t_{j-1}\)(两个字符恰好对调),允许从 \(D_{i-2,j-2}\) 花 1 步过来。
\[ D_{i,j} = \min\bigl(\dots,\; D_{i-2,j-2} + 1\bigr)\quad\text{当 } i,j \ge 2,\; s_i = t_{j-1},\; s_{i-1} = t_j. \]
这就是 OSA(optimal string
alignment,也叫 restricted edit
distance)。它算的不是”允许四种操作的最短编辑序列”,而是”每个子串最多被编辑一次”的最优对齐:一对字符转置之后,不能再在它们中间插入字符,也不能再改它们。reproduce/ed.h
的 osa_dp() 就是在 lev_matrix()
的内层循环里多两行:
            if (i > 1 && j > 1 && s[i - 1] == t[j - 2] && s[i - 2] == t[j - 1])
                v = min2(v, D[(i - 2) * w + j - 2] + 1);
真正的 Damerau-Levenshtein 距离允许任意顺序地使用四种操作。Lowrance 与 Wagner(JACM 1975)证明,当转置代价 \(T\) 与插入、删除代价满足 \(2T \ge I + D\)(单位代价时成立)时,只需考虑一种带转置的形式:转置两个字符,并在它们之间删除 \(s\) 一侧的若干字符、插入 \(t\) 一侧的若干字符。这种形式 OSA 表达不了,所以递推要能从更远的位置跳过来:对当前的 \((i,j)\),找 \(t_j\) 在 \(s_{1..i-1}\) 中最后出现的位置 \(i_1\),和 \(s_i\) 在 \(t_{1..j-1}\) 中最后出现的位置 \(j_1\),候选值是
\[ D_{i_1-1,\,j_1-1} + (i - i_1 - 1) + 1 + (j - j_1 - 1), \]
即删掉 \(s\)
这一侧夹在中间的字符,转置一次,插入 \(t\)
这一侧夹在中间的字符。dl_dp()
用一个按字符索引的数组 da[] 记录”每个字符在
\(s\)
中最后出现的行”,用变量 db
记录”本行最后一次匹配的列”,时间仍是 \(O(mn)\),但需要 \(O(\sigma)\)
的额外空间,且依赖整行之前的信息。
一个最小反例
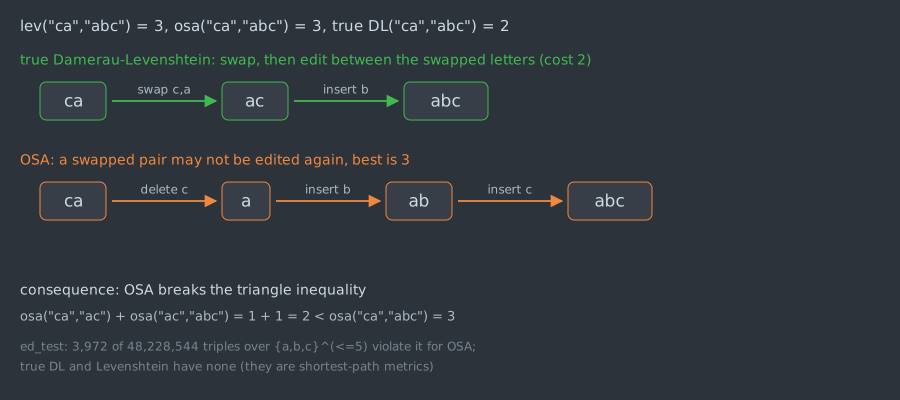
ca 到 abc:Levenshtein 距离
3,OSA 3,真 DL 2(./ed_test example
的输出)。而 \(\mathrm{osa}(\texttt{ca},\texttt{ac})
= 1\),\(\mathrm{osa}(\texttt{ac},\texttt{abc})
= 1\),所以
\[ \mathrm{osa}(\texttt{ca},\texttt{abc}) = 3 > 2 = \mathrm{osa}(\texttt{ca},\texttt{ac}) + \mathrm{osa}(\texttt{ac},\texttt{abc}). \]
OSA 违反三角不等式,不是度量。真 DL 是”四种操作构成的图上的最短路”,天然是度量。
测试程序在字母表 \(\{a,b,c\}\) 上、长度不超过 5 的全部字符串之间做了穷举:
- 用 BFS 在”所有中间串长度不超过
8”的操作图上求出真实最短路,132,496 对上
lev_matrix()和dl_dp()都与 BFS 一致; - OSA 比 Levenshtein 小的有 9,210 对,OSA 比真 DL 大的有 1,740 对;
- 在 48,228,544 个三元组中,OSA 违反三角不等式的有 3,972 个,最短的一个是 \(\mathrm{osa}(\texttt{ab},\texttt{bca}) = 3 > \mathrm{osa}(\texttt{ab},\texttt{ba}) + \mathrm{osa}(\texttt{ba},\texttt{bca}) = 1 + 1\)。Levenshtein 与真 DL 没有违反。
在真实拼写错误上差多少
在第八节使用的维基百科拼写错误语料(2,429 对”错误拼写 → 正确拼写”)上:
| 距离 | 0 | 1 | 2 | 3 | 4 | \(\ge 5\) |
|---|---|---|---|---|---|---|
| Levenshtein | 2 | 1,647 | 700 | 58 | 16 | 6 |
| OSA | 2 | 1,987 | 382 | 42 | 10 | 6 |
| 真 DL | 2 | 1,987 | 384 | 40 | 10 | 6 |
有 364 对(15%)的 OSA 距离小于 Levenshtein 距离,这些错误的最优对齐里都有一次相邻字母对调,转置确实值得算作一步。但真 DL 比 OSA 更小的只有 2 对。对拼写纠错来说,OSA 与真 DL 的差别在统计上可以忽略,这也解释了为什么工程实现普遍选 OSA:它可以直接套用带状 DP、位并行和 Levenshtein 自动机,真 DL 需要额外的全局状态。
代价在别处:OSA 不是度量,不能直接用于依赖三角不等式的索引。BK-tree 这样的度量树用 OSA 剪枝会漏掉结果;第七节的 BK-tree 实验因此只用 Levenshtein 距离。“Damerau-Levenshtein”这个名字在文档里常被不加区分地用于两者,读到它时要看实现。第九节核对的 Lucene、SymSpell、git 实现的都是 OSA。
七、在词典里找:BK-tree、Levenshtein 自动机与对称删除
问题变成:给定词典 \(W\)(\(N\) 个词)、查询 \(q\) 和阈值 \(k\),返回所有 \(d(q,w) \le k\) 的 \(w\)。最朴素的做法是逐词计算。先用
\(|\,|q| - |w|\,| \le k\)
过滤,再用位并行算法验证,这是本文实验的基线
brute+myers。下面三种索引各自避开一部分计算。
BK-tree:只用三角不等式
Burkhard 与 Keller(CACM 1973)的树对任意离散度量都适用。建树时,每个新词从根往下走,算出它与当前节点的距离 \(e\),沿标号为 \(e\) 的边下去;没有这条边就挂成新孩子。查询时,在节点 \(x\) 算出 \(d = d(q, x)\)。对标号为 \(e\) 的子树里任意 \(w\),有 \(d(x,w) = e\),由三角不等式
\[ d(q,w) \;\ge\; |\,d(q,x) - d(x,w)\,| = |d - e|, \]
所以只有 \(e \in [d-k,\, d+k]\) 的子树可能含答案,其余整棵剪掉。
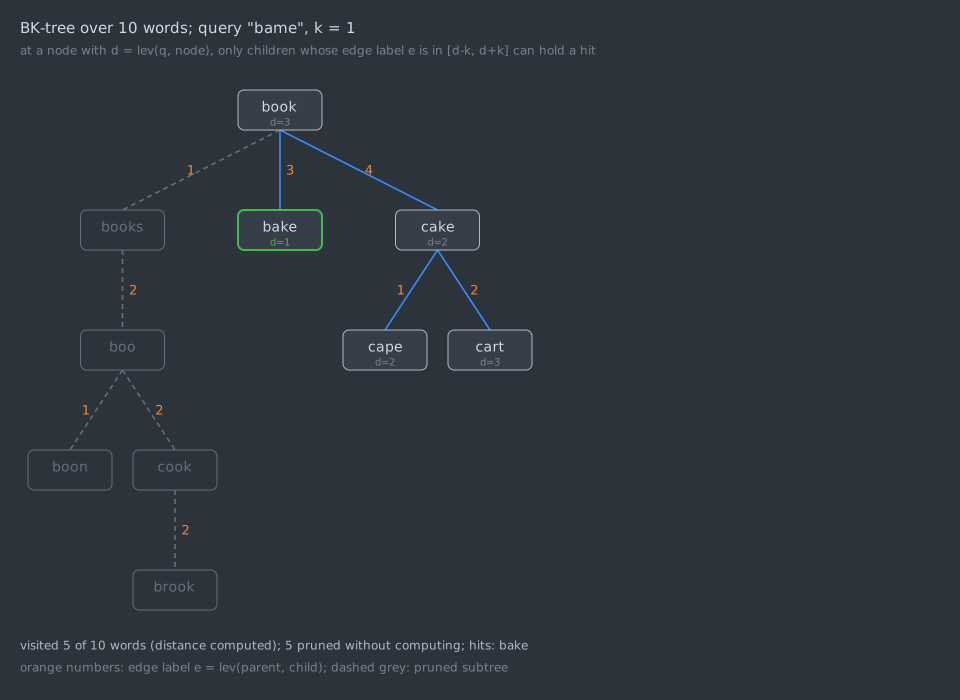
图中的小例子访问了 10 个节点中的 5 个。问题在于编辑距离只取很少几个整数值:英文单词之间的距离大多落在个位数,而 \(k=2\) 时每个节点最多要进入 5 个标号的子树,剪掉的比例有限。第八节的实测是,82,769 词的词典上,\(k=1\) 时 BK-tree 每次查询算 2.5% 的词,\(k=2\) 时 18%,\(k=3\) 时 39%。它又无法像暴力扫描那样先用长度差过滤掉大部分词,\(k=3\) 时比暴力扫描更慢。建树顺序(按词频还是随机打乱)对结果影响不大,树高分别是 20 和 18。
BK-tree 要求距离是度量。第六节已经说明 OSA 不满足三角不等式,用它剪枝会漏结果,所以这里只用 Levenshtein 距离。
Levenshtein 自动机
换个角度:对固定的 \(q\) 和 \(k\),集合 \(L_k(q) = \{\,w : d(q,w) \le k\,\}\) 是有限集,因此是正则语言,可以用自动机识别。NFA 很直观:状态 \((i, e)\) 表示”已经匹配了 \(q\) 的前 \(i\) 个字符,用了 \(e\) 次编辑”。
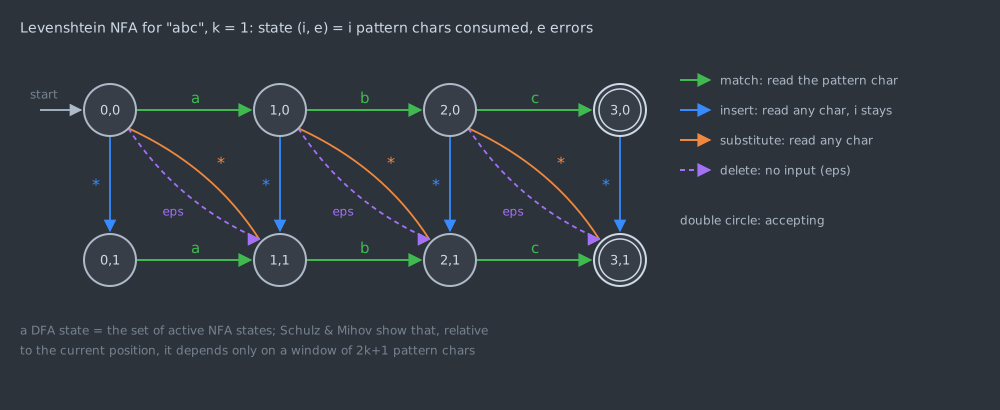
直接确定化的 DFA 大小依赖 \(|q|\)。Schulz 与 Mihov(IJDAR 2002)的关键观察是:DFA 状态(即活跃 NFA 状态的集合)相对于当前位置只依赖 \(q\) 中一个宽 \(2k+1\) 的窗口里哪些位置与输入字符相等。于是可以对每个 \(k\) 离线算好一张与 \(q\) 无关的”参数化”转移表,在线时只需沿着 \(q\) 查表,不必对每个查询做子集构造。这张表的规模随 \(k\) 迅速增长,Lucene 只内置了 \(k=1\) 和 \(k=2\) 两张(第九节)。
有了 DFA,查询就是把它和词典的 Trie(或最小化的词典自动机)做同步遍历:两边都有转移才往下走,DFA 进入死状态就剪枝。Mihov 与 Schulz(Computational Linguistics 2004)系统研究了这种组合。
Trie + DP 行:不预先建自动机
不想实现参数化表时,有一个等价的做法:在 Trie
上深度优先搜索,每个节点维护一行 DP,即 \(q\)
的各个前缀与”从根到该节点拼出的词前缀”之间的距离。进入孩子节点时由父节点的行算出新行,只需
\(O(|q|)\)。行最小值 \(> k\)
时,该子树里任何词的距离都 \(>
k\)(与第四节的提前退出同理),直接剪掉。这一行 DP
本质上就是 Levenshtein NFA
的一个状态集合,只是按需计算,不查表。reproduce/dict_search.c
的 trie_dfs():
        cur[0] = depth + 1;
        int rowmin = cur[0];
        for (int i = 1; i <= m; i++) {
            cur[i] = min3(prev[i] + 1, cur[i - 1] + 1, prev[i - 1] + (q[i - 1] != 'a' + c));
            if (cur[i] < rowmin) rowmin = cur[i];
        }
        if (T[y].word >= 0 && cur[m] <= k) vpush(out, T[y].word);
        if (rowmin <= k) trie_dfs(y, depth + 1, q, m, k, out);
共享前缀的词只算一次前缀部分,这是它比逐词计算快的原因。实测 \(k=2\) 时每次查询访问约 1 万个 Trie 节点,占 204,788 个节点的 5.1%。
对称删除(SymSpell)
Norvig 的拼写纠错短文把 \(q\) 的所有距离 1 的变体都枚举出来查表:长为 \(n\) 的词有 \(n\) 个删除、\(n-1\) 个转置、\(26n\) 个替换、\(26(n+1)\) 个插入,共 \(54n+25\) 个候选,\(k=2\) 时对每个候选再枚举一遍,数量是平方级。Garbe 2012 年提出的 SymSpell 只保留删除:
- 建索引:对词典里每个词,生成删掉至多 \(k\) 个字符得到的所有串,建”删除串 \(\to\) 原词列表”的哈希表;
- 查询:对 \(q\) 同样生成删掉至多 \(k\) 个字符的所有串,逐个查表,取出候选词,再用真正的距离验证。
正确性来自一个简单事实:若 \(d(q,w) \le k\),则从 \(q\) 和 \(w\) 各删掉至多 \(k\) 个字符可以得到同一个串(替换对应两边各删一个,插入和删除对应一边删一个)。候选集因此是完整的,验证只是去掉假阳性。查询时生成的删除串数与字母表大小无关,\(k=2\) 时平均 42.9 个。
代价是索引:82,769 个词在 \(k=2\) 时产生 256
万个不同的删除串和 324 万条倒排记录,\(k=3\) 时是 685 万和 954
万。SymSpell 的默认实现只对词的前 7
个字符生成删除串(prefixLength = 7)来压缩索引。本文的实现不截断前缀,以便与其他方法比较完全相同的结果集。
八、实验:对拍、单对计算与词典检索
环境与方法
- 硬件与系统:Intel Core i9-12900K,WSL2(Linux 6.6.87.2-microsoft-standard-WSL2),GCC 16.1.1;
- 编译:
-O2 -Wall -Wextra,另编一份-O1 -g -fsanitize=address,undefined跑同样的测试; - 计时:
taskset -c 9绑核,每个配置取 5 次重复的中位数,整套跑 3 遍取中位数的中位数。WSL2 上的绝对时间不具有可移植性,下文只用时间看相对趋势;结论主要依据与时钟无关的计数(格子数、字运算次数、距离调用次数、Trie 节点数),这些计数 3 遍完全一致。
复现:
cd post/algorithms/26-edit-distance/reproduce
DATA=/tmp/ed-data sh fetch_data.sh      # 下载词典和拼写错误语料并校验 SHA-256
DATA=/tmp/ed-data sh run.sh 9           # 编译、测试、绑定 CPU 9 跑 3 遍基准
python3 plot_bench.py                   # 需要 matplotlib;汇总 results/summary.txt 并画两张数据图
python3 draw_figures.py                 # 重画本文的 6 张示意图(数值由脚本计算并断言)
java -cp lucene-core-9.12.0.jar LevCheck.java > results/lucene_check.txt   # 第九节;jar 的获取与校验见文件头
正确性
./ed_test test 做两类对拍,输出在
results/test.txt,sanitizer 版本输出相同:
- 穷举:\(\{a,b,c\}\) 上长度不超过 5 的
364 个串两两组合,共 132,496 对,以操作图上的 BFS
最短路为真值,检查
lev_matrix()与dl_dp()(第六节); - 随机:30 万对串(字母表大小
2、4、26,长度 0 到
400),
lev_row()、lev_band()、lev_ukkonen()、myers_blocks()与回溯结果都与lev_matrix()比较;其中 255,959 对长度不超过 64,额外检查myers64();254,705 对检查osa_bitpar64()与osa_dp()。
为确认测试有检出能力,我对实现做了变异:去掉 Myers 算法第
0 行的 | 1、去掉块间进位、去掉真 DL
的转置项、去掉 Hyyrö 的 tr 项,测试分别报告
91,421、43,481、32,588、12,428 对错误。去掉
lev_band() 中把带外左邻居设为 \(k+1\)
的赋值和提前退出,测试仍然通过:前者是冗余的(过期的左邻居加
1 不会小于对角线候选),后者只是优化。
单对计算:格子数与字运算
./ed_test bench 对每个长度 \(n\) 生成两种输入(字母表大小
4):5%-edits 是一个随机串与它做了 \(n/20\)
次随机编辑后的副本,random
是两个独立的随机串。
| \(n\) | 输入 | 距离 \(d\) | 全表格子 | 倍增带状格子 | 带状/全表 | Myers 字更新 | 单行 DP / Myers 时间比 |
|---|---|---|---|---|---|---|---|
| 16 | 5%-edits | 1 | 240 | 44 | 0.18 | 15 | 2.6 |
| 16 | random | 11 | 256 | 540 | 2.11 | 16 | 2.4 |
| 256 | 5%-edits | 11 | 65,024 | 14,069 | 0.22 | 1,016 | 30.8 |
| 256 | random | 139 | 65,536 | 134,007 | 2.04 | 1,024 | 31.1 |
| 1024 | 5%-edits | 42 | 1,056,768 | 195,363 | 0.18 | 16,512 | 29.2 |
| 1024 | random | 538 | 1,048,576 | 2,140,627 | 2.04 | 16,384 | 27.4 |
| 4096 | 5%-edits | 184 | 16,752,640 | 2,082,799 | 0.12 | 261,760 | 25.8 |
| 4096 | random | 2,128 | 16,777,216 | 34,300,063 | 2.04 | 262,144 | 22.0 |
\(n=64\)
的一行与相邻行趋势一致,完整数据在
results/summary.txt。
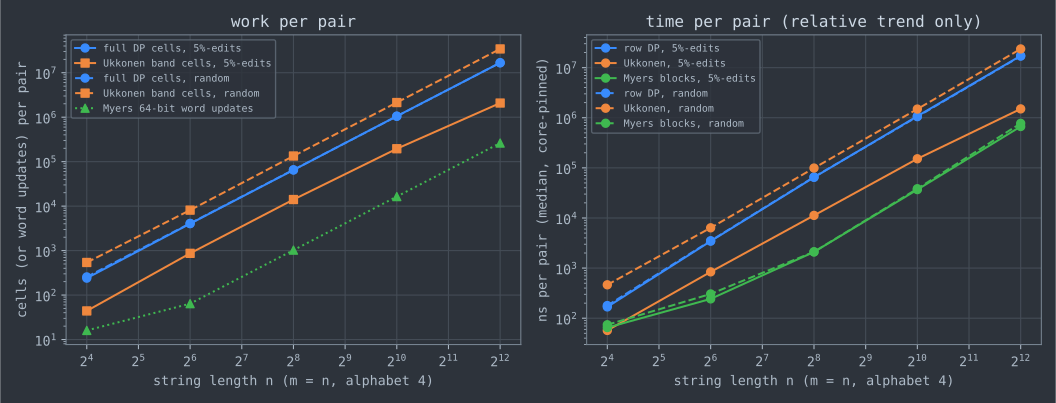
三点观察:
- 带状 DP 的收益完全取决于 \(d/n\)。相似输入上格子数降到全表的 12% 到 22%,随机输入上反而是 2 倍左右,与第四节的分析一致。
- Myers 的字更新次数恰好是 \(n \lceil m/64 \rceil\),与距离无关。\(n \ge 256\) 时它比单行 DP 快 22 到 31 倍。一次字更新代替 64 个格子,但它本身要做十几次位运算和一次加法,而一个格子只需几次比较和加法,所以倍数到不了 64。
- \(n=16\) 时单行 DP 与
Myers 只差 2 到 3 倍,相似输入上倍增带状甚至略快于
Myers。
myers_blocks()每次调用都要清零并填写 256 个字的匹配表,这个固定开销在短串上占比很大。对拼写纠错这种短词场景,单对算法的选择不如索引的选择重要。
词典检索
数据:
- 词典:SymSpell v6.7.3 附带的
frequency_dictionary_en_82_765.txt,82,834 条,只保留纯小写字母的 82,769 个词,词频用于排序; - 查询:伦敦大学伯贝克学院 Roger Mitton
整理的
wikipedia.dat,即维基百科编辑收集的常见拼写错误,文件说明为”1,922 个词的 2,455 个错误拼写”。转小写、只保留字母后剩 2,429 对,去重后 2,222 个查询串,其中 2,186 个查询的正确拼写在词典里。
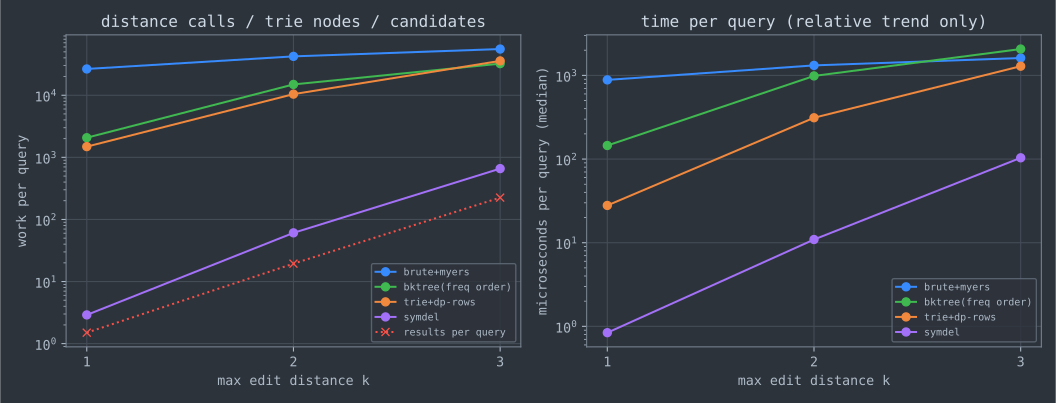
./dict_search 对每个 \(k\) 用 5
种方法各跑一遍全部查询,并检查它们返回的结果集完全相同(实测不一致数为
0)。“工作量”对暴力扫描和 BK-tree 是距离调用次数,对 Trie
是访问的节点数,对对称删除是需要验证的候选词数。
| \(k\) | 方法 | 工作量/查询 | 占比 | µs/查询 |
|---|---|---|---|---|
| 1 | brute+myers | 26,524.4 | 32.05% | 883.76 |
| 1 | BK-tree(按词频建树) | 2,071.6 | 2.50% | 145.22 |
| 1 | Trie + DP 行 | 1,488.6 | 0.73% | 27.89 |
| 1 | 对称删除 | 2.9 | 0.00% | 0.84 |
| 2 | brute+myers | 42,291.1 | 51.10% | 1,317.60 |
| 2 | BK-tree(按词频建树) | 14,941.0 | 18.05% | 985.89 |
| 2 | Trie + DP 行 | 10,426.9 | 5.09% | 311.77 |
| 2 | 对称删除 | 60.8 | 0.07% | 10.92 |
| 3 | brute+myers | 55,500.1 | 67.05% | 1,615.07 |
| 3 | BK-tree(按词频建树) | 32,324.9 | 39.05% | 2,066.30 |
| 3 | Trie + DP 行 | 35,762.2 | 17.46% | 1,288.68 |
| 3 | 对称删除 | 658.8 | 0.80% | 103.50 |
“占比”对 Trie 是相对 204,788 个 Trie 节点,其余是相对 82,769 个词。随机打乱顺序建的 BK-tree 工作量比按词频建树多 5% 到 7%,没有列出。
索引代价:
| 索引 | 规模 | 构建时间(单次) |
|---|---|---|
| BK-tree | 82,769 节点,树高 20 | 约 48 ms |
| Trie | 204,788 节点 | 约 13 ms |
| 对称删除 \(k=1\) | 647,800 个删除串,734,525 条倒排 | 约 0.12 s |
| 对称删除 \(k=2\) | 2,562,657 个删除串,3,239,654 条倒排 | 约 0.40 s |
| 对称删除 \(k=3\) | 6,852,133 个删除串,9,541,124 条倒排 | 约 1.3 s |
结论:
- BK-tree 的剪枝随 \(k\) 迅速失效。\(k=1\) 时它只算 2.5% 的词,\(k=3\) 时算 39%,而且因为没有长度过滤,比暴力扫描还慢。
- Trie + DP 行在 \(k \le 2\) 时明显优于 BK-tree,因为前缀共享让一次 DP 行计算服务许多词;\(k=3\) 时剪枝同样变弱。
- 对称删除的查询工作量比 Trie 少 50 到 500 倍,代价是索引:长为 \(L\) 的词最多产生 \(\sum_{i \le k}\binom{L}{i}\) 个删除串,\(k=3\) 时已有 954 万条倒排。
- \(k\) 本身是质量问题,不只是性能问题。正确拼写落在 \(k\) 以内的查询,\(k=1\)、2、3 时分别是 1,494、2,124、2,168 个(共 2,186)。按”距离最小、词频最高”取第一个候选,正确率在 \(k=1\)、2、3 时分别是 1,312、1,587、1,601(共 2,186)。\(k\) 从 2 放到 3,每次查询的结果从 19.4 个涨到 224.8 个,正确率只多了 14 个。这与 Norvig 在他的测试集上的观察方向一致:开发集 270 个词中只有 3 个超出距离 2,测试集 400 个中有 23 个。
九、生产实现:钉住版本核对
以下内容均来自指定版本的源码或随源码发布的文档。
Lucene 9.12.0:Levenshtein 自动机,最多 2 次编辑
Lucene 4.0 的 CHANGES 记录了两件事:LUCENE-1606 与
LUCENE-2089 用有限状态方法重新实现了
FuzzyQuery(Robert Muir、Mike McCandless、Uwe
Schindler、Mark Miller),LUCENE-3662 加入了转置。9.12.0
中的状况:
FuzzyQuery的 javadoc 写明它”基于 Damerau-Levenshtein(optimal string alignment)算法”,即 OSA;- 默认参数:
maxEdits = 2(常量MAXIMUM_SUPPORTED_DISTANCE),prefixLength = 0,maxExpansions = 50,transpositions = true;构造时maxEdits > 2直接抛IllegalArgumentException; - javadoc 还提醒,编辑距离必须小于查询词与候选词中较短者的长度,因此长度 1 到 2 的词有时匹配不到;
LevenshteinAutomata实现的是 Schulz-Mihov 的参数化构造,参数化表由 moman/finenight 工具离线生成(生成脚本在gradle/generation/moman/createAutomata.py),只有 \(k=1\)、2 两套,toAutomaton(n)在 \(n \ge 3\) 时返回null。
我用 lucene-core-9.12.0.jar 在 JDK 17
上做了验证(reproduce/LevCheck.java,输出在
results/lucene_check.txt):
| 查询 | 设置 | 结果 |
|---|---|---|
pytohn 与 python |
\(k=1\),允许转置 / 不允许转置 | 接受 / 不接受 |
ca 与 abc |
\(k=2\),允许转置 | 不接受(真 DL 距离为 2,OSA 为 3) |
ab 与 ba |
\(k=1\),允许转置 | 接受 |
ab 与 ba |
\(k=1\),不允许转置 | 不接受,需 \(k=2\) |
python 的自动机 |
\(k=2\),允许转置 | 75 个状态 |
python 的自动机 |
\(k=1\),不允许转置 | 24 个状态 |
开头的 pytohn 正是一次相邻对调:允许转置时
\(k=1\) 就能找回
python,否则要 \(k=2\)。ca 与
abc 那一行直接证实 Lucene 的语义是 OSA 而非真
DL。同一程序还确认 toAutomaton(3) 返回
null。
Elasticsearch
8.15.0:fuzziness: AUTO
Elasticsearch 8.15.0 基于 Lucene
9.11.1。Fuzziness 类中 AUTO
的两个阈值是 DEFAULT_LOW_DISTANCE = 3 与
DEFAULT_HIGH_DISTANCE = 6:词长(按 Unicode
码点计)小于 3 允许 0 次编辑,小于 6 允许 1 次,否则 2
次。数值形式的 fuzziness 用 Math.min(2, ...)
截断,写 3 也只按 2 处理。fuzzy
查询的其他默认值与 Lucene 相同。
这套上限与第八节的数据方向一致:在那份语料上 \(k=2\) 已覆盖绝大多数拼写错误,再放宽收益很小而候选暴涨。
SymSpell 6.7.3
SymSpell.cs 中
defaultMaxEditDistance = 2,defaultPrefixLength = 7,默认距离算法是
DamerauOSA,同样是 OSA。作者博客《1000x Faster
Spelling Correction
algorithm》(2012)里的速度倍数是作者自己的测量,本文没有复现;第八节在同一套结果集上的计数对比是本文自己的结论。
git 2.46.0:两种不同的”编辑距离”
git 里有两处用到编辑距离,性质完全不同。
命令纠错(用户敲错子命令时给出”最相似的命令”)。levenshtein.c
的注释称它为 Damerau-Levenshtein,实现只保留 3
行,转置只看相邻交换,属于
OSA。它支持四种操作分别设代价,注释特别说明只有删除与插入代价相等时,算出来的才是距离。help.c
的调用是
levenshtein(cmd, candidate, 0, 2, 1, 3) + 1四个权重依次是交换 0、替换 2、插入 1、删除
3。交换免费,删除比插入贵,结果不对称,更谈不上度量。它不是在衡量”差几个字符”,而是一个为”用户多半打漏了字母”调过的打分函数。另有
SIMILARITY_FLOOR = 7,得分低于 7
才算相似;常用命令的前缀匹配直接记 0 分。
git diff。Documentation/config/diff.txt
里 myers 的说明是”The basic greedy diff
algorithm. Currently, this is the default.”,即 Myers 1986
年的 \(O(ND)\)
算法,解的是只含插入和删除的最短编辑脚本。minimal
选项”Spend extra time to make sure the smallest possible
diff is produced”,言下之意是默认模式不保证给出最短的
diff。
十、争论与开放问题
平方是不是极限:SETH 下界
强指数时间假设(Strong Exponential Time Hypothesis,SETH)断言:对任意 \(\varepsilon > 0\),存在 \(q\) 使得 \(q\)-SAT 不能在 \(O(2^{(1-\varepsilon)N})\) 时间内求解,\(N\) 为变量数。Backurs 与 Indyk(STOC 2015;SIAM J. Comput. 2018)构造了一个归约:若两个长 \(n\) 的串的编辑距离能在 \(O(n^{2-\delta})\) 时间内算出(\(\delta > 0\)),则 CNF-SAT 可以在 \(M^{O(1)}\,2^{(1-\varepsilon)N}\) 时间内求解(\(M\) 为子句数),与 SETH 矛盾。同年 Abboud、Backurs、Vassilevska Williams(FOCS 2015)对 LCS 证明了同类结论,Bringmann 与 Künnemann(FOCS 2015)把它推广到二进制字母表和更多相似度度量。
这是条件下界,不是无条件证明。它的分量来自另一个方向:如果有人找到了强次平方的编辑距离算法,就等于推翻了 SETH,这会同时带来许多被认为不可能的 SAT 算法。
还剩一道缝:去掉多对数因子行不行?Masek-Paterson 已经去掉了一个 \(\log n\)。Abboud、Hansen、Vassilevska Williams 与 Williams(STOC 2016)证明,即便只是把平方时间除以一个足够大的多对数因子,也会推出目前无法证明的电路下界(例如 NEXP 不包含于非一致 \(\mathrm{NC}^1\));按他们的估计,除以约 \(\log^{1000} n\) 就足以得到新的电路下界。所以”平方除以多对数”也被一堵墙挡住了,只是这堵墙是”证明很难”,不是”不可能”。
近似:从 polylog 到常数倍
既然精确算法很可能做不到强次平方,研究转向近似。Andoni、Krauthgamer、Onak(2010)在近线性时间内给出了多对数倍近似。常数倍近似长期没有次平方算法,直到 Chakraborty、Das、Goldenberg、Koucký、Saks(FOCS 2018;JACM 2020)给出 \(\tilde O(n^{2-2/7})\) 时间的常数倍近似;Andoni 与 Nosatzki(FOCS 2020)把时间降到 \(n^{1+\varepsilon}\),近似倍数是依赖 \(\varepsilon\) 的常数。
仍然开放的方向包括:任意接近 1 的近似倍数能否在强次平方时间内做到;常数倍近似里,近似常数与时间指数之间的权衡能压到多紧。这些算法目前主要有理论意义,常数很大,实际系统里仍然用带状 DP、位并行和索引。
OSA 还是真 Damerau-Levenshtein
第六节的数据说明,在拼写错误上两者几乎只在极少数情况不同(2,429
对中 2 对)。实践中选 OSA 的理由很充分:可以复用带状
DP、位并行和 Levenshtein
自动机。争议点在于名字:不少文档与代码把 OSA 直接称作
“Damerau-Levenshtein”(git 的 levenshtein.c
注释就是一例;Lucene 的 javadoc 和 SymSpell 的
DamerauOSA 则在名字里标明了
OSA),使用者误以为它是度量,把它放进 BK-tree
或别的度量索引,就会静默地漏结果。这不是算法问题,是命名与文档问题,读到”Damerau-Levenshtein”时应当去看它是否支持”转置后再编辑”。
索引选型:空间换时间到什么程度
对称删除的查询工作量远低于另外几种方法,但索引按 \(\binom{L}{k}\) 膨胀;自动机方法索引就是词典本身的 Trie 或 FST,额外空间很小,但每个 \(k\) 需要一张参数化表,\(k\) 大了表会很大。Lucene 选了自动机,以 \(k \le 2\) 的限制换取与词项字典的直接结合;SymSpell 选了对称删除,并用前缀截断压缩索引。两者都把 \(k\) 限制在 2 左右,第八节的正确率数据说明这在拼写纠错里并不是太大的牺牲。
十一、工程选型与陷阱
选单对算法:
- 只要”是否 \(\le k\)“:带状 DP 加提前退出,或 Myers 位并行(模式不超过 64 字符时最简单)。
- 要精确距离、串较长:Myers 分块版本;两串很相似时也可以用倍增带状。
- 要编辑序列:全表回溯;内存不够就用 Hirschberg。
- 需要转置:先确认要的是 OSA 还是真 DL。OSA 可以直接用 Hyyrö 的位并行版本。
选词典索引:
- \(k=1\) 且词典中等:Trie + DP 行实现简单,效果已经很好。
- \(k \le 2\)、查询量大、内存充裕:对称删除。
- 已有 Lucene/Elasticsearch:直接用
FuzzyQuery/fuzziness: AUTO,接受 \(k \le 2\) 的上限。 - BK-tree 只在距离计算很贵、又没有更好结构可用的度量空间里值得考虑,对英文词典上的编辑距离不是好选择。
常见陷阱:
- 把 OSA 当度量用在 BK-tree、VP-tree 等度量索引上,静默漏结果。
- 按字节而不是按字符计算距离。UTF-8 下常用汉字占 3
个字节,一次替换可能被算成 3;Elasticsearch 的
AUTO规则按码点计长度。 - 位并行实现只测了 \(m \le 64\)。块间进位是最容易错的地方,第八节的变异测试中去掉它有 43,481 对出错。
- 忽略大小写、Unicode 规范化(组合字符与预组合字符)等预处理,距离算得再快也不对。
- 用绝对时间比较不同机器上的算法。本文的时间只看相对趋势,主要结论来自计数。
十二、参考资料
源码与文档(版本均已钉住)
- Apache Lucene
9.12.0:
org.apache.lucene.search.FuzzyQuery(javadoc、默认参数、maxEdits检查);org.apache.lucene.util.automaton.LevenshteinAutomata(MAXIMUM_SUPPORTED_DISTANCE、toAutomaton());Lev2TParametricDescription文件头关于 moman/finenight 与gradle/generation/moman/createAutomata.py的注释;lucene-core-9.12.0.jar上的验证实验。Lucene 4.0.0-ALPHA 的CHANGES.txt(LUCENE-1606、LUCENE-2089、LUCENE-3662)。 - Elasticsearch
v8.15.0:
org.elasticsearch.common.unit.Fuzziness;org.elasticsearch.index.query.FuzzyQueryBuilder。 - SymSpell
v6.7.3(
https://github.com/wolfgarbe/SymSpell):SymSpell/SymSpell.cs的默认参数;SymSpell/frequency_dictionary_en_82_765.txt。 - git
v2.46.0:
levenshtein.c;help.c中help_unknown_cmd()对levenshtein()的调用、SIMILARITY_FLOOR;Documentation/config/diff.txt中diff.algorithm的说明。
核心论文
- V. I. Levenshtein. Binary codes capable of correcting deletions, insertions, and reversals. Doklady Akademii Nauk SSSR 163(4):845–848, 1965;英译本 Soviet Physics Doklady 10(8):707–710, 1966.
- F. J. Damerau. A technique for computer detection and correction of spelling errors. CACM 7(3):171–176, 1964. doi:10.1145/363958.363994
- R. A. Wagner, M. J. Fischer. The string-to-string correction problem. JACM 21(1):168–173, 1974. doi:10.1145/321796.321811
- R. Lowrance, R. A. Wagner. An extension of the string-to-string correction problem. JACM 22(2):177–183, 1975. doi:10.1145/321879.321880
- E. Ukkonen. Algorithms for approximate string matching. Information and Control 64(1–3):100–118, 1985;Finding approximate patterns in strings. J. Algorithms 6(1):132–137, 1985.
- G. Myers. A fast bit-vector algorithm for approximate string matching based on dynamic programming. JACM 46(3):395–415, 1999(CPM 1998). doi:10.1145/316542.316550
- H. Hyyrö. A bit-vector algorithm for computing Levenshtein and Damerau edit distances. Nordic Journal of Computing 10(1):29–39, 2003(PSC 2002).
- K. U. Schulz, S. Mihov. Fast string correction with Levenshtein automata. IJDAR 5(1):67–85, 2002. doi:10.1007/s10032-002-0082-8
- A. Backurs, P. Indyk. Edit distance cannot be computed in strongly subquadratic time (unless SETH is false). STOC 2015, doi:10.1145/2746539.2746612;SIAM J. Comput. 2018, doi:10.1137/15M1053128
其他论文与综述
- W. A. Burkhard, R. M. Keller. Some approaches to best-match file searching. CACM 16(4):230–236, 1973.
- D. S. Hirschberg. A linear space algorithm for computing maximal common subsequences. CACM 18(6):341–343, 1975.
- W. J. Masek, M. S. Paterson. A faster algorithm computing string edit distances. JCSS 20(1):18–31, 1980.
- J. B. Kruskal. An overview of sequence comparison: time warps, string edits, and macromolecules. SIAM Review 25(2):201–237, 1983.
- E. W. Myers. An \(O(ND)\) difference algorithm and its variations. Algorithmica 1:251–266, 1986. doi:10.1007/BF01840446
- H. L. Morgan. Spelling correction in systems programs. CACM 13(2):90–94, 1970.
- G. Navarro. A guided tour to approximate string matching. ACM Computing Surveys 33(1):31–88, 2001.
- S. Mihov, K. U. Schulz. Fast approximate search in large dictionaries. Computational Linguistics 30(4):451–477, 2004.
- A. Abboud, A. Backurs, V. Vassilevska Williams. Tight hardness results for LCS and other sequence similarity measures. FOCS 2015, 59–78.
- K. Bringmann, M. Künnemann. Quadratic conditional lower bounds for string problems and dynamic time warping. FOCS 2015, 79–97.
- A. Abboud, T. D. Hansen, V. Vassilevska Williams, R. Williams. Simulating branching programs with edit distance and friends (or: a polylog shaved is a lower bound made). STOC 2016, 375–388.
- A. Andoni, R. Krauthgamer, K. Onak. Polylogarithmic approximation for edit distance and the asymmetric query complexity. FOCS 2010.
- D. Chakraborty, D. Das, E. Goldenberg, M. Koucký, M. Saks. Approximating edit distance within constant factor in truly sub-quadratic time. FOCS 2018, 979–990;JACM 67(6), 2020.
- A. Andoni, N. S. Nosatzki. Edit distance in near-linear time: it’s a constant factor. FOCS 2020, 990–1001.
工程资料
- P. Norvig. How to Write a Spelling
Corrector(
https://norvig.com/spell-correct.html,2007 年初稿,2016 年修订)。 - W. Garbe. 1000x Faster Spelling Correction
algorithm(2012,
https://seekstorm.com/blog/1000x-spelling-correction/)。 - R. Mitton. Corpora of
misspellings(
https://www.dcs.bbk.ac.uk/~ROGER/corpora.html),本文使用其中的wikipedia.dat。
实验
- 本文目录下的
reproduce/:ed.h(全部距离算法)、ed_test.c(对拍与单对基准)、dict_search.c(词典检索)、fetch_data.sh(数据下载与 SHA-256 校验)、run.sh、LevCheck.java(Lucene 自动机验证)、plot_bench.py、draw_figures.py,以及results/中的原始输出。
系列导航: - 上一篇:BWT 与 FM-index:从 bzip2 到基因组比对 - 下一篇:字符串哈希:Rabin-Karp、滚动哈希与内容定义分块
相关阅读: - AC 自动机:失败链接、输出链接与转移表布局 - 区间 DP 与矩阵链乘
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
HNSW:分层小世界图的近似近邻搜索
从 NSW 到 HNSW,拆解随机层数、SEARCH-LAYER、启发式邻居选择与参数边界;对照 hnswlib、Faiss、Lucene、pgvector 源码默认值,并用可复现实验比较 simple 与 heuristic 邻居选择的召回成本。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。