把十亿个 128 维 float32
向量直接放进内存,原始数据就是 \(10^9 \times 128 \times 4\)
bytes,约 512
GB(十进制)。图索引还要额外保存邻接边;暴力扫描则要为每次查询读完整数组。乘积量化(Product
Quantization,PQ)给出的不是“免费加速”,而是一种更明确的交易:用有损压缩和近似距离,换每个向量几个字节的常驻内存。
本文按“PQ 压缩 → SDC/ADC 距离估计 → IVF 候选过滤 →
residual IVF-PQ → Faiss v1.8.0 源码 →
可复现实验”的顺序展开。所有自测数字来自同目录
reproduce/ivfpq_experiment.py,只报告召回率、均方误差、候选数与字节数,不报告易受并行任务干扰的耗时。ScaNN
的各向异性量化与 DiskANN 的 SSD 图索引放到下一篇 ScaNN 与
DiskANN:量化损失、Vamana 与 SSD 图检索。
一、问题模型:内存、候选数与召回
给定数据库 \(X=\{x_1,\ldots,x_N\}\),\(x_i\in\mathbb{R}^D\),查询 \(q\) 的精确最近邻需要比较
\[ \operatorname{NN}(q)=\arg\min_{x_i\in X}\lVert q-x_i\rVert_2^2。 \]
近似最近邻(Approximate Nearest Neighbor,ANN)通常同时看三个量:
- 常驻字节数:索引和压缩向量是否能放进目标内存预算;
- 候选数:一次查询实际计算近似距离的向量数;
- Recall@k:返回的 \(k\) 个 id 中有多少属于精确 top-\(k\)。
IVF-PQ 同时压这三个量:PQ 把每个向量编码成 \(M\) 个短码;IVF(Inverted File)只扫描少数倒排列表;必要时再用原始向量或更长码做 re-rank。代价也对应三处:PQ 产生量化误差,IVF 可能没探测到真正近邻所在的 coarse cell,re-rank 则需要额外存储或读取原始向量。
一个常用数量级可以先记住。\(D=128\)、\(M=8\)、每个子码 \(8\) bit 时:
| 项 | 字节数 |
|---|---|
| 原始向量 | \(128\times4=512\) bytes / vector |
| PQ code | \(8\) bytes / vector |
| id(若用 64-bit) | \(8\) bytes / vector |
| \(65,536\) 个 coarse centroid | \(65,536\times128\times4=32\) MiB |
| PQ codebook | \(8\times256\times16\times4=128\) KiB |
所以十亿向量的倒排列表主体大约是 \(8\) GB PQ code 加 \(8\) GB id,不含倒排列表偏移、allocator 元数据、可选的原始向量和 re-rank 存储。这个估算比“某个索引一定只要多少 GB”更可靠,因为真实系统是否保留原始向量、id 宽度、list 存储格式都会改变账本。
二、PQ:笛卡尔积码本,而不是逐维量化
Jégou、Douze、Schmid 在 2011 年 TPAMI 论文 Product Quantization for Nearest Neighbor Search 中把 PQ 用于最近邻搜索。它和逐维标量量化不同:PQ 先把 \(D\) 维空间拆成 \(M\) 个子空间,每个子空间维度为 \(d_s=D/M\),然后分别训练一个 \(K\) 类 k-means 码本:
\[ x=[u_1,\ldots,u_M],\qquad C_m=\{c_{m,0},\ldots,c_{m,K-1}\},\quad c_{m,j}\in\mathbb{R}^{d_s}。 \]
编码一个向量时,每个子向量只保存最近 centroid 的编号:
\[ i_m(x)=\arg\min_{0\le j<K}\lVert u_m-c_{m,j}\rVert_2^2, \qquad \operatorname{code}(x)=(i_1(x),\ldots,i_M(x))。 \]
若 \(K=256\),每个 \(i_m\) 正好是 1
byte。整体可表示的重构向量来自笛卡尔积 \(C_1\times\cdots\times
C_M\),码字数是 \(K^M\),但实际只保存 \(M\times K\times d_s\) 个浮点
centroid。Faiss v1.8.0 的
faiss/impl/ProductQuantizer.cpp
也直接反映了这个定义:d % M == 0,ksub = 1 << nbits,code_size = (nbits * M + 7) / 8;compute_code()
对每个 subquantizer 扫 centroid 并写入编号。

PQ 的压缩比来自码率,而不是来自“所有数据都可无损恢复”。重构向量
\[ \hat{x}=q(x)=[c_{1,i_1(x)},\ldots,c_{M,i_M(x)}] \]
只是一组 centroid 的拼接。量化失真
\[ \lVert x-\hat{x}\rVert_2^2=\sum_{m=1}^M \lVert u_m-c_{m,i_m(x)}\rVert_2^2 \]
会进入后续排序误差。增大 \(M\) 或 \(K\) 往往能降低失真,但会增加 code bytes、训练成本或查表大小。
三、SDC 与 ADC:为什么查询通常不量化
PQ code 存起来以后,距离估计有两种基本做法。
对称距离计算(Symmetric Distance Computation,SDC)把查询 \(q\) 和数据库向量 \(x\) 都量化:
\[ d_{\mathrm{SDC}}(q,x)=\lVert \hat{q}-\hat{x}\rVert_2^2。 \]
它可以预计算各子空间 centroid 两两之间的距离表,但查询本身也被量化,误差来自两边。
非对称距离计算(Asymmetric Distance
Computation,ADC)保留查询的原始
float32,只用数据库的 PQ 重构:
\[ d_{\mathrm{ADC}}(q,x)=\lVert q-\hat{x}\rVert_2^2=\sum_{m=1}^M \lVert q_m-c_{m,i_m(x)}\rVert_2^2。 \]
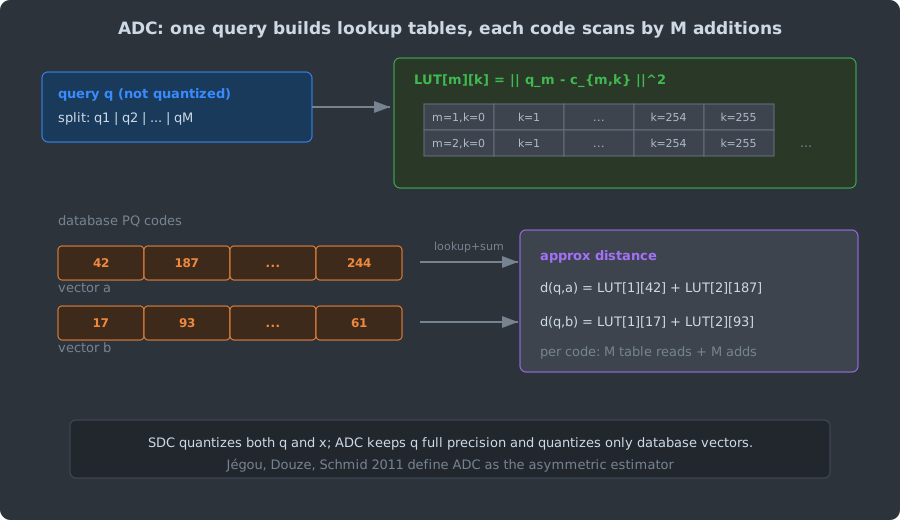
ADC 的关键是查找表。对每个查询,先计算
\[ \operatorname{LUT}[m,j]=\lVert q_m-c_{m,j}\rVert_2^2, \qquad 1\le m\le M, \quad 0\le j<K。 \]
之后扫描一个 PQ code 只需要按 \(M\) 个编号查表并相加。Faiss
v1.8.0 中
ProductQuantizer::compute_distance_table()
正是按子量化器生成这个表;compute_inner_prod_table()
则服务内积度量。
ADC 仍然是有偏近似。令 \(e=x-\hat{x}\),则
\[ \lVert q-\hat{x}\rVert_2^2 =\lVert q-x\rVert_2^2 + 2\langle q-x,e\rangle + \lVert e\rVert_2^2。 \]
最后一项是量化失真,交叉项会因查询位置和残差方向而改变排序。k-means centroid 是训练集 cell 内的均值,并不保证对所有查询交叉项为零。因此工程上不能只看 MSE,还要实测 recall。OPQ 和 ScaNN 的出发点也在这里:更小的重构误差通常有帮助,但“重构误差最小”不等于“排序错误最少”。
四、IVF:先缩小候选集合
仅用 PQ,搜索仍要扫描全部 \(N\) 个 code。IVF 在 PQ 前面加一个粗量化器(coarse quantizer):训练 \(L\) 个 coarse centroid \(\mu_0,\ldots,\mu_{L-1}\),把每个数据库向量分配到最近的 cell,并在对应倒排列表中保存 id 与压缩表示。
查询时先找离 \(q\)
最近的 nprobe 个 coarse
centroid,只扫描这些倒排列表。若各 list
大小均匀,期望候选比例约为 \(\mathrm{nprobe}/L\)。这个近似只说明扫描量,不保证召回:真实近邻可能落在第
nprobe+1 个 cell,或者数据分布倾斜导致某些 list
远大于平均。
IVF 有两个容易混淆的参数:
| 参数 | 作用 | 常见失误 |
|---|---|---|
nlist / \(L\) |
训练时 coarse cell 数 | 太小则 list 长、扫描多;太大则训练和 list 管理成本上升,且 list 可能很短 |
nprobe |
查询时探测的 cell 数 | 太小漏掉近邻;太大接近全扫描 |
Faiss v1.8.0 的 faiss/IndexIVF.h 中
nprobe 默认值是
1,这只是安全的最低默认,不是好配置。实际使用必须在验证集上扫描
nprobe,画 recall 与候选数曲线。
五、IVF-PQ:对 residual 编码
IVF-PQ 通常不直接对 \(x\) 做 PQ,而是对 residual 做 PQ:
\[ r=x-\mu_{\ell(x)}, \qquad \ell(x)=\arg\min_\ell \lVert x-\mu_\ell\rVert_2^2。 \]
查询扫描第 \(\ell\) 个倒排列表时,也用相对该 coarse centroid 的查询 residual:
\[ d(q,x)\approx \lVert (q-\mu_\ell)-\widehat{r}\rVert_2^2。 \]
这就是 Jégou 等人论文中的 IVFADC 路线:IVF 决定候选 cell,ADC 在压缩 residual 上估计距离。Residual 的分布通常比原始向量更集中,PQ 更容易用短码拟合;但它也带来一个实现细节:每个被探测 list 的查询 residual 不同,所以 L2 情况下 LUT 要按 list 准备,或者使用预计算表拆分计算。
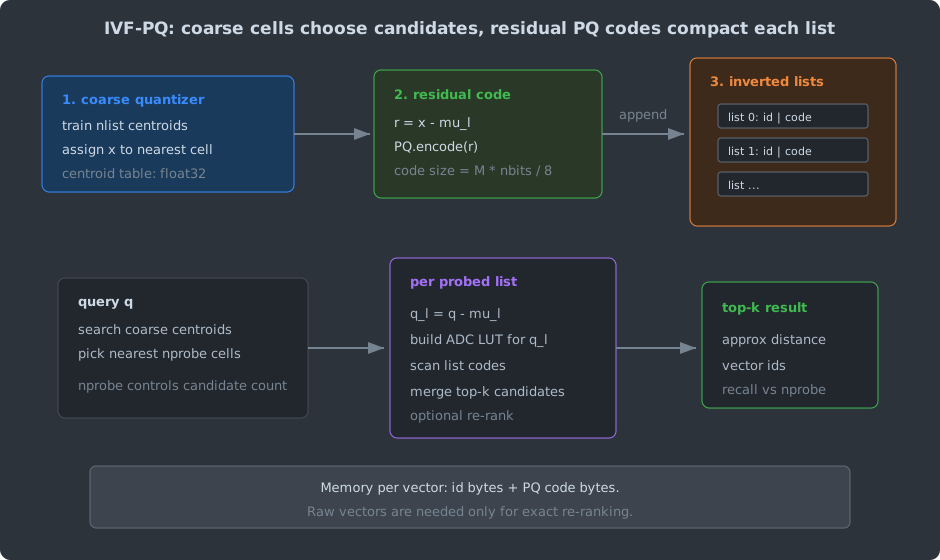
Faiss v1.8.0 的 faiss/IndexIVFPQ.cpp
构造函数把 by_residual 设为
true,encode() 中会调用 coarse
quantizer 的 compute_residual() 后再
pq.compute_code()。同文件
QueryTables 的 L2 路径在
by_residual 为真时,要么为当前 list 计算
q - centroid 的 distance
table,要么使用预计算项把距离拆成源码注释中的三部分:
\[ \lVert x-y_C-y_R\rVert^2 =\lVert x-y_C\rVert^2 + \lVert y_R\rVert^2 + 2\langle y_C,y_R\rangle -2\langle x,y_R\rangle。 \]
这里 \(x\) 是查询,\(y_C\) 是 coarse centroid,\(y_R\) 是 PQ residual
centroid。构造函数还把 use_precomputed_table
初始化为
0(自动选择)、polysemous_ht
初始化为 0、do_polysemous_training
初始化为 false。这些默认值说明一件事:IVF-PQ
的论文结构很简洁,生产实现却有许多可选快速路径和过滤器,不能把一个
index_factory 字符串当作完整配置。
六、OPQ、polysemous 与 fast scan:同一条压缩谱系
标准 PQ 默认按原始维度顺序切块。如果不同维度强相关,或者能量集中在少数方向,固定切块会把可压缩结构切碎。Ge、He、Ke、Sun 在 CVPR 2013 / TPAMI 2014 的 OPQ(Optimized Product Quantization)中学习一个正交变换 \(R\),在旋转后的空间训练 PQ:
\[ \min_{R,C_1,\ldots,C_M}\sum_i \lVert R x_i - q(R x_i)\rVert_2^2, \qquad R^\top R=I。 \]
OPQ 不改变 code 长度,而是改变子空间分解;它优化的是量化失真,不是直接优化 recall。ScaNN 后来把“排序目标和量化目标不一致”推得更远,提出各向异性量化;这部分留给下一篇。
还有两类工程优化经常和 IVF-PQ 一起出现:
- Polysemous
codes(Douze、Jégou、Perronnin,ECCV 2016):把 PQ
code 同时当成二进制签名,先用 Hamming 距离过滤,再做
ADC。Faiss v1.8.0 的
IndexIVFPQ中polysemous_ht=0表示默认不启用。 - Fast scan / 4-bit
PQ:André、Kermarrec、Le Scouarnec 的 fast scan /
Quicker ADC 路线把小查表放进 SIMD 寄存器。Faiss v1.8.0 的
IndexIVFPQFastScan面向这类场景,构造函数默认by_residual=false,源码注释写明这是因为更快;由普通IndexIVFPQ转换而来时才继承原来的 residual 设置。
这些改进不改变主线:先把候选集合压小,再在压缩域估计距离。它们改变的是误差、吞吐和实现复杂度之间的平衡。
七、可复现实验:MSE、码长、nprobe 与候选数
实验程序在同目录:
cd post/algorithms/40-ivfpq
taskset -c 6 python3 reproduce/ivfpq_experiment.py
cat reproduce/results.txt
环境与口径:NumPy 2.5.3、Matplotlib 3.11.2;固定随机种子
20260924;合成聚类数据,\(D=32\),训练集 4096,数据库
6000,查询 200,topk=10,IVF 的
nlist=64。这是机制实验,不代表 SIFT、Deep
或生产 embedding
的绝对数值。程序不下载数据,不报告耗时;所有图表可重画。
码长与量化误差
先只看纯 PQ 全量 ADC,不使用 IVF 候选过滤。下表中的
M8x6 表示 \(M=8\)、每个子码 6 bit,code
size 为 \(\lceil
8\times6/8\rceil=6\) bytes。
| PQ code | bytes / vector | 重构 MSE | full-scan ADC recall@10 |
|---|---|---|---|
| M4x4 | 2 | 3.895021 | 0.1275 |
| M4x6 | 3 | 2.333099 | 0.1480 |
| M4x8 | 4 | 1.870491 | 0.2195 |
| M8x4 | 4 | 2.687941 | 0.2035 |
| M8x6 | 6 | 1.527004 | 0.3400 |
| M8x8 | 8 | 0.901327 | 0.4590 |
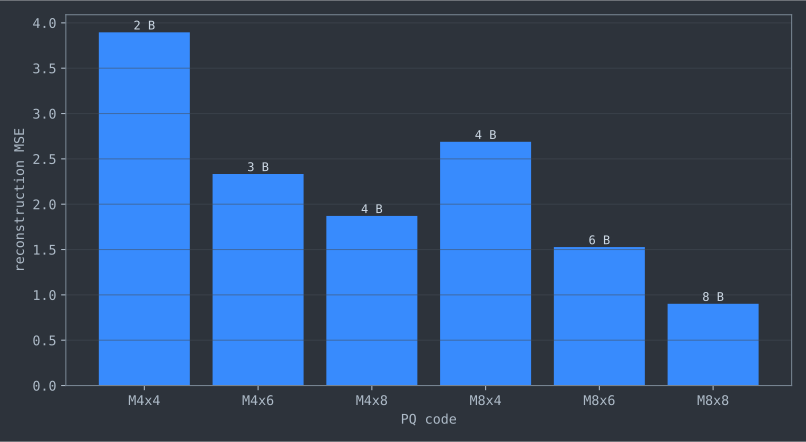
这组数据展示两个事实。第一,更多 bit 通常降低
MSE。第二,MSE 和 recall 不是同一个指标:M8x4
比 M4x6 多 1 byte,MSE 反而更高(2.687941 vs
2.333099),recall 却更高(0.2035 vs 0.1480)。同为 4 bytes
的 M4x8 与 M8x4
也说明子空间切分会改变误差和排序结果,本次合成数据上
M4x8 两项都更好。
nprobe 与候选数
再固定 residual IVF-PQ 为 M8x6,改变
nprobe:
| nprobe | 平均候选数 | 扫描比例 | recall@10 |
|---|---|---|---|
| 1 | 156.28 | 2.60% | 0.4460 |
| 2 | 278.27 | 4.64% | 0.4895 |
| 4 | 471.98 | 7.87% | 0.4995 |
| 8 | 892.25 | 14.87% | 0.5000 |
| 16 | 1657.52 | 27.63% | 0.5025 |
| 32 | 3260.93 | 54.35% | 0.5025 |
| 64 | 6000.00 | 100.00% | 0.5025 |
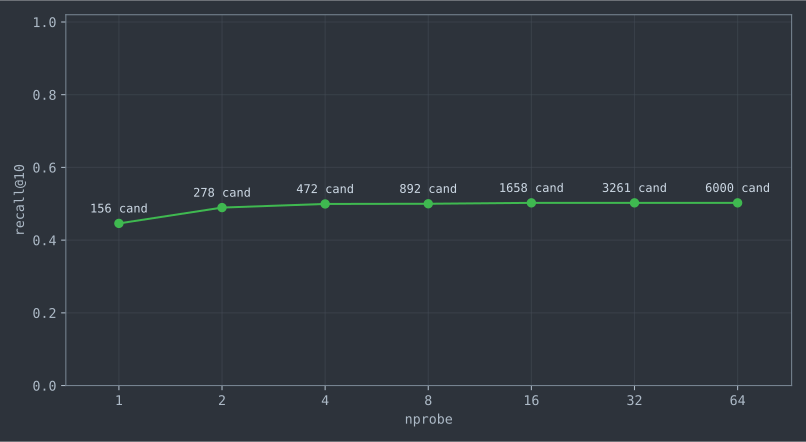
曲线前半段受 IVF 候选截断限制:探测更多 cell
能找到更多真正近邻。后半段进入平台:nprobe=64
已经全扫描,recall 仍只有 0.5025,剩下的错误来自 6-byte
residual PQ 的距离估计。想继续提高,需要更长
code、OPQ、更好的训练数据、polysemous/fast scan 之外的
rerank,或者保存原始向量做精排。
同一实验还给出字节账本:原始向量是 128 bytes /
vector;M8x6 code 是 6 bytes / vector;coarse
centroids 和 PQ codebook 在本实验里各 8192
bytes。这个账本不含 id 和 Python
对象开销,正文只用它说明趋势。
八、工程选型:什么时候该用 IVF-PQ
IVF-PQ 适合的约束很明确:原始向量或图索引放不进内存,但业务可以接受用 recall 换成本,并且有一套验证集来调参。选型时不要只问“PQ 快不快”,而要拆成下面几步:
| 问题 | 检查方法 | 可能动作 |
|---|---|---|
| 内存预算是否被原始向量压爆 | 先算 raw bytes、id bytes、list 元数据、是否保留原始向量 | 决定 code size、是否分片、是否外置原始向量 |
| IVF 是否漏候选 | 扫 nprobe,画 recall 与候选数曲线 |
增大 nprobe、调 nlist、换
coarse quantizer |
| PQ 是否限制排序 | 把 nprobe 提到全扫描,看 recall 平台 |
增大 \(M\) /
nbits、用 OPQ、做 rerank |
| 训练集是否代表线上分布 | 固定参数,按时间片/业务片验证 recall | 重新采样训练集,定期重训 coarse 和 PQ |
| 延迟瓶颈在 LUT 还是扫描 | 用 profiler 看 distance table、list scan、top-k merge | fast scan、precomputed table、并行 list scan |
HNSW 和 IVF-PQ 不是谁淘汰谁。HNSW 用内存换高召回和较少调参;IVF-PQ 用压缩换容量和吞吐,但需要验证集和重排策略。更大的系统常把它们组合:例如用 HNSW 作为 coarse quantizer、用 PQ 存压缩向量、再从对象存储或 SSD 加载候选原文做精排。下一篇的 DiskANN/Vamana 会从“图结构 + SSD”侧继续这条线。
九、争论与开放问题
残差编码是否总是更好。 对 L2
IVF-PQ,residual coding 是 Faiss IndexIVFPQ
的默认路径,也符合 IVFADC 的经典设定;但 fast scan 为了 SIMD
友好可能默认关闭
residual。这里的取舍不是数学定理,而是数据分布、code
长度、CPU 指令和 list 长度共同决定。
量化误差与排序质量不一致。 PQ、OPQ 主要最小化重构失真;近邻搜索关心的是 top-\(k\) 排序是否反转。ScaNN 的各向异性量化、各种 learned quantizer 和 re-rank 策略,都是围绕这条缝隙展开。本文只写到 OPQ,避免和下一篇重复。
PQ 与图索引的边界。 图索引在高召回低延迟上强,代价是邻接表和构建维护;量化索引在内存受限时强,代价是调参和近似误差。Billion-scale 系统往往不是纯算法竞赛,而是在“内存、SSD、训练时间、更新方式、召回 SLA”之间分配预算。
AQ 与 residual vector quantization。 Babenko 和 Lempitsky 的 Additive Quantization(CVPR 2014)用多个 codeword 相加表达向量;Chen、Guan、Wang 的 residual vector quantization(Sensors 2010)则逐级量化残差。它们都放松 PQ 的正交子空间假设,通常能降低失真,但编码和搜索更复杂。它们说明 PQ 不是量化研究的终点,只是工程上非常稳的基线。
十、工程陷阱
| 陷阱 | 后果 | 做法 |
|---|---|---|
用 Faiss 默认 nprobe=1 直接上线 |
候选 cell 太少,recall 可能远低于预期 | 用验证集扫描 nprobe,报告候选数与 recall
曲线 |
| 只报告 QPS,不报告 recall 和候选数 | 无法判断快是因为算法好,还是因为漏掉了近邻 | 固定 ground truth,至少报告 recall@k、平均候选数、code bytes |
| 把 IVF-PQ 的内存估算写成只有 PQ code | 忽略 id、倒排列表、可选原始向量、重排存储 | 分项列出 raw、code、id、centroid、list 元数据 |
| 训练集太小或偏离线上分布 | coarse cell 倾斜,PQ codebook 失真,线上 recall 掉 | 从线上分布抽样训练,按业务片验证 |
| 以为 OPQ 不增加任何成本 | code 长度不变,但训练、旋转矩阵和查询变换都有成本 | 在同一验证集上比较 PQ 与 OPQ 的 recall / 构建成本 |
| cosine 场景忘记归一化 | L2、内积、cosine 的排序语义混乱 | 明确度量:单位向量上 cosine 可转内积或 L2 排序 |
nlist 越大越好 |
list 过短、训练成本高,coarse assignment 可能不稳 | 同时扫 nlist 与
nprobe,看候选数而非只看参数 |
十一、参考资料
源码与文档
- Faiss
v1.8.0,
faiss/impl/ProductQuantizer.cpp:ProductQuantizer::set_derived_values()、compute_code()、compute_distance_table()。 - Faiss
v1.8.0,
faiss/IndexIVF.h:SearchParametersIVF::nprobe、IndexIVF::nprobe、IndexIVF::by_residual。 - Faiss
v1.8.0,
faiss/IndexIVFPQ.cpp:IndexIVFPQ::IndexIVFPQ()、IndexIVFPQ::encode()、QueryTables、initialize_IVFPQ_precomputed_table()。 - Faiss
v1.8.0,
faiss/IndexIVFPQFastScan.cpp:IndexIVFPQFastScan构造函数和by_residual=false默认。
核心论文
- Hervé Jégou, Matthijs Douze, Cordelia Schmid, “Product Quantization for Nearest Neighbor Search”, IEEE Transactions on Pattern Analysis and Machine Intelligence 33(1), 2011, pp. 117–128, DOI 10.1109/TPAMI.2010.57。
- Tiezheng Ge, Kaiming He, Qifa Ke, Jian Sun, “Optimized Product Quantization for Approximate Nearest Neighbor Search”, CVPR 2013, pp. 2946–2953, DOI 10.1109/CVPR.2013.379。
- Tiezheng Ge, Kaiming He, Qifa Ke, Jian Sun, “Optimized Product Quantization”, IEEE TPAMI 36(4), 2014, pp. 744–755, DOI 10.1109/TPAMI.2013.240。
- Jeff Johnson, Matthijs Douze, Hervé Jégou, “Billion-Scale Similarity Search with GPUs”, IEEE Transactions on Big Data 7(3), 2021, pp. 535–547, DOI 10.1109/tbdata.2019.2921572;2019 年 online first,arXiv:1702.08734。
其他论文
- Matthijs Douze, Hervé Jégou, Florent Perronnin, “Polysemous Codes”, ECCV 2016, pp. 785–801, DOI 10.1007/978-3-319-46475-6_48。
- Fabien André, Anne-Marie Kermarrec, Nicolas Le Scouarnec, “Quicker ADC: Unlocking the Hidden Potential of Product Quantization With SIMD”, IEEE TPAMI 43(5), 2021, pp. 1666–1677, DOI 10.1109/TPAMI.2019.2952606。
- Artem Babenko, Victor Lempitsky, “Additive Quantization for Extreme Vector Compression”, CVPR 2014, DOI 10.1109/CVPR.2014.124。
- Yongjian Chen, Tao Guan, Cheng Wang, “Approximate Nearest Neighbor Search by Residual Vector Quantization”, Sensors 10(12), 2010, pp. 11259–11273, DOI 10.3390/s101211259。
工程资料
- Matthijs Douze et al., “The Faiss library”, arXiv:2401.08281v4, 2025(预印本,未经同行评审)。
- Faiss
v1.8.0,
faiss/index_factory.cpp:用于核对IVF...,PQ...、OPQ...、fast scan 等配置语法;正文以同版本源码为准。
实验
reproduce/ivfpq_experiment.py:生成reproduce/results.txt、pq-mse.svg、ivfpq-recall.svg,数据口径见第七节。
系列导航: - 上一篇:HNSW:分层小世界图的近似近邻搜索 - 下一篇:ScaNN 与 DiskANN:量化损失、Vamana 与 SSD 图检索
相关阅读: - 局部敏感哈希:从概率保证到多探针近邻检索 - 从零实现一个向量搜索引擎
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
HNSW:分层小世界图的近似近邻搜索
从 NSW 到 HNSW,拆解随机层数、SEARCH-LAYER、启发式邻居选择与参数边界;对照 hnswlib、Faiss、Lucene、pgvector 源码默认值,并用可复现实验比较 simple 与 heuristic 邻居选择的召回成本。
ScaNN 与 DiskANN:量化损失、Vamana 与 SSD 图检索
从 ScaNN 的 score-aware 各向异性量化到 DiskANN 的 Vamana 图与 SSD beam search,核对论文公式、开源参数和可复现实验,说明内存量化与磁盘图检索各自解决什么问题。
从零实现一个向量搜索引擎
不重复 HNSW、PQ 和 DiskANN 细节,而是把向量检索放回引擎层:段式存储、墓碑删除、过滤搜索、mmap、并发快照与可复现召回评测。
局部敏感哈希:从概率保证到多探针近邻检索
从 (c,r)-ANN 与 LSH 的 rho 参数出发,推导 AND-OR 放大、随机超平面、p-stable 与 multi-probe,复现实测 SIFT1M 上召回率和候选数,并说明为什么理论保证不等于工程排名。