zstd 常被概括成”LZ77 加 FSE 加 Huffman”。这句话没错,但回答不了读格式、调参数时真正会碰到的问题:
- 一个 zstd 帧里到底有哪些字段?解码一个块时,解码器要从前面的块继承哪些状态?
- 字面量用 Huffman、序列用 FSE,这个分工在实际数据上差多少比特?
- FSE 的表在码流里怎么描述?编码器什么时候重新传表,什么时候沿用上一块的表或预定义表?
- 压缩后的比特主要花在哪里:字面量、FSE 状态,还是没有熵编码的额外比特?
- 字典和长距离匹配(long distance matching,LDM)分别在什么数据上有用,什么时候反而变差?
本文以 RFC 8878 为格式依据,以 zstd v1.5.7
的源码为实现依据。实验用 reproduce/ 里的
zbits:它用 libzstd 1.5.7 压缩,再用 zstd
仓库自带的教学解码器(doc/educational_decoder/,打了一个只加计数钩子的补丁)解回来,校验往返一致,并把输出的每个字节、每个比特归到具体字段上。所有指标都是字节数、比特数和计数,不涉及计时。主要结果(Canterbury
语料 11 个文件,2,810,784 字节):
- 比特的去向:level 3 输出 634,558 字节,其中偏移的额外比特占 39.5%,三路 FSE 状态比特占 31.8%,Huffman 编码的字面量占 27.9%,帧头、块头、码表和长度额外比特合计不到 1%。level 19 时偏移额外比特升到 44.4%。
- FSE 与 Huffman 的分工:字面长度、偏移、匹配长度三类码的 FSE 开销只比逐块零阶经验熵多 0.27%–0.83%;若对同样的码改用最优 Huffman 码,要多 1.9%–65%。字面量本身用 Huffman 只比经验熵多 0.71%–1.02%。
- 字典:把语料切成 256 字节的记录逐条压缩,用 64 KB 字典后总大小降到不用字典的 80.4%。但在异构语料、1 KB 和 4 KB 记录、level 3 下,完整字典反而不如只含内容的原始字典,原因是快速策略的启发式总是沿用字典里的码表;换到 level 9 的代价估计路径,这个现象消失。
- LDM:同一个 2.8 MB 的 tar 包连写两遍,level 3 只把窗口放大到 \(2^{27}\) 就足以找到第二份;第二份每 1000 字节插入 1 个字节后,只放大窗口得到 1,006,215 字节,再打开 LDM 降到 650,002 字节。
LZ77 的匹配查找(哈希链、二叉树、lazy 匹配)在第 81 篇,Huffman 码与 DEFLATE 在第 80 篇,ANS 的理论推导在第 83 篇。本文只讲这些部件在 zstd 格式和实现里的具体用法。
一、从首个提交到 RFC 8878:版本与谱系
zstd 的第一个公开提交是 2015 年 1 月 24 日,提交信息为
“Initial release”,作者 Yann Collet,当时仓库在他个人的
GitHub 账号 Cyan4973 下。之后的几个节点可以在仓库的
tag、release 和 CHANGELOG 里核对:
| 时间 | 事件 | 依据 |
|---|---|---|
| 2015-01-24 | 首个提交 “Initial release” | GitHub 提交记录 |
| 2015-08 | v0.1.0(CHANGELOG 记为 Aug 25, 2015,“first
release”) |
tag v0.1.0 |
| 2016-02 | v0.5.0 加入字典构建工具 | CHANGELOG |
| 2016-08-31 | v1.0.0 发布,同时改为 BSD 许可;Facebook 工程博客发文宣布 | release v1.0.0,Collet 与 Turner
的博客 |
| 2017-02 | v1.1.3 加入 COVER 字典构建算法(Nick Terrell) | CHANGELOG |
| 2017-10 | v1.3.2 加入 --long 长距离模式(Stella
Lau) |
CHANGELOG |
| 2018-10 | RFC 8478 发布(Collet、Kucherawy) | RFC 8478 |
| 2021-02 | RFC 8878 取代 RFC 8478 | RFC 8878 |
| 2024-09 | RFC 9659 把 HTTP 内容编码的窗口上限定为 8 MB | RFC 9659 |
| 2025-02-19 | v1.5.7,本文钉住的版本 | release v1.5.7 |
格式的两个来源都更早。LZ77 来自 Ziv 与 Lempel 1977 年在 IEEE Transactions on Information Theory 上的论文;DEFLATE 把 LZ77 的输出交给 Huffman 码,是 zstd 最直接的比较对象。熵编码的另一半来自 Jarek Duda 的非对称数字系统(asymmetric numeral systems,ANS):arXiv 预印本 0902.0271(2009)首次提出,1311.2540(2013)给出了表驱动的形式(tabled ANS,tANS),两篇都未经同行评审;Duda 等人 2015 年在 Picture Coding Symposium 上发表了经评审的版本。Collet 2013 年 12 月在博客上发布了 tANS 的一个实现,取名有限状态熵(Finite State Entropy,FSE)。2016 年的 v1.0 公告明确写道,FSE 基于 Duda 的 ANS,并把大量编码步骤预先算进表里。
所以 zstd 的格式可以看成 DEFLATE 的一个重新设计:仍然是”字面量加(长度、距离)“的 LZ77 序列,但窗口从 32 KB 放大到可配置,三类序列码从 Huffman 换成 FSE,还加了重复偏移、码表复用和字典。下面几节按这个顺序拆开。
二、帧与块:解码器要记住什么
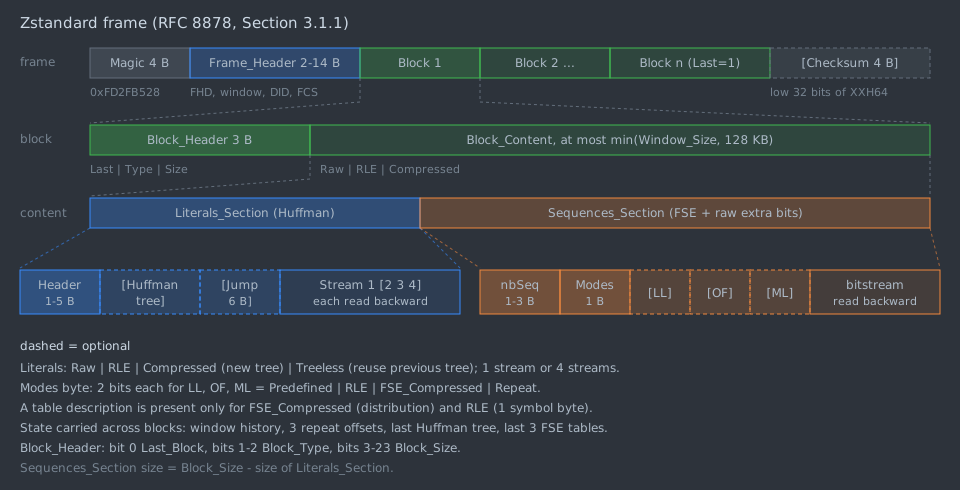
图中自上而下是三层嵌套。帧(frame)以 4
字节魔数 0xFD2FB528 开头,接 2 到 14
字节的帧头,然后是一个或多个块,最后是可选的 4
字节校验和,即 XXH64(种子为 0)的低 32 位(RFC 8878 第
3.1.1
节)。多个帧可以直接拼接,解压结果就是各帧结果的拼接。
帧头的第一个字节是帧头描述符(Frame_Header_Descriptor),它决定后面各字段是否出现、占几个字节(第 3.1.1.1 节):
| 位 | 字段 | 含义 |
|---|---|---|
| 7–6 | Frame_Content_Size_Flag | 原始大小字段占 0/1、2、4、8 字节;2 字节时取值要加 256 |
| 5 | Single_Segment_Flag | 为 1 时省略窗口描述符,窗口大小等于原始大小 |
| 4 | 未使用 | 编码器必须写 0,解码器忽略 |
| 3 | 保留 | 必须为 0,解码器必须检查 |
| 2 | Content_Checksum_Flag | 帧尾是否有校验和 |
| 1–0 | Dictionary_ID_Flag | 字典 ID 占 0、1、2、4 字节 |
窗口描述符(Window_Descriptor)用 1 个字节表示解码所需的最小缓冲区:高 5 位是指数 \(E\),低 3 位是尾数 \(M\),
\[ \text{Window\_Size} = 2^{10+E} + \frac{2^{10+E}}{8}\,M , \]
最小 1 KB,最大 \(2^{41} + 7
\cdot 2^{38}\) 字节,约 3.75 TB。RFC 8878
只建议解码器支持到 8 MB、编码器不要生成超过
8 MB 窗口的帧;RFC 9659(2024)把这条建议对 HTTP 的
zstd 内容编码改成了
MUST。参考实现的解码器默认拒绝超过 \(2^{27}\)
字节窗口的帧(zstd.h 中的
ZSTD_WINDOWLOG_LIMIT_DEFAULT,值为
27),需要调用方显式放宽。公开分发时,字典 ID 中 \(\le 32767\) 和 \(\ge 2^{31}\) 的两段只能用于在
IANA 注册过的字典(第 3.1.1.1.3 节)。
小输入时帧头的固定开销不可忽略。第六节把语料切成 256 字节的记录逐条压缩,每帧的魔数加帧头平均正好 7 字节(魔数 4、描述符 1、原始大小 2),带字典 ID 时是 11 字节;每个块另有 3 字节块头。
块(block)的 3 字节块头按小端序排列:第 0 位 Last_Block 标记最后一块,第 1–2 位是块类型,第 3–23 位是 Block_Size(第 3.1.1.2 节)。块类型有三种可用值:原样存储(Raw_Block)、单字节重复(RLE_Block,内容只有 1 字节,Block_Size 表示重复次数)、压缩块(Compressed_Block)。块的最大尺寸是窗口大小与 128 KB 中的较小者,对压缩前和压缩后都成立,所以解码器读完帧头就能定下所有缓冲区的大小。
块之间并不独立。RFC 8878 第 3.1.1.3 节列出了解码一个压缩块所需的全部外部状态:
- 窗口范围内已经解出的数据(或者从帧开头算起的全部数据);
- 上一个压缩块结束时的三个”最近偏移”;
- 上一个压缩字面量块的 Huffman 树(供 Treeless 模式使用);
- 字面长度、匹配长度、偏移三类码各自最近使用的 FSE 解码表(供 Repeat 模式使用)。
后三项都可以改由字典提供。这四项就是第六节字典要填充的内容:字典的正文充当第 1 项,字典里的码表和偏移值充当第 2 到 4 项。
帧格式里还有一种可跳过帧(skippable
frame):魔数是 0x184D2A50 到
0x184D2A5F 中的任意一个,接 4
字节长度和任意用户数据,解码器直接跳过(第 3.1.2 节)。RFC
9842(2025,压缩字典传输)定义的 dcz
内容编码就利用了这一点:它在 zstd 码流前放一个 40
字节的头,内容是字典的 SHA-256,这个头本身是一个魔数为
0x184D2A5E、长度为 32
的可跳过帧,所以现有解码器不需要修改就能处理。
三、压缩块的两段:字面量与序列
压缩块把 LZ77 的输出拆成两段分别编码:先是所有字面量拼成的字面量段(Literals_Section),再是序列段(Sequences_Section)。每个序列是一个三元组(字面长度 LL,偏移 OF,匹配长度 ML),含义是”从字面量缓冲区复制 LL 个字节,再从 OF 字节之前复制 ML 个字节”。最后一个序列之后剩下的字面量直接追加到输出(第 3.1.1.4 节)。这种”先存全部字面量,再存全部命令”的布局和 DEFLATE 把字面量与长度码混在一张 Huffman 表里的做法不同,好处是两段可以用不同的熵编码器。
3.1 字面量段
字面量段的段头 1 到 5 字节,最低 2 位是类型(第 3.1.1.3.1 节):
| 值 | 类型 | 内容 |
|---|---|---|
| 0 | Raw_Literals_Block | 字面量原样存储 |
| 1 | RLE_Literals_Block | 1 个字节,重复 Regenerated_Size 次 |
| 2 | Compressed_Literals_Block | Huffman 树描述加 Huffman 码流 |
| 3 | Treeless_Literals_Block | 只有码流,沿用上一个压缩字面量块的 Huffman 树 |
压缩的字面量分成 1 路或 4 路 Huffman 码流。4 路时前 3
路各含 \(\lceil n/4
\rceil\) 个字面量,段头之后有一个 6
字节的跳转表,给出前 3 路的压缩长度,让解码器能并行地解 4
路。参考实现的编码器在字面量少于 256 个时只用 1
路(zstd_compress_literals.c),实验里 level 1
到 9 的 28 个块全部是 4 路。
Huffman 码长上限是 11 位。树的描述只传每个符号的权重 \(w\)(码长为 \(L_{\max}+1-w\),权重 0 表示符号不出现),最后一个符号的权重不传,由”所有 \(2^{w-1}\) 之和必须补足到 2 的幂”推出(第 4.2.1 节)。权重本身有两种存法:首字节小于 128 时,权重序列再用一个 FSE 码压缩(精度对数不超过 6,两个状态交错解码);否则每个权重直接存 4 位。也就是说,FSE 在 zstd 里不只编码序列,还编码 Huffman 树。
3.2 序列段
序列段先用 1 到 3 字节写序列个数,接着是 1 字节的符号压缩模式(Symbol_Compression_Modes):第 7–6 位管字面长度码,第 5–4 位管偏移码,第 3–2 位管匹配长度码,最低 2 位保留(第 3.1.1.3.2.1 节)。每类码独立选择四种模式之一:
| 值 | 模式 | 码表来源 |
|---|---|---|
| 0 | Predefined_Mode | RFC 给出的预定义分布,不占码流 |
| 1 | RLE_Mode | 1 个字节,本块所有该类码都是这个值 |
| 2 | FSE_Compressed_Mode | 本块传一张 FSE 表描述(第四节) |
| 3 | Repeat_Mode | 沿用最近使用的表,可以来自前面的块或字典 |
三个数值本身不直接编码,而是先映射成码(code)加额外比特(extra bits),和 DEFLATE 的长度码、距离码思路一样,只有码走 FSE,额外比特原样写入:
- 字面长度码 0–35:码 0–15 直接表示长度 0–15,之后每个码覆盖的区间逐渐变宽,最大的码 35 带 16 个额外比特。
- 匹配长度码 0–52:最短匹配是 3,码 0–31 表示长度 3–34,码 52 带 16 个额外比特。
- 偏移码:码值 \(c\) 本身就是额外比特数,\(\text{Offset\_Value} = 2^{c} + \text{readBits}(c)\)。所以偏移的高位由 FSE 编码,低 \(c\) 位完全不压缩。第五节会看到,这些不压缩的比特是 zstd 输出里最大的一块。
3.3 重复偏移
\(\text{Offset\_Value} > 3\) 时,真实偏移是 \(\text{Offset\_Value} - 3\)。取 1、2、3 时表示重复偏移(repeat offset):解码器维护最近用过的三个偏移 Rep1、Rep2、Rep3,初值为 1、4、8,用了字典时由字典给出(第 3.1.1.5 节)。取值 1、2、3 分别选 Rep1、Rep2、Rep3;但当本序列的字面长度为 0 时,含义整体后移一位,变成 Rep2、Rep3 和 \(\text{Rep1}-1\)。RFC 没有解释这条例外,不过从编码角度看,字面长度为 0 又用 Rep1,等于紧接上一个匹配以同一偏移继续复制,总可以并进上一个序列的匹配长度,所以这个码点留着也用不上。
重复偏移让”隔几个字节再接着匹配”只花一个小的偏移码而不是完整的距离。实验中
level 3 有 38.3% 的序列用了重复偏移,level 19 升到
51.7%。但分布极不均匀:level 19 的 149,217 次 Rep2 中有
146,183 次来自 kennedy.xls 一个文件,占它
158,203
个序列的绝大部分,这是表格二进制格式里两个偏移交替出现的结果;纯文本文件在
level 19 下使用重复偏移的序列不到 1%。
3.4 序列码流的读取顺序
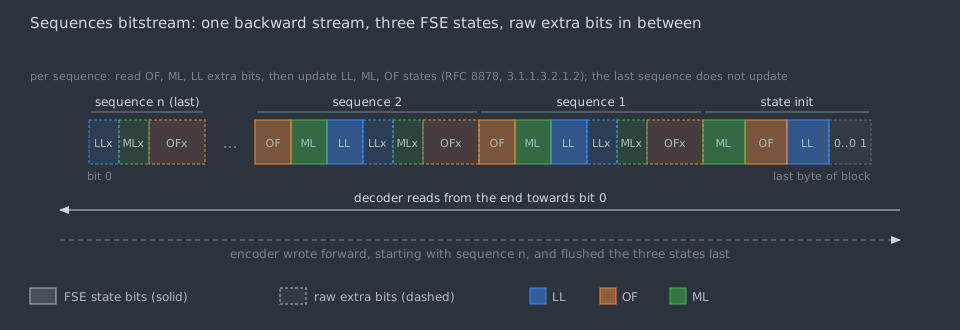
序列码流是从后往前读的:编码器从最后一个序列往前编码,写完后在末尾补一个值为 1 的标记位,解码器跳过最后一个字节里的填充零和这个标记位后倒着读(第 3.1.1.3.2.1.2 节)。这样编码器可以按 ANS 要求的逆序工作,而解码器仍然按序列的自然顺序输出。解码器先读三个 FSE 初始状态,顺序是 LL、OF、ML;然后每个序列按 OF、ML、LL 的顺序读额外比特,再按 LL、ML、OF 的顺序更新三个状态。三个状态共用一条码流交错读取,和 Giesen 分析的交错熵编码器(interleaved entropy coders)是同一思路:多个编码器的输出按确定的顺序织进一条码流,解码器按同样顺序取用,不需要把码流切成多段,也不需要额外的长度字段。
四、FSE 在 zstd 里的用法
ANS 为什么能用非整数比特编码一个符号,推导留给第 83 篇。这里只看 zstd 需要的三件事:解码表怎么从归一化计数建出来,计数怎么写进码流,编码器怎么决定要不要传新表。
4.1 从归一化计数到解码表
设精度对数(Accuracy_Log)为 \(A\),表大小 \(T = 2^{A}\)。每个符号 \(s\) 有一个归一化计数 \(p_s\),满足 \(\sum_s p_s = T\);计数为 \(-1\) 表示”概率小于 1”,按 1 计入总和。RFC 8878 第 4.1.1 节规定了建表的三步:
- 计数为 \(-1\) 的符号从表尾开始各占一格。
- 其余符号按编号顺序,每个符号放 \(p_s\) 次:位置从 0 开始,每放一次前进 \(\text{step} = T/2 + T/8 + 3\)(模 \(T\)),跳过已被第一步占用的格子。\(T \ge 16\) 时 step 为奇数,所以能遍历全表,并把同一符号的格子打散。
- 对每个符号,按状态编号从小到大给它的格子依次编号 \(x = p_s, p_s+1, \dots, 2p_s-1\),然后
\[ n = A - \lfloor \log_2 x \rfloor, \qquad \text{Baseline} = x \cdot 2^{n} - T . \]
解码时,当前状态查表得到符号 \(s\)、比特数 \(n\) 和 Baseline,下一状态是 \(\text{Baseline} + \text{readBits}(n)\)。计数为 \(-1\) 的符号 \(x = 1\),于是 \(n = A\)、Baseline 为 0:它的下一状态可以是全表任意一格,代价是整整 \(A\) 比特。
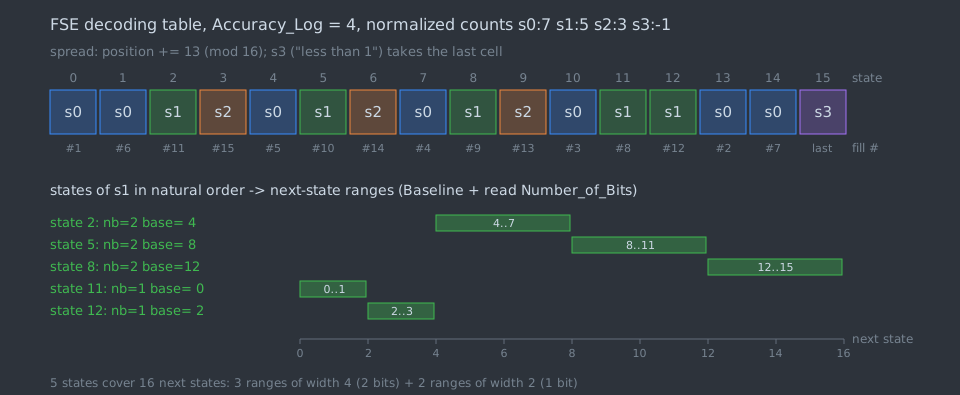
图中的例子取 \(A = 4\),计数为 \((7, 5, 3, -1)\)。以 s1 为例:它的 5 个状态对应 \(x = 5,\dots,9\);\(x = 5,6,7\) 时 \(n = 2\),\(x = 8, 9\) 时 \(n = 1\),得到的 5 个区间 \([4,8)\)、\([8,12)\)、\([12,16)\)、\([0,2)\)、\([2,4)\) 恰好铺满 \([0, 16)\)。这不是巧合:\(x \cdot 2^{n}\) 总落在 \([T, 2T)\) 里,而 \(x\) 从 \(p_s\) 连续取到 \(2p_s-1\),所以各区间无缝拼接。解码 s1 平均读 \((3 \times 2 + 2 \times 1)/5 = 1.6\) 比特,接近 \(\log_2(16/5) \approx 1.68\)。这里按 5 个状态等权平均,实际编码时各状态出现的频率并不相等,所以这只是一个直观的对照。
同一个过程也生成 RFC 附录 A
里三张预定义表。reproduce/fse_table.py
按上面三步实现建表,--check 模式从 RFC
文本里解析附录 A.1 到 A.3,逐格比较符号、比特数和
Baseline,字面长度(64 格)、匹配长度(64 格)、偏移(32
格)三张表全部一致。这也验证了上面对步骤的转述。
4.2 表描述:怎么把计数写进码流
FSE_Compressed_Mode 下,块里要传一张表描述(第 4.1.1 节)。首字节低 4 位是 \(A - 5\);之后按符号顺序写每个计数加 1 的值,所用位数随”剩余可分配的计数”递减而减少,较小的值再省 1 位;某个符号计数为 0 时,后面跟 2 位重复标志,表示再有几个 0,值为 3 时继续读下一个标志。表描述结束于总和恰好达到 \(T\) 的那一刻,按字节对齐。序列三类码的 \(A\) 上限分别是字面长度 9、偏移 8、匹配长度 9,预定义表用的是 6、5、6。
实测这些表描述很便宜:level 3 整个语料 28 个块的 FSE 表描述合计 1,300 字节,Huffman 树合计 1,598 字节,两者加起来不到输出的 0.5%。
4.3 编码器怎么选模式
格式允许每块、每类码自由选四种模式,选择完全由编码器决定。libzstd
1.5.7 的决策在
lib/compress/zstd_compress_sequences.c 的
ZSTD_selectEncodingType
里,按压缩策略分成两条路径。下面是快速策略一侧的核心判断(删去了日志和断言):
if (mostFrequent == nbSeq) {                 /* only one distinct code */
    *repeatMode = FSE_repeat_none;
    if (isDefaultAllowed && nbSeq <= 2) return set_basic;
    return set_rle;
}
if (strategy < ZSTD_lazy) {
    if (isDefaultAllowed) {
        size_t const staticFse_nbSeq_max = 1000;
        size_t const mult = 10 - strategy;
        size_t const dynamicFse_nbSeq_min = (((size_t)1 << defaultNormLog) * mult) >> 3;
        if ((*repeatMode == FSE_repeat_valid) && (nbSeq < staticFse_nbSeq_max))
            return set_repeat;
        if ((nbSeq < dynamicFse_nbSeq_min)
         || (mostFrequent < (nbSeq >> (defaultNormLog - 1)))) {
            *repeatMode = FSE_repeat_none;
            return set_basic;
        }
    }
} else {
    /* estimate basicCost, repeatCost, compressedCost and pick the cheapest */
}
*repeatMode = FSE_repeat_check;
return set_compressed;
flowchart TD
A["one distinct code?"] -->|yes| B["RLE, or Predefined if nbSeq <= 2"]
A -->|no| C{"strategy < lazy?"}
C -->|yes| D{"previous table valid and nbSeq < 1000?"}
D -->|yes| R["Repeat"]
D -->|no| E{"few sequences or flat histogram?"}
E -->|yes| P["Predefined"]
E -->|no| F["FSE_Compressed"]
C -->|no| G["estimate bits: Predefined, Repeat, new table + description"]
G --> H["pick the cheapest"]策略由 lib/compress/clevels.h
按级别和输入大小查表得到:level 1 到 3 在任何输入大小下都是
fast 或 dfast,level 4、5 视输入大小是 dfast、greedy 或
lazy,level 9 起至少是 lazy2。低于 lazy
的策略走启发式路径:只要上一张表”有效”且本块序列少于 1000
个,就无条件沿用,不看它和本块的分布差多远。lazy
及以上走代价估计路径:分别算用预定义表的交叉熵、用旧表的实际比特数、以及新表描述长度乘
8
加上本块经验熵,取最小者。字面量一侧有类似的规则:zstd_compress_literals.c
在策略低于 lazy 且字面量不超过 1024 个时设置
HUF_flags_preferRepeat,倾向沿用上一棵 Huffman
树。启发式路径在大块、同质数据上几乎不会出问题,第六节的字典实验会展示它出问题的场景。
五、比特花在哪里:Canterbury 语料逐比特记账
5.1 记账方法
zbits 对每个输入调用
ZSTD_compress2
生成一个帧(关闭校验和,写入原始大小),再用打了补丁的教学解码器解码。补丁只在解码器读取各字段的位置插入计数钩子,不改变解码逻辑;zbits
用 memcmp
确认往返一致,并断言各类字节之和等于压缩输出的总长度。熵编码的比特按字段归类:
- Huffman 字面量:Huffman 码流里每个符号实际消耗的比特。
- FSE 状态比特:三类序列码的初始状态和每次状态更新读取的比特,也就是”码”本身的开销。
- 偏移额外比特、长度额外比特:不经熵编码直接写入的低位。
- 其余:帧头、块头、字面量段头、Huffman 树、4 路跳转表、序列段头、FSE 表描述和码流末尾的填充。
同时,zbits
对每个块统计三类码和字面量的零阶经验熵 \(\sum_s c_s \log_2 (N /
c_s)\)(\(c_s\)
为符号 \(s\)
在块内的出现次数,\(N\)
为块内符号总数),以及同一块内对同样符号构造的最优 Huffman
码的总长度,二者都不计码表开销。语料是 Canterbury 语料库的
11 个文件,每个文件单独成帧,libzstd 1.5.7。四个级别对大于
256 KB
的输入选用的参数如下(clevels.h,小文件会落到同一张表里针对
256 KB、128 KB、16 KB
以下输入的行,窗口也会缩小到不超过输入长度):
| 级别 | 窗口 | 策略 |
|---|---|---|
| 1 | \(2^{19}\) | fast |
| 3(默认) | \(2^{21}\) | dfast |
| 9 | \(2^{22}\) | lazy2 |
| 19 | \(2^{23}\) | btultra2 |
这些策略的匹配查找算法见第 81 篇。
5.2 结果
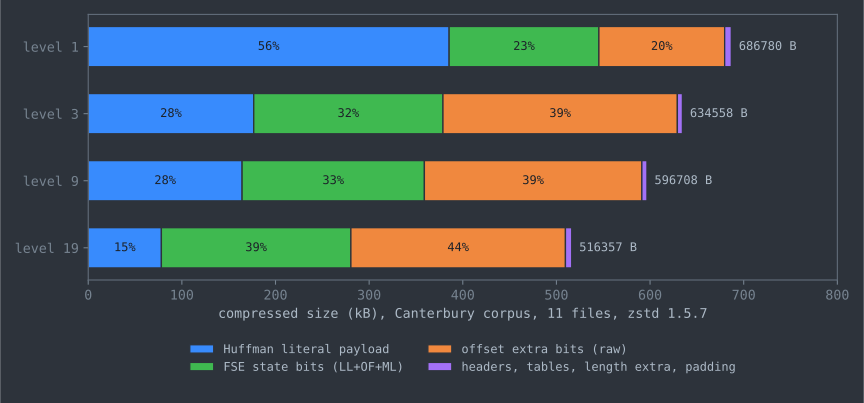
| 类别 | level 1 | level 3 | level 9 | level 19 |
|---|---|---|---|---|
| 输出字节 | 686,780 | 634,558 | 596,708 | 516,357 |
| 序列数 | 197,340 | 256,027 | 234,280 | 318,055 |
| 字面量占输入 | 21.7% | 9.1% | 8.4% | 4.2% |
| Huffman 字面量 | 56.12% | 27.86% | 27.54% | 15.13% |
| FSE 状态比特 | 23.29% | 31.84% | 32.62% | 39.20% |
| 偏移额外比特 | 19.55% | 39.45% | 38.92% | 44.37% |
| 长度额外比特 | 0.50% | 0.30% | 0.33% | 0.37% |
| 帧头、块头、段头、码表、填充 | 0.54% | 0.56% | 0.59% | 0.94% |
三个观察:
偏移的低位是最大的开销。 level 3
以上,不经熵编码的偏移额外比特占输出的 39% 到 44%,level 3
平均每个非重复偏移 12.7 比特。这和第 80
篇在同一语料上对 DEFLATE 的测量一致:zlib 1.3
-9 输出 727,754 字节,距离额外比特占
41.9%。zstd 把窗口从 32 KB 放大到 MB
级,找到了更远、更长的匹配,但远距离匹配的偏移低位近似均匀分布,熵编码压不动它们。第八节会回到这个问题。
级别越高,字面量越少,序列越多。 level 1
的 fast
策略每次只查一个哈希候选,找不到匹配时还会逐渐加大步长跳过位置,漏掉大量匹配,21.7%
的输入以字面量形式输出,Huffman 字面量是最大的一块。level 19
的最优解析把字面量压到输入的 4.2%,代价是序列数增加到
318,055 个,于是 FSE 状态比特和偏移额外比特的份额上升。level
19 的块数从 28 个增加到 49 个,是因为 btopt
及以上的策略在窗口不小于 \(2^{17}\)
时自动启用块切分(ZSTD_resolveBlockSplitterMode),在统计特性变化处切开块,让每块用各自的码表。
固定开销可以忽略。 帧头、各级段头、Huffman 树和 FSE 表描述加起来不到 1%。level 3 下全部 FSE 表描述 1,300 字节,Huffman 树 1,598 字节,对应 28 个块、11 个帧。
5.3 FSE 与 Huffman:分工差多少
把每个块里实际的 FSE 开销和 Huffman 开销,同该块的经验熵以及假想的最优 Huffman 码比较:
| 符号 | 级别 | 实际编码 | 实际比经验熵多 | 改用最优 Huffman 比经验熵多 |
|---|---|---|---|---|
| 字面长度码 | 3 | FSE | +0.59% | +19.00% |
| 偏移码 | 3 | FSE | +0.28% | +11.57% |
| 匹配长度码 | 3 | FSE | +0.52% | +1.94% |
| 字面长度码 | 19 | FSE | +0.83% | +65.21% |
| 偏移码 | 19 | FSE | +0.80% | +15.19% |
| 字面量 | 3 | Huffman | +0.86% | +0.67% |
| 字面量 | 19 | Huffman | +1.02% | +0.55% |
四个级别合起来,三类序列码的 FSE 开销比经验熵多 0.27% 到 0.83%。差距最大的是 level 19 的字面长度码:经验熵平均每个序列只有 \(249{,}990 / 318{,}055 \approx 0.79\) 比特,低于 1 比特,而任何前缀码每个符号至少 1 比特,最优 Huffman 码实际要 1.30 比特。最优解析让大量序列的字面长度为 0,分布高度偏斜,这正是 ANS 相对 Huffman 的优势区。
字面量的情况相反:256 个字节值的分布通常平坦得多,最优
Huffman 码只比经验熵多 0.55% 到 0.69%。zstd 实际的 Huffman
码比最优 Huffman 码还多 0.1 到 0.5
个百分点,可能的来源有三个:格式规定的 11
位码长上限;编码器另选的更小上限(HUF_optimalTableLog,策略低于
btultra 时按输入大小估一个值,btultra
及以上才逐个试探);以及沿用旧树的 Treeless 块。本文没有把这
0.1 到 0.5 个百分点进一步拆到这三项上。用 Huffman
编码字面量省掉的是解码速度上的代价:Huffman
解码每个符号查一次表、按码长移位,没有状态依赖,4
路码流可以并行;这方面的取舍在第八节讨论。
六、字典:预置历史与预置码表
6.1 格式
小输入难压缩有两个原因:LZ77
没有历史可以引用,熵编码器没有统计可以依赖,码表描述的开销还要摊到很少的数据上。字典同时解决这两件事。RFC
8878 第 5 节定义的字典格式依次是:4 字节魔数
0xEC30A437,4 字节非零的
Dictionary_ID,熵表(依次是字面量的 Huffman
表、偏移、匹配长度、字面长度的 FSE 表,再接 3 个各 4
字节的重复偏移),最后是字典正文。不以魔数开头、长度至少 8
字节的任意缓冲区都可以当作”原始内容字典”(raw content
dictionary),相当于只有正文部分。
flowchart LR
    M["dict: magic 0xEC30A437 + Dictionary_ID"] -->|checked against| X["frame header: Dictionary_ID"]
    H["dict: Huffman table"] --> T["state: previous Huffman tree"]
    F["dict: FSE tables OF, ML, LL"] --> P["state: previous FSE tables"]
    R["dict: 3 repeat offsets"] --> O["state: Rep1 Rep2 Rep3"]
    C["dict: content"] --> W["state: history before the frame"]
这正好对应第二节列出的四项块间状态:正文被当作帧开始之前的历史,熵表被当作”上一块用过的”表,于是第一个块就可以用 Treeless 字面量和 Repeat 模式,直接省掉码表描述。正文只在解码输出不超过 Window_Size 之前可以引用,超过后字典不再可访问(第 5 节)。
字典本身不随帧传输,帧头只带 Dictionary_ID。RFC 8878 第 6
节因此要求:以它注册的媒体类型传输的内容不应使用字典,除非有私下协商的机制。RFC
9842(2025)后来为 HTTP 定义了这样的协商:服务器用
Use-As-Dictionary
响应头把一个资源标记为字典,客户端在后续请求里用
Available-Dictionary 告知自己持有的字典的
SHA-256,服务器可以用 dcz
内容编码返回以该字典压缩的 zstd 数据。dcz
用的是原始内容字典,不依赖 Dictionary_ID。
6.2 训练:COVER 与它的来源
zstd --train 和
ZDICT_trainFromBuffer 在 1.5.7 里默认调用
fastCover
算法(d = 8,steps = 4,按 level 3
评估;CLI 默认字典上限 110 KB)。它的源头在
lib/dictBuilder/cover.c
的文件头里写明:Liao、Petri、Moffat、Wirth 在 WWW 2016
上的论文 “Effective Construction of Relative Lempel-Ziv
Dictionaries”,代码最初由 Giuseppe Ottaviano 编写。
这篇论文属于相对 Lempel-Ziv(Relative Lempel-Ziv,RLZ)一脉:Kuruppu、Puglisi、Zobel 在 SPIRE 2010 上提出,把一批相似序列(最初是基因组)都表示成对同一个参考序列的 LZ77 分解,参考序列相当于一个很大的共享字典。之后的问题就变成怎样从样本里挑出一个好的参考。COVER 的做法是贪心覆盖:把样本拼起来,按 \(d\) 字节的子串(d-mer)统计它出现在多少个样本里,记为 \(F(\cdot)\);把拼接串划分成若干段(epoch),在每段里用长度为 \(k\) 的滑动窗口找得分最高的片段,
\[ \text{Score}(S) = \sum_{\text{distinct } d\text{-mer } m \in S} F(m) , \]
选中后把片段里所有 d-mer 的 \(F\) 置零,避免重复选入相同内容,然后轮到下一段。选中的片段从字典尾部往前填,所以最先选中、得分最高的片段离待压缩数据最近,偏移最小。源码注释提到论文建议的 \(L_{0.5}\) 范数”实验上没有帮助”,所以得分用的是简单求和。fastCover 把 d-mer 哈希到 \(2^{f}\) 个桶里代替精确统计,默认 \(f = 20\)。
训练完正文后,ZDICT_finalizeDictionary
用字典压缩全部样本,统计得到的字面量、三类码和重复偏移,生成熵表部分,所以熵表反映的是训练样本在”已有字典”条件下的平均分布。
6.3 实验:什么时候完整字典反而更差
把 Canterbury
的每个文件切成固定长度的记录,按记录在文件内的序号分成偶数组和奇数组:偶数组用
ZDICT_trainFromBuffer 训练一个 64 KB
的字典,奇数组逐条单独压缩成帧,训练集和测试集不重叠。每种情形比较三种做法:不用字典;用完整字典;只用完整字典的正文部分作为原始内容字典(去掉魔数、ID
和熵表,这部分在各个字典里是 150 到 172
字节)。表中百分比是相对不用字典的总大小:
| 记录 | 集合 | 级别 | 不用字典(字节) | 完整字典 | 原始内容字典 |
|---|---|---|---|---|---|
| 256 B | 全部 11 个文件 | 3 | 727,159 | 80.4% | 91.7% |
| 1 KB | 全部 11 个文件 | 3 | 510,499 | 90.6% | 84.5% |
| 4 KB | 全部 11 个文件 | 3 | 419,711 | 97.5% | 87.3% |
| 1 KB | 全部 11 个文件 | 9 | 493,633 | 82.2% | 83.1% |
| 1 KB | 8 个文本文件 | 3 | 355,171 | 78.2% | 83.8% |
256 字节的记录上,完整字典最有用:记录太短,本块自己的统计撑不起一张码表,字典里预置的码表省掉了码表描述,也比预定义表更贴近实际分布。每帧的固定开销也要算进去:不用字典时每帧 7 字节帧头加 3 字节块头,占 256 字节输入的 3.9%;带字典 ID 后帧头变成 11 字节。
1 KB 和 4 KB 记录、level 3 下,完整字典反而不如原始内容字典,差距在 4 KB 时达到 10 个百分点。逐块查看模式选择就能看到原因。以 1 KB 为例,用完整字典时 1,372 个块里偏移码有 1,329 块选了 Repeat 模式,一次也没有选 FSE_Compressed;字面量有 677 块是 Treeless,695 块原样存储,没有一块建新的 Huffman 树。结果偏移码的 FSE 开销比逐块经验熵多 68.8%。用原始内容字典时没有可沿用的表,偏移码有 1,193 块选了 FSE_Compressed,开销只比经验熵多 10.2%。
这正是第四节那段启发式的行为。level 3 的 dfast 低于
lazy,字典加载时每张表只要所有符号计数非零就被标为
FSE_repeat_valid(ZSTD_dictNCountRepeat),而每条记录的序列数远少于
1000,于是 Repeat 模式无条件胜出;字面量一侧,字面量不超过
1024 个时的 HUF_flags_preferRepeat
起同样的作用。字典的熵表是 11
个异构文件混合出来的平均分布,对文本记录、表格记录、图像记录都不贴合。换到
level 9(各行参数表里至少是
lazy2)后,编码器逐块比较三种代价,偏移码 1,193 块选了
FSE_Compressed、114 块选了
Repeat,完整字典又比原始内容字典好。只用 8
个文本文件训练和测试时,字典的熵表贴合数据,level 3
下完整字典同样胜出。
结论不在于”完整字典不好”,而在于快速级别对字典码表的信任是无条件的:数据同质时这省下了码表,数据异构时同一个字典的码表可能对大部分记录都不合适。异构数据更适合按数据类型分别训练字典,或者提高到
lazy 及以上的级别让编码器自己比较。本实验的训练总是按
ZDICT_trainFromBuffer 的默认 level 3
进行,没有测试按目标级别训练的效果。
七、长距离匹配与窗口
7.1 窗口大,不等于找得到
窗口决定格式上允许引用多远,匹配查找器决定实际找得到多远。level
3 的 dfast 用两张哈希表(对大于 256 KB 的输入分别是 \(2^{17}\) 和 \(2^{16}\)
项),每个位置只保留最近一次出现;窗口再大,几 MB
之前的位置早已被覆盖。长距离匹配(ZSTD_c_enableLongDistanceMatching,CLI
的 --long,v1.3.2
加入)是在常规匹配查找之前加的一道独立的预处理:
- 用 gear 滚动哈希扫描输入,哈希值在掩码
stopMask下为 0 的位置作为切分点,平均每 \(2^{r}\) 字节一个,\(r\) 是 hashRateLog,默认 \(7 - \lfloor \text{strategy}/3 \rfloor\)(fast 为 7,btultra2 为 4)。 - 对切分点之前 minMatchLength 字节(默认 64,btultra 及以上为 32)计算 XXH64,按哈希值放进 \(2^{\text{hashLog}}\) 个桶,每桶 \(2^{\text{bucketSizeLog}}\) 项,hashLog 默认为 windowLog 减 \(r\)。
- 新切分点查桶,校验和一致时向前、向后扩展,得到至少 minMatchLength 长的长匹配。
- 长匹配作为现成的序列交给常规的块压缩器,两个长匹配之间的数据仍由原来的策略压缩(
ZSTD_ldm_blockCompress)。
因为只在切分点采样,LDM 的表按 \(2^{r}\) 的比例稀疏,能覆盖
\(2^{27}\)
字节窗口而内存可控;代价是只能找到至少几十字节长的匹配。CLI
的 --long 不带参数时把 windowLog 设为 27;库在
btopt 及以上策略且 windowLog 不小于 27 时自动启用
LDM(ZSTD_resolveEnableLdm)。
7.2 实验:精确副本与带插入的副本
输入是 Canterbury 语料的 tar 包(2,821,120 字节)后接它的一个副本,副本分两种:原样复制;以及每 1000 字节插入 1 个伪随机字节(线性同余生成器,种子 12345)。两份内容的距离约 2,821,120 字节(2.69 MiB),超过 level 3 默认的 \(2^{21}\) 窗口,在 level 19 默认的 \(2^{23}\) 窗口之内:
| 输入 | level 3(\(2^{21}\)) | level 3,\(2^{27}\) | level 3,\(2^{27}\),LDM | level 19(\(2^{23}\)) | level 19,\(2^{27}\),LDM |
|---|---|---|---|---|---|
| 精确副本(5,642,240 字节) | 1,268,364 | 633,989 | 634,041 | 511,689 | 511,665 |
| 带插入的副本(5,645,062 字节) | 1,296,179 | 1,006,215 | 650,002 | 527,313 | 525,533 |
默认窗口下 level 3 看不到第一份,输出 1,268,364 字节。精确副本在 \(2^{27}\) 窗口下即使不开 LDM 也降到 633,989 字节,正好约为前者的一半,也就是第二份几乎不占空间(作为参照,第五节把 11 个文件分别压缩是 634,558 字节);整个副本只用了 30 个超过 2 MiB 的偏移。dfast 在副本开头偶然命中一次远距离候选后,匹配可以一直延伸到块尾;下一块开头 Rep1 仍是这个偏移,而 dfast 在每个位置都先检查 Rep1,于是副本以重复偏移的形式一块接一块地延续下去,不再依赖哈希表。
带插入的副本打破了这条链:每 1000 字节偏移加 1,新偏移既不在三个重复偏移里(\(\text{Rep1} - 1\) 只能表示减 1),也多半已不在 dfast 的哈希表里,只能靠偶然命中重新接上。只放大窗口时输出 1,006,215 字节,序列数 421,520;打开 LDM 后,每段 1000 字节的副本都由切分点采样重新找到,输出降到 650,002 字节,序列数 257,613,接近精确副本。level 19 的 btultra2 用二叉树保存窗口内所有位置,\(2^{23}\) 的默认窗口已经覆盖两份内容的距离,不开 LDM 也只比精确副本多 3%;在它之上加 LDM 只再省 0.3%。
这组实验说明,LDM
的价值取决于匹配查找器本身能记住多远:对快速级别,它是找到远距离重复的主要手段;对使用二叉树的高级别,只要窗口够大,大部分长匹配本来就找得到。代价在解码端:\(2^{27}\)
的窗口意味着解码器要准备 128 MB 缓冲区,超过 RFC 8878 建议的
8 MB;参考实现的 CLI 在 windowLog 大于 27
时要求解压方显式传入 --long=windowLog 或
--memory= 才会解码。
八、争论与开放问题
字面量该用什么编码。 zstd 对字面量用 Huffman、对序列码用 FSE。v1.0 的公告把”数据拆成多路并行码流、Huff0 解码器在单核上同时解多个符号”列为面向现代 CPU 的速度设计:Huffman 解码没有跨符号的状态依赖,4 路码流的指令可以交错执行。从本文的记账看,这个选择在压缩率上几乎没有代价:即使字面量编码到恰好等于逐块零阶经验熵,level 3 也只省 12,031 比特,约 1,504 字节,是输出的 0.24%。真正的差距在模型而不在编码器。zstd 的字面量模型是逐块零阶的,每块一张表;brotli(RFC 7932,Alakuijala 与 Szabadka,2016)为字面量定义了上下文建模,按前两个字节计算上下文 ID,再经上下文映射选择不同的前缀码(第 7 节);LZMA 用自适应的二进制区间编码,字面量的概率模型按前一个字节的高几位(参数 lc,默认 3)和位置低位分组。这些格式能把字面量压到零阶熵以下,代价是解码时要维护更多状态、查更多表。字面量在 level 19 只剩输出的 15%,在 level 1 却占 56%,所以哪种取舍更好,取决于典型数据会被压到哪一档。
偏移的低位能不能压。
第五节里最大的一块是不经熵编码的偏移额外比特,占 39% 到
44%。LZMA 规范展示了另一种做法:距离小于 128
时所有低位都由按距离槽区分的反向比特树建模;更大的距离,中间的比特作为直接比特写入,最低
4
位仍用一棵共用的”对齐”比特树(AlignDecoder)自适应编码。也就是说,LZMA
同样把大距离的中间比特当作近似均匀、原样写入,只对最低几位建模,这对按
2 的幂对齐的数据(例如定长记录的二进制文件)有利。zstd
格式没有对应的机制,要引入就得改格式。偏移低位里到底还有多少冗余,与数据类型强相关,本文没有测量。
编码器启发式与代价估计。 格式允许每块、每类码独立选择码表来源,这给了编码器很大的空间,也让结果依赖实现。第六节的实验显示,libzstd 的快速策略在”有可沿用的表”时会无条件沿用,在异构字典上造成最多 10 个百分点的损失;高级别的代价估计则没有这个问题。代价估计需要对每个块统计直方图并估算三种方案的比特数,快速级别省掉它是为了速度。有没有一种足够便宜的检测,能在快速级别识别”旧表明显不合适”的情况,是实现层面尚未解决的问题;格式本身不需要改动。
窗口与内存。 RFC 8878 允许最大约 3.75 TB
的窗口,只建议 8 MB 以内;RFC 9659 在 HTTP 内容编码里把 8 MB
改成了硬性要求,理由是一些浏览器为控制内存限制了窗口,造成互操作问题。而
RFC 9842 的 dcz 又允许窗口达到 8 MB 与字典大小
1.25 倍中的较大者、上限 128
MB,它的用例是用资源的旧版本作字典、传输新版本的差量,1.25
倍的余量是为了让两个版本之间增长了 25%
的资源仍能在整个输入上引用字典(第 5
节)。第七节的实验说明远距离重复只有在窗口覆盖它时才能被利用;同一个格式在不同部署场景下取不同的窗口上限,是在压缩率和解码端内存风险之间的权衡,没有统一的答案。
九、复现
reproduce/ 下的文件:
| 文件 | 作用 |
|---|---|
build.sh |
下载并校验 zstd v1.5.7 发布包和 Canterbury
语料,make -j1 编译
libzstd.a,给教学解码器打补丁,编译
zbits;SAN=1 时编译带 ASan/UBSan
的 zbits-san |
edu-stats.patch |
对
doc/educational_decoder/zstd_decompress.c
的补丁,只插入计数钩子 |
zstat_hooks.h、edu_api.h |
钩子与教学解码器接口的声明 |
zbits.c |
用 libzstd 压缩、用教学解码器解码并记账;校验往返一致和字节总和;支持级别、窗口、LDM、完整字典与原始内容字典、按记录切分、字典训练 |
run.py |
运行三组实验,写出
results/levels.txt(第五节)、dict.txt(第六节)、ldm.txt(第七节) |
summarize.py |
从结果文件算出正文引用的全部数字,写入
results/summary.txt |
plot.py |
从 levels.txt 画
zstd-bits-by-level.svg,需要 matplotlib |
fse_table.py |
按 RFC 8878 第 4.1 节建 FSE
解码表;打印第四节的示例表,--check 与附录 A
比对,--svg 画示例图 |
运行方式(构建目录放在临时目录,reproduce/
里只写 results/):
cd reproduce
B=$(mktemp -d)
BUILD_DIR=$B sh build.sh
BUILD_DIR=$B python3 run.py
python3 summarize.py > results/summary.txt
python3 plot.py
curl -fsSL -o "$B/rfc8878.txt" https://www.rfc-editor.org/rfc/rfc8878.txt
python3 fse_table.py --check "$B/rfc8878.txt"
BUILD_DIR=$B SAN=1 sh build.sh
"$B/zbits-san" -l 19 "$B"/cantrbry/*
build.sh 校验两个下载文件的
SHA-256:zstd-1.5.7.tar.gz 为
eb33e51f49a15e023950cd7825ca74a4a2b43db8354825ac24fc1b7ee09e6fa3,与
release 页面附带的 .sha256
文件一致;cantrbry.tar.gz 为
f140e8a5b73d3f53198555a63bfb827889394a42f20825df33c810c3d5e3f8fb。压缩结果是确定性的,所有指标都是字节数、比特数和计数,重跑得到相同的数字。zbits-san
在 level 19 全语料、1 KB
记录加完整字典与原始内容字典、字典训练几种情形下都没有报告错误。作为交叉检查,系统自带的
zstd 1.5.5 CLI 以 -19 --no-check 压缩
alice29.txt 得到 49,211 字节,与
zbits 相同;-3 得到 56,995
字节,比 1.5.7 多 25 字节,属于版本差异。
环境记录在 results/env.txt:KVM 虚拟机,2 个
vCPU,AMD EPYC 9754,Linux 6.8.0-90,GCC 13.3.0,Python
3.12.3。帧结构图 zstd-frame-layout.svg
手工绘制,序列码流图 sequence-bitstream.svg 按
RFC 8878 第 3.1.1.3.2.1.2 节的读取顺序绘制。
十、参考资料
规范与文档
- Y. Collet, M. Kucherawy (Ed.). RFC 8878: Zstandard Compression and the ‘application/zstd’ Media Type. February 2021. 第 3 节帧格式,第 4 节 FSE 与 Huffman,第 5、6 节字典,附录 A 预定义表。
- Y. Collet, M. Kucherawy (Ed.). RFC 8478: Zstandard Compression and the application/zstd Media Type. October 2018. 已被 RFC 8878 取代。
- N. Jaju, W. F. Handte (Ed.). RFC 9659: Window Sizing for Zstandard Content Encoding. September 2024.
- P. Meenan, Y. Weiss (Ed.). RFC 9842:
Compression Dictionary Transport. September 2025. 第 5
节
dcz。 - J. Alakuijala, Z. Szabadka. RFC 7932: Brotli Compressed Data Format. July 2016. 第 7 节上下文建模。
- Igor Pavlov. LZMA
specification (DRAFT version). 2015-06-14(LZMA SDK 的
DOC/lzma-specification.txt,此链接为 GitHub 镜像)。距离解码与AlignDecoder,字面量上下文 lc、lp。 - zstd(1)
手册,v1.5.7。
--long与--memory。
源码
- facebook/zstd
v1.5.7,2025-02-19。以下文件均取自该 tag:
lib/compress/clevels.h:级别到参数的映射。lib/compress/zstd_compress_sequences.c:ZSTD_selectEncodingType。lib/compress/zstd_compress_literals.c:单路与 4 路、HUF_flags_preferRepeat。lib/compress/huf_compress.c:HUF_optimalTableLog。lib/compress/zstd_compress.c:ZSTD_resolveBlockSplitterMode、ZSTD_resolveEnableLdm、ZSTD_dictNCountRepeat。lib/compress/zstd_ldm.c:LDM 的参数与 gear 哈希。lib/dictBuilder/cover.c、lib/dictBuilder/zdict.c:COVER、fastCover 与ZDICT_trainFromBuffer。doc/educational_decoder/:本文记账所用解码器的原始版本。
CHANGELOG,v1.5.7:v0.1.0、v0.5.0、v1.0.0、v1.1.3、v1.3.2 的条目。- 首个提交 4856a00 “Initial release”,Yann Collet,2015-01-24。
核心论文
- J. Ziv, A. Lempel. A Universal Algorithm for Sequential Data Compression. IEEE Transactions on Information Theory 23(3), 1977, pp. 337–343. doi:10.1109/TIT.1977.1055714.
- J. Duda. Asymmetric numeral systems. arXiv:0902.0271, 2009(预印本)。
- J. Duda. Asymmetric numeral systems: entropy coding combining speed of Huffman coding with compression rate of arithmetic coding. arXiv:1311.2540, 2013(预印本)。
- J. Duda, K. Tahboub, N. J. Gadgil, E. J. Delp. The use of asymmetric numeral systems as an accurate replacement for Huffman coding. Picture Coding Symposium (PCS) 2015, pp. 65–69. doi:10.1109/PCS.2015.7170048.
其他论文
- F. Giesen. Interleaved entropy coders. arXiv:1402.3392, 2014(预印本)。
- S. Kuruppu, S. J. Puglisi, J. Zobel. Relative Lempel-Ziv Compression of Genomes for Large-Scale Storage and Retrieval. SPIRE 2010, LNCS 6393, pp. 201–206. doi:10.1007/978-3-642-16321-0_20.
- K. Liao, M. Petri, A. Moffat, A. Wirth. Effective Construction of Relative Lempel-Ziv Dictionaries. WWW 2016, pp. 807–816. doi:10.1145/2872427.2883042.
- R. Arnold, T. Bell. A corpus for the evaluation of lossless compression algorithms. DCC 1997, pp. 201–210. doi:10.1109/DCC.1997.582019.
工程资料
- Y. Collet, C. Turner. Smaller and faster data compression with Zstandard. Engineering at Meta, 2016-08-31.
- Y. Collet. Finite State Entropy - A new breed of entropy coder. 2013-12-16.
实验
- The
Canterbury Corpus,
cantrbry.tar.gz。 - 本文
reproduce/目录与results/下的结果文件。
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
算术编码、Range Coder 与 ANS:分数比特的记账方式与精度损失
算术编码、range coder、rANS、tANS 怎样让每个符号只花分数比特,有限精度的损失落在频率量化、区间截断、状态下界、表的排布和收尾字节中的哪一处;用逐比特记账的可复现实验量化离熵多远,并讨论自适应建模、专利与 tANS 建表的开放问题。
Huffman 编码与 DEFLATE:最优前缀码、规范码表与比特的去向
证明 Huffman 码为何最优、离熵多远,讲清规范码、15 位限长、查表解码与 DEFLATE 的三层码表;用逐比特记账的解码器拆开 zlib 1.3 与 zopfli 的输出:Huffman 只比经验熵多 0.64%,距离额外比特却占 42%。
LZ77、LZ78 与 LZW:字典从哪里来,最长匹配怎么找
从 1977、1978 年两篇原始论文出发,讲清滑动窗口与短语表两种字典、LZSS 与 LZW 的改动;用可解码验证的固定码 DEFLATE 输出实测哈希链与二叉树匹配查找器、贪心/lazy/最优解析:二叉树每位置 22 个候选即得最长匹配,最优解析比贪心小 12.7%。
整数压缩:varint、Golomb、PForDelta 与 SIMD 位打包,倒排表里每个整数花几比特
以倒排表的 d-gap 为对象,在两份真实语料和伯努利合成表上实测 varint、Elias、Golomb/Rice、插值编码、Elias-Fano、Simple、PFOR、Stream VByte、BP128 的每整数比特数与下界之差,并在共享 2 vCPU 上测解码的相对速度。