一个二元信源,0 出现的概率是 0.99,熵只有 0.0808 比特每符号。Huffman 码在这里无能为力:字母表只有两个符号时,两个码字都至少 1 比特,平均码长就是 1 比特,是熵的 12 倍。算术编码(arithmetic coding)和非对称数字系统(Asymmetric Numeral Systems,ANS)不给单个符号分配码字,而是让整条消息共享一个区间或一个整数状态,每个符号只让它”变化” \(-\log_2 p\) 比特,于是平均码长可以任意接近熵。
“任意接近”是在无限精度下说的。真实实现用 32 位整数,频率要量化成 \(2^k\) 的分数,区间宽度要截断,状态要限制在一个窗口里,流的末尾还要多写几个字节。本文关心的是:这些有限精度的代价各有多大,落在哪里,参数怎么选才能忽略它。
本文按算术编码 → range coder → rANS → tANS
的顺序讲机制,Huffman 的最优性与 DEFLATE 见第 80
篇,zstd 里 FSE(一种 tANS)的表格式与传输见第 82
篇。数据来自
reproduce/ecbench.c:它实现了四种编码器,每个数字都来自一次真实编码,并且解码回来与输入逐字节比对。所有指标都是比特数,与时钟无关。主要结果:
- 算术编码几乎没有编码器损失:用精确计数做模型时,Canterbury
语料的
ptt5(传真图像)上 Huffman 比熵多 37.2%,算术编码与熵在小数点后 5 位一致,整条消息只多出收尾的约 2 比特。 - 有限精度的损失主要来自频率量化:频率总和 \(M=2^k\) 每加一位,量化损失降到原来的 1/2.3 到 1/5;同一个量化模型下,rANS 在状态下界 \(L \ge 2^5 M\) 之后只剩 4 字节收尾,而 LZMA 式 range coder 的截断损失随 \(k\) 增大而上升。
- tANS
的损失取决于符号在表里怎么排:把同一符号的状态连续排放,表再大损失也降不下去(
alice29.txt上稳定在约 75 毫比特每符号);zstd 用的步长排布和”精确”排布都随表增大收敛到量化下限。 - ANS 做自适应模型要付内存:在概率分段切换的二元源上,自适应模型比静态模型省 17.6%,rANS 能达到与 range coder 相同的大小,但编码端必须先正向走一遍模型、缓存每个符号的概率(本实验 2 字节每符号)。
一、整数码长的代价
熵 \(H = -\sum_s p_s \log_2 p_s\) 是平均码长的下界。Huffman 码是”每个符号单独编成整数长度的码字”这一约束下的最优前缀码,平均码长满足 \(H \le \bar\ell < H + 1\);Gallager(IEEE Transactions on Information Theory, 1978)把上界收紧到 \(H + p_{\max} + 0.086\)(\(p_{\max} < 1/2\) 时),证明与例子见第 80 篇。这个界说明损失集中在”有一个符号占绝对多数”的分布上,而二元信源是极端情形:只要字母表至少有两个符号,前缀码的每个码字至少 1 比特,平均码长不可能低于 1。
传统补救是分组(block coding):把 \(k\) 个符号当成一个超级符号,对
\(2^k\) 个组合建 Huffman
码。每个超级符号的冗余仍不超过 1 比特,摊到源符号上就是
\(1/k\)。下图是
ecbench blocks
对无记忆二元信源精确计算的结果:
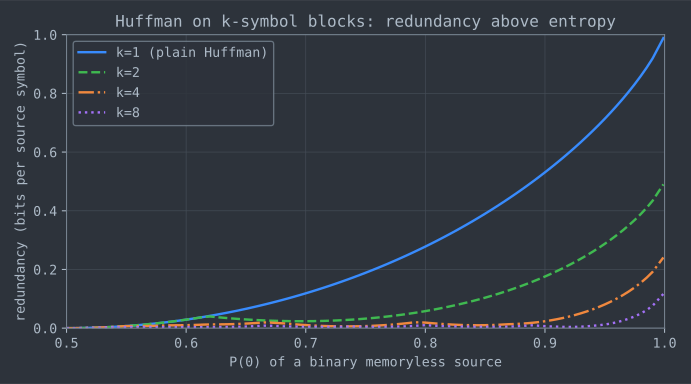
\(P(0)=0.99\) 时,\(k=1\)、2、4、8 的冗余依次是
0.919、0.434、0.192、0.076 比特每符号;分到 8 个一组、码表
256 项,冗余仍然与熵本身(0.0808)相当。码表按 \(2^k\) 增长,而冗余只按 \(1/k\)
下降,这条路走不远。对多符号字母表也是如此:ptt5
有 159 个不同字节值,其中 0 字节占 87.1%,Huffman 每字节
1.661 比特,熵 1.210 比特。
算术编码换了一个问题:不再问”每个符号的码字是什么”,而是问”整条消息落在 \([0,1)\) 的哪个子区间里”。
二、算术编码:把整条消息映射成一个区间
区间细分
三符号信源 \(\{A, B, C\}\),\(P(A)=0.6\)、\(P(B)=0.3\)、\(P(C)=0.1\)。记累积概率 \(C(A)=0\)、\(C(B)=0.6\)、\(C(C)=0.9\)。编码器维护当前区间 \([\mathrm{low}, \mathrm{low}+w)\),初始为 \([0, 1)\);每读一个符号 \(s\),就把当前区间按概率切开,只保留 \(s\) 那一段:
\[ \mathrm{low} \leftarrow \mathrm{low} + w\cdot C(s), \qquad w \leftarrow w \cdot P(s). \]
编码 “BAC” 的三步:

\[ [0, 1) \xrightarrow{B} [0.6,\ 0.9) \xrightarrow{A} [0.6,\ 0.78) \xrightarrow{C} [0.762,\ 0.78). \]
最终宽度 \(w = 0.3 \times 0.6 \times 0.1 = 0.018\),等于消息的概率。在宽度为 \(w\) 的区间里总能找到一个二进制小数,它的前 \(\lceil -\log_2 w \rceil + 1\) 位确定之后,无论后面接什么都还落在区间内。所以整条消息 \(x_1 \ldots x_n\) 的码长满足
\[ \ell(x_1 \ldots x_n) \le \left\lceil -\log_2 \prod_{i=1}^{n} P(x_i) \right\rceil + 1 < \sum_{i=1}^{n} -\log_2 P(x_i) + 2 . \]
与 Huffman 的 \(H+1\) 相比,差别在于这 2 比特是整条消息的开销,不是每个符号的开销。“BAC” 的自信息是 \(-\log_2 0.018 \approx 5.80\) 比特,上界给出不超过 7 比特。
模型也不必固定:每一步用的 \(P(s)\) 可以是”根据已经编码的内容预测下一个符号”的条件概率,只要解码器能算出同样的值。这是算术编码最重要的性质,它把建模(给出概率)和编码(把概率变成比特)完全分开,PPM、上下文混合、CABAC 都建立在这一点上。
解码
解码器拿到一个落在最终区间里的数 \(v\)(例如 \(0.762\)),每一步看 \(v\) 落在哪一段,输出那个符号,再把那一段拉伸回 \([0,1)\):\(v \leftarrow (v - C(s))/P(s)\)。

\(0.762 \to B\),\((0.762-0.6)/0.3 = 0.54 \to A\),\(0.54/0.6 = 0.9 \to C\)。解码器需要知道何时停下:要么事先传消息长度,要么在字母表里加一个结束符。
来源
Howard 与 Vitter(Practical Implementations of Arithmetic Coding,1992)把思想追溯到 Shannon 1948 年的论文,并记述 Elias 约 15 年后重新发现、只在 Abramson 1963 年的教材中被简短提及。上面的写法需要无限精度的实数;按同一文献的梳理,有限精度与增量输出的机制由 Pasco(Stanford 博士论文,1976)、Rissanen(IBM Journal of Research and Development,1976)、Rubin、Rissanen 与 Langdon(IBM J. R&D,1979)、Guazzo 以及 Witten、Neal、Cleary 逐步建立。Witten、Neal、Cleary 1987 年在 CACM 发表的论文附了完整的 C 实现,下一节用它的结构。
三、有限精度:重归一化与待定比特
三种情况
区间越来越窄,直接用浮点数很快就会耗尽精度。解决办法是边编码边输出:区间一旦整个落在 \([0, 0.5)\) 或 \([0.5, 1)\),下一位二进制就确定了,可以立即写出,再把区间放大一倍,把精度”借回来”。

第三种情况是 Witten 等人论文里的关键:区间跨过 \(0.5\),但整个落在 \([0.25, 0.75)\) 内。此时下一位还不能定,但可以断定下一位与再下一位相反(要么是 01,要么是 10)。于是先把区间以 \(0.25\) 为基准加倍,记一个待定比特(pending bit);等后面某一步终于定下一位 \(b\) 时,紧接着补写 pending 个 \(\bar b\)。Howard 与 Vitter 指出,IBM 的 Langdon 等人用的比特填充(bit stuffing)限制进位传播,与这个机制大致等价。
整数实现
用 32 位整数表示 \([0,
1)\),\(\mathrm{high}\)
是闭区间上端。下面摘自 reproduce/ec.h 的
ac_encode(注释为本文所加),常量
AC_Q1、AC_HALF、AC_Q3
分别是 \(2^{30}\)、\(2^{31}\)、\(3\cdot 2^{30}\):
static void ac_encode(ac_enc *e, uint32_t clo, uint32_t chi, uint32_t T)
{
    uint64_t range = e->high - e->low + 1;
    e->high = e->low + range * chi / T - 1;
    e->low  = e->low + range * clo / T;
    for (;;) {
        if (e->high < AC_HALF) {
            ac_emit(e, 0);                   /* 写 0,再补 pending 个 1 */
        } else if (e->low >= AC_HALF) {
            ac_emit(e, 1); e->low -= AC_HALF; e->high -= AC_HALF;
        } else if (e->low >= AC_Q1 && e->high < AC_Q3) {
            e->pending++; e->low -= AC_Q1; e->high -= AC_Q1;
        } else break;
        e->low = 2 * e->low; e->high = 2 * e->high + 1;
    }
}clo、chi 是符号 \(s\) 的累积频数区间 \([c_s, c_s +
f_s)\),T
是频数总和。循环结束时区间既不在某一半里、也不在中间一半里,于是
\(\mathrm{high} - \mathrm{low} + 1
> 2^{30}\)。这给出了精度约束:只要 \(T \le 2^{30}\),频数为 1
的符号也能分到非空的子区间。两次整除各丢掉不到 1
个单位,相对于大于 \(2^{30}\)
的区间宽度可以忽略。
编码结束时再写 2 比特(外加积压的 pending
比特),让解码器读到的值无论后面补什么都落在最终区间内。ecbench e4
的结果(第八节)是:在 alice29.txt
的各长度前缀上,算术编码比模型的交叉熵只多 0.4 到 2
比特。按字节存储时还要再补齐到字节边界。
逐比特输出的缺点在速度:每个比特一次分支、一次写入。下一节的 range coder 把输出单位换成字节。
四、Range coder:按字节输出与进位
从比特到字节
G. N. N. Martin 1979 年在 Southampton 的 Video & Data Recording Conference 上发表了 range encoding:思路与算术编码相同,但把区间看成一个大整数范围,按任意进制(实践中是 256)输出数字。编码器维护下界 \(\mathrm{low}\) 和宽度 \(\mathrm{range}\);编码频数 \(f_s\)、累积频数 \(c_s\)、总和 \(M = 2^k\) 的符号:
\[ r = \left\lfloor \frac{\mathrm{range}}{M} \right\rfloor, \qquad \mathrm{low} \leftarrow \mathrm{low} + r\, c_s, \qquad \mathrm{range} \leftarrow r\, f_s . \]
\(\mathrm{range}\) 小于 \(2^{24}\) 时,\(\mathrm{low}\) 的最高字节已经不会再被宽度影响,可以移出,\(\mathrm{range}\) 左移 8 位。唯一的麻烦是进位:\(\mathrm{low}\) 加上一个数之后可能向已经”移出”的高位进 1。第三节的 pending 比特在这里变成了待定字节。
LZMA 的进位处理
xz 5.6.3 的
src/liblzma/rangecoder/range_encoder.h
里,low 是 64 位,第 32
位充当进位;最近移出的一个字节存在
cache,其后跟着的若干个 0xFF
只记个数 cache_size,因为它们在进位时都会变成
0x00:
static inline bool
rc_shift_low(lzma_range_encoder *rc,
        uint8_t *out, size_t *out_pos, size_t out_size)
{
    if ((uint32_t)(rc->low) < (uint32_t)(0xFF000000)
            || (uint32_t)(rc->low >> 32) != 0) {
        do {
            if (*out_pos == out_size)
                return true;

            out[*out_pos] = rc->cache + (uint8_t)(rc->low >> 32);
            ++*out_pos;
            ++rc->out_total;
            rc->cache = 0xFF;

        } while (--rc->cache_size != 0);

        rc->cache = (rc->low >> 24) & 0xFF;
    }

    ++rc->cache_size;
    rc->low = (rc->low & 0x00FFFFFF) << RC_SHIFT_BITS;

    return false;
}条件的意思是:要么已经发生进位(low >> 32
非零),要么即将移出的字节小于
0xFF、以后再怎么进位也传不过它。满足时,先写
cache 加上进位,再写积压的
cache_size - 1 个字节(0xFF
加进位);否则只把积压计数加一。rc_reset 把
cache_size 置 1、range 置
UINT32_MAX,结束时 rc_flush
连续调用 5 次 rc_shift_low。由于初始区间是
\([0,
2^{32})\),第一个输出字节总是 0;解码器读入 5
个字节初始化,range_decoder.h 的
rc_read_init 会把首字节不为 0
的流判为损坏。
LZMA
本身不用上面的多符号形式。range_common.h 里
RC_BIT_MODEL_TOTAL_BITS 为
11、RC_MOVE_BITS 为 5:每个二值决策有一个 11
位概率 \(p_0\),编码 0 时
\(\mathrm{range} \leftarrow
\lfloor \mathrm{range}/2^{11} \rfloor p_0\),然后
\(p_0 \leftarrow p_0 + \lfloor
(2^{11} - p_0)/2^5 \rfloor\);编码 1 时取另一段并让
\(p_0 \leftarrow p_0 - \lfloor p_0
/ 2^5
\rfloor\)。字面量、长度、距离都拆成比特树上的一串二值决策,再加上不经模型的直接比特(RC_DIRECT_0、RC_DIRECT_1)。这样整个编码器没有除法,模型也可以逐符号自适应。
截断的代价
多符号 range coder 的 \(r = \lfloor \mathrm{range}/M \rfloor\) 每一步丢掉 \(\mathrm{range} \bmod M\),最多是 \(M-1\) 个单位,而且与编的是哪个符号无关。平均丢掉约 \(M/2\),折合每个符号
\[ \Delta \approx \log_2 e \cdot \frac{M}{2\,\mathrm{range}} . \]
若把 \(\mathrm{range}\)
看成在 \([2^{24}, 2^{32})\)
上按对数均匀分布,\(\mathbb{E}[1/\mathrm{range}] =
(2^{-24} - 2^{-32})/(8 \ln 2) \approx 0.18 \times
2^{-24}\);\(M =
2^{16}\) 时 \(\Delta
\approx 0.5\) 毫比特每符号。ecbench e2
实测(第六节的图)在两个 \(2^{20}\) 符号的合成源上是 0.49
与 0.54 毫比特,\(k\)
每减一位约减半,与这个估计一致。算术编码没有这项损失,因为它用的是
\(\lfloor \mathrm{range}\cdot c_s
/ T \rfloor\)
这种先乘后除的形式,代价是一次乘法和一次 64 位除法;range
coder 把除法提到前面,换来的是 \(M\) 越大损失越大。
五、ANS:用一个整数记账
从进制到非对称进制
Jarek Duda 2009 年在 arXiv 上发表 Asymmetric numeral systems(预印本,未经同行评审),2013 年的 Asymmetric numeral systems: entropy coding combining speed of Huffman coding with compression rate of arithmetic coding(同为 arXiv 预印本)给出了今天通行的 rANS 与 tANS 两种形式;经过同行评审的版本是 Duda、Tahboub、Gadgil、Delp 在 Picture Coding Symposium 2015 上的论文。
出发点是普通的进制。把一个比特 \(s \in \{0,1\}\) “压入”自然数 \(x\):\(x' = 2x + s\),\(\log_2 x\) 恰好增加 1。概率均等时这是最优的;ANS 的问题是,能否构造一种”非对称”的进制,让压入概率为 \(p_s\) 的符号时 \(x' \approx x / p_s\),从而 \(\log_2 x\) 增加 \(-\log_2 p_s\)。
rANS 的编码与解码
rANS(range variant)的构造是:把频数量化为 \(f_s\),总和 \(M\),累积频数 \(c_s\)。把自然数按模 \(M\) 分成周期,每个周期里的 \(M\) 个位置(slot)中,\([c_s, c_s + f_s)\) 这 \(f_s\) 个位置属于符号 \(s\)。压入 \(s\) 就是找到”第 \(x\) 个属于 \(s\) 的位置”:
\[ C(s, x) = \left\lfloor \frac{x}{f_s} \right\rfloor M + (x \bmod f_s) + c_s . \]
弹出时,\(x \bmod M\) 落在哪个符号的范围就是哪个符号,即满足 \(c_s \le x \bmod M < c_s + f_s\) 的 \(s\);再数一数 \(x\) 之前有多少个属于它的位置:
\[ D(x) = f_s \left\lfloor \frac{x}{M} \right\rfloor + (x \bmod M) - c_s . \]
\(D(C(s, x)) = (s, x)\) 直接代入即可验证。

\(C(s,x) \approx x \cdot M / f_s\),所以 \(\log_2 x\) 增加约 \(\log_2(M/f_s)\)。算术编码用区间宽度的缩小记账,ANS 用状态数值的增长记账,两者记的是同一个量。
栈语义
\(x' = C(s, x)\) 是一次压栈,\(D\) 是弹栈:最后压入的符号最先弹出。要让解码器按 \(s_1, s_2, \ldots, s_n\) 的顺序输出,编码器必须按 \(s_n, \ldots, s_1\) 的顺序压入。

这是 ANS 与算术编码最重要的工程差别。算术编码是先进先出,编码器可以一边读输入一边输出;ANS 编码器要先看到整块输入,倒着编码,输出也是从缓冲区尾部往前写。对静态模型这只是多一次缓冲;对自适应模型(概率依赖于已经编过的内容)则意味着编码器要先正向走一遍模型、记下每一步的概率,第九节会回到这个问题。反过来,栈语义也有用处:Townsend、Bird、Barber 的 BB-ANS(ICLR 2019)用它实现 bits-back 编码,在潜变量模型上做无损压缩,“先解码出一些比特再编码回去”的操作需要的正是后进先出。
六、流式 rANS:状态窗口与精度
把状态关在窗口里
\(x\) 无限增长就回到了大整数运算。流式 rANS 把状态限制在 \(I = [L, bL)\) 内,\(b\) 是输出进制(通常 \(b = 2^8\) 或 \(2^{16}\)):编码前如果 \(x\) 太大,就把低位的一个 \(b\) 进制数字写出去、\(x \leftarrow \lfloor x / b \rfloor\);解码后如果 \(x < L\),就读入一个数字、\(x \leftarrow bx + d\)。编码端的阈值要保证 \(C(s, x)\) 仍落在 \(I\) 内,并且编码端”何时写出”与解码端”何时读入”一一对应。Duda(2013)的条件是 \(L\) 为 \(M\) 的整数倍;此时编码 \(s\) 之前允许的状态区间恰好是 \([(L/M) f_s,\ (bL/M) f_s)\),于是
\[ x_{\max}(s) = \frac{bL}{M} f_s, \qquad \text{while } x \ge x_{\max}(s):\ \text{emit } x \bmod b,\ x \leftarrow \lfloor x/b \rfloor . \]

Fabian Giesen 的 ryg_rans(公有领域,提交
c9d162d)的 rans_byte.h 取 \(L = 2^{23}\)、\(b = 2^8\),状态用满 31
位。源码注释说明这是有意的:31 位无符号数的精确倒数能放进 32
位,编码端可以用乘法代替除法。下面摘录编码端(删去了部分注释):
#define RANS_BYTE_L (1u << 23)  // lower bound of our normalization interval

static inline RansState RansEncRenorm(RansState x, uint8_t** pptr, uint32_t freq, uint32_t scale_bits)
{
    uint32_t x_max = ((RANS_BYTE_L >> scale_bits) << 8) * freq; // this turns into a shift.
    if (x >= x_max) {
        uint8_t* ptr = *pptr;
        do {
            *--ptr = (uint8_t) (x & 0xff);
            x >>= 8;
        } while (x >= x_max);
        *pptr = ptr;
    }
    return x;
}

static inline void RansEncPut(RansState* r, uint8_t** pptr, uint32_t start, uint32_t freq, uint32_t scale_bits)
{
    RansState x = RansEncRenorm(*r, pptr, freq, scale_bits);
    *r = ((x / freq) << scale_bits) + (x % freq) + start;
}
x_max 就是上式的 \((bL/M)
f_s\),*--ptr
说明输出从缓冲区尾部往前写。编码结束时
RansEncFlush 把最终状态作为 4
个字节写出,解码器先读这 4
个字节;reproduce/ec.h 的
rans_put、rans_advance
是同样的结构,只是把 \(L\)
做成参数。
损失落在哪里
同一个量化模型下,rANS 输出与理想码长(模型的交叉熵 \(\sum_s n_s \log_2
(M/f_s)\))之差就是编码器本身的损失。ecbench e2
把它和量化损失(交叉熵减去经验熵)分开测:
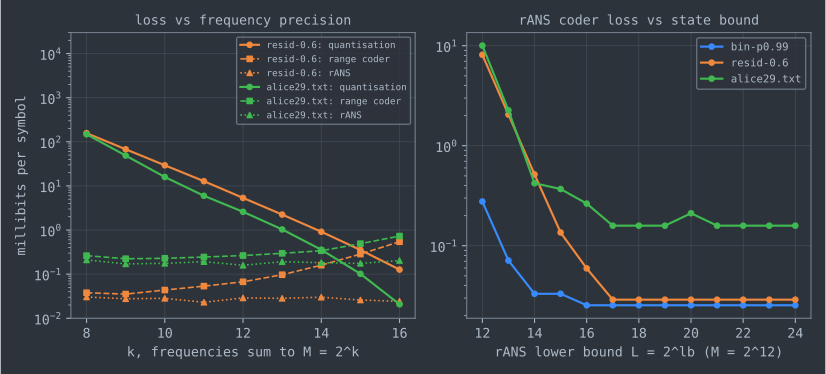
左图说明三件事。第一,量化损失是大头:对 49
个符号的合成残差源(resid-0.6),\(M = 2^8\) 时是 157
毫比特每符号,\(2^{12}\) 时
5.35,\(2^{16}\) 时
0.13;\(k\)
每加一位,损失降到原来的 1/2.3 到 1/5。第二,rANS
的编码器损失几乎不随 \(k\)
变化,在 \(2^{20}\)
个符号上约 0.023 到 0.030 毫比特每符号,折合 24 到 32
比特,就是收尾的 4 字节。第三,range coder 的损失随 \(k\)
上升,这是第四节分析的截断;\(k =
16\) 时它已经超过了量化损失。
右图固定 \(M =
2^{12}\)、改变 \(L\)。\(L = M\) 时
resid-0.6 的编码器损失是 8.1 毫比特,\(L = 2M\) 时 2.05,\(4M\) 时 0.52,\(8M\) 时 0.14:\(L\)
每加倍,损失约降为四分之一,也就是与 \((M/L)^2\) 成正比。\(L \ge 2^5 M\)
之后曲线贴到收尾字节的水平(alice29.txt 只有 15
万字节,同样 4 字节摊下来更多,所以平台更高)。\(L\) 太小时,\(\lfloor x / f_s \rfloor\)
的取整相对于 \(x\)
不再可以忽略,状态的增长偏离 \(M/f_s\)。ryg_rans
的 \(L/M =
2^{23-k}\),对常用的 \(k
\le 16\) 都在平台上。
libjxl 0.11.1
的参数是另一种取法:ans_params.h 里
ANS_LOG_TAB_SIZE 为 12,dec_ans.h
用 32 位状态、状态低于 \(2^{16}\) 时一次读入 16 比特,即
\(L = 2^{16}\)、\(b = 2^{16}\)、\(L/M = 2^4\)。它的初态是
ANS_SIGNATURE << 16(0x13 << 16),解码结束时
CheckANSFinalState
检查状态是否回到这个值,最终状态兼作校验。本文的实验是字节输出,不能直接换算成
libjxl 的数字,但 \(L/M =
2^4\) 这一档在右图里已经接近平台。
交错多个状态
rANS
的每一步都依赖上一步的状态,一条依赖链限制了指令级并行。Giesen
的 Interleaved entropy coders(arXiv
预印本,2014)让 \(W\)
个独立状态轮流编码相邻的符号,共享同一个字节流:只要编码器严格按解码顺序的逆序处理符号,各状态写出的字节就会在解码时按需要的顺序出现,不需要额外的分隔信息。代价是每多一个状态多
4 字节收尾:ecbench e4 里 4 路交错比单路多 72
到 96 比特。CRAM 3.0 的 rANS 编解码器(hts-specs
CRAMcodecs.tex,“rANS 4x8”)就是 4 路交错、按 8
比特重归一化的这种结构。
七、tANS:把状态转移做成表
表的结构
rANS 每个符号要一次除法(编码)或一次乘法(解码)。tANS(tabled ANS)取 \(b = 2\)、\(L = M = 2^R\),状态 \(X \in [L, 2L)\) 只有 \(L\) 个取值,于是全部转移都可以预先算好放进表里。建表分两步:
- 排布(spread):把 \(L\) 个状态分给各符号,符号 \(s\) 分到 \(q_s\) 个,\(\sum_s q_s = L\)。
- 编号:按状态从小到大,给符号 \(s\) 的第 \(i\) 个状态(\(i = 0, \ldots, q_s - 1\))记 \(y = q_s + i \in [q_s, 2q_s)\)。
解码状态 \(X\):查表得到符号 \(s\) 和 \(y\),令 \(nb = R - \lfloor \log_2 y
\rfloor\),读入 \(nb\) 个比特 \(d\),新状态 \(X' = y \cdot 2^{nb} +
d\),它必然落回 \([L,
2L)\)。编码是逆过程:把 \(X\) 右移 \(nb\) 位直到 \(y = \lfloor X / 2^{nb}
\rfloor\) 落进 \([q_s,
2q_s)\),写出被移掉的 \(nb\) 位,再查表找到”符号 \(s\) 编号为 \(y\) 的状态”。下图是 \(L = 16\)、\(q = (7, 6, 3)\)
的一张表(ecbench tiny
的输出,精确排布),并标出了一次编码与对应的解码:
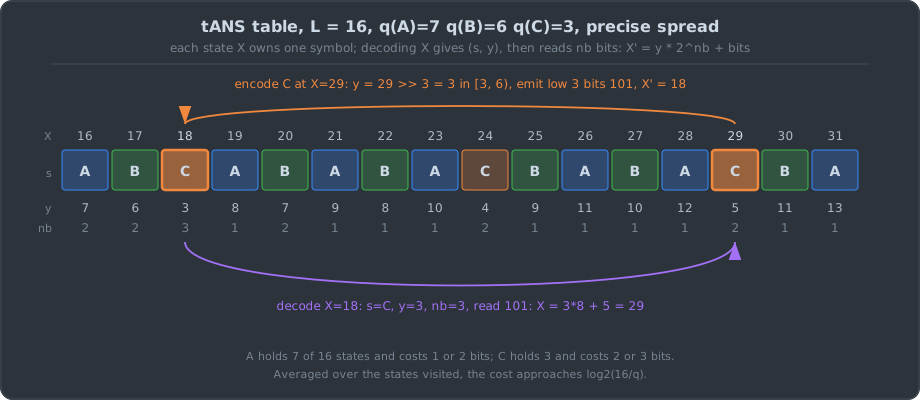
A 占 7 个状态,每次花 1 或 2 比特;C 占 3 个,每次花 2 或 3 比特。单次的比特数是整数,但状态 \(X\) 本身携带了”小数部分”:落在较大的 \(X\) 上意味着下一次多写一位的可能性更大。平均下来,符号 \(s\) 的代价趋近 \(\log_2(L/q_s)\)。编解码的内循环只有查表、移位和按位读写:
for (size_t i = n; i-- > 0;) {                 /* encoder, reverse order */
    int s = in[i];
    int nb = 0;
    while ((X >> nb) >= 2 * t->q[s]) nb++;
    put_bits(out, X & ((1u << nb) - 1), nb);
    X = t->enc[t->c[s] + (X >> nb) - t->q[s]];
}
这段摘自 reproduce/ec.h 的
tans_compress。真实实现会把 nb
的计算也预先存进表里:FSE
为每个符号存一个偏移量,一次加法和移位就能得到
nb(格式与建表细节见第 82 篇)。
排布决定损失
编号规则保证了”符号 \(s\) 的状态从小到大对应 \(y\) 从小到大”。要让代价接近
\(\log_2(L/q_s)\),还需要
\(X' \approx y \cdot L /
q_s\),也就是符号 \(s\) 的 \(q_s\) 个状态在 \([L, 2L)\)
里大致均匀散开。ecbench e3 比较三种排布:
- 连续(sequential):符号 \(s\) 占 \([c_s, c_s + q_s)\) 一整段,与 rANS 的槽位布局相同。
- 步长(fse-step):zstd
FSE_TABLESTEP的做法,位置每次前进 \(L/2 + L/8 + 3\)(模 \(L\)),这个步长是奇数,与 \(L\) 互素,能走遍所有位置。 - 精确(precise):Duda(2013)给出的做法,把符号 \(s\) 的第 \(i\) 个状态放在 \((i + 1/2)/q_s\) 附近,全部按这个键排序。
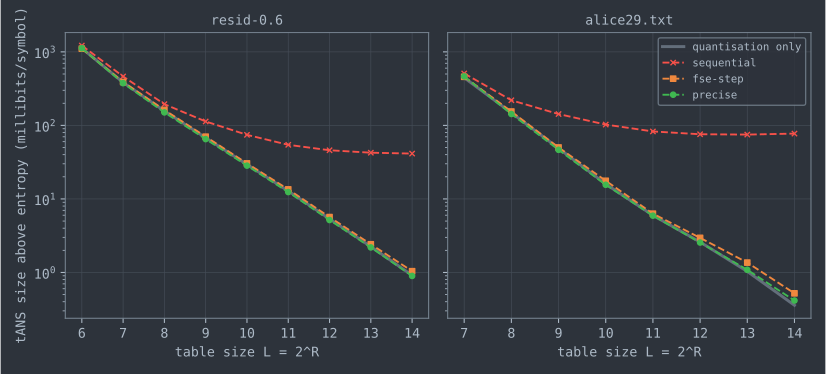
连续排布的损失降不下去:alice29.txt 上 \(R = 12\) 到 14 比经验熵多 75 到
77 毫比特每符号,resid-0.6 上 \(R = 13\)、14 约 41 到 43
毫比特。原因是一段连续的状态只覆盖 \([L, 2L)\) 的一小部分,\(y\) 从 \(q_s\) 走到 \(2q_s - 1\) 时 \(X'\) 只变化 \(q_s\),而不是需要的 \(L\),代价随 \(y\) 大幅波动。rANS
用同样的布局却没有问题,因为它的状态横跨 \([L, 256L)\) 里 \(256L/M\) 个周期,每个周期都有
\(s\)
的一段,整体上已经是均匀散开的。
步长排布和精确排布都随表增大贴近量化下限。\(R = 11\)
时,alice29.txt 上精确排布比经验熵多 5.92
毫比特,步长排布多 6.30,量化下限是
5.98。精确排布比”量化下限”还低,这不是测量误差:tANS
的实际码长由状态的平稳分布决定,并不严格等于 \(\log_2(L/q_s)\),有时反而更接近真实概率。Yokoo(ISIT
2016)分析过二元情形下状态的平稳分布。所以比较 tANS
时应当直接对照经验熵,而不是对照量化后的交叉熵。
表越大越准,但表要占内存、要随每个块传输频数、要在块开始时重建。第八节的数据里,\(R = 11\) 的 tANS 在
ptt5 上比熵多 5.3%,几乎全是量化损失:159
个符号里有 115 个按比例分不到 1 个状态(计数的中位数只有
13),都被抬到 1,多占的状态只能从 0
字节那里扣(按比例它应得约 1784 个)。
八、实测:离熵多远
同一模型下的比特数
ecbench e1
对每份数据用它自己的零阶统计做静态模型,不计模型(频数表)本身的传输。算术编码用精确计数(总和
\(T = n\)),range coder 与
rANS 把频数量化到 \(2^{15}\)(rANS 的 \(L = 2^{23}\)),tANS 用 \(2^{11}\) 的表。合成数据各 \(2^{20}\)
个符号,种子固定;后四份是 Canterbury
语料。单位是比特每符号:
| 数据 | 符号数 | 经验熵 | Huffman | 算术编码 | range coder | rANS | tANS 精确 | tANS 步长 |
|---|---|---|---|---|---|---|---|---|
| 二元 \(P(0)=0.9\) | 2 | 0.46865 | 1.00000 | 0.46865 | 0.46893 | 0.46867 | 0.46866 | 0.46866 |
| 二元 \(P(0)=0.95\) | 2 | 0.28792 | 1.00000 | 0.28792 | 0.28821 | 0.28795 | 0.28793 | 0.28794 |
| 二元 \(P(0)=0.99\) | 2 | 0.08025 | 1.00000 | 0.08025 | 0.08054 | 0.08028 | 0.08026 | 0.08027 |
| 二元 \(P(0)=0.999\) | 2 | 0.01154 | 1.00000 | 0.01154 | 0.01175 | 0.01156 | 0.01155 | 0.01156 |
resid-0.6 |
49 | 3.02725 | 3.08707 | 3.02726 | 3.02789 | 3.02763 | 3.03964 | 3.04073 |
alice29.txt |
74 | 4.56768 | 4.61244 | 4.56769 | 4.56827 | 4.56796 | 4.57360 | 4.57398 |
kennedy.xls |
256 | 3.57347 | 3.59337 | 3.57347 | 3.57380 | 3.57354 | 3.58363 | 3.58616 |
ptt5 |
159 | 1.21018 | 1.66091 | 1.21018 | 1.21221 | 1.21193 | 1.27431 | 1.27658 |
sum |
255 | 5.32899 | 5.36504 | 5.32903 | 5.33033 | 5.32971 | 5.35126 | 5.35528 |
resid-0.6 是以 128
为中心的双侧几何分布(\(P(|d| = j)
\propto 0.6^j\)),模拟预测残差。几点观察:
- Huffman 在二元源上恒为 1 比特;在
ptt5上多 37.2%;在比较”平”的alice29.txt、kennedy.xls上只多 1.0% 和 0.56%。后者与第 80 篇在 DEFLATE 里测到的情形一致:字母表大而平时,整数码长的损失本来就小。 - 算术编码与经验熵的差在第 5 位小数以内,整条消息只多收尾的几个比特。
- rANS 比 range coder 更接近熵,原因是第四节的截断:\(M = 2^{15}\) 时 range coder 的截断损失约 0.25 毫比特每符号,rANS 在这个 \(L/M\) 下只有收尾的 4 字节。
- 两种 tANS 在二元源上与 rANS 相当,在多符号数据上明显差一些:这里的表只有 \(2^{11}\),损失几乎都来自量化(第七节)。换成 \(2^{15}\) 的表,量化损失会与 rANS 一样小,但表要占 32768 项。
短消息的固定开销
ecbench e4 取 alice29.txt 的前
\(n\)
个字节,用它们自己的计数量化到 \(2^{12}\),比较实际输出与模型交叉熵之差(单位:比特)。四种编码器用的是同一套频数,差值只反映编码器的收尾和取整:
| \(n\) | 交叉熵 | 算术编码 | range coder | rANS | rANS 4 路 | tANS \(2^{12}\) |
|---|---|---|---|---|---|---|
| 16 | 24.0 | 2.0 | 40.0 | 32.0 | 104.0 | 12.0 |
| 64 | 215.4 | 0.6 | 32.6 | 24.6 | 104.6 | 11.6 |
| 256 | 885.6 | 0.4 | 34.4 | 26.4 | 106.4 | 11.4 |
| 1024 | 4617.2 | 0.8 | 38.8 | 30.8 | 102.8 | 11.8 |
| 4096 | 18695.4 | 0.6 | 32.6 | 24.6 | 120.6 | 10.6 |
| 65536 | 296524.4 | 1.6 | 35.6 | 27.6 | 115.6 | −6.4 |
算术编码的数字是比特,未补齐到字节;其余是整字节。range coder 的 5 字节收尾(首字节恒为 0)约 33 到 40 比特;rANS 的 4 字节状态约 25 到 32 比特(编码从 \(x = L = 2^{23}\) 开始,最终状态 \(x \in [2^{23}, 2^{31})\) 里高出初态的 \(\log_2(x/L)\) 比特是消息内容,所以开销落在 \((24, 32]\));4 路交错是 4 个状态;tANS 只需写出 \(R = 12\) 位的最终状态。\(n = 65536\) 时 tANS 低于交叉熵,原因同第七节。对几十字节的消息(例如数据库页里的一列、网络协议里的一个字段),这些固定开销与载荷同一个量级,是选型时要算进去的。
九、谱系、争论与开放问题
谱系
| 年份 | 工作 | 与本文的关系 |
|---|---|---|
| 1948、1963 | Shannon;Abramson 的教材记述 Elias 的想法 | 区间表示的起点(据 Howard 与 Vitter 1992 的梳理) |
| 1976 | Rissanen(IBM J. R&D);Pasco(Stanford 博士论文) | 有限精度的算术码 |
| 1979 | Rissanen 与 Langdon(IBM J. R&D);Martin(Video & Data Recording Conf.) | 算术编码的系统化;range encoding |
| 1987 | Witten、Neal、Cleary(CACM) | 带 pending 比特的整数实现,第三节 |
| 2003 | Marpe、Schwarz、Wiegand(IEEE TCSVT) | H.264/AVC 的 CABAC:自适应二值算术编码进入视频标准 |
| 2009、2013 | Duda(arXiv 预印本) | ANS;rANS 与 tANS |
| 2014 | Giesen(arXiv 预印本) | 多状态交错 |
| 2015 | Duda、Tahboub、Gadgil、Delp(PCS) | ANS 的同行评审版本 |
| 2016、2019 | Yokoo(ISIT 2016);Dubé 与 Yokoo(ISIT 2019) | tANS 状态的平稳分布;近似最优排布的快速构造 |
| 2019 | Townsend、Bird、Barber(ICLR) | BB-ANS:利用栈语义做 bits-back 编码 |
| 2020 | Moffat 与 Petri(ACM TOIS) | 大字母表的半静态 ANS 编码 |
| 2025 | Steiner、De Vita、Bezati(ITW) | 差异度意义下最优的 tANS 建表 |
生产实现各取一支:xz/LZMA 用自适应二值 range coder;H.264
的 CABAC 与 AV1 用自适应算术编码;JPEG XL(libjxl)、CRAM
3.0、Draco 用 rANS(Draco 的
src/draco/compression/entropy/ans.h 注明”based
off libvpx’s ans.h”);zstd 与 Apple 的 LZFSE 用 FSE 形式的
tANS(LZFSE 的 README:“using Finite State Entropy
coding”)。
争论一:自适应模型下选算术编码还是 ANS
算术编码是先进先出,模型可以逐符号更新,编码器边读边写,不需要缓冲。AV1
走的是这条路:libaom
的开发文档(doc/dev_guide/av1_encoder.dox)写明
AV1 用 \(M \in [2, 14]\)
元的算术编码,概率以 15 位 CDF
保存并逐符号更新,编码时只用最高 9 位。libaom
在开发期间也有过 ANS 的实现,v1.0.0
标签下仍能看到 aom_dsp/buf_ans.h,它的注释是
“Buffered forward ANS writer. Symbols are written to the
writer in forward (decode) order and serialized backwards
due to ANS’s stack like
behavior”——为了配合自适应模型,编码端要把整段符号连同概率缓存下来再倒着写。
支持 ANS 的一方认为这只是工程问题。ryg_rans
的 rans_byte.h 开头注释指出 rANS 同样具有”being
able to switch models on the fly”的性质,多个 rANS
状态还能共享一个字节流交错执行。JPEG XL
则绕开了逐符号自适应:上下文先聚类到若干直方图,libjxl 的
dec_ans.h 为每个直方图预先建好 alias
表(alias_tables_),解码时查表而不更新,于是编码端也没有缓冲概率的问题。ecbench e5
在同一个 LZMA 式自适应二值模型上比较两者(单位:比特,\(n = 2^{20}\)):
| 数据 | 静态零阶熵 | 静态算术编码 | 自适应模型理想码长 | 自适应 range coder | 自适应 rANS | rANS 编码端缓冲 |
|---|---|---|---|---|---|---|
| 平稳,\(P(1) = 0.05\) | 300297 | 300298 | 310671 | 310704 | 310696 | 2 MiB |
| 每 4096 个符号在 \(P(1) = 0.02\) 与 0.30 间切换 | 664554 | 664555 | 547322 | 547360 | 547352 | 2 MiB |
两种编码器都只比模型的理想码长多 30 多比特,压缩率上没有差别。差别在别处:rANS 编码端要先正向跑一遍模型、为每个符号存 2 字节概率,才能倒序编码;range coder 不需要。表里还有一个与编码器无关的结论:自适应模型在分段切换的源上省了 17.6%,在平稳源上却多花了 3.5%(移位 5 的更新步长带来的估计噪声)。所以”要不要自适应”取决于数据是否平稳,“用哪种编码器”取决于能不能接受编码端缓冲和倒序输出。
争论二:专利
算术编码的推广长期受专利影响。JPEG 标准(ITU-T T.81 | ISO/IEC 10918-1)的附录 L 列出了实现其算术编码过程可能需要的专利,持有人包括 IBM 与 AT&T,例如 US 4,652,856(Mohiuddin、Rissanen,“A Multiplication-free Multi-Alphabet Arithmetic Code”)和 US 4,905,297(Langdon、Mitchell、Pennebaker、Rissanen,“Arithmetic Coding Encoder and Decoder System”)。Independent JPEG Group 的 libjpeg 6b(1998 年 3 月 27 日)在 README 里写道:“support for arithmetic coding has been removed from the free JPEG software. (Since arithmetic coding provides only a marginal gain over the unpatented Huffman mode, it is unlikely that very many implementations will support it.)”
ANS 的作者 Duda 一直主张它不应被专利化,但这并没有排除围绕具体实现的专利。美国专利 US 11,234,023 B2(“Features of range asymmetric number system encoding and decoding”,受让人 Microsoft Technology Licensing,2019 年 6 月 28 日申请,2022 年 1 月 25 日授权)的权利要求 1 是一种”两阶段结构”的 rANS 解码器。The Register 2022 年 2 月 17 日的报道引述 Duda 的话,认为它”looks like just the description of the standard algorithm”,并称 Google 在 2018 年放弃了其在美国和欧洲的一项 ANS 相关专利申请。这项专利的权利要求很窄,它对 JPEG XL、CRAM 等现有实现有没有实际影响,没有公开的判定可以引用。
开放问题
- tANS 的表怎么建才最好。
Duda(2013)的精确排布是启发式;Dubé 与 Yokoo(ISIT
2019)给出了近似最优排布的快速构造;Steiner 等(ITW
2025,arXiv:2504.18541)证明了几种建表算法在差异度(discrepancy)意义下最优,并给出了目前最强的熵损失上界。但他们的实验只是对流式变体”a
brief empirical
evaluation”。第七节的数据提示,在常用的表大小下排布带来的差别(
alice29.txt上 \(R = 11\) 时精确与步长相差 0.38 毫比特每符号)远小于频率量化;频率量化、表大小与排布的联合最优仍缺少系统的结论。 - 频数表的代价。 本文所有实验都不计模型传输。对短块和大字母表,频数表本身可能比量化损失更贵:每块要不要传表、传多精确,是 Moffat 与 Petri(ACM TOIS 2020)讨论的半静态编码问题,也是 zstd 在 FSE 表上设”预定义表”“重复上一块的表”等模式的原因(见第 82 篇)。
十、复现
reproduce/
下的程序生成了本文全部表格和数据图。所有指标都是编码后的比特数、与熵的差值或往返解码是否一致,不涉及计时,因此结果与机器快慢无关,只依赖编译器对整数运算的正确实现。
| 文件 | 作用 |
|---|---|
ec.h |
全部编码器:频率量化、Huffman 码长、整数算术编码、LZMA 式 range coder(含二元自适应模型)、流式 rANS(可调 \(L\)、\(b\) 与交错路数)、tANS(三种排布) |
ecbench.c |
命令行入口:test(随机分布往返测试)、e1–e5(第八节与第九节的实验)、blocks(第一节的块
Huffman 曲线)、tiny(第七节的 tANS 小表) |
run.sh |
编译 -O2 -Wall -Wextra -Werror 与
ASan/UBSan 两个版本,下载 Canterbury 语料并校验
SHA-256,把结果写入 results/ |
plot.py |
读 results/*.txt,生成三张数据图(需要
matplotlib) |
figures.py |
生成其余示意图,只用标准库;tans-table.svg
的内容取自 results/tiny.txt |
cd reproduce
B=$(mktemp -d)
BUILD_DIR=$B bash run.sh
python3 plot.py
python3 figures.py
run.sh
里每一个报告出来的压缩大小都先解码回原文比对过;比对失败时程序以非零状态退出。本文数据的环境是
Linux 6.8.0(x86_64,2 vCPU AMD EPYC 9754)、GCC
13.3.0、Python 3.12.3、matplotlib 3.11.2,语料包
cantrbry.tar.gz 的 SHA-256 为
f140e8a5b73d3f53198555a63bfb827889394a42f20825df33c810c3d5e3f8fb。在这套环境下,test
跑了 3000 组随机分布、27858 次往返,sanitizer 版本跑了 600
组、5576 次往返,均无错误。
只想单独检查某个编码器,可以直接编译:
B=$(mktemp -d)
gcc -std=c11 -O2 -Wall -Wextra -o "$B/ecbench" ecbench.c -lm
"$B/ecbench" test 200
十一、参考资料
规范与文档:
- ITU-T Recommendation T.81 (1992) | ISO/IEC 10918-1, Digital compression and coding of continuous-tone still images, Annex L(专利列表)。
- samtools/hts-specs,
CRAMcodecs.tex:rANS 4x8 与 Nx16 的格式定义。 - AOMedia libaom,
doc/dev_guide/av1_encoder.dox:AV1 编码器开发文档中关于熵编码的说明。 - US 11,234,023 B2, Features of range asymmetric number system encoding and decoding(Microsoft,申请日 2019-06-28,授权日 2022-01-25)。
源码:
- xz 5.6.3,
src/liblzma/rangecoder/range_encoder.h、range_decoder.h、range_common.h。 - Fabian Giesen,
ryg_rans, commitc9d162d,rans_byte.h。 - libjxl v0.11.1,
lib/jxl/ans_params.h、lib/jxl/dec_ans.h。 - Draco 1.5.7,
src/draco/core/ans.h。 - libaom v1.0.0,
aom_dsp/buf_ans.h。 - Apple LZFSE lzfse-1.0,
README.md。 - zstd v1.5.7,
lib/common/fse.h(FSE_TABLESTEP)。
核心论文:
- J. Rissanen, “Generalized Kraft Inequality and Arithmetic Coding,” IBM J. Res. Dev., 20(3):198–203, 1976.
- J. Rissanen, G. G. Langdon, “Arithmetic Coding,” IBM J. Res. Dev., 23(2):149–162, 1979.
- I. H. Witten, R. M. Neal, J. G. Cleary, “Arithmetic Coding for Data Compression,” Commun. ACM, 30(6):520–540, 1987.
- G. N. N. Martin, “Range encoding: an algorithm for removing redundancy from a digitised message,” Video & Data Recording Conference, Southampton, 1979.
- J. Duda, “Asymmetric numeral systems,” arXiv:0902.0271, 2009(预印本)。
- J. Duda, “Asymmetric numeral systems: entropy coding combining speed of Huffman coding with compression rate of arithmetic coding,” arXiv:1311.2540, 2013(预印本)。
- J. Duda, K. Tahboub, N. J. Gadgil, E. J. Delp, “The use of asymmetric numeral systems as an accurate replacement for Huffman coding,” Picture Coding Symposium (PCS), pp. 65–69, 2015.
- F. Giesen, “Interleaved entropy coders,” arXiv:1402.3392, 2014(预印本)。
其他论文:
- R. Pasco, Source Coding Algorithms for Fast Data Compression, Ph.D. thesis, Stanford University, 1976.
- G. G. Langdon, “An Introduction to Arithmetic Coding,” IBM J. Res. Dev., 28(2):135–149, 1984.
- P. G. Howard, J. S. Vitter, “Practical Implementations of Arithmetic Coding,” in Image and Text Compression, Kluwer, 1992.
- A. Moffat, R. M. Neal, I. H. Witten, “Arithmetic Coding Revisited,” ACM TOIS, 16(3):256–294, 1998.
- R. G. Gallager, “Variations on a theme by Huffman,” IEEE Trans. Inf. Theory, 24(6):668–674, 1978.
- D. Marpe, H. Schwarz, T. Wiegand, “Context-based adaptive binary arithmetic coding in the H.264/AVC video compression standard,” IEEE TCSVT, 13(7):620–636, 2003.
- H. Yokoo, “On the stationary distribution of asymmetric numeral systems,” ISIT, pp. 11–15, 2016.
- D. Dubé, H. Yokoo, “Fast construction of almost optimal symbol distributions for asymmetric numeral systems,” ISIT, pp. 1682–1686, 2019.
- J. Townsend, T. Bird, D. Barber, “Practical lossless compression with latent variables using bits back coding,” ICLR, 2019.
- A. Moffat, M. Petri, “Large-alphabet semi-static entropy coding via asymmetric numeral systems,” ACM TOIS, 38(4), 2020.
- R. S. Steiner, M. De Vita, E. Bezati, “Optimal tables for asymmetric numeral systems,” IEEE ITW, 2025; arXiv:2504.18541.
- J. Alakuijala et al., “JPEG XL next-generation image compression architecture and coding tools,” Proc. SPIE 11137, 2019.
工程资料与实验:
- Independent JPEG Group, libjpeg release 6b
README(1998-03-27),LEGAL ISSUES 一节。 - The Register, 2022-02-17,关于 Microsoft rANS 专利授权的报道。
- R. Arnold, T. Bell, “A corpus for the evaluation of lossless compression algorithms,” DCC, 1997(Canterbury 语料)。
- 上一篇:zstd 的格式与实现:序列、FSE 表、字典与长距离匹配
- 下一篇:整数压缩:varint → PForDelta → SIMD-BP128
- 相关阅读:Huffman 编码与 DEFLATE:最优前缀码、规范码表与比特的去向、LZ77、LZ78 与 LZW:字典从哪里来,最长匹配怎么找
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
zstd 的格式与实现:序列、FSE 表、字典与长距离匹配
按 RFC 8878 与 zstd 1.5.7 源码拆开帧、块、字面量段和序列段,讲清 FSE 表怎么建、怎么传、编码器怎么选模式;用逐比特记账的解码器实测:偏移额外比特占 39–44%,FSE 离逐块经验熵不到 1%,字典与长距离匹配的收益取决于数据和编码器的启发式。
Huffman 编码与 DEFLATE:最优前缀码、规范码表与比特的去向
证明 Huffman 码为何最优、离熵多远,讲清规范码、15 位限长、查表解码与 DEFLATE 的三层码表;用逐比特记账的解码器拆开 zlib 1.3 与 zopfli 的输出:Huffman 只比经验熵多 0.64%,距离额外比特却占 42%。
整数压缩:varint、Golomb、PForDelta 与 SIMD 位打包,倒排表里每个整数花几比特
以倒排表的 d-gap 为对象,在两份真实语料和伯努利合成表上实测 varint、Elias、Golomb/Rice、插值编码、Elias-Fano、Simple、PFOR、Stream VByte、BP128 的每整数比特数与下界之差,并在共享 2 vCPU 上测解码的相对速度。
时序数据压缩:delta-of-delta、XOR 浮点编码与十进制数据上的失效
拆解 Gorilla 的时间戳 delta-of-delta 与浮点 XOR 编码,对照 Prometheus、InfluxDB、VictoriaMetrics 钉版本源码,用节点采集数据和 ALP 数据集实测每个值花多少比特,并说明 XOR 在十进制数据上失效的原因与 Chimp、Elf、ALP 的改法。