高维向量检索的瓶颈不是“有没有树”,而是一次查询要算多少个距离。HNSW(Hierarchical Navigable Small World)把问题改写成图遍历:先在稀疏高层用贪心搜索接近目标区域,再在包含全部点的第 0 层用候选集扩展换召回率。
本文只讨论内存型 HNSW
的核心算法、参数和源码默认值。实验数字来自同目录
reproduce/run_hnsw.py,指标是 Recall@10
与距离计算次数;DiskANN/Vamana、IVF-PQ
和完整向量引擎只给边界链接,细节留给后续文章。
一、近似近邻的口径
给定向量集 \(X=\{x_1,\ldots,x_N\}\subset\mathbb{R}^d\) 和查询 \(q\),精确 \(k\) 近邻返回距离最小的 \(k\) 个点。本文默认平方欧氏距离;余弦相似度通常先归一化,再转成内积或欧氏距离问题。
近似近邻(Approximate Nearest Neighbor,ANN)常用 Recall@\(k\) 评价:
\[ \mathrm{Recall@}k = \frac{|R_k(q) \cap G_k(q)|}{k}, \]
其中 \(G_k(q)\) 是暴力扫描得到的真实 top-\(k\),\(R_k(q)\) 是索引返回结果。调 HNSW 时至少记录三项:Recall、距离计算次数、内存。本文不用墙钟时间做结论,因为同机并发任务和 CPU 调频会干扰计时;距离计算次数更稳定。暴力扫描每条查询要做 \(N\) 次距离计算,是图搜索曲线的参考线。
二、从 NSW 到 HNSW 的谱系
NSW(Navigable Small World)由 Malkov、Ponomarenko、Logvinov、Krylov 在 2014 年 Information Systems 论文中提出。它按随机顺序插入点:新点在已有图中搜索候选近邻,再连边。早期点在图很小时留下相对长的边;后期点更多连到局部近邻。长边和短边混在同一层,形成可导航小世界。
HNSW(Malkov 与 Yashunin,arXiv 2016;TPAMI 2020)把不同尺度的边拆到多层图里:高层是稀疏子集,用来粗定位;第 0 层包含全部点,用来精细搜索。

这条线和更早的研究相连:Arya 与 Mount 在 SODA 1993
讨论固定维近似最近邻时已经使用近邻图上的贪心搜索直觉;Kleinberg
在 STOC 2000
说明“小世界有短路径”并不等于“本地贪心能找到短路径”,长边分布要适合导航。后来的
NSG(Fu、Xiang、Wang、Cai,PVLDB 2019)用 Monotonic Relative
Neighborhood Graph 的思想构造单层可导航图;DiskANN/Vamana 的
RobustPrune 又用参数 \(\alpha\)
松弛邻居裁剪规则,细节见 ScaNN 与
DiskANN。
三、层数分布与搜索过程
插入点 \(x\) 时,HNSW 先抽它的最高层:
\[ \ell = \left\lfloor -\ln U \cdot m_L \right\rfloor, \qquad U\sim\mathrm{Uniform}(0,1). \]
若取论文和 hnswlib 常用的 \(m_L = 1 / \ln M\),则 \(\Pr[\ell \ge r] = M^{-r}\)。第 0 层有所有节点;第 1 层期望约 \(N/M\) 个;最高层约 \(O(\log_M N)\)。HNSW 论文第 4.1 节解释了这个选择:\(m_L\) 太小会让每层贪心跳数增加,太大又让相邻层邻居重叠过多;\(1/\ln M\) 对应跳表参数 \(p=1/M\),实验图 3 到 5 把它作为自动选择值标出。
一次查询分两段:
- 从入口点和最高层开始,在每个高层调用
SEARCH-LAYER(q, ep, ef=1, layer),只保留最近的一个点作为下一层入口。 - 到第 0 层后调用
SEARCH-LAYER(q, ep, efSearch, 0),返回候选集里最近的 \(k\) 个点。
插入过程多一步:新点最高层以上只做贪心下降;从 \(\min(\ell,L)\) 到第 0
层,每层用 efConstruction
搜索候选,再用邻居选择算法连边。论文把第 0
层邻居上限单独记作 Mmax0,并在图 6
中比较;建议值是 Mmax0 = 2M。论文还写明
M 是留给用户的主要构建参数,合理范围约为 5 到
48;更大的 M
通常提升高召回和高维数据表现,但内存近似按 M
线性增长。
SEARCH-LAYER 的停止条件不是“访问
ef 个点”。它维护候选集 \(C\) 和结果集 \(W\):\(C\) 每次弹出离 \(q\) 最近且尚未扩展的点,\(W\) 保留当前最近的
ef 个点;若 \(C\) 中最近点已经比 \(W\)
中最远点更远,就停止。一个极小例子如下,距离越小越好,ef=2:
| 步骤 | 候选集 \(C\) | 结果集 \(W\) | 动作 |
|---|---|---|---|
| 初始 | a:0.50 |
a:0.50 |
从入口 a 开始 |
扩展 a |
b:0.31, c:0.44 |
b:0.31, c:0.44 |
b、c 都比旧的最远结果
a:0.50 更近,a 被挤出 |
扩展 b |
d:0.18, c:0.44 |
d:0.18, b:0.31 |
d 进入后把 c 挤出 \(W\);e:0.62 比
c:0.44 远,不进 \(C\) |
扩展 d |
c:0.44 |
d:0.18, b:0.31 |
设 d 没有新的未访问邻居 |
检查 c |
最近候选 c:0.44 |
最远结果 b:0.31 |
0.44 > 0.31,停止 |
四、邻居选择与相对邻域图
简单选择只取离新点最近的 \(M\) 个候选。HNSW 论文推荐的启发式按离 \(q\) 的距离从近到远扫描候选 \(e\),只有当它满足
\[ \operatorname{dist}(q,e) < \operatorname{dist}(e,r) \quad\text{for every selected } r \]
时才接受。若 \(e\) 到某个已选邻居 \(r\) 更近,\(e\) 位于以 \(q\) 和 \(r\) 为圆心、半径 \(\operatorname{dist}(q,e)\) 的 lune 中,容易被 \(r\) 覆盖。
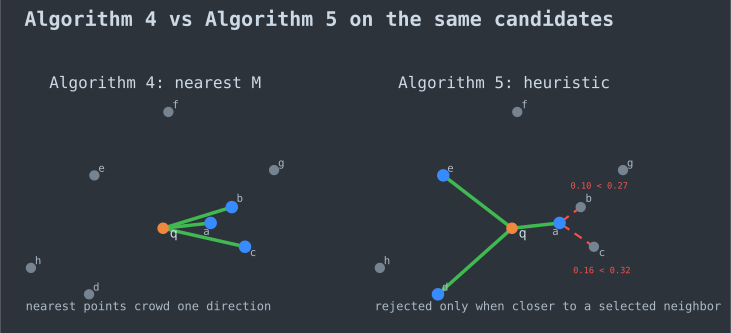
这条规则和相对邻域图(Relative Neighborhood Graph,RNG)直接相关。Toussaint 1980 年在 Pattern Recognition 提出的 RNG 连接点 \(p,q\) 当且仅当不存在第三点 \(r\) 使 \(d(p,r)<d(p,q)\) 且 \(d(q,r)<d(p,q)\)。HNSW 论文第 3 节写明:候选足够多时,该启发式能得到 RNG 作为子图;RNG 有助于在高度聚类数据中保持全局连通。论文图 7 也报告:启发式相对简单近邻选择,在低维、高召回和高度聚类数据上收益最明显;均匀高维数据上差异较小。
论文的启发式还有两个布尔选项:extendCandidates
默认
false,会把候选的邻居也加入工作集,论文说它主要对极端聚类数据有用;keepPrunedConnections
会在启发式选不满 \(M\)
时,把被剪掉的候选按距离补回来,从而得到固定连接数。本文实验中的
heuristic_extend
开启候选扩展,并在选不满时补回被剪候选;simple
则只取最近 \(M\) 个。
五、源码默认值与删除语义
以下只写已经在钉住版本源码中核对过的名字与默认值。
| 项目版本 | 文件 | 源码中看到的默认值与函数名 |
|---|---|---|
| hnswlib v0.8.0 | hnswlib/hnswalg.h |
构造函数默认
M=16、ef_construction=200;maxM_=M_、maxM0_=M_*2、ef_construction_=std::max(ef_construction, M_)、mult_=1/log(M_);函数名包括
getRandomLevel、searchBaseLayer、searchBaseLayerST、getNeighborsByHeuristic2、mutuallyConnectNewElement、addPoint、searchKnn。 |
| Faiss v1.8.0 | faiss/impl/HNSW.h、HNSW.cpp |
HNSW 成员默认
efConstruction=40、efSearch=16;构造时
set_default_probas(M, 1.0 / log(M));函数名包括
random_level、set_default_probas。搜索时多处使用
max(efSearch, k)。 |
| Lucene 9.10.0 | HnswGraphBuilder.java、Lucene99HnswVectorsFormat.java |
DEFAULT_MAX_CONN=16、DEFAULT_BEAM_WIDTH=100。Lucene
的构建宽度叫 beamWidth,不是 hnswlib 的
ef_construction。 |
| pgvector v0.8.0 | src/hnsw.h、src/hnsw.c |
HNSW_DEFAULT_M=16、HNSW_DEFAULT_EF_CONSTRUCTION=64、HNSW_DEFAULT_EF_SEARCH=40;HnswGetMl(m) (1 / log(m));函数名包括
HnswGetM、HnswGetEfConstruction、HnswFindElementNeighbors。 |
几个结论随之而来:M=16 很常见,但
efConstruction
不是统一默认值;efSearch
不改变图,只改变查询候选宽度;Mmax0=2M 是
hnswlib 明确使用的第 0 层上限,内存估算不能只乘一个 \(M\)。
删除也要看版本。hnswlib v0.8.0 的
markDelete(label) 调到
markDeletedInternal(internalId),注释写明“does
NOT really change the current graph”:它只打删除标记、增加
num_deleted_;若构造函数
allow_replace_deleted 为 true,还会把 internal
id 放进
deleted_elements。unmarkDelete(label)
只是去掉标记;源码注释警告,当 replacement
启用时不安全,因为
addPoint(..., replace_deleted=true)
可能复用已删除槽位。搜索路径会跳过被标记删除的结果,但边仍在图里。长期大量删除后的图质量,需要
segment compaction 或重建来处理。
六、可复现实验:simple vs heuristic
reproduce/run_hnsw.py 是一个教学用 numpy
HNSW,实现 simple、只用 Algorithm 5 的 heuristic,以及开启
extendCandidates 的 heuristic。它不是生产库
benchmark,目标是复现论文关于“聚类数据上启发式更稳”的方向性结论,并把候选扩展的贡献分开。
实验口径:
- 数据规模:每组 \(N=20000\)、维度 \(32\)、查询 \(120\) 条、\(k=10\)。
- 数据集:
clustered为 24 个紧簇高斯中心;normal为独立标准正态点,作为不那么聚类的对照。 - 随机种子:
20260924、20260925、20260926三个种子;表中 Recall 是三种子的均值,距离计算次数是三种子的查询中位数再取中位数。 - HNSW
参数:
M=8、Mmax0=16、efConstruction=48、\(m_L=1/\ln M\)。 - ground truth:每条查询用 numpy 暴力扫描全量 \(N\) 个点生成真实 top-10。
- 运行命令:
taskset -c 5 python3 reproduce/run_hnsw.py。
| 数据集 / 选择规则 | ef=10 |
ef=20 |
ef=40 |
ef=80 |
ef=160 |
|---|---|---|---|---|---|
| clustered / simple | 0.397 / 150 | 0.472 / 208 | 0.540 / 306 | 0.574 / 426 | 0.585 / 566 |
| clustered / heuristic | 0.646 / 175 | 0.797 / 250 | 0.894 / 375 | 0.933 / 548 | 0.951 / 728 |
| clustered / heuristic + extend | 0.671 / 181 | 0.838 / 257 | 0.936 / 382 | 0.981 / 558 | 0.993 / 741 |
| normal / heuristic + extend | 0.298 / 227 | 0.453 / 350 | 0.611 / 566 | 0.782 / 974 | 0.907 / 1718 |
表中每格是“平均 Recall@10 / 距离计算次数中位数”。暴力扫描参考线是 \(20000\) 次距离计算。
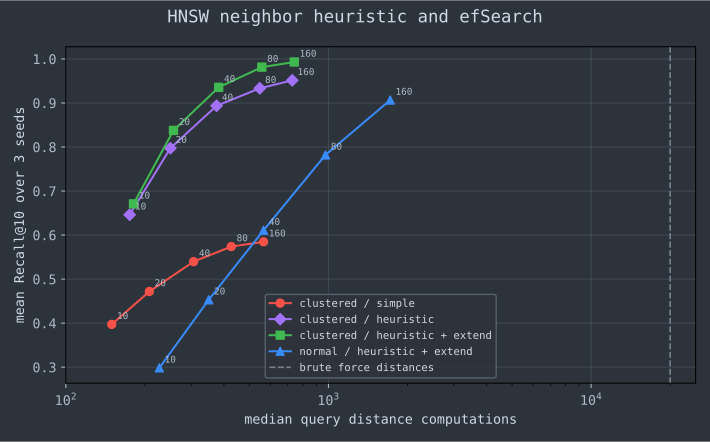
在这组强聚类数据上,只用 Algorithm 5 已明显优于
simple:ef=160 时 Recall@10 为 0.951,而 simple 只有
0.585。打开 extendCandidates 后进一步到
0.993,说明本文这组强聚类数据里“邻居多样化”和“候选扩展”都有贡献;代价是距离计算中位数从
566 增到 728/741。normal 数据没有 simple
对照;它只说明在不那么聚类的数据上,增大
efSearch 仍然是主要召回旋钮。
七、层数分布复查
同一次脚本还记录 clustered / heuristic 三个构建的层数。理论期望为 \(N M^{-r}\),观测值是三种子的均值:
| 层 \(r\) | 观测节点数均值 | \(N M^{-r}\) |
|---|---|---|
| 0 | 20000.0 | 20000.0 |
| 1 | 2466.3 | 2500.0 |
| 2 | 314.0 | 312.5 |
| 3 | 46.0 | 39.1 |
| 4 | 6.7 | 4.9 |
| 5 | 0.7 | 0.6 |
低层与期望很接近,高层样本数少,波动自然更大。这个表只验证随机层数生成式;它不保证高层图本身一定导航良好,边质量仍取决于
efConstruction、邻居选择和数据分布。
八、工程边界与常见误解
Flat 是 ground truth,不是同一条性能曲线上的竞品。 做 Recall@k 时,真实 top-\(k\) 必须来自暴力扫描或可信预计算答案。ANN 索引用召回损失换更少距离计算;Flat 行 Recall 等于 1 是定义。
HNSW 不会替代所有树索引。 kd-tree 在低维、精确查询和范围查询中仍然有清晰边界;HNSW 针对的是高维近似近邻。前一篇 KD-tree 已经讨论低维树索引的有效条件。
过滤搜索会改变图遍历假设。 如果先按标量条件过滤,剩余点可能不再连通;如果先按图搜索再过滤,高选择性条件会浪费大量候选。过滤、事务、WAL、compaction、权限和观测属于向量引擎层,不是 HNSW 论文里的纯算法模型。
内存估算必须把向量、边和元数据分开。
仅邻居 ID 的下界大约是第 0 层 2M 个 ID
加少量上层
ID;实际系统还要存向量、层偏移、删除标记、对齐填充以及可选量化码。十亿级预算应直接测目标实现的索引文件或常驻内存。
九、争论与开放问题
HNSW 论文采用层次结构,hnswlib、Faiss、Lucene、pgvector 也都实现了层或等价的构建宽度控制。但层次是否总是必要,仍有争论。Munyampirwa、Lakshman、Coleman 的预印本 Down with the Hierarchy: The ‘H’ in HNSW Stands for “Hubs”(arXiv:2412.01940,2024/2025)在多组高维数据上报告:平坦 NSW 图可以达到接近 HNSW 的召回与延迟,同时省掉高层内存;他们提出“hub highway”解释,即高维图中自然形成的高频枢纽节点承担了高层高速路的作用。
这篇预印本不能推翻所有 HNSW 工程实践,但它提醒我们:层次结构的收益依赖数据维度、分布、构建算法和实现常数。更稳妥的写法不是“HNSW 证明了对数搜索”,而是“HNSW 通过分层、候选宽度和邻居多样化,在许多向量检索负载上给出很强的经验 Pareto 曲线;但理论保证和层次必要性仍不是闭合问题”。
还需要继续验证的方向包括:动态删除和更新怎样影响长时间运行后的图质量;标量过滤和多向量查询是否能保留纯向量 HNSW 的导航性;高维 embedding 中 hub 节点的形成机制能否转化为更简单、内存更低的构建算法;HNSW 与 PQ、SQ、IVF 组合时,距离近似误差如何影响邻居选择和最终召回。
十、选型边界
| 场景 | 更可能的选择 | 原因 |
|---|---|---|
| 低维空间、精确查询或范围查询 | kd-tree、ball tree、R-tree | 空间剪枝有明确几何含义;HNSW 只给近似近邻。 |
| 内存可容纳向量和图,要求高召回、低毫秒查询 | HNSW 或 HNSW + 标量/乘积量化 | 图遍历访问节点少,调 efSearch
可做召回延迟权衡。 |
| 内存预算紧,允许压缩误差 | IVF-PQ、HNSW+SQ/PQ | 先压缩向量或缩小候选,再精排;详见下一篇 IVF-PQ。 |
| 十亿级、全精度向量无法常驻内存 | DiskANN/Vamana 类磁盘方案 | 设计目标是减少 DRAM,I/O 布局比多层内存图更关键;详见 ScaNN/DiskANN 篇。 |
| 需要事务、删除、过滤、冷热分层和持久化 | 向量数据库或关系型扩展 | 算法只是索引层,生产系统还要处理 WAL、compaction、权限和观测。 |
十一、参考资料
源码
- hnswlib
v0.8.0,
hnswlib/hnswalg.h:HierarchicalNSW构造函数、getRandomLevel、searchBaseLayer、searchBaseLayerST、getNeighborsByHeuristic2、mutuallyConnectNewElement、markDelete、unmarkDelete、addPoint、searchKnn。 - Faiss
v1.8.0,
faiss/impl/HNSW.h、faiss/impl/HNSW.cpp:HNSW默认efConstruction/efSearch、set_default_probas、random_level。 - Apache Lucene
9.10.0,
HnswGraphBuilder.java、Lucene99HnswVectorsFormat.java:DEFAULT_MAX_CONN、DEFAULT_BEAM_WIDTH。 - pgvector
v0.8.0,
src/hnsw.h、src/hnsw.c:HNSW_DEFAULT_M、HNSW_DEFAULT_EF_CONSTRUCTION、HNSW_DEFAULT_EF_SEARCH、HnswGetMl、HnswFindElementNeighbors。
核心论文
- Godfried T. Toussaint, “The relative neighbourhood graph of a finite planar set”, Pattern Recognition 12(4):261–268, 1980。
- Sunil Arya, David M. Mount, “Approximate Nearest Neighbor Queries in Fixed Dimensions”, SODA 1993。
- Jon Kleinberg, “The Small-World Phenomenon: An Algorithmic Perspective”, STOC 2000。
- Yu. A. Malkov, A. Ponomarenko, A. Logvinov, V. Krylov, “Approximate nearest neighbor algorithm based on navigable small world graphs”, Information Systems 45, 2014, DOI 10.1016/j.is.2013.10.006。
- Yu. A. Malkov, D. A. Yashunin, “Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs”, arXiv:1603.09320, 2016;IEEE TPAMI 42(4), 2020, DOI 10.1109/TPAMI.2018.2889473。
其他论文与评测
- William Pugh, “Skip lists: a probabilistic alternative to balanced trees”, Communications of the ACM 33(6), 1990。
- Cong Fu, Chao Xiang, Changxu Wang, Deng Cai, “Fast Approximate Nearest Neighbor Search With The Navigating Spreading-out Graph”, PVLDB 12(5):461–474, 2019。
- Suhas Jayaram Subramanya, Devvrit, Rohan Kadekodi, Ravishankar Krishnaswamy, Harsha Vardhan Simhadri, “DiskANN: Fast Accurate Billion-point Nearest Neighbor Search on a Single Node”, NeurIPS 2019。
- Martin Aumüller, Erik Bernhardsson, Alexander Faithfull, “ANN-Benchmarks: A benchmarking tool for approximate nearest neighbor algorithms”, Information Systems 87, 2020, DOI 10.1016/j.is.2019.02.006;会议版发表于 SISAP 2017。
- Harsha Vardhan Simhadri, George Williams, Martin Aumüller, Matthijs Douze, Artem Babenko, Dmitry Baranchuk, Qi Chen, Lucas Hosseini, Ravishankar Krishnaswamy, Gopal Srinivasa, Suhas Jayaram Subramanya, Jingdong Wang, “Results of the NeurIPS’21 Challenge on Billion-Scale Approximate Nearest Neighbor Search”, PMLR 176, 2022, arXiv:2205.03763。
- Blaise Munyampirwa, Vihan Lakshman, Benjamin Coleman, “Down with the Hierarchy: The ‘H’ in HNSW Stands for ‘Hubs’”, arXiv:2412.01940, 2024/2025(预印本)。
实验
reproduce/run_hnsw.py:本文 HNSW 复现实验、hnsw-recall.svg、reproduce/results.csv和reproduce/layer_counts.csv的来源。reproduce/draw_figures.py:hnsw-layers.svg与hnsw-neighbor-heuristic.svg的生成脚本。reproduce/environment.txt:本次复现环境与参数记录。
系列导航: - 上一篇:局部敏感哈希:从概率保证到多探针近邻检索 - 下一篇:乘积量化与 IVF-PQ:压缩域里的近似最近邻
相关阅读: - KD-tree:切分规则、回溯剪枝与维度增长下的失效边界 - ScaNN 与 DiskANN:量化损失、Vamana 与 SSD 图检索 - 从零实现一个向量搜索引擎
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
乘积量化与 IVF-PQ:压缩域里的近似最近邻
从 Jégou 等人的 PQ/ADC 到 Faiss v1.8.0 的 IVF-PQ 源码,用可复现实验解释码长、量化误差、nprobe 与候选数如何共同决定召回。
从零实现一个向量搜索引擎
不重复 HNSW、PQ 和 DiskANN 细节,而是把向量检索放回引擎层:段式存储、墓碑删除、过滤搜索、mmap、并发快照与可复现召回评测。
局部敏感哈希:从概率保证到多探针近邻检索
从 (c,r)-ANN 与 LSH 的 rho 参数出发,推导 AND-OR 放大、随机超平面、p-stable 与 multi-probe,复现实测 SIFT1M 上召回率和候选数,并说明为什么理论保证不等于工程排名。
编辑距离与模糊匹配:Wagner-Fischer、位并行与 Levenshtein 自动机
从 Wagner-Fischer 填表出发,讲清带状 DP、Myers 位并行、OSA 与真 Damerau 的区别,用可复现程序在 8 万词词典上对比 BK-tree、Trie 自动机与对称删除,并核对 Lucene、git 的实际实现与 SETH 下界。