把 HNSW、IVF-PQ、ScaNN 或 DiskANN
单独讲清楚,只解决了向量检索系统的一半。真正上线后,更常见的问题是:向量和外部
ID 怎样放到磁盘上;删除后图索引会不会把候选浪费在墓碑上;带
tenant_id、category、price
的过滤会不会让召回突然掉下去;新写入怎样不阻塞正在跑的查询。
本文是向量检索子系列的收束篇。算法细节不再重复:低维树索引见
KD-tree:切分规则、回溯剪枝与维度增长下的失效边界,概率分桶见
局部敏感哈希:从概率保证到多探针近邻检索,图搜索见
HNSW:分层小世界图的近似近邻搜索,压缩域候选生成见
乘积量化与
IVF-PQ:压缩域里的近似最近邻,磁盘图与 ScaNN 见 ScaNN 与
DiskANN:量化损失、Vamana 与 SSD
图检索。本文只回答引擎层问题,并用同目录
reproduce/engine.c
给出一个可编译的小引擎,测量召回率、距离计算次数、扫描字节数和候选数。
一、本篇只关心四个不变量
一个最小可用的向量搜索引擎至少要维护四个不变量。
- 逻辑 ID 稳定:外部看到的是用户 ID 或内部递增 ID;compaction 可以移动物理位置,但不能改变 ID。
- 读快照稳定:一次查询读到的段列表、删除位图和索引版本必须自洽,不能一半来自旧段、一半来自新段。
- 删除只改变可见性:先用墓碑或位图隐藏记录,再由 compaction 物理回收;否则在线删除会牵动图边、倒排表和 mmap 布局。
- 召回评测带过滤口径:没有过滤的 Recall@\(k\) 不能代表生产查询;过滤选择性、删除比例和候选预算要一起报告。
给数据库 \(X\)、查询 \(q\)、过滤谓词 \(P\) 和精确答案 \(G_k(q,P)\),本文实验中的召回率定义为
\[ \mathrm{Recall@}k = \frac{|R_k(q,P) \cap G_k(q,P)|}{|G_k(q,P)|}。 \]
若满足谓词的记录不足 \(k\)
条,分母使用实际可返回条数。距离计算次数只统计完整向量 L2
距离;扫描字节数按
distance_calcs * dim * sizeof(float)
计算;候选数表示进入最终候选队列或过滤窗口的 ID 数量。
二、段式布局:把可变性关进小盒子
向量引擎通常不直接维护一个会原地变大的巨型数组。更稳妥的做法是把数据切成段(segment):新写入进入一个 appendable 段;段达到大小阈值或被 flush 后变成 sealed 段;sealed 段只读,适合构建 ANN 索引、payload 索引和 mmap 映射。
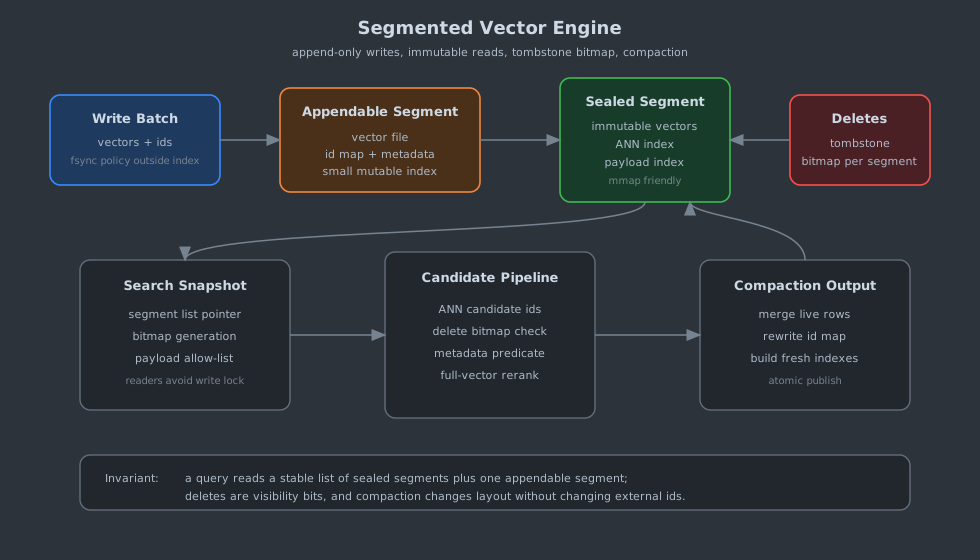
这张图的关键不是“有多少组件”,而是可变性边界:
vectors.bin:定长向量区,最简单布局是 row-major 的float32[N][dim]。PQ、半精度和磁盘图可以换掉这个文件,但 ID 层不应感知编码细节。ids.bin:物理行号到外部 ID 的映射。ANN 索引返回内部 ordinal 后,通过它找到外部 ID。meta.*:payload 或倒排索引,用来生成过滤 allow-list。本文实验只用一个tenant字段。deleted.bitmap:每个物理行一位。删除先设置位图;旧向量和旧图边暂时保留。manifest:当前可见的段列表、每段文件名、行数、维度、校验和和版本号。查询先读 manifest 快照,再访问各段。
Qdrant 当前公开文档把 collection 数据拆成 segment,每个
segment 有独立的 vector storage、payload storage、索引和 ID
mapper,并区分 appendable 与 non-appendable
segment;它还说明向量存储总是在磁盘上的 memory-mapped file
中,并提供 cached / cold
内存层级。本文的小引擎采用同一类段式不变量,但不复刻 Qdrant
的 Rust 实现。
三、写入、WAL、mmap 与 compaction
写入路径可以从最保守的顺序开始:
- 给批次分配内部 ID 和外部 ID;
- 把插入记录追加到预写日志(Write-Ahead Log,WAL),按策略
fsync; - 把向量、ID 和 metadata 追加到当前 appendable 段;
- 更新小型内存索引,或等段 sealed 后离线建索引;
- 写新 manifest,原子替换当前 manifest 指针。
WAL 只保证“已经确认的写入可重放”。它不替代段文件校验,也不替代 manifest 的原子发布。最小记录可以写成只表达布局的 C-like 结构:
typedef struct {
    uint32_t crc32;
    uint8_t type;
    uint64_t logical_id;
    uint32_t dim;
    uint32_t payload_len;
    unsigned char payload[];
} WalRecord;
insert 的 payload 放向量字节和 metadata
字节;delete 的 payload 只需要逻辑 ID。
生产系统还要处理日志轮转、部分写、校验失败和快照之后的截断。本文不把
WAL 代码写进正文,是因为没有崩溃注入测试的 WAL
片段很容易给读者错误安全感;reproduce/engine.c
聚焦段、过滤和删除对召回指标的影响。
mmap 的边界也要说清楚。mmap 让查询线程像读内存一样访问文件页,减少手写缓存池代码;代价是 page fault、预读和脏页回写由内核调度。对 sealed 段,mmap 很合适:文件不再追加,索引 ordinal 到偏移的映射稳定。对 appendable 段,简单做法是先用普通内存或单独小文件承接写入,sealed 时再生成 mmap 友好的定长文件。
compaction 的输入是一组 sealed 段和它们的删除位图,输出是一组只包含 live row 的新段。它必须满足三条规则:
- 只改变物理位置,不改变外部 ID;
- 新段索引构建完成、校验通过后,再通过 manifest 原子发布;
- 老段在没有查询快照引用后再删除。
Milvus v2.6 文档把 growing segment 和 sealed segment 分开:growing segment 接收新写入,flush 后成为 sealed segment;compaction 合并 sealed segment 并处理删除。这个设计与上面的不变量一致,但 Milvus 的分布式 DataNode、QueryNode 和对象存储路径不是本文的小引擎目标。
四、过滤搜索:真正难的是候选前沿
业务查询很少是“全库 top-\(k\)”。更常见的是:
WHERE tenant_id = 42 AND category = 'shoe'
ORDER BY distance(query, embedding)
LIMIT 10
过滤与 ANN 结合有三种基本位置。
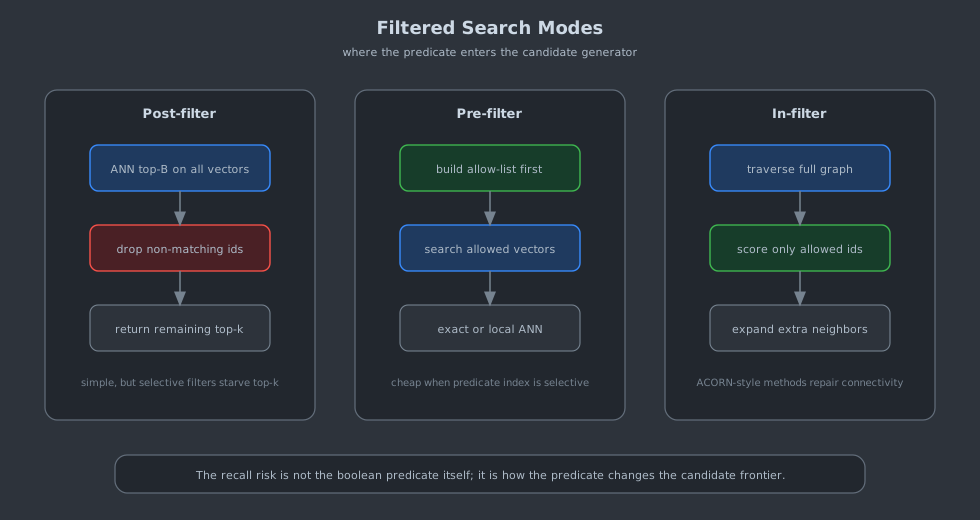
Post-filter 先在全库跑 ANN,拿到 \(B\) 个候选后再丢掉不满足谓词的
ID。它实现最简单,却有明显风险:如果谓词只匹配 \(s\)
比例的数据,候选窗口里期望只有 \(B\cdot s\) 个有效 ID。pgvector
v0.8.0 README 明确写到,近似索引的过滤在 index scan
之后应用;如果条件匹配 10% 行、HNSW 默认
hnsw.ef_search = 40,平均只有约 4
行通过过滤,因此需要调大 hnsw.ef_search,或启用
0.8.0 新增的 iterative scan。
Pre-filter 先用 payload 索引生成 allow-list,再只在 allow-list 内做精确搜索或局部 ANN。它适合高选择性谓词:例如只查某个租户、某个分区、某个时间桶。缺点是当 allow-list 很大时,构造和传递位图也会成为成本;当 allow-list 在图上高度分散时,简单地剪掉非匹配节点会破坏图连通性。
In-filter
不把非匹配节点直接从图里删掉,而是在遍历时允许“路过”它们,只是不把它们加入结果集。Weaviate
的过滤文档把这种做法描述为:用倒排索引生成 allow-list,HNSW
仍沿边正常移动,只在结果集中考虑 allow-list 内 ID。Weaviate
v1.34 起默认使用 ACORN filter
strategy;文档说明它受 Patel、Kraft、Guestrin、Zaharia 的
SIGMOD 2024 ACORN
论文启发,通过多跳邻域和额外入口点改善低相关、强过滤场景。这里的要点不是“ACORN
一定最好”,而是过滤策略必须修复候选前沿,而不是只在末尾做布尔判断。
五、删除:墓碑会消耗候选预算
删除在向量图索引里比在 B-tree 里麻烦。B-tree 可以局部合并或留下空洞;HNSW / Vamana 这类图索引的边表达导航路径,直接删点可能破坏可达性,在线补边又很难保证质量。因此工程上常见两阶段:
- 查询可见性层立刻设置 tombstone,保证被删 ID 不再返回;
- 背景 compaction 把 live row 复制到新段,并为新段重建 ANN / payload 索引。
墓碑的副作用是候选预算被浪费。若 ANN 返回的 top-\(B\) 里有大量已删除点,过滤后剩下的 live 候选可能不足 \(k\)。解决方式有三类:增大搜索宽度;在遍历时跳过墓碑但继续扩展邻居;当删除比例超过阈值时触发 compaction。三者分别消耗 CPU、实现复杂度和后台 IO。
reproduce/engine.c 的 stale-top
模式故意模拟这个问题:候选窗口先从包含 tombstone
的全量索引中取出,再丢弃删除项。它不是高性能
ANN,而是把“墓碑挤占候选窗口”这个失效模式单独隔离出来。
六、并发读写:用发布而不是原地修改
最小并发模型可以很朴素:写入串行,查询并发。关键是查询不要拿着全局写锁跑完整个 ANN 搜索。一个可实现的方案是:
Engine持有一个原子发布的Snapshot指针;Snapshot包含段数组、每段删除位图版本、payload 索引指针和 ANN 索引指针;- 写线程追加当前 appendable 段,必要时生成新 sealed 段;
- compaction 构建新段和新索引后,发布一个新
Snapshot; - 旧快照通过引用计数、epoch 或语言运行时 GC 延迟回收。
这个模型牺牲了写入并行度,换来读路径简单。多写线程版本也不应该让每个查询看到半成品索引:可以按段分锁写入,但发布给查询的仍应是完整快照。真正困难的不是
mutex 怎么写,而是 manifest、位图、mmap
文件和索引文件的生命周期必须一致。
核心数据结构可以小到这样:
typedef struct {
    uint64_t id;
    uint32_t tenant;
    uint8_t deleted;
    float v[DIM];
} Item;

typedef struct {
    int sealed;
    int count;
    Item items[SEG_CAP];
} Segment;
正文不贴几百行“完整实现”。完整程序在
reproduce/engine.c,包含 appendable
segment、sealed
segment、tombstone、compaction、精确过滤基线、post-filter 和
stale tombstone 候选窗口。
七、可复现实验:过滤选择性与删除比例
实验环境来自本机实际查询:Linux
6.6.87.2-microsoft-standard-WSL2,CPU
12th Gen Intel(R) Core(TM) i9-12900K,GCC
16.1.1 20260430。当前机器可能同时运行其他代理,因此正文不报告墙钟时间,只报告与时钟无关的指标。
复现命令:
cd post/algorithms/42-build-vector-engine/reproduce
cc -O2 -Wall -Wextra -std=c11 engine.c -lm -o engine
./engine
cc -O1 -g -fsanitize=address,undefined -Wall -Wextra -std=c11 engine.c -lm -o engine_asan
./engine_asan >/dev/null
数据集固定为 4096 条、维度 16、32 个 sealed
segment、TopK=10、候选窗口 \(B=20\)、128
个查询。随机数使用固定 xorshift32
种子。pre-filter
是精确过滤基线,只扫描匹配租户;post-filter
先全库取 \(B\)
个候选再过滤。
| 模式 | tenant | 近似选择性 | Recall@10 | 距离计算/查询 | 字节/查询 | 候选数/查询 |
|---|---|---|---|---|---|---|
| pre-filter | 0 | 50.6% | 1.000 | 2073 | 132672 | 2073 |
| post-filter | 0 | 50.6% | 0.900 | 4096 | 262144 | 20 |
| pre-filter | 1 | 25.3% | 1.000 | 1035 | 66240 | 1035 |
| post-filter | 1 | 25.3% | 0.520 | 4096 | 262144 | 20 |
| pre-filter | 2 | 14.4% | 1.000 | 590 | 37760 | 590 |
| post-filter | 2 | 14.4% | 0.301 | 4096 | 262144 | 20 |
| pre-filter | 3 | 7.0% | 1.000 | 285 | 18240 | 285 |
| post-filter | 3 | 7.0% | 0.153 | 4096 | 262144 | 20 |
| pre-filter | 4 | 2.8% | 1.000 | 113 | 7232 | 113 |
| post-filter | 4 | 2.8% | 0.055 | 4096 | 262144 | 20 |
这个结果不是在给 pre-filter 做“性能排名”。程序里的 pre-filter 是暴力精确扫描匹配集合;真实 HNSW pre-filter 还要解决图连通性问题。它说明的是一个更基础的事实:固定候选窗口下,post-filter 的召回会随过滤选择性近似线性恶化,尤其当谓词与向量空间低相关时。
删除实验中,live-scan 是只扫描 live row
的精确基线;stale-top 先从包含 tombstone
的全量候选窗口中取 \(B=20\),再丢弃已删除项。
| 模式 | 删除比例 | Recall@10 | 距离计算/查询 | 字节/查询 | 候选数/查询 |
|---|---|---|---|---|---|
| live-scan | 0% | 1.000 | 4096 | 262144 | 4096 |
| stale-top | 0% | 1.000 | 4096 | 262144 | 20 |
| live-scan | 10% | 1.000 | 3687 | 235968 | 3687 |
| stale-top | 10% | 1.000 | 4096 | 262144 | 20 |
| live-scan | 30% | 1.000 | 2867 | 183488 | 2867 |
| stale-top | 30% | 1.000 | 4096 | 262144 | 20 |
| live-scan | 50% | 1.000 | 2047 | 131008 | 2047 |
| stale-top | 50% | 0.922 | 4096 | 262144 | 20 |
| live-scan | 70% | 1.000 | 1229 | 78656 | 1229 |
| stale-top | 70% | 0.613 | 4096 | 262144 | 20 |
删除比例低时,候选窗口还能容纳足够 live 近邻;删除到 50% 以后,固定 \(B=20\) 开始不够用。生产系统不一定用这个简单窗口,但失效模式相同:如果索引或遍历层不知道 tombstone,候选预算会被不可返回的点消耗。
八、生产系统对照:只取已核实边界
下面只列本文用到的公开行为,不推断源码里没有核实的细节。
| 系统 | 版本边界 | 与本文相关的行为 |
|---|---|---|
| Qdrant | 官方文档按 v1.19.1 最新发布核对 | collection 拆成 segment;segment 有 vector/payload
storage、索引和 ID mapper;segment 可 appendable 或
non-appendable;向量文件使用 mmap,并可配置
cached / cold 内存层级。 |
| Milvus | v2.6 文档 | growing segment 接收写入;flush 后成为 sealed segment;compaction 合并 sealed segment 并处理删除。 |
| Weaviate | v1.34 起的过滤文档 | 过滤先由倒排索引生成 allow-list;HNSW
遍历仍沿边移动,只把 allow-list 内 ID
加入结果;ACORN 从 v1.34 起是默认 filter
strategy。 |
| pgvector | v0.8.0 README | HNSW 默认
m=16、ef_construction=64、hnsw.ef_search=40;近似索引过滤在
scan 后应用;0.8.0 新增 iterative index
scan,可继续扫描直到足够结果或达到限制。 |
这些系统的共同点是:检索算法之外都有一层“数据管理”。段、位图、payload 索引、manifest、后台合并和查询快照,决定了算法能否在删除、过滤和持久化条件下稳定工作。
九、谱系、争论与开放问题
向量检索的算法谱系可以压缩成三条线:
- 图索引:Malkov 与 Yashunin 的 HNSW 论文把可导航小世界图做成主流内存 ANN 基线;DiskANN 的 NeurIPS 2019 论文把 Vamana 图、压缩内存表示和 SSD beam search 结合起来,解决十亿级数据的内存边界。
- 量化与倒排:Jégou、Douze、Schmid 的 TPAMI 2011 PQ 论文给出 product quantization 和 ADC;IVF-PQ、ScaNN 与后续工程实现都在候选生成和压缩误差之间做取舍。
- 过滤
ANN:Patel、Kraft、Guestrin、Zaharia 的 SIGMOD 2024
ACORN 论文把结构化谓词放进图遍历问题,指出过滤不是末尾
WHERE子句这么简单。
仍然有三个工程问题没有统一答案。
第一,过滤应当多早进入 ANN。Post-filter 简单但召回不可控;pre-filter 对强选择性很有效,但 allow-list 很大时会退化;ACORN 这类 in-filter 方法改善图遍历,却增加实现复杂度和参数面。
第二,删除比例多高才值得重建段。阈值太低会放大后台 IO,阈值太高会让候选窗口被 tombstone 挤占。这个阈值依赖查询选择性、索引类型、SSD 带宽和尾延迟目标,不能从单篇论文直接搬。
第三,mmap 与自管缓存池的边界。mmap 对 sealed 段非常简洁,但 page fault 尾延迟和 NUMA 放置较难控制;自管缓存池能做更明确的预取和隔离,却要自己处理淘汰、校验与并发生命周期。DiskANN 的论文结果也建立在具体 SSD 与 beam search 假设上,不能直接推出所有 mmap 型系统都会快。
十、参考资料
规范与文档
- Qdrant Documentation, Storage 与 Filtering,按 v1.19.1 最新发布核对,说明 segment、ID mapper、mmap vector storage、payload filtering。
- Milvus Documentation v2.6, Data Processing,说明 growing / sealed segment、flush 与 compaction 的角色。
- Weaviate Documentation, Filtering 与 Vector
indexes,v1.34 起默认
ACORNfilter strategy;HNSW 配置页列出ef、efConstruction、maxConnections等参数。 - pgvector v0.8.0
README.md, HNSW、Filtering、Iterative Index Scans,说明 HNSW 默认参数、post-filter 行为和 iterative scan。
核心论文
- Yu A. Malkov, D. A. Yashunin, “Efficient and Robust
Approximate Nearest Neighbor Search Using Hierarchical
Navigable Small World Graphs,” IEEE Transactions on
Pattern Analysis and Machine Intelligence, 2020. DOI:
10.1109/TPAMI.2018.2889473。 - Hervé Jégou, Matthijs Douze, Cordelia Schmid, “Product
Quantization for Nearest Neighbor Search,” IEEE
Transactions on Pattern Analysis and Machine
Intelligence, 2011. DOI:
10.1109/TPAMI.2010.57。 - Suhas Jayaram Subramanya, Fnu Devvrit, Harsha Vardhan Simhadri, Ravishankar Krishnaswamy, Rohan Kadekodi, “DiskANN: Fast Accurate Billion-point Nearest Neighbor Search on a Single Node,” NeurIPS, 2019。
- Liana Patel, Peter Kraft, Carlos Guestrin, Matei
Zaharia, “ACORN: Performant and Predicate-Agnostic Search
Over Vector Embeddings and Structured Data,” Proceedings
of the ACM on Management of Data / SIGMOD, 2024. DOI:
10.1145/3654923。
实验
- 本文同目录
reproduce/engine.c:段式小引擎、过滤选择性实验、删除比例实验;使用 GCC 16.1.1 编译,并通过 AddressSanitizer / UndefinedBehaviorSanitizer。
上一篇:ScaNN 与 DiskANN:量化损失、Vamana 与 SSD 图检索
下一篇:Dijkstra 与 A*:非负权、启发式与工程优先队列
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【向量检索引擎】Milvus · Segcore · Knowhere · Qdrant · Lance · pgvector
补齐 ANN 算法与 RAG 应用之间的生产级向量引擎层:以 Milvus 2.6.x 为主线拆解 Segment、WAL、Segcore、Knowhere、混合过滤与一致性,并用 Qdrant、LanceDB、pgvector 对照选型。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
B-tree 深度解剖:从磁盘 I/O 模型到 boltdb 源码
从 Bayer-McCreight 1972 推导树高与分裂摊还代价,用计数模拟器和 bbolt v1.5.0 实测:随机插入页填充约 69%,按键序插入由分裂点决定是 50% 还是近 100%;再对照 bbolt、PostgreSQL、SQLite 源码看删除、写时复制与 B-link 并发。
B+tree 与 LSM-tree:原地更新与异地更新的读、写、空间代价
从 O'Neil 1996 与 Dostoevsky 的代价模型推导两类结构的读写空间放大,用计数模拟器在同一负载上实测:B+tree 写放大随缓冲池从 126 降到 8.6,leveled LSM 为 14.4,并对照 RUM 猜想原文与生产数据。