最短路实现里常见三种误解:把 Dijkstra 当成”只要没有负环就能用”,把 Fibonacci 堆当成工程默认优先队列,把 A* 的启发式写成”越大越快”。三句话都危险。Dijkstra 是 label-setting 算法:顶点一旦出堆就被永久确定,因此它需要非负权或等价的非负 reduced cost;A* 只有在启发式满足可采纳性时才保最短,在一致性下才像 Dijkstra 一样不必反复打开节点;工程实现则经常在 lazy deletion、decrease-key、整数桶和道路图预处理之间权衡。
本文按”正确性边界 → 优先队列 → A* 启发式 → 可复现实验 →
道路图工程”展开。所有自测数字来自同目录的
reproduce/shortest_path_bench.c,只统计松弛次数、出堆次数、decrease-key
次数和扩展节点数,不使用容易受并行任务干扰的 wall-clock
时间。DIMACS 第 9
届挑战路网没有放入仓库;本文不伪造道路网耗时,只给出可复现的合成图结果。
一、问题模型:什么时候可以永久确定一个点
设有向图 \(G=(V,E)\),边权函数 \(w:E\to\mathbb{R}\),源点为 \(s\)。单源最短路(single-source shortest paths,SSSP)要求对每个顶点 \(v\) 求
\[ \delta(s,v)=\min_{p:s\leadsto v}\sum_{e\in p} w(e)。 \]
Dijkstra 处理的是从源点可达且没有负权边的情形;更准确地说,它要求每次把当前最小临时距离的顶点 \(u\) 弹出后,后续任何路径都不可能再把 \(d[u]\) 降低。非负边权正好保证这一点:若路径先到某个未确定顶点 \(x\),再绕到 \(u\),路径长度至少不小于到 \(x\) 的前缀,而 \(u\) 已经是队列中最小。
核心操作是松弛(relaxation):若 \(d[u]+w(u,v)<d[v]\),就把
\(d[v]\) 改成 \(d[u]+w(u,v)\),并记录
parent[v]=u。
若所有边权非负,算法如下:
DIJKSTRA(G, s):
    d[s] = 0, other d[v] = infinity
    push s into a min-priority queue keyed by d
    while queue is not empty:
        u = extract-min()
        if u has already been settled: continue
        settle u
        for each outgoing edge (u, v):
            relax (u, v)
这里的 already been settled
不是装饰。它表达了 Dijkstra 与 Bellman-Ford
的本质差别:Dijkstra
一旦给顶点贴上最终标签,就不会再改;Bellman-Ford
允许一轮又一轮地修正标签,因此能处理负权并检测负环。下一篇
Bellman-Ford
与路由协议:负环、SPFA 与距离向量收敛
会专门展开这个边界。
二、Dijkstra 的证明与最小负权反例
Dijkstra 的不变式是:每次出堆并首次被确定的顶点 \(u\),都有 \(d[u]=\delta(s,u)\)。证明只需要一个割点式的前缀论证。
假设 \(u\) 是第一个出堆时仍不正确的顶点。取一条真实最短路径 \(s\leadsto u\),在这条路径上找到最后一个已经确定的顶点 \(x\),以及它后面的第一个未确定顶点 \(y\)。由于 \(x\) 比 \(u\) 早确定,边 \((x,y)\) 已经被松弛,所以
\[ d[y]\le d[x]+w(x,y)=\delta(s,x)+w(x,y)=\delta(s,y)。 \]
另一方面,临时距离永远是某条已知路径长度,因此 \(d[y]\ge\delta(s,y)\),故 \(d[y]=\delta(s,y)\)。若边权非负,\(\delta(s,y)\le\delta(s,u)<d[u]\),这说明队列里存在键更小的 \(y\),不可能先弹出 \(u\),矛盾。
负权边恰好破坏了 \(\delta(s,y)\le\delta(s,u)\)。最小反例如下:
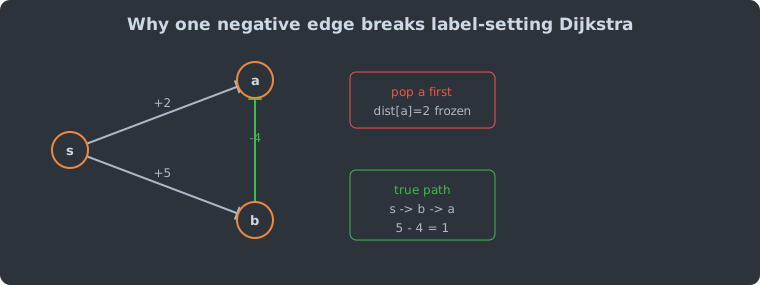
边为 \(s\to a=2\)、\(s\to b=5\)、\(b\to a=-4\)。朴素 label-setting Dijkstra 会先弹出 \(a\) 并冻结 \(d[a]=2\);随后从 \(b\) 松弛到 \(a\) 得到 \(1\),但 \(a\) 已经关闭。Bellman-Ford 会得到正确答案 \(1\)。这个反例没有负环,说明”没有负环”不是 Dijkstra 的充分条件。
三、优先队列:理论界、整数权与工程现实
用不同优先队列实现 Dijkstra,复杂度口径如下,\(n=|V|\)、\(m=|E|\):
| 队列 | extract-min |
decrease-key |
常见总界 | 适用边界 |
|---|---|---|---|---|
| 未排序数组 | \(O(n)\) | \(O(1)\) | \(O(n^2+m)\) | 稠密图或实现极简 |
| 二叉堆 | \(O(\log n)\) | \(O(\log n)\) | \(O((m+n)\log n)\) | 通用 baseline |
| Fibonacci 堆 | \(O(\log n)\) 均摊 | \(O(1)\) 均摊 | \(O(m+n\log n)\) | Fredman-Tarjan 的理论界 |
| Dial 桶 | 与最大整数距离窗口有关 | \(O(1)\) | \(O(m+nC)\) | 小非负整数权,\(C\) 为最大边权 |
| radix heap / 多级桶 | 摊还随字长或键范围变化 | 摊还低 | 依实现与权重模型而定 | 单调非负整数键 |
Fredman 与 Tarjan 在 1987 年 JACM 论文中用 Fibonacci heap 给出 \(O(m+n\log n)\) 的 Dijkstra 界;这在理论上很重要,但不等于生产系统应默认使用 Fibonacci heap。它需要多指针节点、级联切割和复杂合并,缓存局部性差。Chen、Chowdhury、Ramachandran、Lan Roche 与 Tong 的 UTCS TR-07-54 专门比较了 Dijkstra 的优先队列实现,结论也是:实际机器上,简洁堆和缓存行为经常压过渐近优势。
对于非负整数权,桶族结构打开了另一条路线。Dial 的桶队列适合最大边权很小的场景;radix heap 与 Ahuja、Mehlhorn、Orlin、Tarjan 的多级桶把”键单调不降”这一 Dijkstra 特性用得更彻底。Thorup 1999 年在 word RAM 模型下给出无向正整数权 SSSP 的线性时间算法,但模型假设和实现复杂度都与普通道路服务不同,不能直接翻译成”所有整数权图都该线性”。
近年的理论前沿说明 SSSP 仍未结束。Haeupler、Hladík、Rozhoň、Tarjan 与 Tětek 在 FOCS 2024 的 “Universal Optimality of Dijkstra via Beyond-Worst-Case Heaps” 讨论了固定图拓扑上的普适最优性;Duan、Jiayi Mao、Xiao Mao、Shu 与 Yin 的 STOC 2025 “Breaking the Sorting Barrier for Directed Single-Source Shortest Paths” 在比较-加法模型中突破了稀疏有向非负实权图的经典排序屏障。这些结果强调的是模型与最优性问题,不是替代下面这段工程 baseline。
Lazy deletion 与 decrease-key
C/C++ 工程里常见两种二叉堆写法:
- indexed heap:堆外维护
pos[v],距离变小时执行真正的 decrease-key;每个顶点最多在堆中出现一次。 - lazy deletion:距离变小时直接再
push一份新键;出堆时若键已经不是当前d[v],就把它当作 stale entry 丢掉。
两者计算的距离相同,指标不同。本文第六节的随机图实验中,lazy 写法没有 decrease-key,但会多出约四千次 stale 出堆;indexed heap 出堆次数等于顶点数,但执行了同等数量的 decrease-key。选择哪一个,取决于语言库、内存上限、查询批量和缓存局部性,而不是单看大 \(O\)。
四、A*:可采纳、一致与 reduced cost
A* 只求 \(s\) 到目标 \(t\) 的一条最短路。它把队列键从 \(g(v)\) 改成
\[ f(v)=g(v)+h(v), \]
其中 \(g(v)\) 是源点到 \(v\) 的当前已知距离,\(h(v)\) 是从 \(v\) 到目标的估计距离。
可采纳启发式(admissible heuristic)要求对所有顶点 \(v\),\(h(v)\le\delta(v,t)\)。它不高估真实剩余距离,因此目标第一次以最小 \(f\) 出堆时,\(g(t)\) 是最短距离。常见例子包括四邻接栅格上的曼哈顿距离、八邻接且对角代价为 \(\sqrt{2}\) 时的 octile distance、平面道路图上按最大可能车速换算后的欧氏距离下界。
一致启发式(consistent heuristic,也叫 monotone heuristic)更强:对每条边 \((u,v)\),
\[ h(u)\le w(u,v)+h(v), \]
并且 \(h(t)=0\)。前者是三角不等式;没有目标条件时,把所有 \(h\) 同时加上常数仍满足不等式,却会高估剩余距离。一致性推出可采纳性,并保证沿路径的 \(f\) 值不下降:
\[ g(v)+h(v)\ge g(u)+w(u,v)+h(v)\ge g(u)+h(u)。 \]
因此在一致启发式下,A* 仍是 label-setting:顶点第一次出堆即可关闭。
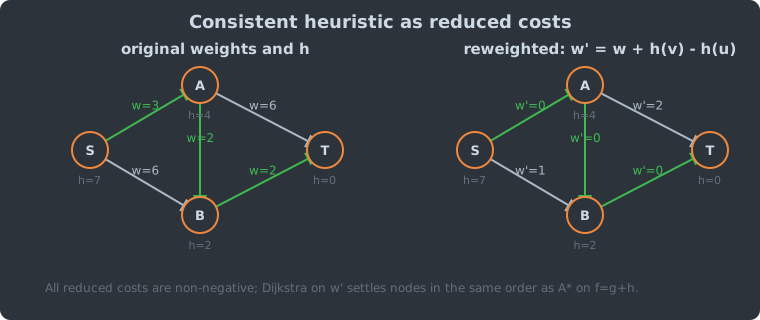
更有用的看法是 reduced cost。令
\[ w'(u,v)=w(u,v)+h(v)-h(u)。 \]
若 \(h\) 一致,则 \(w'(u,v)\ge 0\)。从 \(s\) 到任意 \(v\) 的重加权路径长度满足
\[ \sum w' = \sum w + h(v)-h(s)。 \]
对固定目标和源点,这不会改变路径优劣;Dijkstra 在 \(w'\) 上按 \(g'(v)\) 出堆,等价于 A* 在原图上按 \(g(v)+h(v)\) 出堆。
Hart、Nilsson 与 Raphael 1968 年给出了 A* 的形式化基础。Dechter 与 Pearl 1985 年进一步澄清了”最优效率”问题:只说可采纳不够,一致性与 tie-breaking 条件会影响 A* 是否避免不必要的重复展开。工程实现中,如果启发式只可采纳但不一致,要么允许 reopen closed node,要么接受可能的次优或错误结果;不要把 closed set 写死后再随意换启发式。
五、网格寻路:A* 快在哪里
下面的 SVG 由 reproduce/make_figures.py
运行真实 Dijkstra/A*
得到。两边使用同一张障碍网格、同一条最短路径;颜色表示目标被确定前已经出堆扩展的节点。
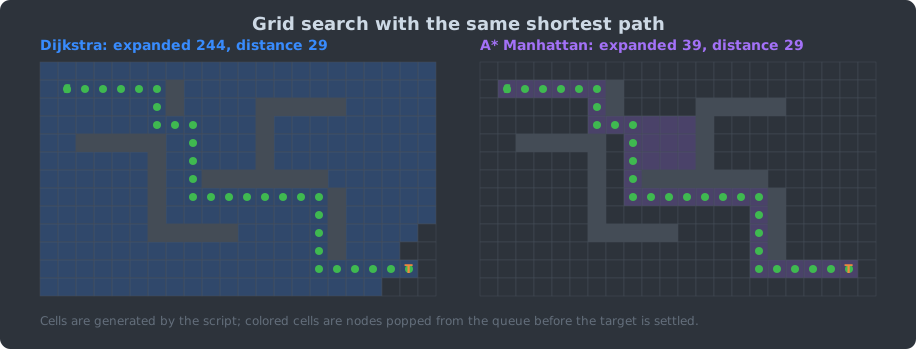
A* 没有改变最短路定义,它只是用下界改变队列顺序。若下界很弱,例如 \(h(v)=0\),A* 退化为 Dijkstra;若下界过强并高估真实距离,它可能错过最短路。游戏和机器人场景里常见的 weighted A* 使用 \(g(v)+\alpha h(v)\) 且 \(\alpha>1\),这是有意牺牲最优性换扩展节点数,应该明确标成近似策略,而不是 A* 的最优版本。
六、复现实验:只看与时钟无关的指标
复现命令如下;taskset -c 9 只是固定
CPU,本文没有使用耗时数字。
gcc -O2 -Wall -Wextra -std=c11 \
  post/algorithms/43-dijkstra-astar/reproduce/shortest_path_bench.c \
  -o post/algorithms/43-dijkstra-astar/reproduce/shortest_path_bench

taskset -c 9 post/algorithms/43-dijkstra-astar/reproduce/shortest_path_bench
校验命令还用 AddressSanitizer 与 UndefinedBehaviorSanitizer 跑了一遍:
gcc -O1 -g -fsanitize=address,undefined -fno-omit-frame-pointer \
  -Wall -Wextra -std=c11 \
  post/algorithms/43-dijkstra-astar/reproduce/shortest_path_bench.c \
  -o post/algorithms/43-dijkstra-astar/reproduce/shortest_path_bench_asan
ASAN_OPTIONS=detect_leaks=1 taskset -c 9 \
  post/algorithms/43-dijkstra-astar/reproduce/shortest_path_bench_asan
环境记录:Linux 6.6.87.2-microsoft-standard-WSL2,GCC
16.1.1,CPU 为 12th Gen Intel Core i9-12900K,24 个逻辑
CPU。程序输出也保存在
reproduce/results.txt。
栅格图:扩展节点数
图为 \(96\times96\) 四邻接单位权栅格,障碍概率为 22%,固定打开上边界和右边界保证可达。三个种子都取从左上角到右下角的查询。
| seed | algorithm | distance | expanded | pops | stale_pops | relax_attempts | successful_relax | decrease_key |
|---|---|---|---|---|---|---|---|---|
| 11 | Dijkstra | 190 | 7279 | 7279 | 0 | 11450 | 7278 | 0 |
| 11 | A* Manhattan | 190 | 191 | 191 | 0 | 340 | 339 | 0 |
| 29 | Dijkstra | 190 | 7191 | 7191 | 0 | 11186 | 7190 | 0 |
| 29 | A* Manhattan | 190 | 191 | 191 | 0 | 344 | 343 | 0 |
| 47 | Dijkstra | 190 | 7299 | 7299 | 0 | 11502 | 7298 | 0 |
| 47 | A* Manhattan | 190 | 191 | 191 | 0 | 327 | 326 | 0 |
这个合成图故意给 A* 友好的 Manhattan 下界:最短距离正好是 \(190\),A* 只扩展路径长度加一的节点数。它证明的是启发式能减少扩展范围,不证明所有地图上都会有这个比例。
随机有向图:lazy deletion 与 decrease-key
随机图有 \(4000\) 个顶点、\(24000\) 条随机有向边,另加一条从 \(0\) 到 \(n-1\) 的链保证可达。两种堆返回同一距离,差别只在队列操作。
| seed | heap | distance | expanded | pops | stale_pops | relax_attempts | successful_relax | decrease_key |
|---|---|---|---|---|---|---|---|---|
| 101 | lazy binary heap | 55 | 4000 | 7860 | 3860 | 14866 | 7859 | 0 |
| 101 | indexed decrease-key | 55 | 4000 | 4000 | 0 | 14866 | 7859 | 3860 |
| 202 | lazy binary heap | 72 | 4000 | 7943 | 3943 | 14851 | 7942 | 0 |
| 202 | indexed decrease-key | 72 | 4000 | 4000 | 0 | 14851 | 7942 | 3943 |
| 303 | lazy binary heap | 26 | 4000 | 8001 | 4001 | 14911 | 8000 | 0 |
| 303 | indexed decrease-key | 26 | 4000 | 4000 | 0 | 14911 | 8000 | 4001 |
lazy deletion 的代价在这里非常清楚:出堆次数约为 indexed heap 的两倍,其中多出来的是 stale entry。indexed heap 把这些 stale 出堆换成 decrease-key。真实系统还要再看内存布局、语言库堆是否支持可变句柄、批量查询时数组清零成本等因素。
七、道路网络:双向搜索、ALT、CH 与 OSRM
道路图查询通常不满足”在线跑一次 Dijkstra 就够”。单次查询可以用双向 Dijkstra,从 \(s\) 和 \(t\) 同时扩展;但停止条件不能写成”两个方向遇到同一个点就停”。正确条件维护当前最短上界 \(\mu\):每当一条边或一个中间点连接了正反两边,就更新 \(\mu\);当正向队列最小键 \(p_f\) 与反向队列最小键 \(p_b\) 满足
\[ p_f+p_b\ge\mu, \]
才可以停止。过早在第一次相遇处返回,是双向最短路实现里最常见的错误之一。
ALT(A* + Landmarks + Triangle inequality)是 Goldberg 与 Harrelson 在 SODA 2005 系统化的道路图加速方法。选一组地标 \(L\),预计算地标到所有点或所有点到地标的距离,用三角不等式得到下界。例如无向图上
\[ h(v)=\max_{\ell\in L}\left|d(\ell,t)-d(\ell,v)\right|。 \]
它仍是可采纳启发式;地标越能捕捉地理绕行,下界越紧。ALT 的代价是 \(O(|L|n)\) 级别的距离表,优点是比 CH 更容易适配部分动态权重。
Contraction Hierarchies(CH)由 Geisberger、Sanders、Schultes 与 Delling 在 WEA 2008 提出。它预先按重要性收缩节点,为必要的两跳最短路添加 shortcut;查询时做只沿”上坡”边的双向 Dijkstra。CH 的强项是静态道路图的低延迟,弱项是边权频繁变化时需要定制化或重预处理。
OSRM Backend v5.27.1 能看到这些工程分工,而不是一个教科书
Dijkstra 文件走天下。源码标签 v5.27.1 对应
commit 4f3ee60:
src/engine/routing_algorithms/direct_shortest_path.cpp为ch::Algorithm和mld::Algorithm分别特化directShortestPathSearch();CH 路径调用ch::unpackPath()解开 shortcut,MLD 路径调用mld::search()。include/engine/search_engine_data.hpp中,CH 的QueryHeap使用util::UnorderedMapStorage<NodeID, int>;MLD 的QueryHeap使用MultiLayerDijkstraHeapData和util::TwoLevelStorage<NodeID, int>,额外记录from_clique_arc。include/util/query_heap.hpp的QueryHeap基于boost::heap::d_ary_heap,arity<4>,mutable_<true>,并提供DecreaseKey()。这说明 OSRM 的查询堆是可变 4 叉堆风格,而不是 Fibonacci heap。
这类源码事实比”某导航系统快几千倍”更值得写进文章:它有版本、文件、函数名和可核对边界。
八、实现清单:容易写错的地方
- 距离类型:若边权和路径长度可能超过 32
位,使用
int64_t或更大类型;加法前检查INF,避免dist[u]+w溢出。 - closed set 与 reopen:Dijkstra 在非负权下可以关闭节点;A* 只有一致启发式才可以同样处理。不一致启发式要支持 reopen。
- 浮点权重:不要用随意的
epsilon改写最短路偏序。若输入来自米、毫秒、成本等离散单位,优先用整数缩放;确需浮点时,明确定义比较规则和误差边界。 - 多次查询初始化:大图服务里每次
memset全部数组可能成为瓶颈;可用 touched list 或时间戳数组只清理访问过的顶点。 - 栅格对角移动:八方向移动时,若允许从两个障碍物夹角穿过,路径会”切墙角”;应同时检查两个正交相邻格。
- 双向搜索停止:第一次相遇只是给出上界,不是证明。用 \(p_f+p_b\ge\mu\) 这类条件收束。
- 负权输入:发现负权边就不要继续用 label-setting Dijkstra;若无负环需求,换 Bellman-Ford / Johnson reweighting,或在业务层拒绝输入。
九、参考资料
核心论文
- E. W. Dijkstra, “A note on two problems in connexion
with graphs,” Numerische Mathematik, 1:269-271,
1959. DOI:
10.1007/BF01386390。 - M. L. Fredman and R. E. Tarjan, “Fibonacci Heaps and Their Uses in Improved Network Optimization Algorithms,” Journal of the ACM, 34(3):596-615, 1987。
- P. E. Hart, N. J. Nilsson and B. Raphael, “A Formal
Basis for the Heuristic Determination of Minimum Cost
Paths,” IEEE Transactions on Systems Science and
Cybernetics, 4(2):100-107, 1968. DOI:
10.1109/TSSC.1968.300136。 - R. Dechter and J. Pearl, “Generalized best-first search
strategies and the optimality of A,” Journal of the
ACM*, 32(3):505-536, 1985. DOI:
10.1145/3828.3830。 - A. V. Goldberg and C. Harrelson, “Computing the Shortest Path: A* Search Meets Graph Theory,” SODA 2005, pp. 156-165。
- R. Geisberger, P. Sanders, D. Schultes and D. Delling,
“Contraction Hierarchies: Faster and Simpler Hierarchical
Routing in Road Networks,” WEA 2008, LNCS 5038,
pp. 319-333. DOI:
10.1007/978-3-540-68552-4_24。
其他论文与报告
- R. B. Dial, “Algorithm 360: Shortest-path forest with topological ordering,” Communications of the ACM, 12(11):632-633, 1969。
- R. K. Ahuja, K. Mehlhorn, J. Orlin and R. E. Tarjan, “Faster Algorithms for the Shortest Path Problem,” Journal of the ACM, 37(2):213-223, 1990。
- M. Thorup, “Undirected Single-Source Shortest Paths with Positive Integer Weights in Linear Time,” Journal of the ACM, 46(3):362-394, 1999。
- M. Chen, R. A. Chowdhury, V. Ramachandran, D. Lan Roche and L. Tong, “Priority Queues and Dijkstra’s Algorithm,” UTCS Technical Report TR-07-54, 2007。
- B. Haeupler, R. Hladík, V. Rozhoň, R. E. Tarjan and J. Tětek, “Universal Optimality of Dijkstra via Beyond-Worst-Case Heaps,” FOCS 2024。
- R. Duan, J. Mao, X. Mao, X. Shu and L. Yin, “Breaking the Sorting Barrier for Directed Single-Source Shortest Paths,” STOC 2025;arXiv:2504.17033。
源码与实验
- OSRM Backend
v5.27.1,commit4f3ee60:src/engine/routing_algorithms/direct_shortest_path.cpp、include/engine/search_engine_data.hpp、include/util/query_heap.hpp。 - 本文复现实验:
post/algorithms/43-dijkstra-astar/reproduce/shortest_path_bench.c、reproduce/results.txt、reproduce/make_figures.py。
上一篇: 从零实现一个向量搜索引擎 下一篇: Bellman-Ford 与路由协议:负环、SPFA 与距离向量收敛 相关阅读: - 路由算法:距离向量 vs 链路状态 vs 路径向量 - 最小生成树:割性质、Kruskal/Prim/Borůvka 与线性时间开放问题
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
Bellman-Ford 与路由协议:负环、SPFA 与距离向量收敛
从 Bellman-Ford 的松弛不变式和负环提取出发,用可复现 C 程序与距离向量模拟器解释 RIP 的 count-to-infinity、split horizon 的边界,以及 Babel、EIGRP、BGP、OSPF 对环路问题的不同取舍。
路由算法:距离向量 vs 链路状态 vs 路径向量
互联网的路由表是人类建造的最大分布式数据结构。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。