线上服务的 RSS(Resident Set
Size)涨了,不一定是业务对象真的变多了。malloc
看到的是请求大小,分配器实际交给你的可能是更大的 size
class;free
之后,对象可能先停在线程缓存、arena、span 或 segment
里,而不是立刻回到操作系统。于是同一时刻至少有三种“内存量”需要分开:
- 请求字节:程序传给
malloc(n)的 \(n\) 之和; - 可用字节:分配器为这些对象实际保留的
slot 之和,可用
malloc_usable_size近似观测; - RSS:内核仍计入进程常驻集的物理页,包含分配器缓存、未清空的空闲页和其他匿名映射。
本文讨论用户态通用分配器,不重复 伙伴系统与
SLUB:Linux 物理页和小对象分配的边界 里内核物理页与 slab
的内容。所有生产实现结论都钉到版本:glibc 2.42、jemalloc
5.3.0、gperftools 2.15、mimalloc v2.1.7;Google 新版
tcmalloc 只用于解释 OSDI 2021 的 hugepage-aware
方向,不把它和 gperftools
的实验结果混在一起。文中的合成实验来自同目录
reproduce/allocator_probe.c。
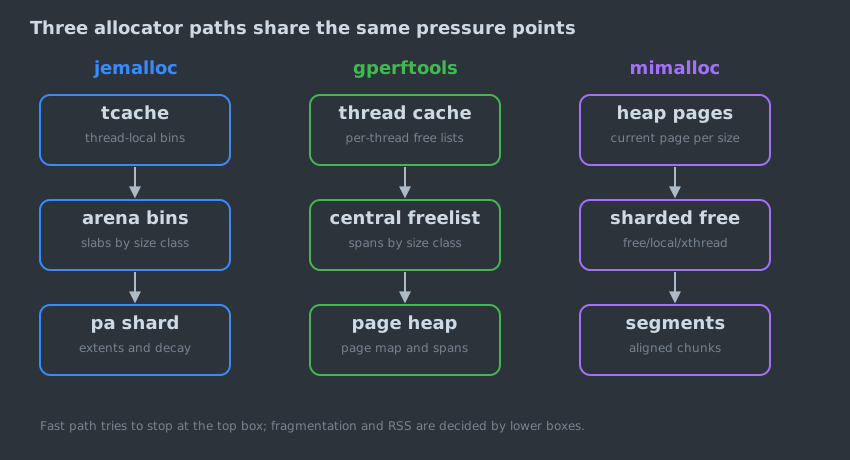
一、先把“碎片”拆成可测量对象
Wilson、Johnstone、Neely 和 Boles 在 1995 年的综述里把动态内存分配(dynamic storage allocation)的核心困难概括为:算法必须在线处理请求、不能知道未来释放顺序,还要在时间、空间和局部性之间取舍。把“碎片率”笼统地说成一个数字容易误导,至少应拆成两层。
第一层是内部碎片(internal fragmentation)。分配器通常把请求大小映射到 size class。若请求 \(r\) 被放进大小为 \(s_i\) 的 slot,内部碎片率为
\[ \frac{s_i-r}{r}. \]
它由 size class 表决定,和应用之后是否释放无关。size class 越密,内部碎片越小;但每个线程、CPU 或 arena 需要维护的缓存也越多。
第二层是外部碎片(external
fragmentation)和缓存滞留。程序释放了一批对象之后,空闲 slot
可能分散在许多 page、run、span 或 segment
中。若这些页上仍有少量存活对象,分配器无法把整页交还给内核;若页已经空了,分配器也可能为了后续复用而延迟
madvise 或 munmap。所以 RSS/live
不是纯算法排名,而是工作负载、内核、释放时机、后台 purge
策略共同决定的观测量。
本文实验记录三个比值:
\[ \text{usable/live} = \frac{\text{malloc\_usable\_size 之和}}{\text{请求字节之和}}, \qquad \text{RSS/live} = \frac{\text{VmRSS}}{\text{请求字节之和}}. \]
这些指标不依赖 wall-clock 时间,适合在共享机器上做定性比较。它们不能证明某个分配器“总是更快”,但能暴露 size class、线程缓存和释放路径的空间代价。
二、谱系:从顺序 first-fit 到可扩展 malloc
分配器不是从 jemalloc、tcmalloc、mimalloc 才开始的。按本文关心的问题,可以把谱系压缩成四条线。
| 工作 | 关注点 | 本文引用点 |
|---|---|---|
| Wilson et al., Dynamic Storage Allocation: A Survey and Critical Review, IWMM 1995 | 系统梳理 first-fit、best-fit、segregated free list、伙伴系统和碎片评价口径 | 证明“碎片”必须按工作负载与指标讨论 |
| Berger et al., Hoard, ASPLOS 2000 | 多处理器 malloc 的锁争用和 memory blowup | 线程局部 heap 不能无限囤积,需要全局上界或再平衡 |
| Evans, A Scalable Concurrent malloc(3) Implementation for FreeBSD, BSDCan 2006 | jemalloc 的 arena、run/bin、低碎片目标 | 生产 jemalloc 的直接源头 |
| Leijen, Zorn, de Moura, Mimalloc: Free List Sharding in Action, MSR-TR-2019-18 | 每个 page 拆成 local/remote free list | 跨线程释放不必污染快速路径 |
| Powers et al., Mesh, PLDI 2019 | C/C++ 堆对象不能移动时,如何用虚拟页 meshing 降碎片 | “通用 malloc 无法压缩对象”的反例与后续 work |
| Hunter et al., Beyond malloc efficiency to fleet efficiency, OSDI 2021 | Google tcmalloc/Temeraire 的 hugepage-aware 设计 | 分配器目标从单进程效率扩展到 fleet TLB 与大页效率 |
Hoard 是这条线上的重要分叉:它强调可扩展分配器不能只给每个线程一个无限缓存,否则锁少了,内存膨胀(blowup)会失控。jemalloc、tcmalloc 和 mimalloc 都继承了“快速路径本地化,慢路径集中管理”的思路,只是本地化的单位不同:线程、CPU、arena 或 page。
另一个分叉是
compaction。托管运行时可以移动对象并更新引用,C/C++
的通用 malloc
不能这么做,因为外部代码只拿着裸指针。Mesh
的贡献是利用虚拟地址映射把物理页“拼合”,在不移动对象虚拟地址的前提下降低碎片;这说明外部碎片不是靠更细
size class 就能完全解决的问题。
三、glibc ptmalloc2:今天也有 tcache,但边界仍在 arena
glibc 的 malloc 仍属于 ptmalloc
系列,但把它描述成“一个 arena
一把大锁,所以现代系统不能用”已经过时。glibc 2.42 的
malloc/malloc.c 默认启用 tcache:源码里
TCACHE_FILL_COUNT 为 7,每个线程、每个 tcache
bin 最多缓存 7 个 chunk。小对象分配和释放命中 tcache
时不需要进入 arena 锁。
ptmalloc2 的边界在 arena 与 chunk 组织方式:
- chunk metadata 放在用户对象前后,空闲 chunk 进入 fastbin、smallbin、largebin 或 unsorted bin;
malloc_par里NARENAS_FROM_NCORES(n)在 64 位上是 \(8n\),即 arena 数会随核心数扩展,但不是无限制;malloc_trim与free的自动 trim 主要处理 top chunk 或可释放的 mmap chunk;很多交错释放模式只能留在 arena 内部复用。
因此,ptmalloc2 的问题不是“没有线程缓存”,而是通用 chunk 合并、arena 数量和 trim 条件决定了它在某些长期服务里更容易留下 RSS 尾巴。反过来,在本文的合成负载上,glibc 的 RSS/live 反而最低;这也是不能用单一故事替代测量的原因。
四、jemalloc 5.3.0:arena、slab 与 decay
jemalloc 5.3.0 的 size class 规则写在
include/jemalloc/internal/sc.h。源码注释明确说,常规组(regular
group)把一个二的幂区间拆成 SC_NGROUP 个等距
class;SC_LG_NGROUP 为 2,所以
SC_NGROUP = 4。这带来一个简单上界:常规组里相邻
class 的步长是 base
的四分之一,最坏请求刚超过前一档时,内部浪费约为下一档的
\(20\%\) 以内。
小对象路径是:
- 线程先查自己的 tcache;
- tcache miss 后进入 arena 的 bin;
- bin 管理 slab,slab 被切成同一 size class 的 region;
- slab 和大对象背后是 page allocator,5.x
源码中核心元数据叫
edata_t,arena 内部通过pa_shard管理 dirty、muzzy、retained 等状态。
这套结构的关键不是“永远最省内存”,而是把争用面缩小。大多数小对象在 tcache 里完成;必须补货或回收时才触碰 bin 锁;更大粒度的 extent/page 操作再进入 arena 的 page allocator。
jemalloc 的另一个重要机制是
decay。dirty_decay_ms 控制 dirty extent 在被
madvise(MADV_DONTNEED)
前保留多久;muzzy_decay_ms 控制已经 lazy-purge
的 extent 进一步留存多久。默认值和后台线程行为会受构建与
MALLOC_CONF 影响,正文不能把“free 后 RSS
马上下降”写成 jemalloc 的保证。可验证的说法是:jemalloc 提供
mallctl 与 stats 接口观察 arena、bin、dirty/muzzy
页,并允许通过配置改变 purge 激进程度。
五、tcmalloc 要分清 gperftools 与 Google 新实现
“tcmalloc”至少有两个常见指代。
- gperftools
tcmalloc:开源历史更早,本文源码钉在 gperftools
2.15。它的主要层次是
ThreadCache、CentralFreeList和PageHeap。 - Google tcmalloc:Google 2019 年后单独开源的实现,包含 per-CPU cache、hugepage-aware allocator 等设计。OSDI 2021 论文把这条线称为 Temeraire,并从 fleet efficiency 的角度讨论大页填充率、TLB 和内存归还。
gperftools 2.15 的 src/common.h
给出几个重要默认值:kPageShift 默认 13,即内部
page 为 8 KiB;kMaxSize 为 256
KiB,小于等于这个阈值的对象走 size
class;kMaxThreadCacheSize 为 4 MiB,默认总
thread cache 上界是 \(8 \times
4\) MiB。CentralFreeList 按 size class
管理 span,PageHeap 管理连续
page;对象指针通过页号查到 span,再知道其 size class。
Google 新 tcmalloc 的目标更偏数据中心。当前开源树(commit
7d8e577bed43a5e4bdee17e8d962815ea87dcef3)里能直接看到
HugePageFiller、HugePageAwareAllocator、CpuCache
和 CentralFreeList。OSDI 2021
的核心动机是:如果分配器把小 span 随意撒在 2 MiB hugepage
上,透明大页很难保持完整;若 page heap 知道 hugepage
的填充状态,就能在小对象 RSS 之外优化 TLB 与 fleet-level CPU
成本。这个结论不能直接外推到本文的 gperftools
实验,也不能外推到没有 THP/hugetlb 条件的小容器。
六、mimalloc v2.1.7:free list sharding 的含义
mimalloc 的论文标题是 Free List Sharding in
Action,源码结构也围绕这个点展开。v2.1.7 的
include/mimalloc/types.h 用
MI_SEGMENT_SIZE 和
MI_SEGMENT_ALIGN 定义 segment 粒度;segment
内部切成 page,page 再切成同一 block size
的对象。mi_page_s 中有三条相关链表:
free:分配快速路径直接弹出的空闲块;local_free:拥有该 page 的线程释放的块,或从远端链表收集来的块;xthread_free:其他线程释放的块,使用原子 CAS 追加,之后由 owner 收进local_free。
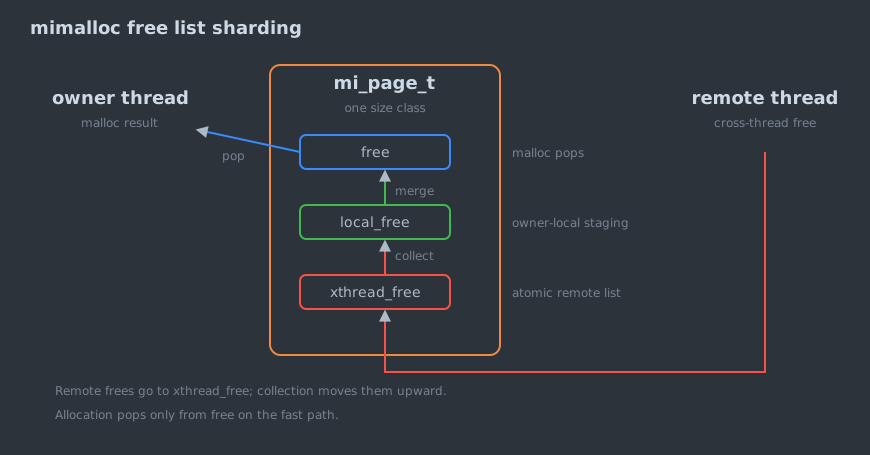
这张图解释了 mimalloc 与传统“每个 size class
一个链表”的差别。跨线程释放(producer 线程分配、consumer
线程释放)在队列、actor、work stealing
里很常见。如果远端线程直接改 owner 的本地 free
list,快速路径就要承担锁或原子操作。mimalloc
把远端释放隔离到
xthread_free。当本地快速链表需要补充时,src/page.c
中 _mi_page_thread_free_collect 先把
xthread_free 收进
local_free,_mi_page_free_collect
再把 local_free 并入
free;分配快速路径只从 free
弹出。常见路径短,少见路径付出 CAS 与链表合并成本。
这个设计不等于 mimalloc 在所有场景下 RSS 最低。v2.1.7 的
page/segment 粒度和 purge 策略仍会影响常驻页;默认配置下
src/options.c 的 purge_delay 为 10
ms,purge_decommits 在 Linux 上使用
MADV_DONTNEED。是否比 jemalloc
更省,要看对象大小分布、跨线程释放比例和空闲页能否成片出现。
七、可复现实验:size-class 抖动与跨线程释放
实验程序放在 reproduce/:
cd post/algorithms/51-memory-allocator/reproduce
BUILD_DIR=$BUILD_DIR CORE=9 THREADS=4 SLOTS=60000 ROUNDS=6 ./run.sh
BUILD_DIR 指向本地构建好的 allocator
源码目录;脚本会优先使用其中的
jemalloc-5.3.0/lib/libjemalloc.so、gperftools-2.15-release/.libs/libtcmalloc_minimal.so
和
mimalloc-v2.1.7/out/release/libmimalloc.so,找不到时再尝试系统库。正文不依赖本机私有路径。
工作负载有两个模式:
local:每个线程释放自己拥有的 slot,然后重新分配;cross:线程 \(t\) 释放线程 \((t+1) \bmod T\) 拥有的 slot,再由 owner 重新分配,模拟生产者—消费者式跨线程释放。
每个 slot 的请求大小在 24 B 到 4095 B
附近抖动,特意落在常见 size class 边界两侧。程序固定 3
个种子,取中位数。运行环境:Linux
6.6.87.2-microsoft-standard-WSL2,GCC
16.1.1,taskset -c 9,4 个线程,60,000
slots/thread,6 轮。结果如下:
| allocator | mode | runs | usable/live | RSS/live |
|---|---|---|---|---|
| glibc | cross | 3 | 1.01 | 1.06 |
| glibc | local | 3 | 1.01 | 1.06 |
| jemalloc 5.3.0 | cross | 3 | 1.06 | 1.18 |
| jemalloc 5.3.0 | local | 3 | 1.06 | 1.18 |
| gperftools tcmalloc 2.15 | cross | 3 | 1.04 | 1.15 |
| gperftools tcmalloc 2.15 | local | 3 | 1.04 | 1.15 |
| mimalloc v2.1.7 | cross | 3 | 1.06 | 1.16 |
| mimalloc v2.1.7 | local | 3 | 1.06 | 1.16 |
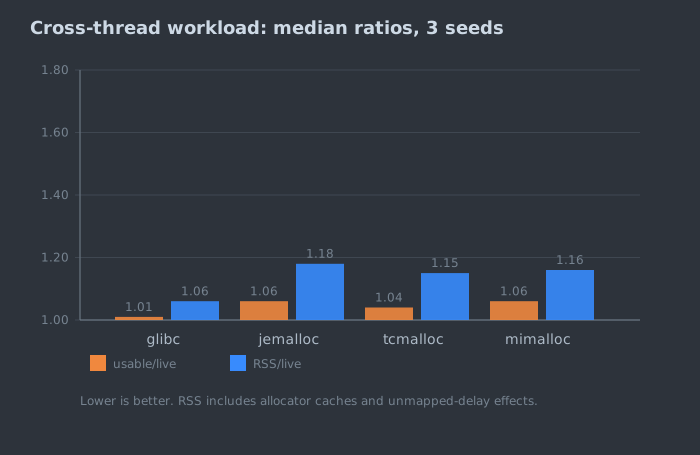
这个结果故意不写成“谁击败谁”。在这组合成负载下,glibc 的
RSS/live 最低,gperftools tcmalloc 的
malloc_usable_size 比值低于 jemalloc 与
mimalloc,三种现代分配器的 RSS/live 差距只有
0.03。这说明三件事:
- size class 越细不必然带来更低 RSS;线程缓存和 page/span 留存同样重要。
- 本实验的 cross 与 local 差异很小,说明 4 线程、该规模下跨线程释放没有压出 mimalloc sharding 的明显空间优势;它可能影响延迟和原子争用,但本文没有用时钟指标下结论。
- 单机合成负载不能替代你的服务。它只提供一套可改参数的探针,用来复现“请求字节、usable 字节、RSS 不是同一个量”。
八、工程选型:先观测,再替换
替换 allocator 的成本很低,误判成本很高。建议按下面顺序做。
第一步:确认问题属于 allocator。 对
C/C++
服务,先同时记录业务对象数量、malloc_usable_size
抽样、/proc/<pid>/smaps_rollup、allocator
stats(jemalloc mallctl、tcmalloc
MallocExtension、mimalloc stats)和容器 cgroup
指标。若 RSS 增长来自文件缓存、JIT、直接 mmap
或 GPU/driver 内存,换 malloc 不会解决。
第二步:按机制选候选。
| 现象 | 优先检查 | 候选 |
|---|---|---|
| 小对象分配频繁,锁等待明显 | tcache/thread cache 是否命中,arena/bin 锁是否热 | jemalloc、tcmalloc、mimalloc 都值得测 |
| 长期运行后 RSS/live 高 | 空闲页是否成片、purge/decay 是否太保守 | jemalloc 可观测性强;mimalloc/tcmalloc 也要看 purge 配置 |
| producer/consumer 跨线程释放多 | 远端释放是否进入原子热点或 central list | mimalloc 的 sharding 值得重点测 |
| 数据中心大页/TLB 成本突出 | THP、hugepage backing、page heap 填充率 | Google tcmalloc/Temeraire 方向,不等同于 gperftools |
| 需要安全隔离、随机化、guard page | 安全 allocator 与 PartitionAlloc/OpenBSD malloc | 通常牺牲吞吐和 RSS,不与本文 benchmark 混排 |
第三步:用同一负载、同一口径重跑。
LD_PRELOAD
只适合动态链接程序;静态链接、setuid、容器路径、语言运行时自带
allocator 都可能绕过它。Rust 的
#[global_allocator]、C++ 的链接顺序、Go/Java
的运行时堆也要分别处理。不要把“某公开 benchmark
的吞吐量”直接写进容量规划。
第四步:把配置写进发布产物。 jemalloc 的
MALLOC_CONF、tcmalloc 的环境变量、mimalloc 的
MIMALLOC_*
选项都属于程序行为的一部分。线上事故复盘时,allocator
版本和配置应该和内核版本、容器限制一起记录。
九、争论与开放问题
开放问题一:C/C++ 堆能否低成本 compact?
传统 malloc
不能移动对象,因为外部代码只保存裸指针。Mesh 用虚拟页
meshing
绕开这一点,但它依赖页级别可重映射和对象布局条件;通用生产系统里,安全性、调试工具、mmap
交互和性能尾延迟仍是难点。
开放问题二:单进程最优与 fleet 最优冲突。 Google tcmalloc 的 Temeraire 说明,allocator 目标可以从“本进程 RSS 低”扩展到“整个 fleet 的 hugepage backing 和 TLB 成本低”。这会改变 page heap 的局部最优:有时宁可在一个 hugepage 内更积极地填洞,也不把小 span 分散到更多 hugepage。
开放问题三:可观测性仍不统一。
malloc_usable_size、jemalloc stats、tcmalloc
MallocExtension、mimalloc stats 和
/proc 指标口径不同。Wilson
综述已经强调评价方法的重要性;三十年后,跨 allocator
的统一、低开销、可在线采样指标仍然不是 C/C++
标准的一部分。
十、参考资料
源码
- glibc
2.42,
malloc/malloc.c、malloc/arena.c:tcache、arena、malloc_trim与madvise路径。 - jemalloc
5.3.0,
include/jemalloc/internal/sc.h、src/tcache.c、src/arena.c、src/pa.c:size class、tcache、arena 与 page allocator。 - gperftools
2.15,
src/common.h、src/thread_cache.h、src/central_freelist.cc、src/page_heap.cc:thread cache、central freelist 与 page heap。 - google/tcmalloc commit
7d8e577bed43a5e4bdee17e8d962815ea87dcef3,tcmalloc/huge_page_filler.h、tcmalloc/huge_page_aware_allocator.*、tcmalloc/cpu_cache.h:Temeraire、HugePageFiller 与 per-CPU cache。 - mimalloc
v2.1.7,
include/mimalloc/types.h、src/page.c、src/free.c、src/options.c:segment/page、free list sharding 与 purge 选项。
核心论文
- Paul R. Wilson, Mark S. Johnstone, Michael Neely, David
Boles, Dynamic Storage Allocation: A Survey and Critical
Review, International Workshop on Memory Management,
1995. DOI:
10.1007/3-540-60368-9_19。 - Emery D. Berger, Kathryn S. McKinley, Robert D. Blumofe,
Paul R. Wilson, Hoard: A Scalable Memory Allocator for
Multithreaded Applications, ASPLOS 2000. DOI:
10.1145/356989.357000。 - Jason Evans, A Scalable Concurrent malloc(3) Implementation for FreeBSD, BSDCan 2006。
- Daan Leijen, Benjamin Zorn, Leonardo de Moura, Mimalloc: Free List Sharding in Action, Microsoft Research Technical Report MSR-TR-2019-18, 2019。
- Bobby Powers, David Tench, Emery D. Berger, Andrew
McGregor, Mesh: Compacting Memory Management for C/C++
Applications, PLDI 2019. DOI:
10.1145/3314221.3314582。 - Andrew Hunter, Chris Kennelly, Paul Turner, Darryl Gove, Tipp Moseley, Parthasarathy Ranganathan, Beyond malloc efficiency to fleet efficiency: a hugepage-aware memory allocator, OSDI 2021。
实验
reproduce/allocator_probe.c:size-class 抖动与跨线程释放负载。reproduce/run.sh:编译、按 allocator 运行 3 个种子并生成results/raw.tsv与results/summary.tsv。reproduce/draw_figures.py:重画本文 SVG 图。
上一篇: 图着色与寄存器分配:从
DSatur 到 Chaitin-Briggs
下一篇: 页面置换算法:从
OPT、LRU 到 ARC 与 Linux 页面回收
相关阅读: - 伙伴系统与 SLUB:Linux 物理页和小对象分配的边界 - epoll 的数据结构:红黑树、就绪队列与回调机制 - 流式算法总论:数据流模型、频率矩下界与线性 sketch
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
伙伴系统与 SLUB:Linux 物理页和小对象分配的边界
以 Linux v6.6 源码和确定性模拟为准,解释伙伴系统的 split/coalesce、migratetype 反碎片策略,以及 SLUB 的 per-CPU freelist、partial list 与安全加固。
CPU 调度:CFS 的虚拟运行时间与 EEVDF 的虚拟截止期
从比例份额调度的论文谱系出发,对照 Linux v6.6 与 v6.12 fair.c 源码,解释 CFS 的 vruntime、EEVDF 的 lag/eligible/deadline,并用确定性模拟复现延迟与 lag 的差异。
I/O 调度:在寻道、队列深度与公平性之间取舍
从电梯算法到 blk-mq,解释 Linux I/O 调度器为何在 HDD 上排序、在共享设备上保公平、在 NVMe 上常选择 none,并用确定性模拟展示寻道距离与队列尾延迟的取舍。
页面置换算法:从 OPT、LRU 到 ARC 与 Linux 页面回收
从 Bélády OPT 与栈算法出发,用可复现的模拟实验对比 FIFO、LRU、CLOCK、2Q、ARC 在循环与扫描负载下的命中率,再对照 Linux 6.12 源码说明 active/inactive、workingset 与 kswapd/direct reclaim 的真实分工。