kmalloc(64, GFP_KERNEL) 看起来只是要 64
字节,内核却不会直接在物理内存里找 64 个连续字节。Linux
把问题拆成两层:伙伴系统(buddy system)管理连续物理页,SLUB
把若干页切成同一大小的小对象。两层的边界很重要:伙伴系统关心“还能不能凑出高阶连续页”,SLUB
关心“当前 CPU 能不能无锁拿到一个对象”。
本文只讨论 Linux v6.6 的主线实现:伙伴系统以
mm/page_alloc.c、mm/internal.h、include/linux/mmzone.h
为准,SLUB 以 mm/slub.c 与
include/linux/slub_def.h 为准。实验是同目录
reproduce/buddy_slab_sim.py
的确定性模拟,不使用 wall-clock 时间,也不把本机
/proc/buddyinfo 当成通用结论。
一、分层边界:页分配和对象分配回答不同问题
Linux 的页分配器返回的是连续页框。若页大小为 \(P\),order 为 \(o\) 的请求需要 \(2^o\) 个连续页,也就是 \(2^o P\) 字节。默认源码里
include/linux/mmzone.h 定义
MAX_ORDER 为 10,mm/page_alloc.c
中多个循环写成
order <= MAX_ORDER,因此默认会维护 order 0
到 10 共 11 档;架构也可以通过
CONFIG_ARCH_FORCE_MAX_ORDER 改这个边界。
小对象不能直接靠伙伴系统服务。64 字节对象若独占 4 KiB 页,内部利用率只有 \(64/4096=1.56\%\);但如果为每种小对象都写一套合并逻辑,又会把物理连续性问题带到上层。SLUB 的做法是:先从伙伴系统拿 1 个或多个页形成一个 slab,再在 slab 内维护固定大小对象的 freelist。页回收、压缩、migratetype 属于下层;per-CPU freelist、partial slab 和对象调试属于上层。
这个边界也解释了 kmalloc
的两种失败模式:小对象路径可能只是当前 CPU freelist
空了,需要换一个 partial
slab;高阶页路径则可能是真的缺少连续物理页,需要回收、压缩,甚至失败。把二者混成“内核分配器很快/很慢”会掩盖关键差异。
二、伙伴系统:二的幂、异或伙伴与外部碎片
伙伴系统的思想至少可以追到 Knowlton 1965 年的 “A fast storage allocator”;Knuth 在 TAOCP 第 1 卷 §2.5C 把它整理成“Buddy systems of storage allocation”。核心规则很少:请求向上取整到 \(2^o\) 个基本单元;找不到正好大小的块,就不断把更大的块对半分裂;释放时只有真正的伙伴同时空闲,才能合并成父块。
Linux v6.6 中,struct free_area 是每个
zone、每个 order 的空闲链表集合:
/* include/linux/mmzone.h, Linux v6.6, excerpt */
struct free_area {
    struct list_head free_list[MIGRATE_TYPES];
    unsigned long nr_free;
};
order 内部还按 migratetype 分链表,这一点留到第三节。先只看纯 buddy。源码里的伙伴地址就是异或:
/* mm/internal.h, Linux v6.6, excerpt */
static inline unsigned long
__find_buddy_pfn(unsigned long page_pfn, unsigned int order)
{
    return page_pfn ^ (1 << order);
}
若一个块起始页帧号是 \(p\),order 为 \(o\),它的伙伴起点就是 \(p \oplus
2^o\)。合并后的父块起点是
p & ~(1 << order),源码注释也写了这两个等式。这个位运算成立的前提是块按
\(2^o\)
对齐;一旦任意大小块都能合并,就不能只靠一位异或判断伙伴。
分裂与合并路径
__rmqueue_smallest() 从请求 order
开始往上找第一个非空链表,拿到更大的块后调用
expand() 逐级拆半:
/* mm/page_alloc.c, Linux v6.6, excerpt */
for (current_order = order; current_order <= MAX_ORDER; ++current_order) {
    area = &(zone->free_area[current_order]);
    page = get_page_from_free_area(area, migratetype);
    if (!page)
        continue;
    del_page_from_free_list(page, zone, current_order);
    expand(zone, page, order, current_order, migratetype);
    set_pcppage_migratetype(page, migratetype);
    return page;
}
释放方向在 __free_one_page():只要
find_buddy_page_pfn() 验证伙伴确实空闲、order
相同、同 zone,就从对应链表删掉伙伴,把 order
加一继续循环。源码还要处理 guard page、pageblock
migratetype、compaction capture 等 VM 细节;buddy
的不变量仍是“同阶、同 zone、同父块”。
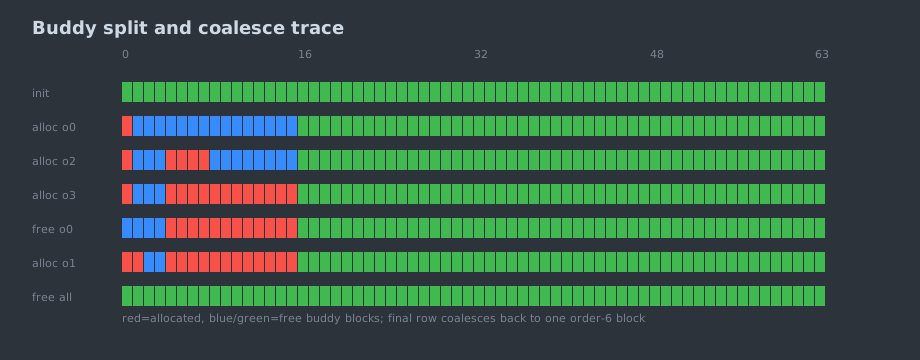
同目录模拟器用 64 页玩具内存跑固定序列:分配 order 0、order 2、order 3,释放一个小块,再分配 order 1,最后全部释放。输出片段如下:
| 步 | 操作 | order 0..6 空闲块数 | 空闲页 | 最大空闲块 | order 4 外部碎片指数 |
|---|---|---|---|---|---|
| 0 | init | 0 0 0 0 0 0 1 |
64 | 64 | 0.000 |
| 1 | alloc a order0 | 1 1 1 1 1 1 0 |
63 | 32 | 0.492 |
| 3 | alloc c order3 | 1 1 0 0 1 1 0 |
51 | 32 | 0.373 |
| 8 | free all | 0 0 0 0 0 0 1 |
64 | 64 | 0.000 |
这里的外部碎片指数定义为:
\[ F_o = 1 - \frac{\text{largest free block with order}\ge o}{\text{total free pages}}. \]
它不是内核指标,只是实验用来表达“空闲页能不能组成目标高阶块”。第 1 步看起来只有 1 页被分配,但最大连续空闲块已经从 64 页降到 32 页;第 8 步说明只要释放顺序最终让真正伙伴重逢,buddy 可以完全合并回去。
三、migratetype:反碎片不是“总能合并”,而是少把页面混住
外部碎片最难处理的情况不是空闲页少,而是不可移动页面把空闲页切碎。Linux
v6.6 在 enum migratetype
里至少区分了三类普通页面:MIGRATE_UNMOVABLE、MIGRATE_MOVABLE、MIGRATE_RECLAIMABLE;MIGRATE_HIGHATOMIC
是高优先级原子分配的保留类型,MIGRATE_CMA、MIGRATE_ISOLATE
受配置影响。每个 free_area[order] 都有
free_list[MIGRATE_TYPES],也就是同一 order
里再按迁移属性分桶。
源码的 fallback 表很直接:
/* mm/page_alloc.c, Linux v6.6, excerpt */
static int fallbacks[MIGRATE_TYPES][MIGRATE_PCPTYPES - 1] = {
    [MIGRATE_UNMOVABLE]   = { MIGRATE_RECLAIMABLE, MIGRATE_MOVABLE   },
    [MIGRATE_MOVABLE]     = { MIGRATE_RECLAIMABLE, MIGRATE_UNMOVABLE },
    [MIGRATE_RECLAIMABLE] = { MIGRATE_UNMOVABLE,   MIGRATE_MOVABLE   },
};
这不是硬隔离。目标 migratetype
的链表耗尽时,分配器会向其他类型
fallback;steal_suitable_fallback()
还会尝试把同一个 pageblock
里的空闲页搬到当前类型,条件满足时改变整个 pageblock 的
migratetype。设计目标是减少混住,而不是承诺永不混住。
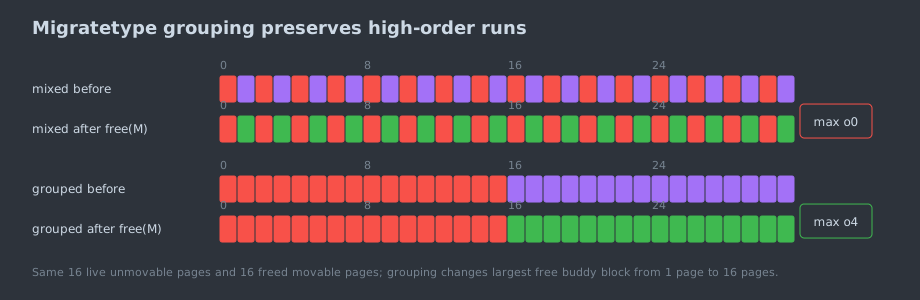
模拟器把 32 页玩具 pageblock 分成两种布局:
| 布局 | 释放 movable 后的空闲页 | 最大空闲 buddy 块 | order 4 外部碎片指数 |
|---|---|---|---|
| unmovable/movable 交错 | 16 | 1 页(order 0) | 1.000 |
| unmovable 与 movable 分组 | 16 | 16 页(order 4) | 0.000 |
这张图故意不用真实 workload:它只验证一个机制结论——同样数量的空闲页,位置决定高阶分配能否成功。Linux 的 pageblock、fallback 和 compaction 都是在这个边界内做启发式取舍。
四、SLAB 谱系:对象缓存、magazine、SLUB 简化
Bonwick 在 1994 年 USENIX 论文中提出 slab allocator,用对象缓存(object caching)减少反复初始化内核对象的成本,并用 slab coloring 改善缓存映射。Bonwick 与 Adams 2001 年的 “Magazines and Vmem” 把 per-CPU magazine 加到 slab 上,解决多 CPU 下的锁竞争;同一篇还提出 vmem,把 slab 背后的资源管理推广到任意地址空间和 ID 资源。
Linux 的 SLAB 借鉴了这条线,但多 CPU、NUMA、调试和多队列让实现越来越复杂。Lameter 2007 年发到 LKML、被 LWN 收录的 SLUB 说明把动机说得很清楚:SLUB 去掉 SLAB 中大量对象队列,为每个 CPU 直接持有一个 slab,partial slab 由中心列表管理。这里的争论不是“SLAB 错、SLUB 对”,而是生产实现要不要继续为旧特性付维护成本。
版本边界要写准:SLOB 的移除 patch series 在 2023 年 3
月说明“aim at 6.4”;SLAB 的移除 patch series 在 2023 年 11
月说明“deprecated since 6.5”并“aim for
6.8”,补丁列表包括移除
CONFIG_SLAB、mm/slab.c 和
slab_def.h。因此“SLAB 在 6.5
移除”是错误说法;6.5 是弃用线,6.8 才是移除线。Linux v6.6
仍可看到 SLUB 与 SLAB 相关兼容结构,本文的实现分析钉在
v6.6。
Wilson、Johnstone、Neely 与 Boles 1995 年的分配器综述提醒了另一条边界:分配器的碎片表现不只由数据结构决定,还取决于策略和 workload。buddy 的二的幂规则让合并便宜,却带来内部碎片;slab/SLUB 用 size class 降低小对象开销,却可能让空闲对象滞留在 per-CPU 或 partial 列表里。没有脱离负载的“最好分配器”。
五、SLUB 快速路径:per-CPU freelist 加 tid
Linux v6.6 的 struct kmem_cache_cpu 包含当前
CPU 的 freelist、事务号 tid、当前 slab 和可选的
per-CPU partial slab:
/* include/linux/slub_def.h, Linux v6.6, excerpt */
struct kmem_cache_cpu {
    union {
        struct {
            void **freelist;
            unsigned long tid;
        };
        freelist_aba_t freelist_tid;
    };
    struct slab *slab;
#ifdef CONFIG_SLUB_CPU_PARTIAL
    struct slab *partial;
#endif
    local_lock_t lock;
};
快速路径在 __slab_alloc_node() 中读取当前
CPU 的 freelist 和 tid。若当前
slab、NUMA node 等条件匹配,就用
__update_cpu_freelist_fast() 原子替换 freelist
和 tid;失败则重试。源码注释强调,这个 cmpxchg 保护的是同一
CPU 上的 per-CPU 队列状态,不是允许其他 CPU 任意改同一个
freelist。
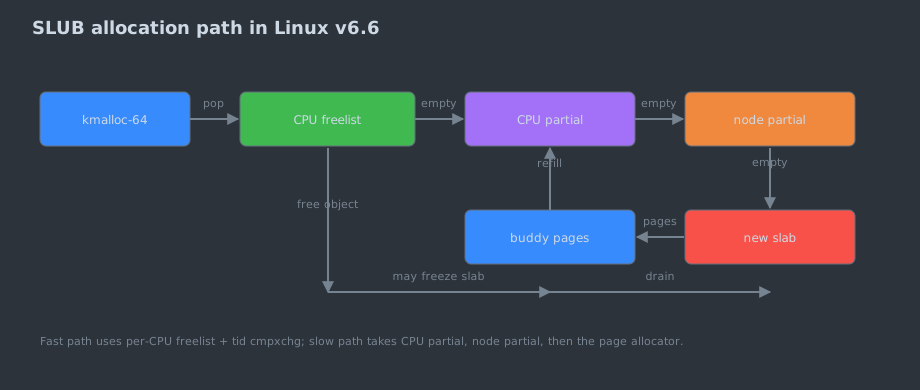
慢路径 ___slab_alloc()
的顺序可以简化为四步:
- 当前 CPU 的
c->freelist为空时,尝试从当前 slab 的slab->freelist接管一串对象; - 当前 slab 不能用时,若
CONFIG_SLUB_CPU_PARTIAL有 per-CPU partial,就取一个 frozen partial slab; - 再不行,调用
get_partial()从 NUMA node 的 partial list 取 slab; - 仍失败,
new_slab()向页分配器申请新页并初始化对象 freelist。
这条路径解释了为什么同一个 kmalloc-64
在热路径和冷路径上的行为完全不同。热路径只是 per-CPU
freelist 的 pop;冷路径可能跨 NUMA 节点找 partial
slab,甚至走到伙伴系统和回收路径。
六、空闲链表放在对象里,也带来安全边界
SLUB 没有单独的 bufctl
数组。空闲对象的下一个指针就写在对象内部,偏移由
kmem_cache.offset 指定:
/* mm/slub.c, Linux v6.6, excerpt */
static inline void set_freepointer(struct kmem_cache *s, void *object, void *fp)
{
    unsigned long freeptr_addr = (unsigned long)object + s->offset;

#ifdef CONFIG_SLAB_FREELIST_HARDENED
    BUG_ON(object == fp);
#endif

    freeptr_addr = (unsigned long)kasan_reset_tag((void *)freeptr_addr);
    *(freeptr_t *)freeptr_addr = freelist_ptr_encode(s, fp, freeptr_addr);
}
CONFIG_SLAB_FREELIST_HARDENED
开启时,freelist_ptr_encode() 会把真实指针与
s->random、swab(ptr_addr)
做异或:
\[ \text{encoded} = \text{ptr} \oplus s.\text{random} \oplus \operatorname{swab}(\text{ptr\_addr}). \]
这不是加密算法意义上的保密协议,而是提高
use-after-free、double-free、越界写破坏 freelist
后可利用的难度。SLUB 还可以通过
CONFIG_SLAB_FREELIST_RANDOM 随机化 slab
内空闲对象顺序;调试场景下,red zone、poisoning、tracking
等特性会牺牲速度换更强的错误定位。
需要纠正一个常见误解:SLUB
并没有“去掉对象构造函数”。Linux v6.6 的
struct kmem_cache 仍有
void (*ctor)(void *) 字段。SLUB
的简化重点是减少 SLAB 的队列、元数据和 slowpath
复杂度,不是把对象生命周期钩子全部删光。
七、kmalloc
size class:不是所有大小都按二的幂浪费
include/linux/slab.h 中,普通配置下
KMALLOC_MAX_CACHE_SIZE 是
1UL << KMALLOC_SHIFT_HIGH,而
KMALLOC_SHIFT_HIGH 通常是
PAGE_SHIFT + 1。在 4 KiB 页机器上,这意味着到
8192 字节仍可走 kmalloc
cache;更大的请求转入页分配路径。具体 size class
由配置和架构影响,不能只写“8、16、32、64、128……”后就结束。
模拟器采用常见 kmalloc 档位
[8,16,32,64,96,128,192,256,512,1024,2048,4096,8192],展示中间档位对内部碎片的影响:
| 请求字节 | 路径 | 分配字节 | 浪费字节 | 浪费 / 请求 |
|---|---|---|---|---|
| 33 | kmalloc-64 | 64 | 31 | 93.9% |
| 65 | kmalloc-96 | 96 | 31 | 47.7% |
| 97 | kmalloc-128 | 128 | 31 | 32.0% |
| 129 | kmalloc-192 | 192 | 63 | 48.8% |
| 5000 | kmalloc-8192 | 8192 | 3192 | 63.8% |
| 9000 | page allocator order 2 | 16384 | 7384 | 82.0% |
这张表不是 Linux ABI 承诺,而是解释趋势:中间 size class
让 65 字节不必直接跳到 128;超过 kmalloc cache
上限后,请求又回到页分配器的 \(2^o\) 连续页规则。应用层
malloc 的 size class、线程缓存和 RSS 边界在 用户态内存分配器
中单独讨论,本文不重复。
八、如何读
/proc,以及不要从单次快照推出规律
/proc/buddyinfo 每行通常是一个 NUMA node
的一个 zone,后面的数字从低到高对应各 order
的空闲块数。它能回答“此刻还有多少高阶空闲块”,不能单独解释原因:高阶块少可能来自长期不可移动页混住,也可能只是当前压力、CMA/ISOLATE、热插拔或压缩时机的结果。
/proc/slabinfo 或
/sys/kernel/slab/<cache>/ 能看到 slab
cache 的对象大小、对象数、partial
情况和调试开关。这里也要区分三件事:对象已经被业务持有、对象空闲但还在
slab cache
中、页是否已经还给伙伴系统。drop_caches、slabtop
或单次 cat /proc/slabinfo
只能给现场快照,不能替代按 workload 设计的复现实验。
工程上有三条更稳的判断:
- 频繁 order 大于 0
的分配要假设可能失败,尤其是在中断上下文或内存压力下;能用
vmalloc、分散页、bio vector 或 scatter-gather 时,不要强求大块连续物理内存。 GFP_KERNEL可以睡眠并触发回收;GFP_ATOMIC不能依赖慢速回收路径,失败概率更高。代码路径要按上下文选 GFP flag,而不是事后补重试。- SLUB 调试和 freelist hardening 是排错/安全工具,不是免费开关。它们改变对象布局、填充模式和 slowpath 成本,性能结论必须注明配置。
九、可复现程序与环境
复现程序只生成确定性状态和 SVG,不依赖计时:
cd post/algorithms/55-buddy-slab
python3 reproduce/buddy_slab_sim.py
输出文件:
reproduce/results/buddy_trace.csv:64 页 buddy 的分裂、合并、外部碎片指数;reproduce/results/kmalloc_roundup.csv:请求大小到 size class / 页分配路径的取整;reproduce/results/summary.txt:本文采用的关键数字摘要;buddy-split-merge.svg、migratetype-fragmentation.svg、slub-fastpath.svg:由脚本按固定坐标生成的图。
本文写作环境用于验证脚本和渲染,不把耗时作为结论:验证机为
x86-64、24 个在线 CPU(0-23)、Linux
6.6.87.2-microsoft-standard-WSL2,Python
3.14.5;Linux 源码分析钉到
v6.6。检查命令使用单篇 validator,未运行全站构建。
十、参考资料
源码与官方文档
- Linux v6.6,
include/linux/mmzone.h:MAX_ORDER、enum migratetype、struct free_area。 - Linux v6.6,
mm/internal.h:__find_buddy_pfn()、find_buddy_page_pfn()、page_is_buddy()。 - Linux v6.6,
mm/page_alloc.c:expand()、__rmqueue_smallest()、__free_one_page()、fallbacks、steal_suitable_fallback()。 - Linux v6.6,
include/linux/slub_def.h与mm/slub.c:struct kmem_cache_cpu、struct kmem_cache、__slab_alloc_node()、___slab_alloc()、freelist hardening。 - Linux v6.6,
include/linux/slab.h:KMALLOC_MAX_CACHE_SIZE、kmalloc_caches、kmalloc_size_roundup()。
核心论文与书
- Kenneth C. Knowlton, “A fast storage allocator”,
Communications of the ACM, 1965. DOI:
10.1145/365628.365655。 - Donald E. Knuth, The Art of Computer Programming, Volume 1: Fundamental Algorithms, §2.5C “Buddy systems of storage allocation”, Addison-Wesley。
- Jeff Bonwick, “The Slab Allocator: An Object-Caching Kernel Memory Allocator”, USENIX Summer 1994 Technical Conference。
- Jeff Bonwick, Jonathan Adams, “Magazines and Vmem: Extending the Slab Allocator to Many CPUs and Arbitrary Resources”, USENIX Annual Technical Conference, 2001。
- Paul R. Wilson, Mark S. Johnstone, Michael Neely, David
Boles, “Dynamic storage allocation: A survey and critical
review”, International Workshop on Memory Management, 1995.
DOI:
10.1007/3-540-60368-9_19。
工程资料
- Christoph Lameter, “SLUB: The unqueued Slab allocator”, LKML/LWN, 2007。
- Vlastimil Babka, “[PATCH 0/7] remove SLOB and allow kfree() with kmem_cache_alloc()”, LKML/LWN mirror, 2023-03-10。
- Vlastimil Babka, “[PATCH 00/20] remove the SLAB allocator”, LKML, 2023-11-13。
实验
reproduce/buddy_slab_sim.py:buddy 分裂/合并、migratetype 分组和 kmalloc size-class 取整的确定性模拟。
系列导航: - 上一篇:I/O 调度:在寻道、队列深度与公平性之间取舍 - 下一篇:文件系统中的树:extent、HTree 与 CoW B-tree 的代价
相关阅读: - 用户态内存分配器:size class、线程缓存与碎片边界 - 页面置换算法:从 OPT、LRU 到 ARC 与 Linux 页面回收 - I/O 调度:在寻道、队列深度与公平性之间取舍
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
CPU 调度:CFS 的虚拟运行时间与 EEVDF 的虚拟截止期
从比例份额调度的论文谱系出发,对照 Linux v6.6 与 v6.12 fair.c 源码,解释 CFS 的 vruntime、EEVDF 的 lag/eligible/deadline,并用确定性模拟复现延迟与 lag 的差异。
I/O 调度:在寻道、队列深度与公平性之间取舍
从电梯算法到 blk-mq,解释 Linux I/O 调度器为何在 HDD 上排序、在共享设备上保公平、在 NVMe 上常选择 none,并用确定性模拟展示寻道距离与队列尾延迟的取舍。
用户态内存分配器:size class、线程缓存与碎片边界
从 Wilson 分配器综述到 jemalloc、gperftools tcmalloc 与 mimalloc 的源码路径,解释 size class、线程缓存、跨线程释放和 RSS 碎片;用可复现实验说明不能只凭 allocator 名字下结论。
页面置换算法:从 OPT、LRU 到 ARC 与 Linux 页面回收
从 Bélády OPT 与栈算法出发,用可复现的模拟实验对比 FIFO、LRU、CLOCK、2Q、ARC 在循环与扫描负载下的命中率,再对照 Linux 6.12 源码说明 active/inactive、workingset 与 kswapd/direct reclaim 的真实分工。