读文件时,文件系统至少要回答两个问题:文件内逻辑块 \(l\) 在哪一个物理块;目录名
foo.db 对应哪个 inode。普通 B-tree
的节点分裂和外存模型已经在 B-tree
深度解剖
里讲过,这里只看文件系统把树改造成什么样,以及这些改造带来什么代价。
本文的源码结论都钉在 Linux v6.6:ext4 的
fs/ext4/ext4_extents.h、fs/ext4/extents.c、fs/ext4/namei.c,btrfs
的 include/uapi/linux/btrfs_tree.h 与
fs/btrfs/ctree.h,XFS 的
fs/xfs/libxfs/xfs_format.h。实验只统计节点数和字节数,不用
wall-clock 时间;复现程序在同目录
reproduce/run.py。
一、树在文件系统里解决的不是同一个问题
同样叫“树”,ext4、btrfs 和 XFS 的目标并不一样:
| 结构 | 键 | 值 | 主要问题 | 版本边界 |
|---|---|---|---|---|
| ext4 extent tree | 文件逻辑块号 | 物理起点与长度 | 用连续区间替代逐块指针 | Linux v6.6 fs/ext4/extents.c |
| ext4 HTree | 文件名 hash | 目录块号 | 大目录按名字查找 | Linux v6.6 fs/ext4/namei.c |
| btrfs CoW B-tree | (objectid, type, offset) |
变长 item | 快照、校验和、引用计数与事务提交 | Linux v6.6
include/uapi/linux/btrfs_tree.h |
| XFS B+tree 族 | 空闲区间、inode、文件 extent、反向映射等 | 各类记录 | 多 Allocation Group 并行分配与可修复性 | Linux v6.6 fs/xfs/libxfs/ |
三个常见误解先放在前面:
- ext4 的 extent tree 不是“每个文件一棵任意大的
B-tree”。inode 的
i_data只有 60 字节,先内联一个 header 和最多 4 条 extent;超出后才分配树块。 - HTree 不是保存文件名的 B-tree。它按目录名 hash 找到叶子目录块,叶子里仍是线性目录项,碰撞还要继续比较名字。
- btrfs 的 CoW B-tree 不是“每写 4KiB 就必然 17 倍写放大”。单次小更新确实要复制路径;一个事务内多次更新会共享上层路径,数据压缩、延迟分配和日志树也会改变实际写入量。
二、ext4 extent tree:把逐块指针压缩成区间
ext2/早期 ext3 的 inode 采用直接块、一级间接、二级间接、三级间接指针。这个设计能表达大文件,但连续文件也要记录每个块号。extent 改成记录区间:
struct ext4_extent {
    __le32 ee_block;    /* first logical block extent covers */
    __le16 ee_len;      /* number of blocks covered by extent */
    __le16 ee_start_hi; /* high 16 bits of physical block */
    __le32 ee_start_lo; /* low 32 bits of physical block */
};
这段结构来自 Linux v6.6
fs/ext4/ext4_extents.h。一条记录 12
字节,表示“从逻辑块 ee_block 开始,长度为
ee_len,映射到物理块
ee_start_hi:ee_start_lo”。同一个文件中的 extent
按逻辑块号递增。
ee_len
的最高位不是普通长度位。源码注释给出边界:initialized extent
最多 \(2^{15}=32768\)
块;unwritten extent 最多 \(2^{15}-1=32767\) 块。以 4KiB
块计,一条 initialized extent 最多覆盖 128MiB。
节点容量来自源码公式
每个 extent 节点都有 12 字节 header:
struct ext4_extent_header {
    __le16 eh_magic;
    __le16 eh_entries;
    __le16 eh_max;
    __le16 eh_depth;
    __le32 eh_generation;
};
内部节点的条目是
struct ext4_extent_idx,也是 12
字节;叶节点条目是 struct ext4_extent。Linux
v6.6 的 ext4_ext_space_block() 和
ext4_ext_space_block_idx() 都用同一个公式:
\[ \left\lfloor \frac{\text{blocksize} - \text{sizeof(header)}}{\text{sizeof(entry)}} \right\rfloor. \]
4KiB 块下得到 \(\lfloor(4096-12)/12\rfloor=340\)
条。inode 内联空间来自
EXT4_I(inode)->i_data,即 60
字节,所以根为叶子时最多放 \(\lfloor(60-12)/12\rfloor=4\) 条
extent;根为内部节点时也最多 4 个索引项。
深度
eh_depth |
形态 | 最大叶 extent 数(4KiB 块) |
|---|---|---|
| 0 | inode 内联叶子 | 4 |
| 1 | inode 索引 → 叶块 | \(4 \times 340 = 1360\) |
| 2 | inode 索引 → 索引块 → 叶块 | \(4 \times 340^2 = 462400\) |
| 3 | 再多一层索引 | \(4 \times 340^3 \approx 1.57 \times 10^8\) |
EXT4_MAX_EXTENT_DEPTH 在 v6.6 中是
5;ext4_find_extent() 发现 inode depth 小于 0
或大于这个常量就报 -EFSCORRUPTED。
查找路径:每层二分,不扫描整棵树
ext4_find_extent() 的路径是:从 inode 内联
header 取当前深度;如果还没到叶子,就调用
ext4_ext_binsearch_idx()
在当前索引节点里二分,读出下一层 extent tree
block;到叶子后调用 ext4_ext_binsearch()
找“起点不大于目标块号的最后一条
extent”。最后还要检查目标块是否落在该 extent 的范围内。
因此单次映射的元数据访问数由树高决定,节点内查找由二分决定。更重要的是,连续大文件根本不需要很多
extent:顺序写产生的相邻区间会在插入时尝试合并。v6.6 的
ext4_can_extents_be_merged() 要求:
- 两条 extent 的 written/unwritten 状态相同;
- 前一条逻辑起点加长度等于后一条逻辑起点;
- 长度相加不超过 initialized 或 unwritten 上限;
- 前一条物理起点加长度等于后一条物理起点。
这也是 extent 与普通 B-tree 键值对的差异:extent tree 不只是索引,还把“连续性”编码进记录格式与插入逻辑。
与逐块指针的元数据差异
下面的图来自
reproduce/run.py:文件大小固定为 1GiB,块大小
4KiB,共 262144 个逻辑块。逐块指针只按每块 4
字节计算;extent 只按每条 12 字节 payload 计算,不把
header、树块填充和日志开销算进去。
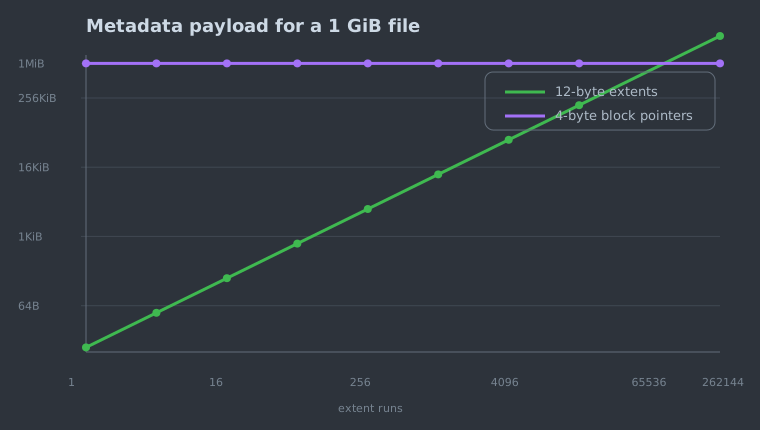
| extent run 数 | 平均每 run 块数 | extent payload | 逐块指针 payload | 指针/extent 比值 |
|---|---|---|---|---|
| 1 | 262144 | 12B | 1MiB | 87381.33 |
| 1024 | 256 | 12KiB | 1MiB | 85.33 |
| 4096 | 64 | 48KiB | 1MiB | 21.33 |
| 262144 | 1 | 3MiB | 1MiB | 0.33 |
结论不是“extent 永远更省”。当每个 run 只有 1 个块时,12 字节 extent 比 4 字节块指针更大;extent 的优势来自文件系统努力把分配保持为长 run。
三、ext4 HTree:目录查找按 hash 分流
extent tree 解决文件数据块映射;目录的瓶颈是名字查找。Daniel Phillips 在 ALS 2001 的 “A Directory Index for EXT2” 中提出 HTree,用 hash 把大目录分到不同叶块。Linux v6.6 的 ext4 仍能看到这个设计。
HTree 的核心条目很小:
struct dx_entry {
    __le32 hash;
    __le32 block;
};
根块比较特殊。按 ext2
目录兼容性,目录文件第一个数据块开头仍放 . 和
..;随后是 dx_root_info,里面有
hash_version、info_length 和
indirect_levels;再往后才是
dx_entry
数组。内部节点则用一个伪造的空目录项隐藏索引数据,让旧的线性扫描代码可以跳过它。
dx_probe()
的查找流程可以直接从源码读出来:
- 读取目录第 0 块为 root;
- 检查 hash 版本,只接受
DX_HASH_TEA、DX_HASH_HALF_MD4、DX_HASH_LEGACY或DX_HASH_SIPHASH; - 对目标文件名调用
ext4fs_dirhash()得到 hash; - 在每层
dx_entry中二分,找最后一个hash <= target_hash的条目; - 按
block读取下一层,直到叶子目录块; - 在叶子块里的普通目录项中比较真实文件名。
HTree 因此有两个边界:它按 hash 而不是字典序组织目录;hash 碰撞或同一叶块内多个候选项仍要比较文件名。内核文档也强调,叶子目录块看起来仍像经典线性目录块。
四、btrfs CoW B-tree:一套键空间承载多种元数据
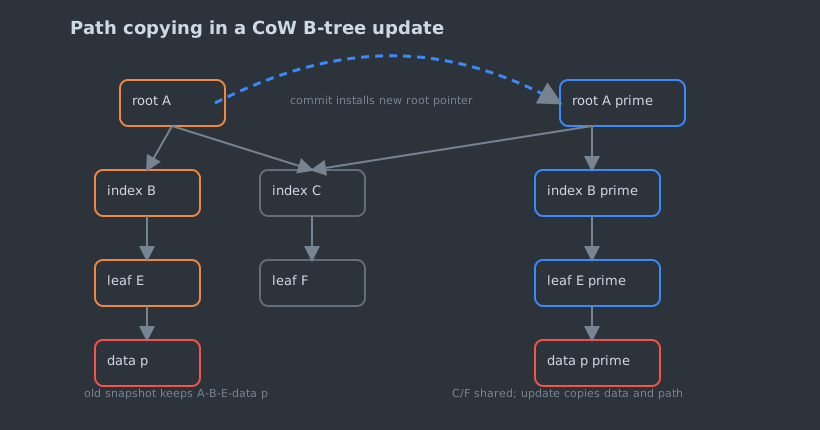
btrfs 把“写时复制(copy-on-write, CoW)”放在核心路径上。修改一个叶子 item 时,不在原地覆盖旧叶子,而是写新叶子、复制父节点并更新指针,一直复制到根;事务提交时安装新的根指针。旧根仍可作为快照入口引用旧版本。
键与 item 类型
Linux v6.6 的 struct btrfs_key
是三元组:
struct btrfs_key {
    __u64 objectid;
    __u8 type;
    __u64 offset;
} __attribute__ ((__packed__));
include/uapi/linux/btrfs_tree.h
还定义了多个树 objectid:root tree、extent tree、chunk
tree、device tree、fs tree、checksum tree 等。常见 item type
包括:
| item type | 数值 | 含义 |
|---|---|---|
BTRFS_INODE_ITEM_KEY |
1 | inode 元数据 |
BTRFS_DIR_ITEM_KEY |
84 | 文件名查找用目录项 |
BTRFS_EXTENT_DATA_KEY |
108 | 文件 extent 数据 |
BTRFS_EXTENT_CSUM_KEY |
128 | 数据 extent 校验和 |
BTRFS_EXTENT_ITEM_KEY |
168 | extent 分配与引用计数 |
btrfs 设计文档说明,上层节点保存
[key, block pointer],叶子节点分成固定大小 item
数组和从另一端增长的变长 item
data。fs/btrfs/ctree.h 中
BTRFS_LEAF_DATA_SIZE(info)
也体现了这个布局:叶子可用空间是
nodesize - sizeof(struct btrfs_header)。
CoW 的学术谱系与工程折中
WAFL 论文(Hitz、Lau、Malcolm,USENIX Winter 1994)把“写到新位置,再原子切换根”的思想用于 NFS 文件服务器。Ohad Rodeh 的 “B-trees, Shadowing, and Clones”(ACM TOS 2008)系统讨论了 B-tree shadowing 与 clones;Rodeh、Bacik、Mason 的 btrfs 论文(ACM TOS 2013)把这条线落到 Linux 文件系统。
争论点也在这里:CoW 让快照、崩溃一致性和引用计数天然统一,却把原来一次原地页更新变成“复制从叶到根的路径”。btrfs 工程实现用事务合并、延迟分配、log tree、压缩和可选的 NOCOW 属性缓解这个问题,但这些缓解都有语义或场景边界。数据库随机覆盖写正是边界最明显的负载之一。
五、XFS:不是一棵树,而是一组面向查询的 B+tree
XFS 论文 “Scalability in the XFS File System”(Sweeney、Doucette、Hu、Anderson、Nishimoto、Peck,USENIX ATC 1996)讨论的重点不是某一种树形,而是整个文件系统如何扩展到大容量和并发。XFS 的关键工程选择是 Allocation Group(AG):每个 AG 有自己的分配元数据和锁,多个线程可以在不同 AG 上并行工作。
Linux v6.6 的 fs/xfs/libxfs/xfs_format.h
能看到这种“多棵树按查询建索引”的风格:
- AGF 中的 B-tree 编号覆盖 bno、cnt、rmap。bno tree 按起始块号组织空闲 extent;cnt tree 按长度组织空闲 extent;rmap tree 做反向映射。
- inode 的
di_format可以是XFS_DINODE_FMT_EXTENTS或XFS_DINODE_FMT_BTREE。小文件 extent 能内联在 inode fork 中;多到放不下时变成 bmbt。 xfs_bmbt_rec是两个 big-endian 64 位字。源码注释写明文件 offset 字段为 54 bits。xfs_rmap_rec记录rm_startblock、rm_blockcount、rm_owner、rm_offset,让系统能从物理块反查所有者。
这与 ext4 的渐进式设计不同。ext4 extent tree 是把 inode 的块指针区重新解释成一个小 B-tree;XFS 则从一开始把“空闲空间按位置查”“空闲空间按长度查”“文件逻辑块映射”“物理块反查所有者”拆成不同索引。好处是查询目标明确,代价是实现复杂度和修复逻辑都更高。
六、实验:extent 省的是条目,CoW 贵在路径复制
实验脚本是纯 Python:
cd post/algorithms/56-fs-trees
python3 reproduce/run.py
输出文件:
reproduce/results/extent_metadata.csv:1GiB 文件在不同 extent run 数下的映射 payload;reproduce/results/cow_vs_inplace.csv:CoW B-tree 与原地更新 B-tree 的节点写入模型;extent-metadata.svg、write-amplification.svg、cow-path-copy.svg:正文图。
环境用于说明可复现性,不参与计时结论:Linux 内核版本、CPU
调度、负载不会影响这些计数。脚本使用固定种子
1,17,42,每个 batch 大小每个种子 2000
次事务。
CoW 模型口径
模型参数来自常见 btrfs 口径,但不是对 btrfs 生产写路径的完整模拟:
| 参数 | 值 |
|---|---|
| 记录数 | 1000000 |
| 每叶记录数 | 256 |
| fanout | 128 |
| 叶子数 | 3907 |
| root-to-leaf 层数 | 3 |
| 节点大小 | 16KiB |
| 逻辑更新大小 | 4KiB |
| 根指针提交写入 | 4KiB |
一次事务随机更新若干叶子。原地更新模型只重写被触碰的叶子页;CoW 模型复制每个被触碰叶子到根的所有唯一节点,再加一次根指针写入。多次更新在同一事务里可能共享父节点,因此 batch 越大,平均到每次更新的 CoW 字节数越低。
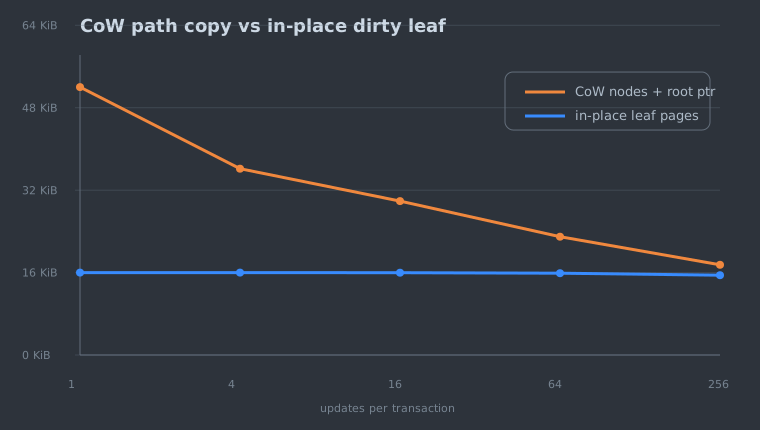
| 每事务更新数 | CoW tree nodes/update | CoW bytes/update | 原地 bytes/update | CoW / 原地 | CoW / 4KiB 逻辑更新 |
|---|---|---|---|---|---|
| 1 | 3.0000 | 52.00KiB | 16.00KiB | 3.25 | 13.00 |
| 4 | 2.1978 | 36.16KiB | 15.99KiB | 2.26 | 9.04 |
| 16 | 1.8514 | 29.87KiB | 15.97KiB | 1.87 | 7.47 |
| 64 | 1.4311 | 22.96KiB | 15.88KiB | 1.45 | 5.74 |
| 256 | 1.0928 | 17.50KiB | 15.49KiB | 1.13 | 4.38 |
这个表说明了两个边界:单次小随机写确实会放大;把多个修改合进同一事务会摊薄上层路径复制。真实文件系统还会加入数据块、校验和、日志、分配器和设备层写放大,不能把这张表当成某个文件系统的性能排名。
七、工程边界与开放问题
哪些结论可以直接带走
- 顺序写大文件:extent 的关键收益是把长连续区间压成少量记录。预分配、延迟分配和减少交错写入,都是在帮文件系统制造长 run。
- 大目录:HTree 把名字查找从线性扫描改成 hash 分流,但它不提供全局字典序,碰撞仍要比较名字。
- 快照与一致性:CoW B-tree 的优势是版本根天然共存;代价是路径复制、引用计数维护和空间回收复杂度。
- 大规模分配器:XFS 的经验是为不同查询维护不同 B+tree,而不是用一棵万能树回答所有问题。
仍在变化的地方
文件系统树的争论没有结束。CoW 系统继续在“快照/校验/一致性”与“随机覆盖写放大”之间折中;XFS 的在线 scrub 和 rmap 依赖更强的反向索引;btrfs 与 bcachefs 都在用日志化、批处理或更紧凑节点格式降低 CoW 更新成本。这里没有给“哪个文件系统最好”的结论,因为那取决于工作负载:目录项数量、文件 run 长度、快照保留时间、覆盖写比例和可接受的恢复语义都会改变答案。
八、参考资料
规范与文档
- Linux kernel documentation, “ext4 Data Structures and
Algorithms”,
filesystems/ext4/,特别是 dynamic structures 与 directory entries/HTree 章节。 - Btrfs documentation, “Btrfs design”,说明 key/item/header、叶子布局、checksum tree、目录索引和引用计数 extent。
源码
- Linux v6.6,
fs/ext4/ext4_extents.h:struct ext4_extent、struct ext4_extent_idx、struct ext4_extent_header、EXT4_MAX_EXTENT_DEPTH、EXT_INIT_MAX_LEN。 - Linux v6.6,
fs/ext4/extents.c:ext4_ext_space_block()、ext4_ext_space_root()、ext4_find_extent()、ext4_ext_binsearch_idx()、ext4_ext_binsearch()、ext4_can_extents_be_merged()。 - Linux v6.6,
fs/ext4/namei.c:struct dx_entry、struct dx_root、dx_probe()。 - Linux v6.6,
include/uapi/linux/btrfs_tree.h:BTRFS_MAX_LEVEL、tree objectid、item type、struct btrfs_key。 - Linux v6.6,
fs/btrfs/ctree.h:BTRFS_LEAF_DATA_SIZE()、BTRFS_NODEPTRS_PER_BLOCK()、btrfs_cow_block()、btrfs_copy_root()。 - Linux v6.6,
fs/xfs/libxfs/xfs_format.h:XFS_DINODE_FMT_EXTENTS、XFS_DINODE_FMT_BTREE、xfs_bmbt_rec、xfs_rmap_rec。
核心论文
- Rudolf Bayer and Edward M. McCreight, “Organization and Maintenance of Large Ordered Indexes”, Acta Informatica 1(3), 1972。
- Daniel Phillips, “A Directory Index for EXT2”, 5th Annual Linux Showcase & Conference, USENIX, 2001。
- Dave Hitz, James Lau, and Michael Malcolm, “File System Design for an NFS File Server Appliance”, USENIX Winter Technical Conference, 1994。
- Ohad Rodeh, “B-trees, Shadowing, and Clones”, ACM
Transactions on Storage 3(4), Article 15, 2008。DOI:
10.1145/1326542.1326544。 - Ohad Rodeh, Josef Bacik, and Chris Mason, “BTRFS: The
Linux B-tree Filesystem”, ACM Transactions on
Storage 9(3), Article 9, 2013。DOI:
10.1145/2501620.2501623。 - Adam Sweeney, Doug Doucette, Wei Hu, Curtis Anderson, Mike Nishimoto, and Geoff Peck, “Scalability in the XFS File System”, USENIX Annual Technical Conference, 1996。
实验
- 本文同目录
reproduce/run.py:生成 extent payload 对比、CoW 路径复制模型和三张 SVG;固定种子1,17,42,只统计节点数与字节数。
系列导航: - 上一篇:伙伴系统与 SLUB:Linux 物理页和小对象分配的边界 - 下一篇:epoll 的数据结构:红黑树、就绪队列与回调机制
相关阅读: - B-tree 深度解剖:从磁盘 I/O 模型到 boltdb 源码 - B+tree 与 LSM-tree:原地更新与异地更新的读、写、空间代价
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【存储工程】小文件问题:为什么文件数量比文件大小更致命
系统分析小文件在块分配、元数据管理、磁盘寻道和网络协议四个层面的放大效应,用数据量化 slack space、inode 开销和 syscall 成本,给出应用层聚合与对象存储归档两种工程方案。
【存储工程】磁盘空间耗尽:从 70% 到 ENOSPC 的行为退化链
逐层拆解 ext4、XFS、Btrfs、ZFS 从 70% 填充到 100% 耗尽过程中的块分配退化、碎片化加剧和 ENOSPC 故障模式,给出各文件系统的容量红线、监控阈值和应急恢复方法。
【存储工程】ext4 架构与调优
ext4 是 Linux 世界中使用最广泛的本地文件系统(Local Filesystem)。从 2008 年合入内核主线至今, 它已经在无数生产服务器、嵌入式设备以及桌面系统上稳定运行了十余年。本文将从磁盘布局、 核心数据结构、日志机制、分配策略等维度,对 ext4 进行全面剖析,并结合实际调优场景给出 可落地的最佳…
【存储工程】文件系统选型与基准测试
在生产环境中,文件系统(Filesystem)的选择直接影响存储栈的性能上限、数据安全边界和运维复杂度。本文将从设计目标、元数据性能、数据吞吐、典型业务场景、基准测试方法论等多个维度,对 ext4、XFS、Btrfs(B-tree Filesystem)、ZFS(Zettabyte File System)四种主流文件…