关于 epoll,流传最广的有四种说法:epoll 是 \(O(1)\)
的;内核选红黑树是因为它最坏情况有界;EPOLLEXCLUSIVE
解决了多个线程在同一个 epoll 实例上等待的惊群;ET 比 LT
快。这四句话都不准确。epoll_wait
的代价与就绪项数 \(k\)
成正比,而不是常数;红黑树取代哈希表的直接原因是哈希表按用户给的大小提示预分配内存,可以被耗尽;同一个
epoll
实例上的等待者本来就是互斥唤醒的,EPOLLEXCLUSIVE
针对的是多个 epoll 实例监听同一个文件;ET 与 LT
在内核里走的是同一条收割路径,差别只在收割后要不要把条目放回就绪链表。
本文按”代价模型 → 数据结构 → 注册与回调 → 收割 →
唤醒与惊群 → 锁的演进 →
实测与争论”的顺序展开。所有内核细节以 Linux v6.12 的
fs/eventpoll.c 为准(v6.12 标签本身,不含之后的
stable
更新),较长的代码片段是节选,省略处在片段首行注明。所有数字来自同目录
reproduce/
下的程序或所引文献,实验环境见第九节。

一、从 select 到 epoll:代价挪到了哪里
select 与 poll 每次调用做了什么
select
用三个位图描述要监听的描述符,位图大小由
FD_SETSIZE 固定为 1024,select(2)
手册明确写着这个限制”不会改变”。poll
换成用户传入的 struct pollfd 数组,去掉了 1024
的上限,但每次调用的工作量没有变。以 v6.12
fs/select.c 中的 do_sys_poll 与
do_poll 为例,一次
poll(fds, n, timeout) 要做四件事:
- 把 \(n\) 个
pollfd从用户态拷进内核,放在按页分块的poll_list里; - 第一遍对每个描述符调用
vfs_poll(),并通过__pollwait()在每个文件的等待队列上挂一个等待项,共 \(n\) 个; - 没有就绪项就睡眠;任何一个文件唤醒它,都要把 \(n\) 个描述符重新
vfs_poll()一遍(第二遍起pt->_qproc被置空,不再重复挂等待项); - 返回前
poll_freewait()摘掉 \(n\) 个等待项,再逐个把revents写回用户态。
所以不论就绪的描述符有几个,单次调用的代价都是 \(\Theta(n)\)。空闲连接越多,每次等待白白付出的越多。
epoll 把代价拆开
epoll 把”声明关心哪些描述符”和”取回已就绪的事件”拆成两个系统调用:
epoll_ctl(ADD)每个描述符只做一次:红黑树插入 \(O(\log n)\),并在目标文件的等待队列上长期挂一个等待项;- 目标文件每唤醒一次,回调
ep_poll_callback()就把对应条目挂进就绪链表,\(O(1)\); epoll_wait只处理就绪链表上的 \(k\) 个条目,\(\Theta(k)\)。

代价并没有消失,而是挪了地方:注册时付 \(O(\log n)\),每个事件付一次回调,空闲描述符付的是常驻内存(第九节算出每个约 192 字节)和目标文件等待队列上的一个节点。第九节的实测和第十节的争论都会回到这一点:当空闲描述符很少、或者兴趣集合频繁变化时,这笔账未必划算。
学术谱系
epoll 不是凭空出现的,它是一条研究线索在 Linux 上的工程落地:
| 年份 | 工作 | 贡献 |
|---|---|---|
| 1998 | Banga & Mogul,USENIX ATC | 广域网延迟使繁忙的事件驱动服务器同时持有大量连接,而
select()
与描述符分配算法都随连接数扩展很差;改写这两处后 Web 代理与
Web 服务器吞吐最多提升 58% |
| 1999 | Banga, Mogul & Druschel,USENIX ATC | 提出 declare_interest() 与
get_next_event():兴趣集合在内核里增量维护,事件显式排队交付;2000
个连接时吞吐提升 28% |
| 2000 | Provos & Lever,USENIX ATC FREENIX | 在 Linux 上实现并评测 Solaris 风格的
/dev/poll 接口 |
| 2000 / 2001 | Lemon,kqueue | 2000 年 4 月提交到 FreeBSD,随 FreeBSD 4.1 发布,2001 年发表于 USENIX ATC FREENIX;用通用的过滤器模型同时覆盖描述符、进程、信号等多类事件 |
| 2001 | Chandra & Mosberger,USENIX ATC | 比较 Linux 上多种事件分发机制的可扩展性 |
| 2002 | Libenzi,epoll | 合入 Linux 2.5.44(2002 年 10 月),glibc 2.3.2 提供封装 |
| 2004 | Gammo, Brecht, Shukla & Pariag,OLS | 在 Linux 2.6.5 上系统对比 select、poll、epoll,发现没有空闲连接时 epoll 并不占优(第十节) |
epoll 的接口几乎就是 1999
年论文里”声明兴趣、取回事件”模型的直接对应;它与 kqueue
的主要差别是只能监听”文件描述符的可读写状态”这一类事件,定时器和信号要借助
timerfd、signalfd 转成文件。
二、三个系统调用与两个核心结构
调用关系
flowchart LR
    A["epoll_create1(flags)"] --> B["do_epoll_create: ep_alloc + anon inode file"]
    C["epoll_ctl(epfd, op, fd, ev)"] --> D["do_epoll_ctl: take mtx, ep_find"]
    D -->|ADD| E["ep_insert"]
    D -->|MOD| F["ep_modify"]
    D -->|DEL| G["ep_remove_safe"]
    H["epoll_wait(epfd, evs, max, timeout)"] --> I["do_epoll_wait -> ep_poll"]
    I --> J["ep_send_events"]
    K["last fput of a watched file"] --> L["__fput -> eventpoll_release -> eventpoll_release_file"]
epoll_create1 分配一个
struct eventpoll,把它作为
private_data 挂在一个名为
[eventpoll] 的匿名 inode
文件上,返回这个文件的描述符。老接口
epoll_create(size) 的参数自 2.6.8
起被忽略,只要求大于
0(第三节解释原因);epoll_create1 自 2.6.27
起提供,唯一的标志是 EPOLL_CLOEXEC。
最后一行容易被忽略:被监听的文件在最后一个引用释放时(fs/file_table.c
的 __fput),才会调用
eventpoll_release() 把它从所有 epoll
实例里摘掉。关闭某一个描述符并不等于关闭文件,第三节和第十一节会用到这一点。
struct eventpoll
/* Linux v6.12 fs/eventpoll.c(节选,省略了 busy poll 与 lockdep 字段;中文注释为本文所加,替换了原注释) */
struct eventpoll {
    struct mutex mtx;            /* ctl 操作、收割循环、文件释放路径持有 */
    wait_queue_head_t wq;        /* sys_epoll_wait() 的等待队列 */
    wait_queue_head_t poll_wait; /* 这个 epoll fd 自己被 poll 时用 */
    struct list_head rdllist;    /* 就绪链表 */
    rwlock_t lock;               /* 保护 rdllist 与 ovflist */
    struct rb_root_cached rbr;   /* 兴趣表:全部被监听的 epitem */
    struct epitem *ovflist;      /* 收割期间到达的事件,单链表 */
    struct wakeup_source *ws;
    struct user_struct *user;
    struct file *file;
    u64 gen;                     /* 嵌套 epoll 环检测用 */
    struct hlist_head refs;
    refcount_t refcount;         /* 与 epitem->dying 一起决定何时释放 */
};
v6.12 里 lock 是
rwlock_t,不是很多资料里写的
spinlock_t。这把锁在不同版本之间换过四次,2025
年又改回了自旋锁,第八节专门讨论。文件开头的注释给出了三级锁的获取顺序:全局的
epnested_mutex(只在把一个 epoll fd 加进另一个
epoll fd 时使用),然后是 ep->mtx,最后是
ep->lock。
struct epitem
/* Linux v6.12 fs/eventpoll.c(字段完整;中文注释为本文所加,替换了原注释) */
struct epitem {
    union {
        struct rb_node rbn;     /* 挂在 ep->rbr 上 */
        struct rcu_head rcu;    /* 释放时复用这块空间 */
    };
    struct list_head rdllink;       /* 挂在 ep->rdllist 上 */
    struct epitem *next;            /* 挂在 ep->ovflist 上 */
    struct epoll_filefd ffd;        /* 键:(struct file *, int fd) */
    bool dying;
    struct eppoll_entry *pwqlist;   /* 挂在目标文件等待队列上的条目 */
    struct eventpoll *ep;           /* 所属 epoll 实例 */
    struct hlist_node fllink;       /* 挂在 file->f_ep 上 */
    struct wakeup_source __rcu *ws; /* EPOLLWAKEUP 用 */
    struct epoll_event event;       /* 用户注册的事件掩码与 data */
};
一个 epitem 同时属于四个集合:所属 epoll
实例的红黑树、就绪链表或 ovflist、目标文件的
f_ep 链表,并通过 eppoll_entry
挂在目标文件的等待队列上。

结构体上方的注释写着:“there can be many thousands of
these on a server and we do not want this to take another
cache line”。eventpoll_init() 里有一句
BUILD_BUG_ON(sizeof(void *) <= 8 && sizeof(struct epitem) > 128)
把这个约束写死,epi_cache 又以
SLAB_HWCACHE_ALIGN
创建。reproduce/epitem_layout.c 按 v6.12
的定义在用户态复刻了布局:x86-64 上
sizeof(struct epitem) 是 120 字节,按 64
字节缓存行对齐后占 128 字节的 slab
槽位,正好两条缓存行。
next 字段有一个约定值
EP_UNACTIVE_PTR(即
(void *) -1L),表示”没有挂在 ovflist
上”;rdllink
指向自身表示”不在就绪链表上”,ep_is_linked()
就是检查这一点。
三、兴趣表:为什么是红黑树
从哈希表到红黑树
2.6.0 的 epoll
用的是哈希表:epoll_create(size)
的参数被用来计算 hashbits,上限
EP_MAX_HASH_BITS 为 17,按页预分配桶数组。2.6.8
的更新日志里有 Libenzi 的补丁 “[PATCH] epoll: replace the
file lookup hash with
rbtrees”,给出的理由是:哈希表按用户提示预分配,最多可达 1
MB,恶意用户或 LTP
测试套件都能借此耗尽内存。改成红黑树后内存与实际注册的描述符数成正比,size
参数从此只剩”必须大于 0”这个兼容要求。
很多文章给红黑树补上了其他理由,比如”哈希表 rehash
会停顿几百毫秒”“AVL
删除旋转太多”。这些说法在补丁说明和源码注释里都找不到。可以确定的只有两点:原始动机是内存预分配问题;兴趣表的操作只发生在
epoll_ctl
和文件释放路径上,都不在事件热路径里,\(O(\log n)\)
的查找对它足够。红黑树与 AVL 在内核里的一般取舍见红黑树 vs
AVL。
4.14 起 rbr 换成了
rb_root_cached,额外缓存最左节点。v6.12 中
rb_first_cached()
用于遍历整棵树的场合,例如关闭 epoll 实例时的
ep_clear_and_put() 和嵌套 epoll 的环检测。
键是 (file, fd),不是 fd
/* Linux v6.12 fs/eventpoll.c */
static inline int ep_cmp_ffd(struct epoll_filefd *p1,
                 struct epoll_filefd *p2)
{
    return (p1->file > p2->file ? +1:
            (p1->file < p2->file ? -1 : p1->fd - p2->fd));
}
先比 struct file
指针,再比描述符号。于是同一个打开的文件经
dup()
得到的两个描述符可以分别注册、各用各的事件掩码(epoll(7)
的问答部分明确允许这样做)。反过来,这个键也带来了 epoll
最著名的语义陷阱:
flowchart LR
    subgraph proc["process fd table"]
        F5["fd 5"]
        F7["fd 7 = dup(5)"]
    end
    FILE["struct file (socket)"]
    F5 --> FILE
    F7 --> FILE
    subgraph ep["epoll interest list"]
        E1["epitem key (file, 5)"]
    end
    E1 -. "f_ep link" .-> FILE
    X["close(5)"] --> Q{"other references to file?"}
    Q -->|"yes: fd 7, or a forked child"| R["epitem stays, events keep reporting fd 5"]
    Q -->|no| S["__fput -> eventpoll_release removes epitem"]
epoll 登记的是打开文件描述(file
description),不是用户态的描述符号。close(5)
只减少引用计数;只要 fd 7 或者 fork
出来的子进程还引用着这个文件,eventpoll_release()
就不会被调用,epitem 留在兴趣表里,事件照样以
data 里的旧值报告出来,而用户已经无法再用
EPOLL_CTL_DEL 删掉它,因为 fd 5
已经不存在了。epoll(7)
的问答对此有专门一条。实践上的对策是先
EPOLL_CTL_DEL 再 close。
谁保护这棵树
红黑树只在持有 ep->mtx
时访问。ep_find()、ep_insert()、ep_remove_safe()
都在 do_epoll_ctl() 取得 mtx
之后调用,而这条路径会以 GFP_KERNEL
分配内存、可能睡眠,所以这里用的是 mutex
而不是自旋锁。回调函数从不碰红黑树,这使得树和回调可以使用两把不同的锁。
四、注册与回调:把 epitem 挂到文件的等待队列上
ep_insert 的调用链
flowchart TD
    A["ep_insert()"] --> B["percpu counter vs max_user_watches"]
    B --> C["kmem_cache_zalloc(epi_cache)"]
    C --> D["attach_epitem(): link into file->f_ep"]
    D --> E["ep_rbtree_insert()"]
    E --> F["ep_item_poll(epi, epq.pt)"]
    F --> G["vfs_poll(): f_op->poll, e.g. sock_poll -> tcp_poll"]
    G --> H["sock_poll_wait() -> poll_wait()"]
    H --> I["ep_ptable_queue_proc(): alloc eppoll_entry, func = ep_poll_callback"]
    I --> J{"EPOLLEXCLUSIVE?"}
    J -->|yes| K["add_wait_queue_exclusive(): append at tail"]
    J -->|no| L["add_wait_queue(): insert at head"]
    F --> M{"revents already set?"}
    M -->|yes| N["list_add_tail to rdllist, wake_up ep->wq"]
关键在于 f_op->poll
这个接口被复用了两次。注册时传入的 poll_table
带着 ep_ptable_queue_proc,驱动在
poll_wait() 里回调它,epoll
借机把自己的等待项挂到驱动的等待队列上;收割时传入的
poll_table
回调为空(ep_send_events() 里的
init_poll_funcptr(&pt, NULL)),同一个
f_op->poll
就只返回当前的就绪掩码。任何实现了 ->poll
的文件(socket、管道、eventfd、timerfd、另一个 epoll
fd)都能被 epoll
监听,原因就在这里;普通磁盘文件没有等待队列,epoll_ctl
对它返回 EPERM。
/* Linux v6.12 fs/eventpoll.c(节选) */
static void ep_ptable_queue_proc(struct file *file, wait_queue_head_t *whead,
                 poll_table *pt)
{
    /* ... 取出 epi,分配 pwq ... */
    init_waitqueue_func_entry(&pwq->wait, ep_poll_callback);
    pwq->whead = whead;
    pwq->base = epi;
    if (epi->event.events & EPOLLEXCLUSIVE)
        add_wait_queue_exclusive(whead, &pwq->wait);
    else
        add_wait_queue(whead, &pwq->wait);
    pwq->next = epi->pwqlist;
    epi->pwqlist = pwq;
}两个入队函数的位置不同:add_wait_queue() 经
__add_wait_queue() 插到队头(跳过带
WQ_FLAG_PRIORITY
的条目),add_wait_queue_exclusive()
插到队尾。第七节的负载分布实验会看到这个差别的后果。
do_epoll_ctl() 在 ADD 和 MOD
时都会给掩码无条件加上
EPOLLERR | EPOLLHUP,所以这两个事件不注册也会收到。
ep_poll_callback
目标文件的状态变化时,驱动调用 wake_up*()
系列函数,__wake_up_common()
依次调用等待队列上每个条目的 func。对 epoll
的条目来说就是 ep_poll_callback():
/* Linux v6.12 fs/eventpoll.c(节选并压缩,省略了 busy poll、wakeup source 与 POLLFREE 处理;中文注释为本文所加) */
static int ep_poll_callback(wait_queue_entry_t *wait, unsigned mode, int sync, void *key)
{
    struct epitem *epi = ep_item_from_wait(wait);
    struct eventpoll *ep = epi->ep;
    __poll_t pollflags = key_to_poll(key);
    unsigned long flags;
    int ewake = 0, pwake = 0;

    read_lock_irqsave(&ep->lock, flags);

    if (!(epi->event.events & ~EP_PRIVATE_BITS))   /* ONESHOT 已触发过 */
        goto out_unlock;
    if (pollflags && !(pollflags & epi->event.events))
        goto out_unlock;                           /* 不是用户关心的事件 */

    if (READ_ONCE(ep->ovflist) != EP_UNACTIVE_PTR) {
        chain_epi_lockless(epi);                   /* 正在收割:进 ovflist */
    } else if (!ep_is_linked(epi)) {
        list_add_tail_lockless(&epi->rdllink, &ep->rdllist);
    }

    if (waitqueue_active(&ep->wq)) {
        if ((epi->event.events & EPOLLEXCLUSIVE) &&
            !(pollflags & POLLFREE)) {
            /* 事件方向与注册的 EPOLLIN / EPOLLOUT 匹配时 ewake = 1 */
        }
        wake_up(&ep->wq);
    }
    if (waitqueue_active(&ep->poll_wait))
        pwake++;

out_unlock:
    read_unlock_irqrestore(&ep->lock, flags);
    if (pwake)
        ep_poll_safewake(ep, epi, pollflags & EPOLL_URING_WAKE);
    if (!(epi->event.events & EPOLLEXCLUSIVE))
        ewake = 1;
    return ewake;
}
这段代码有四处值得停下来看:
- 只拿读锁。回调可能在中断或软中断上下文执行,不能睡眠,所以必须是自旋类的锁;而多个
CPU 上不同文件的回调可以同时持有读锁,入队靠
list_add_tail_lockless()里的cmpxchg和xchg完成。写锁留给其他需要改动rdllist的路径:ep_start_scan()、ep_done_scan(),ep_insert()、ep_modify()、__ep_remove()里的链表操作,以及ep_poll()入睡前的最后检查。 - 已经在就绪链表上就什么也不做。同一个 epitem 在被收割之前,无论文件唤醒多少次,链表上都只有一个节点。
- 唤醒用的是
wake_up(&ep->wq),不是wake_up_locked;wake_up()的nr_exclusive为 1,配合第七节讲的互斥等待项,每次回调只唤醒一个epoll_wait调用者。 - 返回值
ewake决定唤醒是否继续传递。对非 EXCLUSIVE 条目恒为 1;对 EXCLUSIVE 条目,只有当这个 epoll 实例上确实有人在等、且事件方向匹配时才返回 1。第七节会看到这正是EPOLLEXCLUSIVE的全部机制。
一次唤醒的完整路径
sequenceDiagram
    participant RX as TCP receive (softirq)
    participant SQ as socket wait queue
    participant CB as ep_poll_callback
    participant EP as eventpoll
    participant T as task in ep_poll
    RX->>SQ: sk->sk_data_ready = sock_def_readable()
    SQ->>SQ: wake_up_interruptible_sync_poll(EPOLLIN | ...)
    SQ->>CB: __wake_up_common() calls entry->func
    CB->>EP: read_lock_irqsave(ep->lock)
    CB->>EP: link epitem into rdllist (ovflist while harvesting)
    CB->>EP: wake_up(ep->wq), nr_exclusive = 1
    EP->>T: ep_autoremove_wake_function(): runnable
    CB-->>SQ: return ewake
    T->>EP: ep_send_events(): lock mtx, re-poll, copy to user
sock_def_readable() 用
EPOLLIN | EPOLLPRI | EPOLLRDNORM | EPOLLRDBAND
作为 key 调用
wake_up_interruptible_sync_poll(),所以回调能直接从
key 里看到事件方向,不必先调用
->poll。不是所有驱动都会传 key,回调里
pollflags &&
这个判断就是为此准备的。
五、ovflist:收割期间的第二条链
为什么需要它
ep_send_events() 要对每个就绪条目调用
f_op->poll
重新查询,再把结果写进用户缓冲区,这两步都可能睡眠(写用户内存可能触发缺页)。持有
ep->lock
这把自旋类的锁时不能睡眠,所以收割循环只持有
ep->mtx,先在写锁下把 rdllist
整个摘到一个栈上的私有链表
txlist,再释放写锁去遍历它。
问题是遍历期间回调仍然会触发。如果回调照常往
rdllist 上挂,收割循环把 LT 条目放回
rdllist 的动作就必须加锁。v6.12
的做法是在收割期间把 ovflist 从
EP_UNACTIVE_PTR 改成
NULL,回调看到这个值就改挂到
ovflist 上,rdllist
于是专属于收割线程。ep_send_events() 里放回 LT
条目那一行的注释写得很直白:“At this point, no one can
insert into ep->rdllist besides us”。
/* Linux v6.12 fs/eventpoll.c(节选,省略了原有注释;中文注释为本文所加) */
static void ep_start_scan(struct eventpoll *ep, struct list_head *txlist)
{
    lockdep_assert_irqs_enabled();
    write_lock_irq(&ep->lock);
    list_splice_init(&ep->rdllist, txlist);
    WRITE_ONCE(ep->ovflist, NULL);
    write_unlock_irq(&ep->lock);
}

static void ep_done_scan(struct eventpoll *ep, struct list_head *txlist)
{
    struct epitem *epi, *nepi;

    write_lock_irq(&ep->lock);
    for (nepi = READ_ONCE(ep->ovflist); (epi = nepi) != NULL;
         nepi = epi->next, epi->next = EP_UNACTIVE_PTR) {
        if (!ep_is_linked(epi)) {
            /* ->ovflist is LIFO, so we have to reverse it in order to keep in FIFO */
            list_add(&epi->rdllink, &ep->rdllist);
            ep_pm_stay_awake(epi);
        }
    }
    WRITE_ONCE(ep->ovflist, EP_UNACTIVE_PTR);
    list_splice(txlist, &ep->rdllist);   /* 没收割完的放回队头 */
    __pm_relax(ep->ws);
    if (!list_empty(&ep->rdllist)) {
        if (waitqueue_active(&ep->wq))
            wake_up(&ep->wq);
    }
    write_unlock_irq(&ep->lock);
}
一次收割的三个阶段
设就绪链表上依次是 A(LT)、B(ET)、C(LT),调用者的
maxevents 为 2,收割期间 D、E
先后触发回调:

chain_epi_lockless() 用
xchg(&ep->ovflist, epi)
把新条目推到链头,所以 ovflist
是后进先出;ep_done_scan() 从链头开始用
list_add 逐个插到 rdllist
队头,恰好把顺序翻转回来。最终的 [C D E A] 说明
epoll 的交付顺序只是”大致
FIFO”:没收割完的条目会插到本轮新到的事件前面,而被放回的 LT
条目排在最后。依赖 epoll
事件顺序做公平调度的程序应当意识到这一点。
ep_done_scan() 末尾的 wake_up()
也值得记住:只要收割完 rdllist
不空,就再唤醒一个等待者。对 LT 条目而言,它刚被放回
rdllist,所以这里总会触发,第七节的”连锁唤醒”就来自这一行。
六、ep_send_events:LT、ET、ONESHOT 在哪里分岔
收割循环
/* Linux v6.12 fs/eventpoll.c ep_send_events()(节选,省略了 wakeup source 处理;中文注释为本文所加) */
    list_for_each_entry_safe(epi, tmp, &txlist, rdllink) {
        if (res >= maxevents)
            break;
        list_del_init(&epi->rdllink);

        revents = ep_item_poll(epi, &pt, 1);   /* LT 与 ET 都重新查询 */
        if (!revents)
            continue;                          /* 已不就绪:静默丢弃 */

        events = epoll_put_uevent(revents, epi->event.data, events);
        if (!events) {                         /* 写用户内存失败 */
            list_add(&epi->rdllink, &txlist);
            if (!res)
                res = -EFAULT;
            break;
        }
        res++;
        if (epi->event.events & EPOLLONESHOT)
            epi->event.events &= EP_PRIVATE_BITS;
        else if (!(epi->event.events & EPOLLET))
            list_add_tail(&epi->rdllink, &ep->rdllist);
    }
flowchart TD
A["take epi from txlist, list_del_init"] --> B["revents = ep_item_poll(epi)"]
B --> C{"revents == 0?"}
C -->|yes| D["drop silently: stale wakeup"]
C -->|no| E["epoll_put_uevent: copy to user"]
E --> F{"EPOLLONESHOT?"}
F -->|yes| G["events &= EP_PRIVATE_BITS: disabled until EPOLL_CTL_MOD"]
F -->|no| H{"EPOLLET?"}
H -->|yes| I["not re-queued: waits for next callback"]
H -->|no, level-triggered| J["list_add_tail back to rdllist"]三种模式的差别全部集中在循环末尾两行:
- LT:交付后立刻放回
rdllist。下一次epoll_wait会再次ep_item_poll(),如果文件仍然就绪就再报告一次,否则在revents == 0那一步被丢弃。所谓”水平触发”,就是”每次 wait 都重新问一遍”。 - ET:交付后不放回,只有下一次回调才能让它重新入队。
- ONESHOT:交付后把事件位清掉,只留私有标志位。回调开头的
!(epi->event.events & ~EP_PRIVATE_BITS)检查使它此后对任何唤醒都视而不见,直到用户EPOLL_CTL_MOD重新武装。
有两个常见误解可以从这段代码直接否定。第一,“ET
不重新查询状态”:ep_item_poll() 对 LT 和 ET
都会调用,ET
条目如果在回调之后、收割之前被别的线程读空,同样会被静默丢弃。第二,“LT
的重复通知来自新的中断”:LT
的重复报告来自收割循环自己把条目放回链表,与设备有没有新事件无关。
实测:同一个 socket,三种注册方式
reproduce/lt_et_demo.c 用一对
AF_UNIX 流 socket:一次写入 4096
字节,消费者每收到一次报告只读 512 字节,然后以超时 0
再次调用 epoll_wait,直到它返回 0;接着再写 1
字节,重复一遍。
gcc -O2 -Wall -Wextra -o lt_et_demo lt_et_demo.c && ./lt_et_demo| 注册方式 | 第一轮报告次数 | 第一轮读到 | 剩余 | 追加 1 字节后报告次数 | 最终剩余 |
|---|---|---|---|---|---|
| LT | 8 | 4096 | 0 | 1 | 0 |
| ET | 1 | 512 | 3584 | 1 | 3073 |
| LT + ONESHOT | 1 | 512 | 3584 | 0 | 3585 |
| ET + ONESHOT | 1 | 512 | 3584 | 0 | 3585 |
程序输出与时间无关,连续运行 3 次完全一致,AddressSanitizer 与 UBSan 下也无报告。

ET 那一行最有意思:缓冲区里还剩 3584
字节没读,状态从来没有”从不可读变为可读”,追加的 1 字节却让
ET 再次触发了。原因是写入触发了
sock_def_readable(),回调把 epitem
重新挂回了就绪链表。在 Linux
的实现里,“边沿”指的是每一次等待队列唤醒,而不是就绪状态的跳变。这不等于
ET 程序可以不读空缓冲区:如果对端不再发送,剩下的 3584
字节就永远不会再触发通知,这就是 ET 必须循环读到
EAGAIN 的原因。
七、ep_poll 与惊群
同一个 epoll 实例上的等待者
/* Linux v6.12 fs/eventpoll.c ep_poll()(节选) */
        init_wait(&wait);
        wait.func = ep_autoremove_wake_function;

        write_lock_irq(&ep->lock);
        __set_current_state(TASK_INTERRUPTIBLE);
        eavail = ep_events_available(ep);
        if (!eavail)
            __add_wait_queue_exclusive(&ep->wq, &wait);
        write_unlock_irq(&ep->lock);

        if (!eavail)
            timed_out = !schedule_hrtimeout_range(to, slack,
                                  HRTIMER_MODE_ABS);
epoll_wait
的调用者一律以互斥方式挂在
ep->wq 上,而回调里的 wake_up()
只唤醒一个互斥等待者。所以多个线程共享同一个 epoll
实例时,一次回调只会唤醒一个线程,不存在”全部唤醒”的惊群,不需要
EPOLLEXCLUSIVE。epoll(7) 对 ET
的描述也是这个意思:多个线程等待同一个 epoll fd 时,对 ET
描述符的一次事件只唤醒其中一个。
__add_wait_queue_exclusive() 调用的是
__add_wait_queue(),插在队头。因此最后一个入睡的线程最先被唤醒,这是后进先出的顺序。
但共享实例配合 LT 会产生另一种多余唤醒。LT
条目收割后被放回
rdllist,ep_done_scan()
看到链表不空就再唤醒一个等待者;被唤醒的线程重新
ep_item_poll(),文件若仍就绪就再报告一次,报告后条目又被放回,如此连锁下去,直到有人把状态消费掉:
sequenceDiagram
    participant S as listen socket
    participant E as shared eventpoll (LT)
    participant A as worker A
    participant B as worker B
    S->>E: callback: epitem to rdllist, wake_up(wq)
    E->>A: wake one exclusive waiter
    A->>E: ep_send_events(): report fd, LT so list_add_tail back
    E->>B: ep_done_scan(): rdllist not empty, wake_up(wq)
    alt A accepts before B re-polls
        A->>S: accept() succeeds
        B->>E: ep_send_events(): re-poll, revents == 0
        B->>B: sleep again
    else B re-polls first
        B->>E: ep_send_events(): re-poll, fd still readable, reported
        A->>S: accept() succeeds
        B->>S: accept() returns EAGAIN
    end
多个 epoll 实例监听同一个文件
另一种部署方式是每个 worker 各有一个 epoll
实例,都把同一个监听 socket 加进去,多进程的 nginx
就是这样。这时监听 socket 的等待队列上有多个
eppoll_entry,每个属于不同的 epoll
实例。__wake_up_common() 的循环如下:
/* Linux v6.12 kernel/sched/wait.c(节选) */
    list_for_each_entry_safe_from(curr, next, &wq_head->head, entry) {
        unsigned flags = curr->flags;
        int ret;

        ret = curr->func(curr, mode, wake_flags, key);
        if (ret < 0)
            break;
        if (ret && (flags & WQ_FLAG_EXCLUSIVE) && !--nr_exclusive)
            break;
    }
非互斥条目不会让循环提前结束,所以每个 epoll
实例的回调都会执行,每个 worker 都会被唤醒。Jason Baron 在
2016 年 1 月提交的 df0108c5da56 “epoll: add EPOLLEXCLUSIVE
flag”(合入 4.5)针对的正是这个场景:提交说明描述的是多个
epoll fd 挂在同一个唤醒源上,并给出一个 Enduro/X
负载的运行时间从 860 秒降到 24 秒。带
EPOLLEXCLUSIVE 注册的条目带有
WQ_FLAG_EXCLUSIVE,结合回调的
ewake
返回值,唤醒会停在第一个”有人在等且事件匹配”的 epoll
实例上。

do_epoll_ctl()
对这个标志有几条限制:只能用于
EPOLL_CTL_ADD,因为等待项只在 ADD
时挂上;不能用于目标是另一个 epoll fd
的情况;事件掩码只能包含
EPOLLIN、EPOLLOUT、EPOLLERR、EPOLLHUP、EPOLLWAKEUP、EPOLLET
和它自己(EPOLLEXCLUSIVE_OK_BITS),EPOLLRDHUP
和 EPOLLONESHOT 都不行;已带该标志的条目再
EPOLL_CTL_MOD 会返回
EINVAL。epoll_ctl(2)
对语义的措辞是唤醒”一个或多个”epoll
实例,因为一次唤醒可能多次调用回调,队列里也可能混有非互斥的等待者。
实测:四种布局的唤醒次数与负载分布
reproduce/herd_demo.c 起 4 个 worker
线程等待同一个回环监听 socket,主线程逐个建立 100
个连接,每建一个就等系统静止 10 毫秒。统计口径:
- returns:worker 的
epoll_wait返回了监听 fd 的次数,按连接平均; - eagain:其中
accept一个也没拿到的次数; - csw:worker
线程的自愿上下文切换次数(读
/proc/self/task/<tid>/status),每次对应一次在epoll_wait里的睡眠与唤醒; - top%:接走连接最多的那个 worker 所占的比例,均匀分布时是 25%。
每种布局跑 5 次取中位数。下表每格给出两批运行的结果:
gcc -O2 -Wall -Wextra -pthread -o herd_demo herd_demo.c
./herd_demo                 # worker 在所有 CPU 上浮动
taskset -c 4 ./herd_demo # 全部绑到一个 CPU| 布局 | 浮动 returns | 浮动 eagain | 浮动 csw | 浮动 top% | 绑核 returns | 绑核 eagain | 绑核 csw | 绑核 top% |
|---|---|---|---|---|---|---|---|---|
| 共享实例,LT | 1.24 / 1.35 | 0.24 / 0.35 | 2.24 / 2.35 | 48 / 38 | 1.54 / 1.49 | 0.54 / 0.49 | 2.54 / 2.49 | 40 / 39 |
| 共享实例,ET | 1.00 | 0.00 | 1.00 | 100 | 1.00 | 0.00 | 1.00 | 100 |
| 各自实例,LT | 1.29 / 1.24 | 0.29 / 0.24 | 4.01 / 4.01 | 86 / 93 | 1.00 | 0.00 | 4.00 | 28 |
| 各自实例,LT + EXCLUSIVE | 1.00 | 0.00 | 1.00 | 100 | 1.00 | 0.00 | 1.00 | 100 |
这组数字验证了三件事:
- 共享实例没有”全部唤醒”。共享 LT
的唤醒次数是 2.2 到 2.5,而不是 4;多出来的 1.2 到 1.5
次来自上面的
ep_done_scan()连锁。换成 ET 后条目不再被放回,唤醒次数正好是 1。 - 各自实例才是
EPOLLEXCLUSIVE的用武之地。不带标志时 4 个 worker 每次都被唤醒(4.00),带上后降到 1.00。浮动时有 24% 到 29% 的连接让第二个 worker 也拿到了”就绪”报告却accept失败;绑到一个 CPU 时,第一个被调度的 worker 在其他 worker 运行前就接走了连接,eagain 降为 0,但唤醒次数仍是 4。 - “只唤醒一个”不等于”负载均衡”。共享 ET
与 EXCLUSIVE 两种布局的 top% 都是 100%:前者因为
ep->wq是后进先出,刚处理完连接、最后入睡的那个线程总是下一个被叫醒;后者因为add_wait_queue_exclusive()按 ADD 顺序排在队尾,第一个注册的 worker 只要空闲,遍历就停在它那里。本实验每个连接之间都让系统完全静止,是最极端的情形;负载高时第一个 worker 忙碌,它的回调返回 0,唤醒会顺延到下一个。
第三点在生产中是真实问题。nginx 1.11.3(2016 年 7
月)开始使用 EPOLLEXCLUSIVE 并把
accept_mutex 默认关闭;1.21.6(2022 年 1
月)的变更日志又修复了”使用 EPOLLEXCLUSIVE 时客户端连接在
worker 之间分布不均”。1.26.2 的
src/event/ngx_event_accept.c 中
ngx_reorder_accept_events()
的注释说明了原因:“Linux with EPOLLEXCLUSIVE usually
notifies only the process which was first to add the
listening socket to the epoll instance”,对策是每接受 16
个连接就把监听 socket 从 epoll
里删掉再加回去,让自己排到队尾。同一个文件里,nginx 注册监听
socket 时用的是 LT 加
NGX_EXCLUSIVE_EVENT,ngx_epoll_module.c
会在带 EXCLUSIVE 时去掉
EPOLLRDHUP,正对应上面的掩码限制;已建立的连接则用
EPOLLIN | EPOLLOUT | EPOLLET | EPOLLRDHUP。作为对照,Redis
7.4.1 的 src/ae_epoll.c 注册事件时不带
EPOLLET,全部是 LT。
八、锁的演进:一把锁换了四次
ep->lock
保护的是回调与收割线程之间的共享状态,它的类型在历史上几经变化。下表按版本逐一核对了
fs/eventpoll.c 源码:
| 版本 | 保护就绪链表的锁 | 备注 |
|---|---|---|
| 2.6.0 – 2.6.21 | rwlock_t lock,另有
struct rw_semaphore sem |
兴趣表是哈希表(2.6.8 前) |
| 2.6.22 – 4.18 | spinlock_t lock,另有
struct mutex mtx |
形成今天的 mtx 加自旋类锁的两级结构 |
| 4.19 – 5.0 | 复用 ep->wq.lock |
就绪链表与等待队列共用一把锁 |
| 5.1 – 6.17 | rwlock_t lock |
a218cc491420,Roman Penyaev,2019 年 3 月 |
| 6.18 起 | spinlock_t lock |
0c43094f8cc9,Nam Cao,2025 年 7 月撰写;stable 6.12.54 起也回移了这一改动,6.12.53 仍是读写锁 |
5.1 的改动把回调改成持读锁、用
cmpxchg/xchg 无锁入队,好让多个
CPU 上的回调并行。提交说明给出的 stress-epoll
数据是:8、16、32 个线程时,每毫秒处理的事件数从
6402、7045、7395 提升到 10038、12178、13223。
6.18 的改动反其道而行:删掉
list_add_tail_lockless() 和
chain_epi_lockless(),回到普通自旋锁。提交说明给出的理由是优先级反转:读写锁的读者不支持优先级提升(开启
CONFIG_PREEMPT_RT
也一样),高优先级的消费者要拿写锁时,可能被持有读锁的低优先级生产者挡住。代价也写在说明里:同一个
stress-epoll 基准在 12 个 x86 CPU 上、8 到 128
个线程时,每毫秒事件数下降 30% 到 47%;而在锁竞争较低的
perf bench epoll wait 上,结果从每秒 110279
次操作升到 114577 次。补丁说明写明要回移到 stable,这就是
6.12.54 起的变化。
这也意味着”v6.12 的 ep->lock
是什么”必须说清版本:v6.12 标签是读写锁,而 6.12.54 之后的
stable 内核已经是自旋锁。本文第四节的回调代码对应前者。
九、代价模型与实测
复杂度
设兴趣表中有 \(n\)
个描述符,某次 epoll_wait 时就绪链表上有 \(k\) 个条目,其中 \(r\) 个是仍然就绪的 LT
条目:
\[ T_{\text{ctl}}(n) = O(\log n), \qquad T_{\text{callback}} = O(1), \qquad T_{\text{wait}}(k) = \Theta(k) + T_{\text{sleep/wake}} \]
有三处经常被忽略:
- \(\Theta(k)\)
中的每一项都是一次
f_op->poll调用,不是简单的链表节点拷贝; - \(r\) 个 LT 条目在每次
epoll_wait都会被重新查询,即使应用这一轮并不打算处理它们,所以 \(k \ge r\); - 回调的 \(O(1)\) 是就 epoll 一侧而言的,被监听文件每次唤醒都要遍历自己的等待队列,代价与挂在上面的等待者数 \(w\) 成正比。第七节”各自实例、不带 EXCLUSIVE”的 4.00 次唤醒就是 \(w = 4\) 的代价。
内存
reproduce/epitem_layout.c 在用户态复刻了
v6.12 的 struct epitem 与
struct eppoll_entry:
gcc -O2 -Wall -Wextra -o epitem_layout epitem_layout.c && ./epitem_layoutx86-64 上两者分别是 120 字节和 64 字节。内核用它们的和作为记账单位:
\[ \text{EP\_ITEM\_COST} = \texttt{sizeof(struct epitem)} + \texttt{sizeof(struct eppoll\_entry)} = 120 + 64 = 184 \text{ 字节} \]
实际占用的 slab 槽位是 \(128 + 64 = 192\) 字节(只挂一个等待队列的普通 socket),10 万个描述符约 \(1.92 \times 10^7\) 字节,即约 18.3 MiB。
每用户可注册的描述符上限 max_user_watches 在
eventpoll_init() 中按低端内存的 4% 计算:
\[ \text{max\_user\_watches} = \left\lfloor \frac{\lfloor (\text{totalram} - \text{totalhigh}) / 25 \rfloor \cdot \text{PAGE\_SIZE}}{\text{EP\_ITEM\_COST}} \right\rfloor \]
Documentation/admin-guide/sysctl/fs.rst
说每个注册”在 64 位内核上大约 160 字节”,与代码中的 184
字节对不上。在实验机上可以反推验证:MemTotal 为
32725144
kB,/proc/sys/fs/epoll/max_user_watches 为
7282643,反推每个注册 184.1 字节;按 184 字节代入公式得
7284891,相差 0.03%(MemTotal 与启动时的
totalram 略有出入)。若按文档的 160
字节计算会得到约 838 万,按 192 字节约 698
万,都对不上。所以这个上限随内存线性增长,并不存在”默认约 40
万”之类的固定值。
实测:一次等待的代价
reproduce/wait_cost.c 监听 \(n\) 个
eventfd,其中恰有一个可读且从不消费;每次调用超时为
0,都返回这一个就绪项,分别测 poll() 与 LT
模式下 epoll_wait() 的单次耗时。程序会把
RLIMIT_NOFILE 软限制提到硬限制,\(n = 10^5\) 时需要硬限制不低于约
10 万。
gcc -O2 -Wall -Wextra -o wait_cost wait_cost.c
taskset -c 4 ./wait_cost > wait_cost.csv
python3 plot_wait_cost.py    # 生成 ../wait-cost.svg,需要 matplotlib
实验环境:Intel Core i9-12900K,WSL2 内核
6.6.87.2-microsoft-standard-WSL2,GCC 16.1.1,绑定到 4 号
CPU,每个点取 5 次运行的中位数。实验机内核是 6.6 而非
6.12;逐一比对两个版本的
ep_poll_callback、ep_start_scan、ep_done_scan、ep_ptable_queue_proc、ep_send_events
与
ep_poll,除注释外完全相同,锁也都是读写锁,所以本文的实验走的是同一套代码路径。
| \(n\) | poll() 每次调用 |
epoll_wait() 每次调用 |
|---|---|---|
| 10 | 168 ns | 157 ns |
| 100 | 723 ns | 159 ns |
| 1,000 | 5,557 ns | 157 ns |
| 10,000 | 80,030 ns | 164 ns |
| 100,000 | 2,491,131 ns | 165 ns |
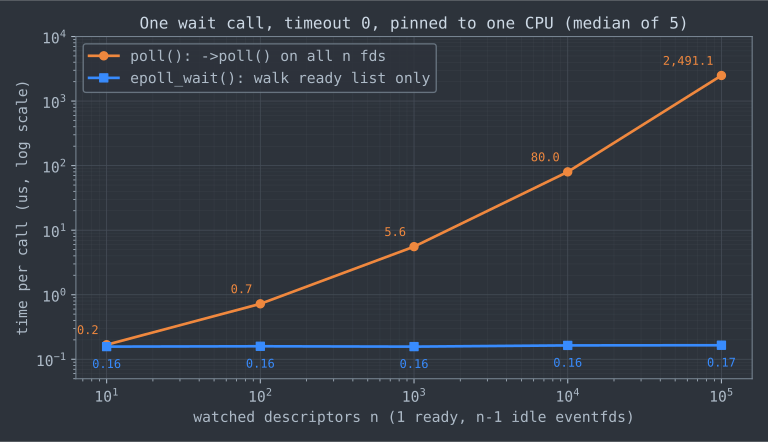
这是共享机器上的墙钟时间,只看趋势,不要比较个位数。另外四次完整运行中,\(n = 10^5\) 时 poll
在 2.18 到 2.74 毫秒之间,epoll_wait 在 162 到
169 纳秒之间,结论不变。\(n =
10\) 时两者几乎相同,这与下一节 OLS 2004
的结论一致。poll 折合到每个描述符的代价从 \(n = 10^3\) 时的约 5.6 纳秒涨到
\(n = 10^5\) 时的约 24.9
纳秒,超出了线性;一个可能的原因是 \(10^5\) 个
struct file 与 eventfd
上下文放不进缓存,但本实验没有用性能计数器验证这一点。
这个实验刻意只有一个就绪项。实际服务器里 \(k\)
也会增长,epoll_wait 的代价随之线性增长,epoll
的优势只体现在”\(n\) 大而
\(k\) 小”的场景里。
十、争论与开放问题
读写锁还是自旋锁
第八节的两次改动代表了两种目标:Penyaev 在 2019 年优化的是多生产者高事件率下的吞吐,Cao 在 2025 年优先保证调度优先级的可预测性,并公开接受了 stress 测试上 30% 到 47% 的吞吐损失。有意思的是双方依据的都是微基准:Cao 的提交说明指出,stress-epoll 里的线程除了不停制造事件什么也不做,真实负载的事件率要低得多;还直言当年改成读写锁的提交”没有提到真实负载,只是基准数字好看”。于是一个基本问题至今没有公开数据回答:真实服务器里,有多少比例的事件会让多个 CPU 同时在同一个 epoll 实例上执行回调?单线程事件循环(如 Redis)几乎不会遇到这种竞争,而多个线程共享一个实例、事件率又很高的服务会。能否在不牺牲实时性的前提下拿回并发入队的吞吐,也还没有答案。
epoll 并不总是更快
Gammo 等人在 OLS 2004 上用 Linux
2.6.5(单处理器模式,双路 2.4 GHz Xeon)对比了分别基于
select、poll、epoll 的 µserver。没有空闲连接时,select 与
poll 的吞吐与 epoll 相当,甚至略好。gprof 显示 epoll-LT
版本有 16.34% 的时间花在 epoll_ctl
上,因为服务器在每个 socket 每次状态变化时都调用它;改用 ET
后这一比例降到 11.06%,他们新加的批量系统调用
epoll_ctlv 只带来小幅改进。加入 10,000
个空闲连接后,select 与 poll 的吞吐最多下降 79%,epoll-LT
略有下降,epoll-ET
不受影响。还有一个容易被忽略的结果:只在建立和关闭时各调用一次
epoll_ctl、始终以 LT 监听读写的 epoll2
方案,在有空闲连接时和 select、poll 一样大幅退化,因为
epoll_wait
返回的绝大多数是服务器此刻并不关心的可写事件。
所以”ET 比 LT
快”如果成立,原因在于系统调用的使用模式(少改兴趣集合、少一次重新查询),而不在于内核路径更短。reproduce/epoll_echo_server.c
因此只在事件掩码真正变化时才调用
EPOLL_CTL_MOD。epoll_ctl
每次只能改一个描述符,这个限制至今仍在;io_uring 可以把 poll
请求和读写一起批量提交,是另一种回答。
描述符与打开文件描述的错位
第三节的图展示了这个问题:epoll
登记的是内核对象,用户操作的是描述符号。Marek Majkowski 在
2017 年的 “Epoll is fundamentally broken”
系列第一篇中把它与多线程负载均衡并列为 epoll
的两个根本设计问题,并引用 Bryan Cantrill
的批评:fork
之后关闭描述符的效果令人意外。这个问题在接口层面无法修补,只能靠”先
EPOLL_CTL_DEL 再
close“这类纪律规避。FreeBSD 的 kqueue(2)
手册写明,对描述符调用 close()
会删除所有引用该描述符的
kevent,这是两种设计的一处真实分歧。
教科书里的”边沿”与 Linux 的”边沿”
Majkowski 在同一篇文章中描述 ET
的饥饿场景时有一步推理,大意是:新连接到达时套接字原本就可读、现在仍然可读,所以
ET 模式不会产生事件。第六节的实验表明 Linux
并不是这样:只要被监听文件调用了唤醒,ET
条目就会重新入队,缓冲区里有没有旧数据都一样。他关于 ET
会造成多余唤醒和 accept
竞争的结论依然成立,但”仍可读就不再通知”这一步在 Linux
上不成立。反过来,也不能依赖这种”每次唤醒都触发”的行为,因为它取决于每个驱动在什么时候调用
wake_up,epoll(7)
手册并没有承诺。一个开放的问题是:这种与驱动实现绑定的语义能否被规范化?手册目前只给出了”读到
EAGAIN 为止”的使用建议。
就绪通知与完成通知
epoll 告诉你”现在可以读了”,读本身还要再发一次系统调用;io_uring 这类完成模型直接告诉你”已经读好了”。两者的取舍涉及缓冲区所有权、系统调用次数和内核复杂度,见站内的 epoll 与 io_uring 对比。
十一、工程陷阱
| 陷阱 | 症状 | 原因 | 对策 |
|---|---|---|---|
close 了但事件还在来 |
已关闭的连接仍收到事件,data.ptr
指向已释放内存 |
描述符被 dup
过或被子进程继承,文件没有真正释放,epitem 仍在兴趣表里 |
先 EPOLL_CTL_DEL 再 close |
| ET 下数据”卡住” | 客户端发了数据却得不到响应 | 没有读到
EAGAIN,对端也不再发送,于是没有新的唤醒 |
ET 下读写都循环到 EAGAIN |
| ET 下写阻塞后停止读取 | 大流量时回显截断或连接挂死 | 写缓冲满后丢弃数据,或暂停读取后忘了自己恢复 | 为每个连接维护输出缓冲;等到 EPOLLOUT
冲刷完后主动继续读,不等新的边沿 |
| LT 下忘记处理挂断 | CPU 占用 100% | EPOLLHUP 或 EPOLLERR
一直成立,LT 每次都报告 |
总是检查这两个位;它们不注册也会上报 |
LT 下长期保留 EPOLLOUT |
CPU 占用异常高 | 发送缓冲几乎总是可写,每次 epoll_wait
都会报告 |
只在有待发送数据时注册 EPOLLOUT |
每次读完都 EPOLL_CTL_MOD |
epoll_ctl 在剖析中占比很高 |
兴趣集合没变也发系统调用 | 在连接对象里缓存当前掩码,变化时才调用 |
以为 EPOLL_CLOEXEC 能挡住
fork |
子进程里仍有 epoll fd 和被监听的文件 | EPOLL_CLOEXEC 只在 execve
时关闭描述符,fork 照样继承 |
子进程不用就显式关闭;需要 exec 时再依赖
CLOEXEC |
期望 EPOLLEXCLUSIVE 均衡负载 |
大部分连接集中在一个 worker | 互斥条目按注册顺序排队,空闲时总是第一个胜出 | 参考 nginx 定期重新注册,或者改用
SO_REUSEPORT 分离监听 socket |
| 共享实例配 LT 监听 socket | 多余唤醒、accept 频繁返回
EAGAIN |
ep_done_scan() 的连锁唤醒 |
监听 socket 用 ET 或 EPOLLONESHOT,或每个
worker 各用一个实例加 EPOLLEXCLUSIVE |
reproduce/epoll_echo_server.c 是一个单线程
ET 回显服务器,处理了表中与 ET 相关的几项:每个连接有 16 KiB
输出缓冲,写阻塞时切换到
EPOLLIN | EPOLLOUT | EPOLLET,冲刷完后自己继续读,而不是等新的边沿。核心循环如下:
/* reproduce/epoll_echo_server.c */
static int pump(int epfd, struct conn *c)
{
    for (;;) {
        int r = flush(c);
        if (r < 0)
            return -1;
        if (r == 0)   /* peer is slow: park until EPOLLOUT */
            return set_events(epfd, c, EPOLLIN | EPOLLOUT | EPOLLET | EPOLLRDHUP);

        ssize_t n = read(c->fd, c->buf, sizeof(c->buf));
        if (n < 0) {
            if (errno == EINTR)
                continue;
            if (errno == EAGAIN || errno == EWOULDBLOCK)
                return set_events(epfd, c, EPOLLIN | EPOLLET | EPOLLRDHUP);
            return -1;
        }
        if (n == 0)
            return -1;  /* EOF */
        c->len = (size_t)n;
        c->off = 0;
    }
}
gcc -O2 -Wall -Wextra -o epoll_echo_server epoll_echo_server.c
./epoll_echo_server 9527 &
python3 echo_test.py 9527echo_test.py 起 8 个客户端,各自发送 8 MiB
随机数据并同时读取回显。普通编译与
-fsanitize=address,undefined 编译的服务器都得到
“8/8 clients got an exact echo of 8388608
bytes”。如果把写阻塞时的处理换成”丢弃没写出去的数据”,这个测试会立刻出现截断,客户端等不到完整回显而超时。
十二、参考资料
规范与文档
- Linux man-pages:epoll(7)、epoll_create(2)、epoll_ctl(2)、epoll_wait(2)、select(2)、poll(2)。
- Linux v6.12
Documentation/admin-guide/sysctl/fs.rst,epoll/max_user_watches一节。 - Linux 2.6.8 ChangeLog,“[PATCH] epoll: replace the file lookup hash with rbtrees”(Davide Libenzi)。
- FreeBSD kqueue(2) 手册。
源码
- Linux
v6.12:
fs/eventpoll.c、kernel/sched/wait.c、include/linux/wait.h、include/linux/poll.h、fs/select.c、net/core/sock.c、net/socket.c、net/ipv4/tcp.c、fs/file_table.c。 - Linux v6.6
fs/eventpoll.c(与实验机内核对照)。 - 历史版本
fs/eventpoll.c:v2.6.0、v2.6.12、v2.6.21、v2.6.22、v4.13、v4.14、v4.18、v4.19、v5.0、v5.1、v5.10、v5.11。 - 提交 df0108c5da56,Jason Baron,“epoll: add EPOLLEXCLUSIVE flag”,2016 年 1 月,Linux 4.5。
- 提交 a218cc491420,Roman Penyaev,“epoll: use rwlock in order to reduce ep_poll_callback() contention”,2019 年 3 月,Linux 5.1。
- 提交 0c43094f8cc9,Nam Cao,“eventpoll: Replace rwlock with spinlock”,2025 年,Linux 6.18。
- nginx
1.26.2:
src/event/ngx_event.c、src/event/ngx_event_accept.c(ngx_reorder_accept_events)、src/event/modules/ngx_epoll_module.c;nginxCHANGES(1.11.3、1.21.6)。 - Redis 7.4.1:
src/ae_epoll.c。
核心论文
- G. Banga, J. C. Mogul, “Scalable kernel performance for Internet servers under realistic loads”, USENIX ATC 1998.
- G. Banga, J. C. Mogul, P. Druschel, “A scalable and explicit event delivery mechanism for UNIX”, USENIX ATC 1999.
- L. Gammo, T. Brecht, A. Shukla, D. Pariag, “Comparing and Evaluating epoll, select, and poll Event Mechanisms”, Ottawa Linux Symposium 2004.
其他论文
- N. Provos, C. Lever, “Scalable Network I/O in Linux”, USENIX ATC 2000, FREENIX Track.
- J. Lemon, “Kqueue: A generic and scalable event notification facility”, USENIX ATC 2001, FREENIX Track.
- A. Chandra, D. Mosberger, “Scalability of Linux Event-Dispatch Mechanisms”, USENIX ATC 2001.
工程资料
- M. Majkowski, “Epoll is fundamentally broken 1/2”, idea.popcount.org, 2017-02-20.
实验
reproduce/lt_et_demo.c:第六节 LT、ET、ONESHOT 的报告次数。reproduce/herd_demo.c:第七节四种布局的唤醒次数与负载分布。reproduce/epitem_layout.c:第二、九节的结构体布局、EP_ITEM_COST与max_user_watches验证。reproduce/wait_cost.c、reproduce/wait_cost.csv、reproduce/plot_wait_cost.py:第九节poll与epoll_wait的单次耗时及图。reproduce/epoll_echo_server.c、reproduce/echo_test.py:第十一节的 ET 回显服务器与压力测试。
系列导航: - 上一篇:文件系统中的树:extent、HTree 与 CoW B-tree 的代价 - 下一篇:定时器数据结构:堆、时间轮与生产系统的精度权衡
相关阅读: - epoll 深度剖析:ET/LT 模式、源码分析与性能特征 - 操作系统百科:epoll 内部 - Linux 异步 I/O:epoll 与 io_uring 对比 - io_uring 系列 - 红黑树与 AVL:旋转次数、树高与 Linux 内核的选择
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
定时器数据结构:堆、时间轮与生产系统的精度权衡
从 Varghese-Lauck 时间轮到 Linux、Go、Netty、Kafka 源码,比较堆、红黑树、简单轮和层级轮在插入、取消、级联与到期误差上的真实边界。
Linux 异步 I/O:epoll 与 io_uring 对比
从就绪通知到完成通知:梳理 epoll 与 io_uring 的架构差异、系统调用开销、适用场景,并附最小可运行 C 示例与示意图。
【Linux 网络子系统深度拆解】Socket 层内核实现:从 VFS 到协议栈的桥梁
你调用 socket(AF_INET, SOCK_STREAM, 0) 创建一个 TCP 连接,底层发生了什么?内核分配了两个核心对象——VFS 层的 struct socket 和协议层的 struct sock,通过 proto_ops 和 proto 两张分发表,把文件系统语义的 read/write 翻译成协议语义的 tcp_sendmsg/tcp_recvmsg。本文从 Linux 6.6 内核源码拆解 socket 创建、双层分发、SO_REUSEPORT 多核分发、epoll 集成的完整实现。
红黑树与 AVL:旋转次数、树高与 Linux 内核的选择
用可复现的计数实验(红黑树部分与 Linux v6.12 lib/rbtree.c 逐操作一致)比较 AVL、红黑树与左倾红黑树的树高、旋转、平衡标记写入和比较次数:AVL 与红黑树平均差距很小,差在删除的最坏情形;并核对内核从 AVL 换到红黑树、再把 VMA 交给 maple tree 的史实。