定时器设施(timer facility)要回答的问题不是“怎么睡一会儿”,而是在大量对象上维护三类操作:启动定时器、取消或重置定时器、取出已经到期的定时器。网络连接超时、RPC deadline、延迟任务、调度器睡眠和内核 I/O timeout 都落在这个抽象里。
常见说法是“时间轮 \(O(1)\),堆 \(O(\log n)\),所以时间轮总更快”。这句话少了三个条件:时间轮是否允许到期误差;长时间定时器是否会反复被扫描或级联;负载里有多少定时器会在到期前被取消。Varghese 与 Lauck 在 SOSP 1987 的论文已经把这些条件分成七种方案讨论,Linux v6.6、Go 1.23、Netty 4.1 和 Kafka 3.9.1 的源码则展示了四种不同取舍。
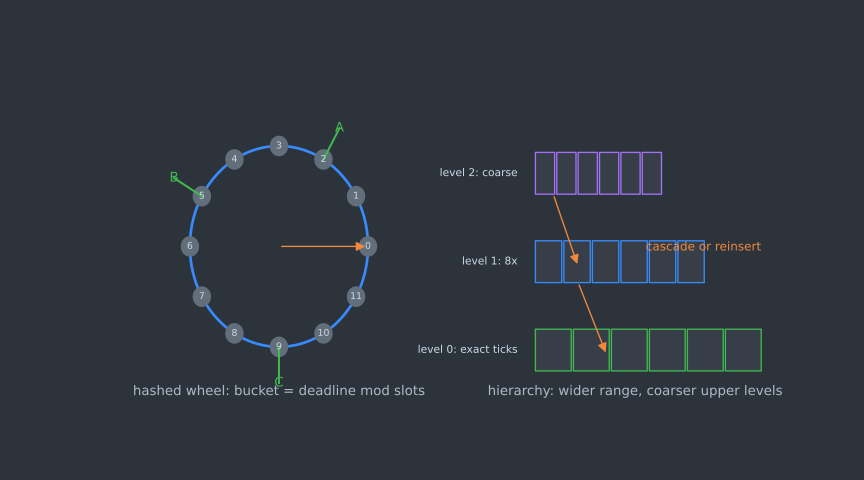
本文按“问题模型 → 七种方案 → 堆与红黑树 → 简单轮 → 层级轮
→ 生产实现 → 实验 →
工程选型”的顺序展开。所有源码结论都钉住版本;所有数字来自同目录
reproduce/timer_experiment.py,实验只统计比较、移动、扫描、级联和
tick 误差,不使用 wall-clock 计时。
一、问题模型:三类操作与两个时间口径
设当前时间为 \(now\),一个定时器的绝对到期时间为 \(expire\),相对延迟为 \(\Delta = expire - now\)。定时器系统至少要支持:
| 操作 | 含义 | 热点来源 |
|---|---|---|
add(expire) |
注册一个未来到期的定时器 | 新连接、新 RPC、time.After |
cancel(timer) /
reset(timer, expire) |
到期前取消或改期 | 连接有活动后重置 idle timeout |
expire(now) |
找到所有 \(expire \le now\) 的定时器并执行回调 | tick、中断、事件循环唤醒 |
定时器还有两个不同口径:
- 精确定时器:必须尽量按绝对时间排序,不能随意延后。Linux
hrtimer、Gotime.Sleep更接近这一类。 - 超时定时器:代表“期望的事件没有发生”,晚几个 tick 通常可接受,且大多数会在到期前被取消。Linux 低精度 timer wheel 正是为这类 timeout 优化。
这两个口径决定数据结构。堆和红黑树维护全序;时间轮把时间划成 bucket,以空间和精度换常数级操作。若一个 bucket 覆盖 \(g\) 个 tick,正确实现必须保证不早触发,到期误差通常满足 \(0 \le error < g\)。
二、Varghese-Lauck 的七种方案
George Varghese 与 Tony Lauck 的 “Hashed and Hierarchical Timing Wheels” 先发表于 SOSP 1987,扩展版发表于 IEEE/ACM Transactions on Networking 1997。论文的价值不只是“提出时间轮”,而是把定时器设施拆成七类方案:
| 方案 | 数据结构 | add |
expire |
关键问题 |
|---|---|---|---|---|
| 1 | 无序链表 | \(O(1)\) | 每 tick 扫 \(O(n)\) | 空闲定时器也反复扫描 |
| 2 | 有序链表 | \(O(n)\) | 看表头 | 插入代价高 |
| 3 | 树或堆 | \(O(\log n)\) | 取最小 | 精确但有对数因子 |
| 4 | 简单轮,覆盖范围内 | \(O(1)\) | 当前 slot | 范围有限 |
| 5 | 哈希轮,每项记录圈数 | \(O(1)\) | 当前 slot,可能扫未到期项 | 长延迟集中时扫描多 |
| 6 | 层级时间轮 | \(O(1)\) 或层数常数 | 级联摊还常数 | cascade 会造成尾延迟 |
| 7 | 带溢出的组合方案 | 取决于溢出结构 | 取决于溢出结构 | 实现复杂 |
今天的生产实现基本都能映射回这张表:Go runtime 是方案 3
的四叉堆;Netty HashedWheelTimer 是方案
5;Kafka 是方案 6 加 DelayQueue 驱动;Linux
v6.6 低精度 timer wheel 是方案 6 的变体,但故意取消
cascade,允许上层 bucket 有到期误差。
三、堆与红黑树:精确顺序的基线
二叉堆或四叉堆把所有定时器按 expire
组成最小堆。堆顶就是最早到期定时器:
\[ \text{parent}(i)=\left\lfloor\frac{i-1}{d}\right\rfloor,\qquad \text{children}(i)=di+1,\ldots,di+d. \]
\(d=2\) 是二叉堆,\(d=4\) 是 Go 1.23 runtime 的选择。四叉堆上浮层数更少,下沉时每层要比较最多 4 个子节点;在现代缓存层次上,这个常数折中经常比二叉堆好。
Go 1.23.0 src/runtime/time.go 明确写着:每个
P 有一个 timers 集合,字段
heap []timerWhen 按 heap[i].when
排序;timerHeapN = 4;siftUp 与
siftDown 用四叉堆维护顺序。文件开头还说明 “Each
P has a heap of pointers to timers that it
manages”。这比早期“全局堆加锁”的描述更精确;讨论 Go
定时器时必须写清版本。
红黑树与堆一样给出 \(O(\log
n)\)
插入和删除,但任意节点删除只需要节点指针,不需要维护“节点在数组中的下标”。Linux
v6.6 kernel/time/hrtimer.c 的
enqueue_hrtimer() 调用
timerqueue_add(&base->active, &timer->node),到期路径用
timerqueue_getnext() 取最小节点;底层
timerqueue 是带缓存最左节点的红黑树。hrtimer
面向纳秒级高精度和硬件 clockevent
编程,因此宁可付对数代价,也不把到期时间粗化成 bucket。
四、简单时间轮:哈希、圈数与到期误差
简单时间轮有 \(N\) 个 bucket,指针每个 tick 前进一步。若只接受 \(0 < \Delta < N\) 的定时器,入桶公式就是:
\[ slot = (current + \Delta) \bmod N. \]
add
是计算一个下标再插入链表;cancel
若持有侵入式链表节点指针,也是 \(O(1)\)。问题在 \(\Delta \ge N\)。方案 5
的做法是把哈希冲突交给“剩余圈数”:
\[ rounds = \left\lfloor \frac{\Delta - 1}{N} \right\rfloor. \]
指针每次走到该
slot,就检查链表上的定时器;rounds > 0
只减一,不触发;rounds = 0 才到期。这里用 \(\Delta-1\) 而不是 \(\Delta\),是为了避免恰好落在整圈边界的定时器晚一圈。若
\(N=256\)、\(\Delta=256\),它应该在第 256 个
tick 到期,rounds 应为 0。
这种方案的复杂度要分两层说:插入与取消仍是 \(O(1)\);但 expire
要扫描当前 slot
的所有节点,其中很多可能只是减圈数。若大量长延迟定时器哈希到同一个
slot,它们会在每一圈都被访问一次。Netty
选择这个方案,是因为网络 I/O timeout
通常允许粗粒度,而且默认配置很保守。
Netty 4.1.115.Final
io.netty.util.HashedWheelTimer
的文件注释写明默认 tick duration 是 100ms,默认 wheel size
是 512,并提醒不要为每个连接创建一个实例。源码中
timeouts 与 cancelledTimeouts 是
MPSC 队列;worker 线程把新任务转入 bucket,计算
remainingRounds = (calculated - tick) / wheel.length,bucket
内节点是双向链表,便于从中间删除。
五、层级时间轮:范围换层数,级联换精度
层级时间轮用多个不同粒度的轮覆盖长延迟。例如最低层有 256 个 1-tick bucket,上层有 64 个 256-tick bucket,再上层有 64 个 16384-tick bucket。插入时按 \(\Delta\) 选择最细且覆盖它的层级:
if Δ < 256:          level 0, granularity 1 tick
else if Δ < 256*64:  level 1, granularity 256 ticks
else:                level 2, granularity 16384 ticks
经典实现要求精确到期:当低层转完一圈,就把高一层当前 bucket 的定时器取出,按它们的绝对到期时间重新插入更低层。这就是 cascade。级联的摊还代价是常数,因为高层 bucket 很久才下移一次;但单次级联可能搬动大量节点,形成尾延迟尖刺。
Kafka 3.9.1 的
server-common/src/main/java/org/apache/kafka/server/util/timer/TimingWheel.java
是用户态层级轮的清晰实现。注释说明:若一个定时器超出当前层
interval = tickMs * wheelSize,就委托给
overflowWheel;overflow wheel 按需创建;高层
bucket
到期后把其中任务递归重新插回低层。SystemTimer.java
不是忙等 tick,而是用
DelayQueue<TimerTaskList> 等待下一个非空
bucket;advanceClock() 取出到期 bucket 后
flush(this::addTimerTaskEntry),完成重插或执行。
这个设计保留了层级轮的 \(O(1)\)
删除:TimerTaskList
是双向链表,TimerTaskEntry 知道自己所在
list。代价是 DelayQueue 对非空 bucket
做堆操作;堆的规模是 bucket 数,不是定时器数。
六、Linux v6.6:低精度轮取消 cascade,hrtimer 保留红黑树
Linux 的低精度 timer_list 和高精度
hrtimer
是两个子系统,不应混写。timer_list 面向 jiffies
级 timeout,hrtimer 面向高精度到期点。
v6.6 kernel/time/timer.c
文件头注释明确给出新版 timer wheel 的取舍:
- wheel 有
LVL_DEPTH个层级,每层LVL_SIZE个 bucket; LVL_CLK_SHIFT = 3,所以上一层粒度是下一层的 8 倍;LVL_BITS = 6,即每层 64 个 bucket;HZ > 100时LVL_DEPTH = 9,否则为 8;- 与旧实现相反,新实现 “removes the need for recascading”;
- 超过最后一层容量的超大 timeout 会被限制到
WHEEL_TIMEOUT_MAX。
calc_index()
先把到期时间右移到对应层级,再加 1
做向上取整,注释解释这是为了保证 timer 不会提前触发:
expires = (expires >> LVL_SHIFT(lvl)) + 1;
*bucket_expiry = expires << LVL_SHIFT(lvl);
return LVL_OFFS(lvl) + (expires & LVL_MASK);
这意味着 Linux 新轮不是“把定时器预先算好最终 slot,然后仍精确触发”,而是“上层 bucket 原地到期,以较粗粒度延后触发”。LWN 2015 年对 Thomas Gleixner 新轮的报道也把动机说得很清楚:旧 cascade 不可预测、cache 不友好,而且很难快速找下一个到期 timer;新轮用较低精度换取 timeout 路径上的效率。
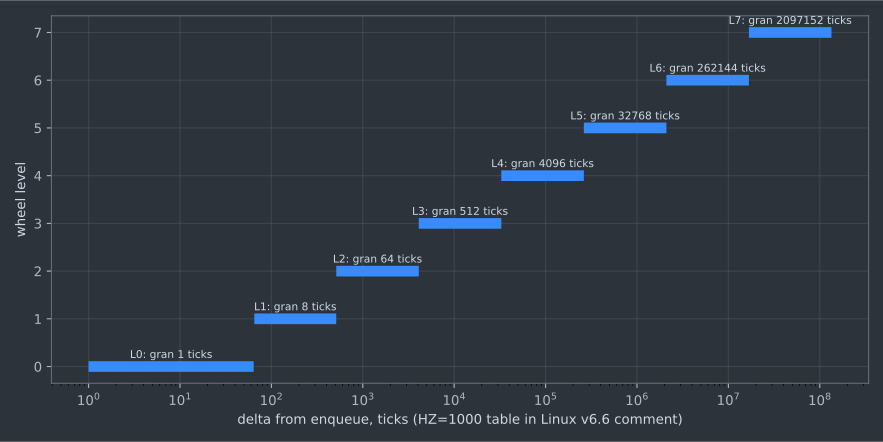
图中只画到 v6.6 注释里 HZ=1000 的前 8 层。若
HZ > 100,源码实际 LVL_DEPTH 为
9,注释表还列出第 8 层覆盖约 1 到 12 天。关键点是:越远的
timeout 被更粗粒度 bucket 批处理,pending_map
位图和 next_expiry 用来快速找到下一批非空
bucket。
hrtimer.c 则走另一条路:每个 clock base 的
active 是
timerqueue_head,即缓存最左节点的红黑树;enqueue_hrtimer()
插入树,timerqueue_getnext()
取最早到期节点。它没有时间轮的 bucket 误差,适合
nanosleep、POSIX
timer、调度器高精度唤醒等场景。
七、可复现实验:比较次数、级联次数与 tick 误差
实验程序 reproduce/timer_experiment.py
生成同一组相对延迟,分别喂给五个模型:二叉堆、四叉堆、带圈数的单层轮、经典层级轮、Linux
风格无 cascade 轮。它不测
wall-clock,而是统计以下与机器负载无关的指标:
- 堆:上浮和下沉中的比较次数、数组移动次数;
- 单层轮:bucket 节点访问次数,长延迟定时器每圈会被访问一次;
- 经典层级轮:节点移动次数、cascade 移动次数;
- Linux 风格无 cascade 轮:节点访问次数、由 bucket 粒度带来的延后 tick 数。
负载为三组规模 \(n=5000, 20000, 80000\),每组跑 3 个种子(7、11、19)。延迟分布是混合负载:70% 短 timeout,22% 中等 timeout,8% 长 timeout,最大 65536 tick。命令如下:
cd post/algorithms/58-timer-algo
python3 reproduce/timer_experiment.py
环境:Linux x86-64,Python 3,matplotlib;生成结果写入
reproduce/results/timer_ops.csv 与
reproduce/results/timer_ops_summary.csv,图写入本文目录。本文运行时绑核
CPU 14;由于指标不是耗时,绑核只用于保持执行环境稳定。
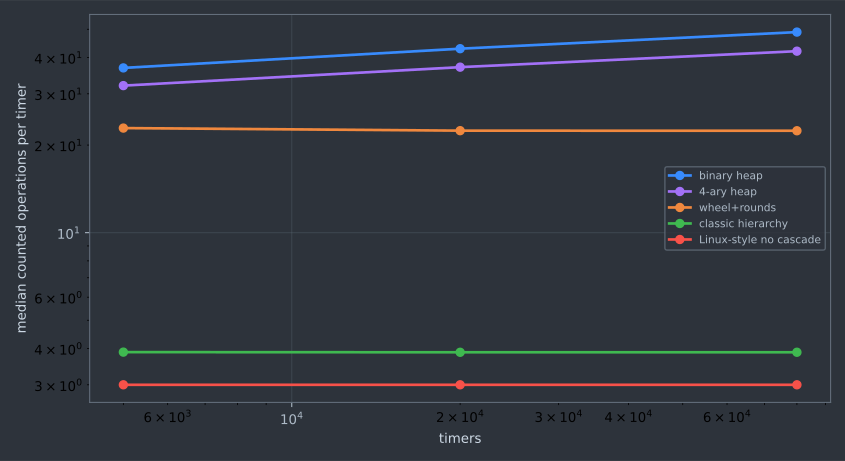
80,000 个定时器时,3 个种子的中位数如下:
| 算法模型 | 计数操作 / timer | cascade / timer | 到期误差 tick / timer |
|---|---|---|---|
| 二叉堆 | 48.8915 | 0 | 0 |
| 四叉堆 | 42.0403 | 0 | 0 |
| 单层轮 + rounds | 22.3945 | 0 | 0 |
| 经典层级轮 | 3.8811 | 0.8811 | 0 |
| Linux 风格无 cascade | 3.0000 | 0 | 168.3776 |
这张表说明三件事。
第一,四叉堆不是改变复杂度,而是改变常数。它比二叉堆少走层数,在本负载中少约 14% 的计数操作;这与 Go 1.23 选择四叉堆的方向一致,但本文实验没有复现 Go runtime 的并发和调度路径,不能推出 Go 的绝对性能。
第二,单层轮没有 cascade,但长延迟定时器会反复被当前 slot 扫到,所以每个 timer 的 bucket 访问次数明显高于层级轮。若所有长延迟都集中到同一个 slot,尾部扫描会更糟;这就是方案 5 的边界。
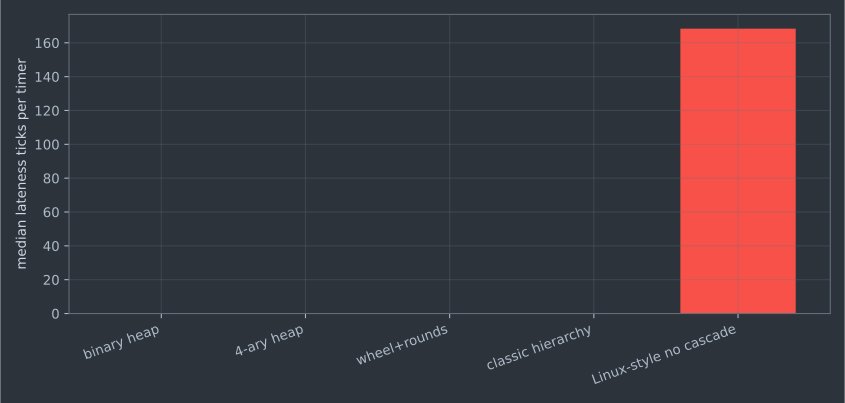
第三,Linux 风格无 cascade
模型的操作数最低,但它支付到期误差。上表中平均延后约 168
tick,是混合延迟分布和 Linux v6.6 HZ=1000
粒度表共同决定的结果。真实内核还会受 jiffies、NOHZ、CPU base
和锁路径影响;本文只复现数据结构层面的取舍。
八、工程选型:先问精度,再问取消率
| 场景 | 常见选择 | 主要理由 |
|---|---|---|
| 少量高精度定时器 | 红黑树、堆 | 保持绝对到期顺序,易取最早 deadline |
| 每个 worker 中等数量定时器 | 四叉堆或二叉堆 | 实现简单,局部锁或 per-P/per-thread 分片即可 |
| 大量粗粒度 timeout | 哈希时间轮 | 插入、取消为常数;允许 tick 粒度误差 |
| 长跨度延迟任务 | 层级时间轮 | 用少量 bucket 覆盖小时、天级范围 |
| 内核 timeout | Linux 风格无 cascade 轮 | 大多数 timeout 会被取消,晚触发比 cascade 尖刺可接受 |
几个边界容易踩错:
- 不要把“摊还 \(O(1)\)”等同于“尾延迟稳定”。 经典层级轮 cascade 摊还是常数,但某个高层 bucket 里有很多 timer 时,单次 tick 仍会搬很多节点。
- 懒删除会改变内存曲线。
堆若用“标记取消,到期时跳过”,在 reset
远多于真正到期的负载中会堆积 zombie 节点。Go 1.23 的
timers结构有zombies计数和清理逻辑,说明这不是理论小问题。 - 单层轮的 bucket 分布要看 deadline,而不是 timer 数。 大量相同超时时间会聚到少数 bucket;如果回调也在推进线程里执行,应该限制单 tick 工作量或把回调转交给 worker 池。
- 精度来自时钟源,不只来自数据结构。
用户态
sleep(tick)循环会受调度延迟影响;需要高精度时应使用timerfd、epoll、kqueue或运行时已有定时器设施,而不是忙等推进轮。 - 跨线程取消要设计所有权。 Netty 用 MPSC 队列把 add/cancel 交给 worker;Linux 用 per-CPU base 和锁;应用层常用 per-event-loop timer,避免跨线程直接改链表。
一个实用顺序是:需要纳秒/微秒级精度或严格 deadline,先用堆或红黑树;需要维护海量连接 timeout,且迟几个 tick 可接受,再选时间轮;需要覆盖很长延迟,再把单层轮升级为层级轮或 Kafka 式按需 overflow wheel。
九、争论与开放问题
低精度 timeout 是否应该牺牲精确性
Varghese-Lauck 的经典层级轮目标是精确到期,只把长延迟暂存在粗粒度层级,到窗口临近时 cascade 到低层。Linux 4.8 之后的方向不同:timeout 不是普通事件调度,而是异常路径检测;若网络包或 I/O 完成正常到达,timer 会被取消;若真的超时,晚几个 tick 通常不是决定性错误。于是新轮把 cascade 尾延迟换成上层 bucket 的延后误差。
这不是算法优劣之争,而是语义之争:如果 timer
表示“必须在某个时刻执行”,Linux 低精度轮就不合适;如果 timer
表示“超过一段时间仍未完成就兜底”,无 cascade
的批处理更合理。timer_list 与
hrtimer
并存,正是因为内核同时需要这两种语义。
时间轮能否替代所有堆
不能。时间轮的优势来自把时间离散化:bucket 越粗,操作越便宜,误差越大;bucket 越细,为覆盖同样范围就需要更多层或更多 slot。堆不需要预先选范围,也不引入 bucket 误差。Go runtime 选择每个 P 的四叉堆,说明当分片后每堆规模可控、精度要求较高时,堆仍是工程上简单而稳健的选择。
仍开放的工程问题
- 尾延迟建模:平均操作次数很容易测,但“一个 bucket 上同时到期 10 万个 timer”这类极端尾部如何限流,取决于回调模型、线程池和上层超时语义。
- timer 与调度器协同:运行时定时器会唤醒线程,也会被线程阻塞延后。数据结构只解决排序问题,不能单独保证 wakeup latency。
- 统一抽象:应用常把 deadline、timeout、periodic ticker、delay queue 混在同一 API 里。它们对精度、取消率、是否允许合并的要求不同,单一结构很难全优。
十、参考资料
源码
- Linux v6.6,
kernel/time/timer.c:LVL_CLK_SHIFT、LVL_BITS、LVL_DEPTH、calc_index()、calc_wheel_index()、pending_map、next_expiry。 - Linux v6.6,
kernel/time/hrtimer.c:enqueue_hrtimer()、__hrtimer_start_range_ns()、timerqueue_getnext()。 - Go go1.23.0,
src/runtime/time.go:timer、timers、timerHeapN = 4、siftUp()、siftDown()、zombies。 - Netty 4.1.115.Final,
common/src/main/java/io/netty/util/HashedWheelTimer.java:默认 100ms tick、512 wheel size、remainingRounds、MPSC add/cancel queues。 - Apache Kafka 3.9.1,
server-common/src/main/java/org/apache/kafka/server/util/timer/TimingWheel.java、SystemTimer.java、TimerTaskList.java:overflowWheel、DelayQueue<TimerTaskList>、bucket flush。
核心论文
- George Varghese, Tony Lauck, “Hashed and Hierarchical Timing Wheels: Data Structures for the Efficient Implementation of a Timer Facility”, SOSP 1987.
- George Varghese, Tony Lauck, “Hashed and Hierarchical Timing Wheels: Efficient Data Structures for Implementing a Timer Facility”, IEEE/ACM Transactions on Networking 5(6), 1997.
工程资料
- Jonathan Corbet, “The new timer wheel”, LWN.net, 2015-06-03.
- Linux kernel documentation and source comments around timer wheel and high-resolution timers in v6.6.
- Netty
HashedWheelTimerJavadoc, Netty 4.1.115.Final. - Apache Kafka timer utility source comments, Kafka 3.9.1.
实验
reproduce/timer_experiment.py:生成本文四张 SVG 和reproduce/results/timer_ops*.csv,比较二叉堆、四叉堆、单层轮、经典层级轮与 Linux 风格无 cascade 轮的计数指标。
系列导航: - 上一篇:epoll 的数据结构:红黑树、就绪队列与回调机制 - 下一篇:Join 算法:嵌套循环、排序归并与 Hybrid Hash 的代价和实现
相关阅读: - 红黑树与 AVL:旋转次数、树高与 Linux 内核的选择 - CPU 调度:CFS 的虚拟运行时间与 EEVDF 的虚拟截止期 - I/O 调度:在寻道、队列深度与公平性之间取舍
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
epoll 的数据结构:红黑树、就绪队列与回调机制
对照 Linux 6.12 fs/eventpoll.c 拆解 epoll 的红黑树兴趣表、rdllist 与 ovflist、ep_poll_callback 和读写锁,并用可复现实验检验 LT/ET 语义、EPOLLEXCLUSIVE 的适用场景与 poll/epoll 开销。
CPU 调度:CFS 的虚拟运行时间与 EEVDF 的虚拟截止期
从比例份额调度的论文谱系出发,对照 Linux v6.6 与 v6.12 fair.c 源码,解释 CFS 的 vruntime、EEVDF 的 lag/eligible/deadline,并用确定性模拟复现延迟与 lag 的差异。
I/O 调度:在寻道、队列深度与公平性之间取舍
从电梯算法到 blk-mq,解释 Linux I/O 调度器为何在 HDD 上排序、在共享设备上保公平、在 NVMe 上常选择 none,并用确定性模拟展示寻道距离与队列尾延迟的取舍。
伙伴系统与 SLUB:Linux 物理页和小对象分配的边界
以 Linux v6.6 源码和确定性模拟为准,解释伙伴系统的 split/coalesce、migratetype 反碎片策略,以及 SLUB 的 per-CPU freelist、partial list 与安全加固。