上一篇讲页面置换时,核心问题是“缓存满了该丢谁”。CPU 调度更苛刻:CPU 时间不能缓存,当前 1 ms 没给某个任务,以后只能用“欠账”近似补偿。围绕 CFS 与 EEVDF 的常见误解有三类:把 CFS 说成简单轮转;把 EEVDF 说成“低延迟魔法”;把 Linux fair class 的源码字段和论文里的变量一一硬套。三者都不准确。
本文按“比例份额问题 → CFS 的虚拟运行时间 → EEVDF 的 lag
与虚拟截止期 → Linux v6.6/v6.12 源码 →
可复现实验”的顺序展开。实验不是跑真实内核,而是同目录
reproduce/cpu_sched_sim.py
里的确定性模拟器;它只保留本文讨论的决策条件,用来观察调度延迟和
lag,不代表 Linux 性能排名。

一、问题模型:比例份额不是固定优先级
设一组可运行任务的权重为 \(w_i\),总权重为 \(W=\sum_j w_j\)。理想的广义处理器共享(Generalized Processor Sharing,GPS)会让任务 \(i\) 在任意小时间片里得到比例
\[ \frac{w_i}{W} \]
的 CPU 服务。真实 CPU 一次只能运行一个任务,所以调度器要用离散时间片逼近这个理想模型。
两个量贯穿全文:
- 实际服务 \(s_i(t)\):任务 \(i\) 到时间 \(t\) 已经真正运行了多久。
- 理想服务 \(S_i(t)\):GPS 在同一时间里本该给它的服务。
两者的差就是 lag:
\[ \operatorname{lag}_i(t)=S_i(t)-s_i(t) \]
\(\operatorname{lag}_i>0\) 表示任务“少拿了 CPU”,\(\operatorname{lag}_i<0\) 表示任务已经超额运行。公平调度不是“nice 值高就一直先跑”,而是长期让每个任务的 lag 围绕 0 波动。
二、谱系:从公平队列到 CFS 与 EEVDF
CPU 调度里的 CFS/EEVDF 不是孤立发明,它沿着比例份额资源分配这条线演进:
| 时间 | 工作 | 本文引用点 |
|---|---|---|
| 1989 | Alan Demers、Srinivasan Keshav、Scott Shenker,Fair Queueing,SIGCOMM | 用虚拟时间逼近 bit-by-bit round robin,保护低速交互流。 |
| 1994 | Carl Waldspurger、William Weihl,Lottery Scheduling,OSDI | 用彩票数量表达比例份额,给 OS 资源分配一个统一接口。 |
| 1995 | Waldspurger、Weihl,Stride Scheduling,MIT/LCS/TM-528 | 把 lottery 的随机性改成确定性的 pass/stride。 |
| 1995/1996 | Ion Stoica 等,EEVDF 技术报告 TR-95-22 与 RTSS 论文 | 在比例份额里加入 eligible time 与 virtual deadline。 |
| 2007 | Ingo Molnar,CFS 合入 Linux 2.6.23 | 用 vruntime 与红黑树替换 O(1)
调度器的交互性启发式。 |
| 2023/2024 | Peter Zijlstra 的 EEVDF 实现进入 Linux fair class | 用 lag、eligible 和 deadline 收敛 CFS 的 sleeper/latency 特例。 |
这条线的共同点是:不要手写“交互式任务加几分”的启发式,而是先定义理想服务,再让实际调度围绕这个理想服务修正。
三、CFS:最小
vruntime 逼近理想处理器
Linux 的 CFS
文档把设计概括为“在真实硬件上模拟理想、精确的多任务
CPU”。每个调度实体(task 或 task group)维护一个虚拟运行时间
se.vruntime。若任务运行物理时间 \(\Delta t\),其
vruntime 增量近似为
\[ \Delta v_i = \Delta t \cdot \frac{w_0}{w_i}, \]
其中 \(w_0\) 是 nice 0 的基准权重。高权重任务的虚拟时间走得慢,因而更容易再次成为最小值;低权重任务的虚拟时间走得快,运行一小段就会被其他任务追上。
CFS 的运行队列是一棵按 vruntime
排序的红黑树:
- 任务入队时按
se.vruntime插入树; - 调度时取最左节点,即虚拟运行时间最小的实体;
- 当前任务运行后调用
calc_delta_fair()增加vruntime; min_vruntime单调前进,用来给新唤醒任务定位。
这一模型解释了 CFS 的长处:长期公平性强,nice
权重进入同一公式,O(1) 调度器时代的 sleep_avg
一类交互性启发式被大幅削弱。它也解释了短处:只按“谁的历史服务最少”排队时,调度器不知道一个任务想要
1 ms 还是 8 ms 的下一次服务;低延迟任务和批处理任务只靠
vruntime 竞争。
四、EEVDF:先看是否 eligible,再看 virtual deadline
EEVDF(Earliest Eligible Virtual Deadline First)的两个关键词是 eligible 与 deadline。
在论文抽象里,任务 \(i\) 的 lag 可写成
\[ \operatorname{lag}_i=w_i(V-v_i), \]
其中 \(V\) 是系统虚拟时间,\(v_i\) 是任务自己的虚拟运行时间。任务只有在 \(\operatorname{lag}_i\ge 0\) 时才 eligible,也就是它确实被欠了服务;eligible 的任务之间,再选择虚拟截止期最早者。
若一个任务请求的物理服务长度为 \(r_i\),Linux 源码注释里的核心关系是
\[ vd_i = ve_i + \frac{r_i}{w_i}, \]
工程实现中可理解为:以当前 vruntime 作为
eligible/service 基准,加上经权重归一化的 slice 得到
deadline。请求更短 slice 的任务在同等 lag
条件下拥有更早
deadline,因此更容易先被挑中;这不是“无条件提高优先级”,因为负
lag 的任务不会 eligible。
EEVDF 的边界同样要说清楚。它给 fair class
内的短期公平和延迟行为一个更统一的模型,但不替代实时调度;需要硬截止期时仍应看
SCHED_DEADLINE。多核负载均衡、NUMA 迁移、cgroup
带宽限制和任务睡眠后的 lag 衰减,仍是 Linux
实现层面的复杂问题。
五、Linux v6.6 与 v6.12 源码里到底有什么
以下只写亲眼核对过的版本:Linux v6.6 与 v6.12 的
kernel/sched/fair.c,以及 v6.12 的
include/linux/sched.h。
sched_entity
字段
v6.12 的 struct sched_entity 里能看到 EEVDF
直接需要的字段:
/* Linux v6.12 include/linux/sched.h, struct sched_entity,有删减 */
struct sched_entity {
        struct load_weight      load;
        struct rb_node          run_node;
        u64                     deadline;
        u64                     min_vruntime;
        u64                     min_slice;
        u64                     exec_start;
        u64                     sum_exec_runtime;
        u64                     prev_sum_exec_runtime;
        u64                     vruntime;
        s64                     vlag;
        u64                     slice;
};
这说明
deadline、vlag、slice
不是文档里的抽象变量,而是 fair class 实体上的真实状态。
vruntime
仍然是底座
v6.12 中 update_curr()
仍然先把当前任务的实际运行时间折算到
vruntime:
/* Linux v6.12 kernel/sched/fair.c, update_curr(),有删减 */
delta_exec = update_curr_se(rq, curr);
curr->vruntime += calc_delta_fair(delta_exec, curr);
resched = update_deadline(cfs_rq, curr);
update_min_vruntime(cfs_rq);
calc_delta_fair() 的逻辑是:如果实体权重不是
NICE_0_LOAD,就用
__calc_delta(delta, NICE_0_LOAD, &se->load)
做比例折算;否则原样返回。也就是说,EEVDF 进入 Linux
后没有丢掉 CFS 的核心计量单位,而是在 vruntime
上增加 lag 与 deadline 选择。
lag 与 eligible
v6.12 源码注释直接写出 \(\operatorname{lag}_i=S-s_i=w_i(V-v_i)\)。
随后 avg_vruntime()
用运行队列中实体的加权平均近似 \(V\)。entity_lag()
计算
vlag = avruntime - se->vruntime;
limit = calc_delta_fair(max_t(u64, 2*se->slice, TICK_NSEC), se);
return clamp(vlag, -limit, limit);
这个 clamp
很重要:论文里的稳态界不能直接照搬到有加入、离开、reweight
的真实系统,Linux 明确把 vlag 限制在和
slice、tick 粒度相关的范围里。判定 eligible
时,entity_eligible() 只是转调
vruntime_eligible();后者没有直接用除法后的
avg_vruntime() >= se->vruntime,而是用未除的加权和比较,避免精度损失:
return avg >= (s64)(vruntime - cfs_rq->min_vruntime) * load;virtual deadline
v6.12 的 update_deadline()
与源码注释对应:
/* Linux v6.12 kernel/sched/fair.c, update_deadline(),有删减 */
if ((s64)(se->vruntime - se->deadline) < 0)
        return false;
if (!se->custom_slice)
        se->slice = sysctl_sched_base_slice;
se->deadline = se->vruntime + calc_delta_fair(se->slice, se);
return true;
同文件顶部给出的默认 sysctl_sched_base_slice
是 750000 ns。这个值不是“每个任务固定跑 0.75
ms”的承诺,而是计算请求长度与 deadline 的基准;真实执行还受
tick、抢占、custom_slice、cgroup
和调度类层级影响。
v6.6 到 v6.12 的实现差异
v6.6 的 __pick_eevdf() 注释说红黑树“按
service 排序”,同时在节点上维护
min_deadline,搜索 eligible 子树里的最早
deadline。v6.12 的 pick_eevdf() 注释改成:树按
deadline 排序,同时维护
min_vruntime 来剪枝
eligibility。两者都不是“取红黑树最左节点”这么简单;共同逻辑是:先排除不
eligible 的实体,再在剩余候选中找最早 virtual deadline。
六、确定性模拟:短请求任务为什么平均更早被调度
模拟器在
reproduce/cpu_sched_sim.py。它刻意只保留两条规则:
- CFS:在 runnable 任务中选最小
vruntime。 - EEVDF:先选 \(V-v_i\ge
0\) 的 eligible 任务,再选最早
deadline。
工作负载是 \(N\) 个一直可运行的批处理任务,每个请求长度为 6 ms;另有一个延迟敏感任务每 20 ms 醒来一次,每次只需要 1 ms CPU。所有任务权重相同。指标是模拟时间,不依赖墙钟,也没有随机种子。
复现命令:
cd post/algorithms/53-cpu-scheduling
python3 reproduce/cpu_sched_sim.py
cat reproduce/results/summary.txt
本次运行环境:Intel Core i9-12900K,WSL2 Linux 6.6.87.2,Python 3.14.5。输出摘要如下:
| 批处理任务数 | 调度器 | p50 延迟 | p95 延迟 | 平均延迟 | 最大延迟 | lag 范围 |
|---|---|---|---|---|---|---|
| 4 | CFS | 2 ms | 4 ms | 2.50 ms | 4 ms | [-0.800, 0.800] ms |
| 4 | EEVDF | 0 ms | 3 ms | 0.40 ms | 4 ms | [-0.800, 0.800] ms |
| 8 | CFS | 5 ms | 8 ms | 4.54 ms | 8 ms | [-0.889, 0.889] ms |
| 8 | EEVDF | 0 ms | 6 ms | 0.72 ms | 8 ms | [-0.889, 0.889] ms |
| 12 | CFS | 6 ms | 12 ms | 6.54 ms | 12 ms | [-0.923, 0.923] ms |
| 12 | EEVDF | 0 ms | 9 ms | 1.09 ms | 12 ms | [-0.923, 0.923] ms |
| 16 | CFS | 9 ms | 16 ms | 8.62 ms | 16 ms | [-0.941, 0.941] ms |
| 16 | EEVDF | 0 ms | 11 ms | 1.36 ms | 16 ms | [-0.941, 0.941] ms |
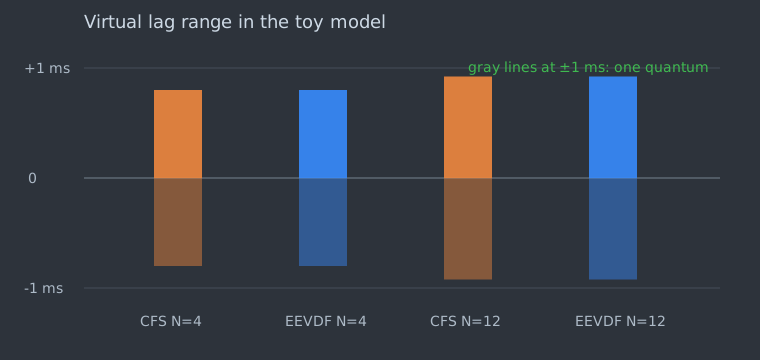
这组数说明两件事。
第一,EEVDF 在这个模型里没有给 1 ms 任务更多 CPU 份额;lag 范围与 CFS 相同,始终落在 1 ms 调度量子以内。它改变的是 eligible 任务之间的顺序:短请求任务的 virtual deadline 更早,所以平均 dispatch delay 明显降低。
第二,最大延迟没有消失。若短任务刚好在不利相位醒来,它仍可能等到一轮批处理任务让出。把这张表解释成“EEVDF 保证真实 Linux 上 p95 降到某个值”是不对的;它只能支持本文的机制结论:deadline 能在不破坏 lag 界的前提下改变短请求任务的排队位置。
七、工程边界:哪些结论不能外推
nice 与 slice 不是实时保证
nice 只改变权重 \(w_i\),从而改变
vruntime 的增长速度和 deadline
的归一化长度。它不保证某个任务在固定毫秒内被调度,也不绕过更高优先级的
SCHED_DEADLINE、SCHED_FIFO、SCHED_RR
调度类。
sleeper 不是免费获得 CPU
早期 CFS 围绕睡眠任务有多种 sleeper fairness 补偿。EEVDF 用 lag 表达“欠账”,但 Linux 文档也明确提到 sleeping task 的 lag 管理仍有讨论:当前实现会让睡眠任务以 deferred dequeue 的方式保留在运行队列一段虚拟时间,使负 lag 衰减,避免“睡一下就清零超额服务”的投机行为。这里的行为是版本相关的,不能用论文公式一句话概括。
单核公平模型不解决 SMP 负载均衡
Fair Queueing、CFS 和 EEVDF
的核心公式最自然地适用于一个服务点。Linux 在多核上还要解决
CPU 选择、迁移成本、缓存热度、能效、NUMA 拓扑和 cgroup
层级。kernel/sched/fair.c 的大部分行数不在
pick_eevdf(),而在 PELT 负载跟踪、wake
affine、idle CPU 选择、load balance 等路径上。
6.12 的
sched_ext 是另一条实验路线
Linux 6.12 的 sched_ext 把一类调度策略交给 BPF
程序:任务唤醒时可以走
ops.select_cpu(),入队时走
ops.enqueue(),调度时通过 dispatch
queue(DSQ)把任务交给 CPU。官方文档强调,BPF scheduler
可动态启用/禁用,出错时回退默认调度器。它解决的是“如何安全实验新策略”,不是取代
fair class 里 CFS/EEVDF 的数学问题。
八、争论与开放问题
延迟还是吞吐。 EEVDF 让短 slice 任务更容易早跑,但更频繁的抢占可能损失 cache locality。这个权衡没有一个全局最优参数;桌面、音频、编译、数据库和虚拟化负载的目标函数不同。
lag 如何随 sleep/reweight 变化。 论文分析通常假设 join/leave 条件较干净;Linux 源码注释也写到,实体加入、离开、reweight 会移动虚拟时间,可能让 lag 变大,所以实现里要 clamp。睡眠任务 lag 衰减仍是工程讨论点。
可观测性仍然困难。 真实调度延迟需要结合
perf sched timehist、perf sched latency、ftrace、PSI
与应用自己的 tail latency。只看 top 里的 CPU
百分比,无法判断任务是在公平排队、被 cgroup
throttle,还是卡在锁、I/O 或 GC。
九、参考资料
规范与文档
- Linux kernel documentation, “CFS Scheduler”,说明 CFS
合入 2.6.23、理想多任务 CPU、
p->se.vruntime与红黑树设计。 - Linux kernel documentation, “EEVDF Scheduler”,说明
EEVDF 的 lag、eligible、virtual deadline、sleeping task lag
decay 与
sched_setattr()自定义 slice。 - Linux kernel documentation, “Extensible Scheduler
Class”,说明 sched_ext 的 BPF
scheduler、
ops.select_cpu()、ops.enqueue()与 DSQ。
源码
- Linux v6.6,
kernel/sched/fair.c:entity_eligible()、update_entity_lag()、__pick_eevdf()、update_deadline()。 - Linux v6.12,
kernel/sched/fair.c:avg_vruntime()、entity_lag()、vruntime_eligible()、pick_eevdf()、update_deadline()、sysctl_sched_base_slice。 - Linux v6.12,
include/linux/sched.h:struct sched_entity中的deadline、min_vruntime、min_slice、vruntime、vlag、slice。
核心论文
- Alan Demers, Srinivasan Keshav, Scott Shenker, “Analysis and Simulation of a Fair Queueing Algorithm”, SIGCOMM 1989.
- Carl A. Waldspurger, William E. Weihl, “Lottery Scheduling: Flexible Proportional-Share Resource Management”, OSDI 1994.
- Carl A. Waldspurger, William E. Weihl, “Stride Scheduling: Deterministic Proportional-Share Resource Management”, MIT/LCS/TM-528, 1995.
- Ion Stoica, Hussein Abdel-Wahab, “Earliest Eligible Virtual Deadline First: A Flexible and Accurate Mechanism for Proportional Share Resource Allocation”, Old Dominion University Technical Report TR-95-22, 1995.
- Ion Stoica, Hussein Abdel-Wahab, Kevin Jeffay, Sanjoy K. Baruah, Johannes Gehrke, C. Greg Plaxton, “A Proportional Share Resource Allocation Algorithm for Real-Time, Time-Shared Systems”, RTSS 1996.
工程资料
- Ingo Molnar, CFS merge/design materials around Linux 2.6.23, 2007.
- Peter Zijlstra, EEVDF patch series and follow-up discussions; LWN, “An EEVDF CPU scheduler for Linux” and “Improvements for Linux’s EEVDF scheduler”。
实验
reproduce/cpu_sched_sim.py:本文第六节表格与两张 SVG 的来源;输出写入reproduce/results/latency.csv与reproduce/results/summary.txt。
系列导航: - 上一篇:页面置换算法:从 OPT、LRU 到 ARC 与 Linux 页面回收 - 下一篇:I/O 调度:在寻道、队列深度与公平性之间取舍
相关阅读: - 红黑树与 AVL:旋转次数、树高与 Linux 内核的选择 - 页面置换算法:从 OPT、LRU 到 ARC 与 Linux 页面回收 - 数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
EEVDF 调度器:Linux 6.6 为什么换掉了 CFS
Linux 6.6 用 EEVDF 取代了 CFS 的 SCHED_NORMAL 选取逻辑。从 1995 年原始论文的 lag、eligibility、virtual deadline,到 commit 147f3ef 只重写 placement/pick/preempt,再到本机内核 6.6 上读 sched/debug 把每个任务的 vruntime、eligible 标志、deadline 一一对上 vd=ve+r/w,外加 nice 带宽与 base_slice 抢占两组实测,讲清换的是哪一块、延迟敏感任务凭什么先跑。
I/O 调度:在寻道、队列深度与公平性之间取舍
从电梯算法到 blk-mq,解释 Linux I/O 调度器为何在 HDD 上排序、在共享设备上保公平、在 NVMe 上常选择 none,并用确定性模拟展示寻道距离与队列尾延迟的取舍。
伙伴系统与 SLUB:Linux 物理页和小对象分配的边界
以 Linux v6.6 源码和确定性模拟为准,解释伙伴系统的 split/coalesce、migratetype 反碎片策略,以及 SLUB 的 per-CPU freelist、partial list 与安全加固。
用户态内存分配器:size class、线程缓存与碎片边界
从 Wilson 分配器综述到 jemalloc、gperftools tcmalloc 与 mimalloc 的源码路径,解释 size class、线程缓存、跨线程释放和 RSS 碎片;用可复现实验说明不能只凭 allocator 名字下结论。