关于页面置换,流传最广的是三种说法:教科书说 LRU 是 OPT 的好近似;工程师说 LRU 怕全表扫描;于是有人把 ARC 当成”自适应、所以总是更好”的默认答案。三句话都只对一半。LRU 在 Zipf 负载上确实比 FIFO 好,但在”比缓存大一页”的循环上缺页率是 100%;ARC 能挡住扫描,却在同一个循环上和 LRU 一样全军覆没;而 ARC 论文给出的是经验上的自适应,不是一条定理。
本文按”问题模型 → 经典算法 → 失效模式 → 抗扫描谱系 →
Linux 实现 →
争论”的顺序展开。所有命中率与缺页数都来自同目录下的模拟器
reproduce/policy_sim.c(实验环境见第五节);所有
Linux 行为都以 v6.12 源码为准。
一、问题模型:在线分页与 OPT
缓存抽象
把问题抽象成在线分页(online paging):
- 快速存储能放 \(k\) 个页面(页框数,下文在 ARC 语境里也记作 \(c\));
- 请求序列 \(\sigma = r_1, r_2, \ldots, r_n\) 逐个到达;
- 请求的页面在缓存里就是命中,代价 0;不在就是缺页,代价 1,缓存满时必须先淘汰一页;
- 在线算法只能看到当前与过去的请求,目标是最小化缺页次数。
这个模型同时覆盖操作系统的页面置换、数据库缓冲池、Redis
的 maxmemory 淘汰和 CDN
缓存。它刻意忽略了三件事,后文都会回来补:页面大小是否相同、写回脏页的代价、以及淘汰发生在什么时刻。教科书里”缺页时选一个牺牲页”的描述,在
Linux 里被拆成了后台回收和同步回收两条路径(第八节)。
缺页按成因可以分两类:第一次访问一个页面的强制缺页(compulsory miss)任何算法都躲不掉;其余缺页取决于容量和策略。硬件缓存常用的”3C”分类里还有冲突缺页(conflict miss),它来自组相联映射(Hill & Smith, 1989),在全相联的分页模型里不存在,不要拿它指代”策略选错导致的缺页”。
Bélády 的 OPT
Bélády 在 1966 年的 IBM Systems Journal 论文里提出了 MIN 策略,今天通常叫 OPT:
缺页时,淘汰下一次被引用最晚(或永远不再被引用)的页面。
命题:对任意请求序列,OPT 的缺页数不超过任何算法(包括离线算法)。严格证明见 Mattson 等人(1970);常见的交换论证如下。
设算法 \(A\) 与 OPT 在前 \(i-1\) 次请求上的淘汰决策相同,第 \(i\) 次缺页时 \(A\) 淘汰 \(u\)、OPT 淘汰 \(v\)。按 OPT 的定义,\(u\) 的下一次引用不晚于 \(v\)。构造 \(A'\):第 \(i\) 步改为淘汰 \(v\),之后模仿 \(A\),只在两者缓存不同的那一页上做对应替换,一旦缓存重合就完全照抄 \(A\)。在缓存重合之前,\(A'\) 只会在请求 \(v\) 时”吃亏”(\(A\) 命中、\(A'\) 缺页);而由于 \(u\) 的下一次引用不晚于 \(v\),\(A'\) 在此之前至少”占便宜”一次(请求 \(u\) 时 \(A\) 缺页、\(A'\) 命中)。所以 \(A'\) 的缺页数不超过 \(A\),而且与 OPT 一致的前缀长了一步。对 \(i\) 归纳,就能把任意 \(A\) 逐步改写成 OPT 而缺页数不增。\(\blacksquare\)
OPT 需要知道未来,不可实现。它的用途是离线基线:拿到一条 trace,先算 OPT,再看在线算法离它有多远。本文所有实验表格的第一行都是 OPT。
二、FIFO 与 Bélády 异常
FIFO 淘汰最早进入缓存的页面,一个环形队列就够了:
typedef struct {
    int *pages;
    int capacity;
    int head;
    int count;
} FIFOCache;

int fifo_access(FIFOCache *cache, int page) {
    for (int i = 0; i < cache->count; i++) {
        if (cache->pages[(cache->head + i) % cache->capacity] == page)
            return 1;  /* 命中 */
    }
    if (cache->count < cache->capacity) {
        cache->pages[(cache->head + cache->count) % cache->capacity] = page;
        cache->count++;
    } else {
        cache->pages[cache->head] = page;
        cache->head = (cache->head + 1) % cache->capacity;
    }
    return 0;  /* 缺页 */
}
Bélády、Nelson 和 Shedler 在 1969 年的 CACM 论文里报告了一个反直觉现象:FIFO 增加页框反而可能增加缺页,即 Bélády 异常(Bélády’s anomaly)。经典反例是序列 1, 2, 3, 4, 1, 2, 5, 1, 2, 3, 4, 5。
3 个页框(每列是处理完该请求后的页框内容,F 表示缺页),共 9 次缺页:
| 请求 | 1 | 2 | 3 | 4 | 1 | 2 | 5 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 页框 0 | 1 | 1 | 1 | 4 | 4 | 4 | 5 | 5 | 5 | 5 | 5 | 5 |
| 页框 1 | - | 2 | 2 | 2 | 1 | 1 | 1 | 1 | 1 | 3 | 3 | 3 |
| 页框 2 | - | - | 3 | 3 | 3 | 2 | 2 | 2 | 2 | 2 | 4 | 4 |
| 缺页 | F | F | F | F | F | F | F | F | F |
4 个页框,共 10 次缺页:
| 请求 | 1 | 2 | 3 | 4 | 1 | 2 | 5 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 页框 0 | 1 | 1 | 1 | 1 | 1 | 1 | 5 | 5 | 5 | 5 | 4 | 4 |
| 页框 1 | - | 2 | 2 | 2 | 2 | 2 | 2 | 1 | 1 | 1 | 1 | 5 |
| 页框 2 | - | - | 3 | 3 | 3 | 3 | 3 | 3 | 2 | 2 | 2 | 2 |
| 页框 3 | - | - | - | 4 | 4 | 4 | 4 | 4 | 4 | 3 | 3 | 3 |
| 缺页 | F | F | F | F | F | F | F | F | F | F |
看第 7 个请求(页面 5)之后的状态:3 页框时缓存是 \(\{1,2,5\}\),4 页框时是 \(\{2,3,4,5\}\)。页面 1 在小缓存里、却不在大缓存里——小缓存的内容不是大缓存的子集,这正是异常的根源。下一节的栈算法就是用”包含性”排除这种情况。
用模拟器对同一序列跑所有策略(缺页次数):
| 策略 | \(k=3\) | \(k=4\) |
|---|---|---|
| OPT | 7 | 6 |
| FIFO | 9 | 10 |
| LRU | 10 | 8 |
| CLOCK | 9 | 10 |
| 2Q | 11 | 9 |
| ARC | 10 | 7 |
CLOCK 在这条短序列上和 FIFO 一样出现了异常;LRU 在 \(k=3\) 时比 FIFO 还多一次缺页,但不会出现异常。短序列只能说明性质,不能用来排名。
三、LRU:栈算法、stack distance 与竞争比
LRU(Least Recently Used)淘汰最近一次使用时间最早的页面。它的依据是时间局部性:刚被用过的页面更可能很快再被用到。
栈算法与包含性
Mattson、Gecsei、Slutz 和 Traiger(1970)定义了栈算法(stack algorithm):设 \(B_t(k)\) 为时刻 \(t\)、使用 \(k\) 个页框时的缓存内容,若对所有 \(t\) 与 \(k\) 都有
\[ B_t(k) \subseteq B_t(k+1), \]
则称该算法满足包含性(inclusion property)。
推论:栈算法没有 Bélády 异常。\(k\) 个页框时的每次命中,页面也在 \(B_t(k+1)\) 中,所以在 \(k+1\) 个页框时同样命中;缺页数随 \(k\) 单调不增。
LRU 是栈算法:它维护一个按最近使用时间排序的栈,\(k\) 个页框的缓存就是栈顶 \(k\) 个元素,自然是栈顶 \(k+1\) 个元素的子集。OPT 也是栈算法;FIFO 不是,上一节的反例就是证据。
Stack distance:一次模拟得到整条缺页曲线
包含性带来一个实用工具:对每次引用,记录该页面在 LRU 栈中的深度 \(d\)(栈顶为 1,首次出现记 \(\infty\))。那么对任意 \(k\),
\[ \text{faults}_{\text{LRU}}(k) = \#\{\, i : d_i > k \,\}. \]
以第二节的 12 个请求为例,stack distance 依次是 \(\infty, \infty, \infty, \infty, 4, 4, \infty, 3, 3, 5, 5, 5\)。于是 \(k=3\) 时缺页 \(5 + 5 = 10\),\(k=4\) 时 \(5 + 3 = 8\),与上表的模拟结果一致。一次扫描 trace 就能得到所有缓存大小下的缺页率曲线(miss ratio curve),这是缓存容量规划的基础工具。
LRU 与 OPT 的关系:不是”时间镜像”
常见说法是”OPT 看未来,LRU 看过去,所以 LRU 是 OPT 的镜像”。这只是直觉,不是定理。在独立引用模型(Independent Reference Model,IRM:每次请求独立地按固定分布抽样)下,Aho、Denning 和 Ullman(JACM 1971)证明,最优的在线策略是始终淘汰驻留页中访问概率最小的那一页(他们称为 \(A_0\)),这是一种依据频率而不是最近性的策略,LRU 在 IRM 下并不最优。第五节的纯 Zipf 实验能看到这一点:缓存为 500 页时,考虑频率的 2Q、ARC 比 LRU 高 9 到 10 个百分点,缓存越大差距越小。LRU 的真正优势是不需要估计概率、并且能很快跟上负载的阶段变化;Johnson 和 Shasha 在 2Q 论文里也观察到,局部性突变后 LRU 恢复得最快。
竞争比:最坏情况下 LRU 已经最优
在线算法 \(A\) 是 \(\alpha\)-竞争的(competitive),如果存在常数 \(\beta\),使得对所有序列 \(\sigma\):
\[ \text{cost}_A(\sigma) \le \alpha \cdot \text{cost}_{\text{OPT}}(\sigma) + \beta. \]
Sleator 和 Tarjan(CACM 1985)证明:缓存大小为 \(k\) 时 LRU 与 FIFO 都是 \(k\)-竞争的,并且任何确定性在线算法的竞争比都不可能低于 \(k\)。下界的构造是循环访问 \(k+1\) 个页面:LRU 每次都缺页,OPT 每 \(k\) 次请求只缺一次(第五节实测 OPT 缺页率 1.10%,\(k=100\))。
同一篇论文还给出了一个更有工程意义的结果:如果在线算法有 \(k\) 个页框、而 OPT 只有 \(h \le k\) 个,LRU 的竞争比是 \(\frac{k}{k-h+1}\)。取 \(k = 2h\),比值不到 2。换句话说,最坏情况分析支持的是”给缓存留余量”,而不是”换一个更聪明的算法”。竞争分析的完整推导见站内 竞争分析 第五节。
四、从精确 LRU 到 CLOCK
软件缓存里的精确 LRU
在应用层缓存里,精确 LRU 用哈希表加双向链表就能做到每次操作期望 \(O(1)\)。关键在于两套索引指向同一批节点:哈希表负责”按 key 找到节点”,双向链表负责”按最近使用时间给节点排序”。
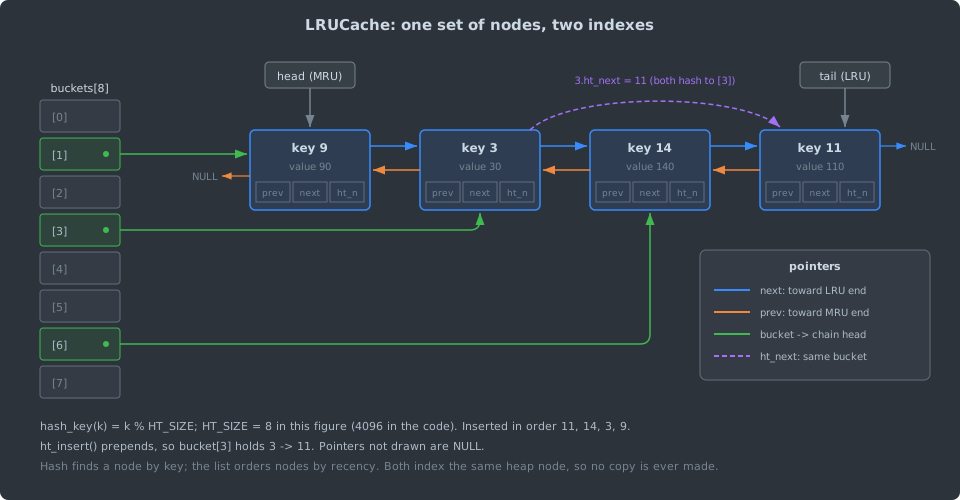
图中按顺序插入了 11、14、3、9,为了便于画图,把
HT_SIZE 取成 8(代码里是
4096),hash_key(k) = k % 8。每个节点有三个指针:prev
和 next 属于双向链表,ht_next
属于哈希桶的单链表。
- 3 和 11 都落在桶 [3],
ht_insert()总是插到桶链头部,所以桶 [3] 的顺序是 3 → 11。 - 链表头
head是最近访问的 9,链表尾tail是最久未访问的 11,也就是下一个淘汰对象。 - 节点只分配一次。哈希表和链表存的都是指向它的指针,移动位置时不拷贝数据。
下面是核心逻辑(省略了初始化和错误处理):
#include <stdlib.h>

#define HT_SIZE 4096

typedef struct LRUNode {
    int key;
    int value;
    struct LRUNode *prev;
    struct LRUNode *next;
    struct LRUNode *ht_next;  /* 哈希桶链 */
} LRUNode;

typedef struct {
    int capacity;
    int size;
    LRUNode *head;   /* MRU 端 */
    LRUNode *tail;   /* LRU 端,淘汰候选 */
    LRUNode *buckets[HT_SIZE];
} LRUCache;

static unsigned hash_key(int key) { return (unsigned)key % HT_SIZE; }

static LRUNode *ht_lookup(LRUCache *c, int key) {
    for (LRUNode *n = c->buckets[hash_key(key)]; n; n = n->ht_next)
        if (n->key == key) return n;
    return NULL;
}

static void ht_insert(LRUCache *c, LRUNode *node) {
    unsigned h = hash_key(node->key);
    node->ht_next = c->buckets[h];
    c->buckets[h] = node;
}

static void ht_remove(LRUCache *c, LRUNode *node) {
    LRUNode **pp = &c->buckets[hash_key(node->key)];
    while (*pp != node) pp = &(*pp)->ht_next;
    *pp = node->ht_next;
}

static void detach(LRUCache *c, LRUNode *node) {
    if (node->prev) node->prev->next = node->next; else c->head = node->next;
    if (node->next) node->next->prev = node->prev; else c->tail = node->prev;
}

static void push_front(LRUCache *c, LRUNode *node) {
    node->prev = NULL;
    node->next = c->head;
    if (c->head) c->head->prev = node;
    c->head = node;
    if (!c->tail) c->tail = node;
}

int lru_get(LRUCache *c, int key) {
    LRUNode *node = ht_lookup(c, key);
    if (!node) return -1;
    detach(c, node);
    push_front(c, node);
    return node->value;
}

void lru_put(LRUCache *c, int key, int value) {
    LRUNode *node = ht_lookup(c, key);
    if (node) {
        node->value = value;
        detach(c, node);
        push_front(c, node);
        return;
    }
    if (c->size == c->capacity) {
        LRUNode *victim = c->tail;
        detach(c, victim);
        ht_remove(c, victim);
        free(victim);
        c->size--;
    }
    node = calloc(1, sizeof(LRUNode));
    node->key = key;
    node->value = value;
    ht_insert(c, node);
    push_front(c, node);
    c->size++;
}
两种操作各自改了哪些指针,见下图(接着上图的状态,先
lru_get(c, 3),再
lru_put(c, 5, 50),容量为 4):
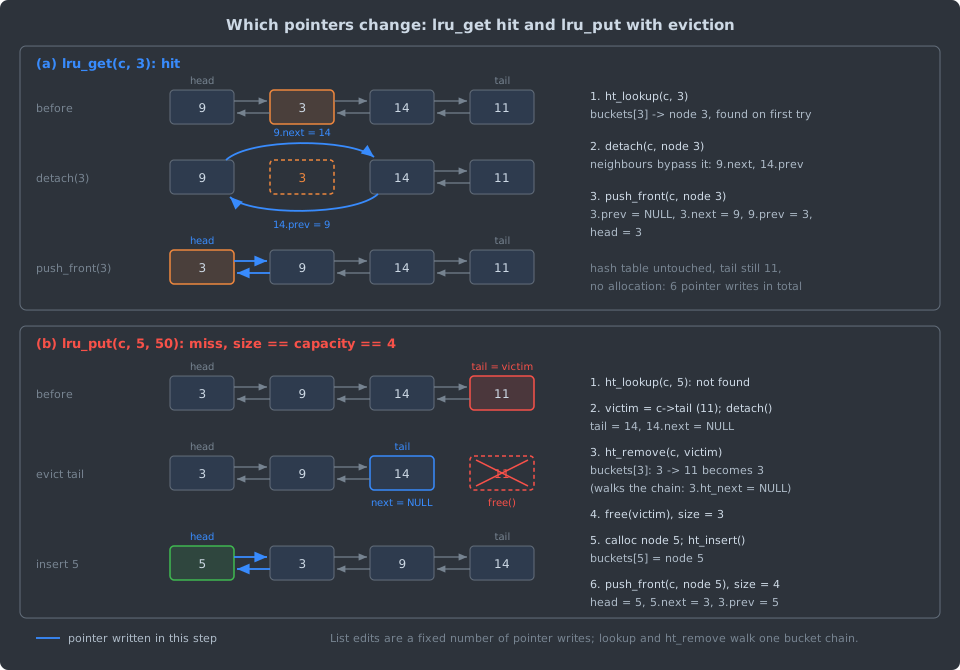
- 命中(a):
ht_lookup()在桶 [3] 的第一个节点就找到 3。detach()让前驱 9 和后继 14 直接互指,把 3 摘下来;push_front()再把它接到 9 前面并更新head。整个过程只写 6 个指针,哈希表不动,也没有内存分配。 - 未命中且已满(b):淘汰对象就是
tail指向的 11。先detach()把tail改到 14,再ht_remove()沿桶 [3] 的链找到 11 并摘除(3 的ht_next变回 NULL),然后free()。新节点 5 用calloc()分配,插进桶 [5],最后push_front()成为新的head。
链表部分每一步都只改固定数量的指针;哈希部分的
ht_lookup() 和 ht_remove()
要走一条桶链,桶数与容量相当时链很短,所以是期望 \(O(1)\),不是最坏 \(O(1)\)。
每次命中都要改链表(图 (a) 中是 6 次指针写),意味着每次读都是一次写共享结构。并发下这就是锁热点:PostgreSQL 8.1 重写缓冲管理器时,提交说明写得很直接——全局空闲链表是争用点,因此”ARC、2Q 以及普通 LRU 都不再可用”,改为 clock sweep。
操作系统为什么只能近似
操作系统的问题更根本:用户态程序访问内存由 MMU 直接完成,内核看不到每次访问,只能在缺页或主动扫描页表时得到信息。要维护精确 LRU,就得让每次访问都陷入内核,这不可行。硬件给出的替代品是页表项里的访问位:x86 的 Accessed 标志在处理器访问页面时被置 1,由软件清零(Intel SDM Vol. 3A,4.8 节)。
CLOCK
CLOCK(也叫 second chance)由 Corbató 在 1968 年 Multics 的分页实验中提出:页框排成一个环,时钟指针扫描,遇到引用位为 1 的页面就清零放过,遇到 0 就淘汰。
typedef struct {
    int *pages;
    int *ref_bits;
    int capacity;
    int hand;
    int count;
} ClockCache;

int clock_evict(ClockCache *cache) {
    while (1) {
        if (cache->ref_bits[cache->hand] == 0) {
            int victim = cache->hand;
            cache->hand = (cache->hand + 1) % cache->capacity;
            return victim;
        }
        cache->ref_bits[cache->hand] = 0;  /* 第二次机会 */
        cache->hand = (cache->hand + 1) % cache->capacity;
    }
}

int clock_access(ClockCache *cache, int page) {
    for (int i = 0; i < cache->count; i++) {
        if (cache->pages[i] == page) {
            cache->ref_bits[i] = 1;
            return 1;  /* 命中 */
        }
    }
    int victim = cache->count < cache->capacity ? cache->count++ : clock_evict(cache);
    cache->pages[victim] = page;
    cache->ref_bits[victim] = 1;
    return 0;  /* 缺页 */
}
下图用上面的代码跑一个 6 个页框的例子:先装入页面 1 到 6,访问 7(缺页,淘汰了页面 1),再命中 2 和 3,然后访问 8。
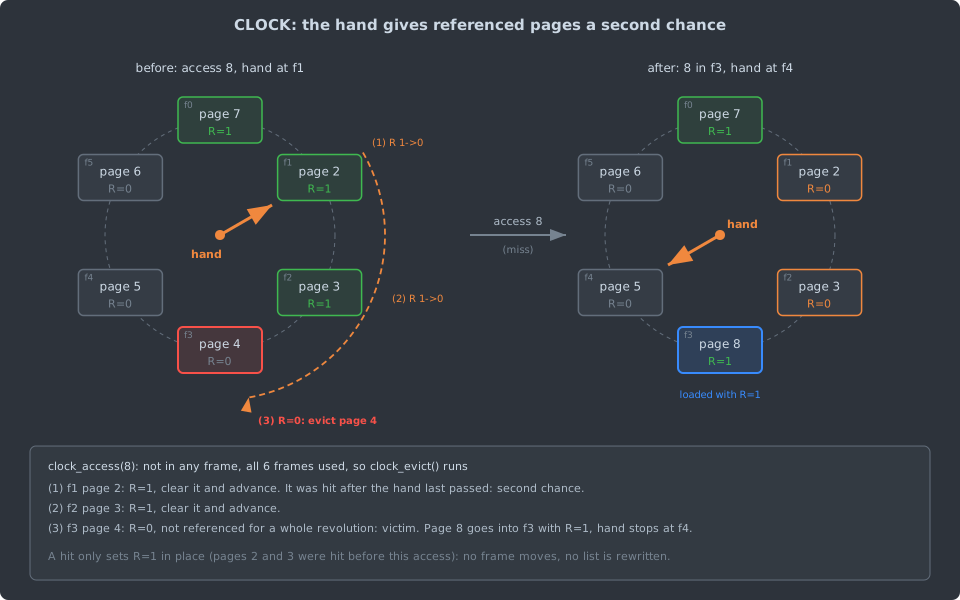
- 环就是
pages[]数组,hand是下标,走到末尾后取模回到 0。 - 页面 2 和 3 在指针上次经过之后被命中过,所以引用位是 1。指针经过时把它们清零放过,这就是”第二次机会”。
- 页面 4 在指针转完一整圈的时间里没有被访问过,引用位还是 0,成为牺牲页。新页面 8 装进同一个页框,引用位置 1,指针停在下一个位置 f4。
- 命中 2 和 3 时,代码只执行了
ref_bits[i] = 1,没有移动任何页框。对照 LRU 那张图里一次命中要写 6 个指针,这就是 CLOCK 适合操作系统的原因:硬件在访问时自动置位,软件只在需要淘汰时才去扫描。
CLOCK 把 LRU 的全序压缩成 1 bit:“上一圈以来用过”和”没用过”。命中只需要置位,不改任何共享链表。代价是:内存压力大、指针转得快时,几乎所有页面都在被再次访问前被扫到,行为退化为 FIFO。上例中访问 7 的那一步就是最极端的情况:
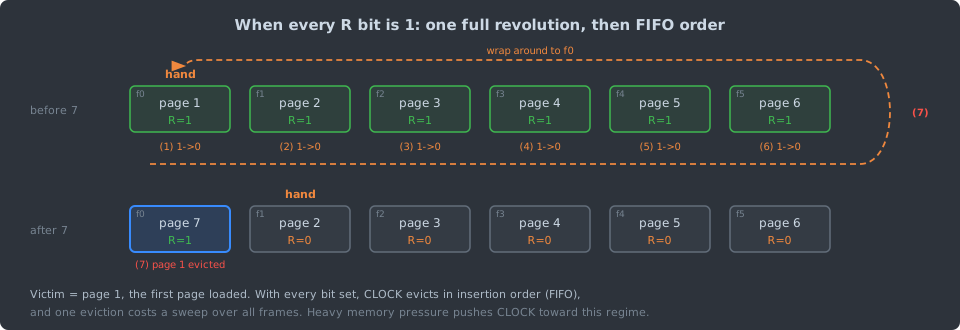
所有引用位都是 1 时,指针要把整圈清零一遍,再回到出发点,淘汰的是最早装入的页面 1,和 FIFO 的选择一样;而且这一次淘汰要扫过全部页框。第五节的 Zipf 实验里,CLOCK 的命中率比 LRU 低 0.2 到 1.2 个百分点。加入脏位 \(M\) 的增强版(按 \((R, M)\) 分四类,优先淘汰 \((0,0)\))可以少写回一些脏页。
五、LRU 在哪里失效:循环与扫描的实测
实验环境与口径
- 模拟器:
reproduce/policy_sim.c,实现 OPT、FIFO、LRU、CLOCK、RANDOM、2Q(论文完整版,\(K_{in}=25\%\)、\(K_{out}=50\%\))与 ARC(论文 Figure 4)。 - 编译运行:
gcc -O2 -Wall -Wextra -o policy_sim policy_sim.c -lm && ./policy_sim。 - 环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,GCC 16.1.1。
- 指标是命中率或缺页数,与时钟无关;模拟器使用固定随机种子,连续运行 3 次输出逐字节一致。RANDOM 取 5 个种子的中位数。
- trace 是合成的,用来展示机制差异,不代表真实系统上的排名。
循环:比缓存大一页就全军覆没
循环访问 101 个页面,缓存 100 页,共 101,000 次请求:
| 策略 | 缺页数 | 缺页率 |
|---|---|---|
| OPT | 1,109 | 1.10% |
| FIFO | 101,000 | 100.00% |
| LRU | 101,000 | 100.00% |
| CLOCK | 101,000 | 100.00% |
| RANDOM | 2,100 | 2.08% |
| 2Q | 4,091 | 4.05% |
| ARC | 101,000 | 100.00% |
LRU 每次要的都恰好是刚被淘汰的那一页;FIFO 和 CLOCK 在这里与 LRU 行为相同,同样 100%。OPT 每 \(k\) 次请求缺一次,缺页率约 \(1/k\)。RANDOM 反而表现很好,因为它不遵守严格的年龄顺序,一部分页面能跨轮驻留;2Q 的 Am 区只在 A1in 不超额时才淘汰,也让一部分页面留了下来。
ARC 为什么也是 100%?页面 \(x\) 再次被引用时,两次引用之间出现了 \(c\) 个其他页面;而纯循环里没有任何命中,所有页面都停留在 \(L_1 = T_1 \cup B_1\) 中,\(|L_1| \le c\) 只能记住最近的 \(c\) 个页面,\(x\) 恰好是第 \(c+1\) 个,所以 ghost 里找不到它,每次都落入”完全未命中”分支,行为退化为 LRU。ghost 列表只能纠正”差一点就命中”的淘汰,纠正不了重用距离超过 \(c\) 的模式。LIRS(Jiang & Zhang, SIGMETRICS 2002)用重用距离而不是最近性来排序,正是针对这类弱局部性模式设计的。
扫描:Zipf 热点混入一次性顺序读
热点请求服从 Zipf 分布(\(\alpha = 0.9\),20,000 个页面),共 2,000,000 次请求。E3b 在其中插入长度 5,000 的顺序扫描,扫描页面只出现一次,实测占全部请求的 34.5%。表中是非扫描请求的命中率(扫描请求对所有策略都必然缺页)。
纯 Zipf(E3a):
| 策略 | \(c=500\) | \(c=1000\) | \(c=2000\) | \(c=5000\) |
|---|---|---|---|---|
| OPT | 59.29% | 67.24% | 75.47% | 86.39% |
| FIFO | 34.77% | 43.19% | 52.81% | 67.95% |
| LRU | 38.92% | 47.55% | 57.32% | 72.17% |
| CLOCK | 37.77% | 46.40% | 56.19% | 71.24% |
| RANDOM | 34.76% | 43.19% | 52.84% | 67.95% |
| 2Q | 47.70% | 55.03% | 63.02% | 74.75% |
| ARC | 48.89% | 56.07% | 63.78% | 74.80% |
Zipf 混入扫描(E3b):
| 策略 | \(c=500\) | \(c=1000\) | \(c=2000\) | \(c=5000\) |
|---|---|---|---|---|
| OPT | 59.22% | 67.16% | 75.38% | 86.22% |
| FIFO | 34.33% | 42.15% | 50.21% | 59.29% |
| LRU | 38.20% | 45.88% | 53.36% | 60.73% |
| CLOCK | 37.16% | 44.94% | 52.65% | 60.49% |
| RANDOM | 33.95% | 41.19% | 48.55% | 58.46% |
| 2Q | 47.71% | 55.03% | 63.03% | 74.27% |
| ARC | 48.91% | 56.19% | 64.16% | 76.26% |
三点观察:
- LRU 并不”差”。在纯 Zipf 上它比 FIFO 高 4 到 5 个百分点。但它离 OPT 很远,因为 Zipf 是 IRM 负载,频率信息比最近性更有用,所以 2Q、ARC 在 \(c=500\) 时领先 LRU 9 到 10 个百分点,到 \(c=5000\) 时差距缩小到 2.6 个百分点。FIFO 与 RANDOM 的命中率几乎相同,这与 IRM 下两者命中率相等的理论结果一致(Gelenbe 1973)。
- 扫描伤害随缓存变大而放大。\(c=500\) 时 LRU 只掉了 0.7 个点,\(c=5000\) 时掉了 11.4 个点(72.17% 到 60.73%):缓存越大,本该留住的热点越多,被 5,000 页的扫描一次冲掉的也越多。
- 2Q 与 ARC 几乎不受扫描影响。扫描页面进入 A1in 或 T1 后只会被淘汰进 ghost,不会再被命中,也就不会占用保护区。ARC 在 \(c=5000\) 时甚至略有上升(74.80% 到 76.26%)。本实验没有拆分原因;ARC 论文第 IV.D 节给出的一个解释是,扫描期间 B2 的命中相对 B1 变多,学习规则会让 T2 进一步扩大。
六、抗扫描谱系:LRU-K、2Q、LIRS 与 CLOCK-Pro
扫描污染的共性是:只被访问一次的页面挤占了多次访问页面的位置。从 1993 年起,数据库和操作系统两个社区各自给出了一系列答案,核心都是”第一次访问不算数”。
LRU-K 与 2Q
O’Neil、O’Neil 和 Weikum(SIGMOD 1993)提出 LRU-K:按第 \(K\) 近一次引用的时间排序淘汰,\(K=2\) 就能拿到大部分收益。代价是需要优先队列,每次访问 \(O(\log n)\)。
Johnson 和 Shasha(VLDB 1994)的 2Q 用常数时间逼近 LRU-2。完整版有三个队列:
- A1in:FIFO,存放第一次进入的页面,上限 \(K_{in}\),论文推荐为缓存的 25%;
- A1out:FIFO,只存从 A1in 淘汰出去的页面 ID,上限 \(K_{out}\),推荐为缓存页数的 50%;
- Am:LRU,存放”离开 A1in 之后又被访问”的页面。
两个细节决定了它的行为。第一,A1in 中的命中不提升,因为短时间内的第二次访问往往只是同一事务的相关引用(correlated reference)。第二,腾空间时,A1in 超额就淘汰 A1in 尾部并记入 A1out,否则直接淘汰 Am 尾部且不留 ghost。下面摘自模拟器:
/* reproduce/policy_sim.c:2Q 完整版 */
static void twoq_reclaim(TwoQ *q)
{
    if (q->am.size + q->a1in.size < q->c) return; /* a free slot exists */
    if (q->a1in.size > q->kin) {
        int y = l_pop_tail(&q->a1in);
        l_push_head(&q->a1out, y);
        q->where[y] = Q_A1OUT;
        if (q->a1out.size > q->kout) q->where[l_pop_tail(&q->a1out)] = Q_NONE;
    } else {
        q->where[l_pop_tail(&q->am)] = Q_NONE;
    }
}

static int twoq_access(TwoQ *q, int x)
{
    switch (q->where[x]) {
    case Q_AM:
        l_remove(&q->am, x);
        l_push_head(&q->am, x);
        return 1;
    case Q_A1IN:
        return 1; /* correlated reference: do not promote */
    case Q_A1OUT:
        l_remove(&q->a1out, x);
        q->where[x] = Q_NONE;
        twoq_reclaim(q);
        l_push_head(&q->am, x);
        q->where[x] = Q_AM;
        return 0;
    default:
        twoq_reclaim(q);
        l_push_head(&q->a1in, x);
        q->where[x] = Q_A1IN;
        return 0;
    }
}
论文的结论是 2Q “requires no tuning”:在 DB2 trace 上把 \(K_{in}\) 从 20% 调到 30%,命中率变化很小。这个主张后来成了争论点,ARC 论文恰恰批评 2Q、LRU-2、LIRS 的参数”没有一组对所有负载都好”。
LIRS 与 CLOCK-Pro
Jiang 和 Zhang 的 LIRS(SIGMETRICS 2002)用重用距离(inter-reference recency)区分热页和冷页。三年后,Jiang、Chen 和 Zhang 把它改造成适合虚拟内存的 CLOCK-Pro(USENIX ATC 2005)。论文摘要说得很清楚:CLOCK-Pro 受 LIRS 启发,不是从 ARC 派生的。
CLOCK-Pro 在一个环上放三类条目:hot 页、驻留的 cold 页、以及已被淘汰但仍保留元数据的 non-resident cold 页。每个 cold 页有一个测试期(test period),测试期内再次被访问就说明它的重用距离足够小,可以转为 hot。所有条目按最近性排在同一个环上,三根指针在这个环上顺时针移动:
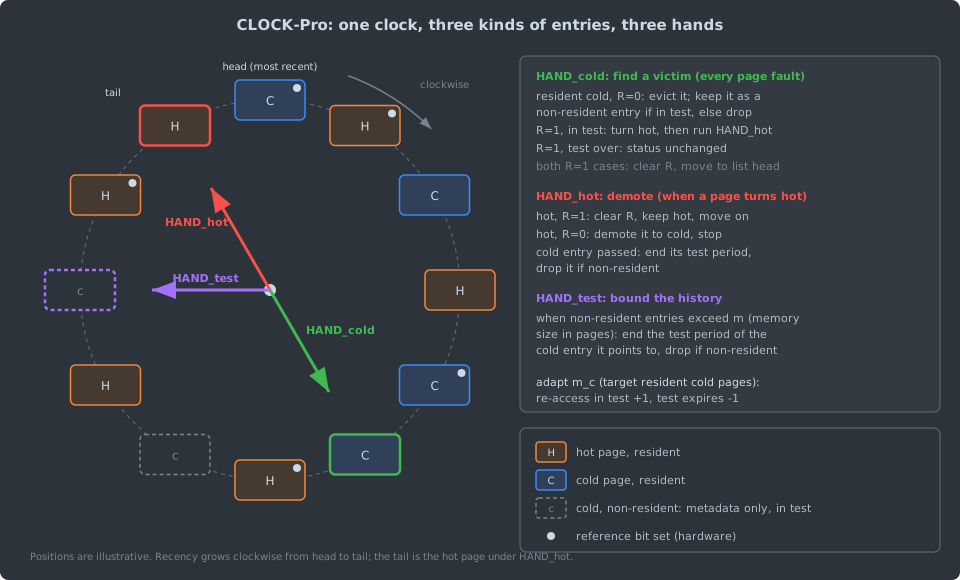
按论文第 4.2、4.3 节,三根指针的位置和分工是:
- HAND_cold 指向最后一个驻留的 cold
页,每次缺页都从这里开始找牺牲页,相当于普通 CLOCK
的那根指针。
- 引用位为 0:淘汰它。若仍在测试期,就留下 non-resident 条目,否则直接移出环。
- 引用位为 1 且在测试期内:转为 hot,并触发 HAND_hot。
- 引用位为 1 但测试期已过:状态不变。两种引用位为 1 的情况都会清零引用位,并把页面移到表头。
- HAND_hot 指向表尾,也就是最近性最大的
hot 页,它的位置就是”hot 的门槛”。只有当有页面转为 hot
时,它才会移动:
- 引用位为 1 的 hot 页清零放过,直到遇到引用位为 0 的 hot 页,把它降级为 cold。
- 沿途经过的 cold 条目会被结束测试期,其中 non-resident 条目顺带移出环。hot 页会被降级,并不是”受保护、不参与淘汰”。
- HAND_test 指向最后一个仍在测试期的 cold 条目。当 non-resident 条目数超过 \(m\)(内存页数)时,它结束所指条目的测试期,并移出 non-resident 条目,从而给历史元数据设上限,总条目数不超过 \(2m\)。
一个页面在这些状态之间怎样流转,以及 \(m_c\) 在哪些边上调整,见下图:
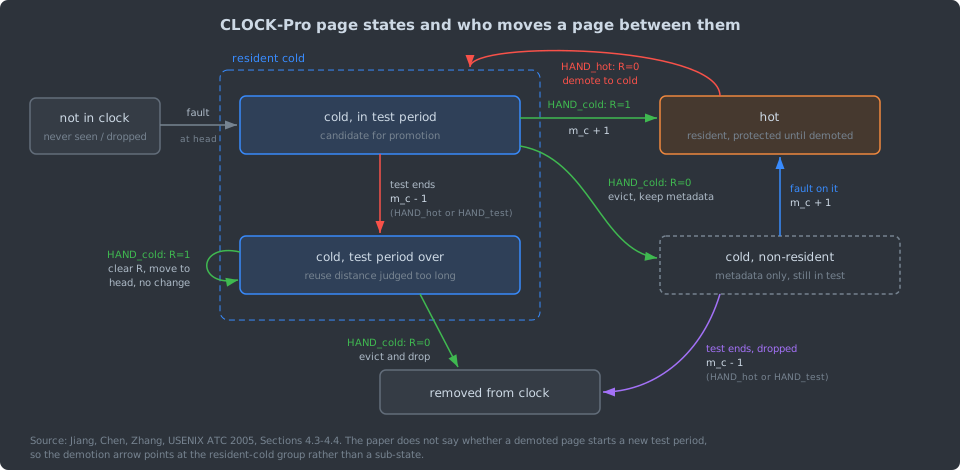
自适应部分很简单:cold 页在测试期内被访问,cold 区目标 \(m_c\) 加 1;测试期结束仍未被访问,\(m_c\) 减 1。这里的 cold 页既包括驻留的,也包括 non-resident 的。\(m_c\) 改变后,论文通过临时调整 HAND_cold 与 HAND_hot 的移动速度来落实新的分配。图里有一处论文没有写明:降级后的页面是否开始新的测试期,所以降级箭头只指向”驻留 cold”这一组,没有指向具体子状态。
论文在 Linux 2.4.21 上实现了原型,报告部分常用程序的执行时间最多缩短 47%。主线内核没有合入 CLOCK-Pro,但后来的 workingset detection(第八节)用 shadow entry 实现了类似的”淘汰后仍记得”。
七、ARC:用 ghost 命中调节 recency 与 frequency
四个列表与不变量
Megiddo 和 Modha(USENIX FAST 2003)的 ARC 把 2Q 的”静态分区”换成一个可移动的分界 \(p\):

- T1:最近只被引用过一次的驻留页;
- T2:最近至少被引用两次的驻留页;
- B1 / B2:分别从 T1 / T2 淘汰出去的页面 ID,不存数据;
- \(p \in [0, c]\):T1 的目标大小。
论文中的不变量是:
\[ |T_1| + |T_2| \le c,\qquad |T_1| + |B_1| \le c,\qquad |T_1| + |T_2| + |B_1| + |B_2| \le 2c. \]
\(|T_2| + |B_2|\) 没有单独的 \(c\) 上限,它可以接近 \(2c\)。
自适应规则
B1 命中说明”T1 再大一点就能命中”,于是增大 \(p\);B2 命中则减小 \(p\):
\[ \text{B1 命中:}\; p \leftarrow \min\!\left(p + \delta_1,\ c\right),\quad \delta_1 = \begin{cases} 1 & |B_1| \ge |B_2| \\ |B_2| / |B_1| & \text{否则} \end{cases} \]
\[ \text{B2 命中:}\; p \leftarrow \max\!\left(p - \delta_2,\ 0\right),\quad \delta_2 = \begin{cases} 1 & |B_2| \ge |B_1| \\ |B_1| / |B_2| & \text{否则} \end{cases} \]
步长按两个 ghost 列表的相对大小缩放:较小的那个 ghost 列表覆盖的历史更短,它的一次命中代表更强的信号。
实现
下面是模拟器中 ARC 的主体,逐条对应论文 Figure 4 的四种情况。\(p\) 用实数保存,与上面的更新公式一致;很多实现用整数和整数除法,行为会略有差别。
/* reproduce/policy_sim.c:ARC,对应 Megiddo & Modha 2003 Figure 4 */
static void arc_replace(Arc *a, int x_in_b2)
{
    if (a->t1.size >= 1 &&
        ((x_in_b2 && a->t1.size == a->p) || a->t1.size > a->p)) {
        int y = a->t1.tail;
        arc_move_head(a, &a->t1, &a->b1, y, A_B1);
    } else {
        int y = a->t2.tail;
        arc_move_head(a, &a->t2, &a->b2, y, A_B2);
    }
}

static int arc_access(Arc *a, int x)
{
    int c = a->c;
    switch (a->where[x]) {
    case A_T1: /* Case I: hit */
        arc_move_head(a, &a->t1, &a->t2, x, A_T2);
        return 1;
    case A_T2:
        arc_move_head(a, &a->t2, &a->t2, x, A_T2);
        return 1;
    case A_B1: { /* Case II: ghost hit in B1, favour recency */
        double d = a->b1.size >= a->b2.size ? 1.0 : (double)a->b2.size / a->b1.size;
        a->p = fmin(a->p + d, c);
        arc_replace(a, 0);
        arc_move_head(a, &a->b1, &a->t2, x, A_T2);
        return 0;
    }
    case A_B2: { /* Case III: ghost hit in B2, favour frequency */
        double d = a->b2.size >= a->b1.size ? 1.0 : (double)a->b1.size / a->b2.size;
        a->p = fmax(a->p - d, 0);
        arc_replace(a, 1);
        arc_move_head(a, &a->b2, &a->t2, x, A_T2);
        return 0;
    }
    default: { /* Case IV: complete miss */
        int l1 = a->t1.size + a->b1.size;
        int total = l1 + a->t2.size + a->b2.size;
        if (l1 == c) {
            if (a->t1.size < c) {
                a->where[l_pop_tail(&a->b1)] = A_NONE;
                arc_replace(a, 0);
            } else {
                a->where[l_pop_tail(&a->t1)] = A_NONE;
            }
        } else if (total >= c) {
            if (total == 2 * c) a->where[l_pop_tail(&a->b2)] = A_NONE;
            arc_replace(a, 0);
        }
        /* otherwise the cache is not yet full: no eviction */
        l_push_head(&a->t1, x);
        a->where[x] = A_T1;
        return 0;
    }
    }
}
Case IV 的最后一个分支最容易写错:\(|L_1| + |L_2| < c\) 时缓存还没满,不能调用 REPLACE。如果在这里也淘汰一页,缓存永远填不满。用 4 个不同页面循环 3 轮、\(c=4\) 做对照:正确实现命中 8 次;在未满分支里也调用 REPLACE 的版本只命中 1 次。
抗扫描:保护的是 T2,不是整个缓存
论文第 IV.D 节的论证是:全新的页面总是进入 T1 的 MRU 端,若在离开 T1 之前没有再次被访问,就不会影响 T2;扫描期间 B1 不会命中,\(p\) 不增长,T1 也就不会侵占 T2。第五节 E3b 的结果符合这个论证。
这个论证有一个前提:T2 里得先有东西可保护。如果扫描到来之前负载一直偏向最近性,\(p\) 已经很大,T2 只剩 \(c - p\) 个位置,扫描能冲掉的就是 T1 那 \(p\) 个位置里的全部内容。
理论保证到底是什么
ARC 论文对自适应性能的主张是 empirically universal:在他们的 trace 上,ARC 的表现与”用离线挑选的最佳固定 \(p\) 运行的 FRC\(_p\)“相当。这是实验结论,论文没有给出”ARC 的缺页数不超过最佳静态分割加 \(O(c)\)“之类的定理。
最坏情况的界是十多年后才出现的:Consuegra 等人(arXiv:1503.07624,预印本,未经同行评审)证明 ARC 的竞争比介于 \(N+1\) 与 \(4N\) 之间,CAR 的上界为 \(18N\)(\(N\) 为缓存大小)。结合 Sleator-Tarjan 的下界可以得出:最坏情况下 ARC 并不比 LRU 好,它的价值体现在真实 trace 的平均表现上。第五节的循环实验就是一个 ARC 与 LRU 同样糟糕的具体序列。
CAR 与专利
Bansal 和 Modha(FAST 2004)的 CAR 用两个时钟代替 T1、T2 两个 LRU 链表,命中时只置位,适合不能在命中路径上改链表的场景。
ARC 的美国专利 US 6,996,676 于 2002-11-14 提交,Google Patents 显示其状态为 Expired - Lifetime,调整后的到期日为 2024-02-22(Google 注明法律状态只是推断,不构成法律意见)。这项专利有过实际影响:PostgreSQL 8.0.2 的发布说明写明,为避开”待批的 ARC 美国专利”,用 2Q 替换了 ARC,并称 2Q 在部分负载上”可能慢几个百分点”;8.1 又因为锁争用把两者都换成了 clock sweep。
八、Linux 的实际方案
以下以 Linux v6.12 为准,未启用
MGLRU(CONFIG_LRU_GEN)的默认路径。
双 CLOCK 链表
Linux 为每个 lruvec
维护五条链表:inactive/active 匿名页、inactive/active
文件页、以及不可回收页。自 4.8 起(Mel Gorman 的 “Move LRU
page reclaim from zones to nodes”),lruvec 按
NUMA 节点而不是 zone 组织;启用 memcg
时,每个(cgroup,节点)组合各有一个
lruvec。
mm/workingset.c 开头的注释把这套结构称为
“Double CLOCK lists”:
- 新页面加到 inactive
链表头部,回收从尾部扫描(
lruvec_add_folio用list_add,回收路径用lru_to_folio取链表尾); - 在 inactive 上被多次访问的页面被提升到 active;active 链表相对过大时,尾部页面被降级回 inactive。
“多次访问”在代码里分两种情况:
- 经由系统调用访问的页缓存(如
read())走folio_mark_accessed():第一次只置PG_referenced,第二次才激活; - 映射进页表的页在回收扫描时由
folio_check_references()判断:有 PTE 访问位时先置PG_referenced并留在 inactive,下一轮再被访问(或被多个 PTE 引用、或是可执行文件页)才激活;没有访问位的页进入回收。
active 与 inactive 的平衡由
inactive_is_low() 决定:当 \(\text{inactive} \times r <
\text{active}\) 时从 active 降级,其中 \(r = \lfloor\sqrt{10 \cdot
\text{GB}}\rfloor\)(总量不足 1 GB 时 \(r=1\))。按源码注释,1 GB 时
inactive 目标约占 25%,100 GB 时约为 3 GB。
匿名页在 5.9 之前是新页直接进 active;Joonsoo Kim 的补丁(5.9)改为先进 inactive,同时把 workingset detection 扩展到匿名页。
脏页的处理和教科书也不一样。回收遇到脏文件页时,只有
kswapd 在该页已被标记过 PG_reclaim、且节点带有
PGDAT_DIRTY
标志(扫描到的文件页全是尚未提交写回的脏页)时才会自己写回;其余情况不在回收路径里写回,而是打上
PG_reclaim 后移回 active 链表,交给 flusher
线程写回,源码注释说明其意图是 “Immediately reclaim when
written back”(shrink_folio_list(),另见 “Only
kswapd can writeback filesystem folios to avoid risk of
stack overflow”)。匿名页没有 flusher,只能由回收路径换出到
swap。
Workingset detection:Linux 的 ghost
Johannes Weiner 的 “mm: thrash detection-based file cache sizing”(提交 a528910e12ec,合入 3.15)解决的是双链表的一个老问题。他在补丁说明里写道:旧方案每次扫描 inactive 时都从 active 尾部拿一部分页面过来,“ultimately was not significantly better than a FIFO policy”,并且按淘汰速度而不是实际需求来挤压缓存。
机制如下:
- 每个
lruvec维护计数器nonresident_age,inactive 上每发生一次淘汰或激活就加一。 - 页面被淘汰时,在页缓存 xarray(3.15 时是 radix tree)原来的槽位里留下 shadow entry,记录当时的计数值 \(E\)。
- 页面重新缺页(refault)时读到当前计数 \(R\),refault distance 为 \(R - E\)。
- 源码注释的推导是:该页的最小访问距离为 \(\mathrm{NR\_inactive} + (R - E)\);只要它不超过 \(\mathrm{NR\_inactive} + \mathrm{NR\_active}\),这个页面在”整块内存都给它用”时本可以留住。化简后,对文件页的判定是
\[ R - E \le \mathrm{NR\_active\_file} + \mathrm{NR\_inactive\_anon} + \mathrm{NR\_active\_anon}. \]
其中匿名页两项只在有 swap
时计入(workingset_test_recent())。满足条件就直接激活,与现有
active 页竞争。
refault distance 比较的对象是 active 链表(工作集)的大小,不是 inactive 链表的长度。直观理解是:\(R - E\) 是 inactive 链表”还差多少格”,而在满载系统里只有 active 页在占用这些格子。
它和 ARC 的 B1/B2、CLOCK-Pro 的 non-resident cold 页一样,都是”记住被淘汰的页面,用重新访问来判断淘汰是否过早”。区别在于 Linux 的 shadow entry 放在页缓存索引现成的空槽里,不需要额外的 ghost 链表。这是本文的归纳,不是补丁作者的表述。
MGLRU
Yu Zhao 的 Multi-Gen LRU 在 6.1
合入,是一套可选的替代实现(编译选项
CONFIG_LRU_GEN,运行时通过
/sys/kernel/mm/lru_gen/enabled
开关)。按内核文档,它用多个代(generation)替代两级链表:aging
通过页表遍历和 rmap 查找访问过的
PTE,把页面提升到最年轻的代;eviction
从最老的代回收,在匿名页与文件页之间先选更老的一类,两类一样老时选首个
tier 的 refault
比例更低的一类。各发行版默认是否启用不一,本文不引用性能数字。
kswapd 与 direct reclaim:回收不只发生在后台
先回答一个常见的误解。“Linux 的页面回收不是在 page fault 时同步执行的,而是由 kswapd 异步完成”——这句话只对了一半。准确的说法是:Linux 尽量让 kswapd 在后台提前回收,使大多数缺页不必自己承担淘汰成本;但当空闲内存消耗得比 kswapd 回收得快时,发起分配的任务(包括正在处理缺页的任务)会在自己的上下文里同步回收,这就是 direct reclaim。 两者是一套水位机制的两个阶段,不是二选一。
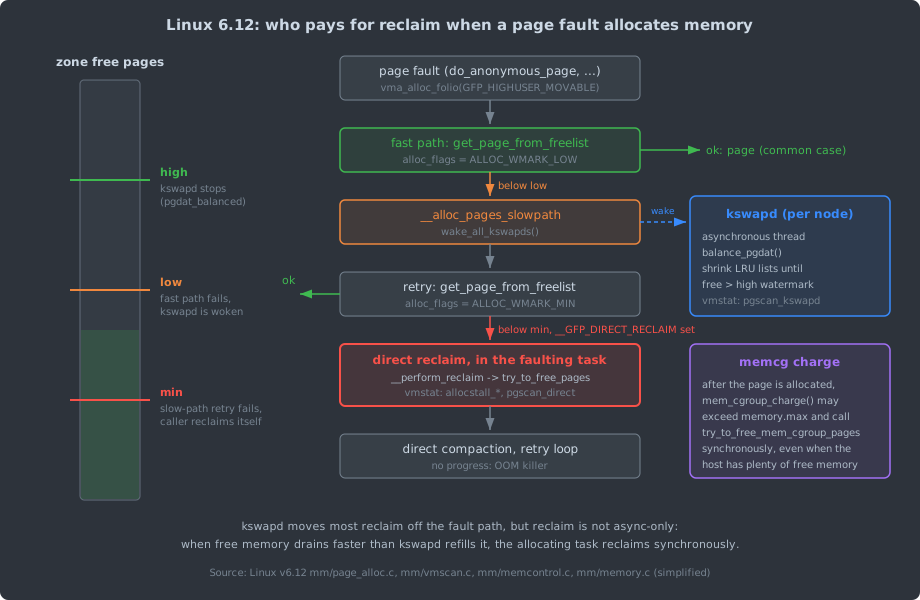
每个 zone 有 min、low、high 三条水位,kswapd
每个节点一个。分配路径的源码如下(Linux
v6.12,mm/page_alloc.c,函数
__alloc_pages_slowpath(),删减了
compaction、cpuset、重试计数等代码):
/* Linux v6.12 mm/page_alloc.c, __alloc_pages_slowpath(),有删减 */
    alloc_flags = gfp_to_alloc_flags(gfp_mask, order); /* ALLOC_WMARK_MIN | ... */

    if (alloc_flags & ALLOC_KSWAPD)
        wake_all_kswapds(order, gfp_mask, ac);

    page = get_page_from_freelist(gfp_mask, order, alloc_flags, ac);
    if (page)
        goto got_pg;
    ...
    /* Caller is not willing to reclaim, we can't balance anything */
    if (!can_direct_reclaim)
        goto nopage;

    /* Try direct reclaim and then allocating */
    page = __alloc_pages_direct_reclaim(gfp_mask, order, alloc_flags, ac,
                            &did_some_progress);
把各段串起来:
- 快速路径:
__alloc_pages_noprof()以ALLOC_WMARK_LOW调用get_page_from_freelist(),空闲页高于 low 水位就直接成功。这是绝大多数缺页的情况。 - 唤醒
kswapd:失败后进入慢速路径,
wake_all_kswapds()唤醒 kswapd。kswapd 在balance_pgdat()里收缩 LRU 链表,直到pgdat_balanced()确认空闲页高于 high 水位才停。kswapd 由分配者唤醒,而不是周期性轮询。 - 按 min
水位重试:
gfp_to_alloc_flags()返回的ALLOC_WMARK_MIN允许动用 low 与 min 之间的储备,成功就返回。 - Direct reclaim:仍失败、并且 GFP 标志含
__GFP_DIRECT_RECLAIM时,调用__perform_reclaim(),源码注释是 “We now go into synchronous reclaim”,接着在当前任务里执行try_to_free_pages()。之后还有 direct compaction、重试循环,最后才是 OOM killer。
缺页路径确实会走到第 4 步。匿名页缺页用
vma_alloc_folio(GFP_HIGHUSER_MOVABLE, ...)
分配,而 GFP_HIGHUSER_MOVABLE 展开后包含
__GFP_RECLAIM,也就是
__GFP_DIRECT_RECLAIM | __GFP_KSWAPD_RECLAIM(include/linux/gfp_types.h)。
还有一条与全局水位无关的同步回收路径:页面分配成功后,mem_cgroup_charge()
要把它记到 cgroup 名下。如果超过
memory.max,try_charge_memcg()
会直接调用
try_to_free_mem_cgroup_pages()。在容器里,即使宿主机空闲内存充足,缺页也可能因为
cgroup 限额同步回收。超过 memory.high
时,任务在 mem_cgroup_handle_over_high() 中调用
reclaim_high()
同步回收,回收不够还会被节流睡眠。
观测时,可以看 /proc/vmstat 中的
allocstall_*(进入 direct reclaim
的次数)、pgscan_direct /
pgsteal_direct 与 pgscan_kswapd /
pgsteal_kswapd 的比例,refault 相关的
workingset_refault_* /
workingset_activate_*,以及 PSI 的
/proc/pressure/memory(try_charge_memcg()
和 reclaim_high() 在回收前后都会调用
psi_memstall_enter() /
psi_memstall_leave())。
九、争论与开放问题
争论一:LRU 真的比 FIFO 好吗
教科书的排序是 OPT > LRU > FIFO,第五节的纯 Zipf 实验也支持 LRU 高于 FIFO。但 Yang 等人在 HotOS 2023 的 “FIFO can be Better than LRU: the Power of Lazy Promotion and Quick Demotion” 和 SOSP 2023 的 “FIFO Queues are All You Need for Cache Eviction” 中认为,决定命中率的关键是快速降级(尽早淘汰只访问一次的对象)和懒提升(命中时不移动链表),而不是精确的最近性。S3-FIFO 只用三个 FIFO 队列(10% 的小队列、90% 的主队列和一个 ghost 队列),在 14 个数据集、6,594 条 trace 上,有 10 个数据集的平均缺页率最低;在 16 线程下吞吐是优化过的 LRU 的 6 倍(均为论文数据,未在本站复现)。
两种结论并不矛盾:他们比较的是带快速降级的 FIFO 变体,不是本文实验里的朴素 FIFO;他们的 trace 来自块存储、CDN 对象缓存和 KV 缓存(论文 Table 1),一次性访问比例高,与操作系统页缓存的负载不同。Weiner 对 Linux 旧双链表”并不比 FIFO 好多少”的评价,则从另一个方向说明,只加一层 active 链表的 LRU 近似,未必比 FIFO 强。
争论二:要不要自适应
ARC 批评 2Q、LIRS 的参数需要调,主张用 ghost 反馈自动调节;2Q 论文则认为自己的默认参数在不同 trace 上都够好;S3-FIFO 更进一步,认为固定 10% 的小队列可以给出有保证的降级速度,比自适应算法的”学习”更可靠。这三方的证据都是各自的 trace 集合,没有一组公认的基准能裁决。
争论三:命中率与并发
PostgreSQL 8.1 为了去掉全局锁放弃了 ARC、2Q 和 LRU;S3-FIFO 的主要卖点之一也是无锁扩展性。命中率高一两个百分点,是否值得在命中路径上多一次共享写,取决于缓存的访问频率和核数。这个权衡在论文里通常只评估命中率,工程上往往被吞吐决定。
开放问题
- 如何从理论上解释自适应算法的优势。 竞争分析给 LRU 和 ARC 的都是 \(\Theta(k)\),区分不了两者。Borodin 等人的 access graph 模型(JCSS 1995)和 Albers、Favrholdt、Giel 的局部性参数化分析(JCSS 2005)尝试用局部性模型替代最坏情况,但还没有一个模型能解释为什么 ARC、LIRS、S3-FIFO 在真实 trace 上领先。
- 操作系统的回收策略怎样评估。 页缓存与匿名页竞争同一块内存、回收代价不对称(换出匿名页要写 swap,干净的文件页可以直接丢弃),还要受 memcg 限额约束,单一的命中率不能描述这些成本。MGLRU 与经典双链表的对比至今主要依赖厂商和补丁作者的负载测试。
- 学习型缓存能否落地。 以 LRB(Song 等,NSDI 2020)为代表的工作用模型近似 Bélády,在 CDN trace 上缩小了与 OPT 的差距;它们的训练、推理开销与在内核这类延迟敏感路径上的可行性,仍是开放问题。
十、工程陷阱与选型
| 陷阱 | 后果 | 做法 |
|---|---|---|
| 应用层缓存用朴素 LRU,负载里有批量扫描或导入 | 大缓存被一次扫描冲掉,第五节 \(c=5000\) 时热点命中率从 72.17% 降到 60.73% | 用 2Q、ARC、S3-FIFO 或 TinyLFU
这类准入过滤;批量读文件时用
posix_fadvise(POSIX_FADV_DONTNEED) 或
O_DIRECT 避免污染页缓存 |
| 工作集是一个比缓存略大的循环 | LRU、FIFO、CLOCK、ARC 的缺页率都是 100%(第五节) | 增大缓存或把循环分块;此类负载下 RANDOM 或 2Q 反而更好 |
| 数据库缓冲池与 OS 页缓存各缓存一份 | 同一页占两份内存,两层替换策略互相干扰 | 按引擎的设计选择:InnoDB 常用
innodb_flush_method=O_DIRECT;PostgreSQL
有意依赖 OS 页缓存,shared_buffers
不宜吃满内存 |
| 低估 ghost 元数据 | ARC 的 B1、B2 合计最多 \(c\) 个条目 | 按条目大小核算:若每个条目约 64 B、页面 4 KiB,ghost 约占缓存字节数的 \(64 / 4096 \approx 1.6\%\);缓存小对象时比例会高得多 |
| 精确 LRU 放在高并发命中路径上 | 每次读都要写共享链表,锁或缓存行争用成为瓶颈 | 分片、CLOCK 类只置位的方案,或 FIFO 类懒提升;PostgreSQL 8.1 为此改用 clock sweep |
| 变长对象按条目数淘汰 | 大对象挤掉大量小对象,字节命中率与对象命中率背离 | 按字节计容量,或使用 size-aware 策略 |
| ARC 在缓存未满时也执行 REPLACE | 缓存永远填不满,4 个页面、\(c=4\) 的循环只命中 1/12 | 严格按论文 Case IV 的三个分支实现,并用”不同页面数不超过 \(c\) 时只有强制缺页”做单元测试 |
| 以为有 kswapd 就不会在缺页里回收 | 水位跌破 min 或 cgroup 超过 memory.max
时,缺页任务会同步回收,产生长尾延迟 |
监控
allocstall_*、pgscan_direct、PSI;视情况调高
vm.min_free_kbytes /
vm.watermark_scale_factor 让 kswapd
更早开始,或为 cgroup 留出余量 |
把 vm.swappiness 当成缓存大小开关 |
它调节的是匿名页与文件页回收的相对代价,不直接决定页缓存容量 | 先用 workingset_refault_*
判断哪一类页在抖动,再决定调整方向 |
选型上,按约束而不是按”算法好坏”来选:
| 场景 | 常见选择 | 决定性约束 |
|---|---|---|
| 操作系统页面回收 | CLOCK 类双链表加 refault 反馈(Linux),或 MGLRU | 只能通过页表访问位间接获得访问信息,回收要与 swap、写回、memcg 协同 |
| 数据库缓冲池 | clock sweep(PostgreSQL)、带中点插入的 LRU(InnoDB) | 命中路径的并发;扫描抗性通过插入位置或准入实现 |
| KV / CDN 缓存 | TinyLFU / W-TinyLFU、S3-FIFO 等 | 对象大小差异大、一次性访问多、吞吐优先 |
| Redis | 采样近似 LRU / LFU | 单线程、百万级 key,不维护全局链表,见站内 Redis maxmemory 淘汰 |
最后是三条判断,依据都在前文:
- LRU 不是谎言。 它是栈算法,有最优的最坏情况竞争比,在最近性主导的负载上表现不差;它的问题是对扫描和”略大于缓存的循环”没有防御,且精确实现的并发代价高。
- ARC 也不是真相。 它的自适应是经验结论,最坏情况并不比 LRU 好,在循环上会同样失败;它最稳定的收益来自”第一次访问不算数”这条抗扫描原则,而 2Q、CLOCK-Pro、Linux workingset、S3-FIFO 都用不同方式实现了这条原则。
- 理解负载比选算法更重要。 先用 stack distance 画出缺页率曲线,看有没有扫描、循环和阶段变化,再决定是加容量、加准入过滤,还是换替换策略。
十一、参考资料
规范与手册
- Intel 64 and IA-32 Architectures Software Developer’s Manual, Vol. 3A, Section 4.8 “Accessed and Dirty Flags”.
- Linux kernel documentation, Multi-Gen
LRU(
Documentation/mm/multigen_lru.rst,6.1 起)。
源码与提交(Linux v6.12)
mm/page_alloc.c:__alloc_pages_noprof()、__alloc_pages_slowpath()、gfp_to_alloc_flags()、__perform_reclaim()、wake_all_kswapds()。mm/vmscan.c:balance_pgdat()、pgdat_balanced()、wakeup_kswapd()、shrink_folio_list()、folio_check_references()、inactive_is_low()、try_to_free_pages()。mm/workingset.c:文件头 “Double CLOCK lists” 注释、workingset_test_recent()。mm/swap.c:folio_mark_accessed();include/linux/mm_inline.h:lruvec_add_folio()。mm/memory.c:匿名页缺页的vma_alloc_folio(GFP_HIGHUSER_MOVABLE, ...);include/linux/gfp_types.h:GFP_HIGHUSER_MOVABLE、__GFP_RECLAIM。mm/memcontrol.c:try_charge_memcg()、reclaim_high()。- Johannes Weiner, “mm: thrash detection-based file cache sizing”, commit a528910e12ec(Linux 3.15),补丁说明见 LWN “mm: thrash detection-based file cache sizing v8”。
- Joonsoo Kim, “mm/swap: implement workingset detection for anonymous LRU”, commit aae466b0052e(Linux 5.9)。
- Mel Gorman, “Move LRU page reclaim from zones to nodes v9”, linux-mm, 2016(Linux 4.8)。
核心论文
- L. A. Bélády, “A study of replacement algorithms for a virtual-storage computer”, IBM Systems Journal 5(2), 1966.
- R. L. Mattson, J. Gecsei, D. R. Slutz, I. L. Traiger, “Evaluation techniques for storage hierarchies”, IBM Systems Journal 9(2), 1970.
- D. D. Sleator, R. E. Tarjan, “Amortized efficiency of list update and paging rules”, CACM 28(2), 1985.
- T. Johnson, D. Shasha, “2Q: A Low Overhead High Performance Buffer Management Replacement Algorithm”, VLDB 1994.
- N. Megiddo, D. S. Modha, “ARC: A Self-Tuning, Low Overhead Replacement Cache”, USENIX FAST 2003.
- S. Jiang, F. Chen, X. Zhang, “CLOCK-Pro: An Effective Improvement of the CLOCK Replacement”, USENIX ATC 2005.
- J. Yang, Y. Zhang, Z. Qiu, Y. Yue, K. V. Rashmi, “FIFO Queues are All You Need for Cache Eviction”, SOSP 2023.
其他论文
- L. A. Bélády, R. A. Nelson, G. S. Shedler, “An anomaly in space-time characteristics of certain programs running in a paging machine”, CACM 12(6), 1969.
- F. J. Corbató, “A Paging Experiment with the Multics System”, MIT Project MAC Report MAC-M-384, 1968.
- A. V. Aho, P. J. Denning, J. D. Ullman, “Principles of Optimal Page Replacement”, JACM 18(1), 1971.
- E. Gelenbe, “A unified approach to the evaluation of a class of replacement algorithms”, IEEE Transactions on Computers C-22(6), 1973.
- M. D. Hill, A. J. Smith, “Evaluating Associativity in CPU Caches”, IEEE Transactions on Computers 38(12), 1989.
- E. J. O’Neil, P. E. O’Neil, G. Weikum, “The LRU-K page replacement algorithm for database disk buffering”, SIGMOD 1993.
- S. Jiang, X. Zhang, “LIRS: an efficient low inter-reference recency set replacement policy to improve buffer cache performance”, SIGMETRICS 2002.
- S. Bansal, D. S. Modha, “CAR: Clock with Adaptive Replacement”, USENIX FAST 2004.
- A. Borodin, S. Irani, P. Raghavan, B. Schieber, “Competitive paging with locality of reference”, JCSS 50(2), 1995.
- S. Albers, L. M. Favrholdt, O. Giel, “On paging with locality of reference”, JCSS 70(2), 2005.
- G. Einziger, R. Friedman, B. Manes, “TinyLFU: A Highly Efficient Cache Admission Policy”, ACM Transactions on Storage 13(4), 2017.
- Z. Song, D. S. Berger, K. Li, W. Lloyd, “Learning Relaxed Belady for Content Distribution Network Caching”, NSDI 2020.
- J. Yang, Z. Qiu, Y. Zhang, Y. Yue, K. V. Rashmi, “FIFO can be Better than LRU: the Power of Lazy Promotion and Quick Demotion”, HotOS 2023.
- M. E. Consuegra, W. A. Martinez, G. Narasimhan, R. Rangaswami, L. Shao, G. Vietri, “Analyzing Adaptive Cache Replacement Strategies”, arXiv:1503.07624(预印本)。
工程资料
- PostgreSQL 8.0.2 Release Notes:“New cache management algorithm 2Q replaces ARC”。
- PostgreSQL 8.1 Release Notes 与提交 “Replace the BufMgrLock with separate locks…”(2005-03),改用 clock sweep。
- Google Patents, US6996676B2, “System and method for implementing an adaptive replacement cache policy”。
实验
reproduce/policy_sim.c:本文第二、五、七节全部数据的来源。
系列导航: - 上一篇:内存分配器对决 - 下一篇:CPU 调度:CFS 的虚拟运行时间与 EEVDF 的虚拟截止期
相关阅读: - 缓冲池管理算法 - 竞争分析 - 缓存无关算法
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
【操作系统百科】内存回收
Linux 内存回收是 VM 最复杂的子系统之一。本文讲 active/inactive LRU、kswapd 与 direct reclaim、watermark 三线、swappiness 的真实含义、MGLRU 改造、memcg 回收与 PSI。
CPU 调度:CFS 的虚拟运行时间与 EEVDF 的虚拟截止期
从比例份额调度的论文谱系出发,对照 Linux v6.6 与 v6.12 fair.c 源码,解释 CFS 的 vruntime、EEVDF 的 lag/eligible/deadline,并用确定性模拟复现延迟与 lag 的差异。
I/O 调度:在寻道、队列深度与公平性之间取舍
从电梯算法到 blk-mq,解释 Linux I/O 调度器为何在 HDD 上排序、在共享设备上保公平、在 NVMe 上常选择 none,并用确定性模拟展示寻道距离与队列尾延迟的取舍。