/sys/block/<dev>/queue/scheduler
里看到的
[none] mq-deadline kyber bfq,不是四个“谁更快”的选项,而是四种回答:要不要按扇区排序、要不要限制在设备里的请求数、要不要给进程或
cgroup 分带宽。HDD 时代,调度器主要为了少寻道;NVMe
时代,软件排序常常帮不上忙,留下来的问题变成队列深度、尾延迟和多租户公平。
本文只讨论 Linux 块层调度器。生产实现以 Linux v6.6 的
block/mq-deadline.c、block/bfq-iosched.c、block/kyber-iosched.c
与 Documentation/block/ 为准;实验是同目录
reproduce/io_sched_sim.py
的确定性模拟,不是裸盘 benchmark。
一、调度器到底在调什么
块设备请求至少有三种代价,硬件世代不同,主导项也不同。
| 代价 | HDD 上的含义 | SSD / NVMe 上的含义 | 调度器对应动作 |
|---|---|---|---|
| 位置 | 磁头跨柱面移动和旋转等待 | 闪存内部映射,主机端扇区相邻性弱化 | SCAN、deadline 的扇区排序与合并 |
| 队列 | 排队能摊薄寻道,但会放大交互延迟 | 队列太深时控制器内部排队推高 P99 | kyber 这类深度控制,或直接 none |
| 份额 | 大顺序流可能让小随机读等待 | 多进程共享同一设备时仍会互相影响 | CFQ / BFQ / cgroup I/O 控制 |
Denning 1967 年的文件存储调度实验、Teorey 与 Pinkerton 1972 年的 disk scheduling 比较,研究的核心都是第一列:请求顺序改变后,磁头移动和响应时间如何变化。Iyer 与 Druschel 在 SOSP 2001 的 anticipatory scheduling 又补了一刀:如果一个同步读进程刚完成一个请求,立刻切走可能导致磁头大幅跳转;短暂等待它的下一个请求,在单主轴磁盘上可能更划算。
这些结论有明确边界。它们假设主机看到的逻辑地址与物理位置强相关,并且一次随机访问的代价远高于顺序访问。SSD、硬 RAID、虚拟盘和 NVMe 控制器会削弱这个假设,所以“电梯算法总能提升 I/O”是错的;“NVMe 上永远不需要调度”也过头,因为多租户公平和队列尾延迟仍然存在。
二、从 legacy 单队列到 blk-mq
Linux 旧块层把请求放进单个
request_queue,调度器和驱动共享同一条队列。多核机器上,所有
CPU 都要争同一路径;而 NVMe
设备本身有多条提交队列,单队列软件层会成为瓶颈。Bjørling、Axboe、Nellans
与 Bonnet 在 SYSTOR 2013 的 “Linux Block IO: Introducing
Multi-queue SSD Access on Multi-core Systems”
中系统描述了这个转向。
Linux v6.6 文档
Documentation/block/blk-mq.rst 把 blk-mq
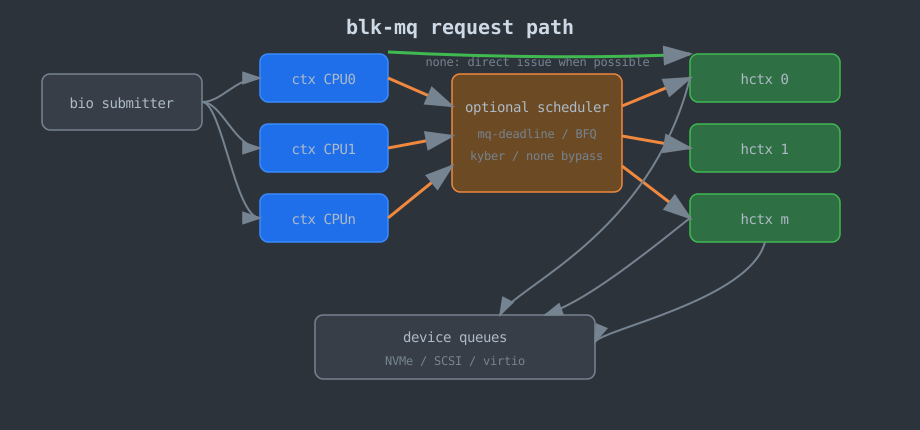
拆成两层:
- software staging queues:通常按 CPU
或节点划分,
struct blk_mq_ctx暂存请求,并尝试相邻扇区合并; - hardware dispatch
queues:
struct blk_mq_hw_ctx映射到设备提交队列或驱动 DMA ring; - I/O
scheduler:可选地插在两层之间;文档明确说
NONE只把请求放到所在 software queue,不做重排。
这也是 CFQ 消失的版本边界。上游提交
f382fb0bcef4c37dc049e9f6963e3baf204d815c(Jens
Axboe,2018-10-12,标题
block: remove legacy IO schedulers)删除了
block/cfq-iosched.c、legacy deadline 和
noop;该提交进入 Linux 5.0 发布周期。CFQ
并不是“算法被证明不好”,而是它依赖 legacy 单队列与
per-process 队列模型,无法作为 blk-mq 调度器继续维护。
三、mq-deadline:排序加软截止时间
mq-deadline 是 legacy deadline 的 blk-mq 版本。Linux v6.6 的文件头写明它是 “adaptation of the legacy deadline scheduler, for the blk-mq scheduling framework”。它仍维护两类视图:按扇区排序的红黑树用于顺序性,按到达时间排列的 FIFO 链表用于超时判断。
v6.6 block/mq-deadline.c
中的默认值如下,只写源码里亲眼看到的量:
| 参数 | v6.6 默认值 | 含义 |
|---|---|---|
read_expire |
HZ / 2 |
读请求软截止时间,通常折算为 500 ms |
write_expire |
5 * HZ |
写请求软截止时间,通常折算为 5 s |
writes_starved |
2 | 读批次最多连续饿写的次数 |
fifo_batch |
16 | 一批顺序请求的规模 |
front_merges |
1 | 允许前向合并 |
prio_aging_expire |
10 * HZ |
低优先级请求老化时间 |
struct deadline_data 在 v6.6 中按
DD_RT_PRIO、DD_BE_PRIO、DD_IDLE_PRIO
三档 I/O priority 各维护 sort_list[READ/WRITE]
与
fifo_list[READ/WRITE]。dd_init_sched()
初始化这些队列后还设置
QUEUE_FLAG_SQ_SCHED,注释写的是 “We dispatch
from request queue wide instead of hw
queue”。这点容易被简化文章漏掉:mq-deadline
不只是“每个硬件队列一个小 deadline”,它在 v6.6 里选择从
request queue 级别调度。
mq-deadline 适合“仍有主机端顺序性可利用,但不想为 per-process 公平付太多成本”的设备:HDD、SATA SSD、部分虚拟盘或 zoned device。它不承诺进程间公平,只用截止时间避免单个请求无限等待。
四、BFQ:把“公平”从时间片改成预算
BFQ(Budget Fair Queueing)来自 Valente 与 Checconi 的 “High Throughput Disk Scheduling with Fair Bandwidth Distribution”(IEEE Transactions on Computers, 2010)。它继承 CFQ 的目标:让多个进程或组共享设备时有可解释的份额;但调度单位不是时间片,而是预算,即一段服务量。
Linux v6.6 block/bfq-iosched.c
文件头把差别说得很直接:BFQ 给进程分配用扇区数衡量的
budget,而不是时间片;从时间域切到服务域后,它可以用 B-WF2Q+
这类加权公平队列算法按 budget 调度。源码默认值包括:
| 量 | v6.6 默认值 | 说明 |
|---|---|---|
bfq_default_max_budget |
16 * 1024
sectors |
默认最大预算 |
bfq_timeout |
HZ / 8 |
近似 CFQ 默认超时 |
bfq_slice_idle |
NSEC_PER_SEC / 125 |
约 8 ms 的空闲等待 |
文档 Documentation/block/bfq-iosched.rst
对工程取舍也很坦白:BFQ 是 proportional-share I/O
scheduler,默认配置偏向低延迟;如果目标只是最大吞吐,应把
low_latency 关掉。该文档还给了一个特定老笔记本
CPU 上的 instrumentation 数据:BFQ 单锁保护的 per-request
插入、分发和完成 hooks 合计约 1.9 µs,mq-deadline 约 0.7
µs。这个数字不能外推到所有机器,但足以说明:公平和低延迟启发式不是免费的。
BFQ 最有价值的场景是共享、慢速或中速设备:桌面前台程序与后台写入争用,eMMC/UFS 上的交互请求,或者需要按 cgroup 权重分配 I/O 的系统。高 IOPS NVMe 上,BFQ 可能把 CPU 时间花在调度而不是提交请求上;这不是 BFQ “错”,而是目标函数不同。
五、kyber 与 none:NVMe 时代还剩什么可调
none
是最短路径:不做调度重排,尽量让请求直接进入硬件分发路径。blk-mq
文档说它只按 software queue 到 hardware queue
的映射排空请求。对单租户 NVMe,设备固件和 FTL
已经知道内部并行度,主机端按逻辑扇区排序往往只会增加 CPU
开销和延迟。
kyber 的出发点不同:它不做 CFQ/BFQ 那样的 per-process
公平,也不做 HDD
电梯排序,而是用令牌限制不同请求域的队列深度。Linux v6.6
block/kyber-iosched.c 的文件头写的是 “Controls
latency by throttling queue depths using scalable
techniques”。源码里的调度域与默认值如下:
| 域 | 最大 device-wide depth | 默认目标延迟 | 批量 dispatch |
|---|---|---|---|
KYBER_READ |
256 | 2 ms | 16 |
KYBER_WRITE |
128 | 10 ms | 8 |
KYBER_DISCARD |
64 | 5 s | 1 |
KYBER_OTHER |
16 | 无目标表项 | 1 |
源码还把 KYBER_ASYNC_PERCENT 设为
75,注释说明是为了给同步操作保留 25%
请求,避免异步洪峰饿死同步请求。kyber
的统计直方图按目标延迟切桶,代码计算 p90/p99 后调整
depth;它关心的是“别把设备喂到尾延迟失控”,而不是“谁的逻辑扇区更近”。
这就形成了 NVMe 上的争论:
- 支持
none:路径短、CPU 开销低,io_uring 与 NVMe 多队列已经能把提交成本压得很低;单租户或应用自己做限流时,块层再调度可能重复。 - 支持轻量调度:共享设备、写放大、控制器内部队列和云盘虚拟化会制造尾延迟;kyber 或 cgroup I/O 控制能把排队压力显式化。
实际选择不能只看设备名。rotational=0 的 SATA
SSD、云盘、virtio-blk、NVMe namespace
在控制路径上差别很大;真正要问的是:瓶颈在主机
CPU、设备内部队列、还是租户之间的隔离。
六、确定性模拟:两个硬件假设,两种结论
同目录 reproduce/io_sched_sim.py
生成本文的实验数据和两张 SVG。运行方式:
cd post/algorithms/54-io-scheduling
python3 reproduce/io_sched_sim.py
环境记录:Linux 6.6.87.2-microsoft-standard-WSL2,Python
3.14.5。模拟固定 3
个种子:20260715、20260716、20260717;表格取中位数。指标来自模拟时间、寻道柱面距离和请求延迟分位数,不使用墙钟。结果会写入
reproduce/results/hdd_summary.csv、reproduce/results/ssd_summary.csv
与 reproduce/results/results.md。
HDD 寻道模型
HDD 模型里有一个前台随机读流、一个批量顺序写流和一个后台随机读流。服务时间由寻道距离、固定旋转等待和传输量组成。这个模型不是要复刻某块盘,而是让“排序是否减少寻道”可见。
| 调度器模型 | 吞吐 req/s | P99 延迟 ms | 前台 P99 ms | 平均寻道柱面 | bulk 字节份额 |
|---|---|---|---|---|---|
| FIFO / none | 231.7 | 5778.8 | 5568.7 | 50987 | 0.83 |
| SCAN | 670.3 | 1961.0 | 2030.7 | 334 | 0.83 |
| mq-deadline-like | 359.6 | 3630.0 | 3018.7 | 28971 | 0.83 |
| BFQ-like budget | 429.1 | 3147.6 | 2881.0 | 1336 | 0.83 |
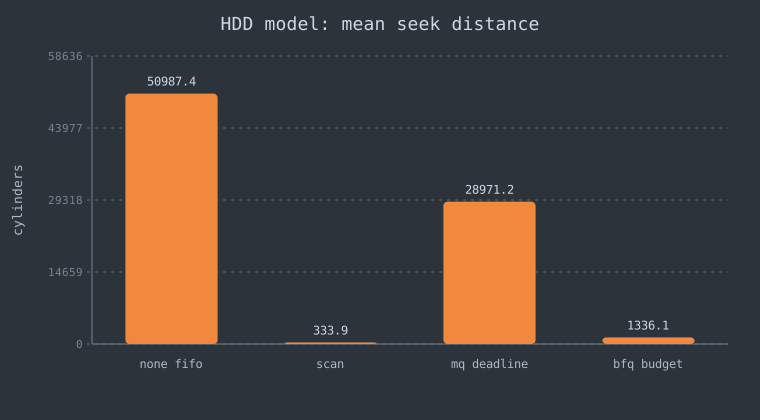
这个实验只支持一个窄结论:当逻辑位置仍近似代表物理位置时,主机端重排能显著减少寻道。它不支持“BFQ 总比 mq-deadline 快”这类结论;BFQ-like 模型同时改变了公平策略和排序策略,真实内核还会受合并、plug、驱动队列与设备缓存影响。
SSD 队列模型
SSD 模型去掉寻道,把设备看成可并行服务的队列;当 inflight
请求超过 32 后,单个请求服务时间按队列压力上升。对比项是三种
host-side
cap:none_q256、mq_deadline_q128
与 kyber_tokens。这不是 kyber
源码复刻,而是抽象它的令牌限深思想。
| 策略模型 | 吞吐 req/s | P50 ms | P99 ms | P99.9 ms |
|---|---|---|---|---|
| none_q256 | 68233 | 13.396 | 29.823 | 29.982 |
| mq_deadline_q128 | 188037 | 5.604 | 10.550 | 10.572 |
| kyber_tokens | 413927 | 1.917 | 4.469 | 4.516 |
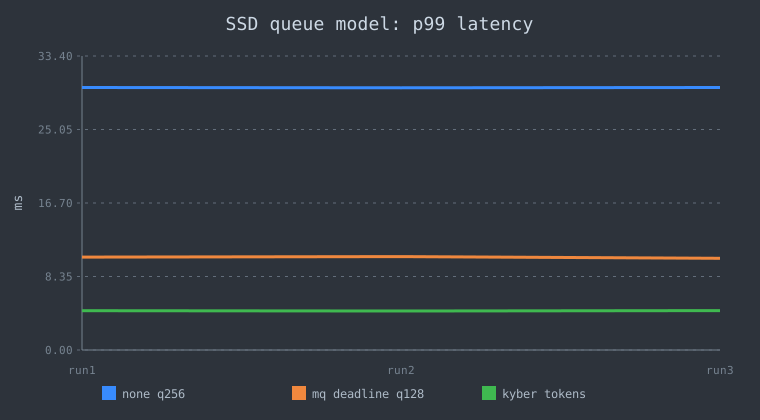
这个模型故意让过深队列降低服务效率,所以限深后的吞吐反而更高。真实
NVMe 上不一定如此:如果设备能在线性区间内消化 256
深度,none
可能吞吐最高;如果云盘或控制器在高深度下排队膨胀,限深会降低尾延迟。正文不能把这张表当硬件排名,只能把它当“队列深度本身也是调度对象”的反例。
七、工程选型与常见误区
| 场景 | 首选检查 | 常见选择 | 风险 |
|---|---|---|---|
| 单块 HDD | rotational=1、是否有并发随机 I/O |
mq-deadline 或 BFQ | none 放弃寻道重排 |
| SATA SSD / 云盘 | 队列深度、虚拟化层是否再调度 | mq-deadline 或 none | 双重调度、过度排序 |
| 单租户 NVMe | CPU 是否成为提交瓶颈、P99 是否可接受 | none | 没有进程间公平 |
| 多租户 NVMe | cgroup、P99、后台写入是否干扰前台 | cgroup I/O 控制、BFQ 或 kyber 需实测 | BFQ CPU 开销,kyber 不保证份额 |
| eMMC / UFS | 前台交互是否被后台 I/O 干扰 | BFQ 或 mq-deadline | 默认低延迟启发式会牺牲吞吐 |
| zoned device | zone append / 顺序写约束 | mq-deadline | 普通排序可能破坏写入约束,需看内核支持 |
几个误区值得单独拆开:
- “SSD 就一定用 none。” 非旋转只说明寻道代价消失,不说明多租户公平和队列尾延迟消失。虚拟盘、云盘和共享 namespace 还要看上层限流。
- “deadline 给了硬延迟上界。” v6.6
源码注释称
read_expire、write_expire是 soft limits;设备已经拥塞或驱动不接请求时,软件截止时间不等于端到端 SLA。 - “BFQ 是 CFQ 的多队列版。” 两者都关心公平,但 BFQ 源码与论文的核心是 budget/B-WF2Q+;CFQ 的 legacy 单队列实现已被删除。
- “kyber 会替你做公平。” kyber 按请求域限深,不按进程或 cgroup 分带宽;共享隔离仍要看 blk-cgroup、应用限流或 BFQ。
- “调度器 benchmark 可以照搬。” I/O 调度高度依赖设备固件、队列深度、文件系统、direct I/O、io_uring、CPU 核数和负载相位。没有复现实验环境的 IOPS 表只能当线索。
持久化配置时,优先用 udev 或发行版 tuned profile;但配置之前先确认设备暴露了哪些调度器:
cat /sys/block/nvme0n1/queue/scheduler
cat /sys/block/sda/queue/rotational
ls /sys/block/nvme0n1/mq/
八、争论与开放问题
io_uring 与块层调度的边界
io_uring 缩短了用户态提交路径,SQPOLL、固定文件和注册缓冲区能减少系统调用与内存注册成本。但请求最后仍要进入块层或驱动队列。争论点不是“io_uring 是否绕过一切调度”,而是限流与公平应该放在哪一层:应用知道请求语义,cgroup 知道租户边界,块层知道设备队列压力,设备固件知道内部并行度。没有一层同时掌握全部信息。
设备内部调度是否让主机端排序过时
NVMe 控制器、FTL 和云盘后端确实会重排请求;主机端按 LBA 做电梯排序常常不再反映物理移动。但主机仍能控制 inflight 数量、读写比例和租户份额。kyber 的存在说明“不要排序”不等于“不要调度”。
公平与吞吐的可证明模型
BFQ 把 fair queueing 理论带进块层,但块设备与网络链路不同:请求大小、合并、写回、flush、discard 和设备缓存都会改变“服务量”的含义。Valente 与 Checconi 的论文给出 BFQ 的设计与实验,Linux 文档也承认默认低延迟会牺牲吞吐。如何在现代 NVMe、云盘和 cgroup 层次结构上给出既可证明又低开销的公平模型,仍是开放问题。
九、参考资料
规范与文档
- Linux kernel v6.6,
Documentation/block/blk-mq.rst。 - Linux kernel v6.6,
Documentation/block/bfq-iosched.rst。 - Linux kernel v6.6,
Documentation/block/deadline-iosched.rst。 - Linux kernel v6.6,
Documentation/block/kyber-iosched.rst。
源码与提交
- Linux kernel v6.6,
block/mq-deadline.c:struct deadline_data、dd_init_sched()、read_expire、write_expire、writes_starved、fifo_batch。 - Linux kernel v6.6,
block/bfq-iosched.c:文件头 BFQ 设计说明、bfq_default_max_budget、bfq_timeout、bfq_slice_idle。 - Linux kernel v6.6,
block/kyber-iosched.c:kyber_depth[]、kyber_latency_targets[]、kyber_batch_size[]、KYBER_ASYNC_PERCENT。 - Jens Axboe,
block: remove legacy IO schedulers, Linux commitf382fb0bcef4c37dc049e9f6963e3baf204d815c, 2018。
核心论文
- Peter J. Denning, “Effects of Scheduling on File Memory Operations”, AFIPS Spring Joint Computer Conference, 1967.
- Toby J. Teorey, Tad B. Pinkerton, “A Comparative Analysis of Disk Scheduling Policies”, Communications of the ACM, 1972;早期版本发表于 SOSP 1971.
- Sitaram Iyer, Peter Druschel, “Anticipatory Scheduling”, SOSP 2001.
- Matias Bjørling, Jens Axboe, David Nellans, Philippe Bonnet, “Linux Block IO: Introducing Multi-queue SSD Access on Multi-core Systems”, SYSTOR 2013.
- Paolo Valente, Fabio Checconi, “High Throughput Disk Scheduling with Fair Bandwidth Distribution”, IEEE Transactions on Computers, 2010.
其他论文与工程资料
- Abhay K. Parekh, Robert G. Gallager, “A Generalized Processor Sharing Approach to Flow Control in Integrated Services Networks: The Single-Node Case”, IEEE/ACM Transactions on Networking, 1993.
- Linux 4.12 release notes / KernelNewbies:BFQ 与 kyber 作为块层调度器进入主线的版本线索。
实验
reproduce/io_sched_sim.py:HDD 寻道模型、SSD 队列模型、CSV 与 SVG 生成程序。
系列导航: - 上一篇:CPU 调度:CFS 的虚拟运行时间与 EEVDF 的虚拟截止期 - 下一篇:伙伴系统与 SLUB:Linux 物理页和小对象分配的边界
相关阅读: - 页面置换算法:从 OPT、LRU 到 ARC 与 Linux 页面回收 - 数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护 - 文件系统中的树:extent、HTree 与 CoW B-tree 的代价
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
CPU 调度:CFS 的虚拟运行时间与 EEVDF 的虚拟截止期
从比例份额调度的论文谱系出发,对照 Linux v6.6 与 v6.12 fair.c 源码,解释 CFS 的 vruntime、EEVDF 的 lag/eligible/deadline,并用确定性模拟复现延迟与 lag 的差异。
伙伴系统与 SLUB:Linux 物理页和小对象分配的边界
以 Linux v6.6 源码和确定性模拟为准,解释伙伴系统的 split/coalesce、migratetype 反碎片策略,以及 SLUB 的 per-CPU freelist、partial list 与安全加固。
用户态内存分配器:size class、线程缓存与碎片边界
从 Wilson 分配器综述到 jemalloc、gperftools tcmalloc 与 mimalloc 的源码路径,解释 size class、线程缓存、跨线程释放和 RSS 碎片;用可复现实验说明不能只凭 allocator 名字下结论。
页面置换算法:从 OPT、LRU 到 ARC 与 Linux 页面回收
从 Bélády OPT 与栈算法出发,用可复现的模拟实验对比 FIFO、LRU、CLOCK、2Q、ARC 在循环与扫描负载下的命中率,再对照 Linux 6.12 源码说明 active/inactive、workingset 与 kswapd/direct reclaim 的真实分工。