关于这两种结构,流传最广的是三句话:“LSM 写快读慢,B+tree 读快写慢”;“InnoDB 的写放大通常在 10 到 30”;“RUM 猜想说读、写、空间三者最多只能同时优化两个”。第一句只在特定条件下成立,第二句找不到出处,第三句和原文措辞不一样。B+tree 一次更新写多少字节,取决于条目大小与页大小之比、缓冲池能装下多少数据、多久做一次 checkpoint;在本文的实验里,同一个 B+tree 的写放大可以从 126 一路降到 8.6,而 leveled LSM 固定在 14.4 左右。
本文先交代三种放大的定义和 RUM 猜想原文,再从 O’Neil 1996 的 LSM 原始论文出发推导两类结构的代价模型,然后用一个只数字节、不计时的模拟器在同一负载上测量,最后讨论几处文献里仍有分歧的地方。B-tree 的节点结构、分裂与并发放在上一篇 B-tree 深度解剖;各种 compaction 策略(STCS、LCS、Universal、FIFO、lazy leveling)的细节放在 LSM-tree Compaction 策略,这里只用到它们的代价结论。
一、三种放大与 RUM 猜想
定义
设用户写入 \(U\) 字节,存储引擎写到数据文件的总字节为 \(W\),磁盘上占用 \(D\) 字节而逻辑上的有效数据为 \(N_{\text{live}}\),一次点查读了 \(r\) 个块:
\[ \mathrm{WA} = \frac{W}{U}, \qquad \mathrm{SA} = \frac{D}{N_{\text{live}}}, \qquad \mathrm{RA} = r \ \text{(每次查询读的块数)}. \]
WiscKey 论文把读放大定义为读出字节与用户请求字节之比(Lu et al., FAST 2016, §2.3),本文用块数,因为块数与块大小无关,便于比较 16 KiB 的 B+tree 页和 4 KiB 的 LSM 数据块。三点口径说明:
- WAL 不计入 WA。两类引擎都要先写日志,这部分对两者相同,只会抬高基数。
- WA 只到文件系统为止。SSD 内部的垃圾回收还会再放大一次,Didona 等人把它记作 WA-D,并指出端到端写放大是应用层 WA-A 与 WA-D 的乘积(Didona et al., PVLDB 14(3), 2021, §4 Pitfall 2)。第七节会看到这一项能改变结论。
- SA 的分母是存活数据。旧版本、墓碑、页内空闲空间都算放大。
RUM 猜想原文说了什么
Athanassoulis 等人在 EDBT 2016 的论文《Designing Access Methods: The RUM Conjecture》中定义了读开销 RO、更新开销 UO、内存(存储)开销 MO,三者的理想值都是 1.0,然后给出猜想:
An access method that can set an upper bound for two out of the read, update, and memory overheads, also sets a lower bound for the third overhead.
也就是说,如果能给其中两项开销设上界,第三项就一定有下界。论文的小节标题确实是 “Optimize Two at the Expense of the Third”,Dong 等人在 CIDR 2017 也转述为”可以为任意两项优化,代价是第三项”。但”最多只能优化两个”这个说法有两处不准确:
- 它是猜想,不是定理。论文写的是 “proving the RUM Conjecture will expand on this line of work”,至今没有一般性证明。已经证明的是它的一个二维切片:Brodal 与 Fagerberg(SODA 2003)在外存比较模型下证明了插入 I/O 与查询 I/O 之间的下界权衡,并给出匹配的上界结构。空间这一维没有对应的下界定理。
- 猜想说的是极限,不是”只能挑两个”。论文紧接着说 “In modern implementations of data systems, however, one can optimize up to some point for all three”,并以块级聚簇索引为例,它同时降低了读开销和空间开销。

图中的分组照搬论文 Figure 1。B-Tree 在读优化角,LSM 在写优化角,Bloom filter 这样的近似索引在空间优化角。LSM 的实际位置由 size ratio 和合并策略决定,会在这张图里移动,这正是 Dostoevsky 一类工作研究的对象(第四节)。
二、谱系:从原地更新到可调的合并策略
| 年份 | 工作 | 贡献 |
|---|---|---|
| 1972 | Bayer & McCreight, Acta Informatica 1(3) | B-tree:平衡多路树,节点大小与磁盘页对齐,更新原地进行 |
| 1978 | Yao, Acta Informatica 9(2) | 随机插入下高阶 B-tree 的节点利用率趋于 \(\ln 2 \approx 69\%\) |
| 1979 | Comer, ACM Computing Surveys 11(2) | 综述 B-tree 变体,包括数据只放叶子、叶子相连的 B+-tree |
| 1996 | O’Neil, Cheng, Gawlick, O’Neil, Acta Informatica 33(4) | LSM-tree:内存组件 \(C_0\) 与磁盘组件 \(C_1 \dots C_K\),滚动合并(rolling merge),给出插入代价公式与几何级数最优定理 |
| 2003 | Brodal & Fagerberg, SODA | 外存字典插入与查询的下界权衡,给出匹配上界 |
| 2006 | Chang et al., OSDI(Bigtable) | memtable + 不可变 SSTable + minor/merging/major compaction |
| 2011 起 | LevelDB;RocksDB 由 Facebook 从 LevelDB 分叉 | leveled compaction、每层 10 倍、表内 Bloom filter 块 |
| 2015 | Bender et al., ;login: 40(5) | Bε-tree 综述:用一个参数 \(\varepsilon\) 在 B-tree 与缓冲树之间连续调节 |
| 2017 | Dayan, Athanassoulis, Idreos, SIGMOD(Monkey) | 按层分配 Bloom filter 内存,使零结果点查代价不再随层数增长 |
| 2018 | Dayan & Idreos, SIGMOD(Dostoevsky) | 统一 leveling 与 tiering 的代价模型,提出 lazy leveling 与 Fluid LSM |
| 2020 | Luo & Carey, VLDB Journal 29(1) | LSM 研究综述,给出各合并策略的渐近代价表 |
这条线索的核心是同一个问题:更新要不要立刻落到它最终的位置。B-tree 说要,于是每次更新都要把目标页读进来、改掉、再整页写回;LSM 说不必,先在内存里攒一批,再批量、顺序地合并下去。后面三十年的工作,大多在调节”攒多少、合并多少次、合并时丢掉多少旧版本”。
三、B+tree:一次更新写多少字节
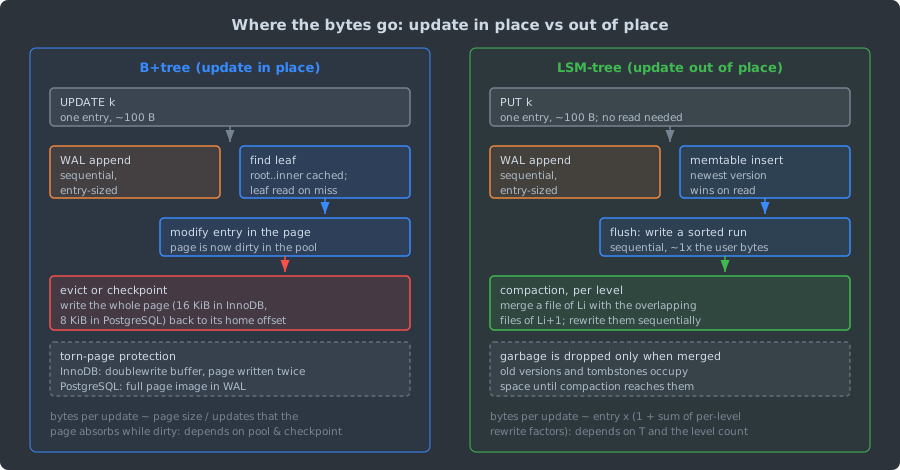
两种极端情况
设条目大小 \(S_e\)、页大小 \(S_p\),每次更新平均导致 \(w\) 次整页写回,则
\[ \mathrm{WA}_{\text{B+}} = w \cdot \frac{S_p}{S_e}. \]
\(w\) 的大小由缓存决定。O’Neil 1996 分析 B-tree 插入时假设叶页”在内存中被引用得太少,来不及积累第二次插入”,于是每次插入要读一次叶子、稳态下写回一个脏页,得到式 (3.1):
\[ \mathrm{COST}_{\text{B-ins}} = \mathrm{COST}_P \cdot (D_e + 1), \]
其中 \(D_e\) 是一次查找中不在缓冲区的页数(论文中的例子约为 2),\(\mathrm{COST}_P\) 是一次随机页 I/O 的代价。这对应 \(w \approx 1\),写放大就是 \(S_p/S_e\)。16 KiB 页、128 B 条目时是 128 倍,4000 B 条目时约为 4。
另一端是缓冲池装得下全部数据:页只在 checkpoint 时写回。设两次 checkpoint 之间有 \(U_c\) 次更新落在 \(P\) 个叶页上,被写的页数约为 \(P\,(1 - e^{-U_c/P})\),于是
\[ w \approx \frac{P\,(1 - e^{-U_c/P})}{U_c}. \]
\(U_c \gg P\) 时几乎所有叶子每轮都脏,\(w \approx P/U_c\),写放大与 checkpoint 间隔成反比。介于两者之间时,\(w\) 约等于缺页率(每次缺页都会把一个脏页挤出去)加上 checkpoint 的贡献。
所以”InnoDB
的写放大是某个固定区间”这种说法没有意义:同一棵树,换一个
innodb_buffer_pool_size 或 redo
日志容量,写放大可以差一个数量级。第五节的实验把这条曲线实测了出来。
模型之外的两项
- 防撕裂页的额外写。InnoDB 默认开启
doublewrite 缓冲(MySQL 8.4
innodb_doublewrite),数据页先写进 doublewrite 区再写到原位置;PostgreSQL 默认full_page_writes = on(REL_17postgresql.conf.sample),每个页在 checkpoint 之后第一次被修改时,整页镜像会写进 WAL。两者都让页写回部分再多一份。 - 分裂。O’Neil 认为分裂对插入代价影响不大,可以忽略;本文的纯覆盖写负载里不发生分裂。
空间与读
B+tree 的空间放大主要来自页内空闲空间。Yao 1978 证明随机插入下高阶 B-tree 的利用率约为 \(\ln 2 \approx 69\%\),对应 \(\mathrm{SA} \approx 1/0.69 \approx 1.44\);Dong 等人在 Facebook 生产库中测得 B-tree 页只有 1/2 到 2/3 满,即 SA 大于 1.5(CIDR 2017, §3)。按键序插入时右端分裂能把页填满,情况完全不同,这部分见 B-tree 深度解剖。
读的一侧,内部节点通常常驻缓存。Bender 等人指出,只有叶子不在缓存时,点查和更新都只需一次 I/O,范围查询的代价与读到的叶子数成正比(;login: 2015)。
四、LSM-tree 的代价模型
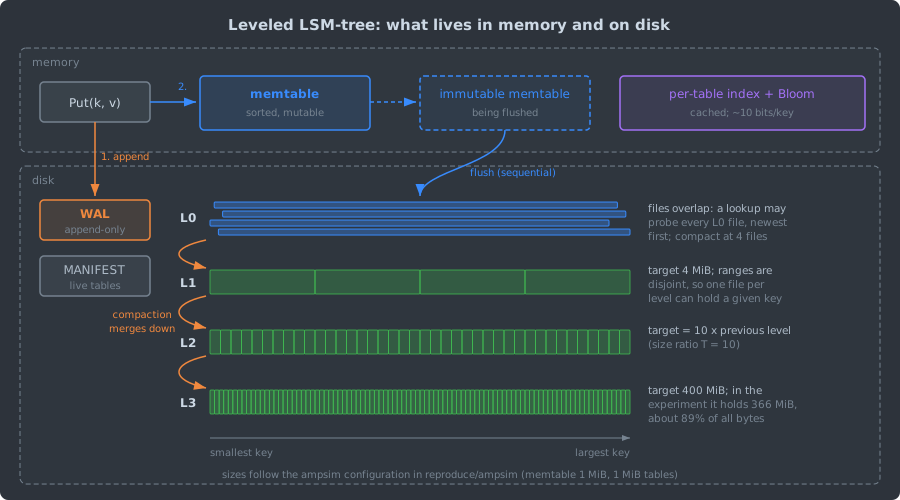
图中的层大小取自第五节实验的配置。真实系统的默认值:LevelDB
1.23 有 7 层(db/dbformat.h 中的
kNumLevels),L0 文件数达到 4 时触发
compaction、达到 8 时减速写入、达到 12 时停写;L1 目标 10
MB,之后每层乘以 10(db/version_set.cc 中的
MaxBytesForLevel)。RocksDB 9.10.0 的默认值是
64 MB memtable、L0 触发阈值
4、max_bytes_for_level_base 256 MB、层间倍数
10、level_compaction_dynamic_level_bytes = true(include/rocksdb/options.h、advanced_options.h)。
写路径与持久化顺序
flowchart TD
    P["Put(k, v)"] --> W["append record to WAL"]
    W --> M["insert into memtable"]
    M --> F{"memtable full?"}
    F -- no --> R["return"]
    F -- yes --> N["switch to a new WAL"]
    N --> T["write sorted L0 table and fsync"]
    T --> MF["write MANIFEST.tmp, fsync, rename"]
    MF --> D["delete the old WAL"]
    D --> C{"some level over target?"}
    C -- yes --> K["merge a file of Li with overlapping files of Li+1, install via MANIFEST, delete inputs"]
    K --> C
    C -- no --> R
顺序是关键:新表先落盘,再由 MANIFEST
原子地”发布”,最后才删除旧 WAL 或 compaction
的输入文件。任意两步之间崩溃,重启时都能从 MANIFEST 与残留的
WAL 恢复出一致状态。WAL 记录每条是否 fsync
是另一个开关:LevelDB 的 WriteOptions::sync
默认是
false(include/leveldb/options.h),进程崩溃不丢数据,操作系统崩溃或断电可能丢掉最近的若干条。
每层写多少次:O’Neil 的 \(1+r\)
O’Neil 把 LSM 的优势拆成两个批量效应。第一个是多页块顺序 I/O 的单页代价 \(\mathrm{COST}_\pi\) 远小于随机页 I/O 的 \(\mathrm{COST}_P\)。第二个是批量合并参数 \(M\):滚动合并经过 \(C_1\) 的每个叶页时,平均有 \(M\) 条来自 \(C_0\) 的新条目并入这一页。设 \(C_0\)、\(C_1\) 叶层大小为 \(S_0\)、\(S_1\),则(式 3.2、3.3)
\[ M = \frac{S_p}{S_e} \cdot \frac{S_0}{S_0 + S_1}, \qquad \mathrm{COST}_{\text{LSM-ins}} = \frac{2\,\mathrm{COST}_\pi}{M}. \]
分子的 2 是 \(C_1\) 叶页读一次、写一次。只看写的那一半,每插入一条要写 \(1/M\) 页,即 \(\frac{S_e}{S_p}\cdot\frac{S_0+S_1}{S_0}\) 页,换算成字节:
\[ \mathrm{WA}_{C_0 \to C_1} = \frac{S_0 + S_1}{S_0} = 1 + r, \qquad r = S_1 / S_0. \]
把它和 B-tree 的 \(w \cdot S_p/S_e\) 对比,得到式 (3.4):
\[ \frac{\mathrm{COST}_{\text{LSM-ins}}}{\mathrm{COST}_{\text{B-ins}}} = K_1 \cdot \frac{\mathrm{COST}_\pi}{\mathrm{COST}_P} \cdot \frac{1}{M}, \qquad K_1 = \frac{2}{D_e + 1} \approx 0.67. \]
论文说两项之积”通常接近两个数量级”,并给出反向条件:若 \(M < K_1 \cdot \mathrm{COST}_\pi / \mathrm{COST}_P\),普通 B-tree 反而更好。这一推导有两点在今天仍然重要:
- 在 HDD 上,大部分优势来自 \(\mathrm{COST}_\pi/\mathrm{COST}_P\),即顺序与随机的差距。在 SSD 上这一项接近 1,剩下的主要是字节比 \((1+r)/(w\,S_p/S_e)\)。
- 条目越大,\(S_p/S_e\) 越小,LSM 的相对优势越小。\(M<1\) 时(条目大到一页只放几条,或 \(C_1\) 远大于 \(C_0\)),每并入一条要读写不止一页。
多组件情形下,O’Neil 的 Theorem 3.1 证明:总大小与最大组件固定时,相邻组件大小成几何级数(公比 \(r\) 相同)使总合并代价最小。今天各层之间的固定倍数 \(T\) 就源于这个结论。
每层写多少次:T 还是 T/2
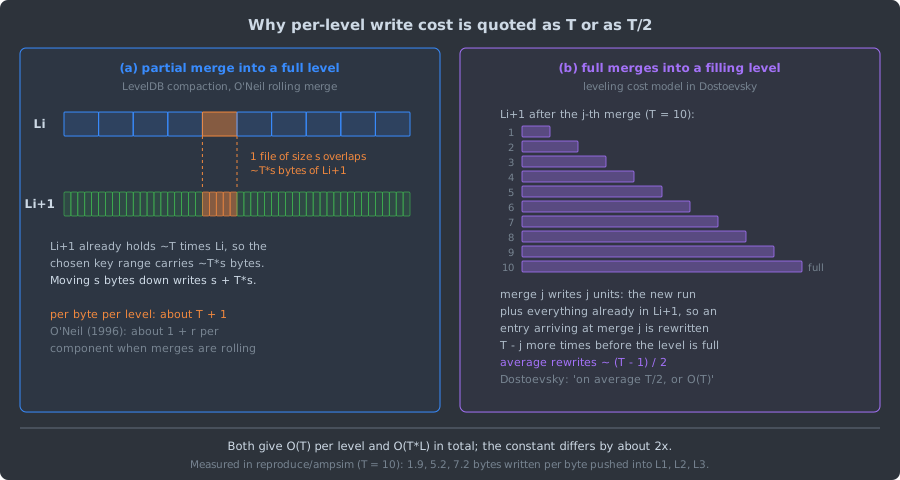
文献里 leveling 每层的写次数有两种常见说法,差别来自合并粒度:
- 部分合并、目标层始终接近满(左图)。LevelDB 一次从 \(L_i\) 挑一个文件,与 \(L_{i+1}\) 中键范围重叠的文件合并。\(L_{i+1}\) 大约是 \(L_i\) 的 \(T\) 倍,一个文件对应的重叠量也约为 \(T\) 倍,每字节每层写 \(T+1\) 次,和 O’Neil 的 \(1+r\) 一致。WiscKey 据此给出 LevelDB 的最坏情况:每跨一层最多 10 倍,从 L1 到 L6 总计可超过 50(FAST 2016, §2.3)。
- 整层合并、目标层从空到满(右图)。Dostoevsky 的分析是:第 \(j\) 个到达 \(L_i\) 的 run 触发一次合并,与已有的 run(此前 \(j-1\) 个 run 的合并结果)合在一起,“an entry gets merged on average \(\frac{T}{2}\), or \(O(T)\), times per level”。Luo 与 Carey 的综述也写作”每个组件在层满之前被合并 \(T-1\) 次”。
两者渐近相同,都是每层 \(O(T)\)。Dostoevsky 式 (12) 在 leveling(\(K = Z = 1\))下给出每次更新的 I/O 为
\[ W = \frac{\phi}{\mu B}\cdot\frac{T-1}{2}\cdot L, \]
其中 \(B\) 是每块的条目数,\(\mu\) 是设备上顺序访问比随机访问快的倍数(合并是顺序 I/O,所以除以它),\(\phi\) 刻画写比读更贵的设备(如闪存)。tiering(\(K = Z = T-1\))下括号里变成 \(\frac{T-1}{T} L\),即每层约写一次。层数 \(L \approx \lceil \log_T (N / N_{\text{buf}}) \rceil\)。注意 Dostoevsky 的分析假设最坏负载:所有更新都指向最大层中的键,旧版本一直要到最底层才被消掉。均匀随机覆盖写会在中间层就把重复键合并掉,实测值会低于模型。
读:Bloom filter 决定点查,范围查询绕不开层数
flowchart TD
    G["Get(k)"] --> MEM{"k in memtable?"}
    MEM -- "value or tombstone" --> RET["return the first version found"]
    MEM -- no --> L0["L0 tables, newest first"]
    L0 --> CHK["per table: k within smallest..largest? Bloom says maybe? index binary search, read one block"]
    CHK -- found --> RET
    CHK -- "not in L0" --> LN["L1..L6: binary search on file ranges, at most one table per level"]
    LN --> CHK2["same per-table check"]
    CHK2 -- found --> RET
    CHK2 -- exhausted --> NF["NotFound"]
点查从新到旧找,找到第一个版本就停;如果那个版本是墓碑(tombstone),就返回”不存在”,更旧的值必须被它遮住。每个表先用键范围和 Bloom filter 过滤,只有 filter 回答”可能存在”时才读数据块。每键 \(b\) 位、\(k\) 个哈希函数时单个 filter 的误判率为
\[ p \approx \left(1 - e^{-k/b}\right)^k . \]
LevelDB 取 \(k = \lfloor 0.69\,
b \rfloor\)(util/bloom.cc),\(b = 10\) 时 \(k=6\),\(p \approx
0.84\%\)。查一个不存在的键,期望多读 \(\sum_i p_i\)
个块;查一个存在的键,期望读 \(1 +
\sum_{\text{更新的层}} p_i\) 个块。所有层用同样的
\(b\)
时,零结果点查的代价随层数线性增长,是 \(O(L\, e^{-M/N})\)(\(M\) 为 filter 总位数,\(N\) 为条目数)。Monkey
的做法是让较小的层获得更多的位、更低的误判率:一次误判在任何层都花一个
I/O,而小层条目少,降低它们的误判率所需的内存少。这样
leveling 下零结果点查降到 \(O(e^{-M/N})\)(据 Dostoevsky 对
Monkey 的转述)。Bloom filter 的各种变体见 Bloom Filter
全家族。
范围查询不能用 Bloom filter,必须在每个可能重叠的 run 上各做一次定位。Bender 等人把这称为 LSM 相对 Bε-tree 的主要劣势:范围查询的搜索代价被平方(;login: 2015)。
空间
Leveling 下,除最后一层外其余各层合计只占最后一层的 \(\sum_{i \ge 1} T^{-i} = \frac{1}{T-1}\)。最坏情况是上面各层全部是最后一层中键的旧版本,此时
\[ \mathrm{SA}_{\text{leveled}} \le 1 + \frac{1}{T-1}, \]
\(T=10\) 时是 \(1.111\)。Dong
等人给出的正是这个数,前提是最后一层恰好填满到目标大小(CIDR
2017, §3);最后一层不满时比值会更高,RocksDB 的
level_compaction_dynamic_level_bytes
就是为了让最后一层始终接近满。Tiering 下一层可以同时有多达
\(T\) 个重叠
run,空间放大是 \(O(T)\)。Dostoevsky 式 (13)
把最大层有 \(Z\) 个 run
时多占的比例写成 \(Z - 1 +
\frac{1}{T}\)。
渐近代价汇总
下表摘自 Luo 与 Carey 的综述 Table 1(\(L\) 为层数,\(T\) 为 size ratio,\(B\) 为每页条目数,\(M/N\) 为每条目的 filter 位数,\(s\) 为范围查询结果的条目数):
| 策略 | 写 | 点查(零结果) | 短范围 | 长范围 | 空间放大 |
|---|---|---|---|---|---|
| leveling | \(O\!\left(\frac{T\cdot L}{B}\right)\) | \(O(L\cdot e^{-M/N})\) | \(O(L)\) | \(O\!\left(\frac{s}{B}\right)\) | \(O\!\left(\frac{T+1}{T}\right)\) |
| tiering | \(O\!\left(\frac{L}{B}\right)\) | \(O(T\cdot L\cdot e^{-M/N})\) | \(O(T\cdot L)\) | \(O\!\left(\frac{T\cdot s}{B}\right)\) | \(O(T)\) |
RUM 论文 Table 1 给 B+tree 更新 \(O(\log_B N)\)、leveled LSM 更新 \(O\!\left(\frac{T}{B}\log_T \frac{N}{B}\right)\),形式不同但含义一致。内部节点缓存时 B+tree 每次随机更新约写一页,LSM 约写 \(\frac{T\cdot L}{B}\) 页,所以 LSM 写得少的前提是这个量小于 1,即每页条目数 \(B\) 足够大。O’Neil 的 \(M = \frac{B}{1+r} > 1\) 是同一条件在单个组件上的形式。
SSTable 的物理格式
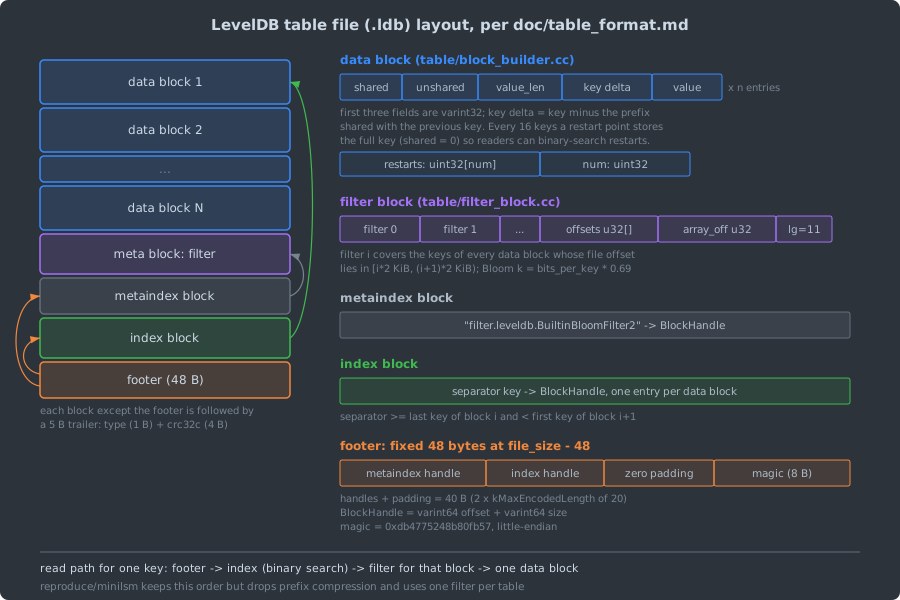
一次点查在一个表上读几个块,取决于这个格式。index 块和 filter 在打开表时读入并缓存,于是每个表最多读一个数据块,这就是 \(\sum_i p_i\) 模型的物理基础。WiscKey 的测量说明了缓存不住时会怎样:100 GB 的 LevelDB 库里,每次查找都可能落到不同的表,要重新读 16 KB 的 index 块和 4 KB 的 filter 块,读放大(按字节计)达到 327。
五、同一负载上的实测
实验环境与口径
- 程序:
reproduce/ampsim/main.go,只计数、不计时。B+tree 为 16 KiB 页、每叶 128 条,配 LRU 缓冲池,每写 64 MiB 日志做一次 checkpoint 刷出所有脏页,内部节点按”checkpoint 时脏了哪些父节点”近似计入;leveled LSM 按 LevelDB 的打分和轮转 compaction 指针挑文件;tiered LSM 在一层攒满 4 个 run 时整体合并到下一层;两种 LSM 都用每键 10 位的 Bloom filter。 - 负载:300 万个 128 B 条目按随机顺序插入(逻辑数据 366.2 MiB),再做 600 万次均匀随机覆盖写。WA 只统计覆盖写阶段,不含 WAL。
- 运行:
cd reproduce/ampsim && go run . -csv ../wa.csv,输出存于reproduce/ampsim/result.txt;曲线图由python reproduce/plot_wa.py reproduce/wa.csv wa-vs-buffer.svg生成。 - 环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,Go
1.26.4,
taskset -c 3绑核。种子 20260923 连续运行 3 次输出逐字节一致;换用种子 1 和 2,leveled 总 WA 为 14.61、14.63,B+tree 各点相差不到 0.5%。 - 这是模型,不是存储引擎:没有压缩、没有并发、没有 SSD 内部的 WA-D,数字用来检验代价公式,不代表任何真实系统的绝对值。
写放大
| 缓冲池 / 数据 | 缓冲池 | 每次更新写页数 | 缺页率 | B+tree WA |
|---|---|---|---|---|
| 0.02 | 7.3 MiB | 0.986 | 0.986 | 126.15 |
| 0.05 | 18.3 MiB | 0.964 | 0.964 | 123.37 |
| 0.10 | 36.6 MiB | 0.928 | 0.928 | 118.75 |
| 0.25 | 91.5 MiB | 0.821 | 0.819 | 105.03 |
| 0.50 | 183.1 MiB | 0.646 | 0.641 | 82.63 |
| 1.00 | 366.2 MiB | 0.313 | 0.290 | 40.11 |
| 1.60 | 585.9 MiB | 0.067 | 0.000 | 8.63 |
同一负载下 leveled LSM(memtable 1 MiB、L1 4 MiB、\(T=10\))的 WA 为 14.40,tiered LSM(每层 4 个 run)为 5.21。
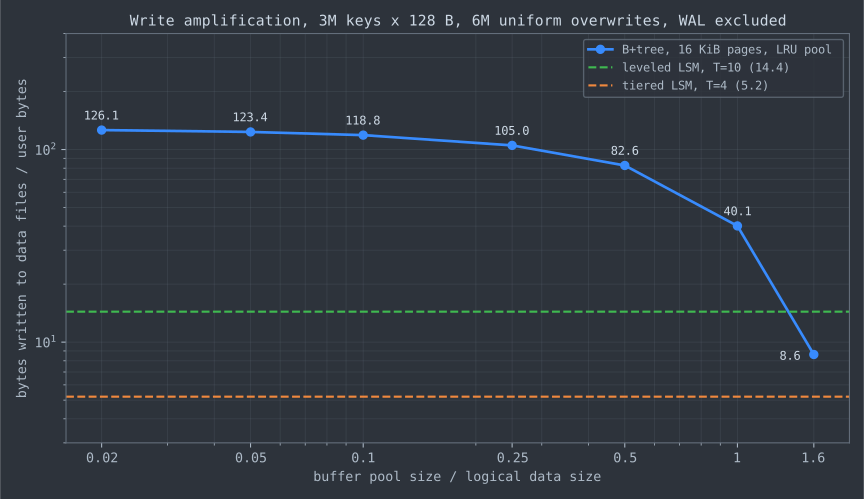
三个区间都能用第三节的公式解释:
- 小缓冲池:每次更新几乎都把一个脏页挤出去,\(w\) 就是缺页率,\(\mathrm{WA} \approx 0.986 \times 16384/128 = 126.2\),与实测 126.15 相符。
- 缓冲池等于逻辑数据量:仍有 29% 的缺页,因为页只有 69.6% 满,物理页数是逻辑数据的 1.44 倍,缓冲池只能装下约 \(1/1.44\) 的页。均匀访问下 LRU 的缺页率约为 \(1 - 1/1.44 \approx 0.31\),接近实测的 0.29。
- 缓冲池装下全部页:只剩 checkpoint 写。叶页数为 \(3 \times 10^6 / (128 \times 0.696) \approx 33{,}700\);加载阶段写了 366.2 MiB 日志,余下约 46 MiB 未触发 checkpoint,覆盖写阶段再写 732.4 MiB,共触发 12 次。每次 checkpoint 之间有 52 万次更新,\(U_c/P \approx 15.6\),几乎每个叶页都脏,于是 \(\mathrm{WA} \approx 12 \times 33{,}700 \times 16384 / (6 \times 10^6 \times 128) \approx 8.6\),与实测 8.63 相符。
以 leveled LSM 为基准,它写的字节在缓冲池为数据 10% 时是 B+tree 的 12%,50% 时是 17%,缓冲池能装下全部数据时反而是 B+tree 的 1.67 倍。Dong 等人报告 Facebook 生产环境中 RocksDB 写入存储的数据量是 InnoDB 的 10% 到 15%(CIDR 2017, §5),与小缓冲池区间的结果同一量级。这只是方向上的佐证:负载、条目大小和压缩都不同。
分层分解:为什么不是 \(1 + T \cdot L\)
| 层 | 写入 / 用户字节 | 每下推 1 字节写入 | 选中时源层大小 | 目标层大小 | 重叠 / 下推 | 选中文件密度 / 层平均 |
|---|---|---|---|---|---|---|
| flush 到 L0 | 0.998 | — | — | — | — | — |
| L0 到 L1 | 1.887 | 1.899 | 3.98 MiB | 3.62 MiB | 0.91 | — |
| L1 到 L2 | 5.140 | 5.230 | 6.09 MiB | 40.61 MiB | 4.33 | 1.87 |
| L2 到 L3 | 6.372 | 7.188 | 41.56 MiB | 364.14 MiB | 7.12 | 1.83 |
| 合计 | 14.40 |
按”每层 \(T+1\)“估算,\(1 + 3 \times 11 = 34\);按 Dostoevsky 的”每层 \(\frac{T-1}{2}\)“估算,\(1 + 3 \times 4.5 = 14.5\)。总数和后者几乎相同,但逐层看两个模型都不对,这个吻合是巧合。表中三列说明了偏差来自哪里:
- L1 经常超标。一次 L0 compaction 把约 4 MiB 一起压进 L1,而 L1 的目标也只有 4 MiB,所以 L1 被挑文件时平均有 6.09 MiB,L2 与 L1 的实际比只有 6.67,不是 10。
- 轮转指针挑到的是密的文件。被选中的文件单位键空间的条目数是所在层平均值的
1.8
倍以上:指针刚扫过的区间最近被重写过、比较稀,前方较久未动的区间积累了更多上层下来的数据。文件越密,同样字节覆盖的键范围越窄,下层重叠越少。RocksDB
默认的
compaction_pri = kMinOverlappingRatio(advanced_options.h)更进一步,直接挑重叠比最小的文件。 - 下推时顺带去重。均匀覆盖写使下层中同一个键的旧版本在合并时被丢掉,L2 到 L3 每下推 1 字节,重叠 7.12 字节,但写出只有 7.19 字节而不是 8.12 字节。
WiscKey 观察到同样的现象:LevelDB 实际写放大达不到最坏情况,“since the average number of files merged between levels is usually smaller than the worst case of 10”,100 GB 的库加载阶段 WA 为 14。
空间放大
| 结构 | SA |
|---|---|
| B+tree(随机插入后) | 1.440,叶子平均 69.6% 满 |
| leveled LSM | 平均 1.116,最大 1.128 |
| tiered LSM | 平均 1.610,最大 2.383 |
B+tree 的 69.6% 与 Yao 的 \(\ln 2\) 吻合。leveled 的 1.116 略高于 Dong 的 1.111,因为最后一层只装到目标的 92%:\(1 + (2.0 + 3.9 + 39.7)/366.2 \approx 1.125\)。
读:点查与短范围扫描
| 结构 | 存在的键:查的 run 数 / 读的块数 | 不存在的键:run 数 / 块数 | 100 条范围扫描 |
|---|---|---|---|
| B+tree(内部节点缓存) | — / 1 | — / 1 | 2.11 个 16 KiB 叶 = 33.8 KiB |
| leveled LSM | 4.50 / 1.028 | 4.66 / 0.039 | 4.68 个 run,8.08 个 4 KiB 块 = 32.3 KiB |
| tiered LSM | 5.76 / 1.039 | 6.00 / 0.051 | 6.00 个 run,9.59 个块 = 38.4 KiB |
不存在的键平均查 4.66 个 run、读 0.039 个块,即每个 run 误判 0.84%,与 \((1 - e^{-0.6})^6 \approx 0.84\%\) 一致。点查上 Bloom filter 几乎抹平了差距。范围扫描读的字节数相近,但 LSM 要在 4.68 个 run 上分别定位、做 8 次 I/O,B+tree 只做约 2 次;在延迟受 I/O 次数支配的设备上,这就是”LSM 读慢”真正成立的地方。
六、一个能跑的 mini LSM
reproduce/minilsm 是一个约 900
行(不含测试)的 Go
实现,用来把上面的读写路径落到真实文件上:WAL 每条记录带
crc32c 与长度,重放到撕裂的尾部为止并截断;memtable 用 map
保存、flush 时排序;SSTable 沿用 LevelDB
的”数据块、filter、index、footer”顺序,但去掉了前缀压缩,每个表只有一个
Bloom filter;MANIFEST 用”写临时文件、fsync、rename、fsync
目录”原子替换;compaction 用 LevelDB 的打分和轮转指针。
cd reproduce/minilsm
go vet ./... && go test -race ./...
go run ./cmd/demo
测试包括:与一个 map 模型对照的 6 万次随机 Put/Delete/Get(每 1.5 万次重开一次库),墓碑遮蔽下层旧值,compaction 后新版本胜出,撕裂的 WAL 尾部,不调用 Close 直接重开,过期文件被删除,数据块损坏被 CRC 检出,Bloom filter 误判率(每键 10 位,实测 0.89%)。
玩具 LSM 最容易写错的是”哪个版本算数”。读路径必须在第一个找到的版本处停下,哪怕它是墓碑:
func (db *DB) Get(key string) ([]byte, error) {
    db.mu.Lock()
    defer db.mu.Unlock()
    if e, ok := db.mem[key]; ok {
        return result(e) // a tombstone returns ErrNotFound here
    }
    for _, t := range db.levels[0] { // newest first
        if e, ok, err := t.get(key); err != nil || ok {
            if err != nil {
                return nil, err
            }
            return result(e)
        }
    }
    // L1..L6: at most one table per level can contain key
    // ...
    return nil, ErrNotFound
}
合并时键相同要留较新的一方,输入必须按从新到旧的顺序合并:
func mergeNewerOlder(newer, older []kv) []kv {
    out := make([]kv, 0, len(newer)+len(older))
    i, j := 0, 0
    for i < len(newer) && j < len(older) {
        switch c := strings.Compare(newer[i].key, older[j].key); {
        case c < 0:
            out = append(out, newer[i])
            i++
        case c > 0:
            out = append(out, older[j])
            j++
        default: // same key: keep the newer version, drop the older
            out = append(out, newer[i])
            i++
            j++
        }
    }
    out = append(out, newer[i:]...)
    return append(out, older[j:]...)
}
墓碑只有在更深的层都不可能再有这个键时才能丢掉(代码中的
isBaseLevelForKey),否则被它遮住的旧值会重新出现。这几条测试确实能抓到对应的错误:把
Get
改成遇到墓碑继续往下查,TestModel、TestTombstoneHidesOlderLevels、TestRecoverWithoutClose
三个测试失败;把合并改成保留旧版本,TestNewestVersionWinsCompaction
等三个测试失败;去掉重放后对 WAL
撕裂尾部的截断,TestTornWALTail 失败。
cmd/demo 用 1/16 的配置(memtable 64 KiB、L1
256 KiB、\(T=10\)、表 64
KiB)写入 18 万个 16 B 键加 112 B 值,再做 36
万次随机覆盖写并删除
1%,逐键校验后打印真实文件的字节数:
verified 180000 keys (1800 deleted)
overwrite phase: user 44.0 MiB, WAL 47.4 MiB, flush 45.7 MiB, compaction 670.5 MiB
write amplification excluding WAL: 16.29
  L0:   1 tables,   0.04 MiB
  L1:   4 tables,   0.24 MiB
  L2:  41 tables,   2.46 MiB
  L3: 374 tables,  22.86 MiB
16.29 与模拟器的 14.40 同一量级,高出约 13%。其中约 4 个百分点是文件格式开销:flush 写 45.7 MiB 对应 44.0 MiB 用户数据,多出来的是每条记录的 varint 头、块 CRC、index 与 filter,每经过一层都要再付一次。其余来自配置上的差别:memtable 按”键长加值长加 16 字节”计满,一个 memtable 只装约 455 条,而模拟器配置按 1/16 缩放后对应 512 条;两者的文件切分方式也不同。这部分本文没有再逐项分解。
七、争论与开放问题
争论一:每层 \(T\) 次还是 \(T/2\) 次
第四节已经说明,两种说法对应不同的合并粒度:LevelDB 式的部分合并面对的是一个接近满的目标层,Dostoevsky 模型里的整层合并面对的是一个从空到满的目标层。Thonangi 与 Yang(ICDE 2017)形式化分析了分区对写代价的影响:总是挑选下一层重叠文件最少的表(ChooseBest)时,整体写代价低于整层合并;但整层合并会把当前层清空、减少之后的合并量,某些时段反而写得更少,于是他们又提出按相邻层大小之比在两种合并之间切换、并在线学习切换阈值的混合策略(据 Luo 与 Carey 综述 §3.6 的转述)。第五节的实测给出了第三种情况:逐层看,两个模型都不准;L1 超标、挑选策略和去重让每层实际值落在 1.9 到 7.2 之间。写代价的常数项对 SSD 寿命和 compaction 带宽是实打实的差别,而常用的模型都只保证渐近正确。
争论二:LSM 一定比 B+tree 写得少吗
Dong 等人的生产数据和 LinkBench 实验(10 亿顶点,50 GB 内存)都显示 RocksDB 的写入量不到 InnoDB 的 20%(CIDR 2017, §5)。Didona 等人在 SSD 上用 RocksDB 和 WiredTiger(B+tree)做长时间测试,默认负载是 16 B 键加 4000 B 值、10 MB 缓存、均匀随机覆盖写,得到了相反的结论:稳态下 RocksDB 的应用层写放大 WA-A 为 12,是 WiredTiger 的 1.2 倍;把 SSD 内部的 WA-D 乘进去,RocksDB 的端到端写放大是 25,是 WiredTiger 的 2.1 倍(PVLDB 2021, §4)。
两者不必矛盾。第三节的公式说明 B+tree 的写放大正比于 \(S_p/S_e\):Didona 的默认条目接近 4 KB,一页只放几条,\(w \approx 1\) 时 B+tree 的写放大也只有个位数,LSM 在这一项上没有多少可省;本文实验用 128 B 条目,\(S_p/S_e = 128\),结论就反过来。LSM 在应用层省下的字节,还可能在设备层以 GC 的形式还回去。Didona 列出的七个评测陷阱(测试太短、忽略 WA-D、忽略 SSD 初始状态、忽略数据集大小、忽略额外空间、忽略超额配置、忽略设备类型),每一个都被实验证明会显著改变测得的性能,拿两类引擎做比较时都要控制。
争论三:RUM 是定理还是经验规律
如第一节所述,RUM 至今是猜想。Brodal 与 Fagerberg 的下界只覆盖”更新与查询”这一对,而且限定在比较模型下;空间这一维、以及允许哈希的模型,都没有对应的下界。KVell(Lepers et al., SOSP 2019)从另一个方向挑战了这组权衡的前提:在 NVMe SSD 上,随机与顺序访问的性能相近,LSM 和 B-tree 类 KV 存储都是 CPU 瓶颈,维持磁盘上的有序性本身就是开销。KVell 在盘上不排序、索引放在内存里,报告读为主负载吞吐至少是最强对手的 2 倍、写为主负载 5 倍;代价是索引必须装进内存,这恰好是 RUM 里 MO 那一项。
开放问题
- 尾延迟。上面的模型都是摊还代价。compaction 与 flush 争抢 I/O 会造成写停顿,SILK(Balmau et al., USENIX ATC 2019)通过调度 flush 与各层 compaction 的 I/O 带宽,报告 p99 延迟比 RocksDB 低至多两个数量级。怎样把尾延迟纳入 RUM 这样的代价框架,还没有公认的答案。
- 设备层写放大的建模。WA-D 取决于 FTL、超额配置和写入模式,Didona 的测量表明它能让结论反转;而 O’Neil、Dostoevsky 的模型和本文的模拟器都只算到应用层写出的字节或 I/O,把两层放在一起的代价模型仍是空白。
- 在两端之间连续调节。Bε-tree 用 \(\varepsilon\) 在 B-tree(\(\varepsilon = 1\))和 buffered repository tree(\(\varepsilon = 0\))之间调节,\(\varepsilon = 1/2\) 时插入代价除以约 \(\sqrt{B}\)、点查最多慢 2 倍;Bender 等人的例子是 \(B = 1024\) 时插入快 16 倍,TokuDB 与 BetrFS 采用了这种结构。Dostoevsky 的 Fluid LSM 在 LSM 内部做同样的事。哪一族在给定负载上更优,目前仍靠实验回答。
八、工程选型
从上面的模型可以直接读出几条判断依据,每条都对应一个可以测量的量:
- 先算 \(S_p/S_e\) 和缓存比例。条目远小于页、数据远大于缓冲池、更新随机分布时,B+tree 的 \(w\) 接近 1,写放大接近 \(S_p/S_e\),LSM 写得少得多;Facebook 把 MySQL 从 InnoDB 迁到 MyRocks 后报告的写入量下降(第五节引用)与这一区间方向一致。条目接近页大小,或热数据装得进缓冲池时,B+tree 的写放大很低,由条目大小或 checkpoint 间隔决定,可能比 LSM 还低。
- 范围扫描看 I/O 次数。短范围扫描上 LSM 要在每个 run 上各定位一次,B+tree 只读连续的叶子。只看扫描的 I/O 次数,B+tree 最少,leveling 次之,tiering 最多。
- 空间看碎片与层数。随机写的 B+tree 页平均只有七成满;leveled LSM 在最后一层接近满时 SA 约为 \(1 + \frac{1}{T-1}\),再加上按块压缩不受页对齐限制,Dong 等人报告的是比压缩后的 InnoDB 少约 50% 空间。
- 写放大要测到设备。用
iostat或设备的 SMART 计数器测端到端写入量,测试要跑到 SSD 进入稳态 GC 之后,否则结论可能与长期运行相反。 - 可调的旋钮。B+tree
侧是缓冲池大小、checkpoint 间隔(PostgreSQL 17 默认
checkpoint_timeout = 5min、max_wal_size = 1GB)和页大小;LSM 侧是 size ratio \(T\)、L0 触发阈值、memtable 大小与每键 filter 位数。compaction 策略的选择见 LSM-tree Compaction 策略,缓冲池替换算法见 缓冲池管理算法。
九、参考资料
规范与文档
- LevelDB
1.23,
doc/table_format.md(表文件格式)、doc/impl.md(compaction 与层结构)。 - MySQL 8.4 Reference Manual,“Doublewrite Buffer” 与
innodb_doublewrite。 - PostgreSQL
17,
src/backend/utils/misc/postgresql.conf.sample(full_page_writes、checkpoint_timeout、max_wal_size默认值)。
源码
- LevelDB
1.23:
table/block_builder.cc(前缀压缩与 restart 点)、table/filter_block.cc(每 2 KiB 一个 filter)、table/format.h(kBlockTrailerSize、Footer::kEncodedLength、kTableMagicNumber)、db/dbformat.h(层数与 L0 阈值)、db/version_set.cc(MaxBytesForLevel、compact_pointer_)、include/leveldb/options.h(WriteOptions::sync)、util/bloom.cc(\(k = 0.69\,b\))。 - RocksDB
v9.10.0:
include/rocksdb/options.h、include/rocksdb/advanced_options.h(memtable、层大小、level_compaction_dynamic_level_bytes、compaction_pri默认值)。
核心论文
- R. Bayer, E. McCreight, “Organization and Maintenance of Large Ordered Indexes”, Acta Informatica 1(3):173–189, 1972.
- P. O’Neil, E. Cheng, D. Gawlick, E. O’Neil, “The Log-Structured Merge-Tree (LSM-Tree)”, Acta Informatica 33(4):351–385, 1996.
- M. Athanassoulis, M. S. Kester, L. M. Maas, R. Stoica, S. Idreos, A. Ailamaki, M. Callaghan, “Designing Access Methods: The RUM Conjecture”, EDBT 2016.
- G. S. Brodal, R. Fagerberg, “Lower Bounds for External Memory Dictionaries”, SODA 2003.
- N. Dayan, M. Athanassoulis, S. Idreos, “Monkey: Optimal Navigable Key-Value Store”, SIGMOD 2017, pp. 79–94.
- N. Dayan, S. Idreos, “Dostoevsky: Better Space-Time Trade-Offs for LSM-Tree Based Key-Value Stores via Adaptive Removal of Superfluous Merging”, SIGMOD 2018.
- C. Luo, M. J. Carey, “LSM-based Storage Techniques: A Survey”, The VLDB Journal 29(1), 2020(arXiv:1812.07527).
其他论文
- A. C. Yao, “On Random 2–3 Trees”, Acta Informatica 9(2):159–170, 1978.
- D. Comer, “The Ubiquitous B-Tree”, ACM Computing Surveys 11(2):121–137, 1979.
- F. Chang, J. Dean, S. Ghemawat, W. C. Hsieh, et al., “Bigtable: A Distributed Storage System for Structured Data”, OSDI 2006(期刊版 ACM TOCS 26(2), 2008).
- L. Lu, T. S. Pillai, A. C. Arpaci-Dusseau, R. H. Arpaci-Dusseau, “WiscKey: Separating Keys from Values in SSD-conscious Storage”, USENIX FAST 2016.
- S. Dong, M. Callaghan, L. Galanis, D. Borthakur, T. Savor, M. Stumm, “Optimizing Space Amplification in RocksDB”, CIDR 2017.
- R. Thonangi, J. Yang, “On Log-Structured Merge for Solid-State Drives”, ICDE 2017, pp. 683–694.
- B. Lepers, O. Balmau, K. Gupta, W. Zwaenepoel, “KVell: the Design and Implementation of a Fast Persistent Key-Value Store”, SOSP 2019, pp. 447–461.
- O. Balmau et al., “SILK: Preventing Latency Spikes in Log-Structured Merge Key-Value Stores”, USENIX ATC 2019.
- D. Didona, N. Ioannou, R. Stoica, K. Kourtis, “Toward a Better Understanding and Evaluation of Tree Structures on Flash SSDs”, PVLDB 14(3):364–377, 2021.
工程资料
- M. A. Bender, M. Farach-Colton, W. Jannen, R. Johnson, B. C. Kuszmaul, D. E. Porter, J. Yuan, Y. Zhan, “An Introduction to Bε-trees and Write-Optimization”, ;login: 40(5), October 2015.
实验
reproduce/ampsim/main.go:第五节全部数字与leveled-merge.svg底部的每层写入;结果文本reproduce/ampsim/result.txt。reproduce/plot_wa.py:由reproduce/wa.csv生成wa-vs-buffer.svg。reproduce/minilsm/:第六节的实现、测试与cmd/demo输出(demo-result.txt)。
系列导航: - 上一篇:B-tree 深度解剖:从磁盘 I/O 模型到 boltdb 源码 - 下一篇:Treap 与跳表:随机平衡的期望代价与生产参数
相关阅读: - LSM-tree Compaction 策略 - 缓冲池管理算法:LRU-K、2Q 与 CLOCK-Pro - Bloom Filter 全家族
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【从零写一个 LSM-Tree 存储引擎】LSM-Tree 全景:为什么要先写日志再排序
从零理解 LSM-Tree 存储引擎的设计哲学:B-Tree 与 LSM-Tree 的本质差异,写放大/读放大/空间放大的三角权衡,以及 WAL、MemTable、SSTable、Compaction、Bloom Filter 各组件的角色与协作关系。从零写一个 LSM-Tree 存储引擎系列第 1 篇。
从零写一个 LSM-Tree 存储引擎
五篇长文,从 LSM-Tree 的设计哲学讲到完整 KV 引擎实现,最后用 Rust 重写并三方 benchmark 对比。每篇含完整 C 代码、架构图、数学推导。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
B-tree 深度解剖:从磁盘 I/O 模型到 boltdb 源码
从 Bayer-McCreight 1972 推导树高与分裂摊还代价,用计数模拟器和 bbolt v1.5.0 实测:随机插入页填充约 69%,按键序插入由分裂点决定是 50% 还是近 100%;再对照 bbolt、PostgreSQL、SQLite 源码看删除、写时复制与 B-link 并发。