数据库恢复最容易被误解成一句话:“提交前写日志,崩溃后重放日志”。这句话不够用。缓冲池允许把未提交事务的脏页刷盘,也允许提交时不刷数据页;于是崩溃后的磁盘可能同时缺少已提交更新、又包含未提交更新。ARIES 解决的是这个组合带来的恢复顺序问题:先把历史重做到崩溃点,再把未完成事务撤销,并且撤销本身也能在再次崩溃后继续。
本文只讨论单机存储引擎里的恢复协议,不展开复制、分布式提交和锁管理。实验数据来自同目录
reproduce/aries_sim.py,指标只统计日志记录数、redo/undo
次数和 CLR 数,不使用墙钟时间。
一、从 steal/no-force 看 WAL 的必要性
Härder 与 Reuter 在 1983 年的综述中用 Atomicity、Consistency、Isolation、Durability 四个词组织事务恢复问题;Gray 与 Reuter 1993 年的教材把这套术语变成了数据库工程的共同语言。恢复协议真正要面对的是缓冲池策略,而不是口号。
| 缓冲策略 | 提交时是否刷数据页 | 是否允许未提交脏页刷盘 | 恢复需要什么 |
|---|---|---|---|
| no-steal + force | 是 | 否 | 最简单,但提交路径慢 |
| no-steal + no-force | 否 | 否 | 需要 redo |
| steal + force | 是 | 是 | 需要 undo |
| steal + no-force | 否 | 是 | 需要 redo 和 undo |
ARIES 选择的是 steal + no-force:缓冲池可以为了腾空间刷出未提交脏页,提交时只保证日志持久化而不强制刷所有数据页。它换来的吞吐很高,代价是恢复协议必须同时满足两条 WAL 约束:
\[ \text{flush page } P \Rightarrow \text{pageLSN}(P) \le \text{flushedLSN} \]
\[ \text{return COMMIT OK for } T \Rightarrow \text{commitLSN}(T) \le \text{flushedLSN} \]
第一条防止“数据页已经落盘、对应日志却丢了”;第二条防止“客户端收到提交成功、日志却没落盘”。数据页头里的
pageLSN 是判断 redo
是否需要执行的局部证据:若页面的 pageLSN
已不小于某条日志记录的
LSN,那条记录对该页的效果已经在页上。
二、ARIES 的几张表和三阶段
Mohan、Haderle、Lindsay、Pirahesh 与 Schwarz 在 1992 年 TODS 论文中提出 ARIES(Algorithms for Recovery and Isolation Exploiting Semantics)。它的关键设计不是“有 redo 和 undo”,而是下列状态如何配合:
| 对象 | 作用 |
|---|---|
| LSN | 日志的单调位置,普通记录、提交记录、CLR 都有 LSN |
prevLSN |
同一事务内的反向链,用于从 lastLSN 往回
undo |
pageLSN |
数据页上已经包含的最新日志 LSN,用于跳过重复 redo |
| ATT | Active Transaction Table,记录事务状态与
lastLSN |
| DPT | Dirty Page Table,记录脏页和该页首次变脏的
recLSN |
| CLR | Compensation Log Record,记录一次 undo 的结果和
UndoNxtLSN |
ARIES 的 restart recovery 按三个阶段执行:

Analysis 从最近 checkpoint 的
begin_checkpoint 位置开始扫描到日志末尾,重建
ATT 和 DPT。ATT 里还没 END
的事务是恢复时的候选;DPT 中最小的 recLSN 给出
redo 的起点。
Redo 从 min(DPT.recLSN)
开始顺序扫描,重复历史(repeating
history):已提交和未提交事务的更新都先按日志重做到崩溃瞬间。每条
UPDATE/CLR 记录还要过三道过滤:页面不在 DPT、记录 LSN
小于该页 recLSN、或磁盘页
pageLSN >= record.LSN,都可以跳过。
Undo 对 loser transactions 取最大
lastLSN,沿 prevLSN
反向撤销。每撤销一条 UPDATE,就写一条 CLR;CLR 是 redo-only
的,后续 undo 看到 CLR 时不撤销它,而是跳到
UndoNxtLSN。
三、一条日志如何经受两次崩溃
下面的例子只保留 ARIES 必需字段。T1 已提交,T2
在崩溃时仍活跃;P1 先被 T1 改成 100,又被 T2
改成 201。
| LSN | 事务 | 类型 | 页 | before | after | prevLSN |
说明 |
|---|---|---|---|---|---|---|---|
| 10 | T1 | UPDATE | P1 | 0 | 100 | - | T1 修改 P1 |
| 20 | T2 | UPDATE | P2 | 0 | 200 | - | T2 修改 P2 |
| 30 | T1 | COMMIT/END | - | - | - | 10 | T1 完成 |
| 40 | T2 | UPDATE | P1 | 100 | 201 | 20 | T2 覆盖 P1 |
| 50 | - | CRASH | - | - | - | - | 第一次崩溃 |
Analysis 后,T2 留在 ATT,DPT 至少包含 P1:10
与 P2:20。Redo 会重做 LSN
10、20、40,让页面回到第一次崩溃瞬间;Undo 再从 T2 的 LSN 40
往回走。
| 新 LSN | 类型 | 撤销对象 | 页变化 | UndoNxtLSN |
|---|---|---|---|---|
| 60 | CLR | LSN 40 | P1: 201 → 100 | 20 |
| 70 | CLR | LSN 20 | P2: 200 → 0 | - |
| 80 | END | T2 | - | - |
如果写完 LSN 60 后第二次崩溃,下一次恢复会 redo LSN
10、20、40、60,然后 undo 阶段从 T2 的
lastLSN=60 开始;看到 CLR 60 后直接跳到
UndoNxtLSN=20,不会再次撤销 LSN 40。这就是 CLR
的价值:恢复过程本身也是可恢复的。
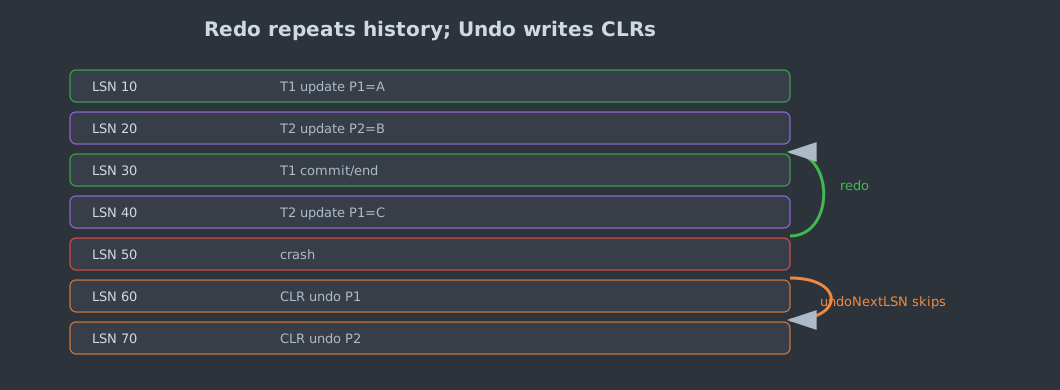
这里也能看出 ARIES 为什么要“重复历史”。如果 Redo 阶段跳过未提交事务 T2 的 LSN 40,Undo 阶段就无法用 LSN 40 的 before image 把 P1 从崩溃瞬间状态精确还原到 T1 的 100。先重复历史,再撤销 loser,是把 redo 变成顺序、幂等、局部判断的代价。
四、可复现实验:随机崩溃点与恢复中再崩溃
reproduce/aries_sim.py 是一个内存页级 ARIES
模拟器:随机生成事务
begin/update/commit/end、随机刷出部分脏页、在随机步数崩溃,并在第一次
undo 写出一条 CLR
后再次模拟崩溃。第二次恢复必须得到“只包含已提交事务更新”的页面集合,而且不能重复撤销已经有
CLR 的更新。
运行命令:
cd post/algorithms/62-wal-aries
python3 reproduce/aries_sim.py
本次记录环境:Intel Core i9-12900K,CPU 0-23;Linux 6.6.87.2-microsoft-standard-WSL2;Python 3.14.5。实际运行时绑到 CPU 17:
taskset -c 17 python3 reproduce/aries_sim.py脚本输出
reproduce/results/aries-summary.csv,并重画本文两张
SVG。核心结果如下:
| seed | crash 时日志记录数 | checkpoint LSN | Analysis 扫描 | Redo 扫描 | 第一次 Redo 应用 | loser 数 | 第二次 Undo | 第二次 CLR | 总 CLR | 最终状态正确 |
|---|---|---|---|---|---|---|---|---|---|---|
| 17 | 111 | 400 | 71 | 49 | 5 | 5 | 10 | 10 | 11 | true |
| 29 | 102 | 600 | 42 | 48 | 13 | 4 | 12 | 12 | 13 | true |
| 43 | 105 | 400 | 65 | 38 | 12 | 3 | 7 | 7 | 8 | true |
| 61 | 112 | 370 | 75 | 48 | 3 | 5 | 5 | 5 | 6 | true |
这些数字不用于比较性能,只用于验证机制:
- Analysis 扫描量随 checkpoint 之后的日志长度变化;
- Redo 扫描量大于实际应用量,因为 DPT 和
pageLSN会过滤已落盘页面; - 第一次恢复故意在 1 条 CLR 后崩溃,第二次 Undo 只处理剩余 loser 更新;
总 CLR = 第一次 CLR + 第二次 CLR,与 loser 更新总数一致,说明已撤销的更新没有被重复撤销。
五、PostgreSQL 16:WAL redo,不是完整 ARIES
PostgreSQL 16 有 WAL、checkpoint、redo 起点和 full-page image,但它不是完整 ARIES:恢复时没有 ARIES 的逻辑 undo 阶段。未提交行版本依靠 MVCC 可见性和事务状态存储处理,后续由清理过程回收;这和“undo loser transactions 直到 END”的 ARIES 模型不同。
钉住 REL_16_4 源码可以看到几处边界:
| 文件 | 亲眼核对到的行为 |
|---|---|
src/backend/access/transam/xlog.c |
fullPageWrites = true
是源码默认值;checkpoint 结构保存
checkPoint.redo 和
fullPageWrites |
src/backend/access/transam/xloginsert.c |
组装 WAL 记录时读取 RedoRecPtr 与
doPageWrites;若页面
PageGetLSN(page) <= RedoRecPtr,该页需要
full-page image |
src/backend/access/transam/xlogrecovery.c |
启动恢复从 ControlFile->checkPoint 读
checkpoint,并把
ControlFile->checkPointCopy.redo 设为
RedoStartLSN;redo loop 调用
ApplyWalRecord() |
full_page_writes
的含义也要谨慎表述。它不是“每次修改都写整页”,而是在开启时让
checkpoint 后首次需要保护的页携带 full-page
image,以便恢复时覆盖 torn page。后续对同页的 WAL
记录通常只记录增量,直到下一次 checkpoint 改变 redo
边界。
六、SQLite 3.46:WAL 文件是页帧序列
SQLite 3.46 的 src/wal.c 头注释把 WAL
模式讲得很直接:WAL 文件由 32 字节 header 和若干 frame
构成;每个 frame 是 24 字节 frame header
加一整页内容;事务在写入带 commit marker 的 frame
时提交。frame header 第二个 32-bit 字段在 commit frame
中保存提交后的数据库页数,其他 frame 为 0。
SQLite WAL 的读路径也不同于 ARIES:读事务开始时记录
mxFrame,之后只在不超过这个 frame
的范围内寻找某页的最后有效版本;wal-index
是可重建的共享内存索引,用来避免每次读页都扫描整个
WAL。checkpoint 时,源码注释写明先对 WAL 做
VFS.xSync,再把有效内容搬回数据库文件,然后对数据库做
VFS.xSync。
这不是 ARIES 的 steal/no-force + CLR 模型。SQLite WAL 更接近“追加页镜像 + commit frame + checkpoint 回填”:它用单写者约束、页帧校验、salt 和 wal-index 组织崩溃恢复,而不是在恢复阶段对 loser transaction 逐条写 CLR。
七、谱系、争论与开放问题
恢复协议的谱系可以压缩成四个节点:
| 时间 | work | 本文引用点 |
|---|---|---|
| 1983 | Härder 与 Reuter,Principles of Transaction-Oriented Database Recovery,ACM Computing Surveys | 用 steal/force、ACID 和恢复分类整理问题空间 |
| 1992 | Mohan 等,ARIES,ACM TODS | repeating history、pageLSN、CLR、fuzzy checkpoint、partial rollback |
| 1993 | Gray 与 Reuter,Transaction Processing: Concepts and Techniques | 把恢复、并发控制、事务处理工程系统化 |
| 2010-2016 | Aether、SiloR、Write-Behind Logging | 在多核和 NVM 下重新讨论集中日志、恢复并行度和写放大 |
Aether(Johnson 等,PVLDB 2010)讨论的是多核数据库里集中日志路径的伸缩性;SiloR(Zheng、Tu、Kohler、Liskov,OSDI 2014)把 logging、checkpoint 和 recovery 都并行化,服务于内存数据库;Write-Behind Logging(Arulraj、Perron、Pavlo,PVLDB 2016)则针对非易失内存(NVM)提出反转 WAL 顺序的协议:先把数据更新持久化,再用后写日志帮助恢复。
这里的争论不是“WAL 已经过时”。更准确的边界是:ARIES 假设顺序日志比随机数据页持久化便宜,并且磁盘页是恢复的基本单位;NVM 让随机持久写的相对代价下降,WBL 这类方案才有意义。但它又引入新的前提:字节可寻址持久内存、缓存行 flush/fence 语义、持久化顺序证明,以及部署硬件是否真的提供这些保证。普通 SSD、云盘或文件系统上的数据库不能直接套用 WBL 的结论。
仍然开放或至少没有统一答案的问题包括:
- 如何把恢复时间上界从“checkpoint 后日志长度”变成更可预测的 SLA,而不让前台写入承担过高代价;
- 如何在多核恢复中并行 redo/undo,同时维持页间依赖、B-tree 结构修改和事务语义;
- 在 NVM、CXL 内存和云块存储混合部署下,WAL、shadow paging、copy-on-write 与 write-behind 的边界如何重新划分。
八、工程检查清单
实现或审阅 WAL 恢复代码时,先问这些可验证问题:
| 问题 | 为什么重要 |
|---|---|
刷脏页前是否保证该页
pageLSN <= flushedLSN |
否则磁盘页可能引用一条丢失的日志 |
| 提交返回前是否保证 commit record 已持久化 | 否则客户端看到的提交可能无法恢复 |
| checkpoint 记录的是精确刷盘点还是 fuzzy 状态 | 决定 Analysis 需要扫描多远、DPT 是否只是上界 |
redo 是否用 pageLSN 判重 |
没有判重会把非幂等操作执行两次 |
undo 是否先写 CLR,再推进 UndoNxtLSN |
恢复中再次崩溃时靠它避免重复 undo |
| 生产系统是否真的有 ARIES undo | PostgreSQL 这类 MVCC 系统不能简单归类为“完整 ARIES” |
WAL 模块不适合靠“看起来像顺序追加”来判断正确性。必须把 crash point 插在写日志、刷页、checkpoint、undo 写 CLR 的边界上,像第四节那样检查重启后状态是否只包含 committed history。
九、参考资料
规范与文档
- PostgreSQL 16 Documentation, “Write-Ahead Logging (WAL)”
与
full_page_writes参数说明。 - SQLite Documentation, “Write-Ahead Logging”,以及 SQLite
3.46
src/wal.c文件头注释。
源码
- PostgreSQL
REL_16_4,src/backend/access/transam/xlog.c、xloginsert.c、xlogrecovery.c。 - SQLite
version-3.46.0,src/wal.c。
核心论文与书
- Theo Härder, Andreas Reuter. “Principles of
Transaction-Oriented Database Recovery.” ACM Computing
Surveys, 15(4):287–317, 1983. DOI:
10.1145/289.291。 - C. Mohan, Donald J. Haderle, Bruce G. Lindsay, Hamid
Pirahesh, Peter M. Schwarz. “ARIES: A Transaction Recovery
Method Supporting Fine-Granularity Locking and Partial
Rollbacks Using Write-Ahead Logging.” ACM Transactions
on Database Systems, 17(1):94–162, 1992. DOI:
10.1145/128765.128770。 - Jim Gray, Andreas Reuter. Transaction Processing:
Concepts and Techniques. Morgan Kaufmann, 1993. ISBN:
1-55860-190-2。
后续论文
- Ryan Johnson, Ippokratis Pandis, Radu Stoica, Manos Athanassoulis, Anastasia Ailamaki. “Aether: A Scalable Approach to Logging.” Proceedings of the VLDB Endowment, 3(1-2):681–692, 2010。
- Wenting Zheng, Stephen Tu, Eddie Kohler, Barbara Liskov. “Fast Databases with Fast Durability and Recovery Through Multicore Parallelism.” OSDI 2014, pp. 465–477。
- Joy Arulraj, Matthew Perron, Andrew Pavlo. “Write-Behind
Logging.” Proceedings of the VLDB Endowment,
10(4):337–348, 2016. DOI:
10.14778/3025111.3025116。
实验
reproduce/aries_sim.py:随机事务、随机刷页、随机崩溃点、恢复中再次崩溃和 SVG 重绘脚本。reproduce/results/aries-summary.csv:本文第四节表格的原始结果。
上一篇:数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
B-tree 深度解剖:从磁盘 I/O 模型到 boltdb 源码
从 Bayer-McCreight 1972 推导树高与分裂摊还代价,用计数模拟器和 bbolt v1.5.0 实测:随机插入页填充约 69%,按键序插入由分裂点决定是 50% 还是近 100%;再对照 bbolt、PostgreSQL、SQLite 源码看删除、写时复制与 B-link 并发。
Join 算法:嵌套循环、排序归并与 Hybrid Hash 的代价和实现
用页 I/O 模拟器按 Shapiro 1986 与 DeWitt 1984 的代价模型对比嵌套循环、排序归并、Grace 与 hybrid hash,再对照 PostgreSQL 17、MySQL 8.4 源码看溢出与倾斜怎么处理,并复现内存中分区与不分区之争。
查询优化器:System R 动态规划、Cascades Memo 与基数误差
从 System R 的左深动态规划与 interesting orders 出发,解释 Volcano/Cascades 如何用 memo、规则和物理性质组织搜索,再用可复现实验展示查询图形状与基数估计误差如何决定计划质量。