向量检索做到百万级时,HNSW、IVF-PQ、LSH 这些名字容易混在一起;做到十亿级时,真正卡住的是两件事:候选生成要少算距离,候选重排又不能把原始向量全部放进内存。ScaNN 和 DiskANN 分别从这两个方向给出答案。
ScaNN(Scalable Nearest Neighbors)把重点放在量化误差怎样影响内积排序:不是单纯压低 \(\lVert x-\tilde{x}\rVert_2^2\),而是让与高分查询相关的残差方向承担更高代价。DiskANN 把重点放在图索引怎样住到 SSD 上:内存里放压缩向量估算距离,SSD 上放 Vamana 图和全精度向量,查询时用 beam search 批量读取少量节点。
本文不重复 HNSW:分层小世界图的近似近邻搜索 的分层机制,也不重讲 乘积量化与 IVF-PQ:压缩域里的近似最近邻 的 PQ/ADC 基础。本文只核对三件事:ScaNN 论文里的各向异性损失到底是什么;DiskANN 论文里的 Vamana、RobustPrune、beam search 如何配合 SSD;小规模复现实验能看到哪些趋势,哪些论文级 benchmark 不能照搬。
一、共同口径:召回、候选数与存储层级
给数据库 \(X=\{x_1,\ldots,x_N\}\) 和查询 \(q\),近似最近邻(Approximate Nearest Neighbor,ANN)通常用 Recall@\(k\) 衡量返回集合 \(R_k(q)\) 与精确 top-\(k\) 集合 \(G_k(q)\) 的重合:
\[ \mathrm{Recall@}k = \frac{|R_k(q) \cap G_k(q)|}{k}。 \]
ScaNN 与 DiskANN 的差别不在于一个“更快”、一个“更省钱”这么简单,而在它们控制的误差项不同:
| 问题 | ScaNN 主要处理 | DiskANN 主要处理 |
|---|---|---|
| 候选从哪里来 | partitioning tree / asymmetric hashing 缩小候选 | Vamana 图导航,SSD 上按节点扩展 |
| 候选如何打分 | 各向异性量化后的近似内积,必要时 reorder | 内存 PQ 估算导航,SSD 读到全精度向量后重排 |
| 主要预算 | 内存中量化码、查表距离、SIMD | 随机 SSD 读取次数、round trip 数、内存 PQ |
| 主要风险 | 量化残差导致内积排序反转 | 图路径变长、SSD 尾延迟、更新与过滤破坏图质量 |
后文所有自测只报告召回率、距离计算次数、模拟磁盘读次数、出度和量化误差,不报告墙钟时间。当前机器同时有其他代理运行,时间指标不适合作为结论。
二、ScaNN:score-aware loss 不是普通加权 k-means
从重构误差到内积误差
传统向量量化常最小化重构误差:
\[ \sum_i \lVert x_i-\tilde{x}_i\rVert_2^2。 \]
对最大内积搜索(Maximum Inner Product Search,MIPS)来说,真正进入排序的是 \(\langle q,x_i\rangle\)。量化后的误差是
\[ \langle q,x_i\rangle - \langle q,\tilde{x}_i\rangle = \langle q, x_i-\tilde{x}_i\rangle。 \]
Guo 等人在 ICML 2020 的 Accelerating Large-Scale Inference with Anisotropic Vector Quantization 中把这个观察写成分数感知量化损失(score-aware quantization loss)。给定权重函数 \(w:\mathbb{R}\to\mathbb{R}_+\),定义
\[ \ell(x_i,\tilde{x}_i,w)= \mathbb{E}_{q\sim Q} \left[w(\langle q,x_i\rangle)\langle q,x_i-\tilde{x}_i\rangle^2\right]。 \]
\(w\) 不是装饰项:它表达“对 \(x_i\) 打分高的查询更重要”。论文第 3 节证明,在查询均匀分布于单位球面的假设下,这个损失可以分解成平行残差和正交残差的加权和。设
\[ r=x_i-\tilde{x}_i,\qquad r_{\parallel}=\frac{\langle r,x_i\rangle}{\lVert x_i\rVert_2^2}x_i,\qquad r_{\perp}=r-r_{\parallel}。 \]
则
\[ \ell(x_i,\tilde{x}_i,w)= h_{\parallel}(w,\lVert x_i\rVert)\lVert r_{\parallel}\rVert_2^2+ h_{\perp}(w,\lVert x_i\rVert)\lVert r_{\perp}\rVert_2^2。 \]
这和原文中常见的误写不同:AVQ 不是简单取一个固定矩阵 \(W(x)=(1-t)\hat{x}\hat{x}^\top+tI\) 后做 k-means。论文先从内积分数权重 \(w\) 出发,再在统计假设下得到“平行方向更贵”的各向异性损失。
\(T\)、\(\eta\) 与论文中的特殊情形
论文第 3.2 节重点讨论
\[ w(t)=\mathbb{I}(t\ge T), \]
也就是只关心内积超过阈值 \(T\) 的查询。此时损失可写成比例形式:
\[ \ell(x_i,\tilde{x}_i,w)\propto \eta(w,\lVert x_i\rVert)\lVert r_{\parallel}\rVert_2^2+ \lVert r_{\perp}\rVert_2^2, \]
其中 \(\eta=h_{\parallel}/h_{\perp}\)。论文 Theorem 3.4 给出高维极限:
\[ \lim_{d\to\infty}\frac{\eta(\mathbb{I}(t\ge T),\lVert x_i\rVert)}{d-1} = \frac{(T/\lVert x_i\rVert)^2}{1-(T/\lVert x_i\rVert)^2}。 \]
所以 \(T\) 越接近 \(\lVert x_i\rVert\),平行残差越贵;\(T=0\) 时平行与正交同权,退回普通重构损失。论文 Figure 3 在 GloVe-1.2M 上使用 \(T=0.2\),并写明对应 \(\eta=4.125\)。这个数依赖维度和范数假设,不能脱离上下文写成“实践中 \(t\in[0.1,0.3]\) 最好”。
开源 ScaNN 里的实际入口
以 google-research/google-research commit
d36068b845da4c2b24927fee2cea1e6ef98dadda
为边界,Python builder 暴露的名字是
anisotropic_quantization_threshold,生成的配置字段是
noise_shaping_threshold。例如
scann/scann/scann_ops/py/scann_builder.py
中:
builder.score_ah(
    dimensions_per_block,
    anisotropic_quantization_threshold=float("nan"),
)
builder.reorder(
    reordering_num_neighbors,
    quantize=ReorderType.FLOAT32,
    anisotropic_quantization_threshold=float("nan"),
)
同一版本的
scann/scann/hashes/internal/stacked_quantizers.h
中,ComputeParallelCostMultiplier(threshold, squared_l2_norm, dims)
对应上面的 \(T\to\eta\)。ComputeAnisotropicCost()
的意图是给 noise shaping
使用各向异性代价;但按该版本源码文本,平行项是
Square(DotProduct(ah_residual, original) / ||original||),返回值为
eta * parallel_component + perpendicular_component,其中
perpendicular_component 逐坐标累加
\[ \sum_j \left(r_j - \frac{x_j}{\lVert x\rVert_2}r_j\right)^2。 \]
这里 \(r\) 对应
ah_residual,\(x\) 对应
original。这个逐坐标表达式不同于论文标准投影残差
\(\lVert r-x\langle
r,x\rangle/\lVert x\rVert_2^2\rVert_2^2\)
的同形写法;本文只记录该钉住版本源码实际使用的打分式,不把它等同为论文公式。随后
NoiseShapeQuantizedVector() 最多迭代 10
轮,逐块尝试替换
code,若该代价更小就保留。也就是说,开源实现里可见的关键字不是“AVQ
k-means 函数”,而是
noise_shaping_threshold、ComputeParallelCostMultiplier、ComputeAnisotropicCost
和 NoiseShapeQuantizedVector。
ScaNN 的检索管线通常还包括 partitioning tree、asymmetric
hashing(AH)和 reorder。只把 AVQ 单独拿出来,不能复现论文或
ann-benchmarks 上的完整曲线。README 还列出 SOAR(Sun
等,NeurIPS 2023;arXiv:2404.00774),当前 builder 中对应
soar_lambda 和
TWO_CENTER_ORTHOGONALITY_AMPLIFIED,本文只把它作为后续
work 指向,不展开其两中心溢出策略。
三、DiskANN:Vamana 如何为 SSD 改造图搜索
RobustPrune 与 \(\alpha\)
DiskANN 论文(Subramanya、Devvrit、Kadekodi、Simhadri、Krishnaswamy,NeurIPS 2019)把 Vamana 建在 GreedySearch 和 RobustPrune 上。GreedySearch 从入口点 \(s\) 出发,维护距离查询最近的候选列表 \(L\),每次展开 \(L\setminus V\) 中最近的未访问点,加入其出邻居,再把候选列表截断到大小 \(L\)。
RobustPrune 的输入是点 \(p\)、候选集合 \(V\)、剪枝参数 \(\alpha\ge1\) 和出度上限 \(R\)。候选按 \(d(p,\cdot)\) 从近到远考虑;选中 \(p^*\) 后,如果另一个候选 \(p'\) 满足
\[ \alpha\cdot d(p^*,p')\le d(p,p'), \]
就认为 \(p'\) 已被 \(p^*\) 覆盖并移出候选。\(\alpha=1\) 接近相对邻域图的剪枝规则;\(\alpha>1\) 时条件更严格,剪枝更少,图通常更稠密,也更可能保留长边。论文解释说,如果把所有点都作为候选并允许无界出度,\(\alpha>1\) 可让到目标的距离按乘法因子下降;实际 Vamana 用 GreedySearch 访问过的少量点近似这个候选集。
Vamana 构建步骤是:随机 \(R\)-正则有向图初始化;取 medoid 作为入口点;按随机排列遍历所有点;对当前点 \(p\) 运行 GreedySearch,把访问过的点作为候选;对 \(p\) 执行 RobustPrune;再给新邻居加反向边,若反向边让对方超过 \(R\),对对方再剪枝。论文明确写到“两遍构建”:第一遍 \(\alpha=1\),第二遍使用用户给定的 \(\alpha\ge1\),因为第一遍直接用较大 \(\alpha\) 会让平均度更高、构建更慢。
与 HNSW 的区别只点到为止:DiskANN 论文第 2.4 节认为 HNSW
把 RobustPrune 候选限制在 GreedySearch 的最终候选集,而
Vamana 使用“访问过的全部点”;HNSW 通过层次图保留长边,Vamana
通过 \(\alpha\)
和两遍构建直接调节单层图的度数与直径。HNSW 的随机层数和
efSearch 机制见前文链接的 HNSW
篇,不在这里重复。
SSD 布局与 beam search
DiskANN 的核心系统设计是:SSD 上保存 Vamana 图和全精度向量,内存里保存所有点的 PQ 压缩向量。论文第 3.1 节给出典型例子:每个点用 32 bytes PQ code 估算距离;图构建仍使用全精度向量;查询时用压缩向量引导搜索,再用从 SSD 顺带读出的全精度向量重排。

磁盘记录是固定大小:点 \(i\) 的全精度向量后面跟不超过 \(R\) 个邻居 id,不足的邻居用 0 填充。这样点 id 到 SSD offset 的换算不需要额外 offset 表。论文第 3.5 节强调,读取 4 KiB 对齐扇区时,把全精度坐标和邻接表放在同一扇区里,展开节点的 I/O 同时也为最终重排提供了精确向量。
普通 GreedySearch 每次只展开一个点,SSD round trip 太多。DiskANN 改为 BeamSearch:每轮从 \(L\setminus V\) 中取最接近查询的 \(W\) 个点,一次发起一批随机读取,取回它们的邻接表并更新候选列表。论文给出的经验区间是 \(W=2,4,8\);\(W\) 太大时会浪费计算和 SSD 带宽。论文的目标是把随机读控制在“几十次”、把顺序 round trip 控制在 10 次以内,最好约 5 次。
论文数字与源码参数边界
DiskANN 论文摘要和 Microsoft Research 页面报告:在 SIFT1B bigann 上,16 核、64 GB RAM、SSD 的机器可以达到超过 5000 QPS、平均延迟小于 3 ms、95%+ 的 1-recall@1。这是论文实验结果,不是本文复现结果;硬件、数据集、查询并发和召回口径都不能省略。
以 microsoft/DiskANN tag
v0.59.0 为源码边界,当前 DiskANN3 的 Rust
配置名与论文符号对应如下:
| 论文符号 / 常用名 | v0.59.0 中的名字 |
含义 |
|---|---|---|
| \(R\) | pruned_degree /
max_degree |
剪枝后的目标出度与触发剪枝的最大出度 |
| \(L\) / build search list | l_build |
构建时 GreedySearch 的候选列表大小 |
| \(\alpha\) | alpha |
RobustPrune 的剪枝阈值 |
search_list |
benchmark JSON 中的
search_list,搜索代码里的
search_list_size |
查询时候选池大小 |
| beam width | beam_width |
每轮并行展开的候选数 |
同一版本 diskann/src/graph/config/mod.rs
的注释也写得很直白:alpha
更大时要求更严格,移除的候选更少,结果图通常更稠密。diskann/src/graph/internal/prune.rs
中的 robust_prune() 维护候选的
occlude_factor,并逐步从
current_alpha=1.0 增长到目标
alpha;这是工程实现上的优化,不改变“更大 \(\alpha\) 更少剪枝”的方向。
四、两个小复现实验:看趋势,不冒充论文 benchmark
复现脚本在同目录
reproduce/run_experiments.py。运行命令:
cd post/algorithms/41-scann-diskann
taskset -c 7 python3 reproduce/run_experiments.py
脚本固定随机种子 20260924,输出
reproduce/results.json,并重绘
avq-recall-error.svg 与
vamana-alpha.svg。本次运行环境:Python
3.14.5、NumPy 2.5.3、Matplotlib 3.11.2、Linux 6.6.87.2
WSL2。所有指标都与时钟无关。
各向异性量化:平行误差下降,但 Recall@10 只小幅变化
第一个实验在 3200 个 32 维合成向量上训练 96 个全向量 codeword。对照组是普通 k-means;各向异性组使用上文 \(\eta=4.125\) 的损失,并用闭式加权最小二乘更新 codeword。查询是同分布合成向量,指标是用量化向量近似内积排序得到的 Recall@10。
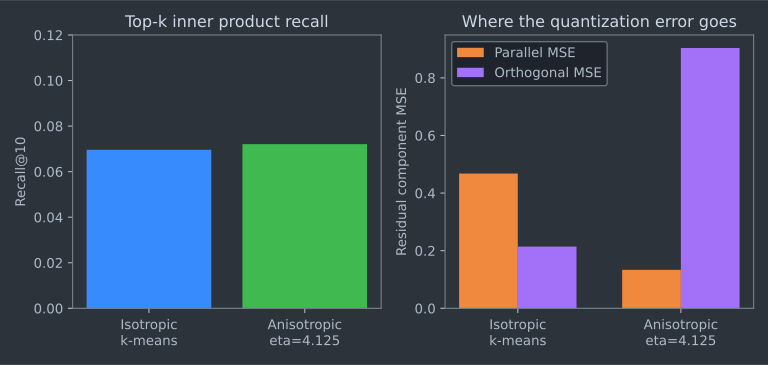
| 方法 | Recall@10 | 总 MSE | 平行残差 MSE | 正交残差 MSE | top-1 内积相对误差 |
|---|---|---|---|---|---|
| 普通 k-means | 0.0696 | 0.6819 | 0.4679 | 0.2141 | 0.4964 |
| 各向异性,\(\eta=4.125\) | 0.0721 | 1.0369 | 0.1333 | 0.9036 | 0.1026 |
这个小实验只说明机制:各向异性损失把误差从平行方向挪到正交方向,top-1 内积估计误差明显下降;但单独一个全向量 codebook 并不能复现 ScaNN 论文的召回曲线。论文级结果还依赖 partitioning、AH/PQ 结构、reorder 与参数扫描。因此,正文不写“ScaNN 比 OPQ 快几倍”之类没有本地复现或明确图表来源的数字。
Vamana:\(\alpha\) 提高出度,召回先升后平
第二个实验实现了简化 Vamana:1000 个 16 维合成点,\(R=12\)、构建列表 \(L=30\),两遍构建;查询时用 \(L=14\)、beam width \(W=4\),把“展开一个节点”记为一次模拟 SSD 读,把一批 beam 记为一次模拟 round trip。精确 top-10 用暴力扫描得到。
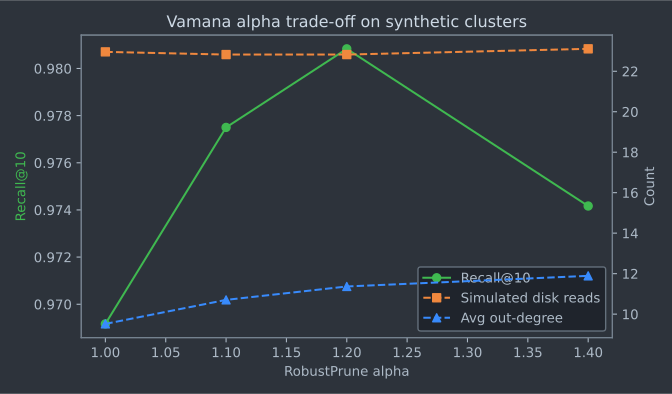
| \(\alpha\) | 平均出度 | Recall@10 | 距离计算 / query | 模拟读节点 / query | 模拟 round trip / query |
|---|---|---|---|---|---|
| 1.0 | 9.52 | 0.969 | 172.5 | 23.0 | 7.10 |
| 1.1 | 10.70 | 0.978 | 172.8 | 22.8 | 6.99 |
| 1.2 | 11.37 | 0.981 | 168.6 | 22.8 | 7.04 |
| 1.4 | 11.89 | 0.974 | 158.4 | 23.1 | 7.18 |
趋势符合论文直觉:\(\alpha\) 从 1.0 增到 1.2 时,剪枝减少、图更密,召回略升;继续增到 1.4 后,出度接近 \(R\),本实验没有继续获益。真实 DiskANN 还会缓存入口附近若干跳、使用 PQ 距离估算、并受 SSD 队列深度影响;这里的“读节点”和“round trip”只是磁盘访问次数模型,不是延迟。
五、更新、过滤与后续工作
原始 DiskANN 论文主要讨论静态索引。FreshDiskANN(Singh、Subramanya、Krishnaswamy、Simhadri,arXiv:2105.09613,2021 预印本)把问题改成流式更新:论文摘要称其支持十亿级 SSD 索引上的实时插入、删除和查询,并保持超过 95% 的 5-recall@5。常见架构是 SSD 上的长期索引(Long-Term Index)、内存中的临时索引(TempIndex)和删除列表;查询合并长期索引与临时索引结果,后台把增删合并进长期索引。由于这是预印本,正文只引用其问题设定与摘要结论,不把“每秒多少插入”“合并期间延迟增加多少”写成本地结论。
Filtered-DiskANN(Gollapudi 等,WWW 2023)处理的是带标签过滤的 ANN:查询不仅要近,还要满足谓词或标签集合。它的关键变化是构图时就把过滤标签纳入邻接选择,而不是先做向量 ANN 再过滤结果。过滤搜索是图索引在生产里最容易失效的场景之一:如果满足过滤条件的点在原图中被稀疏地切开,普通图搜索会在大量不合格节点上浪费扩展。
ScaNN 方向的后续 work 是 SOAR(Sun、Simcha、Dopson、Guo、Kumar,NeurIPS 2023;README 中列为 ScaNN 实现的参考)。它关心 partitioning 阶段的溢出分配,让一个点进入多个中心时兼顾距离与正交性,降低同一查询探测多个中心时的重复候选。本文没有复现 SOAR,只在参考资料中列出。
六、工程选型与开放问题
| 场景 | 更应该先看什么 | 说明 |
|---|---|---|
| 内存预算能放下压缩向量,查询吞吐优先 | ScaNN / IVF-PQ / Faiss 类量化方案 | 关键是量化误差、候选数与 SIMD 实现;需要真实 trace 调
num_leaves_to_search、AH block、reorder
数量 |
| 原始向量和图边放不进内存,但有 NVMe SSD | DiskANN / Vamana 类 SSD 图索引 | 关键是 SSD 随机读次数、beam width、PQ 估算质量和缓存入口附近节点 |
| 高召回且强过滤 | Filtered-DiskANN 或显式过滤感知构图 | “先 ANN 后过滤”在选择性很低时会严重掉召回或增加扩展数 |
| 高频插入删除 | FreshDiskANN / 动态图索引 / 分层冷热索引 | 删除列表、墓碑、后台合并会影响尾延迟和长期图质量 |
| 数据只有几百万且内存充足 | HNSW 或精确 Flat/GPU baseline | 不要为了十亿级论文系统过度工程 |
几个边界需要明确:
- 图 ANN 的最坏情况理论仍弱。 Indyk 与 Xu 的 NeurIPS 2023 论文 Worst-case Performance of Popular Approximate Nearest Neighbor Search Implementations 指出,DiskANN 的慢预处理版本在有界 intrinsic dimension 数据上有常数近似与 poly-log 查询时间保证;但 fast DiskANN、HNSW、NSG 都存在需要线性查询步数才能达到合理精度的构造。真实系统依然有效,但不能把经验曲线写成最坏情况保证。
- 论文延迟不能直接迁移。 DiskANN 论文的 <3 ms 平均延迟绑定了 SIFT1B、16 核、64 GB RAM、两块 Samsung 960 EVO RAID-0、特定召回口径和并发方式;ScaNN 的 ann-benchmarks 曲线也绑定数据集、距离函数和硬件 SIMD。没有同口径复现时,正文只应引用来源,不应合成“成本表”。
- 更新和过滤会改变索引不变量。 Vamana 的剪枝假设候选集合由几何近邻提供;删除、标签过滤、分片合并都会让候选集合不再等价。工程上要监控 Recall、访问节点数、SSD round trip、PQ 量化误差和删除比例,而不是只看 QPS。
七、参考资料
源码
google-research/google-researchcommitd36068b845da4c2b24927fee2cea1e6ef98dadda:scann/README.md、scann/scann/scann_ops/py/scann_builder.py、scann/scann/hashes/internal/stacked_quantizers.h。microsoft/DiskANNtagv0.59.0:README.md、diskann/src/graph/config/mod.rs、diskann/src/graph/internal/prune.rs、diskann-benchmark/example/disk-index.json。
核心论文
- Ruiqi Guo, Philip Sun, Erik Lindgren, Quan Geng, David Simcha, Felix Chern, Sanjiv Kumar, “Accelerating Large-Scale Inference with Anisotropic Vector Quantization”, ICML 2020, PMLR 119:3887–3896. PMLR
- Suhas Jayaram Subramanya, Devvrit, Rohan Kadekodi, Harsha Vardhan Simhadri, Ravishankar Krishnaswamy, “DiskANN: Fast Accurate Billion-point Nearest Neighbor Search on a Single Node”, NeurIPS 2019. Author page
- Hervé Jégou, Matthijs Douze, Cordelia Schmid, “Product Quantization for Nearest Neighbor Search”, IEEE TPAMI 2011.
- Yu. A. Malkov, D. A. Yashunin, “Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs”, IEEE TPAMI 2020.
其他论文
- Philip Sun, David Simcha, Dave Dopson, Ruiqi Guo, Sanjiv Kumar, “SOAR: Improved Indexing for Approximate Nearest Neighbor Search”, NeurIPS 2023; arXiv:2404.00774.
- Aditi Singh, Suhas Jayaram Subramanya, Ravishankar Krishnaswamy, Harsha Vardhan Simhadri, “FreshDiskANN: A Fast and Accurate Graph-Based ANN Index for Streaming Similarity Search”, arXiv:2105.09613, 2021 预印本。
- Siddharth Gollapudi, Neel Karia, Varun Sivashankar, Ravishankar Krishnaswamy, Nikit Begwani, Swapnil Raz, Yiyong Lin, Yin Zhang, Neelam Mahapatro, Premkumar Srinivasan, Amit Singh, Harsha Vardhan Simhadri, “Filtered-DiskANN: Graph Algorithms for Approximate Nearest Neighbor Search with Filters”, WWW 2023, DOI:10.1145/3543507.3583552.
- Piotr Indyk, Haike Xu, “Worst-case Performance of Popular Approximate Nearest Neighbor Search Implementations: Guarantees and Limitations”, NeurIPS 2023; arXiv:2310.19126.
实验
reproduce/run_experiments.py:生成reproduce/results.json、avq-recall-error.svg、vamana-alpha.svg;固定随机种子20260924。
系列导航: - 上一篇:乘积量化与 IVF-PQ:压缩域里的近似最近邻 - 下一篇:从零实现一个向量搜索引擎
相关阅读: - 局部敏感哈希:从概率保证到多探针近邻检索 - HNSW:分层小世界图的近似近邻搜索
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
乘积量化与 IVF-PQ:压缩域里的近似最近邻
从 Jégou 等人的 PQ/ADC 到 Faiss v1.8.0 的 IVF-PQ 源码,用可复现实验解释码长、量化误差、nprobe 与候选数如何共同决定召回。
从零实现一个向量搜索引擎
不重复 HNSW、PQ 和 DiskANN 细节,而是把向量检索放回引擎层:段式存储、墓碑删除、过滤搜索、mmap、并发快照与可复现召回评测。
HNSW:分层小世界图的近似近邻搜索
从 NSW 到 HNSW,拆解随机层数、SEARCH-LAYER、启发式邻居选择与参数边界;对照 hnswlib、Faiss、Lucene、pgvector 源码默认值,并用可复现实验比较 simple 与 heuristic 邻居选择的召回成本。
局部敏感哈希:从概率保证到多探针近邻检索
从 (c,r)-ANN 与 LSH 的 rho 参数出发,推导 AND-OR 放大、随机超平面、p-stable 与 multi-probe,复现实测 SIFT1M 上召回率和候选数,并说明为什么理论保证不等于工程排名。