给 \(10^6\) 个 128 维向量做近邻检索,暴力扫描要算 \(10^6\) 次距离;上一篇 KD-tree 的实测已经说明,维度升高后树上的剪枝会迅速失效。局部敏感哈希(Locality-Sensitive Hashing,LSH)换了一个问题:不再要求索引结构一定排除远点,而是让近点比远点更容易落入同一个桶,再只对桶里的候选做精确距离计算。
LSH 最容易被误解成“把向量哈希一下”的工程技巧。真正有用的是它背后的概率代价模型:一个哈希族给出近点碰撞概率 \(p_1\)、远点碰撞概率 \(p_2\),参数
\[ \rho = \frac{\ln(1/p_1)}{\ln(1/p_2)} \]
决定查询候选数约为 \(n^\rho\),空间约为 \(n^{1+\rho}\)。本文按“问题定义 →
\(\rho\) 推导 → 哈希族 →
放大曲线 → 多探针 → 实测 → 上下界 →
工程争论”的顺序展开。文中曲线和 SIFT1M 数字来自同目录
reproduce/ 下的程序;没有复现的旧 benchmark
和应用案例不再保留。
一、问题:从最近邻到 \((c,r)\)-ANN
设点集 \(P \subset M\),距离函数为 \(D\)。精确最近邻要求返回
\[ \arg\min_{p \in P} D(q,p), \]
这在低维几何数据上可以靠树结构剪枝;在高维向量上,距离集中和剪枝下界变弱会让许多树索引接近线性扫描。LSH 通常分析的是判定版的近似近邻:给定半径 \(r\) 和近似因子 \(c>1\),\((c,r)\)-近似近邻(approximate near neighbor,ANN)要求:
- 如果存在 \(p \in P\) 使 \(D(q,p) \le r\),算法以常数以上概率返回某个 \(p'\),满足 \(D(q,p') \le cr\);
- 如果不存在 \(r\) 内近点,算法可以报告失败或返回任意点。
最近邻查询可以用多组半径、二分半径或外层 rerank 转成这个判定问题,但理论保证钉住的是“有 \(r\) 内近点时,不要错过 \(cr\) 内的点”。工程系统最后仍会把候选集合按真实距离重排;LSH 的工作是生成一个比全量小得多、同时尽量包含真近邻的候选集。
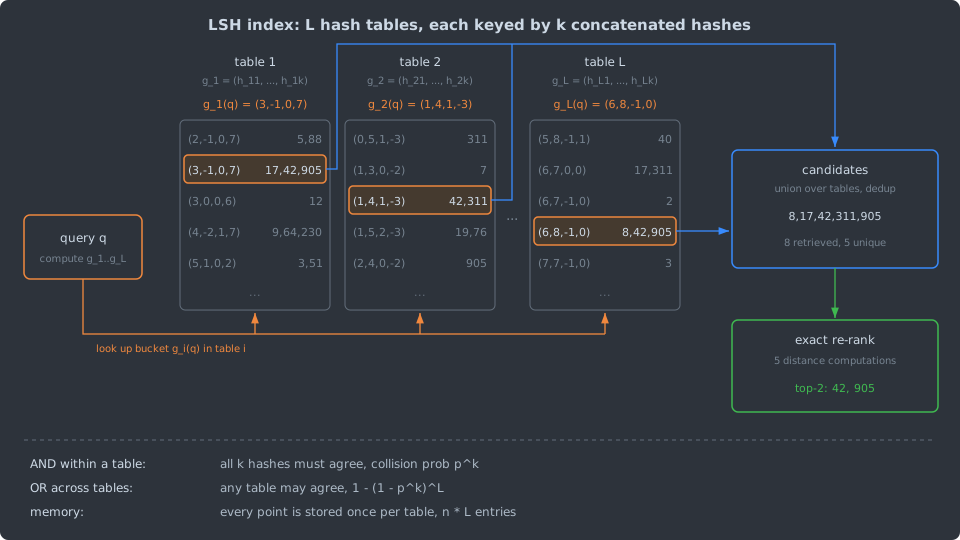
图中的每张表使用一个复合哈希 \(g\)。查询 \(q\) 只读取与 \(g(q)\) 同桶的点,把多张表的桶去重后得到候选集合。这个过程不承诺桶里全是近点,也不承诺每个近点都进桶;它只承诺概率差距可以通过放大变成有用的候选生成器。
二、LSH 定义与 \(\rho\) 的推导
一个哈希函数族 \(\mathcal{H}\) 是 \((r,cr,p_1,p_2)\)-敏感的,如果对任意 \(p,q\):
\[ D(p,q) \le r \Rightarrow \Pr_{h\sim\mathcal{H}}[h(p)=h(q)] \ge p_1, \]
\[ D(p,q) \ge cr \Rightarrow \Pr_{h\sim\mathcal{H}}[h(p)=h(q)] \le p_2, \]
其中 \(p_1>p_2\)。中间区间 \(r < D(p,q) < cr\) 不给保证,这是 ANN 问题故意留下的灰区。
AND:拼接 \(k\) 个哈希,压低远点碰撞
把 \(k\) 个独立哈希拼成
\[ g(x)=(h_1(x),\ldots,h_k(x)). \]
近点在一张表中碰撞的概率至少 \(p_1^k\),远点最多 \(p_2^k\)。若数据集中有 \(n\) 个点,取
\[ k=\log_{1/p_2} n, \]
则远点在一张表中的期望误碰数至多 \(n p_2^k = 1\)。近点单表命中概率变成
\[ p_1^k = p_1^{\log_{1/p_2} n} = n^{-\ln(1/p_1)/\ln(1/p_2)} = n^{-\rho}. \]
OR:建 \(L\) 张表,恢复近点成功率
单表近点命中只有 \(n^{-\rho}\),所以要建多张表。取 \(L=\Theta(n^\rho)\) 时,至少一张表命中的概率是
\[ 1-(1-p_1^k)^L. \]
Andoni 与 Indyk 在 CACM 2008 的综述中给出的 Strategy 1 使用常数更保守的写法:令 \(L=n^\rho/p_1\),实际建 \(3L\) 张表;查询时若候选数超过 \(3L\) 就截断。这么做的含义是:远点带来的期望候选数是 \(O(L)\),用截断控制坏事件;近点命中概率仍是常数级。常数可以换,核心数量级不变:
\[ \text{query candidates} = O(n^\rho),\qquad \text{space} = O(n^{1+\rho}). \]
\(\rho\) 不是“召回率”或“哈希位数”,而是一个指数。\(\rho=1/2\) 与 \(\rho=1/4\) 在 \(n=10^8\) 时分别对应 \(10^4\) 与 \(10^2\) 量级候选,差距非常大;这也是后续论文围绕降低 \(\rho\) 展开的原因。
三、两个基本哈希族:随机超平面与 p-stable
LSH 族必须和距离定义匹配。本篇重点放在余弦 / 角距离和欧氏距离;Jaccard 相似度的 MinHash 已在 MinHash 与 SimHash 中展开。
随机超平面:角距离
Charikar 在 STOC 2002 提出的随机超平面 LSH 对单位向量工作。随机采样 \(a\sim N(0,I_d)\),定义
\[ h_a(x)=\operatorname{sign}(a\cdot x). \]
若两个单位向量夹角为 \(\theta\),随机超平面把它们分到异侧的概率正好是 \(\theta/\pi\),所以碰撞概率为
\[ \Pr[h_a(u)=h_a(v)] = 1 - \frac{\theta}{\pi}. \]
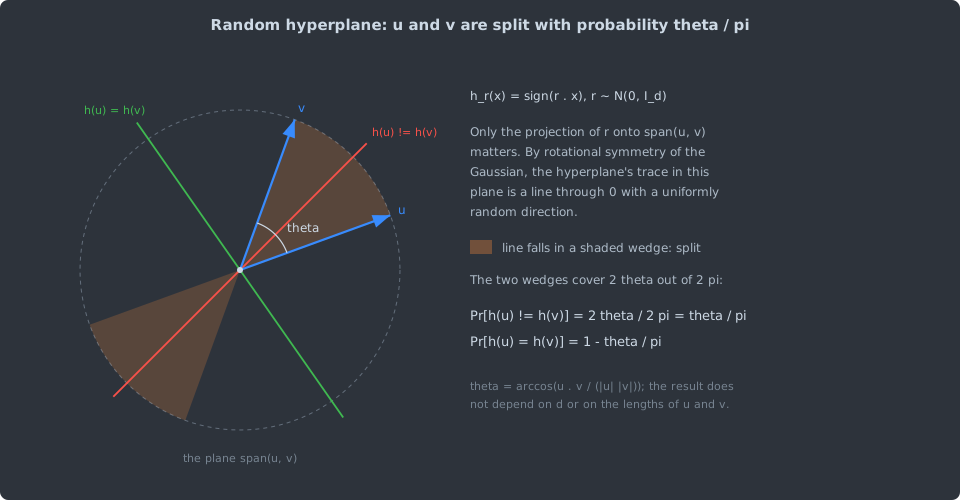
这也是 SimHash 的几何来源。注意:单个 bit 的区分能力很弱;LSH 索引依靠多 bit AND 与多表 OR 把这条线性碰撞概率放大成 S 曲线。
p-stable:\(\ell_p\) 距离,尤其是欧氏距离
Datar、Immorlica、Indyk、Mirrokni 在 SoCG 2004 给出了 \(p\)-stable LSH。对 \(\ell_2\),取高斯随机向量 \(a\),再取 \(b\sim U[0,w)\),定义
\[ h_{a,b}(x)=\left\lfloor\frac{a\cdot x+b}{w}\right\rfloor . \]
若 \(u=\|x-y\|_2\),则 \(a\cdot(x-y)\) 服从标准差为 \(u\) 的高斯分布。两点落在同一宽度为 \(w\) 的格子中的概率为
\[ p(u)=\int_0^w \frac{2}{u}\phi\!\left(\frac{t}{u}\right)\left(1-\frac{t}{w}\right)\,dt, \]
其中 \(\phi\) 是标准正态密度。\(w\) 太小会让近点也频繁跨桶,\(w\) 太大又会让远点同桶;实际使用时要调 \(w/r\)。
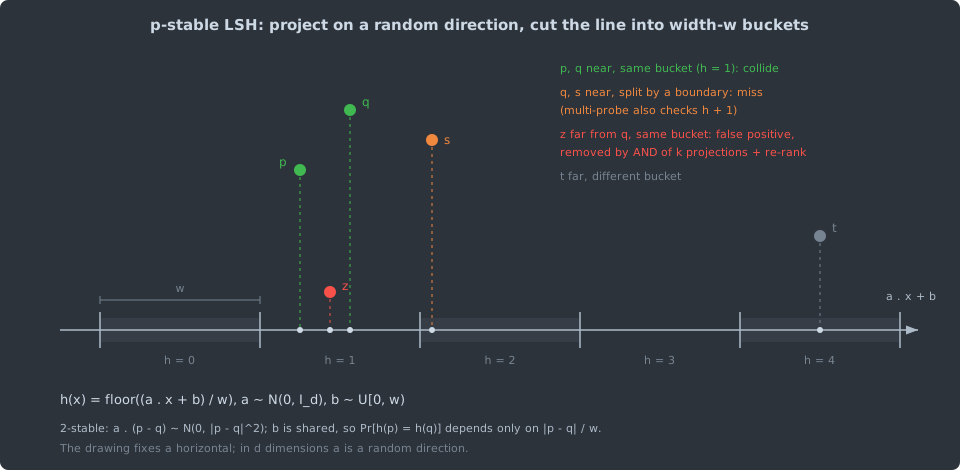
p-stable 的一个容易写错之处是:它不是“欧氏距离越小哈希值越接近”这么泛泛的说法,而是上面这个同桶概率公式。后文的曲线和 \(\rho\) 数值都按该公式计算。
四、AND-OR 放大的 S 曲线
对一个基哈希族,设单哈希碰撞概率是 \(p(d)\)。拼接 \(k\) 个哈希并建 \(L\) 张表后,至少一张表碰撞的概率是
\[ S(d)=1-(1-p(d)^k)^L. \]
\(k\) 增大时,整条曲线向下压,远点更少误碰;\(L\) 增大时,曲线向上抬,近点更少漏掉。LSH 调参的核心就是让 \(S(r)\) 高、\(S(cr)\) 低,同时把候选数压到可接受范围。
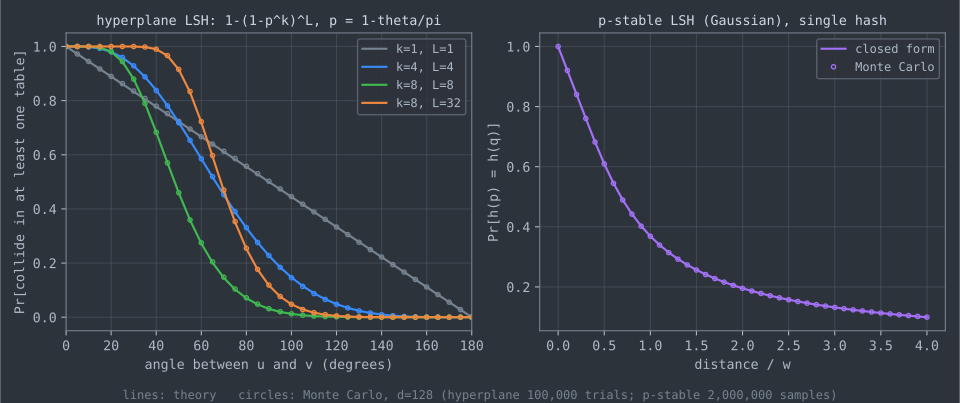
图左边是随机超平面:角度为 \(60^\circ\) 时,单 bit 碰撞概率约 \(2/3\);使用 \(k=8,L=32\) 后,至少一表碰撞概率约 \(0.72\)。角度为 \(90^\circ\) 时,单 bit 仍有 \(1/2\),但放大后只剩约 \(0.118\)。图右边是 p-stable 的单哈希概率;距离等于桶宽 \(w\) 时,同桶概率约 \(0.369\)。
这些点来自
./lsh curve 100000 1:随机超平面做 \(100000\) 组试验,每组 \(256\) 个超平面;p-stable 用
\(2000000\)
个样本。蒙特卡洛点与理论线重合,用来检查公式和绘图程序,而不是给工程性能排名。
五、多探针:用更多桶换更少表
基本 LSH 每张表只查 \(g(q)\) 一个桶。为了提高召回,最直接的办法是增大 \(L\),但空间会线性膨胀。Lv、Josephson、Wang、Charikar、Li 在 VLDB 2007 提出的 multi-probe LSH 走另一条路:每张表不只查查询点所在桶,也按概率顺序查附近桶。
对 p-stable LSH,查询点在第 \(i\) 个投影上的归一化位置为
\[ f_i=\frac{a_i\cdot q+b_i}{w},\qquad h_i(q)=\lfloor f_i\rfloor . \]
到左边界的距离记作 \(x_i(-1)=f_i-\lfloor f_i\rfloor\),到右边界的距离记作 \(x_i(+1)=1-x_i(-1)\)。若一个扰动 \(\Delta\) 把若干坐标的桶号改成 \(\pm1\),Lv 等人的 query-directed probing 用近似分数
\[ \operatorname{score}(\Delta)=\sum_{(i,\delta)\in\Delta} x_i(\delta)^2 \]
从小到大枚举扰动。直觉是:离边界越近,另一个点跨到相邻桶仍与查询相近的概率越高。
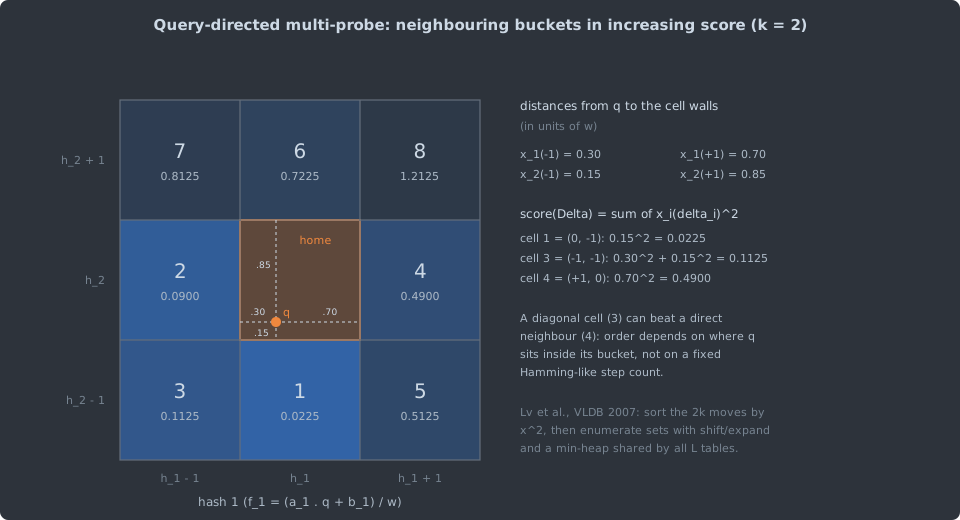
图中的例子设 \(x_1(-1)=0.3\)、\(x_2(-1)=0.15\),所以先查第二维向左,再查第一维向左;组合扰动的分数相加。reproduce/lsh.c
里的堆枚举器用 shift / expand 规则生成所有非零扰动,并用
./lsh test 对 \(k=5,L=3\) 的 \(726\)
个扰动与暴力排序对拍。
multi-probe 并不改变基哈希族的 \(\rho\),它改变的是常数和空间:用同样 \(L\) 表查更多桶,或者用更少表达到类似召回。VLDB 2007 论文摘要报告,在相同搜索质量下,multi-probe LSH 可把哈希表数量减少一个数量级;与 entropy-based LSH 相比,用时更少且表数少 5 到 8 倍。FALCONN 的 cross-polytope LSH 也必须配合 multi-probe 才能在实践中与多探针超平面 LSH 比较。
六、SIFT1M 实测:看候选数,不看受干扰的时钟
本节只测候选数与召回率,不测延迟。机器上可能同时有别的代理运行,墙钟时间不稳定;候选数、桶大小和召回率与时钟无关,更适合复现本文的结论。
实验数据为 ann-benchmarks 的
SIFT1M:sift-128-euclidean.hdf5,大小 525128288
字节,SHA-256 为
dd6f0a6ed6b7ebb8934680f861a33ed01ff33991eaee4fd60914d854a0ca5984。prep_sift.py
转出 train.f32、test.f32 与 100
近邻真值。环境如下:Intel Core i9-12900K,WSL2 Linux
6.6.87.2-microsoft-standard-WSL2,GCC
16.1.1;命令绑定 CPU 4。
cd post/algorithms/38-lsh/reproduce
DATA_DIR=/path/to/prepared/sift
sh run.sh "$DATA_DIR" 4
python plot.py results .. > results/summary.txt
run.sh 做三件事:编译 lsh.c;用
./lsh curve 重画第四节曲线;对两组 p-stable
参数各跑 3 个随机种子、1000
个查询。每次查询得到候选集合后,用 SIFT 提供的真值统计 recall@1 与 recall@10:若真
top-10 中有 \(m\)
个在候选集合里,则本次 recall@10 为 \(m/10\)。候选会再按真实距离重排,所以这里等价于最终
top-10 的召回上限。
两组参数的单表桶分布如下,表中是 3 个种子的中位数:
| 参数 | table 0 非空桶 | 平均桶大小 | size-biased 平均桶大小 | 最大桶 |
|---|---|---|---|---|
| A:\(k=12,w=800\) | 48,207 | 20.7 | 724.5 | 7,503 |
| B:\(k=16,w=1000\) | 75,514 | 13.2 | 545.9 | 8,604 |
普通平均桶大小只有十几到二十,但“查询落到的桶”的平均大小大得多,因为大桶更容易被查询命中。这就是只看平均桶大小会低估候选数的原因。
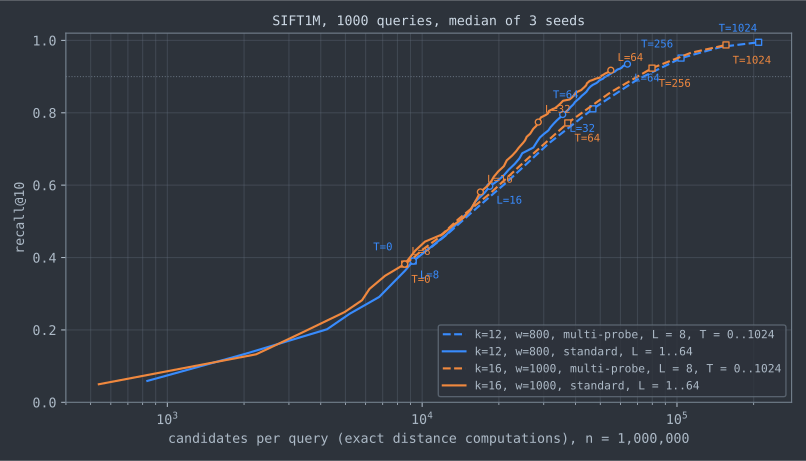
关键点不是哪条曲线“最快”,而是候选数如何换召回:
| 参数与方式 | 表数 / 额外探测 | 平均候选数 | 候选占比 | recall@1 | recall@10 |
|---|---|---|---|---|---|
| A 标准 | \(L=8\) | 9,223 | 0.92% | 0.486 | 0.391 |
| A 标准 | \(L=32\) | 35,602 | 3.56% | 0.871 | 0.795 |
| A 标准 | \(L=64\) | 63,925 | 6.39% | 0.971 | 0.934 |
| A multi-probe | \(L=8,T=128\) | 69,965 | 7.00% | 0.924 | 0.892 |
| A multi-probe | \(L=8,T=256\) | 103,728 | 10.37% | 0.967 | 0.951 |
| B 标准 | \(L=8\) | 8,538 | 0.85% | 0.479 | 0.382 |
| B 标准 | \(L=64\) | 55,005 | 5.50% | 0.955 | 0.918 |
| B multi-probe | \(L=8,T=256\) | 79,811 | 7.98% | 0.957 | 0.923 |
三点结论:
- 候选数是调参的第一成本。A 标准从 \(L=8\) 到 \(L=64\),recall@10 从 0.391 升到 0.934,但候选数从 9,223 升到 63,925。后续精确距离计算和 rerank 都要为这些候选付费。
- multi-probe 用时间换空间。B 的 \(L=8,T=256\) 与 B 标准 \(L=64\) 的 recall@10 接近(0.923 对 0.918),候选更多一些,但表数少 8 倍。若内存比 CPU 更紧,这个交换有意义。
- 高召回会迅速接近大候选集。A multi-probe 到 \(T=512\) 时 recall@10 为 0.982,但平均候选已达 149,238,占全量 14.9%。LSH 不是把任意高维数据都变成 \(O(1)\) 查询;它只是把候选数按概率模型压到可控范围。
复现程序还用 ASan/UBSan 跑了 ./lsh test
与小规模
curve,扰动枚举对拍输出为:probe-order test: 2000 random queries, k=5, L=3, 726 perturbations each: ok。
七、\(\rho\) 的谱系:从数据无关到数据相关
LSH 论文的主线可以看成不断降低 \(\rho\),同时说明哪些边界不可突破。
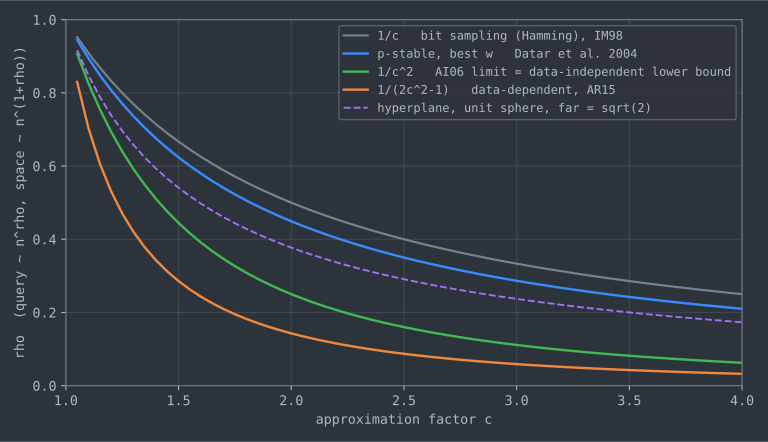
图中的曲线含义如下:
| 族或界 | 典型空间 | \(\rho\) 量级 | 说明 |
|---|---|---|---|
| bit sampling | Hamming | \(1/c\) | Indyk-Motwani 1998 框架中的基本例子 |
| p-stable | \(\ell_2\) | 有限 \(w\) 下低于 \(1/c\),渐近趋近 \(1/c\) | Datar 等 2004;本图对每个 \(c\) 网格搜索最佳 \(w/r\) |
| ball / spherical LSH | \(\ell_2\) | \(1/c^2+o(1)\) | Andoni-Indyk 2006 改进了欧氏数据无关 LSH |
| 数据无关下界 | Hamming / sphere | Hamming 约 \(1/c\),欧氏球面约 \(1/c^2\) | Motwani-Naor-Panigrahy 与 O’Donnell-Wu-Zhou 系列下界 |
| 数据相关 | Hamming / Euclidean | Hamming \(1/(2c-1)\),Euclidean \(1/(2c^2-1)\) | Andoni-Razenshteyn 2015 |
以 \(c=2\) 为例,p-stable 最佳 \(w/r\approx3.77\) 时 \(\rho\approx0.449\);\(1/c^2=0.25\);数据相关欧氏界 \(1/(2c^2-1)=1/7\approx0.143\)。这些数值来自公式,不是本文实测。
这条谱系有几个容易混淆的点:
- Indyk 与 Motwani 1998 给的是 LSH 框架和若干距离族的构造,不是“任意高维向量都 \(O(n^{1/c})\)”。
- Datar 等 2004 的 p-stable 族在欧氏距离上实用、通用,但 \(\rho\) 不等于 \(1/c^2\);\(w\) 有最优有限值。
- Andoni 与 Razenshteyn 2015 的数据相关界允许哈希依赖数据集,结论是查询 \(O(d n^{\rho+o(1)})\)、空间 \(O(n^{1+\rho+o(1)}+dn)\),实现复杂度和常数与基本 LSH 不是一个级别。
- Cross-polytope LSH 早在 Terasawa-Tanaka 2007 与 Eshghi-Rajaram 2008 中出现;Andoni、Indyk、Laarhoven、Razenshteyn、Schmidt 2015 给出了理论分析和 FALCONN 实现,证明它接近球面 LSH 的 \(\rho\),并用快速伪随机旋转和 multi-probe 降低常数。
因此,读论文里的 \(\rho\) 时要同时看三件事:数据是否归一化到球面、哈希是否数据相关、单个哈希函数的评估代价是否已经算入查询时间。
八、争论:为什么图索引常常赢,LSH 仍没有消失
LSH 的理论保证很干净:给定 \((r,cr)\) 和哈希族,能给出空间、候选数和失败概率。工程 benchmark 的结论却更复杂。
Aumüller、Bernhardsson、Faithfull 的 ann-benchmarks 论文(SISAP 2017;期刊版 Information Systems 2020)在总结中写到,图方法在多数数据集上给出最好的质量—性能折中,尤其在高召回区域,HNSW 和 KGraph 等图方法通常领先。Li 等人在 TKDE 2020 的综述实验也报告,DPG、HNSW 等图索引表现最好,而不利用数据分布的随机投影类方法很慢。
这并不意味着 LSH 已被理论或工程完全淘汰。PUFFINN(ESA 2019)给出了一种参数少、能按内存预算工作的 LSH 实现;同一论文的实验显示,在真实 GloVe / GoogleNews 数据上,IVF 与 ONNG 多数区间更快,但在合成的 planted nearest-neighbor 数据上,只有 LSH 方法能在高召回下保持高 QPS。FALCONN 论文也报告,cross-polytope LSH 在随机数据上相对超平面 LSH 的加速可达 3.5 到 10.3 倍,但在 SIFT1M 上只有约 1.2 倍。
更近的理论反例也提醒读者不要把图索引当成无条件答案。Indyk 与 Xu 2023 构造实例证明,HNSW、NSG、DiskANN-fast 在某些输入上需要线性查询时间;DiskANN 的慢预处理版本才有相应保证。这个结果不是说真实数据上 HNSW 不好,而是说图索引的经验优势和 LSH 的概率保证服务的是不同问题。
实际选型可以这样理解:
- 需要可证明的 \((c,r)\) 概率保证、数据分布未知或 adversarial 倾向强:LSH 的模型更直接。
- 追求真实向量数据上的高召回低延迟:HNSW、NSG、DiskANN、IVF-PQ 等通常是第一批候选,LSH 应作为对照或内存受限方案。
- 做理论推导或需要可合并候选生成:LSH 的哈希表结构比动态图索引更容易分析和分片。
下一篇 HNSW 会专门讨论图索引,本篇只把争论边界钉住。
九、工程映射与常见陷阱
LSH 进入工程系统时,名字常常比实现更相似。下面这些边界需要分清:
| 说法 | 实际情况 | 后果 |
|---|---|---|
| “有 LSH 就一定有哈希桶索引” | Faiss v1.12.0 的 faiss/IndexLSH.{h,cpp} 是
IndexFlatCodes:把向量变成二进制码,再对全部码做
Hamming kNN;它不是多表分桶 LSH |
不要把 Faiss IndexLSH
当作本文的桶索引复杂度来引用 |
| “Spark LSH 支持完整 AND-OR 放大” | Spark 3.5.3 文档中
BucketedRandomProjectionLSH 与
MinHashLSH 的 numHashTables 是
OR-amplification,并写明未来才实现 AND-amplification |
增大 numHashTables
只是在多表上取并集,不等价于调 \(k\) |
| “平均桶大小小,所以查询一定快” | 查询更可能落进大桶,应看 size-biased 桶大小;本文 SIFT1M 中 A 的普通平均为 20.7,size-biased 平均为 724.5 | 只看普通平均会低估候选数和长尾 |
| “multi-probe 免费提高召回” | 它减少表数,但增加每次查询探测的桶数和距离计算候选 | 内存紧时值得;CPU / rerank 成本紧时未必 |
| “\(\rho\) 越小实现一定越快” | cross-polytope、数据相关 LSH 的哈希评估和建索引常数更高 | 必须把哈希时间、内存和候选 rerank 一起算 |
| “用 SimHash bit 就是 LSH 检索” | SimHash 指纹常用于近重复检测;LSH 索引还需要 banding / 多表 / 候选重排 | 指纹相近不等于有可控 ANN 查询复杂度 |
| “LSH 不需要归一化” | 随机超平面分析的是角距离 / 单位球;内积检索和欧氏检索要做相应变换或换哈希族 | 混用距离会让 \(p_1,p_2\) 失去意义 |
FALCONN 这个名字也常被写错。其 README 展开为 “FAst Lookups of Cosine and Other Nearest Neighbors”,包含超平面与 cross-polytope LSH,二者都有 multi-probe;项目强调在 RAM 预算紧张时更有竞争力。它最后一个 release 是 v1.3.1(2017-09-14),维护状态也应纳入工程选型。
十、开放问题与本文不展开的方向
数据相关 LSH 的工程化。 理论上,数据相关哈希能把欧氏空间 \(\rho\) 降到 \(1/(2c^2-1)\);工程上,要把这些结构做成动态、可删除、可分片、可观测的服务仍不直接。FALCONN 证明 cross-polytope 的一支可以落地,但它不是当前向量数据库的主流默认方案。
动态图索引与 LSH 的可证明对比。 ann-benchmarks 显示图索引常常领先,但图方法的构造、删除、压缩、磁盘化和最坏情况保证仍在发展。Indyk-Xu 2023 的反例说明,经验 winner 与理论 winner 不是同一概念。
自适应查询与参数选择。 E2LSH 使用样本查询估计碰撞数和哈希时间来选 \(k\);PUFFINN 试图按内存预算自动给出 recall 保证。如何在真实服务中同时处理分布漂移、批量更新和多租户预算,仍是工程问题。
本文没有展开的结构。 乘积量化、IVF-PQ、ScaNN、DiskANN 和 HNSW 属于后续篇目;本篇只用它们作为争论参照,不复述算法细节。
十一、参考资料
规范与文档
- Spark 3.5.3 MLlib
文档,
BucketedRandomProjectionLSH、MinHashLSH与numHashTables的 OR-amplification 说明。 - FALCONN README,项目名、支持的 hyperplane / cross-polytope multi-probe 与内存预算说明。
源码
- Faiss
v1.12.0,
faiss/IndexLSH.h、faiss/IndexLSH.cpp:IndexLSH : IndexFlatCodes,查询对全部二进制码调用 Hamming kNN。
核心论文
- P. Indyk, R. Motwani, “Approximate Nearest Neighbors: Towards Removing the Curse of Dimensionality”, STOC 1998, pp. 604–613, DOI 10.1145/276698.276876。
- A. Gionis, P. Indyk, R. Motwani, “Similarity Search in High Dimensions via Hashing”, VLDB 1999, pp. 518–529。
- M. S. Charikar, “Similarity Estimation Techniques from Rounding Algorithms”, STOC 2002, pp. 380–388, DOI 10.1145/509907.509965。
- M. Datar, N. Immorlica, P. Indyk, V. S. Mirrokni, “Locality-Sensitive Hashing Scheme Based on p-Stable Distributions”, SoCG 2004, pp. 253–262, DOI 10.1145/997817.997857。
- A. Andoni, P. Indyk, “Near-Optimal Hashing Algorithms for Approximate Nearest Neighbor in High Dimensions”, FOCS 2006, pp. 459–468, DOI 10.1109/FOCS.2006.49。
- A. Andoni, I. Razenshteyn, “Optimal Data-Dependent Hashing for Approximate Near Neighbors”, STOC 2015, pp. 793–801, DOI 10.1145/2746539.2746553。
其他论文与综述
- M. Bawa, T. Condie, P. Ganesan, “LSH Forest: Self-Tuning Indexes for Similarity Search”, WWW 2005, pp. 651–660, DOI 10.1145/1060745.1060840。
- Q. Lv, W. Josephson, Z. Wang, M. Charikar, K. Li, “Multi-Probe LSH: Efficient Indexing for High-Dimensional Similarity Search”, VLDB 2007。
- A. Andoni, P. Indyk, “Near-Optimal Hashing Algorithms for Approximate Nearest Neighbor in High Dimensions”, CACM 51(1):117–122, 2008。
- R. O’Donnell, Y. Wu, Y. Zhou, “Optimal Lower Bounds for Locality-Sensitive Hashing (Except When q Is Tiny)”, ACM TOCT 6(1), 2014, DOI 10.1145/2578221。会议版 ICS 2011。
- A. Andoni, P. Indyk, H. L. Nguyen, I. Razenshteyn, “Beyond Locality-Sensitive Hashing”, SODA 2014;arXiv:1306.1547。
- A. Andoni, P. Indyk, T. Laarhoven, I. Razenshteyn, L. Schmidt, “Practical and Optimal LSH for Angular Distance”, NeurIPS 2015;arXiv:1509.02897。
- A. Andoni, P. Indyk, I. Razenshteyn, “Approximate Nearest Neighbor Search in High Dimensions”, ICM 2018 survey;arXiv:1806.09823。
- M. Aumüller, E. Bernhardsson, A. Faithfull, “ANN-Benchmarks: A Benchmarking Tool for Approximate Nearest Neighbor Algorithms”, Information Systems 87, 2020, DOI 10.1016/j.is.2019.02.006。会议版 SISAP 2017。
- M. Aumüller, T. Christiani, R. Pagh, M. Vesterli, “PUFFINN: Parameterless and Universally Fast Finding of Nearest Neighbors”, ESA 2019;arXiv:1906.12211。
- W. Li, Y. Zhang, Y. Sun, W. Wang, M. Li, W. Zhang, X. Lin, “Approximate Nearest Neighbor Search on High Dimensional Data — Experiments, Analyses, and Improvement”, IEEE TKDE 32(8):1475–1488, 2020, DOI 10.1109/TKDE.2019.2909204。
- P. Indyk, H. Xu, “Worst-Case Performance of Popular Approximate Nearest Neighbor Search Implementations: Guarantees and Limitations”, NeurIPS 2023;arXiv:2310.19126。
实验
reproduce/lsh.c:随机超平面与 p-stable 碰撞曲线、p-stable LSH 索引、multi-probe 扰动枚举和 SIFT1M 候选 / 召回实验。reproduce/prep_sift.py:把 ann-benchmarkssift-128-euclidean.hdf5转为原始数组。reproduce/plot.py:生成collision-s-curve.svg、rho-vs-c.svg、recall-candidates.svg。
系列导航: - 上一篇:KD-tree:切分规则、回溯剪枝与维度增长下的失效边界 - 下一篇:HNSW:分层小世界图的近似近邻搜索
相关阅读: - MinHash 与 SimHash:近重复检测的相似度草图与候选生成 - KD-tree:切分规则、回溯剪枝与维度增长下的失效边界 - HNSW:分层小世界图的近似近邻搜索
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
HNSW:分层小世界图的近似近邻搜索
从 NSW 到 HNSW,拆解随机层数、SEARCH-LAYER、启发式邻居选择与参数边界;对照 hnswlib、Faiss、Lucene、pgvector 源码默认值,并用可复现实验比较 simple 与 heuristic 邻居选择的召回成本。
一致性哈希:从 Karger 哈希环到 Jump、Maglev 与有界负载
用可复现模拟量化虚拟节点数与负载偏差(相对标准差约 1/√V),对比环、HRW、Jump、Multi-probe、Maglev 的均衡与迁移代价,并对照 Envoy、Cassandra、nginx 源码说明默认参数的真实含义。
乘积量化与 IVF-PQ:压缩域里的近似最近邻
从 Jégou 等人的 PQ/ADC 到 Faiss v1.8.0 的 IVF-PQ 源码,用可复现实验解释码长、量化误差、nprobe 与候选数如何共同决定召回。
ScaNN 与 DiskANN:量化损失、Vamana 与 SSD 图检索
从 ScaNN 的 score-aware 各向异性量化到 DiskANN 的 Vamana 图与 SSD beam search,核对论文公式、开源参数和可复现实验,说明内存量化与磁盘图检索各自解决什么问题。