给 \(10^6\) 个三维点建一棵 kd-tree,查一次最近邻平均只要算 30 次左右的距离;同样规模换成 20 维均匀数据,一次查询要算约 19 万次,接近全量的五分之一。关于 kd-tree 流传最广的两句话,一句是”最近邻查询 \(O(\log n)\)“,一句是”超过 20 维就退化成暴力搜索”,这两句都把条件省掉了。前一句来自 Friedman、Bentley、Finkel 1977 年的期望分析,它要求维度固定、\(n\) 足够大,而且对数项前面藏着一个随维度指数增长的常数;后一句里的”20”并不是固定阈值,它同时取决于 \(n\) 和数据的内在维度(intrinsic dimensionality)。本文第六节的实测里,20 维时 \(n=10^4\) 要检查 90% 的点,\(n=10^6\) 只要检查 19%。
本文先交代定义和构建(第一、二节),用一个 8
个点的例子逐步走完最近邻的下降、回溯和剪枝(第三节),推导范围查询为什么是
\(\sqrt n\)
量级(第四节),再回到 1977
年的期望分析,说明”对数时间”依赖哪些假设(第五节)。第六节的数字全部来自同目录的
reproduce/kdtree.c,每次查询都和暴力扫描对拍。第七、八节梳理从
Bentley 1975 到随机划分树的谱系,以及
SciPy、scikit-learn、nanoflann、FLANN、PCL、Lucene
在钉住版本下的实际做法;最后是争论、开放边界和选型。
高维近似检索(LSH、HNSW)、R-tree 和最近点对不在本文展开,分别见 局部敏感哈希、HNSW、R-tree 与空间索引 和 最近点对,文末相关阅读列出分工。
一、问题与定义
给定 \(\mathbb{R}^d\) 中的点集 \(P=\{p_1,\dots,p_n\}\),常见的三类查询是:
- 最近邻(nearest neighbor,NN):给查询点 \(q\),求 \(\arg\min_{p\in P}\lVert p-q\rVert_2\);推广为 k 近邻(k-NN)。
- \((1+\varepsilon)\) 近似最近邻:返回某个 \(p\),满足 \(\lVert p-q\rVert \le (1+\varepsilon)\lVert p^*-q\rVert\),\(p^*\) 是真正的最近邻(Arya 等,JACM 1998)。
- 正交范围查询(orthogonal range query):给轴对齐的盒子 \([l_1,h_1]\times\cdots\times[l_d,h_d]\),报告落在盒内的全部 \(m\) 个点。
暴力扫描每次查询 \(O(nd)\),不需要预处理,访存完全顺序。任何索引都要和它比:在同样的查询量下,建索引加查询的总代价要更低。
kd-tree(k-dimensional tree)由 Jon Bentley 在 1975 年的 CACM 论文里提出,原名”多维二叉搜索树”(multidimensional binary search tree)。它是一棵二叉树,每个内部节点记一个判别维(discriminator)\(j\) 和一个切分值 \(c\),把点集按第 \(j\) 个坐标分成两半。Bentley 的原始定义里每个节点存一个点,判别维按层循环:根用第 0 维,下一层用第 1 维,第 \(k\) 层回到第 0 维,即 \(\mathrm{NEXTDISC}(i)=(i+1)\bmod k\)。
Friedman、Bentley、Finkel 1977 年的论文(下文简称 FBF)改了两处:内部节点只存切分,点全部放在叶子上的桶(bucket)里,每个桶最多 \(b\) 个点;判别维不再按层循环,而是选当前子集上散布(spread)最大的维。今天的生产实现基本都是 FBF 这种”桶式”结构。本文代码也用它:叶子最多放 \(b\) 个点,内部节点满足
\[ \text{左子树的点} \le c \le \text{右子树的点}\quad(\text{在判别维上}). \]
每个节点对应空间中的一个轴对齐单元(cell),它是从根到该节点路径上所有切分半空间的交。后面讲剪枝时要用到这个几何对象。
二、构建:切分维与切分值
按中位数切分
下面的 8 个点是全文的例子。按循环维、中位数切分,每个节点取当前子集在判别维上第 \(\lfloor n/2\rfloor\) 小的坐标作为 \(c\),左边 \(\lfloor n/2\rfloor\) 个点,右边其余的点,叶子只放 1 个点:
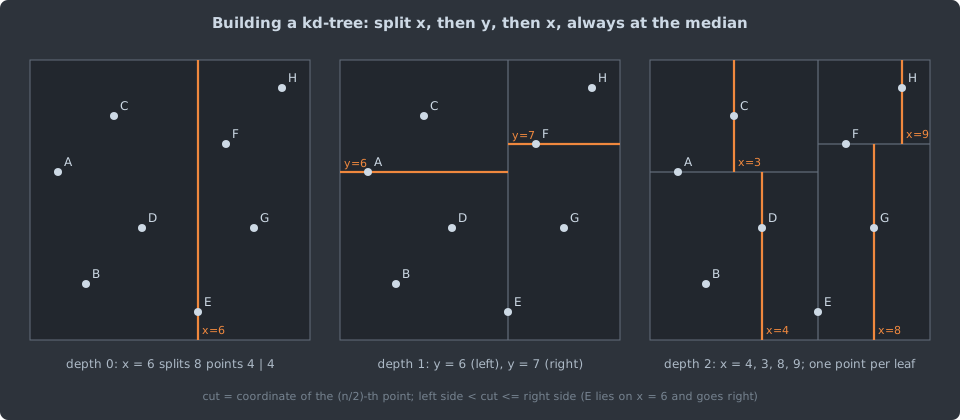
- 第 0 层:8 个点按 \(x\) 排序后,第 4 小的是 E(6,1),于是 \(c=6\)。A、B、C、D 去左边,E、F、G、H 去右边。E 落在切分线上,属于右子树。
- 第 1 层:左半按 \(y\) 切,中位数是 A 的 \(y=6\);右半按 \(y\) 切,中位数是 F 的 \(y=7\)。
- 第 2 层:四个两点子集再按 \(x\) 各切一刀,得到 8 个叶子。
同一棵树画成树形:
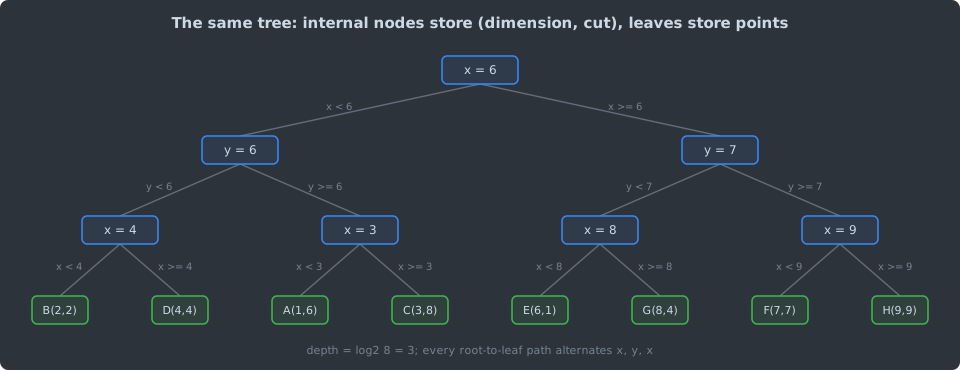
中位数切分保证每层点数减半,树高是 \(\lceil\log_2(n/b)\rceil\)。reproduce/kdtree.c
的构建函数核心如下(摘自 build(),删去了
sliding midpoint 分支和节点数组扩容):
if (t->rule == RULE_CYCLIC) {
    dim = depth % d;
} else if (t->rule == RULE_SPREAD) {
    double best = -1.0;
    for (int j = 0; j < d; j++) {
        double s = spread(t, begin, end, j);   /* max - min along dimension j */
        if (s > best) { best = s; dim = j; }
    }
}
mid = begin + n / 2;
select_kth(t, begin, end, mid, dim);           /* quickselect, three-way partition */
cut = coord(t, mid, dim);
int l = build(t, begin, mid, depth + 1, lo, hi);
int r = build(t, mid, end, depth + 1, lo, hi);构建代价。select_kth()
是随机枢轴的快速选择,配合三路划分处理重复值,期望线性时间;换成
Blum 等人 1973
年的中位数的中位数算法可以做到最坏线性。同一层所有节点的选择工作合计
\(O(n)\),按散布选维还要每层多付
\(O(nd)\),树高 \(O(\log n)\),所以总代价是期望
\(O(dn\log n)\),与 FBF
给出的”正比于 \(kN\log
N\)“一致。另一种做法是预先把点按每一维各排一次序,在递归中维护这
\(d\)
个有序表,避免反复选择,代价是 \(O(dn)\) 的额外空间。
三种切分规则
切分维和切分值怎么选,是各实现之间最大的差别。Mount 的 ANN 库手册(v1.1,第 2.3.3 节)把几种规则的性质写得最清楚:
| 规则 | 切分维 | 切分值 | 性质 | 使用者 |
|---|---|---|---|---|
| 循环中位数 | 深度 \(\bmod d\) | 中位数 | 树高 \(\lceil\log_2 n\rceil\);不看数据形状 | Bentley 1975 |
| 散布中位数(ANN 称 standard) | 点散布最大的维 | 中位数 | 树高 \(\lceil\log_2 n\rceil\);单元的长宽比可以无界 | FBF 1977;scikit-learn;SciPy 默认 |
| 中点(midpoint) | 单元最长边 | 单元中点 | 长宽比有界;可能切出空的一侧,深度可以超过 \(n\) | ANN ANN_KD_MIDPT |
| 滑动中点(sliding midpoint) | 单元最长边 | 单元中点;若一侧为空,滑到最近的点 | 不会空切,深度不超过 \(n\);瘦长单元的兄弟单元在同一维上是”胖”的 | Maneewongvatana 与 Mount 1999;ANN 默认;SciPy
balanced_tree=False |
滑动中点来自 Maneewongvatana 与 Mount 的”It’s okay to be skinny, if your friends are fat”(CGC 计算几何研讨会,1999)。题目就是结论:中点规则遇到聚集的数据会切出大量空单元;滑动中点在切平面一侧没有点时,把切平面移到离它最近的那个点上,只切下这一个点。这样得到的瘦长单元总是紧挨着一个在同一维上很宽的兄弟单元,ANN 手册的说法是这种高长宽比单元对最近邻搜索没有害处。代价是树不再平衡。
循环规则有一个容易忽略的失效方式:某一维在子集上是常数时,它仍然会在这一维上切。所有点和查询点在这一维上坐标相同,切平面穿过查询点,剪枝下界为 0,两个子树都要进。第六节的实验里,2 维数据嵌在 16 维空间的前两个坐标上(其余坐标为 0),循环规则每次查询要检查 25% 的点,按散布选维只检查约 12 个点。
三、最近邻搜索:下降、回溯与两种下界
算法
最近邻搜索是一次带剪枝的深度优先遍历:
- 从根往下走,每一步进入查询点 \(q\) 所在的那一侧(近侧),直到叶子,用叶子里的点更新当前最优距离 \(r^*\);
- 回溯到每个内部节点时,估计 \(q\) 到远侧单元的距离的下界;下界不小于 \(r^*\) 就剪掉远侧,否则进入远侧继续搜索。
正确性只依赖一件事:下界确实不超过远侧单元里任何点到 \(q\) 的距离。满足这一点,被剪掉的子树里不可能有比 \(r^*\) 更近的点。常用的下界有两种:
- 平面下界:\(q\) 到切平面的距离 \(|q_j-c|\)。远侧单元整个位于切平面另一侧,所以它是下界。这是大多数教科书的写法。
- 单元下界:\(q\) 到远侧单元(一个轴对齐盒子)的真实距离。它不小于平面下界,剪得更多。FBF 的”bounds-overlap-ball”测试就是这种。
单元下界不必每次从头算。设 \(o_i\) 是 \(q\) 到当前单元在第 \(i\) 维上的偏移(\(q\) 在该维落在单元范围内时为 0),当前单元的平方距离是 \(\rho=\sum_i o_i^2\)。进入第 \(j\) 维切分的远侧时,远侧单元只在第 \(j\) 维上变了边界,新的偏移就是 \(q_j-c\),于是
\[ \rho_{\text{far}} = \rho - o_j^2 + (q_j-c)^2 . \]
每次回溯只需 \(O(1)\)
次运算。这个增量公式来自 Arya 与 Mount 1993
年的工作,nanoflann 和 SciPy
都用它(第八节)。reproduce/kdtree.c
的搜索函数同时实现了两种下界(摘自
search()):
double diff = s->q[nd->dim] - nd->cut;
int near = diff < 0 ? nd->left : nd->right;
int far = diff < 0 ? nd->right : nd->left;
search(s, near, rd);
if (s->prune == PRUNE_PLANE) {
    if (diff * diff * s->epsf < heap_bound(s->h)) search(s, far, 0.0);
} else {
    double old = s->off[nd->dim];
    double rd_far = rd - old * old + diff * diff;
    if (rd_far * s->epsf < heap_bound(s->h)) {
        s->off[nd->dim] = diff;
        search(s, far, rd_far);
        s->off[nd->dim] = old;
    }
}全程比较平方距离,不开方。heap_bound()
返回当前第 \(k\)
近的平方距离(未满 \(k\)
个时为 \(+\infty\));epsf
是 \((1+\varepsilon)^2\),精确搜索时为
1。
例子:查询点 \(q=(5,5.4)\)
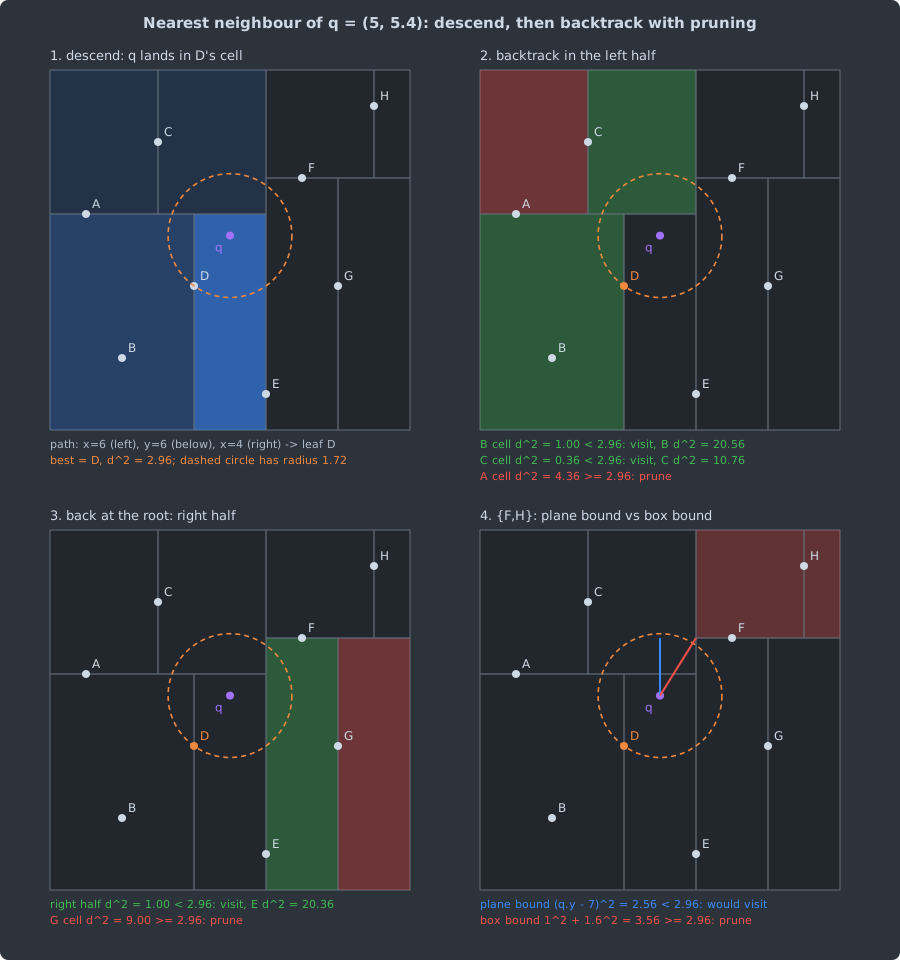
图中虚线圆以 \(q\)
为圆心、以当前最优距离为半径;远侧单元与圆相交就必须访问。完整轨迹如下,数字由
reproduce/draw_figures.py 计算并断言:
| 步 | 位置 | 远侧 | 平面下界 | 单元下界 | 当前 \(r^{*2}\) | 结果 |
|---|---|---|---|---|---|---|
| 1 | 叶子 D | 2.96 | D 成为当前最优 | |||
| 2 | \(x=4\) | {B} | 1.00 | 1.00 | 2.96 | 访问;B 的平方距离 20.56,不更新 |
| 3 | \(y=6\) | {A, C} | 0.36 | 0.36 | 2.96 | 访问;先进近侧叶子 C,10.76,不更新 |
| 4 | \(x=3\) | {A} | 4.00 | 4.36 | 2.96 | 剪掉 |
| 5 | \(x=6\)(根) | {E, F, G, H} | 1.00 | 1.00 | 2.96 | 访问;沿 \(y=7\)、\(x=8\) 的近侧到叶子 E,20.36 |
| 6 | \(x=8\) | {G} | 9.00 | 9.00 | 2.96 | 剪掉 |
| 7 | \(y=7\) | {F, H} | 2.56 | 3.56 | 2.96 | 平面下界会访问;单元下界剪掉 |
8 个点里计算了 4 次距离。第 2、3 步访问的 B、C 都没有改进结果:下界只能保证”可能有更近的点”,不能保证真的有。第 7 步是两种下界分道的地方:到切平面 \(y=7\) 的距离是 1.6,但远侧单元还受根节点 \(x\ge 6\) 的约束,\(q\) 离它的角点 \((6,7)\) 有 \(\sqrt{1^2+1.6^2}\approx 1.89\),比当前最优的 1.72 远。第六节的实测表明,这个差别在 8 到 16 维会把检查点数拉开一个数量级。
k 近邻、近似搜索与优先搜索
k 近邻只需把”当前最优距离”换成一个容量为 \(k\) 的最大堆,剪枝阈值取堆顶,即当前第 \(k\) 近的距离。堆没满时阈值是 \(+\infty\),什么都不剪。\(k\) 越大,阈值越松,回溯越多。
\((1+\varepsilon)\) 近似把剪枝条件放宽成 \((1+\varepsilon)\cdot\text{下界} \ge r^*\)。被剪掉的单元里任何点到 \(q\) 的距离都不小于 \(r^*/(1+\varepsilon)\),所以最终结果不会比真正的最近邻远出 \(1+\varepsilon\) 倍。这个保证是最坏情况的;实际返回的往往就是精确最近邻,第六节的 16 维实验里 \(\varepsilon=0.5\) 的 500 次查询全部精确,检查点数少到约六分之一。
\(\varepsilon\)
作用在距离上还是平方距离上,各库不一样。SciPy 的
query(eps=...) 用
epsfac = 1/(1+eps)**p 去乘 \(L_p\) 距离的 \(p\)
次方,等价于作用在距离上;nanoflann 的
SearchParameters::eps
直接乘平方距离(epsError = 1 + eps),它的
eps=1 只相当于距离上的 \(\sqrt2-1\approx0.414\)。
优先搜索(priority
search)不按深度优先的固定顺序回溯,而是把所有待访问的远侧单元按下界放进最小堆,每次取下界最小的那个。Arya
等人的近似最近邻工作和 ANN 手册都描述了这种做法;Beis 与
Lowe(CVPR
1997)用同样的顺序,但限制最多检查的叶子数,叫最佳箱优先(best-bin-first,BBF),把它变成一个可调精度的近似算法,用于高维形状索引。SciPy
的 cKDTree.query
即使做精确搜索也用这种最小堆顺序;FLANN 的随机 kd
森林则在多棵树之间共享同一个堆,用 checks
参数限制检查的叶子数(第八节)。
四、范围查询:\(\sqrt n\) 从哪里来
递推
范围查询从根往下走,节点的单元和查询盒不相交就剪掉,单元完全落在盒内就整棵子树报告,只有与盒子边界相交的单元才需要继续往下。代价因此分成两部分:与边界相交的节点数,加上输出规模 \(m\)。
先看最简单的情形:二维、循环中位数、每个叶子 1 个点,查询是一条竖线 \(x=c\)。设 \(Q(n)\) 是竖线在一棵根按 \(x\) 切的 \(n\) 点子树里访问的节点数。根节点按 \(x\) 切,竖线只进入一侧;那一侧的节点按 \(y\) 切,竖线同时穿过两个孩子,它们又按 \(x\) 切,各有 \(n/4\) 个点。于是
\[ Q(n) = 2 + 2\,Q(n/4),\qquad Q(1)=1 , \]
解得 \(Q(n)=3\sqrt n-2\)(代入可验证:\(3\sqrt n-2 = 2+2(3\sqrt{n/4}-2)\))。
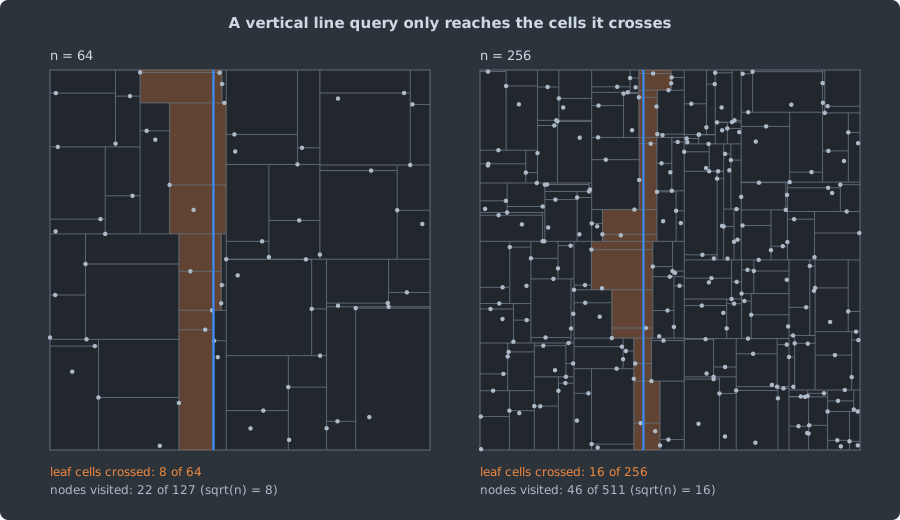
图中 \(n=64\) 时访问 22
个节点,\(n=256\) 时 46
个,正好是 \(3\cdot8-2\) 和
\(3\cdot16-2\)。reproduce/
的 range 模式在 \(n=2^{10}\) 到 \(2^{20}\) 的均匀数据上跑了 200
条随机竖线,循环中位数的平均访问节点数每一档都等于 \(3\sqrt n-2\)(\(n=2^{20}\) 时是
3070)。按散布选维时,均匀数据上切分维不再严格交替,节点数约为
\(3.5\sqrt
n\);滑动中点的树不平衡,在 \(2.7\sqrt n\) 到 \(3.9\sqrt n\) 之间波动。
一个轴对齐矩形的边界是 4 条线段,每条线段穿过的节点数不超过整条直线,所以二维矩形查询的代价是 \(O(\sqrt n + m)\)。同一实验用 \(0.1\times0.1\) 的正方形查询时,访问节点数减去 \(2m\)(完全落在盒内的子树按 \(2m-1\) 个节点计)再除以 \(\sqrt n\),三种规则都从 \(n=2^{10}\) 的 0.9 左右降到 \(2^{20}\) 的 0.7 左右,和 \(O(\sqrt n)\) 的边界项一致。
推广到 \(d\) 维
\(d\) 维时,一个与第 \(j\) 维垂直的超平面每经过 \(d\) 层循环,只在其中 1 层被分到一侧,其余 \(d-1\) 层两侧都要进:
\[ Q(n) = 2^{d-1}\,Q(n/2^d) + O(2^{d}), \]
解为 \(Q(n)=O(n^{(d-1)/d})=O(n^{1-1/d})\)。Lee 与 Wong(Acta Informatica,1977)证明了 kd-tree 正交范围查询的最坏代价是 \(O(n^{1-1/d}+m)\)。Bentley 1975 年的原论文已经分析了它的特例部分匹配查询(partial match query):\(d\) 个坐标中只指定 \(t\) 个,代价 \(O(n^{(d-t)/d})\)。竖线就是 \(d=2\)、\(t=1\) 的部分匹配,给出 \(n^{1/2}\)。
这不是下界
有一种常见说法是”任何线性空间结构做二维范围查询都至少要 \(\sqrt n\)“。这不对。Bentley 1980 年的范围树(range tree)用 \(O(n\log^{d-1}n)\) 空间把查询降到 \(O(\log^d n + m)\);Chazelle(JACM 1990)在指针机模型下证明,要做到 \(O(\mathrm{polylog}\,n + m)\) 的查询,空间必须是 \(\Omega\big(n(\log n/\log\log n)^{d-1}\big)\),并且这个界可以达到。所以真实的情形是空间与时间的折中:kd-tree 站在线性空间一端,付出 \(n^{1-1/d}\) 的查询代价;范围树多付对数因子的空间,换来多对数的查询。
五、最近邻的期望分析与最坏情况
FBF 1977 年的结果经常被缩写成”kd-tree 最近邻平均 \(O(\log n)\)“,但原文的模型更具体。它讨论桶式 kd-tree:每个叶桶最多 \(b\) 条记录,判别维选最大散布,切分值取中位数。建树成本正比于 \(kN\log N\);查询时,从根到候选叶子的下降是 \(O(\log N)\),随后检查所有边界与查询球相交的叶桶。论文在”大文件”假设下给出期望检查记录数的上界:
\[ b\left(\left[(m/b)G(k)\right]^{1/k}+1\right)^k , \]
其中 \(m\) 是近邻个数,\(G(k)\) 来自度量球体积。这个式子不含 \(N\),所以固定维度、样本足够密时,回溯部分可视为常数;但它随 \(k\) 指数增长。若用 \(L_\infty\) 距离、\(m=1\)、\(b=1\),上界就是 \(2^k\)。因此”对数时间”不是无条件复杂度,而是”深度对数 + 一个维度相关常数”。
FBF 还强调了另一个边界:渐近结论要到足够大的 \(N\) 才显现。论文的模拟里,2 维时 128 条记录已接近渐近值,4 维要超过 2000 条,8 维即使 16000 条仍未完全到达。第六节的实测复现了这个趋势:20 维均匀数据在 \(n=10^4\) 时几乎退化成全扫,在 \(n=10^6\) 时仍要检查 18.9% 的点。
精确最近邻也有线性最坏情况。把点均匀放在单位圆上,查询圆心;所有点到查询点的距离几乎相等,候选半径不会迅速缩小,许多单元都与球相交。reproduce/kdtree.c
的 worst 模式得到:
| \(n\) | 规则 | 查询圆心时检查点数 | 占比 | 查询 \((1.2,0.3)\) 时检查点数 |
|---|---|---|---|---|
| 100000 | 循环中位数 | 91381 | 91.4% | 629 |
| 100000 | 散布中位数 | 99998 | 100.0% | 7975 |
| 100000 | 滑动中点 | 100000 | 100.0% | 233 |
同一批点,查询点移到圆外后又能剪掉大部分节点。这说明最坏情况不是”树坏了”,而是精确最近邻的球形判定与数据几何位置不配合。
六、维度增长、内在维度与近似搜索
外在维度增长
下面这张图固定使用散布中位数、叶子大小 8、精确 1-NN,每个点来自 \([0,1]^d\) 的均匀分布,每档 500 次查询。纵轴是每次查询实际计算距离的点数占 \(n\) 的比例,所有结果都和暴力扫描对拍。
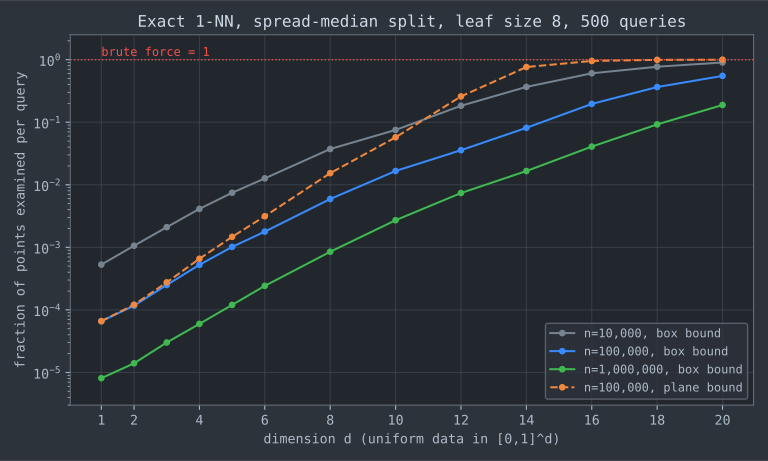
几个数字比”20 维退化”更有信息量:
| 数据量 | \(d=8\) | \(d=12\) | \(d=16\) | \(d=20\) |
|---|---|---|---|---|
| \(10^4\) | 3.73% | 18.31% | 60.52% | 90.12% |
| \(10^5\) | 0.59% | 3.57% | 19.60% | 55.02% |
| \(10^6\) | 0.09% | 0.74% | 4.08% | 18.86% |
维度越高,查询球要覆盖到最近点所需的半径越大,球与更多单元相交;样本量越大,最近点半径变小,同一维度下反而能多剪一些。平面下界和单元下界的差别也在这里放大:\(n=10^5,d=16\) 时,单元下界检查 19.6% 的点,平面下界检查 95.3%;\(d=20\) 时平面下界已达 99.8%,基本就是暴力扫描。
时钟结果只看相对趋势。实验机器是 i9-12900K、WSL2 Linux
6.6.87.2、GCC 16.1.1,-O2 编译并用
taskset -c 3 绑定一个核,三次取中位数:
| \(d\) | 建树 ms | kd-tree μs/query | 暴力 μs/query | 暴力 / kd-tree |
|---|---|---|---|---|
| 2 | 334 | 1.1 | 1091 | 996 |
| 8 | 740 | 21.0 | 4013 | 189 |
| 16 | 1645 | 989.1 | 8230 | 8.3 |
| 20 | 1809 | 4330.8 | 10525 | 2.4 |
内在维度不是自动生效
高维数据常常有低内在维度:例如特征虽然是 64
维,但样本集中在某个 2 维或 4 维子空间附近。kd-tree
能否利用这一点,取决于低维结构是否容易被轴对齐切分发现。下面的实验把
\(m=2\) 或 \(m=4\) 的均匀数据嵌入 \(D\)
维空间:aligned 是只使用前 \(m\) 个坐标,其余为
0;rotated 是乘以固定随机正交矩阵后再查询。
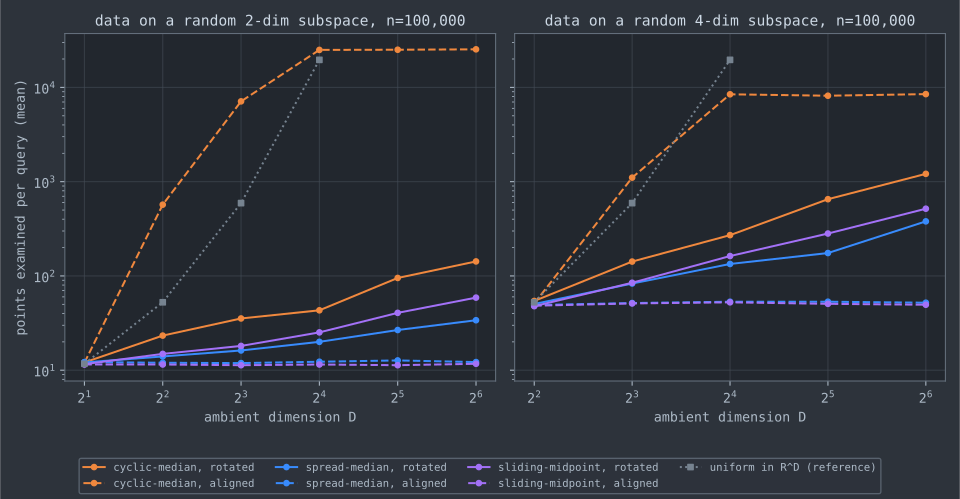
轴对齐的 \(m=2,D=16\) 数据上,循环中位数平均检查 25000 个点,正好是 \(n/4\):它把层数浪费在全为 0 的维度上,切平面穿过查询点,回溯无法剪掉另一侧。散布中位数与滑动中点只检查约 12 个点,因为它们会继续在前两个有散布的坐标上切。
随机旋转后,低维结构仍在,但不再与坐标轴对齐。\(m=2,D=64\) 时,循环中位数检查 142.6 个点,散布中位数 33.9 个,滑动中点 58.9 个;\(m=4,D=64\) 时,三者分别是 1211.0、379.4、516.7 个。结论不是”只看内在维度”,而是:kd-tree 依赖轴对齐切分,数据的低维方向、旋转和切分规则都会改变效果。
近似搜索的收益
第三节说过,\((1+\varepsilon)\)
近似只是在剪枝时把阈值放宽。eps 实验固定 \(n=100000\)、散布中位数、单元下界,比较不同
\(\varepsilon\)
下的检查点数和返回质量:
| \(d\) | \(\varepsilon\) | 平均检查点数 | 精确返回比例 | 最大距离比 |
|---|---|---|---|---|
| 8 | 0 | 589.6 | 100.0% | 1.0000 |
| 8 | 0.5 | 195.9 | 97.2% | 1.1284 |
| 8 | 1.0 | 104.1 | 90.6% | 1.4284 |
| 16 | 0 | 18906.8 | 100.0% | 1.0000 |
| 16 | 0.5 | 2941.2 | 100.0% | 1.0000 |
| 16 | 1.0 | 948.3 | 94.4% | 1.1028 |
这些结果不能外推成通用精度保证;真正的保证只是距离不超过 \((1+\varepsilon)\) 倍。工程上它的意义很直接:当精确搜索已经需要访问大量叶子时,小的 \(\varepsilon\) 往往能把检查点数降一个数量级,而且仍可能返回精确答案。
七、工程实现怎样落地
同样叫 kd-tree,生产库里的切分规则、默认叶子大小、近似参数和回溯顺序并不相同。下面只列钉住版本源码或官方文档能核实到的行为。
| 项目与版本 | 构建规则 | 查询与默认值 | 需要注意的边界 |
|---|---|---|---|
SciPy 1.14.1 cKDTree |
leafsize=16;compact_nodes=True
时按紧包围盒找最大散布维;balanced_tree=True
默认取中位数,False 时用中点并在空侧滑动 |
query
用最小堆做最佳优先搜索;eps 按 \(L_p\) 距离的 \(p\) 次方折算;支持
distance_upper_bound |
文档 Notes 提到 sliding midpoint,但默认
balanced_tree=True 实际是中位数;文档还提醒 20
维已算大,不要指望明显快过暴力 |
| scikit-learn 1.5.2 | KDTree 类默认
leaf_size=40;邻居估计器默认
leaf_size=30;切分维为最大散布,中位数划分 |
algorithm="auto"
会在合法度量、维度不太高、\(k\) 不太大时选 kd-tree |
_fit 中若
metric="precomputed"、n_features>15
或
n_neighbors >= n_samples//2,auto
会改用 brute;所以 KNeighborsClassifier
默认不等于总用 kd-tree |
| nanoflann 1.6.1 | KDTreeSingleIndexAdaptorParams 默认
leaf_max_size=10;middleSplit_
先看包围盒长边,再按数据散布与中点调整 |
递归搜索用增量单元距离;eps
乘在平方距离剪枝上 |
README 说不支持近似 NN,但源码里有
SearchParameters::eps;它不是 FLANN
式随机森林,只是单树可放宽剪枝 |
| FLANN 1.9.2 | KDTreeSingleIndexParams(leaf_max_size=10)
是单树;KDTreeIndexParams(trees=4) 是多棵随机
kd-tree |
随机 kd-tree 在方差最大的前 5
个维度中随机选切分维,多棵树共享优先队列;checks
限制最多检查叶子 |
自动调参来自 Muja 与 Lowe 的工作,不能把单树默认值和随机森林默认值混在一起 |
PCL 1.14.1 KdTreeFLANN |
包装 FLANN 的 Index<Dist>,构建时用
KDTreeSingleIndexParams(15) |
SearchParams(-1, epsilon_),epsilon_
默认 0,-1 表示不限制 checks |
它不是让 FLANN 自动选索引;默认是单棵 kd-tree、叶子最多 15 个点、精确搜索 |
| Lucene 9.12.0 BKD | BKDWriter 的默认叶子上限为 512
点,索引维数上限
8;切分维会避免某一维切分次数远少于其他维,否则选跨度最大维 |
用于点字段的块 kd-tree(BKD)索引、范围过滤与排序,不是通用内存最近邻结构 | 段合并、磁盘布局和 docID 输出是核心工程问题,不能直接套本文的内存 kd-tree 成本模型 |
| PostgreSQL 17 SP-GiST | 官方文档列出内置
kd_point_ops;point 类型默认
opclass 是 quad_point_ops |
quad_point_ops 与 kd_point_ops
都支持 <-> 排序,用于最近邻顺序扫描 |
这是 SP-GiST 框架里的空间划分 opclass,默认并不是 kd-tree;选择 opclass 会改变索引形状 |
一个容易踩的坑是把”文档描述的算法”、“类名”和”默认路径”混为一谈。SciPy
文档会讲 sliding midpoint,但默认是平衡中位数;scikit-learn
的估计器参数叫 algorithm="auto",高维或 \(k\) 太大时会转 brute;PCL
类名里有 FLANN,却固定走 FLANN 的单树参数。
八、谱系、争论与工程选型
从多维二叉搜索树到近似森林
Bentley 1975 年的论文定义了循环判别维的多维二叉搜索树,并分析了随机插入、部分匹配和删除。FBF 1977 年把它改成桶式结构,用最大散布维与中位数分裂,给出近邻搜索的期望检查记录数上界。Lee 与 Wong 1977 年补上正交范围查询的 \(O(n^{1-1/d}+m)\) 最坏界。这三篇基本确定了经典 kd-tree 的定义、构建和两类查询成本。
后续工作沿两条线分叉。一条线继续做精确或半动态结构:Bentley 与 Saxe 1980 年的 logarithmic method 给出半动态集合维护思路,Procopiuc 等人的 Bkd-tree 面向外存块。另一条线接受近似:Arya、Mount 等人在 JACM 1998 年系统化了 \((1+\varepsilon)\) 近似最近邻;Beis 与 Lowe 1997 年的 BBF 用固定检查叶子数换速度;Silpa-Anan 与 Hartley 2008 年、Muja 与 Lowe 2009/2014 年把多随机 kd-tree 和自动调参推向图像特征检索场景。
争论一:“十几维就顺序扫描”到底什么意思
Weber、Schek、Blott 在 VLDB 1998 年比较高维相似搜索时写道,在他们的均匀独立数据、块访问模型和阈值设定下,维数超过约 10 后,简单顺序扫描平均会超过分区或聚类方法。Beyer、Goldstein、Ramakrishnan、Shaft 在 ICDT 1999 年从另一个角度解释高维失效:若最近距离与最远距离的相对方差趋于 0,那么最近邻会变得不稳定,许多点几乎一样近。
这两篇常被合并成”超过 10 维最近邻没意义”,但它们自己都写了边界。Weber 的结论依赖均匀独立和块 I/O 模型;Beyer 等人也指出,聚类结构或低维工作负载可能逃过距离集中。第六节的内在维度实验正是这个反例:64 维外壳里的 2 维子空间,散布中位数平均只检查几十个点,而 20 维均匀数据要检查 18.9 万个点。
争论二:中位数还是滑动中点
中位数切分保证高度,但会产生很瘦的单元;中点切分照顾空间形状,却可能空切。Maneewongvatana 与 Mount 1999 年的滑动中点试图折中:先按最长边的中点切,若一侧没有点,就滑到最近的点,避免空子树。ANN 手册把滑动中点作为建议默认值,因为它牺牲平衡换取更好的单元形状。
生产库并没有统一结论。SciPy 默认选择平衡中位数,只有关闭
balanced_tree 时才走类似滑动中点;scikit-learn
用散布中位数;nanoflann 和 FLANN 的单树用中点式
middleSplit。这不是谁对谁错,而是代价函数不同:批量静态查询常看高度和缓存局部性;低维几何搜索更关心单元是否过瘦;近似森林则用多棵随机树摊平单树偶然性。
开放边界:怎样利用低内在维度
Beyer 等人的反例说明,随机高维数据会让最近邻距离失去对比;第六节的实验又说明,低内在维度可以让 kd-tree 继续有效。但这中间没有一条只看外在维度 \(D\) 或内在维度 \(m\) 的简单规则。Dasgupta 与 Freund 的随机投影树工作强调,标准轴对齐 kd-tree 不一定自动适应低维流形;Ram 与 Sinha 2019 年重新分析了基于随机投影树的 kd 变体,在近似查询下给出与维度相关的改进界。
工程上的开放边界也很具体:什么时候继续调 kd-tree 的切分、叶子大小和 \(\varepsilon\),什么时候切到 LSH、图索引或量化索引?答案依赖数据分布、查询量、更新频率和硬件缓存。本文给出的复现程序只能作为一个可改的基线,不能替代线上 workload 的 A/B 实测。
工程选型
- 先跑暴力基线。如果 \(d\) 高、\(k\)
大、查询少,建树成本和随机访存可能让 kd-tree
输给顺序扫描;scikit-learn 的
auto规则把n_features>15与n_neighbors>=n_samples//2直接转 brute,就是这种判断。 - 低维、静态、多查询时优先试 kd-tree。二维到十几维、欧氏或 \(L_p\) 距离、查询量远大于建树成本,是它最稳的区域。叶子大小不是理论参数,调大可减少树高和指针跳转,调小可减少叶内扫描。
- 用单元下界,不要只用平面下界。第六节的 \(d=16\) 实验里,二者从 19.6% 和 95.3% 拉开到近 5 倍。实现上只需维护增量盒距离。
- 近似比换索引更便宜时,先试 \(\varepsilon\)。对已有 kd-tree,加一个放宽剪枝的参数成本很低;若仍接近全扫,再考虑 LSH、HNSW、IVF-PQ 等高维近似结构。
- 动态更新需要另算账。本文实现是静态树;频繁插入删除会破坏平衡和单元形状。可用定期重建、缓冲层或半动态方法,但那已经是另一套工程问题。
九、复现
reproduce/kdtree.c 实现桶式
kd-tree、三种切分规则、平面 / 单元两种剪枝、精确与 \((1+\varepsilon)\)
k-NN、正交范围查询和暴力对拍。随机数使用固定 SplitMix64
种子;所有实验输出都写到
reproduce/results/。
cd post/algorithms/37-kdtree/reproduce
sh run.sh 3
python3 draw_figures.py ..
python3 plot_results.py results ..
run.sh 用
gcc -O2 -Wall -Wextra -lm 编译,默认把查询绑到
CPU 3。当前结果来自 i9-12900K、WSL2 Linux 6.6.87.2、GCC
16.1.1;同机有其他任务时,计时表只用于观察相对趋势,正文主要采用检查点数、访问节点数、精确返回比例这类与时钟无关的指标。
关键输出文件与正文关系如下:
| 文件 | 内容 | 正文位置 |
|---|---|---|
test.txt |
360000 次 k-NN 与 180000 次范围查询对拍暴力,失败数为 0 | 正确性说明 |
range.txt |
竖线与正方形范围查询的访问节点数 | 第四节 |
dims.txt |
均匀数据随 \(n,d\) 变化的检查点数;同时比较平面 / 单元下界 | 第六节 kdtree-dims.svg |
intrinsic.txt |
低内在维度、轴对齐 / 随机旋转、三种切分规则 | 第六节 kdtree-intrinsic.svg |
eps.txt |
不同 \(\varepsilon\) 的检查点数、精确返回比例和最大距离比 | 第六节 |
worst.txt |
圆周数据的线性最坏情况 | 第五节 |
time1.txt 到 time3.txt |
计时三次,用中位数出表 | 第六节 |
十、参考资料
文档与手册
- D. M. Mount, ANN Programming Manual, v1.1,
2010,第 2.3.3 节切分规则与
ANN_KD_SUGGEST。 - SciPy 1.14.1 文档,
scipy.spatial.cKDTree与query参数说明,https://docs.scipy.org/doc/scipy-1.14.1/reference/generated/scipy.spatial.cKDTree.html。 - PostgreSQL 17 文档,SP-GiST 内置 operator classes 与
kd_point_ops,https://www.postgresql.org/docs/17/spgist.html。
源码
- SciPy
v1.14.1,
scipy/spatial/_ckdtree.pyx,scipy/spatial/ckdtree/src/build.cxx与query.cxx。 - scikit-learn
1.5.2,
sklearn/neighbors/_base.py与sklearn/neighbors/_binary_tree.pxi.tp。 - nanoflann
v1.6.1,
include/nanoflann.hpp,KDTreeSingleIndexAdaptorParams、middleSplit_与searchLevel。 - FLANN
1.9.2,
KDTreeSingleIndexParams、KDTreeIndexParams与getNeighbors相关实现。 - PCL
1.14.1,
kdtree/impl/kdtree_flann.hpp,KdTreeFLANN构建与查询参数。 - Lucene
9.12.0,
lucene/core/src/java/org/apache/lucene/util/bkd,BKDConfig与BKDWriter。
核心论文
- J. L. Bentley, “Multidimensional Binary Search Trees Used for Associative Searching”, CACM 18(9):509–517, 1975, DOI 10.1145/361002.361007。
- J. H. Friedman, J. L. Bentley, R. A. Finkel, “An Algorithm for Finding Best Matches in Logarithmic Expected Time”, ACM TOMS 3(3):209–226, 1977, DOI 10.1145/355744.355745。
- D. T. Lee, C. K. Wong, “Worst-case Analysis for Region and Partial Region Searches in Multidimensional Binary Search Trees and Balanced Quad Trees”, Acta Informatica 9(1):23–29, 1977, DOI 10.1007/BF00263763。
- S. Arya, D. M. Mount, N. S. Netanyahu, R. Silverman, A. Y. Wu, “An Optimal Algorithm for Approximate Nearest Neighbor Searching Fixed Dimensions”, JACM 45(6):891–923, 1998, DOI 10.1145/293347.293348。
- S. Maneewongvatana, D. M. Mount, “It’s Okay to Be Skinny, If Your Friends Are Fat”, 4th Annual CGC Workshop on Computational Geometry, 1999。
其他论文
- J. L. Bentley, J. B. Saxe, “Decomposable Searching Problems I: Static-to-dynamic Transformation”, Journal of Algorithms 1(4):301–358, 1980, DOI 10.1016/0196-6774(80)90015-2。
- J. L. Bentley, “Multidimensional Divide-and-Conquer”, CACM 23(4):214–229, 1980, DOI 10.1145/358841.358850。
- B. Chazelle, “Lower Bounds for Orthogonal Range Searching: I. The Reporting Case”, JACM 37(2):200–212, 1990, DOI 10.1145/77600.77614。
- R. F. Sproull, “Refinements to Nearest-Neighbor Searching in k-Dimensional Trees”, Algorithmica 6:579–589, 1991, DOI 10.1007/BF01759061。
- J. S. Beis, D. G. Lowe, “Shape Indexing Using Approximate Nearest-Neighbour Search in High-Dimensional Spaces”, CVPR 1997, pp. 1000–1006, DOI 10.1109/CVPR.1997.609451。
- R. Weber, H.-J. Schek, S. Blott, “A Quantitative Analysis and Performance Study for Similarity-Search Methods in High-Dimensional Spaces”, VLDB 1998, pp. 194–205。
- K. Beyer, J. Goldstein, R. Ramakrishnan, U. Shaft, “When Is Nearest Neighbor Meaningful?”, ICDT 1999, LNCS 1540, pp. 217–235, DOI 10.1007/3-540-49257-7_15。
- O. Procopiuc, P. K. Agarwal, L. Arge, J. S. Vitter, “Bkd-tree: A Dynamic Scalable kd-tree”, SSTD 2003, LNCS 2750, pp. 46–65, DOI 10.1007/978-3-540-45072-6_4。
- S. Dasgupta, Y. Freund, “Random Projection Trees and Low Dimensional Manifolds”, STOC 2008, pp. 537–546, DOI 10.1145/1374376.1374452。
- C. Silpa-Anan, R. Hartley, “Optimised KD-trees for Fast Image Descriptor Matching”, CVPR 2008, DOI 10.1109/CVPR.2008.4587638。
- M. Muja, D. G. Lowe, “Fast Approximate Nearest Neighbors with Automatic Algorithm Configuration”, VISAPP 2009, pp. 331–340, DOI 10.5220/0001787803310340。
- M. Muja, D. G. Lowe, “Scalable Nearest Neighbor Algorithms for High Dimensional Data”, TPAMI 36(11):2227–2240, 2014, DOI 10.1109/TPAMI.2014.2321376。
- S. Dasgupta, K. Sinha, “Randomized Partition Trees for Nearest Neighbor Search”, Algorithmica 72(1):237–263, 2015, DOI 10.1007/s00453-014-9885-5。
- P. Ram, K. Sinha, “Revisiting kd-tree for Nearest Neighbor Search”, KDD 2019, pp. 1378–1388, DOI 10.1145/3292500.3330875。
实验
reproduce/kdtree.c:桶式 kd-tree、三种切分规则、精确 / 近似 k-NN、范围查询与暴力对拍;reproduce/run.sh生成results/*.txt;draw_figures.py与plot_results.py生成本文 SVG。
系列导航: - 上一篇:流式算法总论:数据流模型、频率矩下界与线性 sketch - 下一篇:局部敏感哈希:从概率保证到多探针近邻检索
相关阅读: - R-tree 与空间索引:PostGIS 的底层结构 - HNSW:分层小世界图的近似近邻搜索 - 乘积量化与 IVF-PQ:压缩域里的近似最近邻 - 最近点对与随机化几何算法
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
R-tree 与空间索引:PostGIS 的底层结构
地理信息系统如何在数百万个多边形中快速找到附近的餐厅?R-tree 用层级化的边界矩形将空间搜索从暴力扫描变为对数级查询。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。