一台网关每秒转发几十万个请求,想实时回答:今天有多少个不同的源 IP,哪些 URL 最热,请求延迟的 P99 是多少,流量分布有没有突然变得更集中。数据只能看一遍,内存只有几 KB 到几 MB。本系列第 30 到 35 篇分别讲了应对这些问题的具体结构:HyperLogLog、Count-Min Sketch、t-digest、水塘抽样、MinHash/SimHash、Misra-Gries 与 Space-Saving。本篇不重复它们的细节,而是回答三个横跨所有篇目的问题。
第一,近似是不是工程上的妥协,多给点内存就能精确?不是。Alon、Matias、Szegedy 在 1996 年证明,除了流长度 \(F_1\) 之外,精确计算任何一个频率矩 \(F_k\) 都需要线性空间,即使允许随机;而确定性地做 10% 以内的近似也需要线性空间。随机和近似两者缺一不可(第三节)。
第二,所有 sketch 都能合并、都能处理删除吗?也不是。只有线性 sketch 天然支持删除和逐项相加的合并;HyperLogLog 的合并是取最大值,不能删除;t-digest 的合并结果依赖合并顺序(第五节)。
第三,\(F_2\) 能用对数空间估计,\(F_3\) 是不是也可以?不行。\(k > 2\) 时 \(F_k\) 需要 \(n^{1-2/k}\) 量级的空间,这个界花了近十年才被上下两个方向同时确定(第二、三节)。
本文先给出流模型的精确定义,再按时间线交代谱系,然后用通信复杂度解释下界从哪里来。第四节拆解
AMS 的 \(F_2\)
sketch,并用同目录 reproduce/
下的程序实测误差随计数器数的变化;第五节讲线性 sketch
与可合并性;第六节把本系列各篇放进同一张路线图;最后是本系列未展开的模型、争论与开放问题。
一、数据流模型
更新向量
几乎所有文献都把数据流看成对一个隐式向量的更新序列。设宇宙大小为 \(n\),向量 \(f \in \mathbb{Z}^n\) 初始为零;第 \(t\) 个更新是一对 \((i_t, c_t)\),含义是
\[ f_{i_t} \leftarrow f_{i_t} + c_t . \]
“源 IP 出现了多少次”就是 \(f_i\),“不同源 IP 数”是 \(f\) 的非零坐标个数。算法看完整个更新序列后要回答关于 \(f\) 的某个函数,衡量它的是三个量:空间(比特数)、扫描遍数(本文默认单遍)、每次更新的时间。随机算法的保证通常写成 \((\varepsilon, \delta)\) 形式:以至少 \(1-\delta\) 的概率,输出落在真实值的 \((1 \pm \varepsilon)\) 倍以内。
三种模型
按 \(c_t\) 的取值,Muthukrishnan 在综述(Foundations and Trends in TCS,2005)“数据流模型”一节里把流分成下面几类。插入式(insertion-only)是后来文献常用的叫法,指每次只加 1 的特例:
| 模型 | 更新 \(c_t\) | 对 \(f\) 的约束 | 例子 | 本系列哪些结构在这个模型下 |
|---|---|---|---|---|
| 插入式(insertion-only) | \(c_t = 1\) | \(f_i \ge 0\) | 请求日志、包计数 | HyperLogLog、t-digest、水塘抽样、MinHash、Misra-Gries、Space-Saving |
| 现金登记(cash register) | \(c_t > 0\) | \(f_i \ge 0\) | 按字节数累加流量 | 同上(需要支持带权更新) |
| 严格十字转门(strict turnstile) | 可正可负 | 任何时刻 \(f_i \ge 0\) | 数据库插入与删除,只能删已插入的记录 | Count-Min(取最小值)、AMS、Count Sketch |
| 一般十字转门(turnstile) | 可正可负 | \(f_i\) 可以为负 | 两个流之差 \(f_A - f_B\) | AMS、Count Sketch、Count-Min(改取中位数) |
综述对这几个名字的来历有交代:现金登记模型由他和合作者在 2001 年的 VLDB 论文(Gilbert、Kotidis、Muthukrishnan、Strauss)中命名,十字转门模型的名字是在综述里起的,比喻地铁站闸机记录不停进出的人流;“严格”指人只能从进来的闸机出去,也就是计数不会为负。综述还列出了更弱的时间序列(time series)模型:第 \(i\) 个元素直接给出 \(f_i\) 的值,按 \(i\) 递增到达。一般性从强到弱依次是十字转门、现金登记、时间序列。
模型决定了什么能做。Count-Min Sketch 第五节的实测显示,在严格十字转门下取最小值仍然给出单边上界;一旦计数可以为负,最小值会让 97% 的 key 被低估,必须改取中位数。HyperLogLog 的寄存器保存”见过的最大值”,删除一个元素无法让最大值回退,所以它只属于插入式模型。
一个常被忽略的假设:输入与随机性无关
上面所有 \((\varepsilon, \delta)\) 保证都隐含一个前提:整条流在算法抽取随机种子之前就已经确定,或者至少与算法的随机性无关,即所谓遗忘式(oblivious)对手。如果输入方能看到算法的输出并据此构造后续输入,这些保证可能全部失效。HyperLogLog 第八节引用的 Paterson 与 Raynal(IEEE EuroS&P 2022)攻击就是这种情况。第八节会回到这个问题。
二、谱系:从 Morris 计数器到频率矩
flowchart TB
  subgraph early["1978-1985: counting with tiny registers"]
    M78["Morris 1978<br/>approximate counting, O(log log n) bits"]
    MP80["Munro-Paterson 1980<br/>p-pass selection"]
    FM85["Flajolet-Martin 1985<br/>distinct elements<br/>O(log n) bits"]
  end
  subgraph ams["1996: frequency moments"]
    AMS["Alon-Matias-Szegedy STOC 1996 / JCSS 1999<br/>F_k upper and lower bounds; Goedel Prize 2005"]
  end
  subgraph after["2000-2010: closing the gaps"]
    IND["Indyk FOCS 2000 / JACM 2006<br/>p-stable sketches, turnstile L_p, p in (0,2]"]
    LB["Bar-Yossef et al. 2002, Chakrabarti-Khot-Sun 2003<br/>F_k lower bound n^(1-2/k)"]
    IW["Indyk-Woodruff STOC 2005<br/>F_k upper bound n^(1-2/k)"]
    KNW["Kane-Nelson-Woodruff 2010<br/>optimal F_0 and small L_p"]
  end
  M78 --> AMS
  FM85 --> AMS
  AMS --> IND
  AMS --> LB
  LB --> IW
  IND --> KNW
FM85 --> KNWMorris(1978)。Robert Morris 在 Communications of the ACM 上发表的《Counting large numbers of events in small registers》要解决的问题是:用很小的寄存器数到很大的数。最常见的写法是寄存器存 \(X\),每来一个事件,以概率 \(2^{-X}\) 把 \(X\) 加一,估计值取 \(2^X - 1\)。它是无偏的:若当前 \(X = x\),下一步 \(2^X\) 以概率 \(2^{-x}\) 变成 \(2^{x+1}\)、否则不变,期望增量恰为 \(2^{-x} \cdot 2^x = 1\),于是 \(n\) 个事件后 \(\mathbb{E}[2^X] = n + 1\)。\(X\) 大约是 \(\log_2 n\),存它只要 \(O(\log\log n)\) 位。Flajolet(BIT,1985)给出了它的完整分析。Nelson 与 Yu(PODS 2022)称它为”第一个流式算法”,并把近似计数的空间复杂度完全确定为 \(\Theta(\log\log N + \log(1/\varepsilon) + \log\log(1/\delta))\) 位,其中对失败概率 \(\delta\) 的依赖比此前已知的 \(\log(1/\delta)\) 指数级地好。
Munro 与 Paterson(1980)。《Selection and sorting with limited storage》研究在只读输入上用有限内存、多遍扫描做选择。它是”遍数与空间”权衡的早期结果,分位数方向的后续发展见 t-digest 第一、二节。
Flajolet 与 Martin(1985)。《Probabilistic counting algorithms for data base applications》(JCSS 31(2),会议版 FOCS 1983)用哈希值二进制表示中的比特模式估计不同元素数 \(F_0\),只用 \(O(\log n)\) 位。AMS 论文指出,FM 的分析假设能拿到”随机性极强”的哈希函数,并证明一个简单的线性哈希版本就够用。从 FM 到 HyperLogLog 的演进见第 30 篇。
Alon、Matias、Szegedy(1996)。《The space complexity of approximating the frequency moments》(STOC 1996,期刊版 JCSS 58(1),1999)定义了频率矩
\[ F_k = \sum_{i=1}^{n} f_i^k , \]
其中 \(F_0\) 是不同元素数,\(F_1\) 是流长度,\(F_2\) 是论文所说的重复率(repeat rate)或 Gini 齐性指数(Gini’s index of homogeneity)。论文同时给出上界和下界:\(F_2\) 可以用 \(O(\varepsilon^{-2}\log(1/\delta)(\log n + \log m))\) 位估计(Theorem 2.2);一般的 \(F_k\) 用 \(O(k\,\varepsilon^{-2}\log(1/\delta)\,n^{1-1/k}(\log n + \log m))\) 位(Theorem 2.1);而对固定的 \(k > 5\),任何随机算法至少需要 \(\Omega(n^{1-5/k})\) 位(Theorem 3.2),近似最大频率 \(F_\infty^* = \max_i f_i\) 需要 \(\Omega(n)\) 位(Proposition 3.1)。2005 年的哥德尔奖授予了这篇论文,SIGACT 的颁奖词称它展示了如何设计”小的随机线性投影,后来被称为 sketch”。
Indyk(2000)。《Stable distributions, pseudorandom generators, embeddings, and data stream computation》(FOCS 2000,期刊版 JACM 53(3),2006)把 AMS 的 \(\pm 1\) 符号换成 \(p\) 稳定分布(\(p\)-stable distribution)的随机变量。\(p\) 稳定分布的定义性质是:若 \(X_1, \ldots, X_n\) 独立同分布,则 \(\sum_i f_i X_i\) 与 \(\|f\|_p X_1\) 同分布。于是计数器 \(\sum_i f_i X_i\) 的绝对值就携带了 \(\|f\|_p\) 的信息,\(p = 2\) 是高斯分布,\(p = 1\) 是柯西分布。论文对任意 \(p \in (0, 2]\),在坐标可增可减的动态更新下用 \(O(\varepsilon^{-2}\log n)\) 个字维护 \(L_p\) 范数的 sketch,解决了 Feigenbaum 等人 1999 年留下的问题。它也是用 Nisan 伪随机数发生器把”需要大量独立随机数”的算法去随机化的范例。
\(k > 2\) 的上下界合拢。AMS 在结论里猜想 \(k > 2\) 时需要 \(n^{\Omega(1)}\) 空间。Bar-Yossef、Jayram、Kumar、Sivakumar(FOCS 2002,JCSS 2004)用信息统计(information statistics)方法把下界推进到接近 \(n^{1-2/k}\);Chakrabarti、Khot、Sun(CCC 2003)改进为常数遍下 \(\Omega(n^{1-2/k}/\log n)\)、单遍下 \(\Omega(n^{1-2/k})\)。上界方向,Indyk 与 Woodruff(STOC 2005)给出任意实数 \(k > 2\) 的单遍 \(\tilde O(n^{1-2/k})\) 算法,摘要里说这”解决了 Alon 等人 1996 年留下的主要问题”。所以 \(F_2\) 是一条分界线:\(k \le 2\) 时空间是多对数的,\(k > 2\) 时是多项式的。
常数与对数因子。Kane、Nelson、Woodruff 在 2010 年的两篇论文把 \(k \le 2\) 一侧的界做到了紧:\(F_0\) 的 \((1 \pm \varepsilon)\) 近似用 \(O(\varepsilon^{-2} + \log n)\) 位,并且更新和查询都是 \(O(1)\) 最坏时间(PODS 2010);\(0 < p \le 2\) 时,在更新值属于 \([-M, M]\)、流长 \(m\) 的十字转门流上,\((1 \pm \varepsilon)\) 近似 \(L_p\) 的单遍空间是 \(\Theta(\varepsilon^{-2}\log(mM) + \log\log n)\) 位(SODA 2010)。
这条线上的两份系统性材料是 Muthukrishnan 的综述《Data Streams: Algorithms and Applications》(FnT TCS 1(2),2005)和 Cormode 与 Yi 的教材《Small Summaries for Big Data》(Cambridge University Press,2020)。前者偏理论与问题分类,后者按摘要类型组织,覆盖了本系列大部分结构的算法与合并方法。
三、下界:把流算法变成通信协议
归约的框架
流算法的空间下界几乎都来自通信复杂度(communication complexity)。设想 Alice 持有输入 \(x\),Bob 持有输入 \(y\),他们要计算 \(g(x, y)\)。如果有一个用 \(s\) 位内存的流算法 \(\mathcal{A}\),他们可以这样合作:
- Alice 把 \(x\) 编码成流的前半段,自己在上面运行 \(\mathcal{A}\);
- Alice 把 \(\mathcal{A}\) 此刻的全部内存(\(s\) 位)发给 Bob;
- Bob 把 \(y\) 编码成流的后半段,从收到的状态继续运行 \(\mathcal{A}\),读出答案。
这是一个只有一条消息、长度 \(s\) 的单向协议。只要能从 \(\mathcal{A}\) 的输出推出 \(g(x, y)\),\(g\) 的单向通信下界就是 \(\mathcal{A}\) 的空间下界。如果流允许扫描 \(p\) 遍,同样的构造需要来回 \(2p - 1\) 条消息,所以一般(多轮)通信下界可以推出多遍流下界。
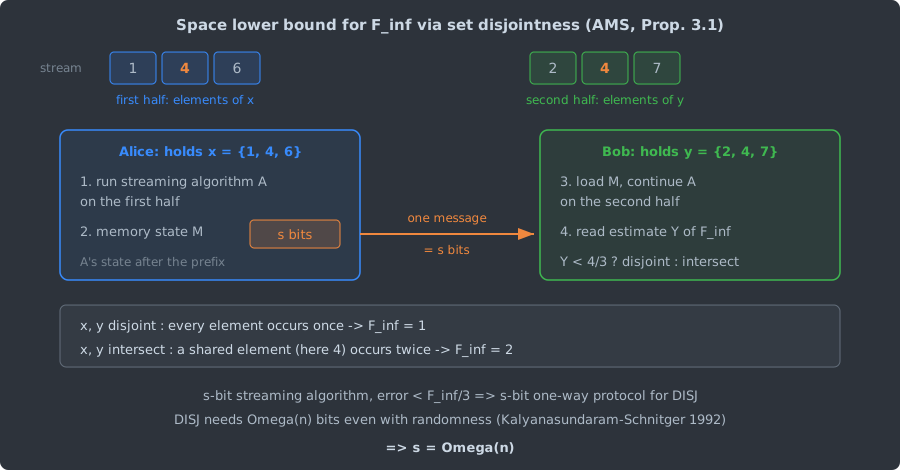
例一:最大频率需要线性空间
AMS 的 Proposition 3.1 是这个方法最短的例子,上图画的就是它。集合不相交问题(set disjointness,DISJ)问 \(x, y \subseteq \{1, \ldots, n\}\) 是否相交。把两个集合的元素依次排成一条流:不相交时每个元素出现一次,\(F_\infty^* = 1\);相交时共同元素出现两次,\(F_\infty^* = 2\)。任何能以相对误差小于 \(1/3\) 估计 \(F_\infty^*\) 的算法都能区分这两种情况。Kalyanasundaram 与 Schnitger(SIAM J. Discrete Math.,1992)证明,即使允许随机、允许多轮,DISJ 的通信复杂度也是 \(\Omega(n)\),所以这个流算法至少要 \(\Omega(n)\) 位。
同一个归约还给出 Proposition 3.8:对任何 \(k \ne 1\),即使允许随机,精确计算 \(F_k\) 也要 \(\Omega(n)\) 位。\(F_0\) 的精确计算就是 \(k = 0\) 的情形:两集合不相交当且仅当 \(F_0 = |x| + |y|\)。
\(k > 2\) 的 \(F_k\) 下界用的是多方版本:\(t\) 个玩家各持一个集合,承诺要么两两不相交,要么恰好有一个公共元素。公共元素出现 \(t\) 次,贡献 \(t^k\),取 \(t \approx n^{1/k}\) 时它足以主导 \(F_k\)。第二节提到的 \(n^{1-2/k}\) 下界来自这个多方问题的通信下界。
例二:确定性算法必须用线性空间
Proposition 3.7 不需要通信复杂度,只用鸽笼原理:对任何 \(k \ne 1\),确定性算法要以 10% 以内的相对误差近似 \(F_k\),就需要 \(\Omega(n)\) 位。证明取 \(2^{\Omega(n)}\) 个大小为 \(n/4\)、两两交集不超过 \(n/8\) 的集合。若内存少于这个族大小的对数,就有两个不同的集合 \(G_1, G_2\) 读完后内存状态相同;那么流 \(G_1 G_1\) 与 \(G_2 G_1\) 得到同一个输出,而前者的 \(F_0 = n/4\)、后者的 \(F_0 \ge 3n/8\),必有一个误差超过 10%。
这就是本系列的 HyperLogLog、Count-Min、AMS 都是随机算法的原因。它与 Misra-Gries 和 Space-Saving 这类确定性算法并不矛盾:后者保证的是 \(\pm\varepsilon m\) 的加性频率误差,不是 \(F_k\) 的相对误差。上面的反例里每个元素的频率只有 1 或 2,远小于 \(\varepsilon m\),加性保证在这里不提供任何信息。
例三:\(1/\varepsilon^2\) 从哪里来
HyperLogLog 的 \(1.04/\sqrt{m}\)、AMS 的 \(16/\varepsilon^2\) 个计数器都是 \(\varepsilon^{-2}\) 量级。这个量级也是必需的,对应的通信问题是间隙汉明距离(Gap-Hamming-Distance):Alice 和 Bob 各持一个 \(n\) 位串,判断汉明距离是大于 \(n/2 + \sqrt{n}\) 还是小于 \(n/2 - \sqrt{n}\)。Indyk 与 Woodruff(FOCS 2003)由此证明单遍近似 \(F_0\) 需要 \(\Omega(\varepsilon^{-2})\) 空间(在 \(\varepsilon\) 不太小的范围内);Chakrabarti 与 Regev(STOC 2011,SICOMP 2012)证明它的随机通信复杂度在多轮下也是 \(\Omega(n)\),从而把 \(\varepsilon^{-2}\) 下界推广到多遍流。上一节 KNW(SODA 2010)的 \(L_p\) 下界也建立在这个问题单向通信的直和(direct sum)性质上。
已知的界
| 问题 | 空间(单遍,常数失败概率) | 出处 |
|---|---|---|
| 近似计数 \(F_1\) | \(\Theta(\log\log N + \log(1/\varepsilon) + \log\log(1/\delta))\) 位 | Morris 1978;Nelson & Yu, PODS 2022 |
| 不同元素数 \(F_0\) | \(\Theta(\varepsilon^{-2} + \log n)\) 位 | Kane, Nelson, Woodruff, PODS 2010 |
| \(F_p\),\(0 < p \le 2\),十字转门 | \(\Theta(\varepsilon^{-2}\log(mM) + \log\log n)\) 位 | AMS 1996(\(p=2\));Indyk 2006;KNW, SODA 2010 |
| \(F_k\),\(k > 2\) | \(\tilde\Theta(n^{1-2/k})\) | Indyk & Woodruff 2005(上界);Chakrabarti, Khot, Sun 2003(下界) |
| 最大频率 \(F_\infty^*\),常数因子近似 | \(\Omega(n)\) | AMS Proposition 3.1 |
| 精确 \(F_k\),\(k \ne 1\),允许随机 | \(\Omega(n)\) | AMS Proposition 3.8 |
| 近似 \(F_k\),\(k \ne 1\),确定性 | \(\Omega(n)\) | AMS Proposition 3.7 |
表中 \(\tilde\Theta\) 隐去了多对数因子。近似计数一行的 \(\delta\) 依赖是 Nelson 与 Yu 的结果,其余几行按常数失败概率陈述,要把失败概率降到 \(\delta\),一般再乘 \(O(\log(1/\delta))\)(独立重复取中位数)。
四、AMS 的 \(F_2\) sketch
一个计数器
AMS 为 \(F_2\) 设计的估计器常被叫作 tug-of-war sketch(拔河 sketch)。给每个元素 \(i\) 分配一个随机符号 \(s(i) \in \{-1, +1\}\),只维护一个整数
\[ Z = \sum_{i=1}^{n} s(i)\, f_i . \]
更新 \((i, c)\) 就是 \(Z \leftarrow Z + s(i)\,c\),与更新顺序无关,也不在乎 \(c\) 的正负。查询时输出 \(X = Z^2\)。展开平方:
\[ Z^2 = \sum_i f_i^2 + \sum_{i \ne j} s(i) s(j) f_i f_j . \]
只要符号两两独立且均值为零,交叉项期望为零,\(\mathbb{E}[X] = F_2\)。方差需要四阶矩:若符号四元独立(4-wise independent),\(\mathbb{E}[s(i)s(j)s(k)s(l)]\) 只在下标两两配对时非零,AMS 的 Theorem 2.2 证明算出
\[ \operatorname{Var}[X] = 4\sum_{i<j} f_i^2 f_j^2 = 2\left(F_2^2 - F_4\right) \le 2F_2^2 . \]
所以单个计数器的相对标准差最多是 \(\sqrt{2}\),而且数据越集中(\(F_4/F_2^2\) 越接近 1)越小。四元独立的符号不需要真随机:AMS 用 BCH 码的校验矩阵构造(强度为 4 的正交表),只需存 \(O(\log n)\) 位的种子;实践中常用素数域上的 3 次随机多项式,本文的实现也是如此。
均值再取中位数
取 \(s_1 = 16/\varepsilon^2\) 个独立计数器的均值 \(Y\),方差降到 \(2F_2^2/s_1\)。由切比雪夫不等式,
\[ \Pr\left[|Y - F_2| > \varepsilon F_2\right] \le \frac{2F_2^2 / s_1}{\varepsilon^2 F_2^2} = \frac{1}{8} . \]
再独立做 \(s_2 = 2\log(1/\delta)\) 组,取中位数。中位数出错要求至少一半的组出错,而每组出错概率不超过 \(1/8\),Chernoff 界把失败概率压到 \(\delta\)。总共 \(O(\varepsilon^{-2}\log(1/\delta))\) 个计数器,每个 \(O(\log n + \log m)\) 位,就是第二节引用的 Theorem 2.2。这个”均值降方差、中位数降失败概率”(median of means)的结构后来几乎出现在每一个随机 sketch 的分析里,Count-Min 的”取 \(d\) 行最小值”是它的单边版本。
分桶:每次更新只碰 \(d\) 个计数器
经典 AMS 的问题是更新代价:\(K\) 个计数器各有一个符号函数,每来一个元素就要算 \(K\) 次哈希。Count Sketch(Charikar、Chen、Farach-Colton,ICALP 2002,TCS 2004)的结构给出另一种做法:每行有一个桶哈希 \(h: [n] \to [w]\) 和一个符号哈希 \(s\),元素 \(i\) 只更新第 \(h(i)\) 个桶,
\[ C_b = \sum_{i:\,h(i) = b} s(i)\, f_i , \qquad \hat F_2 = \sum_{b=1}^{w} C_b^2 . \]
展开后交叉项只在 \(h(i) = h(j)\) 时出现,概率为 \(1/w\),同样的计算给出 \(\operatorname{Var}[\hat F_2] = 2(F_2^2 - F_4)/w\),与 \(w\) 个 AMS 计数器取均值方差相同,但每次更新只算两次哈希。\(d\) 行取中位数则对应”均值再取中位数”。Thorup 与 Zhang(SIAM J. Comput. 41(2),2012)为二阶矩估计、线性探测这类应用构造了不用乘法的 5-wise 独立哈希,并给出了让最常用的 2-wise 独立哈希表现很差的真实输入。
两种结构的核心更新都只有几行(摘自
reproduce/ams_f2.c,poly_eval 是
\(\mathrm{GF}(2^{61}-1)\)
上的多项式求值,sign_of 取其最低位):
static void ams_update(ams_t *a, uint64_t x, int64_t c)
{
    for (int j = 0; j < a->k; j++) a->z[j] += sign_of(&a->s[j], x) * c;
}

static void cs_update(cs_t *t, uint64_t x, int64_t c)
{
    for (int r = 0; r < t->d; r++) {
        uint64_t col = poly_eval(&t->b[r], x) % (uint64_t)t->w;
        t->c[(size_t)r * t->w + col] += sign_of(&t->s[r], x) * c;
    }
}
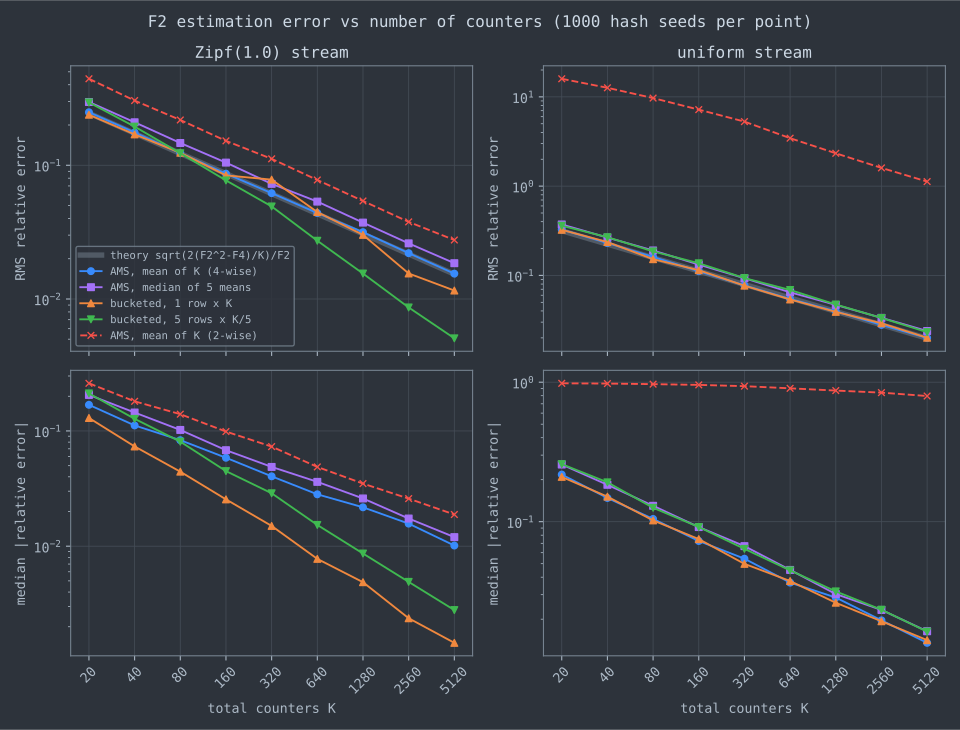
实测:误差随计数器数的变化
口径。reproduce/ams_f2.c
生成两条固定的流,都是 \(m =
10^6\) 次更新、键为 \(1\) 到 \(10^4\) 的连续整数:一条按
Zipf(1.0) 抽样(\(F_4/F_2^2 =
0.400\)),一条均匀抽样(\(F_4/F_2^2 =
0.0001\))。流在所有试验中保持不变,每次试验只重新抽取哈希种子,这正是
\((\varepsilon, \delta)\)
保证的含义:对任意一条固定的输入,概率取自算法的随机性。总计数器数
\(K\) 取 20 到
5120,比较五种配置:
- AMS,\(K\) 个计数器取均值,符号用 3 次多项式(4-wise 独立);
- AMS,分 5 组各 \(K/5\) 个取均值,再取中位数;
- 分桶,1 行 \(\times K\) 个桶;
- 分桶,5 行 \(\times K/5\) 个桶,行间取中位数;
- AMS,\(K\) 个计数器取均值,符号改用 1 次多项式(只有 2-wise 独立)。
每个点做 1000 次试验(主种子 1),报告相对误差 \(\hat F_2/F_2 - 1\)
的均方根(RMS)与绝对值中位数。理论值是均值估计器的标准差
\(\sqrt{2(F_2^2 -
F_4)/K}\,/F_2\)。所有指标都是误差统计,与计时无关,重跑逐字节一致。运行命令是在
reproduce/ 下执行
sh run.sh,环境为 Intel Core i9-12900K、WSL2
内核 6.6.87.2、GCC
16.1.1(-O2 -Wall -Wextra,另用
-fsanitize=address,undefined
跑一遍),taskset -c 2 绑核;原始输出在
reproduce/results/,plot_ams.py
生成下图。
Zipf 流(每格为 RMS / 中位数):
| \(K\) | 理论标准差 | AMS 均值 | AMS 5 组中位数 | 分桶 \(1 \times K\) | 分桶 \(5 \times K/5\) | AMS 均值,2-wise |
|---|---|---|---|---|---|---|
| 80 | 12.2% | 12.3% / 8.3% | 14.7% / 10.2% | 12.4% / 4.4% | 12.3% / 8.1% | 21.8% / 14.0% |
| 320 | 6.1% | 6.2% / 4.0% | 7.3% / 4.9% | 7.8% / 1.5% | 4.9% / 2.9% | 11.2% / 7.3% |
| 1280 | 3.1% | 3.2% / 2.2% | 3.7% / 2.6% | 3.0% / 0.49% | 1.5% / 0.86% | 5.4% / 3.5% |
| 5120 | 1.5% | 1.5% / 1.0% | 1.9% / 1.2% | 1.2% / 0.15% | 0.51% / 0.28% | 2.8% / 1.9% |
均匀流:
| \(K\) | 理论标准差 | AMS 均值 | AMS 5 组中位数 | 分桶 \(1 \times K\) | 分桶 \(5 \times K/5\) | AMS 均值,2-wise |
|---|---|---|---|---|---|---|
| 80 | 15.8% | 16.1% / 10.5% | 19.0% / 13.0% | 15.2% / 10.2% | 18.6% / 12.6% | 969% / 96.8% |
| 320 | 7.9% | 7.7% / 5.4% | 9.3% / 6.7% | 7.7% / 5.0% | 9.3% / 6.4% | 528% / 93.6% |
| 1280 | 4.0% | 4.0% / 2.9% | 4.7% / 3.0% | 3.9% / 2.6% | 4.7% / 3.2% | 233% / 87.1% |
| 5120 | 2.0% | 2.0% / 1.4% | 2.4% / 1.6% | 2.0% / 1.4% | 2.3% / 1.6% | 112.5% / 79.6% |
\(1/\sqrt{K}\) 与理论吻合。4-wise AMS 均值在两条流、所有 \(K\) 上的 RMS 与理论标准差相差不到 4%,\(K\) 每翻两番误差减半。偏斜的作用也看得到:同样 \(K = 5120\),Zipf 流的误差(1.5%)比均匀流(2.0%)小,因为方差里的 \(F_2^2 - F_4\) 扣掉了单个重元素自己的贡献。
中位数的代价。相同总计数器数下,“5 组均值再取中位数”的 RMS 比直接取均值大约 20%。误差近似正态时这是预期的:正态样本的中位数比均值波动大(大样本极限下标准差是均值的 \(\sqrt{\pi/2} \approx 1.25\) 倍),而每组只有 \(K/5\) 个计数器,5 组的中位数只追回了大部分方差。中位数的作用是把失败概率从切比雪夫的 \(1/8\) 指数级地压下去,它保护的是最坏情况下的尾部,在这两条行为良好的流上看不出好处。
分桶在偏斜数据上更好。1 行分桶的 RMS 与 AMS 相当,符合方差相同的推导,但 Zipf 流上它的中位数误差只有 AMS 的七分之一(\(K = 5120\) 时 0.15% 对 1.0%)。原因是误差分布的形状不同:分桶估计的误差主要来自最重的几个元素恰好与另一个重元素落进同一个桶,这种事件概率约为 \(1/w\),一旦发生误差很大,否则几乎为零。5 行取中位数正好切掉这种少见的大误差,\(K = 5120\) 时 RMS 降到 0.51%,95 分位误差 1.02%,而 AMS 均值的 95 分位是 3.06%。每次更新的哈希求值次数,AMS 是 \(K\) 次,5 行分桶是 10 次。均匀流上没有重元素,分桶与 AMS 的误差分布相同,5 行取中位数的 RMS 比 AMS 均值多 15% 到 20%,与 AMS 分组取中位数的代价相当。
2-wise 独立不够。只用 2-wise 独立的符号,期望仍然等于 \(F_2\),但方差不再受控。Zipf 流上 RMS 是理论的约 1.8 倍,平均误差在 \(\pm 1.2\%\) 以内。均匀流上,连续整数键配上线性哈希,符号序列高度规则:绝对误差的中位数在 80% 到 98% 之间,95 分位误差在 \(K = 640\) 时达到 854%,\(K = 5120\) 时 RMS 仍有 112.5%。误差分布的尾部这样重,1000 次试验的平均误差也在 \(-18\%\) 到 \(+24\%\) 之间摆动,这是抽样噪声,不是系统偏差。这组数字说明 AMS 为什么要求 4-wise 独立:期望只要两两独立,方差的界要用到四阶矩。实现时从”好用的哈希”里随手挑一个,在结构化的键上可能完全失效,Thorup 与 Zhang 构造的反例针对的也是这一点。
五、线性 sketch 与可合并性
定义
AMS 计数器、Count Sketch 的桶、Count-Min 的格子、Indyk 的稳定分布计数器有一个共同点:状态是频率向量的线性函数。把 sketch 写成矩阵形式,
\[ S(f) = \Pi f, \qquad \Pi \in \mathbb{Z}^{s \times n}\ (\text{或 } \mathbb{R}^{s \times n}), \]
\(\Pi\) 由随机种子决定,不需要显式存储。更新 \((i, c)\) 就是 \(S \leftarrow S + c\,\Pi_{:,i}\),即把 \(\Pi\) 的第 \(i\) 列乘 \(c\) 加上去。几种 sketch 的区别只在 \(\Pi\) 的形状:
| sketch | \(\Pi\) 的每一列 | 每次更新改动的计数器 | 由 \(S\) 恢复答案 |
|---|---|---|---|
| AMS(\(F_2\)) | 稠密,每个元素是 \(\pm 1\) | 全部 \(K\) 个 | 平方后取均值,再取中位数 |
| Count Sketch | 每行块恰有一个 \(\pm 1\) | 每行 1 个,共 \(d\) 个 | 点查询:\(d\) 行取中位数;\(F_2\):每行平方和取中位数 |
| Count-Min | 每行块恰有一个 \(+1\) | 每行 1 个,共 \(d\) 个 | 点查询:\(d\) 行取最小值 |
| Indyk \(p\) 稳定 | 稠密,\(p\) 稳定分布的随机数 | 全部 | 绝对值取中位数,再按分布的中位数缩放 |
线性带来的三个性质
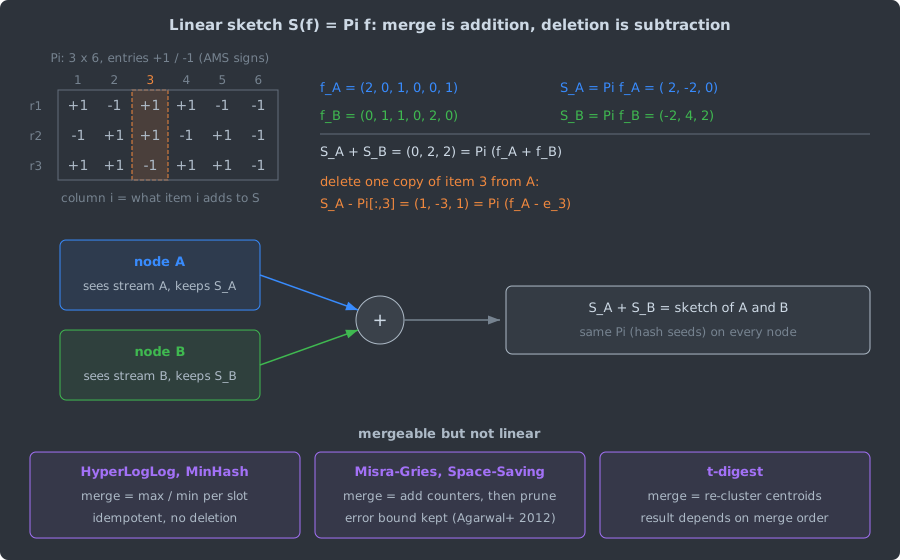
上图用一个 \(3 \times 6\) 的 \(\pm 1\) 矩阵演示了三件事,它们都是 \(\Pi(f + g) = \Pi f + \Pi g\) 的直接推论:
- 与顺序无关。同一个多重集合无论以什么顺序、怎样分批到达,最后的 \(S\) 逐位相同。
- 合并就是相加。两个节点用同一个 \(\Pi\)(同样的哈希种子)各自维护 \(S_A\)、\(S_B\),汇聚端 \(S_A + S_B\) 就是对两条流拼接后的 sketch,差分 \(S_A - S_B\) 就是 \(f_A - f_B\) 的 sketch。
- 删除就是减去一列。十字转门流里的删除与插入没有区别,所以线性 sketch 天然工作在一般十字转门模型下。能不能从 \(S\) 里读出正确答案是另一回事:Count-Min 取最小值要求 \(f \ge 0\),AMS 和 Count Sketch 不需要。
./ams_f2 test 用整数逐位比较验证了这三条。流
A 是 \(10^5\) 次 Zipf(1.0)
抽样,流 B 是 \(10^5\)
次均匀抽样,AMS 取 \(K =
64\),分桶结构取 \(5 \times
64\):
ok    sketch of stream A == sketch of its frequency vector
ok    sketch(A) + sketch(B) == sketch(A then B)
ok    insert A, delete half of it == sketch of the net vector
      strict turnstile: 49913 deletions, true F2 42073619, AMS(K=64) 33955291, CS(5x64) 39332771
ok    sketch(A) - sketch(B) == sketch of f_A - f_B
      general turnstile: 8690 negative coordinates, true ||f_A-f_B||^2 169492390, AMS 141966118, CS 154898392
all tests passed
第三行先插入 A,再把 A 的每次更新以 1/2 概率撤销(共撤销 49,913 次),结果与直接对净频率向量建 sketch 完全相同。第四行的差分向量有 8,690 个负坐标,sketch 仍然精确等于 \(\Pi(f_A - f_B)\)。两行里的估计值只用了 64 个计数器,偏低 6.5% 到 19.3%,与 \(K = 64\) 时的理论标准差(至多 \(\sqrt{2/64} \approx 17.7\%\))同一量级;这里要看的是逐位相等,不是估计精度。
AMS 的 \(\pm 1\) 矩阵也是一种随机投影:\(\|\Pi f\|_2^2 / K\) 就是 \(F_2\) 的估计。这与 Johnson–Lindenstrauss 引理说的”随机线性映射近似保持 \(L_2\) 范数”是同一个现象,区别在于流算法关心的是 \(\Pi\) 能否用很少的随机位生成、每次更新能否只碰很少的坐标。
可合并但不是线性的摘要
Agarwal、Cormode、Huang、Phillips、Wei、Yi 在《Mergeable summaries》(PODS 2012,TODS 2013)里给可合并性下了精确定义:两个数据集上的摘要能合并成并集上的摘要,且误差保证和大小保证都不变。他们指出线性 sketch 按构造就可合并,并证明了几类非线性摘要也可以:\(\varepsilon\) 近似的 heavy hitter 有大小 \(O(1/\varepsilon)\) 的确定性可合并摘要;分位数有 \(O(\varepsilon^{-1}\log(\varepsilon n))\) 大小、只支持受限合并的确定性摘要,以及 \(O(\varepsilon^{-1}\log^{3/2}(1/\varepsilon))\) 大小、完全可合并的随机摘要。本系列的结构按这个视角分成几类:
| 结构 | 篇目 | 线性? | 合并方式 | 删除 |
|---|---|---|---|---|
| Count-Min、Count Sketch、AMS | 31、本篇 | 是 | 逐项相加 | 支持 |
| HyperLogLog | 30 | 否 | 逐寄存器取最大值,幂等 | 不支持 |
| MinHash | 34 | 否 | 逐个哈希取最小值,幂等 | 不支持 |
| Misra-Gries、Space-Saving | 35 | 否 | 计数相加后裁剪(Agarwal 等) | 不支持 |
| 水塘抽样 | 33 | 否 | 按两条流的长度加权,从两个样本中再抽样 | 不支持 |
| t-digest | 32 | 否 | 质心合并后重新压缩,结果依赖合并顺序,无误差界 | 不支持 |
幂等(idempotent)的合并有一个线性 sketch 没有的好处:同一份摘要被重复合并两次,结果不变,消息重复投递无害。反过来,线性 sketch 重复相加就是重复计数。选哪一类,取决于系统更怕重复投递还是需要删除。
六、本系列的路线图
flowchart TB
  subgraph turn["turnstile: linear sketches"]
    A36["36 AMS<br/>F_2, lower bounds"]
    A31["31 Count-Min / Count Sketch<br/>point query"]
  end
  subgraph ins["insertion-only / cash register"]
    A30["30 HyperLogLog<br/>distinct count F_0"]
    A35["35 Misra-Gries / Space-Saving<br/>heavy hitters, deterministic"]
    A33["33 reservoir sampling<br/>uniform sample"]
    A34["34 MinHash / SimHash<br/>set similarity"]
    A32["32 t-digest<br/>quantiles"]
  end
  A36 --> A31
  A36 --> A30
  A31 <--> A35
  A33 --> A34
上图按流模型把本系列的篇目分成两组:线性 sketch 一组能处理删除,其余只适用于插入式或现金登记流。箭头是推荐的阅读依赖:本篇的模型与下界是 30、31 的背景;31 与 35 回答同一个问题(某个元素出现了多少次),一个随机、一个确定,应当对照着读;33 的均匀抽样是理解 34 中”最小哈希值即随机样本”的前提。
| 篇目 | 回答的问题 | 随机 / 确定 | 误差口径 | 最值得带走的结论 |
|---|---|---|---|---|
| 30 HyperLogLog | 有多少个不同元素 | 随机 | 相对误差,标准误差 \(1.04/\sqrt{m}\) | 0.81% 是标准误差不是上限;合并是逐寄存器取最大值,与直接构建逐字节相同;“接近最优”只在数量级上成立 |
| 31 Count-Min Sketch | 元素 \(i\) 出现了多少次 | 随机 | 加性误差 \(\varepsilon\|f\|_1\) | 误差是流总量的 \(\varepsilon\) 倍而非相对误差;负计数时必须改取中位数;与 Count Sketch 孰优取决于看平均误差还是最大误差 |
| 32 t-digest | 分位数,尤其是尾部 | 确定(无误差界) | 经验上的尾部秩误差 | 没有最坏情形保证,Cormode 等人(KDD 2021)的困难分布能让秩误差接近 40 个百分点;合并结果依赖顺序 |
| 33 水塘抽样 | 从未知长度的流中均匀抽 \(k\) 个 | 随机 | 精确的均匀分布,不是近似 | Vitter(TOMS 1985)的 Algorithm Z 一遍扫描、常数额外空间,从 \(N\) 个元素中抽 \(k\) 个的期望时间是 \(O(k(1+\log(N/k)))\),在常数因子内最优 |
| 34 MinHash 与 SimHash | 两个集合 / 向量有多相似 | 随机 | 估计量方差 | Broder(1997):两个集合最小哈希值相等的概率等于 Jaccard 相似度;Charikar(STOC 2002):随机超平面符号一致的概率等于 \(1 - \theta/\pi\) |
| 35 频率估计 | 哪些元素出现得最多 | 确定 | 加性误差 \(m/(k+1)\) | Misra-Gries(1982)用 \(k\) 个计数器,低估不超过 \(m/(k+1)\)(\(m\) 为流长);与 Space-Saving 同构,确定性且可合并(Agarwal 等人 2012) |
| 本篇 | \(F_2\) 与”什么能做、什么不能做” | 随机 | 相对误差 | 随机与近似缺一不可;\(k > 2\) 的 \(F_k\) 需要多项式空间;只有线性 sketch 天然支持删除 |
表中 33 到 35 的”结论”一列只列出对应原始论文的结论,各篇的推导、实现与实验见原文。
按目标选读的路径:
- 只想在系统里用对 sketch:31 → 30 → 32,重点看各篇的”工程上的注意事项”,再回到本篇第五节看合并语义。
- 做监控 / 可观测性:32 → 30 → 31。延迟分位数、独立用户数、热点 key 是三类最常见的指标。
- 做去重与相似检索:33 → 34,然后是下一个主题的 KD-tree 与 LSH、HNSW 等近邻检索篇目。
- 关心理论边界:本篇第二、三节 → 31 第三节的误差界证明 → 30 第八节关于”最优”的争论 → 32 第七节的对抗输入。
七、本系列没有展开的两个模型
滑动窗口。监控里常问的是”最近 \(N\) 个事件”而不是”开机以来”。Datar、Gionis、Indyk、Motwani(SIAM J. Comput. 31(6),2002)研究了最基本的版本:比特流中最近 \(N\) 位有多少个 1。他们的指数直方图(exponential histogram)用 \(O(\varepsilon^{-1}\log^2 N)\) 位给出 \((1 + \varepsilon)\) 近似,并证明这个空间对确定性和随机算法都是下界;同样的方法推广到正整数求和,并能以 \(O(\varepsilon^{-1}\log N)\) 倍的额外空间把许多全流算法改造成窗口版本。工程上更常见的做法是按时间片各建一个可合并的 sketch,查询时合并窗口内的时间片,精度由时间片粒度决定。
图流。流的元素是图的边时,连通性、匹配这类全局性质在 \(o(n)\) 空间里大多无法计算,于是 Feigenbaum、Kannan、McGregor、Suri、Zhang(ICALP 2004,TCS 348(2-3),2005)提出半流(semi-streaming)模型,允许 \(O(n\,\mathrm{polylog}\,n)\) 空间,即存得下一棵生成森林、存不下所有边。只有插入时,并查集就能维护连通分量。允许删边后问题难得多:Ahn、Guha、McGregor(SODA 2012)证明了 \(O(n\,\mathrm{polylog}\,n)\) 维的线性测量足以判断连通性、\(k\) 连通性和二部性,这是线性 sketch 从频率向量推广到图结构的起点。
八、争论与开放问题
十字转门算法是否都是线性 sketch
本文第五节的表里,所有能处理删除的结构恰好都是线性的。这不是巧合。Li、Nguyen、Woodruff(STOC 2014)的论文题目就是结论:《Turnstile streaming algorithms might as well be linear sketches》。他们的摘要指出,十字转门模型里所有已知算法都是线性 sketch,并证明在一定条件下任何十字转门算法都能转换成等价的线性 sketch。这个结果很有用,因为线性 sketch 的下界比一般流算法容易证明。
Kallaugher 与 Price(STOC 2020)指出等价成立的条件很强:流算法必须能处理长度超过 \(2^{2^n}\) 的流,并容忍中间状态的坐标变得极大;Ai、Hu、Li、Woodruff(CCC 2016)把等价推广到严格十字转门,但仍要求中间状态可以任意大。一旦限制流长或要求中间状态保持在 \([-M, M]^n\) 内(这在图流里很自然:边的存在向量应该一直是 0/1),他们构造出了线性 sketch 比十字转门流算法难指数倍的问题。他们还指出 LNW 的等价是非显式、非一致的,需要指数长的建议串(advice string),并对确定性算法给出了显式的转换。所以”删除就意味着线性”在无约束的理论模型里成立,在更贴近系统的有界模型里不成立。
对手能看到输出时
第一节提到,所有 \((\varepsilon, \delta)\) 保证都假设输入与随机种子无关。Hardt 与 Woodruff(STOC 2013)证明这对线性 sketch 是致命的:任何线性 sketch,即使维度达到 \(n - o(n)\)、查询时计算能力不受限制,在多项式次自适应选择的输入下都无法把 \(L_2\) 范数近似到任意乘性因子以内。攻击者只要反复查询,就能找到一个让 sketch 出错的输入分布。
Ben-Eliezer、Jayaram、Woodruff、Yogev(PODS 2020,JACM 69(2),2022)从正面研究了对抗鲁棒(adversarially robust)的流算法:确定性算法天然鲁棒,但本文第三节说明很多核心问题没有亚线性空间的确定性算法;他们证明在插入式模型下,\(F_0\)、\(F_p\) 估计、heavy hitter 等问题都有鲁棒的 \((1 + \varepsilon)\) 近似算法,空间只比非鲁棒算法多 \(\mathrm{poly}(\log n, 1/\varepsilon)\) 倍。论文同时强调,LNW 等人的等价只对静态流成立,对自适应流没有直接推论。
开放问题:十字转门模型下,鲁棒 \(F_p\) 估计需要多少空间?BJWY 在论文修订版(arXiv:2003.14265v3)里把它列为开放问题:静态情形下 \(p \le 2\) 时空间是 \(\mathrm{polylog}\,n\),而已知最好的鲁棒算法对流长 \(m\) 有多项式依赖,但至今没有人证明两者之间存在分离。与之对照,Kaplan、Mansour、Nissim、Stemmer(CRYPTO 2021)已经为一个自适应数据分析的流式变体证明了静态 \(\mathrm{polylog}\)、鲁棒多项式的分离。对工程的含义是具体的:HyperLogLog 第八节的攻击、Count-Min Sketch 第十节提到的公开种子问题,都属于这个框架;在攻击者可控的输入上,用私有随机种子只是必要条件,不是充分条件。
开放问题:从渐近最优到常数最优
\(F_0\) 和 \(F_p\)(\(p \le 2\))的渐近空间在 2010 年已经确定,但工业界用的 HyperLogLog 并不渐近最优,Count-Min 的 \(d = \lceil \ln(1/\delta) \rceil\) 在固定空间下也不是平均误差最优的深度(31 第九节)。这里的争论不在于”哪个渐近界更好”,而在于常数、可合并性和实现复杂度怎么折算。Pettie 与 Wang(STOC 2021)用 Fisher-Shannon 数比较可合并基数草图的常数,只对”可线性化”草图这一子类证明了最优性,一般情形仍然开放(30 第八节)。
九、工程上的几条推论
- 先确认模型。数据里有撤销、退款、窗口过期时就是十字转门流。Count-Min 在严格十字转门下仍可取最小值;计数可能为负时,只能用 Count Sketch、AMS 这类取中位数的结构(31 第五节)。
- 合并前核对种子。线性 sketch 的合并是 sketch 向量相加,只有同一个 \(\Pi\) 下的向量相加才有意义;参数或种子不同的 sketch 相加不会报错,只会给出无意义的数。把哈希函数、种子和尺寸写进序列化格式并在合并前校验。
- 区分幂等合并与累加合并。消息可能重复投递时,HyperLogLog、MinHash 的取最大 / 最小值合并天然去重;线性 sketch 需要上层保证每份数据只合并一次。
- 哈希函数的独立性不是细节。第四节的实验里,2-wise 独立的符号让均匀流上的 \(F_2\) 估计 RMS 超过 100%。需要方差保证时,至少用 4-wise 独立的多项式哈希或 Thorup-Zhang 基于表格的 5-independent 哈希。
- 偏斜数据上优先用分桶结构。同样是 5120 个计数器,5 行分桶的 \(F_2\) 估计在 Zipf 流上的 RMS 约为 AMS 的三分之一,每次更新只算 10 次哈希而不是 5120 次;计数器少时两者差距缩小,\(K = 80\) 时相同。
- 不要为了精确而加内存。第三节的下界说明,精确的 \(F_0\)、\(F_2\) 需要线性空间;需要精确时就直接存哈希表,需要小内存时就接受近似并按 \(\varepsilon^{-2}\) 规划空间。
十、参考资料
文档
- ACM SIGACT,2005 年哥德尔奖说明,https://sigact.org/prizes/g%C3%B6del/2005.html。
核心论文
- R. Morris, “Counting Large Numbers of Events in Small Registers”, CACM 21(10):840–842, 1978, DOI 10.1145/359619.359627。
- J. I. Munro, M. S. Paterson, “Selection and Sorting with Limited Storage”, TCS 12(3):315–323, 1980。初版 FOCS 1978。
- P. Flajolet, G. N. Martin, “Probabilistic Counting Algorithms for Data Base Applications”, JCSS 31(2):182–209, 1985。初版 FOCS 1983, pp. 76–82。
- N. Alon, Y. Matias, M. Szegedy, “The Space Complexity of Approximating the Frequency Moments”, JCSS 58(1):137–147, 1999。初版 STOC 1996, pp. 20–29。预印本 https://www.tau.ac.il/~nogaa/PDFS/amsz4.pdf。
- P. Indyk, “Stable Distributions, Pseudorandom Generators, Embeddings, and Data Stream Computation”, JACM 53(3):307–323, 2006。初版 FOCS 2000, pp. 189–197。
- P. Indyk, D. Woodruff, “Optimal Approximations of the Frequency Moments of Data Streams”, STOC 2005, pp. 202–208。
- D. M. Kane, J. Nelson, D. P. Woodruff, “An Optimal Algorithm for the Distinct Elements Problem”, PODS 2010, pp. 41–52。
- D. M. Kane, J. Nelson, D. P. Woodruff, “On the Exact Space Complexity of Sketching and Streaming Small Norms”, SODA 2010, pp. 1161–1178。
- P. K. Agarwal, G. Cormode, Z. Huang, J. M. Phillips, Z. Wei, K. Yi, “Mergeable Summaries”, PODS 2012, pp. 23–34;期刊版 ACM TODS 38(4), 2013。
其他论文
- P. Flajolet, “Approximate Counting: A Detailed Analysis”, BIT 25(1):113–134, 1985。
- J. Nelson, H. Yu, “Optimal Bounds for Approximate Counting”, PODS 2022, pp. 119–127, DOI 10.1145/3517804.3526225。
- B. Kalyanasundaram, G. Schnitger, “The Probabilistic Communication Complexity of Set Intersection”, SIAM J. Discrete Math. 5(4):545–557, 1992。
- Z. Bar-Yossef, T. S. Jayram, R. Kumar, D. Sivakumar, “An Information Statistics Approach to Data Stream and Communication Complexity”, JCSS 68(4):702–732, 2004。初版 FOCS 2002, pp. 209–218。
- A. Chakrabarti, S. Khot, X. Sun, “Near-Optimal Lower Bounds on the Multi-Party Communication Complexity of Set Disjointness”, CCC 2003, pp. 107–117。
- P. Indyk, D. Woodruff, “Tight Lower Bounds for the Distinct Elements Problem”, FOCS 2003, pp. 283–288。
- A. Chakrabarti, O. Regev, “An Optimal Lower Bound on the Communication Complexity of Gap-Hamming-Distance”, STOC 2011, pp. 51–60;期刊版 SIAM J. Comput. 41(5):1299–1317, 2012。
- J. Feigenbaum, S. Kannan, M. Strauss, M. Viswanathan, “An Approximate L1-Difference Algorithm for Massive Data Streams”, FOCS 1999。
- N. Nisan, “Pseudorandom Generators for Space-Bounded Computation”, Combinatorica 12(4):449–461, 1992。
- A. C. Gilbert, Y. Kotidis, S. Muthukrishnan, M. J. Strauss, “Surfing Wavelets on Streams: One-Pass Summaries for Approximate Aggregate Queries”, VLDB 2001。
- W. B. Johnson, J. Lindenstrauss, “Extensions of Lipschitz Mappings into a Hilbert Space”, Contemporary Mathematics 26:189–206, 1984, DOI 10.1090/conm/026/737400。
- M. Charikar, K. Chen, M. Farach-Colton, “Finding Frequent Items in Data Streams”, TCS 312(1):3–15, 2004。初版 ICALP 2002。
- G. Cormode, S. Muthukrishnan, “An Improved Data Stream Summary: The Count-Min Sketch and Its Applications”, J. Algorithms 55(1):58–75, 2005。
- M. Thorup, Y. Zhang, “Tabulation-Based 5-Independent Hashing with Applications to Linear Probing and Second Moment Estimation”, SIAM J. Comput. 41(2):293–331, 2012。
- P. Flajolet, É. Fusy, O. Gandouet, F. Meunier, “HyperLogLog: the analysis of a near-optimal cardinality estimation algorithm”, AofA 2007, DMTCS Proceedings AH, pp. 127–146。
- J. S. Vitter, “Random Sampling with a Reservoir”, ACM TOMS 11(1):37–57, 1985。
- A. Z. Broder, “On the Resemblance and Containment of Documents”, SEQUENCES 1997, pp. 21–29。
- M. S. Charikar, “Similarity Estimation Techniques from Rounding Algorithms”, STOC 2002, pp. 380–388。
- J. Misra, D. Gries, “Finding Repeated Elements”, Science of Computer Programming 2(2):143–152, 1982。
- A. Metwally, D. Agrawal, A. El Abbadi, “Efficient Computation of Frequent and Top-k Elements in Data Streams”, ICDT 2005, LNCS 3363, pp. 398–412。
- G. Cormode, A. Mishra, J. Ross, P. Veselý, “Theory meets Practice at the Median: A Worst Case Comparison of Relative Error Quantile Algorithms”, KDD 2021, pp. 2722–2731。
- M. Datar, A. Gionis, P. Indyk, R. Motwani, “Maintaining Stream Statistics over Sliding Windows”, SIAM J. Comput. 31(6):1794–1813, 2002。
- J. Feigenbaum, S. Kannan, A. McGregor, S. Suri, J. Zhang, “On Graph Problems in a Semi-Streaming Model”, TCS 348(2–3):207–216, 2005。初版 ICALP 2004。
- K. J. Ahn, S. Guha, A. McGregor, “Analyzing Graph Structure via Linear Measurements”, SODA 2012, pp. 459–467。
- Y. Li, H. L. Nguyen, D. P. Woodruff, “Turnstile Streaming Algorithms Might as Well Be Linear Sketches”, STOC 2014, pp. 174–183, DOI 10.1145/2591796.2591812。
- Y. Ai, W. Hu, Y. Li, D. P. Woodruff, “New Characterizations in Turnstile Streams with Applications”, CCC 2016。
- J. Kallaugher, E. Price, “Separations and Equivalences between Turnstile Streaming and Linear Sketching”, STOC 2020, pp. 1223–1236;arXiv:1905.02358。
- M. Hardt, D. P. Woodruff, “How Robust Are Linear Sketches to Adaptive Inputs?”, STOC 2013, pp. 121–130, DOI 10.1145/2488608.2488624。
- O. Ben-Eliezer, R. Jayaram, D. P. Woodruff, E. Yogev, “A Framework for Adversarially Robust Streaming Algorithms”, PODS 2020;期刊版 JACM 69(2), 2022, DOI 10.1145/3498334;arXiv:2003.14265。
- H. Kaplan, Y. Mansour, K. Nissim, U. Stemmer, “Separating Adaptive Streaming from Oblivious Streaming Using the Bounded Storage Model”, CRYPTO 2021, pp. 94–121。
- K. G. Paterson, M. Raynal, “HyperLogLog: Exponentially Bad in Adversarial Settings”, IEEE EuroS&P 2022, pp. 154–170。
- S. Pettie, D. Wang, “Information Theoretic Limits of Cardinality Estimation: Fisher Meets Shannon”, STOC 2021, pp. 556–569。
书与综述
- S. Muthukrishnan, “Data Streams: Algorithms and Applications”, Foundations and Trends in Theoretical Computer Science 1(2):117–236, 2005。
- G. Cormode, K. Yi, Small Summaries for Big Data, Cambridge University Press, 2020, DOI 10.1017/9781108769938。
实验
reproduce/ams_f2.c:AMS 与分桶 \(F_2\) sketch(\(\mathrm{GF}(2^{61}-1)\) 上的 4-wise / 2-wise 多项式哈希)。./ams_f2 test是第五节的线性性自测,输出见reproduce/results/selftest.txt;./ams_f2 sweep zipf|uniform 1000 1是第四节的误差扫描,输出见reproduce/results/sweep_zipf.csv与sweep_uniform.csv。reproduce/run.sh:编译(含 ASan/UBSan 构建)并运行以上全部实验,默认绑定 CPU 2;reproduce/plot_ams.py:由 CSV 画出第四节的误差图。
系列导航: - 上一篇:频率估计与 Heavy Hitter:Misra-Gries、Space-Saving 与空间下界 - 下一篇:KD-tree:切分规则、回溯剪枝与维度增长下的失效边界
相关阅读: - HyperLogLog:从概率计数到 Redis 实现的基数估计 - Count-Min Sketch:点查询误差界、保守更新与生产实现 - t-digest:缩放函数、合并与尾部分位数误差
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
HyperLogLog:从概率计数到 Redis 实现的基数估计
12 KB 的 HyperLogLog 误差从哪来:沿 FM85、LogLog、HLL、HLL++ 到 Ertl 估计器推导,用 1000 次模拟实测各代估计器在小、中、大基数上的偏差,并对照 Redis 7.2.5 源码拆解稀疏/密集编码和三次更换的估计公式。
Count-Min Sketch:点查询误差界、保守更新与生产实现
Count-Min Sketch 的误差是 εN 的加性界而非相对误差。本文核对原论文定理条件,用 Zipf 实验比较标准更新、保守更新、count-mean-min 与 Count Sketch,并对照 RedisBloom、DataSketches、Caffeine 源码。
t-digest:缩放函数、合并与尾部分位数误差
t-digest 用缩放函数限制质心大小,换来极小的尾部秩误差,但没有最坏情形保证。本文对照 Dunning 与 Ertl 预印本及 Elasticsearch、ClickHouse 源码,用可复现实验测量尾部误差与合并顺序的影响,并复现让误差达到约 40% 的困难分布。
频率估计与 Heavy Hitter:Misra-Gries、Space-Saving 与空间下界
m 个计数器能把流中频率估到多准?核对 Misra-Gries、Lossy Counting、Space-Saving 的定理与两种下界,证明 MG 与 SS 同构,用 Zipf 流实测 top-100 召回与误差,对照 DataSketches、ClickHouse、RedisBloom 源码。