要统计每个 URL、每个源 IP 或每个缓存 key 出现了多少次,最直接的做法是一张哈希表;但 key 的种类可能上亿,内存却是固定的几 KB 到几 MB。Count-Min Sketch(以下简称 CM sketch)用一个 \(d \times w\) 的计数器矩阵回答”key \(i\) 出现了多少次”,空间与 key 的种类数无关。
关于它,流传较广的说法有三条,都需要修正:
- “误差 1%”是相对误差。 不是。论文保证的是加性误差 \(\varepsilon \|a\|_1\),也就是流总量的 \(\varepsilon\) 倍。第四节的实验里,1000 万次更新、\(\varepsilon \approx 0.01\) 的 sketch 对 Zipf(\(z=0.8\)) 流的每个 key 平均多算约 3 万次,而绝大多数 key 的真实计数只有个位数到几十。
- “CM sketch 不支持删除”。 原论文把带删除的 turnstile 模型分成两种:计数始终非负时,取最小值的估计仍然成立;计数可以为负时,要改取中位数,误差界变成 \(3\varepsilon\|a\|_1\)。
- “生产实现就是论文里的参数”。 RedisBloom v8.10.1 用 \(w = \lceil 2/\varepsilon \rceil\)、\(d = \lceil \log_2(1/\delta) \rceil\);Caffeine v3.2.4 用 4 位计数器、固定 4 行、周期性减半;Apache DataSketches C++ 5.2.0 头文件里的误差方向注释与论文定理相反。
本文先把定理和它依赖的条件讲清楚,再用可复现的实验看 Zipf 输入下的误差分布,然后讨论保守更新(conservative update)、count-mean-min、Count Sketch 三种改进各自在什么条件下更好,最后对照三个生产实现的源码。确定性的 heavy hitter 算法(Misra-Gries、Space-Saving)与空间下界见频率估计的理论极限,AMS sketch 与”线性投影”的统一视角见流式算法总论,TinyLFU 作为缓存准入策略的行为见页面置换算法。
一、问题模型与误差口径
数据流模型
Cormode 和 Muthukrishnan 沿用了 Muthukrishnan 数据流综述里的记号:流隐式地维护一个向量 \(a = (a_1, \ldots, a_n)\),初始为零;第 \(t\) 个更新 \((i_t, c_t)\) 表示 \(a_{i_t} \leftarrow a_{i_t} + c_t\)。按 \(c_t\) 的取值分三种情况:
| 模型 | 更新 \(c_t\) | 对 \(a\) 的约束 | 例子 |
|---|---|---|---|
| 现金登记(cash register) | \(c_t > 0\) | \(a_i \ge 0\) | 请求计数、字节计数 |
| turnstile,非负情形(non-negative case) | 可正可负 | 应用保证任何时刻 \(a_i \ge 0\) | 带撤销的计数、窗口内减去过期事件 |
| turnstile,一般情形(general case) | 可正可负 | \(a_i\) 可以为负 | 两个流的差分 \(a - b\) |
表中两种 turnstile 情形的名称取自论文第 2 节;很多文献把前者称为 strict turnstile。
点查询与 \((\varepsilon, \delta)\) 保证
点查询(point query)\(Q(i)\) 要求返回 \(a_i\) 的近似值 \(\hat a_i\)。误差用 \(L_1\) 范数度量:
\[ \|a\|_1 = \sum_{i=1}^{n} |a_i|. \]
在单位更新的现金登记模型里,\(\|a\|_1\) 就是流长度 \(N\)。CM sketch 的保证是:对任意一个固定的 \(i\),
\[ a_i \le \hat a_i, \qquad \Pr\!\left[\hat a_i > a_i + \varepsilon \|a\|_1\right] \le \delta. \]
两个细节决定了它在工程里怎么用:
- 误差是加性的。 对 \(a_i \gg \varepsilon\|a\|_1\) 的高频 key,相对误差很小;对 \(a_i\) 远小于 \(\varepsilon\|a\|_1\) 的 key,估计值可能完全由碰撞噪声构成。
- \(\delta\) 是单次查询的失败概率。 如果要让 \(n\) 个 key 同时满足误差界,需要按并集界把 \(\delta\) 换成 \(\delta/n\),也就是 \(d = \lceil \ln(n/\delta) \rceil\)。论文第 5.2 节在线找 heavy hitter 时,每来一个更新就查询一次,于是对全部 \(\|a\|_1\) 次查询做并集界,空间相应变为 \(O(\frac{1}{\varepsilon}\log\frac{\|a\|_1}{\delta})\)(Theorem 6)。
二、结构、更新与查询
定义
论文第 3 节给出的结构只有三样东西:
- 一个 \(d\) 行 \(w\) 列的计数器数组 \(\mathrm{count}[1..d][1..w]\),初始为零;
- \(d\) 个哈希函数 \(h_1, \ldots, h_d : \{1..n\} \to \{1..w\}\),各自从一个两两独立(pairwise independent)的哈希族里均匀随机选出;
- 参数 \(w = \lceil e/\varepsilon \rceil\),\(d = \lceil \ln(1/\delta) \rceil\)。
更新 \((i_t, c_t)\) 时,每一行加一次:
\[ \mathrm{count}[j][h_j(i_t)] \leftarrow \mathrm{count}[j][h_j(i_t)] + c_t, \qquad j = 1, \ldots, d. \]
非负情形下的点查询取 \(d\) 个格子的最小值:
\[ \hat a_i = \min_{1 \le j \le d} \mathrm{count}[j][h_j(i)]. \]
名字就来自这两步:“counting first and computing the minimum next”。每一行都是一个把 \(n\) 个 key 随机分进 \(w\) 个桶的计数器,某个格子的值等于 \(a_i\) 加上所有与 \(i\) 同桶的 key 的计数之和;只要计数非负,每一行都只会多算不会少算,所以取最小值是离真实值最近的那一行。
一个手算例子
下图用 \(d = 3\)、\(w = 6\)
的小矩阵演示。为了便于手算,哈希值是人为指定的:\(h(A) = (1, 0, 3)\),\(h(B) = (4, 2, 5)\),\(h(C) = (1, 5, 0)\),\(h(D) = (3, 2,
3)\);另有一个从未插入的 \(X\),\(h(X) = (1, 2, 3)\)。流为
A B A C D A B A,真实计数 \(A=4\)、\(B=2\)、\(C=1\)、\(D=1\)。
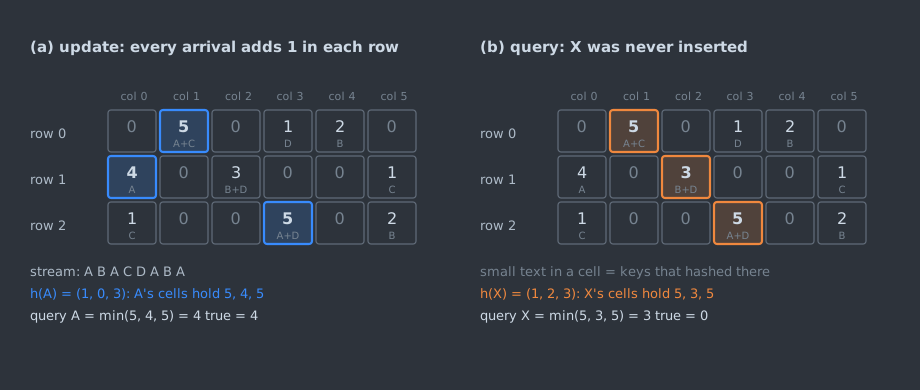
左图中 \(A\) 的三个格子里,第 0 行被 \(C\) 碰撞、第 2 行被 \(D\) 碰撞,只有第 1 行是干净的,最小值恰好等于真实值。右图的 \(X\) 从没出现过,但它在三行里分别撞上了 \(A{+}C\)、\(B{+}D\)、\(A{+}D\),最小值是 3。这就是 CM sketch 误差的全部来源:每一行都有碰撞时,最小值也是高估。例子的数值由 reproduce/example.py 生成,输出见 reproduce/results/example.txt。
两两独立哈希的实现
论文对哈希族只引用了 Motwani 与 Raghavan 的《Randomized Algorithms》。最常用的构造是 Carter 与 Wegman 的线性同余族:取素数 \(p \ge n\),随机选 \(a \in [1, p-1]\)、\(b \in [0, p-1]\),令
\[ h(x) = \big((a x + b) \bmod p\big) \bmod w . \]
每个哈希函数只需存两个字,这也是论文把空间写成 \((2 + e/\varepsilon)\ln(1/\delta)\) 个字的原因:每行 \(w\) 个计数器加 2 个哈希参数。取 \(p = 2^{61}-1\) 时,模运算可以用移位和加法完成。下面的代码摘自本文实验程序 reproduce/cms_sim.c,省略了内存分配:
#define P61 ((1ULL << 61) - 1)

static uint64_t mod61(__uint128_t z)
{
    uint64_t r = (uint64_t)(z & P61) + (uint64_t)(z >> 61);
    r = (r & P61) + (r >> 61);
    return r >= P61 ? r - P61 : r;
}

static uint64_t ph_eval(PairHash h, uint64_t x)
{
    return mod61((__uint128_t)h.a * x + h.b);
}

static int64_t *cell(const Sketch *sk, int i, uint64_t x)
{
    return &sk->c[(size_t)i * sk->w + ph_eval(sk->h[i], x) % (uint64_t)sk->w];
}

static void cm_update(Sketch *sk, uint64_t x, int64_t c)
{
    for (int i = 0; i < sk->d; i++) *cell(sk, i, x) += c;
}

static int64_t cm_query(const Sketch *sk, uint64_t x)
{
    int64_t m = INT64_MAX;
    for (int i = 0; i < sk->d; i++) {
        int64_t v = *cell(sk, i, x);
        if (v < m) m = v;
    }
    return m;
}
最后的 \(\bmod w\) 会让碰撞概率从 \(1/w\) 略微偏离(\(p\) 不是 \(w\) 的整数倍时,有的桶多分到一个余数),偏差量级为 \(w/p\),在 \(p = 2^{61}-1\) 时可以忽略。生产实现通常换成 MurmurHash 一类的通用哈希加每行不同的种子(第八节),这时两两独立性不再有证明,只能靠经验。
参数与内存
每个计数器按 4 字节计,两种参数化的规模如下。RedisBloom
一列按它的 CMS_DimFromProb 计算(第八节):
| \(\varepsilon\) | \(\delta\) | 论文 \(w \times d\) | 论文内存 | RedisBloom \(w \times d\) | RedisBloom 内存 |
|---|---|---|---|---|---|
| 0.01 | 0.01 | \(272 \times 5\) | 5,440 B | \(200 \times 7\) | 5,600 B |
| 0.001 | 0.01 | \(2{,}719 \times 5\) | 54,380 B | \(2{,}000 \times 7\) | 56,000 B |
| 0.001 | 0.001 | \(2{,}719 \times 7\) | 76,132 B | \(2{,}000 \times 10\) | 80,000 B |
| 0.0001 | 0.001 | \(27{,}183 \times 7\) | 761,124 B | \(20{,}000 \times 10\) | 800,000 B |
注意 \(e/0.001 = 2718.28\),向上取整是 2719。空间只与 \(\varepsilon\)、\(\delta\) 有关,与 key 的种类数 \(n\) 和流长度无关;但误差是 \(\varepsilon\|a\|_1\),流越长,绝对误差越大。
三、误差界:证明与它依赖的条件
Theorem 1 的证明
定理(论文 Theorem 1,非负情形):\(a_i \le \hat a_i\),且以至少 \(1-\delta\) 的概率 \(\hat a_i \le a_i + \varepsilon\|a\|_1\)。
证明只有三步。对第 \(j\) 行,定义碰撞噪声
\[ X_{i,j} = \sum_{k \ne i} \mathbf{1}\big[h_j(k) = h_j(i)\big]\, a_k , \]
于是 \(\mathrm{count}[j][h_j(i)] = a_i + X_{i,j}\)。
- 下界。 所有 \(a_k \ge 0\),所以 \(X_{i,j} \ge 0\),每一行都不低于 \(a_i\),最小值也不低于 \(a_i\)。
- 期望。 由两两独立性,对 \(k \ne i\) 有 \(\Pr[h_j(k) = h_j(i)] = 1/w \le \varepsilon/e\),由期望的线性性 \[ \mathbb{E}[X_{i,j}] \le \frac{\varepsilon}{e} \sum_{k \ne i} a_k \le \frac{\varepsilon}{e}\|a\|_1 . \]
- Markov 与行独立。 \(X_{i,j}\) 非负,Markov 不等式给出 \(\Pr[X_{i,j} > \varepsilon\|a\|_1] \le \Pr[X_{i,j} > e\,\mathbb{E}X_{i,j}] < 1/e\)。最小值超界意味着 \(d\) 行同时超界,\(d\) 个哈希函数相互独立地选取,所以 \[ \Pr\big[\hat a_i > a_i + \varepsilon\|a\|_1\big] = \prod_{j=1}^{d} \Pr\big[X_{i,j} > \varepsilon\|a\|_1\big] < e^{-d} \le \delta . \]
每个条件在证明里的位置
| 条件 | 用在哪一步 | 去掉之后 |
|---|---|---|
| 所有 \(a_k \ge 0\) | 第 1 步(单边性)和第 3 步(Markov 要求非负) | 最小值可能低于真值,需要改用中位数(第五节) |
| 行内两两独立 | 第 2 步,只用来算碰撞概率 \(1/w\) | 更强的独立性不改进这个界;更弱的哈希则没有证明 |
| 行与行相互独立 | 第 3 步的乘积 | 若各行哈希相关,\(e^{-d}\) 不再成立 |
| 固定的查询 \(i\) | 整个证明 | 对所有 key 同时成立要做并集界 |
证明只用到期望,所以两两独立就够了;这也是论文强调的实践意义:此前 Count Sketch 等结构的分析要算方差再用 Chebyshev,空间依赖 \(1/\varepsilon^2\),CM sketch 直接用 Markov,得到 \(1/\varepsilon\)。
为什么是 \(e\):一般化的 \(b\)
把 \(e\) 换成任意 \(b > 1\):取 \(w = \lceil b/\varepsilon \rceil\),每行超界概率不超过 \(1/b\),取 \(d = \lceil \log_b(1/\delta) \rceil\) 行即可。忽略取整,计数器总数为
\[ wd \approx \frac{b}{\varepsilon}\cdot\frac{\ln(1/\delta)}{\ln b} = \frac{b}{\ln b}\cdot\frac{\ln(1/\delta)}{\varepsilon}, \]
\(b/\ln b\) 在 \(b = e\) 处取最小值 \(e \approx 2.718\)。论文说实现里可以选别的整数 \(b\) 换取更简单的计算(期刊版此处把 \(w\) 印成了 \(\varepsilon/b\),应为 \(b/\varepsilon\))。RedisBloom 选了 \(b = 2\),\(2/\ln 2 \approx 2.885\),计数器数量比 \(b = e\) 多约 6%,第二节参数表里两列的差别就来自这里。
界有多松:逐行实测
第四节主实验(\(N = 10^7\)、\(w = 272\)、\(d = 5\),所以 \(\varepsilon = e/272 \approx 0.01\))顺带统计了每一行的噪声 \(X_{i,j}\) 超过 \(\varepsilon N\) 的比例(对流中出现过的所有 key 和所有行取平均,3 个随机种子取中位数):
| Zipf 参数 \(z\) | 单行超界比例 | Markov 上界 \(1/e\) | 期望频率超过 \(\varepsilon N\) 的 key 数 |
|---|---|---|---|
| 0.8 | 0.0074 | 0.368 | 1 |
| 1.0 | 0.0324 | 0.368 | 6 |
| 1.2 | 0.0477 | 0.368 | 11 |
Markov 不等式对应的是最坏分布:\(X\) 以 \(1/e\) 的概率等于 \(\varepsilon\|a\|_1\)、其余时候为 0。真实的碰撞噪声要么是许多小计数之和(低偏斜时,集中在均值 \(N/w \approx 3.7 \times 10^4\) 附近,很少超过 \(\varepsilon N \approx 10^5\)),要么主要取决于是否撞上少数几个本身就超过 \(\varepsilon N\) 的大 key(高偏斜时,这类 key 有 \(k\) 个,单行超界概率约为 \(k/w\),\(z=1.2\) 时 \(11/272 \approx 0.040\))。频率超过 \(\varepsilon N\) 的 key 至多 \(1/\varepsilon\) 个,\(k/w \le 1/e\),正好与 Markov 界吻合;实际分布远离这个极端,所以界很松。
四、Zipf 输入下的误差实测
实验设置
实验程序 reproduce/cms_sim.c 是单文件 C 程序,所有随机数来自固定种子的 splitmix64,输出确定。
- 数据:key 空间 \(10^6\),从 Zipf(\(z\)) 抽 \(N = 10^7\) 次,\(z \in \{0.8, 1.0, 1.2\}\);排名到 key 编号经过一次随机置换,避免高频 key 恰好是 0、1、2。这与 Cormode 和 Muthukrishnan 在 SDM 2005 论文里的合成数据规模相同。
- sketch:\(d = 5\)、\(w = 272\),即 \(\varepsilon = e/272 \approx 0.01\)、\(\delta = e^{-5} \approx 0.0067\),\(\varepsilon N \approx 99{,}937\);哈希为第二节的 \(p = 2^{61}-1\) 线性同余族。
- 对比方法:标准 CM(取最小值)、保守更新 CU、count-mean-min(CMM)、Count Sketch(CS)。四者使用相同的 \(d \times w\) 计数器和相同的行哈希,CS 另用一组哈希产生 \(\pm 1\) 符号。CU、CMM、CS 的原理放在第六、七节,这里先把数字列在一起。
- 统计:对流中出现过的每个 key 计算 \(|\hat a_i - a_i|\);另查询 \(10^5\) 个从未插入的 key。3 个随机种子,表中为 3 次的中位数。
- 环境:Intel Core i9-12900K,WSL2(Linux
6.6.87.2-microsoft-standard-WSL2),GCC
16.1.1,
-O2,taskset -c 2绑核。完整程序一次运行约 85 秒,三次运行的输出逐字节相同。
| \(z\) | 方法 | 平均 \(\lvert\)误差\(\rvert\) | 中位数 | p99 | 最大 | 超过 \(\varepsilon N\) 的比例 | 低估比例 | Top-100 平均相对误差 | 未插入 key 平均估计 |
|---|---|---|---|---|---|---|---|---|---|
| 0.8 | CM | 30,590 | 30,463 | 35,066 | 49,337 | 0 | 0 | 5.11 | 30,599 |
| 0.8 | CU | 14,578 | 14,583 | 14,587 | 14,594 | 0 | 0 | 1.50 | 14,588 |
| 0.8 | CMM | 3,090 | 3,063 | 7,197 | 125,111 | 0 | 0.858 | 0.51 | 3,081 |
| 0.8 | CS | 1,568 | 1,192 | 6,859 | 64,740 | 0 | 0.501 | 0.29 | 1,561 |
| 1.0 | CM | 20,119 | 19,656 | 27,665 | 74,135 | 0 | 0 | 1.45 | 20,125 |
| 1.0 | CU | 10,765 | 10,771 | 10,774 | 46,466 | 0 | 0 | 0.10 | 10,774 |
| 1.0 | CMM | 10,891 | 11,498 | 17,834 | 257,134 | 0.00010 | 0.950 | 0.78 | 10,899 |
| 1.0 | CS | 2,815 | 1,929 | 14,289 | 225,465 | 0.00002 | 0.501 | 0.19 | 2,798 |
| 1.2 | CM | 8,694 | 8,266 | 15,960 | 62,038 | 0 | 0 | 0.52 | 8,710 |
| 1.2 | CU | 5,035 | 5,023 | 5,119 | 46,336 | 0 | 0 | 0.00 | 5,046 |
| 1.2 | CMM | 22,121 | 23,366 | 28,991 | 801,681 | 0.00046 | 0.979 | 1.33 | 22,134 |
| 1.2 | CS | 2,631 | 1,542 | 18,314 | 510,272 | 0.00017 | 0.501 | 0.14 | 2,609 |
流中出现过的 key 数分别为 961,887、763,031、355,408(种子间中位数)。完整输出见 reproduce/results/output.txt。
标准 CM 的误差长什么样
没有一个 key 超过 \(\varepsilon N\)。 定理允许每个 key 以 \(\delta \approx 0.67\%\) 的概率超界,实测 9 次运行(3 种偏斜各 3 个种子)都是 0,其中误差最大的 key 也只到 \(0.78\,\varepsilon N\)(77,644)。
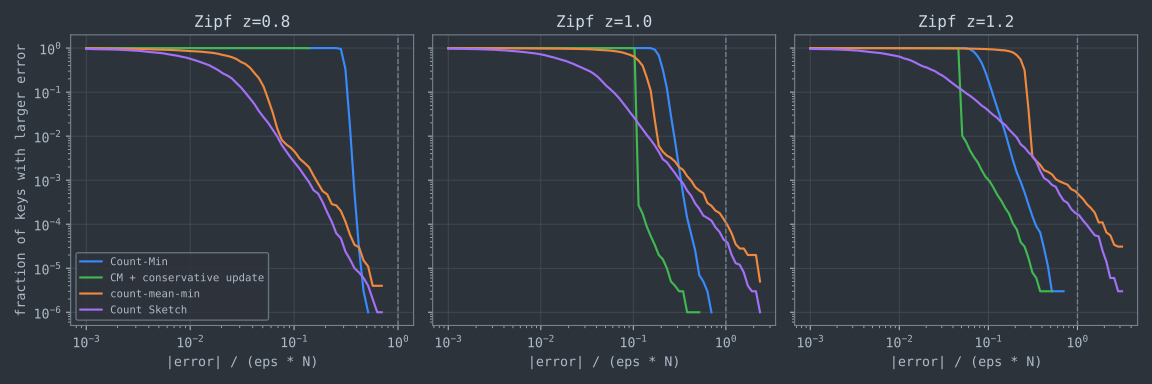
误差几乎与 key 无关。 \(z = 0.8\) 时 CM 误差的中位数是 30,463,p99 是 35,066,未插入的 key 平均也被估成 30,599。每个格子的噪声均值约为 \(N/w \approx 3.7 \times 10^4\),各格子在均值附近波动,最小值只是从 5 个相近的数里挑出最小的一个。下图按误差归一化到 \(\varepsilon N\) 画出互补累积分布,CM 的曲线在 \(0.3\,\varepsilon N\) 附近几乎垂直下落。
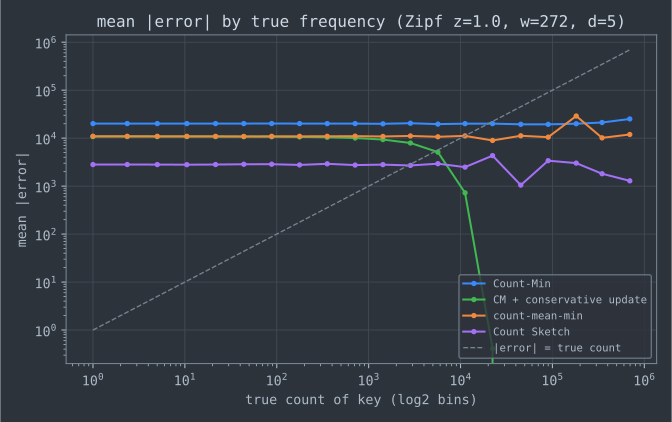
加性误差意味着低频 key 的估计基本不可用。 下图把 \(z = 1.0\)、种子 1 的 key 按真实计数分成 \([2^k, 2^{k+1})\) 的桶,画每桶的平均误差。CM 的误差在所有频率上都约为 \(2 \times 10^4\),与虚线(误差等于真实计数)交于 \(2 \times 10^4\) 附近;763,031 个 key 中只有 43 个计数不低于 \(2^{14} = 16{,}384\),其余 key 所在的桶里,平均误差都大于这个桶的平均真实计数。Top-100 的平均相对误差在 \(z = 0.8\) 时达到 5.11,也就是说连前 100 名的估计平均也约为真实值的 6 倍。
偏斜越大,CM 越准。 从 \(z = 0.8\) 到 \(1.2\),平均误差从 30,590 降到 8,694。原因是流量集中到少数大 key 后,它们只污染自己所在的格子,而最小值会避开这些格子,剩下的噪声只来自尾部。Cormode 和 Muthukrishnan 在 SDM 2005 里把这一点做成了定理:对参数 \(z\) 的 Zipf 分布,达到误差 \(\varepsilon\|a\|_1\) 所需空间为 \(O(\varepsilon^{-\min\{1, 1/z\}}\ln(1/\delta))\),\(z > 1\) 时低于 \(O(1/\varepsilon)\),并证明了匹配的下界 \(\Omega(\varepsilon^{-1/z})\)(该文 Theorem 5.1、5.2)。
未插入的 key 全部被估为正数。 三种偏斜下,\(10^5\) 个未插入 key 的 CM 估计都不小于 1。CM sketch 不能代替 Bloom filter 回答”是否出现过”,除非阈值远高于噪声水平。
五、删除与负计数:turnstile 模型
非负情形:最小值仍然成立
CM sketch 是线性的:每个格子等于落进它的所有 key 的当前计数之和,与更新顺序无关。所以只要查询时刻所有 \(a_k \ge 0\),第三节证明的每一步都照样成立,误差界里的 \(\|a\|_1\) 还是删除之后的净总量,而不是插入加删除的流量。
“所有”两个字很关键:条件约束的是整个向量,不只是被查询的 key。如果应用删除了一个从未插入的 key,这个 key 的计数变成负数,与它同桶的其他 key 的格子就会被拉低,最小值可能低于真实值。非负情形是应用层必须保证的全局不变量,sketch 本身无法检查。
一般情形:改用中位数
当 \(a\) 可以为负(例如两个流之差 \(a = f_A - f_B\)),碰撞噪声 \(X_{i,j}\) 可正可负,最小值会系统性地偏向负方向。论文 Theorem 2 改用中位数:
\[ \hat a_i = \operatorname{median}_{1 \le j \le d} \mathrm{count}[j][h_j(i)], \qquad \Pr\big[\,|\hat a_i - a_i| > 3\varepsilon\|a\|_1\big] < \delta^{1/4}. \]
证明思路是:\(\mathbb{E}\,|X_{i,j}| \le \frac{\varepsilon}{e}\|a\|_1\),由 Markov 不等式,单行误差超过 \(3\varepsilon\|a\|_1\) 的概率小于 \(\frac{1}{3e} < \frac{1}{8}\);中位数出错需要至少一半的行出错,Chernoff 界给出 \(\delta^{1/4}\)。代价是误差常数从 1 变成 3、失败概率从 \(\delta\) 变成 \(\delta^{1/4}\),并且失去了单边性。
实测
这组实验用两个独立的 Zipf(1.0) 流 \(A\)、\(B\),各 \(10^6\) 次抽样,key 空间 \(10^5\),sketch 仍为 \(d = 5\)、\(w = 272\)。非负情形统计 \(A\) 中出现过的 key,一般情形统计 \(A\) 或 \(B\) 中出现过的 key。非负情形先插入 \(A\),再把每个 key 删掉 \(\lfloor a_i/2 \rfloor\) 次;一般情形取 \(a = f_A - f_B\)。表中为 3 个种子的中位数:
| 情形 | 估计方法 | 低估比例 | 超过 \(\varepsilon\lVert a\rVert_1\) | 超过 \(3\varepsilon\lVert a\rVert_1\) | 平均 \(\lvert\)误差\(\rvert\) |
|---|---|---|---|---|---|
| 非负(\(\lVert a\rVert_1 \approx 5.2 \times 10^5\)) | 最小值 | 0 | 0 | 0 | 934 |
| 非负 | 中位数 | 0 | 0.0004 | 0 | 1,340 |
| 非负 | Count Sketch | 0.499 | 0 | 0 | 168 |
| 一般(\(\lVert a\rVert_1 \approx 1.7 \times 10^6\)) | 最小值 | 0.972 | 0.0716 | 0.0216 | 6,199 |
| 一般 | 中位数 | 0.516 | 0.0001 | 0 | 666 |
| 一般 | Count Sketch | 0.498 | 0.0001 | 0 | 646 |
非负情形下,最小值没有一次低估,而且比中位数更准;换成中位数只会白白丢掉单边性。一般情形下,最小值有 97% 的 key 被低估,7% 的 key 误差超过 \(\varepsilon\|a\|_1\),2% 超过 \(3\varepsilon\|a\|_1\),这时的估计已经不可用;改用中位数后误差回到界内,平均误差与 Count Sketch 接近。
生产实现怎么处理负数
- RedisBloom v8.10.1
直接拒绝负增量:
rm_cms.c在解析CMS.INCRBY参数时遇到负数返回CMS: Number cannot be negative,计数器是uint32_t,只支持现金登记模型。 - Apache DataSketches C++ 5.2.0 的
update接受负权重,_total_weight累加的是 \(|\)weight\(|\),但get_estimate始终取最小值,get_lower_bound直接返回这个最小值。这只在非负情形下正确;如果调用方传入的负权重让某个计数变成负数,估计值会像上表的”一般情形 + 最小值”那样大面积低估,get_lower_bound与get_upper_bound(最小值加 \(\varepsilon W\))都可能不再包住真实值,接口不会给出任何提示。
六、保守更新与 count-mean-min
保守更新:只把最小的格子抬上去
保守更新比 CM sketch 还早。Estan 和 Varghese 在 SIGCOMM 2002 的 multistage filter 里提出了”conservative update of counters”(该文 3.3.2 节):multistage filter 的每一级是一个用独立哈希索引的计数器数组,并行的各级合起来在结构上与 CM sketch 相同,只是用来判断一个网络流是否超过阈值。他们的实验中,保守更新让假阳性最多减少到原来的约 1/20,级数越多改进越大。Cohen 和 Matias 在 SIGMOD 2003 的 Spectral Bloom Filter 里把同一思路称为 Minimal Increase,TinyLFU 论文则称为 Minimal Increment。
规则是:更新 \((i, c)\)、\(c > 0\) 时,先读出 \(d\) 个格子的最小值 \(m\),再把每个格子抬到至少 \(m + c\):
\[ \mathrm{count}[j][h_j(i)] \leftarrow \max\big(\mathrm{count}[j][h_j(i)],\ m + c\big), \qquad m = \min_{j} \mathrm{count}[j][h_j(i)]. \]
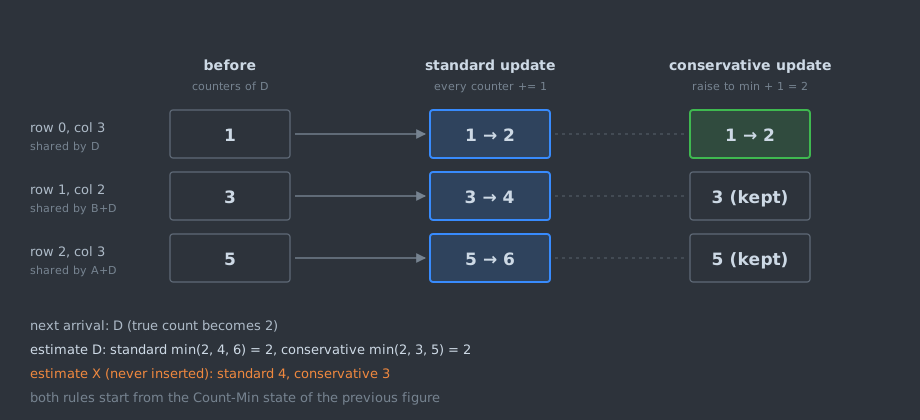
上图接着第二节的例子再来一个 \(D\):标准更新把三个格子都加 1;保守更新只需要让 \(D\) 的估计变成 2,所以只动第 0 行,另外两个格子已经不低于 2,保持不变。与 \(D\) 共享格子的 \(X\) 因此少被高估一次。
它为什么仍然安全:对任何 key \(i\),其 \(d\) 个格子的最小值始终不低于 \(a_i\)。更新 \(i\) 本身之后,最小值至少是 \(m + c \ge a_i + c\);更新其他 key 只会让格子变大。又因为每个格子在保守更新下的增量不超过标准更新下的增量,用同一组哈希时,保守更新的每个格子都不大于 CM 的对应格子,估计值夹在真实值和 CM 估计之间。实验程序在 9 组运行中对流里出现过的每个 key 都检查了”\(a_i \le \hat a_i^{\mathrm{CU}} \le \hat a_i^{\mathrm{CM}}\)“,没有例外。
代价有三条,都来自它不再是线性映射:
- 结果依赖更新顺序。 同样的多重集合,以不同顺序到达会得到不同的矩阵。实验里 CM 可以直接用每个 key 的汇总计数一次性更新,CU 则必须逐条重放 \(10^7\) 次更新。
- 不能删除。 一个格子被抬高时,并不知道是哪个 key 造成的;对 \(i\) 做减法时如果把 \(d\) 个格子都减 \(c\),可能把与 \(i\) 同桶的其他 key 的最小值减到真实值以下。
- 合并只剩上界。 两个 CU sketch 逐格相加后,最小值仍不低于真实值之和,但结果不等于对合并流做保守更新,也会损失一部分保守更新带来的收益。
保守更新的实测表现
第四节的表格里,CU 的平均误差在三种偏斜下都约为 CM 的一半到六成(14,578 对 30,590、10,765 对 20,119、5,035 对 8,694)。更醒目的是误差的形状:
- 低频 key 被估成同一个”底”。 \(z = 0.8\) 时 CU 误差的中位数、p99、最大值分别是 14,583、14,587、14,594,未插入 key 的平均估计是 14,588。保守更新让低频格子一起涨到相近的水平,任何只落在这些格子里的 key 都被估成这个水平。
- 高频 key 几乎精确。 按频率分桶的图里,\(z = 1.0\) 时计数超过约 \(1.6 \times 10^4\) 的 key,CU 的平均误差降到 1 以下;\(z = 1.2\) 时 Top-100 的平均相对误差小于 \(10^{-4}\)。
因此保守更新特别适合 heavy hitter 检测和缓存准入这类”只关心大 key”的场景;对长尾 key,它和 CM 一样只能给出一个与 key 无关的噪声水平。
理论进展
CU 的误差分析长期落后于它的应用。Einziger 和 Friedman 在 ICNC 2015 给出了一个形式化分析;Ben Mazziane、Alouf 和 Neglia(Computer Networks 2022)在 i.i.d. 请求假设下推导了 CU 估计误差期望与 CCDF 的上界,并据此给出 heavy hitter 检测精度的估计和参数配置规则。Fusy 和 Kucherov(CIAC 2023)在 key 均匀分布的假设下发现了相变:把每个 key 看成连接 \(d\) 个计数器的一条超边,不同 key 的数量与计数器数量之比低于随机 \(d\)-一致超图的可剥离(peelability)阈值时,CU 的相对误差趋于 0(标准 CM 做不到),高于阈值时则为常数量级;他们的实验同时显示,这个相变并不延伸到 Zipf 等非均匀分布。换句话说,对实际最常见的偏斜输入,CU 至今没有与 CM 同样简洁的误差保证,工程上的选择主要依靠实验。
count-mean-min:减去估计的噪声
Deng 和 Rafiei 的手稿(未正式发表)提出 count-mean-min(CMM):既然每个格子的噪声大约是本行其余计数的平均,就把它减掉。对第 \(j\) 行,令 \(c_j = \mathrm{count}[j][h_j(i)]\),
\[ \hat a_i = \operatorname{median}_{j}\left(c_j - \frac{N - c_j}{w - 1}\right), \]
其中 \(N\) 是流的总量。减去噪声后估计不再单边,所以取中位数而不是最小值。他们的实验结论是:除高度偏斜的数据外,CMM 比 CM 更准。
本文实验复现了这个边界:
- \(z = 0.8\) 时,CMM 平均误差 3,090,只有 CM 的十分之一;
- \(z = 1.0\) 时,CMM 平均误差 10,891,约为 CM 的一半,与 CU 相当,但 95% 的 key 被低估,最大误差 257,134 超过了 \(\varepsilon N\),而 CU 仍然保持单边;
- \(z = 1.2\) 时,CMM 平均误差 22,121,是 CM 的 2.5 倍,98% 的 key 被低估。
原因在噪声估计 \((N - c_j)/(w-1)\) 的假设:它假定其余计数均匀摊在 \(w - 1\) 个格子里。偏斜越大,总量越集中在少数几个格子,大多数格子的真实噪声远低于平均值,CMM 就系统性地减多了。
七、Count Sketch:用符号抵消噪声
结构
Count Sketch 由 Charikar、Chen 和 Farach-Colton 发表在 ICALP 2002,比 CM sketch 的 LATIN 2004 早约两年,CM 论文把它作为主要的对比对象。它同样是 \(d \times w\) 的计数器矩阵,每行多一个两两独立的符号哈希 \(s_j : \{1..n\} \to \{-1, +1\}\):
\[ \mathrm{count}[j][h_j(i)] \leftarrow \mathrm{count}[j][h_j(i)] + s_j(i)\, c, \qquad \hat a_i = \operatorname{median}_{j}\ s_j(i)\,\mathrm{count}[j][h_j(i)]. \]
与 \(i\) 同桶的 key \(k\) 贡献 \(s_j(i)s_j(k)a_k\),符号随机,期望为 0,所以每一行都是 \(a_i\) 的无偏估计,方差不超过 \(\|a\|_2^2 / w\)。取 \(w = O(1/\varepsilon^2)\),由 Chebyshev 不等式每行以常数概率落在 \(\pm\varepsilon\|a\|_2\) 内,再对 \(O(\log(1/\delta))\) 行取中位数。原论文的表述更细:误差由去掉前 \(k\) 个高频 key 之后的尾部平方和 \(\sum_{q > k} n_q^2\) 决定(该文 Lemma 5),因为高频 key 造成的碰撞只污染少数几行,会被中位数投票掉。
与 CM sketch 的对比
| 性质 | CM sketch | Count Sketch |
|---|---|---|
| 更新 | 每行加 \(c\) | 每行加 \(s_j(i)\,c\) |
| 估计 | 最小值(非负情形) | 中位数 |
| 偏差 | 单边高估 | 每行无偏,结果双边 |
| 误差界 | \(\varepsilon\lVert a\rVert_1\),\(w = \lceil e/\varepsilon \rceil\) | \(\varepsilon\lVert a\rVert_2\),\(w = O(1/\varepsilon^2)\) |
| 空间 | \(O(\varepsilon^{-1}\log(1/\delta))\) | \(O(\varepsilon^{-2}\log(1/\delta))\) |
| 一般 turnstile | 需改用中位数,误差常数变为 3 | 原生支持 |
| 每次更新的哈希计算 | \(d\) 次 | \(2d\) 次 |
两者的误差界量纲不同,不能只比较 \(\varepsilon\):\(\|a\|_2 \le \|a\|_1\),所以同样的 \(\varepsilon\) 下 Count Sketch 的保证更强,但代价是宽度从 \(1/\varepsilon\) 变成 \(1/\varepsilon^2\)。给定相同的宽度 \(w\),最坏情况下 CM 的误差量级是 \(\|a\|_1 / w\),Count Sketch 是 \(\|a\|_2/\sqrt{w}\),哪个更小取决于 \(\|a\|_1/\|a\|_2\) 与 \(\sqrt{w}\) 的比较,也就是数据有多偏斜。
相同空间下的实测
下图固定 \(d = 5\),把宽度从 64 扫到 4096,四种方法共用同一条流和同样的行哈希(3 个种子的中位数):
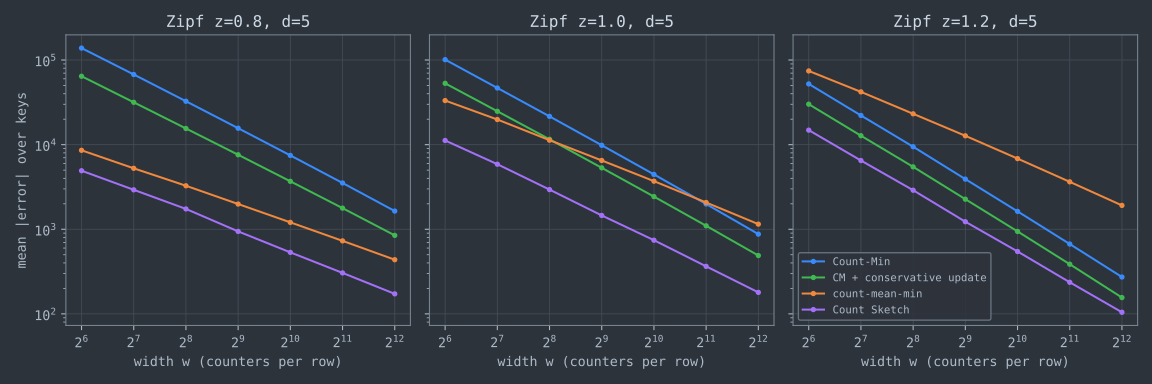
在这个范围里,Count Sketch 的平均误差在每个宽度上都最小,CM 与它的比值随偏斜增大而缩小:\(z = 0.8\) 时从 \(w = 64\) 的 28 倍降到 \(w = 4096\) 的 9.5 倍,\(z = 1.0\) 时从 9.0 倍降到 4.9 倍,\(z = 1.2\) 时从 3.5 倍降到 2.6 倍。按上面的最坏情况量级估算,\(z = 1.2\)、\(w = 272\) 时 \(\|a\|_2/\sqrt{w} \approx 1.35 \times 10^5\),比 \(\|a\|_1/w \approx 3.7 \times 10^4\) 还大,实测的 Count Sketch 平均误差却只有 2,631。这正是 Lemma 5 的尾部表述在起作用:最大的几个 key 撞进来的行会被中位数排除,剩下的方差只来自尾部。
平均误差并不是全部。第四节的表格里,\(z = 1.2\) 时 Count Sketch 的最大误差是 510,272,CM 只有 62,038;p99 也是 CM 略好(15,960 对 18,314)。Count Sketch 的误差分布是主体集中、尾部更长,这一点在第九节还会用到。
八、生产实现:三份源码
以下三份实现分别钉在 RedisBloom v8.10.1(提交
f25aa2f)、Apache DataSketches C++
5.2.0(de8553b)、Caffeine
v3.2.4(836b65c)。
RedisBloom:\(b = 2\) 的参数化
RedisBloom 模块提供
CMS.INITBYDIM、CMS.INITBYPROB、CMS.INCRBY、CMS.QUERY、CMS.MERGE、CMS.INFO
等命令。CMS.INITBYPROB
按误差和概率换算尺寸的函数在 src/cms.c:
void CMS_DimFromProb(double error, double delta, size_t *width, size_t *depth) {
    assert(error > 0 && error < 1);
    assert(delta > 0 && delta < 1);

    *width = ceil(2 / error);
    *depth = ceil(log10f(delta) / log10f(0.5));
}
也就是 \(w = \lceil 2/\varepsilon \rceil\)、\(d = \lceil \log_2(1/\delta) \rceil\),对应第三节一般化公式里的 \(b = 2\):每行超界概率不超过 \(1/2\),\(d\) 行同时超界的概率不超过 \(2^{-d} \le \delta\)。这个选择是正确的,只是比 \(b = e\) 多用约 6% 的计数器。其余要点:
- 哈希:
MurmurHash2(item, itemlen, i),以行号为种子,再对宽度取模。MurmurHash2 不是两两独立族,定理的前提在形式上不成立,实践中通常足够。 - 计数器:
uint32_t,CMS_IncrBy检测到回绕时饱和到UINT32_MAX;更新是标准更新,每行都加,不是保守更新。 - 负数:
rm_cms.c的parseIncrByArgs拒绝负增量(第五节)。 - 合并:
CMS.MERGE支持带权重的逐格加和,checkOverflow先检查结果是否落在 \([0, 2^{32}-1]\)。权重可以为负(源码注释明确允许),可以用来做差分;但它只检查每个格子非负,不检查差分后每个 key 的计数是否非负。只有在被减的流是另一个流的子集这类非负情形下,差分结果上的最小值估计才有第三节的保证。
Apache DataSketches:参数按论文,注释方向相反
C++ 版的 count/include/count_min_impl.hpp
按论文取参数:suggest_num_buckets 返回 \(\lceil e/\varepsilon
\rceil\),suggest_num_hashes 返回 \(\lceil \ln(1/(1-\text{confidence}))
\rceil\)。每行用不同种子调用
MurmurHash3_x64_128,取结果的 h1
字段(64 位)对桶数取模。
问题在接口文档。count_min.hpp 对
suggest_num_buckets 的注释写的是:估计值”never
overestimates the weights but may underestimate the weights
by 5% of the total weight”。这与 Theorem 1
正好相反:非负情形下 CM sketch
从不低估,只可能高估。代码本身是对的:get_upper_bound
返回估计值加 \(\varepsilon
W\),get_lower_bound
返回估计值。另外,第五节提到它接受负权重却仍取最小值,这两处都需要调用方自己保证非负情形。
Caffeine:4 位计数器、块内布局与周期减半
Caffeine 用 FrequencySketch 为 TinyLFU
准入策略提供访问频率的估计。TinyLFU
怎样用这些频率决定淘汰与准入,见页面置换算法;这里只看
sketch 本身。
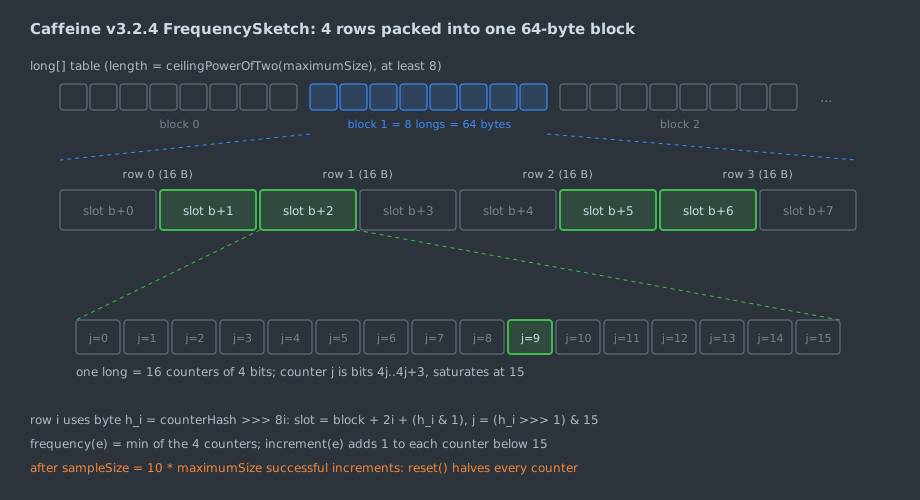
源码里的实现与教科书结构有四处不同:
- 4 位计数器,深度固定为 4。
table是long[],长度为ceilingPowerOfTwo(maximumSize)(至少 8),每个long装 16 个计数器,计数饱和于 15。 - 一个 key 的 4 个计数器限制在同一个 64
字节块里。 先用
blockHash选块,再用counterHash的 4 个字节分别在块内的 4 段(每段两个long)里选计数器。源码注释明确说这”differs from the theoretical ideal”,目的是让一次查询通常只触及一条缓存行。代价是 4 行不再独立:两个 key 只要不在同一块就永远不碰撞,一旦同块,4 行的碰撞是相关的,第三节乘积 \(e^{-d}\) 的前提不再成立。 - 标准更新而非保守更新。
increment对 4 个计数器各调用一次incrementAt,未饱和的都加 1。TinyLFU 论文讨论了 Minimal Increment(即保守更新),Caffeine 的实现没有采用。 - 周期减半(TinyLFU 的 reset)。
每次至少有一个计数器成功加 1 时
size加 1,达到sampleSize = 10 * maximum时调用reset():
void reset() {
    @Var long count = 0;
    for (int i = 0; i < table.length; i++) {
        count += Long.bitCount(table[i] & ONE_MASK);
        table[i] = (table[i] >>> 1) & RESET_MASK;
    }
    size = (int) ((size - (count >>> 2)) >>> 1);
}
(x >>> 1) & 0x7777777777777777L
一次把 16 个 4
位计数器同时右移一位,掩码清掉从相邻计数器移进来的最高位。count
统计奇数计数器的个数,它们在减半时各丢掉 0.5,按每次增量触及
4 个计数器折算,size 先减去
count/4 再减半。
源码注释称这种配置”results in a confidence of 93.75% and an error bound of e / width”。\(93.75\% = 1 - 2^{-4}\) 对应每行失败概率 \(1/2\),即 \(b = 2\) 的参数化,此时误差界应是 \(2/w\);误差 \(e/w\) 对应的是每行失败概率 \(1/e\),4 行的置信度为 \(1 - e^{-4} \approx 98.2\%\)。两个数字分别来自两种参数化,而且都以行独立为前提,第 2 条的块内布局已经不满足这个前提。这些数字更适合当作量级参考。
TiDB:从统计信息里移除 CM sketch
TiDB 开发者指南的”Table Statistics”一章记载:TiDB 曾用 CM sketch 做等值查询的行数估计,点查询采用 count-mean-min;由于高 NDV(不同值很多)的列估计偏差较大,自 5.1 版本起 CM sketch 不再作为默认统计信息收集。这是二手的工程文档,但与第四、六节的实验一致:列的不同值越多,每个低频值得到的估计越接近一个与值无关的噪声水平。
九、争论与开放问题
相同空间下,CM 和 Count Sketch 谁更准
CM 论文的论点是空间从 \(1/\varepsilon^2\) 降到 \(1/\varepsilon\),常数也更小。Cormode 和 Muthukrishnan 在 SDM 2005 里做了直接对比:两者使用尺寸完全相同的计数器矩阵,数据同样是从 \(10^6\) 个值中按 Zipf 抽 \(10^7\) 次,另有文本和网络数据;指标是误差的 99.9 分位数和最大值。结论是 \(z > 1\) 时 CM 更好,在电话呼叫数据上最大误差相差一个数量级。
本文实验得到的是另一面:平均误差上,Count Sketch 在三种偏斜、所有宽度下都更小。两者并不矛盾,差别在指标:
| \(z\) | 平均误差 CM / CS | p99 CM / CS | 最大误差 CM / CS |
|---|---|---|---|
| 0.8 | 30,590 / 1,568 | 35,066 / 6,859 | 49,337 / 64,740 |
| 1.0 | 20,119 / 2,815 | 27,665 / 14,289 | 74,135 / 225,465 |
| 1.2 | 8,694 / 2,631 | 15,960 / 18,314 | 62,038 / 510,272 |
CM 的误差集中在一个很窄的高位区间,Count Sketch 的主体接近 0、尾部很长。关心典型误差(例如查询优化器的行数估计)时 Count Sketch 占优;关心最坏误差或者需要单边上界(例如限流、heavy hitter 报警不能漏报)时 CM 占优,而且偏斜越大 CM 的优势越明显。说”CM 全面优于 Count Sketch”或者反过来,都是只看了一个指标。
深度 \(d\) 该取多少
理论给出 \(d = \lceil \ln(1/\delta) \rceil\),这是为控制单次查询的失败概率服务的。固定总空间时,增加 \(d\) 就要缩小 \(w\),平均误差和尾部误差的最优点并不相同。下表固定 \(d \times w = 2520\)(\(w = 2520/d\)),列出平均误差 / p99(3 个种子的中位数;\(d = 7\) 的数据见输出文件,从略):
| \(z\) | 方法 | \(d=1\) | \(d=2\) | \(d=3\) | \(d=4\) | \(d=5\) | \(d=6\) | \(d=8\) |
|---|---|---|---|---|---|---|---|---|
| 0.8 | CM | 3,957 / 13,200 | 6,556 / 9,914 | 9,611 / 12,335 | 12,753 / 15,422 | 15,918 / 18,690 | 19,114 / 21,955 | 25,578 / 28,634 |
| 0.8 | CU | 3,957 / 13,200 | 4,421 / 4,423 | 5,558 / 5,567 | 6,666 / 6,676 | 7,713 / 7,722 | 8,737 / 8,747 | 10,671 / 10,680 |
| 1.0 | CM | 3,955 / 28,651 | 4,305 / 10,380 | 6,096 / 10,584 | 8,049 / 12,151 | 10,050 / 14,156 | 12,053 / 16,220 | 16,187 / 20,830 |
| 1.0 | CU | 3,955 / 28,651 | 2,943 / 5,381 | 3,758 / 3,754 | 4,615 / 4,621 | 5,429 / 5,437 | 6,214 / 6,223 | 7,771 / 7,781 |
| 1.2 | CM | 3,876 / 38,652 | 1,889 / 7,841 | 2,484 / 6,457 | 3,190 / 6,752 | 3,985 / 7,393 | 4,789 / 8,220 | 6,486 / 10,344 |
| 1.2 | CU | 3,876 / 38,652 | 1,328 / 5,444 | 1,548 / 3,232 | 1,909 / 2,614 | 2,307 / 2,430 | 2,698 / 2,706 | 3,507 / 3,516 |
\(d = 1\) 时 CU 与 CM 完全相同,这是一个自然的正确性检查。标准 CM 的平均误差在 \(d = 1\) 或 \(2\) 时最小,p99 在 \(d = 2\) 或 \(3\) 时最小;CU 的 p99 最优点随偏斜增大而后移,\(z = 1.2\) 时在 \(d = 5\)。按 \(\delta = 0.01\) 取 \(d = 5\) 的标准 CM,平均误差是最优深度的 2 到 4 倍。Aamand、Indyk 和 Vakilian 的预印本(arXiv 1908.05198)对 Zipf 输入下的 CM 做了紧的分析,结论同样是哈希函数个数应取大于 1 的小常数,而不是随 \(1/\delta\) 增长。实践中的折中是:需要可证明的单次失败概率时按 \(\ln(1/\delta)\) 取;已知输入偏斜且更关心平均误差时,用 \(d = 2 \sim 4\) 并把空间让给宽度。
保守更新缺少偏斜输入下的理论
第六节已经提到,CU 在实践中几乎总是更好,但理论只覆盖了均匀分布(Fusy 和 Kucherov 的相变)或 i.i.d. 请求下的上界(Ben Mazziane 等)。对 Zipf 输入,没有像 Theorem 1 那样与数据无关、又能体现 CU 改进幅度的保证;Fusy 和 Kucherov 的实验还表明,均匀分布下的相变在 Zipf 输入下并不出现。这是一个仍然开放的问题。
学习增强的频率估计
Hsu、Indyk、Katabi 和 Vakilian 在 ICLR 2019 提出 learned Count-Min:先用一个学习得到的 heavy hitter 预测器,把预测为高频的 key 放进独占的桶里精确计数,其余 key 进普通 CM sketch。这样高频 key 不再污染其他 key 的格子,仍保留 CM 的单边保证;他们报告在自己的数据集上误差降低 18% 到 71%。Aamand、Chen、Nguyen、Silwal 和 Vakilian 在 NeurIPS 2023 提出了新的算法,在部分参数区间里即使不用预测也优于 Hsu 等人的方法。开放的问题是预测器出错、数据分布漂移时的鲁棒性,以及预测器本身的空间和延迟是否应计入 sketch 的预算。
十、工程上的注意事项与选型
按流量而不是按 key 数定尺寸。 绝对误差是 \(\varepsilon\|a\|_1\)。如果只关心计数不低于阈值 \(T\) 的 key,并希望它们的相对误差不超过 \(r\),就需要 \(\varepsilon \le rT/\|a\|_1\)。流会一直增长时,要么按时间窗口轮换 sketch,要么像 Caffeine 那样周期性衰减,否则误差会随总量线性变大。
不要用它判断低频 key。 第四节里所有未插入的 key 都被估成正数,低频 key 的估计基本是噪声。判断”是否出现过”用 Bloom filter(见 Bloom Filter 家族),精确统计小计数用哈希表。
行哈希要相互独立。 用一次哈希的不同比特段充当多行(Caffeine 的做法)或者各行共用一个种子,都会让各行的碰撞相关。RedisBloom 以行号 \(0, 1, \ldots, d-1\) 作为 MurmurHash2 的种子,种子是公开的;如果 key 可被外部控制,攻击者可以离线构造大量与目标 key 同桶的 key 抬高其估计。对不可信输入,应使用带随机密钥的哈希。
合并要求完全相同的配置。 逐格相加只有在 \(w\)、\(d\)、哈希函数和种子都相同时才有意义;标准 CM 与 Count Sketch 的合并结果等于对拼接流建 sketch,保守更新的合并只剩上界(第六节)。
注意饱和。 RedisBloom 的
uint32_t 计数器在约 \(4.29 \times 10^9\)
处饱和,Caffeine 的 4 位计数器在 15
处饱和。真实计数超过上限的 key
会被低估,单边性只在上限以下成立;Caffeine
的周期减半则是有意让估计值偏离累计计数,它估计的是近期频率。
按需求选择:
| 需求 | 建议 |
|---|---|
| 需要单边上界、可合并,只有插入或非负删除 | 标准 CM,取最小值 |
| 只关心大 key(heavy hitter、缓存准入),只有插入 | 保守更新;也可考虑 Space-Saving 等计数器类算法(见频率估计的理论极限) |
| 计数可能为负(两个流之差) | Count Sketch,或 CM 改取中位数 |
| 关心所有 key 的平均误差,偏斜不高 | Count Sketch;count-mean-min 仅在低偏斜时可用 |
| 频率需要随时间衰减 | 周期性减半(Caffeine、TinyLFU 的 reset)或按窗口轮换 |
十一、参考资料
源码
- RedisBloom v8.10.1(commit
f25aa2faecf718964c49bda18a69a824252c4691):src/cms.c(CMS_DimFromProb()、CMS_IncrBy()、CMS_Query()、checkOverflow()、CMS_Merge()),src/rm_cms.c(parseIncrByArgs()、parseMergeArgs())。 - Apache DataSketches C++ 5.2.0(commit
de8553ba372e618382c2e7b44b0ffc9422b9458c):count/include/count_min.hpp(suggest_num_buckets的接口注释),count/include/count_min_impl.hpp(suggest_num_buckets()、suggest_num_hashes()、get_hashes()、get_estimate()、update()、get_upper_bound()、get_lower_bound())。 - Caffeine v3.2.4(commit
836b65c0a83e5d1641ded9c6de578654bc04b2e9):caffeine/src/main/java/com/github/benmanes/caffeine/cache/FrequencySketch.java(类注释、ensureCapacity()、frequency()、increment()、incrementAt()、reset())。
核心论文
- G. Cormode, S. Muthukrishnan, “An Improved Data Stream Summary: The Count-Min Sketch and Its Applications”, LATIN 2004, LNCS 2976, pp. 29–38;期刊版 Journal of Algorithms 55(1):58–75, 2005, doi:10.1016/j.jalgor.2003.12.001。
- M. Charikar, K. Chen, M. Farach-Colton, “Finding Frequent Items in Data Streams”, ICALP 2002, LNCS 2380, pp. 693–703;期刊版 Theoretical Computer Science 312(1):3–15, 2004。
- C. Estan, G. Varghese, “New Directions in Traffic Measurement and Accounting”, SIGCOMM 2002, pp. 323–336, doi:10.1145/633025.633056。
- G. Cormode, S. Muthukrishnan, “Summarizing and Mining Skewed Data Streams”, SDM 2005, pp. 44–55, doi:10.1137/1.9781611972757.5。
其他论文
- S. Muthukrishnan, “Data Streams: Algorithms and Applications”, Foundations and Trends in Theoretical Computer Science 1(2):117–236, 2005。
- J. L. Carter, M. N. Wegman, “Universal Classes of Hash Functions”, Journal of Computer and System Sciences 18(2):143–154, 1979。
- R. Motwani, P. Raghavan, Randomized Algorithms, Cambridge University Press, 1995。
- S. Cohen, Y. Matias, “Spectral Bloom Filters”, SIGMOD 2003, pp. 241–252, doi:10.1145/872757.872787。
- F. Deng, D. Rafiei, “New Estimation Algorithms for Streaming Data: Count-min Can Do More”, University of Alberta 手稿(未正式发表)。
- G. Einziger, R. Friedman, B. Manes, “TinyLFU: A Highly Efficient Cache Admission Policy”, ACM Transactions on Storage 13(4), 2017, doi:10.1145/3149371。
- G. Einziger, R. Friedman, “A Formal Analysis of Conservative Update Based Approximate Counting”, ICNC 2015, pp. 255–259。
- Y. Ben Mazziane, S. Alouf, G. Neglia, “Analyzing Count Min Sketch with Conservative Updates”, Computer Networks 217:109315, 2022, doi:10.1016/j.comnet.2022.109315。
- É. Fusy, G. Kucherov, “Phase Transition in Count Approximation by Count-Min Sketch with Conservative Updates”, CIAC 2023, LNCS, pp. 232–246, doi:10.1007/978-3-031-30448-4_17;arXiv:2203.15496。
- C.-Y. Hsu, P. Indyk, D. Katabi, A. Vakilian, “Learning-Based Frequency Estimation Algorithms”, ICLR 2019。
- A. Aamand, P. Indyk, A. Vakilian, “(Learned) Frequency Estimation Algorithms under Zipfian Distribution”, arXiv:1908.05198(预印本)。
- A. Aamand, J. Y. Chen, H. L. Nguyen, S. Silwal, A. Vakilian, “Improved Frequency Estimation Algorithms with and without Predictions”, NeurIPS 2023;arXiv:2312.07535。
工程资料
- PingCAP, TiDB Development Guide, “Table Statistics”, https://pingcap.github.io/tidb-dev-guide/understand-tidb/table-statistics.html(二手资料,第八节 TiDB 部分的依据)。
实验
reproduce/cms_sim.c:第四至七节、第九节的全部实验(CM、保守更新、count-mean-min、Count Sketch;Zipf 主实验、宽度扫描、固定空间下的深度扫描、turnstile),gcc -O2 -Wall -Wextra -o cms_sim cms_sim.c -lm && ./cms_sim > results/output.txt,输出见reproduce/results/output.txt。reproduce/example.py:第二、六节手算例子,输出见reproduce/results/example.txt;reproduce/draw_figures.py:由它生成第二、六、八节的三张示意图。reproduce/plot_results.py:由output.txt打印表格数据并画出第四、七节的三张图(需要 matplotlib)。reproduce/run.sh:一次性编译、运行并重画全部图表,用法sh run.sh [带 matplotlib 的 python]。
系列导航: - 上一篇:HyperLogLog:从概率计数到 Redis 实现的基数估计 - 下一篇:t-digest:缩放函数、合并与尾部分位数误差
相关阅读: - 频率估计与 Heavy Hitter:Misra-Gries、Space-Saving 与空间下界 - 流式算法总论:数据流模型、频率矩下界与线性 sketch - 页面置换算法:从 OPT、LRU 到 ARC 与 Linux 页面回收 - Bloom Filter 家族:从位数组到 Ribbon,每键位数离下界还差多少
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
HyperLogLog:从概率计数到 Redis 实现的基数估计
12 KB 的 HyperLogLog 误差从哪来:沿 FM85、LogLog、HLL、HLL++ 到 Ertl 估计器推导,用 1000 次模拟实测各代估计器在小、中、大基数上的偏差,并对照 Redis 7.2.5 源码拆解稀疏/密集编码和三次更换的估计公式。
频率估计与 Heavy Hitter:Misra-Gries、Space-Saving 与空间下界
m 个计数器能把流中频率估到多准?核对 Misra-Gries、Lossy Counting、Space-Saving 的定理与两种下界,证明 MG 与 SS 同构,用 Zipf 流实测 top-100 召回与误差,对照 DataSketches、ClickHouse、RedisBloom 源码。
流式算法总论:数据流模型、频率矩下界与线性 sketch
一遍扫描、内存远小于数据时能算什么:梳理三种流模型、Morris 到 AMS 与 Indyk 的谱系、通信复杂度下界,实测 AMS F2 sketch 误差随计数器数的变化,说明线性 sketch 为何可合并、可删除,并把本系列 30 到 35 篇串成路线图。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。