网关一天处理一千万个请求,想知道最热的 100 个 URL 各被访问了多少次,但只肯给几千个计数器。这是频繁项(frequent items)或 heavy hitter 问题,确定性的答案有三个:Misra-Gries、Lossy Counting 和 Space-Saving。关于它们流传着几种说法:Space-Saving 比 Misra-Gries 准;Space-Saving 不能合并;\(O(1/\varepsilon)\) 个计数器已经是理论极限。第一句只在特定的报告规则下成立,两者其实是同一个摘要换了记账方式;第二句是错的;第三句在”计数器个数”的意义下成立(差一个常数 2),按比特数计算则不成立,2016 年才有比特意义上最优的算法。
本文先给出问题的精确定义,再逐个拆解三个算法的定理和数据结构,证明
Misra-Gries 与 Space-Saving
的同构,然后讲清两种意义下的下界。第七节用
reproduce/ 里的程序在 Zipf 流上实测 top-100
召回率和误差,第八节对照三个生产实现的源码。本文只讨论只插入的流;需要删除、需要查询任意元素时,用的是
Count-Min
Sketch 这类线性
sketch;数据流模型和通信复杂度下界的总体框架见流式算法总论。
一、问题模型
频率估计、heavy hitter 与 top-k
数据流 \(a_1, a_2, \ldots, a_n\) 中每个元素取自大小为 \(u\) 的全集,元素 \(x\) 的频率是 \(f_x = |\{ i : a_i = x \}|\),\(\sum_x f_x = n\)。三个相关问题:
- 频率估计(frequency estimation):对任意 \(x\) 给出 \(\hat f_x\),满足 \(|\hat f_x - f_x| \le \varepsilon n\)。
- \((\varepsilon, \varphi)\)-heavy hitter:给定 \(0 < \varepsilon < \varphi \le 1\),输出一个集合,包含所有 \(f_x \ge \varphi n\) 的元素,且不包含任何 \(f_x \le (\varphi - \varepsilon) n\) 的元素。这是 Bhattacharyya、Dey、Woodruff(PODS 2016)采用的定义。
- top-k:输出频率最高的 \(k\) 个元素。它没有加性误差意义下的保证可言:第 \(k\) 名和第 \(k+1\) 名的频率可能只差 1。
超过 \(\varphi n\) 次的元素最多 \(1/\varphi\) 个,所以候选集本身很小;难点在于流过去之后才知道谁是候选。
为什么必须近似
Karp、Shenker、Papadimitriou(TODS 2003)的 Proposition 2.1 给出了精确版本的代价:任何在线算法,哪怕只要求输出”频率超过 \(\theta n\) 的元素集合”,最坏情况下也需要 \(\Omega(u \log(n/u))\) 比特。证明的思路是:在流的中点,若还没有元素超过阈值,算法必须记住每个元素的精确计数,否则可以构造同一个后半段,让两个不同的前半段得出不同的答案。所以流式算法只能放宽成上面的近似版本。
谱系
flowchart LR
  MJ["MJRTY majority vote<br/>Boyer-Moore, 1981 report"] --> MG["Misra-Gries 1982<br/>k counters"]
  MG --> RD["rediscovered 2002-2003<br/>Demaine et al. / Karp et al."]
  MG --> LC["Lossy Counting<br/>Manku-Motwani 2002"]
  RD --> SS["Space-Saving<br/>Metwally et al. 2005"]
  SS --> CH["experimental survey<br/>Cormode-Hadjieleftheriou 2008"]
  MG --> ME["Mergeable summaries 2012<br/>MG = SS isomorphism"]
  SS --> ME
  ME --> DS["DataSketches<br/>Anderson et al. 2017"]
  MG --> BD["bit-optimal HH<br/>Bhattacharyya et al. 2016"]
Boyer 和 Moore 在 1981 年的技术报告里给出了多数投票算法 MJRTY:一个计数器,一次扫描,找出出现超过一半的元素。Misra 和 Gries 在 1982 年的 Science of Computer Programming 论文里把它推广到多个计数器(论文中的 Algorithm 3),换成本文记号就是:\(k\) 个计数器能找出所有出现超过 \(n/(k+1)\) 次的元素。二十年后,Demaine、López-Ortiz、Munro(ESA 2002)和 Karp、Shenker、Papadimitriou(TODS 2003)在网络测量的背景下各自重新发现了同一个算法,后者在文中注明得知了前者的未发表稿,称其”contains essentially the same algorithm”。Cormode 和 Hadjieleftheriou(PVLDB 2008)的综述梳理了这段历史,并指出出于对最早发现者的尊重,后来的流算法文献称之为 Misra-Gries;该综述自己的实验里把它叫 Frequent。
二、Misra-Gries:一次删掉 k+1 个不同的元素
算法
摘要最多保存 \(k\) 个(元素,计数)对。来一个元素 \(x\):
- \(x\) 已在摘要里:计数加 1。
- 摘要未满:放入 \(x\),计数为 1。
- 摘要已满且不含 \(x\):所有计数减 1,删掉减到 0 的项;\(x\) 本身不存。
第 3 步可以理解成先把 \(x\) 以计数 1 放进来,再把 \(k+1\) 个计数各减 1。被抹掉的是
\(k+1\)
个互不相同元素的各一次出现,整个误差分析都建立在这一点上。reproduce/summaries.c
里的实现:
/* reproduce/summaries.c */
void mg_update(mg_t *s, uint64_t x)
{
    s->n++;
    int32_t i = idx_get(&s->ix, x);
    if (i != NIL) { s->cnt[i]++; return; }
    if (s->size < s->k) {
        s->key[s->size] = x;
        s->cnt[s->size] = 1;
        idx_put(&s->ix, x, s->size++);
        return;
    }
    /* x and the k stored items are k+1 distinct occurrences: drop one of each */
    s->decrements++;
    int j = 0;
    for (int t = 0; t < s->size; t++) {
        if (--s->cnt[t] > 0) { s->key[j] = s->key[t]; s->cnt[j] = s->cnt[t]; j++; }
    }
    s->size = j;
    mg_reindex(s);
}
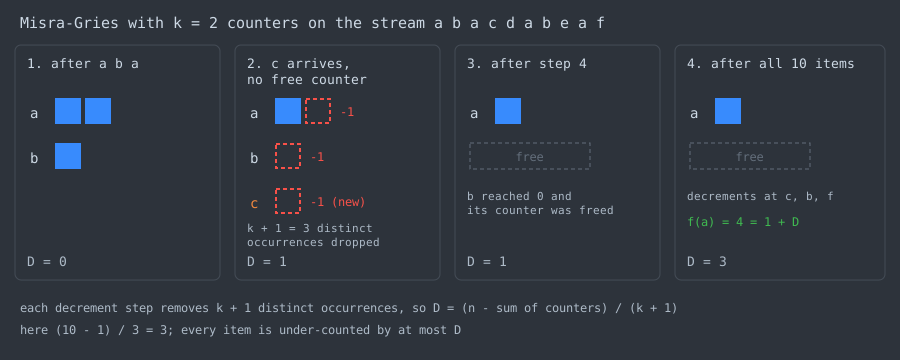
下图是 \(k = 2\) 时处理
a b a c d a b e a f 的过程。第 4 个元素
c
到来时摘要已满,a、b、c
各少一次,b 归零被删;整个流结束时共发生了 3
次扣减。
误差界
记 \(\hat f_x\) 为摘要里 \(x\) 的计数(不在摘要里则为 0),\(\hat n = \sum_x \hat f_x\),\(D\) 为第 3 步发生的次数。Agarwal 等人(PODS 2012,“Mergeable Summaries”)的 Lemma 1 给出了比常见的 \(n/(k+1)\) 更紧的形式:
\[ \hat f_x \;\le\; f_x \;\le\; \hat f_x + \frac{n - \hat n}{k+1}. \]
证明只需两步记账。左边:计数只在 \(x\) 真正出现时增加。右边:每次扣减让计数总和比 \(n\) 少 \(k+1\)(\(k\) 个存量各减 1,外加没存下来的 \(x\)),所以 \(\hat n = n - (k+1)D\),即
\[ D = \frac{n - \hat n}{k+1}. \]
每次扣减中 \(x\) 最多损失 1 次,故 \(f_x - \hat f_x \le D\)。因为 \(\hat n \ge 0\),有 \(D \le n/(k+1)\):凡是 \(f_x > n/(k+1)\) 的元素一定还在摘要里。这也是 Demaine 等人的 Theorem 1:存 \(m\) 个元素的算法能找出所有出现超过 \(n/(m+1)\) 次的元素。
两点在实验里会反复出现:
- \(D\)
是可以精确算出的量。
mg_bound就是 \((n - \hat n)/(k+1)\),reproduce/test_summaries.c在 240 条随机流上检查了整除关系和误差界,没有失败。 - 从第一次出现起就没被删过的元素,每次扣减都会损失 1,所以它的低估恰好等于 \(D\)。越热的元素越可能从头存活,Misra-Gries 对最热元素的误差因此往往正好顶到上界。
要得到 \(\varepsilon n\) 的加性误差,取 \(k \ge 1/\varepsilon\) 即可,此时 \(D \le n/(k+1) < \varepsilon n\)。做 \((\varepsilon,\varphi)\)-heavy hitter 时,报告 \(\hat f_x + D \ge \varphi n\) 的元素:所有 \(f_x \ge \varphi n\) 的都满足这个条件,而报告出来的元素满足 \(f_x \ge \hat f_x \ge \varphi n - D > (\varphi - \varepsilon) n\)。
时间复杂度
第 3 步要扫描全部 \(k\) 个计数,单次 \(O(k)\)。但每减掉一个单位都抵消了之前某次加 1,扣减的总工作量不超过增加的总次数 \(n\),所以摊还 \(O(1)\),另加字典操作。Cormode 和 Hadjieleftheriou 总结了三种实现:Misra 和 Gries 用平衡搜索树,给出摊还 \(O(1)\) 的扣减论证;Karp 等人用哈希表;Demaine 等人用”偏移量加多条链表”的表示把扣减做到最坏情况 \(O(1)\)。实践中字典都是哈希表,所以这些”确定性”算法的实现其实依赖哈希的期望性能。
三、Space-Saving 与 Stream-Summary
算法
Metwally、Agrawal、El Abbadi(ICDT 2005,扩展版 TODS 2006)的 Space-Saving 换了一种处理”满了”的方式:不做全体扣减,而是把计数最小的那一项让给新元素。摘要保存 \(m\) 个三元组(元素,计数 \(c\),误差 \(e\)):
- \(x\) 已在摘要里:\(c_x \mathrel{+}= 1\)。
- 摘要未满:放入 \(x\),\(c_x = 1\),\(e_x = 0\)。
- 摘要已满:找到计数最小的项 \(y\),其计数记为 \(\mu\)。用 \(x\) 替换 \(y\),令 \(c_x = \mu + 1\),\(e_x = \mu\)。
新元素继承了被踢者的计数,这是有意的高估:\(x\) 之前可能出现过,只是没被监视,而它之前出现的次数不会超过 \(\mu\)。
性质
以下编号沿用 Metwally 等人技术报告(UCSB TR 2005-23)。记 \(\min\) 为摘要中的最小计数(未满时视为 0)。
- Lemma 1:每来一个元素恰好有一个计数加 1,所以计数总和始终等于 \(n\)。
- Lemma 2:\(m\) 个计数加起来是 \(n\),最小的那个 \(\min \le \lfloor n/m \rfloor\)。
- Lemma 3:对被监视的元素,\(0 \le e_x \le \min\),并且 \(c_x - e_x \le f_x \le c_x\)。\(c_x - e_x\) 是 \(x\) 最近一次被放入后的出现次数,自然不超过 \(f_x\);\(f_x \le c_x\) 则是因为放入前 \(x\) 未被监视,此前出现的次数不超过当时的最小计数 \(\mu = e_x\)。计数只增不减,所以 \(\min\) 单调不减,\(e_x \le \min\)。
- Theorem 1:\(f_x > \min\) 的元素一定在摘要里。反过来,对未被监视的元素可以取估计值 \(\min\),它满足 \(f_x \le \min\)。
合起来,每个元素的估计值都是高估,且 \(0 \le c_x - f_x \le \min \le n/m\)。取 \(m \ge 1/\varepsilon\) 就得到 \(\varepsilon n\) 误差(Theorem 3)。报告 heavy hitter 时取 \(c_x > \varphi n\) 的项;若还满足 \(c_x - e_x > \varphi n\),就能确定它不是误报。Theorem 2 说明按计数排序后第 \(i\) 个位置的计数不小于真实第 \(i\) 名的频率,这是用它做 top-k 的依据。
Stream-Summary:O(1) 的增量
朴素实现要维护一个按计数排序的结构:用最小堆时每次加 1 是 \(O(\log m)\)。Metwally 等人受 Demaine 等人分组链表的启发设计了 Stream-Summary:
- 一条按计数值升序排列的桶(bucket)双向链表,每个桶只存一个计数值,第一个桶就是 \(\min\);
- 每个桶下挂一条子链表,存放计数等于该值的所有项,每项有指向所在桶的指针;
- 一个哈希索引从元素映射到它所在的项。
下图是 \(m = 3\)
时处理完 a b a c d a b e a
之后的状态,存的计数值只有 2、3、4 三个桶。
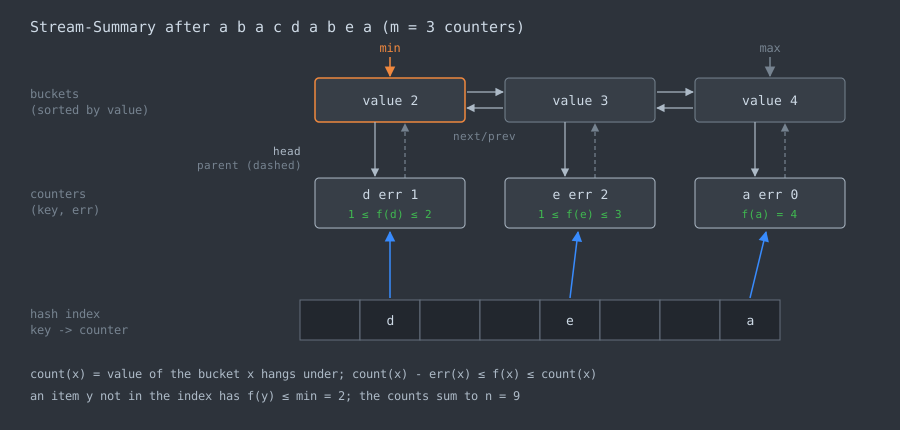
计数加 1 时,项要从值为 \(v\) 的桶移到值为 \(v+1\) 的桶。因为桶按值有序且值连续递增 1,只需要看紧邻的下一个桶:它的值是 \(v+1\) 就挂进去,否则在当前桶后面新建一个值为 \(v+1\) 的桶;原桶空了就删掉。这是 Metwally 等人论文图 2 的过程,全部是常数次指针操作:
/* reproduce/summaries.c */
static void increment(ss_t *s, int32_t ci)
{
    int32_t bk = s->c[ci].bucket;
    int32_t nx = s->b[bk].next;
    int64_t v  = s->b[bk].value + 1;
    detach(s, ci);
    if (nx != NIL && s->b[nx].value == v) attach(s, ci, nx);
    else attach(s, ci, bucket_new(s, v, bk));
    if (s->b[bk].head == NIL) bucket_del(s, bk);
}
替换发生时,从最小桶的子链表里任取一项,改写它的元素和误差,再对它调用一次
increment。下图接着上图,第 10 个元素
f 到来:
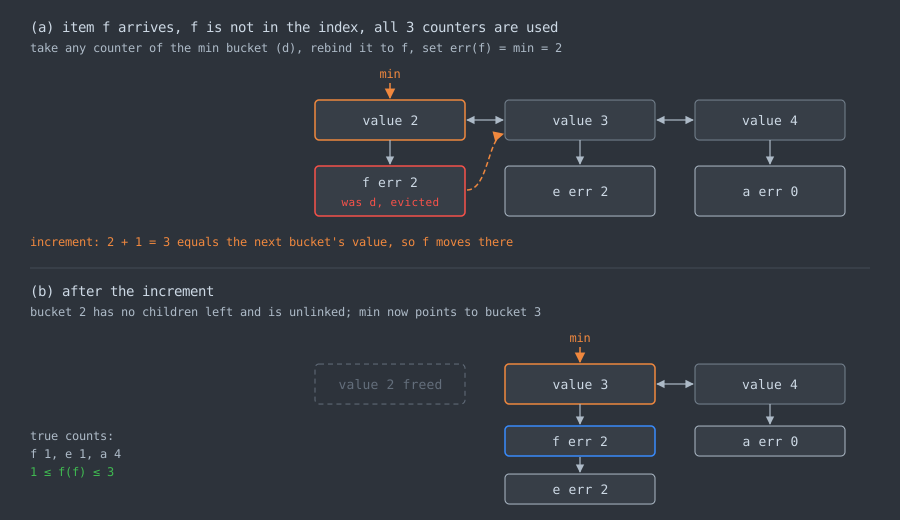
d 所在的桶值为 2,f
接手后误差记为 2、计数变成 3,搬进值为 3 的桶;值为 2
的桶空了被删掉,\(\min\)
变成 3。此时 f 的计数 3 是高估,真实值是
1。
Cormode 和 Hadjieleftheriou 的实验同时实现了两种版本:用 Stream-Summary 的 SSL 和用堆的 SSH。SSL 更快,但因为链表指针,空间约为 SSH 的两倍。第八节会看到 ClickHouse 选了第三条路:有序数组加冒泡式的相邻交换。
四、Misra-Gries 与 Space-Saving 是同一个摘要
逐步对照
把 \(k = 2\) 的
Misra-Gries 和 \(m = 3\) 的
Space-Saving
放在同一条流上逐步运行(reproduce/trace.c,输出在
results/trace.txt)。表中 Space-Saving
的每项写成”计数(误差)“:
| 步 | 元素 | Misra-Gries | \(D\) | Space-Saving | \(\min\) |
|---|---|---|---|---|---|
| 1 | a | a:1 | 0 | a:1(0) | 0 |
| 2 | b | a:1 b:1 | 0 | b:1(0) a:1(0) | 0 |
| 3 | a | a:2 b:1 | 0 | a:2(0) b:1(0) | 0 |
| 4 | c | a:1 | 1 | a:2(0) c:1(0) b:1(0) | 1 |
| 5 | d | a:1 d:1 | 1 | d:2(1) a:2(0) b:1(0) | 1 |
| 6 | a | a:2 d:1 | 1 | a:3(0) d:2(1) b:1(0) | 1 |
| 7 | b | a:1 | 2 | a:3(0) b:2(0) d:2(1) | 2 |
| 8 | e | a:1 e:1 | 2 | e:3(2) a:3(0) d:2(1) | 2 |
| 9 | a | a:2 e:1 | 2 | a:4(0) e:3(2) d:2(1) | 2 |
| 10 | f | a:1 | 3 | a:4(0) f:3(2) e:3(2) | 3 |
每一行都有同一个规律:把 Space-Saving 的每个计数减去
\(\min\)、丢掉不为正的项,得到的正好是
Misra-Gries 的状态,而且 \(\min =
D\)。第 9 步:\(4-2, 3-2,
2-2\) 得到 a:2 e:1;第 10 步:\(4-3, 3-3, 3-3\) 得到
a:1。
同构定理
Agarwal 等人的 Lemma 2 把这个规律写成定理:处理完同一条流后,对任意元素 \(x\),
\[ \hat f_{\mathrm{SS}}(x) - \hat f_{\mathrm{MG}}(x) \;=\; \min{}_{\mathrm{SS}} \;=\; \frac{n - \hat n_{\mathrm{MG}}}{k+1}, \]
其中 Space-Saving 用 \(k+1\) 个计数器,Misra-Gries 用
\(k\)
个,两边的”不在摘要里”分别按 \(\min_{\mathrm{SS}}\) 和 0
计。直观地看,Space-Saving
在最小桶上”抬高地板”的那一刻,对应 Misra-Gries 把所有计数减
1 的那一刻:前者把公共的偏移量 \(\min\)
显式地加在每个计数上,后者把它扣掉,另外记在 \(D\)
里。test_summaries.c 在 240
条随机流(长度、全集大小、\(k\)
都随机,含均匀、偏斜、轮转、分段有序四类)结束时,对全集中每个元素检查了
\(\hat f_{\mathrm{SS}}(x) - \hat
f_{\mathrm{MG}}(x) = \min_{\mathrm{SS}} =
D\),没有例外。
这条等式带来三个推论:
- 两者的误差区间相同。Misra-Gries 给出 \([\hat f, \hat f + D]\),Space-Saving 给出 \([c - \min, c]\),平移 \(D = \min\) 之后是同一个区间。所谓”Space-Saving 更准”,只取决于用区间的哪一端当点估计:Misra-Gries 取下端,Space-Saving 取上端。对从头存活的热门元素,真实值就在上端,所以 Space-Saving 的点估计几乎无误差,而 Misra-Gries 的点估计正好差 \(D\)。第七节的实验会看到这一点。
- Space-Saving 多用一个计数器才等价。\(m\) 个计数器的 Space-Saving 对应 \(m-1\) 个计数器的 Misra-Gries,常数上的差别只有一个计数器。
- Space-Saving 可合并(Corollary 1)。把它转换成 Misra-Gries,用下面的算法合并即可。
合并
两个 Misra-Gries 摘要(各 \(k\) 个计数器,分别处理了 \(n_1\) 和 \(n_2\)
个元素)的合并:对应计数相加,最多得到 \(2k\) 项;取第 \(k+1\) 大的计数 \(C_{k+1}\),所有计数减去它,删掉不为正的项。Agarwal
等人的 Theorem 1 证明合并后的误差仍是 \((n_1 + n_2 - \hat
n_{12})/(k+1)\):剪枝删掉了至少 \((k+1)C_{k+1}\)
的计数总和,而每个元素只多损失 \(C_{k+1}\)。这个界与合并的顺序和树形无关,所以摘要可以在任意多台机器上分别构建,再任意归并。test_summaries.c
对随机切分后的流做了树形归并,检查合并结果对原始整条流仍满足
Lemma 1。
这是可合并摘要(mergeable summaries)框架的核心例子:合并后的大小和误差与在整条流上直接构建时相同。老版本的一些资料说 Space-Saving 不能合并,这个说法在 2012 年之后就不成立了。
五、Lossy Counting:按时间表清理
Manku 和 Motwani(VLDB 2002)的 Lossy Counting 把流切成宽度 \(w = \lceil 1/\varepsilon \rceil\) 的桶,当前桶号 \(b = \lceil n/w \rceil\)。每个表项是 \((x, f, \Delta)\),\(f\) 是放入后的计数,\(\Delta\) 是放入前 \(x\) 可能漏记的最大次数:
- \(x\) 已在表中:\(f \mathrel{+}= 1\)。
- 否则新建 \((x, 1, b - 1)\)。
- 每到桶边界(\(n\) 是 \(w\) 的倍数),删除所有 \(f + \Delta \le b\) 的表项。
/* reproduce/summaries.c,lc_update 的剪枝部分 */
if (s->n % s->w == 0) {            /* bucket boundary: prune f + delta <= bcur */
    int j = 0;
    for (int t = 0; t < s->size; t++) {
        if (s->f[t] + s->delta[t] > s->bcur) {
            s->key[j] = s->key[t]; s->f[j] = s->f[t]; s->delta[j] = s->delta[t]; j++;
        }
    }
    s->size = j;
    lc_reindex(s);
    s->bcur++;
}
保证是 \(f \le f_x \le f + \Delta \le f + \varepsilon n\):一个元素每次被删时,它的真实频率不超过当时的桶号,而 \(\Delta \le b - 1 \le \varepsilon n\)。空间方面,论文的 Theorem 4.2 证明表项数最多 \(\frac{1}{\varepsilon}\log(\varepsilon n)\),比 Misra-Gries 的 \(1/\varepsilon\) 多一个对数因子;Cormode 和 Hadjieleftheriou 转述了对某些输入分布只需 \(O(1/\varepsilon)\) 的结论。
和 Misra-Gries 比,Lossy Counting 的”扣减”是按时间表发生的:不管表满不满,每过 \(w\) 个元素就让所有项接受一次检查。Cormode 和 Hadjieleftheriou 还实现了 Manku 讲稿中的一个变体,去掉每项的 \(\Delta\),改为每过一个桶所有计数减 1,形式上更接近 Misra-Gries。它们的共同后果是空间随数据变化:均匀的长尾会让表项逼近上界,偏斜的数据会让表项远少于 \(1/\varepsilon\)。第七节会看到,同样的 \(\varepsilon\) 下 Lossy Counting 在高偏斜数据上只用了很少的表项,召回率也随之下降。
trace.c
的第二部分给出三个算法的最坏情况:\(k+1 = 1001\)
个元素轮流出现,每个 1000 次。Misra-Gries(\(k =
1000\))最后一项都不剩,每个元素的误差都是 \(1000 =
n/(k+1)\),界是紧的;Lossy Counting(\(w = 1000\))同样全部删光,低估
1000;Space-Saving 用 1000 个计数器时 \(\min = 1001\),误差区间宽
1001,实际高估只有 1;用 1001 个计数器(与 \(k = 1000\) 的 Misra-Gries
同构)时每个估计都精确,恰好是 Misra-Gries 的 \(0 + D = 1000\)。
六、下界:\(\Omega(1/\varepsilon)\) 指的是什么
“频率估计的空间下界是 \(\Omega(1/\varepsilon)\)”这句话要先说清单位。按计数器个数和按比特数,结论不一样。
计数器模型:确定性算法至少要 \(1/(2\varepsilon)\) 个计数器
Metwally 等人的 Theorem 4 仿照 Bose 等人(SIROCCO 2003)的论证:任何确定性的计数器类算法,要保证误差 \(\varepsilon n\),至少需要 \(\min(|A|, \frac{1}{2\varepsilon})\) 个计数器,\(|A|\) 是全集大小。构造两条长度为 \(L(m+1)+1\) 的流,前 \(L(m+1)\) 个元素相同,由 \(m+1\) 个元素各出现 \(L\) 次组成。读完这一段,\(m\) 个计数器只能监视其中 \(m\) 个。第一条流以一个从未出现过的新元素结尾,第二条流以一个出现过 \(L\) 次但未被监视的元素结尾。确定性算法无法区分这两种情况,只能给出同一个估计;估 1 在第二条流上错 \(L\),估 \(L\) 在第一条流上错 \(L\),最好也要错 \(L/2\),即 \(\frac{n}{2(m+1)}\) 左右。要让它不超过 \(\varepsilon n\),计数器数就要约 \(\frac{1}{2\varepsilon}\)。
Space-Saving 用 \(1/\varepsilon\) 个计数器达到 \(\varepsilon n\),所以在这个模型里它与下界只差常数 2。Demaine 等人的 Theorem 3 从另一个方向说明阈值 \(n/(m+1)\) 本身也改进不了:对任何只存 \(m\) 个元素的确定性单遍算法,敌手能构造一条流,其中一个元素出现至少 \(n/(m+1) - 1\) 次、其余都只出现一次,而算法结束时存着的全是只出现一次的元素。上一节的轮转流则说明 Misra-Gries 的 \(n/(k+1)\) 在最坏情况下被取到。
比特模型:Misra-Gries 并不最优
每个计数器要存一个元素 ID(\(\log u\) 比特)和一个计数(\(\log n\) 比特),所以 Misra-Gries 用 \(O(\varepsilon^{-1}(\log u + \log n))\) 比特。Bhattacharyya、Dey、Woodruff 总结了 2016 年以前已知的两个下界:
- 输出本身可能包含 \(1/\varphi\) 个元素,编码它们需要 \(\log\binom{u}{1/\varphi} = \Omega(\varphi^{-1}\log(\varphi u))\) 比特。
- 从 INDEX 问题归约得到 \(\Omega(\varepsilon^{-1})\) 比特,这是一个民间(folklore)结论。Alice 有长度为 \((2\varepsilon)^{-1}\) 的比特串 \(x\),Bob 有一个下标 \(i\)。Alice 把每个 \(x_j = 1\) 的 \(j\) 放进流各一次,用哑元素补足长度,运行 heavy hitter 算法后把内存状态发给 Bob;Bob 追加 \((2\varepsilon)^{-1}\) 个 \(i\) 继续运行。整条流长 \(n = \varepsilon^{-1}\),取 \(\varphi = 1/2\),\(i\) 一定是 heavy hitter,而它的频率随 \(x_i\) 取 0 或 1 相差 1,也就是 \(\varepsilon n\),精度足够的估计就能读出 \(x_i\)。比特串长度为 \(\ell\) 时,INDEX 的单向随机通信复杂度是 \(\Omega(\ell)\)(Kremer、Nisan、Ron 1999),所以即便允许随机化,内存也至少 \(\Omega(\varepsilon^{-1})\) 比特。
上界 \(O(\varepsilon^{-1}(\log u + \log n))\) 与下界 \(\Omega(\varphi^{-1}\log u + \varepsilon^{-1})\) 之间,在 \(\varphi\) 为常数、\(\log u \approx 1/\varepsilon\) 时差了近平方。BDW(PODS 2016)闭合了这个差距:一个随机算法用
\[ O\!\left(\varepsilon^{-1}\log\varphi^{-1} + \varphi^{-1}\log u + \log\log n\right) \]
比特解决 \((\varepsilon,\varphi)\)-heavy hitter,并证明了匹配的下界。它的简化版本思路很直接:先从流中均匀采样 \(O(\varepsilon^{-2})\) 个元素,把采样元素的 ID 哈希到 \(\mathrm{poly}(1/\varepsilon)\) 大小的空间,在短 ID 上运行 \(1/\varepsilon\) 个计数器的 Misra-Gries,只为最靠前的 \(1/\varphi\) 个候选保存完整 ID。省下的是”每个计数器都带一个完整 ID”的那部分空间。
所以”Misra-Gries 与 Space-Saving 达到了理论极限”只在计数器模型下成立,即把一个 ID 加一个计数当作一个单位。它们在比特意义上不是最优的,比特最优的算法是随机算法。
超越最坏情况:尾部界
最坏情况下界针对的是均匀的长尾。真实数据往往高度偏斜,这时有更强的保证。据 BDW 的转述,Berinde、Indyk、Cormode、Strauss(PODS 2009,TODS 2010)证明,用 \(O(k\varepsilon^{-1})\) 个计数器,计数器类算法的误差不超过 \(\frac{\varepsilon}{k}F_1^{\mathrm{res}(k)}\),其中 \(F_1^{\mathrm{res}(k)}\) 是去掉频率最高的 \(k\) 个元素后剩余的频率总和。误差只依赖尾部质量:前几名越集中,误差越小。Metwally 等人的 Theorem 5 针对参数 \(\alpha \ge 1\) 的 Zipf 分布给出了类似的结论:Space-Saving 只需 \(\min(|A|, (1/\varepsilon)^{1/\alpha}, 1/\varepsilon)\) 个计数器。下一节的实验里,\(D\) 远小于 \(n/(k+1)\),原因就在这里。
七、Zipf 实测:召回率与误差
设置
- 流:\(n = 10^7\),全集 \(u = 2^{20}\),第 \(r\) 名的概率正比于 \(r^{-\alpha}\),\(\alpha \in \{0.8, 1.0, 1.2, 1.5\}\);元素键由名次经过一个 64 位双射哈希得到,键值不携带名次信息;每个 \(\alpha\) 取 3 个种子,表中是中位数。
- 摘要:Misra-Gries(\(k =
m\))、Space-Saving(\(m\) 个计数器)、Lossy
Counting(\(w = m\),即
\(\varepsilon =
1/m\))、Apache DataSketches C++ 5.2.0 的
frequent_items_sketch<uint64_t>(lg_max_map_size为 8 到 12,对应 \(m = 0.75 \cdot 2^{\mathrm{lg}}\),即 192 到 3072)。前三个用reproduce/summaries.c的实现。 - 指标:召回率是报告的前 100 名里真实频率不低于真实第 100 名的比例;误差是真实前 100 名中估计误差的最大值。点估计分别取 Misra-Gries 的计数、Space-Saving 的计数(未监视时为 \(\min\))、Lossy Counting 的 \(f\)、DataSketches 的下界。
- 环境:Intel Core i9-12900K,WSL2(内核
6.6.87.2-microsoft-standard-WSL2),GCC 16.1.1
-O2,Python 3.14.5,matplotlib 3.11.2。所有指标都是计数,不涉及计时,结果不依赖机器。
复现命令:
git clone --depth 1 --branch 5.2.0 https://github.com/apache/datasketches-cpp
DS_DIR=$PWD/datasketches-cpp PYTHON=python3 ./reproduce/run.sh
run.sh 依次编译运行正确性测试(普通构建和
ASan/UBSan 构建各一次)、trace 和
bench,再由 plot.py 生成
results/summary.txt
和两张图。在干净目录里重跑一遍,得到的
zipf.tsv、summary.txt 和两张 SVG
与仓库中的逐字节相同。
结果
| \(\alpha\) | \(m\) | 召回 MG | 召回 SS | 召回 LC | 召回 DS | 误差 MG | 误差 SS | 误差 LC | LC 表项 |
|---|---|---|---|---|---|---|---|---|---|
| 0.8 | 384 | 0.16 | 0.17 | 0.19 | 0.21 | 25390 | 22103 | 25018 | 394 |
| 0.8 | 1536 | 0.63 | 0.59 | 0.66 | 0.66 | 6145 | 2796 | 6359 | 1508 |
| 1.0 | 384 | 0.51 | 0.52 | 0.47 | 0.54 | 20365 | 13508 | 24899 | 343 |
| 1.0 | 1536 | 1.00 | 1.00 | 1.00 | 1.00 | 4416 | 2 | 225 | 1156 |
| 1.2 | 384 | 0.85 | 0.86 | 0.58 | 0.87 | 10961 | 3426 | 24723 | 225 |
| 1.2 | 1536 | 1.00 | 1.00 | 1.00 | 1.00 | 1967 | 0 | 28 | 646 |
| 1.5 | 384 | 1.00 | 1.00 | 0.50 | 1.00 | 2601 | 2 | 24415 | 109 |
| 1.5 | 1536 | 1.00 | 1.00 | 0.86 | 1.00 | 321 | 0 | 6294 | 244 |
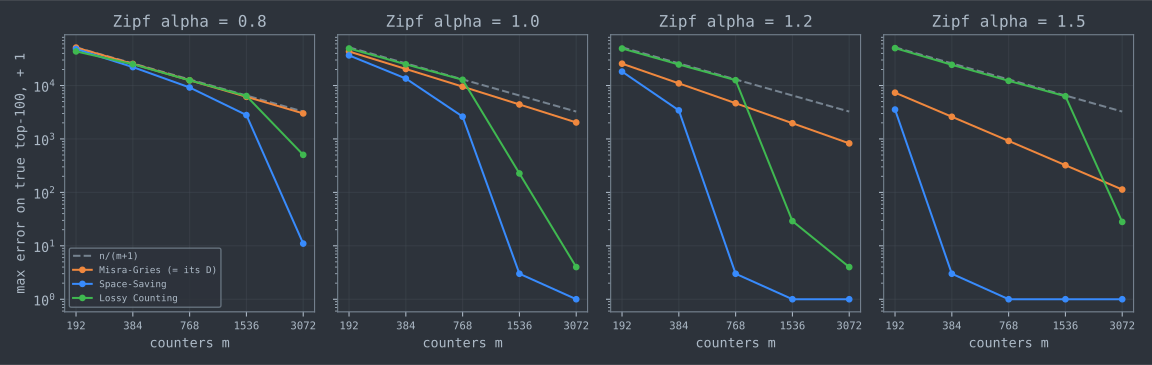
解读
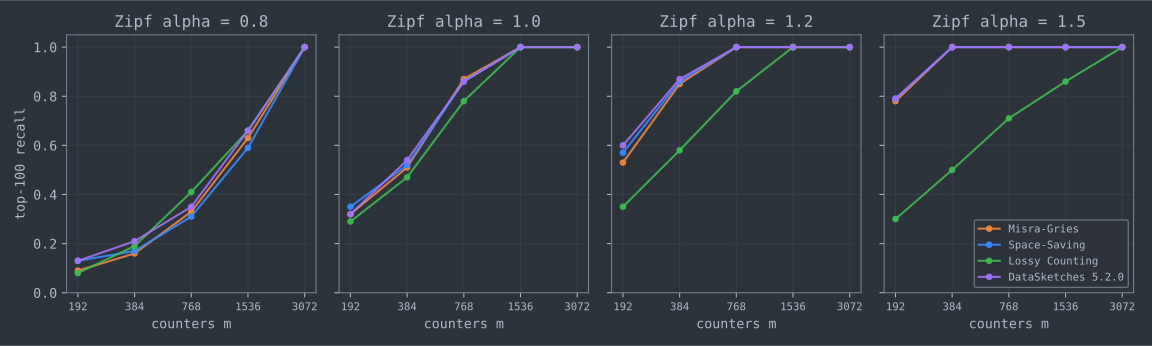
召回率上 Misra-Gries、Space-Saving、DataSketches 几乎一样。三者的差别不超过 0.07,多数在 0.03 以内。这正是同构定理的预言:Space-Saving 的计数等于 Misra-Gries 的计数加同一个常数,排序相同,差别只来自多出的那一个计数器和同分时的顺序。
召回率何时到 1,由 \(D\) 和第 100 名的频率决定。按 Zipf 分布算,第 100 名的期望频率在 \(\alpha = 0.8, 1.0, 1.2, 1.5\) 时分别约为 3324、6925、7541、3831。对四个 \(\alpha\),Misra-Gries、Space-Saving、DataSketches 的召回率首次达到 1.00 的都是满足 \(D\) 小于这个值的最小 \(m\):例如 \(\alpha = 0.8\) 时,\(m = 1536\) 的 \(D = 6145\),召回率 0.63;\(m = 3072\) 的 \(D = 3001\),召回率 1.00。频率低于 \(D\) 的元素与噪声分不开,这与第二节的误差界一致。
点估计上 Space-Saving 远好于 Misra-Gries,但这是区间端点的选择。在全部 60 次运行里,Misra-Gries 在前 100 名上的最大误差都恰好等于 \(D\):最热的元素从头存活,每次扣减都被扣到。Space-Saving 给同一批元素的估计几乎精确(\(\alpha = 1.0\)、\(m = 1536\) 时误差 2,Misra-Gries 是 4416),因为它的计数就是少一个计数器的 Misra-Gries 的计数加上 \(D\)。
最坏情况界在偏斜数据上很松。\(m = 384\) 时 \(n/(m+1) \approx 25974\)。\(\alpha = 0.8\) 时实际 \(D = 25390\),几乎顶到上界;\(\alpha = 1.5\) 时只有 2601,约为上界的十分之一。按 Zipf 分布,\(\alpha = 1.5\) 时前 100 名以外的频率总和约占 7.6%,\(\alpha = 0.8\) 时约占 89%,第六节的尾部界说的就是这种差别。
Lossy Counting 用不满它的预算。相同的 \(\varepsilon\) 下,它的表项数随数据偏斜而下降:\(\alpha = 1.5\)、\(m = 384\) 时最多只存了 109 项,召回率 0.50,而 Space-Saving 用 384 个计数器召回率是 1.00。它的保证 \(\varepsilon n\) 与数据无关,偏斜数据上本可以用更多空间换精度,却在每个桶边界把候选删掉了。反过来,它对早期就进入且从未被删的元素几乎没有低估,\(\alpha = 1.0\)、\(m = 1536\) 时误差 225,远小于 Misra-Gries 的 4416。比较 Lossy Counting 时应该对齐表项数,而不是对齐 \(\varepsilon\)。
DataSketches 的误差偏移量与 \(D\) 几乎一致。60
次运行里有 52 次的 get_maximum_error()
与同样大小的 Misra-Gries 的 \(D\) 完全相同;其余 8 次都在
\(\alpha = 1.5\),偏移量比
\(D\) 大 1 到
95。召回率和误差列也与 Misra-Gries
基本重合。原因见下一节。
这组实验有两个局限。其一,流是独立同分布抽样的,热门元素从一开始就出现;真实流量里热点会中途出现,后来者进入 Space-Saving 时继承较大的误差,Misra-Gries 对它的低估也可能小于 \(D\),两者的点估计差距不会像这里这样一边倒。其二,实验只衡量计数,没有测吞吐量,Stream-Summary 与堆、与 DataSketches 哈希表的速度差别不在本文结论之内。
八、生产实现
Apache DataSketches 5.2.0:中位数扣减的 Misra-Gries
DataSketches 的 frequent items sketch 是 Anderson
等人(IMC 2017)描述的 Misra-Gries 变体。存储是开放寻址的
reverse_purge_hash_map,装载因子
LOAD_FACTOR = 0.75,容量是 \(0.75 \cdot
2^{\mathrm{lg}}\)。新键插入后若活跃项超过容量,而表已到最大尺寸,就触发
purge:
// fi/include/reverse_purge_hash_map_impl.hpp (datasketches-cpp 5.2.0)
V reverse_purge_hash_map<K, V, H, E, A>::purge() {
  const uint32_t limit = std::min(MAX_SAMPLE_SIZE, num_active_);
  uint32_t num_samples = 0;
  uint32_t i = 0;
  AllocV av(allocator_);
  V* samples = av.allocate(limit);
  while (num_samples < limit) {
    if (is_active(i)) {
      samples[num_samples++] = values_[i];
    }
    i++;
  }
  std::nth_element(samples, samples+ (num_samples / 2), samples + num_samples);
  const V median = samples[num_samples / 2];
  av.deallocate(samples, limit);
  subtract_and_keep_positive_only(median);
  return median;
}
它从表中按槽位顺序取最多
MAX_SAMPLE_SIZE = 1024
个活跃计数,求中位数,所有计数减去中位数并删除不为正的项,返回值累加到
sketch 的 offset。和 Misra-Gries 对照:
- 中位数为 1 时,这一步就是 Misra-Gries
的一次扣减:表里恰好有容量加 1
个不同元素(含刚插入的新键),每个减 1,计数为 1
的全部删除。Zipf 流中大量元素只出现一两次,中位数通常是
1,所以第七节 60 次运行里有 52 次
offset与 \(D\) 完全相同。 - 中位数大于 1 时,一次删掉约一半的项,
offset增加得比 \(D\) 快,换来更少的清理次数。若每次清理的中位数都是 1,两者的状态会逐步完全相同,所以第七节那 8 次例外(都在 \(\alpha = 1.5\))说明其中至少有一次清理的中位数大于 1。 - 读取接口:
get_lower_bound返回存储的计数,get_upper_bound和被追踪元素的get_estimate返回计数加offset,get_maximum_error()就是offset。这和第四节的结论一致:下界是 Misra-Gries 的读数,上界是 Space-Saving 的读数。get_frequent_items(NO_FALSE_POSITIVES)只报告下界超过阈值的项,NO_FALSE_NEGATIVES报告上界超过阈值的项。 - 先验误差:
get_epsilon返回 \(3.5 / 2^{\mathrm{lg}}\)(EPSILON_FACTOR = 3.5),比同样容量的 Misra-Gries 的 \(1/(0.75 \cdot 2^{\mathrm{lg}} + 1)\) 宽约 2.6 倍,这是为中位数扣减付出的最坏情况代价。实测里偏移量远低于这个值。 - 合并:把另一个 sketch
的每一项当作加权更新插入,再把两边的
offset相加。
ClickHouse v24.8.4.13-lts:带过滤器的 Space-Saving
ClickHouse 的
topK、approx_top_k 聚合函数用
src/Common/SpaceSaving.h,文件头注释写明实现的是
Homem 和 Carvalho 的 Filtered Space-Saving,合并算法来自
Parallel Space
Saving(arXiv:1401.0702)。与第三节的教科书版本有三处不同:
// src/Common/SpaceSaving.h (ClickHouse v24.8.4.13-lts),insert 中处理未监视键的部分
const size_t alpha_mask = alpha_map.size() - 1;
auto & alpha = alpha_map[hash & alpha_mask];
if (alpha + increment < min->count)
{
    alpha += increment;
    return;
}

// Erase the current minimum element
alpha_map[min->hash & alpha_mask] = min->count;
destroyLastElement();

push(std::make_unique<Counter>(arena.emplace(key), alpha + increment, alpha + error, hash));- 过滤器。未被监视的键先按哈希累加到
alpha_map的一个槽里,槽数是大于 \(6 \times\) 容量的最小 2 的幂。只有槽值加上本次增量不小于最小计数时,才淘汰最小项;新项的计数是槽值加增量,误差是槽值,而不是教科书里的 \(\min + 1\) 和 \(\min\)。被淘汰项的计数写回它自己的槽。这减少了低频键反复顶替最小项的次数。代价是不同的键共享槽位,淘汰时槽值被直接覆盖,第三节的 Lemma 3 不再逐字成立。本文没有对它做误差实验。 - 存储。计数器放在按计数降序排列的数组里,计数加
1 后用
percolate与前一个元素逐个比较交换,而不是 Stream-Summary 的 \(O(1)\) 桶链表。在大量元素计数相同时,一次交换可能要走很远。 - 容量。
src/AggregateFunctions/AggregateFunctionTopK.cpp中topK(N)默认N = 10、load_factor = 3,容量为N * load_factor;approx_top_k的第二个参数直接指定容量。容量只有 \(3N\) 时,按第七节的规律,只有第 \(N\) 名的频率明显高于 \(n/(3N)\) 量级,结果才可靠。
RedisBloom v8.10.1:HeavyKeeper 不是计数器类算法
RedisBloom 的 TOPK.* 命令常被拿来和
Space-Saving 对比,但它实现的是 HeavyKeeper(Yang
等人,IEEE/ACM ToN 2019)。src/topk.c 维护
depth × width 个(指纹,计数)桶和一个大小为
\(k\)
的最小堆。元素在每一行哈希到一个桶:桶空则占用,指纹相同则加
1,否则以 \(\mathrm{decay}^{\mathrm{count}}\)
的概率把对方的计数减 1,减到 0 时占用该桶(衰减概率查一个
256 项的表)。各行的最大计数若不小于堆顶,就更新堆。
这是一个概率算法:大计数几乎不会被衰减,小计数很快被冲掉,没有第二、三节那样的确定性误差界,指纹碰撞还可能造成高估。src/rm_topk.c
中的默认参数是
TOPK_DEFAULT_WIDTH 8、TOPK_DEFAULT_DEPTH 7、TOPK_DEFAULT_DECAY 0.9;redis.io
上 TOPK.RESERVE 的文档写的默认值是”7, 8, and
0.9”,按参数顺序即宽 7、深 8,与源码相反。
九、争论与开放问题
Space-Saving 是否”更好”
Cormode 和 Hadjieleftheriou 2008 年的实验结论是”SPACESAVING appears conclusively better than other counter-based algorithms”:在他们的设置里(默认 Zipf 参数 1.0、\(\varphi = 0.001\),Frequent 取 \(\varepsilon = \varphi\)),Frequent 报告出大量误报,频率估计也明显偏低,而 Space-Saving 的精确率和召回率都是 100%。四年后 Agarwal 等人(其中包括 Cormode)证明两者同构。两个结论并不矛盾,差别来自报告规则:Frequent 把摘要里所有项都当作候选,并用下端读数当估计值;Space-Saving 用上端读数,并以计数超过阈值为准。给 Misra-Gries 的读数加上 \(D\)、按同样的阈值报告,就得到同一个答案。第七节的实验在召回率上看不出差别,在点估计上的差距正好是 \(D\)。
同构也有它不覆盖的部分。Space-Saving 为每项多存一个误差
\(e_x\),下界 \(c_x - e_x\) 比 Misra-Gries
的下界 \(\hat f_x = c_x -
\min\) 更紧,因为 \(e_x \le
\min\)。在第四节表格的第 10 步,a 在
Space-Saving 里是 4(0),区间是 \([4, 4]\);Misra-Gries 只知道
\([1,
4]\)。这一个额外字段就是 Space-Saving
确认”保证正确”的依据,也是它真正多出来的信息。
同样的 \(\varepsilon\) 还是同样的内存
Lossy Counting 的空间随数据变化,Misra-Gries 和 Space-Saving 的空间固定。Cormode 和 Hadjieleftheriou 按相同的 \(\varepsilon\) 比较,看到 Lossy Counting 在低偏斜时约一半是误报;本文第七节同样按 \(\varepsilon\) 对齐,看到它在高偏斜时表项数远低于预算、召回率下降。两种现象都说明,按 \(\varepsilon\) 对齐的比较会把”空间用得少”和”精度差”混在一起。按内存对齐时 Lossy Counting 要设更小的 \(\varepsilon\),而它的最坏空间又多一个 \(\log(\varepsilon n)\) 因子,没有一个参数能让两者在所有输入上同时公平。
比特最优算法与工程实践
BDW 的比特最优算法依赖随机采样和哈希短 ID,常数和实现复杂度都比 Misra-Gries 高。本文查看的三个生产实现都没有采用它,而是用每项存完整键的计数器结构。在 64 位键、计数也是 64 位的场景里,BDW 省下的主要是 ID 部分,它在什么参数范围内能在实际内存上胜出,本文没有找到实测数据。
删除、权重与输入顺序
计数器类算法的证明都依赖”只插入”:一旦允许删除(turnstile 模型),扣减过的计数无法恢复,误差界失效。这时需要 Count-Min 或 Count Sketch 这类线性 sketch,见 Count-Min Sketch 和流式算法总论。加权更新方面,Anderson 等人给出了摊还常数时间的加权 Misra-Gries,这正是 DataSketches 的中位数扣减。另一个问题是输入顺序:最坏情况界与顺序无关,但实际误差依赖热点何时出现,本文的独立同分布实验没有覆盖这一点。滑动窗口上的 heavy hitter 属于流式算法总论的范围。
十、工程选型与常见错误
| 需求 | 选择 | 要点 |
|---|---|---|
| 单机 top-k,要每项的误差区间 | Space-Saving(Stream-Summary 或堆) | 同时报告 \(c_x\) 和 \(c_x - e_x\) |
| 分片统计后合并 | DataSketches frequent items,或自己实现 Misra-Gries 合并 | Space-Saving 先减去 \(\min\) 转换成 Misra-Gries 再合并 |
| 查询任意键的频率,或有删除 | Count-Min、Count Sketch | 见第 31 篇 |
| SQL 里的近似 top-k | ClickHouse
topK |
默认容量只有 \(3N\),偏斜不够时调大
load_factor |
| 内存极小,只要大致排名 | HeavyKeeper(RedisBloom
TOPK) |
没有确定性误差界 |
常见错误:
- 把 Misra-Gries
的计数当作频率。它系统性地低估,最热元素的低估正好是
\(D\)。需要点估计时加上
\(D\)(DataSketches 的
get_estimate就是这么做的),或者直接用 Space-Saving 的读数。 - 把摘要里的所有项都当作 heavy
hitter。摘要里总有接近 \(\min\) 的项。要求无误报时用
\(c_x - e_x > \varphi
n\),或 DataSketches 的
NO_FALSE_POSITIVES。 - 按 \(m =
1/\varphi\)
设置容量。此时误差上界与阈值同量级,阈值附近的元素全都分不清。第七节的规律是看
\(D\)
与目标名次频率的比值:容量要大到 \(D\) 明显小于第 \(k\) 名的频率。运行时 \(D\)
可以直接读出(
get_maximum_error()或 \(\min\)),适合作为监控指标。 - 合并 Space-Saving 时把计数直接相加再截断。这样会丢掉”未被监视的元素最多有 \(\min\) 次”这一信息,误差界不再成立。用 Misra-Gries 合并算法,或者 ClickHouse 采用的 Parallel Space Saving 合并。
- 按相同的 \(\varepsilon\) 比较 Lossy Counting 与计数器类算法。应该对齐实际内存。
十一、参考资料
规范与文档
- Redis 文档,
TOPK.RESERVE(RedisBloom Top-K 命令说明,含默认参数与 HeavyKeeper 出处)。
源码
- Apache DataSketches C++ 5.2.0(tag
5.2.0,提交 de8553b):fi/include/frequent_items_sketch.hpp、frequent_items_sketch_impl.hpp(EPSILON_FACTOR、get_estimate、get_frequent_items、merge)、reverse_purge_hash_map.hpp、reverse_purge_hash_map_impl.hpp(LOAD_FACTOR、MAX_SAMPLE_SIZE、purge、subtract_and_keep_positive_only)。 - ClickHouse
v24.8.4.13-lts:
src/Common/SpaceSaving.h(insert、merge、percolate、nextAlphaSize)、src/AggregateFunctions/AggregateFunctionTopK.cpp(topK与approx_top_k的参数解析)。 - RedisBloom
v8.10.1:
src/topk.c(TopK_Create、TopK_Add)、src/topk.h、src/rm_topk.c(默认参数)。
核心论文
- J. Misra, D. Gries, “Finding repeated elements”, Science of Computer Programming 2(2):143–152, 1982.
- E. D. Demaine, A. López-Ortiz, J. I. Munro, “Frequency Estimation of Internet Packet Streams with Limited Space”, ESA 2002, LNCS 2461:348–360.
- R. M. Karp, S. Shenker, C. H. Papadimitriou, “A simple algorithm for finding frequent elements in streams and bags”, ACM TODS 28(1):51–55, 2003.
- G. S. Manku, R. Motwani, “Approximate Frequency Counts over Data Streams”, VLDB 2002.
- A. Metwally, D. Agrawal, A. El Abbadi, “Efficient Computation of Frequent and Top-k Elements in Data Streams”, ICDT 2005, LNCS 3363:398–412;技术报告版 UCSB TR 2005-23(本文定理编号所据);扩展版 ACM TODS 31(3), 2006.
- P. K. Agarwal, G. Cormode, Z. Huang, J. M. Phillips, Z. Wei, K. Yi, “Mergeable summaries”, PODS 2012;期刊版 ACM TODS 38(4), 2013.
- G. Cormode, M. Hadjieleftheriou, “Finding frequent items in data streams”, PVLDB 1(2):1530–1541, 2008.
- A. Bhattacharyya, P. Dey, D. P. Woodruff, “An Optimal Algorithm for \(\ell_1\)-Heavy Hitters in Insertion Streams and Related Problems”, PODS 2016;arXiv:1603.00213.
其他论文
- R. S. Boyer, J S. Moore, “MJRTY: A Fast Majority Vote Algorithm”, Automated Reasoning: Essays in Honor of Woody Bledsoe, Kluwer, 1991, pp. 105–117(技术报告 1981)。
- R. Berinde, P. Indyk, G. Cormode, M. J. Strauss, “Space-optimal heavy hitters with strong error bounds”, PODS 2009;ACM TODS 35(4), 2010.
- P. Bose, E. Kranakis, P. Morin, Y. Tang, “Bounds for Frequency Estimation of Packet Streams”, SIROCCO 2003.
- I. Kremer, N. Nisan, D. Ron, “On Randomized One-Round Communication Complexity”, Computational Complexity 8(1):21–49, 1999.
- D. Anderson, P. Bevan, K. Lang, E. Liberty, L. Rhodes, J. Thaler, “A high-performance algorithm for identifying frequent items in data streams”, IMC 2017;arXiv:1705.07001.
- T. Yang 等, “HeavyKeeper: An Accurate Algorithm for Finding Top-k Elephant Flows”, IEEE/ACM Transactions on Networking 27(5):1845–1858, 2019.
工程资料
- ClickHouse
SpaceSaving.h文件头引用的两篇文献:Homem 与 Carvalho 的 Filtered Space-Saving,以及 Parallel Space Saving(arXiv:1401.0702)。本文只依据源码描述其行为,未核对论文正文。
实验
reproduce/summaries.c、summaries.h:Misra-Gries(含合并)、Space-Saving(Stream-Summary)、Lossy Counting 的实现。reproduce/test_summaries.c:240 条随机流上的误差界、同构与合并检查,输出results/test.txt。reproduce/trace.c:第四节逐步对照表和第五节轮转流,输出results/trace.txt。reproduce/bench.cpp、plot.py、run.sh:第七节 Zipf 实验,输出results/zipf.tsv、results/summary.txt和两张图。
系列导航: - 上一篇:MinHash 与 SimHash:近重复检测的相似度草图与候选生成 - 下一篇:流式算法总论:数据流模型、频率矩下界与线性 sketch
相关阅读: - Count-Min Sketch:点查询误差界、保守更新与生产实现 - HyperLogLog:从概率计数到 Redis 实现的基数估计 - t-digest:缩放函数、合并与尾部分位数误差
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
Count-Min Sketch:点查询误差界、保守更新与生产实现
Count-Min Sketch 的误差是 εN 的加性界而非相对误差。本文核对原论文定理条件,用 Zipf 实验比较标准更新、保守更新、count-mean-min 与 Count Sketch,并对照 RedisBloom、DataSketches、Caffeine 源码。
流式算法总论:数据流模型、频率矩下界与线性 sketch
一遍扫描、内存远小于数据时能算什么:梳理三种流模型、Morris 到 AMS 与 Indyk 的谱系、通信复杂度下界,实测 AMS F2 sketch 误差随计数器数的变化,说明线性 sketch 为何可合并、可删除,并把本系列 30 到 35 篇串成路线图。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。