用 Redis 的 PFADD / PFCOUNT
统计独立访客时,常听到三句话:一个 key 只占 12 KB;误差
0.81%;多个计数器可以随意合并。第一句和第三句成立。第二句最容易误读:0.81%
是 \(1.04/\sqrt{m}\)
给出的标准误差,大约只有三分之二的估计落在
\(\pm 0.81\%\)
以内;而且它只在基数远大于寄存器数时成立。小基数和中间过渡区的误差取决于用哪个估计公式,Redis
在 2.8.9、4.0、5.0 三个版本里用过三套不同的公式。
本文沿
Flajolet-Martin(1985)、LogLog(2003)、HyperLogLog(2007)、HyperLogLog++(2013)到
Ertl 估计器(2017)这条线推导,用同目录
reproduce/ 下的程序实测这些估计器在 \(10\) 到 \(4 \times 10^9\)
的基数上的偏差,再对照 Redis 7.2.5 的
src/hyperloglog.c 讲实现。
实验环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,GCC
16.1.1,程序用 taskset
绑定在单个核上。所有指标都是估计误差,与计时无关;随机种子固定,重跑结果逐字节一致。
一、问题:精确去重为什么贵
给定一个元素可以重复出现的多重集合(multiset)\(S\),基数(cardinality)是其中不同元素的个数:
\[ n = |\{x : x \in S\}|. \]
流式场景要求一遍扫描、任意时刻都能给出估计,且内存远小于 \(n\)。
精确方案都要记住”见过哪些元素”。哈希集合为每个不同元素存一份:一亿个 64 位 ID 光是原始数据就是 800 MB,还没算哈希表本身的开销。值域已知时可以用位图,32 位值域需要 \(2^{32}\) 位,即 512 MiB,与实际基数无关。
近似方案的目标是 \((1 \pm \varepsilon)\) 近似。理论上的最优空间已经知道:Kane、Nelson 和 Woodruff(PODS 2010)给出了用 \(O(\varepsilon^{-2} + \log n)\) 位、以 \(2/3\) 概率达到 \((1 \pm \varepsilon)\) 近似的算法,并称其空间最优。HyperLogLog 用 \(m\) 个寄存器、每个约 \(\log_2 \log_2 n\) 位,总空间 \(O(\varepsilon^{-2} \log \log n)\),渐近意义上不是最优,但常数小、实现简单、可以合并,这是它成为工业标准的原因(第八节再讨论”最优”之争)。
| 方案 | 空间 | 误差 | 能否合并 |
|---|---|---|---|
| 哈希集合 | \(\Theta(n)\) 个元素 | 精确 | 能(集合并) |
| 位图 | 值域大小 \(\lvert U \rvert\) 位 | 精确 | 能(按位或) |
| 线性计数(Linear Counting) | 与 \(n\) 同阶的位图 | 位图接近填满时发散 | 能(按位或) |
| HyperLogLog | \(m\) 个 \(\lceil \log_2(q+2) \rceil\) 位寄存器 | 标准误差约 \(1.04/\sqrt{m}\) | 能(逐寄存器取 max) |
表中 \(q\) 是哈希值去掉桶索引后剩余的位数,第三节解释。线性计数的”发散”在第四节有实测。
二、比特模式:Flajolet-Martin 与随机平均
前导零的分布
把元素哈希成均匀随机的比特串 \(x\),记 \(\rho(x)\) 为最左边第一个 1 所在的位置(从 1 开始计),例如 \(\rho(1\cdots) = 1\)、\(\rho(0001\cdots) = 4\)。每一位独立地以 \(1/2\) 概率为 0,所以
\[ \Pr[\rho(x) \ge k] = 2^{-(k-1)}. \]
看到一个 \(\rho \ge k\) 的哈希值,大致说明已经见过 \(2^{k-1}\) 量级的不同元素。重复元素的哈希值相同,不会改变任何统计量,这是所有这类算法天然去重的原因。
FM85:位图与第一个 0
Flajolet 和 Martin 的 Probabilistic Counting
Algorithms for Data Base Applications(JCSS 31(2),
1985;会议版 FOCS 1983)用的观测量不是”最大的 \(\rho\)“,而是一个位图:对每个元素把
BITMAP[ρ(h(x)) - 1] 置 1(论文里位置从 0
开始),最后取最左边的 0 的位置 \(R\)。论文 Theorem 3.A 证明
\[ \mathbb{E}[R] \approx \log_2(\varphi n), \qquad \varphi = 0.77351\ldots, \]
所以 \(2^R/\varphi\) 是 \(n\) 的估计。单个位图的 \(R\) 是整数,估计只能在 2 的幂附近跳动,误差以倍数计。
降低方差的直接办法是用 \(m\) 个独立哈希函数各维护一个位图再平均,但每个元素要算 \(m\) 次哈希。FM85 提出了随机平均(stochastic averaging):用 \(a = h(x) \bmod m\) 选一个位图,用剩下的位 \(\lfloor h(x)/m \rfloor\) 更新它,最后对 \(m\) 个 \(R\) 取平均。这就是 PCSA(Probabilistic Counting with Stochastic Averaging),每个元素只算一次哈希,标准误差约 \(0.78/\sqrt{m}\);论文表格给出 \(m = 64\) 时为 9.7%,\(m = 1024\) 时为 2.4%。
后来的 LogLog 和 HyperLogLog 都沿用”一次哈希、用一部分位选桶”的随机平均,改的是每个桶存什么和怎么把桶合成一个估计。下图是本文涉及的谱系,实线是算法上的直接继承,虚线是 Redis 在不同版本采用的估计公式:
flowchart LR
    FM["FM85 / PCSA<br/>bitmap per bucket<br/>0.78/sqrt(m)"] --> LL["LogLog 2003<br/>max rho per bucket<br/>1.30/sqrt(m)"]
    LL --> HLL["HyperLogLog 2007<br/>harmonic mean<br/>1.04/sqrt(m)"]
    HLL --> PP["HLL++ 2013<br/>64-bit hash, sparse,<br/>empirical bias table"]
    HLL --> ER["Ertl 2017<br/>improved raw and ML<br/>estimators"]
    HLL --> ULL["UltraLogLog 2024<br/>richer 8-bit registers"]
    HLL -.-> R28["Redis 2.8.9 - 3.2<br/>LC + polynomial fit"]
    R28 -.-> R40["Redis 4.0<br/>LogLog-Beta"]
    ER -.-> R50["Redis 5.0 - 7.2<br/>Ertl estimator"]
    R40 -.-> R50
三、LogLog 与 HyperLogLog:每个桶只留一个最大值
最大值只需要 \(\log \log n\) 位
对 \(\nu\) 个不同元素取 \(\rho\) 的最大值 \(M\),有
\[ \Pr[M < k] = \left(1 - 2^{-(k-1)}\right)^{\nu} \approx \exp\!\left(-\nu \, 2^{-(k-1)}\right). \]
\(k\) 比 \(\log_2 \nu\) 小几位时这个概率接近 0,大几位时接近 1,所以 \(M \approx \log_2 \nu\)。存 \(M\) 只需要 \(\log_2 \log_2 N_{\max}\) 位,这就是 LogLog 名字的来历。
Durand 和 Flajolet 的 LogLog(Loglog Counting of Large Cardinalities,ESA 2003,LNCS 2832)把哈希值的前 \(p\) 位当桶号 \(j\),\(m = 2^p\) 个寄存器 \(M[j]\) 各存本桶见过的最大 \(\rho\),估计值是
\[ E_{\text{LogLog}} = \alpha_m \, m \, 2^{\frac{1}{m}\sum_{j} M[j]}, \]
即对 \(2^{M[j]}\) 取几何平均。论文给出标准误差 \(\sqrt{\tfrac{1}{12}\ln^2 2 + \tfrac{1}{6}\pi^2}\,/\sqrt{m} \approx 1.30/\sqrt{m}\),\(m = 256\) 时约 8%,\(m = 1024\) 时约 4%。摘要里另有一个常被引用的例子:\(m = 2048\) 个 5 位寄存器、共 1.28 KB,可以数到 \(2^{27}\)(约一亿),误差通常小于 2.5%。这组数字属于论文中的改进版 SuperLogLog,不是基本的 LogLog。
论文自己指出了 LogLog 的弱点:\(M\) 的上尾满足 \(\Pr[M > \log_2 \nu + k] \approx 2^{-k}\),衰减得不够快;估计值是寄存器算术平均的指数,少数异常大的寄存器就能把估计拉高。SuperLogLog 的补救是截断规则:只保留最小的 \(70\%\)(\(\theta_0 = 0.7\))寄存器再平均,经验标准误差降到 \(1.05/\sqrt{m}\),代价是偏差和误差不再容易分析。
HyperLogLog:换成调和平均
Flajolet、Fusy、Gandouet 和 Meunier 的 HyperLogLog: the analysis of a near-optimal cardinality estimation algorithm(AofA 2007,DMTCS Proceedings AH,127–146)沿用 LogLog 的寄存器,只把合成方式换成调和平均。插入一个元素的过程如下图上半部分:
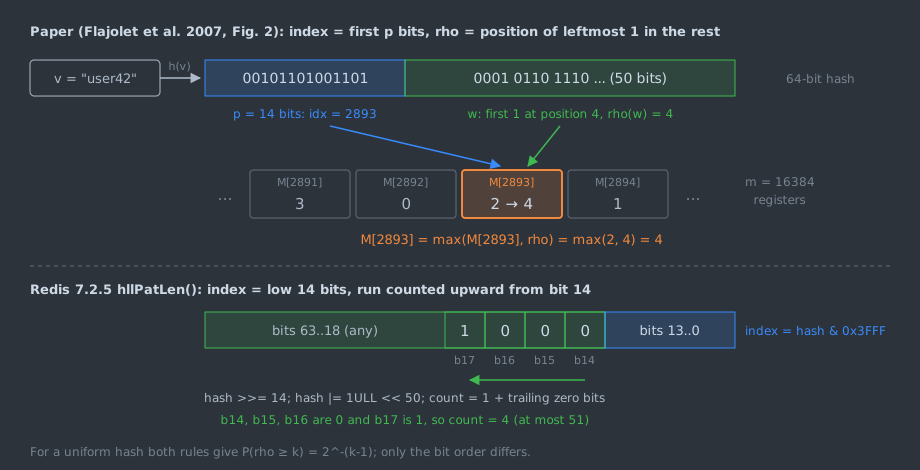
- 前 \(p\) 位决定桶号,剩下的位 \(w\) 决定候选值 \(\rho(w)\),寄存器只在候选值更大时才改写。
- 同一个元素再来一次,哈希值不变,桶号和 \(\rho\) 都不变,寄存器不会变化。
- 下半部分是 Redis 的约定:桶号取低 14 位,从第 14 位往高位数连续的 0。对均匀哈希,两种取法得到的 \(\rho\) 分布相同,只是位序不同(第七节有源码)。
所有元素处理完后,论文 Figure 2 的估计是
\[ E = \alpha_m \, m^2 \left(\sum_{j=0}^{m-1} 2^{-M[j]}\right)^{-1}, \qquad \alpha_m = \left(m \int_0^\infty \left(\log_2 \frac{2+u}{1+u}\right)^m du\right)^{-1}. \]
论文 Figure 3 给出的实用常数是 \(\alpha_{16} = 0.673\)、\(\alpha_{32} = 0.697\)、\(\alpha_{64} = 0.709\),\(m \ge 128\) 时 \(\alpha_m = 0.7213/(1 + 1.079/m)\);极限值 \(\alpha_\infty = 1/(2\ln 2) \approx 0.72135\)。
直觉。 每个桶大约分到 \(n/m\) 个元素,\(2^{M[j]}\) 与 \(n/m\) 同一量级。\(m \big/ \sum_j 2^{-M[j]}\) 是 \(2^{M[j]}\) 的调和平均,乘以 \(m\) 就与 \(n\) 同一量级。但 \(2^{M[j]}\) 是一组几何变量最大值的指数,系统性地偏大,\(m^2 \big/ \sum_j 2^{-M[j]}\) 大约是 \(n/\alpha_m\);乘上 \(\alpha_m \approx 0.72\) 正是为了消掉这个乘性偏差。
为什么调和平均更稳。 在 LogLog 里,一个寄存器多出 \(\Delta\),估计值乘以 \(2^{\Delta/m}\),\(\Delta\) 越大影响越大。在 HyperLogLog 里,每个寄存器对分母的贡献是 \(2^{-M[j]} \in (0, 1]\),一个寄存器哪怕变成无穷大,分母也只少了它原来那一项,大约是总和的 \(1/m\)。异常大的值被自动压住,而异常小的值(空桶贡献 1)会显著拉低估计,这正是小基数时要单独处理的原因。
误差:\(1.04/\sqrt{m}\) 的准确含义
论文 Theorem 1 的前提是”理想多重集合”:哈希值是 \([0,1]\) 上独立均匀的随机数。在此前提下,当 \(n \to \infty\):
- 估计渐近几乎无偏:\(\mathbb{E}[E]/n = 1 + \delta_1(n) + o(1)\),\(m \ge 16\) 时振荡项 \(|\delta_1(n)| < 5 \times 10^{-5}\);
- 标准误差 \(\sqrt{\operatorname{Var}(E)}/n = \beta_m/\sqrt{m} + \delta_2(n) + o(1)\),其中 \(\beta_{16} \approx 1.106\)、\(\beta_{32} \approx 1.070\)、\(\beta_{64} \approx 1.054\)、\(\beta_{128} \approx 1.046\),
\[ \beta_\infty = \sqrt{3 \ln 2 - 1} \approx 1.03896. \]
与 LogLog 的 \(1.30/\sqrt{m}\) 相比,达到同样精度只需 \((1.04/1.30)^2 \approx 64\%\) 的寄存器,论文摘要给出的也是 64%。
\(m = 2^{14} = 16384\)
时,\(1.04/\sqrt{16384} = 1.04/128
\approx 0.81\%\)。论文第 4
节说估计值近似服从正态分布,预期分别有 65%、95%、99%
的估计落在 \(\sigma\)、\(2\sigma\)、\(3\sigma\)
以内。实测(reproduce/accuracy.c,1000
次独立试验,\(n =
10^7\))三个种子下的比例是:
| 种子 | \(\pm 1\sigma\) | \(\pm 2\sigma\) | \(\pm 3\sigma\) | RMSE |
|---|---|---|---|---|
| 1 | 67.2% | 94.2% | 99.3% | 0.85% |
| 2 | 68.8% | 95.6% | 100.0% | 0.81% |
| 3 | 68.2% | 96.4% | 99.9% | 0.80% |
所以”一亿 UV 的估计落在 9919 万到 10081 万之间”只对约三分之二的情况成立;要覆盖 95% 需要放宽到 \(\pm 1.6\%\) 左右。
12 KB 从哪来
论文假设 32 位哈希,\(p = 14\) 时剩下 \(q = 18\) 位,\(\rho \le q + 1 = 19\),5 位寄存器就够。HyperLogLog++ 和 Redis 都改用 64 位哈希:\(q = 50\),\(\rho \le 51\),需要 6 位。
\[ 16384 \times 6 \text{ bit} = 98304 \text{ bit} = 12288 \text{ B} = 12 \text{ KiB}. \]
每加一位哈希,可计数的范围翻倍,而寄存器宽度只随 \(\log_2(q+2)\) 增长,这是 64 位哈希几乎”免费”的原因(HLL++ 论文第 5.1 节)。
四、偏差:小基数、过渡区与大基数
Theorem 1 是 \(n \to \infty\) 的结论。寄存器初始化为 0 时,\(n = 0\) 的原始估计是 \(\alpha_m m \approx 0.7m\)(论文第 4 节),离 0 差得很远。实用算法都要在两端做修正,各代方案的差别主要就在这里。
2007 年论文的三段式
论文 Figure 3 的程序按原始估计 \(E\) 分三段:
- \(E \le \frac{5}{2} m\):若空寄存器数 \(V > 0\),改用线性计数 \(E^* = m \ln(m/V)\);
- \(\frac{5}{2} m < E \le \frac{1}{30} 2^{32}\):直接用 \(E\);
- \(E > \frac{1}{30} 2^{32}\):大范围修正 \(E^* = -2^{32} \ln(1 - E/2^{32})\)。
线性计数来自 Whang、Vander-Zanden 和 Taylor(ACM TODS 15(2), 1990)。把 \(n\) 个球随机扔进 \(m\) 个桶,空桶数约为 \(m e^{-n/m}\),反解得 \(n \approx m \ln(m/V)\);寄存器是否为 0 恰好就是”桶是否为空”。大范围修正针对 32 位哈希的碰撞:论文假设 \(E\) 估计的是不同哈希值的个数,约为 \(2^{32}(1 - e^{-n/2^{32}})\),反解得到上式。
reproduce/estimators.h 里的实现(\(\mathit{hash\_bits} = 64\)
时第三段不可达):
/* reproduce/estimators.h:Flajolet et al. 2007, Figure 3 */
static inline double est_hll2007(const int *C, int m, int q, int hash_bits)
{
    double E = est_raw(C, m, q);
    if (E <= 2.5 * m) return C[0] != 0 ? est_linear(C, m) : E;
    if (hash_bits != 32) return E;
    double two32 = 4294967296.0;
    if (E <= two32 / 30.0) return E;
    return -two32 * log(1.0 - E / two32); /* NaN once E >= 2^32 */
}
所有估计器都只依赖寄存器直方图 \(C_k\)(值为 \(k\) 的寄存器个数),实验程序在插入过程中增量维护直方图,于是同一条插入序列上每个检查点都能同时算出所有估计器。
实测:64 位哈希,\(p = 14\)
实验设置:每次试验插入 \(10^7\) 个不同元素,在 \(1\) 到 \(10^7\) 之间按对数均匀取 130 个检查点(每十倍 20 个,取整后去重),共 1000 次独立试验。元素的哈希值用 splitmix64 生成(它是 64 位整数上的双射,用来近似理想哈希),每次试验的输入区间互不重叠。三个种子的结论一致,下面的图和表用种子 1。
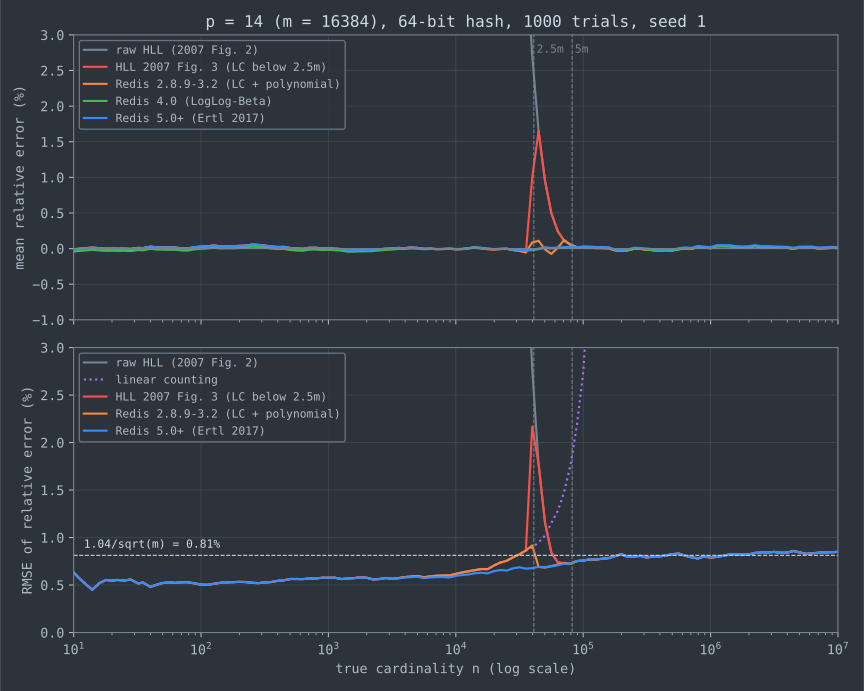
几个检查点的数值(平均相对误差 / 均方根误差,单位 %):
| \(n\) | \(n/m\) | 原始估计 | 线性计数 | 2007 三段式 | Ertl(Redis 5.0+) |
|---|---|---|---|---|---|
| 1,000 | 0.06 | +1130.50 / 1130.50 | +0.01 / 0.58 | +0.01 / 0.58 | +0.01 / 0.58 |
| 10,000 | 0.61 | +73.27 / 73.28 | −0.01 / 0.62 | −0.01 / 0.62 | −0.01 / 0.60 |
| 39,811 | 2.43 | +2.70 / 2.77 | −0.04 / 0.90 | +1.00 / 2.17 | −0.01 / 0.68 |
| 44,668 | 2.73 | +1.65 / 1.77 | −0.02 / 0.95 | +1.65 / 1.77 | −0.00 / 0.69 |
| 63,096 | 3.85 | +0.25 / 0.74 | −0.01 / 1.28 | +0.25 / 0.74 | +0.02 / 0.71 |
| 125,893 | 7.68 | +0.01 / 0.77 | +0.62 / 5.26 | +0.01 / 0.77 | +0.02 / 0.77 |
| \(10^7\) | 610 | +0.01 / 0.85 | 无定义 | +0.01 / 0.85 | +0.02 / 0.85 |
读法:
- 原始估计在小基数时完全不可用。 \(n = 1000\) 时平均高估 11 倍,就是那个 \(0.7m\) 的底。
- 线性计数在小基数时比 \(1.04/\sqrt{m}\) 更准(\(n \le 10^4\) 时 RMSE 约 0.6%),但位图快填满时发散:\(n/m = 7.7\) 时 RMSE 已达 5.26%,再往后空寄存器数变成 0,公式无定义。
- 三段式的切换点附近有一个误差峰。 论文第 4 节说,模拟显示 \(n = \frac{5}{2} m\) 时已经进入渐近区、“没有可检测的偏差”。实测不支持这句话:\(n = 2.73m\) 时原始估计仍有 +1.65% 的平均偏差,要到约 \(5m\) 才降到 0.1% 以下。HLL++ 论文 Figure 4 给出的也是同样的结论(“at that point, the raw estimate is still significantly biased”)。\(n = 2.43m\) 处 RMSE 达到 2.17%,是因为一部分试验的原始估计已越过 \(\frac{5}{2}m\)、用了有偏的原始估计,另一部分仍用线性计数,两种结果混在一起。
- Ertl 估计器全程平滑。 三个种子下平均偏差的绝对值都不超过 0.06%,RMSE 不超过 0.86%,过渡区反而比渐近区更准(约 0.68%)。
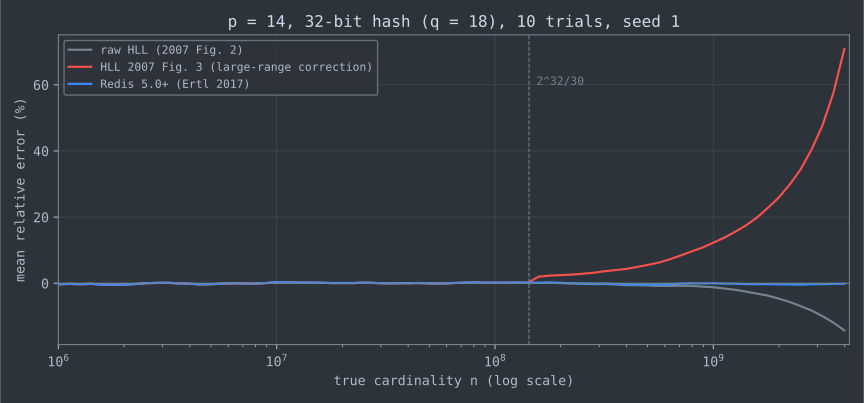
32 位哈希与大范围修正
论文的第三段只在 32 位哈希下有意义。把
accuracy.c 切到 32 位哈希(\(q = 18\)),10
次试验,每次插入到 \(4 \times
10^9\):
| \(n\) | 原始估计 | 2007 三段式(含大范围修正) | Ertl |
|---|---|---|---|
| \(2.0 \times 10^8\) | +0.06% | +2.46% | +0.13% |
| \(5.0 \times 10^8\) | −0.69% | +5.55% | −0.37% |
| \(1.0 \times 10^9\) | −1.20% | +12.27% | −0.02% |
| \(2.0 \times 10^9\) | −4.65% | +25.95% | −0.35% |
| \(4.0 \times 10^9\) | −14.26% | +70.85% | −0.18% |
大范围修正让偏差反了方向,而且比不修正还大:\(10^9\) 时是原始估计的 10 倍,\(4 \times 10^9\) 时是 5 倍。Ertl 估计器在 \(10^6\) 以上的所有检查点上平均偏差都不超过 0.43%。原因在于它的前提不成立:\(n\) 个元素中哈希值相同的那些,写进的是同一个寄存器、同一个值,草图(sketch)的分布与”\(n\) 个独立的 32 位哈希值”完全相同,原始估计本来就在估计 \(n\),而不是不同哈希值的个数。原始估计在大基数时的低估来自寄存器在 \(q + 1 = 19\) 处截断,再套一次碰撞反解就重复修正了。Ertl(arXiv:1702.01284,第 3 节)得出了同样的结论:“it even makes the bias worse … instead of underestimating the cardinalities, they are now overestimated”,并指出所有寄存器都等于 \(q+1\) 时原始估计为 \(\alpha_m 2^{33} > 2^{32}\),修正公式根本无定义。
四种补救:经验表、多项式、LogLog-Beta 与 Ertl
过渡区的偏差是公认的问题,解法分成两类:拿模拟数据拟合偏差,或从模型推出新的估计器。
HyperLogLog++ 的经验偏差表。 Heule、Nunkesser 和 Hall(EDBT 2013)对每个精度 \(p\) 做大量模拟(每个基数 5000 个数据点),记录原始估计的平均值与偏差;估计时对 \(E \le 5m\) 用 \(k\) 近邻插值(\(k = 6\),论文脚注说这个选择”rather arbitrary”)求出偏差并减掉。线性计数与去偏估计的切换阈值也由实验确定,\(p = 14\) 时为 11500,并用线性计数的结果来判断落在哪一侧。论文 Figure 3 显示,\(p = 14\) 时去偏估计在约 18000 到 61000 之间误差更小。这套做法依赖 Google 公布的经验数据表,本文没有复现。
Redis 2.8.9 到 3.2 的多项式。 同样的思路,数据换成一个四次多项式:\(E < 2.5m\) 且有空寄存器时用线性计数,否则在 \(E < 72000\) 时按拟合出的百分比偏差修正(只对 \(m = 16384\) 生效)。实测它把三段式的偏差峰从 1.65% 压到 0.17% 以内,RMSE 最大 0.93%(三个种子)。
LogLog-Beta。 Qin、Kim 和 Tung(arXiv:1612.02284,预印本)用一个以空寄存器数 \(C_0\) 为自变量的函数 \(\beta(C_0)\) 修正分母:
\[ E = \frac{\alpha_m \, m \, (m - C_0)}{\beta(C_0) + \sum_j 2^{-M[j]}}, \]
\(\beta\) 是 \(\ln(C_0 + 1)\) 的七次多项式加一个线性项,系数由拟合得到,只用一个公式覆盖全部范围。Redis 4.0 采用了它。实测三个种子下平均偏差的绝对值不超过 0.08%。
Ertl 的改进原始估计器。 Otmar Ertl 的 New cardinality estimation algorithms for HyperLogLog sketches(arXiv:1702.01284,预印本)不拟合数据,而是在泊松模型下分析原始估计为什么在两端失效:值为 0 的寄存器和值为 \(q+1\) 的寄存器各自”截断”了信息,直接把它们当作普通寄存器代入调和平均就会有偏。他把这两类寄存器的贡献换成由模型推出的期望值,得到论文式 (32):
\[ \hat{n} = \frac{\alpha_\infty m^2}{m\,\sigma\!\left(\frac{C_0}{m}\right) + \sum_{k=1}^{q} C_k 2^{-k} + m\,\tau\!\left(1 - \frac{C_{q+1}}{m}\right) 2^{-q}}, \]
\[ \sigma(x) = x + \sum_{k=1}^{\infty} x^{2^k} 2^{k-1}, \qquad \tau(x) = \frac{1}{2}\left(-x + \sum_{k=1}^{\infty} x^{2^{-k}} 2^{-k}\right). \]
\(\sigma\) 的级数在
\([0, 1)\)
上二次收敛,几次迭代就停。Redis 的 hllTau()
用的是另一种写法 \(\frac{1}{3}\big(1 - x - \sum_{k \ge 1}
(1 - x^{2^{-k}})^2
2^{-k}\big)\),数值上与上式一致(在 \(x = 0.1, 0.3, 0.5, 0.9, 0.99\)
处比较,差异在 \(10^{-16}\)
量级)。取 \(q = 0\)
时这个式子退化为近似的线性计数,所以它把”小范围改用线性计数”这一步也吸收进去了。Ertl
在同一篇文章里还给出了更精确的最大似然估计器,以及基于两个草图联合估计交集的方法。Redis
5.0 起改用式 (32),这就是上文实测里标为”Ertl(Redis
5.0+)“的曲线。
四种方案的共同点是都只看寄存器直方图,不改变插入过程和草图格式,所以 Redis 换估计器不需要迁移已有数据。
五、HyperLogLog++ 的稀疏表示
HLL++ 论文的另一项改进针对”大量小计数器”:在 Google 的 PowerDrill 里,一次查询常常同时维护许多 count distinct,大多数基数远小于 \(m\),每个都占满 \(6m\) 位很浪费。
稀疏表示。 只存非零寄存器的 \((\mathit{idx}, \rho(w))\) 对,把桶号放在高位、\(\rho\) 放在低位拼成一个整数,维护一个有序列表;新元素先放进一个无序的临时集合,临时集合达到稀疏表示上限的 25% 时排序并合并进列表,同桶号只保留最大的 \(\rho\)。列表用变长整数编码加差分编码压缩。稀疏表示超过 \(6m\) 位时转为密集数组。
更高的稀疏精度 \(p'\)。 稀疏阶段可以用更大的精度 \(p' > p\) 计算桶号。转换到密集表示时,桶号取 \(\mathit{idx}'\) 的高 \(p\) 位;\(\mathit{idx}'\) 中多出来的 \(p' - p\) 位如果有 1,就用它们算 \(\rho\),全为 0 时 \(\rho = \rho(w') + (p' - p)\)。论文固定 \(p' = 25\),因为 25 位桶号、6 位 \(\rho\) 和 1 位标志正好放进 32 位整数;而且稀疏阶段总是落在线性计数的范围内,只需要桶号,所以只有 \(p' - p\) 位全为 0 时才需要存 \(\rho(w')\),出现概率是 \(2^{p - p'}\)。
论文 Table 1 列出了 \(p = 14\) 时稀疏表示在达到 \(6m\) 位之前最多能存多少个不同桶号:只用有序列表是 3072 个,加变长编码 5043.91 个,再加差分编码 8366.45 个,再加上述哈希编码的 HLL++ 是 12107 个。结论部分称,\(p = 14\)、\(p' = 25\) 时,基数在约 12000 以下的平均误差降为原来的四分之一。
Redis 也有稀疏表示,但它是对 \(p = 14\) 的寄存器数组做游程编码,不提高精度(第七节)。
六、合并与集合运算
逐寄存器取 max 就是并集
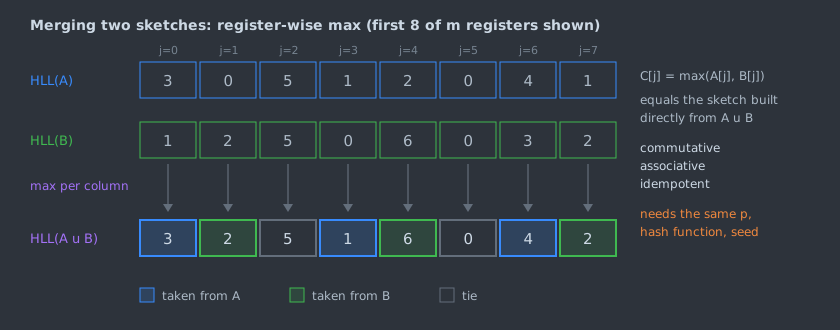
寄存器 \(M_S[j]\) 是集合 \(S\) 中落入桶 \(j\) 的元素的 \(\rho\) 的最大值。\(A \cup B\) 中落入桶 \(j\) 的元素要么来自 \(A\)、要么来自 \(B\),所以
\[ M_{A \cup B}[j] = \max\left(M_A[j],\ M_B[j]\right). \]
这是一个等式,不是近似:合并后的草图与直接对 \(A \cup B\)
建的草图逐字节相同,估计值也就完全相同。reproduce/hll.c
的自测用 memcmp
验证了这一点,同时验证了重复插入不改变草图、合并满足交换律和幂等律:
/* reproduce/hll.c */
static void hll_merge(hll_t *dst, const hll_t *src)
{
    for (int j = 0; j < HLL_M; j++)
        if (src->reg[j] > dst->reg[j]) dst->reg[j] = src->reg[j];
}
ok memcmp(&once, &many, sizeof once) == 0
ok memcmp(&tmp, &u, sizeof u) == 0
ok memcmp(&tmp, &u, sizeof u) == 0
ok memcmp(&tmp, &u, sizeof u) == 0
ok mx <= HLL_Q + 1
|A|=50071 (50000) |B|=50007 (50000) |A u B|=75159 (75000) |A|+|B|-|A u B|=24919 (25000)四行 ok
依次是:同一批元素插一次和插十次的草图相同;\(\mathrm{merge}(A, B)\)
等于直接建的 \(A \cup
B\);\(\mathrm{merge}(B,
A)\) 也等于它;再合并一次 \(A\) 不变。
逐元素取 max 构成一个半格(join-semilattice),合并满足交换律、结合律和幂等律,这正是 Shapiro 等人(SSS 2011)定义的基于状态的无冲突复制数据类型(CRDT)所要求的合并性质。工程上的含义是:分片各自计数、按小时预聚合再合并成天、消息重复投递导致同一份草图被合并两次,结果都一样。前提是所有草图用同样的 \(p\)、同一个哈希函数和同一个种子。
交集与差集只能间接估计
HyperLogLog 原生只支持并集。常见做法是容斥:
\[ |A \cap B| \approx \hat{n}_A + \hat{n}_B - \hat{n}_{A \cup B}. \]
上面的自测是一次这样的估计,得到 24919(真值 25000)。问题在于误差的量级由 \(|A \cup B|\) 决定:三个估计各自有约 \(0.81\%\) 的相对误差,相减后绝对误差仍是 \(|A \cup B|\) 的百分之一量级。按这个量级推算,如果交集只占并集的 1%,交集估计的相对误差就可能与交集本身同一数量级。Ertl 在论文引言里引用前人的结果指出,容斥在 Jaccard 指数小时”can become quite inaccurate”,并在第 5 节给出了基于两个草图的联合最大似然估计,模拟中比容斥好得多。需要精确处理交集时,保留样本的 KMV(k-minimum values)一类方法更合适。
HyperLogLog 也不支持删除:max 不可逆,无法从草图里减去一个元素。需要滑动窗口时,通常按时间片各建一个草图,查询时合并窗口内的时间片。
七、Redis 7.2.5 的实现
Redis 从 2.8.9 起提供
PFADD、PFCOUNT、PFMERGE。antirez
在发布博客里写道,命令前缀 PF 是为了纪念 Philippe
Flajolet。以下源码均出自 Redis 7.2.5 的
src/hyperloglog.c,行为用本地编译的 7.2.5
redis-server 验证过。
参数与头部
/* Redis 7.2.5 src/hyperloglog.c(节选) */
#define HLL_P 14 /* The greater is P, the smaller the error. */
#define HLL_Q (64-HLL_P) /* The number of bits of the hash value used for
                            determining the number of leading zeros. */
#define HLL_REGISTERS (1<<HLL_P) /* With P=14, 16384 registers. */
#define HLL_BITS 6 /* Enough to count up to 63 leading zeroes. */
#define HLL_DENSE_SIZE (HLL_HDR_SIZE+((HLL_REGISTERS*HLL_BITS+7)/8))
HLL 就是一个 Redis 字符串,前 16 字节是
struct hllhdr:4 字节魔数
"HYLL"、1 字节编码(HLL_DENSE 或
HLL_SPARSE)、3 字节保留、8
字节小端的缓存基数。缓存基数最高字节的最高位为 1
表示缓存失效。所以密集表示是 \(16
+ 12288 = 12304\) 字节。
哈希与 \(\rho\)
/* Redis 7.2.5 src/hyperloglog.c, hllPatLen()(删去了注释) */
    hash = MurmurHash64A(ele,elesize,0xadc83b19ULL);
    index = hash & HLL_P_MASK; /* Register index. */
    hash >>= HLL_P; /* Remove bits used to address the register. */
    hash |= ((uint64_t)1<<HLL_Q); /* Make sure the loop terminates
                                     and count will be <= Q+1. */
    bit = 1;
    count = 1; /* Initialized to 1 since we count the "00000...1" pattern. */
    while((hash & bit) == 0) {
        count++;
        bit <<= 1;
    }
哈希函数是 MurmurHash2 的 64 位版本
MurmurHash64A,源码注释说改成了与字节序无关,种子固定为
0xadc83b19。桶号取低 14 位,剩下 50
位从最低位往上数 0,第 50 位强制置 1,保证
count 不超过 51。这就是图”HyperLogLog
插入一个元素”下半部分的约定。
密集表示:6 位寄存器紧密排列
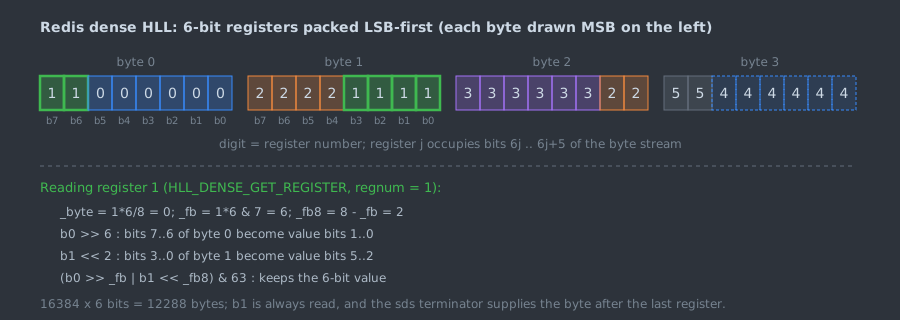
/* Redis 7.2.5 src/hyperloglog.c */
#define HLL_DENSE_GET_REGISTER(target,p,regnum) do { \
    uint8_t *_p = (uint8_t*) p; \
    unsigned long _byte = regnum*HLL_BITS/8; \
    unsigned long _fb = regnum*HLL_BITS&7; \
    unsigned long _fb8 = 8 - _fb; \
    unsigned long b0 = _p[_byte]; \
    unsigned long b1 = _p[_byte+1]; \
    target = ((b0 >> _fb) | (b1 << _fb8)) & HLL_REGISTER_MAX; \
} while(0)
寄存器 \(j\)
占字节流中的第 \(6j\) 到
\(6j+5\)
位,从每个字节的最低位开始用。宏无条件读取下一个字节,不做”是否跨字节”的分支;读最后一个寄存器时越过数组末尾的那个字节由
sds 字符串的结尾 '\0' 提供(源码注释)。
稀疏表示:游程编码
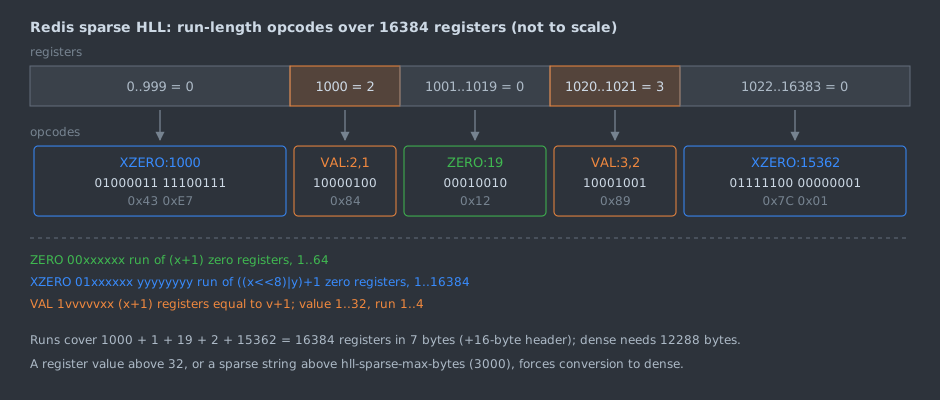
新建的 HLL 总是稀疏的:createHLLObject()
写入一个 XZERO:16384,加上头部共 18
字节。三种操作码是:ZERO(00xxxxxx,1
到 64 个
0)、XZERO(01xxxxxx yyyyyyyy,1
到 16384 个 0)、VAL(1vvvvvxx,1
到 4 个值为 1 到 32
的寄存器)。上图的例子取自源码注释,五个操作码覆盖全部 16384
个寄存器,只用 7 字节。
hllSparseSet() 在两种情况下把 HLL
转为密集表示:新值大于 32(VAL
装不下),或者更新后的长度超过
server.hll_sparse_max_bytes。这个配置项
hll-sparse-max-bytes 在 config.c
里的默认值是 3000,比较的是包含 16
字节头部在内的字符串长度。reproduce/redis_check.py
对 7.2.5 实测:
| 项目 | 实测 |
|---|---|
空 HLL(PFADD key 不带元素)的
STRLEN |
18 字节 |
| 转为密集时已插入的不同元素数(20 次试验) | 最少 1650,中位数 1673,最多 1703 |
| 转换前最后一次的稀疏长度 | 2999 到 3000 字节 |
| 密集表示长度 | 12304 字节 |
源码注释里有一张 100
个样本平均的”基数与稀疏字节数”表:基数 1000 时 1882
字节,2000 时 3480
字节,与实测的转换点一致。redis.conf
的注释建议保持在 3000 左右;如果 CPU
不是瓶颈、数据集由大量基数在 0 到 15000 的 HLL
组成,可以调到约 10000,代价是稀疏编码下 PFADD
是 \(O(N)\) 的。
估计器与三次更换
/* Redis 7.2.5 src/hyperloglog.c, hllCount()(节选) */
    double z = m * hllTau((m-reghisto[HLL_Q+1])/(double)m);
    for (j = HLL_Q; j >= 1; --j) {
        z += reghisto[j];
        z *= 0.5;
    }
    z += m * hllSigma(reghisto[0]/(double)m);
    E = llroundl(HLL_ALPHA_INF*m*m/z);
循环是 Horner 形式:从 \(k = q\) 往下,每步加 \(C_k\) 再乘 \(1/2\),最后得到 \(\sum_{k=1}^{q} C_k 2^{-k} + m\,\tau(\cdot)\,2^{-q}\),再加 \(m\,\sigma(C_0/m)\),正是第四节的式 (32)。按 GitHub 上各版本 tag 的源码,Redis 的估计器经历了三版:
| 版本 | 估计器 | 本文实测(64 位哈希,三个种子) |
|---|---|---|
| 2.8.9 到 3.2 | \(\alpha_m = 0.7213/(1+1.079/m)\);\(E < 2.5m\) 用线性计数,\(E < 72000\) 用多项式修正;不做大范围修正 | 平均偏差绝对值不超过 0.17%,RMSE 不超过 0.93% |
| 4.0 | LogLog-Beta | 平均偏差绝对值不超过 0.08% |
| 5.0 到 7.2 | Ertl 式 (32),hllSigma() /
hllTau() |
平均偏差绝对值不超过 0.06%,RMSE 不超过 0.86% |
3.2 的源码注释说明了为什么不做大范围修正:用的是 64 位哈希和 6 位寄存器,要逼近 \(2^{64}/30\) 需要大得不现实的集合。
reproduce/hll.c 按同样的哈希、桶号、\(\rho\) 和估计器实现,对
elem:0 到 elem:N-1
这组输入,与真实的 PFCOUNT 在 9
个检查点上逐个相等:
| \(N\) | 1 | 10 | 100 | 1000 | 2000 | 5000 | 10000 | 100000 | 1000000 |
|---|---|---|---|---|---|---|---|---|---|
PFCOUNT |
1 | 10 | 100 | 1005 | 1994 | 4973 | 9922 | 99904 | 990064 |
命令层面的细节
PFADD在新建 key 或有寄存器变大时返回 1,并让缓存基数失效;重复元素和不改变任何寄存器的新元素返回 0。- 单 key 的
PFCOUNT缓存有效时直接返回缓存值;否则重算并写回头部。因此这个只读命令会修改 value,源码里为此调用了signalModifiedKey()并增加server.dirty,写回会传播到副本。 - 多 key 的
PFCOUNT key1 key2 ...每次都把所有 key 合并到一个栈上的uint8_t数组(内部编码HLL_RAW),再算一次估计,结果不缓存。代价与 key 数乘以 16384 成正比。 PFMERGE dest src ...的合并循环从argv[1]开始,也就是dest原有的内容也参与并集;只要有一个输入是密集表示,目标就先转成密集表示。
八、争论与开放问题
“接近最优”指的是什么
2007 年论文标题里的 near-optimal 有两层依据(论文第 4 节):\((1 \pm \varepsilon)\) 近似地数到 \(N\) 至少需要 \(\Omega(\log \log N)\) 位;对一大类基于顺序统计量的算法,Chassaing 和 Gérin 证明精度下界接近 \(1/\sqrt{m}\)。这是数量级上的最优。
之后的工作从两个方向说明常数还有空间:
- 渐近空间。 Kane、Nelson、Woodruff(PODS 2010)的 \(O(\varepsilon^{-2} + \log n)\) 位去掉了 \(\log \log n\) 因子,并证明这是最优的。
- 常数。 Pettie 和 Wang(STOC 2021)定义了 Fisher-Shannon 数(草图熵与 Fisher 信息之比)来比较常数。他们证明 PCSA 的各种变体都是 \(H_0/I_0 \approx 1.98016\),而 HyperLogLog 的每个变体都比它差,只在底数趋于无穷时趋近这个值;基于压缩 PCSA 的 Fishmonger 草图用约 \(1.98m\) 位达到 \(1/\sqrt{m}\) 的标准误差,1% 误差约需 2.42 KB。作为对照,固定 6 位寄存器的 HyperLogLog 要达到 \(1.04/\sqrt{m} = 1\%\),需要 \(m = (1.04/0.01)^2 \approx 10816\) 个寄存器,即 8112 字节,约 7.9 KB。Lang(arXiv:1708.06839,预印本)用压缩后的 FM85 状态得到比 HLL 熵还小的草图;Ertl 的 UltraLogLog(PVLDB 17(7), 2024)换用信息更多的 8 位寄存器,在保持可合并、常数时间插入的前提下,用最大似然估计比 HyperLogLog 省 28% 空间,用更简单的估计器省 24%。
所以”HyperLogLog 是最优的”只在数量级上成立。它至今仍是默认选择,靠的是实现简单、固定大小、合并就是逐字节取 max。Pettie 和 Wang 为 \(H_0/I_0\) 是可合并草图的最优 Fisher-Shannon 数给出了间接证据:他们定义了”可线性化”(linearizable)草图这一子类,证明其中没有成员能超过 \(H_0/I_0\),常用的可合并草图都属于这一类。对一般的可合并草图,这仍是开放问题。
估计器该靠经验数据还是靠模型
HLL++ 的经验偏差表、Redis 3.2 的多项式和 LogLog-Beta 都是拟合出来的,绑定具体精度:Redis 3.2 的多项式只在 \(m = 16384\) 时启用,HLL++ 为每个 \(p\) 单独建表。Ertl 的批评是这些方法”treat the symptom and not the cause”,他从泊松模型推出的式 (32) 不需要任何经验数据,对任意 \((p, q)\) 都适用。本文的实测与这个判断一致:实测的两种拟合方案中较好的 LogLog-Beta 偏差不超过 0.08%,式 (32) 不超过 0.06%,而且式 (32) 在 32 位哈希下同样有效(第四节)。HLL++ 的经验表没有复现,不在比较之列。
另一面是 2007 年论文自己的说法与数据不符:它说 \(n = \frac{5}{2}m\) 时已无可检测的偏差,HLL++ 的 Figure 4 和本文的实测都显示此时原始估计仍有 1% 到 3% 的偏差。三段式里的阈值 \(\frac{5}{2}m\) 定得太早;HLL++ 的偏差修正覆盖到 \(5m\),针对的正是这一段。
可合并性与方差
如果只有一条数据流、不需要合并,可以在插入时顺便维护估计值:每当一个寄存器被改写,就按它被改写的概率的倒数给计数加一个增量。这类鞅(martingale)估计器或 HIP(historic inverse probability)估计器见 Ting(KDD 2014)和 Cohen(PODS 2014)。代价是这个计数是插入过程的副产品,不能从寄存器状态里恢复;两个草图合并后,合并结果没有对应的计数可用。所以 UltraLogLog 论文把鞅估计限定在”non-distributed setting”,并报告在这种场景下 UltraLogLog 相对 HyperLogLog 可省 17% 空间。选哪一种取决于是否需要合并。
反例:对抗性输入
所有精度结论都假设哈希值独立均匀。Paterson 和
Raynal(HyperLogLog: Exponentially Bad in Adversarial
Settings,IEEE EuroS&P 2022)证明,如果攻击者了解
HLL
的内部状态、又能在一定程度上选择被计数的输入,就能让估计值比真实基数小指数倍;他们分析了原始算法和
Redis 使用的 Ertl
版本,并给出一种可证明防止这种操纵的简单改法。Redis
的哈希函数和种子 0xadc83b19 都是公开的,所以用
PFCOUNT
统计攻击者可控的输入(例如扫描源地址、用户自报的
ID)时,不能把 0.81% 当作保证。
开放问题
- 可合并草图的最优常数。 \(H_0/I_0 \approx 1.98\) 是否是一般可合并草图的下界,Pettie 和 Wang 只对可线性化这一子类证明了。入口:Pettie & Wang, STOC 2021。
- 只用草图估计交集。 容斥在 Jaccard 指数小时不准,Ertl 的联合最大似然估计明显更好,但要做多维函数最大化,比单个草图的估计贵得多。他在第 6 节推测存在像式 (32) 那样又快又准的双草图算法,扩展到三个以上草图是否可行也待研究。入口:Ertl, arXiv:1702.01284,第 5、6 节。
九、工程上的注意事项
| 问题 | 后果 | 做法 |
|---|---|---|
| 把 0.81% 当误差上限 | 约三分之一的估计超出 \(\pm 0.81\%\)(第三节实测 67% 到 69% 落在 \(1\sigma\) 内) | 按 \(2\sigma \approx 1.6\%\) 或 \(3\sigma \approx 2.4\%\) 设告警阈值 |
| 自己实现时照抄 2007 年三段式 | 基数在 \(2.5m\) 附近平均偏差约 1.65%,RMSE 约 2.2%;32 位哈希下大范围修正越修越偏 | 用 Ertl 式 (32),或至少改用 64 位哈希并去掉大范围修正 |
| 不同服务用不同哈希、种子或 \(p\) 生成草图 | 合并结果没有意义,而且不会报错 | 把哈希函数、种子、\(p\) 写进序列化格式并在合并前校验 |
| 同一个 ID 在不同服务里编码不同(整数与字符串、大小写、字节序) | 同一元素被计为多个 | 在进入草图前统一规范化 |
| 用容斥估计很小的交集 | 误差量级由并集大小决定,交集越小相对误差越大 | 改用联合估计或 KMV 类样本草图 |
| 大量低基数 key | 默认配置下约 1700 个不同元素就转为密集表示,每个 key 固定占 12304 字节 | 按 redis.conf 的说明,在 CPU
与内存之间权衡调高 hll-sparse-max-bytes |
高频调用多 key PFCOUNT |
每次都合并所有 key 的 16384 个寄存器,结果不缓存 | 定期用 PFMERGE 预合并,再对结果调用单 key
PFCOUNT |
| 统计攻击者可控的输入 | 估计可以被操纵得远小于真实值 | 不把公开哈希的 HLL 用于安全决策;确需使用时参考 Paterson 和 Raynal 的改法 |
十、参考资料
文档
- Redis
7.2.5,
redis.conf:hll-sparse-max-bytes的注释与建议值。 - S. Sanfilippo(antirez),“Redis new data structure: the HyperLogLog”,2014,http://antirez.com/news/75。
源码
- Redis 7.2.5(commit
f60370ce28b946c1146dcea77c9c399d39601aaa):src/hyperloglog.c(struct hllhdr、hllPatLen()、HLL_DENSE_GET_REGISTER、稀疏操作码、hllSparseSet()、hllSigma()、hllTau()、hllCount()、pfcountCommand()、pfmergeCommand()),src/config.c(hll-sparse-max-bytes默认 3000)。 - Redis 2.8.9、3.2.0、4.0.0、4.0.14、5.0.0 各 tag 的
src/hyperloglog.c:估计器的演变。
核心论文
- P. Flajolet, G. N. Martin, “Probabilistic Counting Algorithms for Data Base Applications”, JCSS 31(2):182–209, 1985。初版 FOCS 1983, pp. 76–82。
- M. Durand, P. Flajolet, “Loglog Counting of Large Cardinalities”, ESA 2003, LNCS 2832, pp. 605–617。
- P. Flajolet, É. Fusy, O. Gandouet, F. Meunier, “HyperLogLog: the analysis of a near-optimal cardinality estimation algorithm”, AofA 2007, DMTCS Proceedings AH, pp. 127–146。
- S. Heule, M. Nunkesser, A. Hall, “HyperLogLog in Practice: Algorithmic Engineering of a State of The Art Cardinality Estimation Algorithm”, EDBT 2013, pp. 683–692。
- O. Ertl, “New cardinality estimation algorithms for HyperLogLog sketches”, arXiv:1702.01284, 2017(预印本)。
其他论文
- K.-Y. Whang, B. T. Vander-Zanden, H. M. Taylor, “A Linear-Time Probabilistic Counting Algorithm for Database Applications”, ACM TODS 15(2):208–229, 1990。
- J. Qin, D. Kim, Y. Tung, “LogLog-Beta and More: A New Algorithm for Cardinality Estimation Based on LogLog Counting”, arXiv:1612.02284, 2016(预印本)。
- D. M. Kane, J. Nelson, D. P. Woodruff, “An Optimal Algorithm for the Distinct Elements Problem”, PODS 2010, pp. 41–52。
- S. Pettie, D. Wang, “Information Theoretic Limits of Cardinality Estimation: Fisher Meets Shannon”, STOC 2021, pp. 556–569。
- K. J. Lang, “Back to the Future: an Even More Nearly Optimal Cardinality Estimation Algorithm”, arXiv:1708.06839, 2017(预印本)。
- O. Ertl, “UltraLogLog: A Practical and More Space-Efficient Alternative to HyperLogLog for Approximate Distinct Counting”, PVLDB 17(7):1655–1668, 2024。
- D. Ting, “Streamed Approximate Counting of Distinct Elements: Beating Optimal Batch Methods”, KDD 2014, pp. 442–451。
- E. Cohen, “All-Distances Sketches, Revisited: HIP Estimators for Massive Graphs Analysis”, PODS 2014, pp. 88–99。
- K. G. Paterson, M. Raynal, “HyperLogLog: Exponentially Bad in Adversarial Settings”, IEEE EuroS&P 2022, pp. 154–170。
- M. Shapiro, N. Preguiça, C. Baquero, M. Zawirski, “Conflict-Free Replicated Data Types”, SSS 2011, LNCS 6976, pp. 386–400。
实验
reproduce/estimators.h:第四节的六种估计器(原始估计、线性计数、2007 年三段式、Redis 3.2 多项式、LogLog-Beta、Ertl 式 (32))。reproduce/accuracy.c:第三、四节的误差实验,gcc -O2 -Wall -Wextra -o accuracy accuracy.c -lm && ./accuracy 64 1000 10000000 1,输出见reproduce/results/acc64_s1.csv到acc64_s3.csv与acc32_s1.csv。reproduce/hll.c:与 Redis 兼容的 HyperLogLog 与第六节的合并自测,输出见reproduce/results/selftest.txt。reproduce/redis_check.py:第七节对 Redis 7.2.5 的对照与稀疏转换测量,需要REDIS_SERVER指向redis-server,输出见reproduce/results/redis_check.txt。reproduce/run.sh:一次性编译(含 ASan/UBSan 构建)并运行以上全部实验;reproduce/plot_accuracy.py:由 CSV 画出第四节的两张图。
系列导航: - 上一篇:Unicode 文本算法:UTF-8 编解码与验证、规范化、字素簇与双向文本安全 - 下一篇:Count-Min Sketch:点查询误差界、保守更新与生产实现
相关阅读: - Bloom Filter 家族:从位数组到 Ribbon,每键位数离下界还差多少 - 流式算法总论:数据流模型、频率矩下界与线性 sketch
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
查询优化器:System R 动态规划、Cascades Memo 与基数误差
从 System R 的左深动态规划与 interesting orders 出发,解释 Volcano/Cascades 如何用 memo、规则和物理性质组织搜索,再用可复现实验展示查询图形状与基数估计误差如何决定计划质量。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
B-tree 深度解剖:从磁盘 I/O 模型到 boltdb 源码
从 Bayer-McCreight 1972 推导树高与分裂摊还代价,用计数模拟器和 bbolt v1.5.0 实测:随机插入页填充约 69%,按键序插入由分裂点决定是 50% 还是近 100%;再对照 bbolt、PostgreSQL、SQLite 源码看删除、写时复制与 B-link 并发。
B+tree 与 LSM-tree:原地更新与异地更新的读、写、空间代价
从 O'Neil 1996 与 Dostoevsky 的代价模型推导两类结构的读写空间放大,用计数模拟器在同一负载上实测:B+tree 写放大随缓冲池从 126 降到 8.6,leveled LSM 为 14.4,并对照 RUM 猜想原文与生产数据。