“这个字符串有多长”在 Unicode
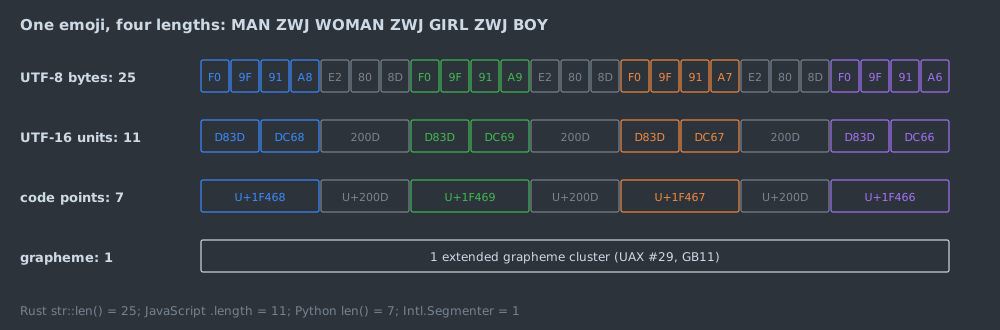
里至少有四个答案。一家四口的表情符号 👨👩👧👦 由 7 个码点组成:4
个人物加 3 个零宽连接符(ZWJ)。它在 UTF-8 里占 25 字节,在
UTF-16 里占 11 个码元,而用户看到的只是 1 个字符。Rust 的
str::len() 返回 25,JavaScript 的
.length 返回 11,Python 的 len()
返回 7,Intl.Segmenter 切出 1
段。四个数都对,只是数的东西不同。
围绕 Unicode 文本处理流传的几种说法都只对一半:
- “UTF-8 最长 6 字节”。1992 年的原始设计确实是 1 到 6 字节、31 位;2003 年的 RFC 3629 把它收窄到 U+10FFFF 和 1 到 4 字节。
- “遇到坏字节,替换成几个 U+FFFD 都行”。标准只推荐一种替换方式;2017 年 Unicode 技术委员会曾决定改推荐 ICU 的做法,不到三个月又撤回。本文实测的 Go 标准库有两种替换数量,都与推荐做法不同。
- “两段 NFC 文本拼起来还是 NFC”。不是:
a和 U+0301 各自都是 NFC,拼起来就不是了。 - “先
lower()再比较,就是大小写无关比较”。德语 ß、土耳其语的 i、希腊语词尾的 σ 都会让它出错。 - “双向控制字符只影响显示”。2021 年的 Trojan Source 攻击正是利用这一点,让编译器读到的代码和审查者看到的代码不一样。
本文按”字节 → 码点 → 字符 → 文本”的顺序展开:先讲 UTF-8 的来历、位布局和合法序列表,再讲解码器和非法序列替换,然后是三种验证算法(逐字符分支、Hoehrmann DFA、Keiser–Lemire SIMD 查表)和实测;后半部分依次是非法序列的安全后果、规范化(UAX #15)、字素簇(UAX #29)、大小写折叠、排序、双向文本与 Trojan Source,最后是工程清单、争论与开放问题。所有规范条目以 Unicode 16.0 为准。
文中的数字有两个来源:同目录 reproduce/
里的程序(C 编解码器和验证器、穷举测试、与 CPython、glibc
iconv、ICU 的交叉比对、Python 3.14.5 与 Node 24.5
的事实核对脚本),以及注明到章节或表格的外部文献。
一、码点、标量值与编码形式
码点空间
Unicode 给每个抽象字符分配一个整数,叫码点(code point),取值范围是 \(0\) 到 \(\mathtt{0x10FFFF}\),写作 U+0000 到 U+10FFFF。这个范围分成 17 个平面,每个平面 \(2^{16}\) 个码点,共
\[17 \times 2^{16} = 1\,114\,112\]
个码点。其中 U+D800 到 U+DFFF 这 2048 个是代理码点(surrogate code point),只供 UTF-16 用来拼接辅助平面字符,本身不代表任何字符。去掉代理码点后剩下的叫 Unicode 标量值(Unicode scalar value,Unicode 16.0 第 3 章 D76),共
\[1\,114\,112 - 2048 = 1\,112\,064\]
个。D79 把编码形式(encoding
form)定义为”从每个 Unicode
标量值到唯一码元序列的映射”。换句话说,UTF-8、UTF-16、UTF-32
编码的对象都是标量值,不是码点:单独的代理码点在任何一种编码形式里都不合法。reproduce/test_utf8.c
对 0 到 \(2^{21}-1\)
的每个整数调用编码器,结果是 1,112,064 个可编码,2048
个代理码点和 983,040 个大于 U+10FFFF
的值被拒绝,与上面的算术一致。
三种编码形式
| 编码形式 | 码元 | 每个标量值的码元数 | 特点 |
|---|---|---|---|
| UTF-8(D92) | 8 位 | 1–4 | 兼容 ASCII;按字节比较的顺序等于码点顺序 |
| UTF-16(D91) | 16 位 | 1–2 | 辅助平面字符用一对代理码元表示 |
| UTF-32(D90) | 32 位 | 1 | 定长,码元值就是标量值 |
编程语言的”字符串长度”通常就是它内部码元的个数,所以不同语言对同一个字符串给出不同的长度。Python
的 len() 数码点,但 CPython
的内部存储并不是固定的 UTF-32:PEP 393(Python 3.3
起)按字符串里最大的码点,选择每个字符 1、2 或 4
字节的存储。
UTF-16 的排序陷阱
UTF-8 有一条容易被忽略的性质,RFC 3629 第 1
节写明:“UTF-8
字符串按字节值的字典序,与按字符编号排序的结果相同。”UTF-16
没有这条性质:辅助平面字符以 0xD800 到 0xDBFF 开头,比
U+E000 到 U+FFFF 的 BMP
字符还小。reproduce/facts.mjs 在 Node 24.5
上的结果是,JavaScript 默认的
Array.prototype.sort() 按 UTF-16 码元比较,把
U+10000 排在 U+FF61 前面;按码点排序时顺序相反。一个系统用
UTF-8 字节序排序、另一个用 UTF-16
码元序排序,两边的”有序”列表会在辅助平面字符上对不齐。这在归并、二分查找和数据库索引迁移中都会出问题。
二、UTF-8 的来历:从 FSS-UTF 到 RFC 3629
1992 年 9 月的一个晚上
Rob Pike 在 2003 年的一封邮件里回忆了 UTF-8 的诞生。1992
年 9 月前后的一个下午,几位参加 X/Open 委员会会议的人(Pike
记得是 IBM 在奥斯汀的人)打电话给贝尔实验室,请 Ken Thompson
和 Pike 审阅一个叫 FSS/UTF 的多字节编码设计。Pike
在电话里列了一串要求,FSS/UTF
至少缺一条:从字节流中途接入时,消耗不到一个字符就能重新同步。两人随后去吃晚饭,Thompson
在新泽西一家小餐馆的餐垫(placemat)上想出了位打包方案;回到实验室后,他们打电话向
X/Open 讲解,并寄去了提纲。当晚 Thompson
写了打包和解包代码,Pike 开始改 C
库和图形库;第二天代码全部完成,开始转换系统里的文本文件;到周五,Plan
9 已经只运行这种后来叫做 UTF-8 的编码。Russ Cox 应 Pike
之请翻查了 Plan 9 的归档:rune.c 在 1992 年 9
月 4 日换成了新编码,寄给 X/Open 的提案在 9 月 8
日上午定稿,其中新增的第 6 条准则就是能够找到字符边界。
这份提案(标题是 FSS-UTF)列了六条设计准则,其中四条直接决定了位布局:
- 兼容历史文件系统:文件名里不能出现 NUL 字节和 ASCII 斜杠;
- 兼容现有程序:非 ASCII 字符的编码里不出现任何 ASCII 字节值;
- 第一个字节就指明后面还有几个字节;
- 从字节流的任意位置出发,都能高效地找到字符的开头。
提案里的编码支持 1 到 6 字节、31
位值,并写明”只有最短编码是合法的”,附带的
mbtowc 示例代码也拒绝过长编码。Pike
在同一封邮件里特意澄清,“UTF-8 是 IBM 设计的”这种说法源自
RFC 2279 的措辞。
从”应当”到”必须”
“只有最短编码合法”在 1992 年就写下了,但此后十年里,它在各个标准中的约束力一直不够。
| 时间 | 文档 | 关于非法序列的规定 |
|---|---|---|
| 1998-01 | RFC 2279(F. Yergeau) | 仍是 1 到 6 字节、31
位;只说实现”应当”(should)防止解码非法序列,并以 C0 80
被误解码为 U+0000 为例;安全一节已经举出
2F C0 AE 2E 2F 绕过 /../
检查的例子 |
| 1999 | Unicode 3.0,一致性条款 C12 | 禁止生成非最短形式,但没有禁止解释它 |
| 2000-11 | Unicode 更正 #1(Corrigendum #1: UTF-8 Shortest Form) | 禁止解释非最短形式,适用于 3.0.0 和 3.0.1;3.1.0(2001 年 3 月)并入正文 |
| 2002 | Unicode 3.2 | 禁止解释对应代理码点的字节序列(如 ED A0 80) |
| 2003-11 | RFC 3629(F. Yergeau),STD 63 | 收窄到 U+0000..U+10FFFF、1 到 4 字节;明确禁止编码 U+D800..U+DFFF;解码器”必须”(MUST)防止解码非法序列 |
RFC 3629 第 12 节列出了相对 RFC 2279 的变化:值域收窄到”UTF-16 可达的范围”0000-10FFFF;UTF-8 的规范性定义改由 Unicode 给出;原来那条提醒不要解码非法序列的注释,改成了规范性的”不得”(MUST NOT);新增了合法字节序列的 ABNF 语法。UTF-16 用一对代理码元最多表示 \(2^{20}\) 个辅助平面码点,加上 BMP 正好到 U+10FFFF,三种编码形式的值域从此一致。RFC 3629 第 3 节还专门点名了 CESU-8:它把 UTF-16 的两个代理码元分别编码成 3 字节序列,对 U+FFFF 以上的字符产生的结果”不是合法的 UTF-8”。
三、位布局与合法序列
位分配
Unicode 16.0 第 3 章表 3-6 规定了标量值的比特如何分配到 1 到 4 个字节里。下图的上排是模板,下排是一个具体码点的比特;灰色格子是固定的标记位,彩色格子是载荷位,同色表示来自标量值的同一段比特:
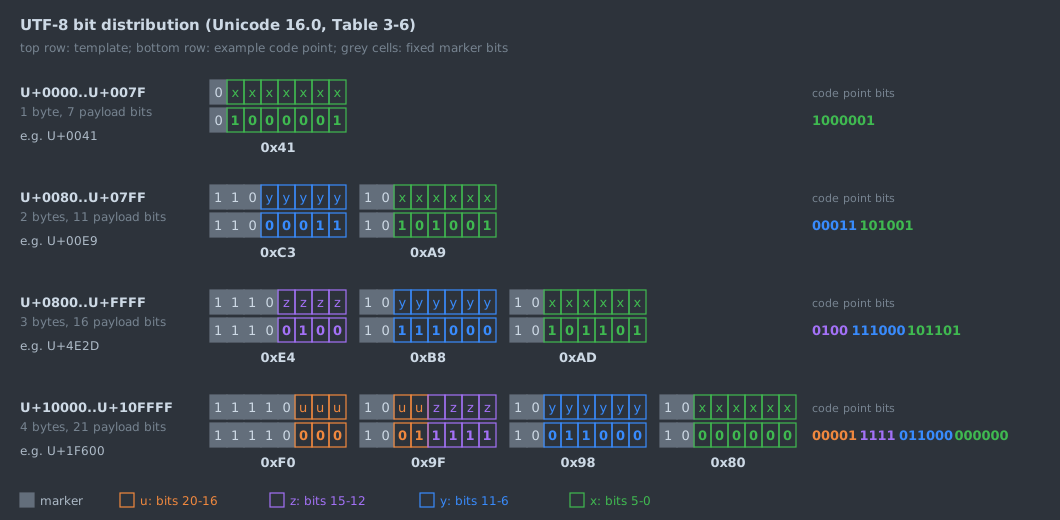
写成公式:设标量值为 \(c\),它的 UTF-8 长度为
\[ \ell(c)=\begin{cases} 1, & c < \mathtt{0x80}\\ 2, & \mathtt{0x80} \le c < \mathtt{0x800}\\ 3, & \mathtt{0x800} \le c < \mathtt{0x10000}\\ 4, & \mathtt{0x10000} \le c \le \mathtt{0x10FFFF} \end{cases} \]
首字节是长度前缀加上 \(c\)
的最高几位,其后每个续字节是 \(\mathtt{0x80} \mathbin{|} (\text{6
位载荷})\)。以 U+4E2D 为例,\(c =
\mathtt{0100\,111000\,101101}_2\),三段分别填进
1110zzzz、10yyyyyy、10xxxxxx,得到
E4 B8 AD。
这个布局直接兑现了第二节的准则:
- ASCII 透明:\(c<\mathtt{0x80}\)
时编码就是它自己;多字节序列的每个字节最高位都是 1,不会出现
NUL、
/或其他 ASCII 字节。 - 长度自描述:首字节开头 1
的个数就是序列长度,续字节一律是
10xxxxxx。 - 自同步:任何字节只看最高两位,就能判断自己是续字节还是字符开头;从任意位置出发,最多向前或向后跳过 3 个续字节就能找到字符边界。
- 保序:长度越长的序列首字节越大,同长度序列内按载荷位的字典序排列,所以字节序等于码点序(第一节)。
合法序列表
位分配只说明怎么编码,没有说明哪些字节序列可以接受。按模板硬解,至少会接受三类不该接受的东西:过长编码(例如用
C0 AF 表示 /)、代理码点(ED A0 80 解出
U+D800)、超出 U+10FFFF 的值(F4 90 80 80 解出
U+110000)。Unicode 16.0 表 3-7
把合法序列直接写成了字节范围:
| 码点范围 | 第 1 字节 | 第 2 字节 | 第 3 字节 | 第 4 字节 |
|---|---|---|---|---|
| U+0000..U+007F | 00..7F | |||
| U+0080..U+07FF | C2..DF | 80..BF | ||
| U+0800..U+0FFF | E0 | A0..BF | 80..BF | |
| U+1000..U+CFFF | E1..EC | 80..BF | 80..BF | |
| U+D000..U+D7FF | ED | 80..9F | 80..BF | |
| U+E000..U+FFFF | EE..EF | 80..BF | 80..BF | |
| U+10000..U+3FFFF | F0 | 90..BF | 80..BF | 80..BF |
| U+40000..U+FFFFF | F1..F3 | 80..BF | 80..BF | 80..BF |
| U+100000..U+10FFFF | F4 | 80..8F | 80..BF | 80..BF |
加粗的四个边界是整张表的关键,而且它们都只约束第二个字节:
- E0 后面必须是 A0..BF,否则载荷不足 12 位,是 3 字节的过长编码;
- ED 后面必须是 80..9F,否则解出 U+D800..U+DFFF;
- F0 后面必须是 90..BF,否则是 4 字节的过长编码;
- F4 后面必须是 80..8F,否则超过 U+10FFFF。
C0、C1 作首字节只能产生 2 字节的过长编码,F5..FF 作首字节必然超过 U+10FFFF,所以这 13 个字节值在合法 UTF-8 里永远不会出现。验证器只需要记住”首字节决定第二字节的范围,其余续字节都是 80..BF”。第五节的三种验证算法都是这句话的不同实现。
有多少合法串
从表 3-7 可以直接数出每种长度的合法序列个数:1 字节 128 个;2 字节 \(30 \times 64 = 1920\) 个(首字节 C2..DF);3 字节 \(2^{16} - 2^{11} - 2048 = 61\,440\) 个(U+0800..U+FFFF 去掉代理码点);4 字节 \(2^{20} = 1\,048\,576\) 个。一个长度为 \(n\) 的字节串合法,当且仅当它能切成若干个合法序列,而 UTF-8 的前缀性质保证切法唯一。所以长度为 \(n\) 的合法串个数 \(V(n)\) 满足
\[V(n) = 128\,V(n-1) + 1920\,V(n-2) + 61\,440\,V(n-3) + 1\,048\,576\,V(n-4),\]
其中 \(V(0)=1\),\(n<0\) 时 \(V(n)=0\)。由此得到 \(V(1)=128\),\(V(2)=18\,304\),\(V(3)=2\,650\,112\),\(V(4)=383\,270\,912\)。4 字节随机串里只有约 8.9% 是合法 UTF-8。
这个递推式是穷举测试的判据。reproduce/test_utf8.c
枚举了全部 \(2^8\)、\(2^{16}\)、\(2^{24}\) 和 \(2^{32}\) 个长度为 1 到 4
的字节串,让四个验证器(第五节)逐个判断,要求它们彼此一致,而且合法串的总数分别等于上面四个值。\(2^{32}\) 那一轮在单核上跑 3 到
4 分钟,结果是 4,294,967,296 个串中 383,270,912
个合法,四个验证器没有分歧。
四、解码器与非法序列的替换
按表 3-7 解码
把表 3-7
翻译成代码,关键是”首字节决定第二字节的范围”。下面是
reproduce/utf8.h
里的解码器,它每次解码一个字符,遇到非法序列时返回应当跳过的字节数:
static inline int utf8_decode(const uint8_t *s, size_t n, int32_t *cp)
{
    uint8_t b0 = s[0];
    uint8_t lo = 0x80, hi = 0xBF;
    uint32_t c;
    int len;

    if (b0 < 0x80) {
        *cp = b0;
        return 1;
    }
    if (b0 >= 0xC2 && b0 <= 0xDF) {
        len = 2;
        c = b0 & 0x1F;
    } else if (b0 >= 0xE0 && b0 <= 0xEF) {
        len = 3;
        c = b0 & 0x0F;
        if (b0 == 0xE0) lo = 0xA0;      /* overlong: < U+0800 */
        if (b0 == 0xED) hi = 0x9F;      /* surrogates U+D800..U+DFFF */
    } else if (b0 >= 0xF0 && b0 <= 0xF4) {
        len = 4;
        c = b0 & 0x07;
        if (b0 == 0xF0) lo = 0x90;      /* overlong: < U+10000 */
        if (b0 == 0xF4) hi = 0x8F;      /* > U+10FFFF */
    } else {
        *cp = UTF8_BAD;                 /* 80..C1, F5..FF */
        return 1;
    }
    for (int i = 1; i < len; i++) {
        if ((size_t)i >= n || s[i] < lo || s[i] > hi) {
            *cp = UTF8_BAD;
            return i;
        }
        c = (c << 6) | (s[i] & 0x3F);
        lo = 0x80;
        hi = 0xBF;
    }
    *cp = (int32_t)c;
    return len;
}
这段代码没有”解出来再检查”的步骤:过长编码、代理码点和越界值都在读第二个字节时就被区间 \([\mathit{lo}, \mathit{hi}]\) 挡住,循环结束时得到的 \(c\) 一定是合法标量值。常见的错误写法是先按模板把比特拼出来,再检查 \(c\) 的范围。这种写法本身可以做对,但它把”字节合法”和”值合法”两件事混在一起,出错时也很难说清应当跳过几个字节。
最大子部分
解码器在非法位置应该跳过几个字节、输出几个 U+FFFD?Unicode 16.0 第 3.9.6 节给出了一种推荐做法,叫”最大子部分替换”。D93b 定义:从无法转换的位置开始,最大子部分(maximal subpart)是满足下列条件之一的最长码元子序列:它是某个合法序列的开头,或者长度为 1。每个最大子部分替换成一个 U+FFFD,然后从它后面继续。
上面的解码器在第 \(i\) 个字节越界时返回 \(i\),这正是最大子部分的长度:前 \(i\) 个字节都落在表 3-7 的区间里,所以是某个合法序列的开头;第 \(i+1\) 个字节让它无法延续。首字节本身非法时返回 1。第 3 章的表 3-8 到 3-11 给了几组例子。下表第一行是表 3-8 的开头两个字节,第二行是表 3-11 的完整输入:
| 输入字节 | 最大子部分切分 | 输出 |
|---|---|---|
| C0 AF | C0 AF |
U+FFFD U+FFFD(C0 不能开始任何合法序列) |
| E1 80 E2 F0 91 92 F1 BF 41 | E1 80 E2 F0 91 92
F1 BF 41 |
4 个 U+FFFD,然后是 A |
这种做法有两条好性质。第一,它从不吞掉合法字节:C2 41 42
输出 U+FFFD A B,而不是把 41 当作
C2 的续字节一起丢掉。这一条不是推荐而是要求:第 3.9
节规定,转换器不得把本身属于合法序列的后继字节当作非法序列的一部分消耗掉,并明确说
C2 41 42 不能输出 U+FFFD B 或单独一个
U+FFFD。否则一个坏字节就能”吃掉”紧跟其后的引号或分隔符。第二,它只需要向前看,不需要回溯,流式解码器很容易实现。
但是标准明确说这种做法”不是一致性所必需的”(not required
for conformance)。例如 F0 80 80 41,输出 1 个或 3 个 U+FFFD
都合规,只要最后的 A
保留下来。第十三节会讲到,这句话背后有一场 2017
年的争论。
怎样确认解码器是对的
编解码器的错误往往集中在少数边界字节上,随机测试很难碰到,所以这里用穷举加交叉比对:
- 编码器:对 0 到 \(2^{21}-1\)
的全部整数编码,再用解码器解回,要求往返一致,并拒绝全部代理码点和大于
U+10FFFF 的值(第一节的计数)。另外把 1,112,064
个标量值的编码结果与 glibc 2.43 的
iconv -f UTF-32LE -t UTF-8逐字节比较,完全相同。 - 解码器的替换行为:把每个输入按最大子部分解码成”标量值或
U+FFFD”的序列,与 CPython 3.14.5 的
bytes.decode('utf-8', 'replace')比较。比较对象包括全部 1、2、3 字节串(共 16,843,008 个),以及用 26 个边界字节(00 41 7F 80 8F 90 9F A0 AF BF C0 C1 C2 DF E0 E1 EC ED EE EF F0 F1 F3 F4 F5 FF)组合出的全部 \(26^4 = 456\,976\) 个 4 字节串。两边输出的 SHA-256 摘要全部一致。 - 变异检查:测试能不能抓到真实的错误?把第五节 Hoehrmann 字节类表里 ED 的类改成与 E1..EC 相同、把 F5..FF 的类改成与 F1..F3 相同,验证器就会接受 ED A0 80(U+D800)等非法序列,穷举测试立刻报错。
所有测试另外在 AddressSanitizer 和
UndefinedBehaviorSanitizer 下跑过一遍。命令和输出见
reproduce/run.sh 与
reproduce/results/。
各实现输出几个 U+FFFD
同样的非法输入,不同语言的标准库会给出不同数量的
U+FFFD。reproduce/fffd/ 对 8
个输入做了比较:
| 输入 | 含义 | 最大子部分 | Python 3.14 | Node 24 TextDecoder /
Buffer |
Rust 1.94 from_utf8_lossy |
ICU 78 uconv |
Go 1.26 []rune(s) |
Go strings.ToValidUTF8 |
|---|---|---|---|---|---|---|---|---|
| C0 AF | 过长的 / |
2 | 2 | 2 / 2 | 2 | 2 | 2 | 1 |
| E0 80 AF | 3 字节过长 | 3 | 3 | 3 / 3 | 3 | 3 | 3 | 1 |
| ED A0 80 | U+D800 | 3 | 3 | 3 / 3 | 3 | 3 | 3 | 1 |
| F4 90 80 80 | U+110000 | 4 | 4 | 4 / 4 | 4 | 4 | 4 | 1 |
| E1 80 41 | 截断后接 A |
1 | 1 | 1 / 1 | 1 | 1 | 2 | 1 |
| F0 9F 98 41 | 截断的 emoji | 1 | 1 | 1 / 1 | 1 | 1 | 3 | 1 |
| F0 80 80 41 | 4 字节过长 | 3 | 3 | 3 / 3 | 3 | 3 | 3 | 1 |
| E1 80 E2 F0 91 92 F1 BF 41 | 表 3-11 | 4 | 4 | 4 / 4 | 4 | 4 | 8 | 1 |
Python、Node、Rust 和 ICU 都与最大子部分一致。Go
的两种写法都不一样。把字符串转换成 []rune
时,Go 对截断序列的每个字节各输出一个 U+FFFD,所以 F0 9F 98
41 得到 3 个。strings.ToValidUTF8
则把连续的一段非法字节合并成一个替换串,表 3-11 的输入只得到
1 个。两种行为都合规,因为标准只要求保留
A。但如果一个系统的两层分别用 Go 和 Python
做替换,同一段坏数据会得到不同的字符串,长度、哈希和签名都对不上。
五、验证:分支、DFA 与 SIMD 查表
只判断”是不是合法 UTF-8”而不取出码点,这就是验证(validation)。JSON 解析器、HTTP 服务器、数据库在收到外部输入时都要先做这一步,所以它的吞吐量很重要。下面三种算法对应三种思路:逐字符分支、查表状态机、按字节并行。
逐字符分支
最直接的做法是反复调用第四节的解码器,遇到 ASCII
字节就跳过:reproduce/utf8.h 里的
utf8_valid_branchy。它的速度取决于输入:纯
ASCII 时每个字节只有一次容易预测的比较;ASCII
和多字节字符随机交错时,“这个字符几个字节”这个分支几乎每次都会预测错。Go
1.26 的 unicode/utf8.Valid
也是这个结构,只是先按 8
字节一个字(word)检查最高位,整段跳过 ASCII。
Hoehrmann DFA
Bjoern Hoehrmann 在 2008–2009 年间发表了一个用确定有限自动机(Deterministic Finite Automaton,DFA)验证和解码 UTF-8 的实现(MIT 许可)。它的思路是把表 3-7 翻译成状态机:
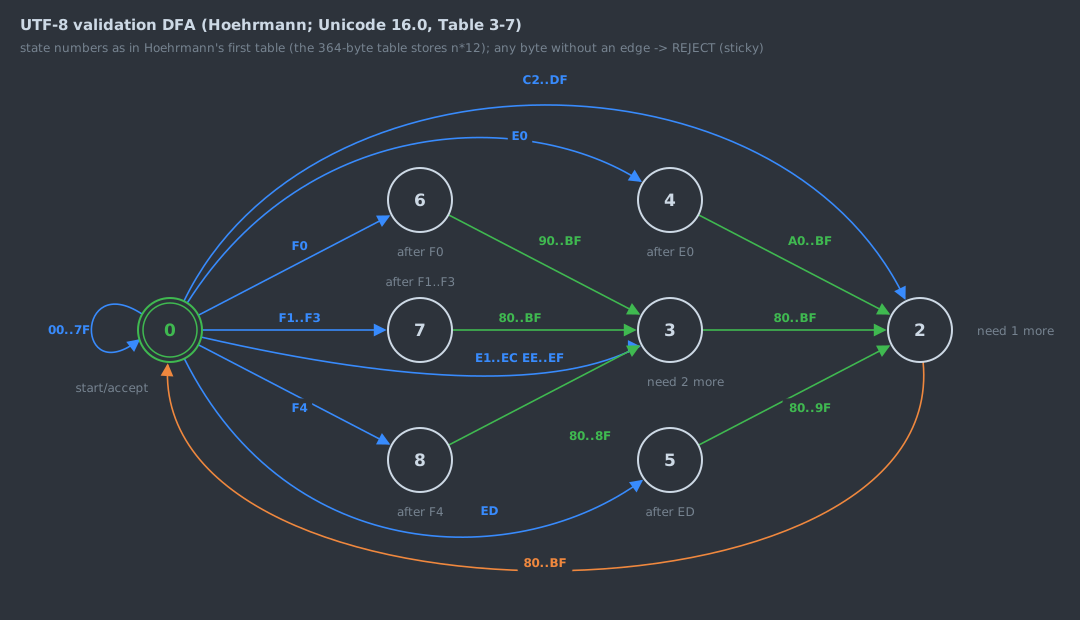
图中每个状态表示”还差几个续字节,下一个续字节的范围是什么”。状态 4、5、6、8 分别对应表 3-7 里加粗的四个第二字节边界,状态 3 和 7 表示还差两个和三个普通续字节,状态 2 表示还差一个。拒绝状态没有画出:任何不在图中边上的字节都进入拒绝状态,并且永远留在那里。
为了把表做小,Hoehrmann 先把 256 个字节映射到 12 个字节类(character class)。表 3-7 里所有的区间边界把字节切成了这 12 类,同一类的字节在任何状态下的转移都相同:
| 字节 | 类 | 字节 | 类 |
|---|---|---|---|
| 00..7F | 0 | E0 | 10 |
| 80..8F | 1 | E1..EC、EE..EF | 3 |
| 90..9F | 9 | ED | 4 |
| A0..BF | 7 | F0 | 11 |
| C0..C1、F5..FF | 8 | F1..F3 | 6 |
| C2..DF | 2 | F4 | 5 |
续字节被分成 80..8F、90..9F、A0..BF 三类,正是因为 8F/90 和 9F/A0 这两处边界:F4 只接受 80..8F,ED 只接受 80..9F,E0 只接受 A0..BF,F0 只接受 90..BF。
第一版的转移表下标是”状态 × 16 + 类”。2010 年 6 月,Rich Felker 指出状态值可以预先乘好,省掉每个字节一次移位;Hoehrmann 据此发布了第二版,把状态号预先乘以 12,同时去掉了原来的填充项。这样”状态 + 类”直接就是转移表下标。字节类表 256 字节,转移表 \(9 \times 12 = 108\) 字节,合计 364 字节,能完整放进 L1 缓存。验证循环只有一行:
static inline bool utf8_valid_dfa(const uint8_t *s, size_t n)
{
    uint32_t state = UTF8_ACCEPT;             /* 0; UTF8_REJECT is 12 */
    for (size_t i = 0; i < n; i++)
        state = utf8d[256 + state + utf8d[s[i]]];
    return state == UTF8_ACCEPT;
}循环里没有分支,速度与输入内容无关。但它有一条贯穿全程的依赖链:第 \(i\) 个字节的查表地址取决于第 \(i-1\) 个字节的查表结果。每个字节至少要等一次 L1 读取的延迟,乱序执行也帮不上忙。实测中它在三种输入上都是 0.81 GB/s(本节末尾的表),正是延迟受限的特征。
打破依赖链的办法是同时跑几条独立的链。Keiser 和 Lemire
在论文第 5
节比较有限状态验证器时,就把输入分成三段交错处理。utf8_valid_dfa3
照此实现:把缓冲区在约 1/3 和 2/3
处切开,切点向后挪到下一个非续字节,然后在同一个循环里推进三个状态。三条链互不依赖,CPU
可以让它们的读取延迟重叠。它和单链 DFA 一起参与了 \(2^{32}\) 穷举测试;在 64 KiB
输入上,它的吞吐量是单链的 3.0 倍。
还有一个细节:切点挪动时最多跳过 3 个续字节。如果连续 4 个都是续字节,输入一定非法,函数直接返回 false。
Keiser–Lemire 查表算法
DFA 每次只看一个字节。John Keiser 和 Daniel Lemire
在论文”Validating UTF-8 In Less Than One Instruction Per
Byte”(Software: Practice and Experience 51(5),
2021)里换了一个角度:绝大多数 UTF-8
错误只需要看相邻两个字节就能发现,而且只需要看其中
12 位,即前一个字节的高 4 位、前一个字节的低 4
位、当前字节的高 4 位。三个 4 位值各自查一张 16
项的表,每张表给出一个 8
位的”可能错误”掩码,三个掩码按位与,结果非零就说明这一对字节属于某种错误。SIMD
的字节重排指令(x86 的
pshufb/vpshufb,ARM NEON
也有对应的查表指令)一条就能完成 16 或 32 个并行的 16
项查表,所以整个判断对 16 个字节只需要几条指令。
reproduce/utf8_sse.h 用 SSSE3
实现了这个算法,三张表和错误位直接取自 simdjson v4.6.11 的
src/generic/stage1/utf8_lookup4_algorithm.h。8
个错误位的含义如下(_ 表示任意位):
| 位 | 名称 | 前一字节 | 当前字节 | 含义 |
|---|---|---|---|---|
| 0 | TOO_SHORT | 11______ |
0_______ 或 11______ |
首字节后面缺续字节 |
| 1 | TOO_LONG | 0_______ |
10______ |
ASCII 后面出现续字节 |
| 2 | OVERLONG_3 | 11100000 |
100_____ |
E0 80..9F,3 字节过长 |
| 3 | TOO_LARGE | 11110100 |
1001____ 及以上 |
F4 90..BF,超过 U+10FFFF |
| 4 | SURROGATE | 11101101 |
101_____ |
ED A0..BF,代理码点 |
| 5 | OVERLONG_2 | 1100000_ |
10______ |
C0、C1 开头,2 字节过长 |
| 6 | TOO_LARGE_1000 / OVERLONG_4 | 11110101 及以上 /
11110000 |
1000____ |
F5..FF 后接 80..8F / F0 80..8F |
| 7 | TWO_CONTS | 10______ |
10______ |
两个续字节相邻,本身不一定是错误 |
前 7 位覆盖了表 3-7
的全部”第二字节”约束。剩下的问题是第三、第四字节:两个续字节相邻(TWO_CONTS)什么时候合法?当且仅当往前数
2 个字节是 3 字节或 4 字节首字节(\(\ge \mathtt{E0}\)),或往前数 3
个字节是 4 字节首字节(\(\ge
\mathtt{F0}\))。算法用饱和减法算出这个”必须是续字节”的掩码:subs_epu8(prev2, 0xE0 - 0x80)
的最高位为 1,当且仅当 prev2 \(\ge\) E0;prev3
同理。最后把这个掩码与查表结果做异或:TWO_CONTS
位与”必须是续字节”位恰好重合时互相抵消,不重合时留下的 0x80
就是错误。
flowchart LR
    CUR["current 16 bytes"] --> A["alignr 15 / 14 / 13"]
    PRV["previous 16 bytes"] --> A
    A -->|prev1| N1["prev1 high nibble"]
    A -->|prev1| N2["prev1 low nibble"]
    CUR --> N3["input high nibble"]
    N1 --> T1["pshufb table 1"]
    N2 --> T2["pshufb table 2"]
    N3 --> T3["pshufb table 3"]
    T1 --> AND["AND: special cases"]
    T2 --> AND
    T3 --> AND
    A -->|prev2, prev3| S["saturating sub: prev2 >= E0 or prev3 >= F0"]
    S --> M["must be 2nd/3rd continuation: 0x80"]
    AND --> X["XOR"]
    M --> X
    X --> E["OR into error accumulator"]
下面两张表是 reproduce/lookup_trace.c
用同一份代码打印的中间结果(前一个块为全零)。第一个输入是
a、é、中、😀
四个字符:
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | |
|---|---|---|---|---|---|---|---|---|---|---|
| input | 61 | C3 | A9 | E4 | B8 | AD | F0 | 9F | 98 | 80 |
| prev1 | 00 | 61 | C3 | A9 | E4 | B8 | AD | F0 | 9F | 98 |
| special_cases | 00 | 00 | 00 | 00 | 00 | 80 | 00 | 00 | 80 | 80 |
| must_be_2_3_cont | 00 | 00 | 00 | 00 | 00 | 80 | 00 | 00 | 80 | 80 |
| error | 00 | 00 | 00 | 00 | 00 | 00 | 00 | 00 | 00 | 00 |
第 5、8、9 列是”续字节后面跟续字节”,查表给出 TWO_CONTS(0x80),而往前 2 或 3 个字节恰好是 E4 或 F0,两者异或为零。第二个输入把五种错误拼在一起:C0 AF(过长)、ED A0 80(代理)、E4 B8 41(缺第三字节)、41 后面的 80(多余续字节)、F4 90 80 80(超过 U+10FFFF):
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| input | C0 | AF | ED | A0 | 80 | E4 | B8 | 41 | 80 | F4 | 90 | 80 | 80 |
| prev1 | 00 | C0 | AF | ED | A0 | 80 | E4 | B8 | 41 | 80 | F4 | 90 | 80 |
| special_cases | 00 | 20 | 00 | 10 | 80 | 00 | 00 | 00 | 02 | 00 | 08 | 80 | 80 |
| must_be_2_3_cont | 00 | 00 | 00 | 00 | 80 | 00 | 00 | 80 | 00 | 00 | 00 | 80 | 80 |
| error | 00 | 20 | 00 | 10 | 00 | 00 | 00 | 80 | 02 | 00 | 08 | 00 | 00 |
错误分别落在第 1 列(0x20,OVERLONG_2)、第 3 列(0x10,SURROGATE)、第 7 列(0x80:E4 要求这里是续字节,查表却没有 TWO_CONTS)、第 8 列(0x02,TOO_LONG)和第 10 列(0x08,TOO_LARGE)。
完整的验证器还有两处细节。一是输入末尾:如果最后
1 到 3
个字节是还没收尾的首字节,前面的检查看不出来,要单独判断最后一个块的末尾是否”未完成”(sse_is_incomplete,同样用饱和减法)。二是
ASCII 快速路径:每 64
字节先把四个向量按位或起来,最高位全为 0
就跳过分类,只把上一块的”未完成”标志并入错误。这就是论文标题”每字节不到一条指令”的来源:论文表
13 在 AMD Rome 上测得查表算法对 ASCII 输入每字节 0.21
条指令,对非 ASCII 输入每字节 0.97 条;同一张表里 DFA 是 7.0
条,逐字符分支是 6.0 到 12 条。
实测
reproduce/bench.c 生成三种 64 KiB 输入:纯
ASCII;U+4E00..U+9FFF 的汉字(每个 3
字节);每个码点的字节长度在 1 到 4 之间均匀随机(记作
mix14)。每种输入让四个验证器各验证 4000 遍算一次,共 5
次,取中位数。机器是 Intel Core i9-12900K,WSL2(Linux
6.6),GCC 16.1.1 -O2 -march=x86-64-v2,用
taskset -c 12 绑在一个核上。单位是 GB/s(\(10^9\)
字节每秒)。这是单机单次环境的结果,只看相对趋势:
| 输入 | 逐字符分支 | DFA | DFA × 3 流 | SSE 查表 |
|---|---|---|---|---|
| ASCII | 4.86 | 0.81 | 2.43 | 93.65 |
| 汉字(3 字节) | 1.71 | 0.80 | 2.39 | 11.10 |
| mix14 | 0.40 | 0.81 | 2.43 | 11.44 |
几个现象都能从算法结构上解释:
- DFA 与输入无关,三种输入都是 0.81 GB/s;拆成三条独立的链后是 2.4 GB/s,正好 3 倍,说明瓶颈确实是依赖链的延迟,而不是查表本身的吞吐。
- 分支版本强烈依赖输入。mix14 上每个字符的长度随机,分支预测几乎每次失败,只剩 0.40 GB/s,比 DFA 还慢一半;字符长度固定的汉字输入上分支可预测,达到 1.71 GB/s。
- SIMD 查表在非 ASCII 输入上仍然领先 DFA 约 14 倍;ASCII 输入走快速路径,每 64 字节只做一次或运算和一次判断,比非 ASCII 快约 8 倍。
论文表 12 用 AVX2(每次 32 字节)在 Intel Skylake(i7-6700)上测得:查表算法 ASCII 59 GiB/s、非 ASCII 12 GiB/s;有限状态(三流交错)1.8 GiB/s;逐字符分支在非 ASCII 输入上 0.35 到 0.40 GiB/s。本文的 SSE 版本每次只处理 16 字节,机器和编译器也不同,绝对值不可比;但三者的相对关系与论文一致:分支版本在字符长度随机时最慢,有限状态稳定但受延迟限制,查表算法比有限状态快一个数量级。
六、非法序列的安全后果
第三节的字节范围限制不是形式主义:过长编码和宽松解码都造成过真实的安全问题。
过长编码绕过路径检查
RFC 2279 的安全一节在 1998 年就举过例子:一个解析器禁止
2F 2E 2E 2F(/../),却接受非法的
2F C0 AE 2E 2F,把 C0 AE 解成
.。RFC 3629 第 10 节补充说,这个字节序列”在
2001 年一种攻击 Web
服务器的广泛传播的病毒中被使用”。同一时期微软 IIS 4.0 和 5.0
的 CVE-2000-0884(“Web 服务器文件夹遍历”,安全公告
MS00-078)属于同一类问题:攻击者用”包含 Unicode
编码字符的畸形 URL”读取 Web
根目录以外的文档,并可能执行任意命令。
问题的根源是检查和解释用的不是同一种字节序列:路径检查在原始字节上找
../,文件系统在宽松解码后的字符串上解析路径。修复有两条原则:先按表
3-7
严格解码,把非法序列当作错误;只在解码并规范化之后的字符串上做安全检查。
解码层不严格,上层防不住
CVE-2008-2938 是 Apache Tomcat 4.1.0–4.1.37、5.5.0–5.5.26
和 6.0.0–6.0.16 的目录遍历漏洞,条件是开启了
allowLinking 并把 URI 编码设成 UTF-8。Tomcat
安全公告给出的根本原因是”JVM 没有正确解码 UTF-8 编码的
URL”,而且影响多个 JVM
实现。应用自己的路径检查写得再对,下面一层接受了过长编码,攻击者就能绕过去。这也是
RFC 3629
把”应当”改成”必须”的原因:只要链条中有一个宽松的解码器,整条链的检查都会失效。
“差不多是 UTF-8”的变体
有几种编码长得像 UTF-8,但按表 3-7 验证会失败。它们与严格的 UTF-8 系统交换数据时,是常见的故障点:
| 变体 | 与 UTF-8 的差异 | 来源 |
|---|---|---|
| CESU-8 | U+FFFF 以上的字符按 UTF-16 代理对分别编码成两个 3 字节序列(ED A0..AF … ED B0..BF …) | RFC 3629 第 3 节:结果不是合法 UTF-8 |
| Java “modified UTF-8” | U+0000 编码成 2 字节的 C0 80;只用 1 到 3 字节形式,辅助平面字符用代理对表示 | Java SE java.io.DataInput 文档 |
MySQL utf8mb3(旧称
utf8) |
每个字符最多 3 字节,只支持 BMP,不能存 emoji 等辅助平面字符 | MySQL 8.4 参考手册第 12.9.2 节 |
Java 的 C0 80 正是第三节禁止的 2
字节过长编码,目的是让编码结果里永远不出现 NUL
字节。DataInput.readUTF 和
DataOutput.writeUTF 读写的就是这种格式。MySQL
手册说明 utf8 是 utf8mb3
的已弃用别名,utf8mb3 本身也已弃用,推荐
utf8mb4;MySQL 8.0 服务器的默认字符集已经是
utf8mb4(排序规则
utf8mb4_0900_ai_ci)。
七、规范化:UAX #15
同一个字符,多种码点序列
é 可以写成一个码点 U+00E9,也可以写成
e 加组合尖音符
U+0301。两者显示相同、含义相同,但按码点比较不相等(reproduce/facts.py:'\u00e9' == 'e\u0301'
为 False)。Unicode
把这种关系叫规范等价(canonical
equivalence)。另一种较弱的关系叫兼容等价(compatibility
equivalence):连字 fi(U+FB01)与
fi、带圈数字 ① 与
1、上标 ² 与
2,它们表示”同一个东西”,但视觉或格式上有差别。
UAX #15(revision 56,对应 Unicode 16.0)定义了四种规范化形式(normalization form):
| 形式 | 分解 | 再组合 | 使用实例 |
|---|---|---|---|
| NFD | 规范分解 | 否 | macOS HFS+ 以 NFD 的一个变体存储文件名(Apple TN1150) |
| NFC | 规范分解 | 规范组合 | W3C《Character Model: String Matching》:内容作者应当(SHOULD)尽量使用 NFC |
| NFKD | 兼容分解 | 否 | 兼容比较的中间形式 |
| NFKC | 兼容分解 | 规范组合 | Python 解析时把标识符转换成 NFKC 再比较(PEP 3131) |
K 形式会丢信息:NFKC 把 x² 变成
x2,把罗马数字
Ⅸ(U+2168)变成两个拉丁字母
IX。所以它只适合用来比较,不适合用来存储。
算法的三步
规范化由三步组成,前两步得到 NFD 或 NFKD,第三步再组合得到 NFC 或 NFKC:
- 递归分解。按 UnicodeData.txt
的分解映射反复替换,直到不能再分解。例如
Ǖ(U+01D5)先分解成 U+00DC U+0304,U+00DC 再分解成 U+0055 U+0308,最终是0055 0308 0304。韩文音节不查表,按公式算出初声、中声、终声字母。 - 规范排序。每个码点有一个规范组合类(Canonical_Combining_Class,ccc),基字符为 0,叫”起始符”(starter);变音符按位置取不同的值。把每一段连续的非起始符按 ccc 做稳定排序。
- 规范组合(只用于 NFC/NFKC)。从左到右,对每个起始符 \(L\) 和它后面的字符 \(C\),如果 \(\langle L, C\rangle\) 有主组合字符(primary composite),不在组合排除表里,并且 \(C\) 没有被阻断(blocked),就把两者替换成组合字符。\(C\) 被阻断是指 \(L\) 和 \(C\) 之间存在某个字符 \(B\),满足 \(\mathrm{ccc}(B)=0\) 或 \(\mathrm{ccc}(B) \ge \mathrm{ccc}(C)\)。
用 s 加上方点 U+0307 和下方点 U+0323
走一遍(ccc 值由 Python 3.14 的 unicodedata
给出):
| 步骤 | 序列 | 说明 |
|---|---|---|
| 输入 | 0073 0307 0323 |
上方点 ccc = 230,下方点 ccc = 220 |
| 规范排序 | 0073 0323 0307 |
220 < 230,下方点排到前面 |
组合 s + U+0323 |
1E63 0307 |
ṣ,U+0307 不再被阻断 |
| 组合 U+1E63 + U+0307 | 1E69 |
ṩ |
输入写成 0073 0323 0307 时,NFC 的结果也是
U+1E69。这正是规范排序的目的:变音符的输入顺序不同,只要它们的
ccc 不同(彼此不相互作用),规范化后就得到同一个序列。ccc
相同的变音符(如 U+0301 和 U+0308 都是
230)不会被交换,因为它们叠在同一侧时,先后顺序会影响显示。
几个特殊情况:
- 单例分解(singleton):欧姆符号 U+2126 的规范分解是希腊字母 Ω(U+03A9),埃符号 U+212B 分解为 Å(U+00C5)。NFC 不会把它们组合回来,任何规范化都会悄悄把 U+2126 换成 U+03A9。
- 组合排除:天城文 U+0958 的 NFC 是
0915 093C,同样不会组合回去。Unicode 16.0 的 CompositionExclusions.txt 把排除项分成四组:文字特定的排除(U+0958 在这一组)、规范化算法冻结之后才加入的预组合字符、单例分解、以非起始符开头的分解。 - 兼容分解:
reproduce/facts.py核对了 NFKC(U+FB01) =0066 0069,NFKC(U+2460) =0031,NFKC(U+FF21 全角 A) =0041,NFKC(U+00B2) =0032,NFKC(U+2168) =0049 0058。
拼接不封闭
UAX #15 第 1.4
节专门提醒:规范化形式在字符串拼接下不封闭。两个
NFC 字符串拼起来不一定是
NFC,因为拼接点两侧的字符可能需要重新排序或组合。最简单的例子是
a(NFC)和单独的 U+0301(也是
NFC,因为它前面没有可以组合的起始符),拼起来是
a + U+0301,NFC 应当是
á(U+00E1)。Python 的
unicodedata.is_normalized 对前两个返回
True,对拼接结果返回 False。
这条性质的工程含义是:数据库里每个字段都是 NFC,不代表拼接出来的键也是 NFC;分块传输的文本,不能每块单独规范化后直接拼接。
快速检查与流式处理
完整规范化要做分解、排序、组合三步,代价不小。UAX #15 定义了 Quick_Check 属性(NFC_QC、NFD_QC 等,取值 Yes、No、Maybe):UAX #15 第 9 节的检测算法逐个字符查这个属性,同时检查 ccc 的顺序,结果是 YES、NO 或 MAYBE:前两种是确定的答案,只有 MAYBE 才需要真正规范化一份副本再比较。标准指出,这比直接运行规范化算法快得多,因为它省去了内存分配和复制。
流式处理还有一个问题:规范排序需要看到一整段非起始符。UAX
#15 第 13 节举了一个极端例子:数字 2 后面跟
10,000 个分音符,再跟一个下方点和数字
3。下方点要排到最前面,所以必须缓存 10,003
个字符才能输出。为此 UAX #15
定义了流安全文本格式(Stream-Safe Text
Format,UAX15-D3):字符串做 NFKD 后,不存在长度超过 30
的非起始符序列。满足这个格式的文本可以用固定大小的缓冲区规范化;不满足的,UAX
#15 给出了插入
U+034F(组合字形连接符)来切断长序列的转换方法。
版本稳定性
Unicode 字符编码稳定性政策中的”规范化稳定性”一条(自 Unicode 4.1 起)保证:只包含某个版本已分配字符的字符串,按该版本规范化的结果,与按之后任何版本规范化的结果完全相同;字符一旦分配,它的 ccc 和分解映射就不再改变。所以用 Unicode 9.0 规范化并存储的键,升级到 16.0 之后仍然有效。第八节会看到,字素簇分段没有这样的保证。
文件系统:HFS+ 与 APFS
文件名是规范化问题的典型现场。Apple 技术说明 TN1150 规定,HFS+ 为了简化 B 树键的比较,把文件名以”完全分解、组合字符按规范顺序排列”的形式存储,其他等价形式都不合法,写入前必须转换。但它用的不是标准 NFD:Mac OS 8.1 到 10.2 基于 Unicode 2.1 的分解,10.3 起基于 Unicode 3.2;U+2000..U+2FFF 和 U+F900..U+FAFF 的字符不分解,以便与旧的 Mac 编码无损互转;韩文音节则分解成组合字母。所以在 Linux 上以 NFC 创建的文件名,拷到 HFS+ 卷上再拷回来,字节序列可能已经变了。
APFS 换了一种做法。Apple 的 APFS 常见问题说明:APFS 保留文件名原来的规范化形式(normalization-preserving),不再转换;macOS 10.13 和 iOS 11 起,它在比较文件名时对规范化不敏感,做法是对规范化后的名字取哈希。中间有过一个过渡期:iOS 10.3 到 10.3.2 的 APFS 对规范化敏感,iOS 10.3.3 和 macOS 10.12.6 改为在运行时做规范化。APFS 只接受合法的 UTF-8 文件名。这意味着同一个目录里看起来相同的两个名字能否共存,取决于文件系统和系统版本。同步工具和版本控制系统在不同平台之间搬运文件名时,需要自己决定采用哪一种规范化形式。
八、字素簇:UAX #29
用户眼中的”一个字符”
光标移动、删除键、文本截断、“最多 N 个字符”的输入限制,都应该以用户感知的字符为单位。UAX #29(revision 45,对应 Unicode 16.0)把它近似为字素簇(grapheme cluster),并给出两个版本:传统字素簇(legacy grapheme cluster)和扩展字素簇(extended grapheme cluster)。标准推荐后者,只有特定环境要求时才用前者。两者的区别只在 GB9a、GB9b、GB9c 三条规则上。
字素簇边界由一组有序规则决定。每个码点有一个 Grapheme_Cluster_Break 属性(CR、LF、Control、Extend、ZWJ、Regional_Indicator、Prepend、SpacingMark,以及韩文字母的 L、V、T、LV、LVT);从前往后逐条匹配,第一条命中的规则决定这个位置断开(÷)还是不断(×):
| 规则 | 模式 | 含义 |
|---|---|---|
| GB1、GB2 | sot ÷ ,÷ eot | 文本首尾断开 |
| GB3 | CR × LF | CRLF 是一个字素簇 |
| GB4、GB5 | (Control | CR | LF) ÷ ,÷ (Control | CR | LF) | 控制字符前后断开 |
| GB6–GB8 | L × (L | V | LV | LVT) 等 | 韩文组合字母拼成音节 |
| GB9 | × (Extend | ZWJ) | 组合符号、ZWJ 前不断 |
| GB9a、GB9b | × SpacingMark,Prepend × | 仅扩展字素簇 |
| GB9c | 辅音 [Extend Linker]* Linker [Extend Linker]* × 辅音 | 仅扩展字素簇:印度系文字的连字(Indic_Conjunct_Break 属性) |
| GB11 | ExtPict Extend* ZWJ × ExtPict | emoji ZWJ 序列 |
| GB12、GB13 | sot (RI RI)* RI × RI,[^RI] (RI RI)* RI × RI | 区域指示符两两配对成旗帜 |
| GB999 | Any ÷ Any | 其余位置断开 |
reproduce/facts.mjs 用 Node 24.5 的
Intl.Segmenter(ICU 77.1,Unicode
16.0)核对了几个例子:
| 输入 | 码点 | 字素簇 | 起作用的规则 |
|---|---|---|---|
| 家庭 emoji | 1F468 200D 1F469 200D 1F467 200D 1F466 |
1 | GB11 |
| 👍🏽 | 1F44D 1F3FD |
1 | GB9(肤色修饰符属于 Extend) |
| 🇨🇳🇺🇸 | 1F1E8 1F1F3 1F1FA 1F1F8 |
2 | GB12、GB13 |
| 三个区域指示符 | 1F1E8 1F1F3 1F1FA |
2 | GB13:第三个落单 |
| 韩文字母 ᄒ ᅡ ᆫ | 1112 1161 11AB |
1 | GB6、GB7 |
| e + 组合尖音符 | 0065 0301 |
1 | GB9 |
| CR LF | 000D 000A |
1 | GB3 |
| क्षि | 0915 094D 0937 093F |
1 | GB9c |
最后一行值得多说一句。天城文的 क्ष
是两个辅音用半音符(virama,U+094D)连成的连字。在 Unicode
15.1 之前的规则下,半音符属于 Extend,元音符号 U+093F 属于
SpacingMark,按 GB9 和 GB9a 会切成
0915 094D | 0937 093F
两段;这是按规则推出的结果,没有在旧版本的 ICU
上实测。Unicode 15.1(2023 年)新增了
GB9c,才把它合成一个字素簇。UAX #29 revision 41(Unicode
15.0)里还没有这条规则。
版本漂移
这说明字素簇的个数依赖 Unicode 版本。与第七节的规范化不同,UAX #29 的分段规则会随版本调整:15.1 加了 GB9c;revision 45 的修订记录显示,16.0 又把 Kirat Rai 文字的一些字符纳入 V 类。每个新版本还会加入新的 emoji 和组合符号。同一个字符串,在两个链接了不同 ICU 版本的服务上可能算出不同的”字符数”。如果数据库用字素簇个数做长度约束,升级 ICU 之后,原来合法的数据可能就不合法了。
所以长度限制要先想清楚用途。存储和协议层的限制应该用字节数,这是确定的、与版本无关的数字。字素簇适合做光标移动、截断显示这类交互操作,但不适合写进持久化的约束。Python
标准库没有字素簇分段;JavaScript 有
Intl.Segmenter,它的结果取决于运行时自带的 ICU
版本。
九、大小写:映射、折叠与无大小写比较
三种数据、两种操作
Unicode 的大小写处理有两种不同目的的操作。大小写映射(case mapping)用于显示,例如把标题转成大写。大小写折叠(case folding)用于比较:把字符串变成一种与大小写无关的形式,再按码点比较。两者用的数据不同:
- UnicodeData.txt 里的简单映射,一个码点对一个码点;
- SpecialCasing.txt 里的完整映射,可以一对多,有些还依赖上下文或语言;
- CaseFolding.txt 里的折叠映射,每一项带一个状态:C(通用)、F(完整折叠,可一对多)、S(简单折叠,一对一)、T(突厥语专用)。完整折叠用 C + F,简单折叠用 C + S。
reproduce/facts.py 在 Python 3.14.5(Unicode
16.0)上的结果:
| 表达式 | 结果 | 数据来源 |
|---|---|---|
'straße'.upper() |
STRASSE |
SpecialCasing:U+00DF → 0053 0053 |
'straße'.lower() |
straße |
不变 |
'straße'.casefold() |
strasse |
CaseFolding:U+00DF 只有 F 项 →
0073 0073 |
'ẞ'.lower(),'ẞ'.casefold() |
ß,ss |
U+1E9E:F → 0073 0073,S → U+00DF |
'ΟΔΟΣ'.lower() |
οδος(03BF 03B4 03BF 03C2) |
词尾 Σ 按 Final_Sigma 上下文变成 ς |
'İ'.lower() |
0069 0307 |
默认映射:i 加组合上点 |
'ı'.upper() |
I |
|
'ff'.upper() |
FF |
一个码点变成两个 |
'ꭰ'.casefold()(U+AB70) |
Ꭰ(U+13A0) |
切罗基文小写折叠到大写 |
德语 ß 与 ẞ
大写 ẞ(U+1E9E)是 Unicode 5.1 加入的(DerivedAge.txt)。德语正字法委员会(Rat für deutsche Rechtschreibung)直到 2017 年 6 月才更新官方规则,在全大写书写时允许用 ẞ 代替 SS(规则 § 25 E3:Straße – STRASSE – STRAẞE)。但 Unicode 的默认大写映射仍然是 ß → SS,而且以后也不会变。Unicode 稳定性政策中的”大小写对稳定性”(Unicode 5.0 起)规定,两个字符构成大小写对的条件是:前者是后者的完整大写,后者是前者的完整小写;在某个版本不构成大小写对的两个字符,以后永远不会构成。ẞ 的小写是 ß,但 ß 的完整大写是 SS,所以两者从加入时起就不是大小写对。
这带来一个不对称:upper(lower('ẞ')) 是
SS 而不是
ẞ。大小写映射本来就不保证往返,需要保留原文时,不要对它做”先小写再大写”之类的处理。
土耳其语的 i
土耳其语和阿塞拜疆语有两对 i:有点的 i/İ 和无点的 ı/I。默认映射按英语处理,把 I 变成 i;突厥语规则要把 I 变成 ı,把 İ 变成 i。CaseFolding.txt 用 T 状态单独列出这两项(0049 → 0131,0130 → 0069),默认折叠不使用它们。
问题常常出在”语言相关的 API
被用在了与语言无关的地方”。Java 的
String.toLowerCase() 使用默认
locale,官方文档专门警告:在土耳其语 locale
下,"TITLE".toLowerCase() 返回
"tıtle";编程语言标识符、协议关键字、HTML
标签这类与语言无关的字符串,应当用
toLowerCase(Locale.ROOT)。一个在土耳其语系统上把
"TITLE" 转成小写后与 "title"
比较的程序,会得到”不相等”。
词尾 sigma 与切罗基文
希腊字母 Σ 的小写有两种:词中是 σ(U+03C3),词尾是
ς(U+03C2)。SpecialCasing.txt 用 Final_Sigma
条件描述这条规则,Unicode 16.0 第 3 章表 3-17
给出了条件的精确定义:前面有带大小写的字母(中间可以隔着可忽略大小写的字符),后面没有。'ΟΔΟΣ'.lower()
得到 οδος:词尾是
ς,而且没有重音符。小写转换不会添加原文没有的重音。
切罗基文在 Unicode 8.0 之前只有大写字母,8.0 加入了小写字母(DerivedAge.txt)。CaseFolding.txt 把新加的小写字母折叠到大写(例如 U+13F8 → U+13F0,U+AB70 → U+13A0),与其他双大小写文字的方向相反。这可以从”大小写折叠稳定性”(Unicode 5.2 起)推出来:8.0 之前已有的大写切罗基字母折叠结果就是它们自己,这个结果不能再改,所以新字母只能折叠到大写。只假设”折叠结果都是小写”的代码,在切罗基文上会出错。
折叠与规范化要一起做
CaseFolding.txt
的文件头特别提醒:“大小写折叠不保持规范化形式!”例如
U+01F0(ǰ,NFC 形式)的完整折叠是
006A 030C,不再是 NFC。反过来,U+00C5(Å)和
A + U+030A
规范等价,但各自折叠后按码点比较并不相等。
Unicode 16.0 第 3 章定义了三个层次的无大小写匹配:D144 无大小写匹配(caseless match)只做折叠;D145 规范无大小写匹配(canonical caseless match)要求
\[\mathrm{NFD}(\mathrm{toCasefold}(\mathrm{NFD}(X))) = \mathrm{NFD}(\mathrm{toCasefold}(\mathrm{NFD}(Y)));\]
D146 兼容无大小写匹配把其中的规范化换成
NFKD,并多做一次折叠。第 3 章解释了内层 NFD
的作用:它只是为了处理 U+0345(希腊组合下写
iota)和含有它的字符这类罕见情况,优化过的实现可以单独处理这些字符,省掉一次规范化。reproduce/facts.py
验证了 U+00C5 与 A + U+030A 满足
D145,但不满足只做折叠的比较。
十、排序:UCA 与 CLDR
按码点排序对人几乎没有意义:reproduce/facts.mjs
里,码点序给出
A < B < a < b < á,所有大写字母排在小写之前,带重音的字母排在最后。Unicode
排序算法(Unicode Collation Algorithm,UCA,UTS
#10,revision 51)改为逐级比较:第 1 级比较基本字母,第 2
级比较重音,第 3
级比较大小写和字形变体,前一级分出胜负就不看后一级。英语排序规则下同一组字母排成
a < A < á < b < B。
每个字符查表得到一组排序元素(collation
element),每个元素包含各级的权重。把整个字符串的第 1
级权重依次排开,接着是第 2 级、第 3
级,级与级之间用比任何权重都小的分隔符隔开,就得到排序键(sort
key,UTS #10 第 7.3
节)。两个字符串的排序结果等于它们排序键的二进制比较,所以数据库可以预先算好排序键建索引,查询时只做
memcmp。空格、标点这类”可变”字符是否参与第 1
级比较,由可变权重(variable weighting,UTS
#10 第 4 节)选项控制。
Node 的 Intl.Collator 用
sensitivity 选项控制比较到哪一级。英语下 a 与
á、a 与 A 的比较结果(0 表示相等):
| sensitivity | a 对 á | a 对 A | 比较到 |
|---|---|---|---|
base |
0 | 0 | 只看基本字母 |
accent |
-1 | 0 | 基本字母和重音 |
case |
0 | -1 | 基本字母和大小写 |
variant |
-1 | -1 | 全部 |
UCA 只给出一套默认顺序(DUCET),各语言的习惯由
CLDR(Unicode Common Locale Data
Repository)以”裁剪”(tailoring)的形式叠加上去。同样是
ö,瑞典语把它当作排在 z
之后的独立字母(o < p < z < ö),德语把它当作
o
的变体(o < ö < p < z)。德语还有两套规则:默认规则得到
Mueller < Muffler < Muller < Müller;电话簿规则把
ü 当作 ue,得到
Mueller < Müller < Muffler < Muller。以上结果都来自
Node 24.5 自带的 ICU 77.1 和 CLDR
47。所以”按名字排序”必须带上语言参数,而且不同 CLDR
版本之间的结果可能不同。
十一、双向文本与 Trojan Source
双向算法的要点
阿拉伯文和希伯来文从右向左书写,其中夹杂的数字和拉丁文字仍然从左向右。文本在内存里始终按逻辑顺序(输入和朗读的顺序)存储,显示时由 Unicode 双向算法(Unicode Bidirectional Algorithm,UBA,UAX #9,revision 50)重排成视觉顺序。算法的要点:
- 每个字符有一个双向类别(Bidi_Class):拉丁字母是
L,希伯来字母是 R,阿拉伯字母是 AL,欧洲数字是 EN,空格是
WS,等等(
reproduce/facts.py核对了这几个值)。 - 根据段落方向、字符类别和显式控制字符,给每个字符算出一个嵌入层级(embedding level):偶数层从左向右,奇数层从右向左。显式层级的最大深度 max_depth 是 125,UAX #9 承诺这个值以后不会改变。
- 规则 L2:从最高层级到最低的奇数层级,逐级把”层级不低于当前值”的连续片段反转。
- 规则 L4:解析方向为 R 且具有 Bidi_Mirrored
属性的字符,显示成镜像字形。所以
(在从右向左的上下文里显示为)。
显式控制字符有两代。第一代是嵌入和覆盖:LRE、RLE、LRO、RLO,以 PDF 结束;其中 RLO(U+202E,从右向左覆盖)强制后面的字符一律按从右向左显示,不管它们本身的类别。第二代是 Unicode 6.3 引入的隔离符(isolate):LRI、RLI、FSI,以 PDI 结束。隔离符里的内容不影响外部的排序,外部也不影响内部。这些控制字符本身不可见。
Trojan Source
Nicholas Boucher 和 Ross Anderson 在 2021 年 11 月公开了一类攻击,并把它命名为 Trojan Source(论文后发表于 USENIX Security 2023)。思路是在注释或字符串字面量里放入双向控制字符,让代码的逻辑顺序(编译器读到的)和视觉顺序(审查者看到的)不一致。论文给出了 C、C++、C#、JavaScript、Java、Rust、Go、Python、SQL、Bash、汇编和 Solidity 的概念验证,归纳了三种手法:提前返回(early return)、注释掉(commenting-out)和拉长字符串(stretched string)。
下图是论文仓库中 C 语言”注释掉”示例的第 6
行,存储顺序和显示顺序都由 GNU FriBidi 1.0.16
实际计算(reproduce/bidi_reorder.sh):
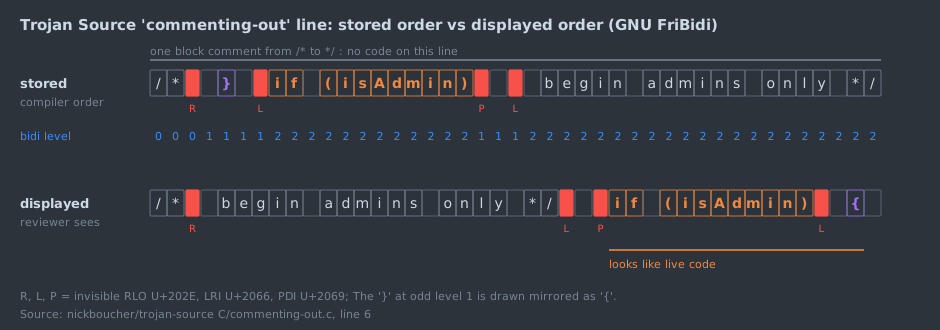
对编译器来说,从 /* 到 */
是一个完整的块注释,这一行没有代码。显示时,RLO
让它后面的内容进入从右向左的层级 1,两个 LRI
各自开出一个层级 2 的从左向右隔离段;按 L2
规则反转后,begin admins only */ 被挪到了
if (isAdmin)
前面,看起来注释已经结束。处在奇数层级的 } 按
L4 规则显示成镜像的 {。于是审查者看到的是
/* begin admins only */ if (isAdmin) {,下一行的
printf("You are an admin.\n");
看起来受这个条件保护,实际上会无条件执行。RLO
的作用范围到行尾(段落结束)为止,所以每一行都自成一体,不会影响周围的代码。
论文还评估了一个相关变体:用视觉上相同的同形字符(homoglyph)定义标识符,比如用西里尔字母 а 冒充拉丁字母 a,对应 CVE-2021-42694;双向控制字符那一类对应 CVE-2021-42574。这类字符此前已被用于其他场景:同一组作者在 IEEE S&P 2022 的论文 Bad Characters 中,用不可见字符、同形字符和双向控制字符构造人眼看不出差别的 NLP 模型对抗样本。
编译器和编辑器的应对
这次披露是在全行业范围内协调进行的,Boucher 和 Anderson 后来在 SCORED ’22 的论文 Talking Trojan 中专门分析了这次披露。各工具链在公开前后陆续发布了防御:
- Rust 1.56.1(2021 年 11 月 1
日)新增两个默认拒绝(deny-by-default)的
lint:
text_direction_codepoint_in_literal和text_direction_codepoint_in_comment,覆盖 U+202A..U+202E 和 U+2066..U+2069。Rust 的安全公告同时声明,这个问题”不是 rustc 的缺陷”。 - GCC 12 新增
-Wbidi-chars,默认值是unpaired:只对没有正确配对结束的双向控制字符报警(GCC bug 103026)。
reproduce/bidi_lint.sh 把一个不配对的 RLO
放进 Rust 和 C 的块注释里编译。rustc 1.94 报错”unicode
codepoint changing visible direction of text present in
comment”,退出码为 1;GCC 16.1.1 默认给出警告”unpaired UTF-8
bidirectional control character detected
[-Wbidi-chars=]“,编译照常成功,加上
-Wbidi-chars=none
后警告消失。两者的取舍不同:Rust 直接拒绝编译;GCC
只做提示,而且默认只针对”不配对”的情况。
Unicode 联盟随后发布了 UTS #55《Unicode 源代码处理》(Unicode Source Code Handling;2023 年 8 月的 revision 3 已是批准发布的版本,本文引用 2024 年 1 月的 revision 5)。它的第 1.2.3 节专门讨论”利用双向重排进行欺骗”,但结论是”解决办法不是禁止双向格式字符”:它前面举的 Ada 例子一个控制字符都没用,只靠希伯来字母本身的从右向左属性,就让一个实际为空区间(从 ת 到 א)的循环看起来遍历了整个希伯来字母表。它提出两条建议:编辑器按源代码的词法结构(而不是把整行当作纯文本)应用双向算法,这样注释和字符串里的控制字符就不会把内容”搬”到它们外面去;语言允许在规定位置插入双向格式字符,并由工具自动删除多余的、补上正确的。这与 Rust 直接拒绝编译的做法并不一致。
同形字符与可混淆检测
双向控制字符改变的是显示顺序,同形字符利用的是字形相似。UTS #39《Unicode 安全机制》(Unicode Security Mechanisms,revision 30,对应 Unicode 16.0)提供了两类工具。第一类是 confusables.txt 数据,以及把字符串映射到”骨架”(skeleton)的算法:两个字符串骨架相同,就认为它们视觉上可混淆。第二类是混合文字检测(mixed-script detection,第 5.1 节)和几档”限制级别”(restriction level)。
Chromium
的国际化域名(IDN)显示策略是一个具体的应用。它基于 UTS #39
的”高度限制”(Highly
Restrictive)级别检查文字混用,拉丁、西里尔、希腊字母不能在同一个标签里混用;还按
UTS #39 检测混合文字可混淆和整体文字可混淆。例如
аррӏе.com(Punycode 为
xn--80ak6aa92e.com)的第一个标签全部由长得像拉丁字母的西里尔字母组成,而顶级域
com
不是西里尔文字的域,也不在大量使用西里尔域名的顶级域列表里(如
ru、su、ua),所以浏览器改为显示
Punycode。
十二、工程清单
| 场景 | 常见错误 | 做法 |
|---|---|---|
| 接收外部字节 | 不验证就当作 UTF-8 处理,或自己写的宽松解码器接受过长编码、代理码点 | 在边界处按表 3-7 严格验证;性能敏感时用 SIMD 验证库 |
| 替换非法字节 | 各层替换方式不同,同一输入得到不同字符串 | 统一采用最大子部分替换;需要可逆时拒绝而不是替换 |
| 路径和权限检查 | 在未解码或宽松解码的字节上找 ../ |
先严格解码,再规范化,最后在同一个字符串上检查并使用 |
| 长度限制 | 用 UTF-16 码元数或码点数限制存储长度 | 存储和协议用字节数;界面截断用字素簇,且不要写进持久化约束 |
| 字符串拼接 | 假设 NFC + NFC 仍是 NFC | 拼接后重新规范化,或在比较时规范化 |
| 大小写无关比较 | lower(a) == lower(b);使用默认 locale 的
API |
用完整大小写折叠加规范化(D145);与语言无关的标识符用
Locale.ROOT 等根区域设置 |
| 排序 | 按码点或 UTF-16 码元排序后展示给用户;两个系统排序规则不同却做归并 | 展示用 UCA/CLDR 并带上语言参数;系统间交换有序数据时约定同一种二进制顺序 |
| 源代码与配置 | 允许任意双向控制字符和混合文字标识符 | 编译器、代码审查工具对不配对的双向控制字符报警或拒绝;标识符按 UAX #31 / UTS #39 限制 |
| 数据库 | MySQL 使用 utf8(即
utf8mb3),emoji 写入失败或被截断 |
使用 utf8mb4 |
十三、争论与开放问题
争论:U+FFFD 该替换几个(2017)
第四节的最大子部分替换,曾经差一点被另一种做法取代。2017 年 5 月 12 日,Unicode 技术委员会(UTC)第 151 次会议以共识 151-C19 接受了提案 L2/17-168,准备在 Unicode 11 里把推荐做法改成 ICU 当时的行为:按首字节的比特模式确定一段非法序列有多长,不再考虑 E0、ED、F0、F4 对第二字节的额外限制。按这种做法,F0 80 80 41 只输出 1 个 U+FFFD,而不是 3 个。
Mozilla 的 Henri Sivonen 在 6 月 12 日提交了 L2/17-197,请求撤回这个决定。他调查了主流实现:Firefox、Chrome、Python 3、Rust 标准库都遵循原来的推荐做法,WHATWG 编码标准(浏览器解码 Web 内容的依据)也写的是这种做法,ICU 反而是少数派;他还发现 Go 对截断序列逐字节输出 U+FFFD。改变推荐做法等于让多数实现从”符合推荐”变成”不符合推荐”。8 月 3 日,UTC 第 152 次会议以 152-C21 撤回了原决定,随后的 L2/17-344r2 修改措辞,明确这种做法”不是一致性所必需的”,并引用了 W3C 版的编码标准。ICU 60(2017 年 11 月 2 日)随即改为与 WHATWG 一致。
这场争论留下两个结果。一是今天 Python、Node、Rust、ICU 的替换结果一致(第四节的表),这是 2017 年之后才实现的。二是标准仍然没有强制任何一种替换方式,Go 的两种写法至今与多数实现不同。需要跨语言得到相同结果的系统,只能自己约定并测试。
争论:Trojan Source 是谁的漏洞
CVE-2021-42574 的描述是”在 Unicode 规范 14.0 及以前版本的双向算法中发现一个问题”。同一条目附有 Unicode 联盟的不同表述:“国际化文本的性质中存在一个问题”,影响所有版本;这类问题已在 UTR #36《Unicode 安全考虑》中记录,缓解措施见 UTS #39、UAX #31,以及 UAX #9 里允许程序文本定制显示的 HL4 条款。NVD 的西班牙语译文直接把这条 CVE 标为”有争议”。
各方的回应也不一致。Rust 修改了编译器,但声明问题”不是 rustc 的缺陷”;GCC 默认只警告不配对的控制字符;UTS #55 明确不主张禁止双向格式字符,而是要求编辑器按词法结构显示代码。问题出在规范、编译器还是显示工具,至今没有共识。从第十一节的例子看,编译器的行为完全符合语言规范,FriBidi 的显示完全符合 UAX #9,出错的是”审查者以为看到的就是编译器读到的”这个假设。把责任放在哪一层,决定了修复放在哪一层。
开放问题:长度与分段的版本依赖
规范化有稳定性保证(第七节),字素簇分段没有。GB9c 在 15.1 才加入,每个新版本都会增加 emoji 和组合符号。于是”字符数”这个看似简单的量依赖于运行时的 Unicode 版本。如何在持久化数据、跨服务协议和用户界面之间定义一个既稳定又符合用户直觉的”长度”,目前没有标准答案。常见的折中是存储用字节、交互用字素簇,但两者之间的换算仍然依赖版本。
开放问题:更宽的 SIMD
Keiser 和 Lemire 在论文结论中提出,AVX-512 这样更宽的向量指令”原则上”可以让性能翻倍,ARM 的 SVE/SVE2 也值得研究,并把它们列为未来的工作。查表算法的核心是三次 16 项查表,与向量宽度无关,但 ASCII 快速路径、块间进位和末尾处理的代价会随宽度变化。在不同的微架构上,这些收益能兑现多少,需要逐个实测。
十四、参考资料
规范与文档
- The Unicode Consortium, The Unicode Standard, Version 16.0.0, 2024, Chapter 3 “Conformance”:D76、D79、D90–D92、D93b,第 3.9.6 节,表 3-6 至 3-11;第 3.13 节 D144–D146 与表 3-17(Final_Sigma)。
- Unicode Corrigendum #1: UTF-8 Shortest Form, 2000(适用于 Unicode 3.0.0、3.0.1)。
- UAX #15, Unicode Normalization Forms, revision 56(Unicode 16.0):第 1.4 节、第 9 节、第 13 节(UAX15-D3、UAX15-D4)。
- UAX #29, Unicode Text Segmentation, revision 45(Unicode 16.0);对照 revision 41(Unicode 15.0)。
- UAX #9, Unicode Bidirectional Algorithm, revision 50(Unicode 16.0):规则 L2、L4,max_depth。
- UTS #10, Unicode Collation Algorithm, revision 51:第 4 节可变权重,第 7.3 节排序键。
- UTS #39, Unicode Security Mechanisms, revision 30(Unicode 16.0):第 5.1 节混合文字检测。
- UTS #55, Unicode Source Code Handling, revision 3(2023-08-29)与 revision 5(2024-01-29):第 1.2.3 节。
- Unicode Character Database 16.0.0:CaseFolding.txt、SpecialCasing.txt、DerivedAge.txt、CompositionExclusions.txt。
- Unicode Character Encoding Stability Policies:Normalization Stability、Case Pair Stability、Case Folding Stability。
- UTC 文件 L2/17-168、L2/17-197(H. Sivonen)、L2/17-344r2;UTC #151 共识 151-C19,UTC #152 共识 152-C21。
- F. Yergeau, “UTF-8, a transformation format of ISO 10646”, RFC 2279, 1998-01。
- F. Yergeau, “UTF-8, a transformation format of ISO 10646”, RFC 3629 / STD 63, 2003-11:第 1、3、10、12 节。
- W3C, Character Model for the World Wide Web: String Matching(charmod-norm)。
- Apple, Technical Note TN1150 “HFS Plus Volume Format”;Apple File System Guide, “Frequently Asked Questions”。
- Oracle, Java SE 21
API:
java.io.DataInput(Modified UTF-8)、java.lang.String.toLowerCase()。 - MySQL 8.4 Reference Manual 第 12.9.2 节(utf8mb3);MySQL 8.0 Reference Manual 第 12.3.2 节(服务器字符集)。
- PEP 393 “Flexible String Representation”(Python 3.3);PEP 3131 “Supporting Non-ASCII Identifiers”。
- Rat für deutsche Rechtschreibung, Pressemitteilung “Amtliches Regelwerk der deutschen Rechtschreibung aktualisiert”, 2017-06-29;Amtliches Regelwerk 2016(2017 年发布),§ 25 E3。
源码
- B. Hoehrmann, “Flexible and Economical UTF-8 Decoder”,Copyright 2008–2010,MIT 许可(第一版与 2010 年 6 月的 ×12 版)。
- simdjson
v4.6.11,
src/generic/stage1/utf8_lookup4_algorithm.h。 - Go
1.26,
src/unicode/utf8/utf8.go:Valid();strings.ToValidUTF8。 - GNU FriBidi 1.0.16。
- N. Boucher,
nickboucher/trojan-source:C/commenting-out.c。
核心论文
- J. Keiser, D. Lemire, “Validating UTF-8 in less than one instruction per byte”, Software: Practice and Experience 51(5), 2021, 950–964, doi:10.1002/spe.2920;arXiv:2010.03090。第 5 节、第 6 节、表 8、表 12、表 13、第 9 节。
- N. Boucher, R. Anderson, “Trojan Source: Invisible Vulnerabilities”, 32nd USENIX Security Symposium, 2023, 6507–6524;arXiv:2111.00169。
其他论文
- N. Boucher, R. Anderson, “Talking Trojan: Analyzing an Industry-Wide Disclosure”, ACM SCORED ’22, 2022, 83–92, doi:10.1145/3560835.3564555。
- N. Boucher, I. Shumailov, R. Anderson, N. Papernot, “Bad Characters: Imperceptible NLP Attacks”, IEEE S&P 2022, 1987–2004。
工程资料
- R. Pike, “UTF-8 history”,致 M. Kuhn 等人的邮件,2003-04-30;附 R. Cox 对 Plan 9 归档的查证(2003-06-07)与 1992 年 FSS-UTF 提案原文。
- Rust Blog, “Security advisory for rustc (CVE-2021-42574)”, 2021-11-01。
- GCC 12 Release Series: Changes, New Features, and
Fixes(
-Wbidi-chars,PR 103026)。 - Chromium,
docs/idn.md:Internationalized Domain Names (IDN) in Google Chrome。 - NVD:CVE-2000-0884、CVE-2008-2938、CVE-2021-42574、CVE-2021-42694;Microsoft 安全公告 MS00-078;Apache Tomcat 6.x 安全公告(CVE-2008-2938)。
实验
reproduce/utf8.h:编码器、表 3-7 解码器、逐字符分支验证器、Hoehrmann DFA 及三流版本;reproduce/utf8_sse.h:SSSE3 查表验证器。reproduce/test_utf8.c:全部 \(2^{21}\) 个整数的编码往返、长度 1 到 4 的全部字节串穷举、随机与覆写测试、变异检查;reproduce/crosscheck.py:与 CPython 替换结果比对。reproduce/bench.c:三种输入上四个验证器的吞吐量;reproduce/lookup_trace.c:查表算法的中间向量。reproduce/fffd/:Go、Rust、Node、Python、ICU 的 U+FFFD 个数比较。reproduce/facts.py、reproduce/facts.mjs:规范化、大小写、双向类别、分段、排序的事实核对。reproduce/bidi_lint.sh、reproduce/bidi_reorder.sh:编译器对双向控制字符的诊断,FriBidi 计算的显示顺序。reproduce/figures.py:生成本文的四张 SVG;reproduce/run.sh:完整复现命令,输出在reproduce/results/。
系列导航: - 上一篇:SIMD 字节扫描:memchr 的页边界、PCMPISTRI 的代价与 JSON/CSV 的引号掩码 - 下一篇:HyperLogLog:从概率计数到 Redis 实现的基数估计
相关阅读: - DFA 最小化:词法分析器生成的核心
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
Swiss Table:控制字节、分组探测与墓碑——对照 Abseil、Go 与 hashbrown 源码
对照 Abseil 20260817.0、Go 1.26.8 与 hashbrown 0.17.1 源码,拆解 Swiss table 的控制字节编码、SIMD/SWAR 分组匹配、三角探测、删除与 rehash 策略,并用可复现实验测量探测长度、墓碑代价与每元素内存。
XXH3 与 wyhash:SIMD 累加器和 128 位标量乘法两条提速路线
对照 xxHash v0.8.3 与 wyhash final4 源码拆解两者的内层循环,用逐位一致的复现程序和 i9-12900K 实测说明:AVX2 版 XXH3 在缓存内领先,默认 SSE2 构建反而慢于 wyhash,两者都有已知的乘零多重碰撞。
AC 自动机:失败链接、输出链接与转移表布局
从 Aho–Corasick 原文出发讲清 goto、失败与输出函数、2n 转移界和输出爆炸,用可复现程序对比满表 DFA、稀疏 NFA、位图 NFA、字节类 DFA 的内存与扫描代价,并核对 grep、Snort、Suricata、Hyperscan 与 Rust crate 的实际选择。
算法工程索引
汇总本站算法工程相关文章,覆盖排序、哈希、树、字符串、近似数据结构、SIMD、随机化与编译器相关算法。