水塘抽样(reservoir
sampling)的题面很短:数据一条一条流过,总长度事先不知道,内存只能放
\(k\)
条,要求任何时刻手里的 \(k\)
条都是”已见数据的均匀随机样本”。常见的讲法到这里就给出三行
Algorithm R,再补一句”每个元素被选中的概率都是 \(k/n\)“。这句话对,但它证明的东西比题目要求的弱:每个元素概率相等,并不推出每个
\(k\)
子集概率相等,系统抽样就是反例,而 PostgreSQL 的
ANALYZE 在源码注释里明说自己只做到了前者。
本文回答四个问题。第一,“均匀”到底指什么,Algorithm R
为什么满足更强的那个定义(第一、二节)。第二,Algorithm R
每条数据都要一个随机数,Vitter 的 Algorithm X/Z 与 Li 的
Algorithm L 怎样把随机数降到 \(O(k
\log(n/k))\),其中 L
为什么是精确算法而不是近似(第三节)。第三,真实系统怎么用:PostgreSQL
17 与 Spark 3.5
的源码各做了什么取舍(第四节)。第四,把问题稍微改一改会怎样:两个水塘怎么合并、带权重时”按权重成比例”到底能不能做到、只要最近
\(w\)
条数据时怎么办(第五到七节)。所有统计检验和计数都来自
reproduce/
里的程序,第三节末尾给出运行方式。
一、问题:什么叫均匀样本
两种均匀
设数据流为 \(x_1, x_2, \dots\),处理完前 \(t\) 条后手里的样本记为 \(S_t \subseteq \{1, \dots, t\}\),\(|S_t| = \min(t, k)\)。常说的”均匀”有两个层次:
- 子集均匀(simple random sample without replacement):对每个 \(A \subseteq \{1,\dots,t\}\)、\(|A| = k\),都有 \(\Pr[S_t = A] = 1/\binom{t}{k}\)。
- 边缘均匀:对每个 \(i \le t\),都有 \(\Pr[i \in S_t] = k/t\)。
子集均匀推出边缘均匀(对包含 \(i\) 的 \(\binom{t-1}{k-1}\) 个子集求和),反过来不成立。反例是系统抽样(systematic sampling):\(t = 6\)、\(k = 3\) 时随机选起点 \(r \in \{0, 1\}\),取 \(\{r, r+2, r+4\}\)。每个元素的边缘概率都是 \(1/2\),但 \(\binom{6}{3} = 20\) 个子集里只有 2 个可能出现。后面第二节的联合分布卡方检验里,系统抽样的统计量是 \(9.0 \times 10^6\)(自由度 19),一眼就能分出来。
区别不只是理论上的。凡是用到样本中两两关系的估计量,都依赖二阶包含概率 \(\pi_{ij} = \Pr[i \in S, j \in S]\):Horvitz-Thompson 估计的方差、样本内去重计数、按样本估计列与列的相关性。子集均匀时 \(\pi_{ij} = \frac{k(k-1)}{t(t-1)}\) 对所有 \(i \ne j\) 相同;只有边缘均匀时,\(\pi_{ij}\) 可以随 \(i, j\) 的位置变化,而且算法通常不告诉你怎么变。
水塘算法与下界
Vitter 1985 年的论文(ACM TOMS 11(1))给了这个问题一个结构性刻画。他把”水塘算法”(reservoir algorithm)定义为:先把前 \(n\) 条放进水塘,后续记录顺序处理、只能在经过时被选入,并且每处理完一条,都能从水塘当前状态中取出一个真正的随机样本(Definition 1)。他的 Theorem 1 说,这个抽样问题的任何单遍算法都是某种水塘算法。理由很直接:总长度未知,所以算法必须随时准备好”数据到此为止”,也就随时要持有前 \(t\) 条的一个合法样本。
(Vitter 用 \(n\) 表示样本大小、\(N\) 表示文件长度;本文统一用 \(k\) 表示样本大小、\(n\) 表示流长度,引用他的公式时已换好记号。)
由此得到下界:第 \(t+1\) 条记录必须以至少 \(k/(t+1)\) 的概率进入水塘,否则”文件恰好有 \(t+1\) 条”时它的包含概率就不够。对 \(t = k, \dots, n-1\) 求和,任何水塘算法期望至少插入
\[ k + \sum_{t=k}^{n-1} \frac{k}{t+1} = k\,(1 + H_n - H_k) \approx k\left(1 + \ln\frac{n}{k}\right) \]
次,其中 \(H_m\) 是调和数。每次插入至少要花常数时间,所以单遍水塘抽样的时间下界是 \(\Omega\!\left(k(1 + \log(n/k))\right)\)。Algorithm R 的插入次数正好达到这个量,它慢的地方不在插入,而在于它给每一条记录都生成一个随机数。第三节的算法都是在”不看被跳过的记录”上做文章。
下文把 \(k(H_n - H_k)\)(不含最初的 \(k\) 次填充)称为期望替换次数,第三节的计数实验会直接和它对照。
二、Algorithm R 与子集均匀的证明
算法
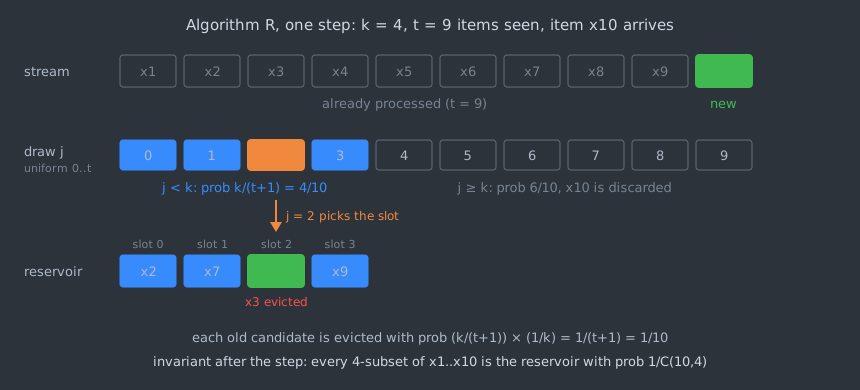
Algorithm R 出自 Knuth《The Art of Computer Programming》第 2 卷 3.4.2 节,Vitter 1985 在第 2 节称它是”a reservoir algorithm due to Alan Waterman”。流下标从 0 开始时,第 \(i\) 条(\(i \ge k\),即第 \(i+1\) 条记录)到达时在 \(\{0, \dots, i\}\) 上均匀抽一个整数 \(j\),若 \(j < k\) 就用它替换第 \(j\) 个槽位:
/* reproduce/reservoir.c:流为 0, 1, ..., n-1,res 容量为 k */
static void alg_r(long n, int k, long *res)
{
    if (!fill(n, k, res)) return;            /* 前 k 条直接放入 */
    for (long i = k; i < n; i++) {           /* 第 i 条是第 i+1 条记录 */
        uint64_t j = below((uint64_t)i + 1); /* [0, i] 上均匀 */
        if (j < (uint64_t)k) { res[j] = i; insertions++; }
    }
}
below(m) 用 Lemire 的乘法移位加拒绝实现,在
\([0, m)\) 上严格均匀。一个
\(j\)
同时决定了两件事:是否接纳(\(j
< k\) 的概率为 \(k/(i+1)\)),以及接纳时替换哪个槽位(条件在
\(j < k\) 上,\(j\) 在 \(\{0,\dots,k-1\}\)
上均匀)。
归纳证明
命题:对所有 \(t \ge k\),处理完前 \(t\) 条后,对每个 \(A \subseteq \{1, \dots, t\}\)、\(|A| = k\),有 \(\Pr[S_t = A] = 1/\binom{t}{k}\)。
证明:对 \(t\) 归纳。\(t = k\) 时 \(S_k = \{1, \dots, k\}\),\(\binom{k}{k} = 1\),成立。设命题对 \(t\) 成立,考虑第 \(t+1\) 条:算法在 \(\{0, \dots, t\}\) 上抽 \(J\),\(J\) 与 \(S_t\) 独立。于是在给定 \(S_t\) 的条件下,第 \(t+1\) 条被丢弃的概率是 \(\frac{t+1-k}{t+1}\),它替换某个指定槽位的概率是 \(\frac{1}{t+1}\)。任取 \(A \subseteq \{1, \dots, t+1\}\)、\(|A| = k\),分两种情况。
情况一,\(t+1 \notin A\)。此时 \(S_{t+1} = A\) 当且仅当 \(S_t = A\) 且第 \(t+1\) 条被丢弃:
\[ \Pr[S_{t+1} = A] = \frac{1}{\binom{t}{k}} \cdot \frac{t+1-k}{t+1} = \frac{1}{\binom{t+1}{k}}, \]
最后一步用了 \(\binom{t+1}{k} = \binom{t}{k} \cdot \frac{t+1}{t+1-k}\)。
情况二,\(t+1 \in A\)。记 \(A' = A \setminus \{t+1\}\),\(|A'| = k - 1\)。此时 \(S_{t+1} = A\) 当且仅当存在 \(y \in \{1, \dots, t\} \setminus A'\) 使 \(S_t = A' \cup \{y\}\),并且 \(J\) 恰好选中 \(y\) 所在的槽位。\(y\) 有 \(t - k + 1\) 种取法,对应的事件两两不交:
\[ \Pr[S_{t+1} = A] = (t-k+1) \cdot \frac{1}{\binom{t}{k}} \cdot \frac{1}{t+1} = \frac{1}{\binom{t+1}{k}}. \]
两种情况都成立,归纳完成。\(\square\)
证明用到的只有三件事:\(J\) 与过去独立;\(J\) 在 \(t+1\) 个值上精确均匀;替换位置只依赖 \(J\),与槽位里放的是谁无关。槽位的排列顺序不影响结论,所以 \(S_t\) 作为集合是均匀的,但作为序列并不是随机排列(前 \(k\) 条最初按到达顺序占据槽位 0 到 \(k-1\)),需要随机顺序时应在输出前再洗牌一次。
这也说明了随机数生成方式为何重要。Spark 3.5.3 的
reservoirSampleAndCount 用
(rand.nextDouble() * l).toLong
求替换位置,nextDouble 只有 \(2^{53}\)
个等距取值,取整后各下标分到的取值个数最多相差 1,概率与
\(1/l\) 的相对偏差在 \(l/2^{53}\) 量级;PostgreSQL 的
(int) (targrows * sampler_random_fract(...))
同理。对数据库统计信息这点偏差无关紧要,但它说明”精确均匀”在浮点实现里只是近似。
卡方检验:正确版本与两类常见错误
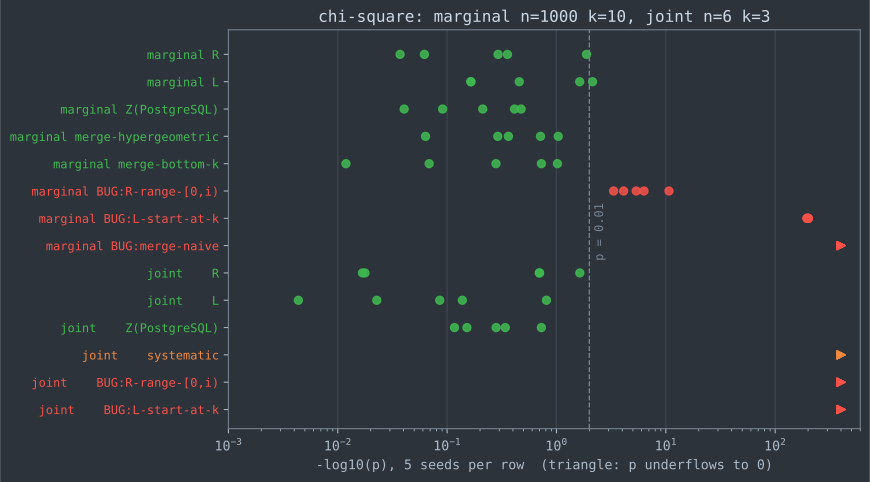
检验分两种。边缘检验:\(n = 1000\)、\(k = 10\),重复 200000 次,统计每个下标被选中的次数 \(c_i\),期望 \(E = 2000\)。由于每次抽样内部是无放回的,\(c_i\) 不是多项分布:单次抽样的包含指示变量方差为 \(p(1-p)\)、两两协方差为 \(-p(1-p)/(n-1)\)(\(p = k/n\)),推出 \(\sum_i (c_i - E)^2/E\) 近似服从 \(\frac{n-k}{n-1}\chi^2_{n-1}\)。程序把统计量乘以 \(\frac{n-1}{n-k}\) 再对自由度 999 求 \(p\) 值。联合检验:\(n = 6\)、\(k = 3\),重复 \(10^6\) 次,统计 20 个子集各出现几次,这才是对子集均匀的直接检验,自由度 19。\(p\) 值用程序里自写的正则化不完全伽马函数计算。
5 个种子的结果:
| 采样器 | 边缘统计量(df 999) | 边缘 \(p\) | 联合统计量(df 19) | 联合 \(p\) |
|---|---|---|---|---|
| Algorithm R | 937.4 至 1101.0 | 0.0131 至 0.918 | 9.6 至 33.1 | 0.0231 至 0.962 |
| 系统抽样 | 未测(按构造边缘均匀) | — | \(9.0 \times 10^6\) | 0 |
| R,范围误写成 \([0, i)\) | 1153.7 至 1323.0 | \(4.7 \times 10^{-4}\) 至 \(2.1 \times 10^{-11}\) | \(2.0 \times 10^5\) | 0 |
\(p\) 值为 0
表示低于双精度能表示的范围。正确实现的 \(p\) 值散布在 \((0, 1)\) 上,5
个种子中有一个低于 0.05
是正常波动;两个错误版本在每个种子上都被拒绝。“范围误写”指把
below(i + 1) 写成
below(i):接纳概率变成 \(k/i\) 而不是 \(k/(i+1)\),后到的元素被系统性高估。在
\(n = 1000\)
的边缘检验里这个偏差不大,有一个种子的 \(p\) 值只有 \(4.7 \times 10^{-4}\);在 \(n = 6\) 的联合检验里第 \(k\) 条(下标
3)必然被接纳,偏差一目了然。小规模的联合检验比大规模的边缘检验更容易抓到这类边界错误。
三、跳过记录:Algorithm X、Z 与 L
跳跃长度的分布
Algorithm R 的随机数次数恰好是 \(n - k\)。要降到下界的量级,只能不再逐条掷骰子,而是直接生成”下一次接纳之前要跳过多少条”。Vitter 把这个量定义为 \(\mathcal{S}(k, t)\)(Definition 2):已处理 \(t\) 条时,接下来被跳过的记录数。第 \(t+1, \dots, t+s\) 条全部被拒绝的概率是
\[ \Pr[\mathcal{S} \ge s] = \prod_{m=t+1}^{t+s} \frac{m-k}{m} = \frac{(t+1-k)^{\overline{s}}}{(t+1)^{\overline{s}}}, \]
其中 \(a^{\overline{s}} = a(a+1)\cdots(a+s-1)\) 是上升阶乘。只要能以常数期望代价从这个分布中取样,总代价就是 \(O(k(1 + \log(n/k)))\),与第一节的下界同阶。
- Algorithm X:抽一个均匀数 \(V\),从 \(s = 0\) 开始顺序累乘 \(\frac{t+1-k}{t+1}\cdot\frac{t+2-k}{t+2}\cdots\),直到乘积不超过 \(V\)。每次跳跃一个随机数,但时间与跳跃长度成正比,总时间仍是 \(O(n)\)。
- Algorithm Z:用一个连续分布包住 \(\mathcal{S}\) 做拒绝采样(rejection sampling),期望常数次迭代就能取到一个样本。拒绝采样保证结果精确服从 \(\mathcal{S}\) 的分布,连续分布只是包络。Vitter 的 Table I 给出的随机数次数:R 为 \(N - n\),X 与 Y 约为 \(2n\ln(N/n)\),朴素的 Z 约为 \(3n\ln(N/n)\);第 6 节的优化让 Z 复用接受检验中的量来生成下一轮的 \(W\),把次数降到约 \(2n\ln(N/n)\)。Z 在 \(t\) 较小时先用 X,阈值取 \(t \le 22n\)(原文 \(T = 22\))。
Algorithm L:从随机键推出来
Li 1994 年在 ACM TOMS 20(4) 上发表的论文给出了三个新算法:Z 的改进版 K,以及 L 和 M,摘要说三者期望时间都是 \(O(n(1 + \log(N/n)))\),其中 L 最简单,M 在 \(n\) 与 \(N/n\) 都大时最快。L 不需要拒绝采样,下面用随机键(random key)视角给出它的推导和正确性,这一视角在第五、六节还会反复用到。
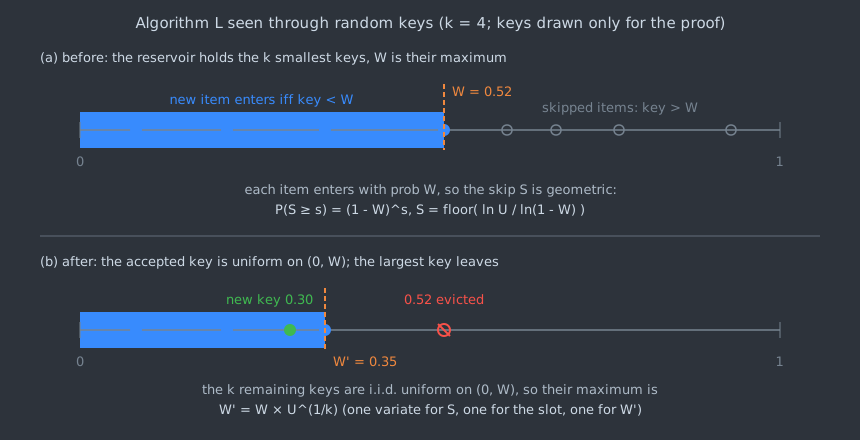
给第 \(i\) 条记录配一个独立的键 \(U_i \sim \mathrm{Uniform}(0, 1)\),只保留键最小的 \(k\) 条(bottom-\(k\))。键是 i.i.d. 连续变量,所以前 \(t\) 条里任何 \(k\) 个下标成为”最小的 \(k\) 个”的概率相同,bottom-\(k\) 集合是子集均匀的样本。记 \(W\) 为水塘中最大的键,即前 \(t\) 个键的第 \(k\) 小值。
- 跳多远。后续记录的键与过去独立,每条以概率 \(W\) 落进 \((0, W)\)、从而进入水塘。给定 \(W\),被跳过的条数服从几何分布:\(\Pr[S \ge s \mid W] = (1-W)^s\)。用逆变换,\(S = \lfloor \ln U / \ln(1 - W) \rfloor\)。
- 新键是什么。被接纳记录的键在”小于 \(W\)“的条件下服从 \(\mathrm{Uniform}(0, W)\)。
- 逐出谁。被逐出的是键等于 \(W\) 的那条。上一轮结束时水塘的 \(k\) 个键在给定最大值的条件下是 i.i.d. 的,最大值落在哪个槽位与最大值本身独立且在 \(k\) 个槽位上均匀,所以均匀随机选一个槽位逐出,分布完全相同。
- 新阈值。给定第 \(k\) 小值为 \(W\),比它小的 \(k - 1\) 个键是 \(\mathrm{Uniform}(0, W)\) 上的 i.i.d. 变量;加上新键,水塘里的 \(k\) 个键是 \(\mathrm{Uniform}(0, W)\) 上的 \(k\) 个 i.i.d. 变量,其最大值为 \(W' = W \cdot U^{1/k}\)。初始时 \(W = U^{1/k}\)。
每一步都是分布上的等式,没有近似,所以 L 在实数运算下是精确算法,只在浮点层面有舍入误差。算法从不存储键,只维护一个标量 \(W\):
/* reproduce/reservoir.c:Algorithm L(Li 1994) */
static void alg_l(long n, int k, long *res)
{
    if (!fill(n, k, res)) return;
    double W = exp(log(u01()) / k);
    long i = k - 1;                          /* 最后一条已见记录的下标 */
    for (;;) {
        double s = floor(log(u01()) / log1p(-W));
        if (s >= (double)(n - 1 - i)) break; /* 下一次接纳已超出流尾 */
        i += (long)s + 1;
        res[below((uint64_t)k)] = i;
        insertions++;
        W *= exp(log(u01()) / k);
    }
}两个实现细节。其一,\(W\) 随 \(t\) 按 \(k/(t+1)\) 的量级衰减(\(W\) 是 \(t\) 个均匀变量的第 \(k\) 小值,\(\mathbb{E}[W] =
k/(t+1)\));流很长时 \(1 -
W\) 在双精度下损失有效位,应当用
log1p(-W) 而不是
log(1 - W)。其二,u01() 返回开区间
\((0, 1)\) 上的值,避免
log(0)。
另一个常见错误是循环起点:若把”最后一条已见记录”初始化成
\(k\) 而不是 \(k - 1\),下标为 \(k\)
的那条永远不会被选中。这个版本在第二节的检验里边缘统计量为
2980.2 至 3020.8(\(p <
10^{-195}\)),联合统计量约 \(1.0 \times 10^6\)。正确的 L 在
5 个种子上的边缘 \(p\) 值为
0.00728 至 0.684,联合 \(p\) 值为 0.155 至 0.99。种子 1
的 0.00728 偏低,用 \(2 \times
10^6\)
次重复在另外三个种子上复查(./reservoir chi 11 2000000
等),L 的 \(p\) 值为
0.615、0.136、0.0726,没有偏差迹象。
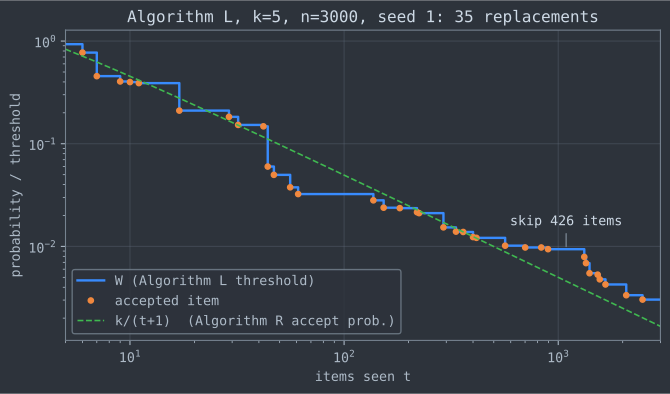
图中每个橙点是一次接纳,两个橙点之间的水平段就是一次跳跃,期间不生成随机数。\(W\) 围绕 \(k/(t+1)\) 上下波动:它是一个随机阈值,不是确定的接纳概率,但对 \(W\) 取期望后,每条记录被接纳的概率恰好回到 \(k/(t+1)\)。
随机数次数
L 每次替换用 3 个随机数(跳跃、槽位、新 \(W\)),外加初始 \(W\) 和最后一次越界的跳跃,共 \(3R + 2\) 个,\(R\) 为替换次数,\(\mathbb{E}[R] = k(H_n - H_k)\)。PostgreSQL 版的 Z 在 X 阶段每次跳跃 1 个随机数、Z 阶段在接受时复用 \(W\),再加 1 个槽位随机数,约为 \(2R\)。三个种子的中位数:
| \(k\) | \(n\) | R 随机数 | L 随机数 | Z(PostgreSQL 实现)随机数 | \(k(H_n - H_k)\) |
|---|---|---|---|---|---|
| 10 | \(10^6\) | 999990 | 362 | 248 | 114.6 |
| 10 | \(10^8\) | 99999990 | 515 | 322 | 160.7 |
| 100 | \(10^6\) | 999900 | 2723 | 1895 | 920.5 |
| 100 | \(10^8\) | 99999900 | 4142 | 2855 | 1381.1 |
| 1000 | \(10^6\) | 999000 | 20792 | 14114 | 6907.3 |
| 1000 | \(10^8\) | 99999000 | 34739 | 23123 | 11512.4 |
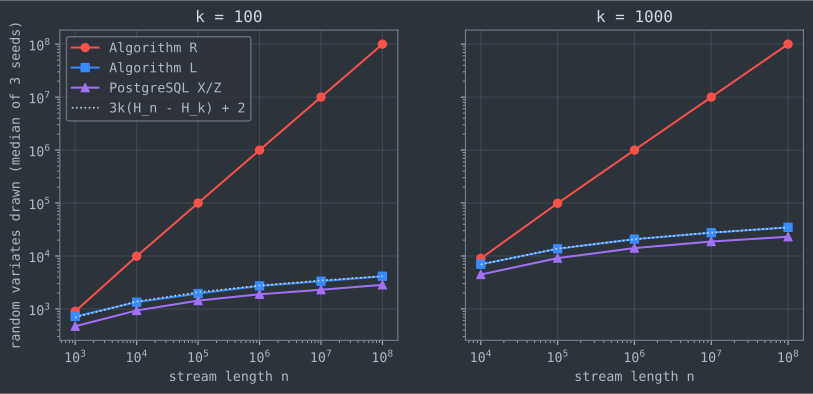
\(k = 100\)、\(n = 10^8\) 时,R 用了约 \(10^8\) 个随机数,L 用了 4142
个,差四个数量级;Z 比 L
再少约三分之一。这里比的是随机数个数,不是时间:L 每步有两次
log 与一次 exp,Z 的拒绝循环和 X
阶段的逐项累乘各有开销,本文没有做计时比较。
复现方式
以上与后文的全部数字来自
reproduce/reservoir.c(C,约 670
行,含全部采样器、卡方检验和计数),图由
reproduce/plot.py 从
reproduce/results/ 生成:
sh reproduce/run.sh 10          # 编译、自检、跑全部实验,绑定到 CPU 10
python reproduce/plot.py        # 重新生成本文的 4 张数据图
环境:Intel Core i9-12900K,WSL2 内核
6.6.87.2-microsoft-standard-WSL2,GCC 16.1.1,编译参数
-O2 -Wall -Wextra(无警告),自检另用
-fsanitize=address,undefined
跑过。随机数生成器是 splitmix64 播种的
xoshiro256**,所有指标都是计数、频率或卡方统计量,与时钟无关;同一种子、同一
libm 下输出逐位可重复。
四、生产系统里的水塘
PostgreSQL 17:块抽样加 Vitter 行抽样
ANALYZE
要从一张可能有上亿行的表里取固定数目的行来算直方图和最常见值。每列所需行数在
std_typanalyze 中定为
300 * attstattarget,源码注释给出依据:Chaudhuri、Motwani、Narasayya
在 SIGMOD 1998 论文的 Theorem 5 推论 1 中给出最小样本量
\(r =
4k\ln(2n/\gamma)/f^2\),取 \(f = 0.5\)、\(\gamma = 0.01\)、\(n = 10^6\) 得 \(r =
305.82k\)。default_statistics_target
默认为 100(guc_tables.c),因此默认每表抽
30000 行;do_analyze_rel 另设下限 100
行,注释说是为了”avoid possible overflow in Vitter’s
algorithm”。
取样本的是 src/backend/commands/analyze.c
中的 acquire_sample_rows(以下均为 REL_17_4
标签)。它的注释写明”As of May 2004”起使用两阶段方法:
flowchart LR
    T["heap: B blocks, row count unknown"] -->|"stage 1: Knuth Algorithm S, B known"| S["up to targrows blocks, in block order"]
    S -->|"read every live row of each chosen block"| R["row stream"]
    R -->|"stage 2: Vitter X / Z skips"| V["reservoir of targrows rows"]
    V -->|"sort by physical position"| C["compute_stats per column"]
第一阶段在 src/backend/utils/misc/sampling.c
的 BlockSampler_Init /
BlockSampler_Next:块数 \(B\) 事先已知,所以用 Knuth
3.4.2 的 Algorithm S(选择抽样,selection sampling)从 \(B\) 块中选 \(\min(B, \text{targrows})\)
块,并且把”每块一个随机数”改成”每个被选中的块一个随机数”(被拒绝时把
\(V\) 重新解释为 \((0, p)\)
上的均匀数)。第二阶段对这些块里的行做水塘抽样,行数事先未知,才轮到
Vitter:
/* PostgreSQL REL_17_4, src/backend/commands/analyze.c, acquire_sample_rows(),节选 */
if (numrows < targrows)
    rows[numrows++] = ExecCopySlotHeapTuple(slot);
else
{
    if (rowstoskip < 0)
        rowstoskip = reservoir_get_next_S(&rstate, samplerows, targrows);

    if (rowstoskip <= 0)
    {
        int k = (int) (targrows * sampler_random_fract(&rstate.randstate));

        heap_freetuple(rows[k]);
        rows[k] = ExecCopySlotHeapTuple(slot);
    }
    rowstoskip -= 1;
}
samplerows += 1;
reservoir_get_next_S 在 \(t \le 22n\) 时走 Algorithm
X,否则走带 RANDOM 优化的 Algorithm Z(注释”The magic
constant here is T from Vitter’s
paper”)。第三节计数实验里的 Z
就是把这个函数移植出来、改成直接按跳跃推进下标的版本,逻辑未改。注意这里行仍然被逐条读取,跳跃省下的只是随机数和元组拷贝,I/O
省在第一阶段。
两阶段方法的代价写在同一段注释里:“Although every row has an equal chance of ending up in the final sample, this sampling method is not perfect: not every possible sample has an equal chance of being selected. For large relations the number of different blocks represented by the sample tends to be too small. We can live with that for now. Improvements are welcome.” 这正是第一节的区分:PostgreSQL 追求的是边缘均匀(严格说,块内行数不等时连边缘概率也只是近似相等),而不是子集均匀。同一块里的行常按插入顺序聚集、取值相关,样本集中在少数块里时,样本内的重复结构就不一定代表全表。这是第八节要讨论的问题之一。
Spark 3.5:RangePartitioner 的分区水塘
Spark 里调用水塘抽样的核心位置不是 SQL 的
TABLESAMPLE,而是 sortByKey
等操作依赖的
RangePartitioner。它要从各分区里取样本、估计键的分位点,从而确定分区边界。v3.5.3
core/src/main/scala/org/apache/spark/Partitioner.scala
中:
- 总样本量
sampleSize = min(samplePointsPerPartitionHint * partitions, 1e6),默认 hint 为 20;每个输入分区的水塘大小sampleSizePerPartition = ceil(3.0 * sampleSize / rdd.partitions.length),注释说是假设分区大致均衡、“over-sample a little bit”。 RangePartitioner.sketch对每个分区调用SamplingUtils.reservoirSampleAndCount(iter, sampleSizePerPartition, seed),种子为byteswap32(idx ^ (shift << 16)),返回(sample, n),其中 \(n\) 是该分区的真实元素数。- 汇总时,每个分区样本中的键带权重
n.toDouble / sample.length,即”一个样本点代表多少原始元素”;若某分区fraction * n > sampleSizePerPartition(水塘相对它太小),就对这些分区重新做一次比例为fraction的 Bernoulli 抽样,权重取1 / fraction。determineBounds按累计权重切分位点。
reservoirSampleAndCount(core/src/main/scala/org/apache/spark/util/random/SamplingUtils.scala)本身就是
Algorithm R,随机数来自 XORShiftRandom(继承
java.util.Random,只覆盖
next(bits)):
// Apache Spark v3.5.3, SamplingUtils.reservoirSampleAndCount,节选
var l = i.toLong
val rand = new XORShiftRandom(seed)
while (input.hasNext) {
  val item = input.next()
  l += 1
  val replacementIndex = (rand.nextDouble() * l).toLong
  if (replacementIndex < k) {
    reservoir(replacementIndex.toInt) = item
  }
}
(reservoir, l)
Spark “合并”各分区水塘的方式是:它不把它们合成一个全局均匀样本,而是把每个分区当作一层做分层抽样(stratified sampling),用 \(n_p / |\text{sample}_p|\) 加权。这样得到的键累计分布估计是无偏的,而且不需要额外的随机性。如果下游确实需要一个全局均匀的 \(k\) 样本,就要用下一节的方法。
五、合并多个水塘
超几何分配
设两段不相交的流 \(A\)、\(B\) 长度分别为 \(n_A\)、\(n_B\),各自的水塘 \(S_A\)、\(S_B\) 是独立的均匀 \(k\) 样本(长度不足 \(k\) 时就是全部元素)。要得到 \(A \cup B\) 的均匀 \(k\) 样本,关键是先确定新样本里有几个来自 \(A\)。\(A \cup B\) 的均匀 \(k\) 子集中来自 \(A\) 的个数 \(X\) 服从超几何分布:
\[ \Pr[X = x] = \frac{\binom{n_A}{x}\binom{n_B}{k-x}}{\binom{n_A + n_B}{k}}. \]
给定 \(X =
x\),这个子集在 \(A\) 上的部分是 \(A\) 的均匀 \(x\) 子集,在 \(B\) 上的部分是 \(B\) 的均匀 \((k-x)\) 子集,两者独立。\(A\) 的均匀 \(k\) 子集再均匀取 \(x\) 个,仍是 \(A\) 的均匀 \(x\) 子集。所以合并算法是:抽
\(X\),从 \(S_A\) 中无放回均匀取 \(X\) 个,从 \(S_B\) 中取 \(k - X\) 个。由于 \(X \le \min(k, n_A)\),\(S_A\)
总是够用。这个方法需要知道 \(n_A\) 与 \(n_B\),Spark 的
reservoirSampleAndCount
返回计数正是为了这类用途。多路合并可以两两进行,每次合并后的计数相加。
bottom-k 键
第三节的随机键给出另一种方法:每条记录带一个 i.i.d. 均匀键,每个水塘保留键最小的 \(k\) 条(连同键一起存)。合并就是取并集中键最小的 \(k\) 条。这个操作满足交换律与结合律,任意合并树、任意顺序得到的结果都相同,也不需要知道各段长度,代价是每个样本多存一个键。如果键取成记录内容的哈希值而不是随机数,同一条记录在不同站点得到相同的键,合并结果就是去重后元素的均匀样本,这就是 bottom-\(k\) MinHash 的思路,见下一篇。
朴素合并为何有偏
一种常见写法是:以 \(S_A\) 为底,对 \(S_B\) 中的每个元素,以概率 \(n_B / (n_A + n_B)\) 把它写进一个随机槽位。它看上去”按比例”,但写入的元素会互相覆盖。\(S_B\) 中进入的元素个数 \(M \sim \mathrm{Binomial}(k, n_B/n)\),每次写入以 \(1 - 1/k\) 的概率不碰某个指定槽位,所以合并后仍来自 \(A\) 的元素期望个数为
\[ \mathbb{E}[\#A] = k\,\mathbb{E}\!\left[(1 - 1/k)^M\right] = k\left(1 - \frac{n_B}{nk}\right)^{k}, \]
而正确值是 \(k n_A / n\)。取 \(n_A = 100\)、\(n_B = 900\)、\(k = 10\):前者为 \(10 \times 0.91^{10} \approx 3.89\),后者为 1,\(A\) 中元素被高估约 3.9 倍。
实验用同样的参数,把长度 1000 的流切成前 100 条(\(A\))和后 900 条(\(B\)),重复 200000 次,统计每个下标的包含频率(种子 1),期望值处处为 \(k/n = 0.01\):
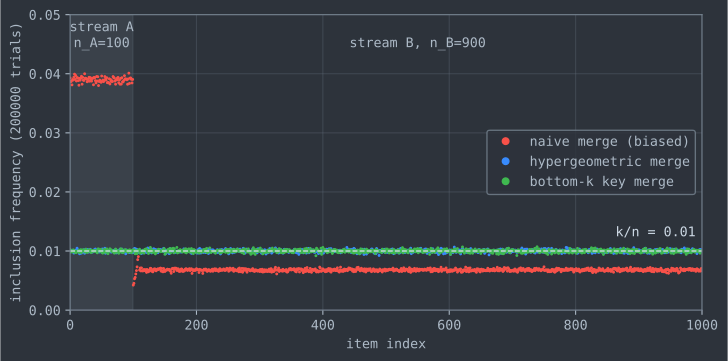
朴素合并中 \(A\) 的平均包含频率为 0.0390,与上面的 3.89/100 一致;\(B\) 为 0.00678。\(B\) 最前面的几条更低,是因为 Algorithm R 让 \(B\) 的前 \(k\) 条最初按顺序占据槽位 0 到 \(k-1\),而朴素合并按槽位顺序写入,越早写入的越容易被后写入的覆盖。第二节意义下的卡方检验:朴素合并统计量约 \(1.88 \times 10^6\)(\(p = 0\));超几何合并 \(p = 0.963\),bottom-k 合并 \(p = 0.427\);换 5 个种子重复,超几何合并的 \(p\) 值为 0.0916 至 0.864,bottom-k 为 0.0955 至 0.973。
分布式流:通信量的上下界
合并是离线的:各段处理完再汇总。更难的版本是 \(r\) 个站点持续接收数据,协调者要随时持有全体数据的均匀 \(k\) 样本,目标是最少的消息数。Cormode、Muthukrishnan、Yi、Zhang(PODS 2010,期刊版 JACM 2012)用随机键与逐轮收紧的阈值给出期望 \(O((r + k)\log n)\) 条消息的协议,并证明了一个下界。Tirthapura 与 Woodruff(DISC 2011)把上界改进到期望
\[ O\!\left(\frac{r\log(n/k)}{\log(1 + r/k)}\right) \]
条消息(\(k \ge r/8\) 时即 \(O(k\log(n/k))\)),并证明任何正确协议都以至少 \(1 - q\) 的概率要发这么多消息,上下界同阶。(论文里站点数记作 \(k\)、样本大小记作 \(s\),这里已换成本文记号。)这项工作还有一段插曲:2019 年挂到 arXiv 的修订版(1903.12065)在脚注中说明,它”corrects an error in the proof of the upper bound on message complexity”,会议版第 4 节的证明被重写,主要定理的陈述不变,错误由 Rajesh Jayaram 指出。也就是说,这个”最优”结论的上界证明在会议版发表后多年才被修正。
六、加权水塘抽样
两个不同的问题
带权重 \(w_i > 0\) 时,“按权重抽 \(m\) 个”有两种互不相容的定义。Efraimidis 在 arXiv 预印本 1012.0256(2015 修订)里把它们分别命名为:
- WRS-N-P(包含概率与权重成比例):\(\Pr[i \in S] = m w_i / W\),\(W = \sum_j w_j\)。只有当所有 \(m w_i \le W\) 时才可行,这就是抽样调查中的 PPS(probability proportional to size)。
- WRS-N-W(逐次按权重抽取,successive sampling):每轮从剩余元素中按 \(w_i / \sum_{\text{剩余}} w_j\) 抽一个,抽 \(m\) 轮。永远可行,但包含概率不与权重成比例。
该文的 Example 1:权重 \((1, 1, 1, 2)\)、\(m = 2\)。WRS-N-P 下三个权重 1 的元素包含概率各为 0.4,权重 2 的为 0.8;WRS-N-W 下权重 2 的元素第一轮被抽中的概率是 \(2/5\),第一轮抽中别人后第二轮被抽中的概率是 \(\frac{3}{5}\cdot\frac{2}{4}\),合计 \(0.7\),其余三个各为 \((2 - 0.7)/3 \approx 0.433\)。
A-Res:键 \(u^{1/w}\) 与指数竞赛
Efraimidis 与 Spirakis(Information Processing Letters 97(5), 2006)给每个元素一个键 \(u_i^{1/w_i}\)(\(u_i\) 为独立均匀数),取键最大的 \(m\) 个;流式版本 A-Res 用一个大小为 \(m\) 的最小堆维护当前最大的 \(m\) 个键。他们证明这等价于 WRS-N-W,而不是 WRS-N-P。
一个简短的证明是把它看成指数竞赛(exponential race)。令 \(E_i = -\ln u_i / w_i\),则 \(E_i \sim \mathrm{Exp}(w_i)\) 且相互独立,键 \(u_i^{1/w_i} = e^{-E_i}\) 是 \(E_i\) 的单调减函数,“键最大的 \(m\) 个”就是”\(E\) 最小的 \(m\) 个”。独立指数变量的最小值落在 \(i\) 上的概率为 \(w_i / \sum_j w_j\);由无记忆性,给定最小值为 \(E_{(1)}\) 且来自 \(i\),其余的 \(E_j - E_{(1)}\) 仍是独立的 \(\mathrm{Exp}(w_j)\)。于是第二小的 \(E\) 在剩余元素中按权重分布,依此类推,这正是逐次抽样的定义。\(w_i\) 全相等时退化为第三节的随机键,得到均匀样本。
这个等价性决定了 A-Res 的适用范围:它适合”按权重偏好、无放回”的场景,但如果下游要用 Horvitz-Thompson 估计 \(\hat{Y} = \sum_{i \in S} y_i / \pi_i\),\(\pi_i\) 不是 \(m w_i / W\),而是一个没有闭式的逐次抽样包含概率,直接代入 \(m w_i / W\) 会有偏。
实测:包含概率、浮点下溢与跳跃次数
对 \((1, 1, 1, 2)\)、\(m = 2\) 各重复 \(10^6\) 次,统计 6 种可能样本对各出现几次,与理论分布做卡方检验(自由度 5),3 个种子:
| 采样器 | 权重 1 的包含频率 | 权重 2 的包含频率 | 对照分布 | \(p\) 值 |
|---|---|---|---|---|
| A-Res(对数键) | 0.4325 至 0.4342 | 0.6999 至 0.7004 | WRS-N-W | 0.726, 0.448, 0.893 |
| A-ExpJ | 0.4326 至 0.4344 | 0.6998 至 0.7005 | WRS-N-W | 0.268, 0.153, 0.63 |
| A-Chao | 0.3994 至 0.4014 | 0.7995 至 0.8002 | 它自己的精确分布 | 0.0673, 0.346, 0.606 |
| A-Chao | 同上 | 同上 | WRS-N-W | 0(统计量 47402 至 47843) |
A-Chao 是 Chao(Biometrika 69(3), 1982)的 PPS
方案在流上的写法:第 \(i\)
个元素以 \(m w_i / W_i\)
的概率进入并随机替换一个槽位,\(W_i\)
为前缀权重和。它的边缘概率正好是 0.4 与 0.8,和 A-Res
的分布显著不同。当某个元素出现 \(m
w_i / W_i > 1\)
时需要”超重元素”的特殊处理,reproduce/
里的实现只覆盖不出现这种情况的输入。
第二个实验针对键的计算方式。直接算
pow(u, 1.0 / w) 在 \(w\) 很小时会下溢:取 \(n = 4\)、\(m = 2\)、权重全为 \(5 \times 10^{-4}\),\(u^{2000}\) 在 \(u < e^{-744.4/2000} \approx
0.689\) 时小于最小正次正规数,结果为 0,实测 68.9%
的键为 0。平局时最小堆保留先到的元素,4 个元素的包含频率变成
0.612、0.816、0.286、0.286(应全为 0.5),统计量约 \(8.3 \times 10^5\)。改用对数键
\(\ln u / w\) 后 \(p\) 值为
0.743、0.391、0.669。\(w\)
极大时 \(u^{1/w}\) 会舍入到
1.0,同样产生平局,对数键也避免了这一点。
A-ExpJ 的跳跃次数依赖权重的排列
A-Res 每个元素都要一个随机数。A-ExpJ 仿照第三节的跳跃:设堆中最小键为 \(T_w\),抽 \(r\),令 \(X_w = \ln r / \ln T_w\),跳过元素直到累计权重首次达到 \(X_w\);落点元素 \(i\) 被接纳,它的新键在 \((T_w^{w_i}, 1)\) 上均匀抽取后再开 \(1/w_i\) 次方。Efraimidis 与 Spirakis 的 Theorem 2 给出期望插入次数 \(\sum_{i=m+1}^{n} m/i = m(H_n - H_m)\),由此 A-ExpJ 的随机数为 \(O(m\log(n/m))\)。但定理的前提是权重为”independent random variables with a common continuous distribution”。\(n = 10^6\)、\(m = 100\) 时 \(m(H_n - H_m) = 920.5\),3 个种子的中位数:
| 权重排列 | A-Res 插入次数 | A-ExpJ 随机数 |
|---|---|---|
| i.i.d. 均匀 | 931 | 1913 |
| 递增 \(w_i = i + 1\) | 1772 | 3587 |
| 递减 \(w_i = n - i\) | 854 | 1791 |
| 几何递增 \(w_i = 1.0001^i\) | 10514 | 21195 |
A-ExpJ 的随机数约为插入次数的 2 倍,与每次跳跃加一次取键的结构一致。权重递增时新元素更容易挤进水塘,几何递增时尤其明显:前缀权重和 \(W_i \approx c^{i+1}/(c-1)\)(\(c = 1.0001\)),每个新元素占总权重的比例约为 \(c - 1\),被接纳的概率约为 \(m(c-1) = 0.01\),插入次数约 \(n m (c-1) = 10^4\),随 \(n\) 线性增长,跳跃不再省随机数。Efraimidis 的 2015 年综述也指出,对 WRS-N-W 的水塘实现,对手可以构造需要 \(O(n\log m)\) 步的输入。
另一条谱系:PPS、优先抽样与 VarOpt
需要无偏子集和估计的场景(网络流量计量、数据库近似查询)更关心 \(\pi_i\) 是否已知,而不是是否”逐次按权重”:
- 优先抽样(priority sampling,Duffield、Lund、Thorup,JACM 54(6), 2007):优先级 \(q_i = w_i / u_i\),保留最大的 \(k\) 个,以第 \(k+1\) 大的优先级 \(\tau\) 为阈值,估计量 \(\hat{w}_i = \max(w_i, \tau)\) 对任意子集和无偏。
- VarOpt(Cohen、Duffield、Kaplan、Lund、Thorup,SODA 2009,期刊版 SIAM J. Comput. 40(5), 2011):固定样本大小 \(k\),包含概率 \(\min(1, w_i / \tau)\)(\(\tau\) 使概率之和为 \(k\)),子集和估计的方差在其论文定义的意义下最优。
- EB-PPS(Hentschel、Haas、Tian,IPL 182, 2023):坚持严格的 PPS,\(\pi_i = \rho w_i\),\(\rho = \min(1/\max_i w_i,\ k/\sum_i w_i)\),代价是样本大小只保证不超过 \(k\),每元素摊还 \(O(1)\)。
Apache DataSketches 的 C++ 库 5.2.0 版在
sampling/include/ 下同时提供
var_opt_sketch.hpp 与
ebpps_sketch.hpp,后者的注释引用了 Hentschel
等人的论文。VarOpt 与 EB-PPS
之间的取舍是第八节的主题之一。
七、滑动窗口与删除
为什么水塘不能直接用于窗口
只关心最近 \(w\) 条(序列窗口,sequence-based window)或最近一段时间(时间窗口,timestamp-based window)时,样本中的元素会过期。Babcock、Datar、Motwani 在 SODA 2002 的两页扩展摘要里先排除了两个直观做法。第一个是先对前 \(w\) 条做水塘抽样,之后每当样本中的元素过期,就用刚到达的元素顶替:样本在每个时刻都均匀,但”高度周期”,第 \(i\) 条在样本里时,第 \(i + cw\) 条(\(c\) 为正整数)也必然在。第二个是以约 \(\frac{ck\log w}{w}\) 的概率把每个新元素放进”后备样本”(backing sample),过期即删,需要时从中下采样出 \(k\) 个;由 Chernoff 界,后备样本以高概率在 \(k\) 与 \(O(k\log w)\) 之间,但期望内存也是 \(O(k\log w)\)。
chain-sample 与 priority-sample
chain-sample(序列窗口,大小为 1 的样本):第 \(i\) 条以 \(1/\min(i, w)\) 的概率成为当前样本;一旦被选中,就立即在 \(\{i+1, \dots, i+w\}\) 中均匀选一个下标,作为它过期时的接替者。接替者到达时存下来,并以同样的方式为它选下一个接替者,形成一条链。
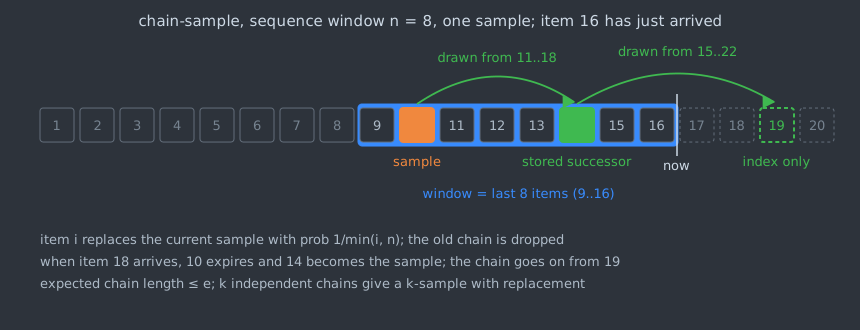
论文给出链长期望满足的递推,并由此得到期望链长不超过 \(e\),同时以高概率不超过 \(O(\log w)\)。要得到大小为 \(k\) 的样本就维护 \(k\) 条独立的链,得到的是有放回样本;无放回需要多维护一些链再去重。
priority-sample(时间窗口,窗口内元素个数随时间变化):每个元素到达时获得一个 \((0,1)\) 上的随机优先级,样本取窗口内未过期元素中优先级最高的那个。只需保存”不存在更晚且优先级更高的元素”的那些元素,它们按时间递增、优先级递减排成一条链表,相当于 treap 的右脊,窗口内有 \(w\) 个活跃元素时期望长度为 \(H_w\)。\(k\) 个样本的内存为 \(O(k\log w)\),既是期望也是高概率上界。这里的随机优先级和第三节、第五节的随机键是同一个想法:只要每个元素的键独立同分布,“键最大的那个”就是均匀样本,过期只是把候选集合缩小。
最坏情况最优与删除
上面的界是期望或高概率的。Braverman、Ostrovsky、Zaniolo(PODS 2009,期刊版 JCSS 78(1), 2012)给出了确定性最坏情况的内存界:序列窗口 \(O(k)\),时间窗口 \(O(k\log w)\),有放回与无放回都适用。时间窗口的 \(O(k\log w)\) 与 Gemulla、Lehner(SIGMOD 2008)证明的下界相符。
窗口过期是删除的一个特例。对任意插入与删除混合的数据集,Gemulla、Lehner、Haas(VLDB 2006,“A Dip in the Reservoir”)提出随机配对(random pairing):维护两个计数,\(c_1\) 为”被删除时在样本中”的未补偿删除数,\(c_2\) 为”被删除时不在样本中”的未补偿删除数。新元素到达时,若 \(c_1 + c_2 = 0\) 就按普通水塘处理;否则以 \(c_1/(c_1 + c_2)\) 的概率加入样本并令 \(c_1\) 减一,否则令 \(c_2\) 减一。每次插入与之前的一次删除配对,样本大小有上界并保持均匀。样本会因删除而变小,要把它重新扩到 \(k\),就必须回头访问底层数据。
八、争论与开放问题
块抽样:I/O 与子集均匀
PostgreSQL 在注释里公开承认两阶段方法”not perfect”,并写下”Improvements are welcome”。问题的实质是:真正的行级子集均匀样本要求随机读取 \(k\) 个行所在的块,而大表上 \(k = 30000\) 行几乎就是 30000 次随机块读取;两阶段方法读取同样数目的块,却把每块内所有行都送进水塘,行级 I/O 利用率高,代价是样本在块上聚集。两者之间没有免费的中间点:减少块数就加重聚集,增加块数就增加 I/O。样本在块上聚集时,基于样本内重复次数的估计(例如不同值个数)会受块内相关性影响,但偏差有多大取决于数据的物理布局,目前这一点只能按数据集分别评估。
固定样本大小还是严格 PPS
VarOpt 与优先抽样对大权重元素取 \(\min(1, w_i/\tau)\),样本大小固定为 \(k\),但包含概率不再与权重成比例。EB-PPS 论文举例:一个权重 4、若干权重 1 的数据集上,这类方法得到 \(\tau = 2/3\),权重 1 的元素被选中的概率是权重 4 的元素的 \(2/3\),而不是 \(1/4\)。作者认为这”can violate the PPS property to an arbitrary degree”,于是选择严格 PPS、让样本变小。反方的理由同样成立:只要 \(\pi_i\) 已知,Horvitz-Thompson 估计就无偏,VarOpt 在固定样本大小下方差最优,样本变小只会让方差变大。哪一方”对”取决于下游:做子集和估计时,已知的 \(\pi_i\) 就够了;把样本当训练集直接使用、希望样本分布本身就与权重成比例时,EB-PPS 的论证更有力。EB-PPS 论文用不平衡损失下的分类实验支持后一种场景。
分布式与加权的组合
第五节的通信最优结果针对的是均匀样本和”站点加协调者”的模型,而且上界证明在修订版里才改对。加权版本和完全分布式(没有中心协调者、按 mini-batch 处理)的模型研究得更少:Hübschle-Schneider 与 Sanders 在 SPAA 2020 发表了两页的 brief announcement,完整版为 arXiv 预印本 1910.11069,给出加权与均匀两种情形的通信高效算法,并在最多 256 个节点(5120 个处理器)上做了加权版本的实验。加权情形下是否存在与 Tirthapura-Woodruff 同样紧的上下界,就本文检索到的文献看还没有定论。
跳跃的前提与对手输入
第六节的实验说明,A-ExpJ 的 \(O(m\log(n/m))\) 依赖权重 i.i.d. 的假设,按时间递增的权重(例如按时间衰减加权时反过来给新数据更大的权重)会让插入次数线性增长。这不是 A-ExpJ 的缺陷:逐次抽样下新元素本来就频繁挤入样本,插入次数是由分布本身决定的,任何算法都要为每次插入付出代价。对这类输入,更合适的做法可能是换问题(例如用前向衰减把权重重新归一化),而不是换算法。
九、工程陷阱
| 陷阱 | 后果 | 做法 |
|---|---|---|
| 只验证每个元素的包含概率是 \(k/n\) | 系统抽样和 PostgreSQL 的块聚集样本都可能通过边缘检查,但不是所有 \(k\) 子集等概率 | 先确认下游是否需要子集均匀或二阶包含概率;测试时加入小规模联合分布卡方检验 |
| Algorithm R 把随机整数范围写成 \([0,i)\) | 第 \(i+1\) 条被接纳的概率变成 \(k/i\),后到元素被高估 | 对第 \(i\) 条记录使用
below(i + 1);用 \(n=6,k=3\)
这类小例子覆盖边界 |
| Algorithm L 把最后已见下标初始化为 \(k\) | 下标 \(k\) 的记录永远不会被选中,边缘检验直接拒绝 | 初始化为 \(k-1\),把”跳过 \(s\) 条后再接纳下一条”写成同一个下标约定 |
用 log(1 - W) 或允许随机数等于 0 |
\(W\)
很小时损失有效位,\(U=0\)
时出现 log(0) |
用 log1p(-W);随机数生成器返回开区间 \((0,1)\) |
| 把多个水塘按比例互相覆盖 | 样本会偏向被当作底座的分段;本文参数下 \(A\) 的包含频率约 0.039 而非 0.01 | 已知分段长度时用超几何合并;能保存键时用 bottom-\(k\) 合并 |
| 把 A-Res 说成”包含概率正比于权重” | A-Res 实现的是逐次加权无放回抽样,\(\pi_i\) 不等于 \(mw_i/W\) | 区分 WRS-N-W 与 PPS;需要已知包含概率做估计时选 Chao、priority、VarOpt 或 EB-PPS |
直接算 pow(u, 1.0 / w) 作为加权键 |
小权重下溢到 0、大权重舍入到 1,平局会让早到元素占优 | 存 log(u) / w
或指数竞赛时间,比较时保持单调等价即可 |
| 把 A-ExpJ 的 \(O(m\log(n/m))\) 当成任意输入保证 | 递增或几何递增权重会让插入次数接近线性 | 检查权重排列是否符合 i.i.d. 假设;对时间衰减权重先重写问题模型 |
| 窗口样本中过期就用新元素顶替 | 序列窗口会出现 Babcock 等人指出的周期性相关 | 对序列窗口用 chain-sample;对时间窗口用 priority-sample 或带最坏情况界的窗口算法 |
十、参考资料
规范与文档
- D. E. Knuth, The Art of Computer Programming, Volume 2: Seminumerical Algorithms, 3.4.2 “Random Sampling and Shuffling”(Algorithm S 与选择抽样背景)。
- PostgreSQL 17.4 文档与源码注释:
ANALYZE统计信息目标、acquire_sample_rows()的两阶段抽样说明。 - Apache Spark 3.5.3 API
与源码注释:
RangePartitioner的samplePointsPerPartitionHint与过采样说明。
源码
- PostgreSQL
REL_17_4,
src/backend/utils/misc/sampling.c:BlockSampler_Init()、BlockSampler_Next()、reservoir_init_selection_state()、reservoir_get_next_S()。 - PostgreSQL
REL_17_4,
src/backend/commands/analyze.c:acquire_sample_rows()、std_typanalyze();src/backend/utils/misc/guc_tables.c:default_statistics_target。 - Apache Spark
v3.5.3,
core/src/main/scala/org/apache/spark/util/random/SamplingUtils.scala:reservoirSampleAndCount()、computeFractionForSampleSize()。 - Apache Spark
v3.5.3,
core/src/main/scala/org/apache/spark/Partitioner.scala:RangePartitioner.sketch()、determineBounds()。 - Apache DataSketches C++
5.2.0,
sampling/include/var_opt_sketch.hpp与sampling/include/ebpps_sketch.hpp。
核心论文
- J. S. Vitter, “Random Sampling with a Reservoir”, ACM Transactions on Mathematical Software 11(1):37–57, 1985, doi:10.1145/3147.3165。
- K.-H. Li, “Reservoir-Sampling Algorithms of Time Complexity \(O(n(1+\log(N/n)))\)”, ACM Transactions on Mathematical Software 20(4):481–493, 1994, doi:10.1145/198429.198435。
- P. S. Efraimidis, P. G. Spirakis, “Weighted random sampling with a reservoir”, Information Processing Letters 97(5):181–185, 2006, doi:10.1016/j.ipl.2005.11.003。
- B. Babcock, M. Datar, R. Motwani, “Sampling from a Moving Window over Streaming Data”, SODA 2002, pp. 633–634。
- G. Cormode, S. Muthukrishnan, K. Yi, Q. Zhang, “Continuous Sampling from Distributed Streams”, PODS 2010, pp. 77–86;期刊版 JACM 59(2), 2012。
- S. Tirthapura, D. P. Woodruff, “Optimal Random Sampling from Distributed Streams Revisited”, DISC 2011, LNCS 6950, pp. 283–297;修订版 arXiv:1903.12065。
- W. Gemulla, W. Lehner, P. J. Haas, “A Dip in the Reservoir: Maintaining Sample Synopses of Evolving Datasets”, VLDB 2006, pp. 595–606。
其他论文
- S. Chaudhuri, R. Motwani, V. Narasayya, “Random Sampling for Histogram Construction: How much is enough?”, SIGMOD 1998, pp. 436–447。
- M.-T. Chao, “A general purpose unequal probability sampling plan”, Biometrika 69(3):653–656, 1982。
- P. S. Efraimidis, “Weighted Random Sampling over Data Streams”, arXiv:1012.0256v2, 2015(预印本)。
- N. Duffield, C. Lund, M. Thorup, “Priority Sampling for Estimation of Arbitrary Subset Sums”, JACM 54(6), 2007。
- E. Cohen, N. Duffield, H. Kaplan, C. Lund, M. Thorup, “Stream Sampling for Variance-Optimal Estimation of Subset Sums”, SODA 2009, pp. 1255–1264;期刊版 SIAM J. Comput. 40(5):1402–1431, 2011。
- M. Hentschel, P. J. Haas, Y. Tian, “Exact bounded-size probability proportional to size sampling”, Information Processing Letters 182:106382, 2023。
- V. Braverman, R. Ostrovsky, C. Zaniolo, “Optimal Sampling from Sliding Windows”, PODS 2009, pp. 147–156;期刊版 JCSS 78(1):260–272, 2012。
- W. Gemulla, W. Lehner, “Sampling Time-Based Sliding Windows in Bounded Space”, SIGMOD 2008。
- P. Hübschle-Schneider, P. Sanders, “Communication Efficient Algorithms for Top-k Selection Problems”, SPAA 2020 brief announcement, pp. 543–545;完整版 arXiv:1910.11069。
实验
reproduce/reservoir.c:Algorithm R/L/Z、合并、加权抽样、卡方检验、随机数计数与自检。reproduce/run.sh:编译、ASan/UBSan 自检、固定种子实验输出。reproduce/plot.py:从reproduce/results/生成本文的统计图与轨迹图。reproduce/results/*.txt、reproduce/results/*.tsv:正文表格与图中的原始数据。
系列导航: - 上一篇:t-digest:缩放函数、合并与尾部分位数误差 - 下一篇:MinHash 与 SimHash:近重复检测的相似度草图与候选生成
相关阅读: - HyperLogLog:从概率计数到 Redis 实现的基数估计 - 局部敏感哈希:从概率保证到多探针近邻检索 - t-digest:缩放函数、合并与尾部分位数误差
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
滑动窗口与流控的算法本质
滑动窗口不只是一道 LeetCode 题型,它是网络协议、流控、限流的通用模式。
数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
TimSort:自然 run、galloping 与从栈不变量到 Powersort 的合并策略
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
pdqsort:坏分区计数、重复键分区与块分区如何改造 introsort
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。