一个服务跑在 100 个实例上,要在看板上画全局 P99 延迟。每个实例保存全部样本再汇总排序,内存和网络都扛不住;于是需要一个几 KB 的摘要,能在实例上增量构建、在汇聚端合并,还要在 \(q=0.99\)、\(q=0.999\) 这些尾部分位上足够准。t-digest 是这类摘要里在工程上用得最多的一个。
围绕它流传着几种说法,每种都只对一半:
- “t-digest 有误差保证”。它的原始论文只给出了质心数的上界,没有给出分位数误差的上界;Cormode 等人在 KDD 2021 构造出让它误差接近 50% 甚至更大的输入。
- “合并不损失精度”。合并后的摘要只满足大小约束,质心之间会出现重叠,误差依赖合并顺序。
- “Prometheus 的 summary 就是 t-digest”。Prometheus Go 客户端的 summary 用的是 CKMS 有偏分位数算法,并且不能跨实例聚合。
本文先把问题和误差口径说清楚,再按论文拆解数据结构、构建与查询,然后用同目录
reproduce/ 下的 C
程序测量尾部误差、输入顺序和合并的影响,复现对抗输入,最后对照三个生产系统的源码。文中所有自测数字都来自
reproduce/(环境与命令见第六节),源码引用都钉了版本。
一、问题:分位数为什么难合并,尾部精度指什么
百分位数不能平均
设 \(n\) 个样本排序后为 \(x_{(1)} \le \cdots \le x_{(n)}\),本文把 \(q\) 分位数取为 \(x_{(\lceil qn \rceil)}\)。看一个两台实例的例子:
| 实例 | 样本 | 本地 P99 |
|---|---|---|
| A | 985 个 10 ms,15 个 200 ms,共 1000 个 | 第 990 个值,200 ms |
| B | 9 个 10 ms,1 个 5000 ms,共 10 个 | 第 10 个值,5000 ms |
| 合并 | 994 个 10 ms,15 个 200 ms,1 个 5000 ms,共 1010 个 | 第 \(\lceil 999.9 \rceil = 1000\) 个值,200 ms |
两个 P99 的平均是 2600 ms,取最大是 5000 ms,按请求数加权平均是 \((1000 \times 200 + 10 \times 5000)/1010 \approx 247.5\) ms,都不等于真实的 200 ms。低流量实例的一个慢请求就能把”平均 P99”拉偏一个数量级。分位数不是可加量,想跨实例聚合,汇聚端必须拿到能重建分布的东西:全部样本、直方图,或者可合并的摘要(mergeable summary)。
秩误差与值误差
记样本流为 \(\sigma\),元素 \(y\) 的秩(rank)\(R_\sigma(y)\) 是严格小于 \(y\) 的样本数。近似分位数算法通常用秩误差衡量:把 \(y\) 报告为 \(q\) 分位数时,误差是
\[ \left| q - \frac{R_\sigma(y)}{n} \right| . \]
按误差随 \(q\) 的变化,有三种常见保证:
- 一致(additive)秩误差:\(|\hat R(y) - R(y)| \le \varepsilon n\),所有 \(q\) 同样准。GK、KLL 属于这一类。\(\varepsilon = 0.001\) 时,报告的 P99.9 可能是真实的 P99.8,也可能是最大值。
- 相对秩误差(relative rank error):\(|\hat R(y) - R(y)| \le \varepsilon R(y)\),或者对称地按 \(\min(R, n-R)\) 缩放,越靠尾部越准。ReqSketch 给出这种保证;t-digest 的设计目标也是这种形状,但没有证明。
- 相对值误差(relative value error):报告值 \(\tilde x_q\) 满足 \(|\tilde x_q - x_q| \le \alpha\, x_q\)。DDSketch 与 HDR Histogram 属于这一类,它直接约束”延迟报告成多少毫秒”,与秩无关。
后两种都叫”相对误差”,含义完全不同:秩误差小不代表值误差小。重尾分布里,秩上差 0.01% 可能对应数值上差几倍(第六节有实测)。
下界从哪里来
Munro 与 Paterson(TCS 1980)证明,用 \(p\) 遍扫描精确求任意分位数需要 \(\Omega(n^{1/p})\) 空间,所以单遍流式算法只能给近似。近似版本也有下界:只保存输入元素的摘要,一致误差至少要存 \(\Omega(1/\varepsilon)\) 个元素,相对秩误差至少要存 \(\Omega(\frac{1}{\varepsilon}\log \varepsilon n)\) 个(Cormode 等人 KDD 2021 第 2.2 节的转述);对确定性、基于比较(comparison-based,只比较元素大小、不做算术)的算法,一致误差的下界提高到 \(\Omega(\frac{1}{\varepsilon}\log \varepsilon n)\)(Cormode & Veselý, PODS 2020),GK 的空间因此在这个模型里渐近最优。
t-digest 用 \(O(\delta)\) 空间,与 \(n\) 无关,看上去违反了这些下界。Cormode 等人(KDD 2021,第 4 节)指出其中并无矛盾:下界只约束基于比较的算法,而 t-digest 对样本求加权平均、在质心之间做线性插值,不在这个模型里。代价是它也拿不到任何最坏情形保证,第七节会看到这一点在什么输入上变成现实。
二、谱系:从 GK 到 t-digest,再到 ReqSketch
流式分位数的研究沿两条线展开:一条追求可证明的空间界,一条追求实际数据上的小误差。t-digest 属于后者,它的对手和批评者大多来自前者。
| 年份 | 工作 | 出处 | 误差口径 | 空间 |
|---|---|---|---|---|
| 1980 | Munro & Paterson | Theoretical Computer Science 12(3) | 精确选择,多遍 | \(p\) 遍需 \(\Omega(n^{1/p})\) |
| 2001 | GK(Greenwald & Khanna) | SIGMOD 2001 | 一致秩误差,确定性 | \(O(\frac{1}{\varepsilon}\log \varepsilon n)\) |
| 2004 | q-digest(Shrivastava 等) | SenSys 2004 | 一致秩误差,值域须为已知整数 | 与压缩参数成正比 |
| 2005 | CKMS 有偏分位数(Cormode, Korn, Muthukrishnan, Srivastava) | ICDE 2005 | 有偏 / 指定目标分位数 | — |
| 2013 | t-digest 开源实现 | GitHub tdunning/t-digest,2013-11 创建 |
经验上的尾部增强秩误差,无证明 | 最多约 \(\lceil\delta\rceil\) 个质心 |
| 2016 | KLL(Karnin, Lang, Liberty) | FOCS 2016 | 一致秩误差,随机化 | \(O(\frac{1}{\varepsilon}\log\log\frac{1}{\eta})\),\(\eta\) 为失败概率,并有匹配下界 |
| 2019 | Dunning & Ertl | arXiv:1902.04023(预印本,未经同行评审) | 同 2013 | 同 2013 |
| 2019 | DDSketch(Masson, Rim, Lee) | PVLDB 12(12) | 相对值误差 \(\alpha\) | 与值域的对数成正比 |
| 2021 | ReqSketch(Cormode, Karnin, Liberty, Thaler, Veselý) | PODS 2021;终版 JACM 70(5), 2023 | 相对秩误差,随机化,完全可合并 | \(O(\varepsilon^{-1}\log^{1.5}\varepsilon n)\) |
| 2021 | Cormode, Mishra, Ross, Veselý | KDD 2021 | 对 t-digest 构造高误差输入 | — |
几个分叉点值得单独说:
- GK 到 KLL:同样是一致秩误差,KLL 用随机化的”压缩器”层级去掉了对 \(n\) 的依赖,并证明这是随机化算法的最优界。Apache DataSketches 实现的是它的一个简化变体(Cormode 等人 KDD 2021 第 2.2 节)。
- q-digest 到 t-digest:Dunning 与 Ertl 在预印本第 1.1 节说明了动机:q-digest 需要预先知道值域并把值映射到整数,且误差与 \(q\) 无关。t-digest 把”桶”换成”均值 + 计数”的质心,允许质心覆盖的值区间互相重叠,再用缩放函数让靠近两端的质心变小。
- t-digest 的文献状态:代码 2013 年开源,详细论文是 2019 年的 arXiv 预印本;同一作者还有两篇配套预印本,分别证明加入数据不会破坏大小约束(arXiv:1903.09919)和给出质心数上界(arXiv:1903.09921)。经过同行评审的有 Dunning 在 Software Impacts 7(2021)上的软件论文,以及 Ross 在 Journal of Statistical Computation and Simulation 92(1)(2022,2021 年在线发表)上关于非对称缩放函数的论文。
- 两种”相对误差”:DDSketch 沿值误差走,用对数桶换来可证明的 \(\alpha\) 相对误差和逐桶相加的合并;ReqSketch 沿秩误差走,用 KLL 式的随机压缩器换来可证明的相对秩误差。t-digest 的目标形状接近后者,但既没有证明,也不是基于比较的算法。
三、数据结构:质心、k-size 与缩放函数
质心与 k-size
t-digest 把样本划分成若干簇,每个簇只保留均值和样本数,称为质心(centroid)\(C_i = (m_i, w_i)\),\(w_i\) 叫权重。质心按均值排序,总权重为 \(n\)。对第 \(i\) 个质心定义它左侧的累计权重 \(W_{\text{left}}(C_i) = \sum_{j<i} w_j\),于是它在分位数轴上占据区间
\[ q_{\text{left}} = \frac{W_{\text{left}}(C_i)}{n}, \qquad q_{\text{right}} = q_{\text{left}} + \frac{w_i}{n}. \]
缩放函数(scale function)\(k(q)\) 是一个单调不减的函数,把分位数映射到”刻度” \(k\)。t-digest 的全部约束就一句话:含多于一个样本的质心,在 \(k\) 轴上的长度不超过 1:
\[ |C_i|_k = k(q_{\text{right}}) - k(q_{\text{left}}) \le 1 . \]
单样本质心(singleton)不受这个限制,因为它的位置是精确的。如果任意相邻两个质心合起来都会违反约束,即 \(|C_i|_k + |C_{i+1}|_k > 1\),就称这个摘要是完全合并的(fully merged)。
\(k\) 在尾部越陡,同样 1 个单位的 \(k\) 长度对应的 \(q\) 区间就越窄,尾部质心就越小。质心在 \(q\) 附近能容纳的最大 \(q\) 宽度近似为 \(1/k'(q)\),乘以 \(n\) 就是最大权重。
四个缩放函数
预印本第 2.8 节给出四个缩放函数(\(\delta\) 为压缩参数):
\[ k_0(q) = \frac{\delta}{2} q, \qquad k_1(q) = \frac{\delta}{2\pi} \arcsin(2q - 1), \]
\[ k_2(q) = \frac{\delta}{Z_2(n)} \log\frac{q}{1-q}, \qquad k_3(q) = \frac{\delta}{Z_3(n)} \begin{cases} \log 2q & q \le 1/2 \\ -\log 2(1-q) & q > 1/2 \end{cases} \]
其中 \(Z_2(n) = 4\log(n/\delta)
+ 24\),\(Z_3(n) =
4\log(n/\delta) + 21\)。归一化项让 \(k_2\)、\(k_3\) 的质心数在 \(n\)
增长时基本保持有界;去掉归一化的版本质心数随 \(\log n\) 增长。Elasticsearch
8.15.0 的 libs/tdigest/.../ScaleFunction.java
里 K_2、K_3 的 Z()
与这两个常数一致。
对 \(q\) 求导,得到四者允许的最大质心宽度:
| 缩放函数 | \(k'(q)\) | 最大宽度 \(1/k'(q)\) 的形状 |
|---|---|---|
| \(k_0\) | \(\delta/2\) | 常数 \(2/\delta\),各处一样 |
| \(k_1\) | \(\dfrac{\delta}{2\pi\sqrt{q(1-q)}}\) | \(\propto \sqrt{q(1-q)}\) |
| \(k_2\) | \(\dfrac{\delta}{Z_2\, q(1-q)}\) | \(\propto q(1-q)\) |
| \(k_3\) | \(\dfrac{\delta}{Z_3 \min(q, 1-q)}\) | \(\propto \min(q, 1-q)\) |
代入 \(\delta = 100\)、\(n = 10^6\):\(k_1\) 在中位数处允许 \(\pi/\delta \approx 3.1\%\) 的宽度,约 31,400 个样本;在 \(q = 0.001\) 处降到约 \(2\pi\sqrt{0.000999}/\delta \approx 0.2\%\),约 1,990 个样本。\(k_2\) 在中位数处允许 \(Z_2/(4\delta) \approx 15.2\%\),在 \(q = 0.001\) 处只允许约 608 个样本。\(k_2\)、\(k_3\) 用中间段的精度换尾部精度,这一点在第六节的误差曲线里会直接看到。
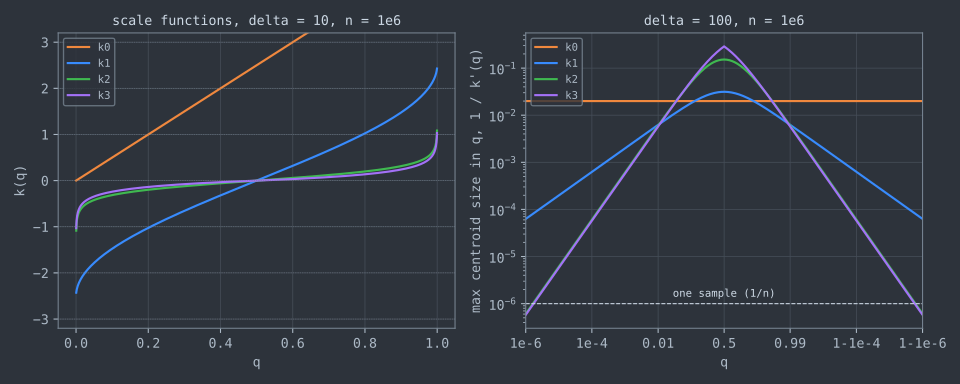
左图里水平虚线是整数刻度:相邻两条水平线之间就是一个质心最多能占的 \(k\) 长度,投影到横轴上,\(k_1\) 在两端的间隔明显变窄。右图的虚线是单个样本的宽度 \(1/n\),\(k_2\)、\(k_3\) 在 \(q\) 小于约 \(1.6 \times 10^{-6}\) 处的允许宽度低于它,意味着那里的质心只能是单样本。
质心数的上界
完全合并这个条件直接给出质心数上界。所有质心的 \(k\) 区间首尾相接,恰好铺满 \([k(0), k(1)]\),总长记为 \(K\)。把质心两两配对成 \((C_1, C_2), (C_3, C_4), \ldots\),共 \(\lfloor m/2 \rfloor\) 对,每对的 \(k\) 长度都大于 1,且互不重叠,所以
\[ \left\lfloor \frac{m}{2} \right\rfloor < K \quad\Longrightarrow\quad m \le 2\left\lfloor \frac{m}{2} \right\rfloor + 1 < 2K + 1 . \]
\(k_0\) 与 \(k_1\) 的 \(K\) 都是 \(\delta/2\),于是 \(m < \delta + 1\),即 \(m \le \lceil \delta \rceil\)。反过来,如果所有质心都含多个样本,每个的 \(k\) 长度不超过 1,就有 \(m \ge K = \delta/2\)。这就是预印本第 2.3 节”质心数至多 \(\lceil\delta\rceil\)、下界接近 \(\lfloor\delta/2\rfloor\)“的来历。\(k_2\)、\(k_3\) 在 \(q \to 0\) 时趋于 \(-\infty\),\(K\) 无界,上面的论证不直接适用;预印本给出的结论是,在归一化项 \(Z(n)\) 下,质心数在 \(10^{60}\) 个样本以内不超过 \(\lceil\delta\rceil\),之后大致按 \(\log\log n\) 增长。
实测(均匀分布、随机顺序、种子 1,最后做一次完全合并):
| \(\delta\) | \(k_0\) | \(k_1\) | \(k_2\) | \(k_3\) |
|---|---|---|---|---|
| 50 | 29 | 33 | 37 | 36 |
| 100 | 55 | 58 | 71 | 72 |
| 200 | 107 | 114 | 143 | 143 |
| 500 | 272 | 284 | 341 | 337 |
| 1000 | 552 | 564 | 663 | 661 |
\(n =
10^6\)。四个缩放函数的质心数都落在 \([\delta/2, \delta]\)
之内,\(k_0\)、\(k_1\) 贴近下界,\(k_2\)、\(k_3\)
多出来的主要是尾部被迫保持为单样本的质心(\(\delta = 100\) 时两端共 7
个单样本质心)。固定 \(\delta =
100\),\(n\) 从
\(10^4\) 增到 \(10^6\) 时,\(k_0\) 一直是 55 个,\(k_2\) 从 57 个增到 71
个。每个质心存两个 double 是 16 字节,\(\delta = 100\) 的 \(k_2\) 摘要约 1.1 KB。预印本第
3.2 节报告其精度实验的摘要有 50 到 60 个质心,均值用
double、计数用 4 字节整数时不到 800 字节;本文
\(k_0\)、\(k_1\) 落在这个范围,\(k_2\)、\(k_3\)
多出十几个,预印本部分实验还叠加了分层压缩(例如图 9
的直接构建用工作压缩 300、最终压缩
100),两者不能直接对比。
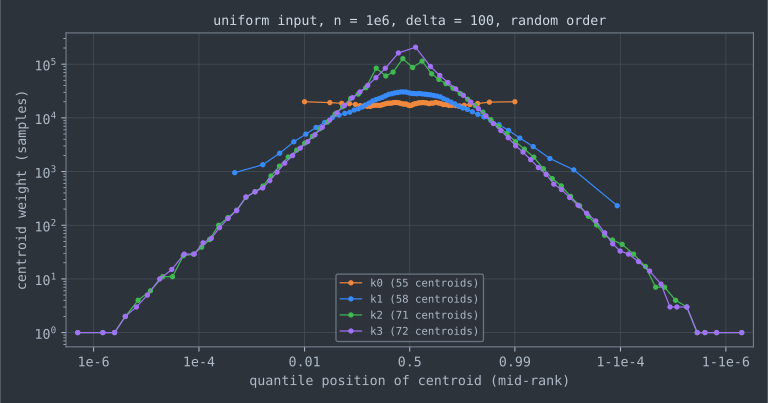
这张图是同一份输入在 \(\delta = 100\) 下的全部质心。\(k_0\) 的每个质心都约有 \(2n/\delta = 20{,}000\) 个样本(实测最大 19,989),包括最靠边的那个,这正是”常数绝对误差”的来源。\(k_1\) 的最边缘质心仍有几百到上千个样本。\(k_2\)、\(k_3\) 两端各有一串权重为 1 的质心,但中位数附近的质心分别达到 12.7 万和 20.7 万个样本,占全部数据的 12.7% 和 20.7%。\(k_1\) 的曲线左右不对称,是因为最后一次合并扫描的方向(见下一节的交替扫描)。
四、构建:合并扫描与聚类两种变体
预印本给出两种构建方式:先缓冲再批量合并的 merging 变体(Algorithm 1),以及每来一个点就找最近质心的 clustering 变体(Algorithm 2)。生产实现以前者为主。
一次合并扫描
merging 变体把新样本先写进缓冲区。缓冲区满(或需要查询)时,把旧质心和缓冲区里的点合在一起按均值排序,从左到右扫一遍:维护当前正在累积的质心 \(\sigma\) 和它的起点 \(q_0\),只要把下一个元素并进来之后的右端点不超过
\[ q_{\text{limit}} = k^{-1}\big(k(q_0) + 1\big), \]
就合并;否则输出 \(\sigma\),以下一个元素为起点开新质心。每输出一个质心才算一次
\(k\) 和 \(k^{-1}\),中间的合并只比较
\(q\),所以一次扫描调用缩放函数的次数等于输出的质心数。下面是
reproduce/tdigest.c 里的实现:
static size_t merge_pass(int scale, double delta, const centroid_t *x, size_t n,
                         double S, int reverse, centroid_t *out)
{
    ptrdiff_t i = reverse ? (ptrdiff_t)n - 1 : 0, step = reverse ? -1 : 1;
    centroid_t sigma = x[i];
    double w0 = 0; /* weight already emitted; q0 = w0 / S */
    double qlimit = td_kinv(scale, td_k(scale, 0, delta, S) + 1, delta, S);
    size_t m = 0;

    for (size_t j = 1; j < n; j++) {
        i += step;
        double q = (w0 + sigma.weight + x[i].weight) / S;
        if (q <= qlimit) {
            sigma.weight += x[i].weight;
            sigma.mean += (x[i].mean - sigma.mean) * x[i].weight / sigma.weight;
        } else {
            out[m++] = sigma;
            w0 += sigma.weight;
            qlimit = td_kinv(scale, td_k(scale, w0 / S, delta, S) + 1, delta, S);
            sigma = x[i];
        }
    }
    out[m++] = sigma;
    /* 删减:reverse 时把 out 翻转回升序 */
    return m;
}
两个细节来自调试。第一,累计量用权重 \(w_0\) 而不是分位数 \(q_0\) 保存,每次用 \(w_0/S\) 现算:最早的版本按
\(q_0 \mathrel{+}= w/S\)
累加,末尾的 \(q\)
因舍入略大于 1,而 \(q_{\text{limit}}\) 被截断到
1,最后一个点被错误地留成单独质心,测试里的”完全合并”断言因此失败。Elasticsearch
的 MergingDigest 同样用累计权重
wSoFar。第二,\(k_2\)、\(k_3\) 在 \(q_0 = 0\) 时 \(k = -\infty\),\(q_{\text{limit}} =
0\),第一个元素永远不会被合并,两端自然是单样本质心。
均值更新写成 \(m \mathrel{+}= (x - m)\,w_x / (w_\sigma + w_x)\),不先求和再相除,这样在第七节那种数值跨越 \(10^{\pm 302}\) 的输入上也不会溢出。
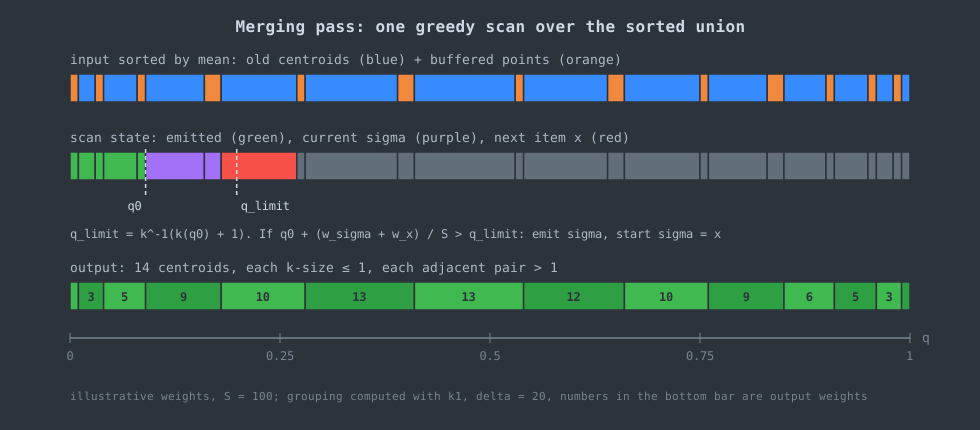
图中的权重是为演示挑的(总权重 100),分组结果由
reproduce/draw_merge_pass.py 按同一规则、用
\(k_1\) 与 \(\delta = 20\)
算出。中间一行显示了一次”拒绝”:\(\sigma\) 起点 \(q_0 = 0.09\),\(q_{\text{limit}} \approx
0.199\),红色元素并入后右端到
0.27,超过上限,于是输出 \(\sigma\)。输出的 14
个质心权重依次为 1, 3, 5, 9, 10, 13, 13, 12, 10, 9, 6, 5, 3,
1。
缓冲区、交替方向与两级压缩
预印本第 2.6 节讨论了三个工程参数:
- 缓冲区大小:每个样本的均摊代价约为 \(C_1 \log c_1 + C_2 \lceil\delta\rceil / c_1\),\(c_1\) 是缓冲区容量,前一项是排序,后一项是缩放函数调用。作者的微基准里把缓冲区加到 \(10\lceil\delta\rceil\) 能明显提速,再大收益很小。本文实现用 \(10\lceil\delta\rceil\)。
- 交替扫描方向:总是从左往右扫,靠近 \(q = 0\) 的质心会不对称地长大并漂移,质心之间的重叠变多。作者建议奇偶次交替方向。四个缩放函数对区间和它的镜像给出相同的 \(k\) 长度,所以反向扫描时规则不变,本文实现默认交替。
- 分层压缩(stratified merge):构建时用更大的工作压缩参数,存储或查询前再用目标 \(\delta\) 做一次最终合并。作者的例子是工作时用 \(3\delta\),代价是合并次数多约 20%,换来质心重叠减少、误差显著下降。第 3.1 节的图 7 用工作压缩 316、最终压缩 100 并交替方向,重叠只出现在相邻质心之间;单向扫描且全程 \(\delta = 100\) 时,重叠常延伸到相邻的 3 到 4 个质心。
Elasticsearch 8.15.0 的
libs/tdigest/src/main/java/org/elasticsearch/tdigest/MergingDigest.java(文件头注明基于
tdunning/t-digest
修改)把这三点都做成了默认值:useAlternatingSort = true;useTwoLevelCompression = true
时内部压缩参数是 \(\sqrt{\text{scale}} \times\)
用户参数,其中
scale = max(1, bufferSize / size - 1),默认缓冲区是主数组的
5 倍,所以内部用的是用户 compression 的 2
倍,查询前再压回用户值。useWeightLimit = true
时不调用 \(k^{-1}\),改用
scale.max(q, normalizer)
直接估计每个位置的最大权重,对应预印本第 2.6 节”直接从 \(q\)
估计最大样本数”的优化。合并循环里还有一条强制规则(删减自
merge()):
if (i == 1 || i == incomingCount - 1) {
    // force last centroid to never merge
    addThis = false;
}
即排序后的第一个和最后一个元素永远单独成质心,首尾质心始终是单样本。
clustering 变体
预印本的 Algorithm 2
每来一个点,就在均值距离最近的质心里挑一个加入后仍满足 \(k\)
长度约束的,找不到就新建质心;质心数超过 \(K\delta\)(\(K\) 通常取 3 到 10)时用
Algorithm 1
整体压缩一次。它的弱点是输入有序时每个新点都是新的最大值,必然新建质心,只能靠周期性压缩兜底。Elasticsearch
8.15.0 在 execution_hint: high_accuracy
时使用的 AVLTreeDigest 就是这一类:质心存在 AVL
树(AVLGroupTree)里,插入时从
floor(x) 开始向两侧找最近的质心。Cormode
等人(KDD 2021)在对抗输入上同时测了两种变体:clustering
变体的精度更好,作者原话是”更好,但仍不够”(better, though
admittedly still inadequate);merging
变体更新更快、没有动态分配,因此更常用。他们测得 ReqSketch
的均摊更新比 merging 变体快两倍多,比 clustering 变体快约
4.5 倍。
五、查询:从质心重建分布
完全合并的摘要只剩质心,查询时必须对样本在质心之间怎么分布做假设。预印本第 2.9 节给出的假设有两条:多样本质心的样本一半在均值左边、一半在右边;相邻两个质心之间的样本在值域上均匀分布。由此分四种情形:
- 两个相邻的多样本质心之间:分到这一段的权重是 \((w_i + w_{i+1})/2\),累积分布函数在两个均值之间线性上升。
- 多样本质心与单样本质心之间:只有多样本一侧贡献 \(w_i/2\),单样本质心本身是位于均值处的点质量。
- 两个单样本质心之间:没有权重,累积分布函数保持水平,在下一个样本处跳一步。
- 首尾质心:
min和max本身各是一个真实样本,作为点质量;多样本首质心的左半边减去这 1 个样本后,在 \([\min, \bar{x}_1]\) 上均匀分布,尾质心对称处理。预印本还提到含 2 个样本的端点质心可以精确还原成两个样本,本文实现没有做这一步。
reproduce/tdigest.c 里的
build_pieces()
把上面的规则变成一串”片段”:每个片段要么是一个点质量,要么是一段区间上的均匀质量。td_cdf()
对片段累加,在点质量处取一半(中秩);td_quantile()
按累积权重找到目标片段,在区间内线性插值。
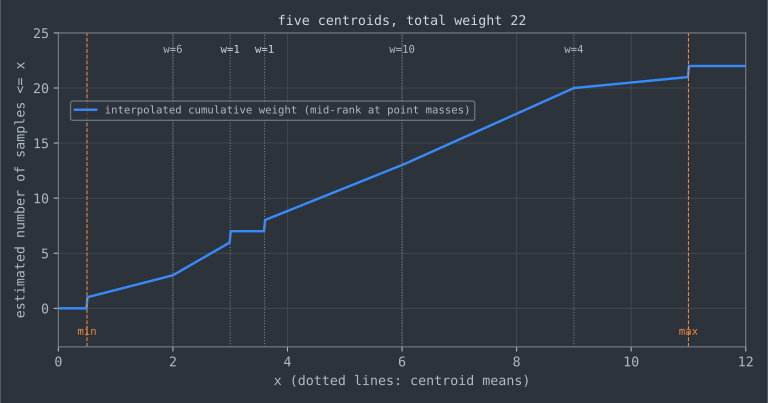
图中五个质心是 \((2, 6), (3, 1), (3.6, 1), (6, 10), (9, 4)\),\(\min = 0.5\),\(\max = 11\),总权重 22。按上面的规则切出来的片段是:
| 片段 | 类型 | 权重 | 来源 |
|---|---|---|---|
| \(x = 0.5\) | 点质量 | 1 | min |
| \([0.5, 2]\) | 均匀 | 2 | 首质心左半边 3,减去 min |
| \([2, 3]\) | 均匀 | 3 | 首质心右半边 |
| \(x = 3\) | 点质量 | 1 | 单样本质心 |
| \(x = 3.6\) | 点质量 | 1 | 单样本质心,与前一个之间没有权重 |
| \([3.6, 6]\) | 均匀 | 5 | \((6, 10)\) 的左半边 |
| \([6, 9]\) | 均匀 | 7 | \(5 + 4/2\) |
| \([9, 11]\) | 均匀 | 1 | 尾质心右半边 2,减去 max |
| \(x = 11\) | 点质量 | 1 | max |
./tdexp interp 输出的累积权重在 \(x = 0.5, 2, 3, 3.6, 6, 9, 11\)
处依次是
0.5、3、6.5、7.5、13、20、21.5,与表中逐段累加(点质量处取一半)一致。
这套插值是在值域上线性的,精度因此依赖数据形状。均匀分布恰好满足”质心之间均匀”的假设,所以均匀数据上的测试会显得格外好;对数正态这类在对数尺度上才接近均匀的数据,同样的秩误差会换来更大的值误差,第六节会看到这一点。第七节的对抗输入则把这条假设推到极端:一个质心的均值被相距几百个数量级的样本平均出来,“质心之间均匀”已经毫无意义。
六、实验:尾部误差、输入顺序与合并
实验设置
所有数字来自 reproduce/ 下的 C
实现(tdigest.c 276 行,实验驱动
tdexp.c 479 行)。环境:Intel Core
i9-12900K,WSL2(Linux 6.6.87.2),gcc
16.1.1(-O2),glibc 2.43;绘图用 matplotlib
3.11.2 与 numpy
2.5.3。实验只报告误差与质心数,不报告耗时。
cd reproduce
sh run.sh 3                      # 编译、跑自检,再把各实验绑到 CPU 3 上运行,结果写入 results/
python plot.py                   # 由 results/ 生成本文的 matplotlib 图
python3 draw_merge_pass.py       # 生成合并扫描示意图
随机数用 xoshiro256**,由 splitmix64
从固定种子展开,所以重跑的结果逐字节相同;results/
里是本文使用的原始输出。./tdexp test
会先检查小输入(不超过 \(\delta\)
时结果精确)、每个非单样本质心的 \(k\) 长度不超过
1、摘要完全合并、\(k_0\)/\(k_1\) 的质心数不超过 \(\lceil\delta\rceil\)、cdf
单调、常数输入等不变量。
误差统一用秩误差:对查询结果 \(y = \hat{Q}(q)\),计算 \(|q - R(y)/n|\),\(R\) 用中秩处理重复值,单位是 ppm(\(10^{-6}\))。每组配置跑 5 个种子取中位数,\(n = 10^6\),\(\delta = 100\),缓冲区 \(10\delta\),交替扫描方向。三种分布:\([0,1)\) 均匀、率为 1 的指数分布、\(\exp(3 + \mathcal{N}(0, 1))\) 对数正态(中位数约 20,模仿延迟数据)。
秩误差随分位数的变化
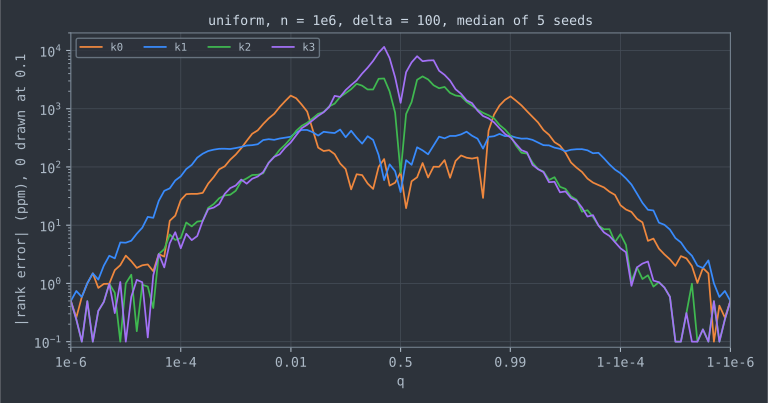
均匀分布、随机顺序时部分分位点的数值:
| 缩放函数 | \(10^{-4}\) | \(10^{-3}\) | 0.01 | 0.1 | 0.5 | 0.99 | 0.999 | 0.9999 | 质心数 |
|---|---|---|---|---|---|---|---|---|---|
| \(k_0\) | 27 | 163 | 1670 | 69 | 81 | 1610 | 175 | 22 | 56 |
| \(k_1\) | 69 | 211 | 328 | 341 | 37 | 325 | 186 | 78 | 58 |
| \(k_2\) | 6 | 38 | 324 | 1960 | 79 | 342 | 41 | 7 | 71 |
| \(k_3\) | 4 | 47 | 257 | 2270 | 1260 | 317 | 40 | 4 | 70 |
三点观察:
- \(k_2\)、\(k_3\) 在 \(q = 10^{-3}\) 与 \(0.999\) 处约 40 ppm,在 \(10^{-4}\) 与 \(0.9999\) 处个位数 ppm。预印本图 6 用同样的设置(\(\delta = 100\)、\(10^6\) 个均匀样本)画出了同样的趋势:绝对误差随 \(q\) 走向极端而下降。代价在中间:\(q = 0.1\) 处约 2000 ppm,比 \(k_1\) 差 6 倍。
- \(k_0\) 在 0.01 和 0.99 附近有约 1600 ppm 的峰,这两个位置正是首尾质心(各约 2% 的数据)的均值所在。升序输入时这两处降到 65 和 32 ppm,所以峰和随机顺序下首尾质心与邻居的重叠有关,本文没有进一步定位。
- \(q = 0.5\) 处 \(k_2\) 只有 79 ppm,\(k_3\) 却有 1260 ppm,但换成指数分布,\(k_3\) 在中位数的误差升到 13,800 ppm(1.38%)。均匀数据让”质心之间均匀”的假设恰好成立,大质心内部的插值误差被掩盖了。
值误差:对数正态分布
对延迟类数据,用户更关心”P99 报的 ms 数偏了多少”。下表是对数正态数据上 P99、P99.9 的相对值误差 \(|\hat{Q}(q) - Q(q)| / Q(q)\):
| 缩放函数 | P99(随机顺序) | P99.9(随机顺序) | P99(升序输入) | P99.9(升序输入) |
|---|---|---|---|---|
| \(k_0\) | 18.1% | 437% | 25.8% | 417% |
| \(k_1\) | 1.33% | 6.6% | 1.05% | 19.3% |
| \(k_2\) | 0.281% | 0.123% | 1.13% | 1.35% |
| \(k_3\) | 0.488% | 0.0513% | 1.39% | 0.79% |
\(k_0\) 在 P99.9 上报出的值是真值的 5 倍多:最右的质心装了 2% 的数据,而对数正态的尾巴在这 2% 里跨越了很大的值域,线性插值完全失真。这说明缩放函数的选择对重尾数据不是微调:质心数相近(55 与 72 个)时,\(k_2\) 的 P99.9 误差是 \(k_0\) 的约 \(1/3500\)。
输入顺序
同一份数据升序输入时,均匀分布上所有缩放函数的秩误差都显著下降(\(k_2\) 在 \(q = 0.1\) 从 1960 ppm 降到 47 ppm),质心数也变为 65 到 76 个。原因是升序输入下每次合并时新样本都在旧质心的右侧,质心之间几乎不重叠,得到的是强有序的摘要。但这不是普遍规律:对数正态数据升序输入时,\(k_2\) 在 \(q = 0.9\) 的秩误差从 930 ppm 升到 1370 ppm,P99 值误差从 0.281% 升到 1.13%,P99.9 从 0.123% 升到 1.35%。顺序会改变结果,而且没有一个方向总是更好。
合并多个摘要
分布式场景里,每个分片各建一个摘要,再在协调节点上合并。实验把 \(10^6\) 个对数正态样本切成 100 份,每份 1 万个样本,比较四种做法(5 个种子取中位数,单位 ppm):
- direct:不切分,整份数据直接建一个 \(\delta = 100\) 的摘要,作为基准。
- one-shot(100→100):每份建 \(\delta = 100\) 的摘要,把 100 份的质心一次性放进缓冲区(缓冲区设为 \(1000\delta\),装得下),最后只做一次 \(\delta = 100\) 的合并。
- one-shot(200→100):同上,但子摘要用 \(\delta = 200\),即预印本图 9 的”分层合并”。
- incremental(100→100):缓冲区保持 \(10\delta\),逐个并入子摘要,缓冲区满就压缩,相当于一边合并一边压缩。
| 缩放函数 | 做法 | \(10^{-4}\) | \(10^{-3}\) | 0.01 | 0.5 | 0.99 | 0.999 | 0.9999 | 质心数 |
|---|---|---|---|---|---|---|---|---|---|
| \(k_1\) | direct | 86 | 27 | 110 | 545 | 391 | 295 | 38 | 57 |
| \(k_1\) | one-shot(100→100) | 90 | 52 | 89 | 608 | 844 | 285 | 21 | 51 |
| \(k_1\) | one-shot(200→100) | 91 | 203 | 246 | 442 | 840 | 411 | 92 | 51 |
| \(k_1\) | incremental | 88 | 45 | 102 | 800 | 732 | 271 | 96 | 52 |
| \(k_2\) | direct | 2 | 7 | 163 | 4030 | 110 | 1 | 1 | 72 |
| \(k_2\) | one-shot(100→100) | 4 | 10 | 77 | 10000 | 601 | 47 | 1 | 49 |
| \(k_2\) | one-shot(200→100) | 4 | 26 | 89 | 8090 | 691 | 51 | 1 | 49 |
| \(k_2\) | incremental | 2 | 22 | 400 | 9080 | 316 | 6 | 2 | 56 |
合并后的摘要在中位数和 P99 附近明显变差:\(k_2\) 的中位数误差从 0.4% 升到 0.8% 到 1%,P99 从 110 ppm 升到 300 到 700 ppm;\(k_2\) 的极端尾部(\(10^{-4}\)、0.9999)几乎不受影响,那里的质心本来就是单样本或很小的质心。合并后质心数少于直接构建(\(k_2\) 49 到 56 个对 72 个);一个解释是子摘要的质心已经是”大块”,合并时只能整块并入、不能拆开,贪心打包后每个质心的 \(k\) 长度留有空余。
这组结果和预印本图 9 不一致。预印本的结论是分层合并(子摘要 200、结果 100)与直接构建相当,而”平坦合并”(全程 100)比直接构建差;本文的 one-shot(200→100) 在 \(k_1\) 上反而比 one-shot(100→100) 差,在 \(k_2\) 上只在中位数略好。可能的差别有两处:预印本的直接构建本身也用了 300 → 100 的分层压缩,本文的 direct 没有;预印本用的是均匀数据、20 次重复,本文是对数正态、5 个种子。本文没有在相同设置下重做图 9,所以只能说:在这个实现和这份数据上,没有观察到分层合并的收益。
合并的另一个性质是顺序相关。把 incremental 的并入顺序从第 0 份到第 99 份改成倒序,在 999 个等距分位点上比较两个摘要的答案,最大秩差(5 个种子的中位数)是 \(k_1\) 785 ppm、\(k_2\) 3280 ppm。t-digest 的合并满足”并入后仍是合法摘要”,但不满足结合律,结果依赖合并树的形状;Agarwal 等人(PODS 2012)定义的可合并性要求合并后的误差界与一次性构建相同,t-digest 没有这样的证明。
七、争论:没有最坏情形保证意味着什么
前面的实验都在”正常”数据上。t-digest 的精度论证全部是经验性的:预印本第 2.5 节承认合并后的摘要只是弱有序,“难以计算严格的误差界”;第 3.3 节观察到误差在 \(\delta\) 小时按 \(1/\delta^2\)、大时按 \(1/\sqrt{\delta}\) 缩放,但写明”严格的解释仍然没有”。Cormode、Mishra、Ross、Veselý 的 KDD 2021 论文 Theory meets Practice at the Median 正面检验了这一点。
嵌套的偏心质心
攻击的核心观察(论文第 4 节)是:一个质心 \((c_1, w_1)\) 的样本如果高度偏心,例如一个样本很小、其余 \(w_1 - 1\) 个样本相等且略大于 \(c_1\),那么对落在 \((c_1, x_2)\) 内的查询点,真实秩只算上了 \(x_1\) 一个样本,t-digest 的估计却把这个质心的大部分权重算了进去,秩被高估至少 \(w_1 - 1\)。接着在这个区间里插入第二批同样偏心的样本,让它们形成新质心 \((c_2, w_2)\),最坏情况下误差叠加到约 \(w_1 + w_2\);如此嵌套下去,同时往被攻击的质心里补 \(v_i\) 个样本把它”填满”,使后续样本不会被并进去。设未被攻击的权重可以忽略,渐近误差为
\[ \gamma = \frac{\sum_i w_i}{\sum_i (w_i + v_i)} . \]
论文算出:\(k_0\)
的渐近误差是 \((\delta -
2)/(\delta - 1)\);\(k_3\) 的下界随 \(\delta\) 增大趋于 1;\(k_2\) 的下界趋于
0.5。关键结论是渐近误差不能靠加大 \(\delta\) 消除,对 \(k_0\)、\(k_3\) 反而随 \(\delta\)
增大。每一轮可用的区间按指数收缩,double
精度几轮就用完,所以实际攻击选在 0
附近进行;攻击者需要知道摘要参数、能查询 0
附近的质心,并记住已经输入的流。论文图 2 用 \(k_0\)、\(\delta = 500\) 对 merging 和
clustering 两种实现都做出了大误差。
这和第一节提到的下界不矛盾。比较模型的下界只约束”只能比较、不能对样本做运算”的算法,t-digest 求加权平均,不在这个模型里。论文的论证是:如果把”均值”换成”从质心里随机取一个样本作代表”,得到的采样变体就受下界约束,不可能用 \(O(\delta)\) 空间保证精度;而这个变体和 t-digest 相差不大,暗示 t-digest 也有弱点。
不需要自适应的困难分布
更有说服力的是论文第 5.2 节的独立同分布输入:
\[ D_{\text{hard}} \sim (-1)^b \cdot 10^{(2R^2 - 1) E_{\max}}, \]
\(b\)
是均匀随机比特,\(R\) 在
\([0, 1]\) 上均匀,\(E_{\max}\) 取到 \(\log_{10}(M/N)\)(\(M\) 是 double
最大值),保证求均值不溢出。\(N =
2^{20}\) 时 \(E_{\max} =
302\),样本的绝对值横跨 \(10^{-302}\) 到 \(10^{302}\),且 \(R^2\) 让大部分样本集中在 0
附近极小的值上。论文用 Dunning 的 Java 实现、非对称 \(k_2\)、\(\delta = 500\),merging 变体在
\(q = 0.8\) 处的误差接近
\(-30\%\),而直接返回最大值也只有
\(+20\%\) 的误差。图 5 按
\(E_{\max}\)
扫描平均相对误差:\(E_{\max} \le
10\) 时 t-digest 明显优于 ReqSketch;在这个指标上
clustering 变体远好于 merging 变体。
本文用自己的实现(对称缩放函数、交替扫描)复现了这组输入:\(N = 2^{20}\),\(\delta = 500\),\(q\) 取 0.01 到 0.99 共 99 个点,报告最大绝对秩误差(百分点,3 个种子的中位数):
| \(E_{\max}\) | \(k_0\) | \(k_1\) | \(k_2\) | \(k_3\) |
|---|---|---|---|---|
| 1 | 0.05 | 0.09 | 2.05 | 3.05 |
| 10 | 0.07 | 0.09 | 2.05 | 2.05 |
| 50 | 0.44 | 0.42 | 6.04 | 13.47 |
| 150 | 3.18 | 3.96 | 30.01 | 35.49 |
| 302 | 9.19 | 12.60 | 39.47 | 40.67 |
| 302,升序输入 | 0.47 | 0.43 | 2.74 | 5.02 |
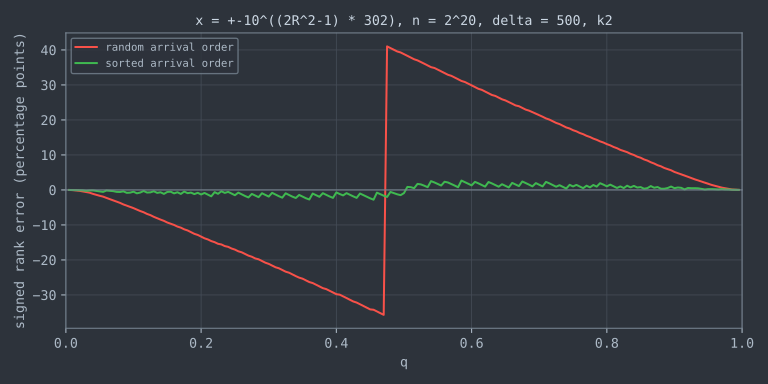
与论文一致的是:\(E_{\max} \le 10\) 时误差很小,\(E_{\max} = 302\) 时 \(k_2\)、\(k_3\) 的最大误差约 40 个百分点。带符号的对数均匀分布(指数里的 \(R\) 不平方)在 \(E_{\max} = 302\) 时 \(k_2\) 为 35.11,与论文”结果类似、t-digest 略好”的描述一致。不一致的是符号:本文在 \(q = 0.8\) 的带符号误差是 \(+13.26\) 个百分点,论文是约 \(-30\%\)。论文脚注 7 说明了它的 merging 变体误差位置为什么发生偏移:非对称缩放函数不支持交替扫描方向,每次都从左往右扫;本文的实现是对称 \(k_2\) 加交替方向,误差曲线因此是图中这种以中位数为界的反对称形状。
\(E_{\max} = 1\) 时 \(k_2\) 也有 2.05 个百分点,这不是攻击的效果。\(D_{\text{hard}}\) 在 \((-10^{-E_{\max}}, 10^{-E_{\max}})\) 内没有样本,中位数两侧有一个空洞;\(\delta = 500\)、\(n = 2^{20}\) 时 \(Z_2 = 4\ln(n/\delta) + 24 \approx 54.6\),中位数处一个质心最多约占 \(Z_2/(4\delta) \approx 2.7\%\) 的数据,跨过空洞的质心会把一部分权重插值到空洞里,而真实秩在空洞中保持 0.5 不变。
机制可以直接在摘要里看到。随机顺序、\(E_{\max} = 302\) 的 \(k_2\) 摘要中,累积权重约 0.45 处的质心均值约为 \(-1.6 \times 10^{60}\),这个值在真实数据中的秩只有 0.11。原因是 \(|x| < 10^{-100}\) 等价于 \(R^2 < (1 - 100/302)/2\),即 \(R < 0.578\),所以 58% 的样本绝对值小于 \(10^{-100}\);一个质心只要混进一个绝对值极大的负样本,均值就由它决定,除以权重只会少几个数量级,成千上万个极小样本对均值毫无贡献。升序输入时每个质心覆盖一段连续的排序区间,秩误差由质心权重限制住,所以只有 2.74 个百分点。论文对 clustering 变体的描述是”质心被极小值平均后拉向 0”,这是同一现象从大值一侧看。
双方的立场
这场争论没有简单的胜负,论文作者自己也这么说。他们在结论里声明立场并不中立:Cormode 与 Veselý 是 ReqSketch 论文的合著者,另两位作者在 Splunk 部署并分析过 t-digest。他们的主要结论是,t-digest 在值域上高度不均匀的输入上可能达不到期望精度,但”这些输入远不像自然数据,不应该给已经部署它的团队造成太大困扰”;ReqSketch 实测也很快、精度稳定,但在”预期内”的分布(小 \(E_{\max}\) 的 \(D_{\text{hard}}\))上明显不如 t-digest。建议是两类算法都考虑,按最坏情形与平均情形的取舍来选。
t-digest 一方的立场体现在预印本里:它没有给出误差上界,并明说弱有序使严格误差界难以计算,给出的是 \(k\) 长度不变量、质心数上界和大量实测;Dunning 的另两篇预印本证明了”加入数据不会破坏大小约束”(arXiv:1903.09919)和质心数的界(arXiv:1903.09921),但这些都是空间性质,不是精度性质。
从本文的实验看,需要记住两点。第一,受影响最大的恰恰是为尾部设计的 \(k_2\)、\(k_3\)。一个可能的原因是它们中间的质心最大,一个质心混进不同数量级样本的机会也最多。第二,这类失败和输入顺序强相关:同一份数据升序输入时误差从约 40 个百分点降到 3 到 5 个百分点。
开放问题
- 弱有序摘要的误差界:即使对随机顺序的独立同分布输入,merging 变体合并后的误差也没有已知的上界;预印本观察到的 \(1/\delta^2\) 与 \(1/\sqrt{\delta}\) 两段缩放律没有理论解释。
- 合并的误差:第六节的实验显示合并结果依赖顺序、比直接构建差,但没有一个界说明合并树多深、多宽时误差会变差多少。可合并性意义上的保证(Agarwal 等人,PODS 2012)目前属于 Agarwal 等人自己构造的随机化分位数摘要、KLL、ReqSketch、DDSketch 这类有证明的结构。
- 相对误差的空间下界:Cormode 等人(KDD 2021)第 2.2 节引述,任何保证相对秩误差 \(\varepsilon\) 的算法至少需要 \(\Omega(\varepsilon^{-1}\log(\varepsilon n))\) 空间;ReqSketch 做到了以常数概率 \(O(\varepsilon^{-1}\log^{1.5}(\varepsilon n))\),两者之间还差 \(\sqrt{\log(\varepsilon n)}\) 因子。t-digest 的 \(O(\delta)\) 空间之所以”低于”比较模型下界,是因为它求平均、不受比较模型约束,代价就是上面的对抗输入。
- 对数值变换的敏感性:t-digest 的插值假设在值域上是线性的,对数据做单调变换(例如取对数)会改变质心的组成和查询结果。第六节的对数正态实验与本节的 \(D_{\text{hard}}\) 都说明了这一点。Ross(JSCS,2022)的非对称缩放函数是从缩放函数一侧改进尾部精度,而不是变换数据;怎样的变换能让摘要在跨数量级数据上更稳健,还没有理论结论。
八、生产实现:钉住版本看源码
生产系统里叫 t-digest
的东西,参数和变体各不相同。本节只写源码里能看到的事实,版本分别是
Elasticsearch v8.15.0、ClickHouse v24.8.4.13-lts、Prometheus
client_golang v1.20.5。
Elasticsearch 8.15
percentiles 聚合默认用 t-digest,也可以切到
HDR Histogram:
{
  "size": 0,
  "aggs": {
    "latency_pct": {
      "percentiles": {
        "field": "latency_ms",
        "percents": [50, 99, 99.9],
        "tdigest": { "compression": 200, "execution_hint": "high_accuracy" }
      }
    }
  }
}
对应的源码事实:
server/.../percentiles/PercentilesConfig.java:TDigest.DEFAULT_COMPRESSION = 100.0,Hdr.DEFAULT_NUMBER_SIG_FIGS = 3;PercentilesMethod.java解析的字段是compression、execution_hint(t-digest)和number_of_significant_value_digits(HDR)。TDigestExecutionHint.java:取值default与high_accuracy,集群级默认值由search.aggs.tdigest_execution_hint设置。TDigestState.java:default对应HYBRID类型,high_accuracy对应AVL_TREE,即第四节的 clustering 变体。libs/tdigest/.../HybridDigest.java:先用精确的SortingDigest保存原始样本,样本数达到round(compression) * 20(默认 2000)时才转成MergingDigest。小分片上的分位数因此是精确的。libs/tdigest/.../TDigest.java:缩放函数默认ScaleFunction.K_2;MergingDigest的交替方向、两级压缩与首尾强制单样本见第四节。MergingDigest还把小于 10 的compression强制提高到 10。
所以 ES 默认的 compression: 100 在内部以 200
构建、查询前压回 100,缩放函数是 \(k_2\);第六节 \(k_2\)
那一行的误差形状(尾部极准、中间 0.1
分位附近最差)大体适用。
ClickHouse 24.8
src/AggregateFunctions/QuantileTDigest.h
的实现和 Java
版差别很大。文件头注释说它按”原始论文的条件”决定合并,即直接限制每个质心的大小,而不是用缩放函数在
\(k\)
空间里量长度,并写明”摘要大小按 \(O(\log n)\) 增长,而 Java
版与点数无关”。核心的合并判断(删减自
compress()):
BetterFloat ql = (sum + l_count * 0.5) / count;
BetterFloat err = ql * (1 - ql);
BetterFloat qr = (sum + l_count + r->count * 0.5) / count;
BetterFloat err2 = qr * (1 - qr);
err = std::min(err, err2);
BetterFloat k = count_epsilon_4 * err;   // count * epsilon * 4
if (l_count + r->count <= k && canBeMerged(l_mean, r->mean))
{
    l_count += r->count;
    ...
}
即相邻两个质心合并后的权重不超过 \(4 \varepsilon N \min\big(q_l(1 -
q_l),\, q_r(1 - q_r)\big)\)。允许宽度正比于 \(q(1-q)\),与 \(k_2\)
的最大宽度形状相同,但没有 \(\log\) 归一化项。默认参数
epsilon = 0.01、max_centroids = 2048、max_unmerged = 2048;质心的均值和计数都是
Float32,排序用
RadixSort;compressBrute()
在浮点误差导致质心数超限时强制截断。Float32
只能精确表示不超过 \(2^{24}\)
的整数,单个质心的计数超过这个值后,再并入的小计数会被舍入。AggregateFunctionQuantileTDigest.cpp
注册的函数是
quantileTDigest、quantilesTDigest
和别名 medianTDigest;同一版本里还有基于
DDSketch 的 quantileDD。
Prometheus:summary 不是 t-digest
Prometheus 的 summary 在客户端算分位数,但算法不是
t-digest。client_golang v1.20.5 的
prometheus/summary.go 导入
github.com/beorn7/perks/quantile,用
NewTargeted 为每个目标分位数维护误差,这是
Cormode、Korn、Muthukrishnan、Srivastava
的有偏分位数算法(CKMS,ICDE
2005)。它还用滑动时间窗:DefMaxAge = 10 * time.Minute,DefAgeBuckets = 5。Prometheus
文档 practices/histograms.md 的对比表把 summary
的聚合一栏写作”Not aggregatable”:各实例上报的 P99
不能再合成全局 P99,这正是第一节的问题。
需要可聚合的延迟分布时,Prometheus 的答案是
histogram,而不是换一种摘要。传统 histogram
用固定桶;原生直方图(native
histogram)用指数桶,相邻桶边界之比是 \(2^{2^{-s}}\),schema \(s \in [-4, 8]\),由
NativeHistogramBucketFactor
选定上限。client_golang v1.20.5
的注释把它标为实验特性,要求 Prometheus 服务端 v2.40
以上。指数桶的思路与 DDSketch
相同:保证相对值误差、合并就是桶计数相加,和 t-digest
没有关系。
九、与 GK、KLL、ReqSketch、DDSketch、HDR Histogram 的比较
这些结构回答的是不同的问题:保证什么误差(加性秩误差、相对秩误差、相对值误差),是否可证明,能否任意合并。
| 结构 | 误差类型 | 保证 | 空间 | 合并 |
|---|---|---|---|---|
| GK(SIGMOD 2001) | 加性秩误差 \(\varepsilon\) | 确定性 | \(O(\varepsilon^{-1}\log(\varepsilon n))\) | 单向可合并 |
| KLL(FOCS 2016) | 加性秩误差 \(\varepsilon\) | 以概率 \(1 - \eta\) | \(O(\varepsilon^{-1}\log\log(1/\eta))\) | 完全可合并 |
| ReqSketch(PODS 2021) | 相对秩误差 \(\varepsilon\) | 以常数概率 | \(O(\varepsilon^{-1}\log^{1.5}(\varepsilon n))\) | 完全可合并 |
| DDSketch(VLDB 2019) | 相对值误差 \(\alpha\) | 确定性 | 与值域的对数跨度成正比,可设上限 | 完全可合并 |
| HDR Histogram | 相对值误差(有效数字位数) | 无公开证明 | 由值域与精度决定 | 桶计数相加 |
| t-digest | 经验上尾部秩误差小 | 无 | \(\le \lceil\delta\rceil\) 个质心(\(k_0\)/\(k_1\)) | 单向可合并;结果依赖顺序、无误差界 |
几点需要展开:
- GK 对每个保存的元素记录秩的上下界,误差界是确定性的。Cormode 与 Veselý(PODS 2020)证明了确定性比较模型下 \(\Omega(\varepsilon^{-1}\log(\varepsilon n))\) 的空间下界,GK 因此是最优的。DDSketch 论文说 GK 只被证明”单向”可合并(one-way mergeable),即合并操作本身不能再分布式地进行;同一段话把 t-digest 一类有偏摘要也归为单向可合并。
- KLL 用一串容量递减的压缩器(compactor),每次随机保留奇数位或偶数位元素,达到了随机算法的最优空间。它的误差对所有分位数相同,要想在 P99.9 上达到 \(10^{-4}\) 的秩误差,就得把 \(\varepsilon\) 整体设到 \(10^{-4}\)。
- ReqSketch 在 KLL 的框架上把误差改成相对秩误差,越靠近一端越准,是 t-digest 目标的”有证明”版本。第七节已经看到它在自然分布上不如 t-digest 准,但没有被困难分布打穿。
- DDSketch 把正数 \(x\) 放进编号为 \(\lceil \log_\gamma x \rceil\) 的桶,\(\gamma = (1 + \alpha)/(1 - \alpha)\),桶内任意值用桶的代表值返回,相对误差不超过 \(\alpha\);负数用第二套桶,0 单独计数。桶数有上限时合并最低的桶,此时只有高分位数仍有保证。DDSketch 论文指出,t-digest 在重尾数据上仍可能有很大的相对值误差,这和第六节 \(k_0\)、\(k_1\) 在对数正态 P99.9 上的结果一致。
- HDR Histogram
用”有效数字位数”控制相对精度,只处理非负值,值域有界。它在工程上被广泛使用(ES
的
percentiles支持hdr方法),但 DDSketch 论文把它列为”没有公开的保证”。
在延迟监控这个最常见的场景里,用户问的是”P99 是多少毫秒”,这是值误差问题。DDSketch、HDR、Prometheus 原生直方图直接控制相对值误差,合并就是加计数,结果与合并顺序无关;t-digest 控制的是秩误差,换算成值误差要看数据形状。
十、工程选型与陷阱
- 需要可证明的误差或面对不可控输入时,不要依赖 t-digest。 第七节的困难分布是独立同分布数据,不需要攻击者;数据里同时有大量接近 0 的值和极大的异常值时,风险真实存在。此时选 KLL(加性秩误差)或 ReqSketch(相对秩误差)。
- 报告毫秒数、要跨实例聚合时,优先考虑相对值误差的结构。 DDSketch、HDR Histogram、Prometheus 原生直方图都满足”合并即加桶”;Prometheus summary 的分位数不能跨实例合成(第八节)。
- 选 t-digest 时,缩放函数决定尾部。 第六节中 \(k_0\) 在对数正态 P99.9 上的值误差是 437%,\(k_2\) 是 0.123%。Elasticsearch 默认用 \(k_2\);自己实现或选库时要确认用的是哪一个。
- 不要假设合并结果与分片方式无关。 第六节中仅仅把 100 个子摘要的合并顺序倒过来,\(k_2\) 的答案就相差最多 3280 ppm。测试断言应当给误差留余量,而不是比较不同分片数下的结果是否相等。
- 小数据上的测试不代表线上精度。
Elasticsearch 的
HybridDigest在 \(20 \times\)compression个样本以内是精确排序,本文实现在 \(\delta\) 个样本以内也是精确的;精度评估要用线上规模的数据量。 - 跨系统比较时先换算参数。 Elasticsearch
的
compression = 100是 \(k_2\) 的 \(\delta\),内部还以 2 倍构建;ClickHouse 的epsilon = 0.01是质心大小上限的系数,没有 \(\log\) 归一化,存储还是Float32。两个系统在同一份数据上给出不同的 P99 并不说明其中一个有 bug。 - 跨越多个数量级的数据是 t-digest 风险最高的场景。 第七节中同一份数据升序输入时,\(k_2\) 的最大误差从 39.47 降到 2.74 个百分点,说明问题出在一个质心混合了不同数量级的样本;DDSketch 的对数分桶从结构上不会发生这种混合。
十一、参考资料
规范与文档
- Prometheus 文档,Histograms
and summaries(
prometheus/docs仓库中的practices/histograms.md,提交 218274e)。
源码
- tdunning/t-digest:参考实现,2013-11-19 创建,Apache-2.0。
- elastic/elasticsearch
v8.15.0:
libs/tdigest/src/main/java/org/elasticsearch/tdigest/下的MergingDigest.java、AVLTreeDigest.java、HybridDigest.java、TDigest.java;server/src/main/java/org/elasticsearch/search/aggregations/metrics/下的PercentilesConfig.java、PercentilesMethod.java、TDigestState.java、TDigestExecutionHint.java。 - ClickHouse
v24.8.4.13-lts:
src/AggregateFunctions/QuantileTDigest.h、AggregateFunctionQuantileTDigest.cpp、QuantileDD.h。 - prometheus/client_golang
v1.20.5:
prometheus/summary.go、prometheus/histogram.go;summary 依赖的 beorn7/perksquantile包。
核心论文
- T. Dunning, O. Ertl. Computing Extremely Accurate Quantiles Using t-Digests. arXiv:1902.04023, 2019(预印本)。
- T. Dunning. Conservation of the t-digest Scale Invariant. arXiv:1903.09919, 2019(预印本)。
- T. Dunning. The Size of a t-Digest. arXiv:1903.09921, 2019(预印本)。
- G. Cormode, A. Mishra, J. Ross, P. Veselý. Theory meets Practice at the Median: A Worst Case Comparison of Relative Error Quantile Algorithms. KDD 2021, pp. 2722–2731. DOI 10.1145/3447548.3467152;arXiv:2102.09299。
其他论文
- J. I. Munro, M. S. Paterson. Selection and Sorting with Limited Storage. Theoretical Computer Science 12(3):315–323, 1980. DOI 10.1016/0304-3975(80)90061-4。
- M. Greenwald, S. Khanna. Space-Efficient Online Computation of Quantile Summaries. SIGMOD 2001, pp. 58–66. DOI 10.1145/375663.375670。
- N. Shrivastava, C. Buragohain, D. Agrawal, S. Suri. Medians and Beyond: New Aggregation Techniques for Sensor Networks. SenSys 2004, pp. 239–249. DOI 10.1145/1031495.1031524。
- G. Cormode, F. Korn, S. Muthukrishnan, D. Srivastava. Effective Computation of Biased Quantiles over Data Streams. ICDE 2005, pp. 20–31. DOI 10.1109/ICDE.2005.55。
- P. K. Agarwal, G. Cormode, Z. Huang, J. M. Phillips, Z. Wei, K. Yi. Mergeable Summaries. PODS 2012, pp. 23–34, DOI 10.1145/2213556.2213562;期刊版 ACM TODS 38(4), 2013, DOI 10.1145/2500128。
- Z. Karnin, K. Lang, E. Liberty. Optimal Quantile Approximation in Streams. FOCS 2016, pp. 71–78. DOI 10.1109/FOCS.2016.17。
- C. Masson, J. E. Rim, H. K. Lee. DDSketch: A Fast and Fully-Mergeable Quantile Sketch with Relative-Error Guarantees. PVLDB 12(12):2195–2205, 2019. DOI 10.14778/3352063.3352135。
- G. Cormode, P. Veselý. A Tight Lower Bound for Comparison-Based Quantile Summaries. PODS 2020, pp. 81–93. DOI 10.1145/3375395.3387650。
- G. Cormode, Z. Karnin, E. Liberty, J. Thaler, P. Veselý. Relative Error Streaming Quantiles. PODS 2021, pp. 96–108, DOI 10.1145/3452021.3458323;期刊版 JACM 70(5), 2023, DOI 10.1145/3617891。
- J. Ross. Asymmetric Scale Functions for t-Digests. Journal of Statistical Computation and Simulation 92(1):191–210, 2022. DOI 10.1080/00949655.2021.1936523。
- T. Dunning. The t-digest: Efficient Estimates of Distributions. Software Impacts 7:100049, 2021. DOI 10.1016/j.simpa.2020.100049。
工程资料
- HdrHistogram 项目 README:有效数字位数与值域配置。
实验
- 本文
reproduce/:tdigest.h、tdigest.c(merging 变体、\(k_0\) 到 \(k_3\)、交替方向、第 2.9 节插值);tdexp.c(自检与全部实验);run.sh;plot.py(matplotlib 图);draw_merge_pass.py(合并扫描示意图);results/(本文使用的原始输出)。
系列导航: - 上一篇:Count-Min Sketch:点查询误差界、保守更新与生产实现 - 下一篇:水塘抽样:Algorithm R/L/Z、加权键与样本合并
相关阅读: - HyperLogLog:从概率计数到 Redis 实现的基数估计 - 频率估计与 Heavy Hitter:Misra-Gries、Space-Saving 与空间下界 - 流式算法总论:数据流模型、频率矩下界与线性 sketch
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
【可观测性工程】Logs:Loki、ClickHouse、Elasticsearch、OpenObserve 的取舍
从日志场景分类出发,深入对比 Elasticsearch/OpenSearch、Grafana Loki、ClickHouse、OpenObserve 四大方案在全文检索、写入吞吐、存储成本、多租户和运维复杂度上的本质差异,结合 B 站、知乎 ClickHouse 日志平台实践,给出选型决策矩阵与工程坑点。
【可观测性工程】时序数据库内核:TSM、TSI、倒排索引与 Gorilla 压缩
深入时序数据库的存储内核:Prometheus TSDB 的 WAL 与块管理、InfluxDB 的 TSM 引擎与 TSI 倒排索引、Gorilla 压缩算法的数学原理、VictoriaMetrics mergeset 架构、ClickHouse MergeTree 作为 metrics 后端,以及国内大厂在 series churn 和 compaction 风暴上踩过的坑。
HyperLogLog:从概率计数到 Redis 实现的基数估计
12 KB 的 HyperLogLog 误差从哪来:沿 FM85、LogLog、HLL、HLL++ 到 Ertl 估计器推导,用 1000 次模拟实测各代估计器在小、中、大基数上的偏差,并对照 Redis 7.2.5 源码拆解稀疏/密集编码和三次更换的估计公式。
流式算法总论:数据流模型、频率矩下界与线性 sketch
一遍扫描、内存远小于数据时能算什么:梳理三种流模型、Morris 到 AMS 与 Indyk 的谱系、通信复杂度下界,实测 AMS F2 sketch 误差随计数器数的变化,说明线性 sketch 为何可合并、可删除,并把本系列 30 到 35 篇串成路线图。